صورة رمزية لدورة لا تحرك سوى فمها يمكنها أن تجذب الانتباه لجملة واحدة، ثم تفقد الدرس. فيديوهات مدرب الدورة بالذكاء الاصطناعي OmniHuman 2.0 تمنحك طريقة لتخطيط تعبير مرئي، وإيماءات هادفة، واتجاه كاميرا حول شرح مسجّل. يوضح مثال تباين الألوان أدناه مشهد مدرب كامل مدته 30 ثانية، وبقدر الفائدة نفسها، مشكلة استمرارية في عنصر مساعد يجب التقاطها قبل نشر الدرس.
النقاط الرئيسية
- المدخلات الأساسية هي صورة المدرب والصوت؛ ويمكن لموجه نصي أن يوجّه الأداء أو اتجاه الكاميرا.
- تعامل مع OmniHuman 2.0 كمرحلة فيديو المقدّم. ما زلت مسؤولاً عن الدرس والشرائح وتسجيلات الشاشة والتحقق من الحقائق والتعديلات.
- يوضح مثال تباين الألوان مدته 30 ثانية تغييرات مفيدة في الإيماءات ووجهة النظر، إضافة إلى بطاقة تختفي تحتاج إلى مراجعة تحريرية.
- راجع مزامنة الشفاه والتعبير والإيماءات وثبات الصورة والحقوق قبل النشر.
- يسرد Atlas Cloud السعر $0.07 لكل ثانية ويعرض سعراً مخفضاً $0.056؛ أكّد السعر الحالي قبل التوليد.
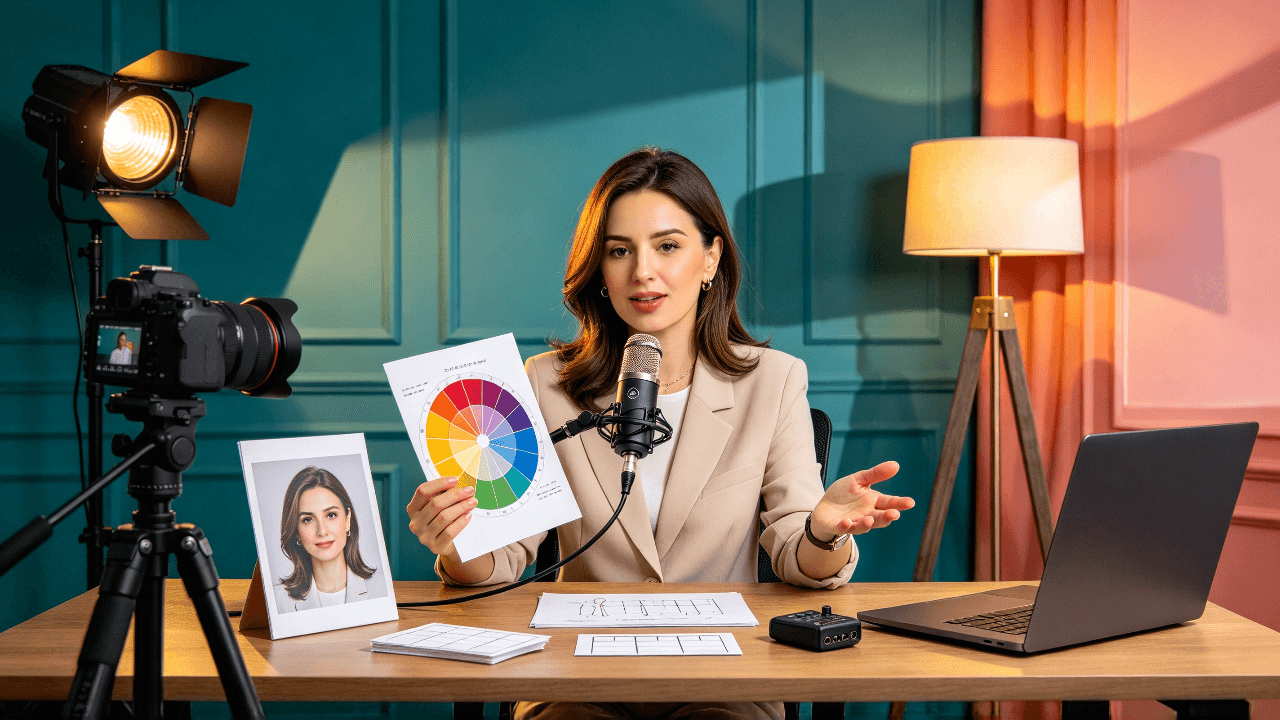
مشهد تحضيري توضيحي: صورة مرجعية، وتسجيل تعليق صوتي، ومواد الدرس هي المدخلات التي يجب تخطيطها قبل إنشاء فيديو مقدّم.
ما الذي يقدمه OmniHuman 2.0 لفيديوهات مدرب الدورة؟
يحوّل OmniHuman 2.0 صورة مرجعية ومساراً صوتياً إلى فيديو بدقة 720p للشخص الظاهر في الصورة وهو يتحدث أو يغني. يصف دليل نماذج Atlas Cloud التوجيه النصي الاختياري، والإيماءات الديناميكية، والمشاهد متعددة الأشخاص، وحركة الكاميرا، ومقاطع تصل إلى خمس دقائق. هذه قدرات مدرجة، وليست ضماناً بأن كل موجه دورة سيُنتج لقطة مناسبة.
(تفاصيل نموذج Avatar Omni Human 2.0)
توزيع المسؤوليات مهم. أنت توفّر المحتوى التعليمي والتسجيل الصوتي. ويولّد النموذج الأداء المرئي. وأنت تقرر أين يفيد وجود مقدّم وأين يشرح المخطط أو الشريحة أو تسجيل البرنامج أو العرض القريب المادة بشكل أفضل.
| عنصر الإنتاج | ما تجهزه أو تفعله | ما يسهم به النموذج | ما تراجعه |
|---|---|---|---|
| صورة المدرب | صورة واضحة مسموح باستخدامها | مرجع الهوية المرئي | اتساق الوجه والملابس والخلفية |
| تعليق الدرس | تسجيل مُراجَع بإيقاع مدروس | أداء نطق مدفوع بالصوت | التوقيت والنطق والوقفات |
| التوجيه | ملاحظة موجزة عن التأطير والأداء | أداء موجّه بالتعليمات واتجاه الكاميرا | ما إذا كانت الحركة تدعم الدرس |
| الوسائل التعليمية المرئية | شرائح أو تسجيلات شاشة أو مخططات أو أمثلة | لا بديل عن هذه المواد | ما إذا كان كل مفهوم سهل المتابعة |
| الدرس النهائي | تحرير وتسميات توضيحية ومراجعة جودة | مقطع فيديو مُولّد | الدقة وإمكانية الوصول والأذونات |
تصف ورقة بحثية مبكرة عن OmniHuman تحريك الإنسان المكيّف بالصوت، لكنها تغطي OmniHuman-1 ولا ينبغي اعتبارها اختبار أداء للإصدار 2.0. لاتخاذ قرار إنتاج دورة، اعتمد على قائمة النموذج الحالية لمدخلاتها المعلنة وحدود الإخراج، ثم احكم على عيّنة صُنعت بموادك الخاصة. (ورقة OmniHuman-1)
ما يجب تحضيره قبل توليد فيديو مدرب بالذكاء الاصطناعي
لا تعتمد عيّنة مقنعة على مجرد رفع أي صورة شخصية وأي تسجيل. اختر مواد تسهّل الحكم على ما إذا كانت النتيجة تناسب درساً حقيقياً.
اختر صورة مدرب واضحة ومسموحاً باستخدامها
استخدم صورة شخصية بمواجهة أمامية أو بانحراف طفيف مع وجه ظاهر بوضوح، وكتفين داخل الإطار، وخلفية غير مزدحمة. تجنّب وجهاً صغيراً جداً، أو حجباً كبيراً، أو ظلالاً درامية، أو قصاً لا يترك مساحة لحركة رأس طبيعية. إذا أردت المقدّم نفسه عبر الوحدات، احتفظ بنسخة من صورة المصدر المعتمدة وأعد استخدامها باستمرار.
استخدم صورتك الخاصة أو أكّد أن الشخص منح الإذن للاستخدام المقصود في الفيديو الاصطناعي. مجرد توافر صورة شخصية على الإنترنت لا يثبت الإذن بتحريكها أو نشرها.
سجّل صوت الدرس ليبدو طبيعياً أمام الكاميرا
سجّل نقطة تعليمية متماسكة واحدة بإيقاع مدروس. فقرة قصيرة أسهل في التقييم والمراجعة من محاضرة كاملة. قبل التسجيل، تحقق من المصطلحات والأسماء والأرقام والادعاءات الواقعية في الدرس. اترك وقفات طبيعية بين الأفكار، لكن قلّص الفجوات الطويلة وضجيج الخلفية الذي قد يجعل تقييم التوقيت أصعب.
استمع مرة واحدة ونص الدرس أمامك. إذا كان رقم أو مصطلح تقني غير واضح في التسجيل، فأصلح الصوت المصدر أولاً. لا يمكن لوجه مُولّد أن يصلح شرحاً غير صحيح أو نطقاً غامضاً.
اجعل الدرس مفيداً دون الصورة الرمزية
اكتب الشرح بحيث يبقى مفهوماً عند دمجه مع شريحة أو تسجيل شاشة. استخدم المقدّم للسياق والانتقالات والشروح القصيرة. استخدم تسجيل شاشة لإجراء برمجي، ومخططاً معنوناً لعملية، ومثالاً محلولاً لعملية حسابية. ثم حرّر تلك العناصر معاً في محرر الدورة لديك.
جهّز حزمة عيّنة تحتوي على الصورة الشخصية، وتعليق صوتي كامل واحد، ومُوجّه توجيه، والشريحة الداعمة أو تسجيل الشاشة الذي تتوقع استخدامه. يمنحك ذلك اختباراً عملياً لسلسلة الإنتاج بدلاً من تحريك وجه معزول.
كيفية إنشاء فيديو مدرب دورة باستخدام OmniHuman 2.0
هدف التوليد الأول هو اتخاذ قرار: هل تساعد تركيبة المقدّم والصوت هذه في هذا الدرس؟ أبقِ الاختبار محدوداً ليسهل تشخيص النتيجة الضعيفة.
ابدأ بمقطع درس قصير واحد
اختر فكرة كاملة تقدّم مفهوماً، وتعطي مثالاً واحداً، وتنتهي إلى خطوة تالية واضحة. لا تقطع جملة إلى نصفين للوصول إلى مدة مستهدفة. يستغرق المثال المرفق أدناه 30 ثانية، وهو طويل بما يكفي لإظهار فعل مرئي ووجهة نظر كاميرا متغيّرة. تحقق من مدة الصوت المدعومة فعلياً وقواعد الإدخال الحالية في واجهة النموذج المباشرة قبل الرفع.
ارفع الصورة والتعليق الصوتي، ثم وجّه الأداء
افتح ملعب Avatar Omni Human 2.0 لفحص المدخلات الحالية. جهّز الصورة والتعليق الصوتي بنفسك؛ إذ تصف قائمة النموذج تحويل الصورة والصوت إلى فيديو، وليس سير عمل تحويل النص إلى كلام. إذا لم تكن قد سجّلت الصوت بعد، فأنشئه وراجعه في سير عمل الصوت المفضل لديك قبل هذه الخطوة.
في سير العمل هذا، يحدد الصوت المرفق الكلمات المنطوقة والإيقاع. ويوجّه المُوجّه النصي الأفعال المرئية والتعبيرات وحركة الكاميرا. راجع نتيجتك المُولّدة بنفسك قبل وصف أي حركة مخطط لها كمخرَج ناجح. يسرد Atlas Cloud مخرجات بدقة 720p ومقاطع تصل إلى خمس دقائق، لكن عناصر التحكم المباشرة والمهمة المكتملة هما الفحص النهائي لتشغيلك الخاص.
راجع المقطع قبل إنشاء درس كامل
شاهد النتيجة مرة مع الصوت، ثم مرة أخرى مع متابعة نص الدرس. سجّل اللحظة الدقيقة التي تبدو فيها حركة الفم أو الوقفة أو الإيماءة مشتتة. إذا ظهرت المشكلة عند عبارة معينة، فقصّر تلك الجملة أو أعد تسجيلها وولّد مقطعاً منقحاً فقط. إذا بقي الوجه مقنعاً لكن الشرح يحتاج مخططات، فأبقِ لقطة المقدّم وأضف تلك المرئيات في التحرير.
فقط بعد أن يجتاز مقطع واحد المراجعة ينبغي أن تعيد استخدام الصورة الشخصية المعتمدة ونمط التسجيل وبنية المُوجّه في قسم الدرس التالي. يأتي الاتساق من عملية إدخال قابلة للتكرار؛ وهو لا يعني أن كل مقطع مُولّد سيكون متطابقاً.
مثال تطبيقي: درس تباين الألوان لمدة 30 ثانية
للدرس مهمة مرئية واحدة: أن يرى المتعلمون كيف يتغير الاقتران الزاهي بين المرجاني والأزرق المخضر عند دخول أصفر أهدأ إلى الترتيب. تتيح لك صورة مدرب مرفقة، وإطاران مختاران من الفيديو المكتمل، والمقطع الكامل، فحص فعل التعليم الفعلي بدلاً من استنتاجه من مُوجّه. يوضح المثال تصميم المشهد والمراجعة التحريرية؛ اختبر سير العمل الموضح أعلاه بصورتك وصوتك المعتمدين قبل استخلاص استنتاج حول مخرجاته.
ابدأ بتركيب بصري يدعم التعليم
تحتوي صورة الإدخال على وجه واضح ويدين ظاهرتين، مع ثلاث بطاقات مطفية على طاولة العمل. المرجاني والأزرق المخضر والأصفر كلها موجودة قبل بدء أي حركة. ينشئ قوس الاستوديو الأزرق المخضر واللوح المرجاني والزجاج الكهرماني خلفية ملونة مع إبقاء البطاقات سهلة التمييز.
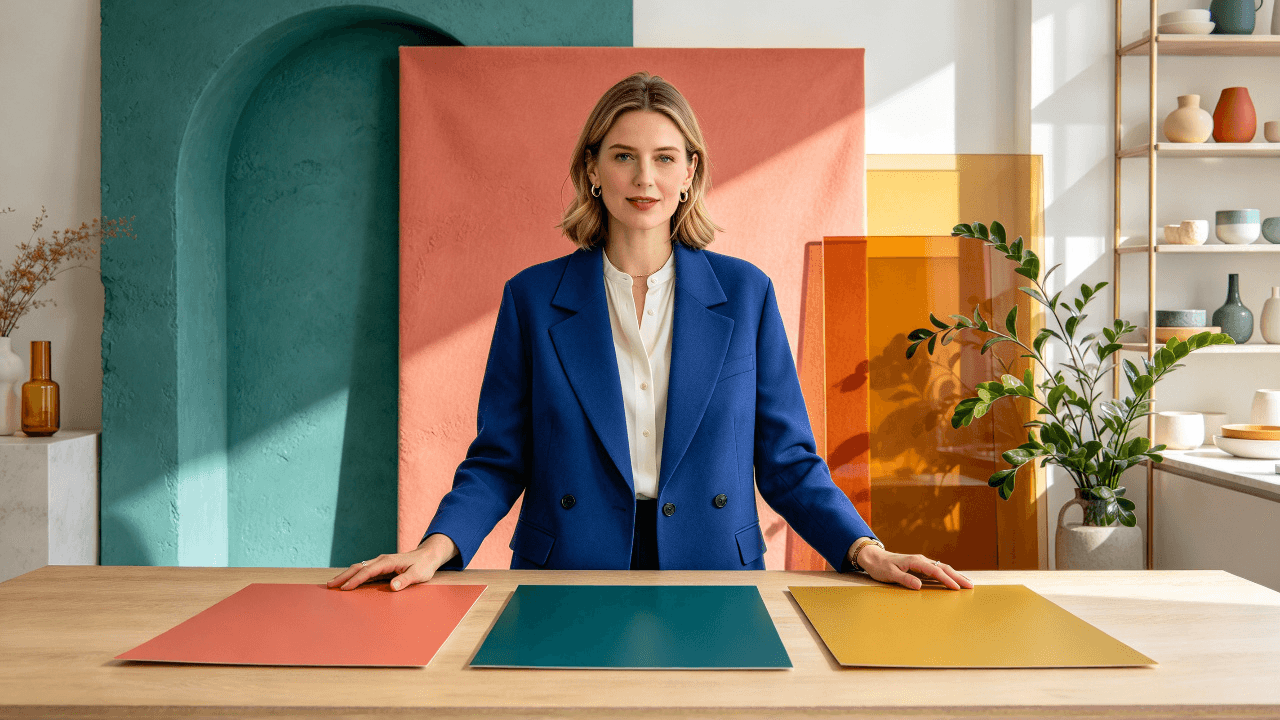
تُبقي صورة المرجع المرفقة وجه المدرب ويديه وثلاثة عناصر تعليمية مساعدة ظاهرة بوضوح قبل التحريك.
المقارنة الأولى قابلة للقراءة
في وقت مبكر من المقطع، تحوّل المدربة انتباهها إلى طاولة العمل وتضع يداً قرب الحد بين المرجاني والأزرق المخضر. اقتربت الكاميرا أكثر من الصورة المرجعية الثابتة، لكن وجهها والألوان الثلاثة الأصلية تبقى ظاهرة. يُظهر هذا الإطار الفعل الذي يحتاج المتعلم إلى متابعته: قارن لونين متجاورين قبل تغيير الترتيب.
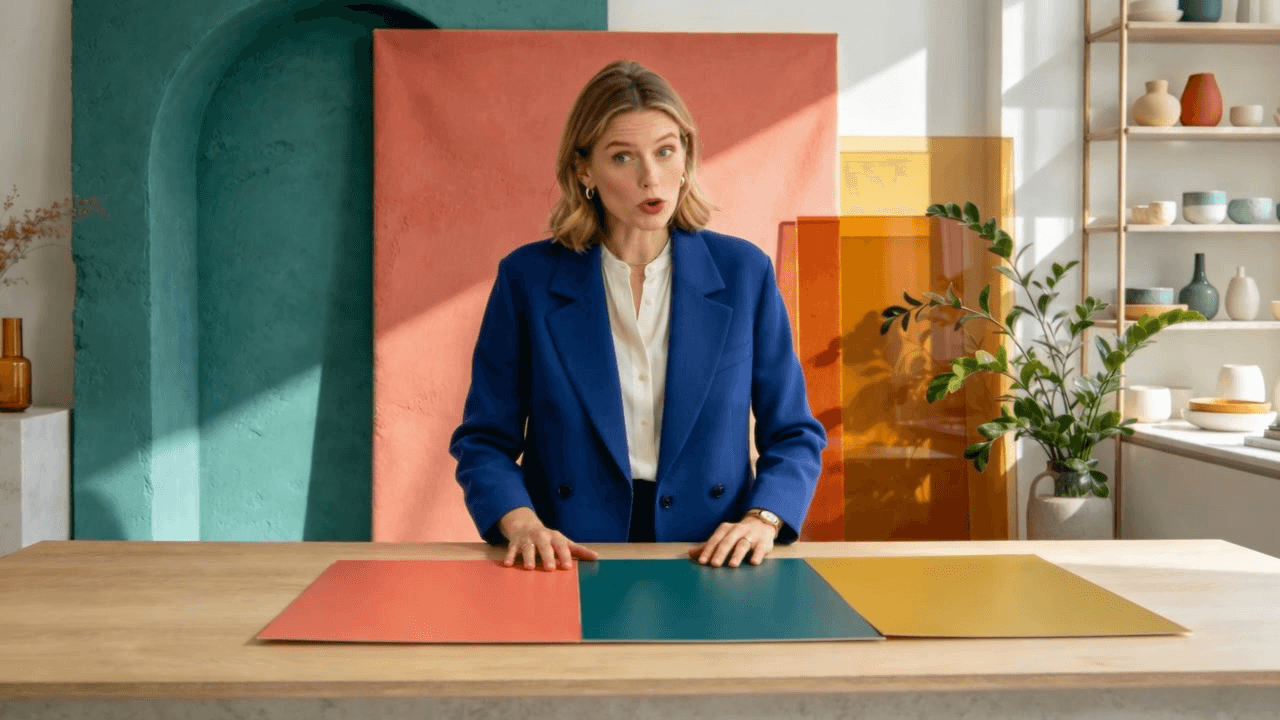
إطار حقيقي من الفيديو المرفق: توجّه المدربة الانتباه إلى الحافة بين المرجاني والأزرق المخضر بينما تبقى البطاقات الثلاث كلها ظاهرة.
وجهة النظر المتغيّرة تكشف مشكلة استمرارية
لاحقاً، تنتقل وجهة النظر إلى الجانب الآخر من الطاولة وتشير المدربة نحو الأصفر. لم تعد بطاقة الأزرق المخضر ظاهرة. وهذا يختلف عن ترتيب البطاقات الثلاث المخطط له، حيث كان الأصفر سيجلس بين المرجاني والأزرق المخضر. تمنح اللقطة الأقرب والتعبير المشهد تنوعاً، لكن البطاقة المفقودة تغيّر المثال التعليمي. لو كان هذا درساً نهائياً في دورة، لاحتاج تغيير العنصر المساعد إلى لقطة أخرى أو تعديل يجعل المقارنة المقصودة دقيقة.
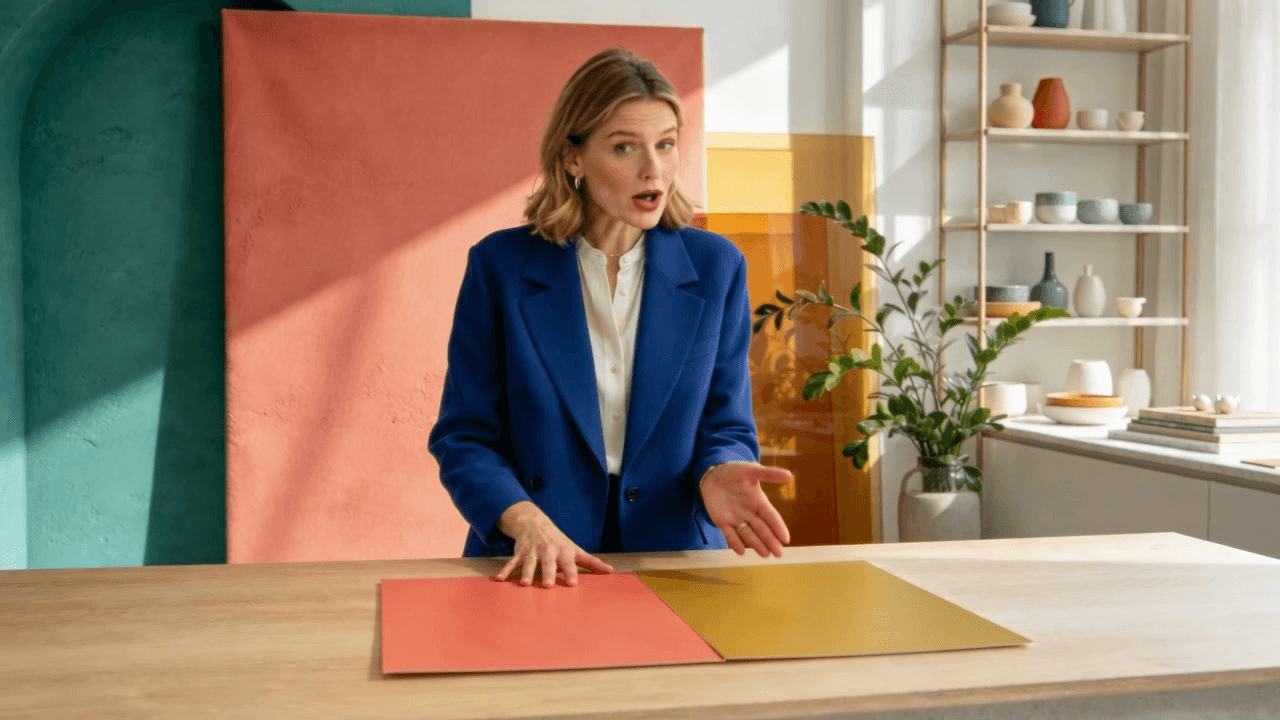
إطار لاحق من المقطع نفسه: تتغير زاوية الكاميرا والإيماءة، بينما اختفت بطاقة الأزرق المخضر من الترتيب.
شاهد المشهد الكامل مع الصوت
يستغرق الفيديو المرفق ما يزيد قليلاً على 30 ثانية ويتضمن مساراً صوتياً. شاهده كمثال متصل واحد كي يمكن الحكم على الإيماءات والتعبير وحركة الكاميرا والصوت معاً. الصورتان الثابتتان أعلاه دليلان على لحظتين مختلفتين، وليستا حالتين مُولّدتين منفصلتين.
ينجح المشهد في منح المدربة أكثر من مجرد مواجهة الكاميرا: فهي تتعامل مع العناصر المساعدة، وتغيّر نظرتها، وتُعرض من أكثر من وجهة نظر. بطاقة الأزرق المخضر المختفية هي نتيجة المراجعة المهمة. لا تُبقِ درساً نهائياً إلا عندما يطابق المثال المرئي ما يُفترض أن يفهمه المتعلم، وتحقق من الشرح المنطوق مقابل الصوت قبل النشر.
كيفية التحقق من جاهزية فيديو المدرب بالذكاء الاصطناعي
استخدم تمريرة مراجعة تفحص كلاً من الأداء المُولّد والدرس كما سيراه المتعلمون:
- توقيت الفم: هل تتبع حركات الفم بشكل عام المقاطع اللفظية الرئيسية والوقفات؟ أعد تشغيل الأسماء الصعبة والوقفات القصيرة.
- التعبير: هل يناسب الوجه شرحاً هادئاً، أم يتحول إلى ابتسامة غير ذات صلة أو عاطفة مبالغ فيها؟
- الإيماءات: هل تبقى اليدان بعيدتين عن الوجه وتتجنبان تشتيت الانتباه عن شريحة مهمة؟
- الهوية والمشهد: هل تبقى ملامح الوجه والملابس والخلفية مستقرة خلال المقطع؟
- دقة الصوت: هل تُنطق المصطلحات والأسماء والأرقام بشكل صحيح في التسجيل المرفق؟
- وضوح التعليم: هل يتضمن التحرير الشريحة أو تسجيل الشاشة أو الترجمة أو المثال المحلول المطلوب في اللحظة المناسبة؟
- الحقوق والإفصاح: هل لديك إذن للصورة والصوت، وهل راجعت قواعد الإفصاح وسياسة المؤسسة للجمهور والسوق المقصودين؟
قرر ما إذا كنت ستبقي المقطع، أو تراجع الصوت أو الصورة المصدر، أو تستخدم تعليقاً صوتياً مع الشرائح بدلاً من ذلك. لا تُبقِ لقطة مقدّم لمجرد أن التوليد استغرق وقتاً. قد يعلّم تسجيل شاشة واضح خطوة إجرائية بشكل أفضل.
التكلفة والتوسع لفيديوهات الدورات
اعتباراً من أكتوبر 2026، تسرد صفحة نموذج Atlas Cloud سعراً قياسياً قدره $0.07 لكل ثانية وتعرض سعراً مخفضاً قدره $0.056 لكل ثانية بخصم 20%. والتقديرات البسيطة من تلك الأسعار المدرجة هي:
| المدة المُولّدة | عند $0.07/ثانية | عند $0.056/ثانية المعروض |
|---|---|---|
| 20 ثانية | $1.40 | $1.12 |
| 60 ثانية | $4.20 | $3.36 |
| 5 دقائق | $21.00 | $16.80 |
هذه حسابات بسعر النموذج، وليست عرض سعر لحسابك أو ضماناً للرسم النهائي. قد يتغير الخصم المعروض، وقد تؤثر الضرائب أو شروط على مستوى الحساب أو رسوم أخرى في الدفع. أعد التحقق من تفاصيل النموذج وشاشة التأكيد الفعلية قبل الإنتاج.
تحدّ العيّنة القصيرة من تكلفة فحص صورة شخصية أو صوت أو مُوجّه جديد. للمواد الأطول، قسّم الدرس عند حدود تعليمية حقيقية مثل مفهوم جديد أو مثال محلول. لا تقسّم جملة أو تحذف شرحاً مطلوباً فقط لمطابقة حد التوليد. عند السعر القياسي المدرج، سيكون مخرَج مدته خمس دقائق $21 قبل أي خصم سارٍ؛ قارن ذلك بمقاطع أقصر زائد وقت التحرير وقرر أي تنسيق يخدم الدرس.
الخصوصية والموافقة وثقة الدورة
قبل التوليد، أكّد أنك تستطيع استخدام صورة المدرب وصوته لفيديو اصطناعي في الدورة وقناة التوزيع والمدة المقصودة. إذا ظهر متعاقد أو موظف أو محاضر ضيف أو طالب، فوثّق الإذن وأي حدود. تحقق من متطلبات مؤسستك للوسائط المُولّدة أو المعدلة بالذكاء الاصطناعي والقواعد المعمول بها في أسواقك المستهدفة؛ لا تحدد هذه المقالة الالتزامات القانونية.
راجع الدرس المكتمل كما يفعل المدرب. صحّح النص والتسجيل، وافصح عن العرض الاصطناعي حيث يتوقع جمهورك أو سياستك ذلك، وأبقِ إنساناً مسؤولاً عن ادعاءات الدورة. يمكن لمقدّم مصقول أن يجعل مادة ضعيفة أو غير مُراجَعة تبدو موثوقة، لذا ينبغي لمالك الدرس اعتماد الكلمات والتحرير النهائي معاً.
لأول إنتاج، أنشئ مقطعاً قصيراً واحداً، وراجعه مقابل قائمة التحقق، وقدّر الدفعة التالية باستخدام السعر الحالي لكل ثانية. يخبرك ذلك القرار الصغير ما إذا كانت فيديوهات مدرب الدورة بالذكاء الاصطناعي OmniHuman 2.0 تنتمي إلى سير عمل دورتك.
الأسئلة الشائعة
هل يمكن لـ OmniHuman 2.0 إنشاء فيديو دورة من النص وحده؟
تصف قائمة Atlas Cloud سير عمل تحويل الصورة والصوت إلى فيديو مع توجيه نصي اختياري. وهي لا تسرد النص العادي كبديل لصوت التعليق، لذا جهّز المسار الصوتي بشكل منفصل.
هل يمكنني إعادة استخدام صورة المدرب نفسها عبر دروس متعددة؟
يمكنك تجهيز الصورة المعتمدة نفسها لتوليدات منفصلة. تدعم إعادة استخدامها مرجعاً بصرياً متسقاً، وإن كانت لا تضمن تعبيرات أو تأطيراً أو إيماءات متطابقة في كل مخرَج. راجع كل مقطع قبل ضمها.
هل يولّد OmniHuman 2.0 صوت الدرس؟
يأخذ سير العمل المدرج مساراً صوتياً كمدخل. سجّل الصوت أو أنتجه بشكل منفصل، وتحقق منه، وارفع التعليق الصوتي المكتمل.
كم تبلغ تكلفة مقطع دورة مدته 20 ثانية من OmniHuman 2.0 على Atlas Cloud؟
عند السعر القياسي المدرج $0.07 لكل ثانية، تُحسب 20 ثانية بسعر $1.40. وعند السعر المعروض $0.056، تُحسب بسعر $1.12. أكّد التسعير الحالي والرسم النهائي قبل تشغيل التوليد.


