
 Atlas Cloud ist jetzt autorisierter US-Reseller von Dreamina Seedance 2.5 und Seedream 5.0 Pro.Atlas Cloud ist jetzt autorisierter US-Reseller von Dreamina Seedance 2.5 und Seedream 5.0 Pro.

Qwen ist die Large-Language-Model-Familie von Alibaba Cloud, und die Qwen API macht die gesamte Modellpalette für Entwickler zugänglich. Nutzen Sie das Flaggschiff Qwen3.7 Max für fortgeschrittenes Reasoning und Coding, effiziente Mixture-of-Experts-Modelle in vielen Größenordnungen sowie Qwen3.5 Flash für sofortige Antworten mit hohem Durchsatz. Auf Atlas Cloud läuft jedes Modell über einen einzigen Endpoint mit transparenter Pay-as-you-go-Preisgestaltung und Day-0-Zugriff auf neue Releases. Legen Sie noch heute los.
Qwen wurde von Alibaba entwickelt. Atlas Cloud (betrieben von Atlas Cloud AI LLC) stellt lediglich den Zugang bereit und ist nicht Eigentümerin des Modells. Alle Marken sind Eigentum ihrer jeweiligen Inhaber.
Atlas Cloud bietet Ihnen die neuesten branchenführenden kreativen Modelle.
Erfahren Sie, wie jeder Qwen API-Endpunkt Text-Prompts in generierten Text umwandelt – von schnellen, leichtgewichtigen Assistenten bis hin zu Flaggschiff-Modellen für Reasoning, damit Sie das passende Modell für Ihre Workload auswählen können.
| Modalität | Beschreibung |
|---|---|
| Qwen3.6 35B A3B (Text zu Text) | Das neueste Reasoning-Modell der Reihe: Dieser 35B Mixture-of-Experts-Endpunkt aktiviert etwa 3B Parameter pro Token, sodass tiefgehendes Reasoning bezahlbar bleibt. Nutzen Sie ihn für mehrstufige Mathematik-, Logik- und Analyseaufgaben, bei denen die Qualität des Chain-of-Thought wichtiger ist als reine Geschwindigkeit. |
| Qwen3.6 Plus (Text zu Text) | Qwen3.6 Plus ist vielseitig in Chat- und Produktivitäts-Workflows einsetzbar und kombiniert hohe Gesprächsqualität mit Prompt-Caching und gestaffelter Preisgestaltung für mehr als 256K Token. Greifen Sie darauf zurück, wenn Assistenten über lange Dokumente oder umfangreiche Multi-Turn-Sitzungen hinweg kohärent bleiben müssen. |
| Qwen3.5 122B A10B (Text zu Text) | Dieses 122B Mixture-of-Experts-Modell arbeitet mit rund 10B aktiven Parametern pro Token und tauscht etwas Skalierung gegen schnellere, günstigere Inferenz. Es eignet sich für allgemeine Textgenerierung, Zusammenfassung und Reasoning, wenn Sie Large-Model-Qualität zu Kosten im mittleren Segment wünschen. |
| Qwen3.5 35B A3B (Text zu Text) | Wenn Durchsatz und Budget gleichermaßen wichtig sind, hält dieser 35B MoE-Endpunkt nur etwa 3B Parameter pro Token aktiv. Nutzen Sie ihn für Chat, Entwürfe und Klassifizierung mit hohem Volumen, deren Ausführung auf einem Flaggschiff-Modell verschwenderisch wäre. |
| Qwen3.5 27B (Text zu Text) | Als dichtes 27B-Modell liefert Qwen3.5 27B vorhersehbare Latenz und konstante Qualität ohne Mixture-of-Experts-Routing. Es passt zu unkomplizierten Generierungs- und Instruction-Following-Aufgaben, die von einem kompakten, verlässlichen Backbone profitieren. |
| Qwen3.5 397B A17B (Text zu Text) | Das größte Modell im 3.5-Tier: Dieser 397B Mixture-of-Experts-Endpunkt aktiviert rund 17B Parameter pro Token und ergänzt Prompt-Caching, um Kosten für wiederholten Kontext zu senken. Setzen Sie es für anspruchsvolle Reasoning- und Generierungsaufgaben ein, die die größte Kapazität der Familie erfordern. |
| Qwen3.7 Max (Text zu Text) | Als Flaggschiff zielt Qwen3.7 Max auf fortgeschrittenes Reasoning, Coding und komplexe mehrstufige Aufgaben ab; Prompt-Caching reduziert die Kosten bei wiederholtem Kontext. Wählen Sie es für agentische Pipelines, schwierige Coding-Probleme und Workloads, bei denen Genauigkeit wichtiger ist als der Preis. |
| Qwen3.5 Plus (Text zu Text) | Qwen3.5 Plus ist auf Effizienz ausgelegt und unterstützt Alltagsaufgaben sowie AI-Assistenten, inklusive Prompt-Caching und Eingaben mit mehr als 256K Token. Es ist eine verlässliche Standardwahl für Produktionsassistenten, die stabile Qualität zu überschaubaren Kosten benötigen. |
| Qwen3.7 Plus (Text zu Text) | Sie brauchen Leistungsfähigkeit, Geschwindigkeit und Effizienz in einem Modell? Qwen3.7 Plus bringt alle drei in Balance, ergänzt Prompt-Caching und nutzt gestaffelte Preise für Prompts mit mehr als 256K Token. Setzen Sie es für skalierte Assistenten und dokumentenintensive Workflows ein, die dennoch schnelle Antworten verlangen. |
| Qwen3.5 Flash (Text zu Text) | Optimiert für sofortige Antworten und Nutzung in großem Maßstab ist Qwen3.5 Flash die schnellste und wirtschaftlichste Option der Familie. Nutzen Sie es in Chat mit hohem Traffic, Autocomplete und Echtzeitfunktionen, bei denen niedrige Latenz Priorität hat. |
| Qwen3 VL 235B A22B Thinking (Text zu Text) | Dieser auf Reasoning abgestimmte Endpunkt nutzt eine 235B Mixture-of-Experts-Architektur mit etwa 22B aktiven Parametern und einem dedizierten Thinking-Modus. Greifen Sie darauf zurück für strukturierte Problemlösung und Analyse, bei denen explizites, schrittweises Reasoning einen Mehrwert bietet. |
| Qwen3-235B-A22B-Instruct-2507 (Text zu Text) | Mit insgesamt 235B Parametern und rund 22B aktiven Parametern pro Token bewältigt dieses instruction-tuned MoE-Modell der Qwen3-Serie breite Textgenerierung und Reasoning. Das 2507-Release macht es zu einer soliden Wahl für Universalassistenten und Content-Pipelines auf der Qwen API. |
Die Qwen API vereint Dual-Mode Thinking, natives Function Calling, Kontext jenseits von 256K tokens, Abdeckung von 119 Sprachen und Prompt Caching hinter einem OpenAI-kompatiblen Schlüssel – von Qwen3.5 Flash bis Qwen3.7 Max.
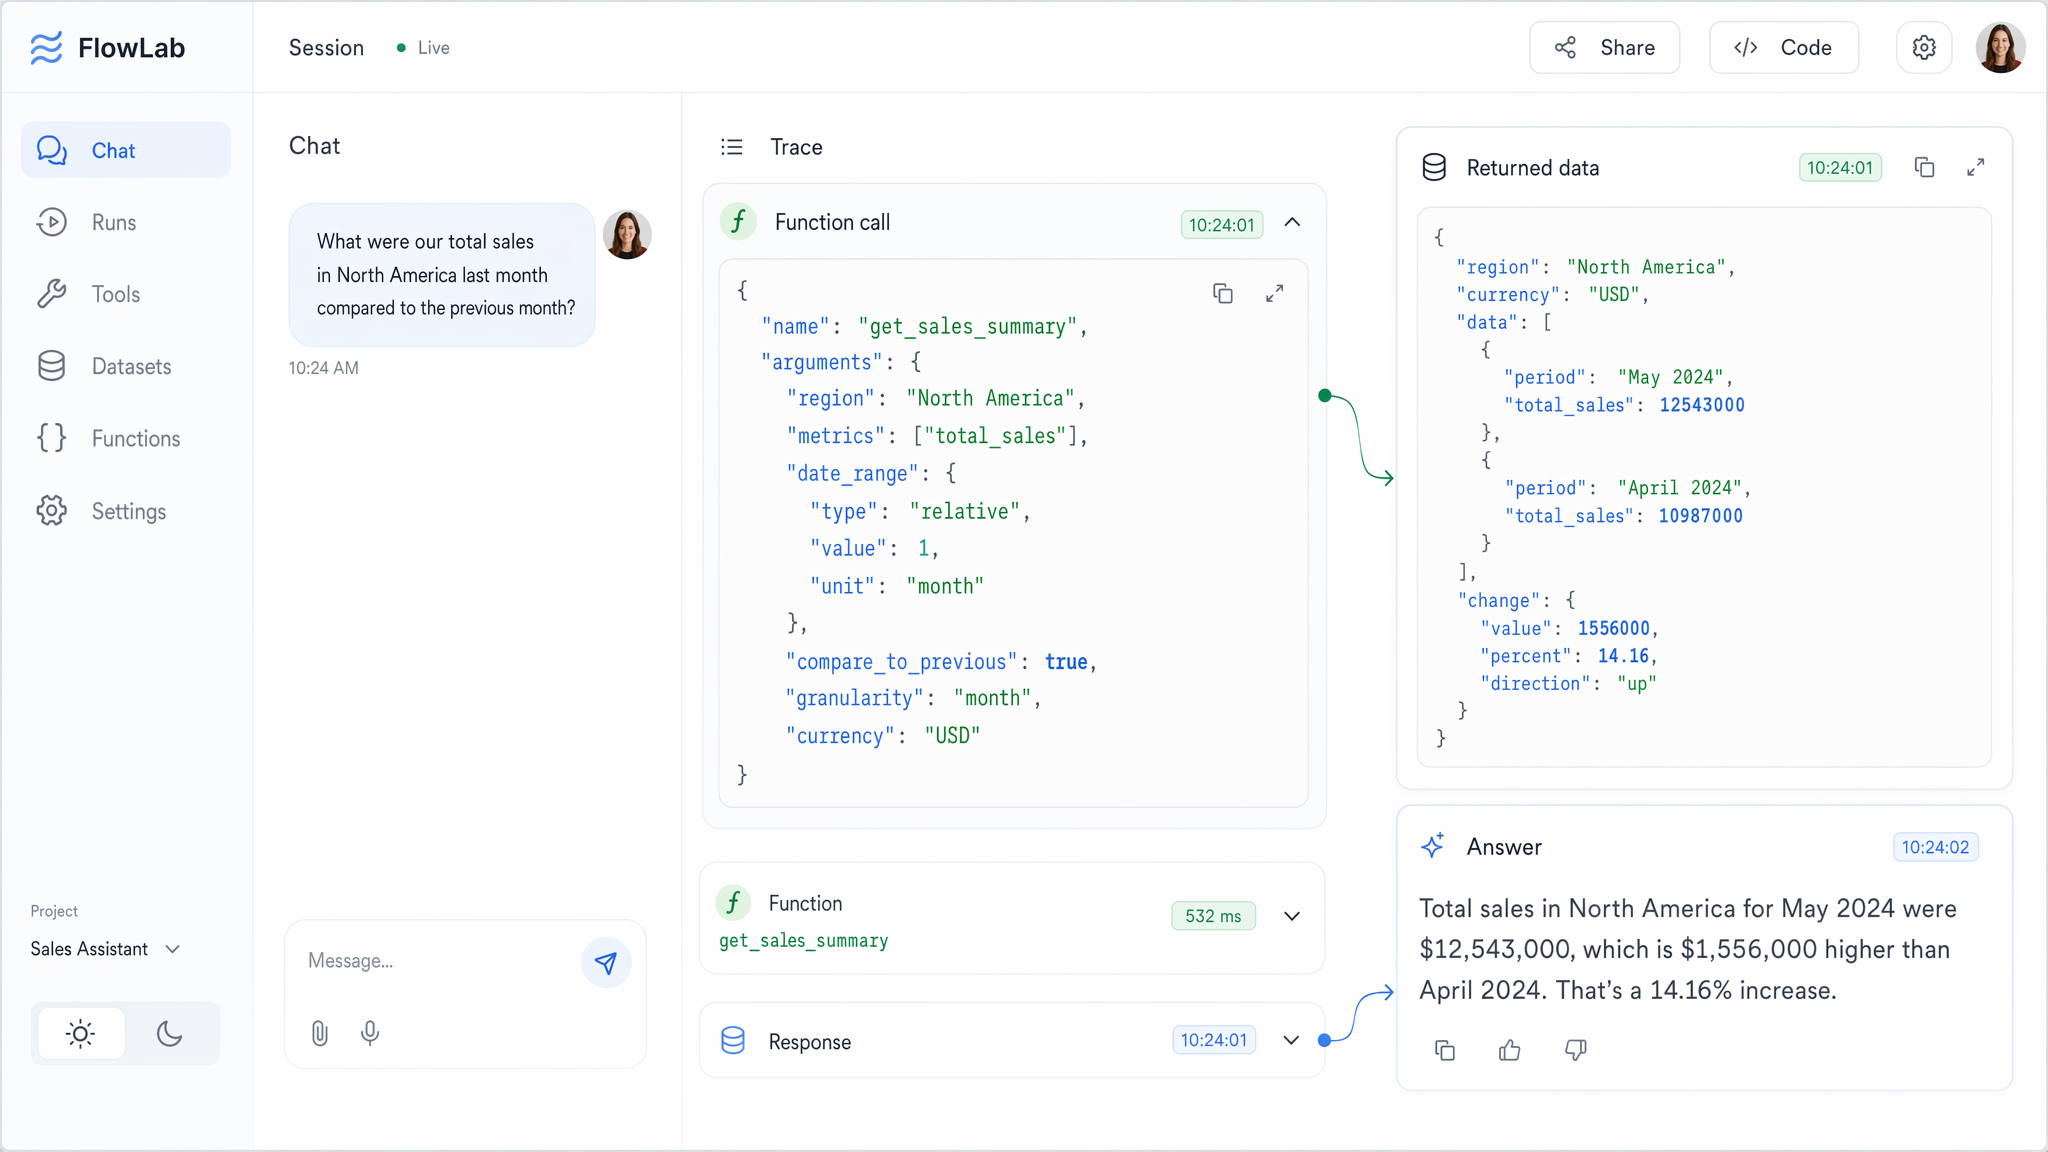
Function Calling ermöglicht es Qwen-Modellen, strukturierte Tool-Aufrufe auszugeben, die sich direkt an Ihre eigenen APIs, Datenbanken und MCP servers anbinden lassen. Das Modell entscheidet, wann eine Funktion aufgerufen wird, formatiert die Argumente und integriert das Ergebnis anschließend wieder in seine Antwort. In Kombination mit dem OpenAI-kompatiblen endpoint wird bestehender SDK-Code so zu autonomen Agents, Retrieval-Pipelines und Workflow-Automatisierungen.
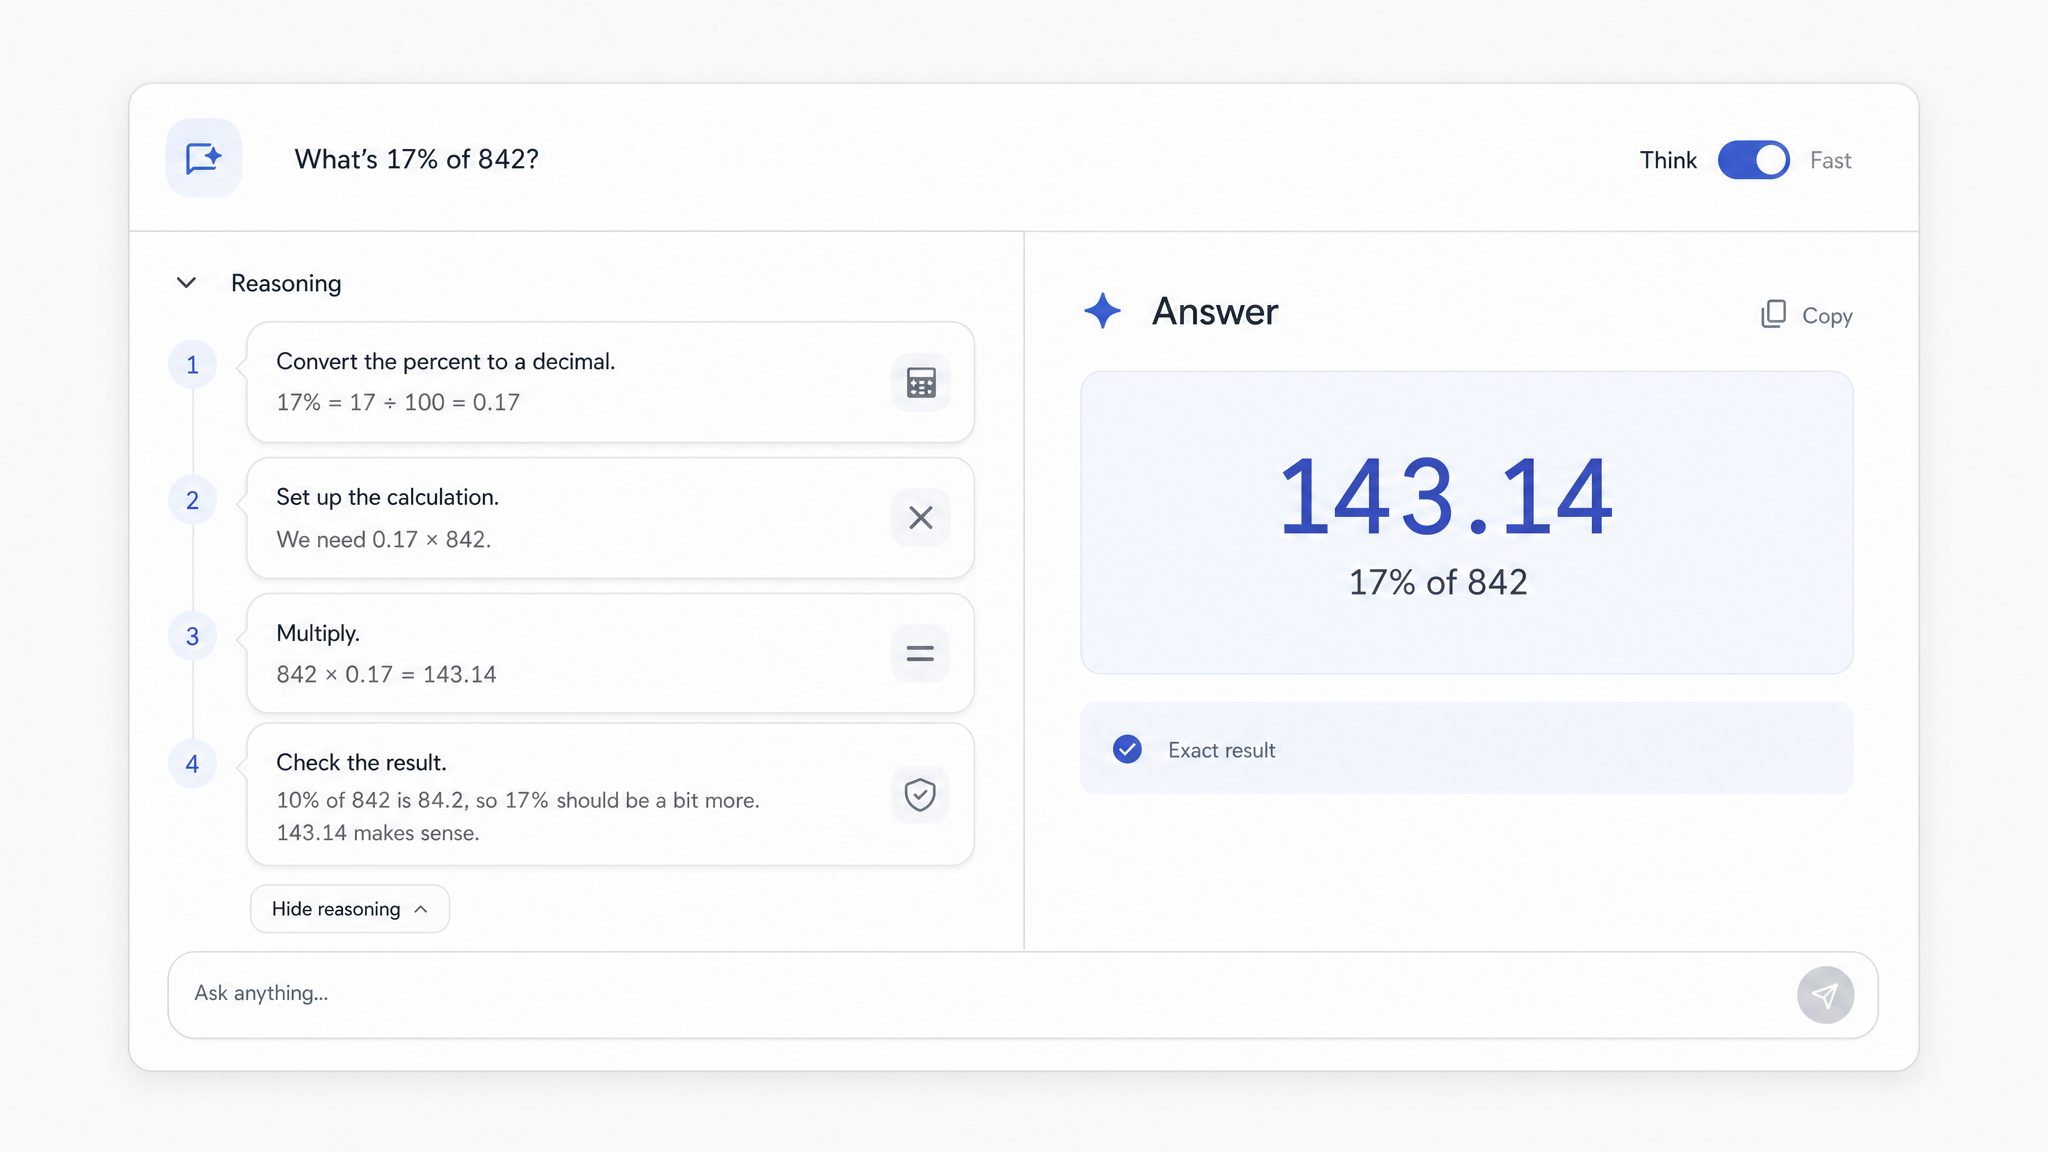
Schalten Sie ein einzelnes Modell zwischen einem bewussten Thinking Mode für Mathematik, Logik und Coding und einem schnellen Non-Thinking Mode für alltägliche Dialoge um. Reasoning-Modelle wie Qwen3.6 35B A3B und das Flaggschiff Qwen3.7 Max stellen diese Tiefe über einen einzigen endpoint bereit. Wenn eine Aufgabe schrittweise Schlussfolgerungen erfordert, aktivieren Sie Thinking; wenn Latenz zählt, schalten Sie es aus – ohne Modell- oder Schlüsselwechsel.
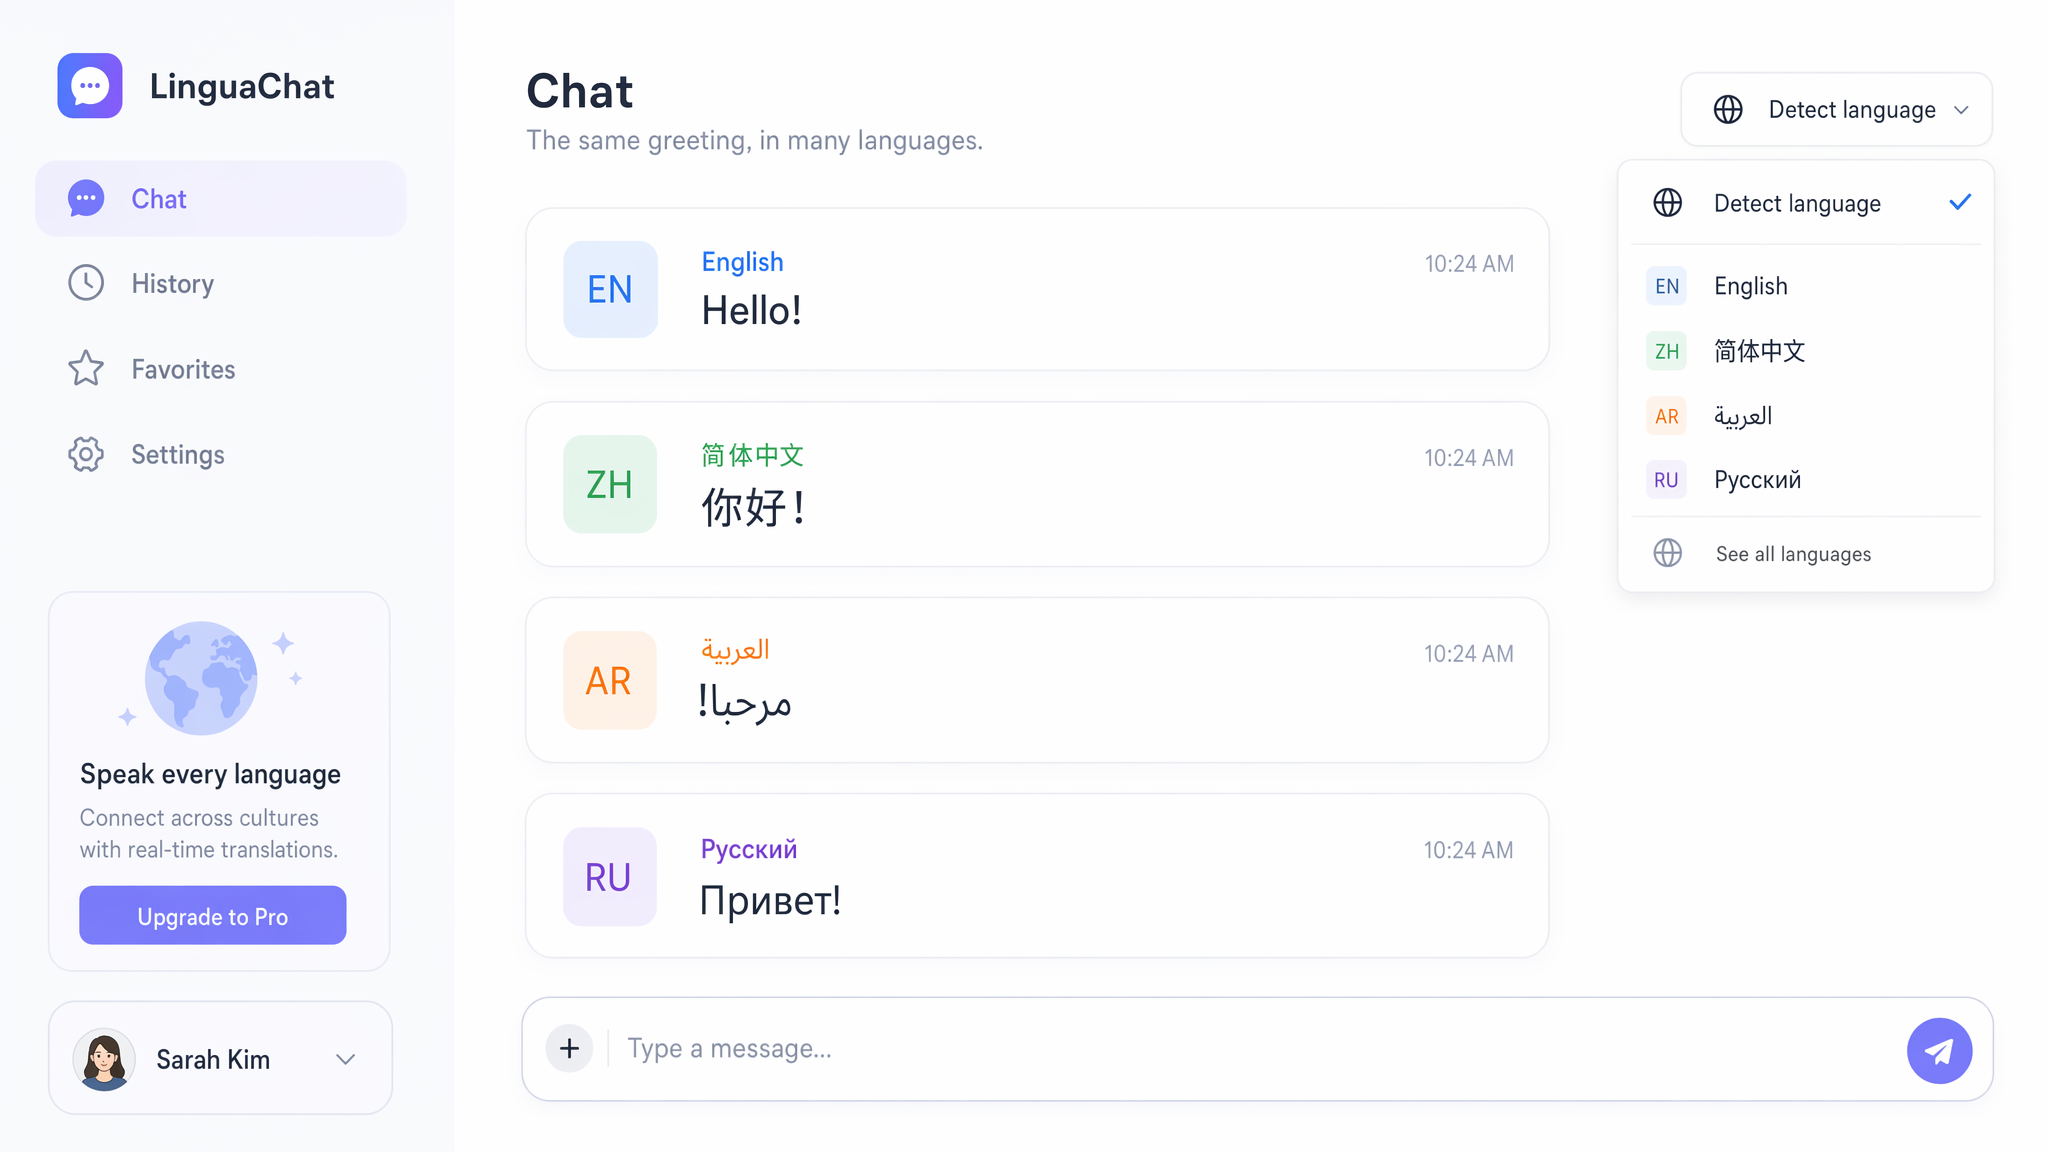
Qwen wurde auf 119 Sprachen und Dialekten trainiert und beherrscht mehrsprachige Anweisungsbefolgung und Übersetzung in Chinesisch und Englisch gleichermaßen flüssig. Ein einzelner Prompt kann zwischen Sprachen wechseln, ohne separaten Übersetzungsdienst. Teams, die für globale Zielgruppen veröffentlichen, nutzen es für lokalisierten Chat, sprachübergreifende Suche und Texte, die in jedem Zielmarkt natürlich klingen.
Vom latenzarmen Qwen3.5 Flash bis zum Flaggschiff Qwen3.7 Max reagiert die gesamte Familie auf einen einzigen OpenAI-kompatiblen Schlüssel. Effiziente mixture-of-experts-Designs wie 397B A17B und 235B A22B aktivieren pro token nur einen Bruchteil ihrer Parameter, und jede Leistungsstufe nutzt dasselbe Anfrageformat. Leiten Sie einfache Aufrufe an Flash und anspruchsvolles Reasoning an Max weiter, ohne auch nur eine Zeile Integrationscode umzuschreiben.
Wiederholter Kontext wird zu einem Cache-Tarif abgerechnet, der deutlich unter dem Standardpreis für Eingaben liegt. Dadurch kosten System-Prompts und gemeinsam genutzte Dokumente bei jedem Folgeaufruf weniger. Die Preisgestaltung bleibt Pay-as-you-go und transparent, mit veröffentlichten Preisen pro token und ohne Abonnement. Besonders profitieren Assistenten mit hohem Volumen, RAG-Stacks und lange Unterhaltungen, da dasselbe Präfix immer wieder gesendet wird.
Gib der Qwen API und konkurrierenden Engines ein identisches Briefing und beobachte dann, wie jedes Modell dieselbe Anweisung in eine funktionierende Single-File-Webseite verwandelt, die du sofort öffnen und anklicken kannst.
Erstelle eine vollständige, eigenständige HTML-Seite in einer einzigen Datei (sämtliches CSS und JavaScript inline in einer .html-Datei), die ein interaktives „Late-Night French Patisserie Window“ rendert — eine Boutique-Dessertvitrine, die nach Ladenschluss noch in warmem Licht leuchtet. Absolute Einschränkung: KEINE externen Ressourcen jeglicher Art — keine CDNs, keine verlinkten Stylesheets oder Scripts, keine Web Fonts, keine `<img>`-Tags, keine SVG-Dateien, keine base64-Fotos, keine Emoji als Kunst. Jedes visuelle Element muss rein aus HTML-Elementen bestehen, die mit CSS gestaltet sind: geschichtete linear/radial/conic gradients, gestapelte und inset box-shadows, border-radius, blur/backdrop-filter, transforms sowie nur Canvas- oder DOM-gezeichnete Formen. Dies ist ein Test für faux-realistische Material- und Lichtdarstellung allein mit Vector CSS. Die Szene: eine frontale Ansicht auf Augenhöhe in ein gläsernes Patisserie-Schaufenster, die Regale in einer ruhigen Drittelregel-Komposition angeordnet. Auf dem Regal steht eine Reihe von mindestens vier unterschiedlichen, sorgfältig ausgearbeiteten Desserts, jedes vollständig aus gradients und shadows aufgebaut: (1) eine glänzende Schokoladen-Kakao-Mousse-Kuppel mit Mirror-Glaze-Finish, die ein weiches specular highlight und reflektiertes Licht zeigt; (2) ein Mille-feuille mit vielen knusprigen, sichtbar getrennten Blätterteigschichten; (3) ein gestufter Macaron-Turm mit zuckerbestäubten, leicht matten Schalen; (4) eine Zitronentarte auf einem langsam rotierenden Turntable-Teller. Modelliere glaubwürdige Tiefe: warmes goldenes spotlight von oben (die Display-Lampe des Schaufensters) im Kontrast zu kühlem blauem Nachtambiente, mit cast shadows, rim light an Kanten und sanften glänzenden Reflexionen. Eine subtile Glasschicht schwebt vor allem — schwache Spiegelungen, Schlieren und verstreute Kondensationstropfen — und auf der Regalfläche darunter gibt es eine weiche Reflexion jedes Desserts. Interaktionen (alle mit flüssigen, federartigen CSS/JS transitions): - HOVER über ein Dessert: Es hebt sich sanft, sein spotlight und shadow werden intensiver, und eine Cross-Section-„Cutaway“-Animation zeigt seine innere Struktur — die geschichtete Creme, Ganache, Curd und den Biskuit-/Teigboden, gezeichnet als gestapelte gradient-Bänder mit Label. - CLICK auf ein Dessert, um in einen „Customize“-Modus zu wechseln: Ein elegantes Panel erscheint mit Sliders und Toggles, mit denen der Nutzer dekorative Elemente in Echtzeit hinzufügen und anpassen kann — gestreute Zuckerperlen (density slider), geträufelter gezogener Karamell (amount + strand thickness) und eine Mirror-Glaze/glossy pectin coat (glossiness slider), plus ein accent-berry-red Drizzle. Das Dessert muss live neu gezeichnet werden, während sich Werte ändern; highlight/gloss reagieren dabei auf den glossiness-Wert. Stelle eine „Reset“- und eine „Exit“-Steuerung bereit. Speichere die Customization jedes Desserts beim Wechsel zwischen ihnen. - Optionale Ambient-Details: ein schwaches animiertes Flackern der warmen Lampe, treibende Kondensation und die Zitronentarte, deren Turntable in einer Schleife rotiert. Visueller Stil: raffiniert, gemütlich, verführerische Late-Night-Stimmung; Palette aus Karamellbraun, Cremeweiß und Beerrot, akzentuiert mit Mintgrün, vor einem tiefen kühlblauen Nachthintergrund. Die Typografie soll wie eine schicke Patisserie wirken — setze Überschriften und Dessertnamen in einem eleganten CSS-only serif stack mit großzügigem letter-spacing; halte das Layout aufgeräumt, geordnet und responsive, sodass es von Mobile bis Widescreen gut aussieht. Priorisiere geschmackvolle Micro-Animations, geschichtete Tiefe und Materialrealismus gegenüber Überladung. Enthält alles, was nötig ist, um die Datei direkt im Browser zu öffnen und sofort damit zu interagieren. Gib ausschließlich das vollständige HTML-Dokument aus, sonst nichts.
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.5 397BA17B on Atlas Cloud
Erstelle eine einzelne eigenständige HTML-Datei (sämtliches CSS und JavaScript inline, absolut keine externen libraries, CDNs, images, fonts oder network requests), die ein in Echtzeit spielbares Wildwasser-Kajakspiel namens „Rapid Run“ vollständig auf einem einzigen HTML5 Canvas element rendert, das das Browserfenster ausfüllt und beim Resize responsive bleibt. Die Ansicht ist eine Third-Person top-down camera mit leichter Vorwärtsperspektive, die auf einen prozedural generierten alpinen Gebirgsbach blickt, der kontinuierlich von oben nach unten scrollt und sich nie wiederholt: Seede das Level mit einem noise/pseudo-random generator, sodass jeder Run einen anderen verzweigten Kanal formt, mit enger werdenden Chutes, Midstream-Boulders, wirbelnden Whirlpools, kleinen Waterfall Drops und aufgewühlten White-Foam Wave Trains. Der Spieler steuert ein einzelnes crimson-and-amber Kajak, das nahe dem unteren Bildschirmdrittel bleibt, während der Fluss vorbeirauscht; steuere mit den Left/Right arrow keys (oder A/D), um zu kanten und zu carven, und lasse die Maus als Paddle fungieren — das Kajak lehnt sich und zieht zur horizontalen Mausposition; ein Klick oder gedrückter Button setzt einen harten Paddelschlag, der das Boot auf eine engere Linie schnalzen lässt. Simuliere das Wasser als live flow field, angetrieben von layered scrolling noise: Die Strömung drückt das Kajak flussabwärts und seitwärts, schneller in den Tongues und langsamer in Eddies, sodass der Spieler das Wasser lesen und um die Racing Line kämpfen muss. Erzeuge ein reichhaltiges GPU-friendly particle system — einen Fächer aus Spray, der vom Bug aufbricht, wenn er auf eine Welle schlägt, eine trailing turbulence wake, die am Heck aufwirbelt, Foam Sheets, die bei Impacts explodieren, und Ringe, die aus Whirlpools herauskräuseln. Trifft man einen Felsen, gerät das Boot mit einem harten Wobble ins Drehen, die Kontrolle geht kurz verloren, und die Kamera erzittert. Rendere in einem klaren Flat-Illustration-Stil, kombiniert mit leichter fluid realism: Die Wasseroberfläche zeigt animierte Ripples und refractive highlight glints aus dem flow field, Noon-High-Plateau-Top-Light, kühle weiße Speculars auf dem Spray und tiefe Pools, die von Türkisgrün in tintiges Teal übergehen. Die Farbpalette ist von glacier cyan-blue dominiert, mit dem vermilion-orange-yellow des Kajaks als kräftigem Akzent; die Ufer sind in Grey Stone und Pine Green gehalten. Füge ein On-Screen-HUD hinzu: zurückgelegte Distanz, aktuelle Geschwindigkeit, eine Stability/Health meter, die bei Rock Hits sinkt, und einen Live Score; zeige einen Start Screen mit kurzen Controls, einen Game-Over Screen, wenn die Stability aufgebraucht ist, mit Restart-Option, und steigere die Schwierigkeit allmählich (schnellere Strömung, dichtere Hazards), je weiter man hinabfährt. Ziele auf einen flüssigen 60fps game loop mit requestAnimationFrame und delta-time physics, alles abgestimmt auf ein wirklich spannendes, befriedigendes Spielgefühl, bei dem sich eine saubere Linie durch einen schäumenden Chute verdient anfühlt.
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.7 Max on Atlas Cloud
Erfahren Sie, wie sich die Qwen API im Vergleich zu anderen führenden Textmodellen auf Atlas Cloud schlägt – bei Kontextlänge, Ausgabeobergrenzen, unterstützten Eingabetypen und transparenter Preisgestaltung pro Aufruf.
| Modell | Kontextfenster | Maximale Ausgabe-Tokens | Eingabetypen | Eingabepreis ($/1M) | Ausgabepreis ($/1M) |
|---|---|---|---|---|---|
| Qwen3.7 Max | 1M | 67,072 | Text | $2.50 | $7.50 |
| Qwen3.7 Plus | 1M | 67,072 | Text | $0.40 (≤256K) / $1.20 (>256K) | $1.60 / $4.80 |
| Qwen3.6 35B A3B | 256K | 65,536 | Text, Bild, Video | $0.248 | $1.485 |
| Qwen3.5 Flash | 1M | 67,072 | Text | $0.10 | $0.40 |
| DeepSeek V4 Pro | 1M | 393,216 | Text | $1.74 | $3.45 |
| Grok 4.5 | 500K | 500,000 | Text | $2.00 | $6.00 |
| GLM 5.2 | 1M | 131,072 | Text | $1.40 | $4.40 |
In wenigen Minuten startklar — folgen Sie diesen einfachen Schritten, um Modelle über die Plattform von Atlas Cloud zu integrieren und bereitzustellen.
Registrieren Sie sich auf atlascloud.ai und schließen Sie die Verifizierung ab. Neue Nutzer erhalten kostenlose Credits zum Erkunden der Plattform und Testen von Modellen.
Die Kombination der fortschrittlichen Qwen-Modelle mit der GPU-beschleunigten Plattform von Atlas Cloud bietet unübertroffene Leistung, Skalierbarkeit und Entwicklererfahrung.
Niedrige Latenz:
GPU-optimierte Inferenz für Echtzeit-Reasoning.
Einheitliche API:
Führen Sie Qwen, GPT, Gemini und DeepSeek mit einer Integration aus.
Transparente Preisgestaltung:
Vorhersehbare Token-basierte Abrechnung mit serverlosen Optionen.
Entwicklererfahrung:
SDKs, Analysen, Fine-Tuning-Tools und Vorlagen.
Zuverlässigkeit:
99,99% Verfügbarkeit, RBAC und compliance-bereite Protokollierung.
Sicherheit & Compliance:
SOC 2 Type II, HIPAA-Ausrichtung, Datensouveränität in den USA.
Die Qwen API bietet Entwicklern programmgesteuerten Zugriff auf die Qwen-Familie großer Sprachmodelle von Alibaba Cloud für Textgenerierung, Reasoning, Coding und mehrsprachige Aufgaben. Auf Atlas Cloud erreichen Sie die gesamte Modellpalette über einen einzigen OpenAI-kompatiblen Endpoint, sodass ein Schlüssel für jedes Qwen-Modell ausreicht.
Atlas Cloud hostet eine breite Auswahl: vom schnellen und kosteneffizienten Qwen3.5 Flash über vielseitige Plus-Stufen bis hin zum Flaggschiff Qwen3.7 Max, das für fortgeschrittenes Reasoning und Coding entwickelt wurde. Reasoning-fokussierte Modelle wie Qwen3.6 35B A3B und große Mixture-of-Experts-Varianten wie Qwen3.5 397B A17B stehen ebenfalls für anspruchsvollere Workloads bereit.
Der Einstieg dauert nur wenige Schritte: Erstellen Sie ein Atlas Cloud-Konto, generieren Sie einen API-Schlüssel und richten Sie Ihren bestehenden OpenAI-kompatiblen Client auf den Atlas-Endpoint aus. Die Abrechnung erfolgt nutzungsbasiert mit transparenten Preisen pro Aufruf, und Day-0-Zugriff bedeutet, dass neue Qwen-Releases sofort zum Launch verfügbar sind. Beginnen Sie noch heute mit dem Entwickeln.
Ja. Die Qwen API auf Atlas Cloud folgt dem OpenAI-Format für Chat Completions, sodass die meisten SDKs funktionieren, indem Sie einfach die Base URL und den Schlüssel austauschen. Sie behalten Ihre bestehenden Tools und können jedes Qwen-Modell aufrufen, ohne Ihre Integration neu zu schreiben.
Qwen-Modelle auf Atlas Cloud nutzen eine transparente Pay-as-you-go-Preisgestaltung mit Abrechnung pro Token, ohne dass ein Abonnement erforderlich ist. Die Preise beginnen bei $0.1 pro Million Input Tokens und $0.4 pro Million Output Tokens für Qwen3.5 Flash und steigen auf $2.5 bzw. $7.5 pro Million Tokens für das Flaggschiff Qwen3.7 Max, sodass Sie die Kosten passend zum jeweiligen Workload steuern können.
Flaggschiffmodelle wie Qwen3.7 Max bieten Kontextfenster von bis zu einer Million Tokens und eignen sich damit für lange Dokumente, große Codebases und umfangreiche Gesprächsverläufe. Die Familie umfasst außerdem Text- und Vision-Language-Varianten wie Qwen3-VL, sodass Sie Optionen haben, wenn eine Aufgabe über reine Prompts hinausgeht.
Über einfachen Chat hinaus unterstützen Qwen-Modelle Streaming-Antworten, Function Calling und strukturierte Tool-Nutzung über die Standard-API-Parameter. Spezialisierte Reasoning-Modelle wie Qwen3.7 Max und Qwen3.6 35B A3B ermöglichen schrittweises Problemlösen für Mathematik, Coding und komplexe agentische Aufgaben.
Die Wahl hängt davon ab, welches Gleichgewicht zwischen Geschwindigkeit, Kosten und Leistungsfähigkeit Sie benötigen. Wählen Sie Qwen3.5 Flash, wenn Latenz und hohes Volumen entscheidend sind, die Plus-Stufen für alltägliche Assistenten und Produktivitäts-Workflows und Qwen3.7 Max, wenn eine Aufgabe stärkstes Reasoning und Coding erfordert. Da alle Modelle denselben Endpoint verwenden, ist der Wechsel zwischen ihnen nur eine Änderung eines einzelnen Parameters.
Die Seedance 2.5 API ist jetzt auf Atlas Cloud verfügbar! Sie bietet Entwicklern das neueste Videomodell von ByteDance. Es generiert in einem einzigen Durchgang bis zu 30 Sekunden natives Video aus Text, einem einzigen Bild oder bis zu 50 multimodalen Referenzen, mit synchronisiertem Audio und mehrsprachigem Text im Bildrahmen. Auf Atlas Cloud greifen Sie über einen einzigen Schlüssel darauf zu, wobei Motivkonsistenz und verbesserte Physik lange Einstellungen kohärent halten.

Die Wan 3.0 API ist die nächste Generation von Alibabas Wan-Videofamilie, die entwickelt wurde, um Langformat-Generierung, Multi-Referenz-Steuerung und audiovisuelle Qualität auf ein neues Niveau zu heben. Atlas Cloud hostet bereits Wan 2.7, 2.6 und 2.5, und Wan 3.0 läuft mit demselben einheitlichen Schlüssel ohne separate Einrichtung. Beginnen Sie noch heute mit der Entwicklung. Scrollen Sie nach unten zum Showcase, um zu sehen, was Wan 3.0 erschaffen kann.
MiniMax H3 ist die multimodale Videofamilie von MiniMax für text-, bild- und referenzgesteuerte Erstellung. Über die unterstützten Routen hinweg bleiben Motive aus Referenzmedien erhalten, flexible Seitenverhältnisse stehen zur Verfügung, und H3 Developer kombiniert generierten Ton mit visuellen Inhalten, wobei die Ausgabeprofile je nach Endpoint ausgewählt werden. Atlas Cloud bündelt die Familie hinter einem OpenAI-kompatiblen Schlüssel mit transparenter nutzungsbasierter Abrechnung zum Standardtarif von $0.038 pro Sekunde. Beginnen Sie noch heute mit der Entwicklung.
Die gpt-image-2.5-Familie von OpenAI bietet Entwicklern die Wahl zwischen Flare und Sunburst für produktive Bild-Workflows. Rendern Sie mit beliebigen Auflösungen bis zu 3840x2160 und wählen Sie aus fünf Qualitätsstufen, darunter xhigh und max, um spezifische Ausgabeanforderungen zu erfüllen. Atlas Cloud stellt eine sofort einsatzbereite REST-Inferenz ohne Kaltstarts und mit einer Standardpreisgestaltung ab $0.004 pro Generierung bereit. Beginnen Sie noch heute mit der Entwicklung.
Die Seedream 5.0 Pro API bietet Entwicklern das steuerbare Bildbearbeitungsmodell von ByteDance auf Atlas Cloud. Sie platziert Bearbeitungen präzise mit Ankern und Koordinaten, trennt Bilder in bearbeitbare Ebenen, verschmilzt mehrere Referenzen und passt exakte Farben und Materialien an, mit mehrsprachigem Text in 2K und 3K. Auf Atlas Cloud erreichen Sie es über einen einzigen Schlüssel!
Seedance 2.0 ist ByteDances Produktionsvideomodell für die präzise Erstellung von Einstellungen. Verwandle Prompts in Videos, animiere ein Erstbild mit optionaler Führung durch ein Letztbild oder gestalte Ergebnisse mit Referenzmedien und optionaler Websuche. Atlas Cloud vereint diese Workflows in einer einheitlichen API mit transparenter nutzungsbasierter Preisgestaltung und einem einzigen OpenAI-kompatiblen Schlüssel. Beginne noch heute mit der Entwicklung.
Die Kling 3.0 API bringt die Flaggschiff-Video-Suite von Kuaishou über einen OpenAI-kompatiblen Schlüssel in die Atlas Cloud. Sie umfasst zwei Modelle: Kling 3.0 für AI Director Storytelling, mehrsprachiges Lip-Sync und präzisen Bildschirmtext sowie Kling 3.0 Omni (O3) für das Klonen von Motiven und Stimmen aus einem kurzen Video oder Bild. Beide generieren im selben Durchgang natives Audio mit einer Ausgabe von bis zu 4K. Erstellen Sie kinoreife Erzählungen, globales Marketing, mehrsprachige Anzeigen und serielle Charakterinhalte auf einer zuverlässigen Infrastruktur.
Grok Imagine Video ermöglicht Entwicklern den Zugriff auf xAIs Videofamilie zum Erstellen, Animieren, Erweitern und Bearbeiten von Clips. Erstelle 1- bis 15-sekündige Videos aus Prompts, steuere Personen, Objekte oder Stile mit bis zu sieben Referenzbildern und arbeite in 480p oder 720p. Atlas Cloud bündelt diese Möglichkeiten über OpenAI-compatible Endpoints mit transparenten Pay-as-you-go-Preisen. Beginne noch heute mit der Entwicklung.
Vidu Q4 ist Vidus neuestes Flaggschiff-Videomodell, entwickelt für die Generierung von Image-to-Video- und Reference-to-Video-Inhalten. Es kann ein einzelnes Standbild animieren und automatische Szenenübergänge erstellen, sodass Entwicklern zwei Eingabepfade für unterschiedliche Produkt-Workflows zur Verfügung stehen. Atlas Cloud stellt dedizierte API-Endpunkte mit veröffentlichten Parameterschemata zum verifizierten Standardpreis von $0.04 pro Sekunde bereit. Beginnen Sie noch heute mit der Entwicklung.
Gemini Omni 1.1 Flash ist die von Google DeepMind entwickelte, von Grund auf multimodale Videomodellfamilie für flexible Produktions-Workflows. Bearbeiten Sie bestehendes Filmmaterial per Textanweisung, wahren Sie mit bis zu 10 Referenzbildern und 3 Videoclips die visuelle Konsistenz oder verlängern Sie eine Aufnahme in verkettbaren Segmenten auf bis zu 40 Sekunden. Greifen Sie mit einem einzigen OpenAI-kompatiblen API-Schlüssel, nutzungsabhängiger Abrechnung und Verfügbarkeit ab Tag 0 auf jeden Workflow in Atlas Cloud zu. Beginnen Sie noch heute mit der Entwicklung.
Nano Banana 2.1 is Google's image model family built on Gemini 3.6 Flash. It delivers Pro-level generation and editing at Flash-level speed, supports natural-language edits and merges across 1 to 14 input images, and maintains consistency for up to 4 characters and 10 objects. Through Atlas Cloud, developers can access the family with one OpenAI-compatible key, reliable uptime, and Day-0 availability. Start building today.
Entwickeln Sie mit der Nano Banana 2 API, angetrieben vom Gemini 3.1 Flash Image-Modell von Google. Sie generiert natives 4K-Bildmaterial mit bis zu 4096x2304 Pixeln, präzisem Text-Rendering und konsistenten Charakteren über bis zu 14 Referenzbilder hinweg, sowohl für die Generierung als auch für die Bearbeitung. Auf Atlas Cloud haben Sie über eine einheitliche API neben über 300 Modellen Zugriff darauf, mit Preisen ab 0,04 $ pro Bild, 99,99 % Betriebszeit und kostenlosem Startguthaben.
Anleitungen, Tutorials und Produkt-Updates, mit denen Sie das Beste aus Atlas Cloud herausholen.


