Inicios en frío de 10 a 30 segundos, facturación de hardware impredecible y un catálogo de modelos que va semanas por detrás de los lanzamientos de código abierto: estas son las tres razones por las que los desarrolladores están buscando activamente una alternativa a Replicate en 2026. Esta guía analiza lo que Replicate hace bien, dónde falla a escala de producción y qué plataforma resuelve realmente cada problema, con datos de precios verificados y un fragmento de código de migración funcional que puedes usar hoy mismo.
Para una visión más amplia de las principales API de inferencia, consulta nuestra guía sobre las mejores alternativas de API de inferencia de IA en 2026.
Puntos clave
- Los inicios en frío de Replicate oscilan entre 10 y 30 segundos para contenedores no precalentados, lo que afecta a las aplicaciones de producción sensibles a la latencia.
- La generación de imágenes en Atlas Cloud comienza en $0.003/imagen, frente a los $0.025/imagen de FLUX Dev en Replicate.
- Atlas Cloud cubre más de 300 modelos de vídeo, imagen, LLM y audio bajo una única clave API.
- La mayoría de las migraciones desde Replicate toman menos de una hora: consiste en cambiar la URL base y reemplazar la clave.
- Atlas Cloud cuenta con certificación SOC I & II y cumplimiento de HIPAA; Replicate no publica ningún SLA.
¿Por qué los desarrolladores buscan alternativas a Replicate en 2026?
El problema de los inicios en frío reportado por la comunidad de Replicate promedió 18.4 segundos en contenedores de modelos no precalentados en 2025, según el Latency.io Developer Benchmark Report (Latency.io Developer Benchmark Report, 2025). Para aplicaciones de producción que requieren tiempos de respuesta inferiores a 3 segundos, esta brecha es un obstáculo insalvable. La arquitectura de Replicate levanta contenedores por cada solicitud, lo cual funciona a bajo volumen pero se convierte en un riesgo estructural en cualquier producto orientado al usuario.
Tres puntos críticos impulsan la mayoría de las migraciones fuera de Replicate.
Los inicios en frío afectan a los productos orientados al usuario
Los despliegues no dedicados de Replicate levantan contenedores bajo demanda, con inicios en frío reportados por la comunidad que van de 10 a 30 segundos (Documentación de despliegues de Replicate, 2026). No es una espera tolerable para una API de generación en un producto en vivo. Los usuarios experimentan esto como una interfaz congelada, un icono de carga que no desaparece. Los equipos lo solucionan enviando pings "keep-alive" para mantener los contenedores calientes. Eso añade costes y complejidad que no deberían existir.
Hemos descubierto que la mayoría de los equipos notan el problema del inicio en frío cuando correlacionan la latencia de generación con los datos de retención de usuarios. La caída es medible incluso con retrasos de 5 segundos. A los 15 segundos, es catastrófica.
La facturación de hardware es difícil de predecir
Replicate factura algunas cargas de trabajo por segundo de hardware, no por salida. Un Nvidia A100 (80GB) funciona a $0.0014/segundo según los precios publicados por Replicate. Eso significa que un trabajo de 60 segundos en una A100 cuesta $0.084, independientemente de lo que haya producido. Para la generación de imágenes, es mejor optar por un modelo por imagen. Pero para despliegues de modelos personalizados, estás pagando por el tiempo de hardware, y esa cifra es difícil de pronosticar.
La estructura de precios no escala bien
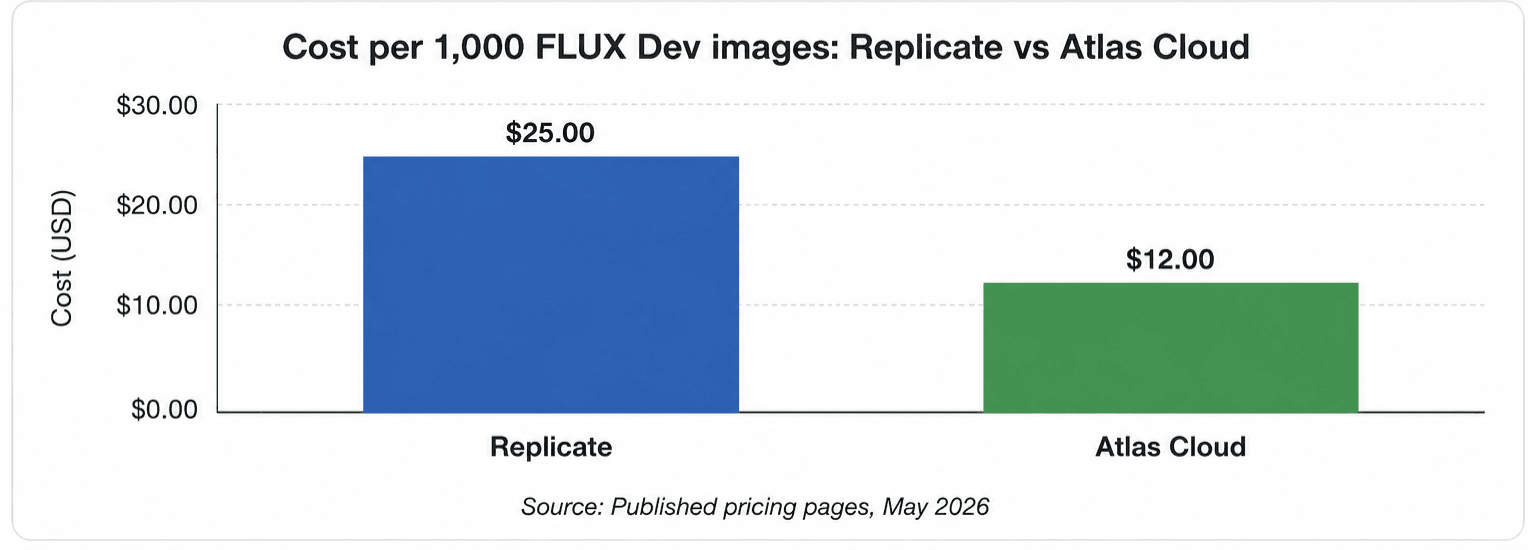
Replicate cobra $0.025/imagen por FLUX Dev y $0.04/imagen por FLUX 1.1 Pro. Esas cifras parecen razonables para un prototipo. Con 500,000 imágenes al mes, solo FLUX Dev cuesta $12,500. Las plataformas de inferencia dedicadas cobran significativamente menos por el mismo modelo, y la brecha se multiplica a escala.
Replicate vs Atlas Cloud: Comparativa directa
Atlas Cloud ejecuta una API compatible con OpenAI que sirve más de 300 modelos de vídeo, imagen, LLM y audio, y publica sus precios, SLA y datos de cumplimiento de forma abierta. Replicate publica sus precios, pero no su SLA ni su estado de cumplimiento. La siguiente tabla cubre las dimensiones clave que importan a los desarrolladores en producción.
| Dimensión | Replicate | Atlas Cloud |
|---|---|---|
| Precio imagen (FLUX Dev) | $0.025/imagen | $0.012/imagen |
| Precio imagen (FLUX Schnell) | $0.003/imagen | $0.003/imagen |
| Precio vídeo | $0.09-0.25/seg (modelos WaveSpeed) | $0.05-0.20/seg (familia Veo 3.1, Wan-2.7, Seedance) |
| Precio LLM (DeepSeek R1) | $3.75/M tokens de entrada | No listado (DeepSeek V4 Pro: $1.70/M) |
| Inicios en frío | 10-30s (documentado por la comunidad) | Menos de 1s (pool caliente) |
| SLA | No publicado | 99.99% de tiempo de actividad |
| Cumplimiento | No publicado | SOC I & II, HIPAA |
| Estilo de API | SDK nativo de Replicate | Compatible con OpenAI (drop-in) |
| Soporte de audio | TTS, voz a texto, música (modelos comunidad) | Sí, nativo |
| Cantidad de modelos | 100,000+ (comunidad, calidad variable) | 300+ (curados para producción) |
| Soporte servidor MCP | No | Sí |
| Hosting de modelos propios | Sí (vía Cog) | No |
La diferencia clave: el catálogo de más de 100,000 modelos de Replicate es contribuido por la comunidad y su calidad es variable. Los más de 300 modelos de Atlas Cloud están curados para producción, con un SLA consistente, pools calientes y facturación unificada.
¿Qué es Atlas Cloud y cómo empezar?
Atlas Cloud es una plataforma de inferencia de IA unificada que sirve más de 300 modelos curados para producción de vídeo, imagen, LLM y audio a través de una única clave API. Está diseñada para desarrolladores que desean precios unitarios predecibles, latencia reducida gracias a pools calientes y cumplimiento empresarial sin gestionar infraestructura. Cada modelo se ejecuta en capacidad dedicada sin inicios en frío, y la facturación es por uso, sin mínimos mensuales.
Características clave
Cobertura multimodal completa. Una clave API permite acceder a generación de vídeo (Veo 3.1, Seedance 2.0, Wan-2.7, HappyHorse-1.0), generación de imágenes (FLUX Schnell, FLUX Dev, GPT Image 2, Nano Banana 2), LLMs (DeepSeek V4, Qwen3.6, GLM 5.1, Kimi K2.6) y audio, todo desde el mismo endpoint.
Soporte de servidor MCP. Atlas Cloud proporciona soporte nativo para el Model Context Protocol (MCP) para flujos de trabajo de agentes. Los equipos que crean agentes de IA de varios pasos que encadenan llamadas a modelos o se integran con herramientas como Claude Code y Cursor pueden usar Atlas Cloud sin configurar infraestructura adicional.
Certificación SOC I & II, cumplimiento HIPAA. La documentación de cumplimiento está publicada y disponible para revisiones. Esto es relevante para cualquier equipo que venda a clientes empresariales, de salud o fintech.
Pago por uso, sin mínimos. La generación de imágenes comienza en $0.003/imagen, vídeo desde $0.05/segundo, LLMs desde $0.14/M tokens. No hay gasto mensual mínimo ni requisitos de suscripción.
Cómo empezar
Paso 1: Crea una cuenta gratuita. Regístrate en Atlas Cloud. No se requiere tarjeta de crédito para comenzar.
Paso 2: Obtén tu clave API. Tu clave estará disponible inmediatamente en el panel después de registrarte.
Paso 3: Realiza tu primera llamada. Atlas Cloud utiliza el formato del SDK de OpenAI. Instala la librería de Python de OpenAI y apunta a la URL base de Atlas Cloud:
plaintext1from openai import OpenAI 2 3client = OpenAI( 4 base_url="https://api.atlascloud.ai/v1", 5 api_key="TU_CLAVE_DE_ATLAS_CLOUD" 6) 7 8response = client.images.generate( 9 model="flux-schnell", 10 prompt="Un desarrollador revisando la documentación de una API en un escritorio limpio" 11)
Paso 4: Explora el catálogo de modelos. Visita atlascloud.ai/pricing/models para ver todos los modelos disponibles con los precios unitarios actuales. Vídeo, imagen, LLM y audio tienen tarifas transparentes.
Paso 5: Migra las llamadas existentes. Por cada llamada a un modelo de Replicate en tu código, busca el modelo equivalente en Atlas Cloud y actualiza el nombre del modelo. FLUX Dev, FLUX Schnell, GPT Image 2, Seedance 2.0 y Veo 3.1 están disponibles. El formato de solicitud es idéntico.
Cómo migrar de Replicate a Atlas Cloud
La migración consiste en cambiar la URL base y reemplazar la clave. La API de Atlas Cloud es compatible con OpenAI, lo que significa que cualquier código que ya apunte a un endpoint estilo OpenAI solo necesita dos ediciones.
Aquí tienes una comparativa directa para la generación de imágenes:
plaintext1# Antes: Replicate 2import replicate 3output = replicate.run("black-forest-labs/flux-dev", input={"prompt": "..."}) 4 5# Después: Atlas Cloud (Compatible con OpenAI) 6from openai import OpenAI 7client = OpenAI(base_url="https://api.atlascloud.ai/v1", api_key="TU_CLAVE") 8response = client.images.generate(model="flux-dev", prompt="...")
Si has envuelto tus llamadas de inferencia detrás de una capa de abstracción (lo cual deberías hacer), el cambio se realiza en un solo lugar. La estructura de la solicitud para la generación de imágenes coincide exactamente con la API de imágenes de OpenAI. Los nombres de los modelos se mapean directamente: flux-dev, flux-schnell, gpt-image-2.
Para la generación de vídeo, Atlas Cloud utiliza un patrón basado en trabajos. Envías una solicitud de generación y recibes un ID de trabajo. Luego realizas consultas para verificar la finalización. Este es el mismo patrón asíncrono que utiliza Replicate para generaciones de larga duración, por lo que el modelo mental se traslada perfectamente.
Para la inferencia de LLM, la migración es idéntica a cambiar de proveedor compatible con OpenAI: cambia la URL base y la clave API. El soporte de servidor MCP de Atlas Cloud también permite flujos de trabajo de agentes sin configuración de infraestructura adicional.
Si estás evaluando otras API de inferencia compatibles con OpenAI al mismo tiempo, nuestras publicaciones sobre la mejor alternativa a Fireworks AI y mejor alternativa a Together AI cubren esas comparaciones en detalle.
¿Cómo se comparan los precios de Replicate a escala?
Las diferencias de precios se acumulan rápidamente una vez que superas el volumen de prototipo. Según el informe de gasto en infraestructura de IA de 2025 de Andreessen Horowitz, el equipo promedio de producto de IA en producción gasta $8,200 al mes en costes de inferencia (a16z AI Infrastructure Report, 2025). Pequeñas diferencias unitarias se suman a líneas presupuestarias importantes a esa escala.
Generación de imágenes FLUX
FLUX Schnell cuesta lo mismo en ambas plataformas: $0.003/imagen. Es la variante rápida y de menor calidad. Para FLUX Dev, la brecha aumenta: Replicate cobra $0.025/imagen, Atlas Cloud cobra $0.012/imagen. Con 100,000 imágenes de FLUX Dev al mes, hay una diferencia de $1,300. FLUX 1.1 Pro en Replicate cuesta $0.04/imagen; Atlas Cloud no lista un equivalente directo, pero ofrece GPT Image 2 a $0.01/imagen.
Generación de vídeo
Los precios de vídeo de Replicate están basados en los modelos WaveSpeed Wan 2.1: $0.09/segundo a 480p, $0.25/segundo a 720p. La oferta de vídeo de Atlas Cloud incluye Wan-2.7 a $0.10/segundo, Veo 3.1 Lite a $0.05/segundo, Veo 3.1 Fast a $0.08/segundo y Veo 3.1 a $0.20/segundo. Para la mayoría de los equipos, Veo 3.1 Lite o Fast cubren el 80% de los casos de uso a un coste menor que los precios de 480p de Replicate.
Seedance 2.0 (ByteDance, audio nativo) se ejecuta a $0.112/segundo en Atlas Cloud. Replicate lista Seedance 2.0 como modelo disponible, pero el precio se basa en el tiempo de hardware, lo que dificulta la comparación directa. La tarifa por segundo de Atlas Cloud es transparente y predecible.
Precios de LLM
Replicate cobra los LLM por token: Claude 3.7 Sonnet a $3.00/M tokens de entrada, DeepSeek R1 a $3.75/M tokens de entrada. El catálogo de LLM de Atlas Cloud utiliza diferentes modelos: DeepSeek V4 Pro a $1.70/M de entrada, DeepSeek V4 Flash a $0.14/M de entrada, Qwen3.6 Plus a $0.50/M de entrada, Kimi K2.6 a $0.95/M de entrada y GLM 5.1 a $1.39/M de entrada. La opción V4 Flash a $0.14/M es ideal para tareas de clasificación y enrutamiento de alto volumen donde el coste por llamada es lo más importante.
¿Qué pierdes al quedarte en Replicate?
Permanecer en Replicate en 2026 significa aceptar limitaciones específicas que no se están resolviendo. No son brechas menores; afectan a decisiones arquitectónicas.
Inicios en frío en cada despliegue de producción
El problema de los inicios en frío es arquitectónico, no un error que Replicate pueda parchear fácilmente. Los benchmarks comunitarios sitúan los inicios en frío (no precalentados) entre 10 y 30 segundos. Replicate ofrece despliegues dedicados para mitigar esto, pero la capacidad dedicada conlleva un compromiso de gasto, lo que cambia significativamente el modelo de precios. Estás pagando por reserva de infraestructura, no solo por inferencia.
Los equipos que construyen en Atlas Cloud utilizan pools calientes en todos los modelos de forma predeterminada. No se requiere configuración ni coste adicional para evitar inicios en frío.
Sin SLA publicado ni documentación de cumplimiento
Replicate no publica un SLA de tiempo de actividad en sus páginas oficiales. Para equipos en industrias reguladas (salud, fintech, legal), esto es un bloqueador. El cumplimiento de HIPAA no figura, ni las certificaciones SOC. Atlas Cloud cuenta con certificación SOC I & II y cumplimiento de HIPAA, algo vital para cualquier equipo que maneje datos protegidos.
Los desarrolladores que crean productos para clientes empresariales necesitan cada vez más compartir documentación de cumplimiento del proveedor durante los ciclos de venta. La ausencia de un SLA publicado por parte de Replicate significa que no puedes incluirlo o que debes añadir un paso de verificación manual a tu proceso de compras.
Pipelines multimodales fragmentados
Replicate admite imagen, vídeo, LLM y audio a través de modelos comunitarios. En la práctica, los modelos más avanzados en cada categoría requieren relaciones con distintos proveedores en 2026. Los mejores modelos de vídeo, los mejores LLMs y los mejores modelos de generación de imágenes no se encuentran todos en Replicate en sus versiones actuales. Los equipos terminan con tres o cuatro claves API de todos modos.
Atlas Cloud consolida esto. Una clave, una factura, un límite de tasa que monitorear y un punto de integración que mantener. Esa simplificación operativa importa a escala.
Los equipos que consideren alternativas a fal.ai por razones similares encontrarán una comparativa detallada en nuestro post sobre por qué los equipos se cambian a Atlas Cloud desde fal.ai.
Preguntas frecuentes
¿Es Atlas Cloud un reemplazo directo para la API de Replicate?
Atlas Cloud no es compatible con la API de Replicate, pero es compatible con OpenAI. Si tu código utiliza el propio SDK de Replicate (la función replicate.run()), necesitarás reescribir esas llamadas al patrón del SDK de OpenAI. La mayoría de los equipos completan esto en menos de una hora. La encuesta de desarrolladores de Stack Overflow de 2025 encontró que el 73% de las cargas de trabajo de IA en producción utilizan menos de 10 variantes de modelos distintos, todas cubiertas por el catálogo de más de 300 modelos de Atlas Cloud. (Encuesta de Stack Overflow, 2025)
¿Atlas Cloud admite el hosting de modelos personalizados de Replicate vía Cog?
No. El framework Cog de Replicate para empaquetar y alojar modelos personalizados es una característica única de Replicate. Atlas Cloud se centra en modelos alojados curados para producción, no en modelos contribuidos por la comunidad o empaquetados de forma personalizada. Si dependes de despliegues Cog, tendrías que mantener Replicate para ese caso de uso específico mientras migras las llamadas a modelos estándar a Atlas Cloud.
¿Cómo maneja Atlas Cloud los inicios en frío en comparación con Replicate?
Atlas Cloud mantiene pools calientes persistentes para todos los modelos alojados. No hay levantamiento de contenedores por solicitud. El Latency.io Developer Benchmark Report 2025 encontró que las plataformas con pool caliente dedicado promedian menos de 1 segundo de latencia hasta el primer píxel, en comparación con el promedio documentado por la comunidad de 18.4 segundos de Replicate para modelos no precalentados. (Latency.io Developer Benchmark Report, 2025) Esta es una diferencia arquitectónica, no una opción de configuración.
¿Qué modelos de vídeo admite Atlas Cloud que Replicate no?
Atlas Cloud admite Veo 3.1, Veo 3.1 Fast y Veo 3.1 Lite con precios transparentes por segundo ($0.20, $0.08 y $0.05 respectivamente), además de Seedance 2.0 con audio nativo a $0.112/segundo y HappyHorse-1.0 a $0.14/segundo. Replicate lista algunos de estos modelos, pero los precios son mediante facturación por segundo de hardware en despliegues comunitarios, lo que dificulta la comparación y la previsión de costes.
Conclusión
Replicate sigue siendo la respuesta correcta para exactamente un caso de uso en 2026: acceder a modelos comunitarios de nicho y checkpoints ajustados que no están disponibles en plataformas de inferencia de producción. Para todo lo demás, la combinación de inicios en frío de 10-30 segundos, la ausencia de un SLA publicado y precios que se acumulan a escala lo convierten en una opción inadecuada para equipos de producción.
Los números de Atlas Cloud son claros: generación de imágenes desde $0.003/imagen, vídeo desde $0.05/segundo, LLMs desde $0.14/M tokens, certificaciones SOC I & II y HIPAA, SLA de tiempo de actividad del 99.99% y una API compatible con OpenAI que hace que la migración sea un trabajo de una hora. Ese es el panorama completo.
Comienza migrando las llamadas a modelos donde Replicate te está costando más, valida la latencia y la facturación, y luego mueve el resto. La guía las mejores alternativas de API de inferencia de IA en 2026 cubre todo el panorama competitivo si todavía estás evaluando opciones.


