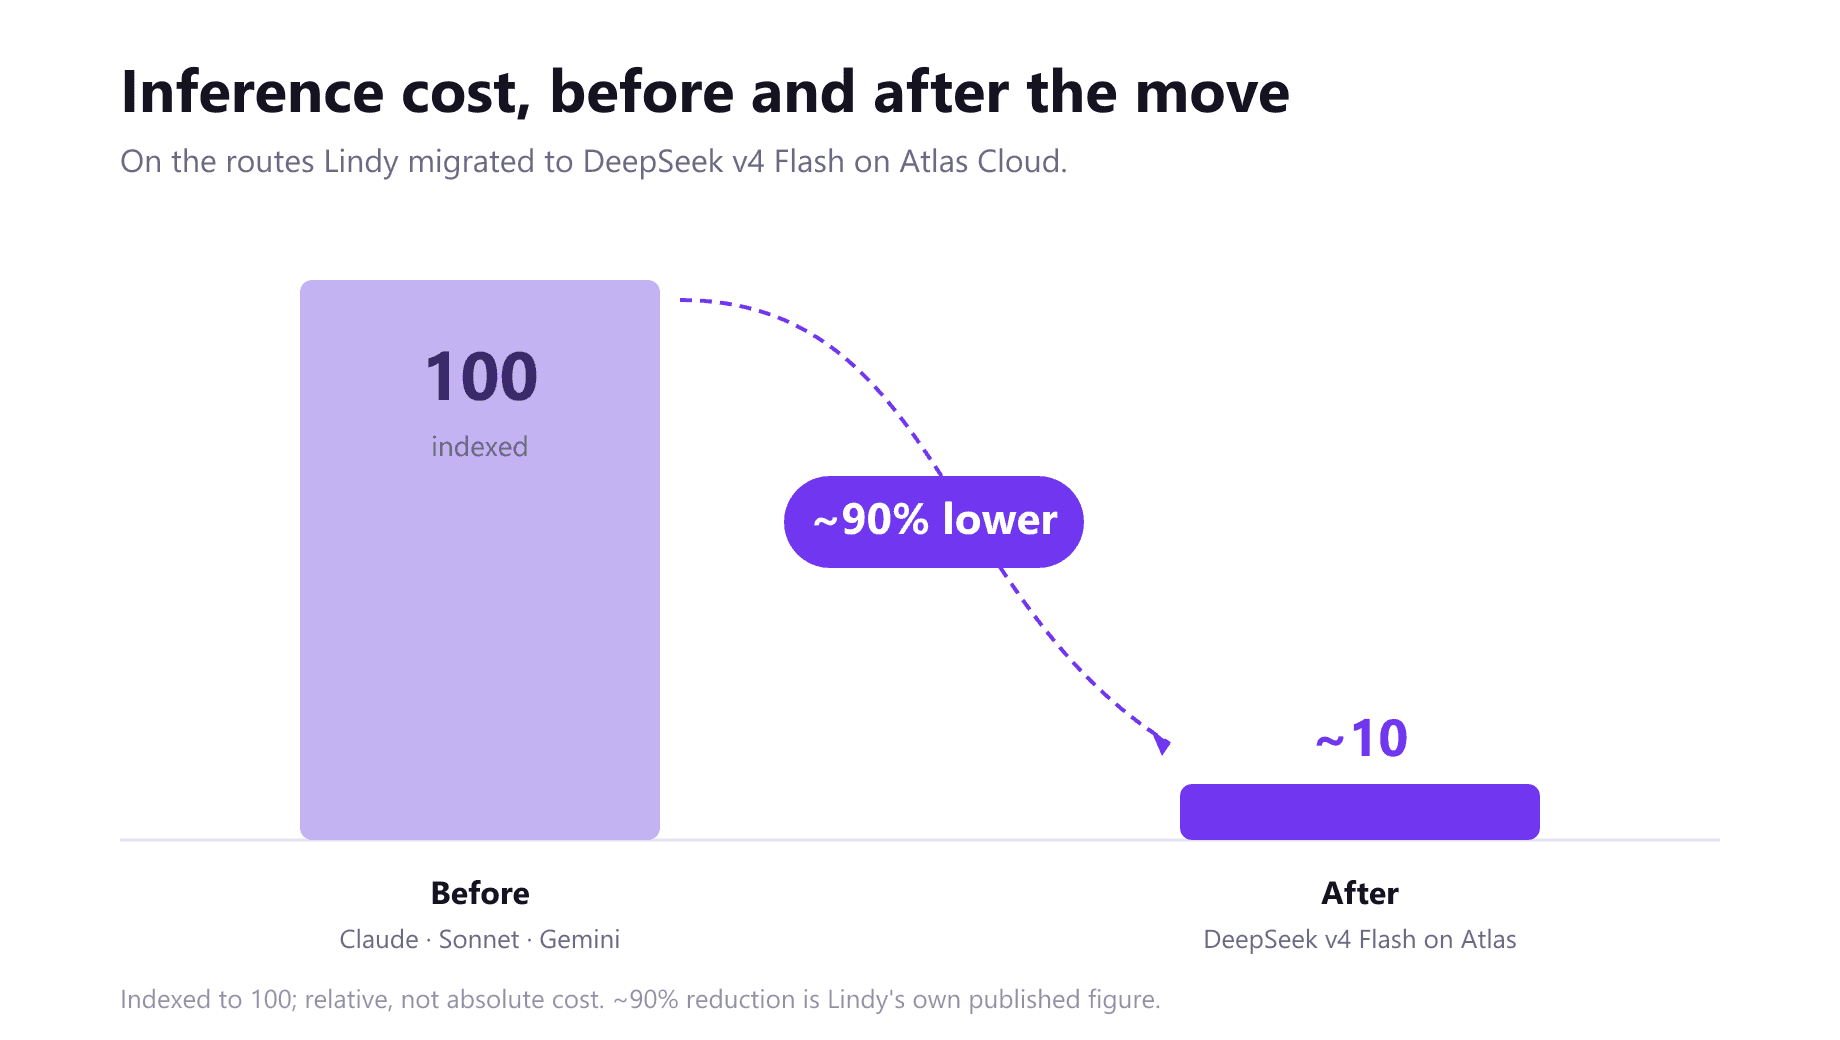
Lindy_ construyó el empleado de IA. Trasladó la flota a pesos abiertos servidos por Atlas Cloud, recortó su factura de inferencia en aproximadamente un 90% y lo hizo sin enviar peor producto.
~90% menor costo de inferencia · 60% de los tokens de entrada servidos desde caché · 3.000+ solicitudes por minuto sostenidas · 10x+ crecimiento del tráfico sin reconstruir nada · 24 modelos de 11 laboratorios en una sola clave
Lindy ejecuta una de las cargas de trabajo de agente más exigentes en producción, y lo hace en Atlas Cloud. Esto es lo que cambió:
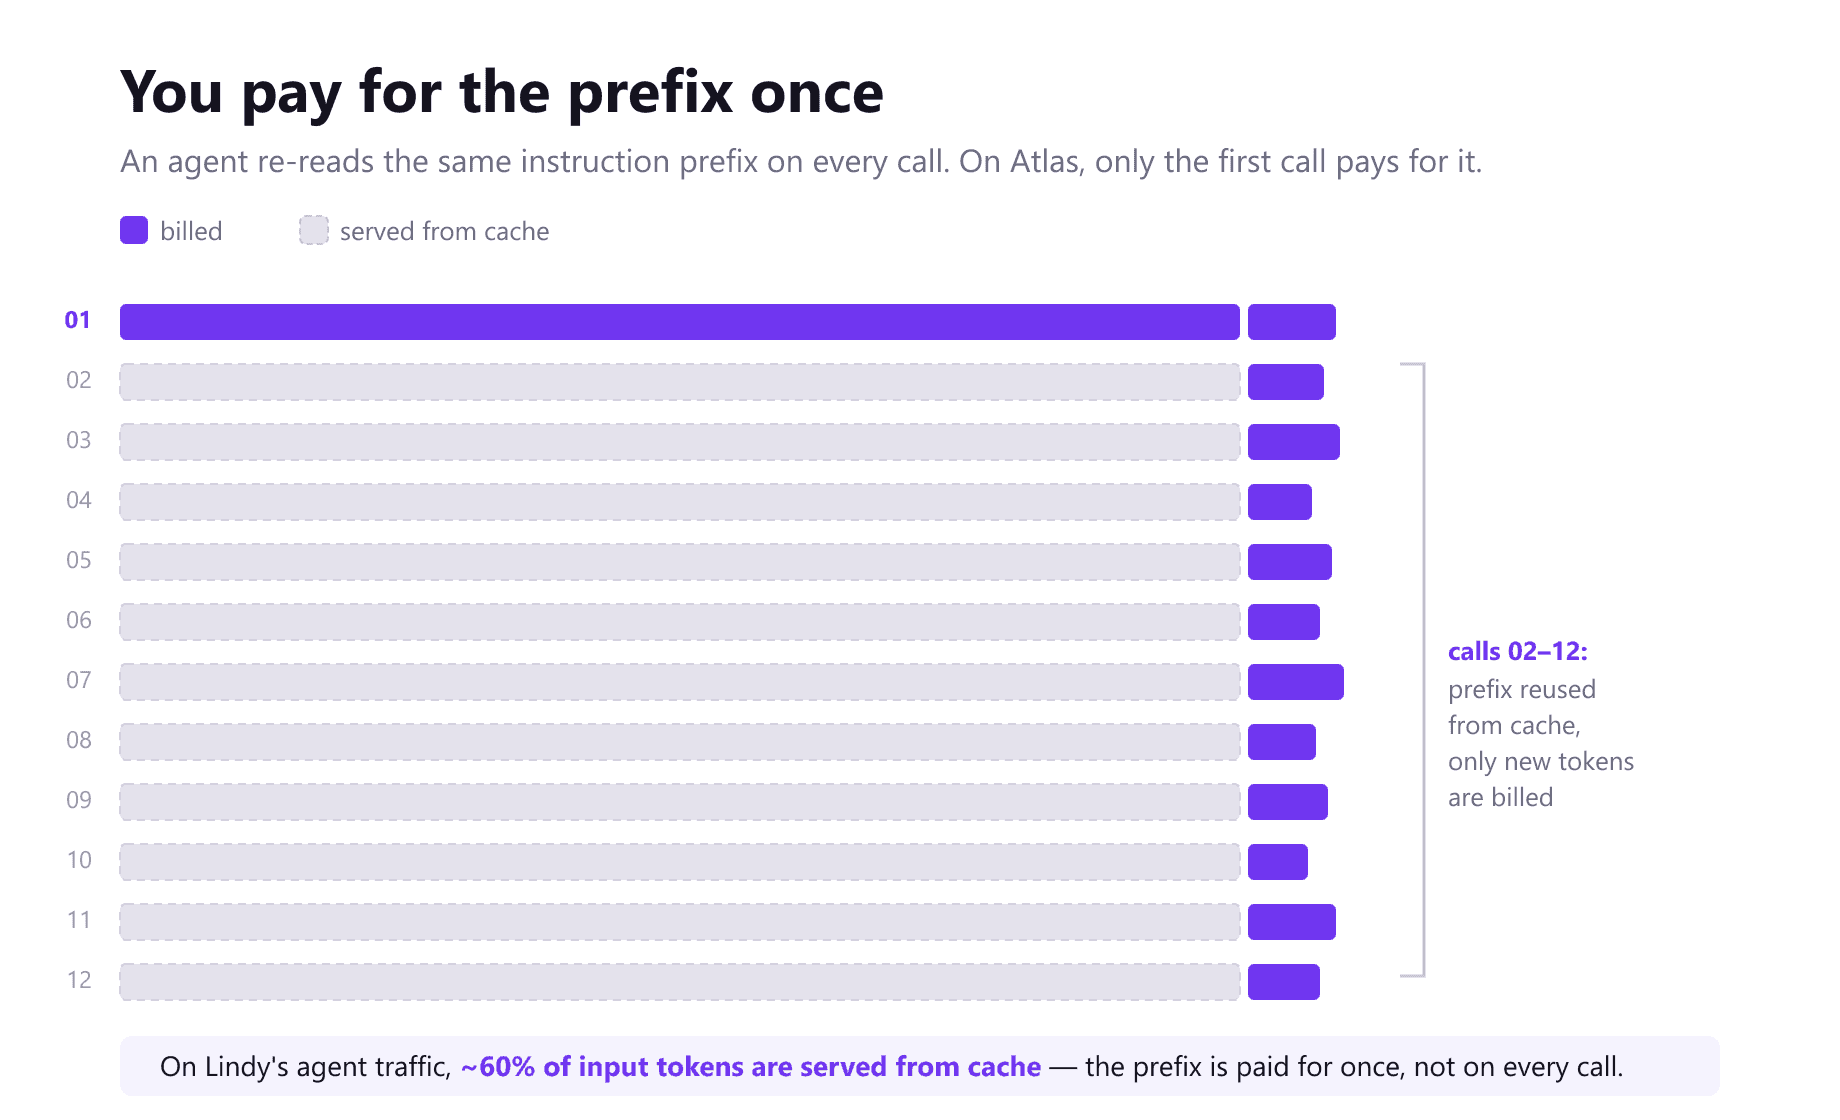
- Porque Atlas cobra las llamadas repetidas a precio de caché, Lindy ejecuta agentes que comprueban su trabajo en lugar de adivinar. Seis de cada diez tokens de entrada que envía se sirven desde caché, de modo que el prefijo que un agente relee una docena de veces por tarea cuesta casi nada.
- Porque Atlas Atliza previsión de la carga de trabajo, Lindy multiplicó su volumen por más de diez simplemente enviando más tráfico, sin reconstruir nada, y Atlas mantuvo más de 3.000 solicitudes por minuto durante una hora entera.
- Porque Atlas tiene todo el catálogo en una sola clave, Lindy puede cambiar a un modelo nuevo en una tarde. Ha ejecutado 24 modelos de 11 laboratorios con una única integración.
- Porque Atlas ofrece un contrato con nombre y certificación SOC 2, Lindy puede poner un modelo de pesos abiertos delante de los datos de sus clientes y responder por quién lo ejecuta.
El 90% es el titular de Lindy. La razón por la que se mantiene, y por la que la próxima migración será más fácil que esta, es la plataforma detrás.
Para Lindy, la factura es el negocio
Lindy construye empleados de IA. Un Lindy Teammate se une a una empresa como lo haría un nuevo contratado: recibe solicitudes en Slack, se conecta a las herramientas que el equipo ya usa, se sienta en reuniones y conserva lo aprendido para que la siguiente solicitud comience más avanzado que la anterior. Nadie escribe automatizaciones; las personas delegan y el agente hace el trabajo.
Ese diseño establece una factura de infraestructura dura. Un empleado de IA que lee un hilo, revisa un calendario, busca un registro y redacta una respuesta hace una docena de llamadas de modelo antes de que alguien vea una palabra; como un Teammate atiende a todo un equipo, el volumen crece según el número de empleados. Con esa forma de trabajo, el precio del modelo detrás del producto determina la viabilidad del negocio.
"El precio de Lindy solo funciona si la inferencia se abarata constantemente."
— Bruno Škvorc, Staff Software Engineer, Lindy
Así que Lindy hizo lo que exigen las matemáticas financieras. Movió la mayoría de su tráfico de agente gestionado de Claude, Sonnet y Gemini hacia DeepSeek v4 Flash corriendo en Atlas Cloud, y los costes de inferencia bajaron alrededor de un 90%. Cambiar el nombre del modelo tomó una tarde. Que se sostuviera a volumen de producción, sin empeorar el producto, es la razón por la que eligieron Atlas Cloud.
Por qué aguanta el 90%: la llamada número once casi gratis
Cobrado por token, un agente paga completo por el mismo prefijo docena de veces por tarea, y la factura crece con lo cuidadosamente que piensa. Ese alquiler es lo que mantiene llanos los productos de agente: una pasada en lugar de tres, porque la tercera cuesta lo mismo que la primera. También es por eso que un cambio de modelo aparentemente más barato produce menos de lo que se ve, porque el prefijo repetido llena silenciosamente la factura.
Atlas retira el impuesto donde más molesta. Seis de cada diez tokens de entrada de Lindy se reconocen en lugar de reprocesarse, con una tarifa acordada contra su volumen real, por lo que el prefijo que domina cada llamada de agente queda cercano a cero. Así es como un cambio de modelo se convierte en un 90% duradero en lugar de un número que se erosiona a medida que sube el uso, y es lo que permite que un agente ejecute tres ejecuciones donde uno, al precio por token, haría un.
"Las cargas de trabajo de agentes reutilizan mucho contexto entre muchas llamadas de modelo. El caché de Atlas nos permite no pagar el mismo contexto completo cada vez, lo que es bastante parte de por qué el ahorro se mantuvo a medida."
— — Ian McGregor, Head of Engineering, Lindy
Capacidad previa a la necesidad de Lindy
El tráfico de agente no tiene ventana de silencio nocturno ni día de lanzamiento para prepararse. La carga llega mientras los equipos trabajan y no se detiene mientras escuchas. Lo que importa no es el pico que un búfer puede absorber, sino el ritmo que un proveedor puede mantener. Lindy multiplicó su volumen por más de diez con solo enviar más tráfico, sin reconstruir nada, y Atlas se mantuvo por encima de 3.000 solicitudes por minuto durante una hora de seguido. La capacidad estaba delante de la carga, así que escalar fue decisión de empresa, nunca un proyecto de infraestructura.
Soporte que entrega producto, no tickets
A este volumen la diferencia entre proveedores está más en quien responde cuando se ve algo mal que en el panel. Los ingenieros de Lindy y los de inferencia de Atlas comparten un canal, y las respuestas vuelven el mismo día de gente que puede actuar. Algunas de esas respuestas se convierten en cambios de producto: Lindy pedía una manera de transferir el administrador de una cuenta de equipo, Atlas no la tenía en ese momento, y se envió, con los ingenieros de Atlas que movieron la cuenta ellos mismos.
Un proveedor al que puedes nombrar
Pasar a un modelo distribuido abierto deja a la fuerza que antes respondía por la forma en que se ejecutaba el modelo. Las preguntas que solía responder el sello del laboratorio ahora apuntan al proveedor: quién sirve esto, con qué controles, y qué pasa con los datos que lo atraviesan. Atlas responde con el nombre, no con un enrutador, en un contrato certificado SOC 2, donde los datos de clientes no se guardan ni se usan para entrenar. Eso nota más en un empleado IA que en un chat, porque un Teammate lee los hilos, calendarios y registros de la compañía donde trabaja. La pregunta de infraestructura se queda directamente bajo la pregunta de confianza del cliente, y Atlas contesta ambas.
No atado a DeepSeek, atado a nada
La migración comprometió a Lindy con una estrategia, no con un modelo. DeepSeek v4 Flash ganó con las cargas de trabajo testadas y conserva en el puesto mientras que sea la mejor precio a la adecuada calidad. El próximo ganador vendrá de otro laboratorio con una licencia distinta, y como Atlas Cloud permite el acceso a todos los modelos con una sola API, la prueba no cuesta más que un descenso de tarde, no un ciclo de compra. En un día de prueba, Lindy hizo 47 todelos a doce que nunca había usado, en siete laboratorios y tres modalidades, todos con la clave que ya tenía. Tres se volvieron redes de producción. La libertad de ejecutar siempre el mejor modelo por Atlas Cloud da la capacidad de operación comercial real.
Si corre agentes en el mercado, muévalosl
Lindy siguió este camino exacto. Primero conoció DeepSeek en OpenRouter, allí pasó el modelo por sus evaluaciones y demuestró que valía la migración. En esa misma prueba encontró el motivo por el que la producción se decidió.
"También probamos el mismo modelo en diferentes proveedores de inferencia. Molestia, el proveedor importaba. El mismo nominal puede puntuar distinto según el está detrás."
— Bruno Škvorc, Staff Software Engineer, Lindy
Un mercado existe para que compares, no para que corras tu producto. Proyecta tráfico a través de un enrutador y termina en cualquier con capacidad libre; no eliges quién presta tu modelo y no puedes ver quién. Iguales pesos en diferentes máquinas dan números diferentes, por cuantificación o una atajo en la pila del usuario, y esos números llegan a tus usuarios antes que a tu pastel. Cada salto de enrutador reescribe en silencio la calidad del producto por el que tus clientes pagan. No puedes soplarlo, porque no vez quién atendió la petición. No puedes corregirlo, porque no tienes completo control de la ruta. Eso es su reputación, decidida por una moneda que nunca gira directamente.
Por eso no corrió producción en OpenRouter. Cuando quiso vivir, se lo llevó con contrato directo con Atlas: una pila de servicio, la misma en cada petición, entendizada para el modelo, cuando agregar el un contrato, con la potencia de caché y la que un agente vivo necesita, y el catálogo total en la misma tecla. Si tus agentes están en producción y todavía pasan por un enrutador, estás enviando un producto que no puedes tener estable, y no lo sabrás hasta que un usuario lo sepa.
. Muévelos, como Lindy.
Habla con nosotros sobre tu carga y te diremos cuál, o visita el catálogo.**
About Lindy
Lindy construye empleados de IA. Lindy Teammate, que sale en agosto de 2026, trabajo con tu equipo humano, recoge solicitudes en Slack, se conecta a herramientas que ya usa la empresa, asiste reuniones y enriquece el contexto para que cada nueva petición înțepe desde más lejos. Ninguna petición automatización; con una persona que, no no: delega. Fue fundada por Flo Crivello y está en San Francisco.
About Atlas Cloud
Atlas Cloud es una plataforma singular de múltiples modalidades de IA: más de 400 modelos de vídeo, imagen, e speech, y lenguaje, a través de una única clave de API, un solo end point y una cuenta de billing, compatible con OpenAI para modelos de lenguaje. Certificados SOC 2 y HIPAA.


