Tu solicitud se devuelve correctamente. La aplicación sigue sin tener una imagen utilizable. Quizá la respuesta contenga un ID de tarea, o la imagen final incluya un objeto adicional que la haga inadecuada para la página.
Una API de IA generativa para desarrolladores permite que tu aplicación envíe entradas a un modelo y reciba contenido generado. Elige una en función de tus entradas requeridas, el formato de salida, el tiempo de espera y los criterios de aceptación. Después, crea la gestión de tareas y las comprobaciones que convierten una respuesta en algo que un usuario pueda usar.
Esta guía sigue un flujo de trabajo de imágenes desde la selección hasta la entrega. Obtendrás una tabla de selección de tareas, ejemplos correspondientes en JavaScript y Python, 3 briefs de imagen concretos y una hoja de cálculo de costes. El mismo proceso de decisión se aplica al texto y al vídeo, con protocolos y comprobaciones de salida diferentes.
Puntos clave
- Elige la tarea y los criterios de aceptación antes que el modelo.
- Guarda los ID de tareas asíncronas para que el trabajo interrumpido pueda reanudarse.
- Mide el coste por salida aceptada, incluidas las generaciones rechazadas.
- Prueba los archivos y las restricciones de negocio antes de mostrar un resultado final.
API de IA generativa para desarrolladores: qué hace
Un modelo realiza la generación. Una API define cómo tu software solicita ese trabajo. Un SDK envuelve la interfaz en asistentes específicos del lenguaje. Una plataforma alojada gestiona el acceso a los modelos, mientras que tu aplicación proporciona la experiencia de usuario, los permisos y las reglas para aceptar el resultado.
Estas distinciones importan al leer una página de producto. Una aplicación de chat que crea imágenes no demuestra que su endpoint para desarrolladores acepte las mismas entradas. Un SDK con un método cómodo no elimina la necesidad de entender su respuesta subyacente y sus estados de fallo.
Empieza con el siguiente mapa de tareas. La columna de interacción describe un diseño de aplicación a evaluar, no una promesa de que todos los proveedores admitan ese modo.
| Tarea | Entrada | Capacidad requerida | Salida | Interacción a evaluar | Criterios de aceptación |
|---|---|---|---|---|---|
| Borrador de respuesta de soporte | Ticket y contenido de ayuda aprobado | Generación de texto fundamentada | Texto de borrador | Síncrona o en streaming | Responde al ticket; sin políticas inventadas |
| Extracción de campos de documentos | Texto del documento o archivo compatible | Extracción estructurada | Campos JSON | Solicitud o tarea en cola | Esquema válido y evidencia de origen |
| Ilustración editorial | Brief visual escrito | Texto a imagen | Archivo de imagen | Tarea asíncrona | Objetos, composición y dimensiones correctos |
| Edición de imágenes | Imagen de origen e instrucción | Edición condicionada por imagen | Imagen editada | Tarea asíncrona | Cambio solicitado; detalles preservados |
| Generación de vídeo | Prompt o referencia compatible | Generación de vídeo | Archivo de vídeo | Tarea en cola | Duración, movimiento y audio correctos si se requieren |
| Respuesta asistida por recuperación | Pregunta y pasajes recuperados | Recuperación más generación | Respuesta y referencias | Síncrona o en streaming | Afirmaciones respaldadas por los pasajes recuperados |
Generar una imagen, analizar una imagen subida y editar una imagen existente son capacidades distintas. Verifica cada una de forma explícita. De manera similar, un endpoint de vídeo puede admitir un fotograma inicial sin admitir referencias arbitrarias de varias imágenes.
Los embeddings convierten entradas en vectores útiles para la recuperación y la similitud. Pueden ayudar a encontrar documentos relevantes antes de que se genere una respuesta. Por sí mismos no producen la respuesta ni establecen que el contenido recuperado respalde sus afirmaciones.
El límite práctico es entrada → solicitud → salida → aceptación de la aplicación. Tú eres responsable de la etapa final. Un campo de factura generado todavía necesita validación; una imagen todavía necesita inspección; una respuesta de soporte todavía necesita permiso para hacer la promesa que contiene.
Las opciones de protocolo también varían. La referencia de Google distingue entre generación estándar, streaming e interacción en vivo. Toma eso como evidencia de que los modos de interacción difieren, en lugar de asumir un soporte idéntico en otros lugares. (Referencia de la API de Google Gemini, consultado en septiembre de 2026.)
API de IA generativa para desarrolladores: cómo elegir
Escribe un breve documento de aceptación antes de comparar catálogos. Para una función de imagen editorial, podría especificar salida horizontal, un número limitado de objetos, ausencia de marcas visibles y un paso de revisión humana. Para la clasificación de tickets, podría especificar un conjunto fijo de etiquetas y un resultado incierto explícito.
Evalúa los candidatos en este orden:
- Entradas y salidas. Comprueba el endpoint exacto del modelo para archivos compatibles, límites de entrada, formatos de salida y comportamiento con imágenes de referencia. El nombre de una familia de modelos es demasiado amplio para servir como contrato.
- Cumplimiento de la tarea. Prueba briefs representativos, incluidos los difíciles. Cuenta los fallos de restricciones por separado de los fallos de archivo o red para saber qué hay que corregir.
- Idoneidad de integración. Confirma la autenticación, los envoltorios de respuesta, los valores de estado de tarea y el soporte de la biblioteca cliente. Incluye el trabajo necesario para adaptarlos a tu backend existente.
- Tiempo de espera y concurrencia. Decide si los usuarios pueden marcharse y volver. Prueba tu carga de trabajo esperada antes de comprometerte con una experiencia interactiva con un plazo corto.
- Claridad de facturación. Identifica la unidad facturable y qué ajustes la modifican. Comprueba el tratamiento de fallos y reembolsos en lugar de asumir que cada solicitud enviada recibe el mismo cargo.
- Requisitos de datos. Revisa el tratamiento de entradas, la retención, la eliminación y los términos aplicables frente a los datos reales que pretendes enviar. Documenta las preguntas sin resolver antes de usar material sensible.
- Gestión de cambios. Mantén un conjunto de regresión y registra los identificadores de modelo, los prompts y los parámetros. Planifica cómo reevaluarás el comportamiento tras una actualización o sustitución.
Las guías institucionales ilustran por qué las reglas de acceso y datos pertenecen a esta decisión: Harvard describe rutas de acceso aprobadas y restricciones en torno a sus herramientas de IA para desarrolladores. Esos son los acuerdos de Harvard, no permisos universales para tu aplicación. (Harvard University Information Technology, consultado en septiembre de 2026.)
| Ruta de acceso | Equipo adecuado | Trabajo de integración | Responsabilidad operativa | Limitación principal | Verificar antes de elegir |
|---|---|---|---|---|---|
| Proveedor directo de modelos | Equipo centrado en las capacidades de un proveedor | API específica del proveedor, cuentas, adaptadores | Tu aplicación y tareas; inferencia del proveedor | Los proveedores adicionales añaden contratos separados | Funciones del endpoint, regiones, cuotas, términos |
| Plataforma alojada multimodelo | Equipo que evalúa varios modelos compatibles | Acceso compartido más validación específica por modelo | Tu aplicación y tareas; inferencia alojada en la plataforma | El acceso compartido no estandariza todos los parámetros | Modelos exactos, esquemas, facturación, ruta de datos |
| Modelo abierto autoalojado | Equipo con habilidades de infraestructura y servicio de modelos | Desplegar, exponer, asegurar y mantener la inferencia | Hardware, servicio, escalado, monitorización, actualizaciones | Capacidad y sobrecarga de ingeniería | Licencia, idoneidad del hardware, rendimiento, mantenimiento |
Atlas Cloud es una opción alojada que puedes evaluar cuando varias capacidades de modelos pertenecen a la misma aplicación. Este artículo utiliza su interfaz de tareas de imagen como ejemplo concreto. Aun así, debes validar las entradas y salidas de cada modelo; cambiar solo un ID de modelo no es suficiente.
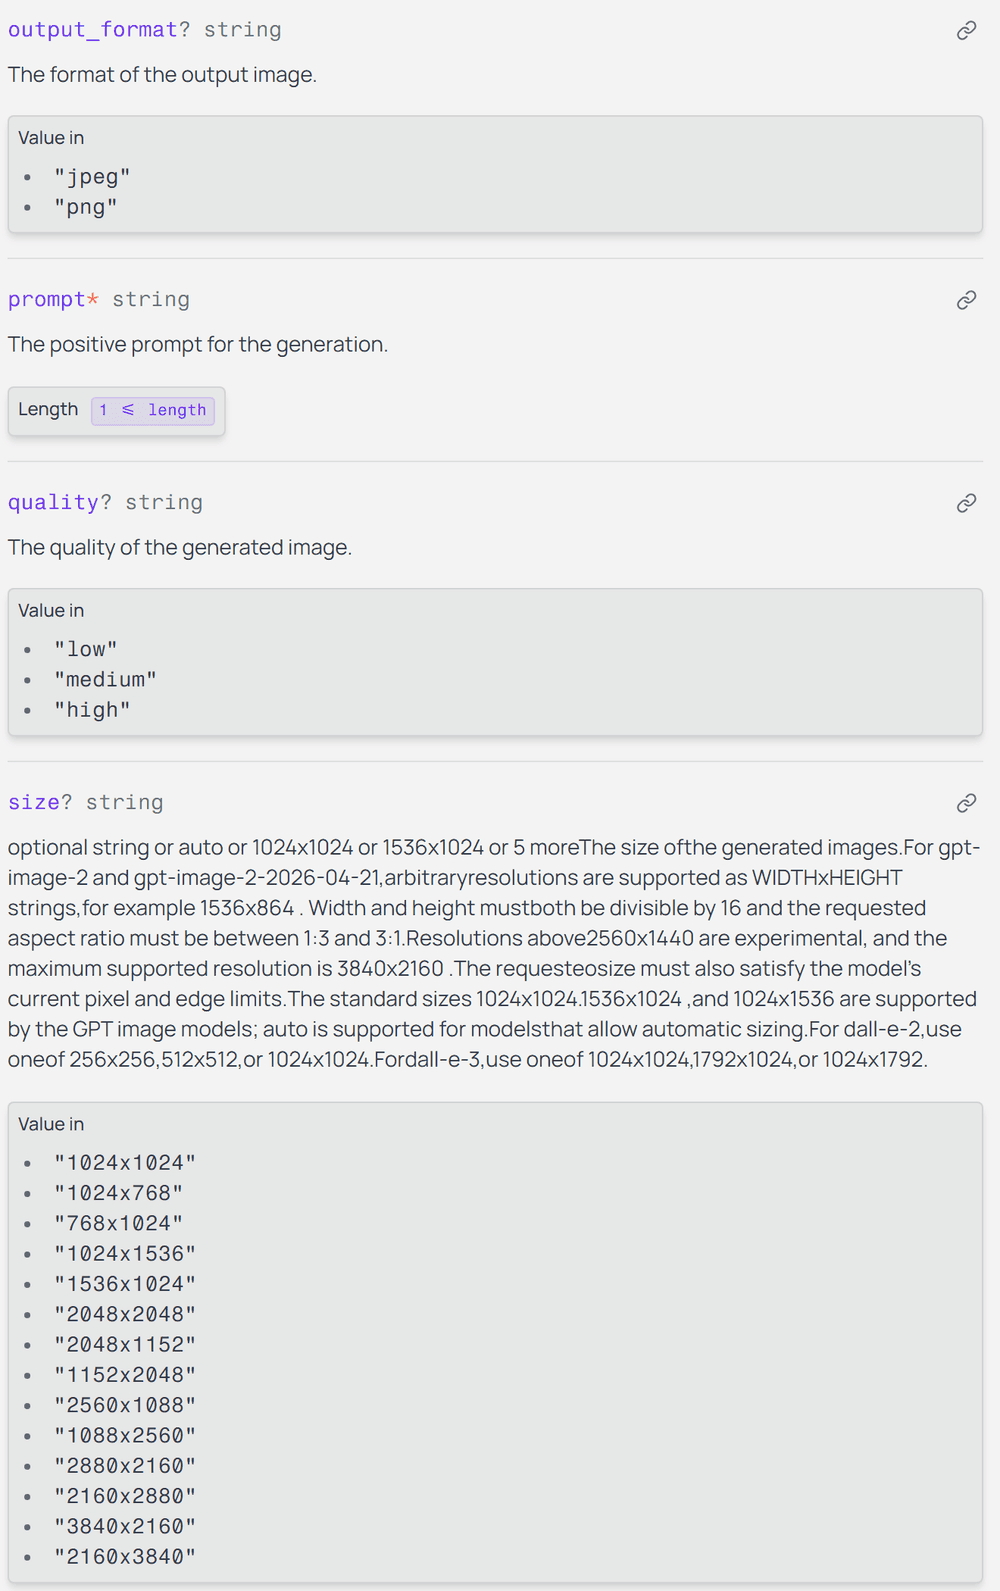
Documentación oficial del endpoint de imágenes que muestra el formato de salida, la calidad y las restricciones de tamaño
Los parámetros específicos del modelo forman parte del contrato de integración. Lee sus valores permitidos antes de reutilizar un cuerpo de solicitud.
Para un equipo pequeño de SaaS, la comparación útil es el esfuerzo total para entregar un resultado aceptado. Incluye el código del adaptador, la investigación de soporte, el tiempo de revisión y las pruebas de migración junto con el cargo de inferencia. Así evitas que un prototipo cómodo oculte un flujo de trabajo de producción costoso.
API de IA generativa para desarrolladores: primera solicitud
El ejemplo usa GPT Image 2 Text-to-Image, con el ID de modelo openai/gpt-image-2/text-to-image. La documentación de su endpoint indica quality: high, size: 2048x1152 y output_format: png. Estos son los ajustes solicitados para los ejemplos siguientes.
1. Establece el prompt en el playground. Usa el brief de desayuno de abajo sin añadir una imagen de referencia. Comprueba el nombre del modelo y los ajustes confirmados antes de pulsar Run. Una selección que se revierte al salir de un campo no es el ajuste que solicitaste.
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. Mantén la autenticación en el servidor. Tu frontend debe pedir a tu propio backend que inicie una tarea. Guarda ATLAS_API_KEY en el entorno del servidor. Nunca la incluyas en JavaScript del navegador, URLs de imágenes ni registros visibles para el cliente. Configura ATLAS_API_HOST como api.atlascloud.ai; esto es un nombre de host, sin esquema ni ruta.
3. Envía una sola vez y conserva el ID. La ruta de generación documentada es POST /api/v1/model/generateImage. Lee data.id y luego guárdalo asociado a la tarea de tu aplicación. Si se pierde la respuesta de envío, investiga antes de crear otra tarea potencialmente facturable.
4. Consulta periódicamente la tarea guardada. Consulta GET /api/v1/model/prediction/{prediction_id}. La documentación de predicciones describe processing, completed y failed, con URLs de salida en data.outputs. Un estado completado aún debe comprobarse para asegurar que el array de salida no esté vacío.
5. Descarga y valida. Guarda el archivo bajo tu control, verifica que se decodifica e inspecciónalo frente al brief. Solo entonces devuelve un resultado aceptado a la aplicación. Un error de descarga o validación debe permanecer asociado a la tarea existente.
El siguiente código está ensamblado a partir de la documentación oficial de la interfaz. No se presenta como un benchmark de API en vivo. El flujo de trabajo multimedia del artículo usa el playground de pruebas del navegador, no una clave de API.
Guarda el prompt exacto del desayuno como prompt.txt. Para Node.js, usa un entorno con fetch integrado, instala sharp y guarda esto como generate.mjs. Ejecútalo en un directorio de trabajo dedicado. Ejecuta solo uno de los dos ejemplos de lenguaje, a menos que quieras intencionadamente dos tareas.
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
El equivalente más corto en Python usa requests y Pillow, el mismo prompt.txt y ajustes idénticos. También acepta PREDICTION_ID para reanudar. Estos scripts demuestran una tarea local; un servicio desplegado necesita registros de tareas persistentes y descargas limitadas.
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
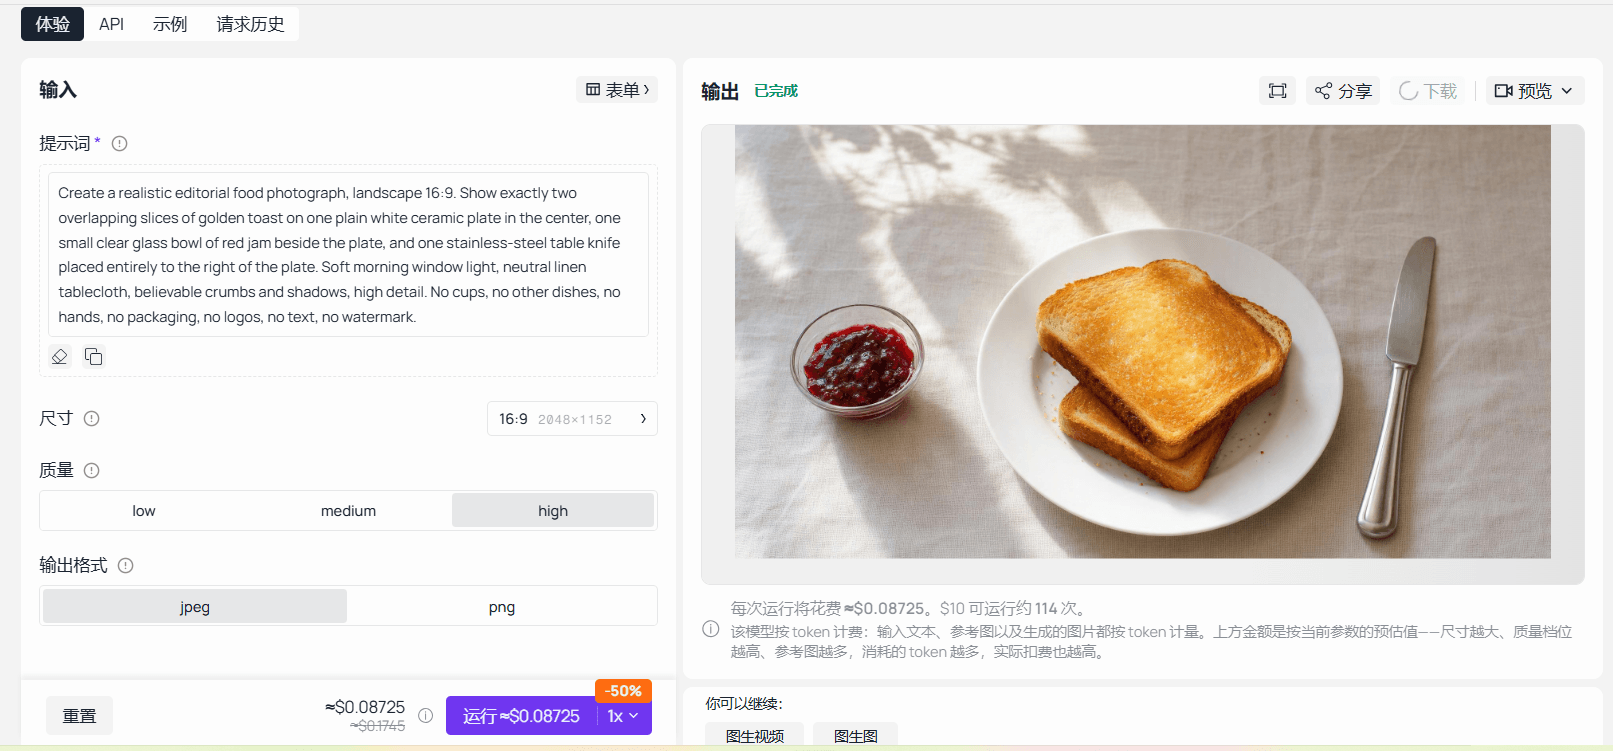 Playground de GPT Image 2 completado que muestra el prompt de desayuno enviado y la salida finalizada
Una ejecución completada del playground registra juntos el prompt enviado, el tamaño de salida, el ajuste de calidad y el resultado generado.
Un plazo límite de consulta impide que este cliente siga esperando; no cancela el trabajo del lado del servidor. Una solicitud ya en curso puede finalizar después de la ventana de consulta, por lo que esto no es una garantía estricta de latencia de extremo a extremo. Conserva el ID y permite que un worker lo compruebe más tarde.
API de IA generativa para desarrolladores: usos prácticos
Los 3 briefs siguientes prueban requisitos diferentes. Son solicitudes independientes, no una cadena en la que un resultado se convierte en la siguiente entrada. Mantén el mismo modelo y los ajustes solicitados para que las diferencias entre los briefs sigan siendo fáciles de entender.
A. Imagen editorial de comida: recuento y colocación. El prompt del desayuno prueba si la salida contiene 2 rebanadas de tostada, 1 plato, 1 cuenco de mermelada y 1 cuchillo. El cuchillo debe estar a la derecha del plato, y todos los objetos requeridos deben permanecer dentro del encuadre.
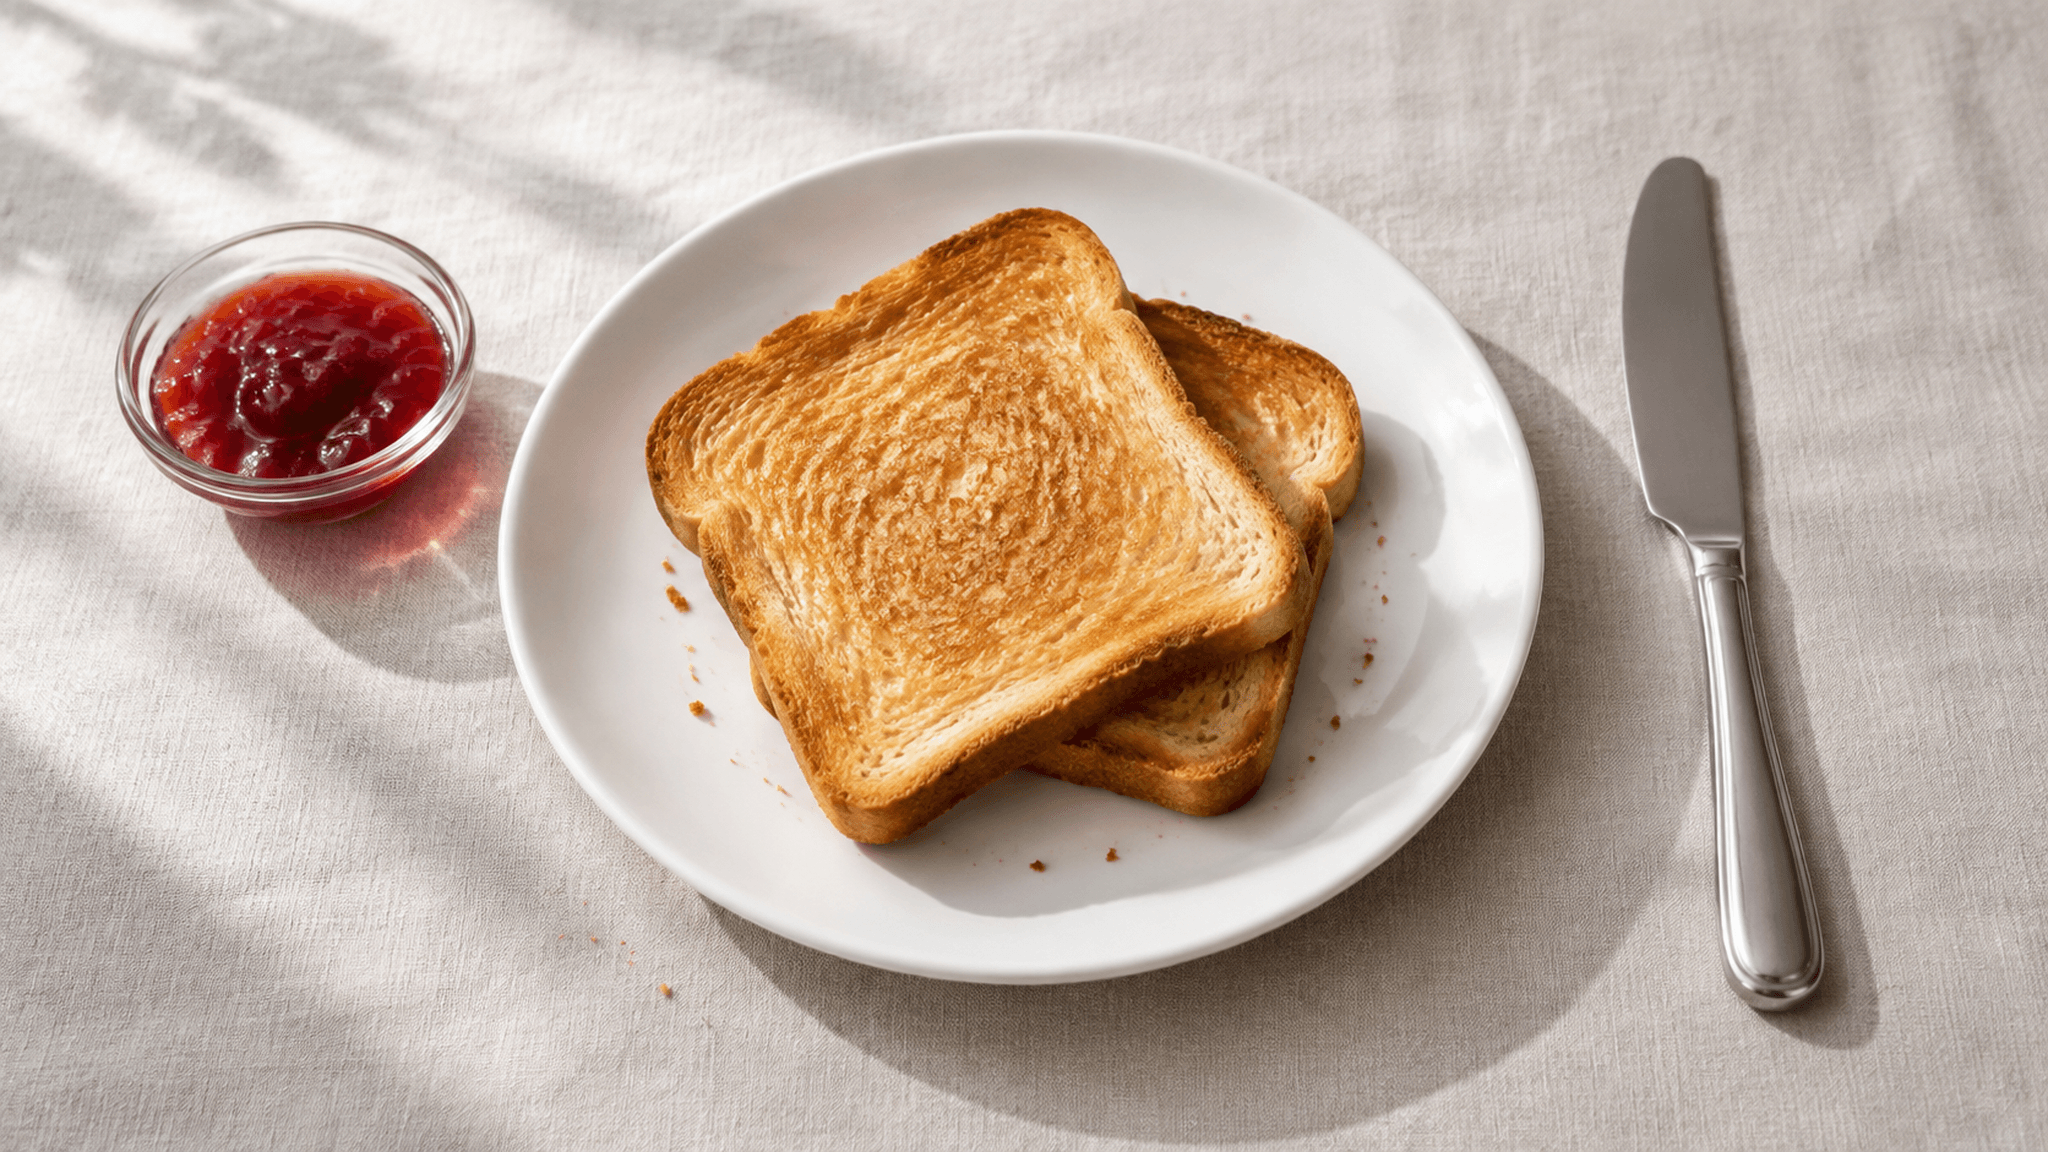
Ejemplo de generación de imagen de desayuno junto con las comprobaciones_Todos los objetos solicitados —plato, tostada, cuenco de mermelada y cuchillo a la derecha— aparecen en el resultado generado, listos para la revisión de colocación de abajo.
Inspecciona individualmente las rebanadas superpuestas. Un desayuno visualmente convincente todavía puede fallar si aparece una taza en el fondo o el cuchillo se mueve sobre el plato. Si un resultado falla, revisa la instrucción espacial ambigua, cambia una variable y conserva el motivo del rechazo. Evita pedir repetidamente una imagen mejor en general.
B. Portada de artículo: espacio utilizable para el titular. Esta solicitud trata la composición como una dependencia de diseño. El editor de la página necesita espacio vacío a la izquierda, mientras que el lado derecho contiene las herramientas y la maceta. Añade el título real más tarde usando HTML/CSS para que siga siendo editable y legible.
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
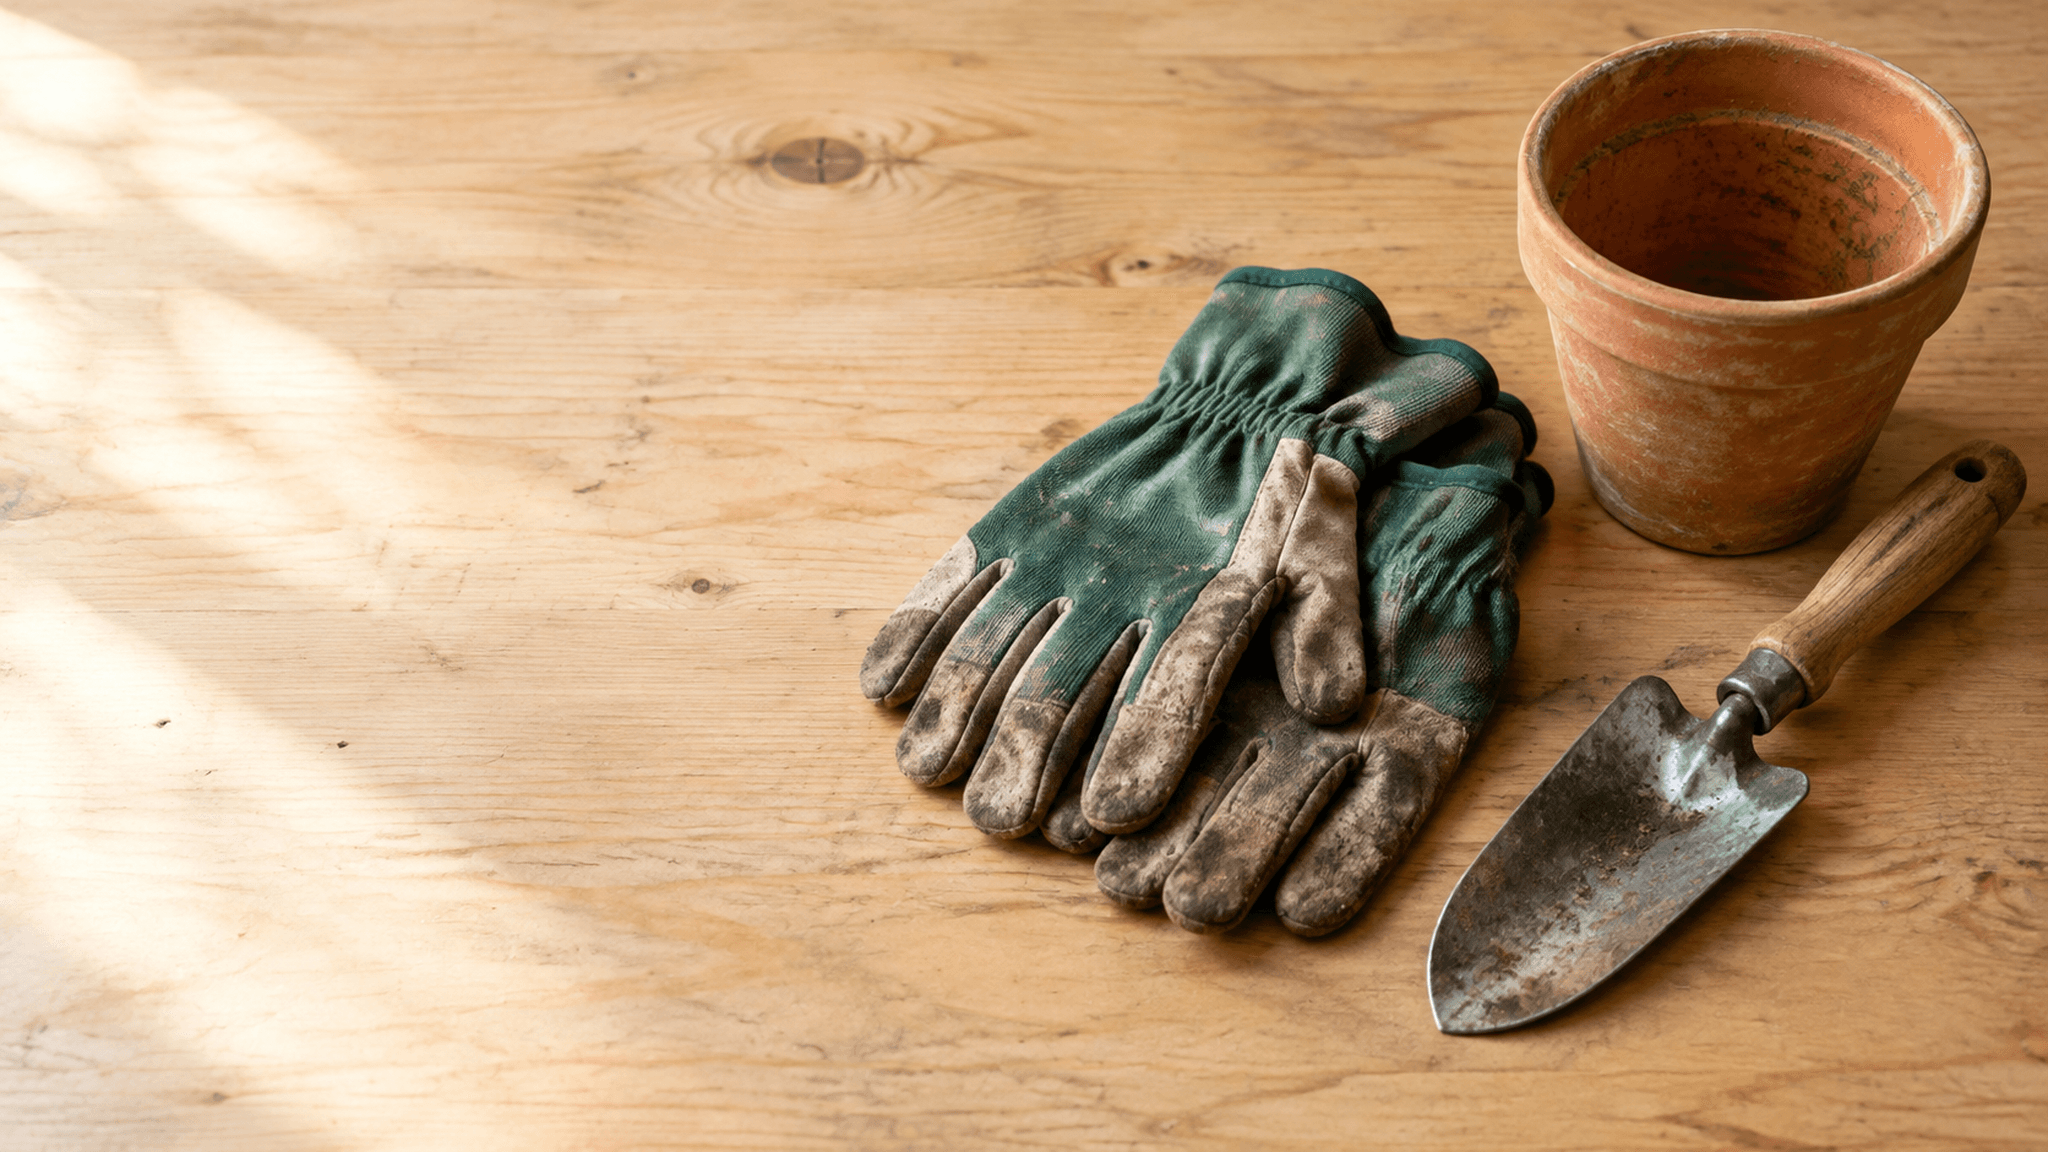 Ejemplo de portada de banco de trabajo que muestra el espacio solicitado para el titular a la izquierda y los objetos a la derecha
El resultado conserva espacio vacío utilizable a la izquierda mientras mantiene los guantes, la maceta y la paleta a la derecha.
Comprueba el resultado con el recorte de publicación previsto. Una imagen maestra horizontal puede perder su región vacía útil cuando una tarjeta móvil recorta desde el centro. Si la composición falla, especifica límites de objeto más ajustados o cambia el recorte de la aplicación. No ocultes el fallo colocando texto sobre los sujetos solicitados.
C. Ilustración de tejidos: detalle y orden. La siguiente solicitud pide 3 muestras dobladas con texturas visibles distinguibles. Prueba el recuento, la posición y si el resultado sirve como ilustración explicativa al tamaño que verán los lectores.
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
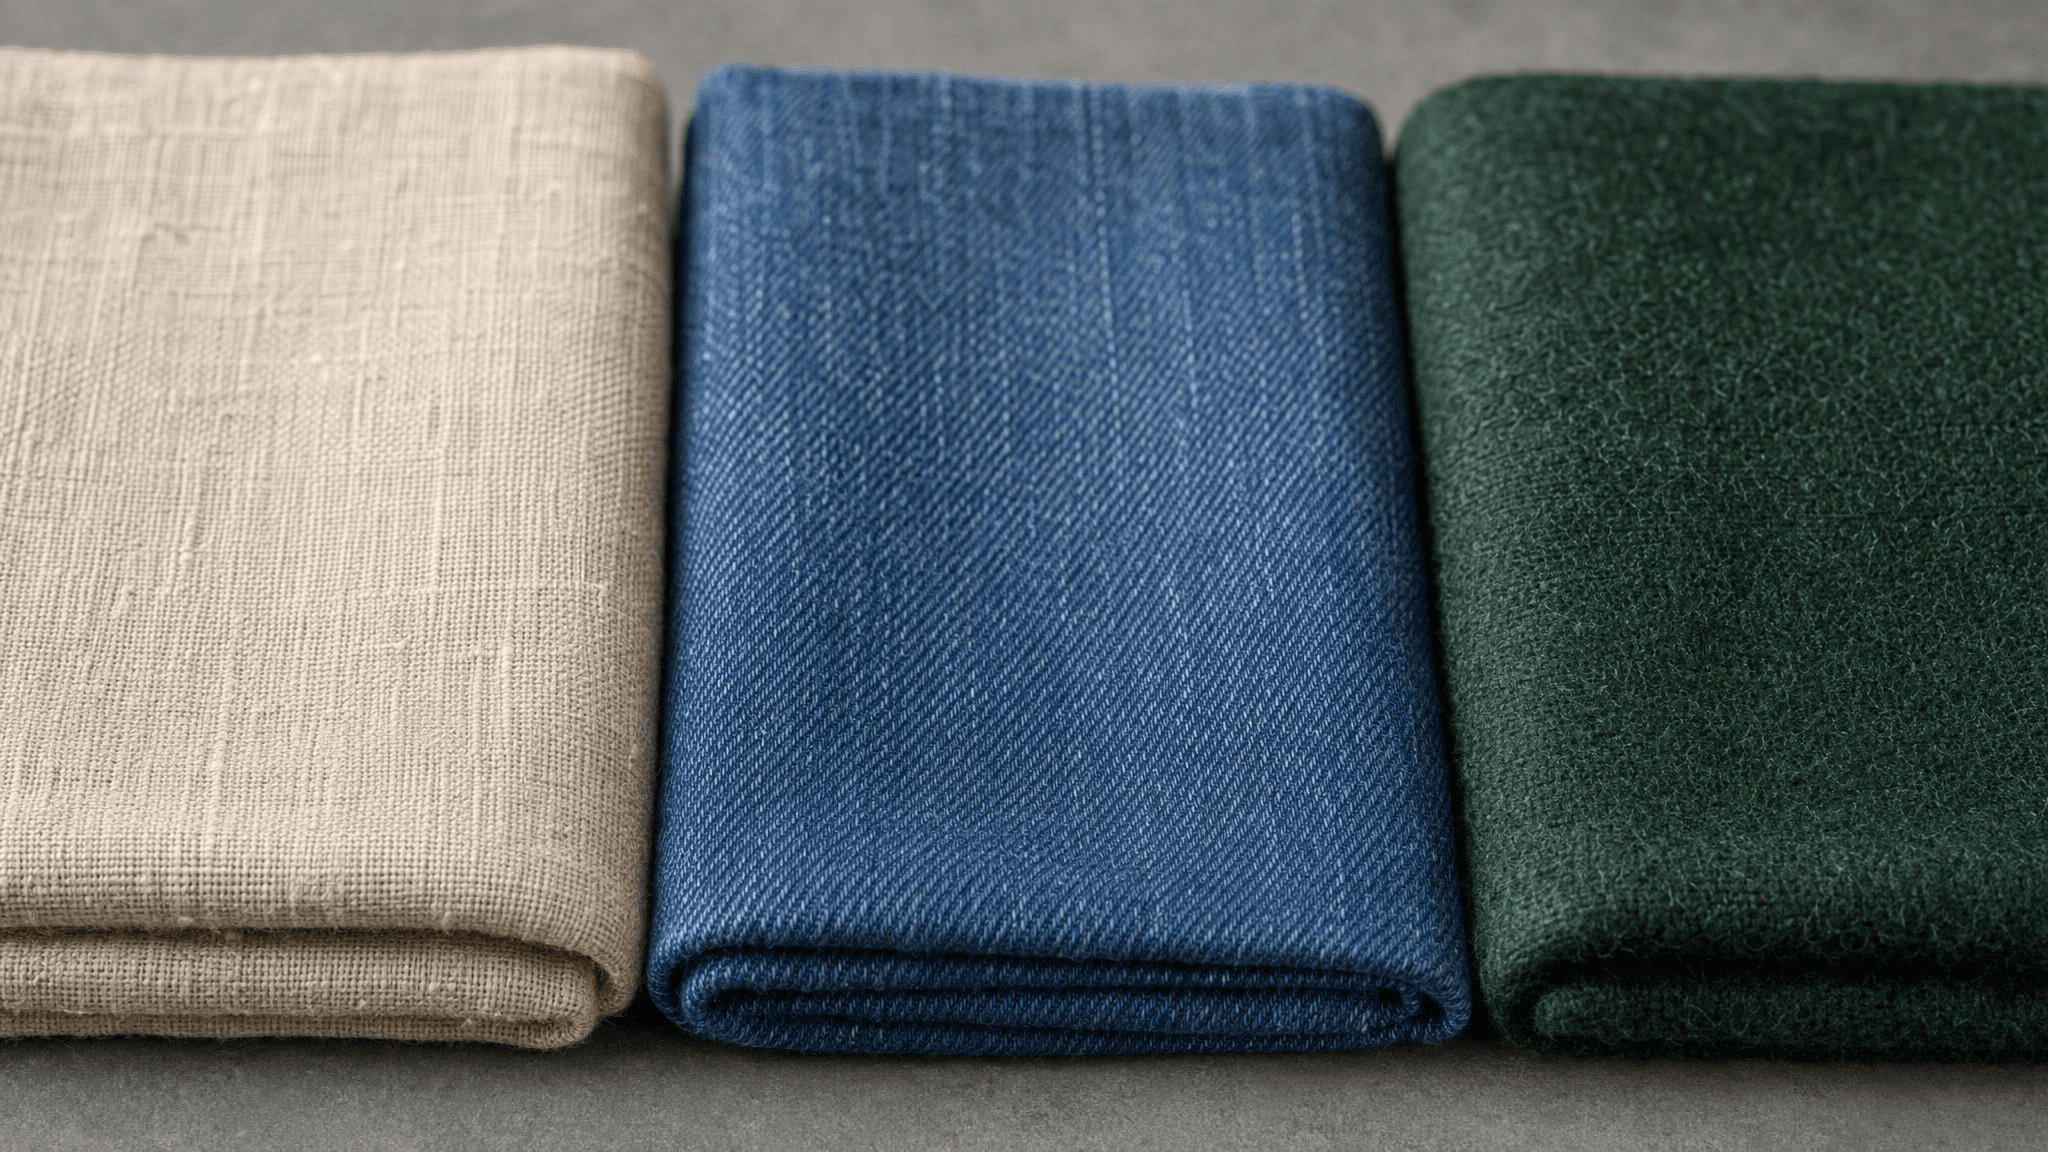 Ilustración de tejidos generada por IA con comprobaciones de colocación de muestras beige, azul y verde oscuro
Las tres muestras solicitadas son visualmente distintas. Esta textura generada es una ilustración, no evidencia de la composición de fibras de un producto real.
Si la muestra central carece de un tejido legible, registra ese problema y ajusta el encuadre o la instrucción de detalle. Nunca describas una textura generada como una propiedad medida de un producto real.
Las funciones de texto necesitan comprobaciones igualmente específicas. Para la clasificación de tickets, rechaza las etiquetas fuera del conjunto permitido y mantén una ruta incierta. Para la extracción de documentos, exige campos y fragmentos de origen junto con un JSON analizable. Una respuesta sintácticamente válida todavía puede colocar el importe equivocado en el campo equivocado.
API de IA generativa para desarrolladores: gestionar fallos
Registra por separado el éxito del transporte, la finalización de la tarea y la aceptación de negocio. Una respuesta HTTP correcta puede contener una tarea en proceso. Una tarea completada puede producir una descarga defectuosa. Una imagen legible puede incumplir el brief. Cada caso necesita una acción de recuperación diferente.
Configura 3 tiempos deliberadamente: un timeout HTTP individual, un intervalo de consulta y una ventana de espera general. Los ejemplos usan un timeout de solicitud de API de 30 segundos, consultas cada 2 segundos y una ventana de consulta de 10 minutos. Son decisiones de la aplicación, no el rendimiento anunciado del servicio.
| Síntoma | Posible causa | Comprobar a continuación | Enfoque de reintento |
|---|---|---|---|
| Error de parámetro | Campo o valor no compatible | Esquema exacto del endpoint y payload enviado | Corrige primero la solicitud |
| HTTP 401 | Problema de autenticación o ruta incorrecta | Configuración de la clave y ruta del endpoint | Sin reintento sin cambios |
| Saldo insuficiente | Saldo disponible o asignación | Estado de facturación de la cuenta | Resuelve primero el saldo o la asignación |
| HTTP 429 | Límite de velocidad alcanzado | Concurrencia de cuenta/modelo y tasa de solicitudes | Retroceso acotado con jitter |
| La tarea informa de fallo | Fallo del modelo, la entrada o la política | ID de predicción, código de error, detalle del error | Investiga antes de una nueva generación |
| Timeout de consulta | Plazo del cliente o tarea lenta | Estado de la tarea existente | Reanuda consultando el mismo ID |
| Completado con salida vacía | Resultado ausente o inesperado | Respuesta completa estructurada de la tarea | Marca para investigar; no reenvíes a ciegas |
La documentación actual de errores de la plataforma indica que los endpoints de LLM y multimedia no proporcionan cabeceras Retry-After ni de límite de velocidad restante. Usa una política de retardo del lado del cliente; no hagas que la recuperación dependa de una cabecera que estas rutas no devuelven. Otras familias de API pueden comportarse de forma diferente.
Mantén acotados los reintentos automáticos de lectura. Los retardos exponenciales más un poco de jitter aleatorio ayudan a evitar que muchos workers reintenten a la vez. Reduce la concurrencia si la limitación de velocidad persiste. Los fallos repetidos deben convertirse en un incidente observable en lugar de un bucle infinito oculto tras un spinner.
Los reintentos de envío merecen un tratamiento más estricto. Cuando se cierra una conexión después de enviar el cuerpo, puede que no sepas si el servidor creó una tarea. Registra una intención local antes del envío e investiga el historial de solicitudes o los rastros de soporte cuando no llegue un ID de predicción. No inventes una cabecera de idempotencia a menos que el endpoint la documente.
Cuando tengas un ID, úsalo para reanudar. Un fallo de descarga debe provocar otro intento de descarga o una comprobación de estado, no otra solicitud de generación de imagen. Los ejemplos mantienen deliberadamente el reintento automático en las lecturas de consulta y se detienen ante un envío fallido.
Para cada tarea, conserva el ID de tarea de tu aplicación, el ID de predicción, los ID de solicitud, el modelo, los ajustes, las marcas de tiempo y la disposición final. Almacena los prompts solo bajo una política de datos adecuada. Nunca incluyas cabeceras de autorización ni contenido sensible del usuario en los registros generales de errores.
Proporciona al frontend estados que pueda explicar: preparando, procesando, comprobando salida, listo o necesita atención. Muestra una tarea recuperable cuando alguien recargue la página. Desactiva el envío repetido mientras la misma tarea local esté pendiente, pero permite una nueva solicitud intencionada cuando corresponda.
API de IA generativa para desarrolladores: costes reales
Un precio bajo por solicitud no te dice el coste de una función utilizable. Tu presupuesto necesita el importe cobrado, el número de salidas aceptadas y el trabajo de apoyo necesario para entregarlas.
Las API de texto suelen distinguir entre tokens de entrada y de salida. El contexto largo, los pasajes recuperados, el historial de conversación y las respuestas repetidas pueden contribuir al uso. Registra las categorías que el endpoint elegido factura realmente en lugar de aplicar una única estimación de tokens a cada carga de trabajo.
Para imágenes, inspecciona la unidad de facturación y la configuración del modelo exacto. El tamaño y la calidad pueden afectar a la facturación de forma distinta según el modelo. Para vídeo, la duración, la resolución y la elección de modelo pueden cambiar el cargo. No conviertas el precio inicial de un catálogo en un presupuesto para una configuración específica.
El precio exacto de alta calidad, 2048 × 1152, del modelo de imagen seleccionado no se verificó en el catálogo y la página de detalle durante la investigación de este artículo. Aquí no se afirma ningún precio unitario ni descuento actual. Confírmalo antes de ejecutar una evaluación de producción de pago.
Usa 2 cálculos relacionados:
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
Mantén el periodo de observación coherente. Para el almacenamiento continuo, indica si el cálculo cubre el primer mes, un periodo de retención definido o un coste recurrente asignado. Evita comparar la cifra de solo inferencia de un modelo con el coste totalmente cargado de otro flujo de trabajo.
Ejemplo hipotético: envías 100 solicitudes y aceptas 80 salidas. Divide el cargo total real de ese lote entre 80. Si a las 100 solicitudes se les cobró un importe idéntico c, el coste de API por salida aceptada sería 1.25c. Esa condición importa: no se asume que cada solicitud fallida se facture.
| Modelo | Ajustes | Envíos | Cargo real | Salidas aceptadas | Coste de API por salida aceptada | Fecha de medición |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high; 2048x1152; PNG | Por registrar | Por registrar | Por registrar | Por calcular | Por registrar |
| Mismo modelo, siguiente lote de evaluación | Registra los ajustes exactos | Por registrar | Por registrar | Por registrar | Por calcular | Por registrar |
Usa esto como una hoja de trabajo, no como una tabla de resultados. Las demostraciones de imagen no establecen una tasa de aceptación representativa ni un coste de producción. Mantén las estimaciones del playground separadas de los registros de facturación liquidados, especialmente al evaluar en un entorno de pruebas.
Cuando las salidas aceptadas sean cero, informa del lote como no exitoso y muestra el gasto total. La relación de coste por salida aceptada no está definida en ese caso. Ocultar los lotes fallidos haría que tu presupuesto pareciera mejor de lo que se comporta la aplicación.
Reduce primero el desperdicio: valida las entradas antes del envío, guarda los ID de tarea, evita duplicados accidentales y reutiliza los recursos aceptados cuando el producto lo permita. Después compara ajustes más baratos con los mismos briefs y comprobaciones. Un ajuste que reduce el presupuesto pero duplica el trabajo de rechazo puede aumentar el coste de la función.
Prueba la salida, no solo la respuesta
Escribe los criterios de aceptación mientras redactas el prompt. Esto evita que una imagen convincente cambie tu definición de éxito a posteriori. Mantén los requisitos obligatorios separados de las preferencias opcionales y registra por qué un revisor rechazó un resultado.
Automatiza las comprobaciones que tienen respuestas mecánicas claras: éxito de descarga, decodificación del archivo, formato, dimensiones y límites de tamaño de archivo. Para JSON, valida el esquema, los campos obligatorios, las etiquetas permitidas y los tipos. Un campo obligatorio ausente no debería convertirse silenciosamente en un valor predeterminado inventado.
Usa revisión humana para los requisitos que necesitan interpretación. En el ejemplo del desayuno, un revisor debe distinguir las rebanadas superpuestas, identificar el cuchillo, evaluar su posición y buscar objetos adicionales. Un verificador de visión automatizado puede ayudar, pero evalúa sus errores antes de dejar que apruebe resultados por sí solo.
La revisión del desayuno debe incluir las siguientes comprobaciones independientes:
- Exactamente 2 rebanadas de tostada, 1 plato blanco, 1 cuenco de mermelada transparente y 1 cuchillo.
- Cuchillo a la derecha del plato; objetos requeridos totalmente dentro del encuadre.
- Sin tazas, platos, manos, envases ni marcas visibles adicionales.
- PNG legible en las dimensiones solicitadas.
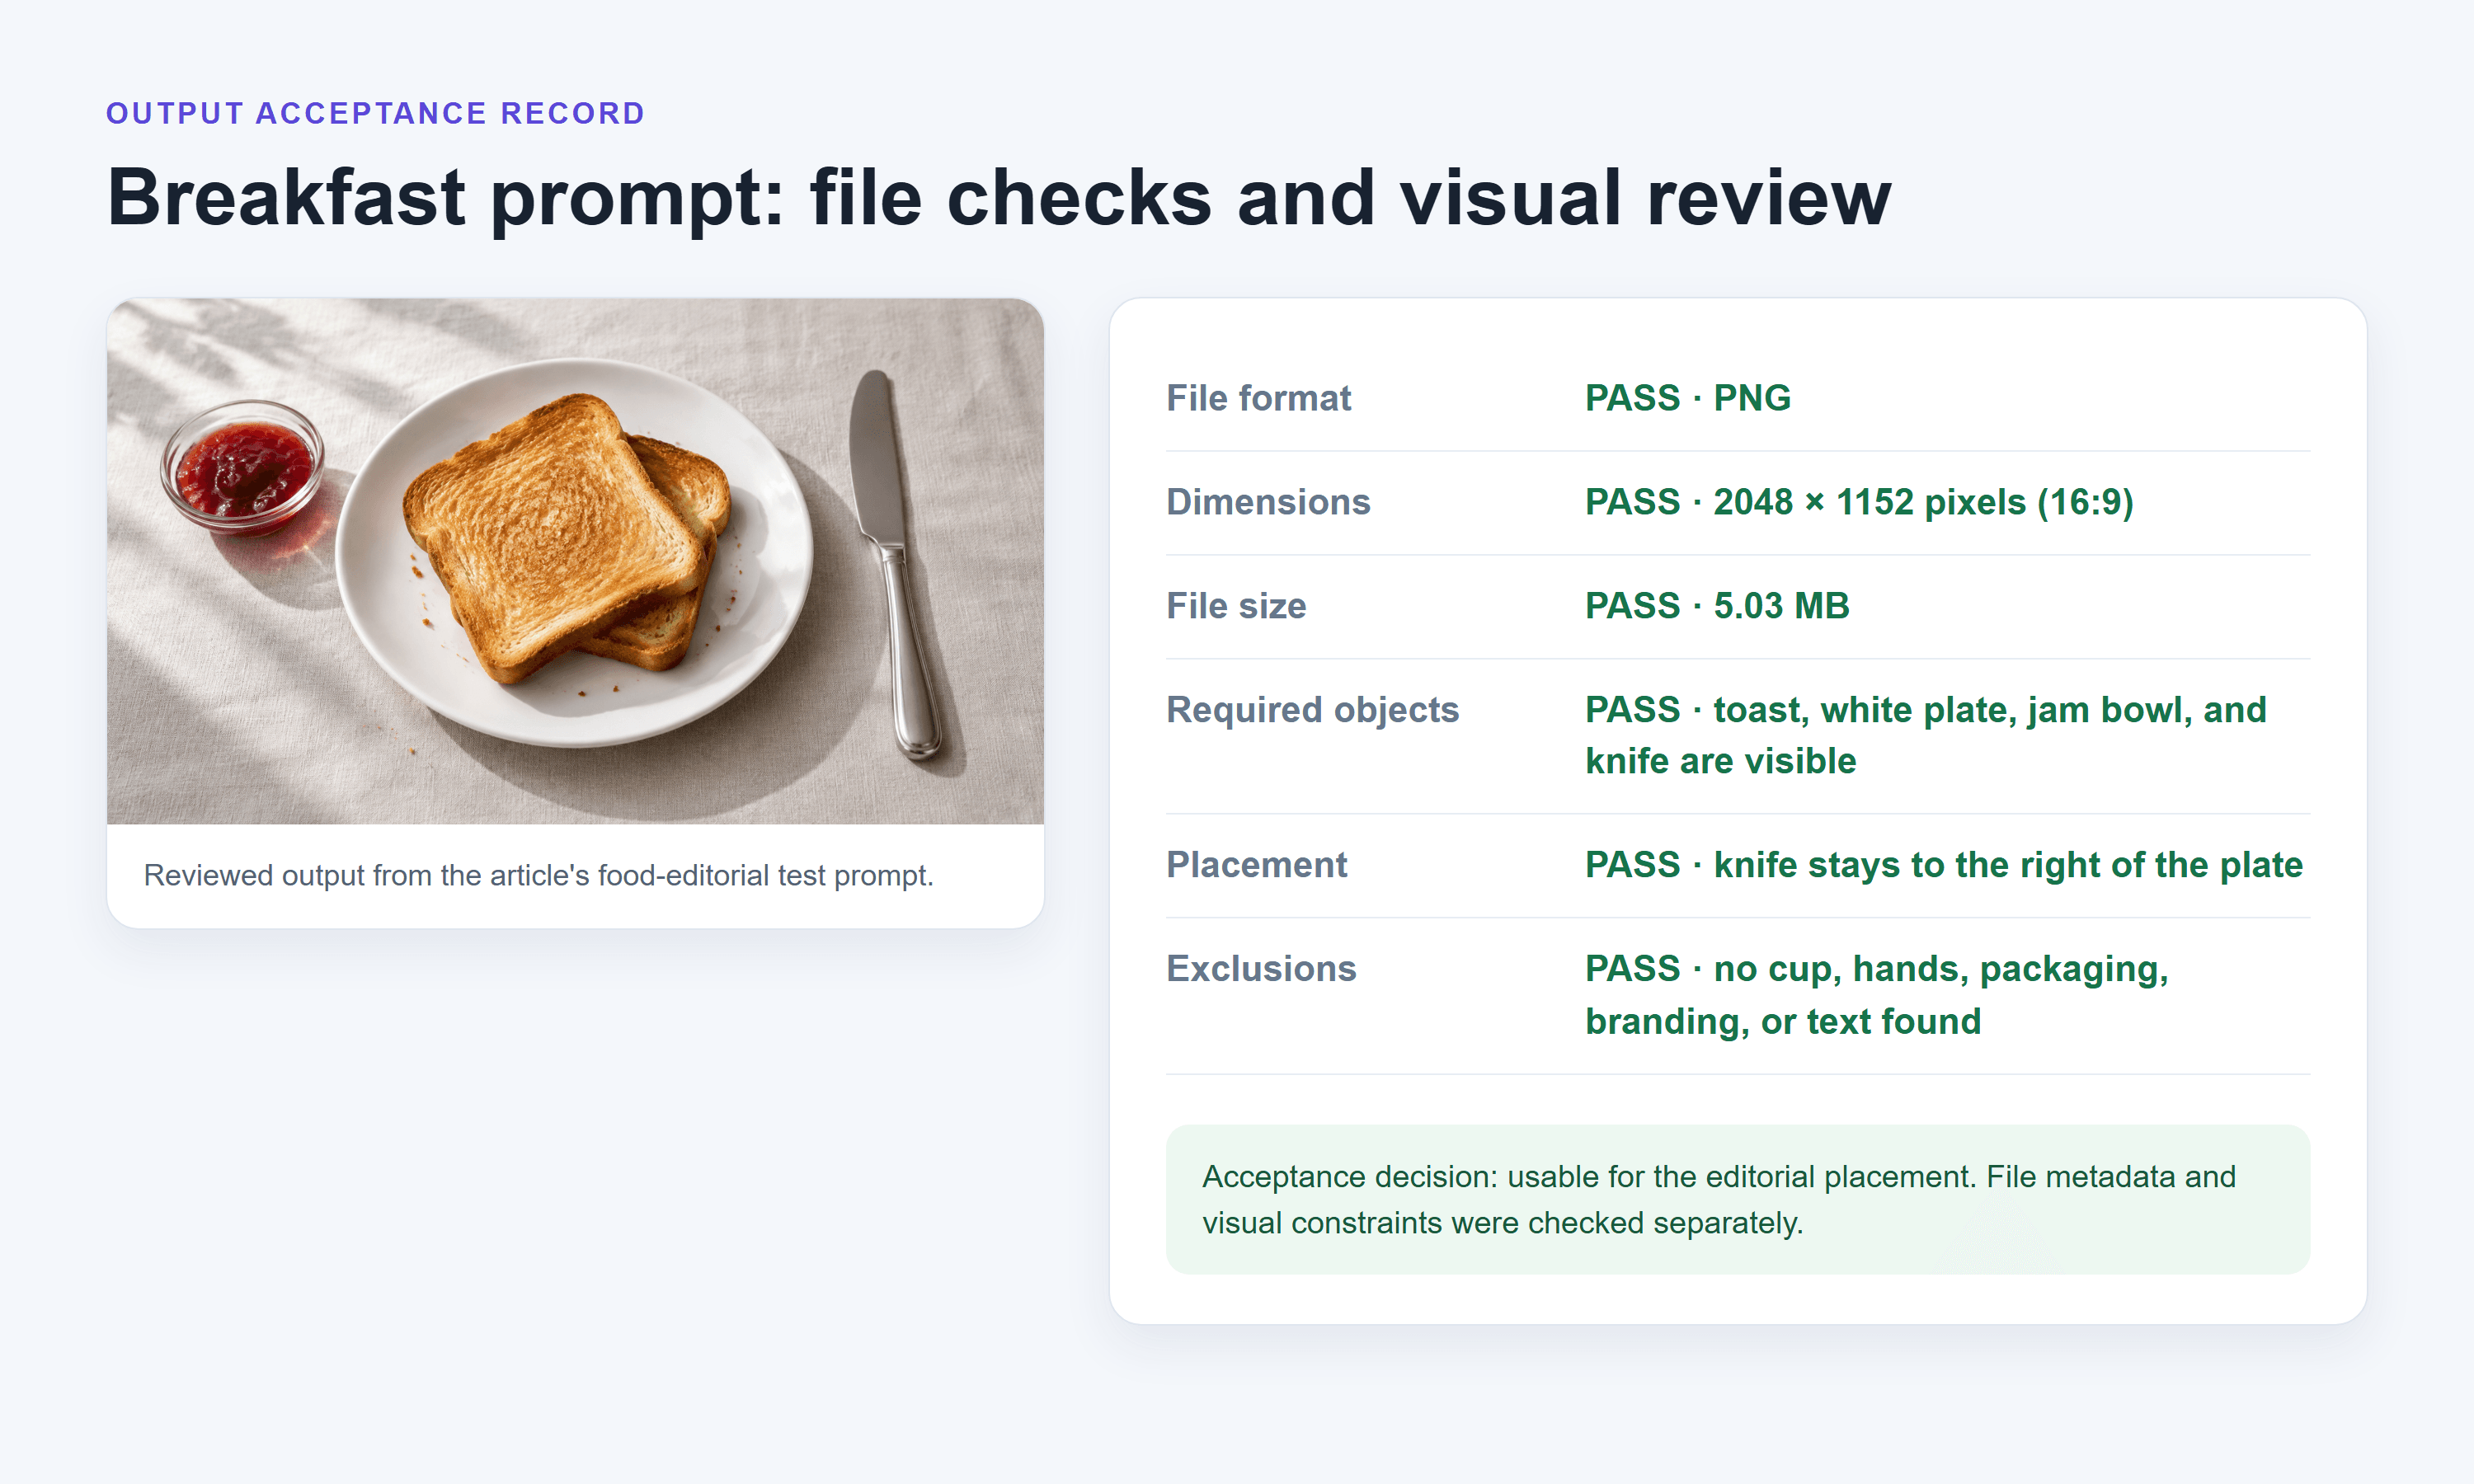 Registro de validación que separa las comprobaciones de metadatos del archivo de las comprobaciones de aceptación visual
El registro informa de las dimensiones y el tamaño reales del archivo generado por separado de sus comprobaciones de aceptación visual.
Crea un conjunto de regresión fijo a partir de la función real: solicitudes ordinarias, composiciones abarrotadas, instrucciones contradictorias, recortes difíciles y límites de entrada relevantes. Versiona los briefs y las reglas del revisor. Repítelos al cambiar el modelo, la plantilla de prompt o los ajustes de salida.
Informa por separado del éxito técnico y de la tasa de salidas aceptadas. Un archivo legible que contiene un objeto adicional cuenta como una entrega exitosa y un rechazo de contenido. Combinar esos resultados en un único número de éxito oculta la corrección que tu equipo necesita.
La encuesta a desarrolladores de 2025 encontró que el 46 % desconfiaba de la precisión de las herramientas de IA y el 33 % confiaba en ella; el 3 % declaró una confianza alta. Estas respuestas se refieren a herramientas de IA en flujos de trabajo de desarrollo, no a una tasa de fallo medida para API de generación. (Stack Overflow Developer Survey, 2025.)
Del mismo modo, 3 ejecuciones ilustrativas no pueden establecer la precisión general ni una latencia p95 útil. Recopila una muestra más amplia y relevante en las condiciones que esperas en producción, y conserva los valores atípicos. Usa las demostraciones para desarrollar las comprobaciones y luego usa una evaluación sistemática para tomar una decisión de lanzamiento.
Lista de comprobación de producción antes de lanzar
La primera solicitud que funciona solo resuelve una pequeña parte de la decisión de lanzamiento. Tu aplicación también tiene que contener el gasto, recuperar el trabajo inacabado y explicar qué ocurrió cuando no hay ningún resultado disponible.
Protege el acceso. Mantén las credenciales en el backend, separa los entornos, restringe el acceso a los registros de tareas y planifica la rotación de credenciales. Autoriza cada solicitud de estado y descarga frente al usuario propietario de esa tarea. Un ID de tarea imposible de adivinar no sustituye a las comprobaciones de permisos.
Limita las entradas y el uso de recursos. Valida la longitud del prompt, el tipo y tamaño de las subidas, los ajustes de salida solicitados y las combinaciones compatibles. Para medios descargados, aplica destinos permitidos, redirecciones, límites de bytes y límites de decodificación. Los scripts compactos anteriores ilustran el ciclo de vida; no son un servicio de descarga público reforzado.
Establece presupuestos antes del envío. Define límites por usuario y por tarea, el máximo de tareas concurrentes y quién puede solicitar ajustes más caros. Reserva presupuesto mientras el trabajo está pendiente para que las solicitudes simultáneas no puedan pasar todas la misma comprobación de saldo restante.
Persiste el estado. Escribe la tarea local antes de llamar al proveedor. Guarda inmediatamente el ID de predicción devuelto y haz que la consulta sea reanudable después de reiniciar el proceso. Si se desconoce el estado del envío, usa un estado de investigación en lugar de decir a los usuarios que la tarea falló definitivamente.
Asume la propiedad del recurso entregado. Decide dónde viven los archivos aceptados, quién puede acceder a ellos y cuándo caducan. Verifica la vida útil de los enlaces del proveedor y los términos de retención en lugar de depender indefinidamente de una URL de salida temporal. Incluye la eliminación de archivos derivados en el flujo de datos de la aplicación.
Haz que el fallo sea comprensible. Distingue entre una tarea retrasada, un resultado rechazado y un error de servicio. Ofrece una ruta clara para reintentar intencionadamente o solicitar revisión. Conserva el brief del usuario para que la recuperación no requiera reconstruir el trabajo.
Monitoriza los cambios. Registra por separado la finalización, la aceptación, el coste y el tiempo de espera. Vuelve a ejecutar el conjunto de regresión después de cambios en el modelo o los parámetros, y mantén disponible la configuración anterior cuando sea viable. Anonimiza los registros sensibles y asigna periodos de retención tanto a los registros de contenido como a los operativos.
Para evaluar la plataforma de ejemplo en tu propia aplicación, empieza con el catálogo de modelos de Atlas Cloud y luego lee la documentación del endpoint y de predicciones seleccionados. Elige una tarea, define la aceptación y registra lo que la evaluación entrega realmente antes de ampliar el acceso.
Preguntas frecuentes
¿Qué API de IA generativa debería elegir para mi aplicación?
Elige en función de las entradas, las salidas, el tiempo de espera aceptable y los requisitos de revisión de la función. Ejecuta los mismos briefs representativos con los candidatos que puedas usar legal y operativamente. Compara el coste por salida aceptada y el trabajo de integración junto con las capacidades. No hay una elección universal establecida por estos 3 ejemplos de imagen.
¿Existen API de IA generativa gratuitas para desarrolladores?
Algunos servicios ofrecen pruebas o uso gratuito limitado, pero la disponibilidad, la elegibilidad, las cuotas y los usos permitidos cambian. Verifica los términos actuales para el endpoint exacto. Una asignación gratuita de herramienta de consumo no incluye necesariamente el acceso a la API. El autoalojamiento también consume hardware, electricidad y tiempo de ingeniería, incluso cuando los pesos del modelo se pueden descargar.
¿Necesito experiencia en machine learning para usar una API de IA generativa?
Puedes empezar con HTTP, JSON, autenticación y habilidades habituales de desarrollo backend. Entregar una función fiable requiere además trabajo de evaluación y operaciones. Necesitas entender las limitaciones del modelo lo suficiente para definir una salida aceptable, sin necesidad de entrenar tú mismo un modelo.
¿Puede una sola API gestionar texto, imágenes y vídeo?
Una plataforma puede proporcionar las 3, pero cada capacidad puede usar endpoints, parámetros, tipos de salida y patrones de espera diferentes. Verifica cada interfaz por separado. Una cuenta o credencial compartida no hace que un cuerpo de solicitud de texto sea compatible con un modelo de imagen o vídeo.
¿Por qué mi solicitud de imagen devuelve un ID de tarea en lugar de una imagen?
El endpoint envía el trabajo de forma asíncrona. Guarda el ID y consulta la ruta de estado documentada. Recupera el archivo cuando la tarea se complete y luego valídalo. Si tu cliente deja de esperar, la tarea del lado del servidor puede seguir en ejecución; reanuda esa tarea antes de enviar otra.
¿Cómo puedo reducir los costes de API sin romper el flujo de trabajo?
Evita envíos duplicados, valida las entradas pronto, reutiliza los recursos aceptados cuando proceda y prueba configuraciones más baratas con criterios de aceptación sin cambios. Mide los cargos reales por resultado aceptado. Una API de IA generativa para desarrolladores se gana su lugar cuando la aplicación que la rodea puede entregar trabajo utilizable a un coste que puedas sostener.


