Una API de IA para generación por lotes es útil cuando cada resultado puede encontrarse, revisarse y reintentarse por sí solo. Eso importa más que cuántos prompts envíes a la vez. El momento costoso no es la solicitud número 1.000. Es cuando la tarea 37 agota el tiempo de espera, la tarea 38 tiene éxito, dos archivos comparten nombre y nadie puede decir qué imagen es segura para publicar.
Trata un lote como una colección de trabajos de activos recuperables. Asigna a cada trabajo un ID de negocio duradero, guarda la entrada exacta y la configuración del modelo, limita la concurrencia y reintenta solo el elemento que realmente falló. Esta guía usa un flujo de trabajo de campaña de personaje con 8 activos para que un desarrollador o un equipo de crecimiento pueda convertir un manifiesto en una ejecución de producción controlada.
Puntos clave
- Un trabajo por lotes y las solicitudes en paralelo resuelven problemas distintos de latencia y control.
- Los ID de activos estables y las claves de idempotencia hacen manejable el fallo parcial.
- Comienza con 4 a 8 activos visuales, revísalos y luego amplía.
- Una respuesta exitosa de la API todavía necesita revisión visual y de derechos antes de publicarse.
API de IA para generación por lotes: la respuesta primero
Una API de IA para generación por lotes envía un conjunto de tareas de generación distintas a una cola asíncrona y luego devuelve sus resultados mediante verificaciones de estado, una devolución de llamada de finalización o un archivo de salida descargable. Cada tarea necesita una identidad que exista fuera del proveedor del modelo. El ID de trabajo del proveedor ayuda a las operaciones, pero maya-ridgeline-001 es lo que permite que tu sistema editorial o de campaña identifique el activo meses después.
No fusiones tres ideas relacionadas. Un solo prompt puede solicitar varias variaciones. Tu propio worker puede enviar varias solicitudes normales al mismo tiempo. Un trabajo por lotes del lado del servidor es una colección gestionada por el proveedor que se completa más tarde. Esto último suele encajar en el trabajo offline, mientras que las solicitudes paralelas controladas encajan en un panel que necesita progreso inmediato.
La documentación actual de la Batch API de OpenAI ilustra el patrón asíncrono: las solicitudes se recopilan en JSONL, se envían como un trabajo, se verifica su finalización y se recuperan como resultados. Su ventana de 24 horas, sus límites de tarifa de lote independientes y sus límites son específicos de ese servicio, no una promesa que todo proveedor de imágenes haga (documentación de OpenAI Batch API, septiembre de 2026). La referencia actual de Gemini documenta igualmente trabajos por lotes de larga duración, verificaciones de estado y soporte de webhooks para su servicio (referencia de Gemini Batch API, septiembre de 2026).
| Punto de decisión | API por lotes | Solicitudes paralelas controladas |
|---|---|---|
| Respuesta esperada | Finalización diferida | Cada solicitud devuelve resultados al terminar |
| Ideal para | Catálogo offline, storyboard y trabajo de biblioteca de contenido | Herramientas interactivas y bucles cortos de revisión |
| Manejo de fallos | Leer los resultados por elemento tras finalizar el trabajo | Manejar cada solicitud secundaria a medida que termina |
| Coste y límites | Las reglas de lote específicas del proveedor pueden diferir del tráfico en vivo | Usa los límites de solicitudes habituales de la cuenta |
| Registro esencial | ID de activo, ID de solicitud, estado del resultado, ubicación de salida | Los mismos campos, más el estado del intento en curso |
Elige solicitudes paralelas controladas cuando un revisor necesita ver la primera imagen utilizable rápidamente. Elige un trabajo por lotes del lado del servidor cuando el trabajo pueda esperar y el proveedor documente una vía de lote. En cualquier caso, guarda asset_id, la entrada normalizada, el hash de referencia, el modelo, el número de intentos y la URL de salida. Esa capa común mantiene el flujo de trabajo portable si cambia el mecanismo de entrega.
Por qué los proyectos de imágenes por lotes fallan a escala
Los lotes en producción suelen fallar por partes. Una solicitud puede completarse, agotar el tiempo de espera, rechazarse o devolver una salida que es técnicamente válida pero visualmente inutilizable. Una aplicación que solo registra una URL final ha descartado la información necesaria para recuperarse de todos los casos salvo el éxito más simple.
El primer fallo es la identidad faltante. Si la solicitud solo lleva una cadena de prompt, una salida no puede mapearse de forma fiable a un producto, una configuración regional de campaña o una fila de origen. Los nombres de archivo derivados del prompt son frágiles porque las revisiones de prompts y los productos repetidos colisionan. Usa un ID de activo estable del registro de negocio, luego da a cada intento de generación su propio sufijo.
El segundo fallo es reintentar sin idempotencia. Un tiempo de espera de red no demuestra que el proveedor no haya realizado trabajo. Si un worker reenvía inmediatamente el mismo activo con una nueva identidad de solicitud, puede crear salidas duplicadas y cargos duplicados. Una clave de idempotencia permite al llamador decir, en efecto, "este sigue siendo el mismo activo solicitado". Que un endpoint específico soporte ese mecanismo depende del proveedor, así que confírmalo en la documentación de la API antes de confiar en él.
El tercer fallo es una cola ciega de 40 o 60 prompts. Una deriva de color, composición o identidad de producto puede hacerse visible solo después de que termine la ejecución. Un debate reciente de creadores describe revisar páginas de storyboard de aproximadamente 7 a 8 imágenes antes de enviar la siguiente página, específicamente para detectar errores de precisión y consistencia (debate sobre generación de imágenes por lotes, junio de 2026). Esa es experiencia de la comunidad, no un punto de referencia, pero es un punto de control operativo sensato.
Usa una regla de control de calidad de lotes pequeños: ejecuta 4 a 8 activos, inspecciónalos, repara el prompt o la referencia si es necesario y luego desbloquea el siguiente grupo. Guarda el prompt original, la versión del prompt, la referencia de entrada, la revisión del modelo cuando esté disponible, la configuración de calidad, la relación de aspecto, las marcas de tiempo, la clase de error y la decisión de revisión. Una URL por sí sola no puede responder por qué existe un activo o si debería reutilizarse.
Diseña una API de IA fiable para generación por lotes
La implementación puede ser pequeña. Un manifiesto, un worker de cola, un registro de trabajos de solo anexar y una carpeta de salida cómoda para el revisor bastan para empezar. El objetivo no es un gran sistema de orquestación. Es un flujo de trabajo donde una persona pueda responder: ¿qué se solicitó, qué ocurrió y qué debería ejecutarse después?
Da a cada salida por lotes una identidad de activo duradera
Haz que asset_id sea una clave de negocio, no un ID de trabajo del proveedor. Un registro de tarea útil puede incluir los campos siguientes. Guárdalo en una base de datos cuando operen varios workers, o en un CSV versionado más un registro JSONL para un equipo más pequeño.
| Campo | Por qué existe |
|---|---|
asset_id | Identidad inmutable del activo publicable |
source_row | Mapea de vuelta al producto, campaña o registro de contenido |
prompt_version | Muestra qué plantilla de instrucción produjo el resultado |
reference_hash | Confirma qué imagen de origen bloqueada se usó |
model, aspect_ratio, quality | Hace la ejecución lo bastante reproducible para diagnosticar |
attempt, idempotency_key, status | Separa un reintento de trabajo secundario de una nueva solicitud |
output_url, review_status, failure_reason | Conecta la entrega y la aceptación humana |
Por ejemplo, maya-train-001 sigue siendo la identidad del activo. maya-train-001-a2 es el intento 2. La clave de idempotencia puede ser maya-train-001-v1, donde v1 identifica la especificación solicitada inmutable. Si el brief cambia de forma sustancial, crea una nueva versión de prompt en lugar de sobrescribir el registro anterior.
Usa una cola por lotes, no un bucle ilimitado
Establece un techo de concurrencia, un límite de número de activos, una barrera monetaria y un límite de reintentos antes del despacho. Una configuración inicial práctica es de 4 trabajos en curso, como máximo 2 intentos de generación por trabajo y no más de 8 tareas visuales antes del siguiente control de calidad. Son valores iniciales, no garantías de la plataforma. Establécelos por debajo de los límites documentados de tu cuenta y ajústalos tras observar tiempos de finalización y tasas de error reales.
El worker debe reclamar una tarea pendiente, marcarla como submitted, guardar el ID de solicitud del proveedor y actualizar ese mismo registro cuando llegue un resultado. Cuando se alcance un límite de presupuesto, deja de reclamar trabajo. Cuando la cola se pause para revisión, permite que el trabajo ya enviado se resuelva, pero no liberes otro grupo automáticamente.
Reintenta solo el trabajo secundario fallido
Reintenta los estados failed, timed_out o los estados reintentables específicos del proveedor, un activo a la vez. Usa retroceso exponencial limitado con jitter para respuestas 429, respuestas 5xx transitorias y tiempos de espera de transporte genuinos. Guarda la clasificación del error y la hora de reintento programada. No repitas automáticamente un rechazo por política de contenido, una entrada malformada, una referencia faltante ni un rechazo visual de un revisor humano.
Nunca reenvíes un lote completo porque un trabajo secundario falló. Archiva los resultados exitosos inmediatamente y conserva el mapeo de origen a salida. Si un trabajo por lotes caduca con resultados parciales, incorpora los trabajos secundarios completados, identifica los ID de activos sin terminar y crea un nuevo trabajo que contenga solo esos registros restantes. Esta es la diferencia entre recuperación y duplicación.
Un flujo de trabajo copiable de 8 activos por lotes
El siguiente ejemplo es deliberadamente ficticio: Maya, una fotógrafa de viajes adulta en una asignación en las tierras altas. Hace concretos los mecanismos operativos sin insinuar que una persona real respaldara la campaña. Sustituye los campos por tus propios datos permitidos de personaje, liberación de talento o campaña, y conserva la estructura.
Paso 0: crea el manifiesto antes de generar
Crea batch-manifest.csv antes de abrir un playground o llamar a un endpoint. Da al operador un objetivo de aceptación claro para cada activo.
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | referencia de personaje canónica | 16:9 | pending |
| maya-ridgeline-001 | a | imagen de campaña en la cresta al amanecer | 16:9 | pending |
| maya-market-001 | a | imagen editorial de mercado de montaña | 16:9 | pending |
| maya-cabin-001 | a | imagen editorial de planificación en cabaña | 16:9 | pending |
| maya-lake-001 | a | imagen de notas de campo junto al lago | 16:9 | pending |
| maya-forest-001 | b | imagen de campaña en sendero forestal | 16:9 | pending |
| maya-train-001 | b | imagen editorial de viaje en tren | 16:9 | pending |
| maya-workbench-001 | b | imagen de preparación del equipo de campo | 16:9 | pending |
| maya-portrait-001 | b | imagen de campaña de retrato cercano | 16:9 | pending |
Genera una clave de idempotencia determinista para cada solicitud inmutable, como maya-ridgeline-001-v1. La forma siguiente es neutral respecto al proveedor a propósito. Coloca el endpoint del proveedor y sus parámetros documentados dentro de request; no copies un endpoint privado ficticio en producción.
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
Paso 1: crea una referencia de personaje canónica
Genera la imagen maestra por separado. Es el ancla de identidad para cada escena posterior, así que merece una revisión breve antes de que comience cualquier lote. En el playground de GPT Image 2, selecciona calidad High y 16:9, luego usa este prompt:
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
Conserva una imagen que muestre claramente el rostro, el cabello, la chaqueta, la correa de la cámara y un par completo de manos de Maya, sin texto ni persona duplicada. Guárdala como maya-master-001.png, calcula un hash de referencia y adjunta esa misma fuente a los trabajos secundarios posteriores. No hagas lote en este paso. Una referencia maestra débil multiplica la ambigüedad en cada escena.
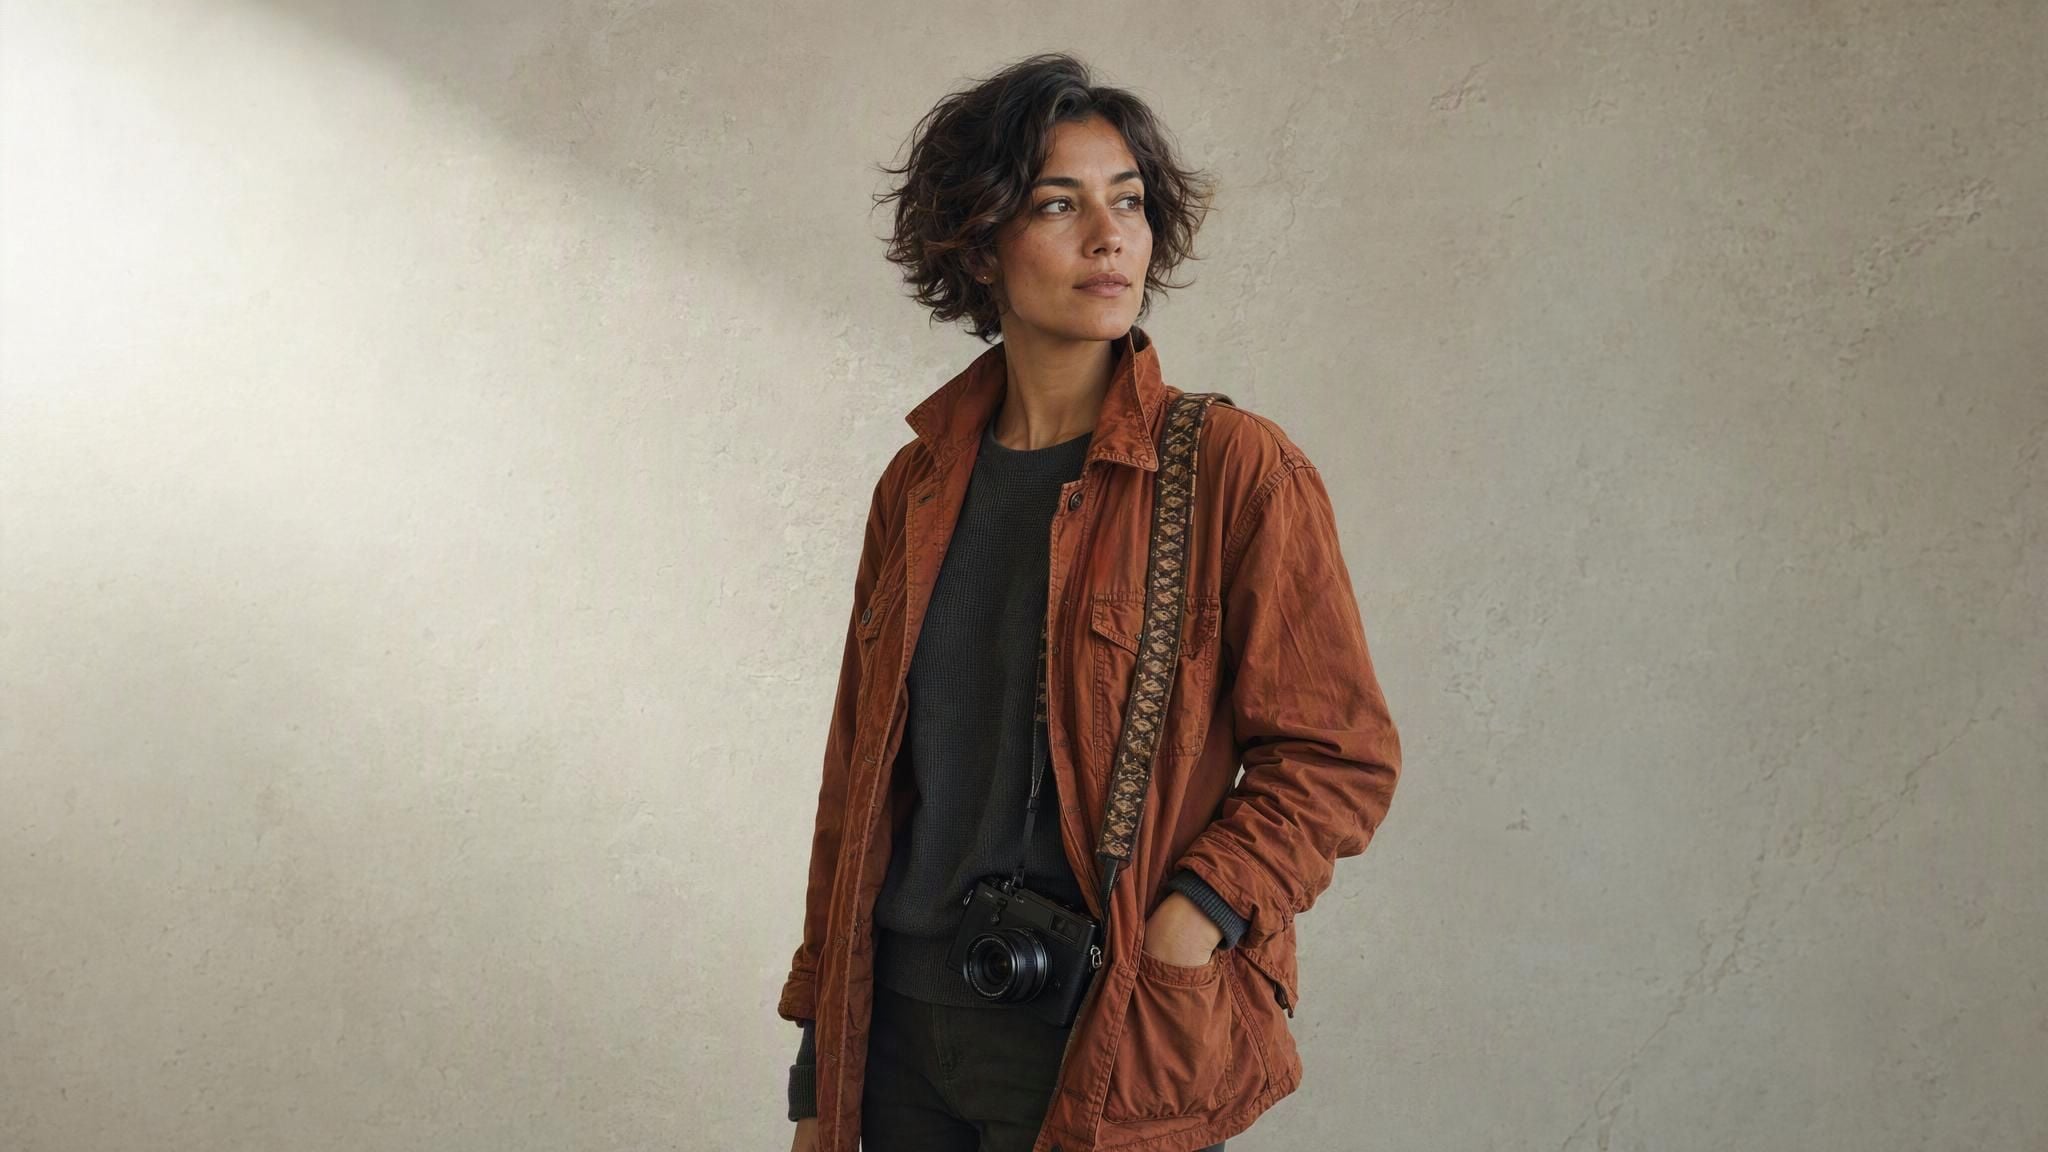
Demostración de la función API de IA para generación por lotes: el prompt de referencia de personaje de Maya junto al retrato generado de la fotógrafa de viajes
Una ejecución real de referencia maestra de GPT Image 2: el prompt establece la fotógrafa ficticia cuya identidad deben preservar los trabajos de escena posteriores.
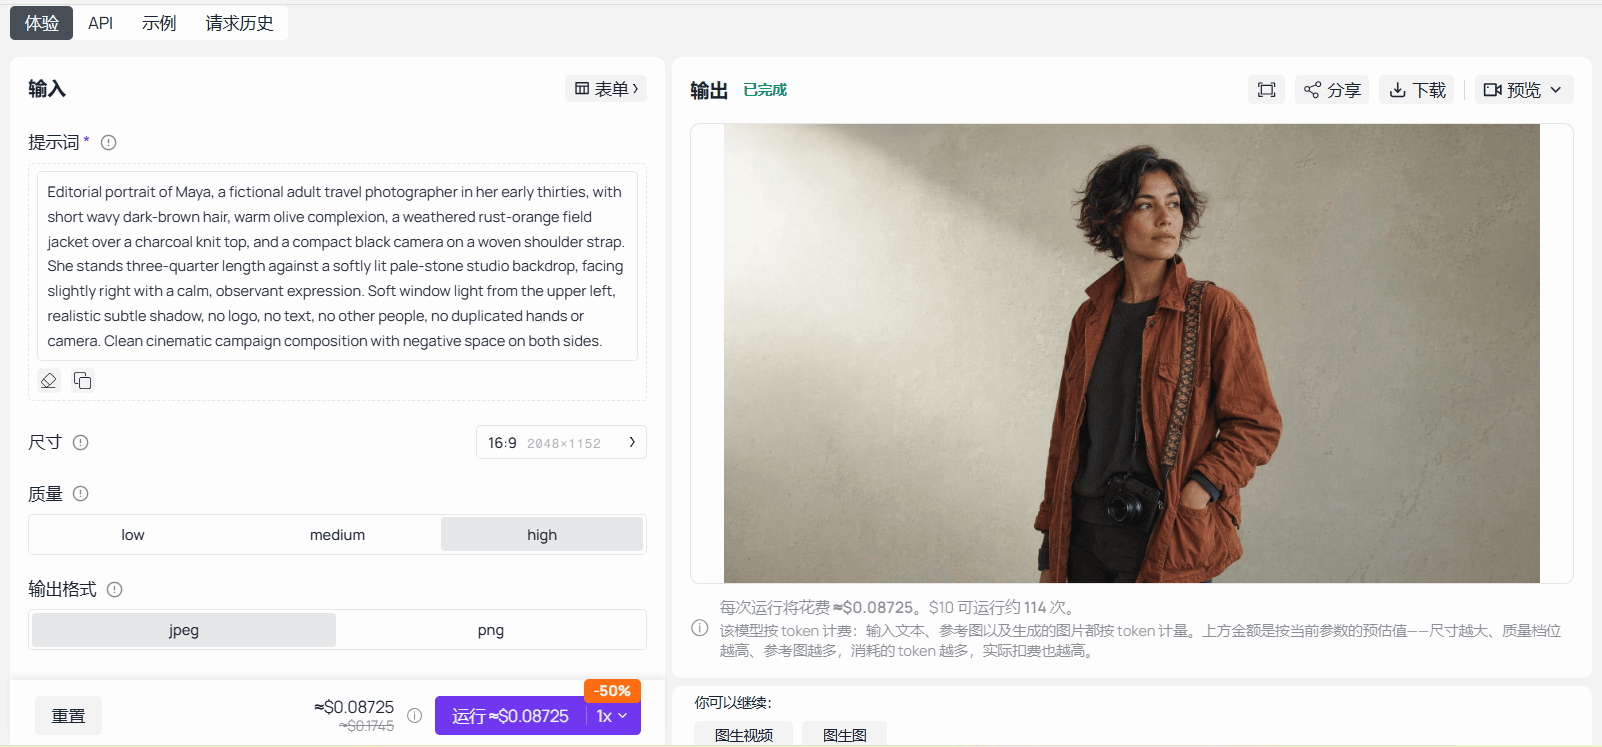
Playground de GPT Image 2 completado con calidad High, ajuste 16:9 y el retrato maestro de Maya
GPT Image 2 en Atlas Cloud con el prompt de referencia de personaje del artículo y su resultado completado en el panel de salida.
Paso 2: ejecuta el lote A como 4 escenas de personaje vinculadas
Sube maya-master-001.png a Seedream v4.7 Sequential. Mantén la referencia, la plantilla de prompt y la relación 16:9 constantes. Usa este prompt:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
Usa el modo secuencial o de lote coherente que la página en vivo realmente exponga. Acepta solo salidas que puedan mapearse sin ambigüedad a maya-ridgeline-001 hasta maya-lake-001. Si el playground devuelve una salida por solicitud en lugar de 4 activos secundarios separados, envía la misma plantilla bloqueada como 4 trabajos secundarios. Conserva el mismo hash de referencia y parámetros en lugar de fingir que la interfaz devolvió una función que no tenía.
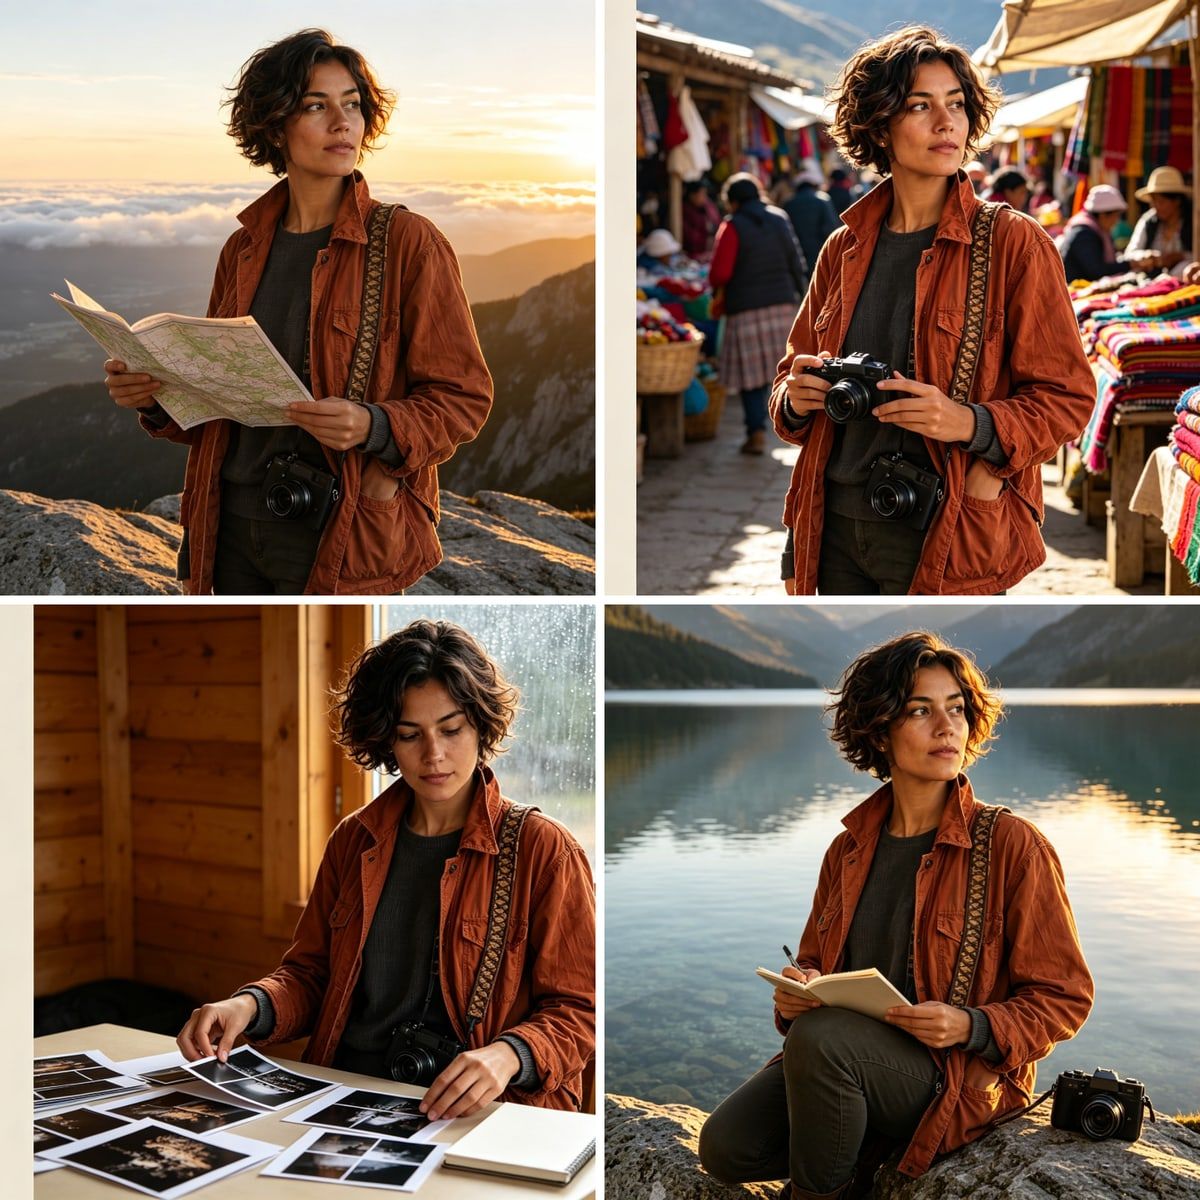
Cuatro salidas reales de escena de Maya con Seedream v4.7 Sequential en una cuadrícula, mapeadas a los ID de activos de cresta, mercado, cabaña y lago
La cuadrícula de salida del lote A de 4 escenas: cada fotograma sigue siendo un registro de activo separado incluso cuando el modelo produce una secuencia coherente.
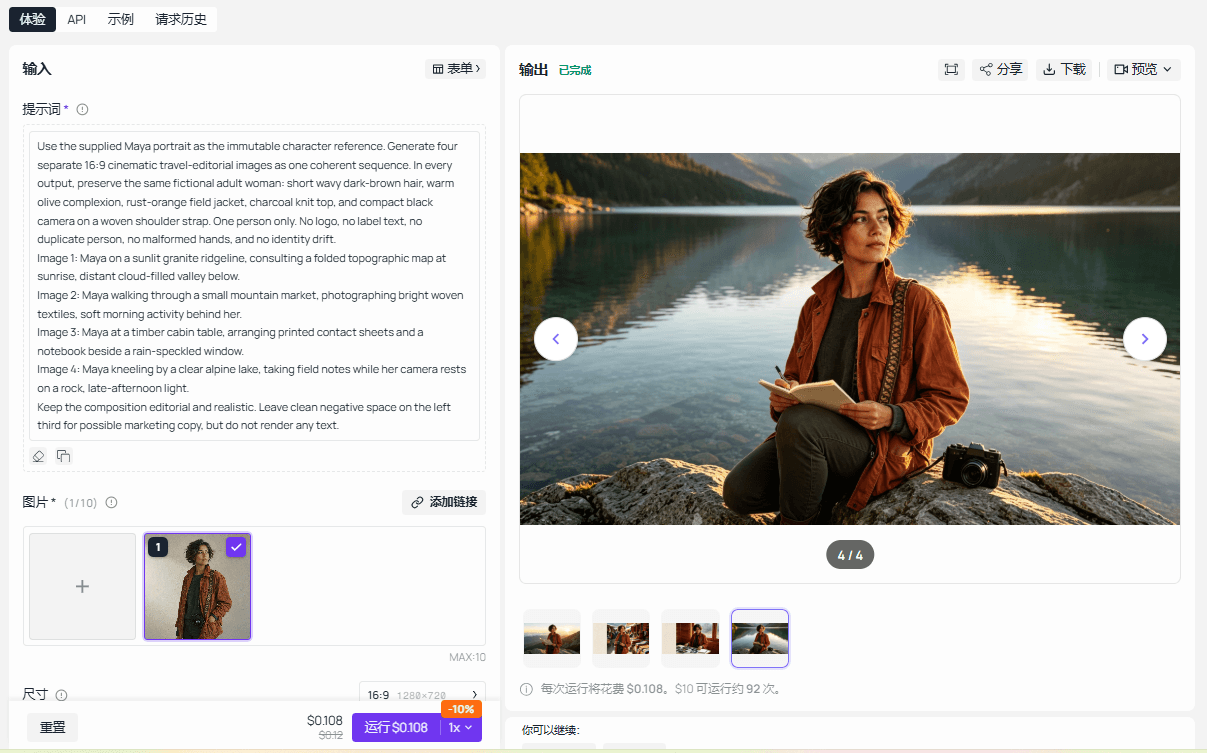
Playground de Seedream v4.7 Sequential completado con el prompt de escena de Maya vinculado y su salida real
Seedream v4.7 Sequential en Atlas Cloud con el prompt de escena de personaje vinculado del artículo y un resultado completado.
Paso 3: ejecuta el lote B y luego detente para el control de calidad
Reutiliza la referencia maestra aprobada. No la vuelvas a crear ni reescribas las reglas de identidad. Envía las siguientes 4 escenas con una nueva etiqueta de lote y las mismas verificaciones de aceptación:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
Después del lote B, detente. Revisa los 8 registros de escena antes de liberar otra secuencia de campaña. Esta pausa detecta los tipos de deriva que las colas ocultan: cambios de cabello o vestuario, aparición de una segunda persona, rotulación no solicitada, manos malformadas o una escena que ya no sirve a su canal. Guarda la decisión del revisor junto al activo en lugar de en un mensaje de chat no rastreado.
Paso 4: aplica una decisión de publicar, reintentar o rechazar
Marca una imagen como approved cuando contenga una sola Maya, coincida con la referencia maestra en rostro, cabello, vestuario y cámara, no contenga texto roto ni anatomía malformada, y encaje con su escena asignada. Márcala como retry cuando Maya se duplique, derive, pierda un accesorio necesario o muestre manos o rotulación malformadas. Márcala como rejected cuando la composición no pueda servir al canal previsto o el personaje ya no sea reconocible.
Para un reintento, conserva maya-train-001 como el activo de negocio y crea el intento maya-train-001-a2. Envía solo ese trabajo secundario con la especificación de clave de idempotencia original ajustada solo si el prompt se está versionando deliberadamente. No vuelvas a ejecutar los otros 7 activos solo porque una escena necesita reparación.
Elegir modelos para generación por lotes
Elige un modelo en función de la unidad de trabajo, no de una tabla de clasificación. Una referencia maestra limpia y una secuencia de escenas coherente son trabajos distintos. La edición de una imagen fallida es aún otra cosa. Si un equipo quiere probar esas etapas mediante una integración compatible con OpenAI, Atlas Cloud ofrece un lugar natural para validar las dos páginas de modelos usadas en este ejemplo.
| Trabajo | Modelo y método de trabajo | Contexto de precio a verificar antes de encolar |
|---|---|---|
| Crear un maestro de personaje limpio | GPT Image 2, una ejecución High de 16:9 que se convierte en el ancla de referencia | GPT Image 2 Developer text-to-image se lista desde aproximadamente $0.004 por imagen frente a $0.009 estándar, un 50% de descuento mostrado a septiembre de 2026 |
| Construir un conjunto de escenas coherente | Seedream v4.7 Sequential, misma referencia y esquema de prompt bloqueado en los trabajos secundarios | El catálogo actual lista $0.03 por imagen; verifica el modo de salida en vivo y el precio antes de producción |
| Reparar un activo fallido | Modo edición de GPT Image 2, limitado al activo que falló la revisión | Confirma el endpoint de edición, el tamaño de salida, la calidad y el precio actual antes de comprometerte |
Los precios cambian según el modelo, el modo y los ajustes seleccionados. Usa el catálogo de modelos de Atlas Cloud para volver a verificar la disponibilidad, los descuentos y el modo exacto el día en que encoles trabajo. Trata la tabla como un insumo de estimación, nunca como una afirmación promocional o una garantía de coste.
Control de calidad, coste y derechos antes de escalar
La finalización de la generación tiene 3 significados distintos: el proveedor informa éxito, el archivo se archivó correctamente y un revisor humano lo acepta para publicación. Haz visibles los 3 en tus registros. Una tarea completada con un archivo de salida faltante es un fallo operativo. Un archivo guardado con un personaje duplicado es un fallo creativo. Ninguno debería avanzar automáticamente a publicación.
Usa una lista de verificación del revisor lo bastante simple para aplicarla a cada activo secundario:
| Verificación | Pregunta del revisor |
|---|---|
| Identidad del personaje | ¿Coincide Maya con la referencia maestra aprobada en rostro, cabello, vestuario y cámara? |
| Recuento de objetos | ¿Hay exactamente el número esperado de objetos clave? |
| Coincidencia con el prompt | ¿La escena entrega el caso de uso asignado? |
| Artefactos de texto | ¿Hay texto no deseado, malformado o no soportado? |
| Relación y nombre de archivo | ¿Coincide el archivo guardado con el registro del manifiesto? |
| Revisión de derechos | ¿Están permitidos la referencia y las afirmaciones previstas para este uso? |
Estima el coste después de la ejecución con coste del activo aprobado = coste total de los intentos completados / activos aprobados. Esto expone el coste de los reintentos y los resultados rechazados sin fingir que cada imagen tiene el mismo coste final. Establece un límite de tareas, un límite de lote y un límite diario antes de empezar. Pausa el despacho si se alcanza cualquiera de esos techos.
Usa solo imágenes de referencia propias, con licencia o de otro modo permitidas. Comprueba las políticas actuales de la plataforma y los términos del modelo antes del uso comercial. No pidas al modelo que invente certificaciones, resultados de laboratorio, promesas de seguridad, afirmaciones médicas ni especificaciones de producto no verificadas. Una salida pulida no convierte una afirmación no respaldada en publicable.
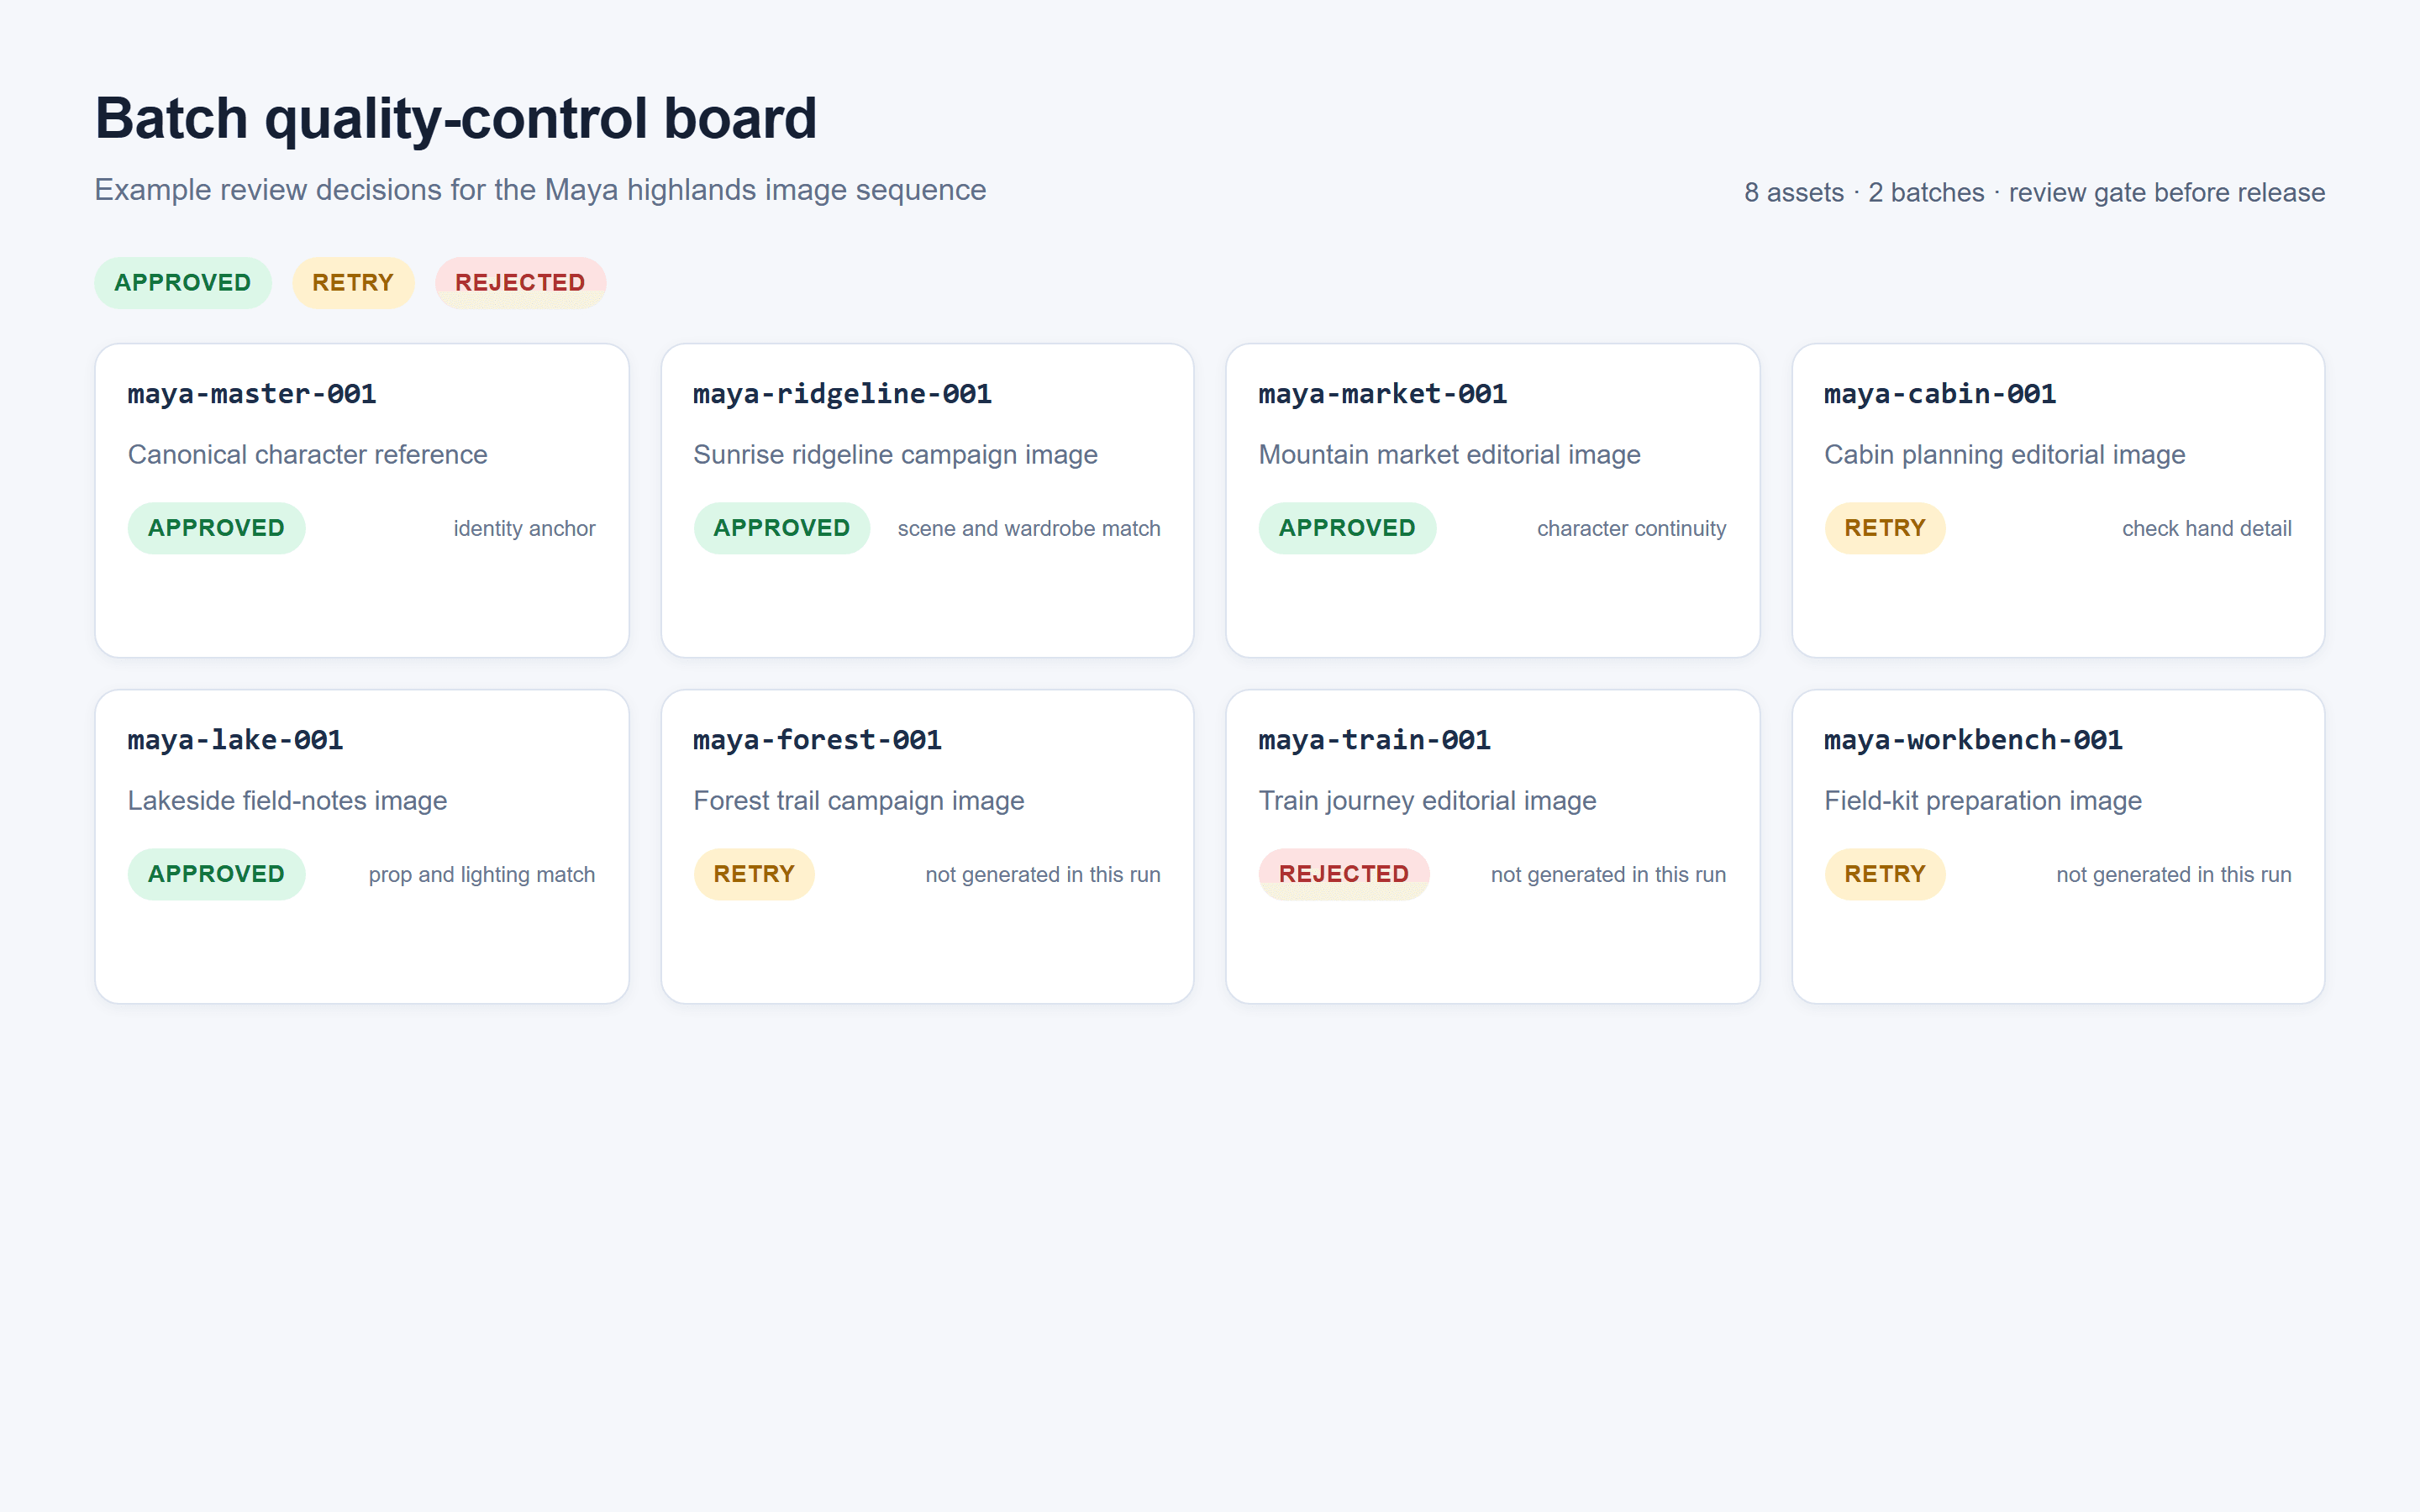
Panel de control de calidad por lotes renderizado en el navegador que muestra 8 ID de activos de Maya con estados de revisión de aprobado, reintentar y rechazado
Un panel de revisión renderizado en el navegador mapea los archivos de la ejecución real a sus 8 ID de activos y hace visible la decisión de publicar, reintentar o rechazar.
API de IA para generación por lotes: lista de verificación de lanzamiento en producción
Antes de pasar del ejercicio de 8 activos a un catálogo o biblioteca de contenido en vivo, confirma cada elemento a continuación.
- Cada activo tiene un
asset_idinmutable. - Se registran el prompt, el hash de referencia, el modelo, la relación y la calidad.
- Cada envío tiene una clave de idempotencia donde el proveedor la soporte.
- La concurrencia se mantiene por debajo del límite documentado real de la cuenta.
- Existen límites de presupuesto de tareas, de lote y diarios.
- Las respuestas 429, las respuestas 5xx, los tiempos de espera y los rechazos de contenido siguen reglas distintas.
- Los reintentos tienen un máximo estricto.
- Los resultados exitosos se archivan y se mapean de vuelta a los datos de origen inmediatamente.
- Pasa una compuerta de control de calidad de lotes pequeños antes de liberar el siguiente grupo.
- Una revisión final de muestra verifica la identidad del personaje, el texto, la relación, los nombres de archivo y los derechos.
Esta lista de verificación mantiene útil una API de IA para generación por lotes cuando crece el volumen. También deja un rastro de auditoría claro cuando un editor pregunta por qué se generó, aceptó o volvió a ejecutar una imagen concreta.
Preguntas frecuentes: API de IA para generación por lotes
¿Qué es una API de IA para generación por lotes?
Es una forma de enviar muchas tareas de IA independientes, rastrear su ejecución y recopilar resultados más tarde. Una buena implementación mantiene un ID de activo de negocio duradero para cada tarea, independientemente de si el proveedor usa un trabajo por lotes asíncrono o solicitudes concurrentes normales.
¿Es mejor una API por lotes que enviar solicitudes de imágenes en paralelo?
Ninguna es automáticamente mejor. Usa solicitudes paralelas controladas cuando el flujo de trabajo necesite progreso inmediato. Usa un trabajo por lotes del proveedor para volumen no urgente cuando sus reglas documentadas de cola, tiempo de respuesta y coste encajen con tu trabajo. Ambos necesitan registros por activo y revisión.
¿Cuántas imágenes de IA debería poner en un lote?
Comienza con 4 a 8 activos visuales cuando estés validando un nuevo esquema de prompt o una referencia de personaje. Amplía solo después de que el equipo pueda mapear cada resultado, detectar la deriva rápidamente y recuperar un trabajo secundario fallido sin reiniciar el grupo. Los límites del proveedor pueden permitir mucho más, pero un lote operativamente útil es uno revisable.
¿Cómo evitan las claves de idempotencia los costes de generación duplicados?
Identifican un envío como la misma operación prevista tras un reintento. Si el endpoint soporta idempotencia, el proveedor puede evitar tratar una llamada de red repetida como una generación totalmente nueva. Guarda la clave con el registro del activo y confirma la semántica exacta en la documentación del proveedor.
¿Puedo generar imágenes por lotes a partir de la misma referencia de personaje?
Sí. Usa una imagen de referencia aprobada y permitida; adjunta su hash a cada trabajo secundario; bloquea las instrucciones de identidad; y revisa un grupo pequeño de escenas antes de ampliar. La consistencia de referencia reduce la ambigüedad, pero no sustituye el control de calidad visual.
¿Debería reintentar un lote fallido completo o solo los activos fallidos?
Reintenta solo los activos fallidos. Archiva primero los éxitos, clasifica el fallo y crea un nuevo registro de intento para el trabajo secundario afectado. Reenviar el lote completo hace más probables los activos duplicados y el gasto innecesario.


