Un informe de pruebas de API en verde parece tranquilizador hasta que notas que cada aserción solo verifica HTTP 200. La respuesta podría contener el registro de un cliente equivocado y aun así pasar.
Elige herramientas de IA para pruebas de API en función del trabajo que ya tienes. Evalúa Postman Agent Mode si tu equipo mantiene colecciones, KushoAI si una especificación es tu punto de partida, y Keploy si necesitas flujos generados o pruebas de regresión creadas a partir de tráfico grabado. Revisa y ejecuta las pruebas resultantes antes de confiar en ellas.
Esta guía cubre la asistencia de IA para probar API comunes. Probar la exactitud de las respuestas de un modelo de IA es un problema de evaluación aparte.
Conclusiones clave
- Proporciona el contrato, las dependencias de las solicitudes y las expectativas de negocio aprobadas.
- Verifica si las aserciones rechazan datos incorrectos, campos faltantes y tipos rotos.
- Compra solo después de que las pruebas revisadas se ejecuten repetidamente en tu entorno de CI previsto.
La comparación de productos a continuación refleja la documentación oficial consultada el 21 de septiembre de 2026. No es un benchmark cara a cara de tres cuentas de pago.
El ejemplo práctico usa una especificación fijada de Swagger Petstore y separa expectativas de contrato, comportamiento observado y copias de respuesta modificadas deliberadamente.
Nuestra ejecución local pasó 5 pruebas en vivo y rechazó las 3 copias de respuesta cambiadas deliberadamente. Una sonda separada de nombre faltante aún devolvió 200, lo que muestra por qué importa el alcance de un informe en verde.
Qué hacen realmente las herramientas de IA para pruebas de API
La asistencia de IA suele entrar en cuatro partes de las pruebas de API. Un modelo lee tu especificación, propone escenarios, redacta aserciones y ayuda a explicar fallos. Cada parte requiere evidencia diferente. Una explicación plausible de un fallo no establece que la corrección propuesta sea correcta.
Para la revisión de especificaciones, proporciona el archivo OpenAPI y las reglas de negocio relevantes. Para la planificación de escenarios, agrega ejemplos de datos válidos y límites conocidos. Para scripts ejecutables, incluye tu runner, la configuración de autenticación y las convenciones de fixtures. Para el diagnóstico, proporciona la solicitud real, la respuesta y el mensaje de fallo después de eliminar secretos.
Mantén separados estos cuatro mecanismos al evaluar productos:
- Generación por LLM: propone pruebas a partir de lenguaje, esquemas y ejemplos. Un revisor debe verificar los resultados esperados.
- Reproducción de tráfico: compara el comportamiento posterior con interacciones capturadas, a menudo usando respuestas de dependencias grabadas.
- Pruebas basadas en propiedades: construye entradas sistemáticamente para desafiar propiedades como la conformidad con el esquema.
- Ejecución de pruebas: envía solicitudes, evalúa aserciones y devuelve informes y códigos de salida.
Un producto puede combinar varios mecanismos. Pregunta qué mecanismo produjo cada prueba y qué determina su resultado esperado. Grabar una respuesta incorrecta puede conservar el mismo error como línea base de regresión. Generar un nombre de prueba pulido puede disfrazar una expectativa no respaldada.
Piensa en las aserciones en tres profundidades. Primero, ¿el servidor respondió correctamente? Segundo, ¿el cuerpo tiene los campos y tipos documentados? Tercero, ¿este cuerpo representa el recurso y la operación que solicitaste?
Para una búsqueda de mascota, un objeto válido con un ID entero aún falla la tercera verificación si ese ID pertenece a otra mascota. A la inversa, que coincida con el ID solicitado no prueba que cada campo cumpla el esquema. Usa ambas verificaciones y agrega reglas de negocio solo donde el equipo tenga una fuente acordada para ellas.
El resultado práctico que quieres es un activo de prueba mantenible con un oráculo explicable: una razón clara de por qué cada resultado debería pasar o fallar. Cuenta escenarios útiles después de la revisión, incluidos los que rechazas, en lugar de celebrar la longitud de la lista generada inicial.
Comparación de herramientas de IA para pruebas de API por flujo de trabajo
Empieza con el artefacto que tu equipo puede proporcionar hoy. Migrar una colección establecida, reconstruir reglas de negocio faltantes y configurar la grabación de dependencias son proyectos diferentes. Una herramienta que sirve para un punto de partida puede crear trabajo adicional en otro.
| Herramienta o enfoque | Entrada útil | Rol de IA o automatización | Ruta de ejecución y CI | Salida revisable | Pregunta principal de prueba |
|---|---|---|---|---|---|
| Postman Agent Mode | Colecciones, solicitudes, respuestas, entornos, especificaciones | Redacta y edita scripts de prueba en el contexto del espacio de trabajo | Collection Runner y flujo de trabajo CLI compatible | Aserciones estándar de JavaScript de Postman | ¿Conserva tus variables y prueba el contrato? |
| KushoAI | OpenAPI, colección de Postman, cURL | Genera escenarios y suites de prueba; admite refinamiento en lenguaje natural | Ejecución en la plataforma e integración de CI documentada; verifica la habilitación | Inspecciona solicitudes generadas, dependencias y resultados esperados | ¿Puede tu plan seleccionado ejecutar y conservar la suite donde la necesitas? |
| Keploy | Especificaciones o definiciones de solicitudes; alternativamente, tráfico real | Generación por IA y una ruta separada de grabación/reproducción | Flujos generados o pruebas grabadas en entornos locales/CI compatibles | Revisa definiciones de prueba, líneas base y mocks de dependencias | ¿Qué ruta cubre tus modos de fallo reales? |
| Runner existente más un LLM | Matriz aprobada, especificación, convenciones de fixtures | Redacta código para revisión | Tu pytest u otro runner establecido | Código confirmado en tu repositorio | ¿La revisión es más barata que escribir las mismas pruebas directamente? |
Postman Agent Mode para colecciones existentes
Postman es una primera evaluación razonable cuando tu colección ya contiene un orden de solicitudes útil, variables de entorno y configuración de autenticación. Agent Mode puede usar ese contexto para generar scripts de prueba estándar de JavaScript. Esos scripts pueden entrar en el flujo de ejecución de colecciones existente en lugar de requerir un nuevo lenguaje de aserciones.
Una prueba enfocada revela más que pedirle que lo pruebe todo. Selecciona la solicitud que recupera un recurso creado antes en la colección. Proporciona su esquema y pide validación de campos requeridos, tipos de campo documentados y una aserción que conecte el ID devuelto con el ID de creación almacenado.
Luego inspecciona los cambios propuestos antes de aceptarlos. Un ejemplo de respuesta podría contener una mascota llamada Milo. La igualdad con Milo es significativa si tu fixture creó explícitamente a Milo; es frágil si el generador copió un nombre de un registro de muestra compartido. El mismo literal puede ser una aserción válida o una dependencia accidental, según su origen.
Verifica el alcance de las variables con cuidado. Un ID almacenado en una variable de entorno debe estar disponible para la solicitud posterior y debe pertenecer a esa ejecución. Las variables compartidas entre ejecuciones concurrentes pueden crear fallos intermitentes que se parecen a defectos del servidor. Pide al generador que explique la configuración y la limpieza, así como las aserciones.
Para la primera prueba de aceptación, ejecuta la colección dos veces contra datos aislados y luego inspecciona la representación exportada o versionada. Confirma que un compañero de equipo puede revisar los scripts cambiados sin repetir la conversación con la IA. También verifica que tu CLI, reporter y plan elegidos admitan la ruta de ejecución que pretendes usar.
Aquí no se presenta ninguna generación operada de Postman. La pregunta de evaluación útil es si su contexto de espacio de trabajo reduce tu trabajo de revisión en una colección existente. Eso requiere tu propia colección y una prueba a nivel de cuenta, no una conclusión extraída de una captura de pantalla del producto.
KushoAI para generación de pruebas basada en especificaciones
KushoAI acepta entradas de Swagger/OpenAPI, Postman y cURL y documenta la generación de pruebas, el refinamiento en lenguaje natural y la ejecución en CI. Eso lo convierte en candidato cuando un equipo tiene definiciones de API útiles pero una acumulación de pruebas sin escribir. Estas son capacidades descritas por el proveedor, no resultados medidos de detección de defectos. (Documentación de KushoAI, septiembre de 2026)
Elige la entrada con el contexto confiable más rico. Una solicitud cURL puede describir una solicitud válida, pero normalmente dice poco sobre campos opcionales, valores de enum permitidos o errores documentados. Un archivo OpenAPI agrega estructura; una matriz de escenarios aprobada agrega la intención que la estructura puede dejar ambigua.
Para una prueba de Petstore, pide casos separados para una mascota válida, un name requerido faltante, un ID con el tipo incorrecto y un filtro de status inválido. Revisa si la herramienta distingue los requisitos del cuerpo de la solicitud de los requisitos del esquema de respuesta. Pueden parecer similares en un ejemplo mientras imponen obligaciones diferentes.
A continuación, examina un flujo conectado de creación-lectura-actualización. La lectura debe usar el ID asociado con la configuración actual. La actualización debe apuntar al mismo recurso, y una lectura posterior debe verificar el campo cambiado. Cuatro solicitudes independientes con nombres de prueba atractivos no establecen que la cadena de dependencias funcione.
Trata la primera generación como una propuesta. Conserva las expectativas documentadas, revisa los scripts con flujo de datos incorrecto y marca los resultados poco especificados para una decisión de requisitos. Si la herramienta sugiere varios casos equivalentes de campo faltante, conserva las distinciones útiles en lugar de pagar por mantener duplicados.
Antes de comprar, pide ejecutar la suite desde tu pipeline previsto e inspeccionar el artefacto de fallo. Confirma los permisos actuales de CI, el manejo de credenciales y los formatos de exportación disponibles en el plan seleccionado. No asumas que una prueba interactiva gratuita otorga los mismos derechos de automatización que un despliegue de equipo.
Keploy para pruebas generadas y reproducción de tráfico
La documentación de Keploy presenta dos rutas de inicio distintas. La generación por IA acepta recursos como OpenAPI, Postman, cURL o endpoints y construye flujos de API conectados. Grabar y reproducir captura interacciones de API y sus dependencias para su ejecución posterior con mocks. La descripción del flujo por IA y la descripción de grabación de dependencias no deben tratarse como mecanismos idénticos. (Documentación de Keploy, septiembre de 2026)
Si tu dificultad es reproducir lo que una aplicación hizo con una base de datos o un servicio upstream, evalúa la ruta de grabación. Captura un recorrido pequeño de creación-lectura-actualización en un entorno aislado, inspecciona las dependencias capturadas y reproduce después de un cambio controlado en la aplicación. Verifica qué admite el runtime antes de planificar un despliegue mayor.
Si tu dificultad es derivar casos de una especificación, evalúa la ruta de generación por separado. Pregunta cómo sus solicitudes propuestas obtienen credenciales, transportan IDs entre pasos y limpian datos. La presencia de funciones de grabación en otras partes del producto no responde esas preguntas para una suite generada.
Los valores dinámicos necesitan criterio. Una marca de tiempo puede variar legítimamente; un ID de recurso puede conectar dos solicitudes y, por lo tanto, necesitar comparación. Ignorar ampliamente todos los campos cambiantes puede ocultar errores. Revisa las exclusiones campo por campo y conserva las comparaciones que expresan relaciones significativas.
También inspecciona la línea base antes de aceptarla. Una grabación que contiene el total incorrecto, una respuesta de fallback accidental o datos obsoletos puede reproducirse de forma consistente. La consistencia ayuda a detectar cambios, pero el equipo sigue decidiendo si el comportamiento capturado era correcto.
Un complemento útil: Schemathesis proporciona pruebas de API basadas en propiedades impulsadas por esquemas. Puede desafiar una API con entradas generadas junto con ejemplos revisados. Trátalo como un mecanismo de prueba diferente, no como sinónimo de un generador de pruebas LLM. Sus hallazgos aún necesitan interpretación frente al contrato y la implementación.
Herramientas de IA gratuitas para pruebas de API: límites y costos
“Gratis” puede describir un cliente, una asignación limitada de IA, un runner de código abierto o una prueba temporal. Estas ofertas cubren diferentes partes del flujo de trabajo. Un cliente gratuito no establece que la generación automatizada, la ejecución programada o la exportación de informes también sean gratuitas.
Según lo consultado el 21 de septiembre de 2026, el plan Free de Postman indica 50 créditos de IA al mes. Los créditos son su unidad de facturación; no significan 50 pruebas ni 50 suites completas. Su tabla comparativa distingue la asignación de IA de la ejecución, las funciones basadas en datos y las exportaciones de resultados. (Precios de Postman, septiembre de 2026)
La presentación actual de precios de KushoAI usa Developer Edition y Enterprise. Keploy distingue Playground, Pro y Enterprise, junto con su oferta de código abierto. Usa la pantalla de compra actual para confirmar los límites relevantes. Las recopilaciones de herramientas más antiguas pueden describir nombres de planes retirados o combinar asignaciones que se facturan por separado.
| Componente de costo | Qué registrar en una prueba | Qué puede hacer que la factura sea engañosa |
|---|---|---|
| Asientos y plan | Editores, revisores, intervalo de facturación, funciones requeridas | Comparar precios anuales destacados con compromisos mensuales |
| Generación de IA | Uso de créditos para la misma tarea aprobada, incluidos los reintentos | Asumir que un crédito equivale a una prueba |
| Ejecución | Ejecuciones locales, ejecuciones alojadas, jobs de CI, programaciones, informes | Tratar las ejecuciones interactivas como permiso para cada ruta de automatización |
| Modelo independiente | Tokens de entrada y salida para redacción y revisión | Ignorar envíos repetidos de la especificación completa |
| Tiempo de ingeniería | Revisión, reparación de fixtures, triaje de fallos, mantenimiento | Contar el tiempo de generación inicial como tiempo total de entrega |
Usa una pequeña tarea de aceptación para estimar el costo. Dale a cada candidato las mismas operaciones y expectativas, y luego registra cuántos escenarios sobreviven a la revisión. Mantén el tiempo de generación, el tiempo de revisión manual y el tiempo de ejecución en columnas separadas. Esperar a un modelo y corregir una aserción peligrosa imponen costos diferentes al equipo.
Un denominador útil son los escenarios revisados y ejecutables que tu equipo conservaría. Evita que un generador con muchos casos redundantes parezca más barato simplemente porque su salida es más larga. Registra los casos no respaldados que eliminaste y los requisitos que siguen sin resolverse.
Este artículo no afirma un porcentaje medido de ahorro de trabajo ni compara el rendimiento de planes de pago. Esas cifras necesitan una prueba controlada con entradas equivalentes. Para una decisión de compra, incluye un cambio de mantenimiento realista, como agregar un campo requerido, para que la estimación cubra el próximo sprint así como la primera demo.
Herramientas de IA para pruebas de API: de OpenAPI a una primera ejecución
Usa una instancia local aislada del proyecto real Swagger Petstore. Fija el commit d57941e8fe959e508796b27469b1e8bba73392dc; su especificación declara OpenAPI 3.0.4 y versión de aplicación 1.0.29-SNAPSHOT. Lee el archivo fijado en lugar de una demo pública actualizada de forma independiente. (Especificación de Swagger Petstore, septiembre de 2026)
1. Prepara el servicio y registra el entorno. Obtén el repositorio a través de esa página de origen, haz checkout de la revisión fijada e instala un JDK y Maven compatibles. El README del proyecto da este comando de inicio desde el directorio del repositorio:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty usa el puerto 8080. Establece BASE_URL en tu origen HTTP de loopback en ese puerto con /api/v3 añadido. Confirma que /openapi.json sea legible en relación con esa base antes de probar.
Esta ejecución usó Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 y jsonschema 4.26.0. Registra también tus versiones. La compilación desde el código fuente descarga dependencias y Swagger UI, por lo que un commit de aplicación fijado por sí solo no es una compilación totalmente hermética.
2. Importa la especificación fijada. Selecciona /pet, /pet/{petId} y /pet/findByStatus. Mantén delete disponible para la limpieza. Anula la ubicación del servidor público de la especificación con tu base local. Verifica esta configuración antes de enviar cualquier solicitud de escritura.
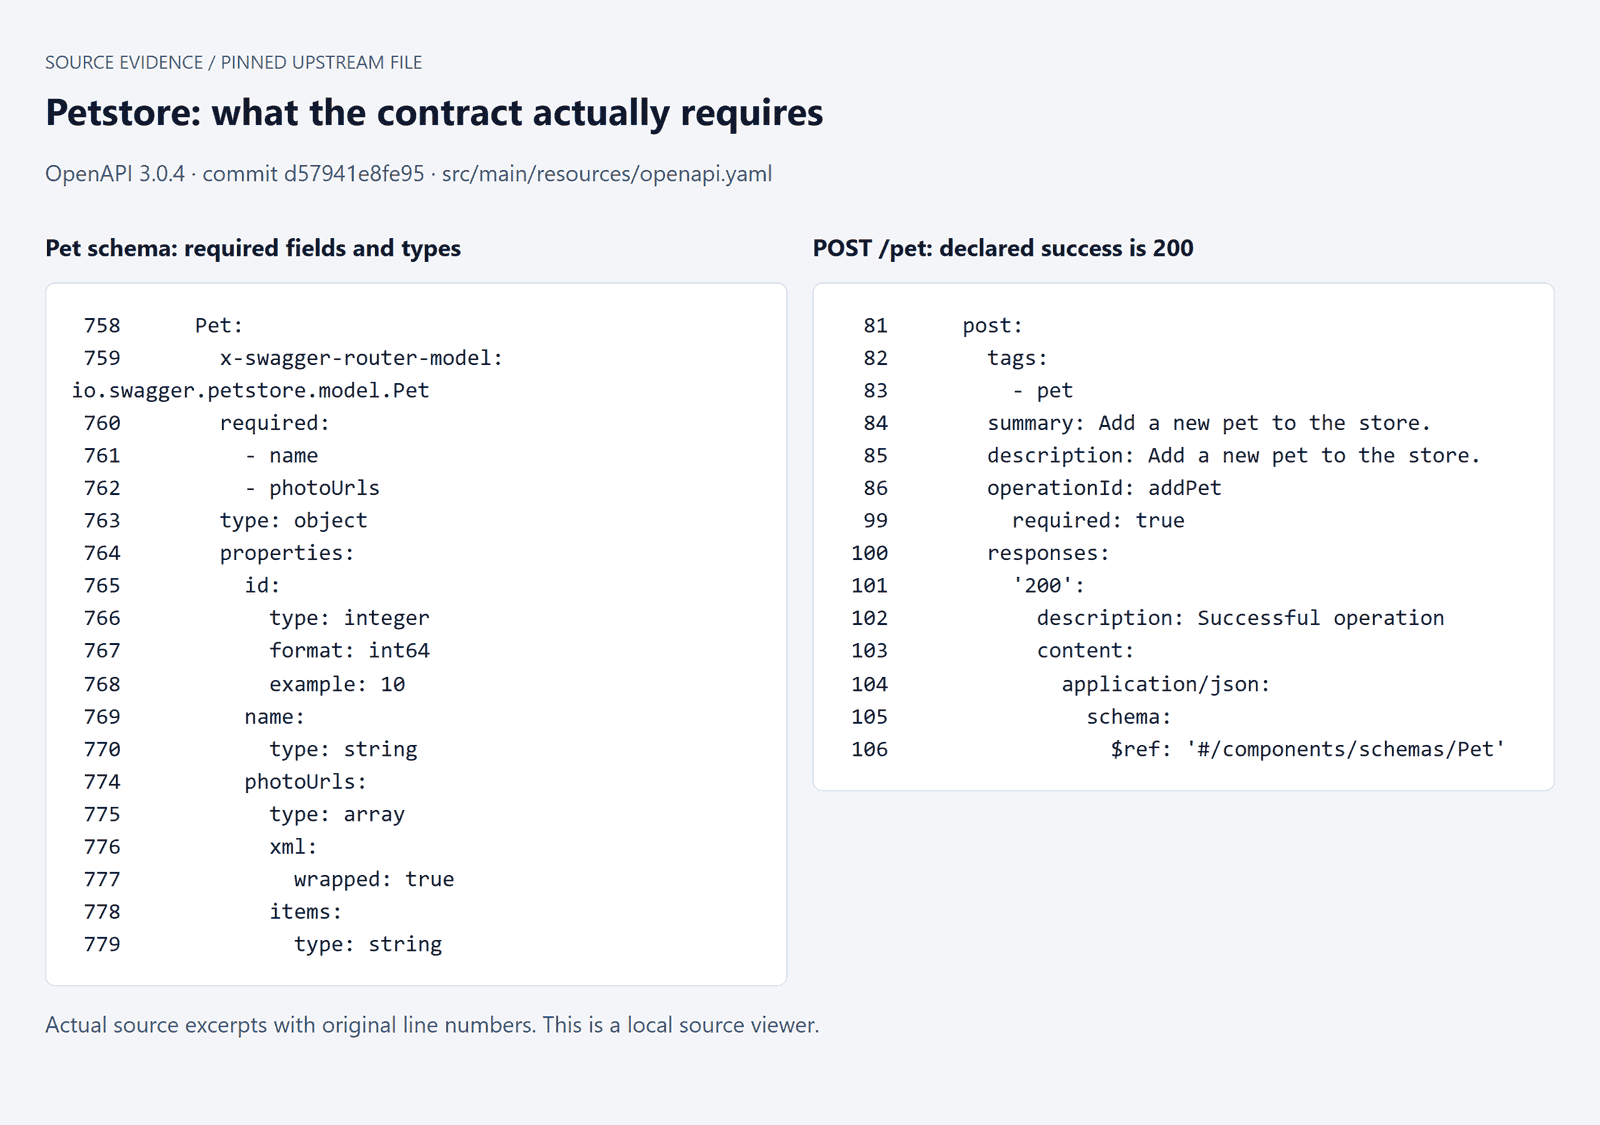 Código fuente fijado de OpenAPI Petstore que muestra campos requeridos y definiciones de operaciones seleccionadas
Extractos reales del código fuente renderizados localmente: Pet requiere name y photoUrls; POST /pet declara 200 para éxito. Se conservan los números de línea originales.
3. Genera una matriz antes del código ejecutable (Prompt A). Adjunta la especificación y pega este prompt en el generador que elijas:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Revisa el oráculo para cada escenario. Petstore documenta una creación exitosa como 200. Su esquema Pet requiere name y photoUrls; id tiene un tipo entero pero no está en esa lista de requeridos. Por lo tanto, la validación de campos faltantes y la identidad solicitud-respuesta necesitan verificaciones diferentes.
| Operación | Entrada o secuencia | Evidencia del resultado esperado | Aserción a revisar | Estado de ejecución |
|---|---|---|---|---|
| addPet, getPetById | Crear, luego leer el ID actual | 200 documentado y esquema Pet; expectativa explícita del flujo | Validar cuerpo y comparar ID devuelto | Aprobado localmente |
| updatePet, getPetById | Cambiar name y volver a leer | Operación de actualización más intención de fixture aprobada | Mismo ID, nuevo name, esquema válido | Aprobado localmente |
| findPetsByStatus | Consultar available después de la configuración | Enum documentado y respuesta de arreglo exitosa | Todos los estados devueltos coinciden; el ID creado está presente | Aprobado localmente |
| getPetById | ID de ruta no entero | 400 documentado por ID inválido | Estado exacto para este caso documentado | Aprobado: 400 |
| findPetsByStatus | Valor de enum no documentado | 400 documentado por status inválido | Estado exacto, conservar cualquier discrepancia | Aprobado: 400 |
| addPet | Omitir name requerido | Campo requerido del esquema; las descripciones 400 y 422 no mapean cada variación | Registrar comportamiento; resolver el mapeo exacto antes de condicionar la compuerta | Devolvió 200 sin name; discrepancia conservada |
5. Genera e inspecciona el archivo de ejecución (Prompt B). Adjunta la matriz aprobada y la especificación con este prompt:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Ejecuta, conserva y limpia. Usa un ID de mascota específico de la ejecución, captura la respuesta de creación y pasa su ID a solicitudes posteriores. Valida la actualización mediante una lectura nueva. Una respuesta de actualización exitosa por sí sola no prueba que el servidor haya persistido el cambio.
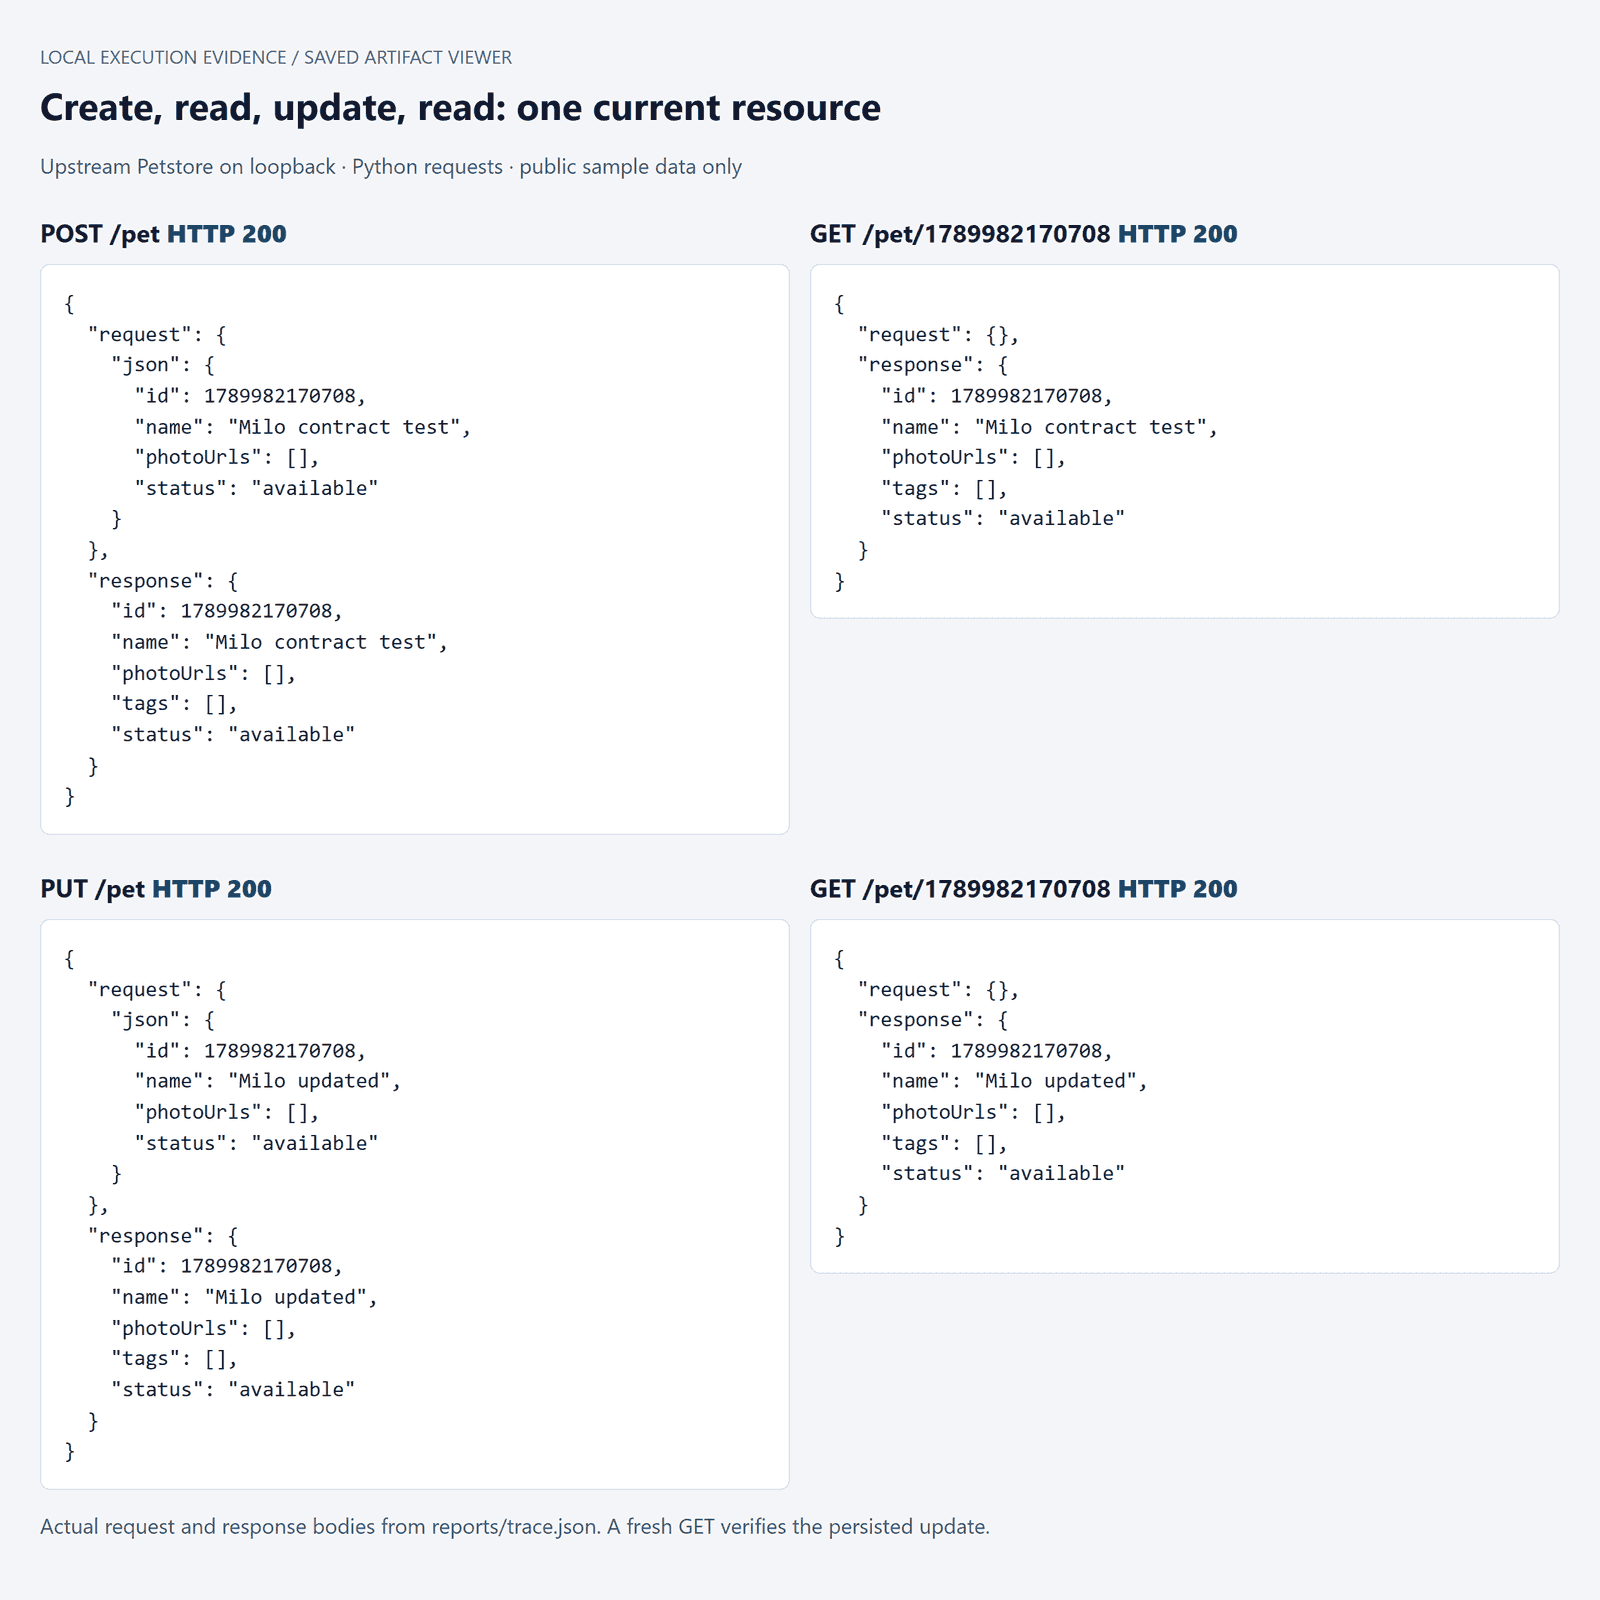 Evidencia local de la cadena de solicitudes de Petstore que muestra creación, búsqueda, actualización y transferencia de ID
Solicitudes y respuestas locales guardadas: el mismo ID específico de la ejecución sobrevive a la creación, lectura, actualización y una lectura nueva. Las 4 solicitudes mostradas devolvieron 200.
Guarda los cuerpos de solicitud, las respuestas, los fallos de aserción y el resultado de la limpieza. Restringe la eliminación a los ID creados por esta ejecución. Conserva las respuestas inesperadas como hallazgos, incluidos los casos en que la implementación de demostración acepta entradas inválidas. No ajustes las aserciones solo para obtener una captura de pantalla en verde.
Lo que encontró esta ejecución: las 5 funciones de prueba en vivo pasaron, incluidas las verificaciones de ID inválido y status inválido que devolvieron 400. La sonda separada de nombre faltante devolvió 200 y un cuerpo sin name. Conservamos esa discrepancia de esquema fuera de la suite en verde; su mapeo de error previsto exacto aún necesita aclaración. Ambos registros creados se eliminaron correctamente.
Las pruebas locales se redactaron en esta ejecución del artículo, de forma independiente de las tres herramientas comerciales. Se conservaron las 5 pruebas en vivo; ninguna se eliminó ni se relajaron sus expectativas después de la ejecución. No se midió el tiempo de revisión humana. La carpeta de evidencia contiene los archivos de prueba, el lock de dependencias, las respuestas sin procesar y las instrucciones de reproducción.
Cómo validar herramientas de IA para pruebas de API
Una aserción útil debería rechazar una respuesta incorrecta relevante. Puedes probar esa propiedad sin cambiar el servicio en ejecución: guarda una respuesta exitosa real, cópiala y modifica deliberadamente un campo a la vez. Estas son mutaciones de respuesta controladas, no vulnerabilidades de producción ni un benchmark completo de pruebas de mutación.
Mantén juntos el estado y el cuerpo originales. Primero ejecuta el validador contra la respuesta sin modificar y verifica que acepte la línea base. Luego crea tres copias independientes. Cambia el ID, cambia el tipo de name y elimina el name requerido. Cada copia debería fallar por una razón que coincida con la alteración.
| Línea base guardada | Modificación controlada | Verificación relevante | Resultado real |
|---|---|---|---|
| Búsqueda exitosa de la mascota actual | Sustituir por otro ID entero; mantener estado 200 | El ID devuelto es igual al ID esperado de esta ejecución | Falló: los ID esperados y reales difieren |
Cadena name | Reemplazar name por un número | Tipo string del esquema Pet | Falló: 42 no es una cadena |
name requerido presente | Eliminar name | Lista de requeridos del esquema Pet | Falló: name es requerido |
El ejemplo del ID expone una debilidad común. Un validador de esquema puede aceptar el entero incorrecto porque la forma sigue siendo válida. La aserción de relación aporta la restricción faltante. En los otros dos ejemplos, la validación de esquema aporta restricciones que una verificación solo de estado no puede ver.
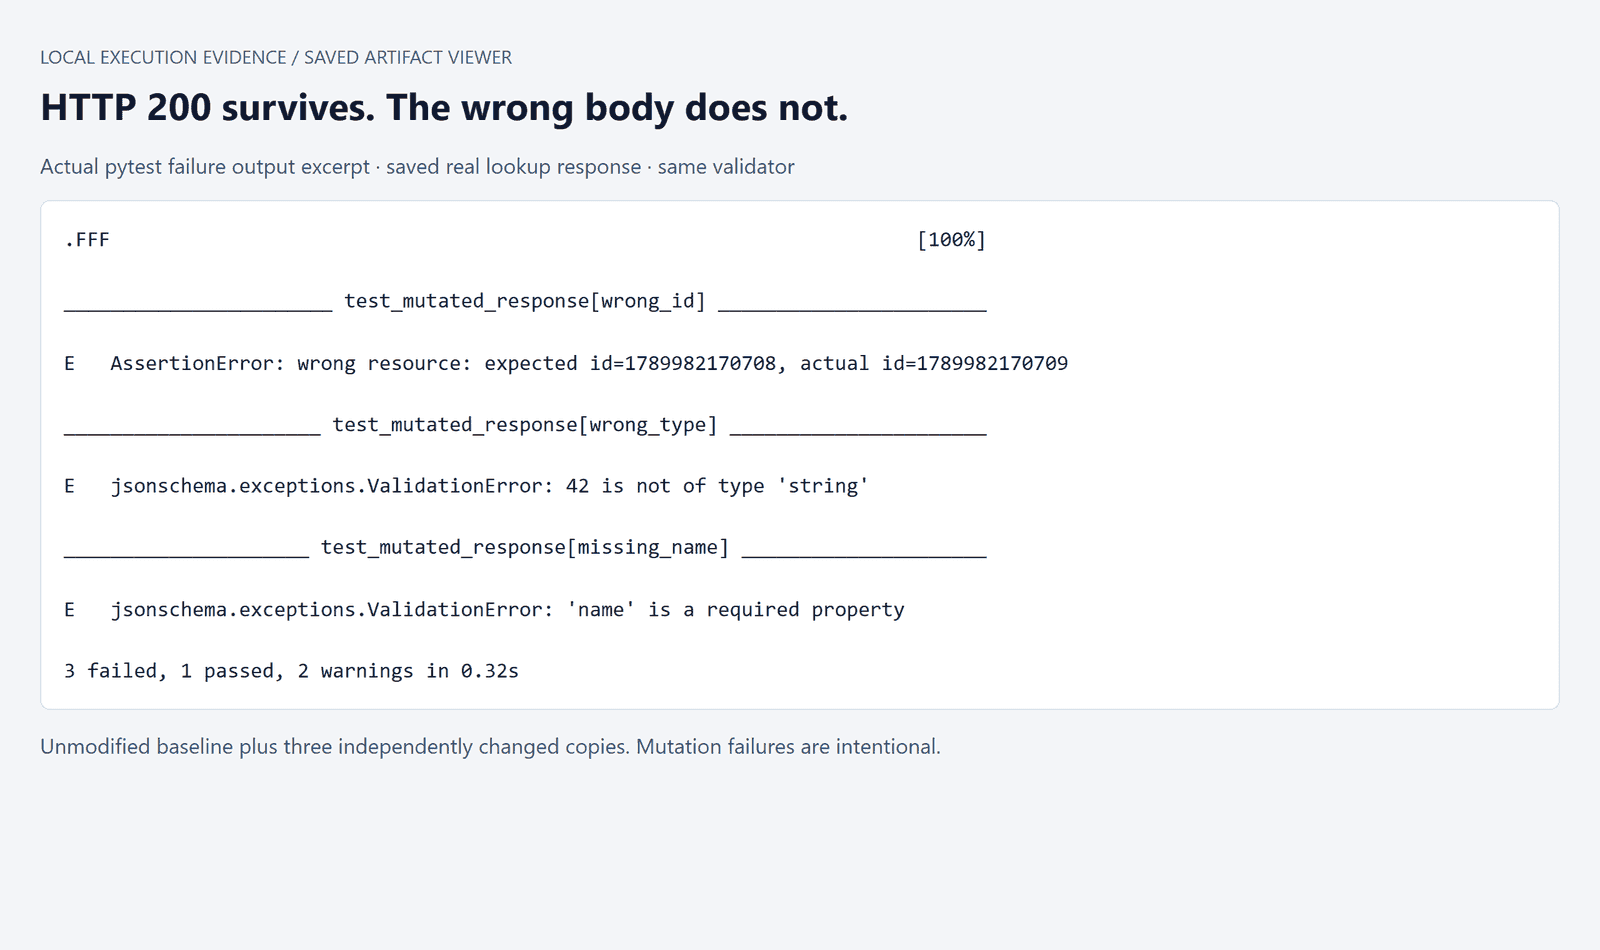 Salida real de fallo de aserción para mutaciones controladas de respuestas de Petstore
Extractos reales de fallos de pytest: la respuesta original pasó y las 3 mutaciones independientes fallaron. Estos fallos se indujeron deliberadamente en copias guardadas.
En esta ejecución, la línea base sin cambios pasó y 3 de 3 copias alteradas fallaron. La ejecución de mutación devolvió el código de salida 1, preservando la señal de fallo. El validador aplica las restricciones estructurales relevantes del esquema Pet y una verificación separada de relación de ID; esta pequeña demostración no es un validador completo de conformidad con OpenAPI.
Para una auditoría repetible, adjunta el archivo de prueba y la especificación fijada al Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Revisa con especial cuidado los cambios de “autorreparación” sugeridos. Reemplazar un 400 esperado por 200 puede ocultar una regresión. Un cambio de contrato legítimo necesita una referencia de requisitos y un cambio de prueba revisado. La respuesta observada es evidencia para investigar, no permiso automático para redefinir la corrección.
Separa las categorías de fallo antes de pedirle una corrección a la IA. Un timeout puede indicar un entorno no disponible. Un fallo de búsqueda puede venir de un fixture roto. Un error de importación pertenece al código de prueba. Una discrepancia reproducible con el contrato acordado puede pertenecer al producto. Conserva suficiente contexto para distinguirlos.
Informa el denominador con honestidad. Detectar tres cambios de respuesta seleccionados demuestra sensibilidad a esos tres cambios. No establece cobertura de endpoints, cobertura de código, cobertura de seguridad ni una tasa general de detección de defectos. Asimismo, un gran número de pruebas dice poco sobre escenarios duplicados o la fortaleza de sus aserciones.
La autenticación y la autorización merecen pruebas independientes en una aplicación adecuada: credenciales faltantes, credenciales expiradas y acceso a los recursos de otro usuario. El comportamiento de demostración de Petstore no puede establecer que tus controles de acceso de producción funcionen.
Herramientas de IA para pruebas de API en CI/CD
Una vez que un revisor acepta la suite, haz commit de esa versión exacta. Una compilación debe ejecutar expectativas conocidas contra la aplicación candidata. Regenerar pruebas durante cada compilación introduce otro componente cambiante y hace más difícil reproducir los fallos.
Fija el runner, las dependencias, los fixtures y la especificación. Guarda un lock de dependencias junto con las pruebas y conserva la revisión de la aplicación en el informe. Resuelve los secretos desde el entorno de CI, manténlos fuera de los archivos generados y verifica que los registros de fallos no los expongan.
Con pytest, la forma básica de generación de informes es simple:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Proporciona BASE_URL a través del entorno del job. Inicia el servicio local en el ciclo de vida del job, espera a que esté listo y luego ejecuta la suite. Recopila siempre el informe y el registro del servicio, incluso en caso de fallo. Termina deteniendo el servicio propio del job y limpiando sus datos; evita comandos de limpieza de todo el proceso en agentes compartidos.
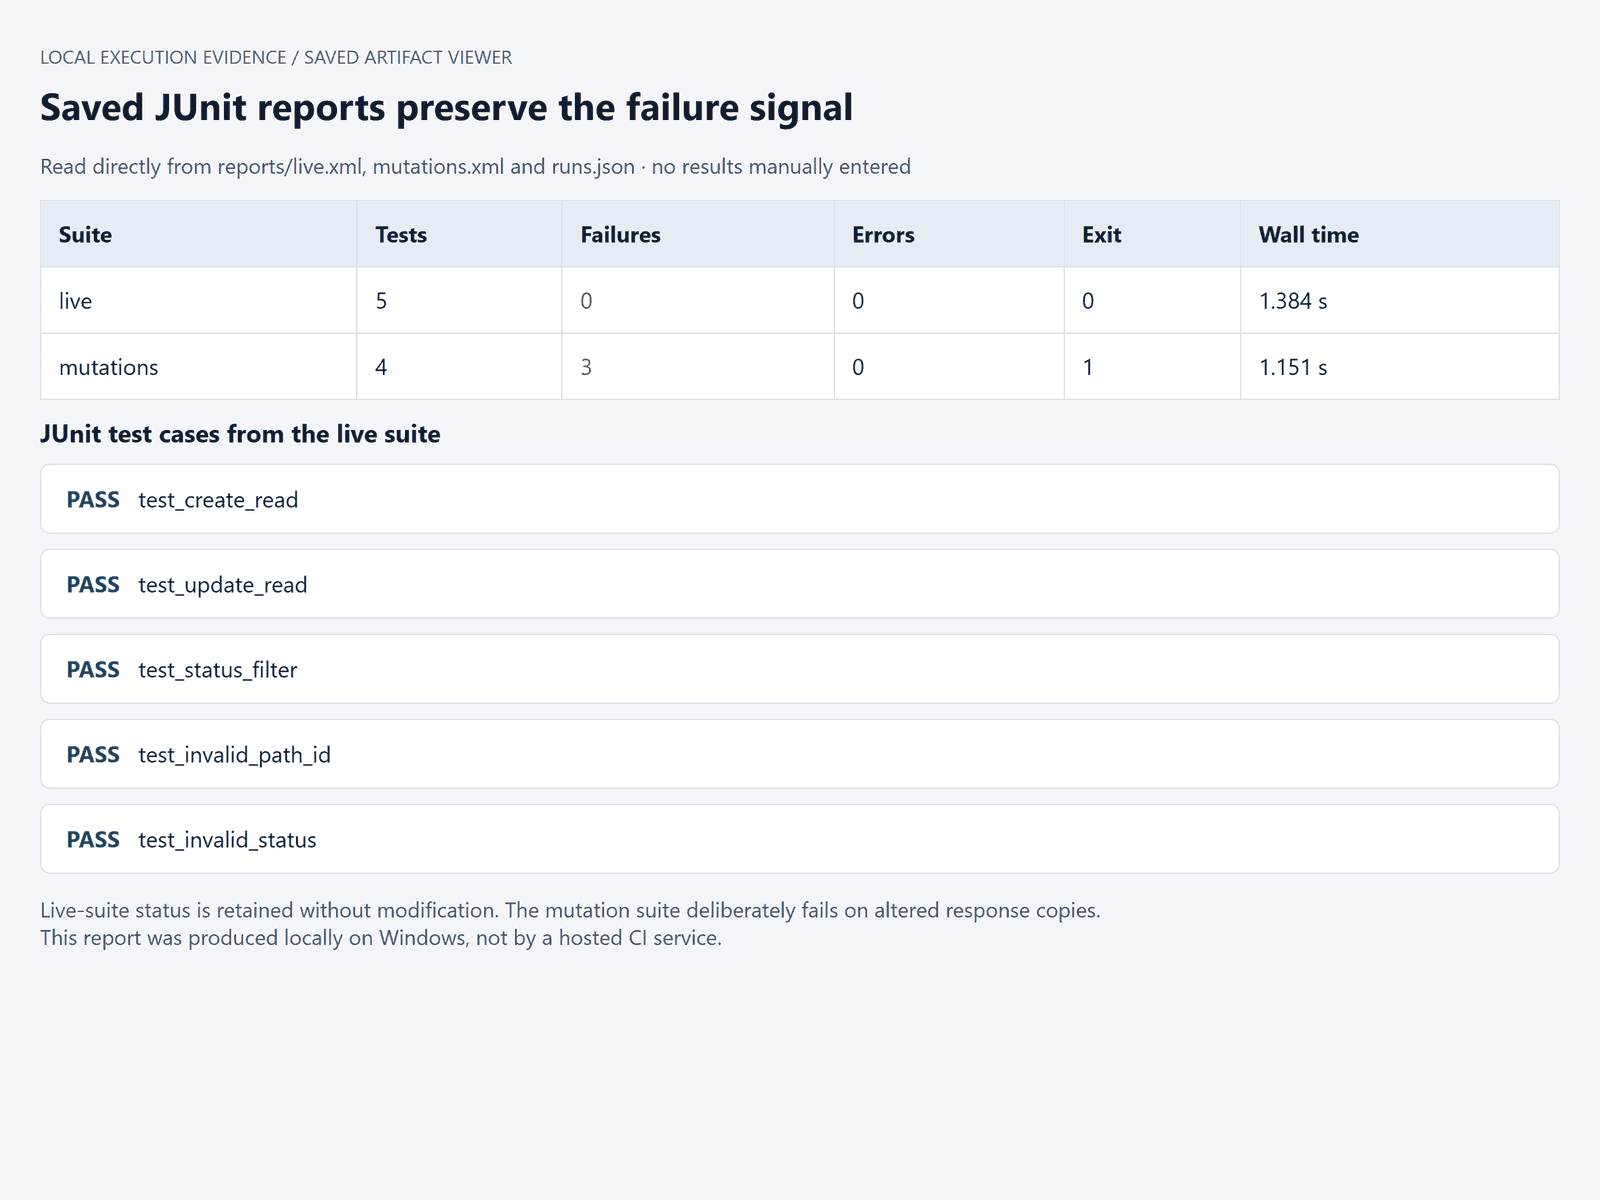 Informe local de JUnit de pytest con resultados separados de contrato en vivo y verificación de aserciones_Actual local
Resultados de JUnit: 5 pruebas en vivo pasaron; la suite de copias controladas contiene 1 línea base aprobada y 3 fallos intencionales. No se afirma ninguna ejecución de CI alojada.
Los tiempos de reloj medidos, incluido el arranque del proceso de Python, fueron 1,384 segundos para la suite en vivo y 1,151 segundos para la suite de copias controladas. Estos excluyen la compilación/inicio del servicio, la instalación de dependencias, el borrador y la revisión. Los archivos JUnit y los registros completos se guardan por separado.
Prueba la ruta de fallo antes de confiar en la compuerta. Una aserción fallida debe producir un código de salida de job fallido. Los reintentos deben ser acotados y justificados para transitorios de infraestructura conocidos; los reintentos repetidos que finalmente ocultan un fallo del producto hacen que la compuerta sea menos informativa.
Maneja los fallos de limpieza de forma explícita. Mantén visible el fallo de aserción principal, registra qué recurso queda y deja que el teardown informe su propio problema. Los jobs paralelos necesitan identificadores o espacios de nombres separados. Una prueba que pasa sola pero lee datos de otro job no está lista para uso desatendido.
Si ya tienes pytest, puedes elegir el modelo de redacción por separado. Atlas Cloud encaja en este rol más acotado: una capa de modelo para un flujo de trabajo personalizado cuya ejecución y generación de informes ya existen. No se presenta aquí como una plataforma completa de pruebas de API ni como un backend nativo para los tres productos anteriores.
Para esa evaluación, abre DeepSeek V4.1 Flash, ID de modelo deepseek-ai/deepseek-v4.1-flash, y proporciona la misma especificación pública y matriz revisada usadas localmente. Usa el Prompt B y luego guarda el borrador devuelto por separado de la prueba revisada. Compara sus supuestos con el contrato antes de ejecutar nada.
Si la interfaz lo expone, una temperatura de 0.2 es un ajuste inicial para redactar, no una garantía de determinismo. Verifica el límite de salida disponible frente al tamaño de tu suite. Consulta el catálogo actual de modelos para el precio por tokens en lugar de presupuestar a partir de un artículo antiguo.
La división del trabajo sigue siendo explícita: el modelo propone código, un revisor aprueba las expectativas y el runner produce resultados. La compuerta de acceso al entorno de pruebas impidió una ejecución completa de Atlas para este artículo, por lo que esto es una receta de evaluación en lugar de un resultado medido del modelo. Puedes evaluar esta ruta sin migrar un runner de pruebas en funcionamiento ni entregar sus responsabilidades de ejecución a un modelo de chat.
Elegir herramientas de IA para pruebas de API para tu equipo
Elige la evaluación más pequeña que pueda cambiar tu decisión. Usa un flujo de trabajo conectado, un caso negativo documentado y unas pocas respuestas incorrectas controladas. Mantén entradas equivalentes entre candidatos. Una experiencia de incorporación pulida no debería pesar más que una prueba que no puede identificar el recurso incorrecto.
Para un flujo de trabajo de colección maduro, empieza evaluando las funciones de IA en ese espacio de trabajo. La configuración de entorno existente y las dependencias de las solicitudes son contexto valioso. Mide si los cambios generados ahorran esfuerzo de revisión sin introducir supuestos frágiles.
Para un equipo con una especificación sólida y una acumulación de escritura pendiente, evalúa la generación basada en especificaciones. Presta atención a qué ocurre cuando la especificación está incompleta. Un generador que señala claramente las expectativas faltantes es más fácil de revisar que uno que las inventa con confianza.
Para una aplicación cuyos fallos dependen del comportamiento upstream, evalúa la grabación y reproducción. Inspecciona las líneas base capturadas y el soporte de dependencias antes de invertir en grabaciones grandes. Decide qué campos dinámicos pueden variar y qué relaciones deben permanecer intactas.
Para un equipo con un runner estable, evalúa un modelo independiente para redacción y revisión. Conservas el formato de ejecución que ya conoces, pero también asumes la integración, el diseño de fixtures y el mantenimiento. Incluye esa propiedad en el cálculo de costos.
Antes de pagar por herramientas de IA para pruebas de API, exige cinco demostraciones concretas:
- La suite revisada se ejecuta contra tu entorno previsto.
- Errores controlados relevantes hacen fallar las aserciones adecuadas.
- Las pruebas y los informes útiles se pueden conservar en un formato aceptable.
- Las ejecuciones repetidas, incluida la ejecución en CI, preservan el aislamiento y las señales de fallo.
- Los costos de generación, ejecución y mantenimiento se ajustan al presupuesto del equipo.
Asigna a alguien para mantener la suite aceptada. Un cambio en la especificación debe activar una revisión de las aserciones, los fixtures y los consumidores afectados. Conserva la evidencia de fallo anterior hasta que se entienda el cambio. Eso hace que la próxima versión sea más fácil de evaluar y le da al equipo una razón para confiar en un informe en verde.
Preguntas frecuentes
¿Qué herramienta de IA debería usar para pruebas de API?
Empieza con tus entradas existentes. Evalúa Postman Agent Mode para colecciones establecidas, KushoAI para generación guiada por especificación y Keploy por sus distintas rutas de flujo generado y grabación. Si tu equipo ya mantiene pytest u otro runner, un modelo de redacción separado puede encajar. Usa el mismo flujo de trabajo pequeño para evaluar las aserciones, la ejecución y el esfuerzo de revisión de cada candidato.
¿Existen herramientas de IA gratuitas para pruebas de API?
Hay clientes gratuitos, herramientas de pruebas de código abierto y asignaciones limitadas de IA. Cubren necesidades diferentes. El plan Free de Postman indica 50 créditos de IA mensuales a partir del 21 de septiembre de 2026; eso no es un conteo de pruebas. Verifica si tus funciones requeridas de exportación, automatización, informes y colaboración están incluidas antes de tratar una prueba interactiva como una solución de CI gratuita.
¿Puede la IA generar pruebas de API a partir de una especificación OpenAPI?
Sí, un generador puede usar operaciones, esquemas, parámetros y definiciones de respuesta para proponer pruebas. La especificación aún puede omitir reglas de negocio o dejar ambiguos los mapeos de errores. Proporciona expectativas aprobadas y revisa el resultado. En el ejemplo fijado de Petstore, una creación exitosa está documentada como 200, lo que ilustra por qué las convenciones REST familiares no pueden reemplazar el contrato real.
¿Cómo sé si las aserciones generadas por IA son útiles?
Verifica tres cosas: restricciones de esquema documentadas, relaciones entre solicitudes y respuestas, y sensibilidad a datos deliberadamente incorrectos. Guarda una respuesta real, modifica una propiedad relevante y vuelve a ejecutar el mismo validador. Conserva el mensaje de fallo. Esto da evidencia estrecha y reproducible sobre esas aserciones, mientras deja abiertas para pruebas separadas las preguntas más amplias de cobertura y seguridad.
¿Puedo ejecutar pruebas de API generadas por IA en CI/CD?
Sí, cuando el formato generado, el runner, el entorno y el plan admiten esa ruta. Haz commit de las pruebas revisadas, instala dependencias fijadas, usa fixtures aislados y exporta un informe estructurado como JUnit. Verifica que los fallos devuelvan un código de salida distinto de cero. Una ejecución local exitosa prepara la suite para CI; no demuestra que se haya ejecutado una pipeline alojada.
¿Puede la IA reemplazar las pruebas manuales de API?
La IA puede reducir la redacción repetitiva y ayudar a los revisores a encontrar aserciones débiles. Las personas siguen decidiendo el comportamiento previsto, investigando fallos ambiguos y explorando riesgos fuera de los ejemplos proporcionados. Usa herramientas de IA para pruebas de API para producir activos de prueba revisables y luego júzgalos por evidencia reproducible. Una suite más pequeña que detecta errores significativos es más fácil de confiar que una colección inexplicable de verificaciones en verde.


