El código parece terminado. Luego fallan las pruebas, la corrección cambia una interfaz y otra solicitud empieza a ejecutarse. Elegir la mejor API de IA para programar significa encontrar un modelo y un endpoint que terminen tu tipo de trabajo dentro de un presupuesto aceptable.
Empieza con Claude, GPT o Gemini como candidato de referencia. Compara DeepSeek, Qwen y Kimi en las mismas tareas si quieres opciones alternativas de despliegue y gasto. Para la depuración, prioriza las pruebas de regresión. Para la refactorización, inspecciona el diff. Para un agente de programación, verifica todo el bucle de herramientas antes de comparar precios de tokens.
La frustración es medible. En la Encuesta a Desarrolladores de Stack Overflow de 2025, el 66% de los encuestados que respondieron a la pregunta sobre frustraciones reportaron soluciones de IA casi correctas; el 45% reportó dedicar más tiempo a depurar código generado. Estas son respuestas de encuesta, no una evaluación de modelos de 2026. (Stack Overflow Developer Survey, 2025)
Puntos clave
- Elige la API y el agente por separado.
- Preselecciona por tarea y características requeridas del endpoint.
- Guarda las primeras respuestas y evalúalas contra pruebas de aceptación fijas.
- Incluye los intentos fallidos y las reparaciones en tu cálculo de costos.
Esta guía ofrece una preselección, tres tareas de evaluación copiables y una hoja de cálculo de costos. La investigación se verificó el 21 de septiembre de 2026. La disponibilidad del modelo, las capacidades documentadas y los resultados medidos son categorías de evidencia distintas a lo largo de este texto.
Mejor API de IA para programar: la preselección
Empieza con dos candidatos: uno que encaje en tu aplicación existente y una alternativa. Usa estas seis familias para construir ese par inicial.
La tabla propone pruebas, sin afirmar un rendimiento comparativo. El acceso depende de tu cuenta, región, cuota y endpoint; una ficha en la documentación no confirma que tus credenciales puedan invocarlo.
| Modelo e ID específicos | Ruta de acceso | Tarea que vale la pena evaluar | Límite principal de decisión | Evidencia del endpoint | Comprobación de precio |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Cambios restringidos en varios archivos | Verificar los controles de cliente y razonamiento | Descripción general del modelo de Claude Platform; acceso a cuenta no probado | Sin tarifa indicada |
GPT-6 Astra, gpt-6-astra | OpenAI API | Tareas de programación con múltiples condiciones | Verificar la ruta y las herramientas | Documentación de modelos de OpenAI; acceso a cuenta no probado | Sin tarifa indicada |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Generación y revisión interactivas | Verificar la latencia y el protocolo | Directorio de modelos de Google AI; acceso a cuenta no probado | Sin tarifa indicada |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud model route | Correcciones numéricas; experimentos de contexto | Mantener separada la versión 0813 | Página exacta del modelo verificada; características en tiempo de ejecución no probadas | 21 de septiembre de 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud model route | Refactorizaciones; interfaces autocontenidas | Versión especificada; no la más reciente | Página exacta del modelo verificada; características en tiempo de ejecución no probadas | 21 de septiembre de 2026 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud model route | Las mismas tres tareas; interfaz CSV | Verificar los límites de salida y finalización | Página exacta del modelo verificada; características en tiempo de ejecución no probadas | 21 de septiembre de 2026 |
Claude, GPT y Gemini proporcionan candidatos de referencia útiles. Sus directorios oficiales de modelos identifican las versiones anteriores. Usa un proveedor que ya conozcas como línea base, luego prueba si una alternativa reduce el costo por tarea aceptada o el trabajo de integración. No trates el comportamiento de un asistente de consumo como el resultado correspondiente de la API.
El directorio de modelos de OpenAI lista GPT-6 Astra junto con la familia GPT-5.6. Eso establece un candidato actual, no una victoria en programación sobre las otras filas. La tabla evita deliberadamente importar IDs de modelos antiguos de páginas de comparación sin fecha. (Directorio de modelos de OpenAI, consultado en septiembre de 2026)
DeepSeek se gana un lugar como familia de modelos independiente que conviene investigar. Prueba si corrige el error concreto sin ampliar el cambio. Elige otro candidato si la ruta desplegada no puede satisfacer tu formato de respuesta requerido, el comportamiento de las herramientas o el límite de latencia, independientemente de la reputación general del modelo.
Evalúa Qwen por versión. El despliegue 122B A10B nombrado ofrece una referencia de precio concreta. Ejecuta las comprobaciones de análisis y navegador antes de sacar una conclusión de valor. Las cifras de contexto de otras versiones de Qwen no se pueden asignar a este modelo.
Kimi es el candidato de configuración desarrollado. Su página pública identifica el ID del modelo. La revisión de la configuración es posible; la generación exitosa sigue sin verificarse. Evalúa su salida completada contra las mismas restricciones que los demás candidatos.
Atlas Cloud se sitúa en la capa de acceso en esta comparación. No es un séptimo modelo. Su relevancia es práctica: puedes inspeccionar varias páginas de modelos candidatos y comparar sus requisitos de integración antes de comprometerte con un flujo de trabajo.
Para pesos abiertos, verifica la licencia exacta de la versión y el artefacto de despliegue. La inferencia alojada tiene términos de servicio y costos operativos separados; la familia de modelos por sí sola no puede establecerlos.
API de programación, modelos y agentes explicados
Un modelo produce contenido en respuesta a una entrada. Una API define cómo tu aplicación envía esa entrada y recibe el resultado. Un agente de programación organiza el trabajo circundante: leer archivos, llamar herramientas, aplicar ediciones, ejecutar pruebas y decidir si continuar.
Esas tres capas pueden fallar de forma independiente. Un modelo puede proponer un parche correcto mientras el agente lo escribe en el archivo equivocado. Una API puede devolver JSON válido mientras la aplicación ignora una llamada a herramienta. Un agente capaz puede bloquearse porque su endpoint seleccionado rechaza un parámetro.
Supón que envías un controlador y pides un analizador de ID. Una API básica de generación de código devuelve texto que contiene código. Tu programa todavía necesita extraer ese código, colocarlo en un espacio de trabajo adecuado y ejecutar las pruebas. Una respuesta HTTP exitosa establece la entrega, no la corrección.
Un agente puede automatizar esos pasos solo si le proporcionas las herramientas y los permisos. También necesita una condición de parada. Sin ella, puede editar repetidamente una función ya aceptable, ampliar la tarea o gastar solicitudes adicionales tratando de mejorar un detalle irrelevante.
Mantén tres líneas de presupuesto separadas:
- Suscripción a herramientas: la aplicación, la integración con el editor o el servicio de agente que usas.
- Uso de inferencia: solicitudes al endpoint del modelo seleccionado, bajo sus términos de facturación.
- Entorno de ejecución: contenedores, ejecutores de pruebas, almacenamiento y otra infraestructura.
Algunos productos agrupan partes de esta pila. Otros esperan que aportes credenciales separadas. Comprueba el plan concreto antes de asumir que una suscripción de editor incluye tráfico arbitrario de API desde tu propia aplicación.
La compatibilidad de protocolo también tiene un límite. Un servicio que acepta un array messages familiar todavía puede exponer un comportamiento de herramientas distinto, eventos de streaming, límites de contexto o controles de razonamiento diferentes. Copiar una URL base no puede establecer compatibilidad con todas las características del ecosistema de otro proveedor.
Mapea aplicación, agente, endpoint, modelo, herramientas y pruebas. Identifica el componente facturable y el operador responsable en cada paso antes de cambiar de modelo.
Mejor API de IA para programar: 7 comprobaciones de selección
1. Corrección funcional y comportamiento de regresión. Escribe las salidas esperadas antes de solicitar código. Una función de precios que maneja números enteros ordinarios pero acepta null como cero viola el contrato. Ejecuta tanto los nuevos casos límite como las pruebas existentes del proyecto; pasar una nueva prueba puede ocultar un llamador roto en otro lugar.
2. Alcance del cambio. Compara el parche con la solicitud. Extraer un analizador de ID debería preservar la URL, la respuesta de éxito y la respuesta de error. Una migración de framework no solicitada añade trabajo de revisión incluso cuando el reemplazo compila. Decide de antemano si las ediciones no relacionadas descalifican la respuesta o requieren una reparación.
3. Contexto útil y espacio de salida. Tu solicitud incluye instrucciones, archivos relevantes, definiciones de herramientas y conversación previa. Reserva suficiente espacio también para la respuesta. Una gran ventana de contexto anunciada no establece que el modelo encontrará la invariante relevante, ni que tu endpoint acepte el mismo máximo.
Prueba la calidad del contexto con una dependencia que importe. Incluye un llamador cuya interfaz deba permanecer estable y verifica que el modelo lo respete. Mide el truncamiento por separado: una respuesta que termina a mitad de una función no se puede aceptar porque sus primeras líneas parecían prometedoras.
4. Llamadas a herramientas y salida estructurada. Verifica la ruta desplegada con tu esquema de herramientas real. Comprueba los tipos de argumentos, los campos faltantes, los identificadores de herramientas y la respuesta de seguimiento tras un resultado de herramienta. Un modelo que escribe un objeto JSON plausible no necesariamente ha completado un ida y vuelta nativo de llamada a herramienta.
5. Tiempo hasta un resultado aceptado. Registra la duración de todo el intento, incluidas las reparaciones y las pruebas. Para un asistente interactivo, el tiempo hasta el primer texto visible también importa, pero no puede reemplazar el tiempo de finalización. Un primer token rápido seguido de una respuesta larga e inutilizable sigue bloqueando al desarrollador.
6. Cargos de entrada, salida, caché y reintentos. Lee las categorías de facturación que realmente reporta el endpoint elegido. Separa las lecturas de caché de la entrada ordinaria cuando corresponda. Rastrea las solicitudes fallidas y los bucles abortados. Si el proveedor no expone el detalle que necesitas, marca explícitamente los supuestos faltantes de la estimación.
7. Condiciones de integración y manejo del código. Confirma que tu editor o aplicación admite la ruta, el método de autenticación y el formato de error. Revisa los términos actuales de manejo de datos del proveedor antes de enviar código fuente privado. Los pesos abiertos describen una elección de distribución del modelo; no establecen cómo trata un servicio alojado tus solicitudes.
Los benchmarks públicos pueden ayudarte a seleccionar candidatos, siempre que leas sus condiciones. SWE-bench Verified contiene 500 instancias filtradas por humanos. Su página actual también describe una vista Bash Only que usa el mismo entorno mini-SWE-agent. Estos detalles ayudan a explicar qué se está comparando. (SWE-bench, consultado en septiembre de 2026)
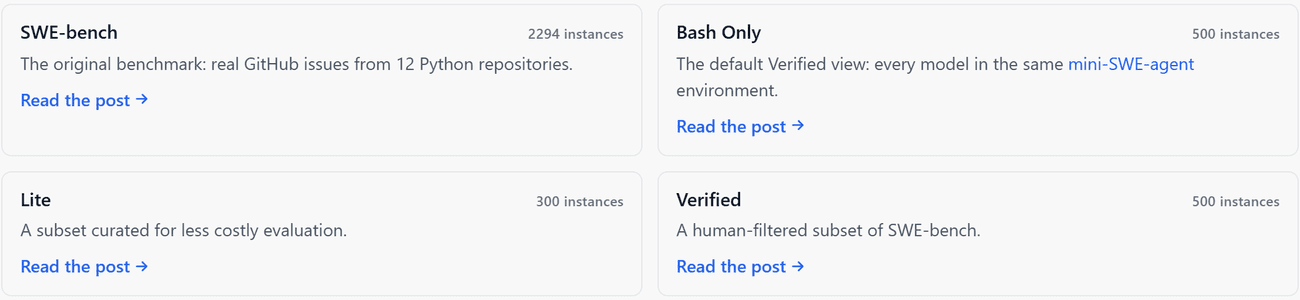 Página de SWE-bench que muestra el tamaño del conjunto de datos Verified y el entorno de agente compartido
Evidencia de origen: la página real del benchmark, capturada el 21 de septiembre de 2026. El conjunto de datos y las condiciones de ejecución pertenecen junto a cualquier afirmación de rendimiento.
Los resultados de benchmarks describen una configuración concreta. Tu lenguaje, reglas de negocio, permisos y estándares de revisión pueden diferir. Toma la decisión final sobre trabajo que puedas inspeccionar.
Mejor API de IA para programar: ejecuta tres comprobaciones prácticas
Estos tres ejemplos de evaluación reproducibles exponen modos de fallo distintos. Fija sus reglas de aceptación antes de solicitar la salida. Evalúa la función o la página contra su contrato, independientemente de la calidad de la explicación.
Para DeepSeek V4 Pro, Qwen3.5 122B A10B y Kimi K3, el protocolo previsto es de tres ejecuciones independientes por tarea. Eso significa 27 intentos iniciales. Permite como máximo una reparación por retroalimentación por intento, conserva la primera respuesta e informa los resultados iniciales y reparados por separado.
Solicita temperatura cero solo donde sea compatible, registrando el valor real aceptado. Usa un límite de salida solicitado de 4.096 tokens para A y B, y de 8.192 para C, después de comprobar los límites del endpoint. Los valores predeterminados y los controles no compatibles deben registrarse. Una temperatura baja no garantiza respuestas idénticas.
Estado de la evidencia: el acceso al entorno de pruebas quedó bloqueado por una pantalla de inicio de sesión de Cloudflare Access. Los 27 intentos candidatos no pudieron ejecutarse. La siguiente evidencia muestra código original ejecutado localmente y un fixture de referencia CSV creado para el artículo, no resultados de modelos candidatos. Las tasas de aprobación de modelos, el uso de tokens y los costos de tareas siguen sin medirse.
Tarea A: corregir la selección numérica de precios. Pega este prompt exacto en una sesión nueva:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
Las entradas de aceptación fijas son [2,10,3], ["12","3"], un array vacío, valores solo inválidos, cero, números negativos y cadenas solo con espacios en blanco. Rechaza las cadenas en blanco después de recortarlas. Comprueba que el array original tenga exactamente los mismos elementos en el mismo orden después de la llamada.
El original usa el orden predeterminado de JavaScript y muta su entrada. Por lo tanto, la tarea comprueba dos obligaciones distintas: seleccionar el mínimo numérico correcto y evitar cambiar los datos del llamador. Prueba las reglas de conversión explícitamente, porque una solución corta basada en coerción puede aceptar booleanos o null por accidente.
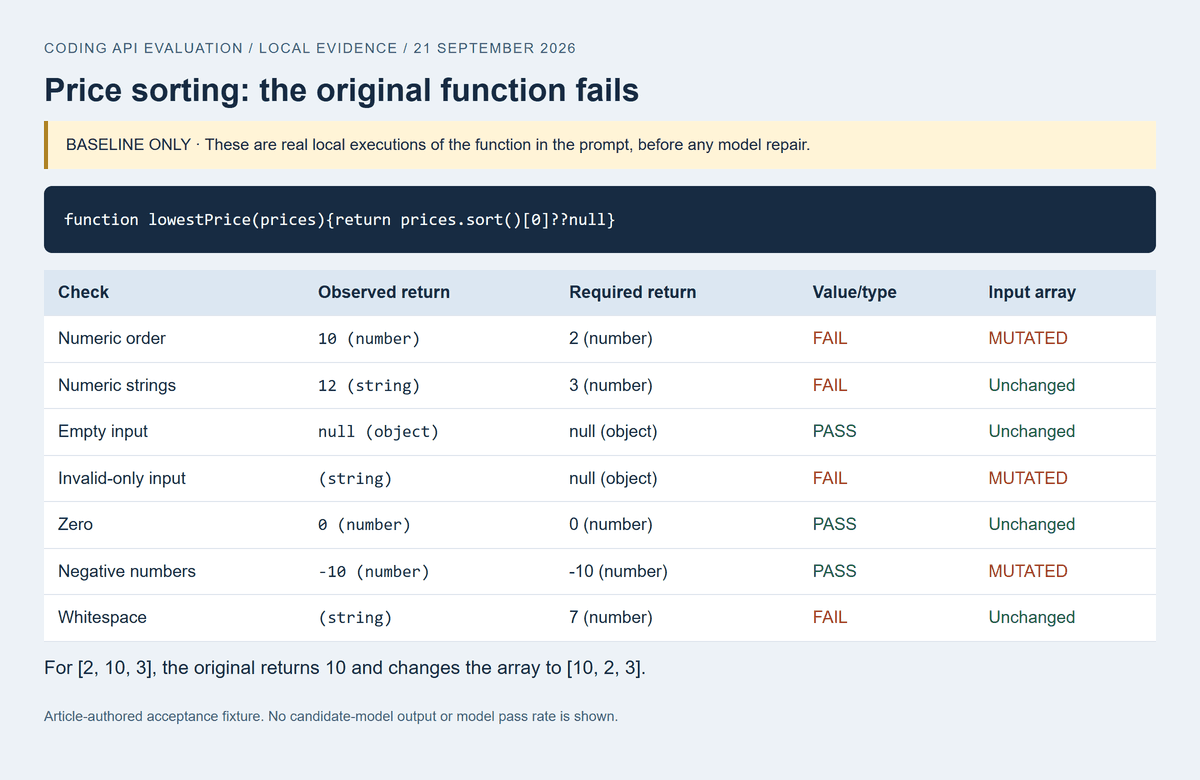 Ejecución local de la función de precios original que muestra ordenamiento numérico incorrecto y entrada mutada
Línea base ejecutada: la función original devuelve 10 para [2,10,3] y cambia el array a [10,2,3]. Las cadenas numéricas también incumplen el contrato del valor de retorno. No se muestra ninguna reparación del modelo.
Tarea B: preservar una interfaz durante una refactorización pequeña. Usa este prompt sin cambios:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Acepta "12" y "0012" como 12. Rechaza "1e2", "1.0", negativos, cero, espacios en blanco, entradas que no sean cadenas y valores más allá del rango de enteros seguros de JavaScript. Verifica la ruta registrada y ambos cuerpos de respuesta. La entrada inválida no debe llegar a findUser.
Esta tarea comprueba si el modelo entiende la diferencia entre la conversión numérica y la gramática de cadenas especificada. Inspecciona el diff en busca de cambios no relacionados, luego llama al controlador con objetos de solicitud y respuesta simulados. Un helper correcto emparejado con un controlador permisivo sin cambios sigue fallando.
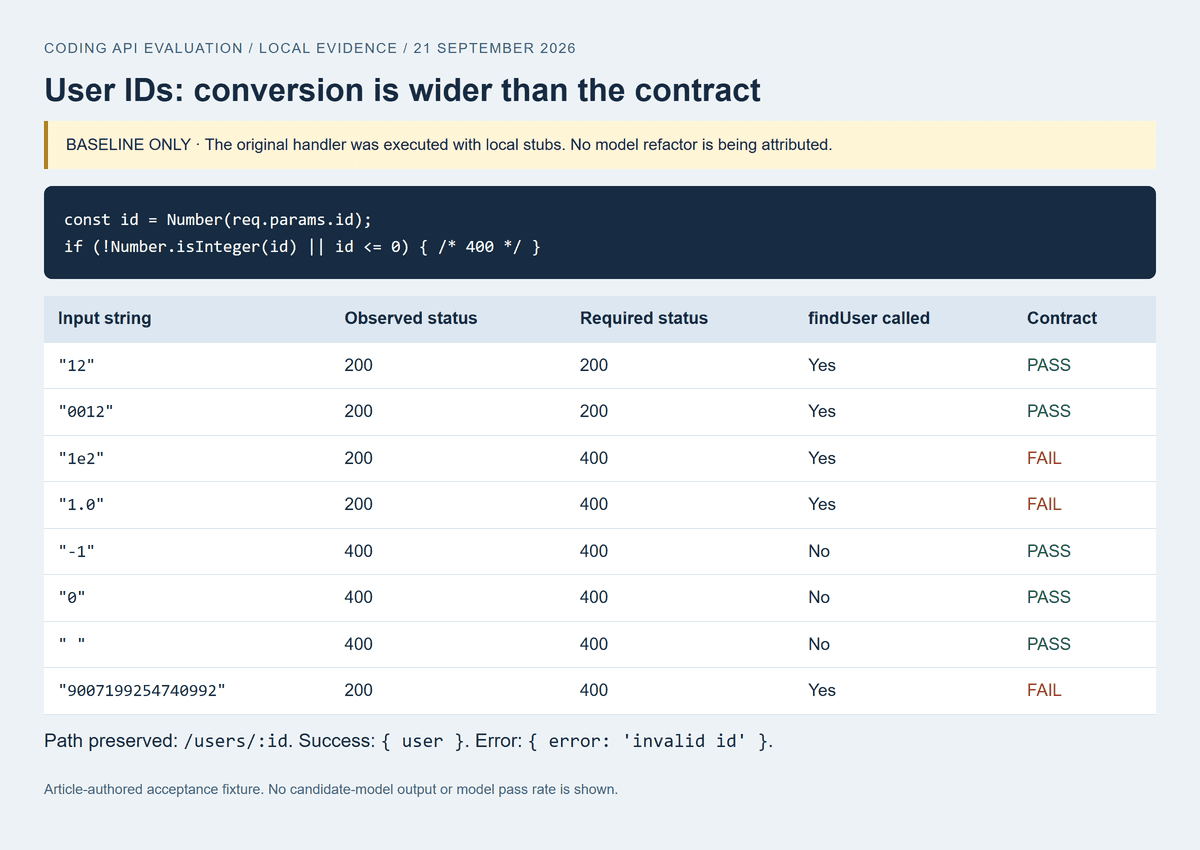 Registro de pruebas del controlador original que muestra cadenas numéricas inválidas aceptadas con estado 200
Línea base ejecutada: el controlador original devuelve 200 para "1e2", "1.0" y "9007199254740992", a pesar de la respuesta 400 requerida. Los stubs locales registraron las llamadas; esto no es una refactorización generada por un modelo.
Tarea C: crear una vista previa de CSV que puedas operar. Envía:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Prueba con estos registros exactos, primero con LF y luego con CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Espera dos columnas, tres filas de datos, la coma de Alice dentro de una celda y la comilla escapada de Bob mostrada correctamente. El valor de Eve debe aparecer como texto literal, sin elemento de imagen, ejecución de eventos ni solicitud de red. Añade una fila con tres campos y confirma que la página informa la discrepancia de forma visible.
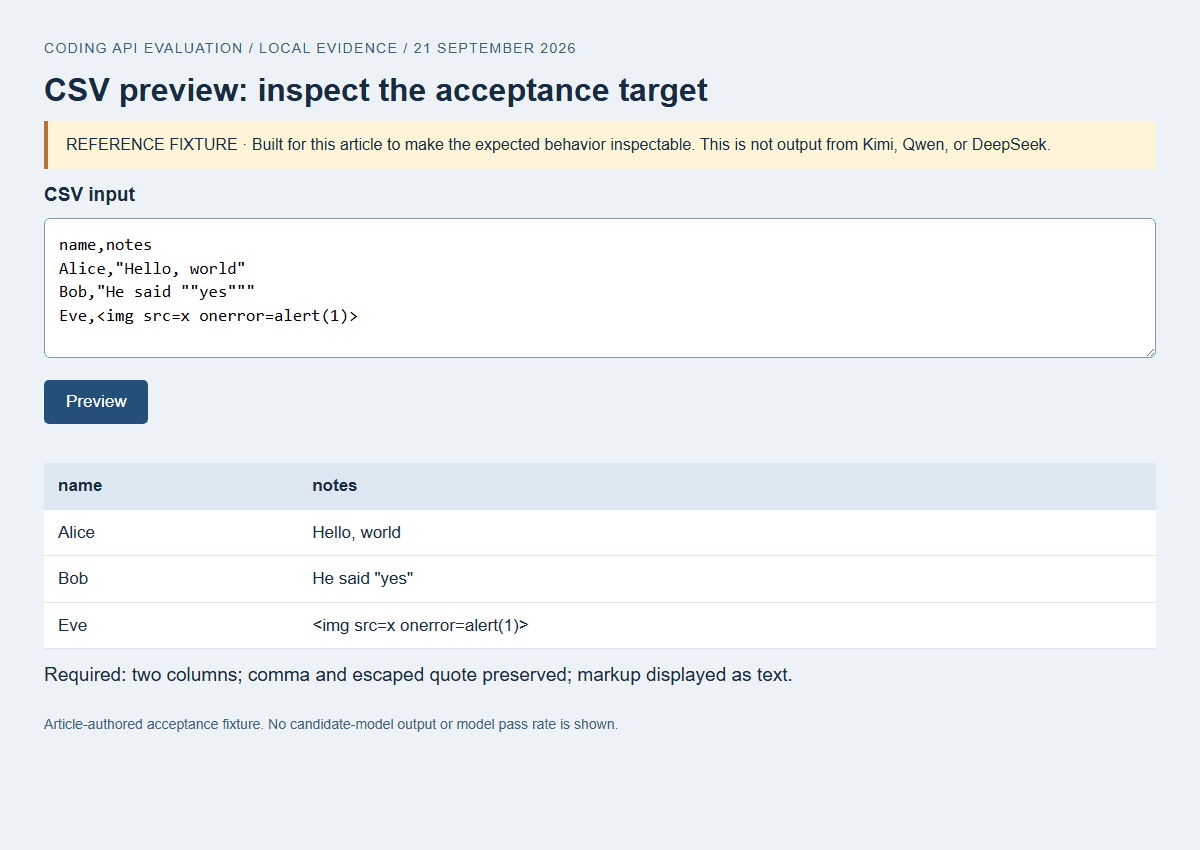 Fixture de aceptación CSV que muestra valores entrecomillados y requisitos de marcado literal
Fixture de referencia operado, creado para este artículo, no generado por un modelo candidato. Las comprobaciones en el navegador verificaron el análisis LF/CRLF, las comillas escapadas, el marcado literal, los errores visibles de recuento de campos y la ausencia de solicitudes HTTP. La captura muestra el estado de entrada válida tras hacer clic en Preview.
Guarda la salida sin procesar, los registros, el ID del modelo, la fecha, los parámetros, los tiempos, las reparaciones y las ediciones manuales. Envía las aserciones fallidas para una reparación sin cambiar los resultados esperados. Conserva los rechazos, los truncamientos y los errores junto a los éxitos.
Mejor API de IA para programar con presupuesto ajustado
Compara las tarifas de tokens junto con la calidad de finalización y el uso. Las entradas repetidas pueden dominar los costos de revisión de código; la generación de archivos completos puede aumentar los cargos de salida. Las reparaciones repetidas añaden ambos.
El catálogo de Atlas y las páginas de detalle exactas mostraron estas tarifas en USD por millón de tokens el 21 de septiembre de 2026:
- DeepSeek V4 Pro: $1.68 de entrada y $3.38 de salida. La ficha separada de V4 Pro 0813 usa tarifas distintas; no la sustituyas.
- Qwen3.5 122B A10B: $0.30 de entrada y $2.40 de salida. El catálogo mostraba tarifas normales de $0.40 y $3.20 con un 25% de descuento, a septiembre de 2026.
- Kimi K3: $3.00 de entrada y $15.00 de salida.
Estas son tarifas de producción mostradas, no facturas de la evaluación del artículo. Las tarifas específicas de caché y su aplicabilidad no se confirmaron. Los descuentos promocionales de DeepSeek y Kimi no se confirmaron. La falta de observación de un descuento no prueba que no exista ninguna oferta.
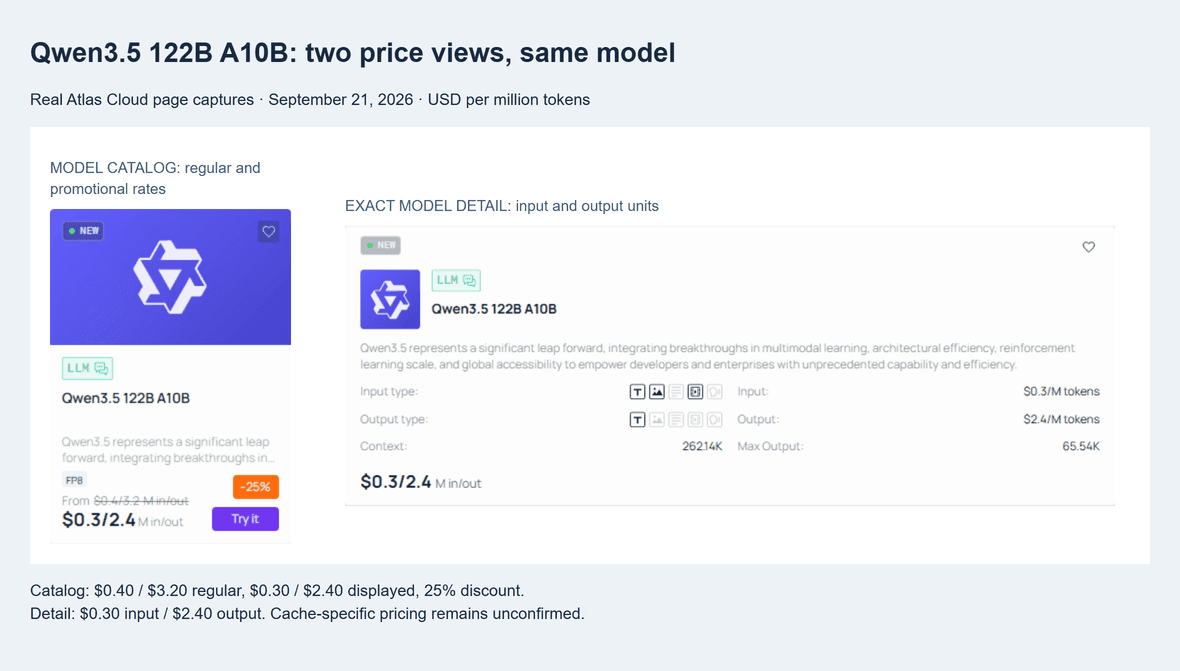 Descuento del catálogo de Qwen3.5 122B A10B junto a sus tarifas exactas de entrada y salida en el detalle del modelo
Verificación cruzada de precios de Qwen, 21 de septiembre de 2026: el catálogo muestra la promoción del 25%; el detalle exacto del modelo confirma $0.30 de entrada y $2.40 de salida por millón de tokens. Las tarifas específicas de caché siguen sin confirmarse.
Calcula la porción del modelo de una tarea como:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
No cobres los tokens en caché otra vez como entrada ordinaria si el registro de facturación los trata por separado. Comprueba si el uso de razonamiento está incluido en la salida facturable. Si no pasa ninguna tarea, informa "ningún resultado exitoso"; dividir entre cero o mostrar un costo de finalización cero induciría a error al lector.
Como ejemplo aritmético transparente, supón 10.000 tokens de entrada ordinarios y 2.000 tokens de salida con las tarifas mostradas de Qwen. El cargo estimado del modelo es $0.0078, antes de cualquier otro elemento aplicable. Esta es una solicitud hipotética, no un uso de tokens observado ni una factura real.
Una reparación del mismo tamaño llevaría la estimación a $0.0156. Las reparaciones reales incluyen contexto y salida diferentes, así que calcula cada solicitud a partir de su uso registrado.
| Tarea | Modelo | Primera pasada | Tras reparación | Uso de tokens | Fuente del costo | Cargo total | Tiempo total | Cambios manuales |
|---|---|---|---|---|---|---|---|---|
| A, B, C; 3 repeticiones de cada una planificadas | DeepSeek V4 Pro | No medido | No medido | No registrado | Sin registro de uso | Desconocido | No medido | Ninguno evaluado |
| A, B, C; 3 repeticiones de cada una planificadas | Qwen3.5 122B A10B | No medido | No medido | No registrado | Sin registro de uso | Desconocido | No medido | Ninguno evaluado |
| A, B, C; 3 repeticiones de cada una planificadas | Kimi K3 | No medido | No medido | No registrado | Sin registro de uso | Desconocido | No medido | Ninguno evaluado |
Para tu propia hoja de cálculo, expande cada fila en una fila por modelo y repetición. Cuenta un éxito reparado una vez en el denominador de tareas aceptadas. Incluye los intentos fallidos en el numerador y conserva columnas separadas de primera pasada y aceptación final.
Rastrea la revisión humana y la infraestructura por separado. Desenredar una reescritura innecesaria puede borrar un ahorro de inferencia. Compara los candidatos que cumplen tanto los requisitos de aceptación como tu presupuesto de tiempo de revisión.
Mejor API de IA para programar con Atlas Cloud
Empieza con la página del modelo Kimi K3, confirma el ID e inspecciona las vistas de API y Code. Mantén la versión elegida junto al registro de pruebas.
Lee la documentación del protocolo LLM antes de tratar dos rutas como intercambiables. Identifica Chat Completions como la ruta de cobertura amplia y dirige a los usuarios a supported_apis de cada modelo. Los controles de muestreo y las características de herramientas también dependen del soporte anunciado del modelo.
Hay detalles concretos de integración que vale la pena comprobar aquí. La documentación dice que las solicitudes traducidas de Anthropic no aplican cache_control, y que las herramientas alojadas por el proveedor no están disponibles en esa ruta traducida. Esas restricciones importan si tu agente existente asume caché nativa o una herramienta de navegación alojada. Empareja el cliente con la ruta real.
El siguiente ejemplo de Node.js ilustra una solicitud de texto. Usa fetch integrado, una variable de entorno para las credenciales y el ID verificado del modelo Kimi. Guarda el prompt exacto de la Tarea A como task-a.txt. Establece la variable de entorno de la URL base con la base de la API de Atlas mostrada en su documentación, terminada en /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages transporta la tarea; model selecciona el despliegue; max_tokens solicita un límite de salida. El lector de respuesta comprueba que haya texto completado ordinario antes de devolver código. El tiempo de espera limita la espera de este ejemplo; no establece que el servidor dejara de procesar ni que no se produjera ningún cargo.
Se omite la temperatura porque el soporte por modelo y el comportamiento comprometido necesitan verificarse. El ejemplo no reintenta automáticamente. Revisa la clase de fallo antes de añadir una política de reintentos acotada, y nunca registres el encabezado de autorización. Este código de publicación no se ejecutó con una clave de API durante la producción del artículo.
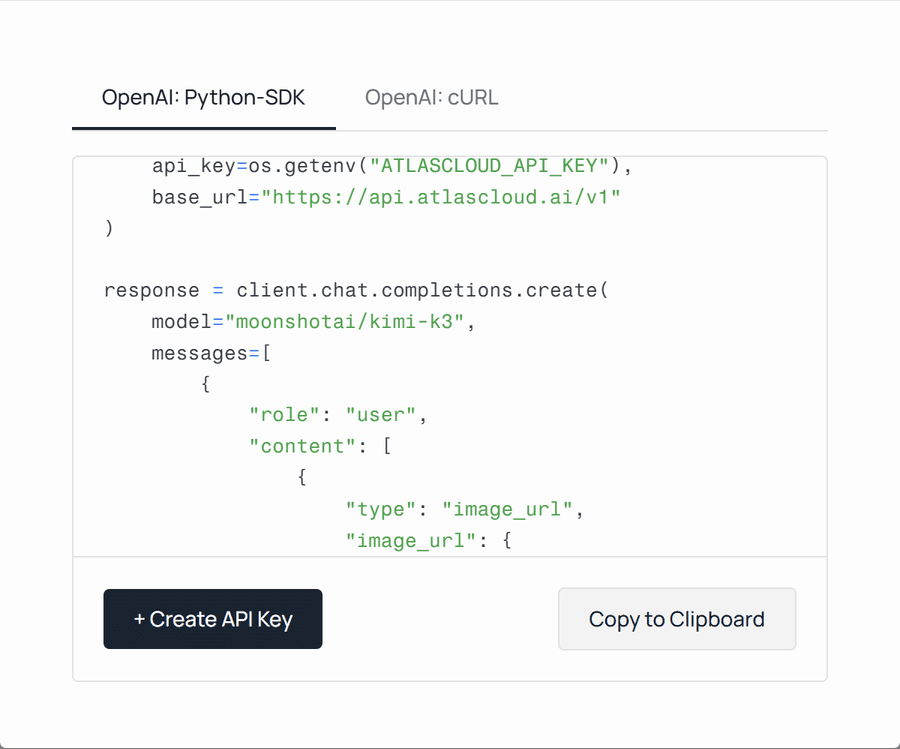 Ejemplo público de código de la API de Kimi K3 que muestra el endpoint de Atlas y el identificador del modelo
Diálogo público de Code de Kimi K3, capturado el 21 de septiembre de 2026. Esto es evidencia de configuración, no una ejecución de programación completada. El ejemplo de la página incluye entrada multimedia; el ejemplo del artículo usa solo texto.
Ejecuta las comprobaciones de aceptación de la Tarea A sobre cualquier función devuelta. Antes de cambiar a DeepSeek o Qwen, verifica su protocolo y parámetros. Mantén los prompts y las pruebas sin cambios mientras comparas la salida y el uso; una forma de solicitud compartida no establece un comportamiento idéntico.
Antes de usar una API de programación en producción
Ejecuta el código generado en una rama desechable o un espacio de trabajo aislado primero. Para la tarea CSV, usa un contexto de navegador local con las solicitudes de red bloqueadas y sin acceso a estado sensible de la aplicación. Para las tareas de repositorio, da al proceso solo los archivos y comandos necesarios para la evaluación.
Define el éxito fuera de la respuesta del modelo. Que un agente diga "todas las pruebas pasaron" debería llevarte a un registro de pruebas real, un código de salida y una revisión comprobada. Guarda el diff con esa evidencia. De lo contrario, una reparación posterior puede cambiar los archivos después del éxito aparente y dejar el informe obsoleto.
Trata los tiempos de espera y los reintentos como comportamiento de aplicación que tú controlas. Establece un plazo de solicitud y un presupuesto total de tarea. Separa los errores causados por credenciales o parámetros inválidos de los fallos transitorios de transporte. Repetir una solicitud inválida desperdicia tiempo; repetir una solicitud que desencadena efectos secundarios puede crear trabajo duplicado.
Cuando el agente puede llamar herramientas, distingue la inspección de solo lectura de las escrituras. Asigna identificadores de operación donde tu diseño de herramientas lo permita, y confirma el estado antes de repetir una escritura incierta. La política de reintentos de un endpoint de modelo no puede garantizar la idempotencia de las herramientas que tu aplicación ejecuta después.
Protege los registros con la misma deliberación que los archivos fuente. Registra IDs de modelo, marcas de tiempo, estado, tiempos y uso sin copiar rutinariamente secretos o repositorios privados completos a la telemetría. Mantén cualquier evidencia de salida sin procesar requerida en una ubicación debidamente restringida, y establece cuánto tiempo necesita conservarla el equipo.
Comprueba el streaming con tu cliente real. Debe manejar eventos parciales, terminación, errores y registros de uso cuando estén disponibles. Confirma los límites de tasa para la cuenta y el despliegue reales. Un experimento tranquilo de un solo usuario no puede establecer cómo se comporta la misma ruta cuando un equipo envía solicitudes a la vez.
Usa esta breve lista de verificación de lanzamiento:
- Las pruebas de aceptación y las regresiones existentes pasan en la revisión final.
- El diff se mantiene dentro del límite de tarea aprobado.
- Se han ejercitado el tiempo de espera, la cancelación y el comportamiento de reintentos.
- Las llamadas a herramientas y las respuestas estructuradas funcionan en el endpoint seleccionado.
- Los registros excluyen credenciales y código privado innecesario.
- Los términos de manejo de datos cumplen los requisitos del equipo.
- Un respaldo tiene su propia configuración verificada y su registro de pruebas.
Los repositorios privados requieren una decisión específica del servicio. Revisa las condiciones actuales de retención, uso para entrenamiento, acceso y contractuales con la persona responsable del código. Envía solo material aprobado. No infieras confidencialidad del hecho de que los pesos del modelo estén disponibles, ni de que un protocolo se parezca a uno que ya usas.
Mejor API de IA para programar: toma tu decisión final
Toma la decisión en tres pasadas.
Primero, elimina los candidatos que carecen de una capacidad requerida. Anota las condiciones que deben cumplirse: un formato de salida aceptado, un bucle de herramientas funcional, un acuerdo de manejo de datos adecuado o un plazo de respuesta viable. Un candidato que incumple una de ellas necesita una decisión de remediación por separado antes de pertenecer a la comparación final.
Segundo, compara el costo por tarea aceptada y el tiempo transcurrido. Usa todos los intentos bajo la misma política de reparación. Separa los éxitos de primera pasada de los éxitos reparados, y muestra los registros de uso faltantes. Si dos modelos cumplen el contrato, compara su carga de revisión además de los cargos del modelo. Tus desarrolladores vivirán con los parches resultantes.
Tercero, mantén un respaldo y define su activador. Los ejemplos incluyen una interrupción sostenida del endpoint, fallos repetidos de salida estructurada o costos de tarea que superan un límite elegido. Prueba la configuración alternativa con antelación. Cambiar un ID de modelo bajo presión puede introducir un segundo problema de integración si sus controles o su comportamiento de respuesta difieren.
Las tres tareas pequeñas de esta guía son un ejercicio de selección. Amplía la suite con trabajo representativo de tu propia base de código antes de confiar en un candidato para cambios amplios. Mantén algunas tareas fuera del ajuste de prompts para poder comprobar si las mejoras se transfieren más allá de los ejemplos que optimizaste.
La mejor API de IA para programar es la combinación que puedes explicar: completa el trabajo requerido, expone costos que puedes rastrear y encaja con la forma en que se ejecuta tu aplicación. No se necesita un ganador universal para tomar esa decisión.
Abre el catálogo actual de modelos, elige dos candidatos y guarda sus IDs y configuraciones exactos. Luego usa la misma tarea, las mismas pruebas y la misma regla de parada para ambos.
Preguntas frecuentes
¿Cuál es la mejor API de IA para programar con un presupuesto ajustado?
Empieza con un candidato cuyas tarifas mostradas encajen en tus volúmenes probables de entrada y salida, luego compara el costo por tarea aceptada. Las filas de Qwen, DeepSeek y Kimi ofrecen versiones concretas que investigar, sin afirmar un ganador de valor probado. Limita los intentos de reparación, reutiliza el contexto relevante de forma deliberada y rastrea las solicitudes fallidas. Incluye el tiempo de revisión por separado para que una factura de inferencia baja no oculte una gran carga de limpieza.
¿Es más barata una suscripción de programación que pagar por tokens de API?
Depende de tu carga de trabajo y de lo que incluya el plan. Una suscripción puede convenir para uso interactivo dentro de su aplicación compatible, mientras que la facturación por uso puede encajar en un servicio personalizado con tráfico variable. Comprueba el acceso a modelos, los límites, la concurrencia y si las llamadas externas a la API están incluidas. Compara la misma cantidad de trabajo útil durante un periodo representativo; un precio mensual de etiqueta y una tarifa de tokens miden cosas distintas.
¿Cuál es la diferencia entre un modelo de programación y un agente de programación?
El modelo genera respuestas. El agente gestiona el bucle alrededor de esas respuestas, incluido el acceso a archivos, la ejecución de herramientas, las pruebas y las reglas de parada. Puedes llamar a un modelo de programación a través de una API sin construir un agente, por ejemplo para sugerir una función para revisión humana. Si quieres ediciones autónomas, evalúa el modelo junto con el agente y los permisos que realmente usará.
¿Qué API de IA debería usar para depuración y refactorización?
Preselecciona candidatos que encajen en tus requisitos de endpoint y manejo de código, luego usa errores pequeños y refactorizaciones restringidas de tu trabajo. La Tarea A comprueba la corrección y la mutación de entrada; la Tarea B comprueba el análisis y la preservación de la interfaz. Síguelas con pruebas de repositorio representativas.
Prefiere el candidato que cumpla tus condiciones de aceptación con un esfuerzo de revisión manejable, en lugar de uno que simplemente produzca la explicación más larga o la reescritura más extensa.
¿Existe una API de IA gratuita para programar?
Un crédito de prueba, una aplicación con nivel gratuito y pesos de modelo descargables son ofertas distintas. Ninguna otorga automáticamente a tu aplicación inferencia alojada ilimitada. Verifica la elegibilidad actual, la caducidad, las cuotas y los modelos compatibles antes de presupuestar en torno al acceso gratuito. Este artículo no afirma que exista una asignación gratuita disponible actualmente.
Si alojas los pesos tú mismo, ten en cuenta el cómputo y la operación incluso cuando descargar los pesos no cueste nada.
¿Puedo enviar código de repositorios privados a una API de programación?
Envía solo código que tu organización te permita compartir bajo los términos aplicables del servicio concreto. Revisa la retención, el uso para entrenamiento, los controles de acceso y los requisitos contractuales del despliegue elegido.
Elimina credenciales y archivos no relacionados, y comprueba qué incluye tu agente automáticamente en los prompts y los registros. Un modelo de pesos abiertos o un formato de API familiar no establece, por sí solo, que un servicio alojado cumpla los requisitos de confidencialidad de tu equipo.


