DeepSeek Harness no formaba parte de ese benchmark. Se lanzó dos días después. Esto significa que la pregunta útil no es «¿cuál ganó?». La pregunta útil es cómo ejecutar la misma tarea con ambas herramientas, en el mismo modelo, y leer la factura sin engañarse.
Conclusiones clave
- La elección del harness puede variar el uso de tokens en aproximadamente 7x en tareas de agente comparables.
- Mide DeepSeek Harness y OpenCode con el mismo modelo y el mismo estado del repositorio.
- Usa claves de API separadas antes de elegir una para el trabajo diario.
Dos portátiles ejecutando la misma tarea de codificación a través de dos harnesses de agente
La configuración justa: un modelo, una tarea, dos terminales.
Lo que nos dice el benchmark público
Composio ejecutó 30 flujos de trabajo complejos multi-aplicación a través de 8 harnesses de agente, todos usando DeepSeek V4 Flash, un límite de 900 segundos por tarea y calificación binaria programática en 240 ejecuciones (Composio, agosto de 2026). Mismo modelo, diferente harness.
| Harness | Tasa de aprobación | Tiempo medio | Tokens promedio por tarea |
|---|---|---|---|
| Pi Agent | 66.7% | 132.2s | 559,000 |
| Prime Agent | 62.5% | 242.1s | 1,400,000 |
| OMP | 56.7% | 272.4s | 742,000 |
| Claude Code | 53.3% | 122.7s | 742,000 |
| Codex | 53.3% | 245.0s | 678,000 |
| DeepAgents | 53.3% | 187.1s | 665,000 |
| Hermes Agent | 50.0% | 175.5s | 192,000 |
| OpenCode | 46.7% | 129.7s | 692,000 |
La columna de tokens importa más que el ranking. La dispersión va desde 192,000 hasta 1,400,000 tokens promedio por tarea. Eso es el mismo modelo haciendo trabajo comparable a través de diferentes runtimes.
OpenCode nos da una línea base con fuente: 692,000 tokens por tarea, 46.7% de tasa de aprobación y 129.7 segundos de tiempo medio. DeepSeek Harness no tiene un número de comparación directa pública de este benchmark porque DeepSeek lo lanzó el 13 de agosto de 2026, dos días después de que se publicara el benchmark.
Usa la tabla como advertencia, no como veredicto. Muestra que el harness puede dominar el costo. No prueba si DeepSeek Harness supera a OpenCode en tu repositorio.
Lo que cambia al cambiar de harness
Antes de probar, compara las dos herramientas por las partes que afectan a un desarrollador en activo: superficie de configuración, madurez, visibilidad de tokens y cuánto del bucle del agente puedes reemplazar.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| De | DeepSeek AI | Anomaly (originalmente SST) |
| Lanzado | 13 de agosto de 2026 | Finales de 2025 |
| Estrellas GitHub | ~143k | ~198k |
| Licencia | MIT | MIT |
| Lenguaje | TypeScript | Go |
| Interfaz | Interfaz web en 127.0.0.1:3080 | TUI de terminal |
| Estado | Vista previa para desarrolladores, se esperan cambios que rompan compatibilidad | Maduro, ampliamente desplegado |
| Arquitectura | Plugins reemplazables para modelos, herramientas, sesiones, sandboxes, almacenamiento, bucles e IU | Núcleo fijo con agentes de construcción/planificación, soporte MCP y extensiones LSP |
| Configuración | $DSH_HOME/settings.yaml | opencode.json |
| Contabilidad de tokens | Medidor de tokens con presión de contexto y proyecciones detalladas | Seguimiento de tokens y costo por sesión en la TUI |
| Mejor para | Equipos que quieren modificar el bucle del agente en sí mismo | Equipos que quieren un agente de codificación que funcione hoy |
OpenCode te da un agente de codificación estable con puntos de extensión alrededor de los bordes. DeepSeek Harness te da un runtime donde el bucle en sí mismo puede intercambiarse. Esa flexibilidad ayuda si estás construyendo infraestructura de agente. Añade riesgo si necesitas una herramienta predeterminada para código de producción esta semana.
Ambas herramientas pueden alcanzar el mismo endpoint compatible con OpenAI. Eso hace posible una prueba justa: un modelo, una URL base, una tarea y un estado inicial del repositorio.
Para este tutorial, DeepSeek V4 Flash se ejecuta a través de Atlas Cloud, que expone un endpoint compatible con OpenAI aceptado por ambas herramientas. La lista de deepseek-v4-flash-0731 muestra $0.14 por millón de tokens de entrada, $0.28 por millón de tokens de salida, una ventana de contexto de 1,048,576 tokens y un máximo de salida de 393,216 a partir de agosto de 2026. Cualquier proveedor funciona si ambos harnesses usan el mismo endpoint y el mismo id de modelo.
OpenCode también publica datos agregados de uso. Los modelos DeepSeek han movido 233 billones de tokens a través de OpenCode, con V4 Flash representando el 85.5% y V4 Pro el 14.5% (OpenCode, agosto de 2026). Ese patrón de uso hace de V4 Flash un valor predeterminado práctico para la comparación.
Paso 1: Apunta ambas herramientas al mismo modelo
Crea una clave de API y una URL base, luego proporciona a ambas herramientas el mismo par. Crea la clave en la consola de Atlas Cloud y expórtala una vez:
plaintext1export ATLAS_API_KEY="tu-clave-de-api" 2
Verifica el endpoint antes de dárselo a cualquiera de los harnesses:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Responde con la única palabra: listo"}] 7 }' 8
Esa llamada prueba que la ruta, la clave y el id del modelo funcionan antes de que un harness agregue herramientas, reintentos o reproducción de conversación.
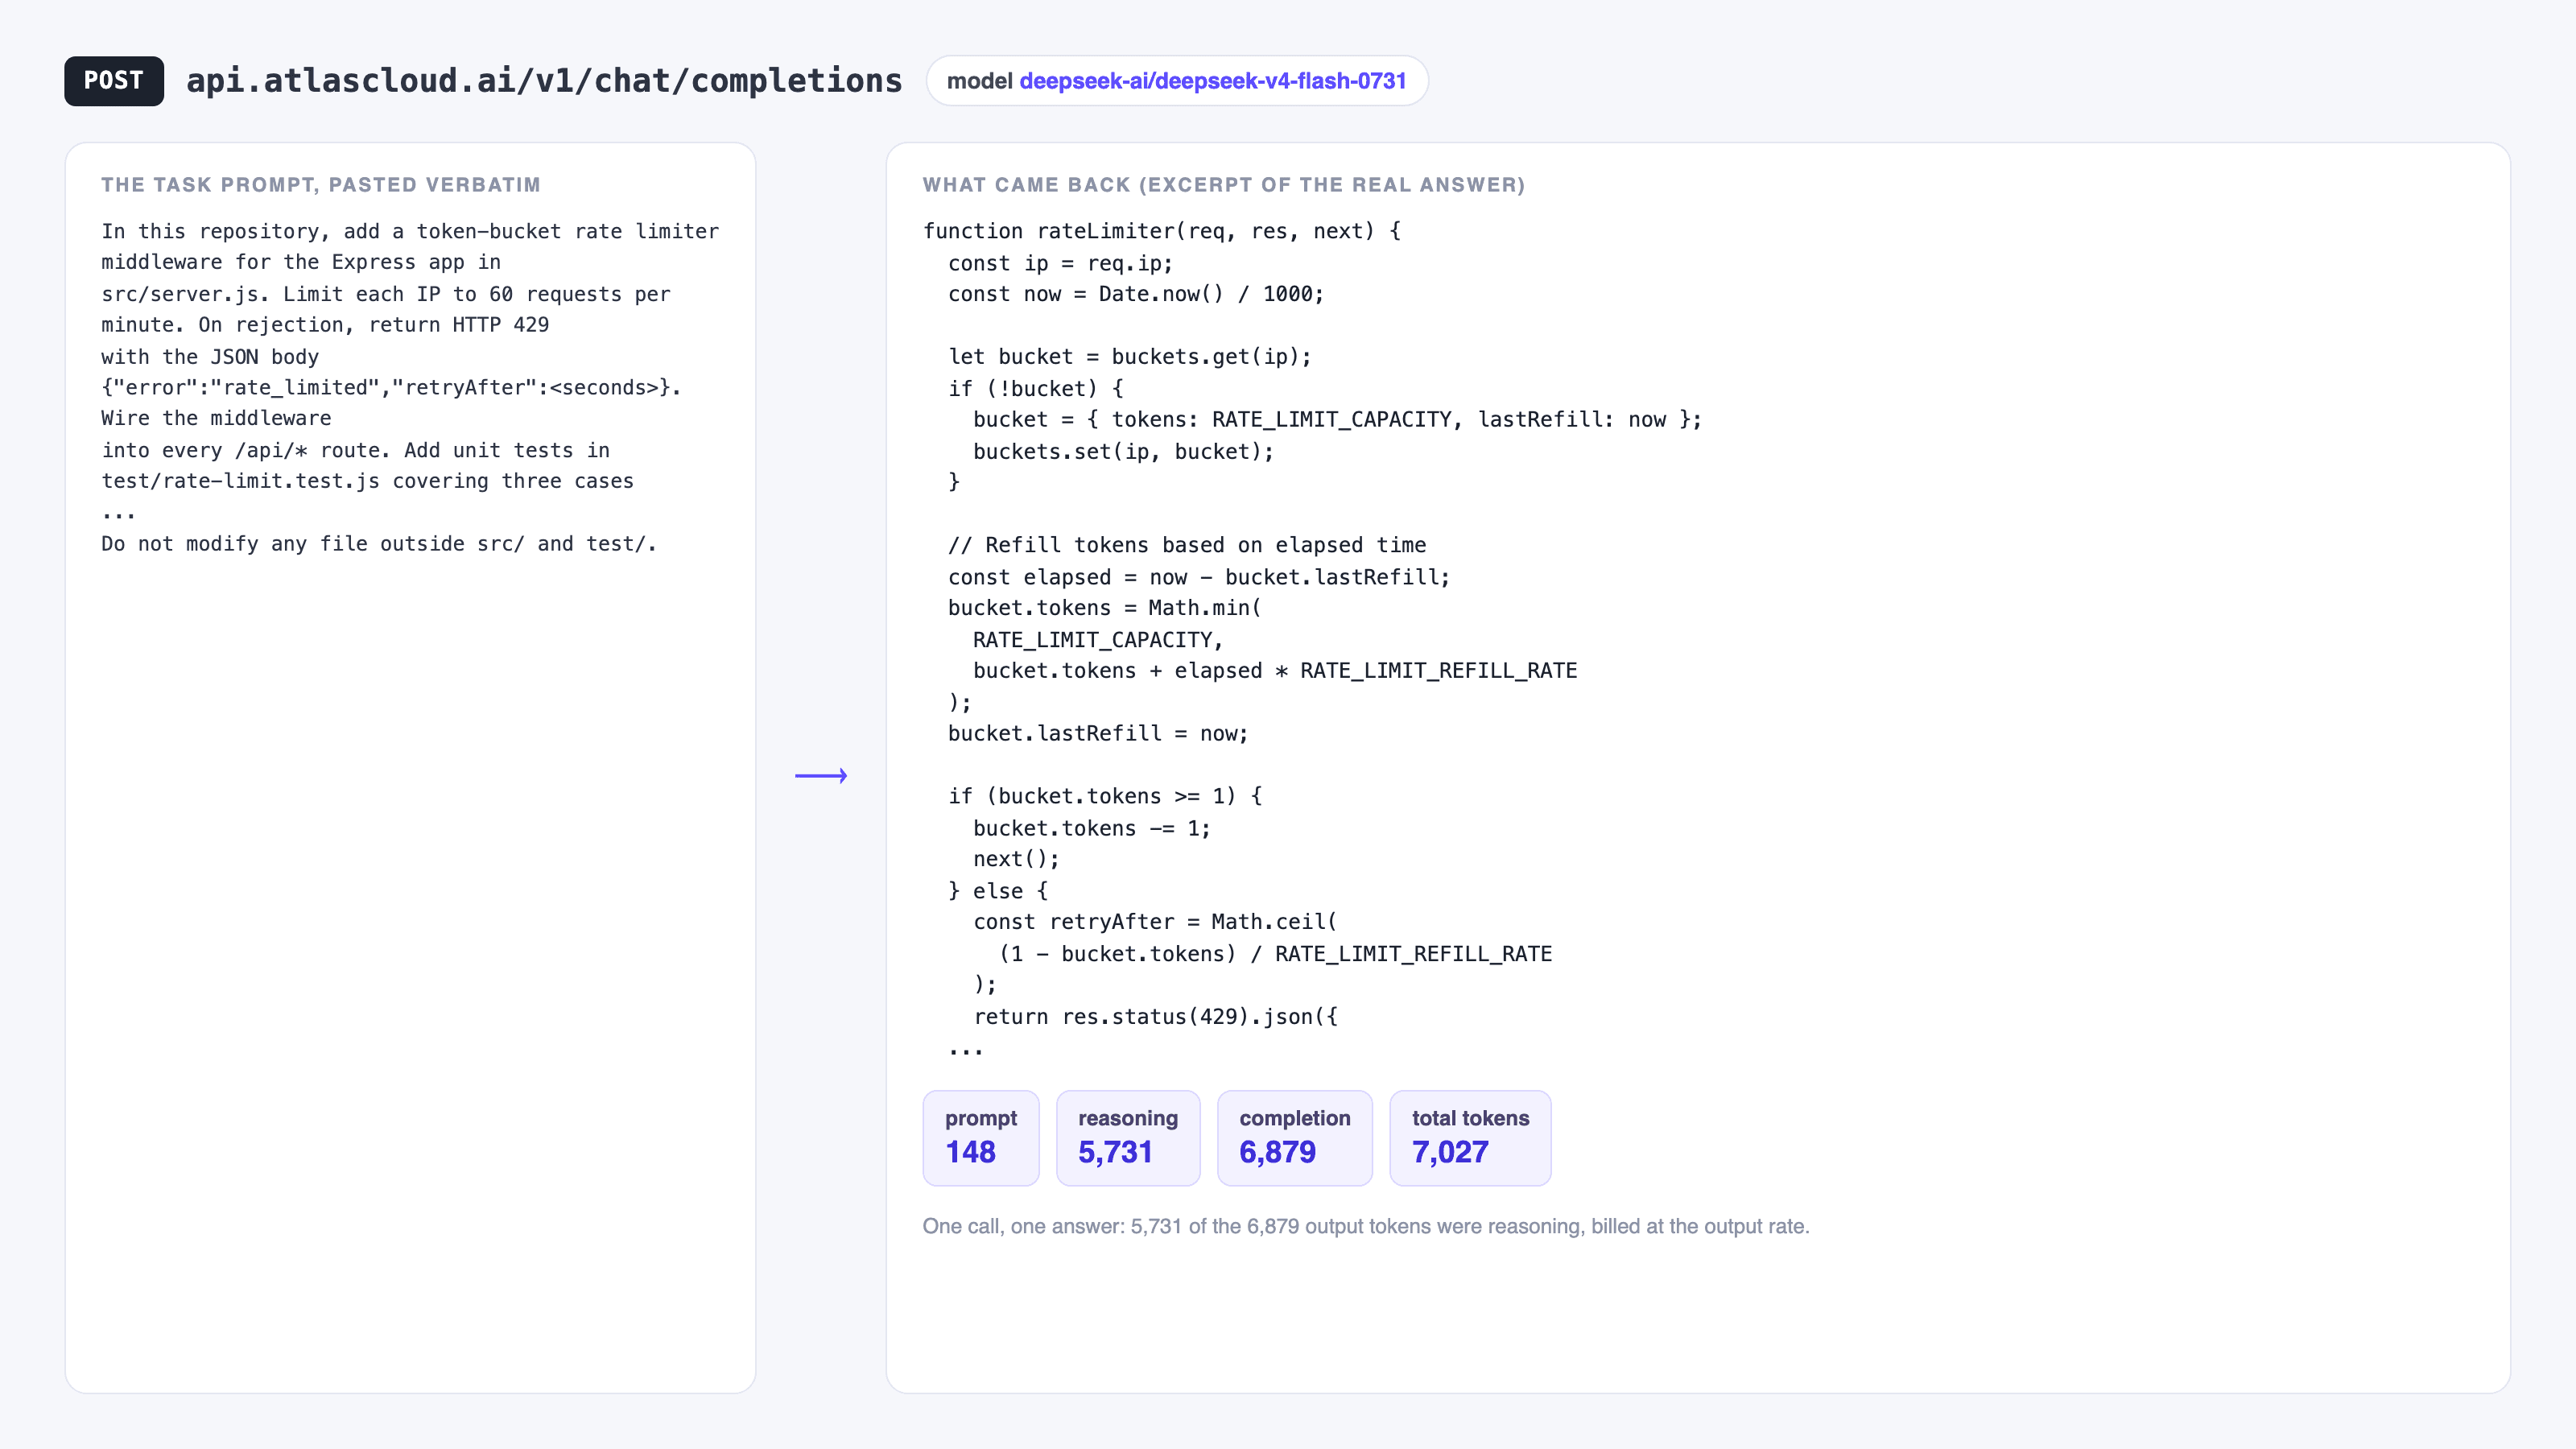
Prompt de codificación, código generado y estadísticas de tokens de una llamada al modelo
Una llamada directa a deepseek-ai/deepseek-v4-flash-0731: 148 tokens de prompt de entrada, 6,879 tokens de salida devueltos, incluyendo 5,731 tokens de razonamiento. Trátalo como el piso antes de que un harness agregue esquemas de herramientas e historial.
DeepSeek Harness lee $DSH_HOME/settings.yaml, y los proveedores personalizados compatibles con OpenAI se colocan bajo el plugin llm-pi-ai (documentación de DeepSeek Harness, agosto de 2026):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
Usa openai-completions para este endpoint. La interfaz web puede escribir el mismo bloque de proveedor desde Configuración, Modelos, Añadir proveedor personalizado, luego almacenar la clave en $DSH_HOME/.credentials.yaml.
OpenCode lee opencode.json en la raíz de tu proyecto o en el directorio de configuración global (documentación de OpenCode, agosto de 2026):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
Usa @ai-sdk/openai-compatible, porque este endpoint sirve /v1/chat/completions. Establece los límites reales de contexto y salida. OpenCode los usa cuando decide cuándo resumir, y límites incorrectos pueden distorsionar la comparación de tokens.
Paso 2: Ejecuta la misma tarea de benchmark en DeepSeek Harness
Elige una tarea lo suficientemente grande como para necesitar varias llamadas a herramientas y lo suficientemente pequeña como para calificarla. Usa el mismo estado del repositorio para ambas ejecuciones, así que haz commit o stash antes de empezar.
Pega esta tarea exacta en ambas herramientas:
plaintext1En este repositorio, agrega un middleware de limitador de velocidad de bucket de tokens para la aplicación 2Express en src/server.js. Limita cada IP a 60 solicitudes por minuto. En caso de rechazo, 3devuelve HTTP 429 con el cuerpo JSON {"error":"rate_limited","retryAfter":<segundos>}. 4Conecta el middleware en cada ruta /api/*. Agrega pruebas unitarias en 5test/rate-limit.test.js que cubran tres casos: se permite una solicitud por debajo del límite, 6se bloquea una solicitud por encima del límite con 429 y el contador se reinicia después 7de que expire la ventana. Ejecuta el conjunto de pruebas y corrige fallos hasta que pase. 8No modifiques ningún archivo fuera de src/ y test/. 9
Inicia Harness desde tu directorio de proyecto:
plaintext1cd /ruta/a/tu/repositorio 2npx @deepseek-ai/dsh web 3
La interfaz se ejecuta en http://127.0.0.1:3080. Selecciona el proveedor atlas y el modelo deepseek-ai/deepseek-v4-flash-0731, pega la tarea y deja que termine. No agregues pistas después de que comience la ejecución. La ayuda extra para una herramienta invalida la comparación.
Cuando Harness termine, abre la vista Trajectory. Ese registro de sesión es donde viven sus números de tokens.
Paso 3: Repite la ejecución en OpenCode
Restablece el repositorio al estado inicial exacto. El segundo harness no debe heredar archivos que el primero ya haya cambiado.
plaintext1git checkout -- . && git clean -fd 2
Luego ejecuta OpenCode contra el mismo modelo:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
Pega el mismo prompt de tarea del Paso 2. Usa el agente build predeterminado. Deja que termine sin pistas.
Califica ambas ejecuciones con el mismo comando:
plaintext1npm test 2
Una ejecución que deja el conjunto en rojo falla, incluso si el resumen del agente suena seguro. Usa calificación binaria: pasa o falla.
Paso 4: Lee el uso de tokens
Ambas herramientas rastrean el uso, pero ningún contador debe ser tu número final de factura.
DeepSeek Harness incluye un medidor de tokens montado por defecto. Expone tokenUsage, contextPressure y contextBreakdown en la vista Trajectory. contextBreakdown te dice si la factura provino del prompt del sistema, esquemas de herramientas, lecturas de archivos o reproducción de conversación. El medidor estima aproximadamente un token por cada cuatro caracteres, así que úsalo como vista de diagnóstico.
OpenCode rastrea tokens y costo por sesión y los imprime en la línea de estado de la TUI. Su desglose integrado es más pequeño, por lo que los equipos que necesitan atribución por herramienta a menudo inspeccionan la base de datos de sesiones con analizadores externos.
Usa los números del lado del proveedor para la comparación:
| Qué comparar | Dónde obtenerlo |
|---|---|
| Total de tokens de entrada | Panel de uso del proveedor, por clave de API |
| Total de tokens de salida | Panel de uso del proveedor, por clave de API |
| Número de llamadas al modelo | Vista Trajectory del harness / registro de sesión de OpenCode |
| Tiempo de reloj de pared | Cronómetro, desde el inicio hasta la última escritura de archivo |
| Pasa o falla | Código de salida de npm test |
Crea dos claves de API, harness-test y opencode-test, y usa cada clave para una ejecución. El panel del proveedor te dará un uso limpio lado a lado sin tener que conciliar dos estimadores internos.
Por qué se mueve la factura
El uso de tokens cambia por razones concretas. Estas cinco suelen importar más que el precio del modelo.
La reproducción de conversación se acumula. Los agentes reenvían la conversación creciente en cada paso. Una tarea de 40 pasos cuesta más cerca de la suma de 40 prompts crecientes que de 40 prompts idénticos. Los harnesses que resumen temprano se acercan al extremo inferior de la dispersión del benchmark.
Los aciertos de caché reducen el costo de entrada. Los aciertos de caché de DeepSeek V4 Flash tienen un precio de alrededor de $0.0028 por millón de tokens frente a $0.14 por millón en un fallo, aproximadamente un 98% más barato. El almacenamiento en caché necesita un prefijo estable byte por byte. Si un harness mezcla el texto del prompt del sistema entre llamadas, convierte aciertos en fallos.
Los esquemas de herramientas viajan con ellos. Veinte servidores MCP conectados significan veinte conjuntos de esquemas en el prompt, incluso si la tarea usa dos de ellos. Desconecta las herramientas que no necesites antes de hacer benchmark, o estarás midiendo tu configuración de herramientas en lugar del harness.
Las salidas grandes de herramientas envenenan el contexto. Un cat de un archivo de 3,000 líneas o un registro de prueba fallida verboso permanece en la conversación para llamadas posteriores. DeepSeek Harness puede podar resultados de herramientas grandes antes de resumir. Actívalo cuando la tarea produzca salida ruidosa.
Los reintentos se esconden dentro del conteo de llamadas. Un harness que reintenta un bucle de prueba fallida gasta tokens cada vez. Compara las llamadas al modelo junto con el total de tokens para poder separar un bucle de reintento de un prompt costoso.
A la tarifa de Atlas Cloud para DeepSeek V4 Flash, una tarea de 692,000 tokens con peso hacia la entrada cuesta unos pocos centavos de dólar. Eso es pequeño para una ejecución y grande en un equipo que ejecuta agentes todo el día. Explora el catálogo de modelos completo si quieres repetir la prueba en un segundo modelo y separar los efectos del modelo de los efectos del harness.
DeepSeek Harness sigue siendo una vista previa para desarrolladores, y su README advierte sobre cambios que rompen compatibilidad. Haz benchmark si quieres control sobre el bucle del agente. Estandarízate en él solo si tu equipo puede absorber la inestabilidad. OpenCode es la opción más estable para equipos que necesitan una herramienta hoy.
Preguntas frecuentes
¿Es DeepSeek Harness mejor que OpenCode?
No para la mayoría de los equipos todavía. OpenCode es maduro, nativo de terminal, tiene aproximadamente 198k estrellas y un gran catálogo de proveedores, y funciona hoy. DeepSeek Harness es más nuevo, está en vista previa para desarrolladores y advierte sobre cambios que rompen compatibilidad. Elige Harness si quieres modificar los internos del agente. Elige OpenCode si quieres un agente de codificación para el trabajo diario.
¿DeepSeek Harness solo funciona con modelos DeepSeek?
No. Es agnóstico respecto al modelo. Incluye proveedores de catálogo para DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure y Codex, y puedes agregar cualquier proveedor personalizado que hable openai-completions, openai-responses o anthropic-messages en $DSH_HOME/settings.yaml. La configuración del Paso 1 lo apunta a un endpoint compatible con OpenAI sin código de adaptador.
¿Cómo verifico el uso de tokens de DeepSeek Harness?
Usa el medidor de tokens integrado en la vista Trajectory. Expone tokenUsage, contextPressure y contextBreakdown. Trátalo como una estimación porque usa aproximadamente un token por cada cuatro caracteres. Para precisión de facturación, lee el panel de uso del proveedor, idealmente con una clave de API dedicada para cada ejecución.
¿Qué harness usa menos tokens, DeepSeek Harness u OpenCode?
Ningún benchmark público cara a cara responde eso todavía. El benchmark de Composio midió OpenCode en 692,000 tokens promedio por tarea, pero se ejecutó antes de que DeepSeek Harness se lanzara. Ejecuta la prueba del Paso 2 al Paso 4 en tu propio repositorio porque el uso de tokens depende del tamaño del código base, la configuración de herramientas y la forma de la tarea.
¿Puedo ejecutar DeepSeek Harness y OpenCode contra la misma clave de API?
Sí, para una prueba casual. Para una medición limpia, usa dos claves separadas, una por harness. El panel del proveedor atribuirá entonces cada token a la ejecución correcta.
¿Cuál es la diferencia entre un agente y un harness?
DeepSeek describe un agente como Modelo más Harness. El modelo razona. El harness conecta el modelo con archivos, comandos de shell, herramientas, sesiones, aprobaciones y el bucle que decide la siguiente acción. Cambia el harness y el mismo modelo puede gastar un número diferente de tokens en la misma tarea.


