

Un archivo de proyecto de 900 páginas es fácil de subir. La pregunta más difícil es si el modelo puede señalar la cláusula, el commit o el punto de datos exacto que necesita. Los casos de uso de la ventana de contexto de 1M de DeepSeek V4.1 Flash tienen sentido cuando se deben considerar juntas varias fuentes relacionadas, como una base de código, un corpus de investigación o años de registros de proyectos. La ventana más grande reduce la necesidad de dividir esos materiales de antemano, mientras que las comprobaciones de evidencia siguen determinando si una respuesta es confiable.
Los mejores escenarios son la revisión de código entre archivos, la síntesis de investigación, la comparación de políticas, el análisis de comentarios, las cronologías de proyectos y los registros multimodales largos. DeepSeek indica un contexto de 1M de tokens, pero esa capacidad no garantiza que cada detalle se recuerde con precisión. Verifique los límites del modelo y de la API para su ruta, luego pruebe su propio material antes de confiar en el resultado.
Puntos clave
- Use una ventana de un millón de tokens cuando la pregunta dependa de relaciones entre muchas fuentes relevantes.
- Solicite referencias de archivo, sección o página y separe la evidencia directa de la inferencia.
- Comience con una prueba de respuesta conocida y amplíe el contexto solo cuando mejore el resultado.
- Estime el costo a partir de la entrada, la salida y el tratamiento de caché, no solo del límite de contexto.
¿Qué significa una ventana de contexto de 1M de tokens?
Una ventana de contexto es la cantidad de información que un modelo puede considerar en una solicitud o estado de conversación, incluido el material proporcionado y las instrucciones circundantes. La página de precios actual de la API de DeepSeek incluye DeepSeek-V4.1-Flash con una longitud de contexto de 1M y una salida máxima de 384K tokens. Ese es el límite declarado por el proveedor; su aplicación, endpoint o configuración de solicitud puede imponer un límite menor. ( Documentación de la API de DeepSeek )
Los tokens son piezas de texto, no palabras ni páginas. Un archivo fuente que contenga código, tablas, marcado, texto repetitivo y escaneos puede tokenizarse de forma muy diferente a la prosa limpia de la misma cantidad de páginas. Para una carga de trabajo real, estime los tokens con el tokenizador o el informe de uso de la API que va a llamar. Incluya las instrucciones del sistema, los nombres de archivo, los metadatos, el texto de la pregunta y el presupuesto de respuesta en su estimación.
El beneficio práctico es la continuidad. Puede preguntar sobre dependencias entre varios módulos o contradicciones entre una política actual y sus apéndices sin tener que unir resúmenes manualmente primero. La contrapartida es que un prompt muy grande puede contener material irrelevante o duplicado, tardar más en procesarse y, aun así, dificultar la recuperación exacta. Trate “cabe en la ventana” como una verificación de capacidad, luego pruebe si el modelo puede encontrar los hechos que su tarea necesita.
Los mejores casos de uso del contexto de 1M de DeepSeek V4.1 Flash
La pregunta correcta no es “¿Puedo subir todo?”. Es “¿Qué fuentes deben compararse para responder esto?”. Use un contexto largo cuando la respuesta dependa de vínculos entre materiales, y defina cómo verificará esa respuesta antes de enviar el archivo completo.
| Caso de uso | Por qué ayuda un contexto largo | Qué incluir | Qué verificar |
|---|---|---|---|
| Revisión de base de código grande | Las interfaces y convenciones abarcan módulos | Fuente relevante, pruebas, notas de arquitectura | Rutas de archivo, símbolos, evidencia de pruebas |
| Síntesis de investigación | Los métodos y hallazgos necesitan comparación lado a lado | Artículos, informes, limitaciones | Fuente y salvedades de cada afirmación |
| Comparación de contratos o políticas | Las definiciones y excepciones se repiten en las secciones | Versiones actuales y anteriores, apéndices | Números de cláusula y redacción exacta |
| Análisis de comentarios | Los temas aparecen en muchos comentarios | Comentarios anonimizados y reglas de codificación | Citas representativas y método de conteo |
| Cronología del historial del proyecto | Las decisiones evolucionan en los registros de reuniones | Actas, registros de decisiones, notas de versión | Fechas, responsables, registros en conflicto |
| Revisión de incidentes largos | Los registros, tickets y postmortems explican diferentes etapas | Rango de tiempo relevante y documentos del incidente | Marca de tiempo, fuente del evento, incertidumbre |
| Revisión de documentos multimodales | La evidencia textual y visual puede requerir lectura conjunta | Imágenes compatibles y sus pies de foto o contexto | Si el endpoint admite el tipo de medio |
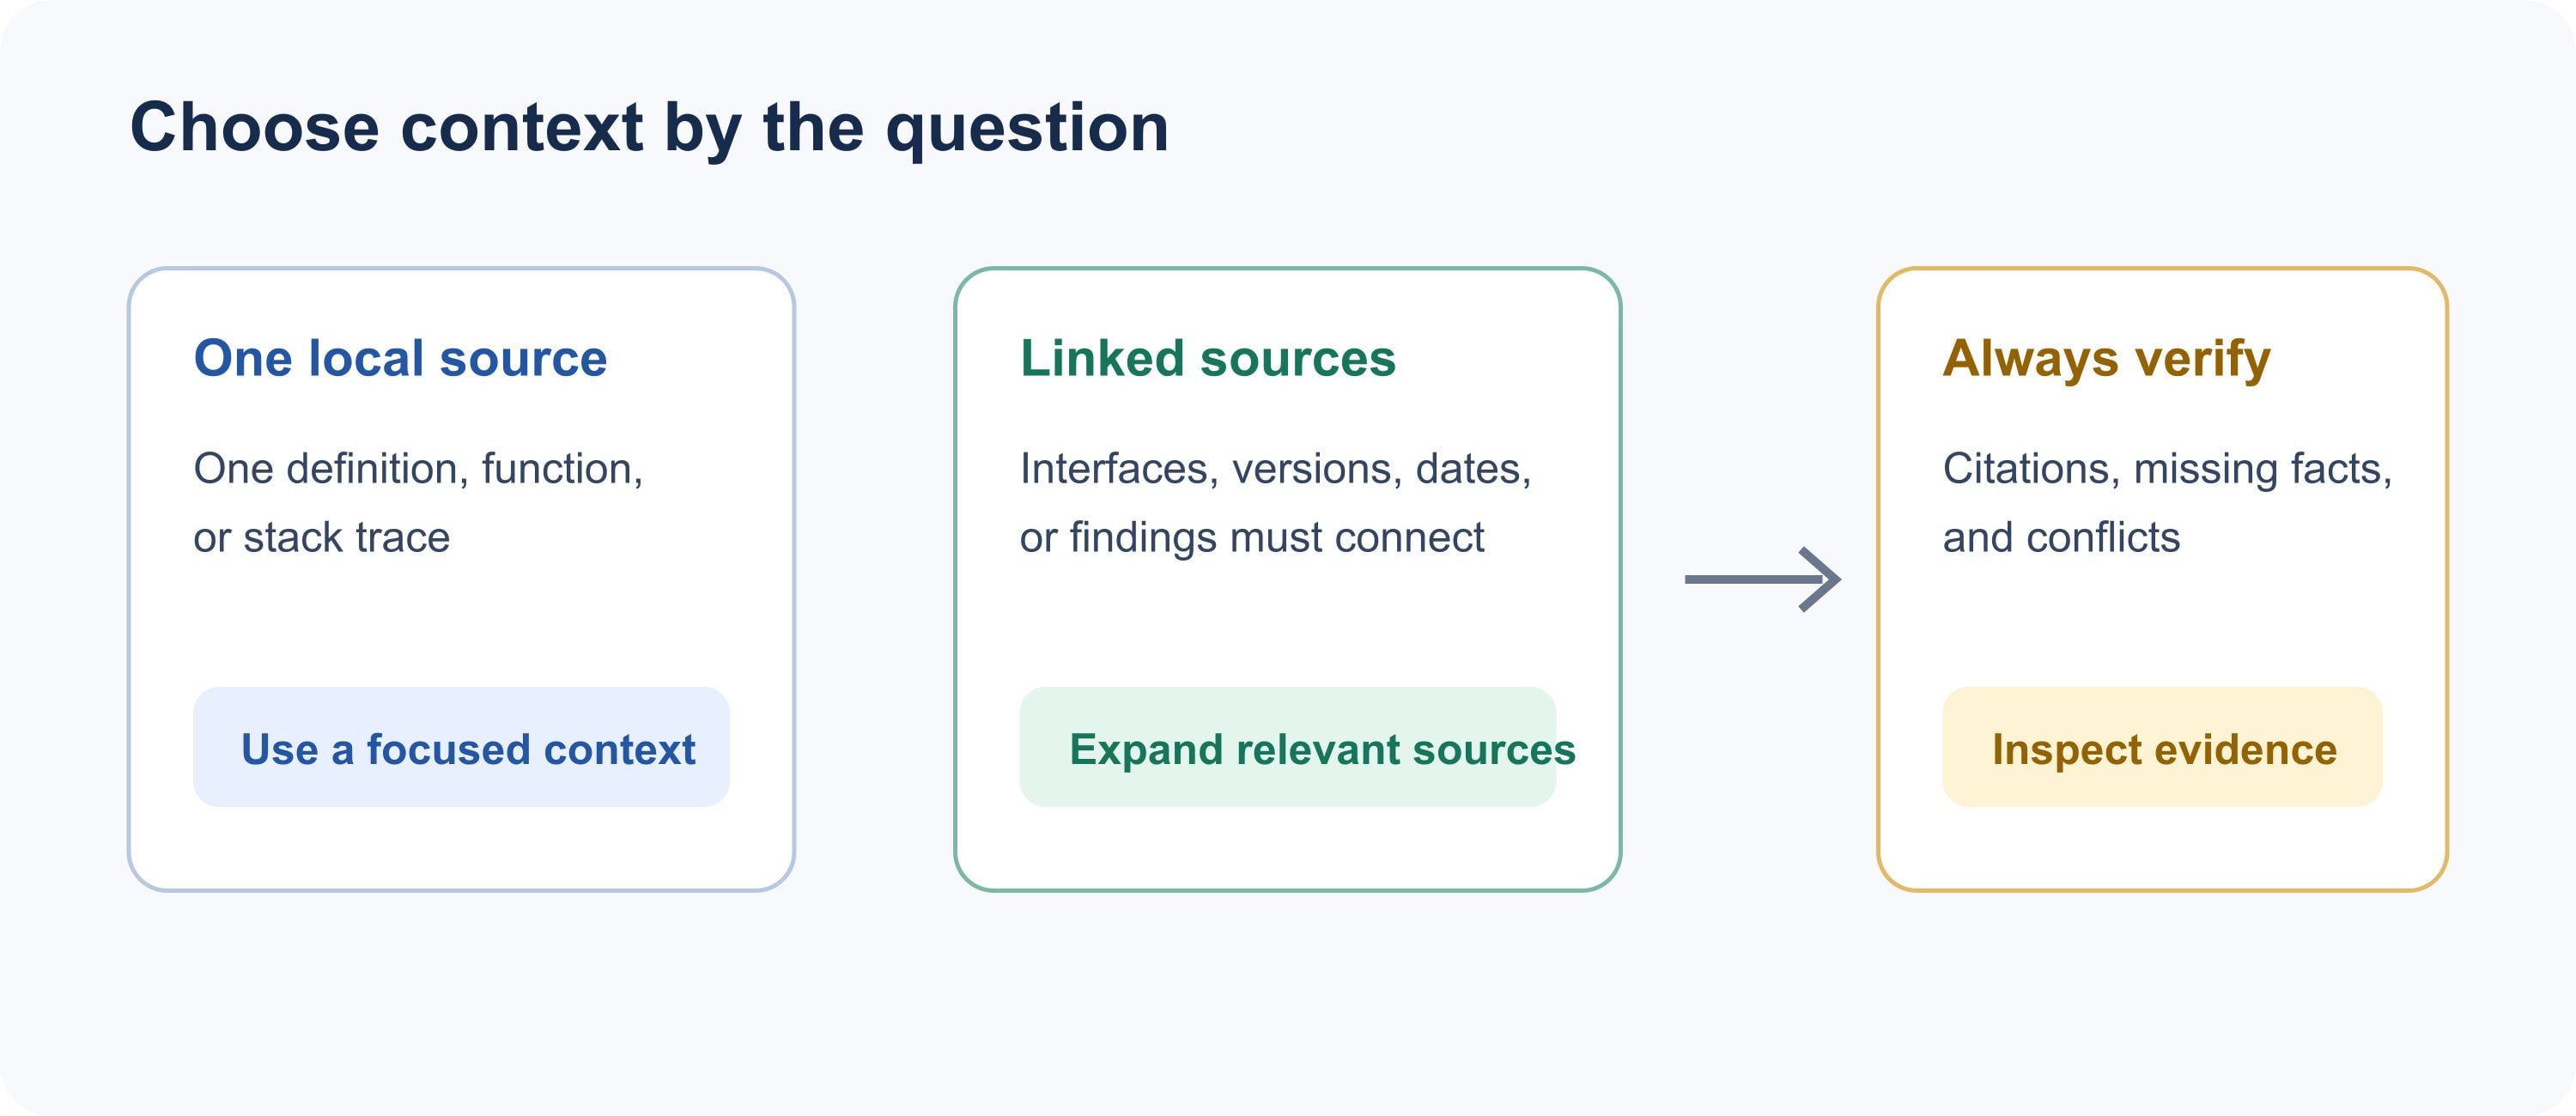
Use un contexto enfocado para una pregunta local; amplíe cuando las fuentes deban conectarse, luego inspeccione la evidencia.
Revisión de una base de código grande entre archivos
Un contexto de un millón de tokens puede ayudar a un ingeniero a rastrear una estructura de datos desde un límite de API a través de la lógica de servicio, el almacenamiento y las pruebas. Es útil para resúmenes de arquitectura, encontrar módulos probablemente afectados y redactar un plan de refactorización que respete las convenciones documentadas en varios lugares.
De al modelo una instantánea acotada del repositorio en lugar de un volcado de disco sin filtrar. Incluya archivos fuente relevantes para el cambio, las pruebas más cercanas, manifiestos de dependencias y notas de arquitectura. Excluya los resultados de compilación, dependencias de terceros, paquetes generados y copias duplicadas a menos que la pregunta se refiera a ellos. Solicite rutas de archivo y nombres de símbolos para cada dependencia propuesta, además de una distinción entre el comportamiento observado y una suposición.
Use la salida como un plan de revisión. Confirme que cada símbolo citado existe, inspeccione las líneas citadas y ejecute las comprobaciones del proyecto usted mismo. El modelo no debería afirmar que las pruebas pasaron a menos que una herramienta realmente las ejecutara y devolviera el resultado. Para un error localizado en una función, un contexto más pequeño suele ser más rápido y fácil de auditar.
Sintetizar investigación entre artículos e informes
Un contexto largo ayuda cuando los estudios usan métodos, poblaciones, medidas o definiciones diferentes. Solicite una tabla comparativa con una fila por fuente y columnas para pregunta de investigación, datos, método, resultado, limitaciones y relevancia para su pregunta. Mantenga las afirmaciones a nivel de fuente vinculadas a su fuente en lugar de dejar que un resumen combinado borre el desacuerdo.
Por ejemplo, al comparar evaluaciones de una herramienta, distinga un resultado de benchmark de un estudio de campo y de la interpretación de un autor. Pida al modelo que señale medidas incompatibles en lugar de clasificar resultados que no se pueden comparar. Luego abra los pasajes de origen detrás de las afirmaciones más relevantes para la decisión. Una síntesis es un mapa de evidencia, no un sustituto de revisar los artículos.
Comparar contratos, políticas o especificaciones largas
Los contratos y las políticas a menudo definen un término una vez y lo califican en otro lugar. Proporcionar juntos la versión operativa, las enmiendas, los anexos y el borrador anterior relevante puede ayudar a descubrir definiciones cambiadas, referencias cruzadas, condiciones faltantes y conflictos aparentes.
Solicite la sección o cláusula exacta para cada observación y un extracto breve que un revisor pueda localizar. Separe las diferencias textuales de sus posibles consecuencias. El modelo puede ayudar a organizar una revisión, pero la interpretación legal, las decisiones de cumplimiento y la autoridad de firma siguen siendo de personas calificadas que puedan tener en cuenta la jurisdicción y el contexto.
Analizar comentarios de clientes a escala
Un gran volumen de comentarios puede revelar solicitudes y objeciones recurrentes en distintos canales o períodos de tiempo. Proporcione una muestra definida, elimine la información personal que no sea necesaria y especifique un esquema de codificación como “fricción de incorporación”, “integración faltante” o “confusión de precios”. Solicite ejemplos representativos y contraejemplos, no solo una lista de temas.
No presente porcentajes de temas generados por el modelo como estadísticas de encuesta. Si necesita recuentos, defina la unidad (mensaje, cliente o incidencia), deduplique los registros, aplique una regla de etiquetado consistente y verifique el recuento con un script repetible o una muestra revisada por humanos. El modelo es útil para proponer categorías y encontrar ejemplos; un método documentado respalda las afirmaciones cuantitativas.
Construir una cronología a partir de documentos de proyecto
Para un traspaso o postmortem, la evidencia relevante puede estar dispersa en actas de reuniones, notas de versión, registros de decisiones y tickets. Solicite una tabla cronológica con fecha, evento, responsable nombrado cuando se indique, ubicación de la fuente y confianza o ambigüedad. Indique al modelo que preserve las fechas en conflicto en lugar de elegir una en silencio.
Una cronología útil ayuda a un nuevo miembro del equipo a ver qué se decidió, cuándo cambió un requisito y qué documento respalda cada evento. Verifique las transiciones críticas contra el registro de origen, especialmente cuando una nota se escribió más tarde o resume una reunión en lugar de registrarla directamente.
Revisar registros de incidentes largos y material multimodal
La revisión de incidentes puede beneficiarse de mantener alertas, notas operativas, tickets y el postmortem en un solo conjunto de evidencia. Solicite una secuencia de eventos observados y distinga explícitamente las marcas de tiempo en los registros de las estimaciones posteriores en notas narrativas. Esto puede hacer que la primera pasada sea más coherente, mientras que el ingeniero de guardia aún verifica los sistemas de origen antes de actuar.
El anuncio oficial de DeepSeek dice que V4.1-Flash está disponible en su API con soporte multimodal nativo. Los formatos de imagen exactos, los métodos de solicitud y los límites dependen del endpoint y la integración, así que confirme esos detalles antes de asumir que un presupuesto de texto de un millón de tokens también describe el manejo de imágenes. ( Anuncio de DeepSeek V4.1-Flash )
¿Cuándo ayuda un millón de tokens y cuándo añade ruido?
Más contexto ayuda cuando las fuentes deben ser referenciadas de forma cruzada. Un cambio de código que involucra una interfaz compartida puede requerir varios módulos y pruebas. Una comparación de versiones necesita ambas versiones completas y sus apéndices. Una cronología de proyecto puede necesitar registros distribuidos a lo largo de meses.
Un error local con un stack trace claro puede necesitar solo la función, sus llamadores y la prueba relevante. Una pregunta que solicita una definición puede necesitar solo la sección autorizada. Para esas tareas, incluir un repositorio completo añade espacio de búsqueda y puede enterrar el pasaje útil.
Antes de expandir el prompt, elimine exportaciones repetidas, borradores obsoletos, carpetas no relacionadas, texto repetitivo y registros fuera del rango de tiempo de la pregunta. Mantenga un manifiesto de lo que incluyó y por qué. Si la respuesta cambia cuando agrega un lote grande de archivos no relacionados, eso es una señal para ajustar el conjunto de fuentes y volver a ejecutar la prueba.
Un flujo de trabajo práctico para respuestas confiables con contexto largo
Use un protocolo de evidencia consistente para que una respuesta fluida no se confunda con una verificada. Primero etiquete las fuentes con nombres de archivo estables y, cuando sea posible, números de página, encabezados, números de línea, fechas o identificadores de versión. Preserve suficiente contexto circundante para interpretar los extractos correctamente.
Luego, plantee una decisión o pregunta de investigación. Especifique la forma de salida y las ubicaciones que el modelo debe citar. Un prompt reutilizable es:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
Para una base de código, agregue: “Cite rutas del repositorio y nombres de funciones o clases. Antes de proponer un cambio, enumere los archivos afectados y la evidencia de prueba que respalda la propuesta. No diga que se ejecutó una prueba a menos que su resultado esté incluido en la evidencia proporcionada.”
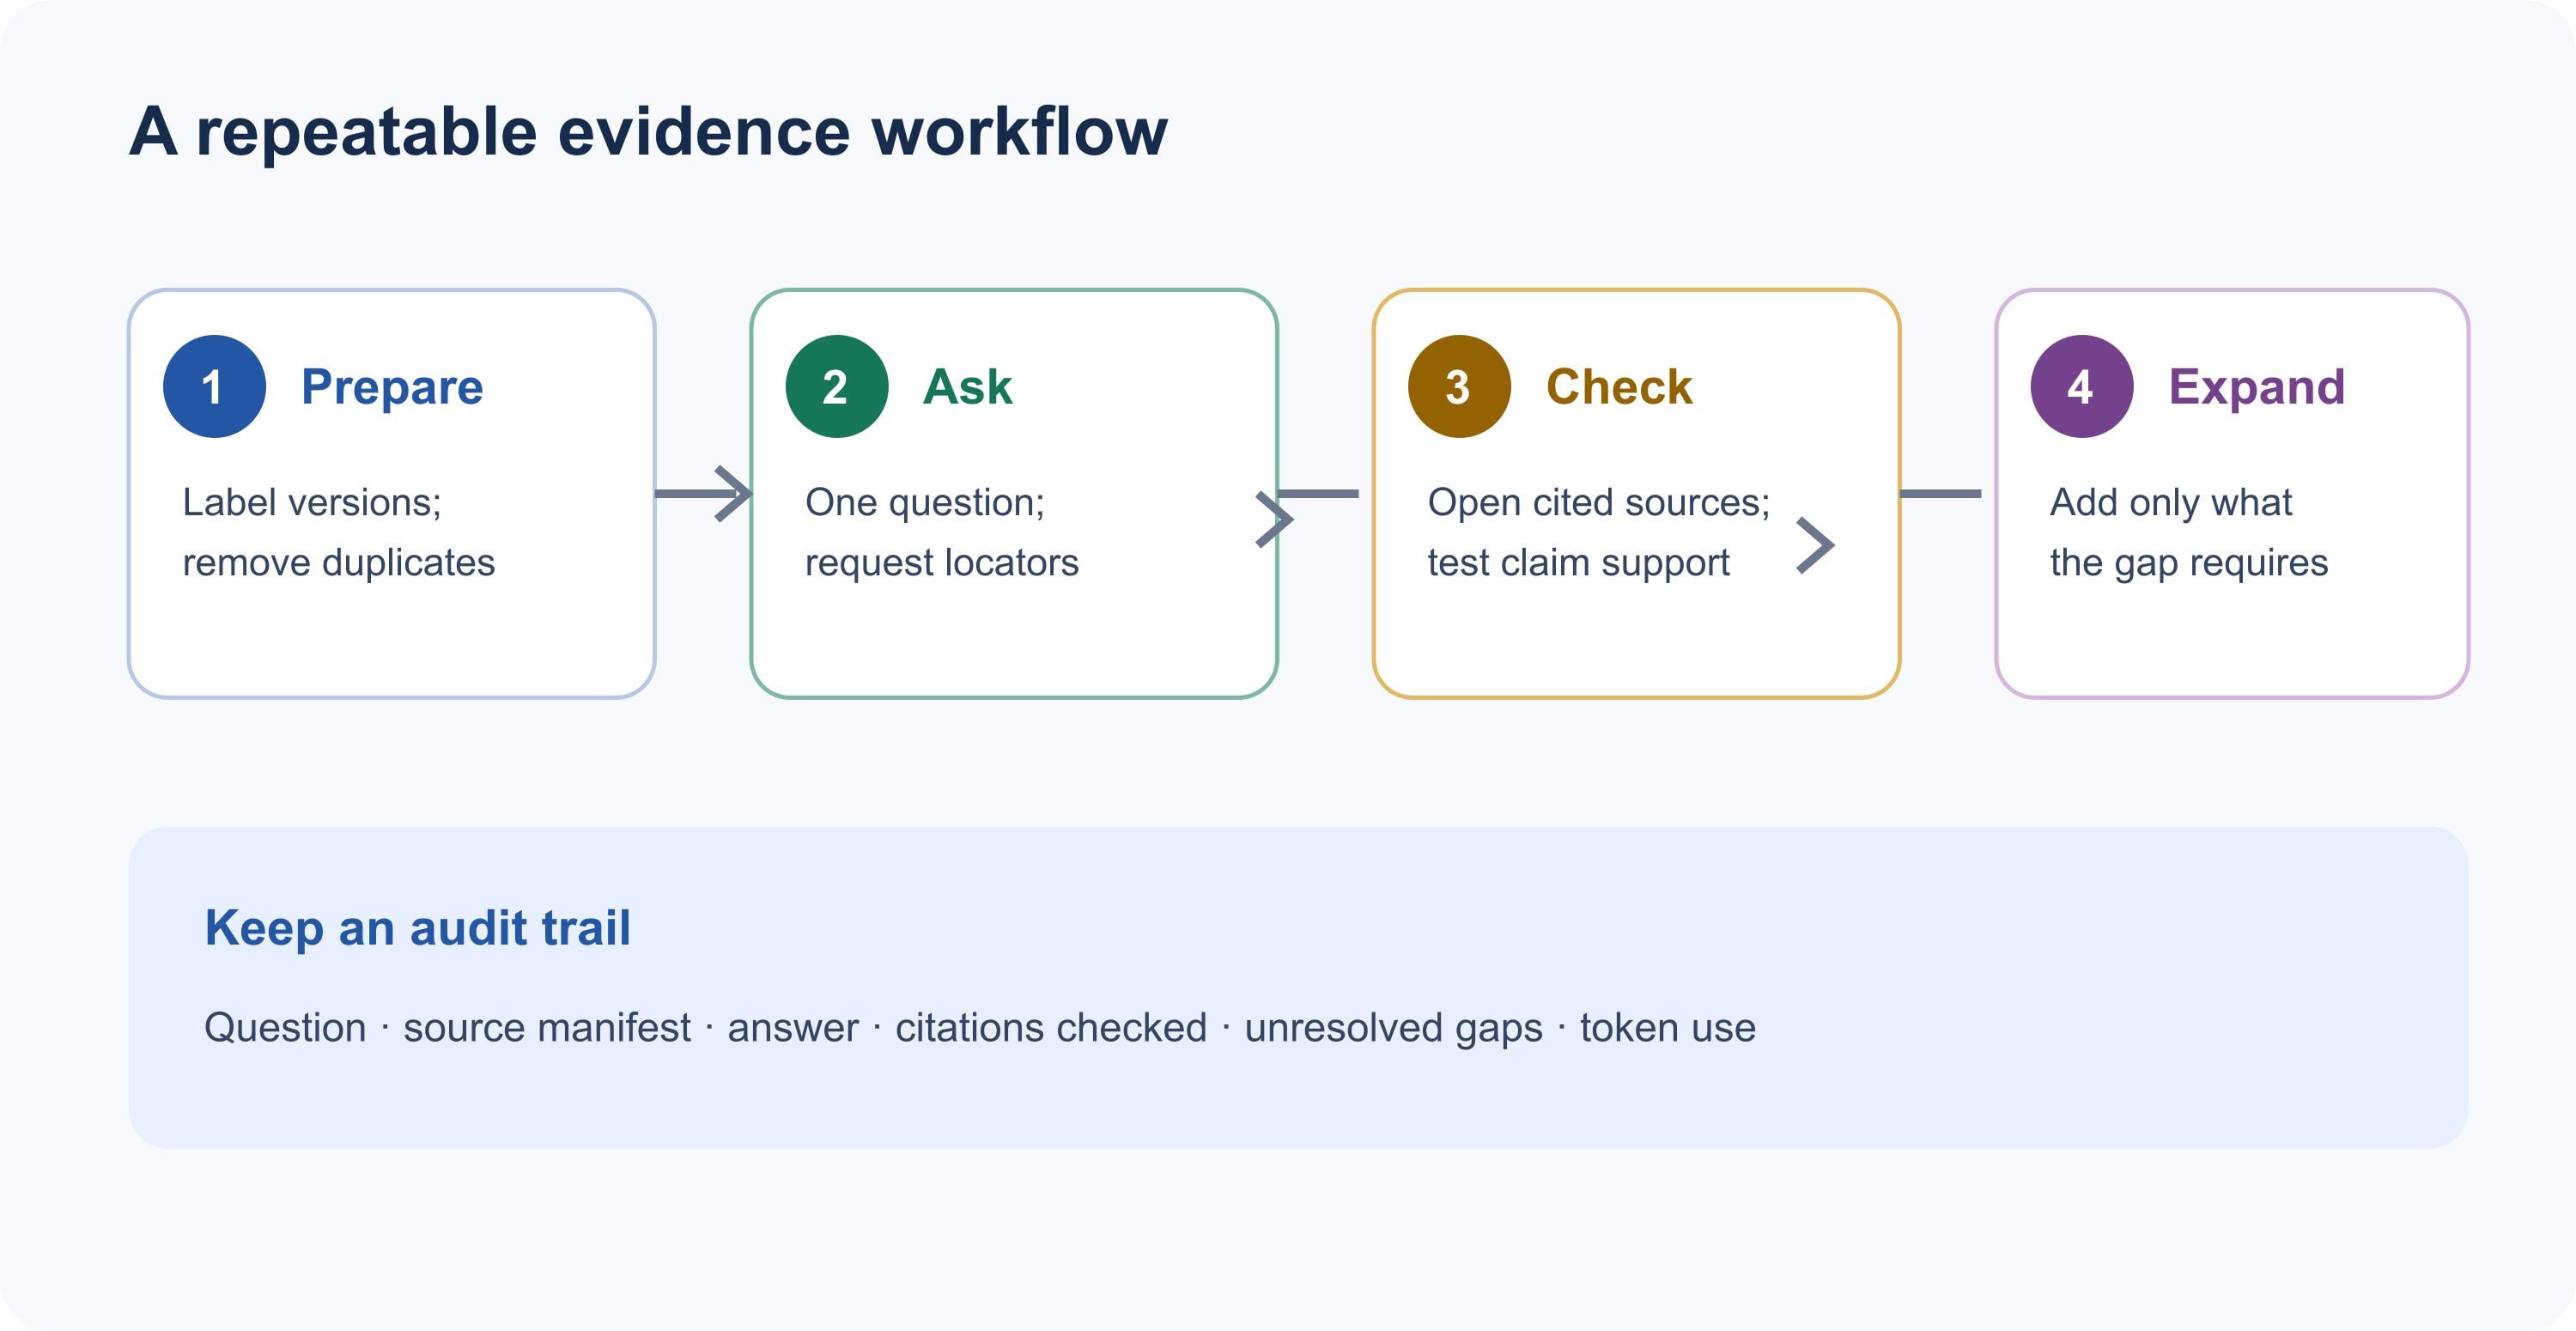
Prepare fuentes, haga una pregunta acotada, verifique las citas y amplíe solo para resolver una brecha.
Luego inspeccione la respuesta en tres pasadas. Verifique si cada cita apunta a una ubicación real. Verifique si el pasaje citado respalda la afirmación, en lugar de simplemente mencionar el tema. Finalmente, revise las omisiones y los conflictos haciendo preguntas de seguimiento específicas sobre el mismo conjunto de fuentes. Para decisiones de alto riesgo, haga que un revisor calificado lea el material de origen directamente.
Mapa de evidencia del flujo de trabajo con contexto largo
| Etapa | Acción | Conservar | Señal de detención |
|---|---|---|---|
| 1. Preparar | Etiquetar, deduplicar y acotar las fuentes | Manifiesto de fuentes y versiones | Procedencia desconocida o duplicado obsoleto |
| 2. Preguntar | Establecer una pregunta y un formato de evidencia | Nombres de archivo y localizadores en la respuesta | Solicitud amplia sin objetivo de decisión |
| 3. Verificar | Abrir pasajes citados y comparar afirmaciones | Afirmaciones respaldadas y brechas explícitas | La cita no respalda la afirmación |
| 4. Ampliar | Agregar solo las fuentes necesarias para vínculos no resueltos | Mejora en las pruebas de respuesta conocida | Más entrada sin mejor evidencia |
Cómo probar si el contexto de 1M es útil para su tarea
Cree un pequeño conjunto de evaluación antes de cargar el archivo completo. Escriba preguntas cuyas respuestas ya conozca del material de origen. Coloque algunos hechos cerca del principio, algunos en el medio y algunos cerca del final. Agregue al menos una pregunta que requiera conectar dos documentos y una que no pueda responderse con las fuentes proporcionadas.
Ejecute las mismas preguntas primero en un subconjunto más pequeño y relevante, luego aumente el contexto en pasos medidos. Registre la corrección factual, la precisión del localizador, la evidencia omitida, las afirmaciones no respaldadas, la negativa ante la pregunta sin respuesta, la latencia y el uso de tokens. Mantenga el prompt y la configuración de decodificación estables para que los cambios sean interpretables. Repita una pregunta si las salidas varían materialmente entre ejecuciones.
| Comprobación | Qué muestra una respuesta aprobatoria | Qué hacer después de un fallo |
|---|---|---|
| Hecho conocido en posiciones temprana, media y tardía | Recuperación a lo largo del intervalo de la fuente | Verificar indexación, etiquetas de archivo y longitud del prompt |
| Vínculo entre documentos | La evidencia se puede unir entre fuentes | Solicitar ambas citas, luego acotar la pregunta de vínculo |
| Pregunta sin respuesta | El modelo puede informar evidencia faltante | Reforzar “use solo las fuentes proporcionadas” y volver a probar |
| Auditoría de citas | El localizador y el extracto respaldan la afirmación | Tratar la afirmación como no verificada hasta que se corrija |
| Comparación con contexto más grande | El material extra mejora la tarea objetivo | Eliminar ruido si la precisión o la latencia empeoran |
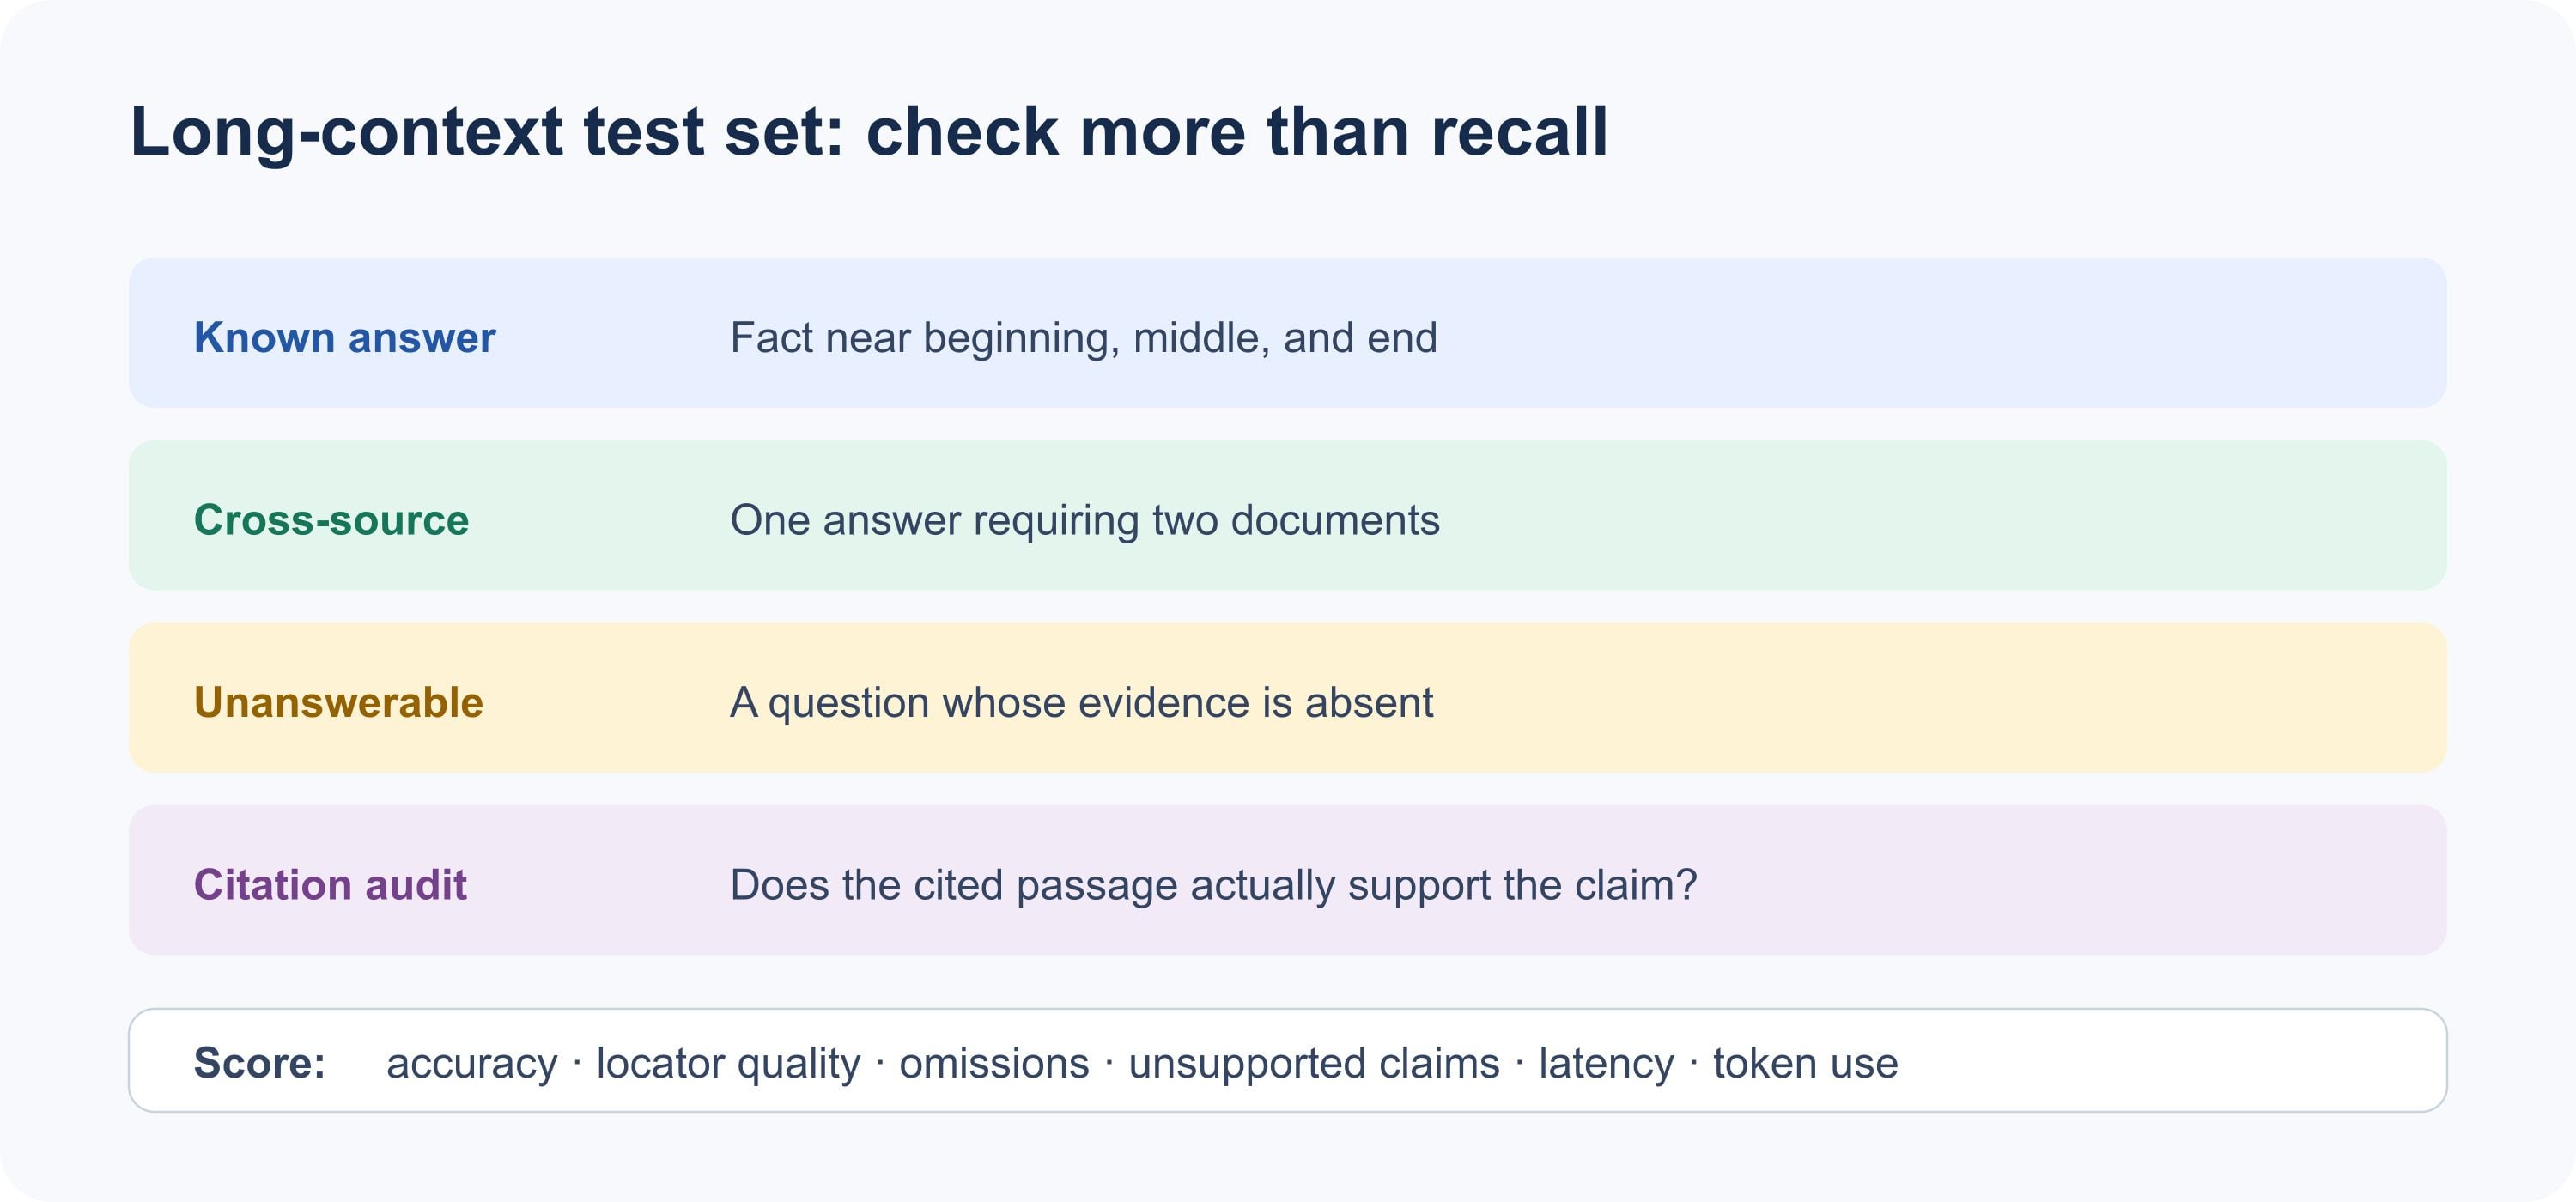
Puntúe la recuperación, el respaldo de citas, las omisiones, las afirmaciones no respaldadas, la latencia y el uso de tokens.
Los informes de la comunidad son mixtos y dependen de la tarea. Un usuario de Reddit compartió un aumento específico del harness en argumentos de herramientas malformados con tamaños de contexto más grandes, mientras que los comentaristas describieron trabajo exitoso con recuentos de tokens más altos en otras configuraciones. Esa es una razón útil para hacer benchmark de su propio harness, no evidencia de un umbral de fallo universal. ( Discusión sobre el contexto de DeepSeek en Reddit )
Un escalado sensato es: validar el prompt en una muestra pequeña, agregar los grupos de fuentes necesarios para preguntas entre documentos, luego probar una solicitud grande representativa. Mantenga el contexto más pequeño que responda la pregunta real con evidencia confiable. Esto también hace que las comparaciones de latencia y costo sean más fáciles de interpretar.
Precios y acceso a la API de DeepSeek V4.1 Flash
En Atlas Cloud, el listado del modelo muestra actualmente DeepSeek V4.1 Flash con un contexto de 1M y tarifas de $0.30 por millón de tokens de entrada, $1.20 por millón de tokens de salida y $0.03 por millón de tokens de lectura de caché. El listado no muestra descuento para este modelo. Estas son tarifas de Atlas Cloud, distintas de los precios de hora pico y fuera de hora dependientes del tiempo de DeepSeek. Vuelva a consultar el catálogo de modelos de Atlas Cloud y la página de precios de modelos antes de publicar o presupuestar porque las tarifas pueden cambiar.
Con las tarifas indicadas, una solicitud con 100,000 tokens de entrada no almacenados en caché y 2,000 tokens de salida cuesta aproximadamente $0.03 por entrada más $0.0024 por salida, o $0.0324 en total antes de otros cargos aplicables. Si la entrada se factura como lecturas de caché, 100,000 tokens en caché costarían $0.003 en su lugar. El ejemplo asume esos recuentos de tokens y tarifas; no es una cotización para una carga de trabajo específica. La capacidad completa de 1M no se cobra solo porque exista. La facturación sigue el uso y el tratamiento de caché.
Para los equipos que desean un único punto de entrada de API, la página del modelo DeepSeek V4.1 Flash proporciona el modelo y los detalles de llamada. Compare su uso medido de tokens y sus necesidades de integración también con el endpoint oficial; los nombres de los modelos, los límites y los precios pueden diferir según el proveedor.
Preguntas frecuentes
¿Una ventana de contexto de 1M de tokens es lo mismo que 1M de palabras?
No. Los tokens pueden ser partes de palabras, puntuación, fragmentos de código u otras unidades. La cantidad de palabras o páginas que caben depende del material y de su tokenización. Use recuentos de tokens medidos en lugar de una conversión fija de páginas.
¿DeepSeek V4.1 Flash siempre usa la ventana de contexto completa?
No. Un millón de tokens es una especificación de contexto máxima, no un objetivo para cada solicitud. Un prompt corto usa menos, y una interfaz o ruta de API particular puede imponer un límite menor. Consulte la documentación del endpoint y los campos de uso reales.
¿Es suficiente un contexto de 1M para una base de código completa?
Puede ajustarse a algunas bases de código por recuento de tokens, pero eso no hace que cada archivo sea relevante ni que cada respuesta sea confiable. Incluya los archivos necesarios para la pregunta, verifique las rutas y los símbolos citados, y pruebe los cambios con las comprobaciones reales del proyecto.
¿Debería poner todos los documentos disponibles en un solo prompt?
Solo si los documentos se relacionan con la misma pregunta. Comience con un manifiesto de fuentes, elimine duplicados y material no relacionado, luego agregue más cuando una prueba entre documentos lo necesite. Los mejores casos de uso de la ventana de contexto de 1M de DeepSeek V4.1 Flash se definen por la evidencia que debe compararse, no por el tamaño del archivo.





