Dos equipos pueden reportar cientos de tokens por segundo para DeepSeek V4.1 Flash y aun así estar midiendo cosas diferentes. Uno puede referirse a la velocidad de decodificación de una sola solicitud; otro puede referirse a la salida agregada de docenas de solicitudes concurrentes. Para mejorar la optimización del rendimiento de inferencia de DeepSeek V4.1 Flash, primero elige la métrica que necesita tu servicio, luego evalúa tu propia mezcla de solicitudes, cambia una variable de servicio a la vez y verifica latencia, calidad y costo en conjunto. La familia de modelos ahora incluye la actualización Flash-1017 del 17 de octubre, así que registra el checkpoint exacto antes de comparar resultados. Los informes públicos muestran rutas de optimización útiles, pero ninguno sustituye una prueba emparejada en tu hardware.
Puntos clave
- Los tokens/s de salida agregados miden la capacidad entre solicitudes; la velocidad de decodificación por solicitud mide la experiencia de un usuario individual.
- Reproduce la longitud de tus prompts, los límites de salida, la concurrencia, el estado en caliente y el objetivo de latencia antes de ajustar.
- La caché KV comprimida y la reproducción acotada de V4.1 Flash reducen la presión de memoria, pero no garantizan una aceleración fija de extremo a extremo.
- Compara vLLM y SGLang solo bajo condiciones emparejadas de modelo, hardware, carga de trabajo y medición.
¿Qué significa el rendimiento para DeepSeek V4.1 Flash?
El rendimiento es una tasa, pero el numerador y el límite de la prueba importan. Para un servicio de inferencia, registra al menos cinco mediciones:
| Métrica | Qué te indica | Uso típico |
|---|---|---|
| Tokens/s de salida agregados | Tokens de salida producidos por todas las solicitudes activas por segundo | Planificación de capacidad y eficiencia de la flota |
| Tokens/s de decodificación por solicitud | Velocidad de generación experimentada por una solicitud individual | Capacidad de respuesta interactiva durante la generación |
| Tokens/s de prefill | Tokens de entrada procesados por segundo | Prompts largos y cargas con mucho uso de recuperación |
| Tiempo hasta el primer token (TTFT) | Tiempo desde la llegada de la solicitud hasta el primer token de salida | Retardo de inicio percibido |
| Latencia de extremo a extremo, p50/p95 | Duración total de la solicitud en la distribución del tráfico | Objetivos de nivel de servicio y comportamiento de cola |
Un servidor puede aumentar el rendimiento agregado al agrupar más secuencias, mientras hace que cada usuario espere más entre tokens. A la inversa, una configuración ajustada para baja concurrencia puede ofrecer respuestas individuales ágiles pero dejar los aceleradores infrautilizados. Ningún resultado es universalmente mejor. El objetivo correcto es un punto de la curva de rendimiento-latencia que cumpla el objetivo de servicio de tu producto.
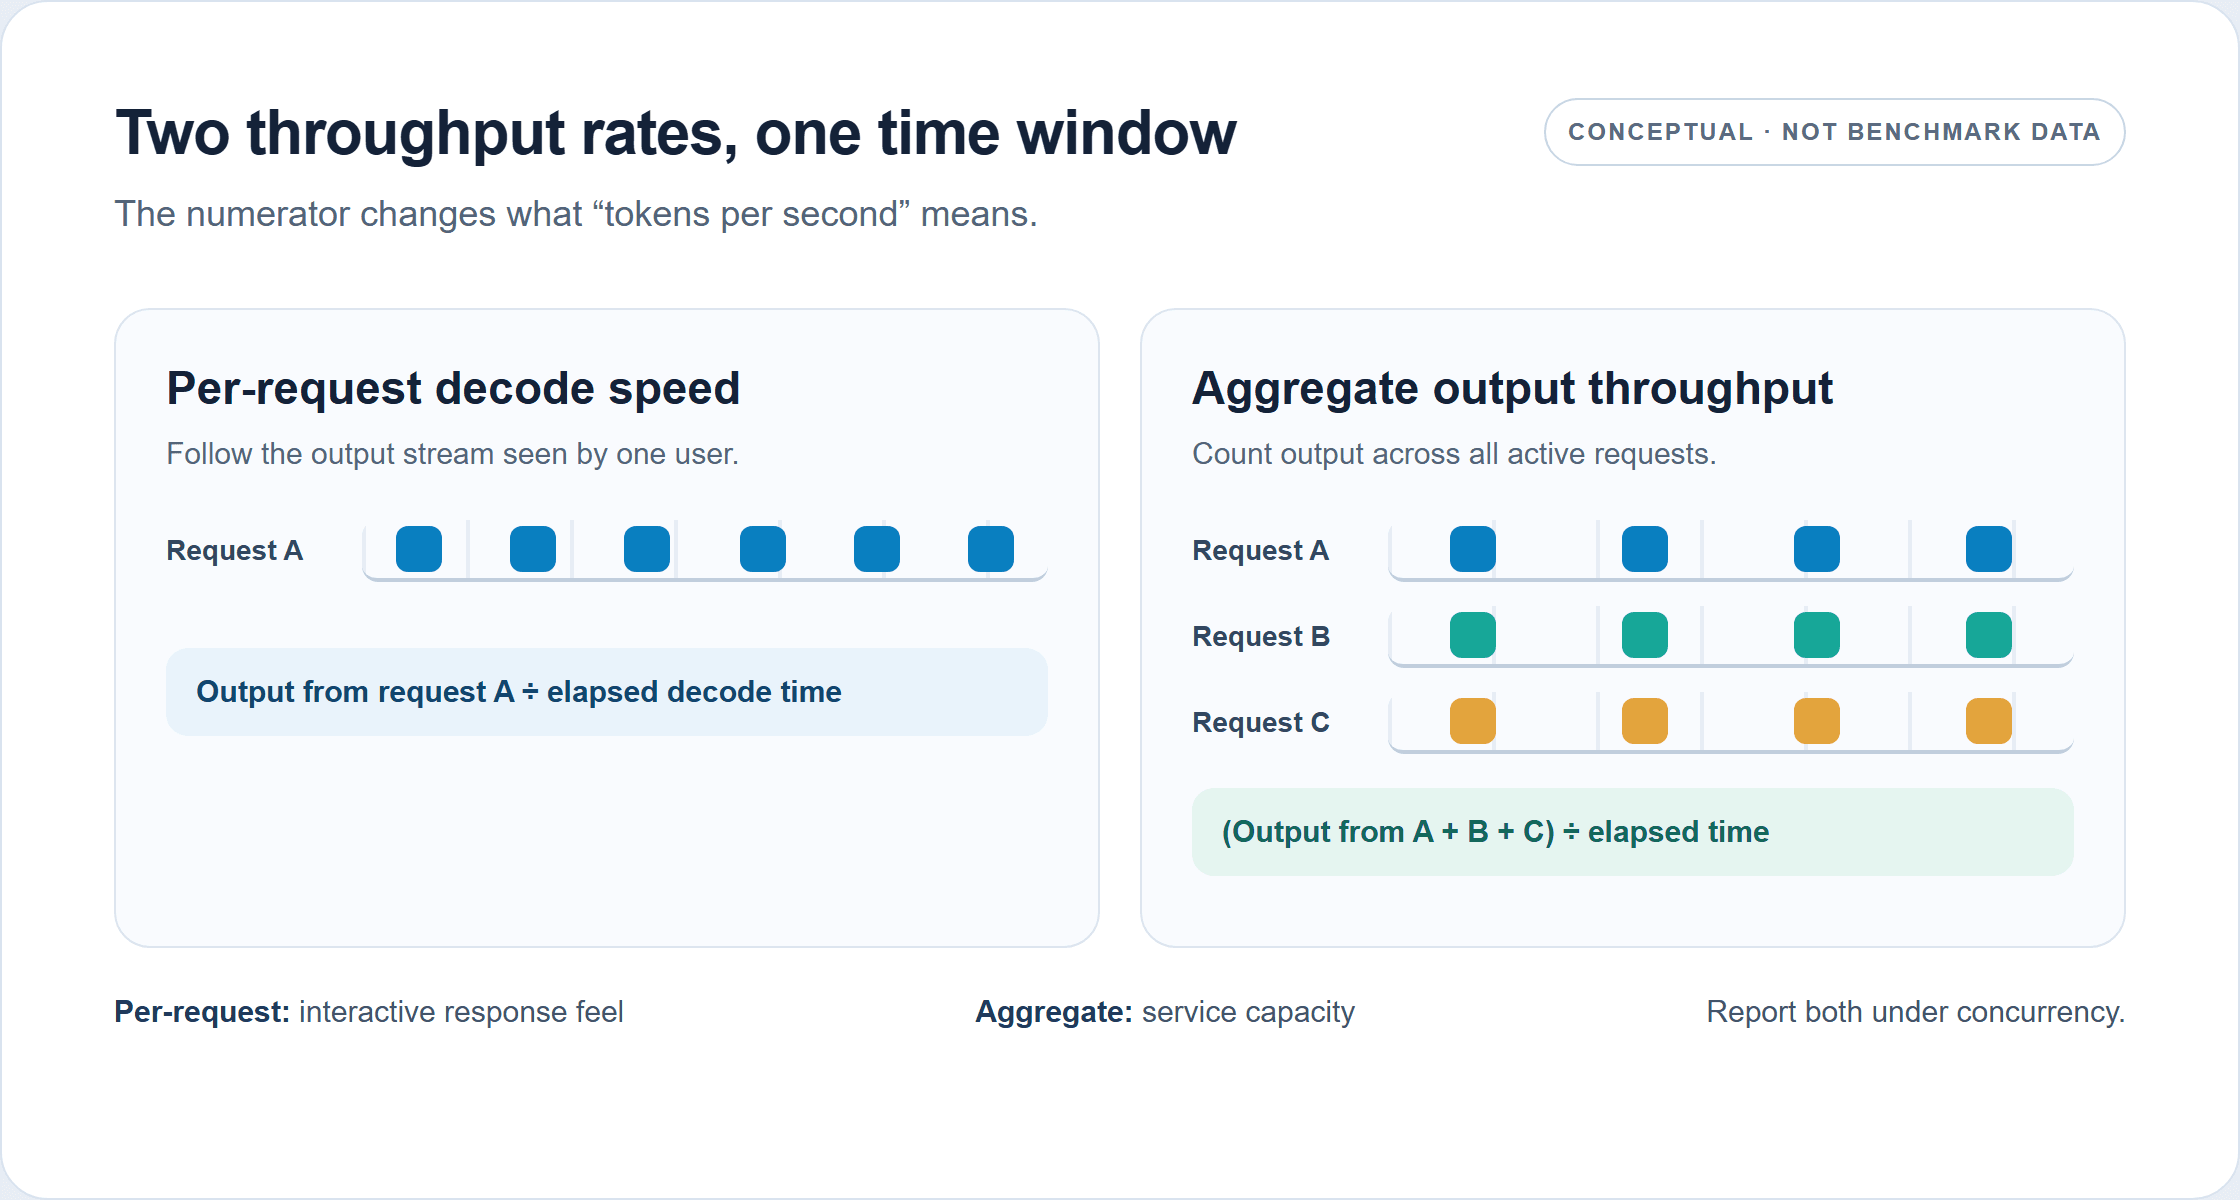
Las dos tasas cuentan flujos de salida diferentes. Este es un diagrama conceptual, no un rendimiento medido de DeepSeek V4.1 Flash.
Especifica si el rendimiento incluye prefill, decodificación o ambos. Indica si divides por la cantidad de GPU. Reporta tokens de salida exitosos en lugar de los tokens máximos solicitados, y divulga cancelaciones o errores. Sin esos detalles, una cifra de tokens/s no puede decirle a un operador si predice su aplicación.
Crea una línea base reproducible de DeepSeek V4.1 Flash
Una línea base útil se parece lo suficiente al tráfico de producción como para exponer su cuello de botella. Un solo prompt corto es un mal proxy para un agente que envía repetidamente un historial de conversación grande, y una salida fija de 1,024 tokens no capta cargas de trabajo que se detienen antes o varían mucho.
Fija la carga de trabajo y la ventana de medición
Crea grupos de solicitudes a partir del tráfico observado. Para cada grupo, conserva la longitud de entrada aproximada, la longitud de salida esperada, el patrón de llegada y cualquier prefijo compartido. Incluye turnos de herramientas o razonamiento si forman parte de la ruta real de la solicitud. Mantén fijos los prompts, la configuración de muestreo, las condiciones de parada y los límites de salida entre ejecuciones.
Ejecuta tanto un caso de baja concurrencia como la concurrencia que tu servicio espera en el pico. Luego agrega niveles de concurrencia intermedios para revelar dónde el rendimiento deja de subir o la latencia cruza su límite. Usa una ventana de medición estable después del calentamiento, repite cada punto e informa la mediana más el rango. Una ráfaga corta puede medir el comportamiento de arranque en lugar de la capacidad de servicio estable.
Separa las mediciones de arranque en frío del servicio en caliente. Las ejecuciones en frío incluyen la carga del modelo, la captura de grafos o la población de caché según el stack; las ejecuciones en caliente describen un sistema listo para servir. Para una carga de trabajo con caché de prefijos, mide por separado el tráfico con aciertos y fallos de caché. No los combines en un solo promedio a menos que la mezcla coincida con producción.
Lleva un registro de benchmark
Guarda una fila por cada ejecución con estos campos: checkpoint o revisión del modelo; runtime y commit; modelo y cantidad de GPU; interconexión; precisión y cuantización; diseño paralelo de tensor, expertos o pipeline; distribución de tokens de entrada y salida; concurrencia y patrón de llegada de solicitudes; estado en caliente o en frío; duración de la ejecución; tasa de éxito; rendimiento agregado; velocidad de decodificación por solicitud; TTFT; y latencia de extremo a extremo p50/p95.
Este registro es más útil que un número de tabla de clasificación porque hace reproducible el siguiente experimento. Congélalo antes de ajustar. Si la carga de trabajo o el checkpoint cambian, inicia una nueva línea base en lugar de atribuir la diferencia a un flag de servicio.
Diagnostica prefill, decodificación, caché KV o planificación
Usa los síntomas para elegir la siguiente medición, no para adivinar una solución. Un TTFT alto con una velocidad de decodificación aceptable apunta al procesamiento de entrada, la cola, los fallos de caché o la sobrecarga de arranque. Una decodificación lenta con baja concurrencia sugiere examinar kernels, ancho de banda de memoria, comunicación paralela y la ruta de ejecución del modelo. Un rendimiento agregado que se estanca a medida que aumenta la concurrencia puede indicar presión de memoria, límites del planificador, sobrecarga de comunicación o una ruta de cómputo saturada. La degradación con contexto largo exige medir la residencia de caché, el trabajo de prefill y el movimiento de host a dispositivo.
| Observación | Primeras comprobaciones |
|---|---|
| El TTFT crece con la longitud del prompt | Tasa de prefill, tiempo de cola, tasa de aciertos de caché de prefijos, calentamiento de grafos o compilación |
| La velocidad de decodificación es baja incluso con concurrencia 1 | Ruta del modelo en runtime, soporte de kernels, precisión, utilización de GPU, sobrecarga de comunicación |
| Los tokens/s agregados se estancan a medida que aumenta la concurrencia | Capacidad de caché KV, batching del planificador, ancho de banda de memoria, topología paralela |
| La latencia p95 aumenta bruscamente mientras mejora la salida agregada | Tamaño de lote, política de colas, mezcla de longitudes de solicitud, objetivo de servicio |
| Los prompts largos desalojan solicitudes activas útiles | Residencia de caché KV, asignación de caché, distribución de contexto, tráfico de memoria del host |
V4.1 Flash tiene características arquitectónicas diseñadas para aliviar parte de estas presiones. El informe del modelo describe CSA2 con reutilización de caché entre capas y almacenamiento KV global en FP4, lo que da una huella KV global reportada de 890 bytes por token, aproximadamente una cuarta parte de la huella correspondiente de V4-Flash. SWA Bounded Replay aborda una compensación de almacenamiento diferente: en lugar de persistir todo el estado de atención de ventana deslizante, un despliegue puede reconstruir el estado faltante reproduciendo la ventana reciente. DeepSeek reporta una caché KV persistente cercana a un octavo de la huella de V4-Flash para este diseño, con una pequeña cantidad de recómputo de prefill adicional. Estos son resultados de arquitectura y despliegue, no una promesa de rendimiento ocho veces mayor. (Informe técnico de DeepSeek, septiembre de 2026)
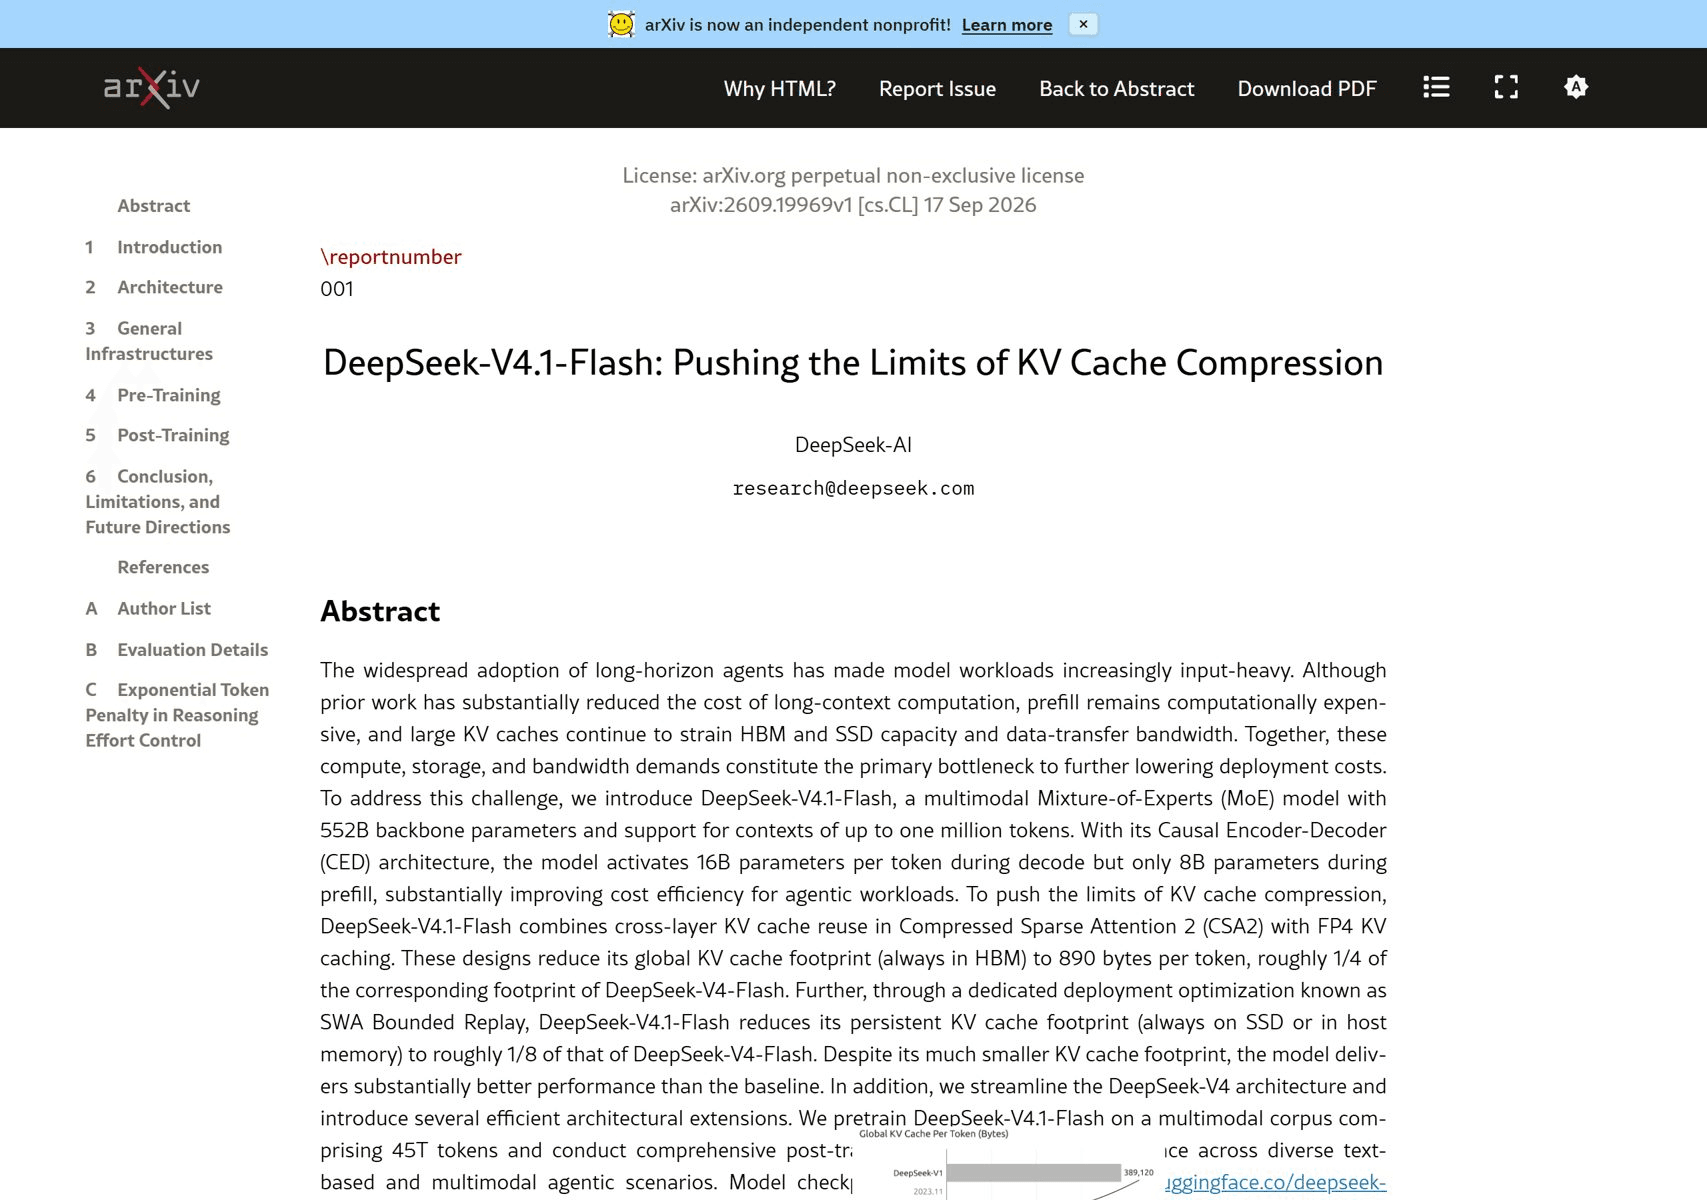
La figura de origen describe la capacidad de caché, no un multiplicador de rendimiento de extremo a extremo para todos los despliegues.
Cuando el diagnóstico no está claro, perfila una ejecución representativa e inspecciona el tiempo de cola, la utilización de GPU, el uso de memoria y los tiempos por etapa. Cambia una variable, vuelve a ejecutar la misma carga de trabajo y verifica la correctitud de salida o la calidad de la tarea. Esto evita que una aparente aceleración oculte una regresión en el servicio o en las respuestas.
Ajusta vLLM o SGLang contra el mismo objetivo
Elige un runtime cuya ruta de modelo actual admita el checkpoint y el hardware que planeas desplegar. Verifica la versión exacta, los kernels, el comportamiento de grafos y el diseño paralelo. Que un modelo figure como compatible no significa que todas las cuantizaciones o topologías estén igualmente optimizadas.
vLLM: valida la ruta del modelo específica de la versión
El informe de octubre del equipo de vLLM describe una progresión en su benchmark AgentX: alrededor de 1,9× de mejora en su resultado de baja latencia y alrededor de 5,3× de rendimiento bajo una restricción de 150 TPS frente a su línea base del día cero. El trabajo incluyó SWA bounded replay con grafos CUDA e integración de kernels específicos del modelo. Trata esos valores como evidencia de que el stack cambió sustancialmente con el tiempo bajo ese benchmark, no como multiplicadores para aplicar a otro clúster. ( informe de ingeniería de vLLM, octubre de 2026)
Para tu ejecución, establece primero una versión compatible y una configuración validada. Luego mide individualmente el comportamiento de captura o reproducción de grafos, el batching y el paralelismo. Conserva la restricción de latencia usada para seleccionar un punto de mayor rendimiento. Si la captura de grafos cambia el arranque o las necesidades de memoria, incluye esos costos en la decisión de despliegue.
SGLang: iguala su perfil de concurrencia
El informe del equipo de SGLang ofrece un ejemplo inusualmente claro de por qué importa el contexto de la prueba. En 8 GPU H200, su ejecución optimizada sin decodificación especulativa pasó de aproximadamente 76 a 168 tokens/s por usuario con concurrencia uno, y de alrededor de 96 a 221 tokens/s de salida por GPU con concurrencia 64. Usó entradas fijas de 8,192 tokens y salidas de 1,024 tokens. Sus resultados separados con 4×GB300 usaron longitudes de prompt, configuraciones paralelas y decodificación especulativa DSpark diferentes. Por lo tanto, el informe respalda evaluar las optimizaciones de SGLang en tu tráfico, no clasificarla directamente frente a los números de AgentX de vLLM. ( informe de optimización de LMSYS/SGLang, septiembre de 2026)
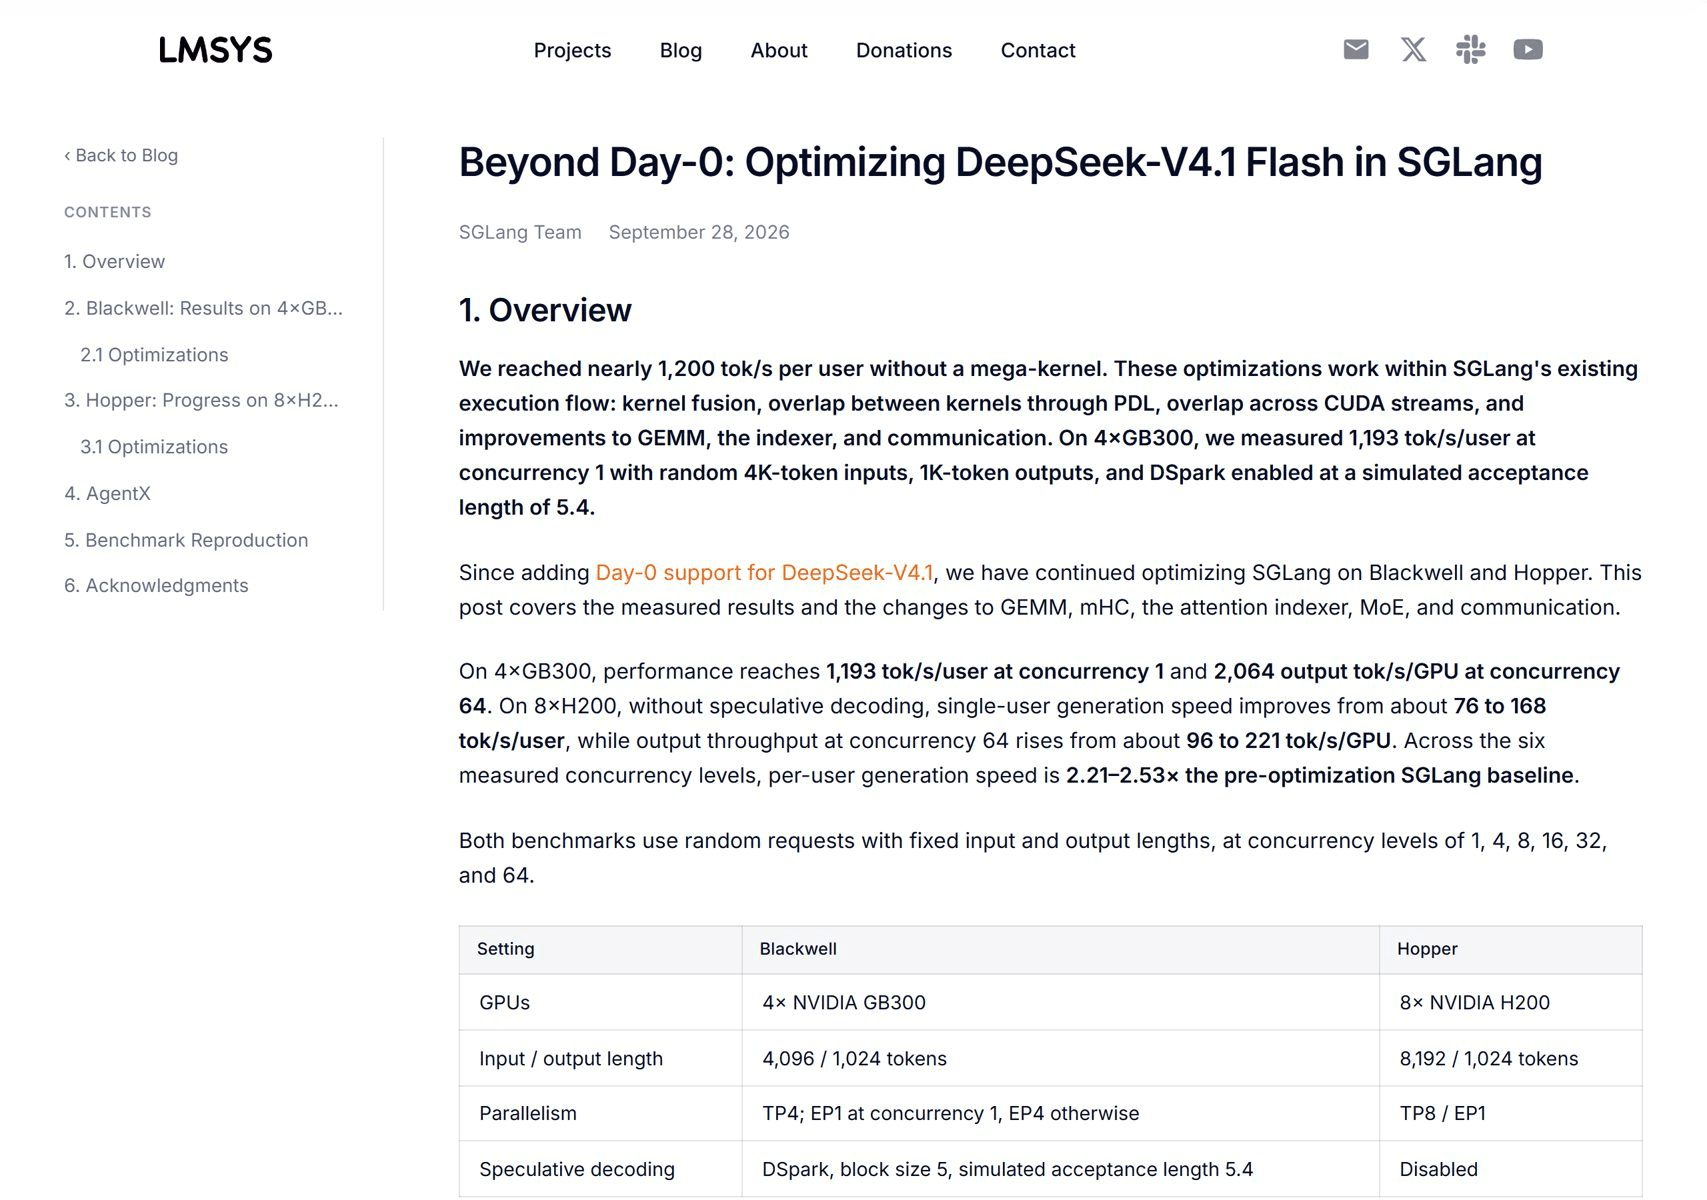
Los informes de origen usan cargas de trabajo y hardware diferentes; sus números no deben leerse como un gráfico comparativo directo.
Empieza con un runtime y optimiza su ruta compatible. Solo construye una comparación con un segundo runtime si puedes mantener constantes el checkpoint, la asignación de GPU, las distribuciones de prompt y salida, la concurrencia, el calentamiento y el objetivo de servicio. Esa comparación cuesta tiempo de ingeniería, así que primero confirma que el stack actual es realmente el factor limitante.
Optimiza la concurrencia y el contexto largo sin romper el SLO
Aumenta la concurrencia por pasos y captura la salida agregada, la velocidad de decodificación por solicitud, el TTFT, la latencia p95, el uso de memoria y los fallos en cada paso. Conserva el punto de mayor rendimiento solo si su latencia y tasas de error aún cumplen el objetivo de servicio. Si las solicitudes hacen cola antes de la generación, un lote más grande puede mejorar la utilización del dispositivo mientras hace que el producto se sienta más lento.
Para tráfico de contexto largo, mide la distribución del contexto activo y la tasa de aciertos de caché. Una ventana de contexto máxima declarada no significa que todas las solicitudes puedan servirse de forma concurrente con esa longitud. La caché KV compite por memoria con los pesos, las activaciones, los pools de grafos y los búferes del runtime. Deja margen para longitudes de solicitud variables y mide el desalojo o la preempción bajo tráfico realista.
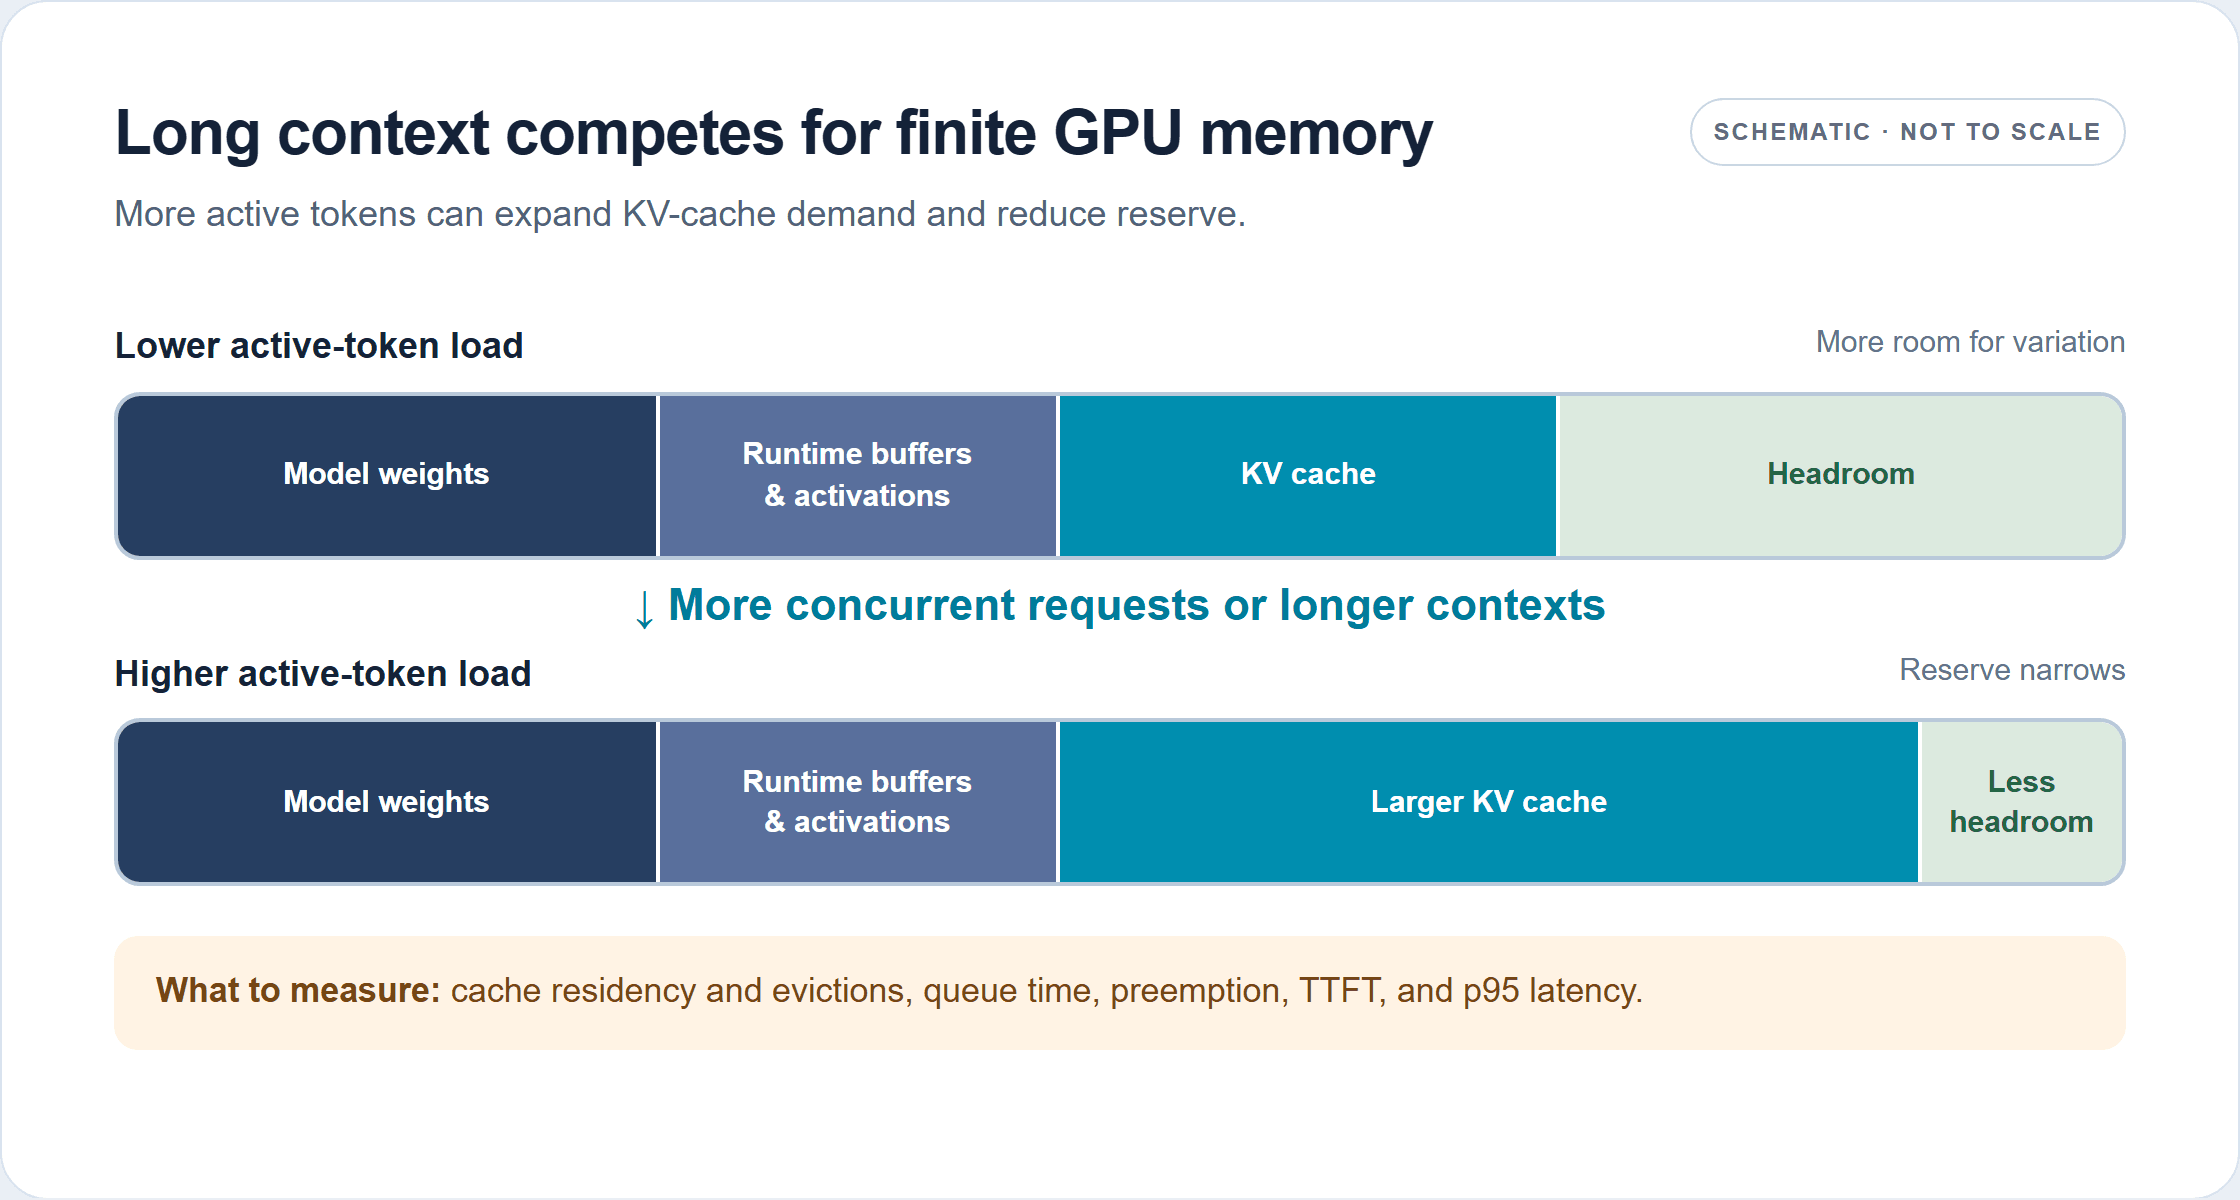
Contextos más largos o más solicitudes concurrentes pueden aumentar la demanda de caché KV. Los bloques de memoria son esquemáticos y no están a escala.
Trata la cuantización, la precisión de la caché KV, el paralelismo de tensores, el paralelismo de expertos y la desagregación de prefill/decodificación como experimentos separados. Pueden cambiar el uso de memoria, la comunicación, la selección de kernels, la calidad de salida y la latencia. El mejor diseño depende del tipo de GPU y la interconexión; agregar más GPU puede aumentar los costos de comunicación o dejar algunos recursos inactivos. Verifica la calidad exacta de salida y los modos de fallo después de cambiar la precisión o la ejecución del modelo.
La secuencia práctica es simple: reproduce la línea base, identifica la métrica que no alcanza su objetivo, formula una hipótesis de cuello de botella, cambia una configuración y repite. Si la configuración mejora una métrica y perjudica otra, decide explícitamente si esa compensación encaja con el producto. Esto convierte la optimización en una decisión controlada en lugar de un montón de flags.
Valida la decodificación especulativa y cada aceleración declarada
La decodificación especulativa puede reducir el trabajo serial del modelo objetivo cuando los tokens borrador se aceptan de manera eficiente y el runtime implementa bien la verificación. Su beneficio depende de la ruta de borrador, el comportamiento de aceptación, la forma del lote, el hardware y la mezcla de prompt/salida. Puede ayudar al tráfico limitado por decodificación y tener poco valor cuando dominan el prefill, la cola o la comunicación.
Ejecuta una prueba A/B con la especulación habilitada y deshabilitada. Mantén fijos el checkpoint del modelo, el conjunto de prompts, el límite de tokens, el patrón de llegada, la concurrencia, el calentamiento y la ventana de medición. Registra los tokens aceptados por paso de verificación si están disponibles, junto con el rendimiento agregado, la velocidad por solicitud, el TTFT, la latencia p95, el uso de GPU, los fallos y la calidad de la tarea. Una longitud de aceptación simulada en un benchmark publicado es una condición de prueba, no un valor que debas asumir para tus prompts.
Una aceleración declarada es útil solo si supera tres comprobaciones: el mismo objetivo de servicio, una calidad de respuesta aceptable y una comparación de costos justa. Informa el contexto completo con cualquier número que publiques. Evita comparar diferentes cantidades de GPU, longitudes de prompt, longitudes de salida, modos de precisión, revisiones del modelo o métricas como si fuera un experimento controlado.
¿Autoalojar o usar una API gestionada de DeepSeek V4.1 Flash?
El autoalojamiento tiene sentido cuando el tráfico es lo suficientemente estable como para mantener las GPU útiles, el equipo puede operar infraestructura de inferencia y el control sobre el hardware o la ejecución justifica el trabajo operativo. Incluye el costo completo de aceleradores, margen de capacidad, energía, red, almacenamiento, mantenimiento y tiempo de ingeniería. Un resultado alto de tokens/s en el pico por sí solo no establece un menor costo por tarea exitosa.
Una API gestionada es útil cuando un equipo necesita validar rápidamente la demanda del producto, evitar operar una flota de servicio o comparar una línea base de API con su propio despliegue. Atlas Cloud lista DeepSeek V4.1 Flash bajo el ID de modelo deepseek-ai/deepseek-v4.1-flash con una API compatible con OpenAI. La página del modelo DeepSeek V4.1 Flash muestra actualmente $0.30 por millón de tokens de entrada, $1.20 por millón de tokens de salida y $0.03 por millón de tokens de lectura de caché, sin descuento mostrado a fecha de octubre de 2026. Consulta la lista de precios actual antes de estimar el gasto. Un endpoint gestionado no elimina la necesidad de medir la latencia de tus propias solicitudes o la economía de tu tráfico.
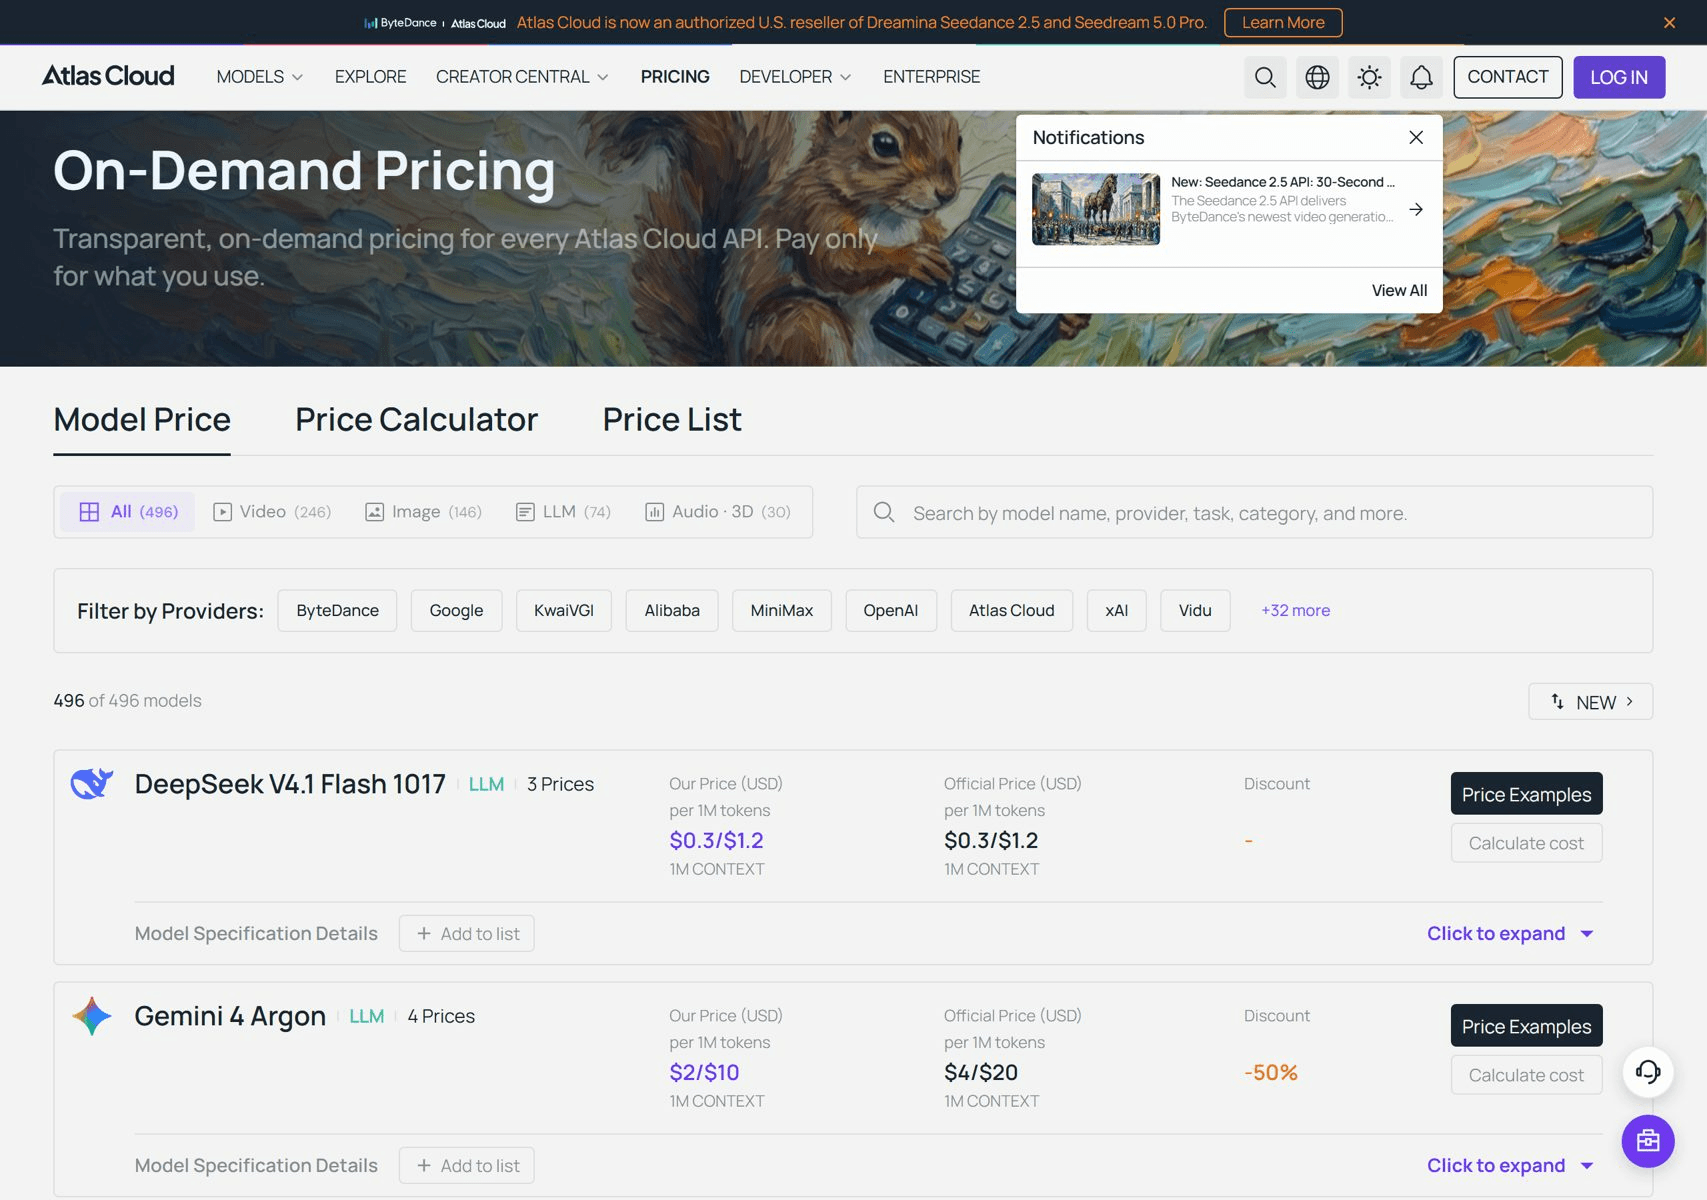
La lista identifica una opción de API gestionada; no es un benchmark de servicio.
Para una decisión de despliegue justa, reproduce las mismas solicitudes de negocio contra el servicio autoalojado y el endpoint gestionado. Compara el costo por tarea completada, la distribución de latencia, la confiabilidad y el tiempo del personal necesario para mantener cada opción. Si tu objetivo principal es la optimización del rendimiento de inferencia de DeepSeek V4.1 Flash, mantén la misma carga de trabajo y los mismos criterios de éxito para ambas rutas.
Preguntas frecuentes
¿Cuál es la diferencia entre rendimiento y tokens por segundo por usuario?
El rendimiento agregado cuenta la salida de todas las solicitudes activas. Los tokens/s por usuario miden la tasa de decodificación de una solicitud. El batching puede aumentar el primero mientras reduce el segundo, así que informa ambos para servicios interactivos.
¿Aumentar la concurrencia siempre mejora el rendimiento?
No. La salida agregada puede aumentar hasta que el cómputo o la memoria se saturan, y luego se aplana. La cola y la latencia de cola pueden seguir empeorando después de ese punto. Deja de aumentar la concurrencia cuando falle el objetivo de servicio.
¿Se pueden comparar directamente los números de benchmark de vLLM y SGLang?
Solo si coinciden la revisión del modelo, el hardware, las longitudes de prompt y salida, la concurrencia, el estado en caliente, el límite de medición y la restricción de latencia. Los informes publicados usan configuraciones diferentes, por lo que demuestran rutas de optimización en lugar de un ganador directo de runtime.
¿Cuándo debería usar una API gestionada en lugar de autoalojar?
Usa una API gestionada cuando la velocidad de integración y la reducción del trabajo de infraestructura importan más que poseer el stack de servicio. Autoaloja cuando la utilización, la experiencia operativa, el control y un caso de costo total medido justifiquen ejecutar las GPU.





