Una ventana de contexto de un millón de tokens le dice cuánto texto puede aceptar un modelo, no con qué fiabilidad interpretará cada cláusula. Para la precisión del análisis de documentos largos de DeepSeek V4.1 Flash, la evidencia pública es útil pero incompleta: la ficha del modelo de DeepSeek reporta 45.2 de coincidencia exacta en LongBench-V2 para el modelo base V4.1 Flash en una configuración 1-shot, mientras que la API desde entonces pasó a un build 1017 más reciente. Ese benchmark es una señal sobre una configuración de evaluación, no una tasa de acierto para su contrato, informe anual o archivo de investigación.
La respuesta práctica es usar Flash para recuperación rápida y síntesis inicial, y luego exigir evidencia a nivel de página y revisión humana para las decisiones que importan. Ninguna fuente pública citada aquí proporciona una evaluación reproducible del build actual en las cinco tareas de documentos a continuación. El plan de prueba es un protocolo listo para ejecutar, no una afirmación de que esas ejecuciones ya ocurrieron.
Puntos clave
- La familia de modelos admite hasta 1M de tokens, pero un límite de contexto no es una garantía de precisión.
- La puntuación publicada de 45.2 en LongBench-V2 corresponde al modelo base y a una configuración de benchmark 1-shot.
- La API de DeepSeek ahora sirve V4.1-Flash-1017; sus notas de la versión no publican una nueva puntuación en documentos largos.
- Pida ubicaciones de evidencia, compruébelas con la fuente y mida los errores en sus propios documentos.
Qué significa la ventana de 1M de tokens para el análisis de documentos
La ficha del modelo de DeepSeek describe V4.1 Flash como compatible con contextos de hasta un millón de tokens. La documentación de la API identifica actualmente el modelo servido como DeepSeek-V4.1-Flash-1017 y enumera una longitud de contexto de 1M. Esas son especificaciones de capacidad. No establecen con qué frecuencia el modelo encuentra una nota al pie, mantiene separadas dos versiones de un documento o admite que un dato solicitado está ausente. (Ficha del modelo DeepSeek)
Un token no es una página. El número de páginas varía con tablas, notas al pie, diseño, idioma y calidad de extracción. Un PDF escaneado puede necesitar OCR; una tabla puede perder las etiquetas de sus filas al convertirse a texto; los encabezados y los elementos repetitivos de página pueden consumir contexto sin ayudar a la pregunta. El prompt y la respuesta solicitada también usan tokens. Por lo tanto, un límite nominal de un millón de tokens no significa que todos los archivos de un millón de tokens lleguen intactos a través de cada interfaz de chat o cliente de API.
Antes de una prueba, registre el identificador exacto del modelo, el cliente y el método de entrada. Compruebe si se envió el texto extraído completo, si el proveedor lo truncó y si la solicitud llegó a la versión esperada del modelo. La API actual de DeepSeek usa deepseek-flash para el build más reciente de Flash. Si su puerta de enlace o SDK usa otro alias, registre ese alias y verifique su enrutamiento. Los equipos que configuran llamadas alojadas repetibles pueden empezar desde la plataforma de modelos de Atlas Cloud, y luego abrir su listado de la API de DeepSeek V4.1 Flash.
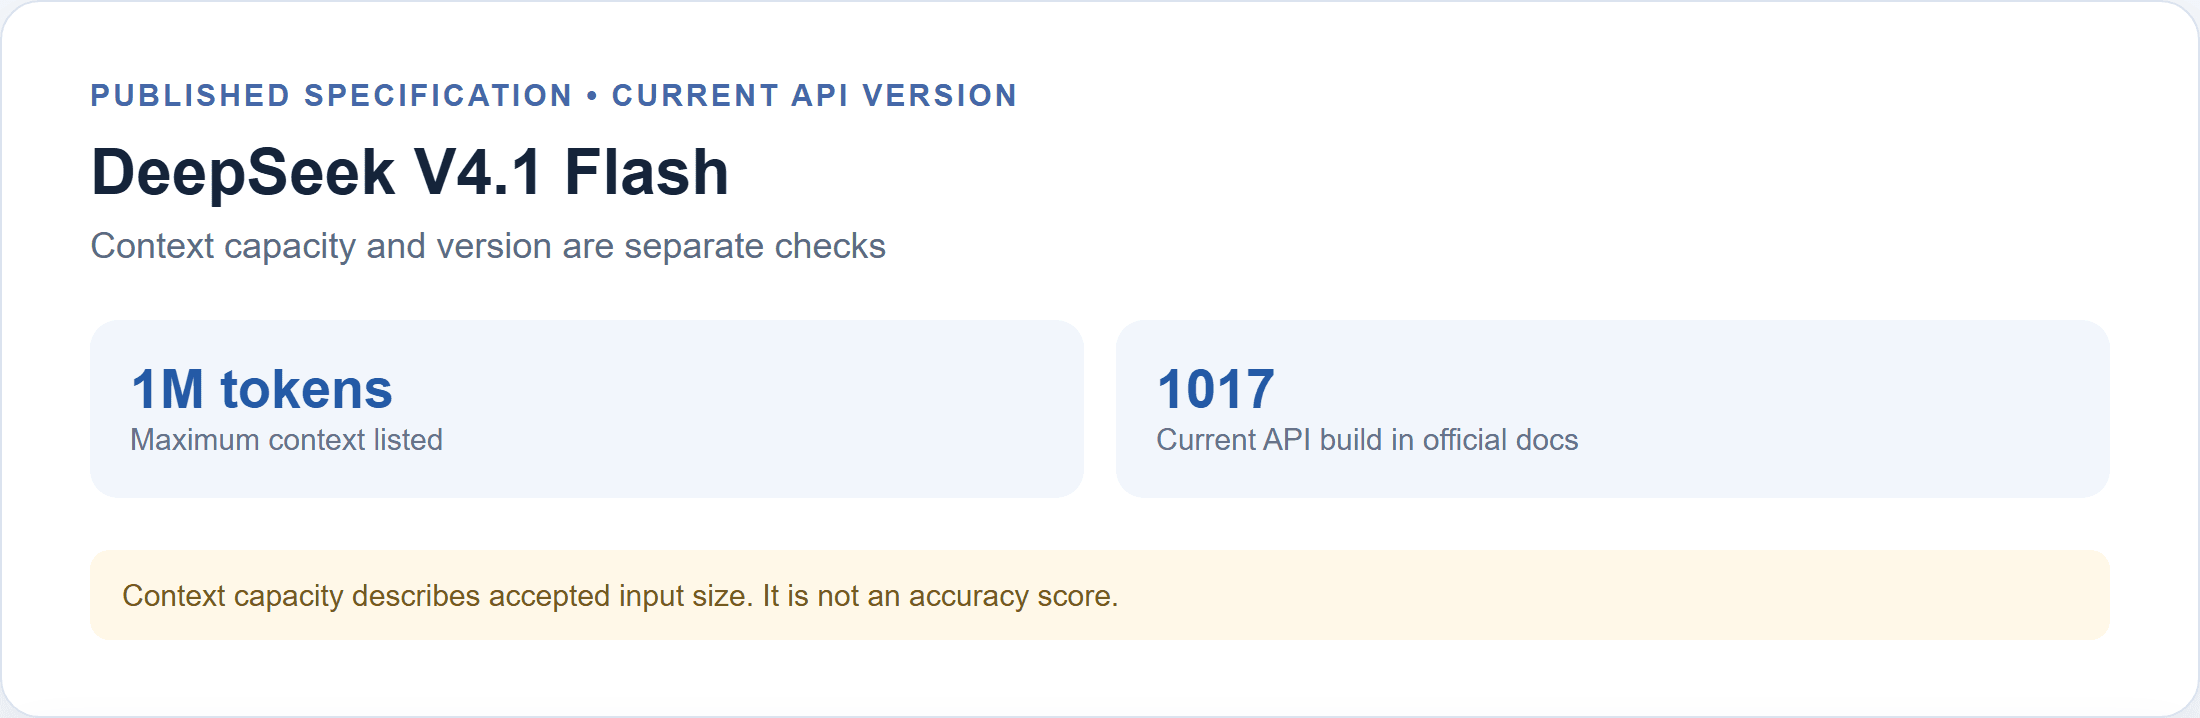
La especificación publicada da un máximo de contexto de 1M; la documentación actual de la API identifica el build 1017.
Una carga o solicitud exitosa solo muestra que el sistema aceptó una entrada. Para establecer que un detalle relevante influyó en la respuesta, pida una ubicación precisa, recupere ese pasaje y confirme que el texto circundante respalda la afirmación.
Qué muestra y qué no muestra la puntuación de LongBench-V2
La fila de LongBench-V2 de la ficha del modelo reporta puntuaciones de coincidencia exacta en una configuración 1-shot. Su tabla etiqueta los resultados como evaluaciones de modelos base y dice que todos los modelos base usan el mismo marco de evaluación interno. También afirma que las puntuaciones dentro de 0.3 se consideran equivalentes. Los valores son:
| Modelo base en la ficha del modelo | LongBench-V2 (EM) | Disparos |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
La diferencia de 0.5 puntos entre V4-Flash-Base y V4.1-Flash-Base es mayor que la banda de equivalencia de 0.3 indicada en la ficha, pero sigue siendo una comparación de benchmark estrecha. El 45.2 no es “45.2% de precisión en PDF largos”. Es una puntuación de coincidencia exacta para un modelo base, conjunto de benchmark, configuración de prompt y evaluador concretos. No puntúa directamente a un modelo instruct/API alojado que responde a sus preguntas con un prompt diferente.
LongBench-V2 contiene 503 preguntas de opción múltiple en seis categorías, incluidas respuesta a preguntas de un solo documento y de varios documentos, diálogo largo, repositorios de código y datos estructurados. Sus contextos abarcan de 8,000 a 2 millones de palabras. Los autores del benchmark reportan una precisión promedio de 53.7% para expertos con un límite de 15 minutos, y de 50.1% para el mejor modelo de respuesta directa en su evaluación reportada. Su amplitud lo convierte en una prueba de esfuerzo útil, pero un número agregado no puede diagnosticar qué operación documental es sólida o débil. (Artículo de LongBench-V2)
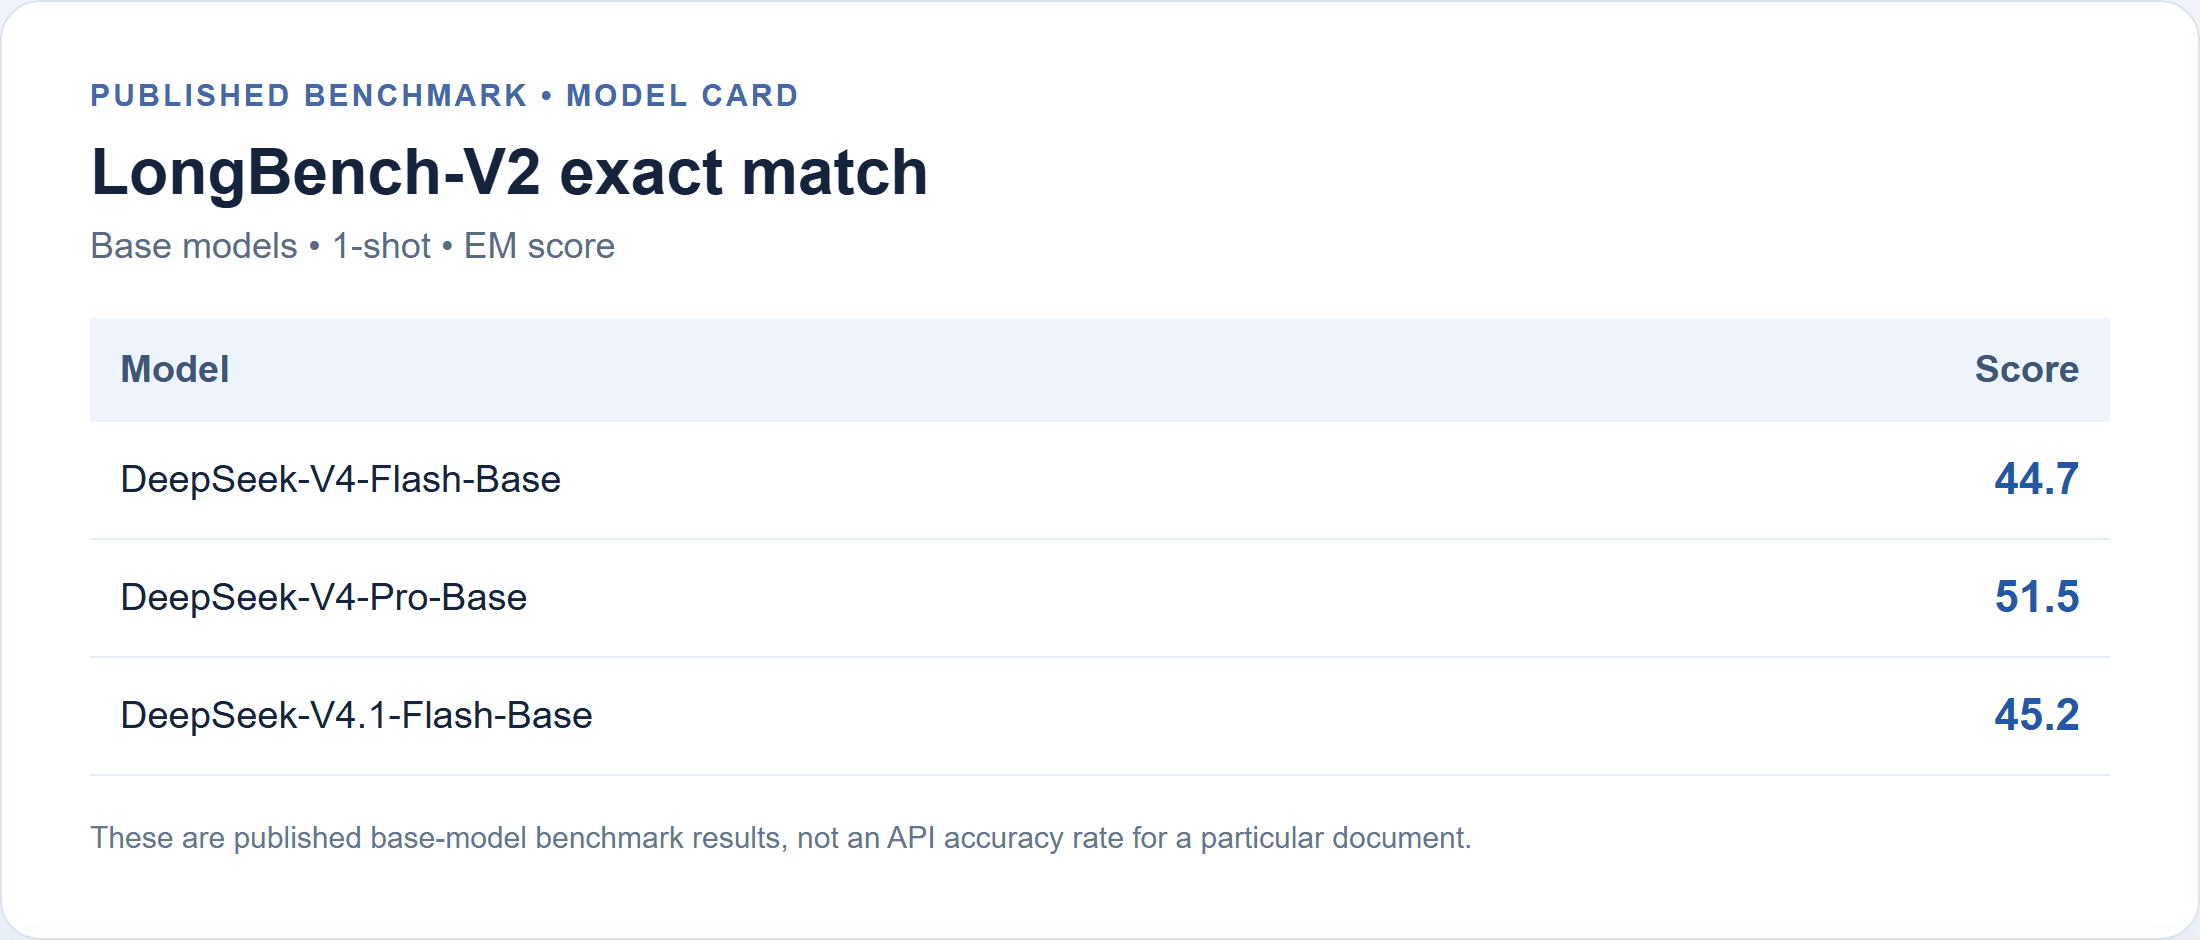
La fila publicada es un resultado de modelo base, 1-shot. No es una tasa de acierto medida de la API.
Hay una advertencia sobre la versión. Las notas de la versión del 17 de octubre de DeepSeek dicen que la API y la aplicación web se actualizaron a V4.1-Flash-1017, y el nombre del modelo de la API sigue siendo deepseek-flash. Las notas enumeran benchmarks actualizados de agentes y razonamiento, pero no reportan un nuevo resultado de LongBench-V2. Así que 45.2 sigue siendo una referencia publicada útil para el modelo base V4.1 Flash, mientras que la precisión del build actual de la API en preguntas de documentos largos sigue sin cuantificar en esas fuentes. No transfiera mejoras de benchmarks no relacionadas a la respuesta a preguntas sobre documentos. (Actualización de DeepSeek V4.1-Flash-1017)
Cómo realizar una prueba justa de precisión en documentos largos
Una evaluación útil necesita una fuente fija, una clave de respuestas y reglas de puntuación. Comience con un informe anual o informe técnico público cuya versión y estructura de páginas se puedan compartir. Guarde el PDF y el texto extraído, registre la URL de origen y la fecha de consulta, e indique si usó extracción de texto nativa u OCR. Evite seleccionar un documento porque ya sabe que el modelo lo maneja bien.
Antes de hacer el prompt al modelo, escriba usted mismo la clave de respuestas a partir de la fuente. Para cada pregunta, registre la respuesta esperada y la página o sección exacta. Esto evita que una respuesta convincente se convierta en el estándar de calificación. Mantenga las preguntas lo bastante específicas para puntuarlas, sin eliminar la ambigüedad que un lector realmente enfrentaría.
Use el mismo documento, conjunto de preguntas, identificador de modelo, prompt, configuración de razonamiento y formato de salida para cada ejecución. Si la API expone controles de temperatura o razonamiento, regístrelos. Ejecute el conjunto más de una vez si desea estimar la variabilidad; una ejecución es una muestra, no una tasa estable. No corrija silenciosamente la salida antes de puntuarla.
Un conjunto compacto puede cubrir cinco oportunidades diferentes de fallo:
| Tarea | Ejemplo de tipo de pregunta | Qué verificar |
|---|---|---|
| Búsqueda puntual | “¿Qué fecha da el informe para la política revisada?” | Valor exacto y página citada |
| Vínculo entre secciones | “¿Cómo se relaciona el riesgo de la Sección 2 con el control de la Sección 7?” | Ambos pasajes y si el vínculo se declara o se infiere |
| Manejo de excepciones | “¿Quién queda excluido de la cobertura indicada?” | Nota al pie, alcance y calificadores |
| Conflicto de versiones | “¿Qué valor se aplica después de la revisión y qué reemplazó?” | Fechas, etiquetas de versión y ambas ubicaciones |
| Información faltante | “¿Qué período de retención especifica el informe para las copias de proveedores?” | Reconocimiento si el documento no dice nada |
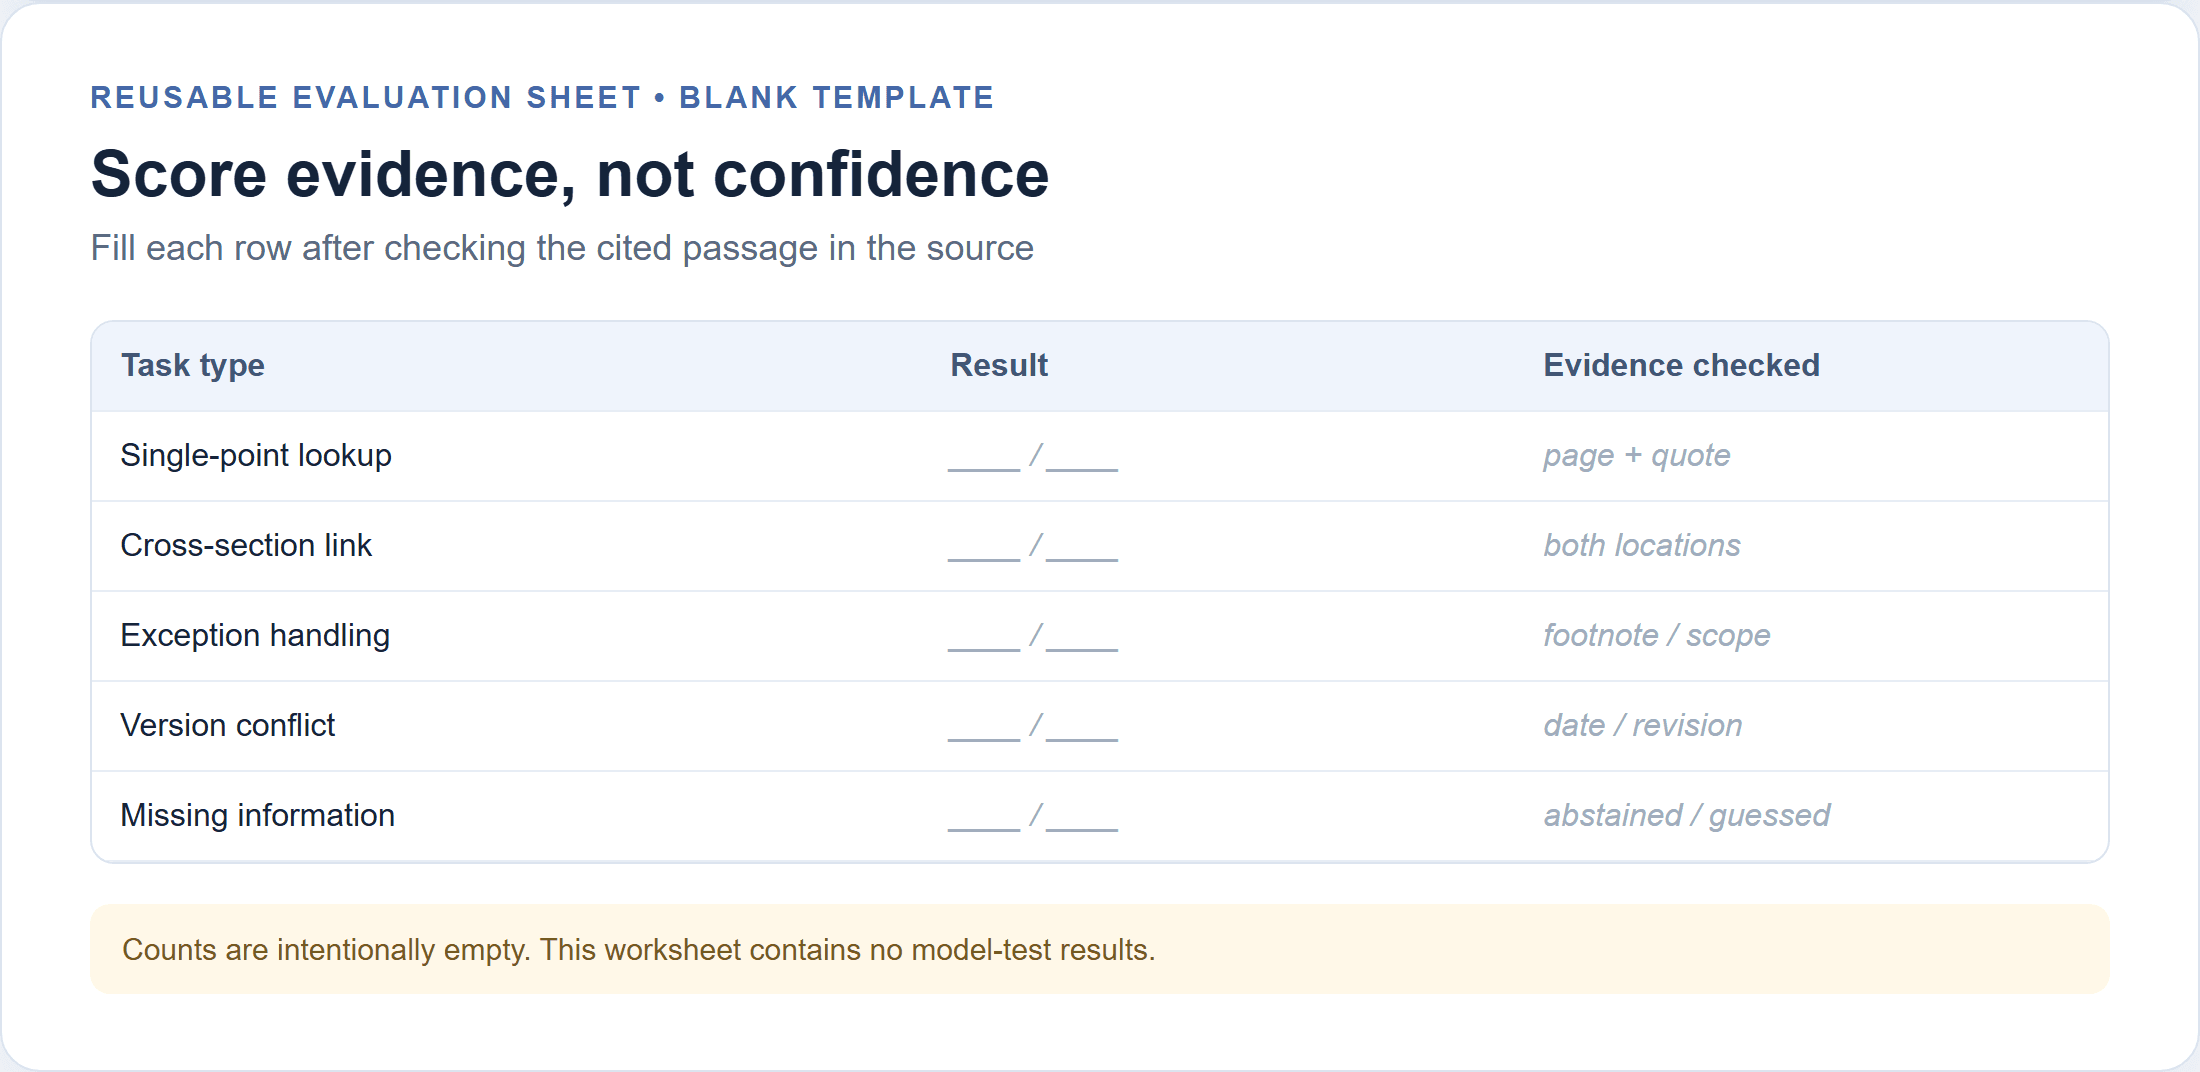
Esta es una hoja de puntuación en blanco, no una tabla de resultados. Complétela solo después de verificar cada respuesta con el documento fuente.
Puntúe cada respuesta como correcta, parcial, incorrecta, no respaldada o correctamente abstenida. Cuente las afirmaciones no respaldadas por separado de las respuestas incorrectas, porque una respuesta puede dar la respuesta principal correcta e inventar un detalle. Compruebe si cada cita apunta al pasaje que respalda la afirmación. Reporte el recuento de preguntas y los recuentos por categoría juntos. Un porcentaje general oculta si el modelo omitió notas al pie o tuvo dificultades solo cuando la información estaba distribuida entre secciones.
Conserve el archivo fuente exacto, la extracción, los prompts, las respuestas sin procesar y la hoja de puntuación. Publique solo material que tenga permiso de compartir y oculte nombres confidenciales o datos de cuentas. Un revisor debería poder rastrear cada respuesta puntuada desde la salida del modelo hasta una página de la fuente guardada.
Dónde suelen fallar las respuestas sobre documentos largos
Sin una ejecución del build actual contra un documento declarado, sería incorrecto afirmar que V4.1 Flash exhibió una tasa de error o un patrón de fallo concretos. Las categorías siguientes son aspectos que hay que inspeccionar, no hallazgos medidos sobre este modelo.
Comience con la pérdida de alcance. Un párrafo del cuerpo puede enunciar una regla mientras una nota al pie la limita a una región, un rango de fechas o una clase de clientes. Pida la excepción explícitamente e inspeccione si el pasaje citado la incluye. Una cita solo del párrafo principal puede ser insuficiente.
Después, compruebe la confusión de versiones. Los informes pueden repetir valores similares en un borrador y una sección revisada. Pídale al modelo que indique la fecha o versión asociada con cada valor en lugar de solicitar solo “el número actual”. Si elige uno en silencio, puntúe la respuesta como incompleta incluso cuando acierte por casualidad.
Las preguntas entre secciones invitan a la inferencia. Un modelo puede combinar dos hechos precisos en una explicación causal que el documento nunca ofrece. Exíjale que etiquete las afirmaciones directas por separado de las inferencias. Luego compare la inferencia con la evidencia y decida si es razonable para la tarea.
Por último, pruebe la abstención. Incluya una pregunta cuya respuesta esté ausente. Una conjetura segura es un fallo aunque suene plausible. Para contratos, cumplimiento normativo, material clínico o análisis financiero de consecuencias importantes, pida a una persona cualificada que revise el texto original antes de usar una conclusión.
Un flujo de trabajo de verificación para respuestas más seguras
Este prompt facilita la auditoría de las respuestas. No puede garantizar la corrección ni reemplazar la revisión de la fuente. Úselo con una extracción que conserve las etiquetas de página y luego haga preguntas específicas en lugar de solicitar un resumen general de un archivo enorme.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Para un informe largo, divida el trabajo por tarea, no automáticamente por un número arbitrario de páginas. Primero pida un mapa de la fuente: títulos de secciones, fechas, términos definidos y tablas relevantes. Luego consulte un tema específico y solicite sus pasajes de respaldo. Para una conclusión entre secciones, proporcione o recupere ambos pasajes en el mismo turno y pida al modelo que explique el vínculo mientras marca cualquier inferencia.
Use un bucle de verificación humana:
- Verifique la página citada y la cita en el archivo original.
- Confirme que la cita incluya excepciones cercanas y encabezados de tabla.
- Marque cada afirmación como directa, inferida, no respaldada o contradicha.
- Corrija el prompt o divida la tarea si la extracción omitió estructura importante.
- Guarde la solicitud y la respuesta sin procesar para que un revisor pueda reproducir la decisión.
Cuando use un endpoint alojado, incluya el uso de tokens en el registro de ejecución. La página de precios de modelos de Atlas Cloud enumera actualmente DeepSeek V4.1 Flash a $0.30 por 1M de tokens de entrada, $1.20 por 1M de tokens de salida y $0.03 por 1M de tokens de lectura de caché, sin descuento indicado. Consulte el listado actual antes de presupuestar. Esta referencia de precios es para Atlas Cloud, no un precio universal de la API de DeepSeek.
Con esas tarifas indicadas, 100,000 tokens de entrada sin caché y 3,000 tokens de salida cuestan aproximadamente $0.033: $0.030 por entrada más $0.0036 por salida.
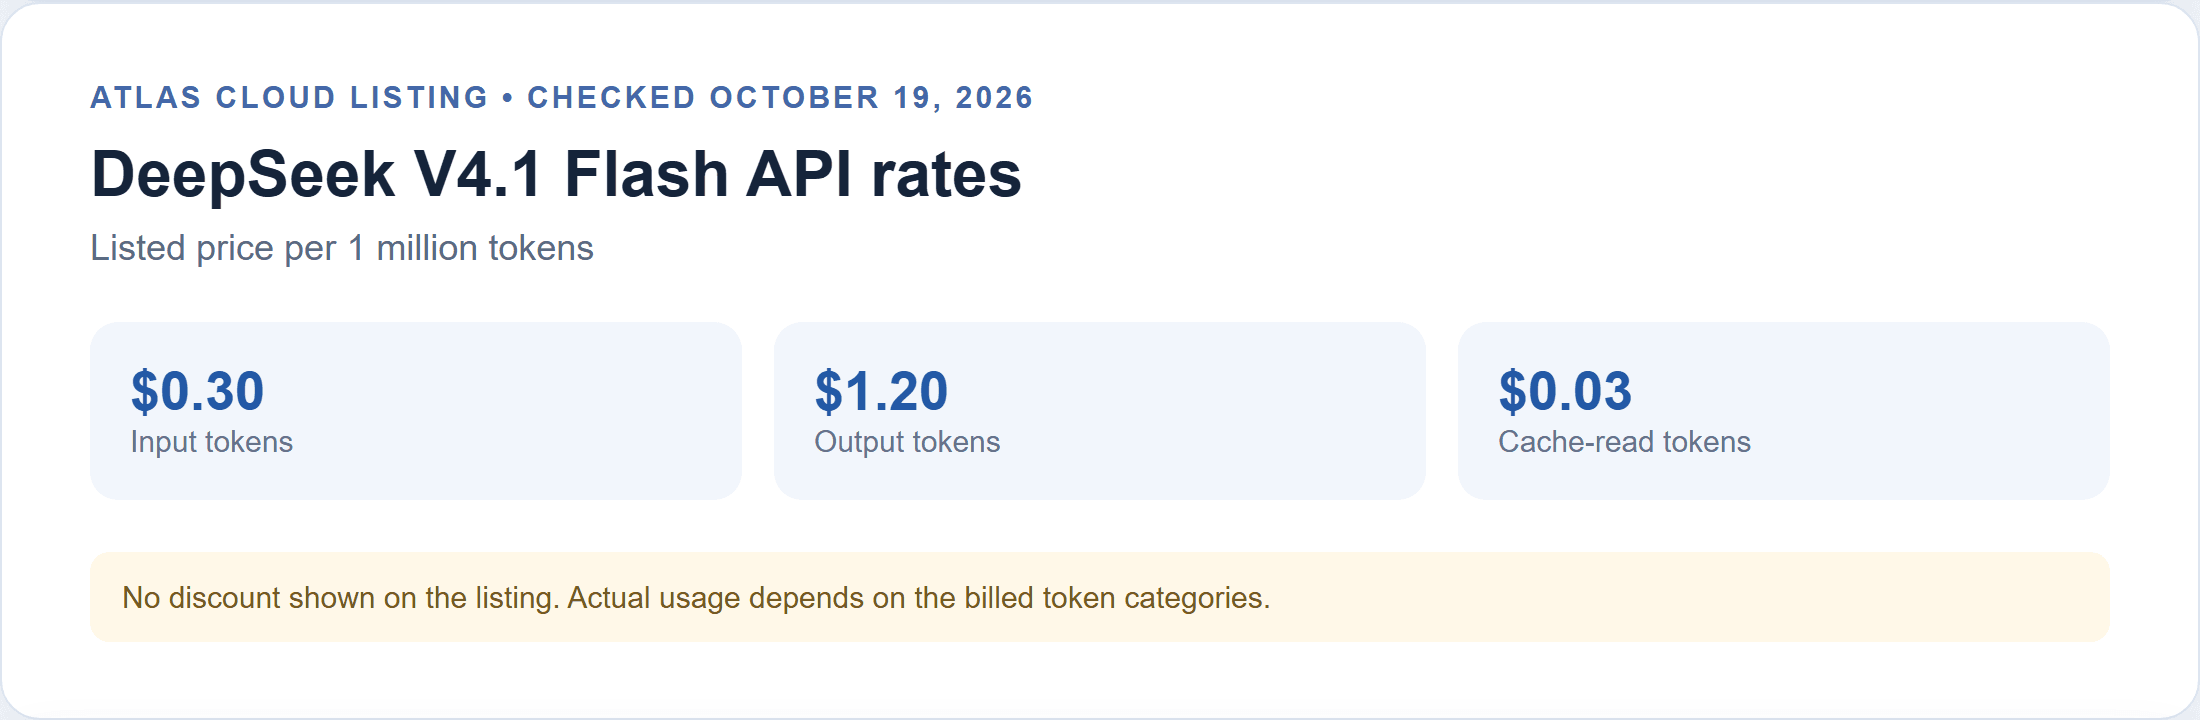
Precios de Atlas Cloud verificados el 19 de octubre de 2026; el listado no muestra descuento. Una entrada de 1M de tokens y una respuesta de 20,000 tokens costarían aproximadamente $0.324 con las mismas tarifas, antes del tratamiento de caché u otros conceptos facturables. Estos son ejemplos aritméticos, no facturas medidas de pruebas de documentos. La entrada real incluye el prompt y el texto extraído; las llamadas repetidas añaden uso. Use los recuentos de tokens devueltos por el proveedor en lugar de estimar a partir del número de páginas.
Cuándo usar DeepSeek V4.1 Flash para documentos largos
Flash es una primera pasada razonable cuando necesita localizar definiciones, reunir fechas, crear un mapa de secciones o redactar un resumen que una persona revisará. Esas tareas tienen rastros de evidencia visibles y son fáciles de volver a ejecutar con preguntas más precisas. Para el trabajo recurrente, conserve preguntas con respuesta conocida y vuelva a ejecutarlas cuando cambie la versión del modelo, el canal de extracción o el prompt.
Añada controles cuando una pregunta combine secciones distantes, dependa de una nota al pie o compare revisiones. Use las citas como ayudas de navegación, no como prueba por sí mismas. Si una respuesta afectará una obligación contractual, una posición de cumplimiento, una divulgación financiera u otra decisión de alto impacto, haga que un revisor cualificado verifique cada afirmación importante en la fuente.
La pregunta útil es si este modelo, en su versión del documento y flujo de trabajo exactos, devuelve respuestas con evidencia que resiste la verificación. Esa es la prueba que puede establecer la precisión del análisis de documentos largos de DeepSeek V4.1 Flash para su propio caso de uso.
Preguntas frecuentes
¿Una ventana de contexto de 1M de tokens significa que un modelo puede analizar con precisión un documento de 1M de tokens?
No. Describe la capacidad de contexto admitida. La solicitud real también incluye instrucciones y presupuesto de salida, mientras que la extracción, los límites de la interfaz y la dificultad de la pregunta afectan si la evidencia útil está disponible y se interpreta correctamente.
¿LongBench-V2 es lo mismo que la precisión de respuesta a preguntas sobre documentos?
No. Incluye varias categorías de tareas de contexto largo y reporta el rendimiento bajo una configuración específica. Es una señal de comparación, no una garantía para un PDF, build de API, prompt o dominio en particular.
¿Debo usar un solo prompt o dividir un documento largo en secciones?
Use un mapa de la fuente y preguntas específicas cuando la estructura importe. Mantenga juntos los pasajes que deban compararse para el paso de síntesis y conserve las etiquetas de página para poder verificar la respuesta.
¿Cómo debo verificar las citas de un resumen generado por IA?
Abra cada página citada en el archivo original, revise la cita y el texto circundante, y confirme que el pasaje respalde la afirmación específica. Verifique los encabezados de tabla y las notas al pie, así como la frase citada.
¿Cómo afectan los tokens de entrada y salida al costo?
Los tokens de entrada cubren el documento, las instrucciones y la pregunta. Los tokens de salida cubren la respuesta. Los prompts más largos, las llamadas múltiples y los pasajes repetidos aumentan el uso; use los recuentos de tokens facturados y la tabla de precios actual del proveedor para las estimaciones.





