

Un desarrollador ve "1M tokens" y se prepara para enviar un repositorio completo, su historial de incidencias y un extenso informe de diseño en una sola solicitud. El detalle clave de la ventana de contexto de 1M de Gemini 4 Argon es que 1,048,576 tokens se comparten entre entrada, pensamiento y salida. No son un millón de tokens de entrada más otro millón para la respuesta. Google indica un límite predeterminado de 65,536 tokens para la salida síncrona, mientras que la decodificación larga puede extender la generación hasta la capacidad compartida restante. La especificación del modelo de Google proporciona los límites; esta guía los convierte en un presupuesto y en una decisión sobre contexto largo, recuperación y fragmentación.
Puntos clave
- El contexto de 1,048,576 tokens es un presupuesto combinado de entrada, pensamiento y salida.
- La salida síncrona predeterminada está limitada a 65,536 tokens; la decodificación larga no añade más contexto.
- Usa contexto largo cuando importen las relaciones entre un conjunto de fuentes conocido; usa recuperación o fragmentación cuando no sea así.
¿Qué significa la ventana de contexto de 1M de Gemini 4 Argon?
El presupuesto de 1,048,576 tokens es compartido
Una ventana de contexto es el límite de tokens disponible para una solicitud. Para Argon, Google documenta un total unificado de 1,048,576. El prompt, el material fuente adjunto, los tokens de pensamiento y la respuesta generada se toman de esta asignación. Describe capacidad, no una promesa de que cada detalle sea igual de fácil de recuperar o razonar.
Si una solicitud contiene 900,000 tokens de fuente, quedan como máximo 148,576 entre pensamiento y salida, antes de las restricciones específicas de la interfaz. Una aplicación que asume que luego puede solicitar una respuesta de 200,000 tokens ha sobrecomprometido el mismo presupuesto.
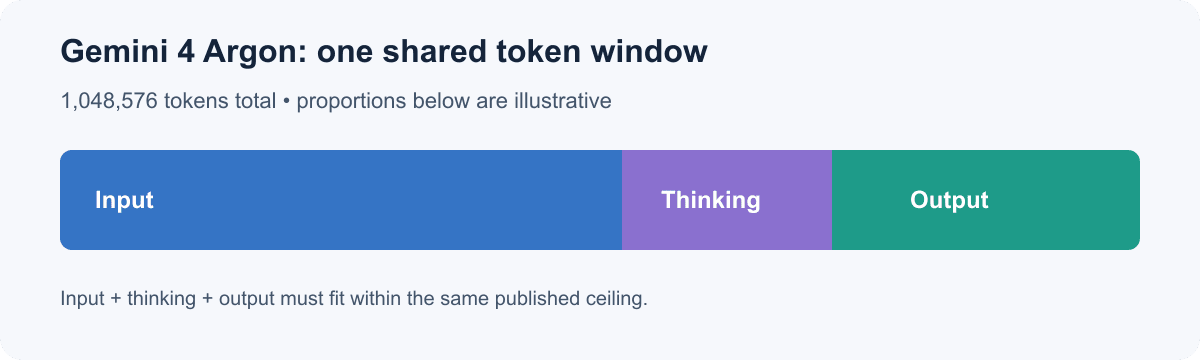
La ventana publicada es un techo compartido. Los tamaños de segmento son conceptuales, no una asignación fija.
La entrada, el pensamiento y la salida se toman de una misma ventana
Una ecuación útil para la planificación es:
input tokens + thinking tokens + output tokens <= 1,048,576
Esta es una verificación de presupuesto, no una afirmación de que los desarrolladores puedan establecer un número exacto de tokens de pensamiento para cada llamada. Google enumera ajustes de pensamiento bajo, medio y alto; el consumo interno puede variar según la tarea y los ajustes. Reserva espacio para el razonamiento en lugar de tratar el resto teórico como capacidad de respuesta garantizada.
Argon acepta entrada de texto, imagen, video, audio y PDF, con salida de texto. La contabilidad de medios no es equivalente al texto sin formato, por lo que un recuento de archivos o de páginas no puede predecir de forma fiable los tokens totales. Inspecciona los metadatos de uso de una solicitud representativa.
Ventana de contexto vs. límite de salida: la diferencia crucial
El límite de salida predeterminado
La página del modelo indica una salida máxima de 65,536 tokens para la generación síncrona predeterminada, aproximadamente una decimosexta parte de la ventana total. Una solicitud puede caber dentro del límite de contexto general y aun así superar el límite de salida activo.
Para muchas aplicaciones, ese valor predeterminado es suficiente. Una revisión de repositorio o una síntesis de documentos suele necesitar una respuesta enfocada, no una tan extensa como el conjunto de fuentes. Una salida acotada es más fácil de revisar, almacenar y pasar a otro paso.
Qué cambia la decodificación larga
La decodificación larga admite una generación mucho más extensa, de hasta 1,048,576 tokens según la especificación del modelo. No amplía la ventana total. Si el prompt ya ocupa la mayor parte, queda menos capacidad para el pensamiento y la salida. La ruta de API, el SDK, la configuración de la solicitud y el manejo de la respuesta también importan, así que consulta la guía de integración actual antes de depender de una respuesta larga en producción.
Usa la decodificación larga solo cuando el entregable realmente necesite material generado extenso, como una gran transformación estructurada devuelta en una sola operación. Si la respuesta se puede dividir en secciones validadas, la generación por etapas puede facilitar la detección y recuperación de resultados incompletos.
Cómo presupuestar tokens de entrada, pensamiento y salida
Comienza por el entregable y luego estima los tokens de fuente con el método de conteo del modelo seleccionado, cuando esté disponible. Cuenta también las instrucciones, los resultados de herramientas, el texto del esquema y el historial de conversación. Reserva un margen para el pensamiento y el error de estimación en lugar de gastar el resto teórico.
Las cifras a continuación son ejemplos aritméticos, no un consumo de razonamiento fijo. El "resto de planificación" es el total después de la entrada supuesta y la reserva de pensamiento apartada. Los límites reales del servicio siguen aplicándose.
| Entrada supuesta | Reserva de pensamiento | Resto de planificación para salida | Ejemplo |
|---|---|---|---|
| 120,000 | 20,000 | 908,576 | Varios manuales, síntesis concisa |
| 500,000 | 40,000 | 508,576 | Revisión de base de código con referencias a archivos |
| 900,000 | 50,000 | 98,576 | Comparación de archivo con una respuesta acotada |
Aritmética ilustrativa a partir de un techo de 1,048,576 tokens; las reservas son suposiciones de planificación.
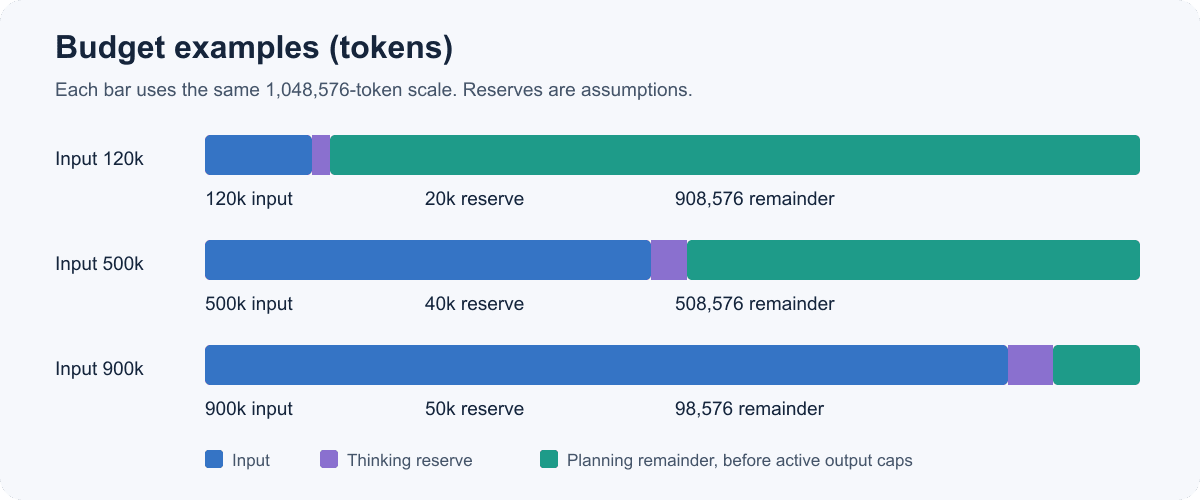
Usa esta lista de verificación para planificar solicitudes:
- Entrada: tokens estimados de fuente y prompt.
- Pensamiento: reserva capacidad según la complejidad de la tarea y los ajustes admitidos.
- Salida: elige un límite que se ajuste al entregable.
- Verificación: suma las tres cantidades y deja margen para el error de estimación.
- Ruta: confirma que el endpoint o SDK seleccionado admita la longitud de salida y el comportamiento de continuación.
Para una revisión de base de código de 500,000 tokens, un equipo podría reservar 40,000 tokens para pensamiento y apuntar a una respuesta de 25,000 tokens. Ese plan usa 565,000 tokens sobre el papel y deja margen para estimaciones imperfectas o instrucciones adicionales. El equipo aún debe verificar el uso real y los límites de generación configurados. La reserva es una herramienta de planificación, no una predicción del razonamiento privado.
Antes de una ejecución por lotes, toma una muestra de más de un tipo de solicitud. Una página breve de documentación, un módulo con mucho código y un PDF con tablas pueden producir recuentos de tokens diferentes aunque sus tamaños de archivo parezcan similares. Cuenta entradas representativas y luego compara las estimaciones con el uso devuelto por la API. Si el reporte real de pensamiento o salida del modelo difiere de tus suposiciones, actualiza la reserva y el límite antes de aumentar el tamaño del lote. Este pequeño paso de calibración ayuda a mantener un flujo de trabajo de contexto largo dentro de su envolvente de tokens y presupuesto.
¿Qué cabe en un millón de tokens?
Documentos, código y material multimodal
Un millón de tokens puede hacer plausible un análisis en una sola pasada para un conjunto de manuales, varios contratos, un árbol de código fuente grande o una transcripción larga con notas. Google ha usado ilustraciones aproximadas, como alrededor de 1,500 páginas de texto o 30,000 líneas de código. Trátalas como ejemplos de escala, no como garantías. La disposición, la densidad del código, el idioma, el formato y la tokenización afectan el recuento.
Para el trabajo con repositorios, incluye en tu estimación archivos de compilación, código generado, comentarios, metadatos de dependencias, pruebas y contexto relevante de incidencias. Luego pregúntate si la tarea necesita todo. Una revisión de arquitectura entre módulos puede beneficiarse de un conjunto amplio de fuentes; una pregunta sobre un mensaje de error probablemente no.
Las entradas multimodales también complican las estimaciones. La duración de un video, el muestreo de fotogramas, el audio, la resolución y el tratamiento de la API pueden afectar el uso y la evidencia que ve el modelo. Para una pregunta concreta, incluye solo los medios relevantes e inspecciona el uso de una solicitud representativa antes de escalar.
Los recuentos de tokens no son recuentos de páginas
Un token es una unidad de procesamiento del modelo, no una palabra, un carácter, una página ni una línea. Los identificadores, las tablas, el código fuente y la escritura en idiomas distintos del inglés pueden tokenizarse de forma diferente a la prosa común. Una estimación de páginas no puede decirte si tu colección concreta cabe.
La capacidad también es diferente de la calidad. Que un conjunto de fuentes quepa no demuestra que el modelo encontrará cada excepción oculta, preservará cada dependencia o resolverá correctamente pasajes en conflicto. La especificación establece un límite, no un recuerdo exhaustivo ni una puntuación de precisión específica de la tarea. Para conclusiones importantes, solicita ubicaciones de las fuentes y valida las afirmaciones importantes contra los originales.
Cuándo ayuda una ventana de 1M y cuándo no
El contexto largo es más útil cuando una respuesta depende de relaciones dispersas en material que una consulta simple podría no recuperar. Es menos convincente para preguntas concretas repetidas en un corpus cambiante, donde la recuperación puede seleccionar un conjunto de evidencia más pequeño. Estas son compensaciones del flujo de trabajo, no una clasificación universal de precisión.
| Enfoque | Considéralo cuando | Compensación |
|---|---|---|
| Solicitud de contexto largo | Un análisis puntual necesita relaciones entre un conjunto de fuentes conocido | Una entrada grande puede aumentar el costo y la latencia; verifica la cobertura |
| Recuperación | Los usuarios hacen preguntas repetidas en un corpus cambiante | La indexación y la recuperación determinan qué evidencia llega al modelo |
| Fragmentación | Los documentos se pueden procesar como unidades o etapas independientes | Las relaciones entre fragmentos necesitan reconciliación |
| Híbrido | Necesitas una orientación amplia seguida de verificaciones de evidencia enfocadas | Más orquestación y manejo de estado |
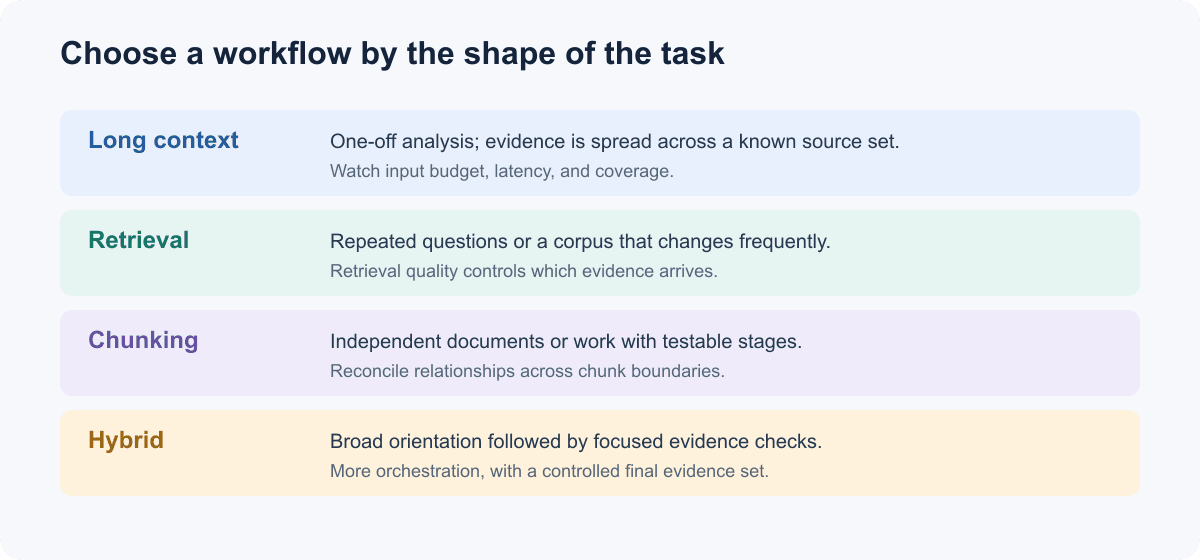 Elige según la forma de la tarea y el patrón de consulta, luego valida con entradas representativas.
Considera el contexto largo para comparar políticas cuyas cláusulas se afectan entre sí, revisar un cambio en muchos módulos de software o sintetizar documentos donde un detalle de una fuente cambia la interpretación de otra. La recuperación encaja con preguntas de soporte repetidas contra una base de conocimiento en crecimiento. La fragmentación funciona cuando las unidades de fuente son independientes o cada etapa tiene una salida comprobable. Un flujo de trabajo híbrido puede mapear primero la colección y luego recuperar y verificar pasajes para una respuesta final.
Evalúa las opciones con las mismas preguntas representativas. Registra si se incluyó la evidencia necesaria, si las citas apuntan a los pasajes correctos, el uso de tokens, el tiempo de respuesta y el esfuerzo de recuperación tras una respuesta incompleta. Eso le da a tu equipo evidencia para su carga de trabajo en lugar de asumir que una ventana más grande la mejora automáticamente.
Uso de Gemini 4 Argon para tareas de contexto largo
Confirma el ID del modelo y la ruta de la solicitud
Google indica el ID del modelo de la API de Gemini como `gemini-4-argon`. Confirma que esté habilitado para tu cuenta y que la superficie exacta de la API admita las funciones que necesitas. El mismo nombre de modelo no garantiza que cada proxy, SDK, consola o cliente exponga límites idénticos o el mismo comportamiento de decodificación larga.
Antes de producción, verifica:
- El ID del modelo y la disponibilidad para tu cuenta o región.
- El límite de salida síncrona y cómo se solicita o devuelve la decodificación larga.
- Si el SDK maneja la continuación y cómo reporta respuestas parciales o fallidas.
- Los ajustes de pensamiento admitidos, las herramientas, el almacenamiento en caché y las modalidades para la API seleccionada.
- Los campos reales de uso de entrada y salida de la solicitud.
La guía de contexto largo de Google describe el presupuesto unificado. Su guía de SDK y API puede cambiar, así que fija una versión de SDK admitida, inspecciona el ejemplo actual y prueba de integración el mismo transporte y manejo de respuesta que planeas para producción. No copies nombres de parámetros de una integración de modelo anterior sin comprobar que sigan aplicándose.
Haz que el contrato de salida sea más pequeño que el conjunto de fuentes
Dale al modelo una tarea acotada y una forma de respuesta. Para una auditoría de repositorio, solicita hallazgos agrupados por severidad con rutas de archivo y referencias de línea, e indica si se deben incluir hipótesis o solo defectos confirmados. Para una comparación de contratos, nombra las cláusulas y solicita identificadores de sección o breves extractos de apoyo. Esto es más fácil de revisar que "analiza todo". Para respuestas grandes, planifica la continuación y la finalización parcial. Conserva identificadores y fragmentos de respuesta cuando el SDK los exponga, valida la salida estructurada antes de usarla en pasos posteriores y reintenta solo la parte fallida cuando sea posible. Estas son salvaguardas que se deben implementar y verificar, no una afirmación de que cada SDK maneja las interrupciones de forma idéntica.
Precios y acceso: qué verificar antes de ejecutar
El anuncio de Google actualmente indica tarifas introductorias de $2 por millón de tokens de entrada y $10 por millón de tokens de salida hasta el 30 de noviembre de 2026, seguidas de tarifas declaradas de $4 y $20 por millón. Esto es sensible al tiempo: vuelve a consultar el anuncio oficial de Gemini 4 Argon antes de publicar o pronosticar gasto. Estima la entrada y la salida por separado, porque las cargas de trabajo con mucho prompt y con mucha generación tienen perfiles de costo diferentes.
La disponibilidad de Argon a través de Atlas Cloud no está confirmada en las páginas de directorio consultadas para este artículo. El catálogo de modelos Gemini de Atlas muestra los modelos Gemini y los detalles de acceso que se indican actualmente allí; no establece que Argon esté disponible. Confirma una página de detalles, el protocolo y el precio específicos del modelo antes de enrutar solicitudes o comparar costos.
Comienza con una solicitud representativa y registra las versiones del modelo y del SDK, el uso de tokens, la latencia, los errores y las comprobaciones de calidad específicas de la tarea. Revisa el presupuesto y la elección de recuperación cuando cambien los conjuntos de fuentes o los patrones de consulta. La ventana de contexto de 1M de Gemini 4 Argon es útil cuando su amplitud resuelve un problema real entre fuentes y tu solicitud tiene un presupuesto claro y un plan de verificación.
Preguntas frecuentes
¿La ventana de 1M de Gemini 4 Argon se comparte entre entrada y salida?
Sí. Google define una única ventana de 1,048,576 tokens compartida entre entrada, pensamiento y salida. La cantidad que queda para una respuesta depende de la solicitud y de los límites de interfaz aplicables.
¿Cuál es el límite de salida predeterminado de Gemini 4 Argon?
La especificación indica 65,536 tokens para la salida síncrona predeterminada. La decodificación larga puede admitir una generación mayor, sujeta a la capacidad compartida restante y a la ruta de API.
¿Puede Gemini 4 Argon generar 1M de tokens en una sola respuesta?
La página del modelo indica decodificación larga de hasta 1,048,576 tokens de salida, pero esta es una capacidad máxima, no una garantía de que una solicitud que contenga entrada también pueda devolver un millón de tokens. La entrada y el pensamiento ocupan la misma ventana total.
¿Una ventana de contexto de 1M significa que cada detalle se recordará con precisión?
No. Describe el presupuesto máximo de tokens, no una recuperación o un razonamiento perfectos. Exige referencias de evidencia y prueba casos límite conocidos de tu propio material.
¿Gemini 4 Argon está disponible actualmente a través de Atlas Cloud?
No pude confirmar un listado de modelo ni una página de detalles específicos de Argon en el catálogo de Atlas Cloud consultado para este artículo. Consulta el directorio actual antes de asumir compatibilidad; el enlace al catálogo de Gemini anterior no establece por sí mismo la disponibilidad de Argon.


