Una escena de dos personas se vuelve convincente cuando puedes ver y oír quién es dueño de cada línea. Para que el diálogo con múltiples hablantes de Gemini Omni 1.2 Flash sea fácil de seguir, dale a cada personaje una identidad visual y vocal fija, escribe líneas cortas en orden de habla y revisa el video terminado con tus ojos y oídos. La actualización de Google de noviembre de 2026 admite habla con múltiples hablantes más natural y clips de hasta 15 segundos, pero un prompt no puede garantizar una asignación limpia de hablantes en el primer render. Empieza con un intercambio simple de 2 personas, luego añade un tercer turno o ambiente de calle solo después de que puedas juzgar el traspaso básico.
Puntos clave
- Gemini Omni 1.2 Flash genera video con sonido nativo, incluido diálogo; es diferente de los modelos de texto a voz de Gemini solo de audio.
- Usa hablantes con nombre, líneas citadas exactas, posiciones claras y un oyente silencioso para cada turno.
- Deja espacio para pausas dentro del máximo de 15 segundos, luego verifica cada línea contra el clip.
- Calcula el precio de un render a partir de su duración y resolución seleccionadas, no de la tarifa más baja anunciada por una plataforma.
¿Qué significa diálogo con múltiples hablantes en Gemini Omni 1.2 Flash?
El modelo crea una escena corta en la que las personas pueden hablar como parte del audio y video generados. La prueba práctica es si un espectador puede saber quién dice cada línea sin leer una transcripción. Las palabras, la voz, la persona visible y el movimiento de la boca deben coincidir al mismo tiempo. Un clip puede parecer convincente con el sonido silenciado y aun así fallar esa prueba.
Google anunció Gemini Omni 1.2 Flash el 5 de noviembre de 2026, con hasta 15 segundos de video generado o editado. Describe diálogo más fluido, sincronización labial más clara y condicionamiento distinto para múltiples hablantes. Esas son afirmaciones de capacidad, no una promesa de que cada guion se entregará exactamente como está escrito (anuncio de Google de noviembre de 2026).
La demostración publicada por Google muestra la capacidad que anunció. Es independiente de los tres casos de video proporcionados a continuación.
¿Qué cambió respecto a Gemini Omni 1.1 Flash?
La comparación oficial le da a 1.2 un límite superior más largo: 15 segundos en lugar de 10. También menciona mejoras en habla, sincronización labial, seguimiento de referencias y edición conversacional. Los 5 segundos adicionales hacen más plausible escribir un intercambio de 3 turnos, pero una duración más larga no crea más tiempo de habla si un director también pide pausas, reacciones físicas y cambios de escena.
La interpretación más segura es direccional. Un mejor condicionamiento puede hacer que el diálogo sea más fácil de dirigir, mientras que cada clip entregado aún necesita inspección. Un creador puede usar el límite de 15 segundos para fijar un objetivo de guion. Un productor que prometa texto legal exacto o una coincidencia de voz precisa debe tratar la salida generada como un borrador hasta que pase la revisión.
Diálogo en video vs texto a voz con múltiples hablantes
Los modelos de texto a voz de Gemini aceptan texto y devuelven audio. Su configuración de hablante y elecciones de voz pertenecen a ese flujo de trabajo de audio, que Google documenta por separado (documentación de texto a voz de Gemini de Google, consultada en noviembre de 2026). La ruta de texto a video de Gemini Omni 1.2 Flash acepta un prompt de escena y produce video con sonido nativo. Un ejemplo de speech_config de texto a voz no es un control de video de Gemini Omni 1.2 Flash. Estos ejemplos describen el carácter vocal en texto; no afirman subir, clonar ni seleccionar una voz grabada. Si un brief requiere la voz de un actor específico, verifica ese acceso y consentimiento por separado antes de planificar la toma.
Si tu entregable es una conversación de pódcast o una locución fija, usa texto a voz y edita la imagen alrededor de ese audio. Si son dos personas hablando visiblemente en una escena generada, usa el video de Gemini Omni 1.2 Flash y prueba la alineación en la salida real.
¿Dónde puedes ejecutarlo y cuánto costará un clip?
Elige la ruta de texto a video
Google incluye Gemini Omni 1.2 Flash en sus productos creativos y para desarrolladores. Para una prueba reproducible, usa una ruta: Atlas Cloud ofrece el modelo, y su playground de texto a video de Gemini Omni 1.2 Flash es donde pegar los prompts a continuación. El ID de la ruta es google/gemini-omni-1.2-flash/text-to-video. Los prompts a continuación usan solo texto, sin referencias de imagen, movimiento o voz.
Los prompts solicitan 12 segundos en 16:9 para la oficina, 15 segundos en 16:9 para la cafetería y 12 segundos en 16:9 para la entrevista callejera. Los tres archivos proporcionados son 720p. Confirma los controles en vivo y los valores seleccionados antes de pulsar Run. Una configuración anunciada en una página de producto no es prueba de que una ejecución de prueba concreta la haya aceptado. Guarda los valores seleccionados y la cotización con cada salida. Esto hace que cada render sea evidencia útil: puedes comparar el prompt con la resolución y la ruta seleccionadas al revisar su salida. Esta guía especifica la ruta de texto a video, por lo que un resultado de una ruta de imagen a video o de referencia a video debe identificarse por separado.
Los archivos de video proporcionados no incluyen una captura completa del playground, la configuración seleccionada ni una cotización previa al envío. Por lo tanto, su ruta y configuración permanecen sin verificar.
| Ruta | Entrada para esta guía | Mejor opción | Dónde verificar el costo |
|---|---|---|---|
| Productos creativos de Google | Un prompt de escena; los controles varían según el producto | Creación manual en el editor de Google | La pantalla del plan o créditos actual |
| API de Google | Una solicitud de video para desarrolladores | Integración de aplicaciones | El precio de Google para la resolución exacta |
| Texto a video de Atlas Cloud | Prompt, duración, relación de aspecto, resolución | Repetir estas pruebas solo de texto en un playground | La cotización previa al envío de la configuración seleccionada |
Verifica el precio antes de renderizar
Google cotiza $0.07 por segundo generado para 720p a través de su API, 30% menos que Gemini Omni 1.1 Flash. A esa tarifa cotizada, 12 segundos de 720p son $0.84 antes de cualquier otro trabajo facturable. Ese cálculo no es una cotización de Atlas Cloud para los archivos proporcionados; su ruta y facturación no están verificadas. Los créditos en Flow u otro editor siguen las reglas propias de ese producto.
Atlas Cloud lista una tarifa inicial por segundo más baja en su catálogo de modelos, pero el mínimo puede corresponder a otra resolución o configuración. Lee la cotización en vivo después de elegir duración y resolución. Un borrador en 360p puede ayudar a explorar un prompt; es una generación separada en lugar de una vista previa fotograma a fotograma de un render posterior en 1080p.
Ajusta dos voces a una escena de 15 segundos
Dale a cada hablante una identidad visual y vocal
Escribe descripciones que un revisor pueda verificar. "El hablante A está a la izquierda con una camisa azul marino" es más claro que "el primer compañero de trabajo". Añade una distinción audible, como tono medio frente a más grave. Mantén nombres, ropa, posición y voces consistentes en todo el prompt. Estos anclajes hacen que una línea intercambiada sea más fácil de detectar.
La identidad visual importa porque solo el audio puede engañar a un revisor. Si las voces difieren pero se mueve la boca equivocada, el clip tiene un problema de sincronización labial. Si se mueve la boca correcta pero la voz de A cambia en el segundo turno de A, hay deriva de voz. El ejemplo de la cafetería trae de vuelta a A después de B para que un revisor pueda comprobar si la voz de A se mantiene consistente.
Calcula el tiempo para habla y reacción
Lee el guion en voz alta al ritmo previsto. Incluye una pausa natural en cada traspaso, luego deja espacio para que un oyente reaccione y para que el plano inicial establezca ambos rostros. El guion revisado de oficina tiene 5 turnos en 12 segundos. La cafetería tiene 8 turnos cortos en 15 segundos, lo que lo convierte en la prueba de tiempo más exigente aquí. Estos son guiones de ejemplo, no un umbral universal de palabras por segundo ni una promesa sobre la salida.
| Presupuesto de escena | Secuencia hablada | Tiempo necesario más allá de las palabras |
|---|---|---|
| Oficina de 12 segundos | A-B-A-B-A | Establecer a ambas personas y encajar 4 traspasos |
| Cafetería de 15 segundos | Ocho turnos alternos | Siete traspasos con poco tiempo libre |
| Calle de 12 segundos | A-B-A-B-A | Cuatro traspasos sobre ambiente de calle |
Una línea larga invita a apresurarse u omitir cerca del final. Si el borrador ocupa casi los 15 segundos al leerlo en voz alta, acórtalo antes de la generación. Si el escenario necesita más diálogo, planifica tomas separadas y verifica la continuidad como otra tarea de producción. Mantén los rostros visibles durante las líneas habladas en el primer intento. Los cortes rápidos y las bocas ocluidas dificultan juzgar la asignación de hablantes. Haz una lectura cronometrada de mesa con dos personas si el orden de las líneas importa. Haz que una persona diga A y la otra B mientras una tercera anota dónde termina cada oración. Si la última palabra cae en el límite del clip, elimina una cláusula o un compás de reacción antes de renderizar. Un guion más corto es más fácil de auditar porque el revisor puede reproducir todo el intercambio sin adivinar si una línea debía continuar fuera de pantalla.
Cómo hacer prompts a Gemini Omni 1.2 Flash para 2 hablantes
Un prompt útil se lee como un brief de rodaje compacto: escenario y cámara, identidades, diálogo exacto, luego sonido y reglas de exclusión. Este orden también le da al revisor una lista de verificación. Es un método de prompting, no una garantía documentada de control. Mantén las etiquetas de los personajes idénticas desde el párrafo de identidad hasta el bloque de diálogo. Evita referirte a la misma persona como A y “el cliente” en instrucciones sobre un turno posterior, a menos que la correspondencia ya sea explícita. Un lector debería poder dibujar dos columnas, una por persona, y colocar cada acción solicitada y línea hablada en exactamente una columna.
Usa etiquetas de hablante explícitas y líneas entre comillas
Usa una línea por turno con Speaker A: o Speaker B: y palabras entre comillas. Especifica quién permanece en silencio. Pedir "una discusión sobre la preparación del lanzamiento" permite improvisación. Un guion exacto te permite marcar inmediatamente una palabra faltante o reescrita.
Aquí está el primer prompt para copiar. Mantiene a ambos adultos en un plano continuo para que el espectador pueda inspeccionar cada boca.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
Render de oficina proporcionado de 12 segundos en 720p. Ambas personas permanecen visibles; las cinco líneas habladas y la sincronización labial aún requieren una revisión auditiva.
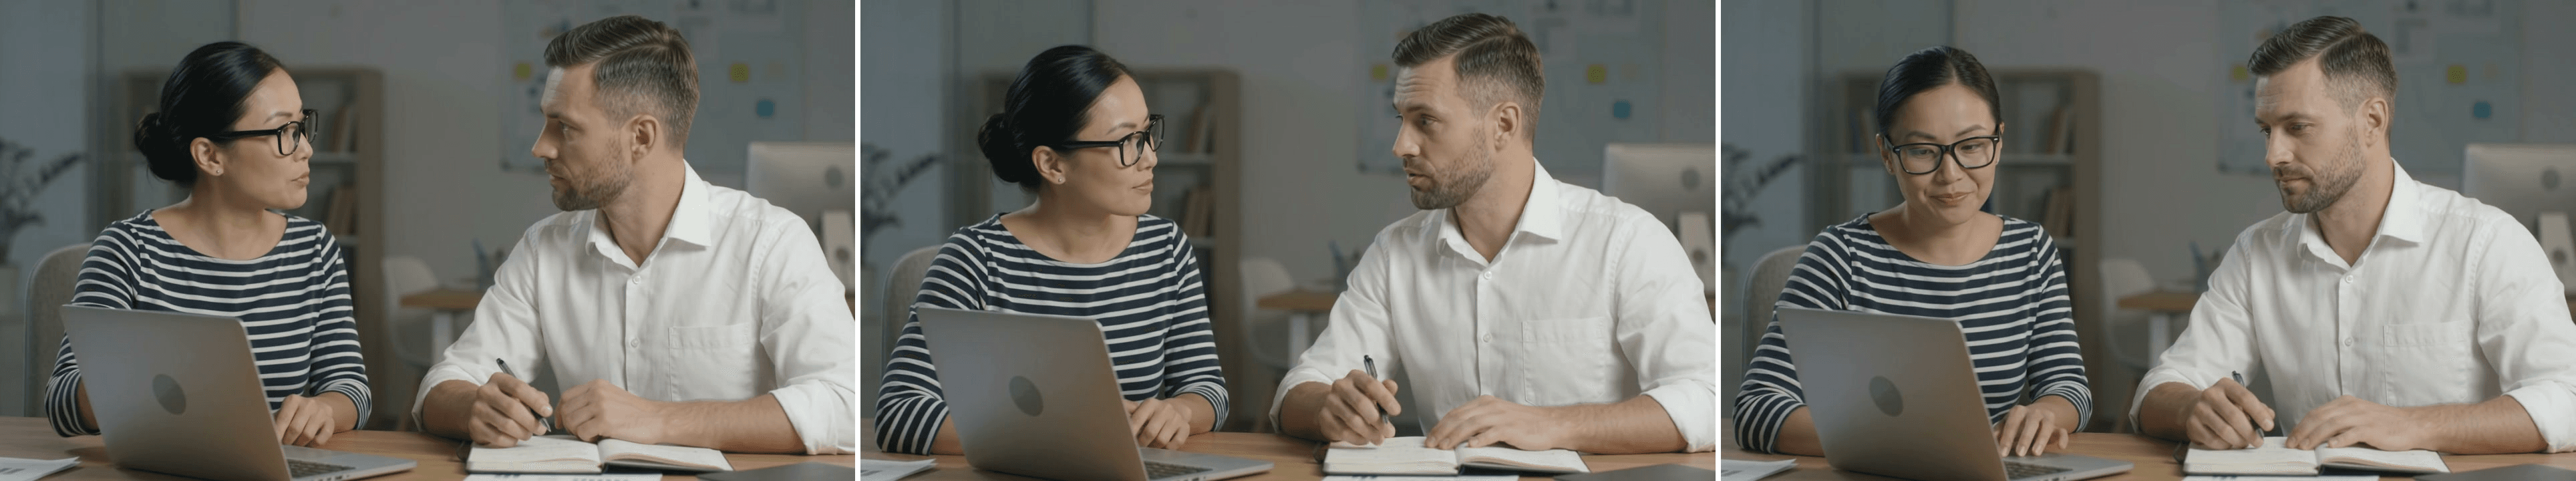 Fotogramas del caso A, de izquierda a derecha (aprox. 0:02, 0:05, 0:10): la mujer mira a su compañero; él parece responder mientras ambos permanecen en cuadro; vuelven su atención a la laptop y el cuaderno.
Controla la cámara sin perder al hablante
Un plano medio continuo de 2 personas es una elección de diagnóstico. Ambos rostros permanecen a la vista, así que un traspaso omitido no puede esconderse detrás de la edición. El modelo aún puede variar el encuadre, por lo que el archivo final necesita inspección.
Una vez que el traspaso funcione para tu propósito, prueba un movimiento modesto que conserve ambos rostros. El prompt de calle solicita uno en un encuadre 16:9 que mantiene ambos rostros visibles, lo que facilita juzgar los movimientos de boca. Es una razón para establecer primero la línea base de oficina.
Mantén el audio de fondo por debajo del diálogo
Nombra el ambiente y su prioridad. Un tono de sala silencioso le da al clip de oficina poco con lo que competir con el habla. Un sonido suave de cafetería añade contexto mientras mantiene las líneas comprobables. El prompt de calle pide pasos y sonido distante por debajo de ambas voces, sin habla de transeúntes.
Las instrucciones negativas pueden reducir el audio no deseado, pero siguen siendo solicitudes. Escucha si hay una tercera voz, narración, música y audio de marca. Revisa también la imagen en busca de subtítulos y logotipos.
3 escenas de diálogo que muestran quién habla cuándo
Los tres archivos de video proporcionados muestran las escenas previstas de oficina, cafetería y calle. Su contenido visual puede inspeccionarse aquí, pero los archivos no establecen qué ruta o configuración los produjo. Los prompts a continuación son solicitudes reproducibles, no una afirmación de que la salida dijo cada palabra correctamente. La oficina comprueba 5 turnos, la cafetería prueba 8 turnos rápidos y la calle añade sonido ambiental.
| Caso | Solicitud del prompt | Archivo proporcionado | Comprobación principal |
|---|---|---|---|
| A: traspaso en oficina | 12 s, 16:9, 5 turnos | 12 s, 16:9, 720p | Cinco líneas, bocas correctas |
| B: intercambio en cafetería | 15 s, 16:9, 8 turnos | 15 s, 16:9, 720p | Ocho líneas, voces estables |
| C: entrevista callejera | 12 s, 16:9, 5 turnos | 12 s, 16:9, 720p | Audibilidad en calle y turnos de hablante |
Un traspaso de oficina de cinco turnos
Usa el prompt completo y el video de arriba. Ambos compañeros permanecen en el mismo plano, así que cada uno de los cinco turnos solicitados tiene una persona visible que comprobar. Registra cada línea audible contra el texto e inspecciona la boca activa. El archivo proporcionado establece la escena y la duración, pero sus palabras y sincronización labial no han sido verificadas de forma independiente.
Un traspaso claro en un clip respaldaría una conclusión sobre ese clip únicamente, no una tasa de éxito de todo el modelo. Conserva el primer resultado para que cualquier revisión pueda compararse con el original.
Un intercambio de cafetería de ocho turnos
Solicita 15 segundos en 16:9. Ocho turnos cortos ponen bajo presión la propiedad repetida de la voz y el tiempo. Compara la primera y la última línea de cada persona, luego comprueba si alguna línea se superpone o desaparece. El archivo proporcionado es 720p.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
Una sesión de preguntas y respuestas al aire libre
Solicita 12 segundos en 16:9. Esto añade un movimiento de cámara suave y sonido ambiental. El archivo proporcionado es 16:9 a 720p y puede revisarse para cinco turnos de hablante y audibilidad en la calle.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
Reproducción combinada: 0:00–0:15 es el caso B, el intercambio en la cafetería; 0:15–0:27 es el caso C, la entrevista callejera. Ambos clips de origen se incluyen completos.
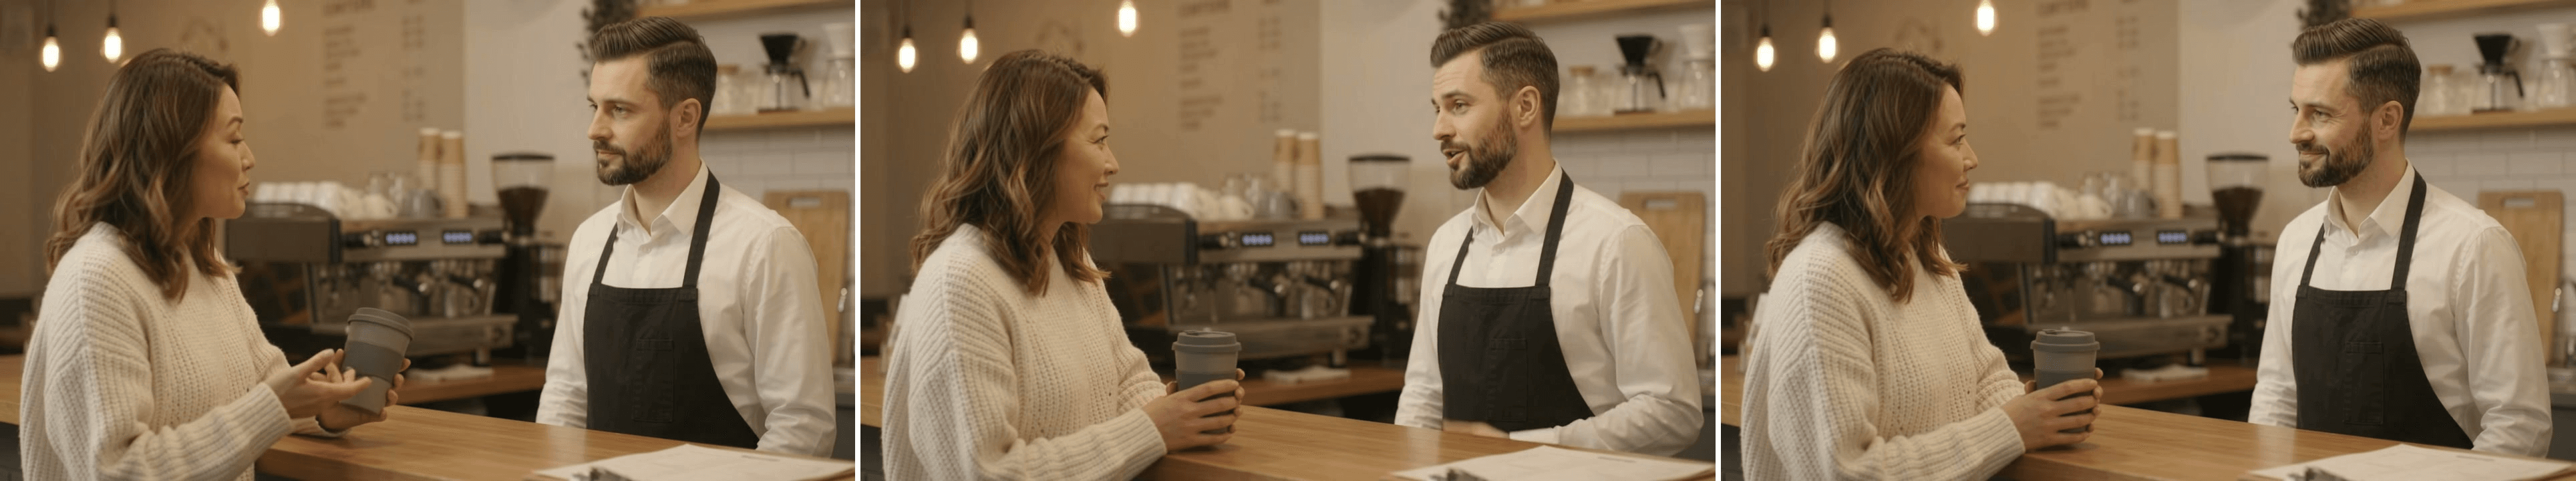 Fotogramas del caso B, de izquierda a derecha (aprox. 0:02, 0:08, 0:13 del video combinado): la clienta muestra su vaso; el trabajador de la cafetería parece responder; se miran al final.
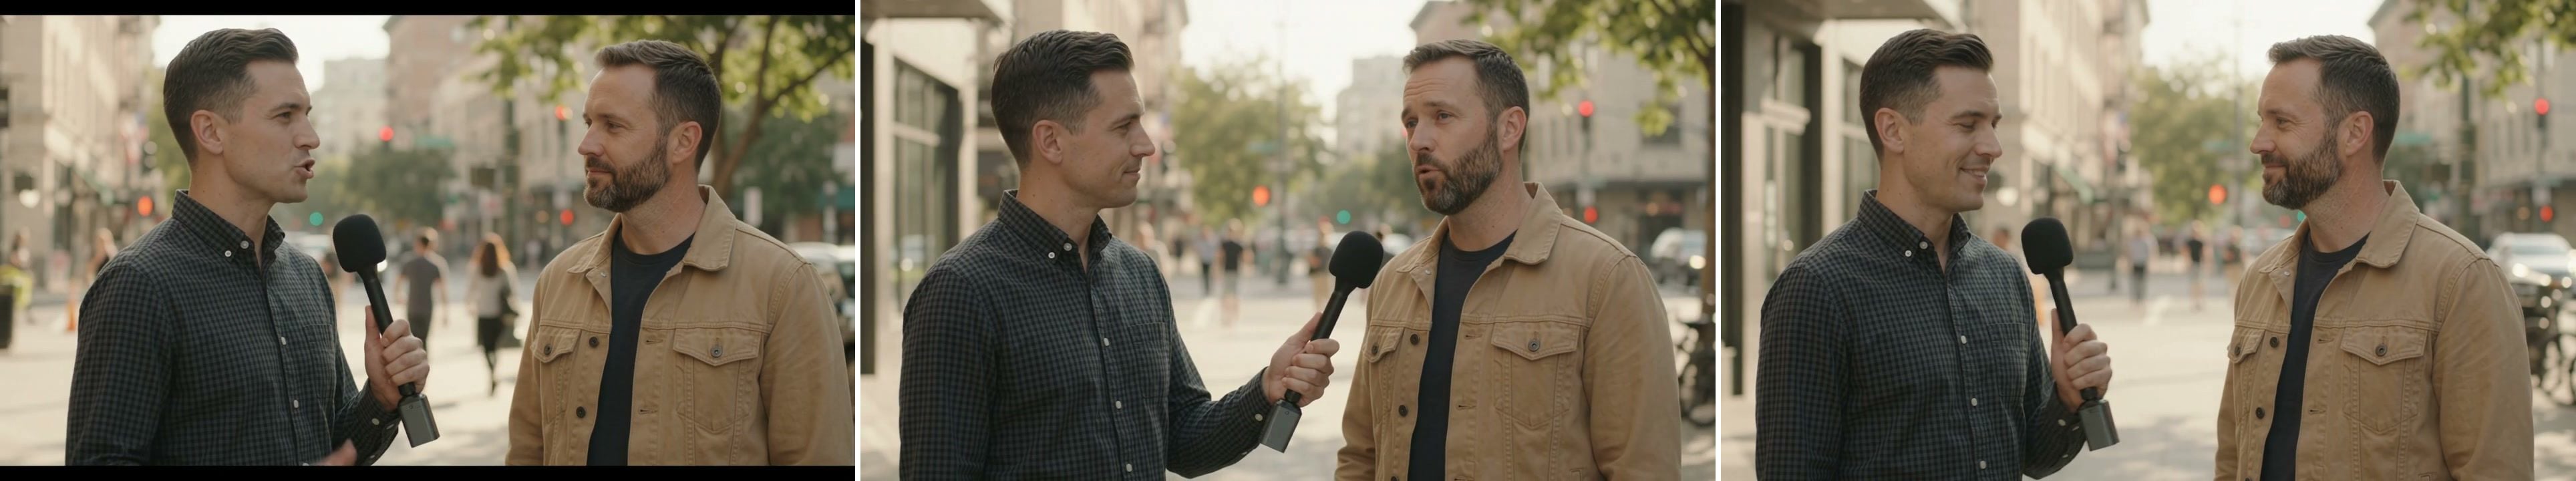
Fotogramas del caso C, de izquierda a derecha (aprox. 0:16, 0:19, 0:26 del video combinado): el entrevistador sostiene el micrófono; lo gira hacia el entrevistado; ambos se miran al final.
Verifica el orden de hablantes, la sincronización labial y la deriva de voz antes de publicar
Revisa el clip línea por línea
Descarga el video. Reprodúcelo una vez sin leer el guion para encontrar confusión obvia, luego vuelve a reproducirlo con el prompt al lado. Pausa en cada turno y anota lo que oyes. Inspecciona ambas bocas y anota el habla fuera de los turnos guionizados. Para una revisión repetible, registra la hora de inicio y fin de cada línea audible, el hablante esperado, la voz que oíste y la boca visible que se movió. Escribe “poco claro” si un rostro está oculto o el sonido enmascara una palabra. No conviertas una celda poco clara en aprobada porque el resto de la escena parezca convincente. Un segundo oyente que no haya visto el prompt puede identificar quién cree que habla; compara ese juicio con el guion antes de decidir si un espectador público entenderá la escena.
Comprueba 4 cosas en cada línea:
- Palabras: ¿Se dijeron las palabras citadas en orden, sin una terminación omitida o una oración añadida?
- Dueño de la voz: ¿Sonó la persona nombrada como el hablante, especialmente cuando A volvió?
- Sincronización visible: ¿Se movió la boca de esa persona mientras el oyente permanecía en silencio?
- Otro contenido: ¿Añadió el clip un narrador, transeúnte, subtítulos, logotipo o música?
Una línea de tiempo de control de calidad con marcas de tiempo queda pendiente hasta que se hayan revisado el audio y los movimientos de boca línea por línea.
Revisa una restricción a la vez
Si la última línea desaparece, acorta el guion o dale más duración dentro del límite de 15 segundos. Si habla el personaje equivocado, repite la posición visual y especifica que el oyente permanece en silencio. Si el ambiente tapa una palabra, bájalo o elimínalo. Si un corte oculta la boca activa, vuelve a un plano continuo de 2 personas. Cambia un factor por reintento para que la siguiente salida responda a una pregunta clara.
Ninguna de estas ediciones garantiza una solución. Si un render necesita revisión, guarda su archivo, la configuración y el problema que quieres abordar. Un productor puede entonces decidir si vale la pena el costo de otro render o si voces grabadas y edición manual darían la precisión necesaria. Para un intercambio corto hablado visiblemente, empieza con el prompt de oficina y acepta un clip solo después de la comprobación línea por línea. Ese es el estándar para diálogo con múltiples hablantes de Gemini Omni 1.2 Flash.
Preguntas frecuentes
¿Puede Gemini Omni 1.2 Flash mantener las mismas voces en clips separados?
Que una voz siga siendo reconocible dentro de un clip generado es un requisito más limitado que conservarla en generaciones separadas. Estos ejemplos solo de texto prueban el primer caso. No prometas identidad de voz entre clips a partir de ellos. Una campaña que necesite un hablante recurrente debería ejecutar una prueba de continuidad separada.
¿Puede Gemini Omni 1.2 Flash generar diálogo en idiomas distintos del inglés?
El modelo puede producir otros idiomas, pero estos prompts están en inglés. Revisa el idioma objetivo palabra por palabra con un oyente fluido, incluidos nombres, números y afirmaciones localizadas. La prueba de idioma exitosa de otro creador es evidencia para esa prueba, no una garantía para tu guion.
¿Cómo mantengo cada línea asignada al hablante correcto?
Dale a cada persona una posición visual y una voz, etiqueta cada línea citada y especifica quién permanece en silencio durante el turno de la otra persona. Revisa el video generado línea por línea. Si un render no cumple el brief, acorta el intercambio o usa un flujo de trabajo de audio controlado para una entrega exacta.
¿Cuántos turnos de diálogo caben en un clip de 15 segundos de Gemini Omni 1.2 Flash?
El prompt de la cafetería solicita ocho turnos breves en 15 segundos, mientras que los prompts de oficina y calle solicitan cinco turnos en 12 segundos. Estos son ejemplos de guion, no límites garantizados. Lee las líneas en voz alta, deja espacio para pausas y acórtalas si el último turno llega al final del clip.
¿Necesita Gemini Omni 1.2 Flash una imagen de referencia para diálogo de dos hablantes?
No se usa ninguna imagen de referencia en estos tres prompts de texto a video. Describen la posición, la ropa y la voz de cada hablante en texto. Si un proyecto necesita un rostro o estilo visual específico, prueba una ruta que acepte referencias y revisa su salida por separado.


