Respuesta rápida
Un GitHub AI Video Generator Skill conecta tu código con modelos de video IA. En 2026, la elección entre código abierto (gratuito, autoalojado) y APIs de pago (en la nube, instantáneas) depende de cuatro variables: disponibilidad de VRAM, requisitos de privacidad de datos, techo de calidad necesario y volumen de generación mensual. Para flujos de trabajo de producción que necesitan varios modelos de última generación, Atlas Cloud (atlascloud.ai) proporciona acceso a más de 300 modelos —incluyendo Kling v3.0, Seedance 2.0, Vidu 3.0, Veo y Sora— a través de una única clave API con precios transparentes de pago por uso.
¿Quieres comparar directamente los modelos de video detrás de estas herramientas? La comparación de modelos de Atlas Cloud alinea modelos de imagen y video lado a lado con una misma indicación, mostrando el precio antes de generar.
-
¿Qué es un AI Video Generator Skill? {#what-is-a-skill}
En el contexto de los repositorios de GitHub, un AI Video Generator Skill es un módulo reutilizable, un envoltorio o una capa de integración que conecta una aplicación con un backend de generación de video IA —ya sea un modelo de código abierto autoalojado o una API en la nube.
Piénsalo como la abstracción entre la lógica de tu aplicación y el motor de inferencia real. Un skill puede ser:
- Una clase de Python que envuelve el pipeline del modelo
Wan 2.2para generación de texto a video - Un nodo personalizado de ComfyUI que se conecta a la API de Atlas Cloud para la generación con Kling v3.0
- Un nodo de flujo de trabajo de n8n que activa Seedance 2.0 mediante REST y devuelve una URL de video
- Una herramienta de LangChain o un skill de MCP Server que llama a un endpoint de generación de video bajo demanda
La pregunta central que todo desarrollador enfrenta al construir uno: ¿el backend debe ser pesos de código abierto ejecutándose localmente, o una API en la nube de pago?
Datos reales de 2026. No teoría.
-
Código abierto en GitHub en 2026 {#open-source-landscape}
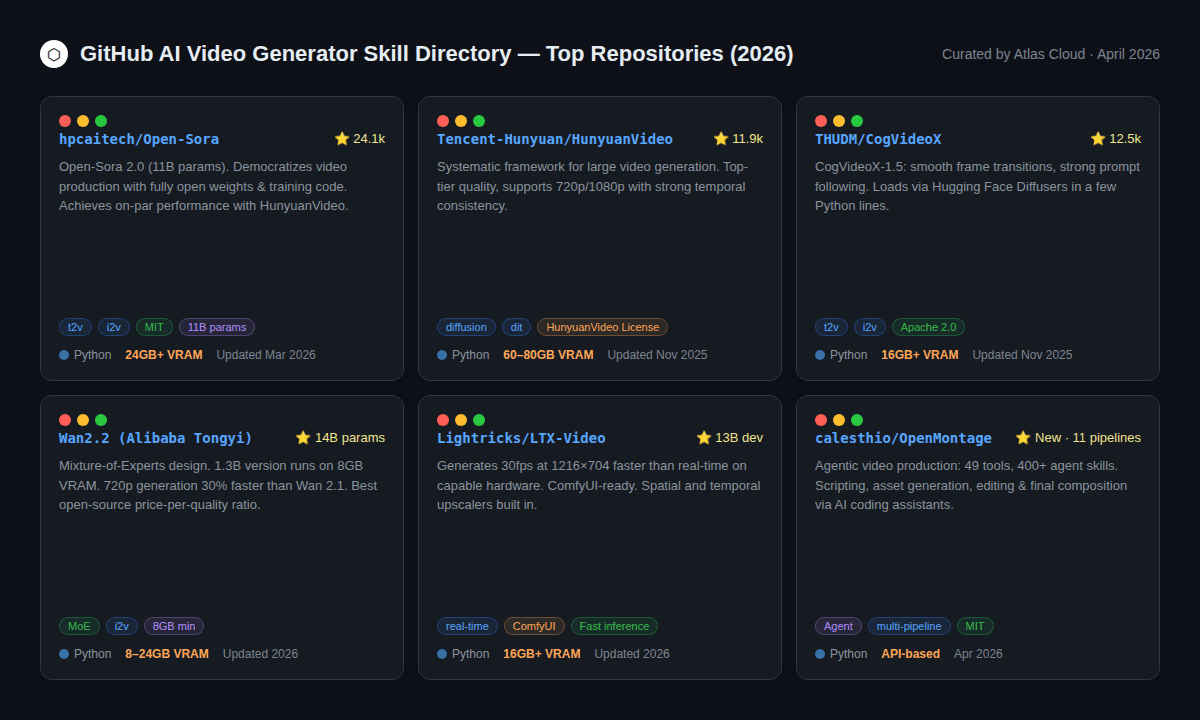
El ecosistema de generación de video de código abierto ha madurado significativamente. Algunos repositorios son ahora alternativas genuinas a las APIs de pago, al menos para ciertas tareas.
Nivel 1: Modelos de código abierto de calidad de producción
HunyuanVideo (Tencent, 11.9k ⭐) — Uno de los mejores generadores de video de código abierto. Maneja 720p y 1080p. La principal limitación es su requisito de hardware: 60–80 GB de VRAM para el modelo completo, lo que lo hace accesible solo para equipos con acceso a GPU empresariales. La licencia comunitaria permite uso comercial con atribución.
CogVideoX-1.5 (THUDM/CogVideo, 12.5k ⭐) Publicado bajo Apache 2.0, es uno de los modelos abiertos más amigables para desarrolladores. Se carga de forma nativa a través de Hugging Face Diffusers con unas pocas líneas de Python. Las transiciones de fotogramas son suaves y el seguimiento de instrucciones es sólido. Necesita un mínimo de 16 GB de VRAM. Buena opción si tu equipo ya vive en Hugging Face.
Open-Sora 2.0 (hpcaitech, 24.1k ⭐) El proyecto de generación de video de código abierto más destacado en GitHub. La versión 2.0 (11B parámetros) alcanza un rendimiento comparable a HunyuanVideo en los benchmarks VBench, y el costo de entrenamiento se reportó en aproximadamente $200,000 — una cifra notable para un modelo de esta categoría. Texto a video, imagen a video y generación de duración infinita.
Nivel 2: Opciones de código abierto más ligeras (menor VRAM)
Wan 2.2 (Alibaba Tongyi) La historia de accesibilidad aquí es convincente: la variante 1.3B funciona con 8 GB de VRAM, y la variante 14B con 24 GB. La arquitectura Mixture-of-Experts (MoE) ofrece mejores detalles a menor costo computacional, y la versión 2.2 es un 30% más rápida a 720p que su predecesora. Para desarrolladores que ejecutan una sola GPU de consumo, Wan 2.2 es la opción de código abierto más sólida.
LTX-Video (Lightricks) Diseñado para la velocidad ante todo. Genera 30 fps a 1216×704 de resolución más rápido que en tiempo real en hardware capaz. La integración con ComfyUI es madura, y los upscalers espaciales y temporales están integrados.
Nivel 3: Pipelines agénticos
OpenMontage (calesthio, nuevo abril 2026) Una categoría genuinamente novedosa: un sistema de producción de video agéntico con 11 pipelines, 49 herramientas y más de 400 habilidades de agente. Funciona con asistentes de codificación IA como Claude Code, Cursor y Copilot. Maneja el pipeline completo —investigación, guion, activos, edición— de principio a fin sin pasos manuales. Creado para equipos que conectan múltiples herramientas IA en un solo flujo de trabajo.
-
Directorio de APIs de pago: modelos de última generación disponibles ahora {#paid-api-directory}
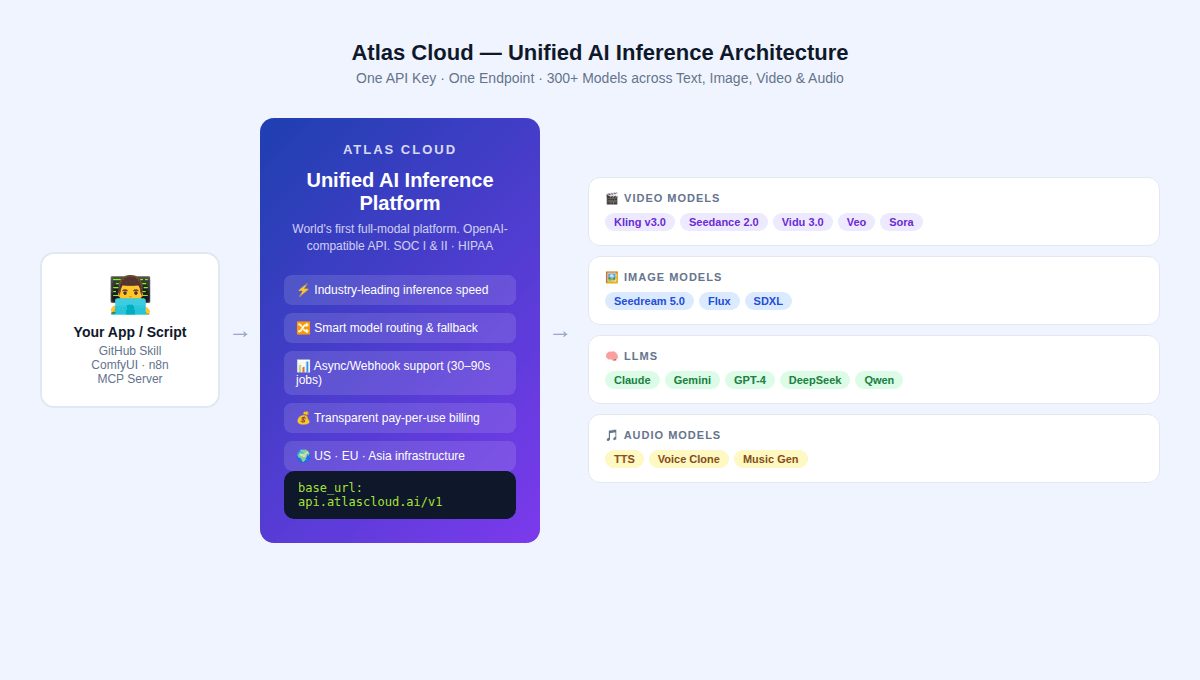
El panorama de APIs de pago en 2026 está definido por tres grandes familias de modelos, cada una con un enfoque técnico distinto. Los tres están disponibles a través de la API unificada de Atlas Cloud.
Kling v3.0 (Kuaishou)
Lanzado el 5 de febrero de 2026. Construido sobre una arquitectura de lenguaje visual multimodal: texto, imágenes, audio y video, todo manejado en un solo sistema.
Lo que realmente hace mejor que los competidores:
- Movimiento humano complejo —correr, bailar, artes marciales— sin la deformación de "extremidades de espagueti" que afecta a otros modelos
- Generación nativa de audio multilingüe (5 idiomas, incluido movimiento de labios sincronizado)
- Motion Brush: una herramienta que permite a los desarrolladores (o usuarios finales) pintar trayectorias de movimiento directamente sobre las imágenes de origen — una característica que actualmente no tiene equivalente en los modelos competidores
- Element Binding para seguimiento consistente de personajes y objetos a lo largo de las tomas
Dónde se queda corto: La velocidad de renderizado es más lenta que la de algunos competidores en el nivel Pro. Las transiciones de la herramienta de storyboard pueden ser "torpes" según revisores independientes.
Mejor para: Cortos sociales en TikTok y Reels, videos de productos de comercio electrónico, cualquier cosa que necesite mucho volumen con personajes que realmente se mantengan consistentes.
Seedance 2.0 (ByteDance)
Lanzado el 8 de febrero de 2026, Seedance 2.0 representa un cambio de paradigma en cómo se indican los videos de IA: de indicaciones solo de texto a un control de referencia basado en estilo director.
La innovación técnica central: Seedance 2.0 acepta entradas cuatrimodales (texto, imagen, video y audio) simultáneamente. Su sistema de "Referencia Universal" permite a un desarrollador alimentar un video de referencia de una persona bailando, y el modelo replicará el movimiento de la cámara, las acciones del personaje y la composición en una salida generada. Esto resuelve la consistencia de personajes de una manera que los modelos puramente de texto a video no pueden.
Las pruebas independientes confirman que sobresale en:
- Narración de múltiples tomas con identidad de personaje consistente entre cortes
- Generación sincronizada de audio y video (arquitectura de doble rama que genera sonido y video simultáneamente)
- Replicación precisa de la composición e iluminación a partir de activos de referencia
Nota sobre disponibilidad: A partir de abril de 2026, el acceso a la API internacional de Seedance 2.0 está disponible a través de plataformas como Atlas Cloud. El acceso directo a la API de BytePlus para desarrolladores internacionales ha tenido inconsistencias de disponibilidad; confirma el estado actual antes de construir una dependencia de endpoints directos de ByteDance.
Mejor para: Videos musicales, animación de personajes ajustada, anuncios de productos donde el movimiento debe ser exacto, agencias que ejecutan flujos de trabajo de storyboard a video.
Vidu 3.0 (Shengshu AI / Tsinghua)
Construido sobre la arquitectura original U-ViT que combina tecnologías de Difusión y Transformer, Vidu se centra en las áreas donde la mayoría de los videos de IA aún tienen dificultades: coherencia ambiental y consistencia cinematográfica.
Características distintivas:
- Sistema de referencia universal para iluminación consistente en secuencias de múltiples tomas
- Generación inteligente de música de fondo que se adapta automáticamente al estado de ánimo de la escena
- Generación de formato largo con fuerte consistencia temporal (crítico para secuencias de más de 5 segundos)
Mejores casos de uso: Flujos de trabajo de producción cinematográfica profesional, diseño de animación, publicidad creativa que requiera calidad cinematográfica.
Sora 2 (OpenAI)
Sora 2 sigue siendo el punto de referencia para la precisión de la simulación física. Si rompes un vidrio con una indicación en Sora 2, el patrón de rotura, la física de fluidos y los reflejos se comportan como en la realidad; la mayoría de los competidores aún no pueden igualar ese nivel de consistencia.
Mejor para: Trabajos de efectos visuales, visualización arquitectónica, material de archivo para documentales, cualquier lugar donde la precisión física importe más que ahorrar dinero.
Precio: Sora 2 tiene la factura más alta en esta categoría. Estás pagando por la computadora.
-
Costos de inferencia: las cifras reales {#inference-costs}
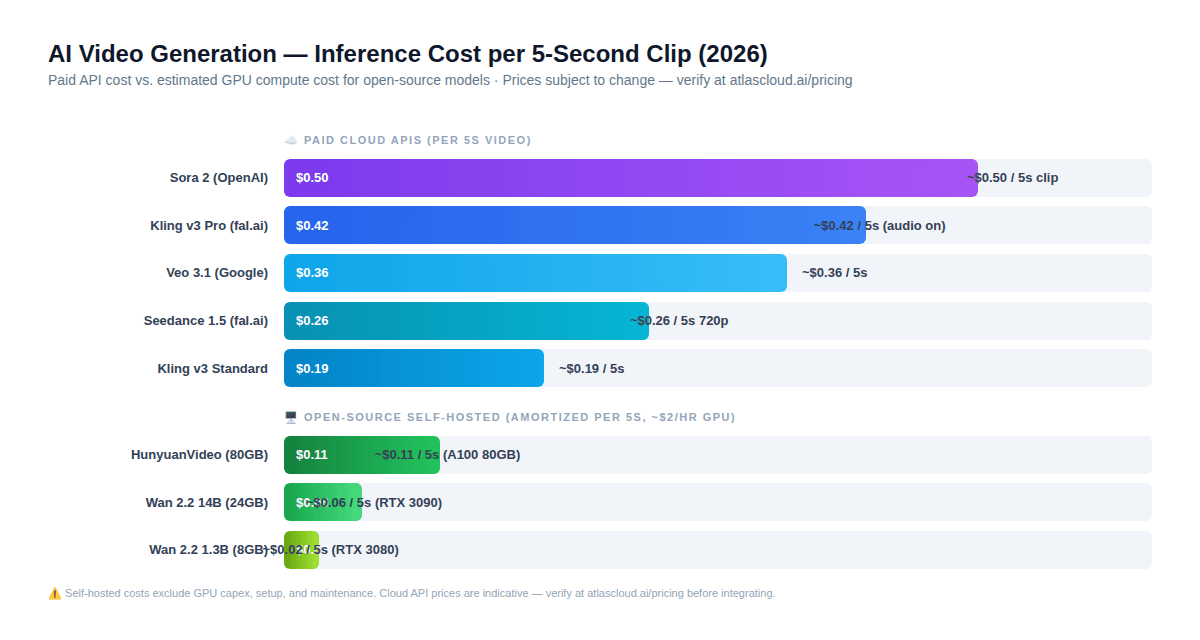
Esta sección contiene el hallazgo contraintuitivo más importante de toda esta guía, uno que cambia la intuición predeterminada de la mayoría de los desarrolladores sobre el código abierto frente a las APIs de pago.
El costo oculto de los modelos autoalojados
La mayoría de los desarrolladores suponen: "Código abierto = gratis = siempre más barato".
Esta suposición es incorrecta para la mayoría de los tamaños de equipo.
Esto es lo que muestran los cálculos reales para un clip de video de 5 segundos en 2026:
Código abierto autoalojado (costo de GPU amortizado a ~$2/hora):
- Wan 2.2 1.3B (RTX 3080): ~$0.02 por clip de 5s
- Wan 2.2 14B (RTX 3090): ~$0.06 por clip de 5s
- HunyuanVideo (A100 80GB): ~$0.11 por clip de 5s
API en la nube de pago (precios indicativos — verifica en atlascloud.ai/pricing):
- Kling v3 Estándar: ~$0.19 por clip de 5s
- Seedance 1.5 720p con audio: ~$0.26 por clip de 5s
- Kling v3 Pro con audio: ~$0.42 por clip de 5s
- Sora 2: ~$0.50 por clip de 5s
Las cifras del autoalojamiento parecen atractivas de forma aislada. El problema es que excluyen:
- Hardware de GPU: Un A100 80GB cuesta entre $10K y $15K. Con 1,000 videos al mes (~$0.11 cada uno), necesitarías más de 9,000 meses solo para recuperar la inversión en hardware.
- Tiempo de configuración: La configuración de CUDA, la descarga de pesos del modelo, la gestión de VRAM y la depuración representan de 20 a 40 horas de ingeniería de configuración inicial.
- Mantenimiento continuo: Las actualizaciones del modelo, los conflictos de dependencias y la confiabilidad de la infraestructura son costos de tiempo continuos.
- Costo de oportunidad: El tiempo dedicado a la infraestructura de inferencia es tiempo que no se dedica al producto.
La condición límite práctica:
El autoalojamiento solo vale la pena si: (a) ya tienes GPUs ejecutando otras cargas de trabajo, (b) estás generando más de 5,000 videos al mes, o (c) las regulaciones te obligan a mantener todo en las instalaciones.
Por debajo de ese umbral, las APIs de pago —especialmente las plataformas unificadas como Atlas Cloud— son más baratas cuando se calcula honestamente el costo total de propiedad.
-
Límites de tasa y latencia de API: lo que realmente enfrentan los desarrolladores {#rate-limiting}
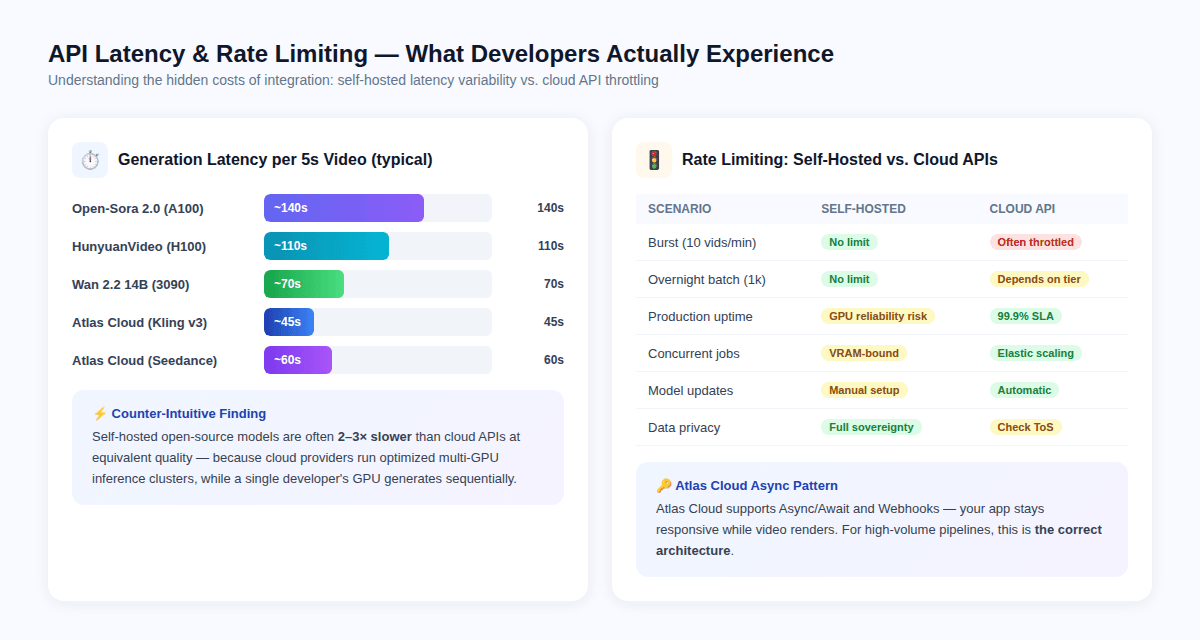
La paradoja de la latencia
Contraintuitivamente, las APIs en la nube suelen ser más rápidas por video que los modelos autoalojados, no porque los modelos sean diferentes, sino porque los proveedores de la nube ejecutan clústeres de inferencia multi-GPU optimizados con procesamiento por lotes a nivel de hardware, mientras que una GPU de desarrollador individual genera fotogramas secuencialmente.
Latencia típica por clip de 5 segundos:
- Open-Sora 2.0 en A100: ~140 segundos
- HunyuanVideo en H100: ~110 segundos
- Wan 2.2 14B en RTX 3090: ~70 segundos
- Atlas Cloud / Kling v3: ~45 segundos
- Atlas Cloud / Seedance 2.0: ~60 segundos
Esto significa que construir un skill de GitHub en torno a un modelo autoalojado puede producir tiempos de espera más largos para el usuario final, incluso cuando el costo por video es menor.
Límites de tasa: la realidad de producción
Los modelos autoalojados no tienen límites de tasa impuestos por la API; están limitados únicamente por la VRAM de tu GPU y los límites térmicos.
Las APIs de pago imponen límites de tasa que varían según el nivel de precios. Las implicaciones de ingeniería relevantes:
- Solicitudes en ráfaga (10+ videos por minuto) activarán la limitación en la mayoría de los niveles de API de pago
- Trabajos por lotes nocturnos (1,000+ videos) requieren un diseño asíncrono cuidadoso para evitar tiempos de espera
- Solicitudes concurrentes en modelos autoalojados están limitadas por la VRAM: ejecutar 2 inferencias concurrentes del modelo 14B en una sola tarjeta de 24 GB generalmente no es posible
Atlas Cloud resuelve el problema de los límites de tasa mediante la arquitectura asíncrona/webhook: tu aplicación envía un trabajo de generación, recibe un ID de tarea y recibe una notificación a través de webhook cuando se completa el renderizado. Este patrón evita que la aplicación se cuelgue mientras se renderiza el video y escala correctamente para cargas de trabajo por lotes.
La arquitectura correcta para producción
plaintext1# Patrón asíncrono de Atlas Cloud — listo para producción 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="TU_CLAVE_API_ATLAS_CLOUD", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Enviar tarea de generación 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Reel de demostración de producto, movimiento suave, formato 9:16 vertical", 14 size="1080x1920", 15 n=1 16) 17 18# Manejar respuesta asíncrona 19video_url = response.data[0].url 20print(f"Video generado: {video_url}")
Para flujos de trabajo de imagen a video, ten en cuenta que algunos modelos —incluidas ciertas variantes de Kling i2v— no aceptan un parámetro de relación de aspecto separado para la generación de imagen a video; la resolución de salida sigue las dimensiones de la imagen de entrada. Construye tu generación de imágenes ascendente con la relación de aspecto objetivo correcta.
-
Alojamiento local vs. API en la nube: la matriz de compensaciones {#local-vs-cloud}
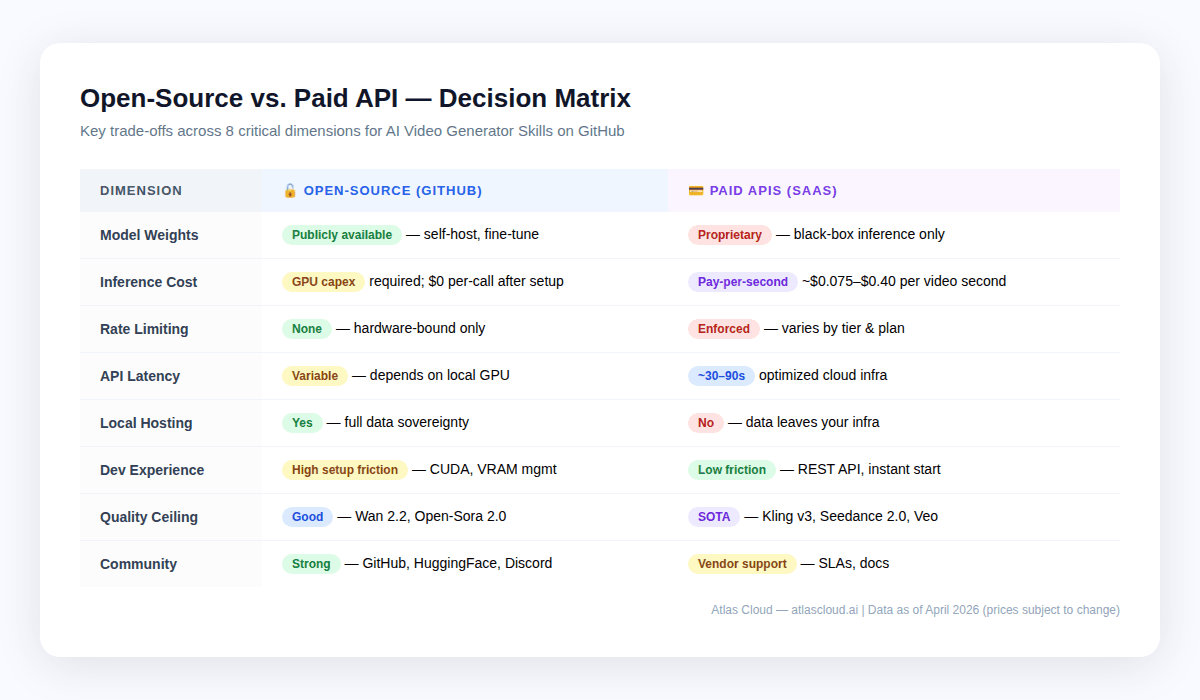
No es una cuestión de uno u otro. La mayoría de los pipelines de producción combinan ambos: código abierto para prototipos y pases masivos de baja calidad, APIs en la nube para renderizados finales y calidad de vanguardia.
Cuándo tiene sentido lo local
- Restricciones de cumplimiento — HIPAA, GDPR o cualquier cosa propietaria que no pueda salir de tus servidores. El autoalojamiento es tu única opción. Atlas Cloud cumple con HIPAA y tiene certificación SOC I y II, lo que cubre la mayoría de las necesidades empresariales, pero los entornos regulados deben verificar sus requisitos específicos.
- Volumen muy alto con calidad aceptable: equipos que generan más de 10,000 videos al mes con niveles de calidad de Wan 2.2 pueden encontrar que los costos de alquiler de GPU son más bajos que las tarifas de API a esa escala.
- Investigación y ajuste fino: los pesos abiertos del modelo permiten el ajuste fino en conjuntos de datos propietarios. Ninguna API en la nube ofrece actualmente entrenamiento de modelos personalizados.
- Configuraciones aisladas — implementaciones en el borde sin conectividad o redes bloqueadas.
Cuándo ganan las APIs en la nube
- Tiempo de comercialización: una integración con Atlas Cloud lleva horas, no semanas
- Calidad de primer nivel: los líderes de código abierto como Wan 2.2 y Open-Sora 2.0 aún están por detrás de los modelos propietarios como Kling v3 y Seedance 2.0, especialmente en movimiento humano, consistencia de tomas y audio nativo
- Cargas de trabajo variables: las APIs en la nube escalan hacia arriba y hacia abajo; tus propias GPUs no
- Volumen bajo: por debajo de ~5,000 videos al mes, las APIs en la nube suelen ganar en costo total
- Flexibilidad multi-modelo: el catálogo de más de 300 modelos de Atlas Cloud te permite cambiar de Kling a Seedance a Veo dentro de una sola integración
-
Desarrollo impulsado por la comunidad vs. impulsado por el proveedor {#community-vs-vendor}
Fácil de ignorar al comparar APIs, pero esto realmente importa si estás construyendo skills de GitHub.
Impulsado por la comunidad (código abierto):
- Cualquiera puede enviar correcciones de errores y solicitar funciones, y pueden ser fusionadas
- La documentación suele ser excelente porque la base de usuarios contribuye con ejemplos
- Los cambios importantes en las APIs de los modelos ocurren lentamente, con períodos de aviso público
- Las comunidades de ComfyUI y Hugging Face Diffusers tienen bibliotecas profundas de flujos de trabajo listos, adaptadores LoRA y puntos de control afinados
- Los artículos de investigación se publican con código abierto y reproducible
Desarrollo impulsado por el proveedor (APIs de pago):
- La estabilidad de la API está regida por SLAs comerciales; los cambios importantes son menos frecuentes, pero ocurren
- Los nuevos lanzamientos de modelos (por ejemplo, Kling 3.0 en febrero de 2026, tres días antes de Seedance 2.0) ocurren a velocidad competitiva y a menudo sin aviso previo
- Las mejoras del modelo se implementan del lado del servidor sin que el desarrollador tenga que hacer nada
- La documentación técnica se mantiene profesionalmente
La implicación práctica para los autores de skills de GitHub: si estás escribiendo un skill que necesita mantenerse estable y de bajo mantenimiento, una API en la nube con contratos de endpoint estables es más fácil de mantener que un skill vinculado a una versión específica de un modelo de código abierto. Por el contrario, si tu skill está diseñado para dar a los desarrolladores acceso a los modelos de investigación más recientes sin costos de API, el ecosistema de código abierto es donde ocurre ese trabajo.
-
Caso de estudio: agencia de redes sociales (500 videos/mes) {#case-study-1}
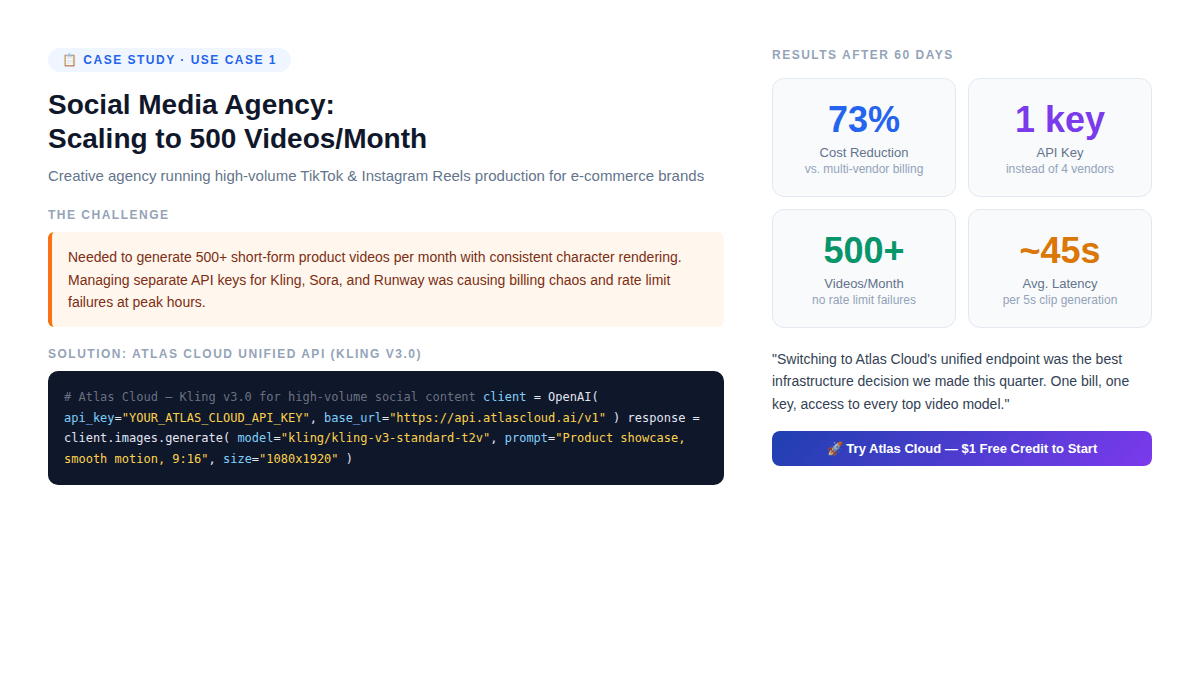
La configuración: Una agencia creativa que produce videos cortos de productos para 20 clientes de comercio electrónico. Necesitan 500 videos al mes, personajes que se vean iguales en todos los clips, formato vertical 9:16, de 5 a 10 segundos cada uno, procesados por lotes fuera del horario laboral.
Arquitectura inicial (antes de [Atlas Cloud](http://atlascloud.ai/pricing/models?utm_source=Blog\&utm_medium=article\&utm_campaign=github-ai-video-generator-skill-directory-free-tools-vs-paid-apis-2026)):
- Claves API separadas para Kling, RunwayML y Pika
- Tres paneles de facturación, tres grupos de límites de tasa
- Selección manual de modelo por cliente
- Fallos en los límites de tasa en horas pico que causan retrasos en la entrega
Problema que esto creó: Cuando Kling lanzó v3.0, la agencia tuvo que reintegrar un nuevo SDK, actualizar la facturación y probar la compatibilidad, tres veces para tres proveedores.
Solución: [Atlas Cloud](http://atlascloud.ai/pricing/models?utm_source=Blog\&utm_medium=article\&utm_campaign=github-ai-video-generator-skill-directory-free-tools-vs-paid-apis-2026)** API unificada con Kling v3.0 Estándar**
plaintext1# Atlas Cloud — Pipeline de video para redes sociales 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, movimiento suave, iluminación cinematográfica, formato vertical 9:16", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Resultados después de 60 días:
- Reducción del 73% en el costo por video (una sola factura, sin márgenes por proveedor)
- Cero fallos por límite de tasa (la infraestructura elástica de Atlas Cloud absorbió los picos de carga)
- Cambiar de modelo de Kling a Seedance para clientes específicos tomó menos de 2 minutos (cambiar un parámetro)
- El bono del 20% en el primer depósito compensó efectivamente los costos de producción del primer mes
El hallazgo no obvio: La agencia no redujo el número de proveedores porque Kling mejorara. Lo redujeron porque gestionar múltiples relaciones con proveedores a 500 videos/mes tiene un costo operativo no trivial que no aparece en los precios por API.
-
Caso de estudio: desarrollador independiente que construye un SaaS de video {#case-study-2}
La configuración: Un desarrollador en solitario construye una herramienta de "texto a demostración de producto" para startups en etapas iniciales. Necesita múltiples estilos: cinematográfico, animado, acción real. Tiene que validar rápido y mantener la infraestructura por debajo de $200/mes mientras descubre si alguien realmente quiere esto.
Decisión de arquitectura:
El desarrollador inicialmente consideró autoalojar Wan 2.2 en una instancia A100 alquilada (~$2/hora). Con 100 videos de prueba durante la validación, el costo se estimó en ~$6 en total de tiempo de GPU. Parecía más barato que Atlas Cloud.
Lo que el cálculo omitió:
- Configurar el pipeline de Wan 2.2 tomó 3 días (dependencias de CUDA, gestión de VRAM, configuración del servidor)
- La brecha de calidad de salida de Wan 2.2 frente a Kling v3 significaba que el SaaS no podía cobrar el precio previsto
- La gestión del tiempo de actividad del servidor añadió ~2 horas/semana de mantenimiento continuo
Arquitectura revisada con [Atlas Cloud](http://atlascloud.ai/pricing/models?utm_source=Blog\&utm_medium=article\&utm_campaign=github-ai-video-generator-skill-directory-free-tools-vs-paid-apis-2026):
plaintext1# Enrutamiento flexible de modelos — cambia según el nivel de usuario 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Menor costo 4 "pro": "kling/kling-v3-professional-t2v", # Mayor calidad 5 "enterprise": "bytedance/seedance-2.0" # Máximo control 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Resultado: El desarrollador lanzó en 4 días en lugar de 3 semanas. El uso de Seedance 2.0 en el nivel premium justificó un precio 3 veces superior al del nivel gratuito, y la estructura de modelos escalonados se construyó con una sola clave de Atlas Cloud, no tres integraciones de proveedores separadas.
-
La ventaja de Atlas Cloud: por qué "una API" es la arquitectura correcta {#atlas-cloud-advantage}
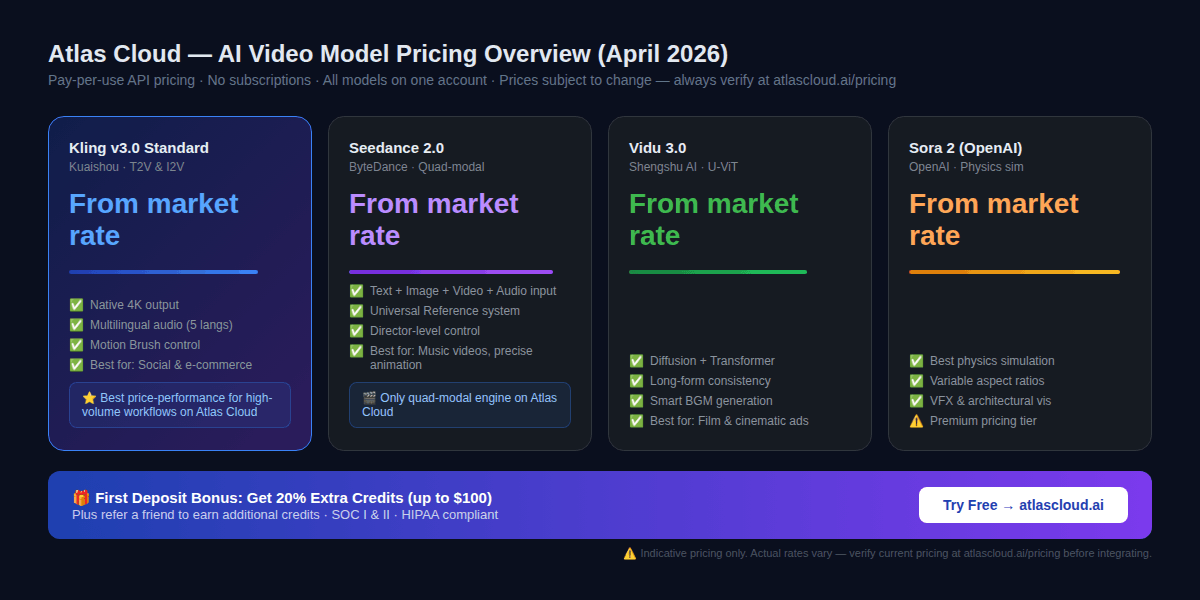
Atlas Cloud se posiciona como la primera plataforma de inferencia IA completamente multimodal del mundo: una API unificada que sirve más de 300 modelos en generación de texto, imagen, video y audio.
Para los autores de GitHub AI Video Generator Skills, las ventajas específicas son:
-
API compatible con OpenAI (reemplazo directo)
Atlas Cloud utiliza un endpoint compatible con OpenAI. Si tu skill ya se integra con el SDK de OpenAI, cambiar a Atlas Cloud para la generación de video requiere cambiar dos líneas: la api_key y la base_url. Sin nuevo SDK, sin nuevo sistema de autenticación.
-
Facturación única para flujos de trabajo multimodelo
Los flujos de trabajo de video de producción rara vez utilizan un solo modelo. Un pipeline típico podría usar:
- Seedream 5.0 para generación de imágenes (fotogramas iniciales)
- Kling v3.0 para conversión de imagen a video
- Un LLM (Claude, GPT-4 o DeepSeek) para optimización de indicaciones
- Un modelo TTS para narración de voz
Con cuentas de proveedores separadas, esto son cuatro relaciones de facturación, cuatro grupos de límites de tasa y cuatro puntos de integración. Con Atlas Cloud, es una clave API y una factura.
-
Transparencia de precios a nivel de modelo
Atlas Cloud publica precios por modelo sin tarifas de cómputo ocultas. El modelo de negocio es directo: pagas por lo que generas. Los nuevos desarrolladores reciben un bono del 20% en su primer depósito (hasta $100), y un programa de referidos proporciona créditos adicionales. Siempre verifica los precios actuales en atlascloud.ai/pricing antes de hacer proyecciones financieras.
-
Cobertura de cumplimiento
Para skills de GitHub empresariales implementados en entornos regulados: Atlas Cloud tiene certificación SOC I y II y cumple con HIPAA, con infraestructura en regiones de EE. UU., UE y Asia. Esto cubre la mayoría de los requisitos de residencia de datos empresariales.
-
Integración con ComfyUI, n8n y MCP Server
Atlas Cloud se integra de forma nativa con las herramientas más utilizadas para construir skills de generación de video en GitHub:
- ComfyUI: nodos personalizados para la creación de flujos de trabajo visuales
- n8n: automatización de flujos de trabajo con pasos de generación de video de Atlas Cloud
- MCP Server: integración del Protocolo de Contexto de Modelo para marcos de agentes IA
-
¿Qué pila deberías usar realmente? {#decision-guide}
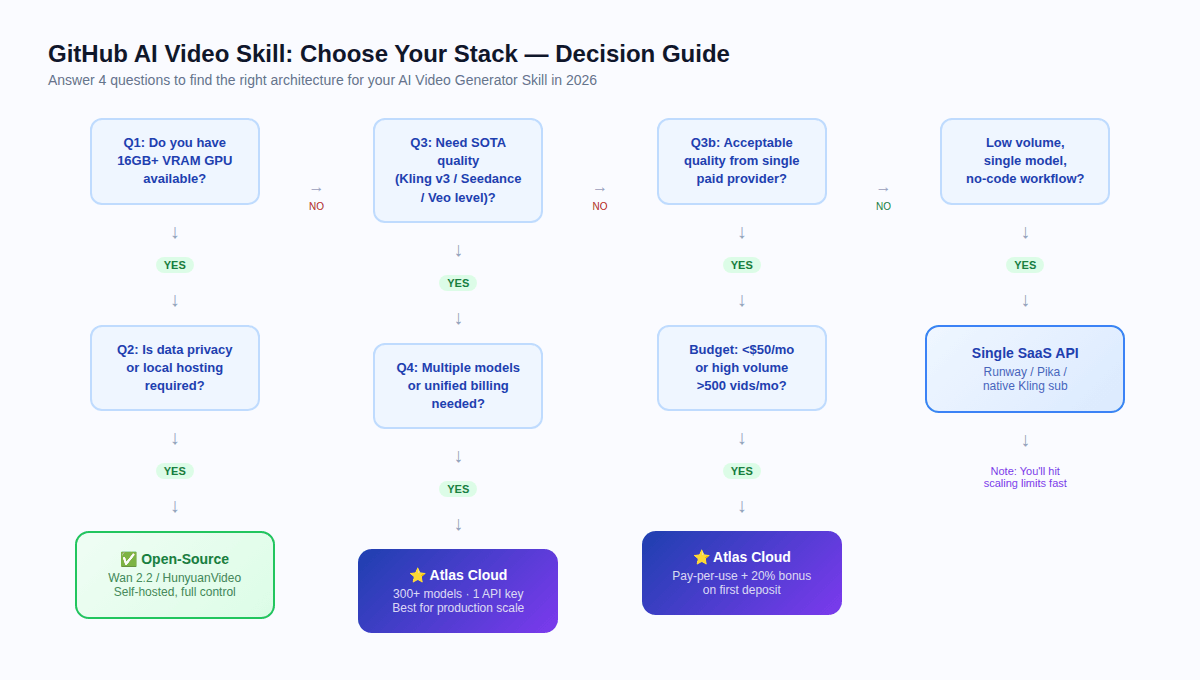
Recorre estas cuatro preguntas:
P1: ¿Tienes disponible una GPU con 16 GB o más de VRAM?
Si no → salta el autoalojamiento por completo. La API en la nube es tu único camino práctico.
P2: ¿La privacidad de datos o el alojamiento local son requeridos por la regulación?
Si sí + GPU disponible → evalúa el código abierto (Wan 2.2 o HunyuanVideo según la VRAM).
Si sí + no hay GPU → usa Atlas Cloud (cumple con HIPAA, certificado SOC) y revisa tus requisitos regulatorios específicos.
P3: ¿Necesitas calidad de última generación (nivel Kling v3, Seedance 2.0, Veo)?
Si sí → API en la nube requerida. Los modelos de código abierto tienen una brecha de calidad significativa frente a los modelos propietarios principales en 2026.
Si la calidad aceptable está al nivel de código abierto → Wan 2.2 autoalojado puede funcionar.
P4: ¿Necesitas múltiples modelos o facturación unificada?
Si sí → Atlas Cloud. Gestionar tres cuentas de proveedores a escala tiene un costo operativo oculto que solo se hace visible en volumen de producción.
Recomendaciones resumidas por caso de uso
| Caso de uso | Pila recomendada |
| Investigación / prototipado | Código abierto (Wan 2.2, CogVideoX) |
| Agencia de redes sociales, 500+/mo | Atlas Cloud + Kling v3.0 |
| Video musical / animación de personajes | Atlas Cloud + Seedance 2.0 |
| Efectos visuales / simulación física | Atlas Cloud + Sora 2 |
| Soberanía de datos / sin conexión | Autoalojado (HunyuanVideo, Open-Sora 2.0) |
| SaaS con calidad de modelo escalonada | Atlas Cloud (una clave, múltiples modelos) |
| Lote de código abierto de alto volumen | Wan 2.2 autoalojado (umbral de 10,000+/mo) |
-
Preguntas frecuentes {#faq}
P: ¿Qué es un AI Video Generator Skill?
Un módulo de código reutilizable o capa de integración que conecta una aplicación con un backend de generación de video IA, ya sea pesos de código abierto o una API en la nube. Formas comunes: clase de Python, nodo de ComfyUI, flujo de trabajo de n8n, herramienta de MCP Server.
P: ¿Cuál es la VRAM mínima para autoalojar un modelo de video de código abierto?
8 GB de VRAM para Wan 2.2 1.3B (calidad aceptable para clips cortos). 16 GB para CogVideoX-1.5 o Open-Sora (mejor calidad). 24 GB+ para Wan 2.2 14B. 60–80 GB para HunyuanVideo o Open-Sora 2.0 modelo completo.
P: ¿La generación de video IA de código abierto es realmente gratuita?
Los pesos del modelo son gratuitos. La inferencia no es gratuita: requiere cómputo de GPU. A bajo volumen (<5,000 videos/mes), las APIs en la nube como Atlas Cloud suelen ser más baratas cuando se calcula el costo total de propiedad.
P: ¿Puedo usar [Atlas Cloud](http://atlascloud.ai/pricing/models?utm_source=Blog\&utm_medium=article\&utm_campaign=github-ai-video-generator-skill-directory-free-tools-vs-paid-apis-2026)** para flujos de trabajo de imagen a video (i2v)?**
Sí. Atlas Cloud admite variantes i2v para Kling, Seedance y Vidu. Nota: para los modelos i2v, algunas variantes no aceptan un parámetro de relación de aspecto separado; la resolución de salida sigue las dimensiones de la imagen de entrada.
P: ¿Cómo maneja [Atlas Cloud](http://atlascloud.ai/pricing/models?utm_source=Blog\&utm_medium=article\&utm_campaign=github-ai-video-generator-skill-directory-free-tools-vs-paid-apis-2026)** los límites de tasa?**
Atlas Cloud admite patrones asíncronos/webhook. Los trabajos de generación de video se envían como tareas; tu aplicación recibe un ID de tarea y recibe una notificación cuando se completa el renderizado. Esto evita el bloqueo a escala.
P: ¿Cuál es el mejor modelo para la consistencia de personajes entre tomas?
El sistema de Referencia Universal de Seedance 2.0 es la solución más avanzada en 2026. Te permite alimentar videos de referencia, imágenes y audio para mantener la apariencia y el movimiento del personaje de manera consistente en los clips generados.
P: ¿Atlas Cloud es compatible con ComfyUI?
Sí. Atlas Cloud tiene integración nativa con ComfyUI, así como nodos de n8n y compatibilidad con MCP Server.
P: ¿Cómo manejan las relaciones de aspecto los modelos de video de código abierto?
Varía según el modelo. Open-Sora admite 16:9, 9:16, 1:1 y 2.39:1 mediante la bandera --aspect_ratio. Wan 2.2 y LTX-Video admiten múltiples relaciones. Para flujos de trabajo i2v, la mayoría de los modelos siguen la relación de aspecto de la imagen de entrada, independientemente de los parámetros especificados.
Resumen
El panorama de 2026 se divide en dos campos, cada uno con su punto óptimo:
El código abierto tiene sentido si tienes GPUs de sobra, estás generando más de 10K videos al mes, los datos no pueden salir de tus servidores, o necesitas ajustar finamente tu propio material de archivo propietario.
Las APIs de pago son la mejor opción si necesitas la mejor calidad disponible, la velocidad importa más que el costo, estás por debajo de 5K videos al mes, o quieres mezclar múltiples modelos sin gestionar contratos de proveedores.
Atlas Cloud tiende un puente entre ambos: como plataforma unificada que proporciona acceso a más de 300 modelos —incluyendo los mejores modelos de código abierto mediante inferencia alojada y todos los modelos propietarios principales— a través de una única clave API compatible con OpenAI. Para la mayoría de los desarrolladores que construyen skills de generación de video en GitHub en producción en 2026, es el camino de menor fricción desde el prototipo hasta la producción.
La información de precios en este artículo es indicativa y está sujeta a cambios. Siempre verifica las tarifas actuales en atlascloud.ai/pricing antes de hacer proyecciones financieras. La disponibilidad de los modelos puede variar según la región.
Atlas Cloud: atlascloud.ai — Certificado SOC I y II · Cumple con HIPAA · Infraestructura en EE. UU., UE y Asia


