Un cliente Enterprise pregunta si se puede reembolsar un plan anual después de la renovación. Tu asistente escanea un enorme conjunto de documentos y da un sí rotundo. Incluso cita una política. El problema: eligió la v4.1, una política archivada, mientras que un addendum firmado y la v4.2 dicen algo distinto.
Por eso, las mejores prácticas de la base de conocimiento de gpt-6 astra comienzan con la prueba. Dale al modelo un orden de autoridad, recupera solo evidencia actual autorizada y haz que cada afirmación material remita a un documento, una versión y una sección. Si la evidencia entra en conflicto o se agota, la respuesta debe detenerse.
GPT-6 Astra puede funcionar con File Search y una ventana de contexto de 1.050.000 tokens, con una salida máxima de 128.000 tokens. La capacidad ayuda a la investigación. No decide qué política está vigente, qué usuario puede verla ni si una cita respalda realmente una afirmación cercana. ( página del modelo OpenAI GPT-6 Astra, septiembre de 2026 )
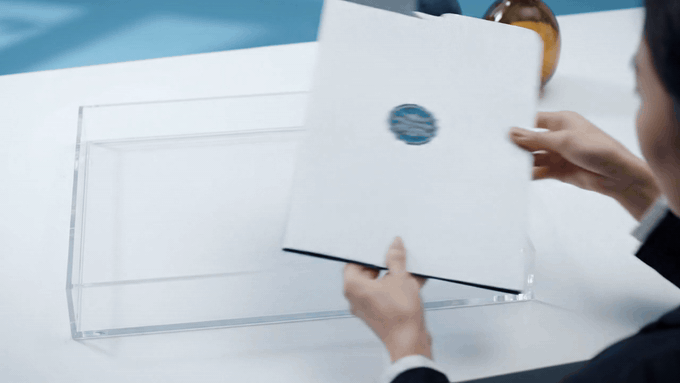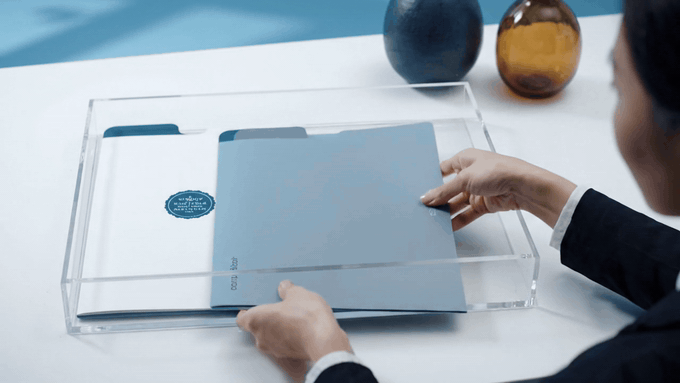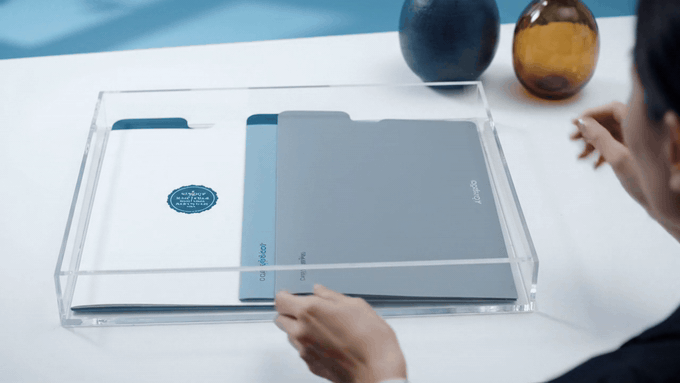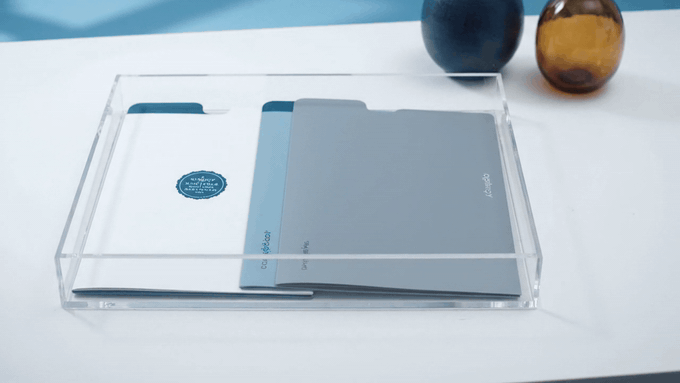
Flujo de trabajo animado de base de conocimiento con prioridad en la autoridad
Visual de flujo de trabajo generado de 8 segundos: una anulación firmada y la política vigente permanecen en la bandeja de evidencia, mientras que un archivo archivado se aparta visiblemente. Esto ilustra la gobernanza de fuentes, no una interfaz de producto real ni un documento fuente.
Puntos clave
- Aprueba la autoridad de las fuentes antes de subirlas.
- Mide por separado la recuperación y la fidelidad de la respuesta.
- Filtra por acceso, estado, fecha y región antes de la recuperación.
- Trata el contexto largo como una herramienta de investigación, no como un prompt predeterminado.
- Escala los conflictos y la evidencia faltante a personas.
Por qué fallan las bases de conocimiento de GPT-6 Astra con 1M de tokens
La mayoría de los fallos empiezan antes de la respuesta. Una exportación de Drive trata un addendum firmado, una política vigente, una FAQ antigua y un borrador como prosa igualmente buscable. Un modelo capaz puede convertir ese conjunto desordenado en un párrafo convincente muy rápidamente.
Cuatro comprobaciones detectan los modos de fallo comunes:
- Deriva de autoridad: una política nueva o un addendum del cliente pierde frente a una FAQ antigua popular.
- Teatro de citas: la respuesta contiene un enlace a la fuente, pero el pasaje citado no respalda la afirmación.
- Experimentos sin control: el tamaño de chunk, el top-k y el presupuesto de contexto cambian a la vez, así que nadie sabe qué mejoró.
- Deriva de acceso: excepciones regionales, borradores restringidos o notas privadas se vuelven recuperables para la audiencia equivocada.
Los profesionales de RAG jurídico que debaten sobre evaluación tienden a separar «¿encontró la recuperación la fuente requerida?» de «¿aplicó la respuesta esa fuente con fidelidad?». Esa separación debe estar en cada puerta de liberación, incluido un bot interno de soporte. ( debate sobre base de conocimiento jurídica en r/Rag, septiembre de 2026 )
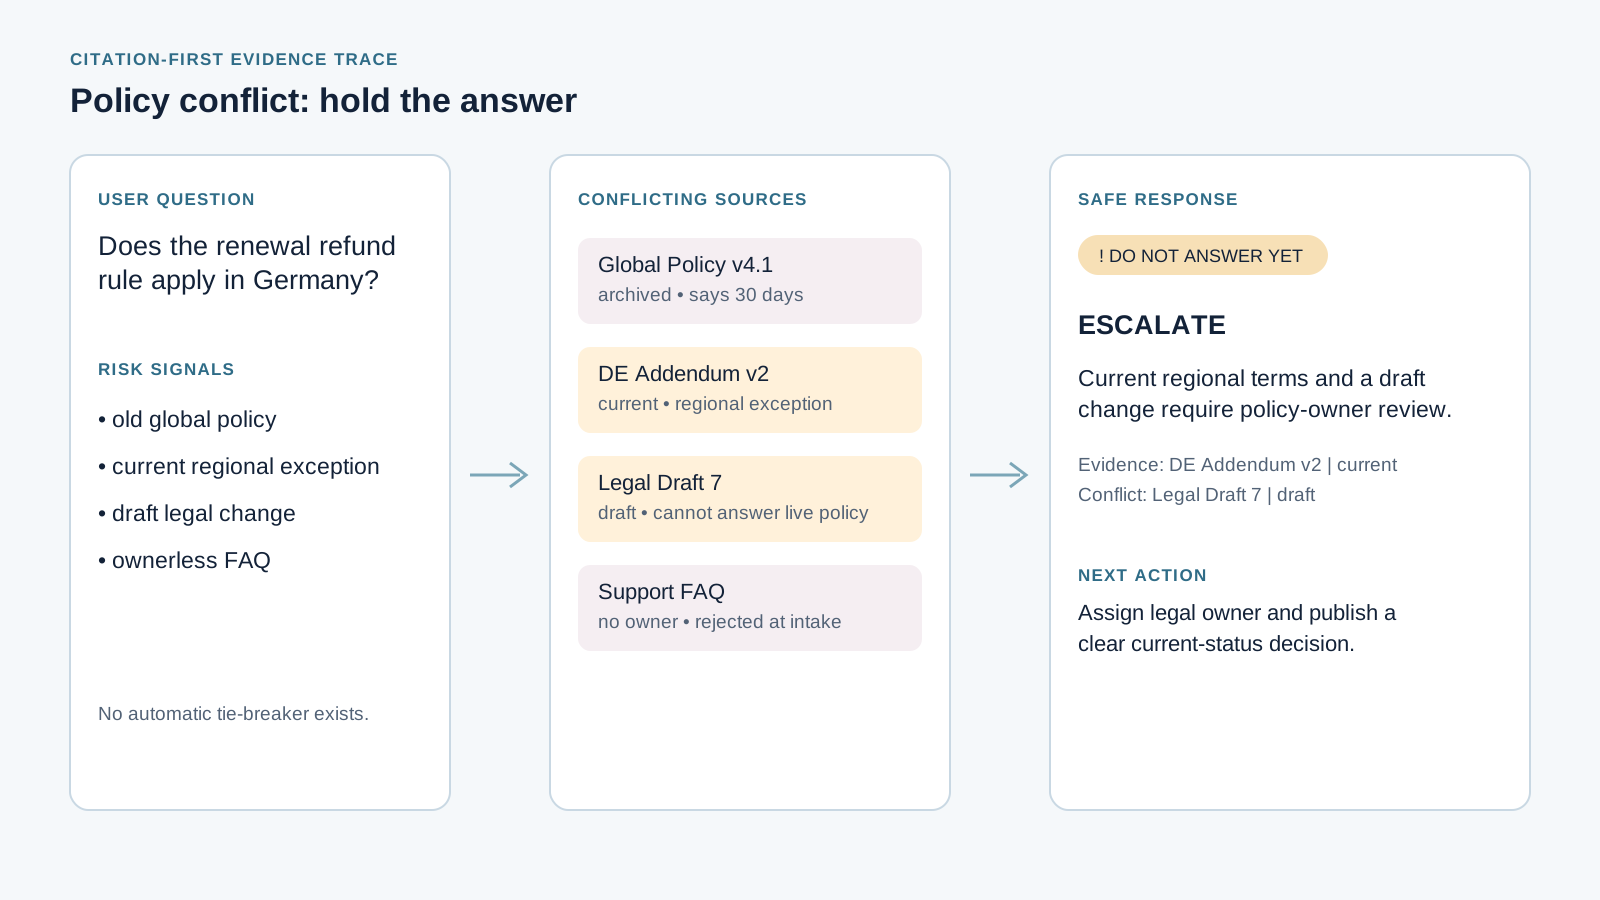
Rastro de evidencia de conflicto de versiones de la base de conocimiento con un resultado de abstención
Un conflicto es una salida útil. Este caso muestra por qué un sistema debería devolver «no responder todavía» en lugar de elegir en silencio entre un borrador, una excepción regional, una política antigua y un archivo sin propietario.
Flujo de trabajo, modelos y coste de la base de conocimiento de GPT-6 Astra
Usa una sola pestaña del navegador para el piloto: inventaría las fuentes, aprueba el manifiesto de autoridad, normaliza archivos y metadatos, recupera un pequeño conjunto de evidencia y luego responde y evalúa. El objetivo operativo es un rastro de evidencia revisable, no una demostración ingeniosa de chat.
Para los equipos que comparan el resto de su stack, Atlas Cloud ofrece un lugar donde revisar las opciones de modelos actuales. No asumas que un catálogo incluye GPT-6 Astra hasta que lo hayas comprobado el día de la publicación.
| Capa | Trabajo que resuelve | Lo que no puede resolver por sí sola | Regla del piloto |
|---|---|---|---|
| Contexto largo | Leer un paquete de investigación grande | Autoridad, permisos, respaldo de citas | Úsalo para excepciones e investigación |
| File Search | Recuperar un conjunto pequeño de fuentes | Gobernanza de versiones | Filtra antes de buscar |
| Recuperación personalizada | Ajustar indexación y ranking | Fidelidad de la respuesta | Mantén constante el presupuesto de contexto en las pruebas |
| Escalado humano | Resolver conflictos y llamadas de alto impacto | Escala rutinaria | Define propietario y tiempo de respuesta |
| Modelo o herramienta | Trabajo | Configuración sugerida | Precio publicado para usar en la planificación |
|---|---|---|---|
| GPT-6 Astra | juicio de conflictos, síntesis, evaluación | reasoning.effort: high | $10/MTok de entrada, $50/MTok de salida |
| OpenAI File Search | recuperación de documentos autorizados | filtros de metadatos y citas | verifica los cargos de la herramienta antes del lanzamiento |
| Ruta de modelo rutinaria | etiquetas y clasificación de bajo riesgo | benchmark primero | no codifiques un precio en duro |
| catálogo de modelos de Atlas Cloud | exploración posterior de modelos | usa el catálogo en vivo | no se asume la disponibilidad de Astra |
Empieza con 20 a 50 preguntas de alto valor y un conjunto de documentos deliberadamente incómodo. Incluye una política sustituida, un addendum faltante, una excepción regional y al menos una pregunta que no debe recibir respuesta.
Paso 1: Crea un manifiesto de autoridad
Antes de subir nada, convierte el inventario en una capa de decisión aprobada. Un propietario humano debería aprobar el JSON devuelto antes de que se convierta en KB_MANIFEST.md. Esta es la primera barrera contra una respuesta impecable construida sobre texto retirado.
plaintext1You are the knowledge-governance reviewer for an enterprise support knowledge base. 2 3Goal: 4Create an authority manifest before any answer-generation workflow begins. 5 6For every supplied document, identify: 7- document_id 8- title 9- owner 10- effective_date 11- region 12- audience 13- status: current, draft, archived, superseded, or unknown 14- authority_rank from 1 to 5 15- conflict_rules 16- access_policy 17- reason_for_rank 18 19Authority rules: 201. Signed customer addenda override general policies for the covered account. 212. Current policy versions override archived or superseded versions. 223. Official policy documents override FAQs and training notes. 234. Drafts may be used only when the user explicitly asks about a draft. 245. If two current sources conflict, do not resolve the conflict. Return ESCALATE. 25 26Return valid JSON only. Do not infer missing dates or policy terms.
Configuración: modelo gpt-6-astra; Responses API; reasoning.effort: high; salida JSON estructurada. Proporciona solo título, propietario, fecha de entrada en vigor, región, estado y nivel de acceso para la revisión inicial.
Finalizado cuando: cada archivo tiene propietario, fecha, estado y rango, y Refund Policy v4.1 está marcada como sustituida por la v4.2.
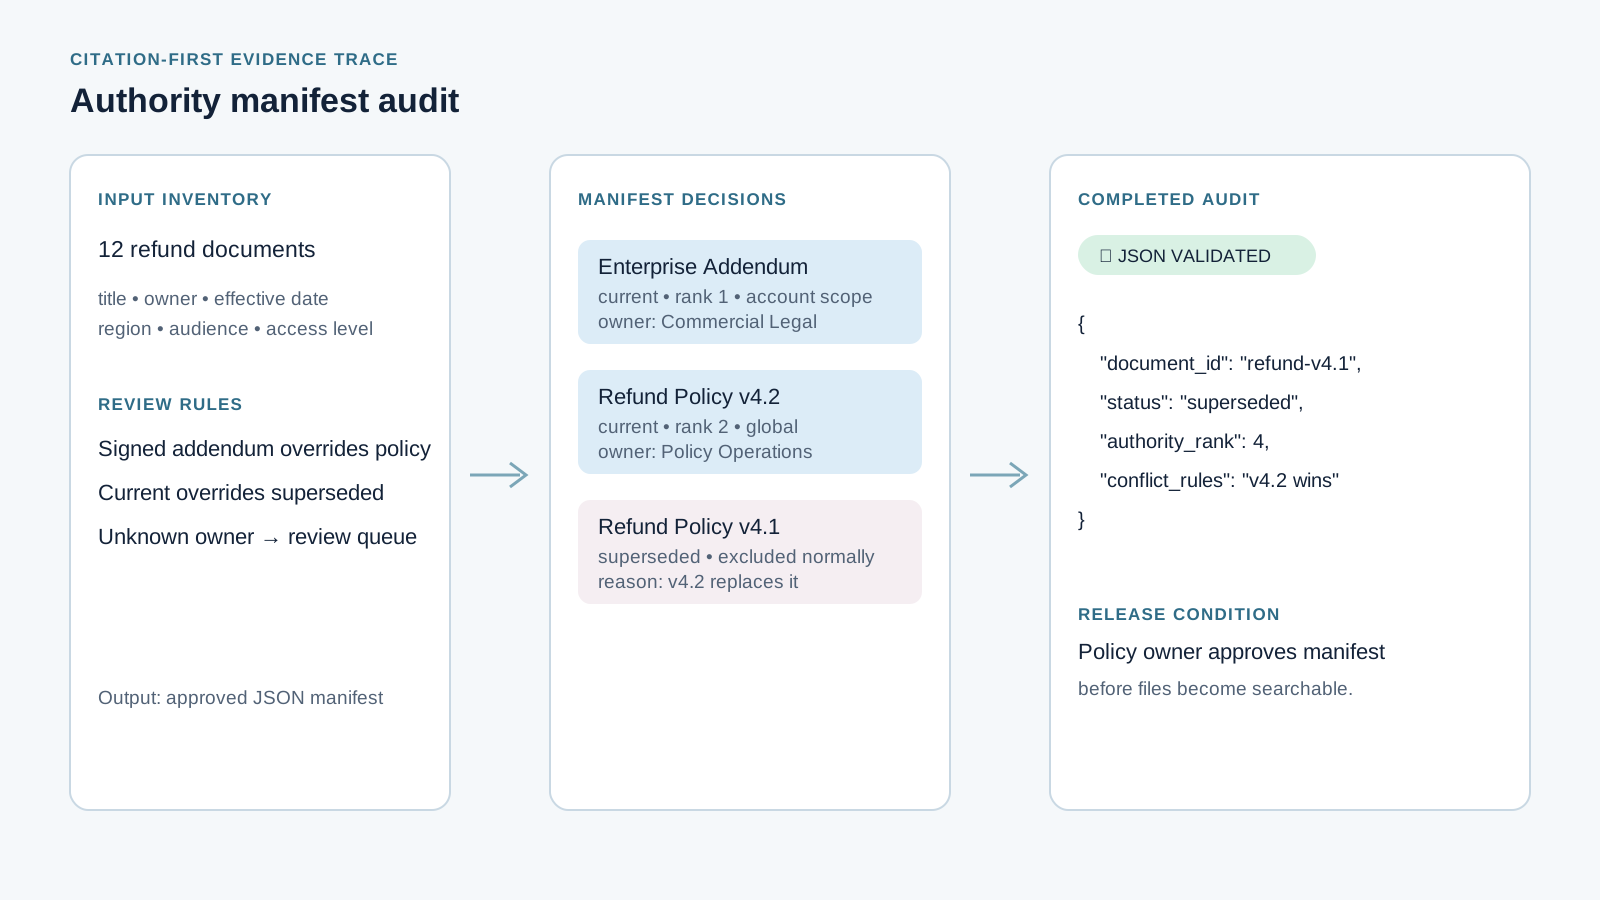
Auditoría del manifiesto de autoridad con decisiones JSON completadas
Auditoría completada del manifiesto de autoridad para el piloto de reembolsos. La página de auditoría registra una v4.1 sustituida y la regla de anulación de Enterprise.
Paso 2: Prepara una base de conocimiento de GPT-6 Astra para la recuperación
Normaliza las fuentes aprobadas. Conserva encabezados, condiciones, marcadores de página y datos de versión. Elimina pies de página duplicados, navegación y restos de OCR. No subas un documento que no tenga propietario o fecha de entrada en vigor.
plaintext1You are preparing files for a retrieval-based knowledge base. 2 3Inspect the supplied document inventory and return a file-preparation checklist. 4 5For each file: 61. Keep the source title, version, effective date, owner, and page or section markers. 72. Remove navigation, duplicated footers, stale boilerplate, and OCR fragments. 83. Preserve headings and lists that carry policy conditions. 94. Mark whether the file is current, archived, draft, or restricted. 105. Reject any file that cannot be assigned an owner and effective date. 11 12Return a table with: 13file_name | status | metadata_to_attach | cleanup_required | upload_decision | reason
Configuración: adjunta document_id, version, effective_date, status, region, audience y authority_rank como metadatos. Empieza las pruebas de recuperación con aproximadamente 2000 tokens de contexto recuperado total. Cambia una variable a la vez: estrategia de chunking o número de recuperaciones, nunca ambas.
Finalizado cuando: el material archivado queda excluido de las consultas normales y los archivos sin propietario conocido van a una cola de revisión.
El siguiente caso en movimiento hace visible la decisión de clasificación: dos carpetas de fuentes aprobadas permanecen juntas en la bandeja de autoridad, mientras que un borrador ambiguo pasa a una ruta de revisión separada. Es una representación ilustrativa del flujo de trabajo, no una respuesta real de GPT-6 ni una interfaz de producto.
Transferencia animada de evidencia a revisión humana
Visual de flujo de trabajo generado de 8 segundos: las carpetas de fuentes aprobadas permanecen juntas, mientras que la carpeta no resuelta se enruta a revisión humana.
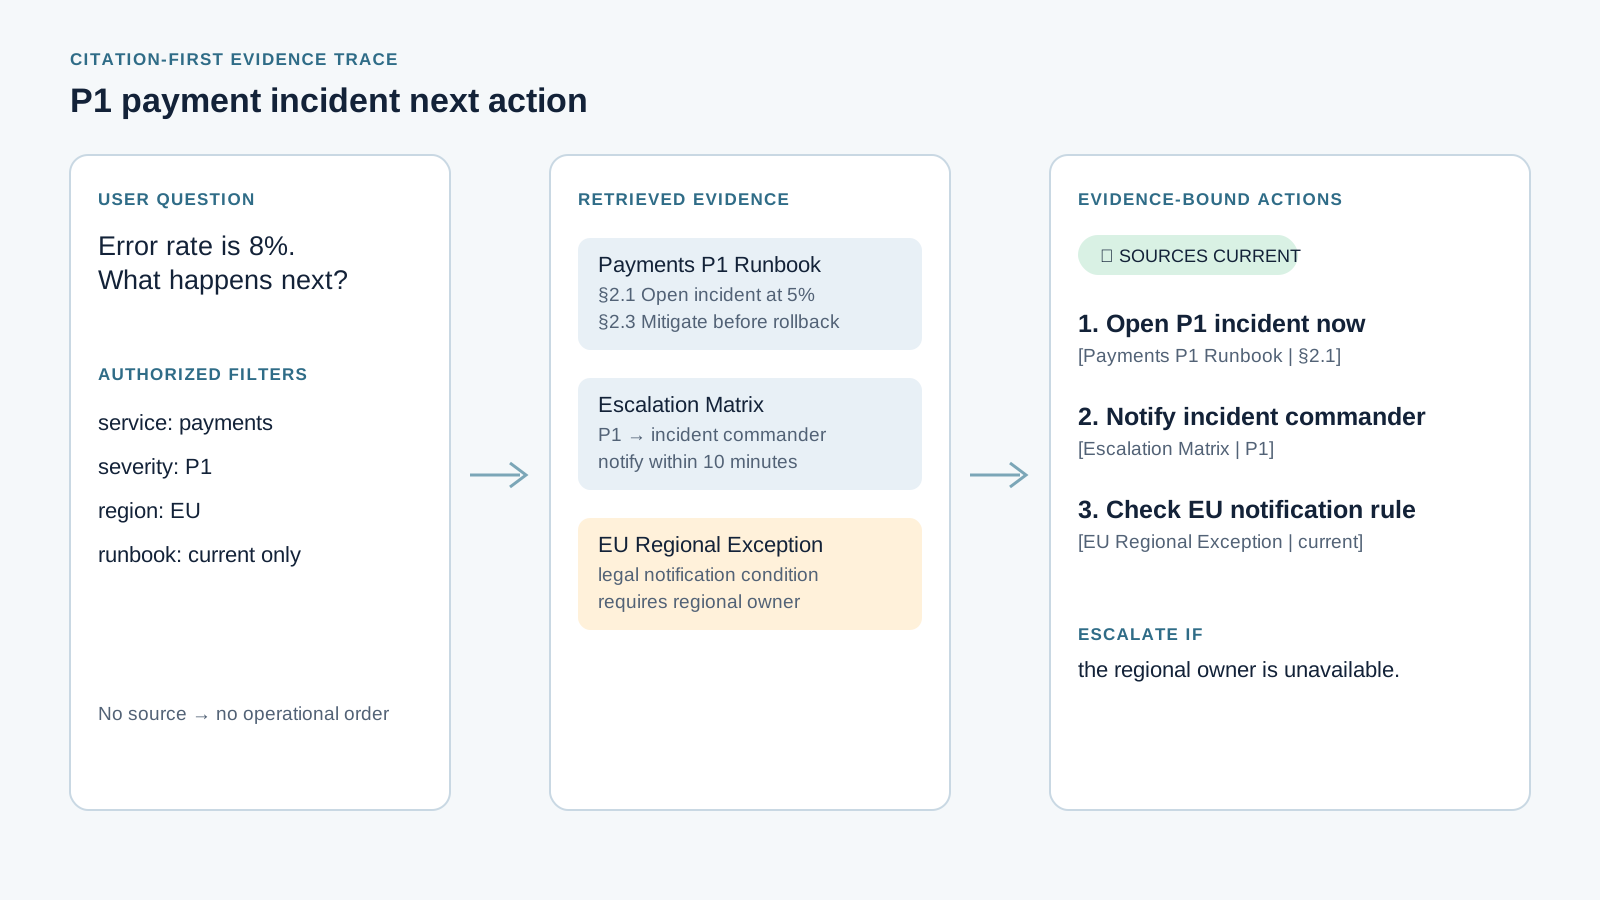
Rastro de evidencia de incidente de pago P1 con una condición de escalado
Caso 2. Una pregunta sobre un error de pago extrae un runbook de guardia, una matriz de escalado y una excepción regional. La respuesta identifica el desencadenante del comandante de incidentes en lugar de improvisar un plan de recuperación.
Paso 3: Pide una respuesta vinculada a la evidencia
Vincula la generación de respuestas a evidencia recuperada y autorizada. El modelo debe separar hechos, suposiciones y próximas acciones para que los revisores vean dónde deja de saber el sistema.
plaintext1You are an evidence-bound knowledge-base assistant. 2 3Answer the user question using only the retrieved, authorized knowledge-base sources. 4 5Rules: 6- Treat the authority manifest as binding. 7- Prefer the highest-ranked current source that applies to the user’s region and audience. 8- Every factual claim must include [document title | version | section or page]. 9- If sources conflict, identify the conflict and return ESCALATE instead of choosing silently. 10- If the evidence does not support a claim, write INSUFFICIENT_EVIDENCE. 11- Do not use general model knowledge to fill gaps. 12- Separate confirmed facts, assumptions, and recommended next actions. 13- For regulated or high-impact questions, state that a qualified human review is required when the evidence is incomplete. 14 15User question: 16Can an Enterprise annual-plan customer receive a refund after renewal if the account has a signed Enterprise addendum? 17 18Return: 191. Decision 202. Evidence 213. Exceptions or conflicts 224. Next action 235. Confidence: supported, partial, or insufficient
Configuración: usa reasoning.effort: high y File Search. Aplica filtros de estado actual, autorización del usuario, región y audiencia antes de recuperar. El uso de herramientas corresponde a la Responses API; la guía actual de OpenAI también recomienda condiciones de éxito claras y límites de herramientas para los flujos de trabajo de Astra. ( guía del modelo de OpenAI, septiembre de 2026 )
Finalizado cuando: la respuesta cita la política general vigente y el addendum de Enterprise firmado, nunca usa la v4.1 archivada como regla y devuelve INSUFFICIENT_EVIDENCE si el addendum está ausente.
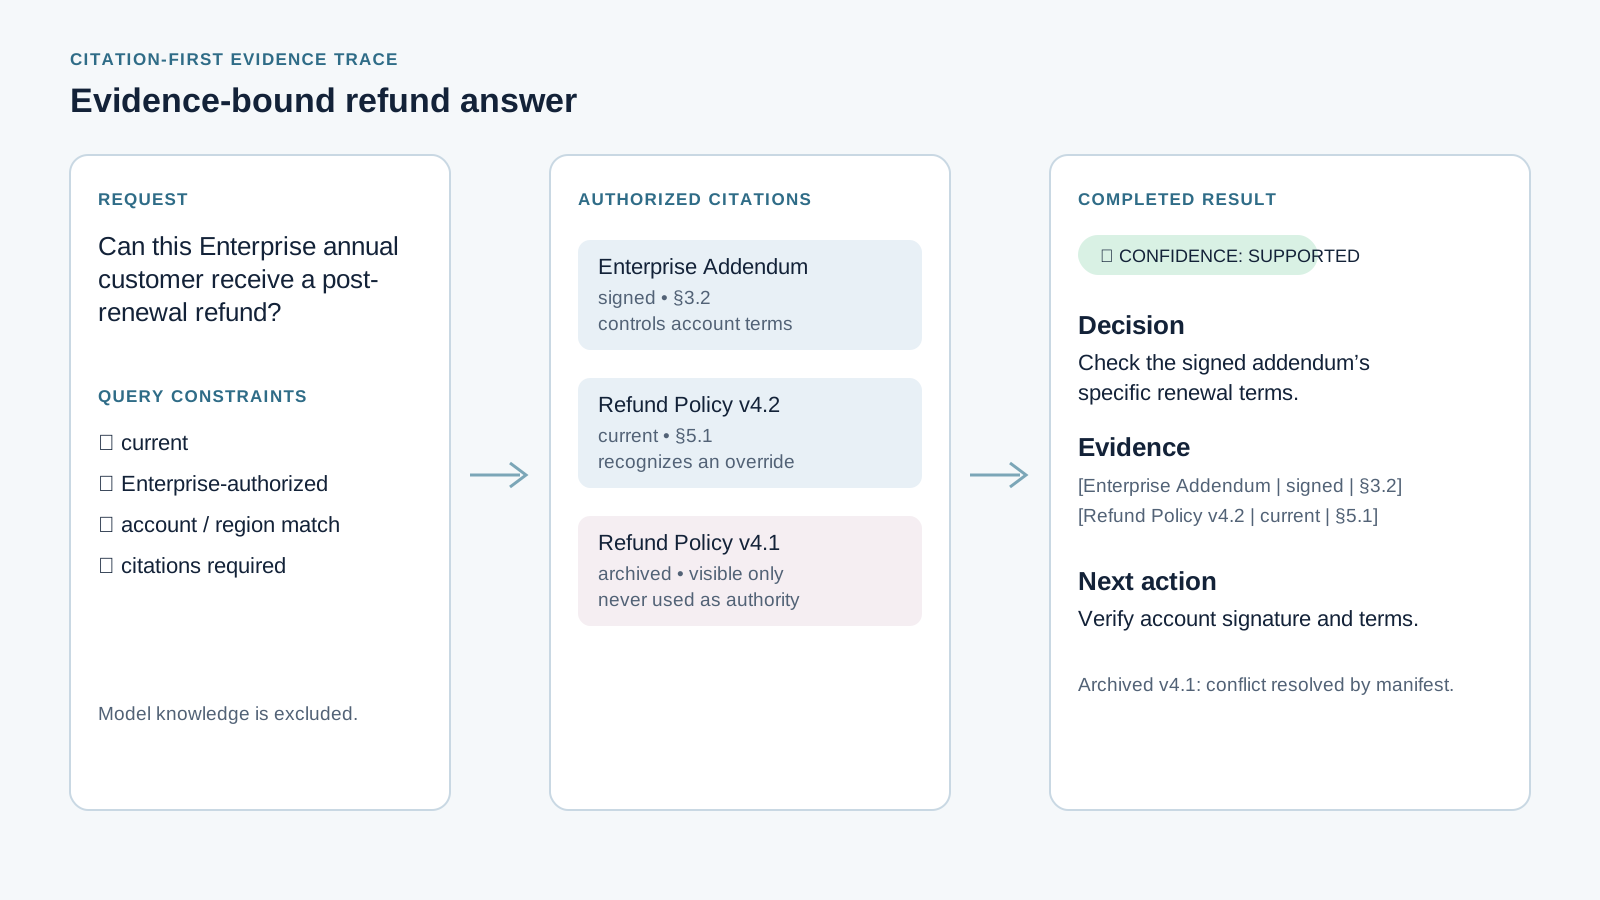
Respuesta de reembolso vinculada a la evidencia con citas de la política vigente
Resultado principal completado: la decisión está respaldada por la v4.2 y el addendum firmado, mientras que el documento archivado permanece visible solo como un conflicto resuelto.
Paso 4: Evalúa la recuperación y la fidelidad por separado
Una respuesta puede citar un documento y aun así aplicar la cláusula equivocada. Puntúa por separado la exhaustividad de la recuperación y la fidelidad de las afirmaciones. Esto produce una decisión de liberación que un propietario de producto, soporte o legal puede defender.
plaintext1You are evaluating a knowledge-base answer. 2 3Given: 4- the user question 5- expected source sections 6- retrieved source sections 7- the final answer 8 9Score these dimensions separately: 101. Retrieval recall: did the required source appear in the retrieved evidence? 112. Citation precision: does each cited source support the nearby claim? 123. Claim faithfulness: is every atomic factual claim supported by retrieved evidence? 134. Conflict handling: did the answer surface conflicting current sources? 145. Abstention quality: did the answer refuse unsupported conclusions? 15 16Return JSON with: 17question_id, retrieval_recall, citation_precision, claim_faithfulness, 18conflict_handling, abstention_quality, unsupported_claims, reviewer_notes, 19release_decision 20 21Use FAIL if any high-risk factual claim lacks supporting evidence.
Configuración: crea un conjunto dorado de 20 preguntas con 4 preguntas para cada caso: simple, común, conflictivo, sin respuesta y de alto riesgo. Mantén las preguntas de alto riesgo y conflicto con razonamiento alto. Evalúa un esfuerzo menor solo para trabajo de bajo riesgo después de que pase la línea base.
Finalizado cuando: el conjunto incluye un fallo de documento correcto recuperado / cláusula incorrecta aplicada y una abstención correcta. Los revisores humanos muestrean cada respuesta de alto riesgo respaldada.
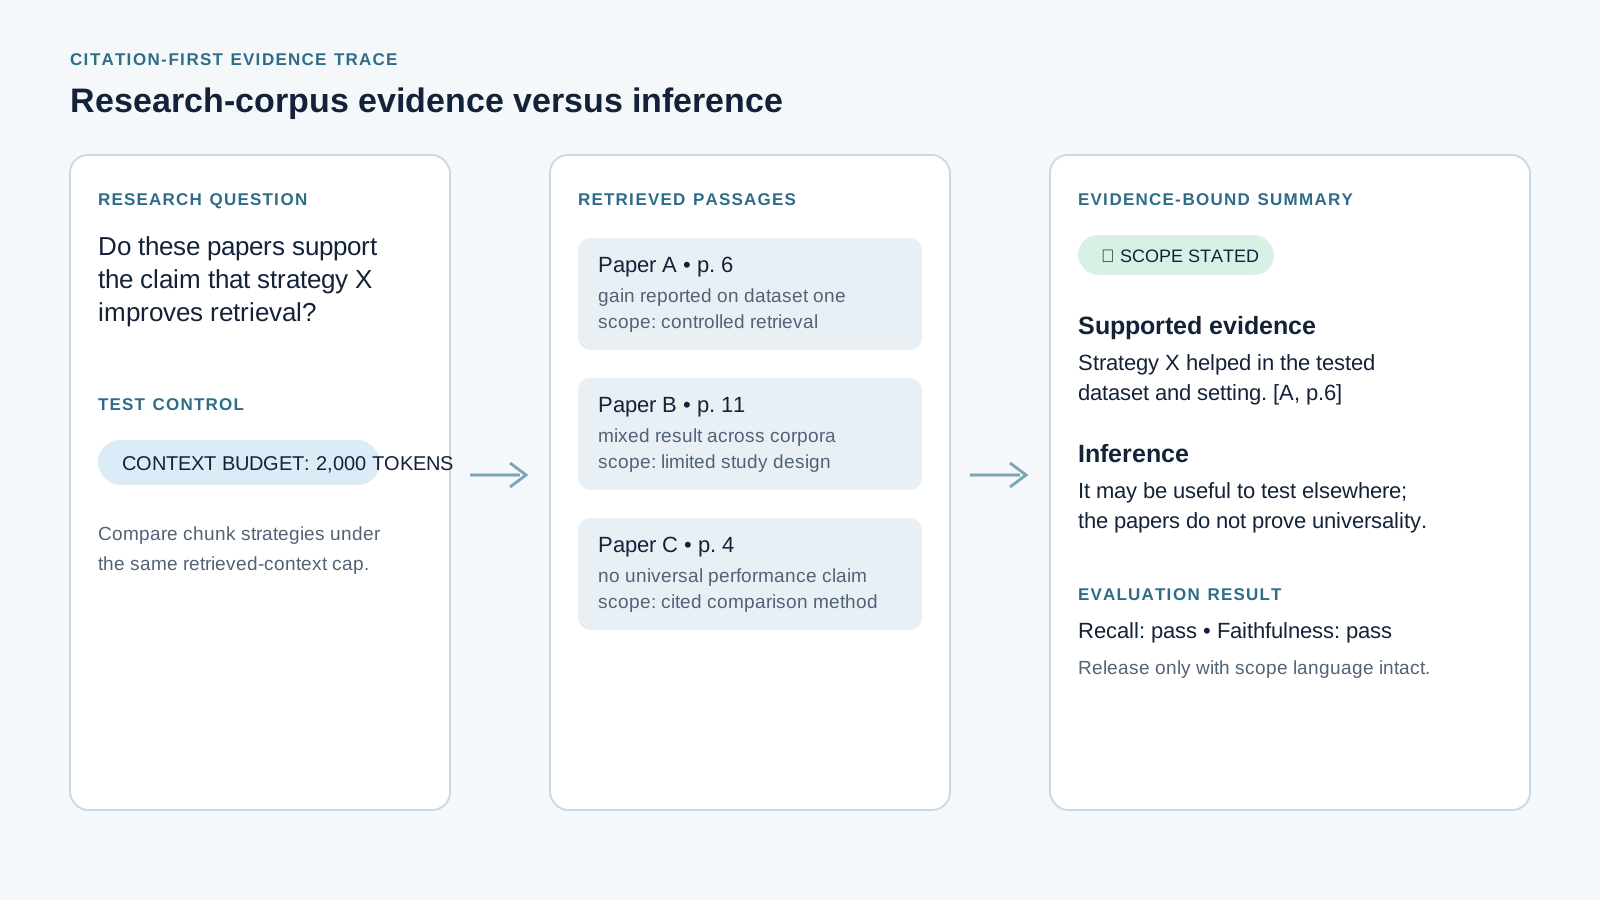
Rastro de evidencia de corpus de investigación que compara respaldo e inferencia con un presupuesto de 2000 tokens
Caso 3. Una respuesta de corpus de investigación separa lo que tres artículos respaldan explícitamente de una inferencia. La comparación de recuperación mantiene el presupuesto de contexto en 2000 tokens.
Escala la base de conocimiento de GPT-6 Astra sin perder la prueba
Los patrones del piloto cambian según el dominio. Conserva el rastro de evidencia, pero haz que la fuente de autoridad y el límite de rechazo sean específicos para el trabajo.
| Piloto | Fuente de autoridad | Metadatos requeridos | Rechazar o escalar cuando | Puerta de liberación humana |
|---|---|---|---|---|
| Política de reembolso Enterprise | addendum firmado, política vigente | cuenta, región, fecha de entrada en vigor, estado | falta el addendum o las fuentes vigentes entran en conflicto | soporte y propietario de la política |
| Runbook de incidente P1 | runbook vigente y matriz de escalado | servicio, severidad, propietario, último simulacro | la acción carece de propietario o de runbook vigente | comandante de incidentes |
| Corpus de investigación | pasajes de artículos citados | DOI, página, fecha de publicación, método | la conclusión excede la evidencia | revisor de materia |
Para código y bibliotecas de reglas internas, da rangos explícitos a AGENTS.md, decisiones de arquitectura, procedimientos de despliegue vigentes y scripts retirados. Para investigación, devuelve «evidencia» e «inferencia» como campos distintos. Para soporte al cliente, los filtros por producto, región y fecha de entrada en vigor hacen la mayor parte del trabajo de fiabilidad.
Lista de verificación de costes y enrutamiento. Una respuesta de alto riesgo con 20K tokens de entrada y 2K tokens de salida cuesta aproximadamente $0.30 en tokens de texto de GPT-6 Astra: 20,000 × $10 / 1,000,000 + 2,000 × $50 / 1,000,000. Eso excluye File Search y otros cargos de herramientas, que deben verificarse en la consola actual antes del lanzamiento. Las entradas por encima de 272K tokens tienen un precio de modelo más alto, por lo que un prompt de 1M de tokens no debería ser la ruta habitual.
| Riesgo de la tarea | Esfuerzo de razonamiento | Regla de evidencia | Revisión humana |
|---|---|---|---|
| Etiquetas y enrutamiento | benchmark antes de reducir | solo metadatos | muestreada |
| Soporte estándar | medio o alto después de probar | fuente citada vigente | cola de excepciones |
| Conflicto, política o incidente | alto | cada afirmación vinculada a la fuente | requerida |
| Legal, médico, financiero, RR. HH., privacidad | alto | abstenerse si está incompleto | requerida antes de actuar |
Empieza el control de costes aguas arriba: elimina archivos obsoletos y sin propietario, filtra metadatos antes de la recuperación, prueba primero las preguntas de alto valor y conserva el manifiesto, los pasajes recuperados, la versión del modelo y la decisión de liberación. Los equipos que necesiten una ruta multimodelo posterior pueden revisar la documentación actual de la API de LLM junto con los resultados de su propio piloto.
Para contenido regulado, privado, laboral, sanitario, financiero o de incidentes en producción, aplica el filtrado de acceso antes de la recuperación, confirma los términos de procesamiento y retención de datos, mantén una ruta de retirada y enruta la evidencia incompleta a una persona responsable. Una respuesta fluida nunca es asesoramiento final en esos contextos.
Preguntas frecuentes
¿Una ventana de contexto de 1M de tokens elimina la necesidad de RAG?
No. Puede ayudar a un investigador a leer un paquete más grande, pero no establece la autoridad del documento, el acceso del usuario, la frescura, la precisión de las citas ni una prueba de liberación. Usa la recuperación para la selección rutinaria de evidencia y reserva el contexto amplio para la investigación de excepciones.
¿Qué nunca debería entrar en una base de conocimiento de GPT-6 Astra?
No ingieras archivos sin propietario, políticas sin fecha, borradores sin un flujo de trabajo explícito para borradores, contenido que el solicitante no está autorizado a ver o material archivado que carece de una regla de uso histórico. Pon esos archivos en revisión o archívalos fuera de la recuperación normal.
¿Cómo deben gestionarse dos documentos vigentes que no coinciden?
Devuelve ESCALATE, nombra el conflicto, conserva ambas citas y asigna un propietario. Un modelo no debe inventar en silencio un desempate. El manifiesto necesita una regla documentada antes de la siguiente liberación.
¿Cuál es el mejor tamaño de chunk para una base de conocimiento de GPT-6 Astra?
No hay un número universal. Conserva encabezados y condiciones de política significativos, luego compara estrategias bajo el mismo presupuesto de contexto. Un top-k fijo puede ocultar un presupuesto de tokens recuperados mucho mayor y hacer que un experimento parezca mejor de lo que es.
¿Cómo demuestro que una respuesta se basa en la fuente correcta?
Guarda la fuente esperada para cada pregunta dorada, los pasajes recuperados, las afirmaciones atómicas finales y la puntuación de un revisor para exhaustividad, precisión de citas, fidelidad, manejo de conflictos y abstención. Para respuestas de alto riesgo, un enlace de respaldo faltante es un fallo.
¿Cuánto cuesta una base de conocimiento de GPT-6 Astra?
Usa la fórmula de tokens y luego añade los cargos actuales de File Search y herramientas. Para el ejemplo anterior, 20K de entrada más 2K de salida son aproximadamente $0.30 en tokens de modelo. El ahorro práctico proviene de mantener fuera el material obsoleto y usar razonamiento alto donde la evidencia importa. Esa es la versión duradera de las mejores prácticas de la base de conocimiento de gpt-6 astra.





