Los límites de velocidad de GPT Image 2.5 actualmente van de 5 a 250 imágenes por minuto en los niveles de API de pago que aparecen en las páginas de los modelos Flare y Sunburst de OpenAI. Ambas páginas también indican límites de tokens. Comprueba la configuración real de tu cuenta antes de programar trabajo: las cuotas de uso de ChatGPT, los límites de la API de OpenAI y las restricciones de los puntos de conexión de Atlas Cloud requieren verificaciones por separado.
El momento incómodo llega cuando una campaña está casi lista y todavía faltan las últimas imágenes. Volver a hacer clic en Generar puede dejarte con una tarea original, una tarea duplicada y ninguna idea clara de cuál terminará primero.
Esta guía conecta los límites publicados con un plan de entrega práctico. Encontrarás una tabla de diagnóstico, un procedimiento de cola, un cálculo de ejemplo con 100 imágenes y un método controlado para comprobar si una imagen generada cumple realmente con el brief. El objetivo útil es una carpeta de archivos aprobados antes de tu fecha límite.
Documentación consultada el 16 de septiembre de 2026. La capacidad específica de la cuenta y los costes configurados exactos requieren verificación por separado.
Estado editorial: la pasarela de acceso al entorno de pruebas impidió las seis generaciones previstas. El artículo incluye el protocolo reproducible y las pruebas de fuentes oficiales, pero sus tres comparaciones de resultados y la captura de la ejecución completada siguen sin estar disponibles.
Conclusiones clave
- Identifica tu vía de acceso antes de aplicar cualquier límite.
- Comprueba la cuenta, el proyecto, el modelo y cualquier cuota compartida.
- Diagnostica el error antes de decidir si reintentar.
- Haz un presupuesto para las imágenes aprobadas, incluyendo inspección y retrabajo.
Los límites de velocidad de GPT Image 2.5 dependen de tu vía de acceso
Empieza por el lugar donde pulsaste Generar. Una suscripción a ChatGPT, un proyecto de la API de OpenAI y una cuenta de Atlas Cloud son vías de acceso diferentes. Una captura de pantalla de una de ellas no puede establecer la cuota de otra.
En ChatGPT, comprueba tu plan actual, el acceso a la función de imágenes y el mensaje que aparece cuando la generación se detiene. Una suscripción de pago no establece una cuota ilimitada. Evita planificar el trabajo de un día en torno a un número diario de imágenes copiado de la cuenta de otra persona.
El hilo de discusión del lanzamiento incluye usuarios que preguntan si Plus sigue teniendo un límite diario de imágenes. Eso establece una inquietud de los lectores; los números de esas preguntas no establecen ninguna política. (Hilo de discusión del lanzamiento en Reddit, septiembre de 2026.)
Para la API, registra la organización, el proyecto y el identificador exacto del modelo que utiliza tu aplicación. Para Atlas, identifica el punto de conexión seleccionado y la cuenta que lo ejecuta. Luego clasifica la señal visible en un tipo de límite.
| Tipo de límite | Señal visible | Siguiente comprobación |
|---|---|---|
| Cuota de uso del producto | ChatGPT dice que la creación de imágenes no está disponible temporalmente | Lee el mensaje actual de la cuenta y cualquier hora de reinicio |
| Imágenes por minuto, IPM | Restricción de velocidad de imagen durante envíos repetidos | Confirma la cuota de imágenes para esa vía y modelo |
| Tokens por minuto, TPM | Un error o el panel de la cuenta menciona un límite de tokens | Inspecciona la cuota de tokens correspondiente |
| Trabajo concurrente | Las tareas esperan mientras otras tareas siguen activas | Cuenta el trabajo en curso y verifica la política de concurrencia |
| Saldo o cuota de facturación | Aviso de facturación o error de cuota | Comprueba fondos, estado de facturación y restricciones de gasto |
| Acceso al modelo | Respuesta de permiso o modelo no disponible | Confirma la elegibilidad de la cuenta y el punto de conexión exacto |
Mantén esta distinción visible en la hoja de trabajo de tu equipo. Una persona de marketing que diga «he llegado al límite» debe registrar la vía y el mensaje antes de que otro compañero empiece a solucionar el problema.
Identifica también quién más utiliza los mismos recursos de la cuenta. Una segunda estación de trabajo no proporciona necesariamente capacidad adicional. Pregunta al propietario de la cuenta si el sitio web, la herramienta interna y los trabajos nocturnos se alimentan del mismo grupo.
La entrada «Free: not supported» de la tabla de la API se refiere a ese nivel de modelo de la API. No establece si el producto gratuito de ChatGPT puede generar imágenes.
Límites de velocidad de GPT Image 2.5 por nivel de API
Las páginas oficiales de los modelos publican actualmente la siguiente tabla para ambas variantes. Son cifras públicas por nivel de uso, consultadas el 16 de septiembre de 2026, y no una garantía de que cada cuenta tenga exactamente esta configuración.
| Nivel de uso de la API de OpenAI | TPM | IPM |
|---|---|---|
| Gratuito | No compatible | No compatible |
| Nivel 1 | 100 000 | 5 |
| Nivel 2 | 250 000 | 20 |
| Nivel 3 | 800 000 | 50 |
| Nivel 4 | 3 000 000 | 150 |
| Nivel 5 | 8 000 000 | 250 |
Fuentes: (Página del modelo Flare de OpenAI, consultada en septiembre de 2026) y (Página del modelo Sunburst de OpenAI, consultada en septiembre de 2026).
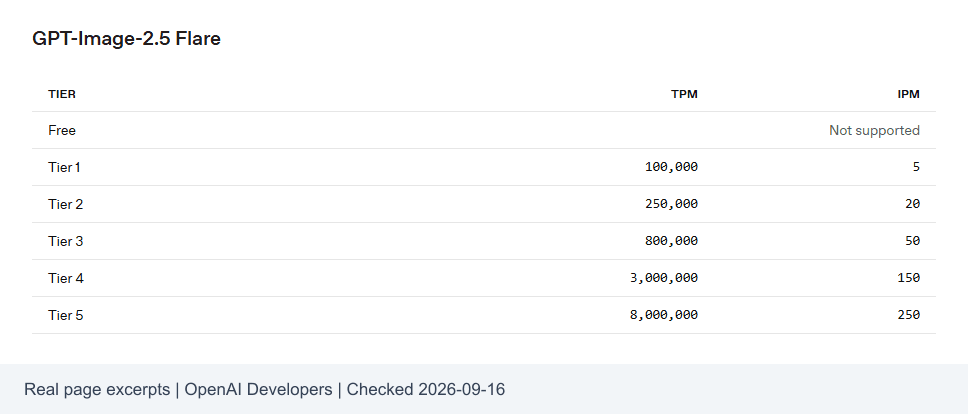 Página oficial del modelo OpenAI que muestra los límites de velocidad de GPT Image 2.5 por nivel de uso
Prueba de la página oficial del modelo. Fecha de consulta: 16 de septiembre de 2026.
IPM cuenta imágenes; RPM cuenta solicitudes. Conserva esa distinción en tu hoja de planificación. Con una imagen por solicitud correcta, los dos recuentos pueden coincidir en una estimación simple. Las salidas múltiples, los reintentos u otros comportamientos del punto de conexión pueden romper esa suposición.
Usa la tabla como punto de partida para una conversación sobre capacidad. Anota el nivel publicado y luego compáralo con los límites visibles para la cuenta que realiza realmente el trabajo. Si difieren, investiga antes de comprometer una fecha límite.
Las tablas coincidentes no demuestran que Flare y Sunburst terminen una tarea en el mismo tiempo. Tampoco establecen que alternar entre las variantes sume sus cuotas. Confirma cualquier límite compartido en la configuración de la cuenta.
Un equipo que prepara una campaña para el viernes puede convertir esto en una breve verificación previa: identifica la ruta de producción, verifica la cuota actual, comprueba otras cargas de trabajo programadas y asigna a una persona para que supervise la cola. Guarda la fecha de consulta para que una captura de pantalla antigua no se convierta en una suposición operativa permanente.
No multipliques una cuota por minuto por los minutos del día y prometas esa cantidad de imágenes terminadas. Ese cálculo excluye el tiempo de inactividad, la latencia de generación, otras restricciones y las salidas rechazadas.
Diagnostica los límites de velocidad de GPT Image 2.5 antes de reintentar
Guarda el cuerpo del error, el código de estado HTTP, la marca de tiempo y el identificador de solicitud disponible antes de cambiar nada. Una captura de pantalla que solo dice «429» deja demasiadas incógnitas.
La documentación de OpenAI describe límites de organización y de proyecto, grupos de modelos compartidos, cabeceras de respuesta y gestión de errores temporales. Recomienda esperar al menos tanto como indique una cabecera Retry-After proporcionada, añadir jitter y evitar fallos rápidos repetidos, que pueden consumir la cuota por minuto. (Límites de velocidad de OpenAI, consultado en septiembre de 2026.)
El siguiente procedimiento de diagnóstico es una propuesta de diseño de aplicación. Las etiquetas de error y los controles de recuperación deben asignarse a la plataforma que realmente uses.
| Situación visible | Comprobar primero | Acción |
|---|---|---|
| 429 temporal | Cuerpo del error y cualquier indicio de espera o reinicio | Pausa la cola afectada y luego reduce el ritmo de envío |
insufficient_quota de OpenAI | Saldo, estado de facturación y elegibilidad de la cuenta | Resuelve el problema de la cuenta; detén los reintentos automáticos |
| Tiempo de espera agotado tras el envío | Registro de la solicitud original, ID de tarea si está disponible, historial | Concilia la tarea original antes de volver a enviar |
| Cola larga | Estado pendiente y número de tareas activas | Sigue esperando mientras la tarea siga siendo válida; investiga los retrasos por separado |
| Rechazo de parámetros o contenido | Motivo específico de validación o rechazo | Corrige la solicitud; no la clasifiques como reintento por límite de velocidad |
El código de OpenAI en la tabla es un ejemplo de diagnóstico específico de OpenAI. No es una promesa de que Atlas devuelva el mismo objeto de error o admita las mismas cabeceras.
Ante un tiempo de espera agotado, separa lo que sabes de lo que sospechas. «Mi cliente dejó de esperar» no establece si el servidor aceptó el trabajo. Marca el registro local como incierto e inspecciona la operación original mediante el mecanismo de estado o historial que proporcione la vía.
Si no existe ningún mecanismo de conciliación, deriva esa incertidumbre a un operador. Enviar de nuevo a ciegas puede crear otro trabajo facturable. Registra ese riesgo antes de que alguien decida reintentar.
Para el momento de reinicio, usa la respuesta o el mensaje de la cuenta correspondiente al límite que alcanzaste. Evita asumir que toda restricción se reinicia a medianoche o exactamente 60 segundos después del error.
Conserva las pruebas después de la recuperación. Un pequeño registro del incidente con la vía, el error original, la duración de la espera y el resultado final ayuda al siguiente operador a distinguir un problema de cuenta de un pico de tráfico.
Gestiona los límites de velocidad de GPT Image 2.5 con una cola
Una cola le da a tu equipo un único lugar para decidir qué se ejecuta a continuación. Para una campaña pequeña, una hoja de cálculo y un operador pueden ser suficientes. Una aplicación puede implementar las mismas decisiones en un almacén de trabajos duradero.
Utiliza este procedimiento operativo estándar de seis pasos:
- Asigna un ID de negocio estable. Registra la versión del prompt, la salida deseada, el modelo, las dimensiones, la calidad y la fecha límite. Un brief revisado recibe una versión nueva.
- Comprueba el trabajo existente. Devuelve la salida guardada para un trabajo completado. Deja un trabajo activo o incierto en conciliación en lugar de crear otro envío.
- Controla el ritmo y la concurrencia por separado. Admite trabajo solo cuando el presupuesto de ritmo local y una ranura en curso estén disponibles. Los reintentos usan los mismos controles de admisión.
- Respeta una indicación de espera del servidor. Para un error reintentable confirmado, espera al menos la duración indicada y añade un poco de aleatoriedad.
- De lo contrario, usa retroceso acotado. Aumenta los retrasos entre intentos, añade jitter y limita el retraso. Mantén a la vista la fecha límite general de la tarea.
- Detente deliberadamente. Cuando se agote el presupuesto de reintentos o la fecha límite, guarda las últimas pruebas y envía la tarea para revisión.
Este pseudocódigo neutral respecto a la plataforma ilustra las decisiones de planificación. No es un SDK de Atlas ni un contrato de punto de conexión.
plaintext1claim business_job_id atomically 2if completed: return saved_asset 3if active_or_uncertain: reconcile_original; stop 4 5while attempts_remaining and before_deadline: 6 wait_for_rate_budget_and_inflight_slot() 7 result = submit_once_and_record_identifiers() 8 9 if completed: save_asset_and_finish() 10 if accepted: track_original_until_terminal(); stop 11 if submission_outcome_unknown: mark_uncertain(); stop 12 if billing_or_access_or_validation_error: stop_for_review() 13 if not_retryable: stop_for_review() 14 15 delay = server_minimum_wait_if_present() 16 otherwise: delay = capped_exponential_backoff() 17 schedule_next_attempt_after(delay + random_jitter) 18 19save_final_state_for_review()
La reclamación atómica importa cuando dos trabajadores ven la misma fila en cola. Ambos no deben concluir de forma independiente que el trabajo está libre para enviarse. Persiste el estado del envío antes de que un trabajador desaparezca o se reinicie.
La deduplicación a nivel de aplicación sigue dejando una ventana difícil: un servicio puede aceptar una solicitud justo antes de que el cliente pierda la respuesta. La idempotencia nativa del punto de conexión puede abordar algunos riesgos de envío duplicado cuando está documentada. Un ID de negocio local por sí solo no puede garantizar una ejecución exactamente una vez, y esta guía no asume que Atlas acepte una cabecera de idempotencia concreta.
Prioriza según la necesidad de entrega. Termina la imagen que falta de la campaña aprobada antes de admitir variaciones opcionales. Mantén una nota breve del operador explicando por qué se detuvo el trabajo, para que un compañero pueda reanudar sin tener que adivinar.
Planifica 100 imágenes en torno a los límites de velocidad de GPT Image 2.5
Usa dos contadores: salidas generadas y entregables aceptados. El segundo contador le dice al responsable de la campaña si el trabajo está listo.
Considera un ejemplo de planificación hipotético, con una salida por tarea. Supón una cuota efectiva de 5 IPM, una ocupación media de ranura de 60 segundos y un máximo de 2 tareas simultáneas. Estos datos son ilustrativos, no mediciones de Atlas ni de OpenAI.
| Dato de planificación o cálculo | Valor hipotético | Interpretación |
|---|---|---|
| Imágenes aprobadas necesarias | 100 | El objetivo real de entrega |
| Cuota de imágenes efectiva | 5 IPM | Capacidad de cuenta asumida |
| Cuota de imágenes necesaria para 100 salidas | 100 ÷ 5 = 20 minutos | Requisito de capacidad de cuota, no una promesa de finalización |
| Tareas concurrentes | 2 | Techo en curso asumido |
| Ocupación media de ranura | 60 segundos | Desde el envío hasta la finalización |
| Capacidad por concurrencia | 2 × 60 ÷ 60 = 2 imágenes/minuto | Inferior a la cuota de imágenes |
| Tasa de aceptación asumida | 80 % | Estimación simplificada para planificar |
| Cuota de generación para 100 imágenes aceptadas | 100 ÷ 0,8 = 125 salidas | Incluye un presupuesto aproximado de retrabajo |
| Tiempo de capacidad a 2 salidas/minuto | 125 ÷ 2 = 62,5 minutos | Excluye inspección adicional y trabajo de traspaso |
Una aproximación útil es:
plaintext1imágenes sostenibles/minuto ≈ mínimo de: 2 cuota de imágenes 3 cuota de solicitudes × imágenes por solicitud 4 cuota de tokens ÷ tokens aplicables por imagen 5 concurrencia × 60 ÷ segundos medios de ocupación
Usa unidades comparables y mediciones reales de la cuenta. Si el consumo de tokens no está disponible, deja ese término sin resolver en lugar de estimarlo a partir del número de palabras del prompt. Esta fórmula describe un modelo de planificación, no la implementación del proveedor.
La estimación de 125 salidas asume una probabilidad de aceptación estable entre intentos. El retrabajo real puede estar correlacionado: un prompt que cuenta mal los objetos repetidamente puede seguir fallando hasta que alguien lo cambie. Revisa los defectos recurrentes antes de comprar más intentos.
Los distintos trabajos necesitan distintos controles de aceptación:
- Ilustraciones semanales para contenido: el tema debe coincidir con el artículo y el recorte debe funcionar al tamaño de publicación.
- Material de concepto de producto: la imagen debe conservar la forma y la colocación requeridas. Una imagen conceptual no puede sustituir a la fotografía de producto verificada.
- Ilustraciones didácticas o de recetas: los recuentos, los objetos y los detalles de la secuencia deben coincidir con la explicación. Un ingrediente extra puede confundir a los lectores.
Añade al calendario el tiempo de descarga, inspección, revisión y traspaso. Si una sola persona revisa cada recurso, mide también el ritmo de esa persona.
Antes de una fecha límite, separa las imágenes esenciales de las variantes opcionales. Haz un seguimiento independiente de los elementos listos, rechazados, activos e inciertos. Una carpeta con 100 archivos puede seguir estando varios entregables aprobados por debajo de lo necesario.
Reduce el retrabajo antes de aumentar tus límites
Define un criterio de aprobación antes de pulsar Generar. Eso hace que la decisión sea repetible e impide que una imagen convincente pase con un recuento incorrecto o un texto inutilizable.
El protocolo controlado que se presenta aquí utiliza GPT Image 2.5 Flare Text-to-Image, un PNG por tarea, a 2048x1152. Para cada brief, ejecuta primero max y luego high, manteniendo el resto de ajustes disponibles sin cambios. Conserva los originales e inspecciona ambos al mismo tamaño de visualización.
Estado de las pruebas: las seis salidas de Flare que aparecen a continuación se generaron para los tres briefs a 2048x1152. Cada par registra un resultado MAX y uno HIGH. Estos ejemplos respaldan los pasos de inspección que se muestran aquí, pero seis salidas no establecen una clasificación amplia de calidad ni una tasa de aceptación.
A. Recuento de objetos y composición
Copia este prompt sin cambios:
plaintext1Create a realistic overhead food photograph for a recipe article. 2Show exactly six whole red tomatoes arranged in two neat rows of three 3on a light wooden cutting board. Place one stainless-steel kitchen knife 4to the right of the board and one folded beige linen towel to the left. 5No other vegetables, no sliced tomatoes, no plates, no hands, no text, 6and no logos. Use soft natural window light from the upper left. 7Keep the entire cutting board inside the frame. 8Horizontal 16:9 composition.
Cuenta cada tomate, comprueba las dos filas e inspecciona los cuatro bordes de la tabla. Luego busca objetos prohibidos. Acepta el encuadre solo cuando todo el brief se cumpla. Un recuento correcto de tomates con una tabla recortada sigue requiriendo una decisión sobre reparar o regenerar.
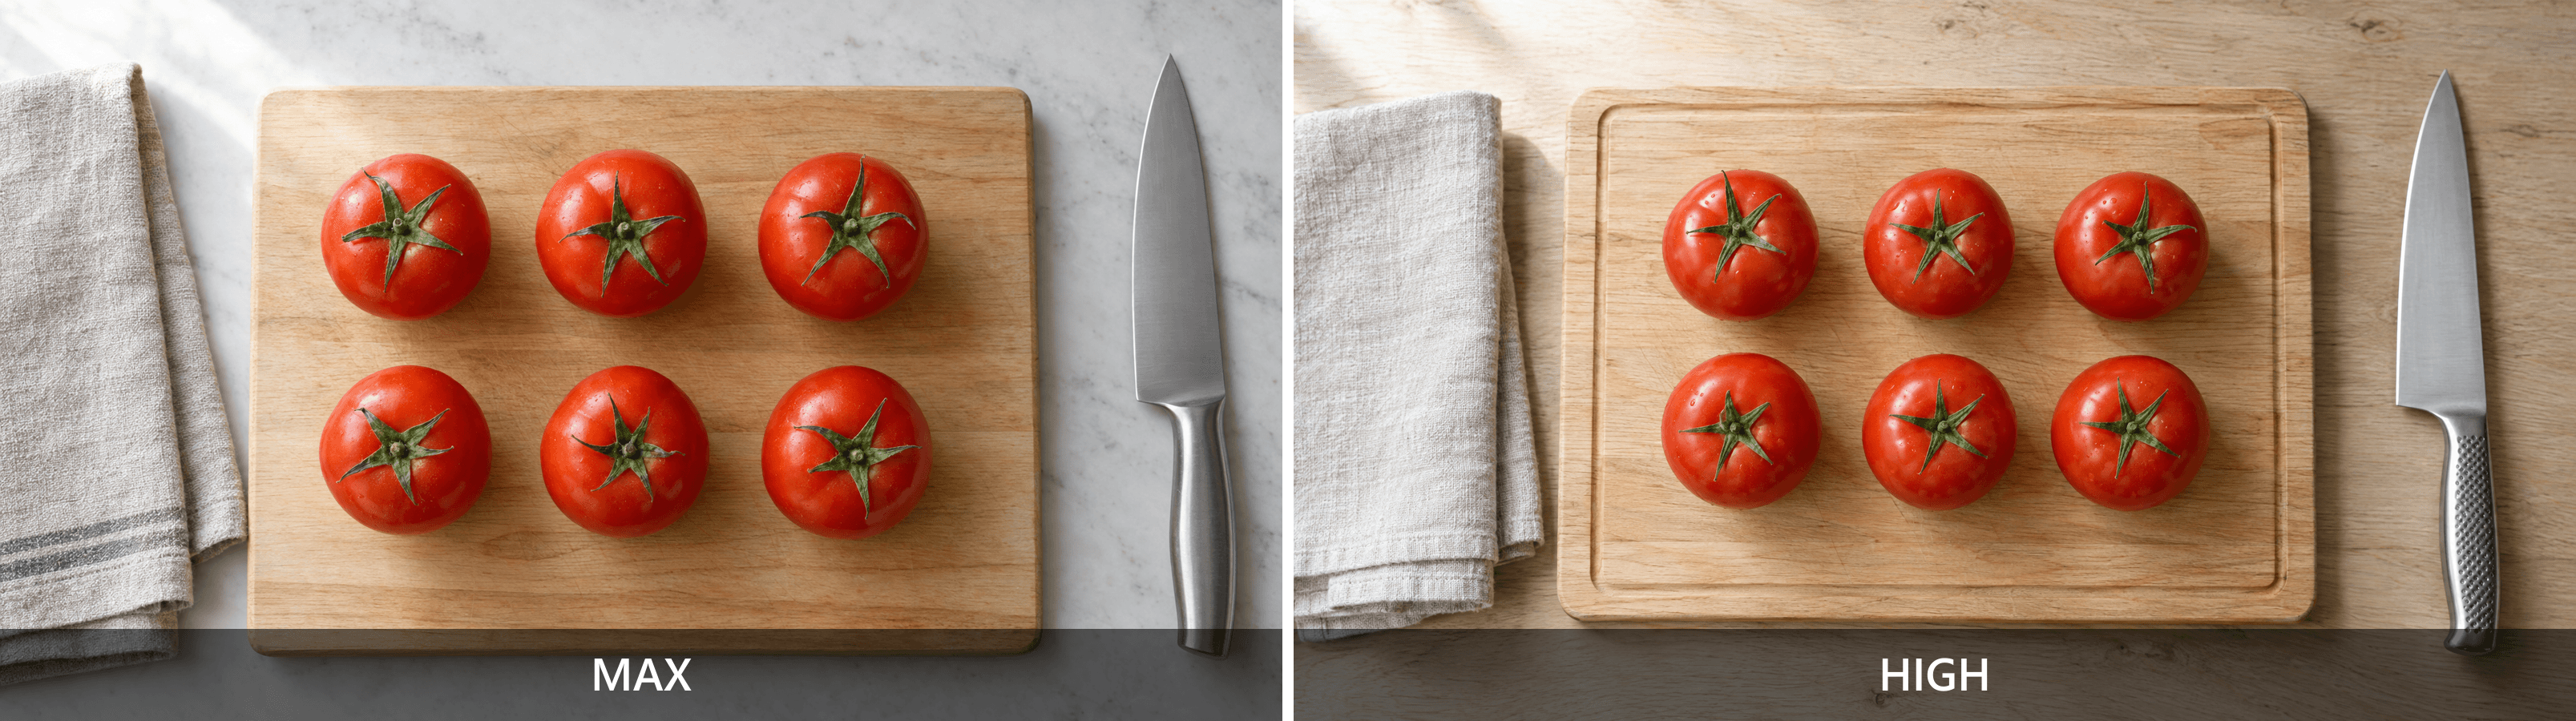 Salidas High y max de Flare para el recuento de seis tomates y la comprobación de la tabla completa
Izquierda: MAX. Derecha: HIGH. Ambas salidas muestran seis tomates en dos filas; inspecciona la tabla completa, el cuchillo, el paño y cualquier objeto prohibido antes de aprobar cualquiera de los resultados.
B. Espacio para un titular
plaintext1Create a realistic editorial still-life photograph for a home-office 2article. Place an open unbranded notebook, one black pen, and one plain 3ceramic coffee cup entirely within the left half of a pale oak desk. 4Keep the right 45 percent of the frame empty, showing only the desk 5surface so a designer can add a headline later. No laptop, no phone, 6no plants, no visible writing, no text, and no logos. 7Use soft daylight and a slightly elevated camera angle. 8Horizontal 16:9 composition.
A 2048 píxeles de ancho, el 45 % más a la derecha comienza aproximadamente en x = 1126. Comprueba esa zona en el original. Luego coloca un titular real en una vista previa de maquetación local para evaluar la legibilidad. Una línea guía es una anotación de postproducción, no parte de la escena generada.
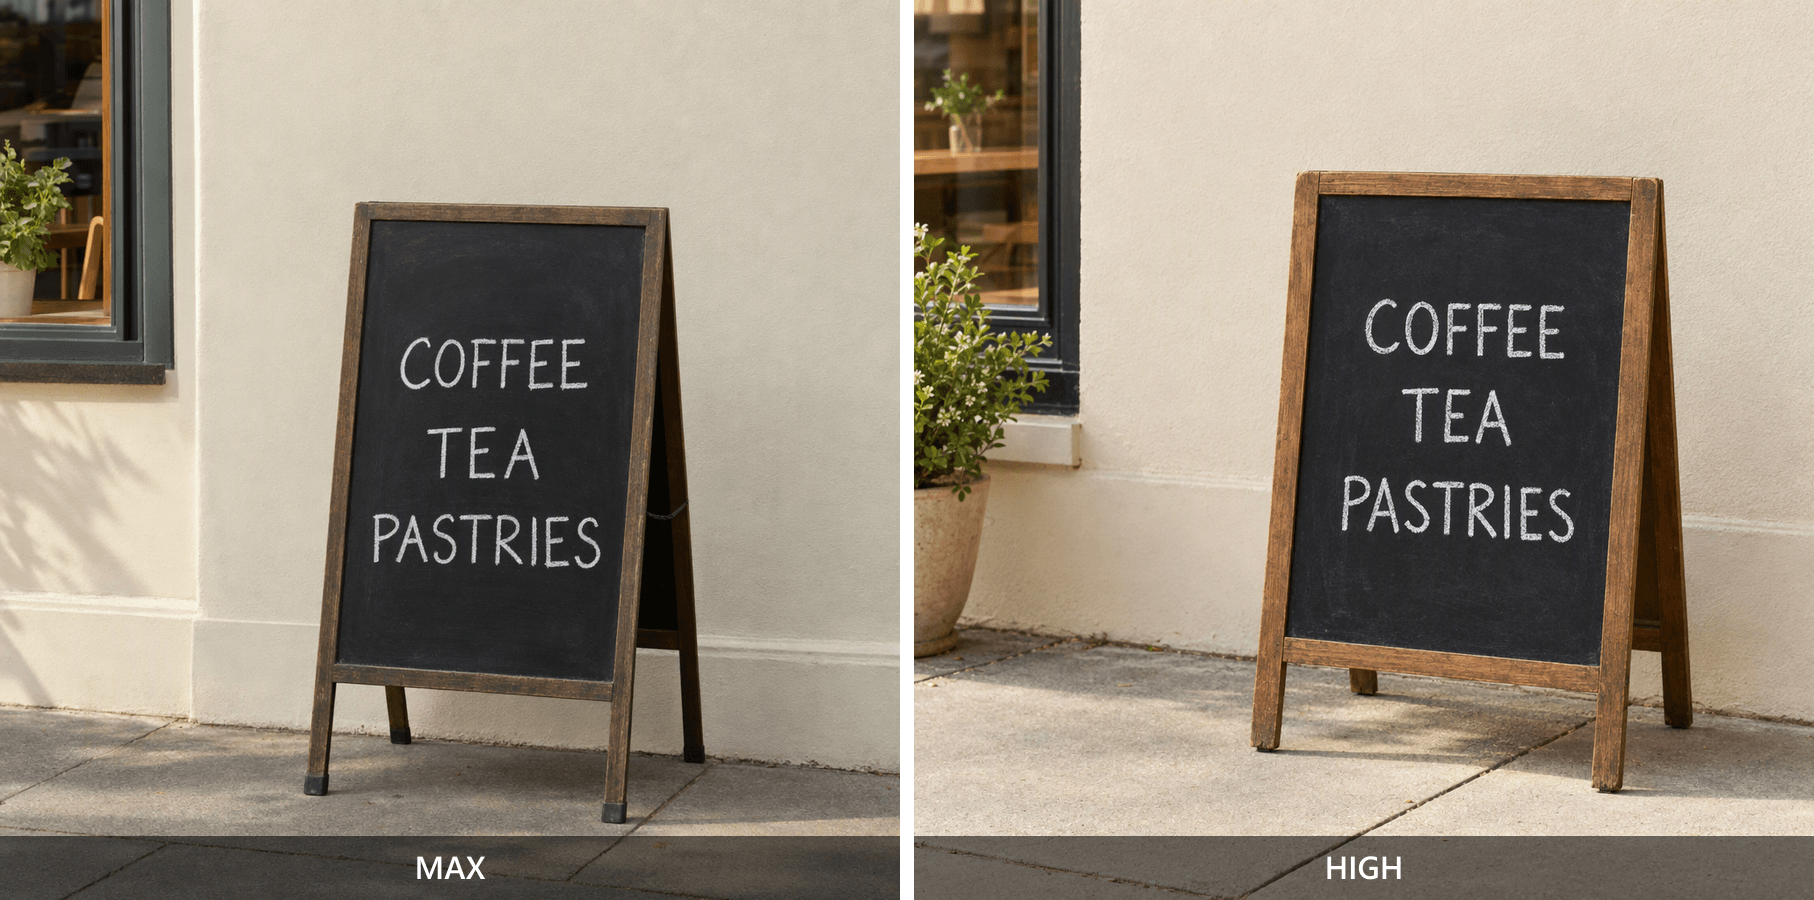 Salidas high y max de la oficina en casa con la zona derecha para titular marcada según lo solicitado
Izquierda: MAX. Derecha: HIGH. Ambas salidas conservan una zona útil de escritorio a la derecha para un titular; evalúa esa región vacía al tamaño de visualización final.
C. Texto corto exacto
plaintext1Create a realistic photograph of a small freestanding black chalkboard 2outside a quiet neighborhood cafe. The board must contain exactly 3these three lines of clearly readable white lettering: 4COFFEE 5TEA 6PASTRIES 7Do not add prices, extra words, logos, or other readable signs. 8Show the full board with a simple cream-colored wall behind it, 9warm morning daylight, and a small area of clean pavement. 10No people. Horizontal 16:9 composition.
Lee cada letra en el original y en la vista previa al tamaño de publicación. Comprueba el fondo para detectar carteles legibles adicionales. Esta es una escena de prueba generada por IA, no una fotografía que documente una cafetería real. Conserva las faltas de ortografía en las pruebas en lugar de retocarlas.
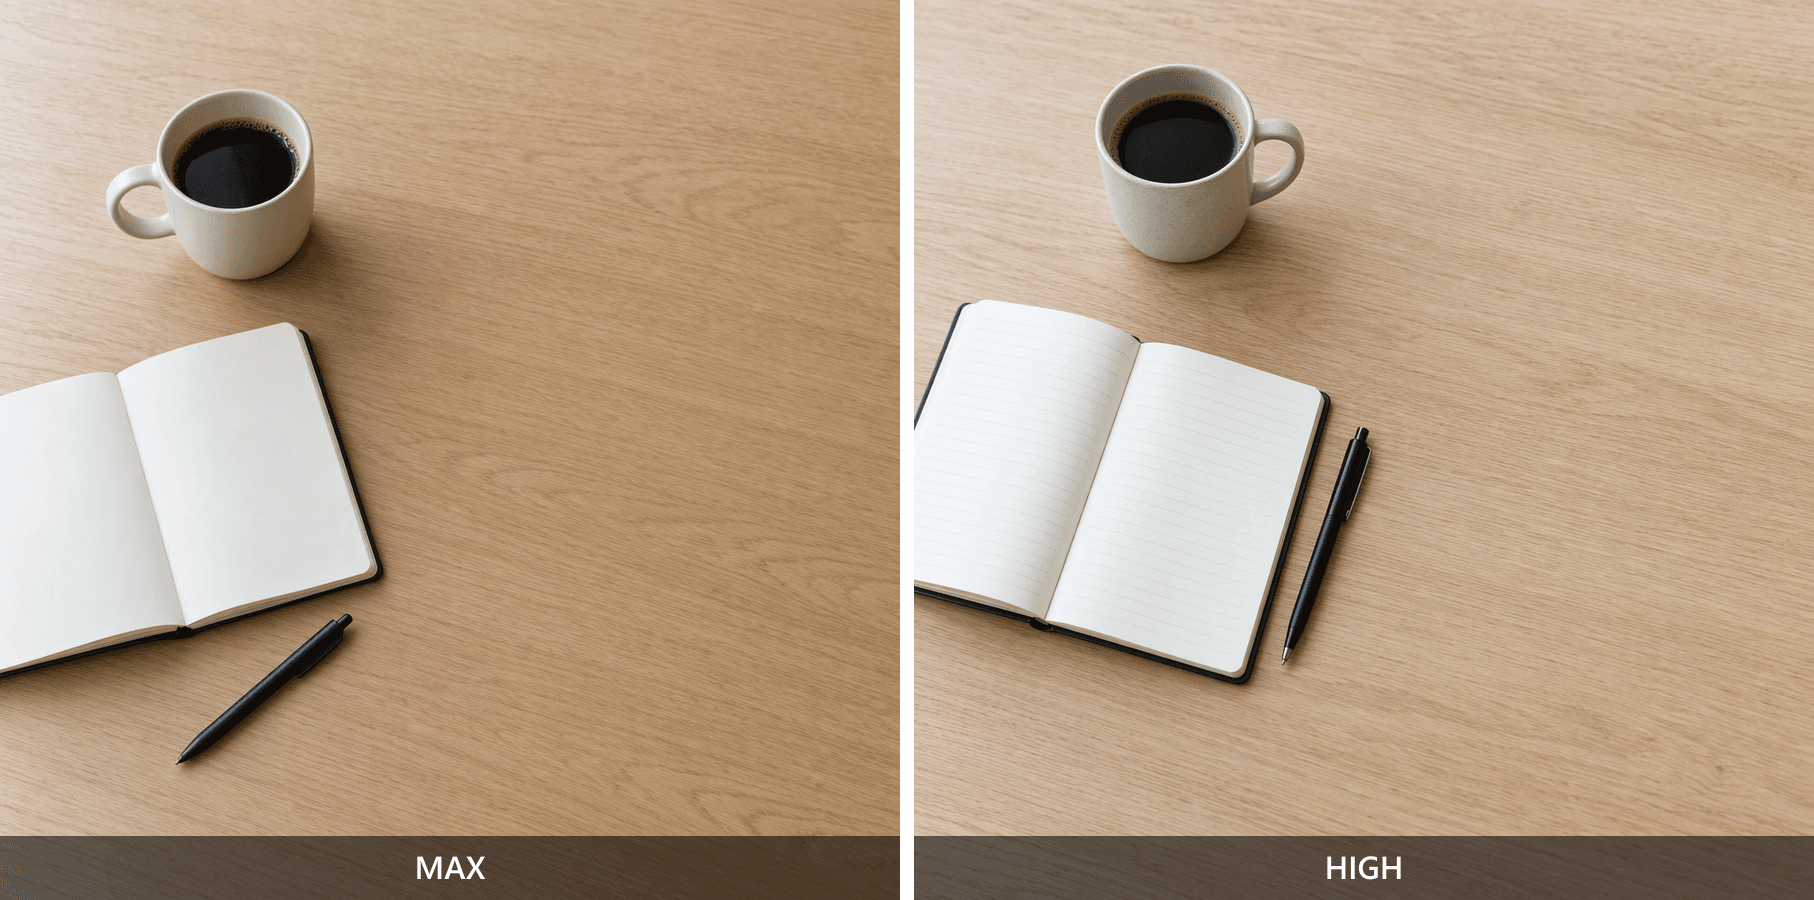
Pizarras de cafetería generadas por IA en high y max para comprobar COFFEE, TEA y PASTRIES
Izquierda: MAX. Derecha: HIGH. Lee cada línea al tamaño de publicación y comprueba el fondo para detectar texto legible adicional antes de aprobar un resultado.
Seis salidas pueden demostrar un proceso de inspección. No pueden establecer una tasa de éxito de la plataforma, un rendimiento de producción ni un techo de límite de velocidad. Un solo par tampoco puede aislar los efectos de los ajustes de calidad de la variabilidad de la generación.
Juzga un ajuste por el recurso aceptado y su coste registrado. Sin cargos exactos, una conclusión sobre el coste de high frente a max sigue sin medirse. Si ambos pasan, regístralo; si ninguno pasa, revisa el brief antes de repetir el mismo fallo.
Evalúa Atlas Cloud para tu flujo de trabajo de imágenes
Usa la misma tarea representativa para evaluar una vía de acceso. Esto mantiene la evaluación vinculada al trabajo que tu equipo necesita entregar.
La página seleccionada de GPT Image 2.5 Flare Text-to-Image es el punto de conexión para este protocolo. Ábrela, confirma el nombre del modelo, pega uno de los prompts completos anteriores y selecciona el tamaño y la calidad solicitados.
Comprueba qué conserva realmente el formulario después de salir de cada control. Una anchura escrita que se revierte antes del envío no crea una prueba de 2048 píxeles. Registra los ajustes confirmados, ejecuta una tarea, espera a que llegue a un estado terminal y descarga la salida real.
Guarda el identificador de la tarea si se expone, la hora de envío, la hora de finalización y el archivo de resultado juntos. Para la ejecución comparativa, crea una tarea separada y cambia solo la calidad. No deduzcas una salida nueva a partir del arte de muestra ya mostrado en la página del modelo.
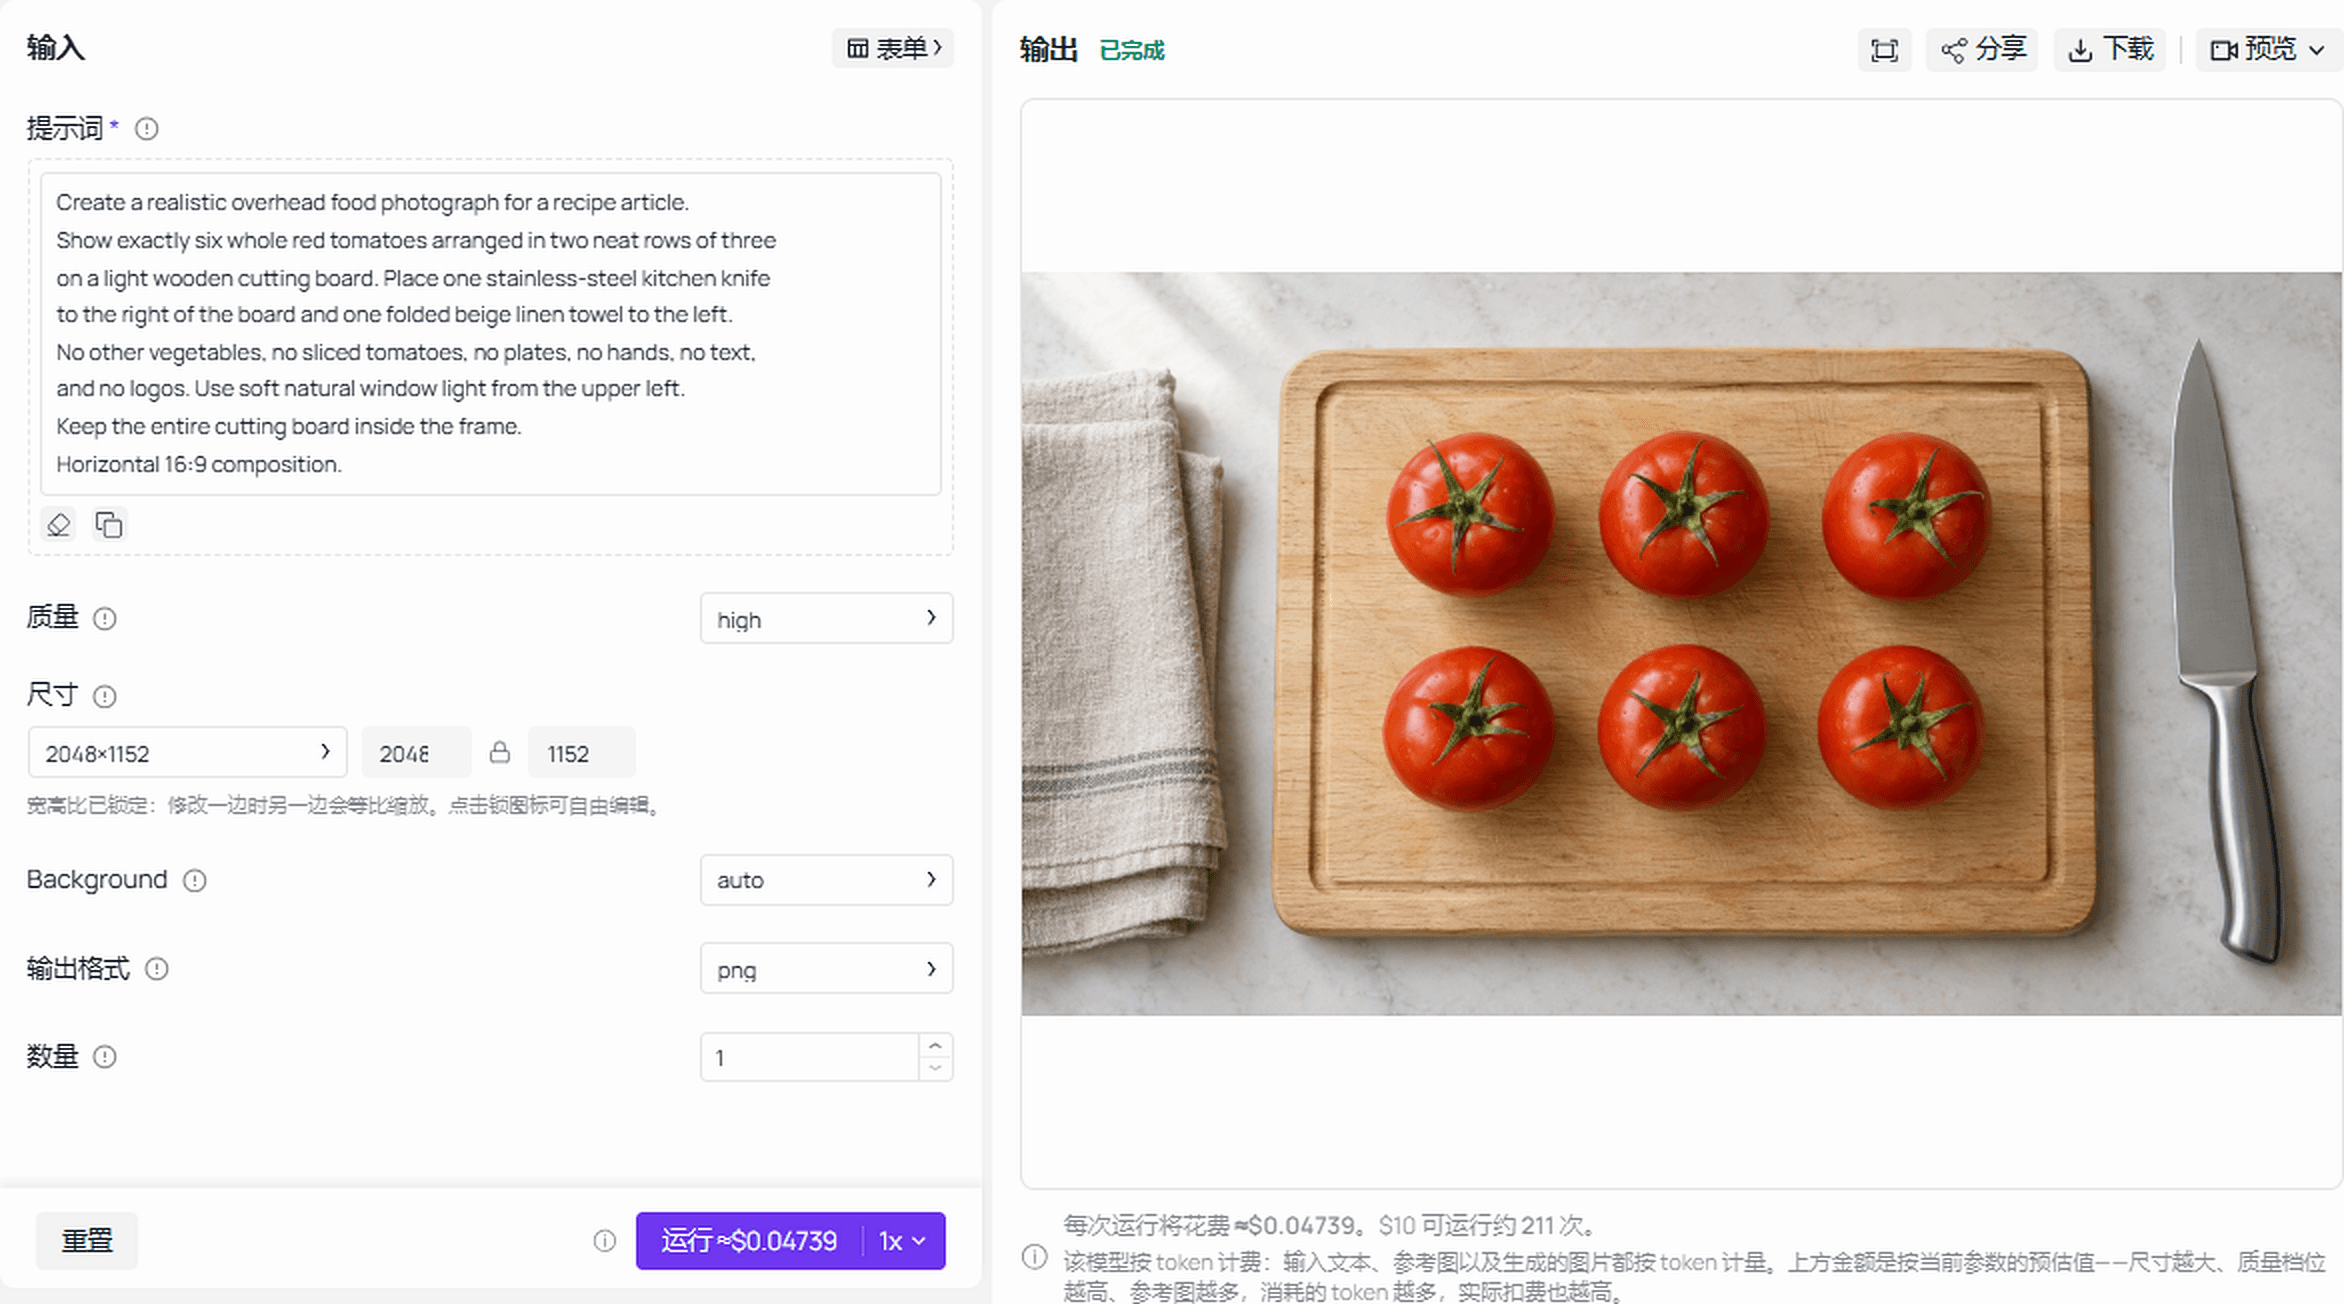 Ejecución de Flare completada que muestra el brief de los tomates, los ajustes activos y el resultado generado
Ejecución de Flare completada: la pantalla muestra el brief de los tomates, calidad HIGH, tamaño 2048x1152, salida PNG y el resultado devuelto de seis tomates.
Evalúa la vía en cinco campos:
- Modelo y punto de conexión: confirma Flare text-to-image y no un punto de conexión de edición ni una variante diferente.
- Velocidad y concurrencia: obtén los límites de cuenta aplicables y si las cargas de trabajo los comparten.
- Recuperación de tareas: verifica cómo expone la cuenta el trabajo activo, los fallos terminales y los resultados después de un tiempo de espera agotado.
- Coste configurado: comprueba la unidad, las dimensiones seleccionadas, la calidad y cualquier condición de descuento.
- Aceptación y retrabajo: conserva la salida original y un motivo breve para cada recurso rechazado.
Usa el directorio de modelos actual como punto de entrada para comprobar precios y luego inspecciona la configuración seleccionada. Un precio inicial redondeado no establece el cargo por 2048x1152 + max.
La concurrencia de cuentas de Atlas, el rendimiento de producción, las cuotas compartidas y la facturación de tareas fallidas no se establecieron de forma independiente para este artículo. Confírmalo en el lado de la cuenta. Los tiempos de tarea del entorno de pruebas tampoco pueden establecer el rendimiento de la API en producción.
Ejecuta un prompt representativo, inspecciona el resultado y comprueba los límites de tu cuenta antes de escalar.
Preguntas frecuentes sobre los límites de velocidad de GPT Image 2.5
¿Cuántas imágenes de GPT Image 2.5 puedo generar por minuto?
Los niveles de API de pago de las páginas de los modelos indican de 5 a 250 IPM. Usa la configuración actual de tu cuenta para la planificación operativa, incluyendo los tokens y cualquier otra restricción aplicable. Una cuota de imágenes publicada no garantiza que cada imagen termine o pase la revisión dentro de ese minuto.
¿ChatGPT Plus tiene un límite diario de imágenes fijo?
Este artículo no establece un recuento diario fijo universal para Plus. Comprueba el mensaje actual de generación de imágenes y la información del plan de tu cuenta. Los informes de usuarios pueden ayudar a identificar una pregunta que investigar, pero un número de la sesión de otra persona no puede convertirse de forma segura en el presupuesto diario de producción de tu equipo.
¿Flare y Sunburst tienen los mismos límites de velocidad?
Sus páginas oficiales de modelo mostraban tablas de niveles coincidentes cuando se consultaron el 16 de septiembre de 2026. Eso no establece tiempos de generación coincidentes ni grupos de capacidad separados. Antes de planificar una carga de trabajo dividida, confirma los límites y las reglas de uso compartido que se aplican a ambas variantes en tu cuenta.
¿Por qué recibo un error 429 si todavía tengo crédito?
Un saldo responde a si quedan fondos; no responde a si la solicitud actual cabe dentro de una restricción de velocidad. Lee el cuerpo del error y cualquier indicio de espera. Si el error identifica un problema de cuenta o de cuota, aborda ese problema en lugar de asumir que los envíos retrasados repetidos lo resolverán.
¿Cuándo se reinician los límites de velocidad de GPT Image 2.5?
Usa las cabeceras de respuesta o el aviso de la cuenta correspondientes. Diferentes restricciones pueden tener diferentes ventanas, y aquí no se establece una única hora de reinicio para todas las vías. Sigue una espera mínima proporcionada, reduce el ritmo de la cola y conserva el estado original del trabajo mientras decides si un reintento es apropiado.
¿Usar Atlas Cloud elimina los límites de velocidad de GPT Image 2.5?
No. Evalúa Atlas como una opción de acceso con su propio comportamiento de punto de conexión y restricciones de cuenta. Confirma esos detalles antes de aumentar el volumen. Un plan práctico para los límites de velocidad de GPT Image 2.5 combina capacidad verificada, envíos controlados, recuperación de tareas y controles de aceptación que reducen el retrabajo evitable.


