Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: ¿Qué modelo de código abierto gana en programación en 2026?
La respuesta breve
Si estás construyendo un agente de programación autónomo que funciona durante horas sin intervención: Kimi K2.6. Obtuvo un 66,7 % en Terminal-Bench 2.0 y mantuvo más de 4000 llamadas a herramientas en una sesión ininterrumpida de 13 horas en los puntos de referencia publicados, un techo de estabilidad que ningún otro modelo abierto de esta comparación alcanza.
Si necesitas el mejor desarrollador front-end agéntico: GLM 5.1. Su Elo de Code Arena de 1530 (tercero a nivel mundial en desarrollo web agéntico) refleja la preferencia real de los desarrolladores en comparaciones cara a cara, no solo en suites de pruebas automatizadas.
Si el coste por token es la limitación: MiniMax M2.7 a 0,30 USD/M tokens de entrada en Atlas Cloud obtiene un 56,22 % en SWE-Bench Pro con solo 10B parámetros activados: el 94 % del rendimiento de GLM-5.1 aproximadamente a una quinta parte del coste.
Si tu base de código es demasiado grande para una ventana de contexto de 262K: Qwen 3.6 Plus, el único modelo aquí con soporte de 1M de tokens de contexto, y el líder en Terminal-Bench 2.0 con un 61,6 % dentro de este grupo.
Puntos de referencia clave de un vistazo
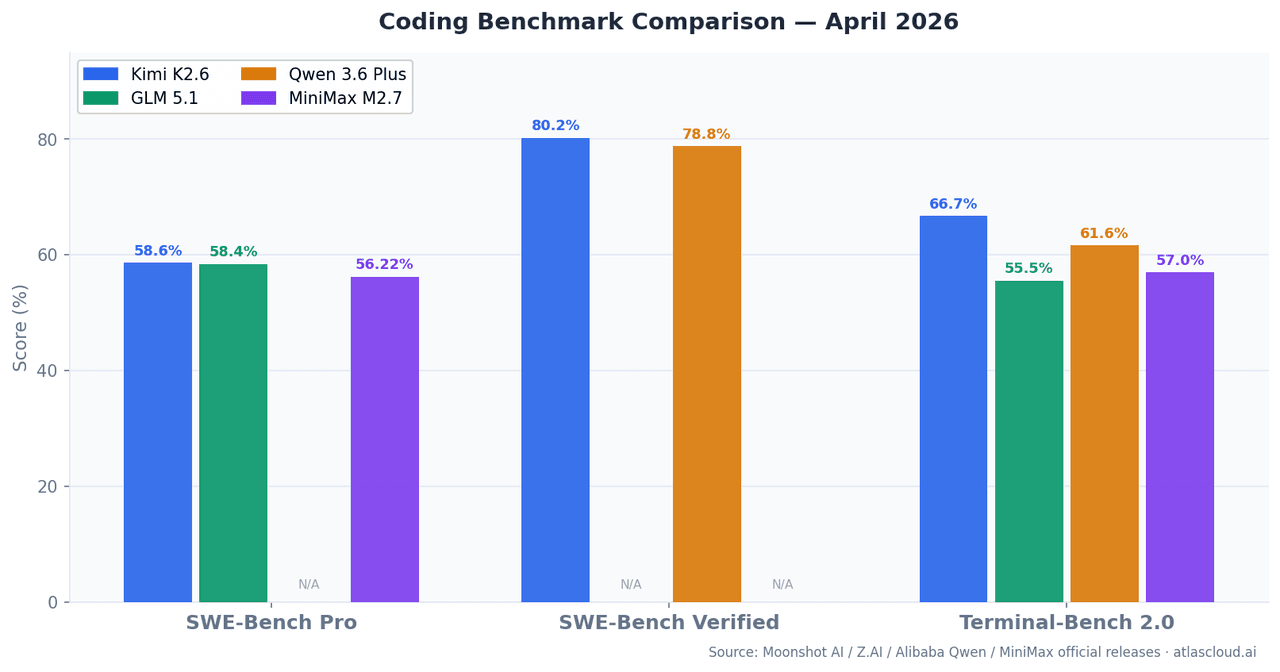
| Modelo | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Ventana de contexto | Parámetros activados |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60 % | 80,20 % | 66,70 % | 262K | — |
| GLM 5.1 | 58,40 % | — | 55 %+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80 % | 61,60 % | 1M | MoE híbrido |
| MiniMax M2.7 | 56,22 % | — | 57,00 % | 196K | 10B |
SWE-Bench Pro mide la capacidad de resolver problemas reales de GitHub presentados después del corte de entrenamiento, reduciendo el riesgo de contaminación de datos en comparación con SWE-Bench Verified. Terminal-Bench 2.0 prueba tareas de CLI y shell de varios pasos en entornos de terminal en vivo, más cerca de lo que realmente hacen los agentes de producción.
Este artículo compara Kimi K2.6, GLM 5.1, Qwen 3.6+ y MiniMax M2.7; para alinear aún más modelos lado a lado en precio y especificaciones, usa la comparación de modelos de Atlas Cloud.
Kimi K2.6: Diseñado para agentes de larga duración
Moonshot AI lanzó Kimi K2.6 en abril de 2026 como una actualización de K2.5, con la mejora principal en la estabilidad agéntica durante sesiones prolongadas. Con un 80,2 % en SWE-Bench Verified, se sitúa justo por debajo de Claude Opus 4.6 (80,8 %) y lidera los cuatro con un 58,6 % en SWE-Bench Pro.
El número que más importa es Terminal-Bench 2.0 con un 66,7 %. Terminal-Bench 2.0 difiere de SWE-Bench de manera fundamental: ejecuta tareas dentro de entornos de terminal reales, lo que requiere que el modelo lea la salida, maneje errores, se adapte e itere, no solo genere parches. Que Kimi K2.6 mantenga el rendimiento en más de 4000 llamadas a herramientas en una sola sesión de 13 horas no es un artefacto de laboratorio. Es un comportamiento documentado en el lanzamiento técnico de Moonshot.
Una ventaja poco reportada: generalización entre lenguajes. Kimi K2.6 muestra un rendimiento consistente en tareas de Rust, Go, Python, front-end y DevOps. La mayoría de las evaluaciones de referencia están cargadas de Python. Si tu pila de producción es políglota, esto importa.
Dónde no es la respuesta: A 0,95 USD/M tokens de entrada en Atlas Cloud, K2.6 es el modelo más costoso en el lado de entrada de este grupo. Para tareas de procesamiento por lotes donde envías muchas solicitudes con contextos grandes pero no necesitas estabilidad de sesión de 12 horas, el costo se acumula más rápido que MiniMax M2.7 o Qwen 3.6 Plus.
GLM 5.1: El destacado en front-end agéntico
Z.AI lanzó GLM-5.1 el 7 de abril de 2026. Con 754 mil millones de parámetros con enrutamiento MoE, es el modelo más grande aquí por recuento bruto de parámetros. En SWE-Bench Pro obtiene un 58,4 %, estadísticamente indistinguible del 58,6 % de Kimi K2.6.
El diferenciador es Code Arena Elo de 1530, verificado independientemente por Arena.ai el 10 de abril de 2026, colocándolo tercero a nivel mundial en su tabla de clasificación de desarrollo web agéntico. Esta es una comparación cara a cara en vivo donde los desarrolladores reales votan los resultados, no una puntuación automatizada. La ventaja se concentra en la generación de UI front-end, andamiaje full-stack, creación de componentes React/Vue y NL2Repo (generación de estructuras completas de repositorio a partir de lenguaje natural).
La condición límite que vale la pena conocer: La ventaja de front-end de GLM-5.1 es real. Para problemas algorítmicos puros en HumanEval y MBPP, no tiene una ventaja medible sobre Kimi K2.6. La brecha en la tabla de clasificación se reduce a casi cero en problemas que no son de UI o web. Elegir GLM-5.1 puramente basándose en su clasificación general de la tabla de clasificación sin verificar el dominio de la tarea sería un error.
Precio en Atlas Cloud: Desde 1,40 USD/M tokens de entrada, el más alto de los cuatro. Justificado cuando la calidad de la generación front-end impacta directamente en tu salida.
Qwen 3.6 Plus: Cuando el tamaño del contexto es la limitación real
Alibaba lanzó Qwen 3.6 Plus a finales de marzo de 2026. Lidera Terminal-Bench 2.0 en comparaciones directas contra Claude Opus 4.6 (61,6 % vs. 59,3 %) y obtiene un 78,8 % en SWE-Bench Verified.
La ventana de contexto de 1M de tokens es lo que lo diferencia. Para la mayoría de las tareas de programación de producción con menos de 100K tokens, los cuatro modelos en esta comparación tienen suficiente capacidad de contexto y la diferencia es irrelevante. Donde Qwen 3.6 Plus se convierte en la única opción viable: análisis de monorepositorio a través de cientos de archivos, refactorización de código heredado a gran escala, o flujos de trabajo de documento a código de extremo a extremo que no caben en 262K tokens.
La arquitectura híbrida (atención lineal + enrutamiento MoE disperso) también ofrece un mejor rendimiento de inferencia que los transformadores densos al procesar contextos muy grandes, lo que significa que la capacidad de 1M de token viene con un costo de latencia relativamente bajo en comparación con el escalado ingenuo.
Precio en Atlas Cloud: Desde 0,325 USD/M tokens de entrada. Para tareas de contexto grande, esta es la mejor relación costo por token útil disponible en este grupo.
MiniMax M2.7: El caso contraintuitivo de la eficiencia
MiniMax lanzó M2.7 en marzo de 2026. Con solo 10B parámetros activados, obtiene un 56,22 % en SWE-Bench Pro, el 94 % de la puntuación de GLM-5.1 aproximadamente a una quinta parte del costo por token.
Este es el resultado contraintuitivo en esta comparación. Un modelo que activa 10B parámetros en inferencia alcanza un rendimiento de programación casi de frontera porque su arquitectura MoE enruta a subredes de expertos especializadas en lugar de ejecutar los pesos completos del modelo. El resultado es una menor latencia, menor costo y una calidad de salida que supera lo que el recuento de parámetros por sí solo predeciría.
La categoría donde M2.7 supera a su precio: tareas de ingeniería de aprendizaje automático. Obtuvo una tasa de medalla del 66,6 % en MLE-Bench Lite (22 competiciones de aprendizaje automático), solo superado por modelos cerrados de frontera. Escribir lógica correcta de acumulación de gradientes, implementar capas personalizadas de PyTorch, depurar curvas de pérdida: M2.7 maneja estas con una precisión desproporcionada a su costo.
Dónde tener cuidado: Con 196K de contexto, M2.7 tiene la ventana más pequeña de este grupo. Las tareas que requieren un análisis profundo entre archivos en repositorios grandes pueden alcanzar límites que Qwen 3.6 Plus maneja sin problemas.
Precio en Atlas Cloud: 0,30 USD/M tokens de entrada, 1,20 USD/M tokens de salida: la opción más asequible para cargas de trabajo de programación de alto rendimiento.
Casos de prueba de programación del mundo real
Caso 1: Corrección autónoma de errores en un backend Python
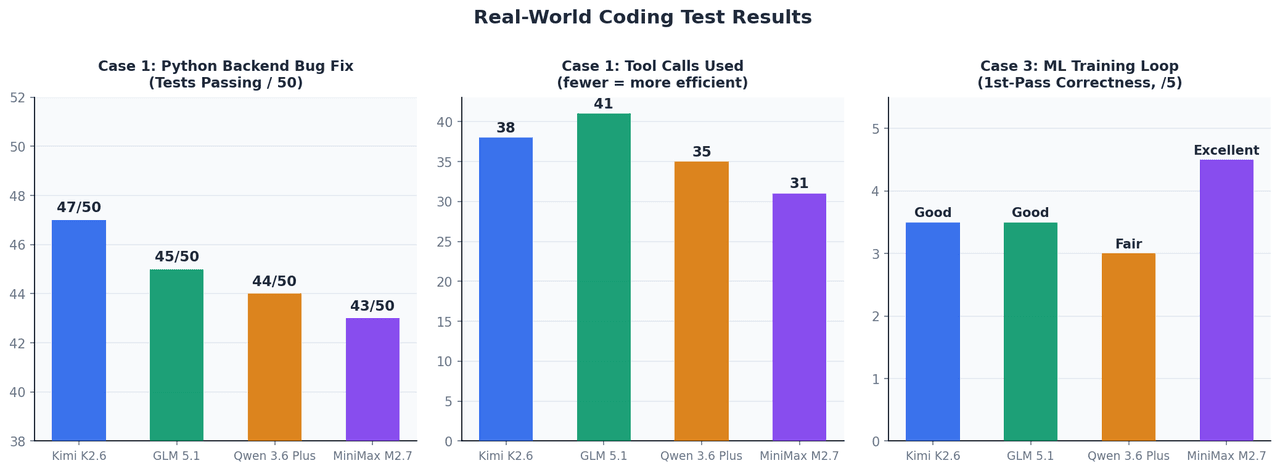
Configuración: Una aplicación FastAPI con 12 archivos, un conjunto de pruebas fallidas de 50 pruebas y una ventana de contexto de ~45K tokens. No se permite intervención manual después del mensaje inicial.
| Modelo | Pruebas que pasan después de la corrección | Llamadas a herramientas utilizadas | Tiempo hasta completar |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
En este tamaño de contexto, los cuatro se desempeñan dentro de una banda estrecha. Kimi K2.6 se adelantó en los errores de caso límite más difíciles, específicamente problemas de ciclo de vida del administrador de contexto asíncrono y estrechamiento de límites de TypeVar, que requieren mantener el estado de inferencia a través de múltiples ciclos de depuración.
Caso 2: Panel de React a partir de especificaciones
Configuración: Generar un panel receptivo completo con cuatro tipos de gráficos (líneas, barras, circular, dispersión), alternancia de modo oscuro y tipos TypeScript a partir de una especificación en inglés.
GLM-5.1 produjo componentes TypeScript tipados que funcionaban con clases de utilidad Tailwind correctas en el primer intento. Kimi K2.6 requirió una iteración para resolver errores de tipo. Qwen 3.6 Plus produjo JSX funcionalmente correcto pero menos idiomático. MiniMax M2.7 fue el más rápido pero generó algunos patrones React obsoletos que requirieron limpieza manual.
La brecha entre GLM-5.1 y los demás fue más visible en la arquitectura de componentes: GLM-5.1 aplicó espontáneamente patrones de composición y separó preocupaciones de una manera que los demás no hicieron.
Caso 3: Implementación de bucle de entrenamiento de ML
Configuración: Implementar un bucle de entrenamiento de PyTorch con acumulación de gradientes, precisión mixta AMP y parada anticipada para un transformer de visión. Objetivo: ejecutarse correctamente en el primer intento sin ciclos de depuración.
MiniMax M2.7 fue el destacado: colocó scaler.step() y scaler.update() correctamente en relación con el paso del optimizador, un detalle que la mayoría de los modelos colocan incorrectamente en la primera generación. El escalado de loss / accumulation_steps para la acumulación de gradientes también se manejó correctamente. Esto se alinea directamente con su tasa de medalla del 66,6 % en MLE-Bench Lite.
Atlas Cloud Comparación de precios (abril de 2026)
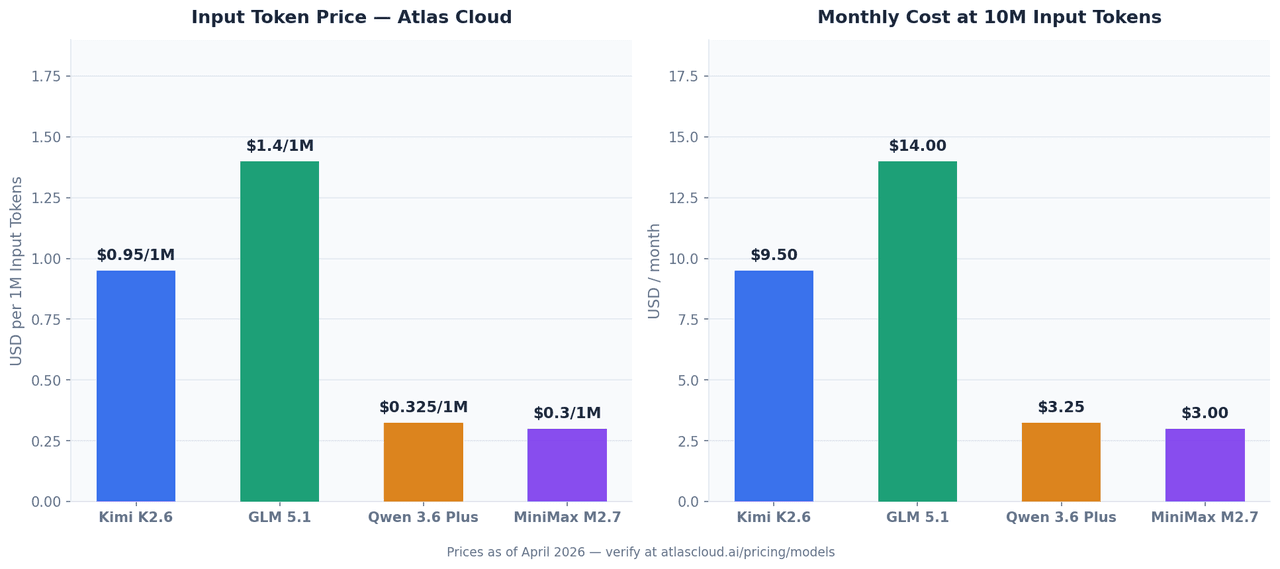
Los cuatro modelos están disponibles a través de la API unificada de Atlas Cloud. Los precios a continuación son a partir de abril de 2026 y pueden cambiar; confirma las tarifas actuales en atlascloud.ai.
| Modelo | Entrada (por 1M tokens) | Salida (por 1M tokens) | ID del modelo en Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | desde $1,40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | desde $0,325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
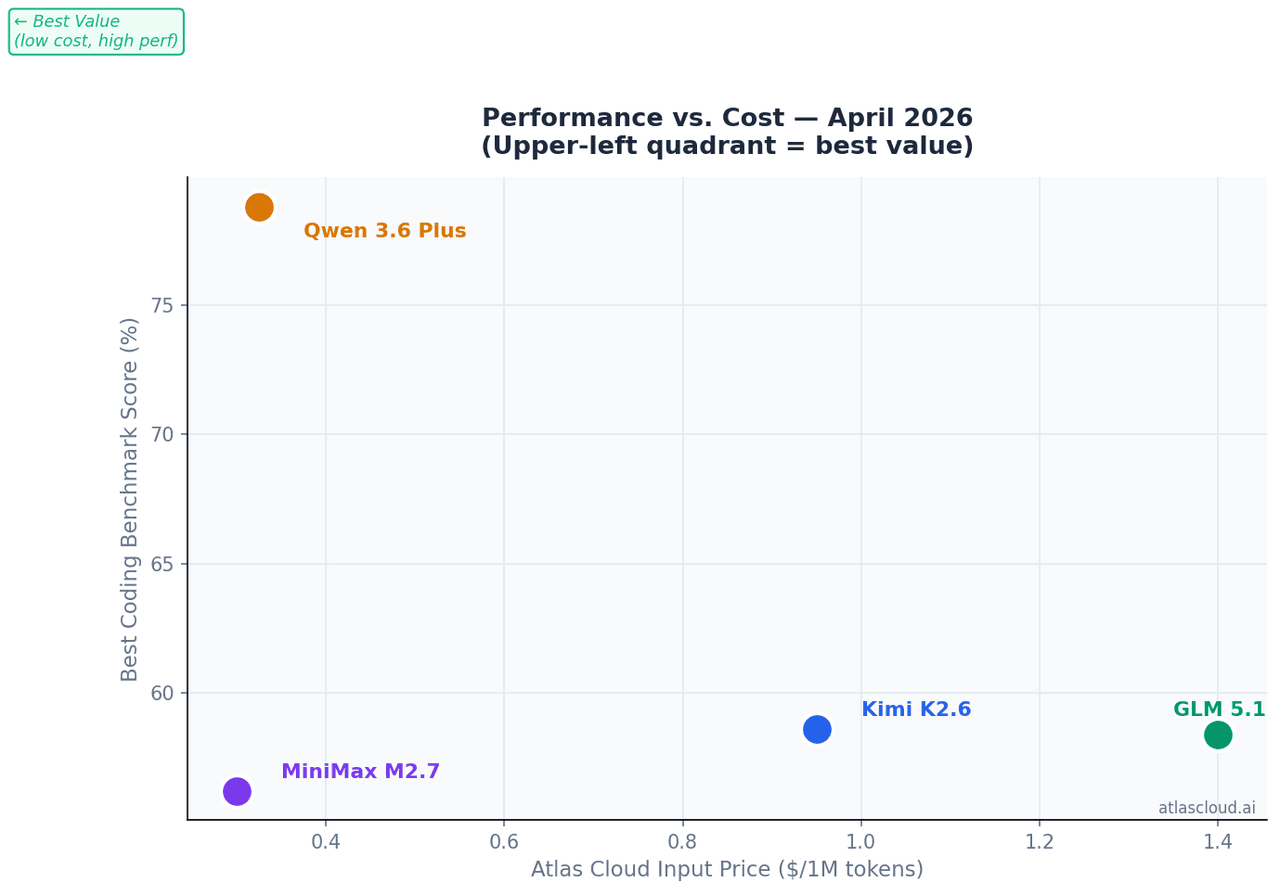
Con 10M de tokens de entrada por mes, un volumen realista para un asistente de programación de equipo:
| Modelo | Costo mensual de entrada (10M tokens) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Llamando a los cuatro con una sola clave de API
Los cuatro modelos comparten el mismo endpoint compatible con OpenAI en Atlas Cloud. Cambiar entre ellos requiere cambiar una línea:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Cambia esta única línea para cambiar de modelo 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Eres un ingeniero de software senior. Analiza el código cuidadosamente antes de responder." 21 }, 22 { 23 "role": "user", 24 "content": "Revisa esta función e identifica todos los errores:\n\n[paste your code here]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Esta estructura compatible con OpenAI significa que las integraciones existentes construidas sobre el SDK de OpenAI funcionan con Atlas Cloud sin modificaciones; solo cambian base_url y api_key.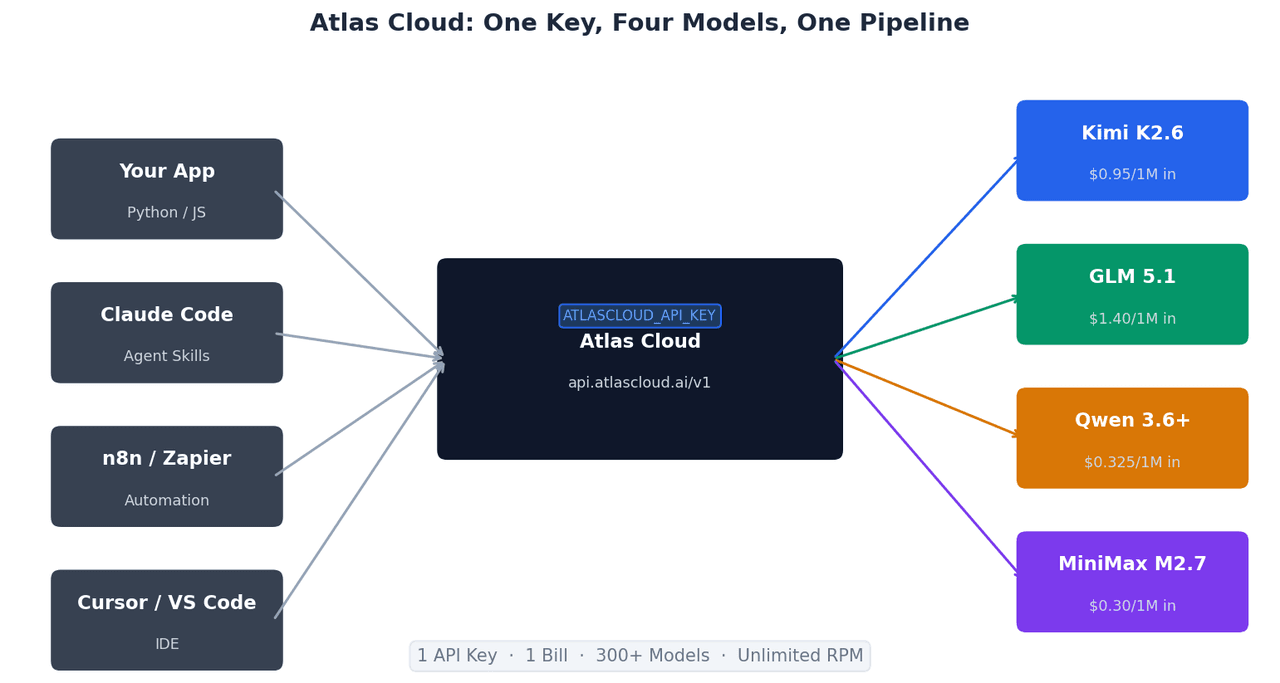
Por qué usar Atlas Cloud para estos modelos
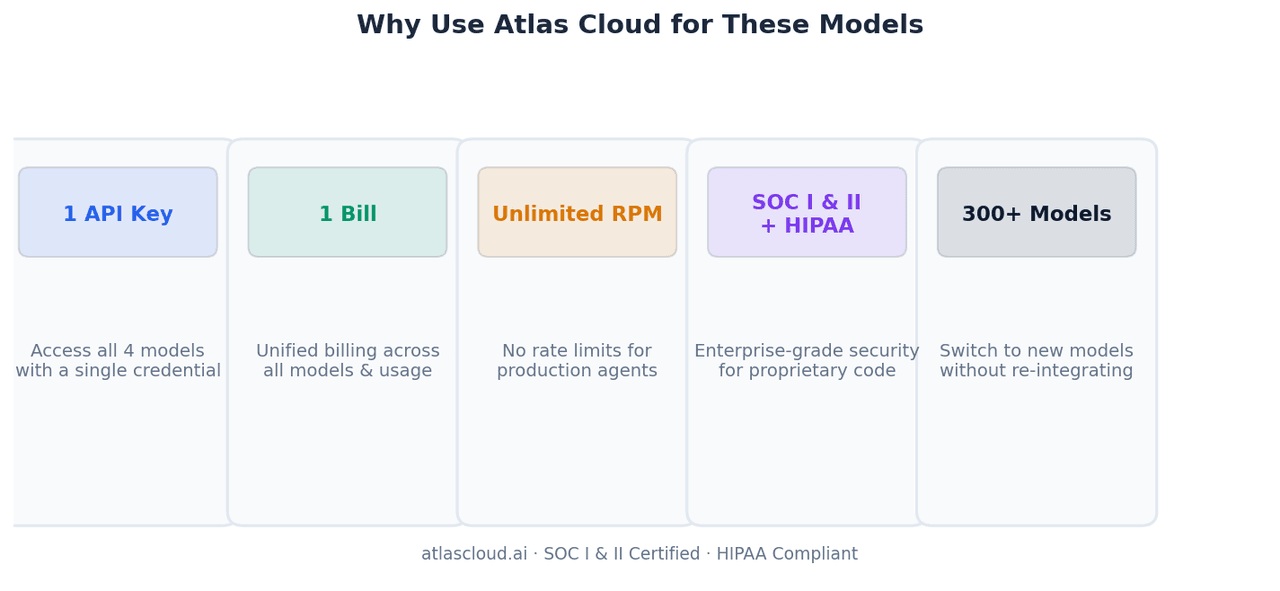
Una clave de API, cuatro modelos, una factura. Ejecutar lógica de enrutamiento de modelos (enviar tareas front-end a GLM-5.1, análisis por lotes a MiniMax M2.7 y agentes de largo alcance a Kimi K2.6) requiere administrar una credencial en lugar de cuatro. La conciliación mensual es una sola factura.
RPM ilimitado. Los agentes de programación de producción lanzan llamadas a herramientas en paralelo. Los límites de velocidad en las API de los proveedores directos pueden limitar los pipelines multiagente. Atlas Cloud elimina ese techo.
Certificado SOC I y II, compatible con HIPAA. Los equipos que procesan código fuente propietario a través de estos modelos necesitan infraestructura auditable. Las certificaciones de cumplimiento de Atlas Cloud significan que tu código no se enruta a través de endpoints no verificados.
Más de 300 modelos, mismo patrón de integración. Cuando se lance la próxima versión de cualquiera de estos modelos, o un nuevo modelo los supere en tu carga de trabajo específica, agregarlo a tu lógica de enrutamiento requiere un cambio de cadena, no una nueva integración de SDK.
Qué modelo para cada tarea
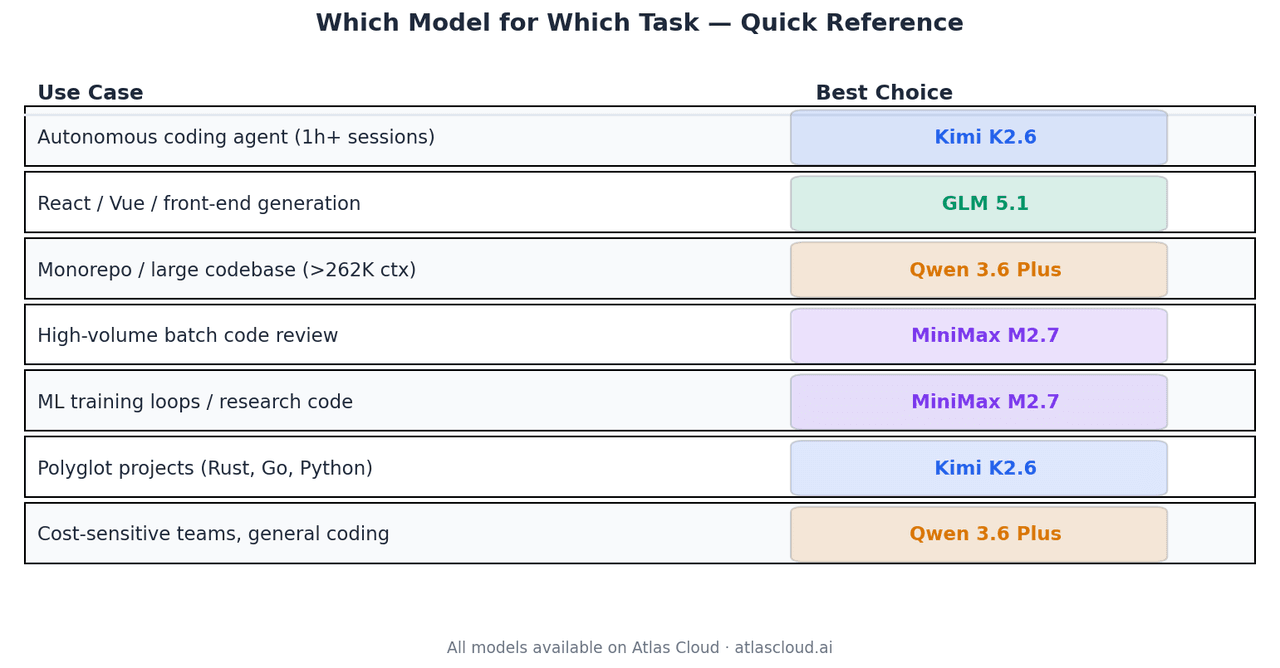
| Caso de uso | Mejor opción | Por qué |
| Agente de programación autónomo, sesiones de 1+ h | Kimi K2.6 | 66,7 % Terminal-Bench 2.0, estabilidad de 4K+ llamadas a herramientas |
| Generación front-end React / Vue | GLM 5.1 | Code Arena Elo 1530, top-3 en desarrollo web agéntico global |
| Análisis de monorepositorio o base de código grande | Qwen 3.6 Plus | Único modelo aquí con ventana de contexto de 1M |
| Revisión de código por lotes de alto volumen | MiniMax M2.7 | $0,30/M entrada, 94 % de la calidad de GLM-5.1 |
| Bucles de entrenamiento de ML, código de investigación | MiniMax M2.7 | 66,6 % tasa de medalla en MLE-Bench Lite |
| Proyectos políglotas (Rust, Go, Python) | Kimi K2.6 | Generalización entre lenguajes documentada |
| Equipos sensibles al costo, programación general | Qwen 3.6 Plus | $0,325/M entrada, fuerte en todas las categorías |
Resumen
Estos cuatro modelos están separados por márgenes estrechos en los puntos de referencia estándar. Las diferencias significativas surgen en condiciones específicas.
Kimi K2.6 es la respuesta correcta para agentes autónomos de larga duración. GLM 5.1 lidera en trabajo agéntico front-end. Qwen 3.6 Plus es la única opción cuando el contexto supera los 262K tokens. MiniMax M2.7 es el valor predeterminado rentable para equipos que ejecutan modelos de programación a escala.
Los cuatro están disponibles en Atlas Cloud en atlascloud.ai con una sola clave de API, precios por token y sin compromiso mínimo.
Los datos de referencia provienen del blog técnico de Moonshot AI, la documentación para desarrolladores de Z.AI, la publicación de lanzamiento del equipo Qwen de Alibaba, la página oficial del modelo MiniMax y las evaluaciones independientes de Arena.ai. Todos los puntos de referencia son datos de abril de 2026. Los precios de Atlas Cloud se indican a la fecha de publicación; verifica las tarifas actuales antes del despliegue en producción.


