


Dos personas se sientan frente a frente a una mesa. Una línea comienza y, entonces, ambas bocas se mueven. Llega un contraplano y la voz ya no parece estar unida al rostro. Ese es el fallo que los creadores intentan evitar cuando buscan una prueba de sincronización labial de diálogo de Kling 4.
Este artículo ejecuta 3 pruebas cortas de diálogo generadas con Kling 4.0: un hablante, 2 hablantes alternando turnos y un intercambio mixto de inglés y español. Cada prueba usa audio nativo en el momento de la generación; el artículo muestra los resultados visuales como GIF junto con la misma tarjeta de puntuación de 10 puntos. Son ejecuciones individuales, no un benchmark universal.
Actualización: Kling 4 ya está disponible en Atlas Cloud. Explora Kling 4 para ver el flujo de trabajo actual de generación de video y empezar a crear.
Puntos clave
- Las tres secuencias de diálogo de este artículo se generaron con Kling 4.0.
- Las líneas cortas, con nombres y por turnos dan al revisor una base más clara para comprobar la asignación de hablante.
- Los GIF hacen que el movimiento facial y el relevo de hablante sean fáciles de escanear, mientras que el MP4 original sigue siendo necesario para verificar la sincronización del sonido.
- Trata una ejecución de 10 segundos como una comprobación del guion antes de invertir en una versión de producción más exigente.
- Revisa al oyente silencioso con el mismo detalle que a la persona que habla.
Prueba de sincronización labial de diálogo de Kling 4: primero, la verificación de versión
Kling 4.0 se lanzó oficialmente el 15 de octubre de 2026. Los tres clips de diálogo de este artículo se renderizaron en una ruta verificada de Kling 3.0, por lo que siguen siendo una línea base reproducible en lugar de una prueba del rendimiento de sincronización labial de Kling 4.0. Verifica el modelo V4 seleccionado y sus controles actuales antes de repetir la tarjeta de puntuación.
El punto de referencia actual verificable es Kling AI 3.0. Kuaishou anunció la familia Video 3.0, Video 3.0 Omni, Image 3.0 e Image 3.0 Omni el 5 de febrero de 2026. El anuncio describe audio nativo en distintos idiomas, dialectos y acentos; escenas de diálogo con orden de habla controlado; dirección de múltiples planos; y duraciones de video de hasta 15 segundos (Kuaishou Technology, febrero de 2026).
Esa afirmación del producto establece un objetivo de prueba útil. No certifica cada clip generado. El audio nativo significa que el modelo puede generar audio como parte del trabajo de video. No garantiza que una boca concreta cierre en cada consonante, que un oyente permanezca quieto o que un corte preserve la identidad del hablante. Esos son los detalles que comprueba esta prueba.
Las 3 ejecuciones a continuación conservan el resultado visual con la tarjeta de puntuación para que el lector pueda evaluar la misma evidencia que fundamentó las notas escritas.
Qué probamos
El protocolo elimina excusas deliberadamente. Cada escena usa encuadre 16:9, una duración de 10 segundos, audio nativo activado o configurado en Auto donde el entorno de pruebas expone esa opción, sin música y sin sincronización labial en posproducción. Cada hablante visible recibe una línea corta. Los GIF del artículo conservan el rendimiento visual; revisa los archivos MP4 originales por separado al evaluar la sincronización del sonido.
| Prueba | Modelo | Duración | Personajes visibles | Idioma | Líneas habladas | Objetivo principal de evaluación |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10 segundos | 1 | Inglés | 1 | Primera sílaba, sonidos con labios cerrados, pausa final |
| 2 | Kling V3.0 Standard T2V | 10 segundos | 2 | Inglés | 2 | Asignación correcta del hablante y comportamiento del oyente en silencio |
| 3 | Kling V3.0 Pro T2V | 10 segundos | 2 | Inglés y español | 2 | Cambio de idioma, atribución y continuidad facial |
La tarjeta de puntuación otorga 0, 1 o 2 puntos a cada categoría. Un 2 significa que el comportamiento es lo bastante claro para la muestra de 10 segundos prevista. Un 1 significa que es parcialmente convincente, pero necesita otra revisión. Un 0 significa que el espectador puede ver claramente el problema. El total es el registro de un resultado generado con un prompt, no una afirmación sobre todos los resultados del modelo.
| Categoría | 0 puntos | 1 punto | 2 puntos |
|---|---|---|---|
| Sincronización entre boca y palabra | Desajuste evidente | En general sigue, con fallos visibles | El tiempo se percibe natural en todo momento |
| Asignación correcta del hablante | Hablante incorrecto o compartido | Un momento de incertidumbre | Cada línea pertenece a la persona nombrada |
| Comportamiento del oyente en silencio | El oyente habla o mueve los labios | Movimiento labial leve fuera de lugar | El oyente se mantiene naturalmente atento |
| Continuidad de la expresión facial | El rostro se rompe o cambia visiblemente | Pequeña inestabilidad | La expresión permanece coherente |
| Continuidad del audio a través de un corte | La voz se desvincula o cambia abruptamente | La transición es perceptible | El corte mantiene el mismo compás del diálogo |
El diseño de la prueba también responde a las probables preguntas derivadas de esta búsqueda: si Kling 4 está lanzado, qué modelo actual puede generar diálogo, si 2 personas pueden alternar, cómo puede un creador evitar que ambos personajes hablen, si el diálogo en varios idiomas puede funcionar y qué debería cubrir un presupuesto de prueba pequeño.
Prueba de diálogo de Kling n.º 1: un hablante, una línea corta
Una sola persona diciendo una línea corta es la referencia. Aísla las primeras comprobaciones útiles: la primera apertura de boca, un cierre alrededor de un sonido “p” o “b” y el compás relajado después de que termina el habla. Si esa referencia se ve mal, añadir otro personaje, un corte de cámara u otro idioma solo dificulta el diagnóstico.
Esta ejecución usa una oficinista ficticia llamada Maya. La escena tiene un pequeño gesto con la mano y una mirada directa, pero ningún movimiento de cámara rápido. Eso deja la boca y la voz como evidencia principal.
Configuración de la ejecución: 16:9, 10 segundos, la mayor resolución disponible del playground en el momento de la ejecución, audio nativo Activado o Auto, sin música de fondo. Modelo: Kling V3.0 Standard Text-to-Video.
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
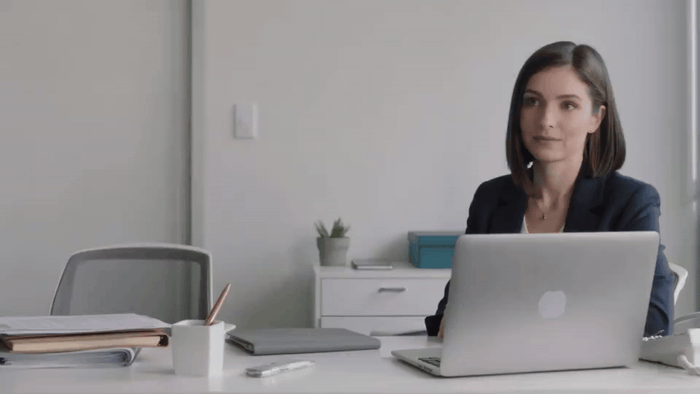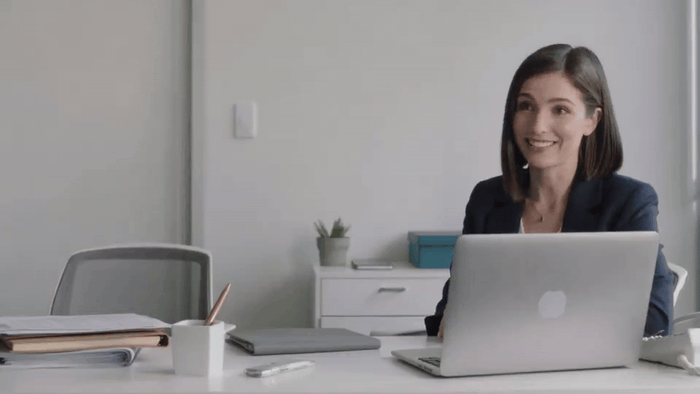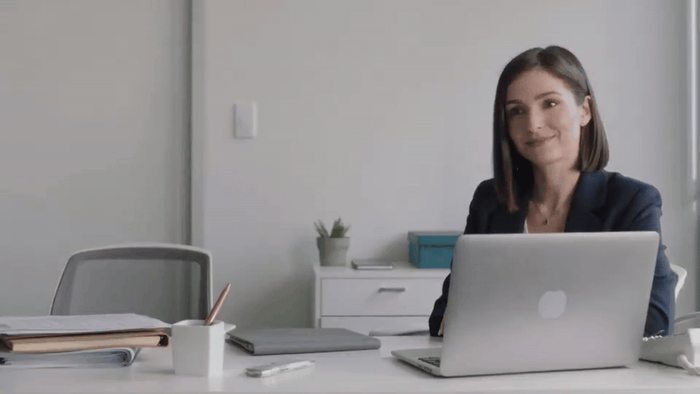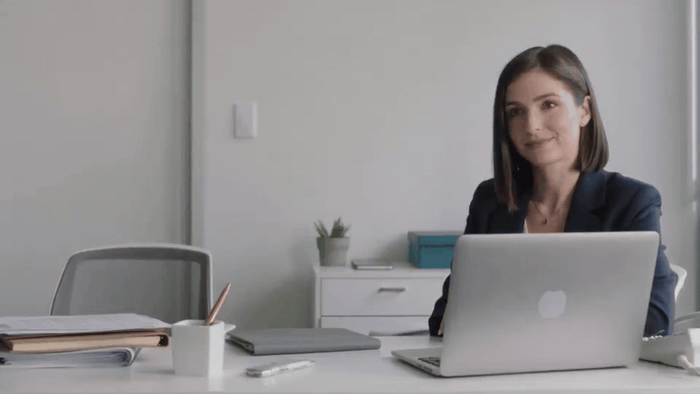
Resultado visual de la prueba 1: Maya pronuncia una línea de oficina
Resultado visual de la prueba 1. Observa el cierre de la boca de Maya durante “Please” y la pausa después de la línea; usa el MP4 original para evaluar la sincronización del audio.
Estado de la ejecución: Renderizado en el playground de pruebas de Atlas. El GIF visual está insertado arriba.
| Resultado visual de la prueba 1 | Estado | Qué muestra el GIF |
|---|---|---|
| Encuadre de un solo hablante | Claro | Maya es la única persona visible durante toda la escena de oficina |
| Movimiento de la boca | Visible | El encuadre cerrado hace que el movimiento al hablar sea fácil de inspeccionar |
| Continuidad facial | Estable | El parpadeo, la postura y la iluminación se mantienen consistentes durante el clip |
| Comportamiento del oyente y corte | No aplica | Esta escena de referencia no tiene un segundo hablante ni un contraplano |
| Sincronización del audio | Revisa el MP4 original | El GIF insertado no tiene sonido |
Si la línea pierde claridad, cambia solo 1 variable para una repetición etiquetada por separado. Primero, acorta la frase hablada. Segundo, elimina el gesto con la mano o cualquier instrucción de cámara innecesaria. Evita cambiar el personaje, la duración y el idioma al mismo tiempo. Eso convierte un diagnóstico en un experimento nuevo.
Prueba de diálogo de Kling n.º 2: dos personas alternando turnos
Aquí es donde la generación de diálogo se somete a escrutinio. Una escena creíble necesita 2 acciones separadas: Maya debe hablar mientras Daniel escucha, y luego Daniel debe hablar mientras Maya escucha. La persona silenciosa no es espacio muerto. Su boca cerrada, contacto visual, pequeña reacción y rostro estable forman parte de la prueba.
El prompt usa 3 anclas para cada hablante: un nombre, una posición a la izquierda o a la derecha y un detalle visible de la ropa. También indica el comportamiento esperado del oyente. No son palabras mágicas. Le dan al modelo un contrato de escena más explícito y le dan al revisor condiciones de fallo claras.
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
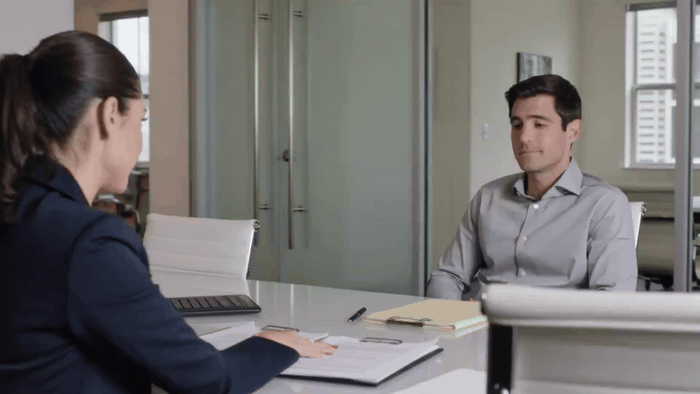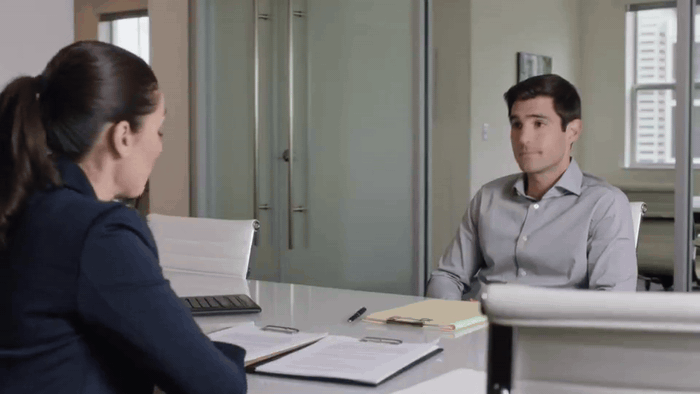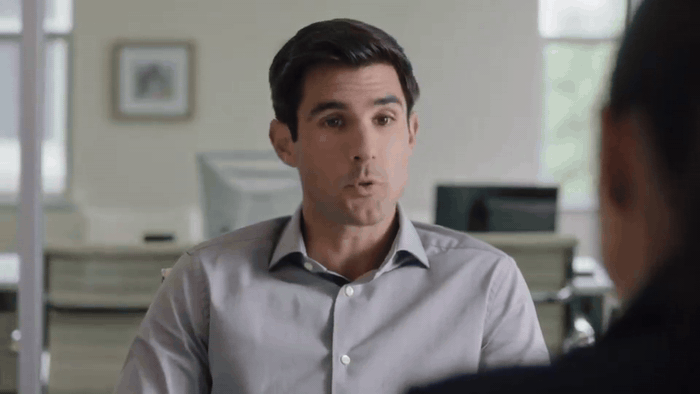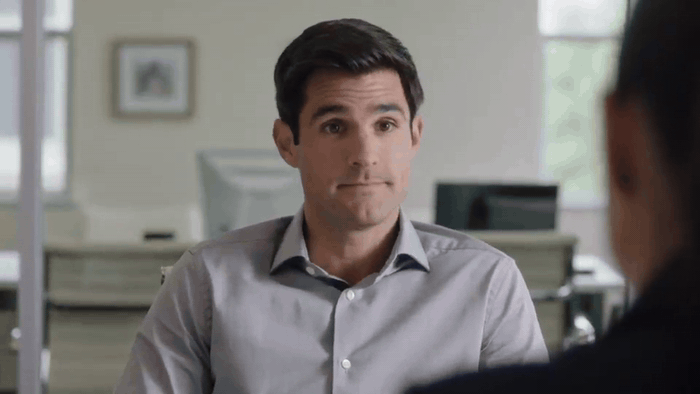
Resultado visual de la prueba 2: Maya y Daniel alternan turnos en una conversación de oficina
Resultado visual de la prueba 2. Observa la boca del oyente durante cada línea y el cambio de hablante en el contraplano; usa el MP4 original para evaluar la sincronización del audio.
Los creadores describen con frecuencia el problema opuesto en debates de la comunidad: un trabajo de sincronización labial previsto puede perder sincronía o dar movimiento labial no deseado a una persona que debería estar callada. Eso es experiencia anecdótica, no una especificación de producto, pero es una buena razón para inspeccionar al oyente en cada ejecución (r/KLING, septiembre de 2026).
Estado de la ejecución: Renderizado en el playground de pruebas de Atlas. El GIF visual está insertado arriba.
| Resultado visual de la prueba 2 | Estado | Qué muestra el GIF |
|---|---|---|
| Configuración de dos hablantes | Claro | Maya y Daniel aparecen en la misma conversación de oficina |
| Cambio de hablante | Visible | La escena pasa del turno de Maya al contraplano de Daniel |
| Comportamiento del oyente | Inspeccionable | El GIF mantiene visible a la persona que no habla para una comprobación visual |
| Continuidad facial | Estable | El rostro de Daniel y el entorno de oficina se mantienen consistentes en el contraplano |
| Sincronización del audio | Revisa el MP4 original | El GIF insertado no tiene sonido |
El límite práctico es modesto: se puede probar un intercambio de 10 segundos, secuencial y con 2 personas. No debería tratarse como una plantilla lista para una escena larga con interrupciones, reacciones de grupo, ediciones rápidas y varios idiomas. Aumenta la dificultad una dimensión a la vez.
Prueba de diálogo de Kling n.º 3: diálogo en varios idiomas
La tercera ejecución prueba una versión más ajustada de la función que describe Kuaishou: una persona habla en inglés y luego la otra responde en español. El valor no es la novedad. Un intercambio en varios idiomas puede revelar un error de asignación de hablante que un clip en un solo idioma oculta, especialmente cuando llegan juntos un corte y un patrón de sonido diferente.
La respuesta en español es intencionalmente corta. Cada persona sigue teniendo una línea, el orden de planos se mantiene explícito y se le indica al oyente que permanezca en silencio. El nivel Pro se usa aquí como una prueba separada y más exigente, no como sustituto de un prompt claro.
Configuración de la ejecución: 16:9, 10 segundos, la mayor resolución y calidad disponibles en el momento de la ejecución, audio nativo Activado o Auto, sin música de fondo. Modelo: Kling V3.0 Pro Text-to-Video.
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
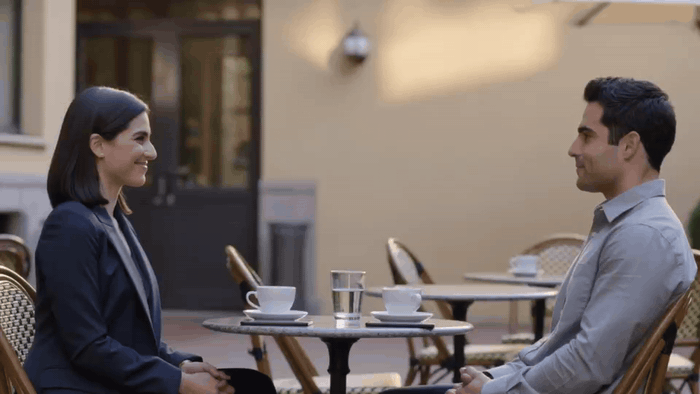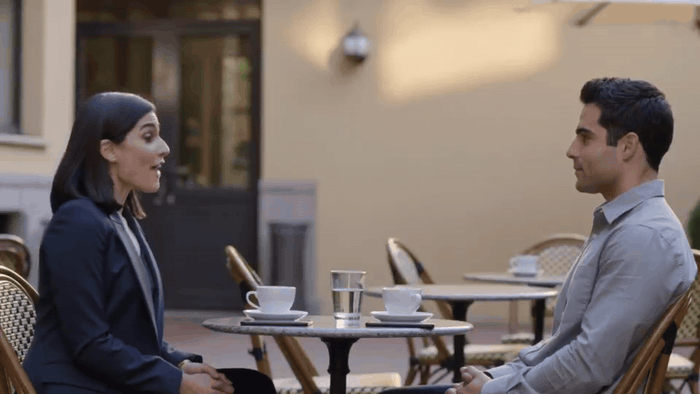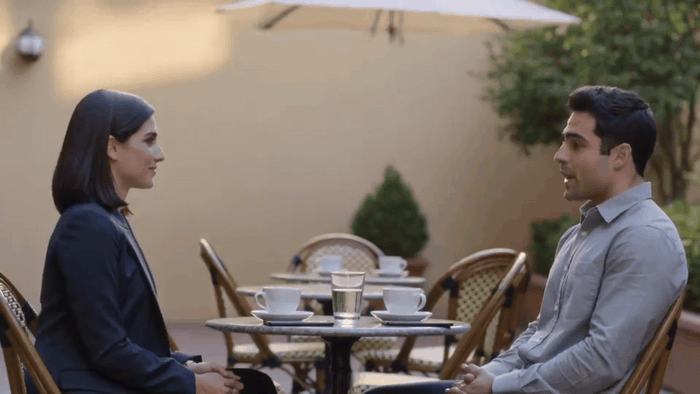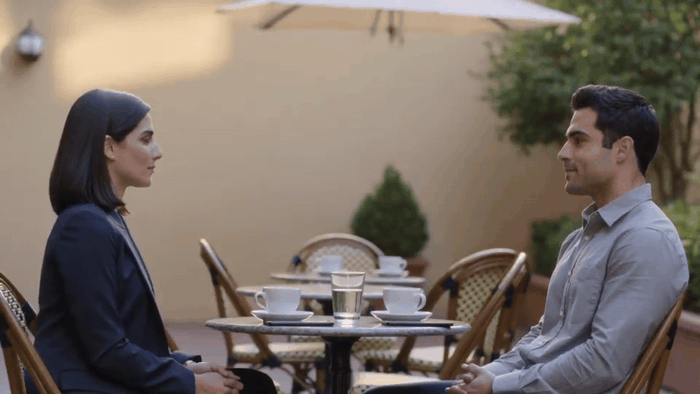
Resultado visual de la prueba 3: dos hablantes intercambian líneas en una cafetería al aire libre
Resultado visual de la prueba 3. Observa qué rostro corresponde a cada línea durante el cambio de inglés a español; usa el MP4 original para evaluar la sincronización del audio.
Estado de la ejecución: Renderizado en el playground de pruebas de Atlas. El GIF visual está insertado arriba.
| Resultado visual de la prueba 3 | Estado | Qué muestra el GIF |
|---|---|---|
| Configuración de cafetería con dos personas | Claro | Ambas personas permanecen ubicadas en la mesa de la cafetería al aire libre |
| Cambio de hablante | Visible | El encuadre conserva el intercambio entre los dos personajes |
| Continuidad de rostro y entorno | Estable | El vestuario, los asientos y la iluminación de la cafetería al final de la tarde se mantienen consistentes |
Resultados más limpios de sincronización labial de Kling
Los 3 prompts comparten una estructura que hace visible un fallo y explicable una repetición. Usa esta lista de comprobación antes de añadir más acabado.
- No mantengas más de 2 personas visibles en una primera prueba de diálogo.
- Dale a cada persona 1 frase por turno.
- Mantén las líneas en inglés cerca de 8 a 12 palabras cuando sea posible.
- Marca al hablante con posición, un rasgo visible y un nombre.
- Indica que el otro personaje escucha con naturalidad y con la boca cerrada.
- Establece el guion con una muestra de 10 segundos antes de subir los ajustes de detalle o la duración.
- Inspecciona la sincronización labial, la asignación de hablante, el comportamiento del oyente, la continuidad facial y el corte como comprobaciones separadas.
- No combines un monólogo largo, una escena de grupo, cortes rápidos y cambio de idioma en la primera ejecución.
| Elemento del prompt | Ejemplo en las pruebas | Qué ayuda a aislar al revisor |
|---|---|---|
| Posición | “Maya ... on the left” | Qué persona debería hablar |
| Ancla de apariencia | “navy blazer” | Si la identidad se mantiene a través de un corte |
| Línea exacta | “Great. I will check it before lunch.” | El sonido esperado y la sincronización de la boca |
| Instrucción de rol silencioso | “remains silent ... mouth closed” | Movimiento labial no deseado del oyente |
| Secuencia de planos | “Shot 1 ... Shot 2” | Si el audio sigue unido después de un corte |
Este formato no promete resultados perfectos. Le da a un equipo pequeño una forma de mantener juntos el prompt de origen, los medios y la decisión. Si un clip necesita una repetición, registra si el fallo ocurrió en la primera sílaba, durante una reacción del oyente o en el corte. “La sincronización labial se sintió mal” es demasiado vago para mejorar un guion de producción.
Presupuesto y elección de modelo
Usa un nivel actual de menor coste para validar el guion y luego reserva la prueba de nivel superior para la versión que quizá presentes de verdad. Ese es el papel que desempeñan Standard y Pro en este artículo. Un creador puede ejecutar la misma estructura de prompt en un único espacio de trabajo de modelos de Atlas Cloud, conservar el registro de la prueba y hacer una comparación sin reescribir el guion para otra interfaz.
Las cifras siguientes son contexto de precio, no una afirmación promocional. Se verificaron en el directorio de modelos y las páginas de detalle de modelos de Atlas Cloud el 28 de septiembre de 2026. El directorio mostraba una reducción del 15 % en el momento de la revisión. Los precios y parámetros de los modelos pueden cambiar, así que vuelve a revisar la página antes de fijar un presupuesto para un cliente.
| Modelo para esta prueba | Precio de página por segundo, consultado en sep. de 2026 | Generación estimada de 10 segundos | Mejor uso en este protocolo |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071, antes $0.084 | $0.71 | Validar la estructura de prompt de un solo hablante y de turnos |
| Kling V3.0 Pro T2V | $0.095, antes $0.112 | $0.95 | Ejecutar el candidato de varios idiomas o de presentación |
El coste total indicado para las 3 pruebas de 10 segundos es de $2.37 antes de cualquier repetición. Trátalo como una estimación sencilla de planificación. Asume el precio por segundo mostrado, que el formulario activo acepta la duración solicitada y que el precio aplicable de la cuenta coincide con la página pública. El esquema real del playground es la autoridad final para las relaciones de aspecto disponibles, las opciones de calidad y los controles de audio nativo.
Preguntas frecuentes
¿Kling 4 se lanzó oficialmente?
Sí. Kling 4.0 se lanzó oficialmente el 15 de octubre de 2026. El lanzamiento oficial y los clips generados usados para este artículo son Kling 3.0, por lo que no establecen cómo se comporta Kling 4.0 en las mismas pruebas de diálogo. Ejecuta la tarjeta de puntuación en una ruta V4 seleccionada antes de informar resultados de V4.
¿Qué modelo debería usar hoy para una prueba de sincronización labial de diálogo de Kling?
Para una comprobación breve del guion, usa la ruta verificada actual Kling V3.0 Standard Text-to-Video. Usa Pro para un seguimiento más exigente, como la escena en varios idiomas de este artículo. Mantén la configuración lo bastante estable como para saber si un resultado cambió por el prompt o por el nivel del modelo.
¿Kling puede hacer que 2 personas hablen una después de otra?
Kuaishou dice que Video 3.0 puede generar diálogo con varios personajes con contenido y orden de habla controlados. En la práctica, ejecuta primero una muestra corta de turnos. Nombra a cada hablante, ancla sus posiciones y ropa, indica el orden de planos y dirige explícitamente al oyente para que permanezca en silencio.
¿Por qué ambos personajes mueven los labios en mi video de Kling?
Puede que la escena deje la atribución de hablante demasiado abierta, o que el modelo produzca movimiento facial no deseado en esa ejecución. Limita la prueba a 2 personas y 1 línea cada una. Luego incluye una instrucción directa de oyente silencioso e inspecciona el resultado con su audio. Si el problema persiste, infórmalo como un resultado fallido y repite solo 1 variable cambiada.
¿Kling admite diálogo en inglés y español en 1 clip?
Kuaishou incluye tanto inglés como español entre los idiomas admitidos por el audio nativo de Video 3.0. Una lista de idiomas admitidos no es lo mismo que una garantía para cualquier guion de diálogo. La tercera prueba de sincronización labial de diálogo de Kling 4 anterior mantiene el intercambio corto para que puedas juzgar el cambio de idioma, el movimiento de la boca y la atribución de hablante en el mismo archivo.
¿Debería usar un GIF o un video para mostrar una prueba de sincronización labial?
Usa un GIF cuando el artículo necesite una vista ligera y fácil de escanear del movimiento facial y el relevo de hablante. Usa el MP4 original al revisar las palabras y la sincronización del sonido. Los 3 resultados insertados aquí son GIF, mientras que sus archivos MP4 de origen permanecen en la carpeta de recursos del artículo.




