

Una prueba de memoria útil se parece menos a preguntar: «¿Qué recuerdas sobre mí?» y más a una comprobación a libro cerrado con una corrección y algunas distracciones. Para ejecutar una prueba de Active Memory de Muse Wonder, da a Muse Wonder detalles ficticios en una conversación, corrige uno de ellos y luego pide los hechos actuales relevantes en una conversación nueva. Registra qué recupera, en qué se equivoca y si admite incertidumbre.
La secuencia siguiente tarda unos 10 minutos en configurarse y puntuarse. No es prueba de memoria entre días, cuentas ni todas las superficies de productos de Muse. Es una primera comprobación repetible. Usa detalles inventados en lugar de información privada.
Ideas clave
- Prueba por separado la recuperación, las correcciones, la resistencia a los distractores, la incertidumbre y la trazabilidad.
- Ejecuta la prueba en la superficie del producto que piensas usar, con su configuración de memoria documentada.
- Una solicitud de API nueva solo prueba memoria persistente si la aplicación o el servicio la proporciona.
- MemoryBench de Meta es una evaluación interna mucho más larga; esta comprobación breve no la reproduce.
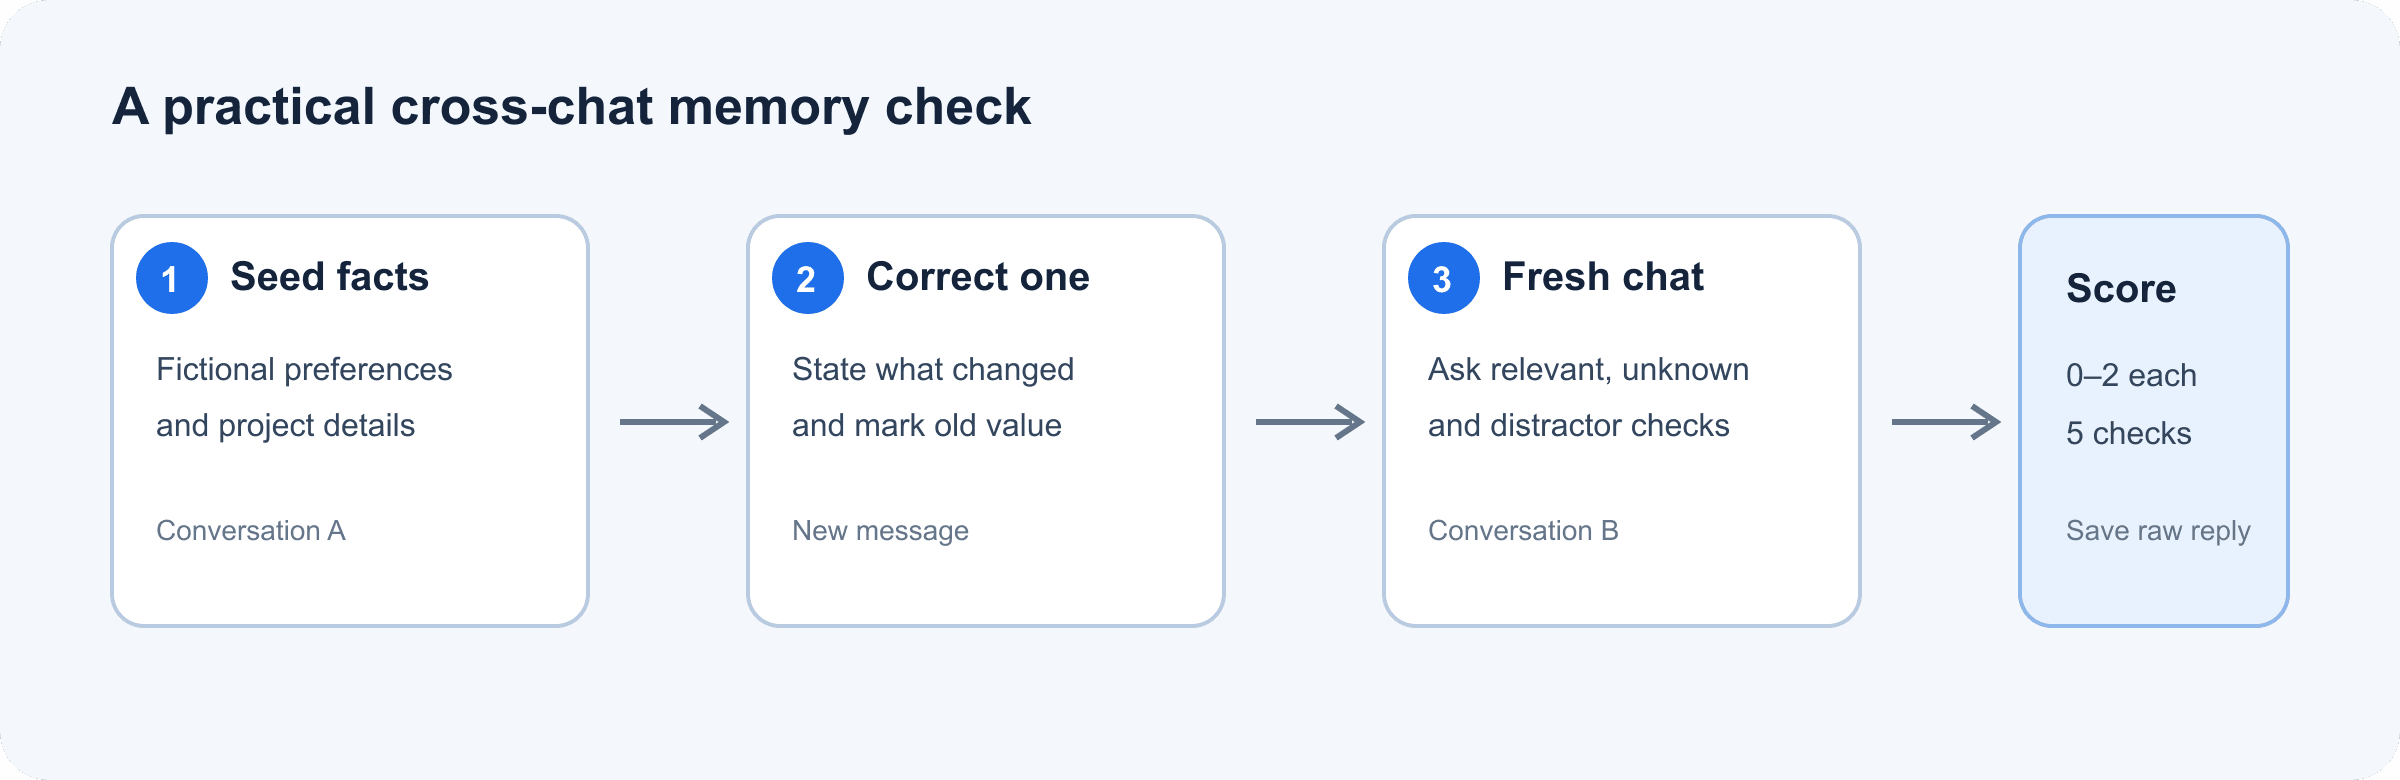
Flujo de la prueba de Active Memory de Muse Wonder desde detalles ficticios hasta corrección, recuperación en chat nuevo y puntuación
El flujo de la prueba separa los hechos iniciales, una corrección explícita y la recuperación en una conversación nueva.
Qué se supone que debe hacer Active Memory de Muse Wonder
Meta describe Active Memory como la capacidad de llevar contexto importante sobre una persona a través de conversaciones y recuperar detalles cuando importan para una tarea posterior. Active Focus se refiere al trabajo continuado hacia un objetivo, incluido probar alternativas cuando se está bloqueado y adaptarse a nueva información. Esas ideas están relacionadas, pero responden a preguntas distintas: la memoria se ocupa de qué contexto se recuerda; el enfoque se ocupa de cómo avanza el trabajo.
Esa descripción es una afirmación sobre la capacidad de un producto, no una garantía de que todas las interfaces o llamadas a la API compartan automáticamente el historial de un usuario. Meta dice que Muse Wonder está disponible a través de su Model API y Muse Code. Su documentación para desarrolladores indica una ventana de contexto de 1.048.576 tokens y ajustes de razonamiento compatibles, pero una ventana de contexto es la cantidad de contexto que puede contener una solicitud, no una prueba de que las solicitudes anteriores persistan. Comprueba qué historial o memoria proporciona realmente el producto que elijas.
Cómo ejecutar una prueba de memoria de Muse Wonder
Usa una sola cuenta y la misma variante del modelo durante toda una ejecución. En un producto de chat, activa la función de memoria que quieres evaluar y registra su configuración. En una integración de API, anota si tu propia aplicación incluye turnos anteriores, un perfil almacenado o notas recuperadas en la solicitud. Sin esa información, no puedes atribuir el recuerdo solo al modelo.
1. Dale hechos relevantes
En la primera conversación, pega este perfil ficticio. Pide solo un acuse de recibo, para que el modelo no convierta inmediatamente los hechos en un plan.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Abre una conversación realmente nueva en el mismo producto y luego pregunta:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Una buena respuesta usa la preferencia por actividades tranquilas al aire libre. No necesita mencionar el presupuesto ni el marisco, porque ninguno de esos detalles hace falta para sugerir una actividad. Vigila las preferencias inventadas. Si el producto no puede acceder a chats anteriores o la memoria está desactivada, registra “memoria no disponible en esta superficie” en lugar de puntuar al modelo como si hubiera recibido los hechos.
2. Corrige un hecho obsoleto
En otro hilo de prueba, introduce una cita y luego reemplázala explícitamente. Mantén la corrección en un mensaje aparte para que puedas saber si prevalece la actualización posterior.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Pregunta por ella en una conversación nueva:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Aprueba si da jueves a las 10 a. m. y trata el martes como obsoleto. Una respuesta mezclada o el uso seguro del martes es un fallo significativo, aunque haya recordado perfectamente el detalle original.
3. Añade distractores y prueba lo que es desconocido
Añade dos o tres hechos ficticios inofensivos a la conversación inicial, como un color de proyecto inventado o un número de paquete ficticio. Tras un retraso, inicia una conversación nueva y haz una pregunta sobre una preferencia relevante y otra sobre un hecho que nunca proporcionaste. Mantén las preguntas separadas para que cada respuesta sea fácil de puntuar.
Un resultado sólido usa la preferencia relevante, deja fuera los detalles no relacionados y dice que no sabe el hecho faltante. Para una prueba de retraso más estricta, repite el mismo mensaje al día siguiente. Diez minutos pueden comprobar un límite de chat nuevo, pero no pueden establecer retención de una semana.
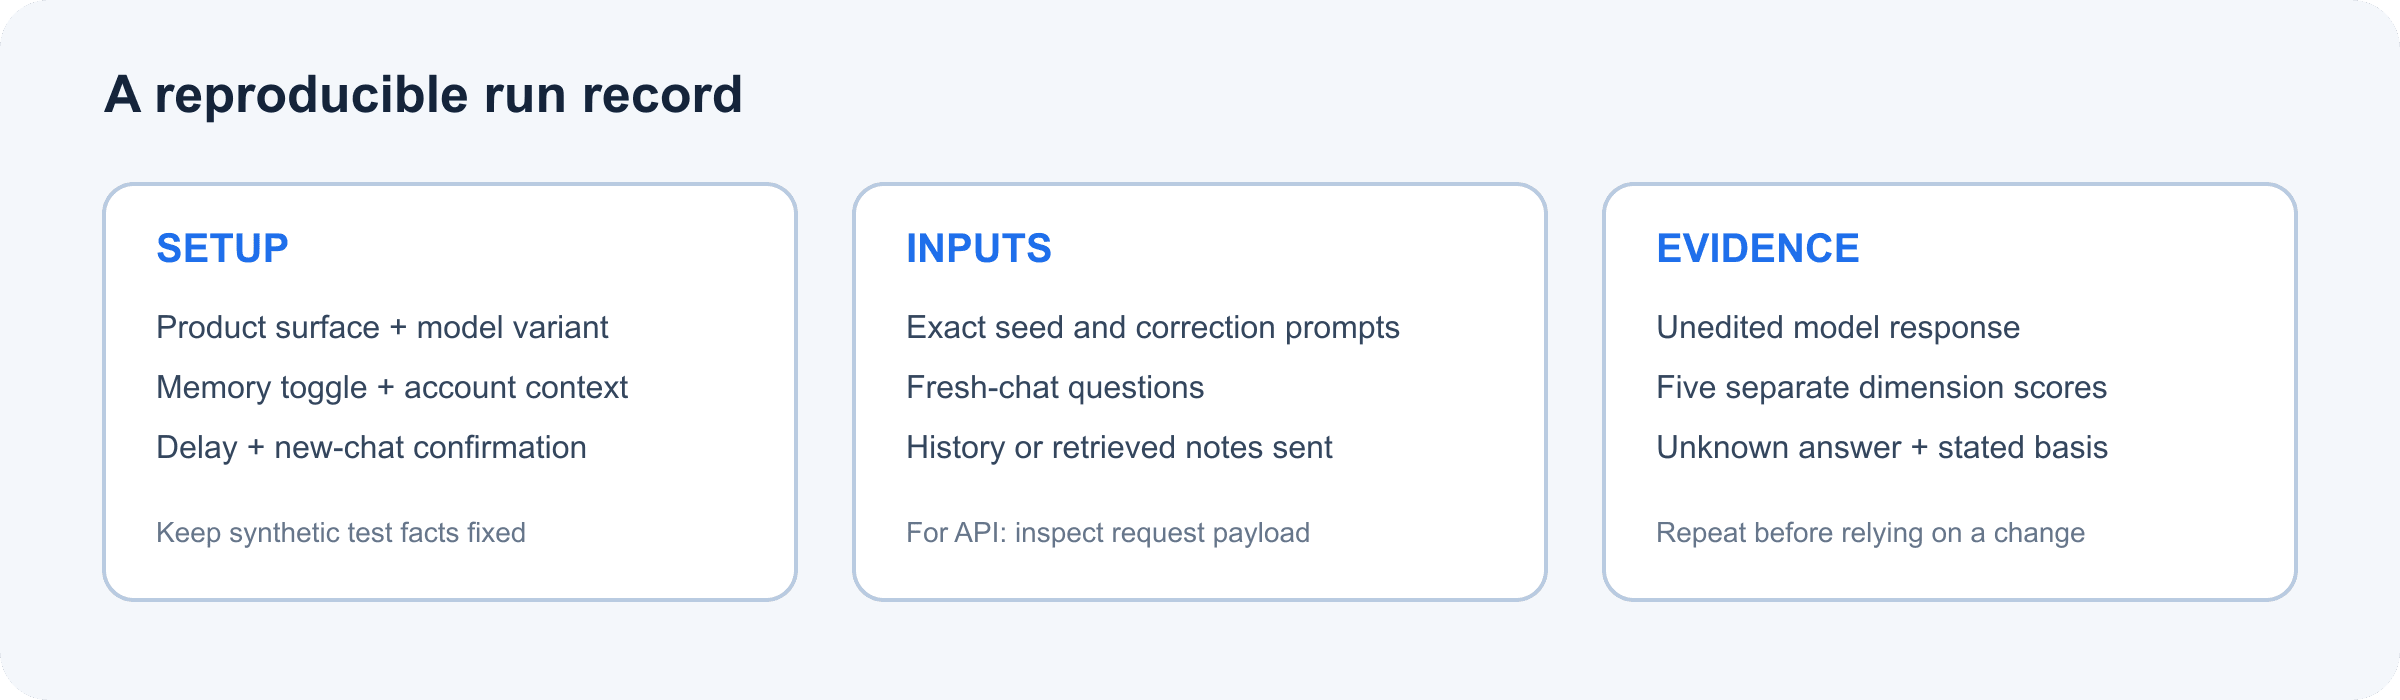
Tarjeta de prueba de Active Memory de Muse Wonder que muestra la configuración, las preguntas en un chat nuevo y la evidencia que se debe registrar
Guarda el mensaje, la superficie del producto, la configuración de memoria, el retraso y la respuesta sin editar juntos para que otro revisor pueda reproducir la comprobación.
Cómo puntuar la prueba de Active Memory
Puntúa cada comportamiento de 0 a 2. Usa el resultado para comparar ejecuciones en tu propio flujo de trabajo, no para clasificar modelos de forma universal.
| Dimensión | 0 puntos | 1 punto | 2 puntos |
|---|---|---|---|
| Recuperación de hechos relevantes | Omite o inventa el hecho necesario | Parcialmente correcto | Selecciona el hecho correcto con precisión |
| Manejo de correcciones | Usa el valor antiguo | Es vago o mezcla ambos | Usa el valor más reciente e identifica el antiguo como obsoleto |
| Control de distractores | Se deja atraer por hechos irrelevantes | Incluye algún detalle irrelevante | Usa solo el contexto relevante para la pregunta |
| Incertidumbre | Adivina con confianza | Matiza, pero igualmente adivina | Dice claramente que la respuesta no se proporcionó |
| Trazabilidad | No da ninguna base | Nombra solo parte de su base | Enumera brevemente el contexto en el que se basó |
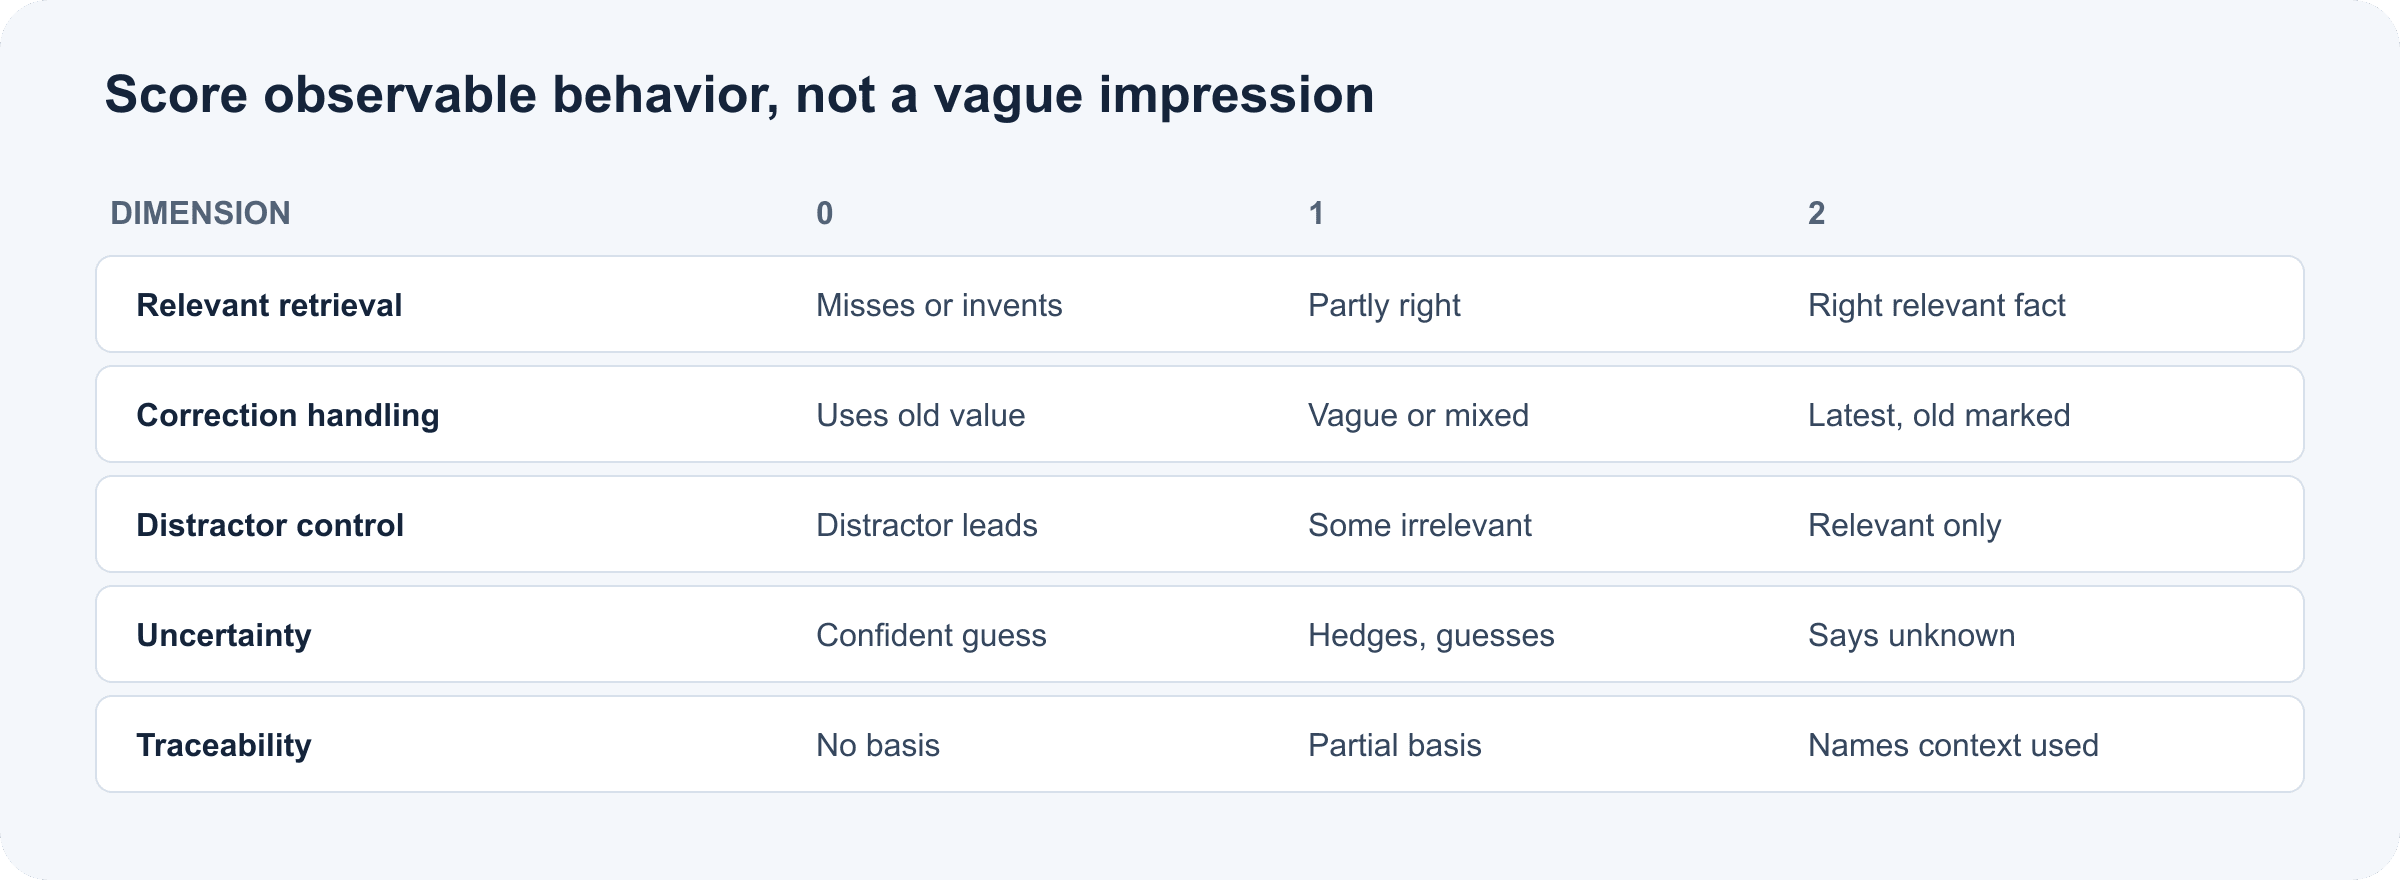
Cinco dimensiones de puntuación de Active Memory de cero a dos puntos, con criterios de aprobación observables
La rúbrica de 0 a 2 convierte una impresión subjetiva en cinco comprobaciones observables.
Diez puntos es una puntuación interna conveniente, no un umbral validado. Conserva las puntuaciones de cada dimensión: un total puede ocultar un fallo grave de corrección detrás de un buen recuerdo en otro aspecto. Guarda los mensajes exactos y las salidas sin editar, y luego repite la ejecución antes de cambiar tu decisión de despliegue.
Qué puede y qué no puede decirte MemoryBench
La tarjeta de modelo de Meta describe MemoryBench como una evaluación interna sobre conversaciones largas y complejas de 64K a 100K tokens. Sus tareas incluyen múltiples hechos, conversaciones con distractores y turnos inyectados que entran en conflicto con detalles objetivo o los actualizan después; un juez LLM puntúa las respuestas según criterios ponderados específicos de cada pregunta. Ese es un contexto útil para entender el alcance del benchmark, pero no es lo mismo que la configuración de memoria personal de un usuario funcionando entre chats.
La tarjeta de modelo explica el diseño de la tarea; no convierte este ejercicio de 10 minutos en una réplica. La puntuación publicada por Meta es evidencia sobre la configuración de evaluación reportada. Tu ejecución responde a una pregunta operativa más concreta: ¿esta superficie de producto, configuración y cuenta en particular recuperan los hechos que tu flujo de trabajo necesita? Ninguna de las dos por sí sola establece una memoria fiable para todos los usuarios o tareas.
Muse Wonder vs. Muse Wonder Full: dónde probar
Las dos variantes no tienen rutas de acceso idénticas. La documentación actual para desarrolladores de Meta dice que Muse Wonder (muse-wonder-1.0) está disponible en Model API y en Muse Code. Muse Wonder Full solo está disponible en Muse Code en los planes Power Usage y Maximum Usage. Ajustar el esfuerzo de razonamiento de Muse Wonder a “max” no lo cambia a Wonder Full.
| Variante | Acceso documentado | Qué registrar |
|---|---|---|
| Muse Wonder | Model API y Muse Code | ID de modelo de API o superficie de Muse Code, además de si se proporciona contexto anterior |
| Muse Wonder Full | Muse Code en los planes Power Usage y Maximum Usage | Plan, variante seleccionada y configuración de memoria disponible en esa superficie |
Ejecuta el mismo perfil ficticio por separado en cada superficie disponible. No compares una prueba de Muse Code que puede recuperar detalles guardados del perfil con una llamada a la API sin estado que solo recibió el mensaje actual. Eso compararía sistemas diferentes, no solo dos variantes de modelo.
Privacidad y pruebas repetibles
Usa preferencias, fechas y detalles de proyecto inventados. Antes de probar con datos reales, revisa los controles de memoria del producto, la ruta de eliminación, la información de retención y la configuración de uso de datos. La documentación de la API de Meta dice que el contenido en modo Standard no se usa para entrenar modelos de Meta; Muse Code también ofrece el modo Contributor, que está activado de forma predeterminada y puede usar contenido para entrenamiento a menos que se desactive. Comprueba la configuración y los términos actuales del producto que uses en lugar de asumir que todas las superficies tratan los datos igual.
En una API, separa el modelo de la capa de memoria de tu aplicación. Una base de datos, un sistema de recuperación o un historial de mensajes que envíe tu software puede ser lo que recuerda. Registra qué recuperó la aplicación y qué pasó a cada solicitud, manteniendo los registros de prueba sintéticos.
Los equipos pueden convertir las tres rondas en un pequeño conjunto de evaluación versionado. Mantén fijos el perfil de hechos, la corrección, los distractores, la variante del modelo, la configuración del producto, el retraso y la respuesta sin editar. Vuelve a ejecutar tras cambios de configuración o de modelo y revisa los fallos por dimensión. Para los equipos que ya comparan modelos alojados en un entorno repetible, Atlas Cloud ofrece un catálogo y una guía unificada de API de LLM. Puedes explorar su directorio de modelos para una comparación aparte. El directorio actualmente no incluye Muse Wonder, y usar otro modelo allí solo probaría el contexto proporcionado explícitamente a ese modelo, a menos que tu aplicación añada una capa de memoria.
Preguntas frecuentes
¿Cómo pruebo Active Memory de Muse Wonder entre chats?
Proporciona hechos ficticios en una conversación y luego pregunta por detalles relevantes en una conversación nueva. Incluye una corrección y un hecho faltante, y registra la superficie del producto y la configuración de memoria.
¿Muse Wonder recuerda correcciones o solo detalles anteriores?
La descripción de MemoryBench de Meta incluye turnos que actualizan o entran en conflicto con detalles anteriores. Tu propia prueba de corrección comprueba si la configuración actual del producto sigue la actualización; repítela porque un solo resultado no establece un comportamiento consistente.
¿Esta prueba de historial de chat es lo mismo que MemoryBench de Meta?
No. Meta describe MemoryBench como un benchmark interno de contexto largo que usa conversaciones de 64K a 100K tokens, distractores, hechos en conflicto o actualizados y un juez LLM. Esta comprobación breve es una prueba de humo práctica, no una réplica.
¿Puedo probar Active Memory de Muse Wonder a través de la API?
Puedes probar el recuerdo del modelo de API del contexto que llega a la solicitud. Para la persistencia entre solicitudes, verifica qué almacena y envía la API o tu aplicación. La disponibilidad de una ventana de contexto grande no demuestra por sí sola que solicitudes separadas compartan memoria.
¿Cómo distingo la memoria del modelo de la memoria almacenada por la aplicación?
Inspecciona la solicitud completa enviada al modelo. Si tu aplicación inserta un perfil, una nota recuperada o una conversación anterior, esa capa de software proporcionó la memoria. Compárala con una ejecución controlada que lo omita, cuando corresponda.
¿Es seguro usar información personal en una prueba de Active Memory?
Usa información ficticia para la prueba. Si luego evalúas datos reales, revisa primero la configuración de memoria, eliminación, retención y uso de datos del producto específico.
Una prueba de Active Memory de Muse Wonder es más útil cuando expone qué paso falló: el acceso al contexto anterior, la recuperación, la corrección, el filtrado o la incertidumbre. Guarda la ejecución sin procesar y luego repítela con la configuración exacta en la que piensas confiar.
Fuentes: Anuncio de Muse Wonder de Meta (12 de octubre de 2026); Documentación de modelos de Model API de Meta (consultado el 15 de octubre de 2026); Model Card de Muse Wonder (octubre de 2026).





