

Un resultado líder en un benchmark puede parecer decisivo hasta que el mismo modelo omite un requisito en la siguiente ejecución. Una prueba de fiabilidad de Muse Wonder útil plantea una pregunta más acotada: ¿el modelo completa tu tarea, según tu estándar, de forma repetida y en las mismas condiciones?
La evidencia inicial es mixta porque las pruebas miden cosas distintas. Un conjunto de tareas del día de lanzamiento dio a Muse Wonder estándar una puntuación muy alta tras una ejecución por tarea. Otra evaluación encontró fortalezas en el análisis de investigación junto con debilidades en el diseño de encuestas, las afirmaciones de ventas y el diseño de diapositivas. Ninguno de los resultados demuestra con qué consistencia manejará tu base de código o tu flujo de trabajo de agentes.
Puntos clave
- Trata los benchmarks de lanzamiento como señales de capacidad, no como garantías de producción.
- Muse Wonder y Muse Wonder Full son variantes separadas. Mantén sus resultados separados.
- Mide la tasa de aprobación, la repetibilidad, la finalización y la recuperación como resultados distintos.
- Empieza con 10 a 20 tareas reales, congela la configuración y repite las tareas importantes al menos tres veces.
- Elige un umbral según el costo de una respuesta incorrecta y tu proceso de revisión humana.
¿Es fiable Muse Wonder? La respuesta breve
La evidencia disponible al 15 de octubre de 2026 respalda una evaluación tarea por tarea, no un veredicto universal de fiabilidad. Muse Wonder tuvo un buen desempeño en algunas comprobaciones iniciales, mientras que otras ejecuciones expusieron errores o trabajo de presentación que aún requería revisión. Los estudios difieren en los prompts, la configuración de razonamiento, los evaluadores, los tamaños de muestra y el número de intentos.
(Meta, 12 de octubre de 2026) dice que Muse Wonder y Muse Wonder Full están diseñados para tareas de agentes profesionales y personales, con funciones que denomina Active Memory y Active Focus. Esas son afirmaciones de producto sobre el comportamiento previsto. La afirmación de que un modelo puede recuperarse de errores es una razón para probar la recuperación en tu propio flujo de trabajo, no una prueba de que se recuperará de forma fiable.
Mantén Wonder estándar separado de Wonder Full. Meta incluye Muse Wonder estándar para su Model API y Muse Code, mientras que Full se ofrece mediante suscripciones de Muse Code. Ejecutar Wonder estándar con una configuración de razonamiento más alta no lo convierte en Full.
Para tomar una decisión que puedas defender, prueba la variante y la ruta exactas que piensas desplegar. Cuenta una tarea como exitosa solo cuando cumpla una regla de aceptación escrita y su resultado pueda comprobarse.
Qué debe medir una prueba de fiabilidad de Muse Wonder
Precisión y consistencia son diferentes
Una tasa de aprobación mide cuántos intentos cumplen una rúbrica definida. La consistencia mide si ejecuciones repetidas de la misma tarea producen resultados aceptables cada vez. Un modelo puede tener una tasa de aprobación alta y aun así variar de formas que importan para tu flujo de trabajo.
Registra cuatro dimensiones por separado:
| Medida | Qué registrar | Comprobación de ejemplo |
|---|---|---|
| Precisión | Intentos que aprueban la rúbrica | ¿El total extraído coincide con el documento de origen? |
| Consistencia | Si los intentos repetidos aprueban y coinciden | ¿Tres ejecuciones conservan las mismas restricciones obligatorias? |
| Calidad de finalización | Si todos los entregables solicitados están presentes | ¿Se incluyen todos los archivos, citas y campos solicitados? |
| Recuperación | Si la ejecución se reanuda correctamente tras una falla | ¿Informa un fallo de herramienta, reintenta de forma segura y luego verifica el estado final? |
Una respuesta que suena completa no es necesariamente completa. Un cambio de código necesita pruebas; un resumen de investigación necesita fuentes trazables; una ejecución de agente necesita evidencia de que ocurrió su acción final.
Separa los fallos del modelo de los fallos del flujo de trabajo
Registra suficiente contexto para distinguir un error del modelo de un problema de servicio o de herramienta. Como mínimo, registra la variante y versión del modelo, la configuración de razonamiento, el prompt, la configuración de herramientas, la fecha, el tiempo de ejecución, el costo en tokens o por tarea y la salida sin procesar.
Clasifica los fallos antes de puntuarlos:
- Modelo: dato incorrecto, razonamiento deficiente o requisito omitido.
- Herramienta: llamada a API fallida, argumentos de herramienta inválidos o resultado incorrecto de un sistema externo.
- Servicio: tiempo de espera agotado, interrupción o endpoint no disponible.
- Evaluación: rúbrica poco clara o una comprobación que no puede distinguir trabajo aceptable de inaceptable.
Si combinas los cuatro en una sola tasa de fallos, no sabrás qué corregir.
Qué muestran las pruebas actuales de Muse Wonder
Las comparaciones de benchmarks publicadas por Meta son evidencia del proveedor sobre el desempeño en benchmarks. No son lo mismo que una evaluación de flujo de trabajo ejecutada de forma independiente. Las pruebas independientes también tienen límites: un conjunto de tareas públicas pequeño, un solo intento, una ruta de modelo concreta o una valoración de preferencia humana responden solo a una pregunta acotada.
La siguiente tabla separa la evidencia por fuente y alcance. Es una guía sobre qué puede respaldar cada resultado, no una puntuación combinada.
| Fuente de evidencia | Qué probó | Fecha y configuración | Qué puede decirte | Limitación principal |
|---|---|---|---|---|
| Anuncio y materiales del modelo de Meta | Benchmarks de capacidad y funciones previstas para agentes | Anunciado el 12 de octubre de 2026; comparaciones reportadas por el proveedor | Qué capacidades destaca Meta y qué variantes lanzó | Las pruebas del proveedor no establecen repetibilidad en tu flujo de trabajo |
| (Spring Prompt, 13 de octubre de 2026) | Encuestas, fichas de producto, diapositivas, planificación de anuncios, ajedrez y búsqueda visual | 13 de octubre; modelo estándar de API, razonamiento generalmente medio; tareas públicas | El desempeño varió según la tarea; algunas evaluaciones incluyeron ejecuciones repetidas de fichas de producto | La mayoría de las tareas eran muestras pequeñas; muchos resultados fueron una ejecución por tarea; no es una prueba de codificación ni de Muse Code |
| (Quantslant, 12 de octubre de 2026) | 23 tareas que abarcan agentes, codificación, escritura, razonamiento y un documento largo | 12 de octubre; modelo estándar vía OpenRouter, razonamiento bajo; una ejecución por tarea | El modelo aprobó ese conjunto de tareas definido a una tasa alta bajo esa configuración | Una sola ejecución no puede medir la consistencia entre ejecuciones; los resultados cercanos al 100 % necesitan inspección a nivel de tarea |
| Publicaciones de la comunidad | Reacciones individuales sobre codificación, agentes y benchmarks | Publicaciones del período de lanzamiento; usuarios y tareas autoseleccionados | Pistas útiles sobre qué probar después | Las anécdotas y los votos no son tasas de aprobación medidas |
El contraste entre fuentes importa. Quantslant reportó 99,7 % en su conjunto de 23 tareas, con una ejecución por tarea y una configuración de razonamiento baja. También señaló una prueba unitaria fallida en una tarea de codificación de convertir números a palabras. Ese resultado es evidencia sobre ese conjunto concreto, no evidencia de que el 99,7 % de las tareas cotidianas aprobará o de que las ejecuciones repetidas coincidirán.
Spring Prompt reportó un panorama más variado para Wonder estándar con los valores predeterminados de la API el 13 de octubre. Su puntuación de análisis de investigación fue de 93,6/100 en nueve tareas públicas, mientras que solo tres de nueve planes de encuesta aprobaron todas las comprobaciones. Para fichas de producto, la proporción considerada fiable y lista para publicar en tres repeticiones fue del 66,1 % para briefs informativos y del 51,8 % para briefs de ventas. Cinco de seis presentaciones de diapositivas necesitaron correcciones de diseño, y una se consideró presentable. Son medidas separadas con denominadores separados, no partes de una puntuación general única.
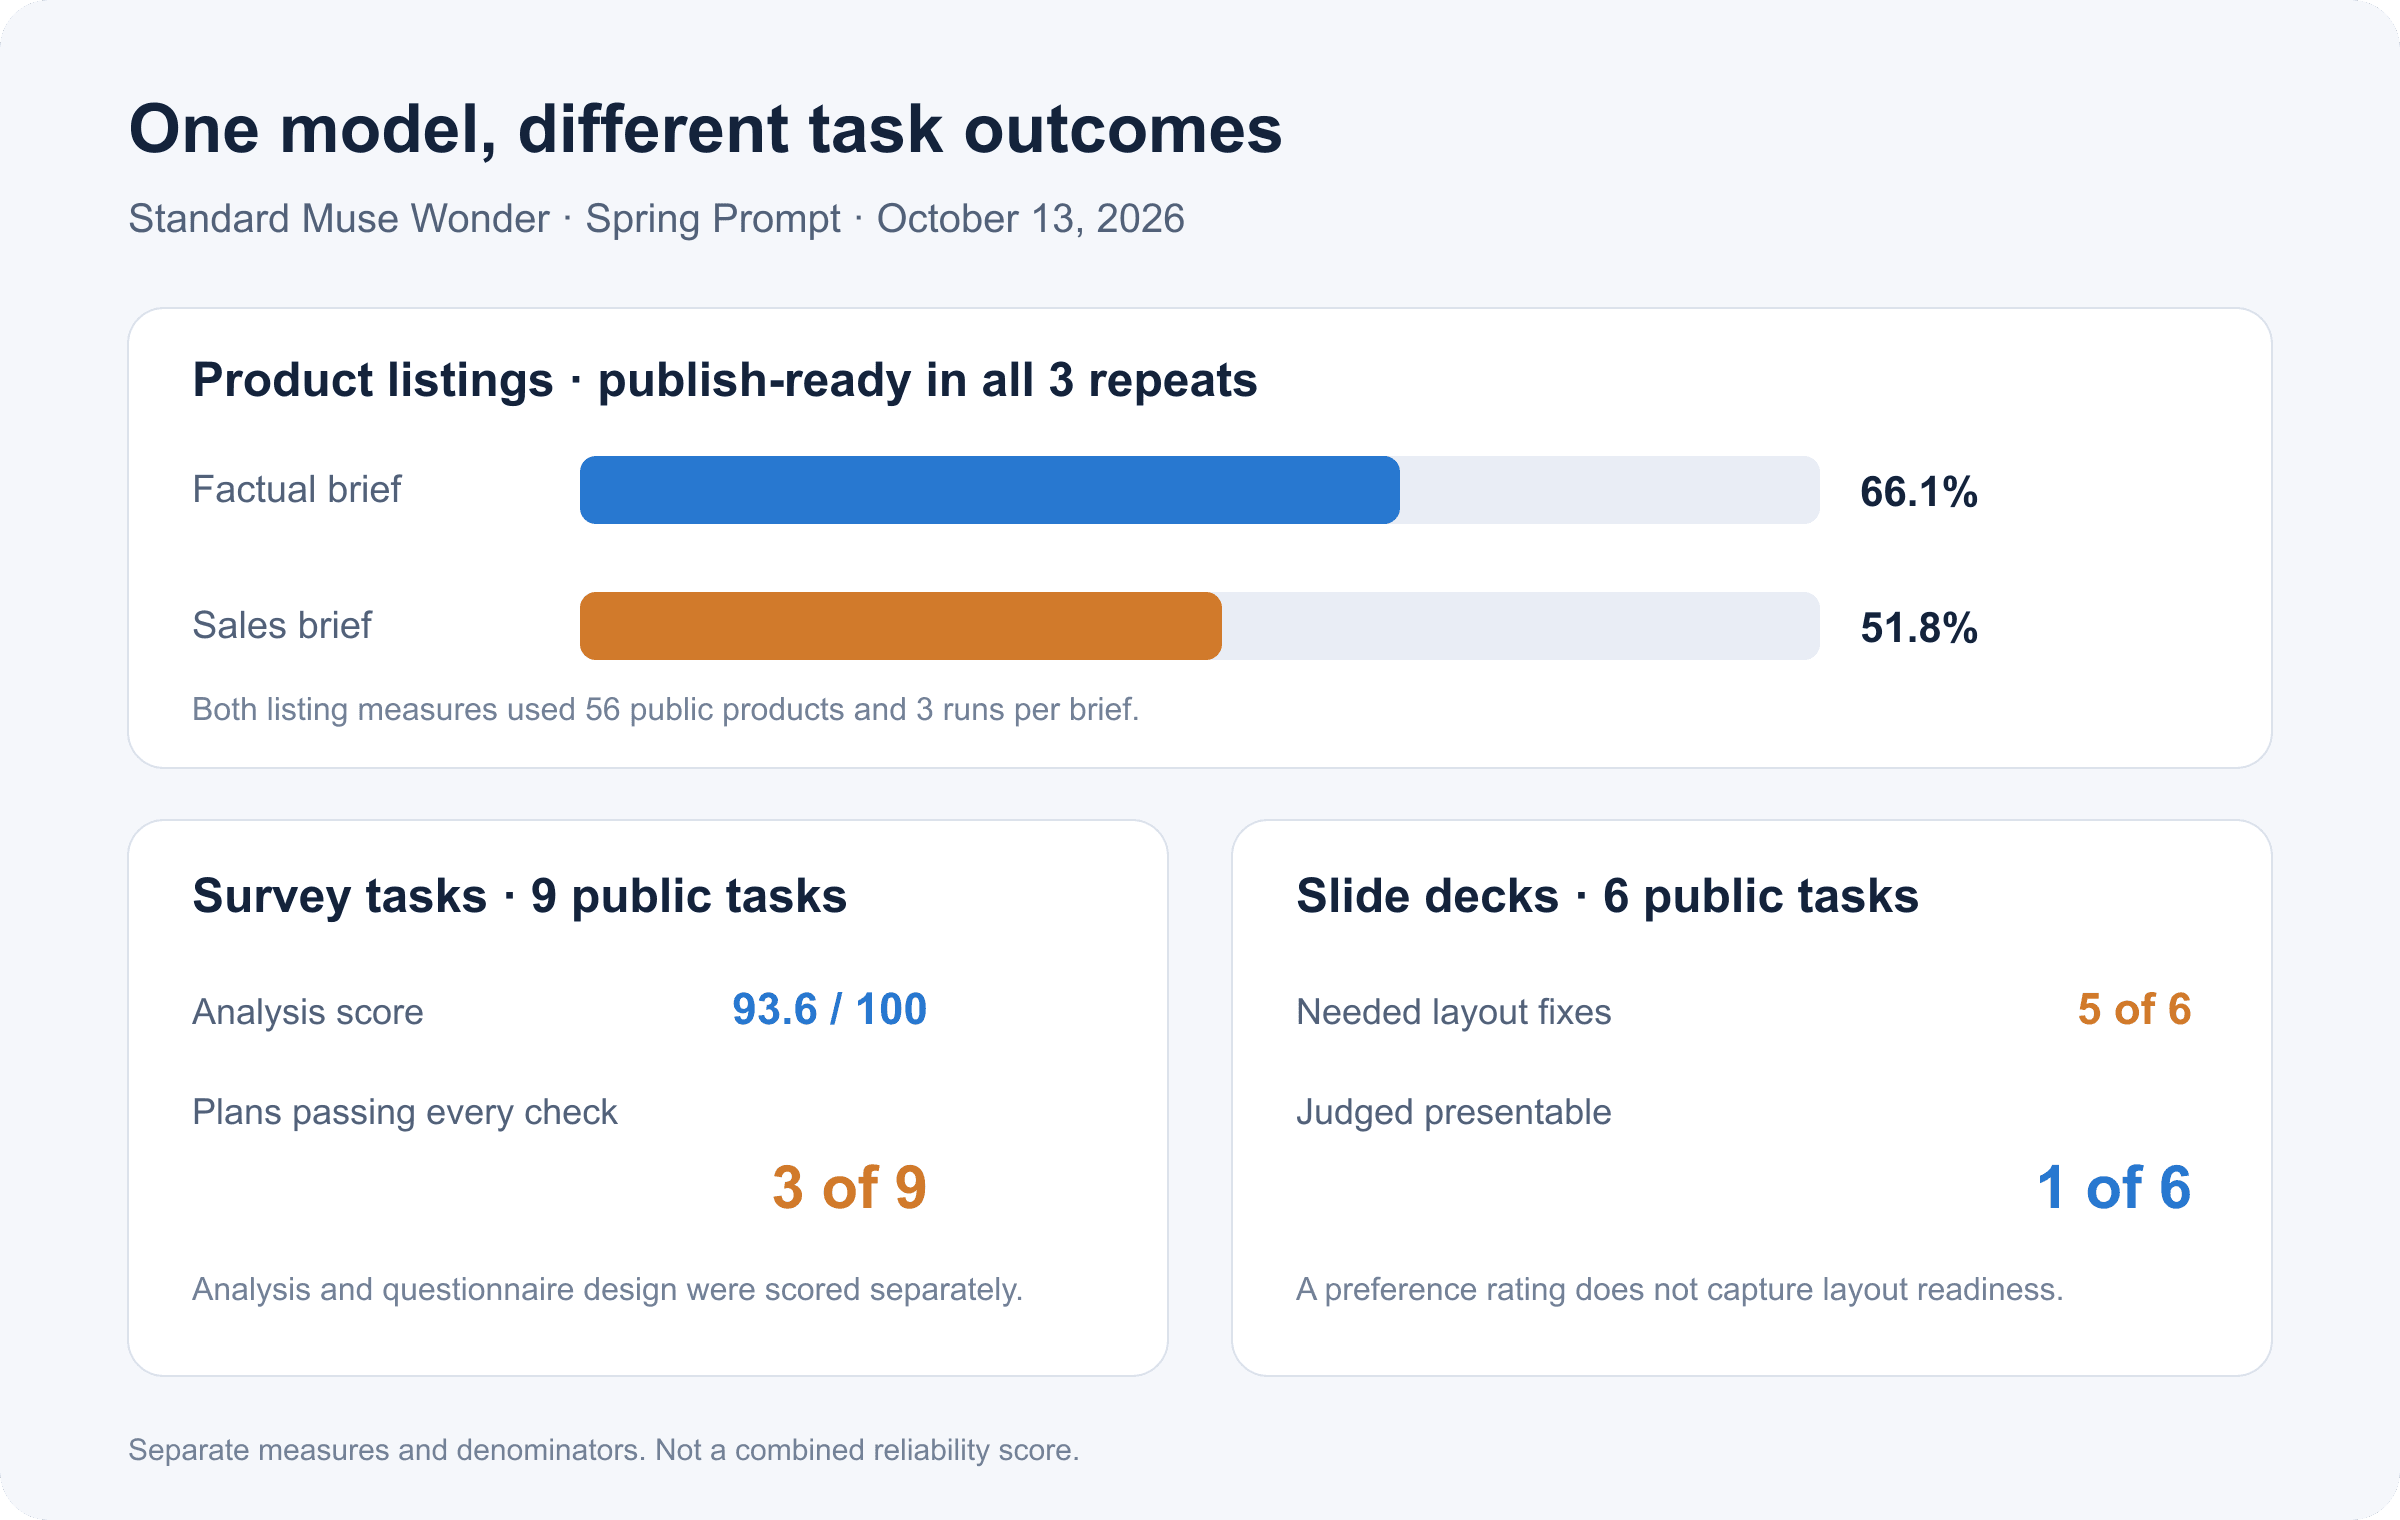
Resultados de Muse Wonder estándar de Spring Prompt del 13 de octubre de 2026: tasas de aprobación de fichas probadas repetidamente, análisis de encuestas y resultados de revisión de presentaciones
Resultados de tareas independientes de una evaluación. Las medidas usan denominadores distintos y se muestran por separado, no combinadas en una puntuación.
Las pruebas de Spring Prompt no midieron codificación, memoria persistente ni Muse Code. Por lo tanto, su comparación no puede determinar si Wonder es fiable para codificación ni si Full tiene un mejor desempeño. Sí muestra por qué una sola etiqueta amplia oculta diferencias importantes entre tareas.
El artículo de lanzamiento de Meta dice que Muse Wonder estándar está disponible a través de Meta Model API y Muse Code, mientras que Wonder Full está disponible para suscriptores de Muse Code. Describe Active Memory y Active Focus como funciones para retener detalles útiles y continuar el trabajo a pesar de errores. Esas descripciones ayudan a definir casos de prueba, pero el artículo de lanzamiento no es un estudio independiente de ejecuciones repetidas.
Para las afirmaciones sobre codificación y construcción 3D analizadas en hilos de la comunidad durante la semana de lanzamiento, trata las publicaciones como hipótesis. Convierte una queja específica en una tarea reproducible y verifica la salida. No conviertas comentarios o votos positivos en una tasa de éxito.
Cómo ejecutar una prueba de fiabilidad de Muse Wonder repetible
1. Crea un conjunto pequeño de tareas a partir de trabajo real
Elige de 10 a 20 tareas que tu equipo realmente espera que el modelo maneje. Divídelas en categorías como codificación, extracción de datos fácticos, seguimiento de instrucciones, contexto largo y uso de herramientas. Prioriza tareas con pruebas objetivas, respuestas de referencia o una rúbrica clara.
Incluye casos límite realistas: entrada faltante, requisitos contradictorios, una herramienta no disponible y una tarea que deba generar una pregunta de aclaración. Mantén fuera los datos sensibles o regulados, a menos que tu proceso aprobado lo permita.
2. Congela el prompt, el modelo y la configuración
Anota el prompt exacto y las instrucciones de sistema. Registra el nombre y la versión del modelo, el nivel de razonamiento, las herramientas, el contexto proporcionado, la fecha y cualquier límite de tiempo. No compares Wonder estándar con Full como si fueran el mismo modelo.
Un prompt de prueba útil puede pedir al modelo que muestre su evidencia e identifique requisitos no verificables:
Lee la especificación y la implementación adjuntas. Devuelve solo: (1) cada requisito marcado como PASA, FALLA o NO VERIFICABLE; (2) la evidencia exacta para cada estado; (3) cualquier requisito faltante; (4) una prueba reproducible mínima para cada FALLA. No afirmes que una prueba pasó a menos que puedas señalar su salida.
Esta es una entrada de evaluación, no una garantía de que el modelo la seguirá. Puntúa la respuesta resultante y verifica de forma independiente cualquier salida de prueba declarada.
3. Repite las tareas y puntúa cada intento
Ejecuta cada tarea de alto impacto al menos tres veces con la misma configuración. Si el presupuesto solo permite un intento, etiqueta el resultado como muestra inicial en lugar de resultado de consistencia. Conserva cada respuesta sin procesar; no reportes solo la mejor.
Usa una fila por cada intento. Mantén la regla de aceptación estable entre ejecuciones.
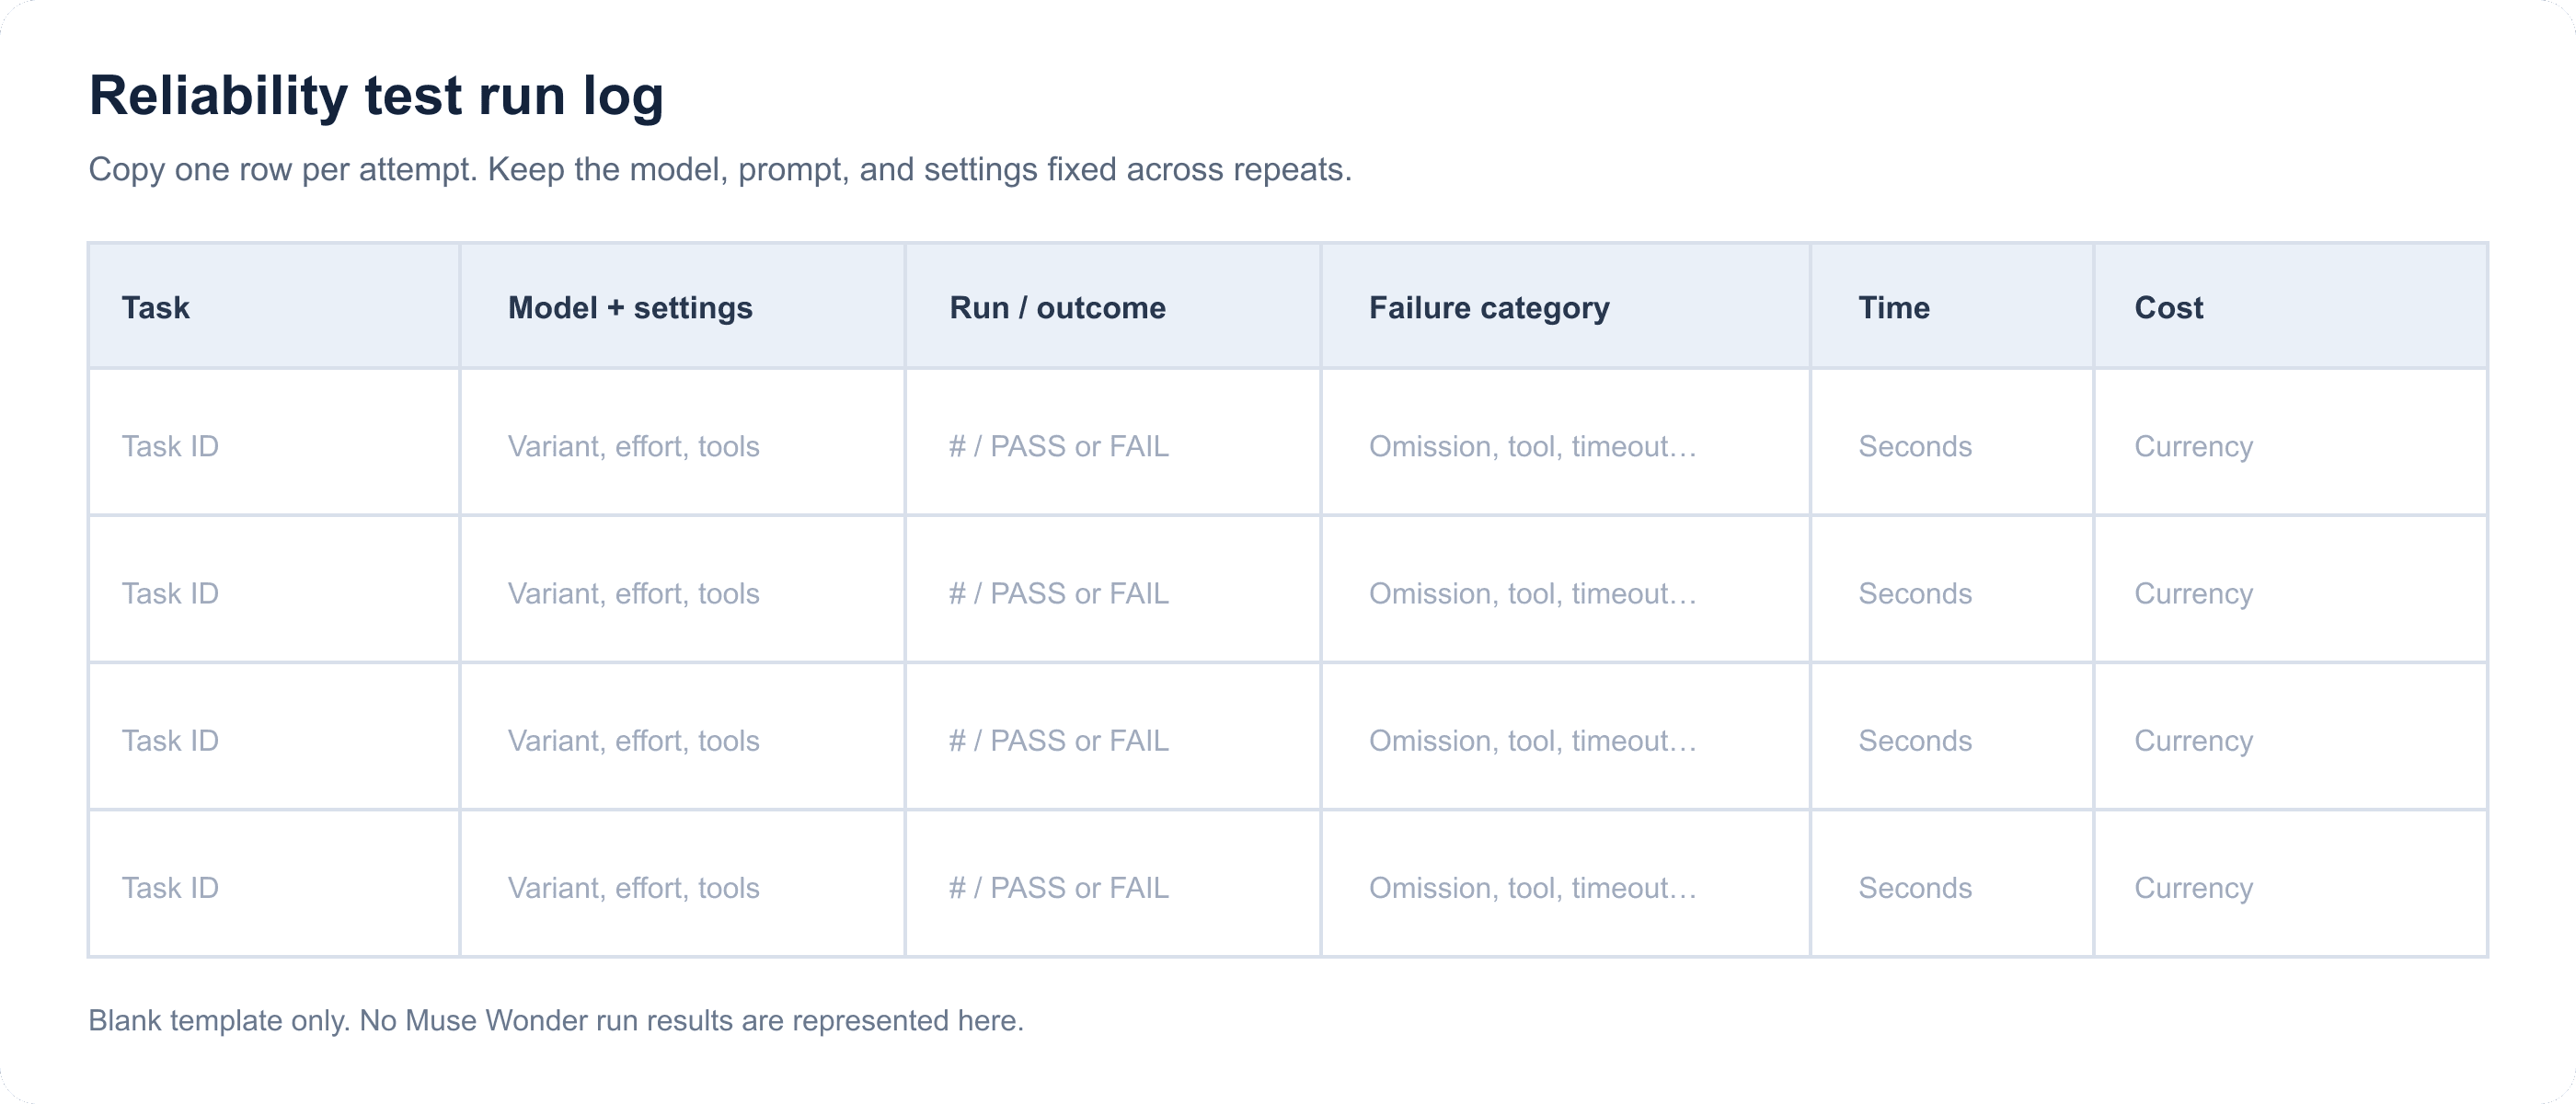
Registro en blanco de prueba de fiabilidad de Muse Wonder que muestra campos para tarea, modelo, ejecución, resultado, error, tiempo y costo
Plantilla de registro en blanco reutilizable. Completa una fila por intento; no contiene resultados medidos de Muse Wonder.
4. Lleva un registro de fallos y verifica la recuperación
Usa categorías específicas: error fáctico, omisión, prueba de código fallida, error de herramienta, tiempo de espera agotado, afirmación de finalización no respaldada o discrepancia de formato. Para trabajo de varios pasos, anota dónde se detuvo la ejecución y si un reintento repitió acciones completadas o verificó el estado final.
Un agente que dice “hecho” sin evidencia no ha pasado una comprobación de finalización. Exige un resultado de prueba, un archivo guardado, una cita de fuente o un estado verificado que coincida con la tarea.
5. Establece un umbral de decisión en función del costo del fallo
No existe un corte universal útil de tasa de aprobación. Un borrador que una persona revisa línea por línea tiene un perfil de riesgo distinto del de una migración de base de datos o un pago automatizado.
Establece el umbral a partir de tres factores:
- ¿Qué tan dañino o costoso es un resultado incorrecto?
- ¿Puede una persona detectar el error antes de que afecte a alguien?
- ¿El flujo de trabajo falla de forma segura, con una parada clara y un rastro de auditoría?
Para borradores de bajo riesgo, la revisión puede ser suficiente. Para cambios de código, finanzas, temas legales, salud o acciones que afectan a usuarios, usa pruebas más sólidas y verificación independiente. No dejes que un promedio alto oculte un modo de fallo grave.
Fiabilidad de Muse Wonder por tipo de tarea
Codificación y construcciones de varios pasos
Ejecuta la suite de pruebas real del repositorio y comprueba el comportamiento solicitado. Puntúa la cobertura de requisitos, los fallos de regresión y si los cambios declarados por el modelo coinciden con los archivos y la salida de las pruebas. Una grabación de pantalla o una explicación convincente no sustituye una comprobación ejecutable.
El conjunto inicial de Quantslant incluía cuatro tareas de codificación y reportó 15 de 16 pruebas unitarias aprobadas en una tarea de conversión de números a palabras. Esa es una señal pequeña de una sola ejecución. Spring Prompt no probó codificación de forma explícita, así que sus hallazgos no deben usarse para generalizar sobre la fiabilidad de agentes de codificación.
Investigación y extracción de datos fácticos
Usa un paquete de fuentes o respuestas de referencia que tu revisor pueda inspeccionar. Comprueba cada afirmación fáctica contra una fuente primaria y registra las citas inventadas y la atribución incorrecta por separado de la calidad general de la respuesta.
El análisis de encuestas de Spring Prompt fue una fortaleza relativa en su pequeña evaluación, pero el diseño de preguntas de encuesta fue más débil. Una puntuación alta de análisis no debería certificar de forma silenciosa el instrumento de encuesta ni las fuentes detrás de una nueva tarea de investigación.
Flujos de trabajo de contexto largo y agentes
Comprueba si el modelo conserva cada restricción, usa cada herramienta correctamente y verifica el estado final. Prueba la recuperación ante interrupciones de forma deliberada: detén una ejecución después de un paso conocido y observa si se reanuda desde un punto de control o repite un efecto secundario.
El anuncio de Meta describe capacidades de memoria y recuperación, pero las evaluaciones públicas iniciales citadas aquí no establecen consistencia a largo plazo para memoria persistente o recuperación de agentes. Mide esos comportamientos directamente antes de confiar en ellos.
Muse Wonder vs. Muse Wonder Full: mantén la evidencia separada
Muse Wonder y Muse Wonder Full son variantes distintas. La información de lanzamiento de Meta describe rutas de acceso separadas, y las pruebas independientes de API de Wonder estándar no se convierten en resultados de Full solo porque cambie la configuración de razonamiento.
| Pregunta de comparación | Qué respalda la evidencia disponible |
|---|---|
| ¿Full es lo mismo que Wonder estándar con razonamiento máximo? | No. Trátalos como variantes distintas y registra el nombre exacto. |
| ¿La evaluación de API de Spring Prompt citada probó Full? | No. Probó Wonder estándar; Full quedó fuera de esa comparación. |
| ¿Los números de API estándar citados pueden clasificar a Full? | No. No prueban Full. |
| ¿Qué haría una comparación justa? | El mismo conjunto de tareas, rúbrica de puntuación, ventana de fechas, acceso a herramientas y configuración documentada, con repeticiones para ambas variantes. |
Una comparación justa comienza con tareas emparejadas y condiciones igualadas. Si las rutas de acceso imponen prompts, herramientas o facturación diferentes, documenta esas diferencias y llama a la comparación exploratoria.
Costo, acceso y dónde probar Muse Wonder
Compara el costo por tarea aceptada, no solo el precio indicado por token. Los prompts largos, los reintentos, los tokens de razonamiento, las llamadas a herramientas, los tiempos de espera agotados y la revisión humana cambian el costo de un resultado utilizable. Quantslant reportó las tarifas de tokens de Wonder estándar como $4 por millón de tokens de entrada y $20 por millón de tokens de salida el 12 de octubre de 2026, y su propia ejecución de 23 tareas costó $0.64. Esa es una ruta y una carga de trabajo reportadas, no un precio universal por tarea.
El anuncio de lanzamiento actual de Meta incluye Wonder estándar a través de Meta Model API y Muse Code, y Full a través de suscripciones de Muse Code. Confirma el acceso, la elegibilidad regional y la facturación actual en la interfaz oficial antes de presupuestar.
Empieza en Atlas Cloud para obtener una visión más amplia de su plataforma para desarrolladores. Al 15 de octubre de 2026, no pude confirmar Muse Wonder en el catálogo de modelos, por lo que este artículo no presenta Atlas Cloud como una ruta de ejecución para este modelo. Si tu equipo está comparando otros modelos ya listados allí, la biblioteca de modelos de Atlas Cloud puede ayudarte a identificar candidatos para ejecutarlos con el mismo conjunto de tareas.
El resultado útil de una prueba de fiabilidad de Muse Wonder es una decisión de despliegue vinculada a evidencia: qué tarea aprobó, con qué frecuencia aprobó, cuánto costó y qué revisión sigue siendo necesaria.
Preguntas frecuentes
¿Es fiable Muse Wonder para codificación?
Las pruebas iniciales de lanzamiento proporcionan solo una pequeña muestra de codificación. Quantslant reportó cuatro tareas de codificación, con una prueba unitaria no superada en una tarea, mientras que Spring Prompt no probó codificación. Ejecuta las pruebas del repositorio en tus propias tareas y repite las importantes antes de tomar una decisión sobre un flujo de trabajo de codificación.
¿Cómo pruebo yo mismo la fiabilidad de Muse Wonder?
Usa un conjunto fijo de tareas reales, conserva los ajustes exactos del modelo y del prompt, define los criterios de aprobación de antemano y conserva cada salida. Repite las tareas importantes y verifica los resultados con pruebas o documentos de origen.
¿Cuántas veces debo repetir cada tarea de Muse Wonder?
Usa al menos tres ejecuciones para tareas de alto impacto como comprobación inicial de consistencia. Tres intentos siguen siendo una muestra pequeña, así que amplía el conjunto cuando los errores sean costosos o las salidas varíen.
¿Cuál es la diferencia entre Muse Wonder y Muse Wonder Full?
Son variantes de modelo separadas con rutas de disponibilidad diferentes. No trates Wonder estándar con razonamiento máximo como Full, ni transfieras resultados entre ellos sin una prueba emparejada.
¿Puedo confiar en las puntuaciones de benchmark de Muse Wonder de Meta?
Úsalas como evidencia de capacidad reportada por el proveedor y lee la configuración del benchmark. No demuestran un rendimiento consistente con tus prompts, herramientas y ejecuciones repetidas.
¿Está Muse Wonder disponible en Atlas Cloud?
No pude verificarlo en el catálogo de modelos de Atlas Cloud al 15 de octubre de 2026. Consulta el catálogo en vivo antes de elegir un proveedor de ejecución.





