

La frase trata sobre extrañar a alguien. La voz se generó con una configuración de emoción triste, pero el retrato de referencia tiene una amplia sonrisa. Ese es el tipo de conflicto que un guion gráfico estático no puede responder. Para hacer concreto el emparejamiento de voz emocional y expresión facial de OmniHuman 2.0, primero mantuvimos fijo un retrato y una pista de voz de 9.68 segundos, luego generamos dos videos con direcciones faciales opuestas. Otros dos videos usan retratos, interpretaciones de voz y direcciones emparejados de ira y duelo. Los GIF silenciosos te permiten inspeccionar las expresiones visibles.
Existe un límite de versión importante. Atlas Cloud ahora incluye Avatar Omni Human 2.0. Nuestra ejecución del 20 de octubre de 2026 en el entorno de pruebas de Atlas devolvió un error de modelo no compatible aguas arriba antes de la renderización. Los cuatro videos de avatar completados en este artículo se generaron allí con Avatar Omni Human 1.5. Demuestran un flujo de trabajo relacionado basado en audio y un método de diagnóstico útil, no un rendimiento medido de OmniHuman 2.0.
Puntos clave
- Escucha primero el audio proporcionado. En la prueba a continuación, la misma grabación triste produjo elecciones de mirada, boca y gestos visiblemente diferentes cuando cambió la dirección.
- Un retrato de origen sonriente puede trasladar su expresión a los fotogramas iniciales, incluso cuando el prompt pide contención.
- Un segundo par hace que la ira y el duelo sean visiblemente distintos al emparejar el retrato inicial, la interpretación de voz y la dirección con cada estado de ánimo. No aísla una entrada como la causa.
- Compara las mismas marcas de tiempo con el sonido activado y desactivado; describe qué cambia realmente en lugar de asumir que un prompt funcionó exactamente como se escribió.
- Verifica la versión del modelo y una salida completada antes de usar el resultado de una versión para ilustrar otra.
Qué aporta cada uno: el audio, el retrato y el prompt
Atlas describe Omni Human 2.0 como un modelo de avatar basado en audio que acepta una imagen de referencia, una pista WAV o MP3 y un prompt de texto opcional. Su página de modelo pública indica salida en 720p y audio de entrada de 4 a 300 segundos. La página dice que el prompt puede dirigir gestos, acciones, detalles de la escena y movimiento de cámara. Estas son especificaciones de la página del producto, no una afirmación de que cada golpe facial solicitado aparecerá en un clip generado (página del modelo Atlas Omni Human 2.0).
El artículo anterior de OmniHuman-1 enmarca la familia de investigación como animación humana condicionada por imagen, audio, texto y otras señales. No establece los controles o resultados exactos de una versión posterior del producto (artículo de OmniHuman-1, ICCV 2025). Para un creador que prepara una prueba, una división del trabajo más simple es más útil:
| Entrada | Función en la prueba | Qué verificar |
|---|---|---|
| Retrato | Ancla la identidad de la persona y la expresión inicial | ¿Es visible el rostro y la sonrisa inicial lucha contra el estado de ánimo previsto? |
| Audio | Proporciona las palabras reales, el tiempo, las pausas y la interpretación | ¿La grabación suena como la emoción que implica el guion? |
| Prompt | Solicita comportamiento visible alrededor de la grabación | ¿El rostro, la mirada y los gestos siguieron realmente esas direcciones? |
El movimiento de la boca y la expresión emocional son verificaciones separadas. Un rostro puede parecer hablar mientras sus ojos y sonrisa comunican el significado equivocado. Un fotograma fijo puede revelar la expresión, pero solo un video con su audio original te permite juzgar la relación voz-rostro.
Las entradas de prueba reales: una frase triste y una imagen de origen sonriente
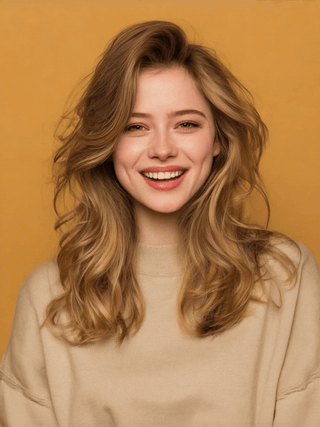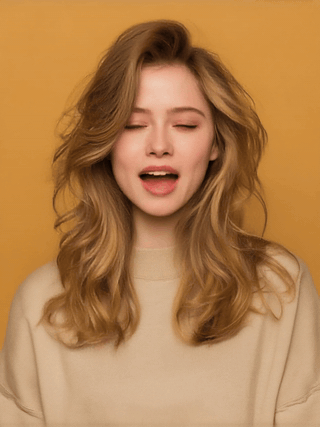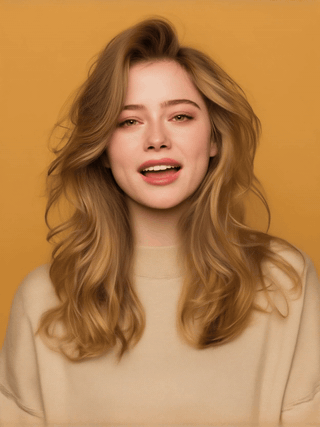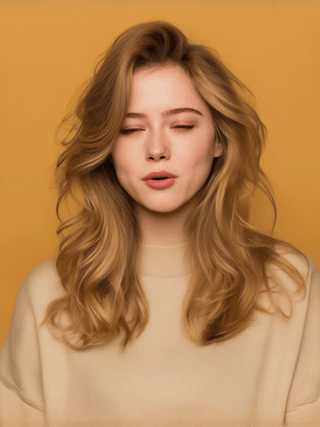
Usamos deliberadamente el retrato de muestra sonriente de Atlas en lugar de un rostro ya afligido. El rostro es claro y frontal, lo que hace que la expresión generada sea fácil de inspeccionar, pero la sonrisa inicial crea un caso exigente para una frase triste.
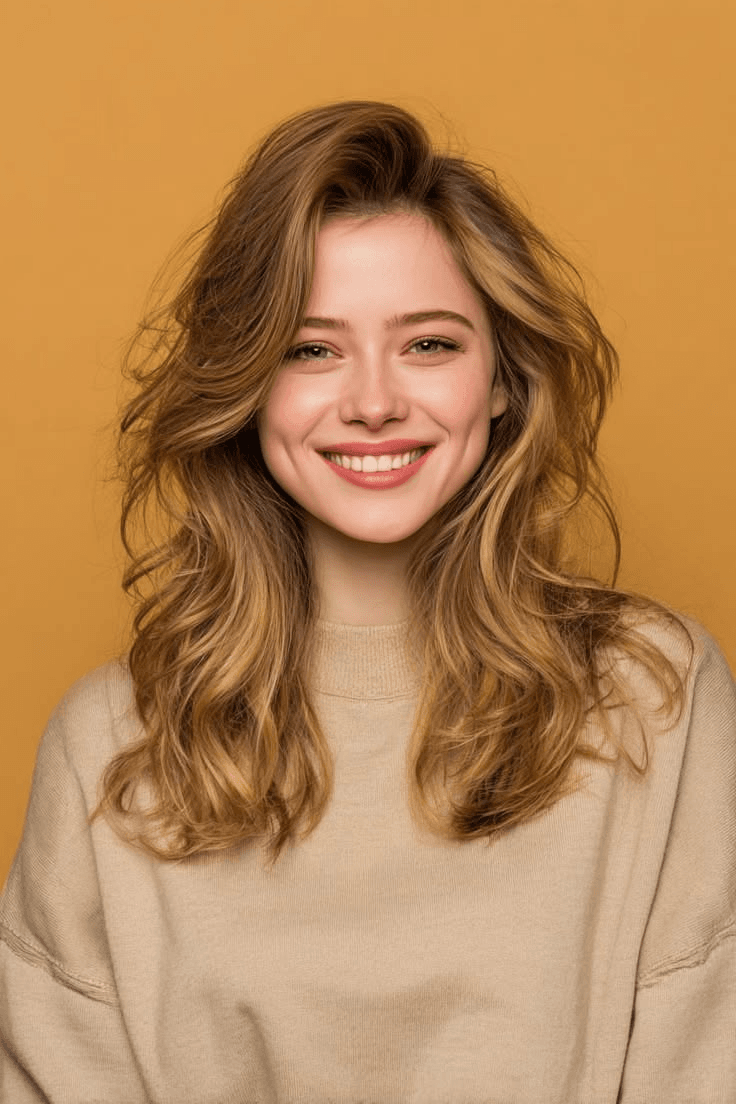 Imagen de entrada fija para ambos videos. La sonrisa es parte de la imagen de origen, así que inspecciona los primeros segundos por separado de la interpretación posterior.
Para el audio, usamos el entorno de pruebas de Atlas MiniMax Speech 2.6 HD playground con la voz en inglés "Upset Girl" y la configuración de emoción sad. El guion exacto era: "Pensé que estarías aquí hoy. Seguí mirando la puerta, incluso después de que todos se hubieran ido. Te extraño más de lo que puedo decir." El MP3 resultante dura 9.68 segundos. Ambas ejecuciones del avatar usaron ese mismo archivo de audio y el mismo retrato; solo cambió el prompt de dirección opcional. Ambas devolvieron MP4 de 9.8 segundos con una pista de audio. Esta es una pequeña comparación práctica, no un benchmark formal del modelo.
Esta elección de entrada importa. El guion le da a la hablante una razón para mirar hacia abajo o contener una sonrisa, mientras que la foto de referencia sugiere lo contrario. Si el rostro sigue sonriendo, primero pregúntate si la imagen de origen o la dirección tienen más peso en esa toma. No asumas que agregar más adjetivos emocionales resolverá el conflicto.
Dos resultados de video reales: la misma voz, diferente dirección facial
Ejecución A: pedir un rostro contenido
Aquí está la dirección utilizada para la primera ejecución completada de Omni Human 1.5:
La mujer habla en voz baja y con tristeza a la cámara. Su amplia sonrisa inicial se desvanece antes de la primera palabra. Mantén las cejas suavemente fruncidas, los ojos húmedos y bajos, y la boca contenida. En la frase final, vuelve a mirar a la cámara pero no sonríe. Movimiento mínimo de cabeza y manos; plano medio cercano estable.
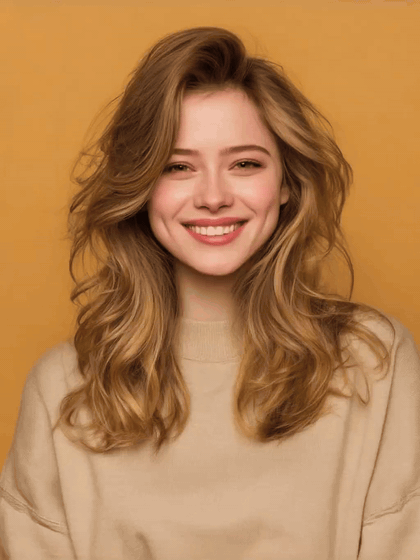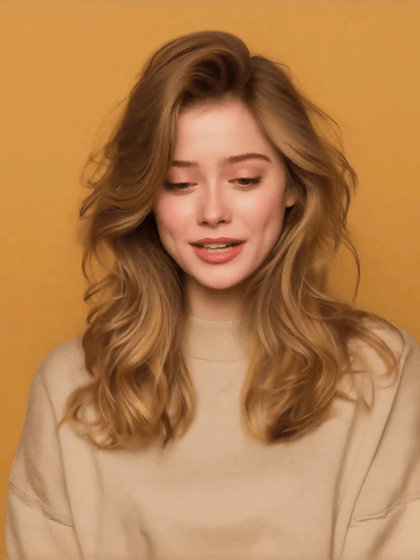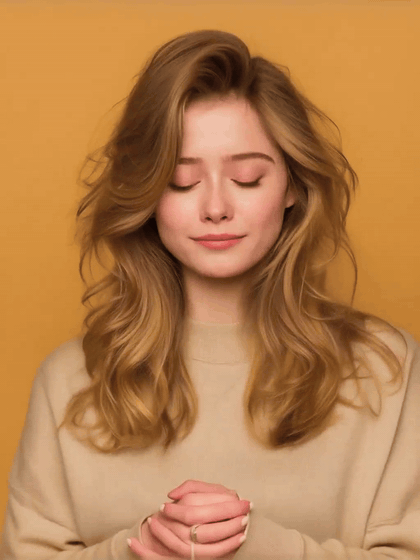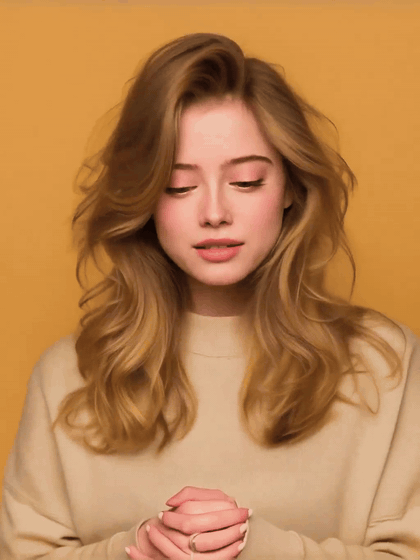
Ejecución A, entorno de pruebas de Atlas, Avatar Omni Human 1.5. Este GIF es silencioso. El fotograma inicial aún conserva la sonrisa de origen; alrededor de 2 a 4 segundos la mirada baja y la boca se relaja, y cerca de 6 a 8 segundos los ojos se bajan o se cierran. El prompt no eliminó la sonrisa antes de la primera palabra exactamente como se solicitó.
Ejecución B: pedir una sonrisa que entra en conflicto con la frase
El retrato y el MP3 triste permanecieron igual. Solo cambiamos la dirección:
La mujer habla alegremente a la cámara con una amplia y alegre sonrisa durante todo el audio. Mantén los ojos vivaces y las cejas relajadas; agrega un pequeño asentimiento animado mientras habla. Nunca dejes que la sonrisa se desvanezca, incluso durante la frase final. Movimiento mínimo de manos; plano medio cercano estable.
Ejecución B, entorno de pruebas de Atlas, Avatar Omni Human 1.5. De 2 a 6 segundos, ella mira más a menudo hacia la cámara y mantiene una ligera sonrisa. La sonrisa se suaviza cerca del final, por lo que "durante todo" no se siguió literalmente. La señal visual sigue siendo menos consistente con la frase triste proporcionada que la Ejecución A.
Los dos resultados responden a la pregunta práctica del título con mayor claridad que un prompt genérico de "sé emocional". El audio por sí solo no forzó el mismo estado de ánimo visible en ambas tomas. La dirección de texto afectó la mirada y la expresión generadas, mientras que la entrada fuertemente sonriente permaneció visible al inicio. Estas observaciones se aplican a estas dos ejecuciones de 1.5. No cuantifican la precisión de expresión de Omni Human 2.0.
Verifica los mismos momentos, luego haz un cambio
El par de fotogramas a continuación proviene de los dos videos reales a unos seis segundos. El resultado izquierdo mira hacia abajo y junta las manos; el resultado derecho mira al espectador con una ligera sonrisa. Es una comparación visual de resultados, no un reemplazo de reproducir los clips con su sonido.
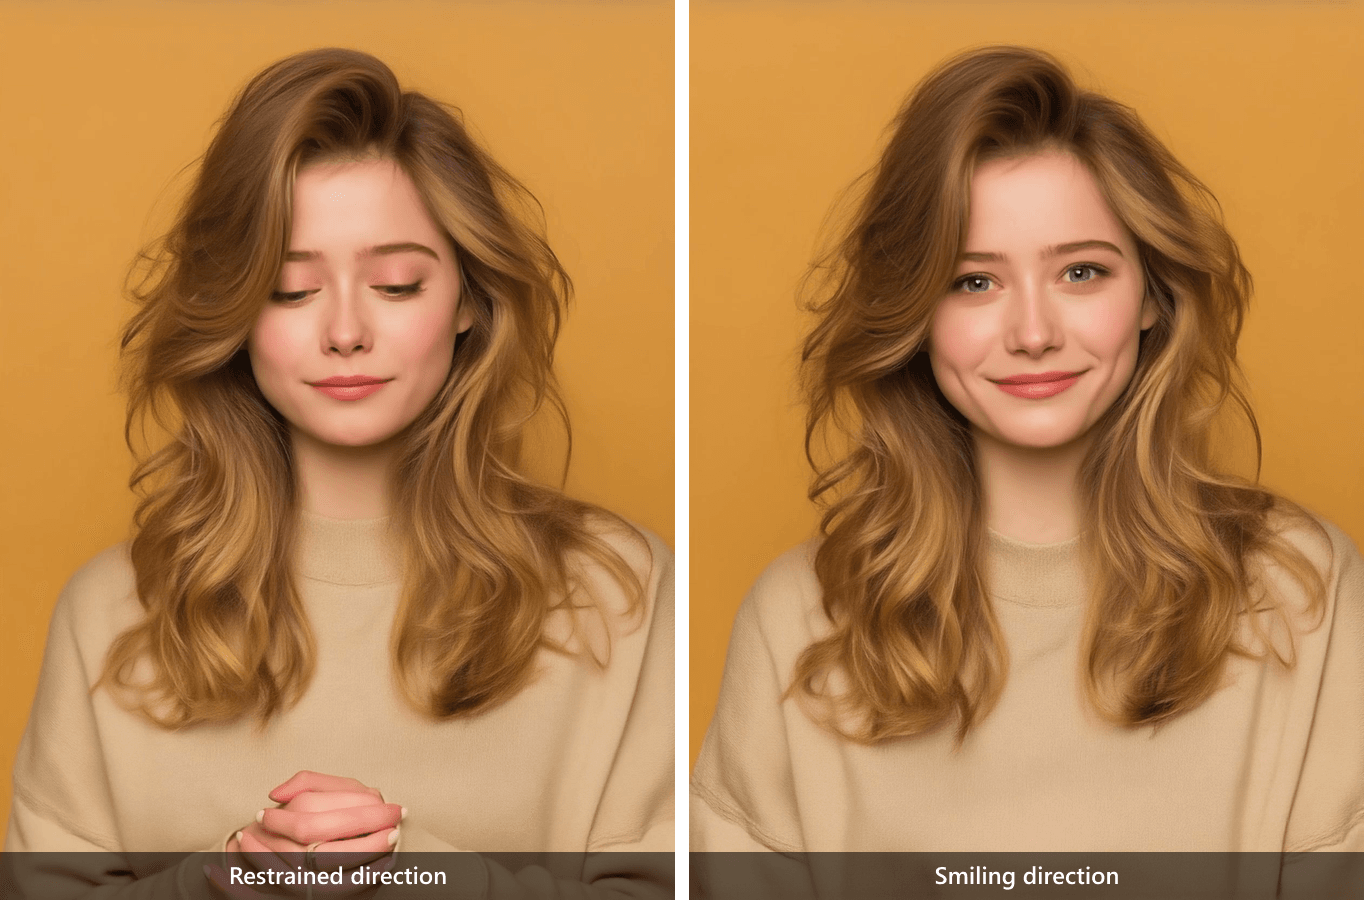 Mismo retrato y audio triste, aproximadamente 00:06. Izquierda: dirección contenida. Derecha: dirección sonriente. Ambos fotogramas son de salidas reales de Omni Human 1.5.
Usa tres pasadas para tu propio clip:
- Escucha sin mirar. Marca las palabras y pausas que llevan la emoción. En esta prueba, la frase sobre mirar la puerta y extrañar a alguien es el significado a proteger.
- Mira en silencio en esos momentos. Verifica los ojos, las comisuras de la boca, el ángulo de la cabeza y los gestos. Una hablante puede mover los labios y aún parecer alegre o distante.
- Reproduce sonido e imagen juntos. Decide si el rostro apoya la frase, la debilita o cambia su significado. Si falla, cambia una entrada o instrucción y revisa las mismas marcas de tiempo nuevamente.
| Momento en estos dos clips | Ejecución A, dirección contenida | Ejecución B, dirección sonriente | Qué apoya la comparación |
|---|---|---|---|
| Apertura | Ambas heredan la amplia sonrisa del retrato de origen | Ambas heredan la amplia sonrisa del retrato de origen | La expresión de origen es visible antes de que un cambio solicitado pueda afianzarse |
| Alrededor de 00:04 | La mirada baja y la boca es comparativamente neutral | La mirada permanece más cerca de la cámara con una expresión más ligera | La dirección cambia más que solo el movimiento de labios |
| Alrededor de 00:06 | Los ojos permanecen bajos; las manos están juntas | Los ojos miran a la cámara; queda una pequeña sonrisa | El mismo audio puede acompañar distintas señales emocionales visibles |
| Alrededor de 00:08 | Los ojos se cierran y la expresión permanece contenida | La mirada directa regresa, aunque la sonrisa se ha suavizado | Ninguno de los prompts se siguió palabra por palabra en todo momento |
Esta es una tabla de revisión útil, no una puntuación de calidad numérica. No ejecutamos suficientes muestras para separar los efectos del prompt de la variación aleatoria del modelo. Los videos permiten a un creador juzgar si esta toma particular sirve a la frase prevista.
Un contraste más amplio: ira y duelo de la misma frase
Las ejecuciones A y B mantuvieron fijos el retrato y la grabación para examinar un cambio de dirección. Para un contraste emocional más visible, hicimos dos nuevos clips cortos de la misma hablante y el mismo guion. Esta vez, la expresión de origen, la interpretación de voz y la dirección del video se emparejaron con el estado de ánimo previsto. El propósito es mostrar dos resultados finales prácticos, no afirmar que un solo parámetro causó la diferencia.
El guion compartido era: Prometiste que estarías aquí. Esperé toda la noche, mirando la puerta. No sé cómo confiar en ti después de esto. En el entorno de pruebas de Atlas, MiniMax Speech 2.6 HD lo leyó dos veces con la misma voz English_captivating_female1, idioma inglés, velocidad 1, volumen 1 y tono 0. Configuramos la emoción en angry para la primera grabación (6.73 segundos) y sad para la segunda (7.34 segundos). Ninguno de los archivos de audio está incrustado en este artículo; los GIF son silenciosos.
Partiendo de la misma foto sonriente usada anteriormente, hicimos dos retratos de referencia con Seedream v4.7 Edit. Estas son las entradas de imagen reales para el modelo de avatar:
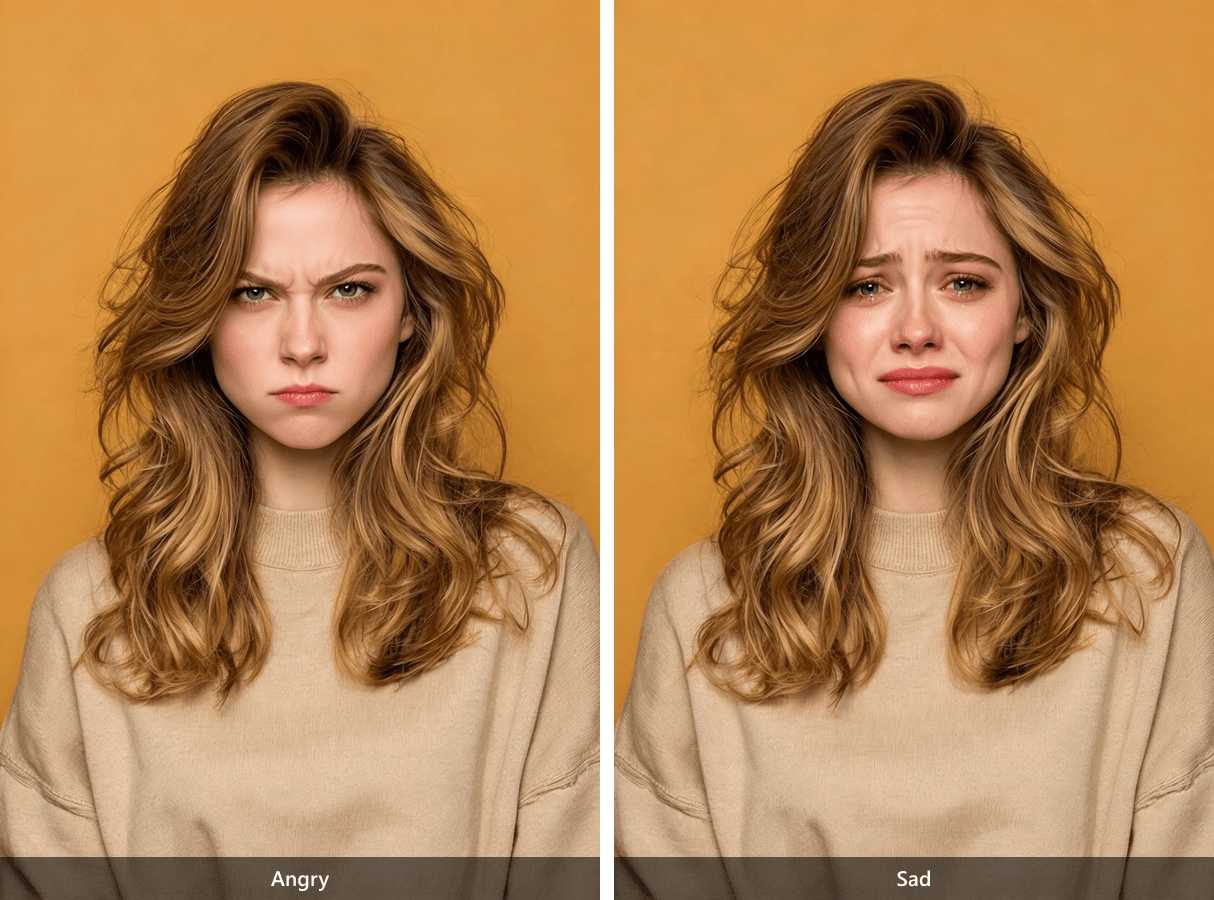
Izquierda: cejas bajas y fruncidas y boca firme. Derecha: cejas internas elevadas, ojos húmedos y boca hacia abajo. Ambos fueron editados del retrato sonriente original; la edición también cambia detalles faciales finos, por lo que las dos fuentes no son idénticas píxel a píxel aparte de la expresión.
La instrucción completa de edición de Seedream para el retrato de ira fue:
Edita el rostro de la mujer a una expresión claramente enojada y controlada: cejas bajas y fruncidas, ojos entrecerrados en una mirada directa y dura, mandíbula tensa, labios presionados firmemente. Mantén la misma identidad de la mujer, peinado, suéter beige, fondo naranja, iluminación, estilo fotográfico, ángulo de cámara y encuadre de retrato medio. Sin sonrisa, sin lágrimas, sin personas u objetos adicionales.
Para el retrato de duelo, usamos:
Edita el rostro de la mujer a un duelo visible: cejas internas elevadas y fruncidas, ojos húmedos y bajos, comisuras de la boca hacia abajo, labios suavemente cerrados, hombros ligeramente bajos. Mantén la misma identidad de la mujer, peinado, suéter beige, fondo naranja, iluminación, estilo fotográfico, ángulo de cámara y encuadre de retrato medio. Sin sonrisa, sin mirada enojada, sin personas u objetos adicionales.
Ambos clips de avatar terminados usaron Avatar Omni Human 1.5, salida 1080p y semilla 20261021. Duran 6.76 y 7.40 segundos, cerca de sus grabaciones correspondientes.
Ejecución C: ira después de una promesa rota
El retrato de ira y la grabación angry se emparejaron con esta dirección de video completa:
Ella habla directamente a la cámara con ira controlada. Sus cejas permanecen bajas y fruncidas, los ojos se entrecierran, la mandíbula se tensa y sus labios se presionan firmemente entre frases. En "promised", se inclina ligeramente hacia adelante y levanta una mano en un breve gesto señalador; en la última frase, mantiene una mirada directa y dura. Sin sonrisa, sin lágrimas. Mantén la cámara estable, primer plano medio, fondo naranja sin cambios.
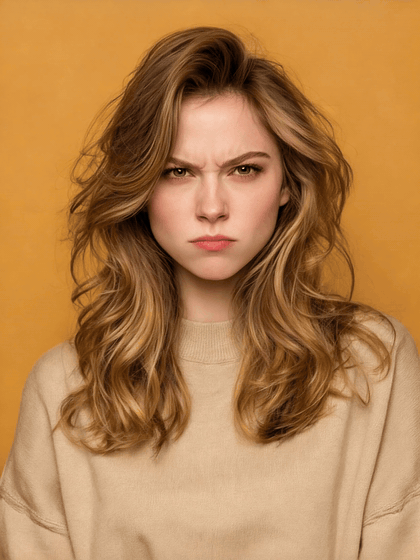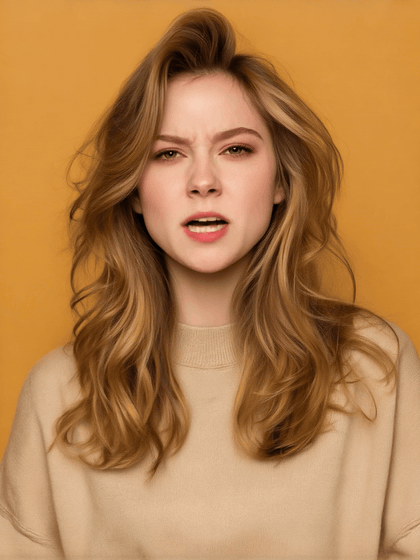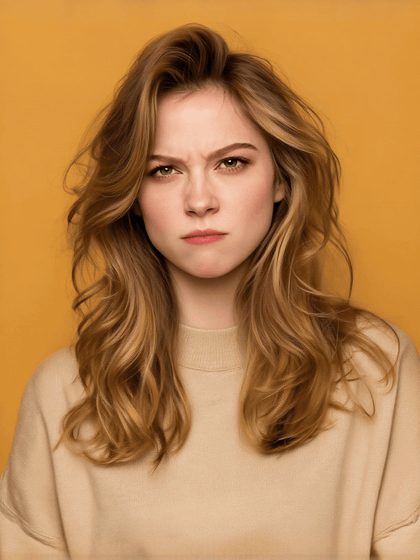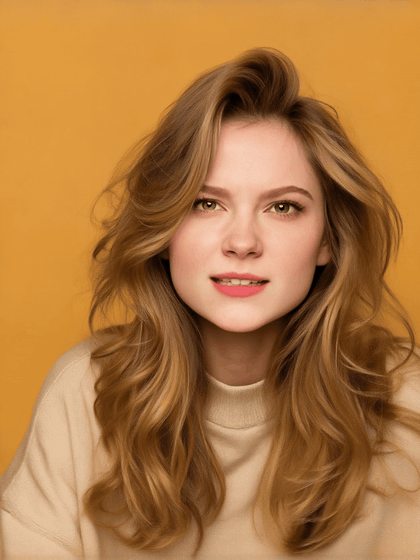
Ejecución C, entorno de pruebas de Atlas, Avatar Omni Human 1.5. Alrededor de la apertura y la mitad, ella habla con ojos entrecerrados y cejas fruncidas. La expresión se suaviza cerca del final; el gesto señalador solicitado con la mano no es claramente visible. Este GIF no tiene sonido.
Ejecución D: duelo después de la misma promesa rota
El retrato de duelo y la grabación sad se emparejaron con una dirección diferente:
Ella habla a la cámara con duelo. Sus cejas internas se elevan y se fruncen, los ojos se vuelven brillantes y bajos, los hombros bajan y su boca se relaja en un ligero gesto hacia abajo. En "waited all night", mira hacia abajo y hace una pausa; cerca de la última frase, vuelve a mirar hacia arriba sin sonreír. Sin mirada enojada ni gestos señaladores. Mantén la cámara estable, primer plano medio, fondo naranja sin cambios.
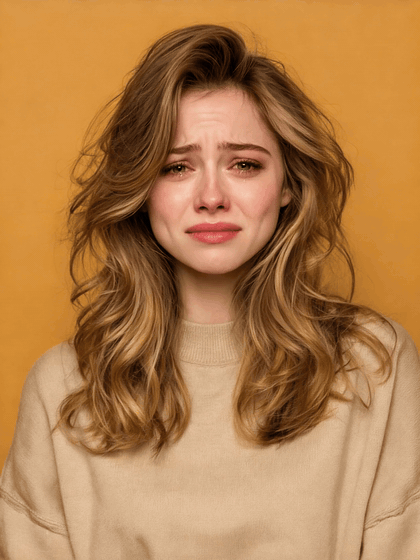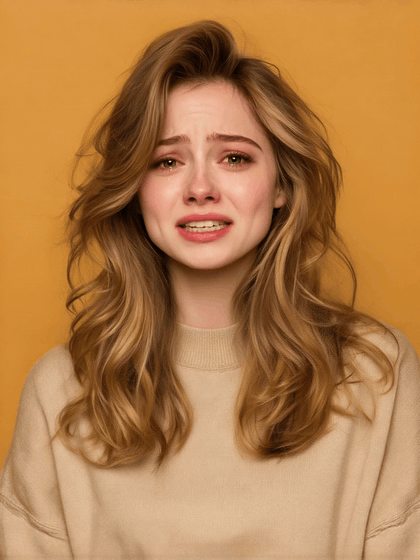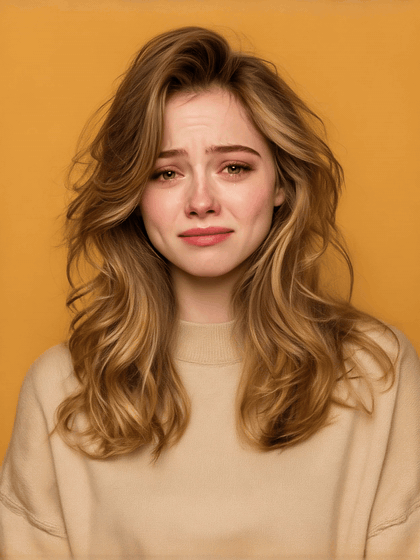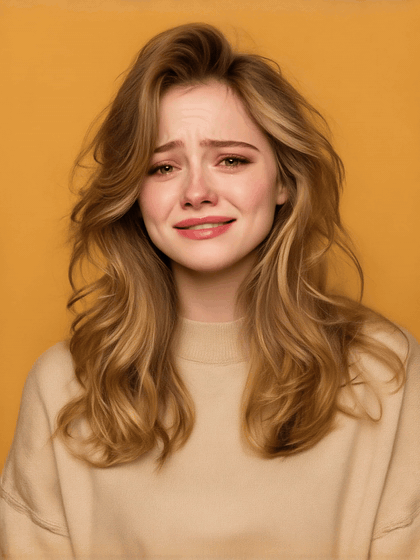
Ejecución D, entorno de pruebas de Atlas, Avatar Omni Human 1.5. Ojos húmedos, lágrimas y cejas internas elevadas permanecen visibles durante el clip. Ella mira mayormente a la cámara en lugar de mirar claramente hacia abajo en la frase solicitada. Este GIF no tiene sonido.
En los mismos momentos, C se ve tensa y confrontacional mientras que D se ve angustiada. La diferencia es visible en los videos completados, no solo en los fotogramas iniciales editados. Debido a que el retrato, la grabación y la dirección cambiaron juntos, estos ejemplos muestran un flujo de trabajo de entradas emparejadas en lugar de una prueba controlada de la emoción de la voz por sí sola. Para juzgar si alguno de los rostros sigue la interpretación con precisión, revisa su video original con sonido; un GIF silencioso no puede establecer la sincronización voz-expresión.
Prompt para habla o canto sin luchar contra la pista
Comienza con el evento de audio que quieres que los espectadores noten, luego nombra la acción visible más pequeña. Para una frase tranquila, solicita mirada baja o boca contenida en lugar de "máxima tristeza". Para un cambio genuino en la interpretación, coloca una sonrisa o un asentimiento después de la pausa audible. Si la grabación permanece triste de principio a fin, una expresión alegre durante todo el tiempo es un desajuste deliberado como la Ejecución B.
El canto usa el mismo principio de revisión, aunque no generamos un clip de canto para este artículo. Una dirección comprobable sería: Primer plano medio. La cantante se ve concentrada, cierra brevemente los ojos durante la nota sostenida, luego baja el mentón cuando termina la frase. Mantén la cámara estable. La canción proporcionada aún determina la letra, la duración de las notas y el tiempo. Juzga una salida real de canto con la música activada; un guion gráfico estático no puede establecer que el rostro siga una nota sostenida.
Mantén palabras temporales como "luego" o "al final" solo cuando la grabación tenga un pulso claro. Evita apilar direcciones conflictivas como "cámara fija" y "cámara en órbita". Si un prompt falla un pulso, simplifica o mueve una indicación en lugar de reescribir el retrato, el audio y la dirección a la vez.
Soluciona problemas de expresión plana o desajustada
| Lo que notas | Lugar probable a inspeccionar | Siguiente prueba más pequeña |
|---|---|---|
| Una frase triste comienza con una sonrisa | El retrato mismo está sonriendo | Prueba un retrato de origen cuya expresión inicial se adapte a la escena mientras mantienes fijos el audio y el prompt |
| El rostro permanece alegre durante una frase seria | El prompt solicita una sonrisa o una interpretación animada | Elimina esa instrucción y pide una acción contenida concreta |
| El rostro cambia pero la sincronización de la boca se siente mal | La grabación de origen, ediciones o toma generada | Usa una edición de audio más limpia y corta y compara las mismas palabras |
| Un prompt pide un pulso que nunca aparece | La grabación no tiene pausa o cambio audible | Mueve la dirección a una pausa real, o elimínala |
| Las dos salidas difieren menos de lo esperado | El modelo puede no seguir cada indicación de expresión | Prueba una toma adicional, luego juzga si la limitación importa para el caso de uso |
Las ejecuciones A y B también muestran por qué "más detalle en el prompt" no es una solución universal. Ninguna obedeció cada palabra de su dirección. El resultado útil es un diagnóstico más específico: la sonrisa de origen persiste en la apertura, mientras que la mirada y la expresión posteriores pueden diferir. Eso te dice qué parte cambiar a continuación.
¿Está OmniHuman 2.0 disponible en Atlas Cloud?
Sí, la página actual del modelo Atlas en inglés incluye Avatar Omni Human 2.0. Esto corrige la versión anterior de este artículo, que decía que el modelo estaba ausente del catálogo. Una inclusión no es lo mismo que una generación exitosa en todos los entornos. El 20 de octubre de 2026, nuestra solicitud de 2.0 a través del playground de desarrollo de Atlas se detuvo con el mensaje aguas arriba req_key <realman_avatar_picture_omni20_cv> not supported; su página decía que la solicitud fallida no fue cobrada. No se produjo ningún video 2.0 en ese intento. Los clips exitosos anteriores están etiquetados como 1.5 por esa razón.
Para un proyecto en vivo, abre la página exacta del modelo y confirma una ejecución completada con tus propias entradas. La página de 2.0 incluye una imagen, un MP3 o WAV de 4 a 300 segundos, dirección de prompt opcional y salida en 720p. La documentación de 1.5 tiene diferentes límites y opciones de resolución, así que no trates los clips de 1.5 de este artículo como un benchmark de 2.0. Consulta el catálogo actual de modelos de Atlas para disponibilidad en vivo y precios.
Verifica derechos y contexto antes de publicar
Antes de compartir una persona animada, confirma el permiso para usar el retrato y la voz para el propósito previsto. Revisa también los derechos de música, imagen, voz y distribución para el contexto. Etiqueta el metraje sintético o editado cuando los espectadores podrían confundirlo con material documental o una declaración actual de una persona real. Mantén juntos la imagen de origen, el audio, el prompt y la salida para que un colaborador pueda entender qué se generó realmente.
El siguiente paso útil para el emparejamiento de voz emocional y expresión facial de OmniHuman 2.0 es una prueba controlada con una salida 2.0 completada: elige una imagen cuya expresión inicial se adapte a la grabación, marca un pulso emocional, escribe una dirección visible, luego compara las mismas marcas de tiempo con el sonido activado y desactivado. Los cuatro videos de 1.5 anteriores muestran cómo realizar esa verificación y cómo puede verse una sonrisa conflictiva.
Preguntas frecuentes
¿OmniHuman 2.0 genera la voz en este flujo de trabajo?
La página del modelo Atlas describe una pista de audio subida como una entrada requerida. En este artículo, un modelo de voz MiniMax separado creó primero la grabación de voz; el modelo de avatar animó el retrato a partir de ese MP3. No trates la salida del avatar como evidencia de que inventó la línea hablada.
¿Por qué una voz triste todavía tiene una cara sonriente?
La imagen inicial y un prompt animado opcional pueden favorecer una sonrisa incluso cuando las palabras son tristes. Las ejecuciones A y B comenzaron con la misma foto sonriente, pero la mirada y la expresión posteriores difirieron cuando cambió la dirección. Revisa tu propio clip con sonido antes de decidir qué indicación domina.
¿Puede OmniHuman 2.0 animar el canto?
Atlas incluye el canto como un caso de uso para 2.0, con el audio proporcionando la interpretación. No completamos una ejecución de canto 2.0 aquí. Usa una sección corta con la voz al frente e inspecciona las notas sostenidas y los finales de frase en un video real con sonido.
¿Debería un prompt repetir el diálogo o la letra?
Generalmente no. El audio ya proporciona las palabras y el tiempo. Dirige la expresión visible, el gesto, el encuadre o la escena en términos que concuerden con la grabación.
¿Generó este artículo un video de OmniHuman 2.0?
No. La solicitud de 2.0 en el entorno de pruebas de Atlas falló antes de la renderización. Los dos resultados mostrados aquí como GIF se generaron allí con Avatar Omni Human 1.5 y están etiquetados en consecuencia.





