

Le pides a un personaje que haga un gesto a lo ancho del encuadre, pero tu imagen de origen es un primer plano del rostro. Ninguna frase ingeniosa puede restaurar con certeza los hombros, las manos o los detalles de la ropa que faltan. La generación de gestos de cuerpo completo de OmniHuman 2.0 a partir de una imagen funciona mejor como una elección coordinada: dale al modelo un encuadre que contenga las partes del cuerpo que quieres mover, audio con una señal clara de interpretación y un prompt breve que describa una acción.
OmniHuman es un sistema de generación de video humano impulsado por audio. Su flujo de trabajo anunciado combina una imagen fija y audio, con dirección de texto opcional para el movimiento o el comportamiento de cámara. Considera “cuerpo completo” como el tipo de interpretación que deseas, no como una garantía de que cada retrato pueda producir una figura completa y estable. Las especificaciones documentadas públicamente citadas aquí son para OmniHuman 1.5, por lo que no debe asumirse que describan cada interfaz o implementación de OmniHuman 2.0.
Puntos clave
- La imagen de origen define el área corporal visible y la composición inicial.
- El audio proporciona el ritmo del habla o del canto; un prompt añade dirección visual.
- Haz coincidir el recorte con el gesto y mantén la acción solicitada dentro del encuadre visible.
- Verifica la versión, los límites de entrada y el precio en la página oficial actual del producto antes de comprometerte.
Qué hace OmniHuman 2.0 para los gestos de cuerpo completo
OmniHuman 2.0 se presenta como una forma impulsada por imagen y audio de crear un video de interpretación humana. La imagen fija establece el sujeto y la vista inicial. El audio le da a la interpretación una voz, un ritmo y una referencia temporal. El texto opcional puede describir la escena, el movimiento o la dirección de cámara. El clip generado combina estas señales en un resultado en movimiento.
Eso hace que la tarea sea más amplia que hacer que una boca inmóvil se mueva. Una toma útil puede incluir movimiento de labios, expresión, movimiento de cabeza, postura y gestos con las manos. Esas partes deben concordar con la misma interpretación. Para una explicación hablada, un pequeño gesto de palma abierta en una frase importante puede leerse de forma más natural que un movimiento continuo de brazos. Para el canto, el cuerpo puede seguir el fraseo y la energía a lo largo de la pista.
El modelo no recibe un registro 3D completo de la persona a partir de una sola fotografía. Tiene que inferir qué hay fuera del recorte y cómo deberían verse las superficies ocultas mientras el sujeto se mueve. Por lo tanto, una solicitud de acción de cuerpo completo conlleva más incertidumbre cuando la entrada solo muestra el rostro. El control práctico consiste en elegir la imagen de referencia en función de la acción que necesitas y luego usar texto para refinar lo que ya está respaldado visualmente.
La página del proyecto de investigación de OmniHuman 1.5 describe la animación impulsada por audio a partir de una sola imagen y analiza el control de movimiento y de prompts. Eso es un contexto útil para la familia de modelos, pero no es prueba de que un prompt concreto de OmniHuman 2.0 vaya a producir un gesto específico cada vez (página del proyecto OmniHuman 1.5).
Antes de elegir las entradas, define la toma prevista en una sola frase: “un presentador de cintura para arriba enfatiza un punto”, “un intérprete de cuerpo completo desplaza el peso mientras canta” o “un hablante en primer plano pronuncia una frase con calma”. Así, el encuadre y el audio pueden servir a esa única tarea.
Elige una imagen de origen que deje espacio para el gesto
Para gestos de cuerpo completo, empieza con la imagen de origen más amplia que aún se ajuste a la composición final. Si el resultado está pensado como un video de una persona hablando en primer plano, un retrato cerrado puede ser adecuado. Si el espectador necesita ver una mano que señala un objeto o al sujeto desplazar su peso, incluye esas partes en la imagen de origen.
| Resultado previsto | Recorte inicial útil | Movimiento razonable que solicitar |
|---|---|---|
| Narración en primer plano | Cabeza y hombros | Expresión, giros de cabeza, movimiento contenido de hombros |
| Explicación de producto | De cintura para arriba con las manos visibles | Señalar brevemente, presentar o enfatizar con la palma abierta |
| Interpretación de pie | Figura completa con espacio alrededor del cuerpo | Cambios de postura, desplazamientos de peso y gestos más amplios |
Estas son decisiones de producción, no requisitos publicados por BytePlus ni garantías de éxito. Para un encuadre de cuerpo completo, deja algo de aire alrededor de las manos, los codos y los pies. Una mano que ya está contra el borde puede quedar recortada en cuanto se mueva. Mantén el rostro lo bastante claro para leerlo, usa luz uniforme cuando sea posible y evita una imagen de origen con otra persona que cruce al sujeto. Un fondo limpio también hace que sea más fácil detectar movimiento no deseado en el fondo.
La imagen debe parecerse a la toma que planeas publicar. Una imagen de origen en orientación retrato colocada en una salida horizontal puede requerir más fondo y área corporal inventados. Una imagen de origen con encuadre vertical suele ser más fácil de evaluar para un personaje de pie destinado a una publicación social vertical. Estas son pautas de composición; consulta los controles actuales de la herramienta objetivo para conocer los límites reales de relación de aspecto o resolución.
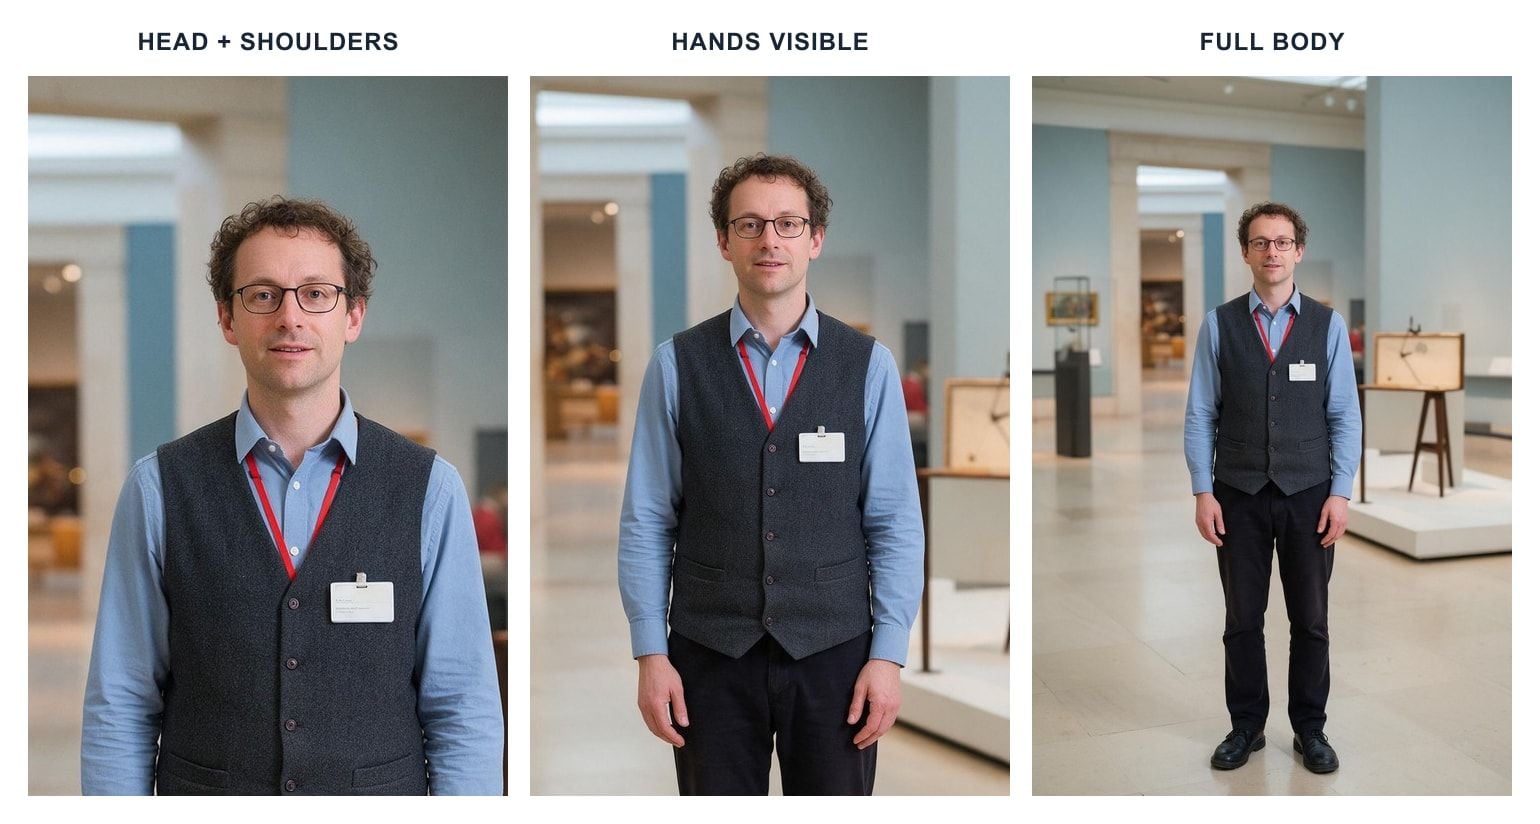
La misma foto de origen de ejemplo en tres recortes: un encuadre cerrado favorece la expresión facial, las manos visibles le dan espacio a un presentador para gesticular y la figura completa permite una interpretación de pie.
Una prueba de decisión sencilla ayuda: señala la parte del cuerpo que debe moverse en la toma final. Si no está en la imagen de origen, cambia la imagen o reduce el objetivo de movimiento. Por ejemplo, usa una imagen de cintura para arriba con las manos visibles para un presentador que enfatizará “tres pasos prácticos”. Un retrato solo del rostro encaja mejor con un saludo breve o una narración en primer plano.
Crea una interpretación a partir de una sola imagen con audio y dirección
Piensa en las entradas como tres trabajos distintos. La imagen responde quién está en pantalla y cómo empieza la toma. El audio transporta las palabras reales, las pausas y la energía vocal. La dirección de texto pide un comportamiento visual que encaje con esas señales. Mantén las entradas alineadas; una voz calmada combinada con “baile salvaje y constante” le da al modelo una dirección contradictoria y puede producir una interpretación torpe.
Un flujo de trabajo útil para una primera pasada es:
- Elige la toma. Decide si el espectador necesita un rostro en primer plano, las manos visibles o la figura completa. Selecciona una imagen de origen con esa área en el encuadre.
- Prepara audio representativo. Usa una sección corta de la voz en off o canción real, incluida la frase donde debería ocurrir el gesto. La prueba debe representar el ritmo y la entrega finales.
- Añade una idea de movimiento. Describe un solo gesto y dónde corresponde dentro de la interpretación. Mantén contenidas las demás acciones y solicitudes de cámara.
- Genera y revisa. Revisa el rostro, las manos, el cuerpo, el fondo y el encuadre general. Cambia una entrada a la vez en el siguiente intento.
Para una explicación de producto, una línea de prueba original podría ser: “Cubriremos tres pasos prácticos y luego podrás elegir el que se ajuste a tu equipo”. Grábala con una breve pausa antes de la frase “tres pasos prácticos”. Usa una imagen de cintura para arriba con ambas manos visibles. Eso le da al gesto previsto una señal semántica clara y un rango de movimiento visible.
La documentación oficial de BytePlus que puede verificarse aquí se refiere a OmniHuman 1.5, no a 2.0. Para 1.5, enumera una imagen y audio como entradas requeridas, un prompt opcional, idiomas de prompt admitidos y salida en 720p o 1080p. Su descripción general también indica un límite de audio de 60 segundos y recomienda audio más corto para mejorar la calidad. Estos detalles ayudan a distinguir el producto 1.5 documentado; verifica la interfaz o la documentación oficial de 2.0 antes de aplicar cualquiera de ellos a 2.0 (documentación de generación de video OmniHuman de BytePlus, actualizada en octubre de 2026).
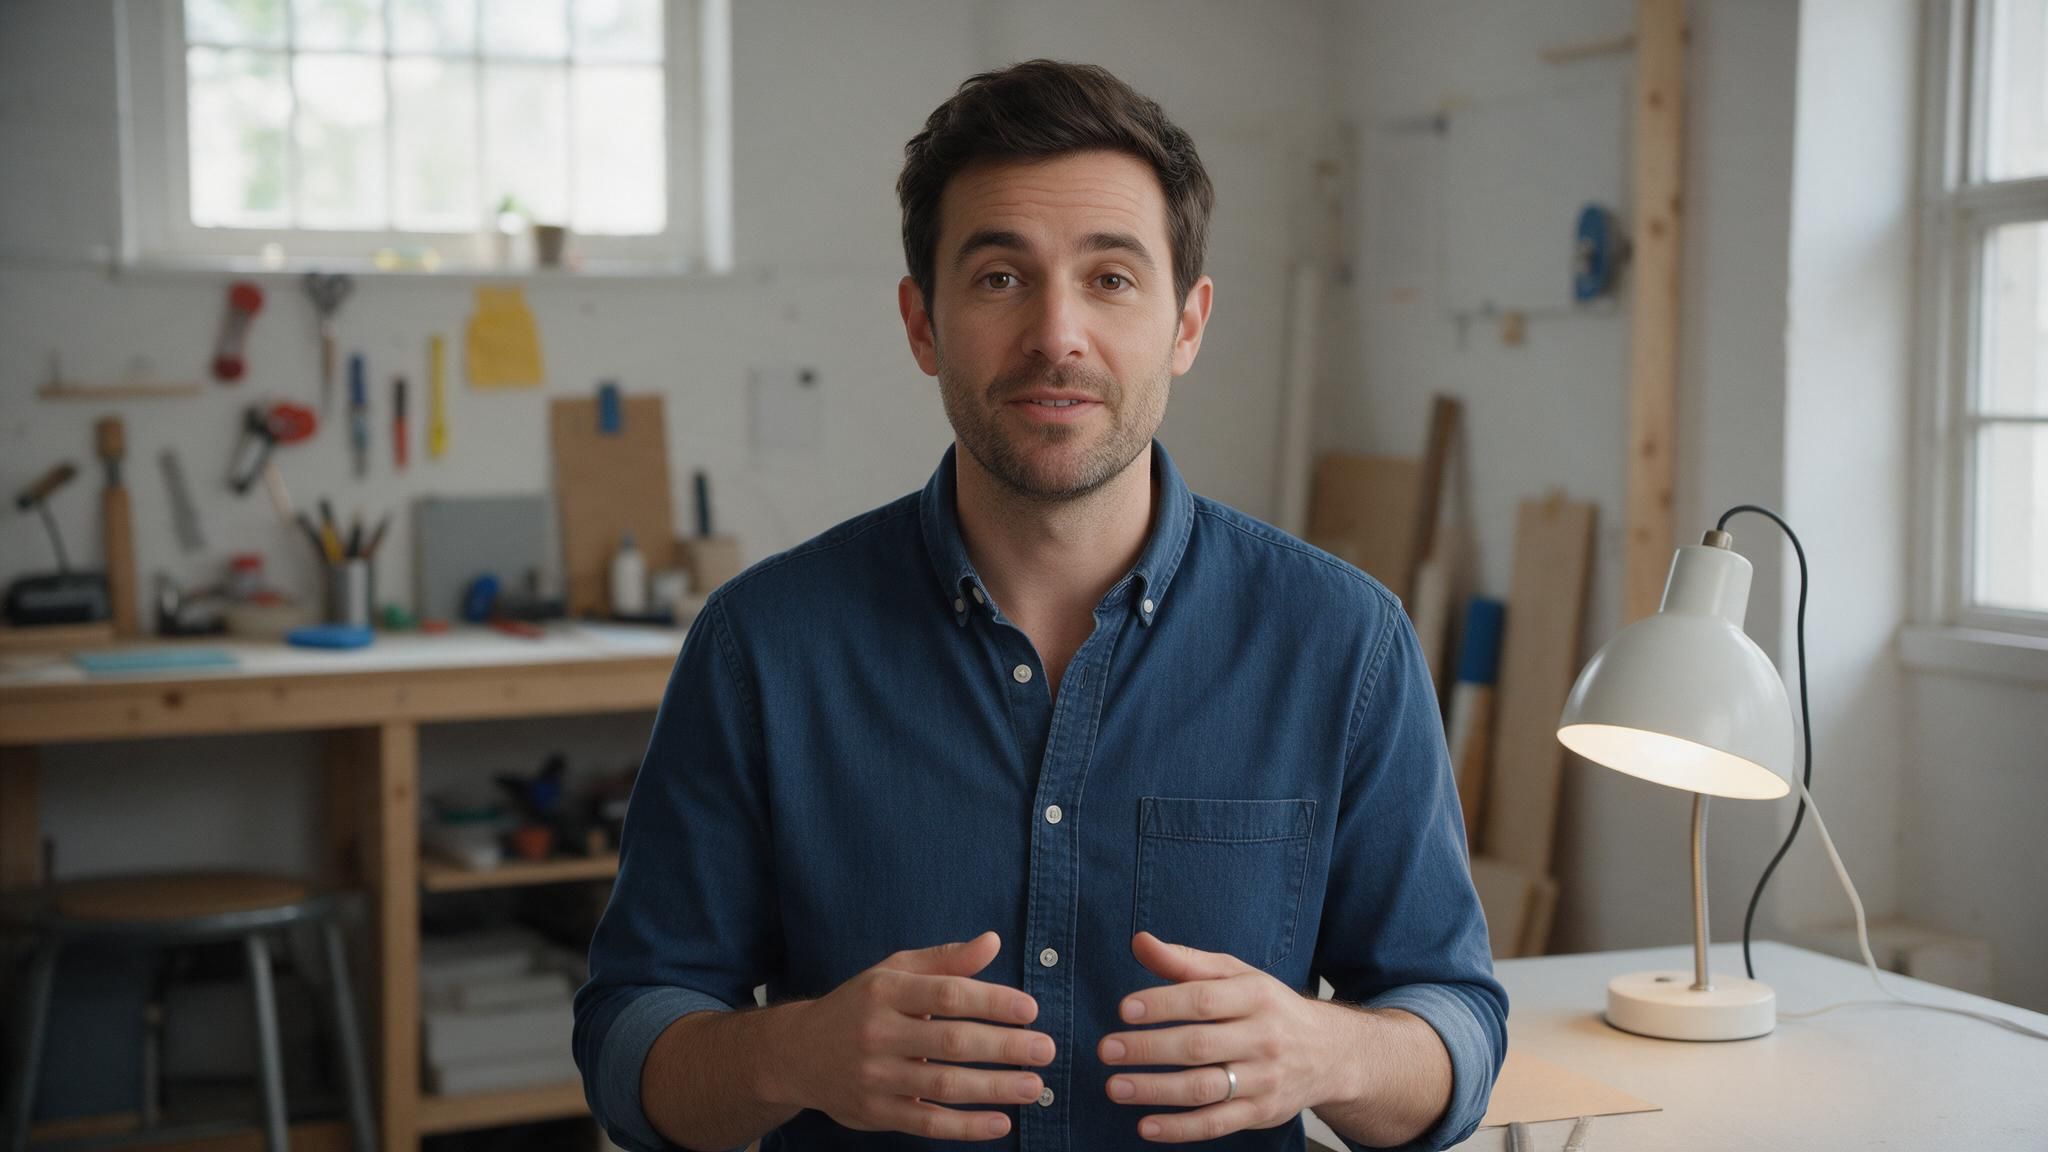
Imagen fija de origen de ejemplo para la explicación de producto: el rostro del presentador, ambas manos y la lámpara son visibles, lo que facilita evaluar un pequeño gesto de mano sincronizado. Esta es una foto de entrada, no una salida de OmniHuman.
Usa una muestra representativa antes de preparar una grabación larga. Una prueba corta permite detectar más rápido un recorte que no encaja, una frase sin señal de gesto o un prompt que pide demasiado. Es una decisión de control de calidad, no una afirmación sobre un límite de duración específico de 2.0.
Escribe prompts de gestos con una señal clara
Un prompt se vuelve más fácil de evaluar cuando nombra una acción, su señal, su tamaño o ritmo y cualquier restricción de encuadre. Una instrucción amplia como “haz que la persona sea natural y expresiva” deja varias decisiones abiertas. Una instrucción enfocada le dice al modelo qué acción visible importa y cuándo debe ocurrir.
Prueba este ejemplo con la línea de muestra anterior:
El hablante pronuncia la frase con un tono calmado y seguro. Mantén la cámara fija. Cuando el hablante diga “tres pasos prácticos”, levanta una mano brevemente para enfatizar el punto y luego bájala con naturalidad. Usa gestos pequeños y relajados que permanezcan dentro del encuadre visible.
La frase entre comillas conecta la acción con un momento del audio. “Levanta una mano brevemente” da un gesto acotado, y “permanezcan dentro del encuadre visible” evita pedir movimiento más allá del recorte. Esta es una plantilla para escribir prompts, no un comando probado ni garantizado de OmniHuman 2.0. Si el sistema no sigue las palabras exactas ni los tiempos de forma consistente, mantén la frase como una señal amplia y evalúa el movimiento renderizado en lugar de asumir una coreografía con precisión de fotograma.
Cambia solo una variable principal entre intentos. Si el gesto aparece demasiado pronto, ajusta la señal o la pausa del audio. Si el movimiento de la mano es demasiado grande, reduce la amplitud solicitada. Si el brazo es inestable o está inventado en parte, elige una imagen de origen donde el brazo ya sea visible. Cambiar la imagen, el audio, el movimiento y la dirección de cámara a la vez dificulta saber qué cambio ayudó.
Evita acumular solicitudes no relacionadas: un saludo con la mano, una señal, un giro, un paseo, una órbita de cámara y un cambio emocional, todo en una misma línea corta. Cada una añade otra exigencia a la misma interpretación. Empieza con un movimiento con propósito; añade un segundo solo si el primer resultado sigue siendo legible y la escena lo requiere.
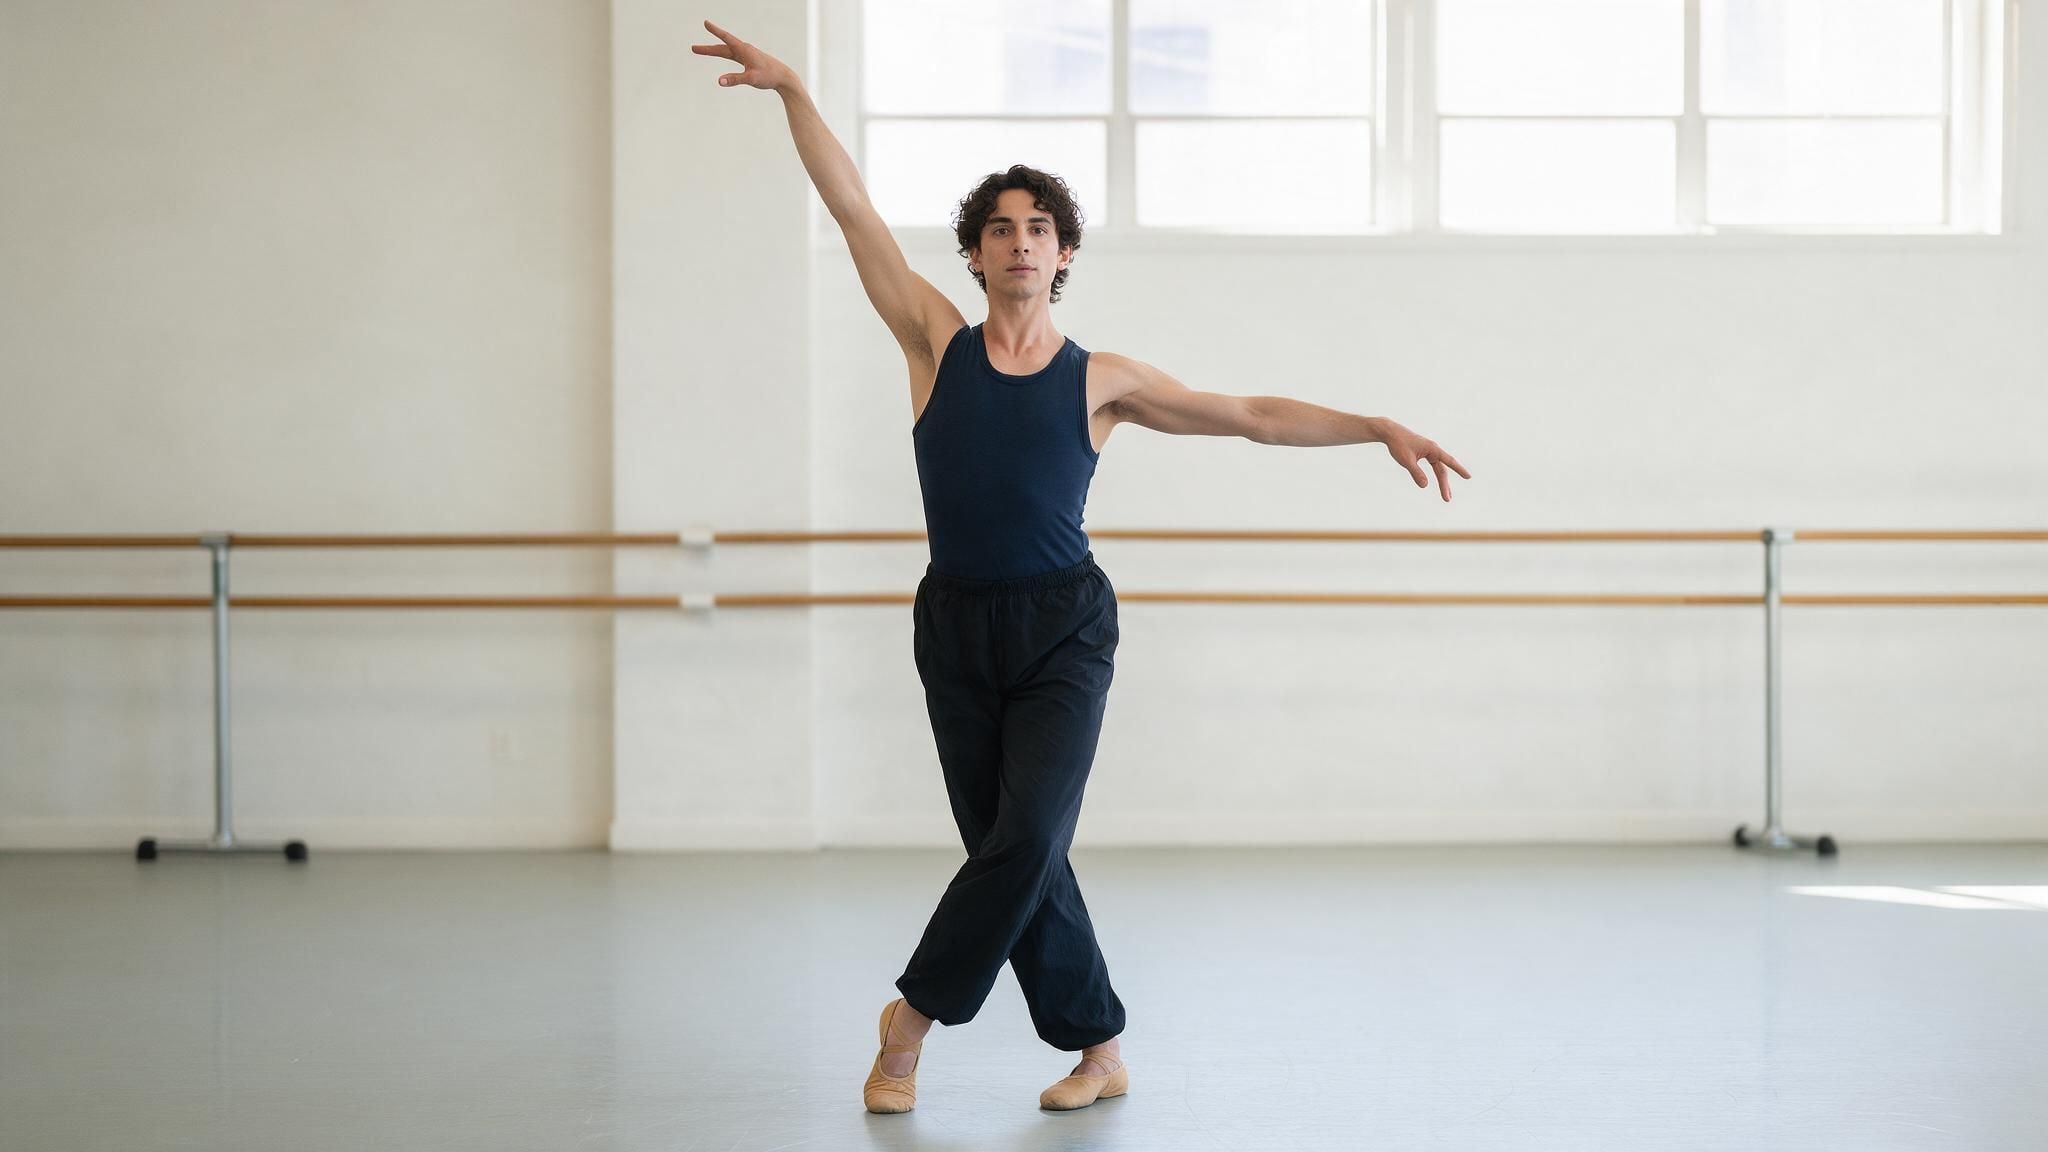
Imagen fija de origen de ejemplo para una pose coordinada de cuerpo completo: el brazo levantado, el brazo extendido y los pies en paso permanecen dentro del encuadre. Esta es una imagen de referencia para planificar un gesto, no un fotograma generado por OmniHuman.
Revisa el resultado antes de publicar
Mira el resultado una vez para la interpretación general y luego otra vez para detalles específicos. La segunda visualización es útil porque un clip puede parecer plausible a velocidad normal y, al inspeccionarlo más de cerca, revelar un problema en la mano o el fondo.
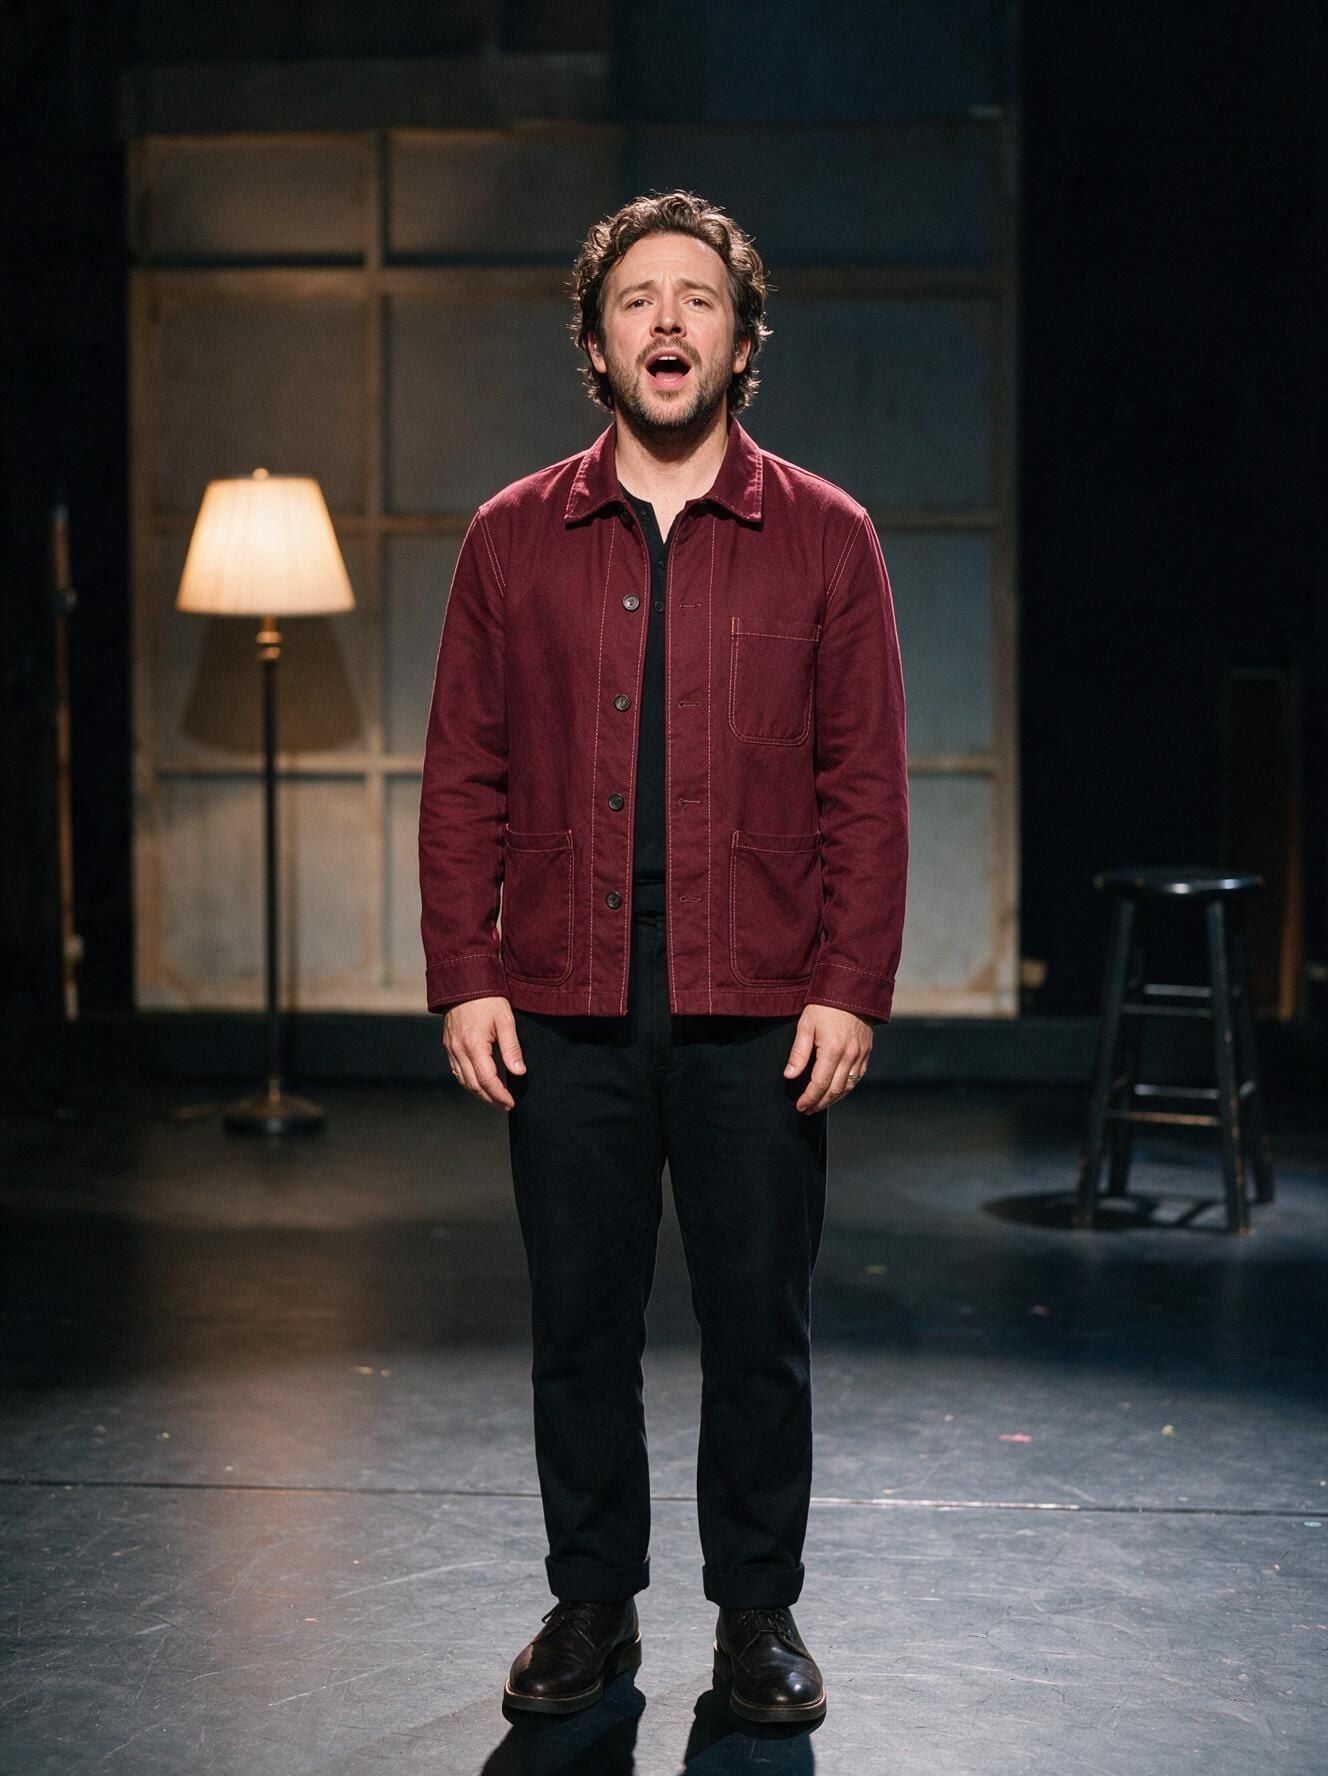
Imagen fija de origen de ejemplo para una interpretación de pie: compara cualquier toma generada con el rostro, las manos, la chaqueta, los zapatos, la lámpara y el taburete visibles al verificar la identidad y la consistencia de la escena. Esta es una foto de entrada, no un fotograma generado.
Revisa estas cinco áreas:
- Habla y expresión: ¿La boca sigue en términos generales la frase hablada o cantada? ¿Las expresiones encajan con la entrega vocal?
- Sincronización del gesto: ¿El movimiento aparece cerca de la idea o pausa previstas? ¿Se detiene cuando termina el énfasis?
- Manos y cuerpo: Busca dedos fusionados brevemente, articulaciones dobladas, mangas que cambian o proporciones corporales que varían entre fotogramas.
- Identidad y escena: ¿El rostro sigue siendo reconocible? ¿La ropa, los objetos del fondo y la iluminación se mantienen razonablemente consistentes?
- Encuadre de la entrega: ¿Se cortan las manos o los pies? ¿El sujeto permanece claro en la relación de aspecto y el recorte que necesitas?
Cuando algo falle, vincula el siguiente intento con la causa observada. Reemplaza la imagen cuando falte el área corporal necesaria o el recorte no deje espacio para el movimiento. Reemplaza o acorta el audio cuando la frase clave sea apresurada, poco clara o no coincida emocionalmente. Reescribe la dirección cuando la acción llegue en el momento equivocado o sea demasiado amplia. Si el clip es para una campaña pública, confirma también que tienes permiso para animar la imagen y usar la grabación de voz, y obtén cualquier consentimiento requerido para las personas representadas.
Un resultado útil no es necesariamente el que tiene más movimiento. Para una introducción de curso o una explicación de producto, un gesto contenido que preserve la identidad y mantenga al sujeto dentro del encuadre puede comunicar mejor que una acción elaborada que llame la atención sobre errores visuales. Conserva la toma que respalde el mensaje y cumpla con el formato de publicación; luego guarda juntos la imagen de origen, el audio, el prompt y la salida seleccionada para futuras revisiones.
Acceso, versiones y precios de OmniHuman 2.0
BytePlus incluye OmniHuman V2.0 en su documentación de planes de ahorro para modelos de video. Eso confirma que el nombre de la versión aparece en materiales de BytePlus, pero no establece un playground público de 2.0, límites de entrada detallados ni un endpoint de Atlas Cloud (BytePlus AI Savings Plans). Verifica la versión exacta del modelo antes de construir un flujo de trabajo en torno a él. El nombre “OmniHuman 2.0” no debe tratarse como intercambiable con “OmniHuman 1.5”. La documentación de BytePlus que aparece actualmente para este artículo está etiquetada como OmniHuman 1.5. Documenta su propio esquema de entrada y restricciones de servicio, que no deben trasladarse a 2.0 sin una fuente oficial correspondiente.
En el momento en que se verificó para este artículo, el directorio público de modelos de Atlas Cloud mostraba un catálogo amplio de modelos, pero no se pudo verificar allí ninguna página de detalles de OmniHuman 2.0. La página del modelo Avatar Omni Human específica identifica la oferta adyacente de 1.5. Su precio inicial mostrado se ha reportado como $0.12 por segundo en los materiales oficiales, pero los precios y descuentos pueden cambiar. Vuelve a revisar la página de detalles y el directorio de modelos de Atlas Cloud antes de presupuestar o publicar. No uses el precio de 1.5 como estimación para 2.0.
Si necesitas específicamente OmniHuman 2.0, confirma su ruta de acceso oficial, los requisitos de entrada actuales y el precio con BytePlus antes de preparar activos de producción. Si estás abierto a una versión adyacente, el directorio de Atlas Cloud puede ayudarte a verificar qué modelos de video y avatar listados actualmente están disponibles desde un solo catálogo. Trata eso como una elección de producto separada: una ejecución de 1.5 no puede validar un prompt ni un resultado de 2.0.
Preguntas frecuentes
¿Puede OmniHuman 2.0 generar un video de cuerpo completo a partir de una imagen solo del rostro?
Una imagen solo del rostro no muestra el detalle corporal necesario para guiar una interpretación de cuerpo completo. Un sistema puede inferir las áreas que faltan, pero su apariencia y movimiento están menos directamente fundamentados en la imagen de origen. Para un gesto con la mano, usa una imagen de origen que muestre la mano y suficiente brazo. Para una acción de pie, empieza con una imagen de cuerpo completo.
¿OmniHuman 2.0 necesita audio, o puede un prompt de texto animar la imagen por sí solo?
El flujo de trabajo descrito de OmniHuman se basa en una imagen y audio, con dirección de texto opcional. No asumas que el servicio 2.0 exacto que planeas usar admite animación de imagen solo con texto. Consulta la página actual del producto de ese servicio para conocer las entradas que acepta.
¿Cuánto puede durar una entrada de audio de OmniHuman 2.0?
No pude verificar un límite oficial actual de duración de audio para 2.0. La descripción general publicada de 1.5 de BytePlus indica un límite inferior a 60 segundos y recomienda entradas más cortas para la calidad, pero eso es una especificación de 1.5. Confirma el límite de 2.0 en su punto de acceso oficial antes de grabar o subir una pista larga.
¿Ya está OmniHuman 2.0 disponible en Atlas Cloud?
No se pudo verificar ningún listado público de OmniHuman 2.0 en el directorio de Atlas Cloud cuando se revisó este artículo. La página adyacente de OmniHuman de Atlas Cloud es para 1.5. Vuelve a consultar el directorio antes de usarlo, ya que la disponibilidad del catálogo puede cambiar.
Antes de comenzar tu próximo intento de generación de gestos de cuerpo completo de OmniHuman 2.0 a partir de una imagen, toma primero una decisión: identifica el área corporal que debe mostrar la toma final y luego elige una imagen de origen que ya la contenga. Verifica la versión exacta y los límites actuales en el servicio que usarás, y prueba un pasaje de audio corto y representativo antes de preparar la toma de producción completa.





