MiniMax lanzó H3 el viernes. En menos de veinticuatro horas, Seedance 2.5 ya estaba en manos de la gente, y la línea de tiempo colapsó en una conversación: treinta segundos, 4K nativo, cincuenta entradas de referencia. La publicación de lanzamiento de H3 quedó debajo, en silencio, con casi nadie ejecutando una prueba real.
Entiendo por qué. Treinta segundos es un número excelente. Encaja en un titular.
Pero si realmente produces dramas cortos verticales, sabes que lo que arruina tu noche no es el segundo treinta. Es el plano 4. La mandíbula del protagonista masculino se desplaza medio centímetro, su corbatín pierde un pliegue, y el espectador se desliza antes de que el gancho aterrice. Nadie abandona porque un clip durara quince segundos en lugar de treinta. Abandonan porque el tipo del primer plano no es el tipo del plano general.
Así que me salté el duelo de especificaciones. Construí una hoja de referencia de personaje, un tablero de localización de seis paneles, escribí un prompt de drama corto gótico de 15 segundos, y envié el paquete idéntico a ambos lados. Luego me quedé mirando la cara.
Conclusiones clave
- Solo H3 se puede llamar hoy — La API de Seedance 2.5 está disponible en ByteDance, pero sigue siendo una página de Día 0 en esta plataforma.
- Las especificaciones se dividen claramente: Seedance 2.5 = 30s en una sola toma, 4K nativo, hasta 50 referencias; H3 = 5–15s, 2K, audio estéreo en cada clip.
- La estabilidad del personaje es un problema de empaquetado — un buen paquete de referencia, no un modelo más grande, mantiene el rostro.
- Ambos generan audio nativo; H3 también fija una voz a partir de hasta tres referencias de audio.
- Juzga píxeles por fotograma, no segundos — en la misma ejecución, H3 devolvió 1440p frente a 720p de Seedance.
El resultado de Seedance 2.5 vs MiniMax H3, antes de cualquier teoría
Antes de cualquier teoría, esto es lo que produce el flujo de trabajo. Estas son cuatro tomas extraídas de un clip vertical terminado de 15 segundos y dispuestas en mosaico. Es la propia ejecución de referencia H3 de MiniMax construida exactamente a partir de la hoja de personaje y el tablero de localización que verás en el Paso 1 y el Paso 2, en 1440x2560 nativo. Mis propias ejecuciones del mismo paquete vienen más adelante, en el tutorial, con el estado del playground visible.
Ella llega a la puerta tallada, que es el panel 4 del tablero de localización, luego el enfrentamiento en el pasillo, luego un primer plano cerrado de él, luego el plano de dos. Su línea del cabello se separa de la misma manera en el perfil y en el primer plano. Su corona trenzada a medio recoger sobrevive a un primer plano de rostro completo, que es exactamente donde la mayoría de los modelos reconstruyen silenciosamente un rostro. El corpiño de encaje color crema mantiene el mismo escote y puño de manga desde el primer fotograma hasta el último.
Esa es toda la prueba. No treinta segundos. Cuatro tomas y una mandíbula.
Por qué Seedance 2.5 vs MiniMax H3 se lanzaron la misma semana, y por qué la mayoría de las pruebas de personajes son inútiles
MiniMax lanzó H3 el 30 de julio, un modelo de video multimodal de propósito general que lee texto, imágenes, video y audio como un solo contexto y devuelve clips de 5 a 15 segundos en hasta 2K con sonido estéreo nativo. También puede editar metraje existente y transferir movimiento de un clip a otro, y MiniMax dijo que los pesos seguirían en días (Reuters, julio de 2026).
Seedance 2.5 aterrizó en la misma ventana con un número más llamativo: 30 segundos en una sola generación, 4K nativo y hasta 50 entradas de referencia multimodal en un solo trabajo (The Next Web, julio de 2026). Su API ya está en manos de desarrolladores, con edición localizada que redibuja parte de un fotograma mientras deja intactos el rendimiento, la iluminación y el comportamiento de la cámara, referencia a video que acepta placas de croma o maquetas 3D en blanco, once idiomas y un modo de video largo experimental que alcanza los 180 segundos (CineD, julio de 2026).
La brecha de atención es la parte interesante. Casi todas las publicaciones que pude encontrar eran un clip de 2.5. Mientras tanto, los números de la arena pública dicen algo más: en el leaderboard de imagen a video de Artificial Analysis, Seedance 2.0 a 720p lidera con 1196 Elo, Gemini Omni Flash le sigue con 1195, y MiniMax H3 ya es tercero con 1185, cuatro días después de su lanzamiento. Seedance 2.5 aún no tiene calificación allí (Artificial Analysis, julio de 2026). El modelo con menos ruido es el que tiene la mayor relación entre puntuación y atención.
Ahora la parte que realmente decide tu resultado, porque casi no tiene nada que ver con qué logo elijas.
La mayoría de las pruebas de consistencia de personajes fallan antes de que el modelo siquiera participe. Cuatro modos de fallo, y los cuatro son tuyos para arreglar:
| Modo de fallo | Lo que ves en el resultado | La solución |
|---|---|---|
| Referencias multivista enviadas como archivos separados | El rostro de cada plano es "casi correcto" y ninguno coincide | Compone las vistas en una sola imagen, luego asigna roles en el prompt ("el hombre a la IZQUIERDA", "la mujer a la DERECHA") |
| Reescribir la descripción del personaje por plano | El vestuario y los accesorios varían de un plano a otro | Escribe el bloque de identidad una vez y reutilízalo textualmente; solo cambian la cámara y la acción por plano |
| Dejar que la iluminación se mueva con la escena | El rostro se reconstruye estructuralmente con la nueva luz | Construye un tablero de localización separado que fije la dirección de la luz, la niebla y el reflejo del suelo, y úsalo como referencia |
| Tratar la duración máxima como una métrica de calidad | Una deriva dentro de 30 segundos arruina los 30 | Reduce a la granularidad que puedas regenerar, luego habla de duración |
¿Quieres poner a Seedance 2.5 y MiniMax H3 frente al mismo prompt tú mismo? La comparación de modelos de Atlas Cloud los ejecuta uno al lado del otro en una sola pasada — prompt y configuraciones idénticos, con el costo estimado antes de generar — para que puedas juzgar rostros, movimiento y texto en pantalla sin reservar dos pruebas separadas.
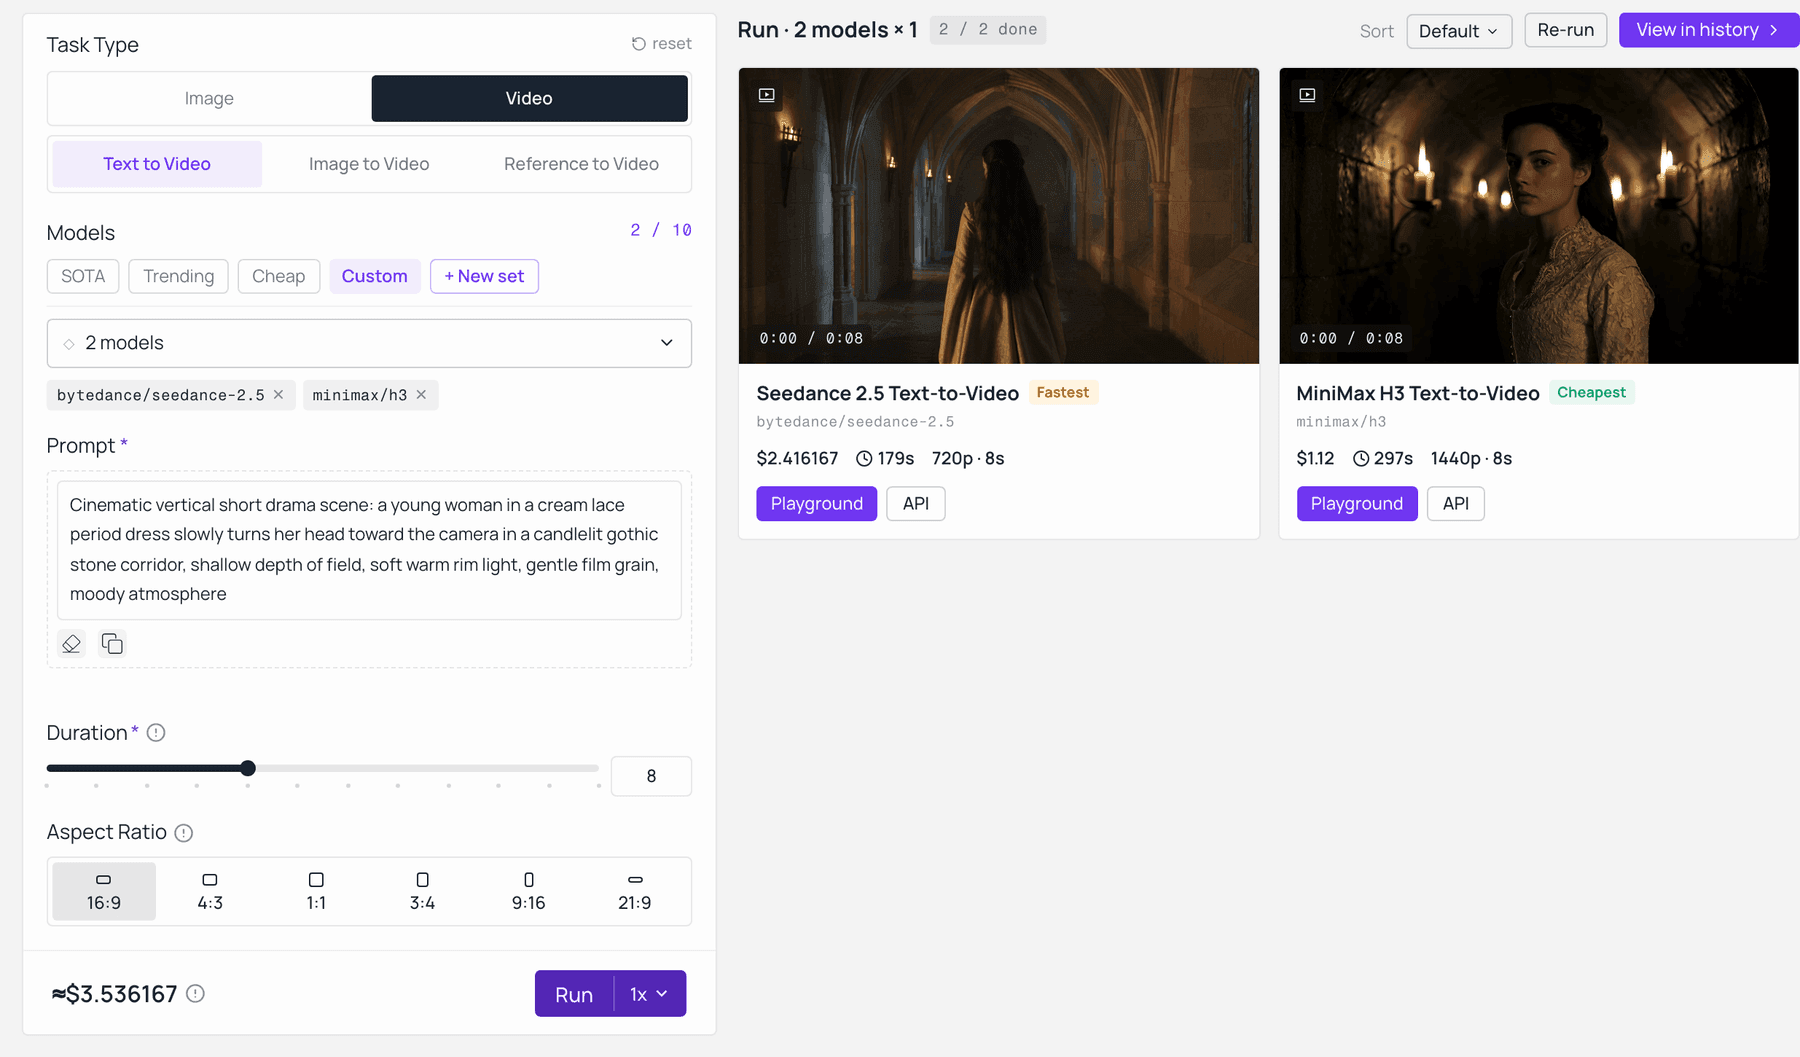
Seedance 2.5 y MiniMax H3 en el prompt idéntico en la comparación de modelos de Atlas Cloud. Seedance 2.5 devolvió 720p a $2.42; MiniMax H3 devolvió 1440p por $1.12, y ambos precios se estimaron antes de la ejecución. Capturado en vivo en el explorador de modelos.
La fila uno es la que la gente se equivoca con más frecuencia. Envía seis imágenes de una sola vista y el modelo las trata como seis candidatos a persona y las promedia. Envía un solo compuesto limpio y los trata como una sola persona vista desde tres lados. Mismos píxeles, resultado completamente diferente.
Hoja de especificaciones de Seedance 2.5 vs MiniMax H3, y lo que realmente puedes llamar hoy
Separa la capacidad de la disponibilidad y la tensión se vuelve clara. En capacidad bruta, Seedance 2.5 lidera en duración, techo de resolución, número de referencias y granularidad de edición. En disponibilidad, H3 es el que tiene tres endpoints activos en una plataforma de modelo de propósito general esta semana. Si estás haciendo comparación de modelos de video IA para la planificación de 2026, esa segunda columna importa tanto como la primera.
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-to-Video (lo que ejecuté) | |
|---|---|---|---|
| Duración máxima, una generación | 5 a 15 s | hasta 30 s, sin costuras (modo beta a 180 s, experimental) | menú de clips cortos, ver página del modelo |
| Resolución | 2K nativo, 1440p lado corto en 16:9 a 9:16; un nivel de 768p aparece como próximo | 4K nativo, color de 10 bits | hasta 720p en este endpoint |
| Fotogramas por segundo | 24 fps | no publicado por separado | no publicado por separado |
| Entradas de referencia | 9 imágenes + 3 videos + 3 audios, 12 archivos en total | hasta 50 referencias multimodales | 9 imágenes + 3 videos + 3 audios |
| Audio nativo | sí, cada salida, estéreo | sí, más 11 idiomas de subtítulos y voz | sí |
| Granularidad de edición | ediciones de instrucción de clip completo (intercambiar personaje, fondo, iluminación, diálogo) | ediciones a nivel de región que redibujan parte de un fotograma | ediciones de instrucción de clip completo |
| Límite de prompt | 7000 caracteres | no publicado | no publicado |
| Pesos abiertos | anunciados para días después del lanzamiento | no anunciados | no anunciados |
| Elo I2V de Artificial Analysis, 31 jul 2026 | 1185 (3º) | aún no calificado | 1196 (1º, entrada Dreamina 720p) |
| Invocable en la plataforma que probé | sí, 3 endpoints | aún no, página de Día 0 | sí |
Divulgación completa sobre la configuración de la prueba. Seedance 2.5 no estaba abierto en mi plataforma cuando ejecuté esto, así que el lado de Seedance es Seedance 2.0 Reference-to-Video, el miembro actualmente en envío de la misma familia con el mismo sistema de referencia cuadrimodal. Donde 2.5 cambiaría la respuesta, lo digo. La página de Seedance 2.5 es un aviso de Día 0 por ahora.
Todo lo siguiente se ejecuta en una sola pestaña del navegador, con una clave, tres modelos en total:
| Paso | Modelo | Lo que produce | Configuraciones clave | Lo que impulsa el costo |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | la hoja de referencia del personaje | calidad alta, 16:9 | por imagen, pago por uso, tarifa actual en la página del modelo |
| 2 | mismo modelo, segunda ejecución | el tablero de localización e iluminación de seis paneles | calidad alta, 16:9 | por imagen, pago por uso |
| 3 | MiniMax H3 Reference-to-Video | el clip 9:16 con audio nativo | 9:16, 2K, duración 5 para prueba y 15 para el corte real | segundos x resolución, facturado por segundo |
| 4 | Seedance 2.0 Reference-to-Video | la ejecución de control, entradas idénticas | 9:16, resolución máxima disponible, misma duración | segundos x resolución, facturado por segundo |
| 5 | H3 Reference-to-Video, clip como entrada | una toma fija sin regenerar todo | misma resolución, duración corta | segundos x resolución, facturado por segundo |
H3 también tiene entradas de texto a video e imagen a video si quieres una línea base de solo texto o control de primer y último fotograma.
Una cosa más que vale la pena saber antes de planificar un lote: texto en pantalla. Esta secuencia de título H3 de 15 segundos mantiene los créditos en inglés a través de ocho cortes duros sin una sola falta de ortografía, que es una de las cosas más difíciles de mantener estable en video generado.
El flujo de trabajo de drama corto Seedance 2.5 vs MiniMax H3, paso a paso
Cinco pasos. Copia los prompts exactamente como están escritos, incluyendo las partes feas. No los limpié para el artículo y no deberías limpiarlos para el modelo.
Paso 1: Construir la hoja de personaje con GPT Image 2
Haz el paquete de referencia antes de hacer cualquier video. Una imagen, dos personajes, tres vistas cada uno, fondo blanco puro sin costuras, iluminación de estudio uniforme. Eso elimina toda ambigüedad excepto la que te importa: ¿cómo es esta persona?
plaintext1Una hoja de referencia de personaje de cuerpo completo sobre un fondo blanco puro sin costuras, dos personajes lado a lado, seis figuras en total, iluminación de estudio neutra y uniforme, sin sombras en el suelo, sin texto, sin etiquetas, sin marca de agua. 2 3MITAD IZQUIERDA, protagonista masculino, tres vistas en fila: frente, perfil derecho, espalda. Finales de los 20, tez pálida, cabello oscuro ondulado de longitud media, mandíbula marcada. Vistiendo un abrigo cruzado de terciopelo negro hasta el suelo con bordado sutil tono sobre tono en las solapas y puños, un chaleco de brocado negro, una corbata de seda negra, pantalones negros rectos, zapatos de charol negro con cordones. Brazos relajados a los costados, expresión neutra. 4 5MITAD DERECHA, protagonista femenina, tres vistas en fila: frente, perfil derecho, espalda. Principios de los 20, tez clara, cabello largo ondulado castaño claro con una corona trenzada a medio recoger. Vistiendo un vestido victoriano de encaje de algodón color crema, mangas largas con puños de encaje, corpiño ajustado con botones pequeños, falda larga hasta el tobillo, zapatos de tacón bajo con correa al tobillo color crema. Brazos relajados a los costados, expresión neutra. 6 7Realismo fotográfico, escala consistente entre las seis figuras, pies alineados en la misma línea base, enfoque nítido de borde a borde.
Configuraciones: modelo OpenAI GPT Image 2 Text-to-Image, Calidad alta, Relación de aspecto 16:9, todo lo demás por defecto.
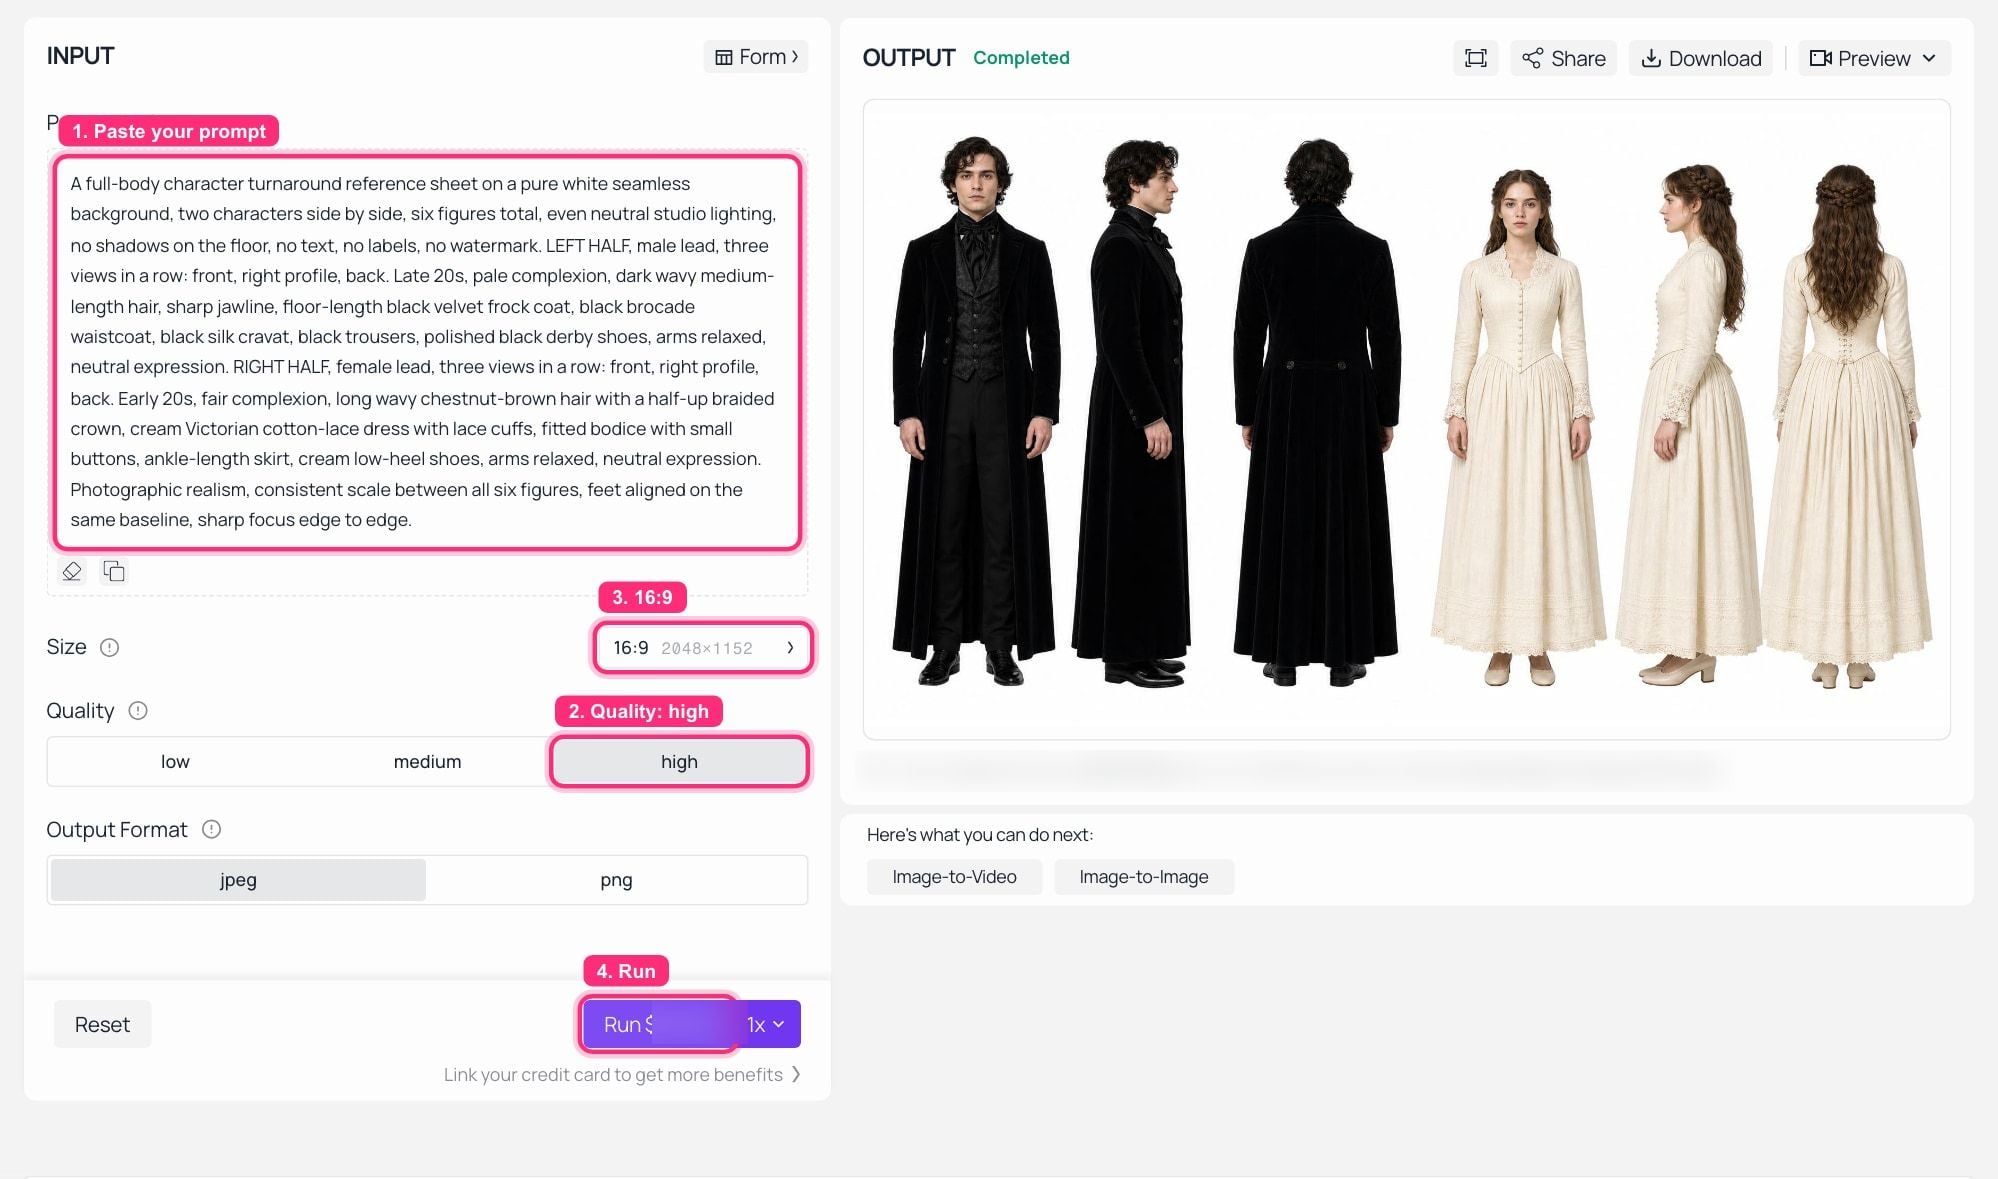 GPT Image 2 Text-to-Image en Atlas Cloud, ejecución completada: el prompt de referencia a la izquierda, seis figuras en una hoja blanca en el panel OUTPUT.
Esta es la forma objetivo. Seis figuras, una línea base, nada en el fondo para discutir:
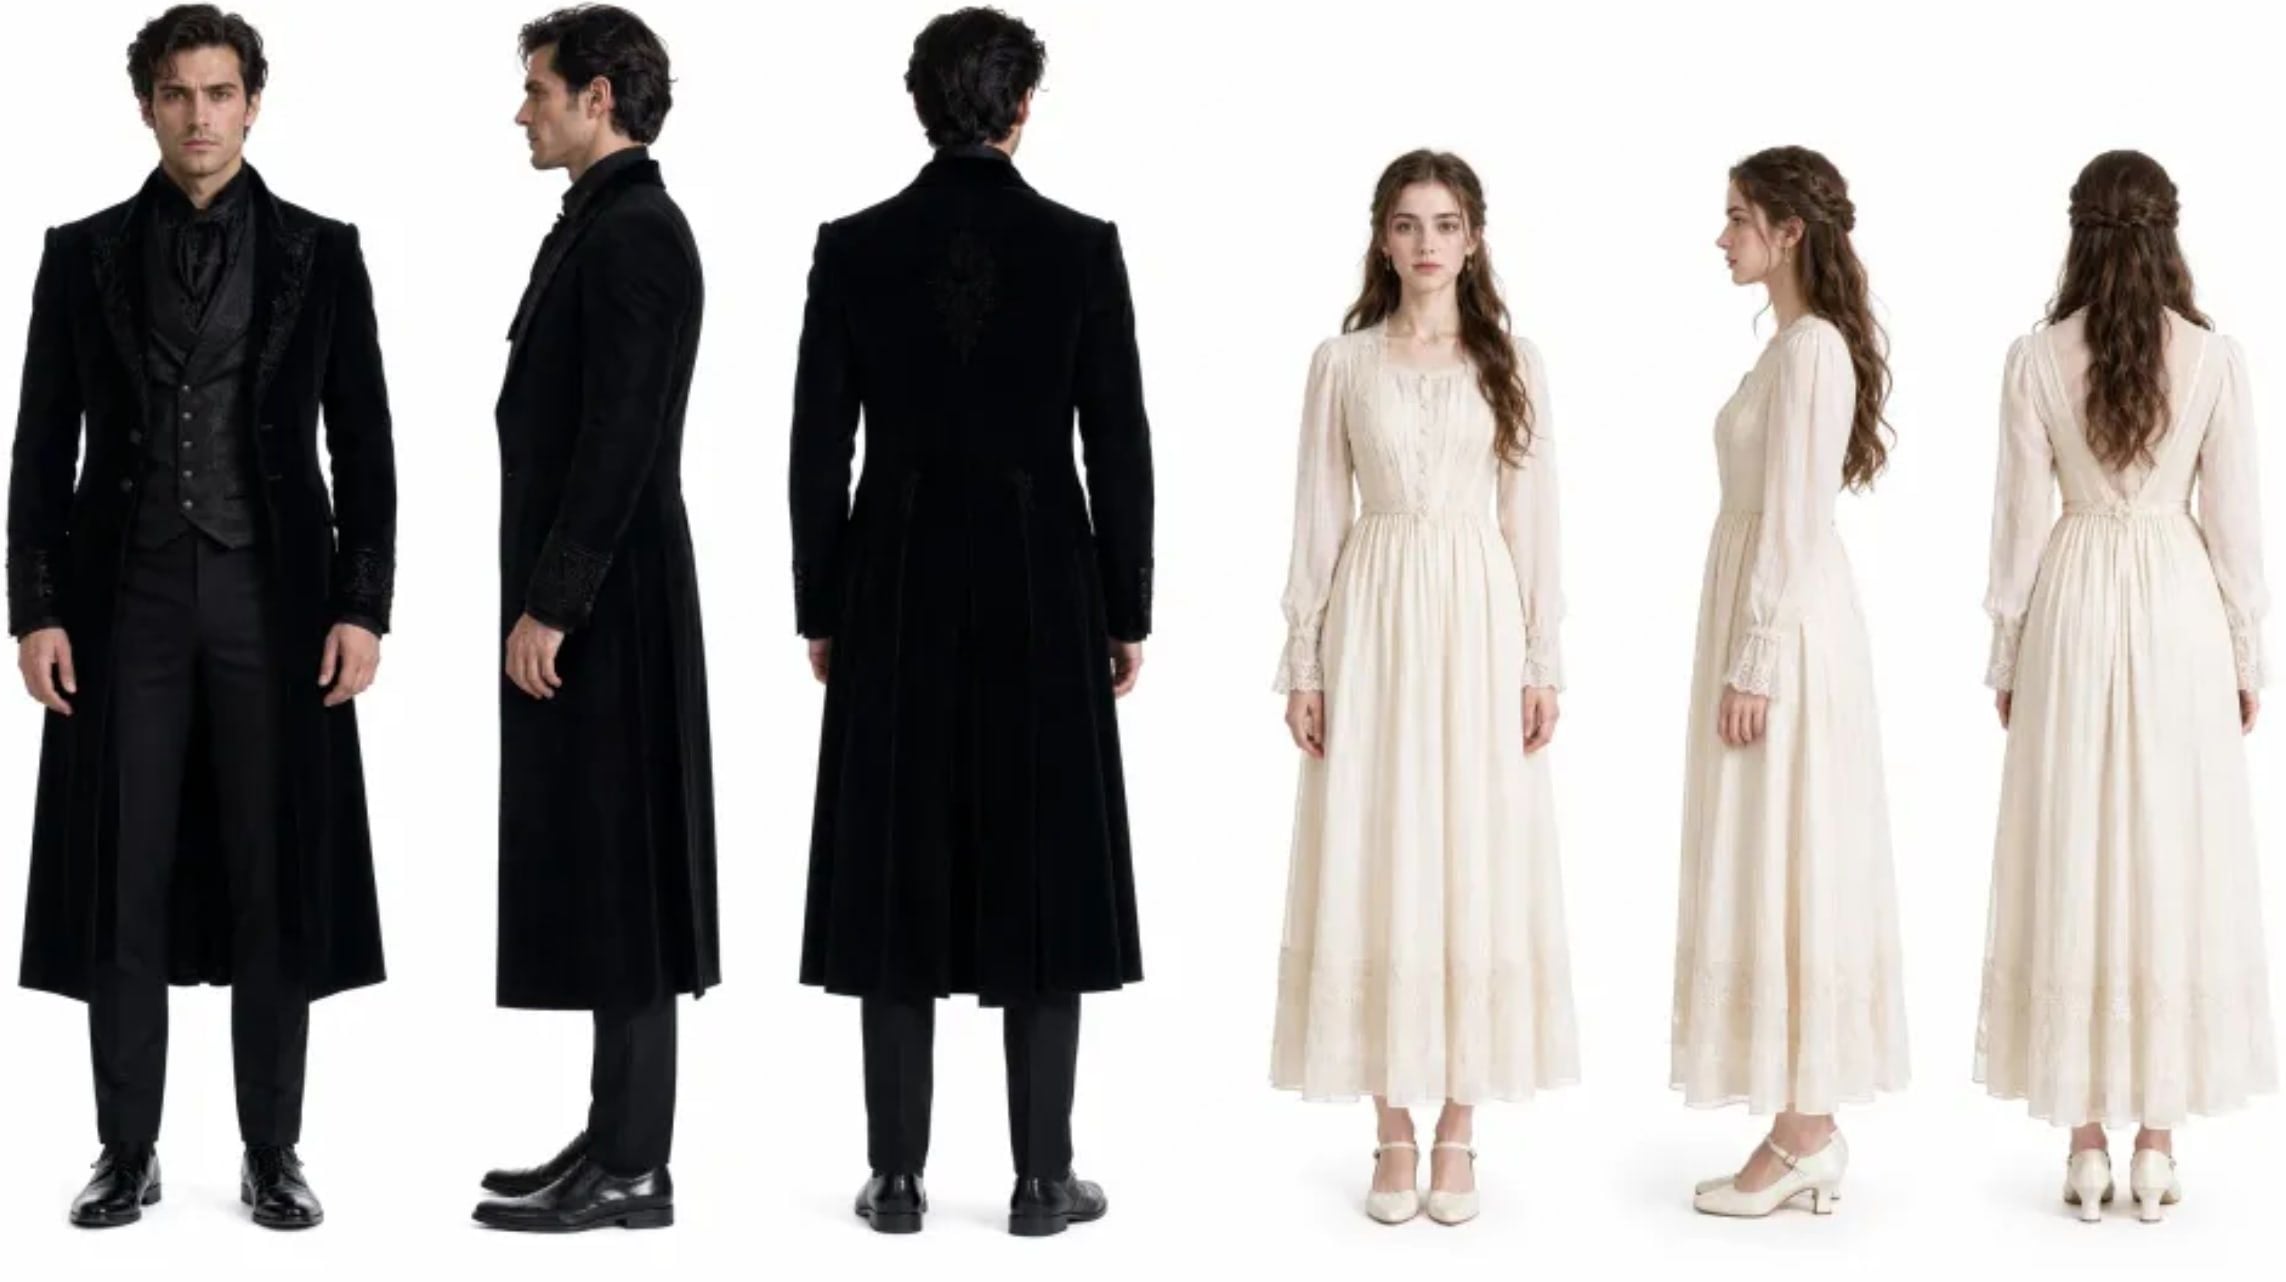 El paquete de referencia que impulsó el clip de demostración: protagonista masculino en terciopelo negro, protagonista femenina en encaje victoriano color crema, tres vistas cada uno, un archivo.
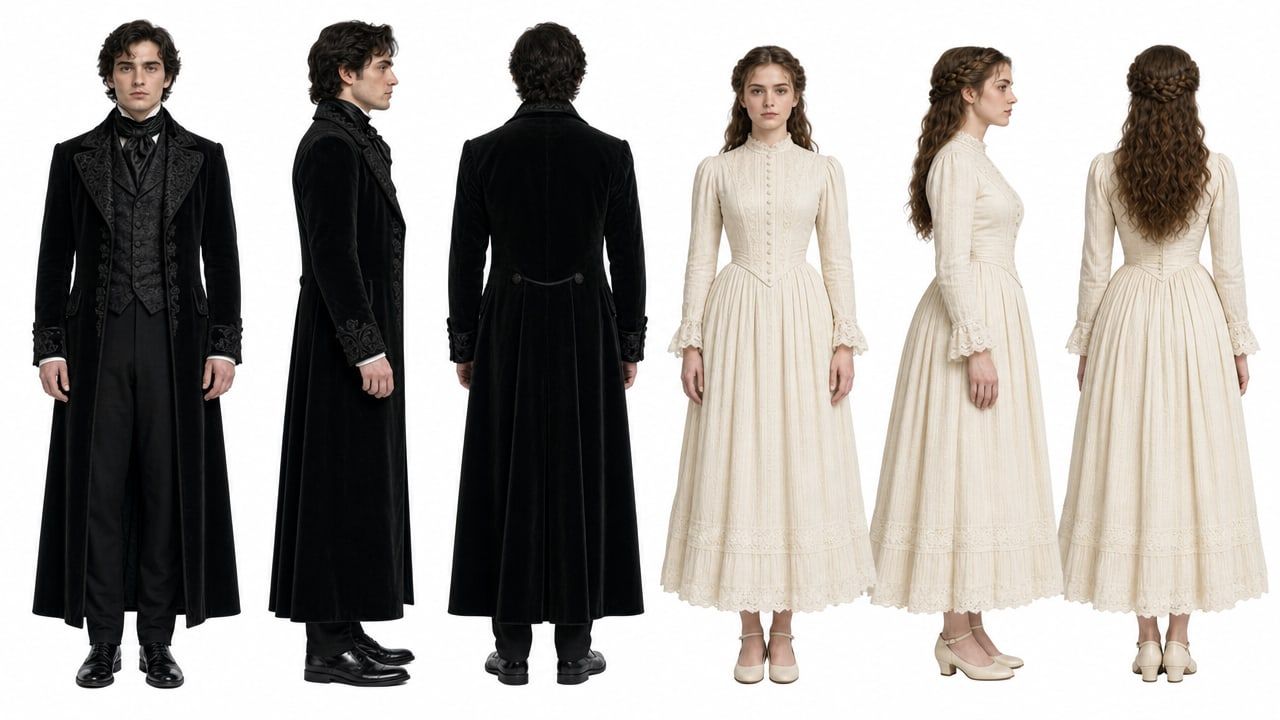 Mi propia ejecución de GPT Image 2 del prompt del Paso 1, para comparación con la referencia anterior.
Paso 2: Fijar la localización con un tablero de escena de seis paneles
Sostuviste el rostro. La luz aún te traicionará. La segunda imagen de referencia fija seis posiciones de cámara, la dirección de la luz de luna, cuánta niebla hay en el aire y qué tan húmedo se lee el suelo. Le estás diciendo al modelo que esta película tiene exactamente una configuración de iluminación.
plaintext1Un tablero de localización cinematográfico de seis paneles, 2 filas por 3 columnas, finos bordes negros entre los paneles, cada panel subtitulado en letras blancas elegantes pequeñas en mayúsculas espaciadas en la parte inferior de ese panel. Tema: el interior de un castillo gótico abandonado por la noche. Luz de luna azul fría, niebla baja a la deriva, piso de piedra mojado reflectante, ventanas altas de vidrieras, candelabros de hierro con pequeñas llamas cálidas, negros desaturados profundos, cortinas de terciopelo pesadas. Sin personas en ningún panel. 2 3Panel 1, título "VISTA GENERAL AMPLIA - PASILLO": un largo pasillo con columnas que se aleja hacia una ventana de vidriera iluminada. 4Panel 2, título "ÁNGULO BAJO - LUZ DE LUNA CRUZANDO EL SUELO": cámara baja, un haz de luz de luna que barre losas mojadas. 5Panel 3, título "COMPOSICIÓN DE PUERTA Y ESCALERA": una entrada arqueada que enmarca una escalera de piedra curva. 6Panel 4, título "DETALLE CERCANO - PUERTA TALLADA": primer plano ajustado de una puerta de madera tallada pesada con manija de hierro. 7Panel 5, título "VISTA JUNTO A LA VENTANA - NIEBLA Y CORTINAS": ventana alta, niebla entrando, borde de cortina en primer plano. 8Panel 6, título "FOTOGRAMA FINAL DE CARTEL - SALÓN VACÍO": salón vacío simétrico, alfombra de pasillo estampada que lleva a la ventana. 9 10Fotográfico, cinematográfico, grano de película, gradación de color consistente en los seis paneles.
Configuraciones: mismo modelo, Calidad alta, Relación de aspecto 16:9.
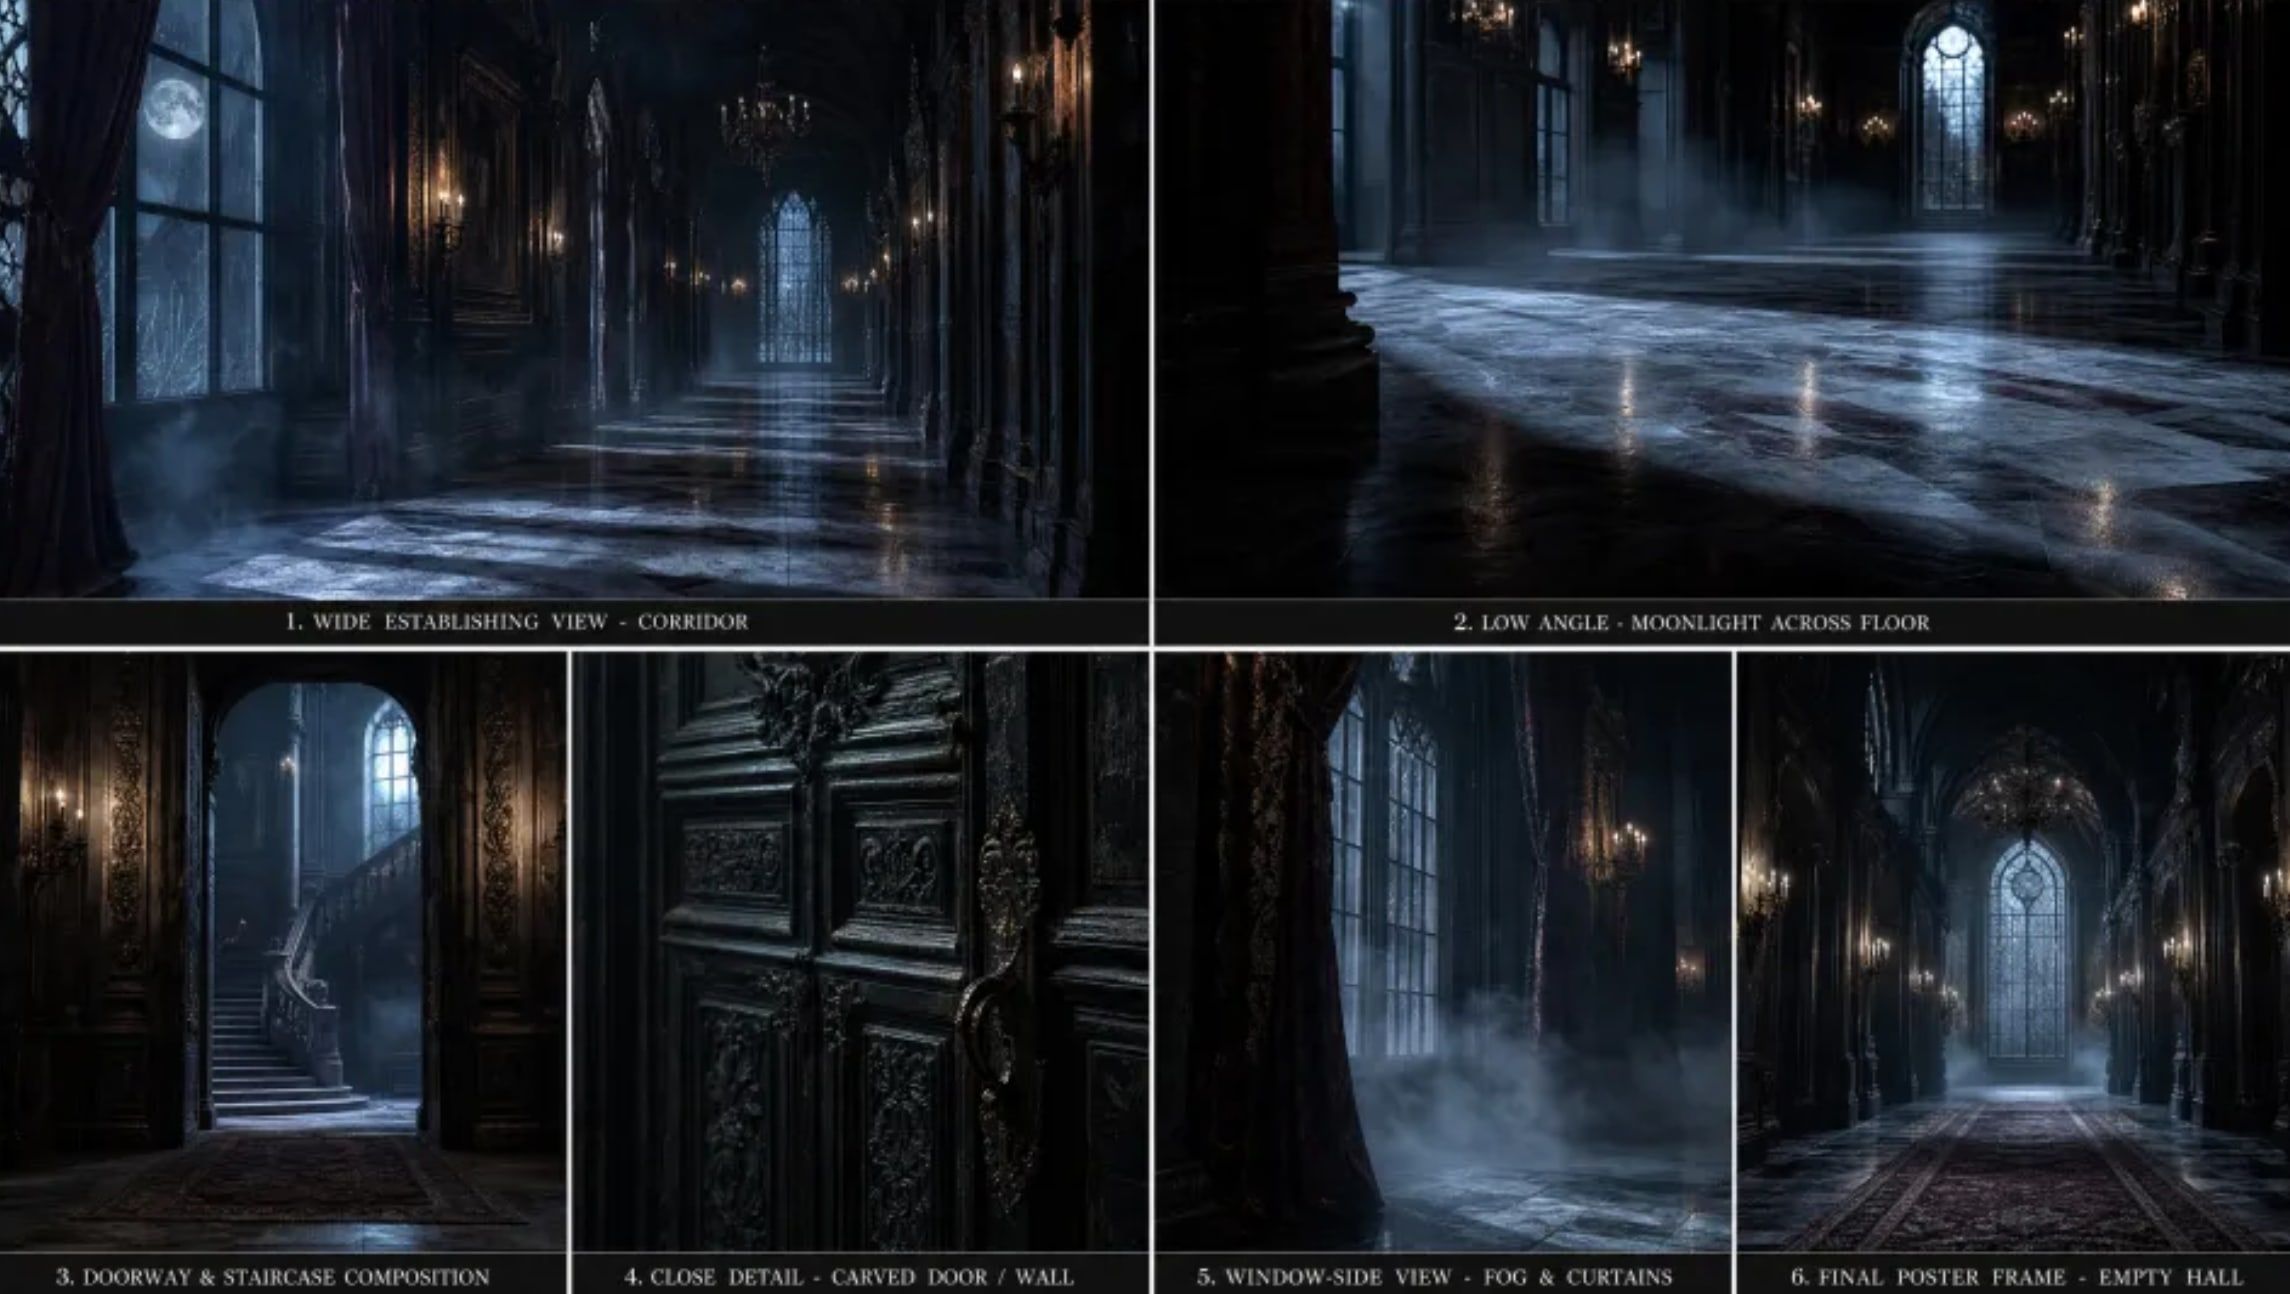 El tablero de localización que impulsó el clip de demostración: seis interiores de castillo gótico, una gradación de color, títulos legibles.
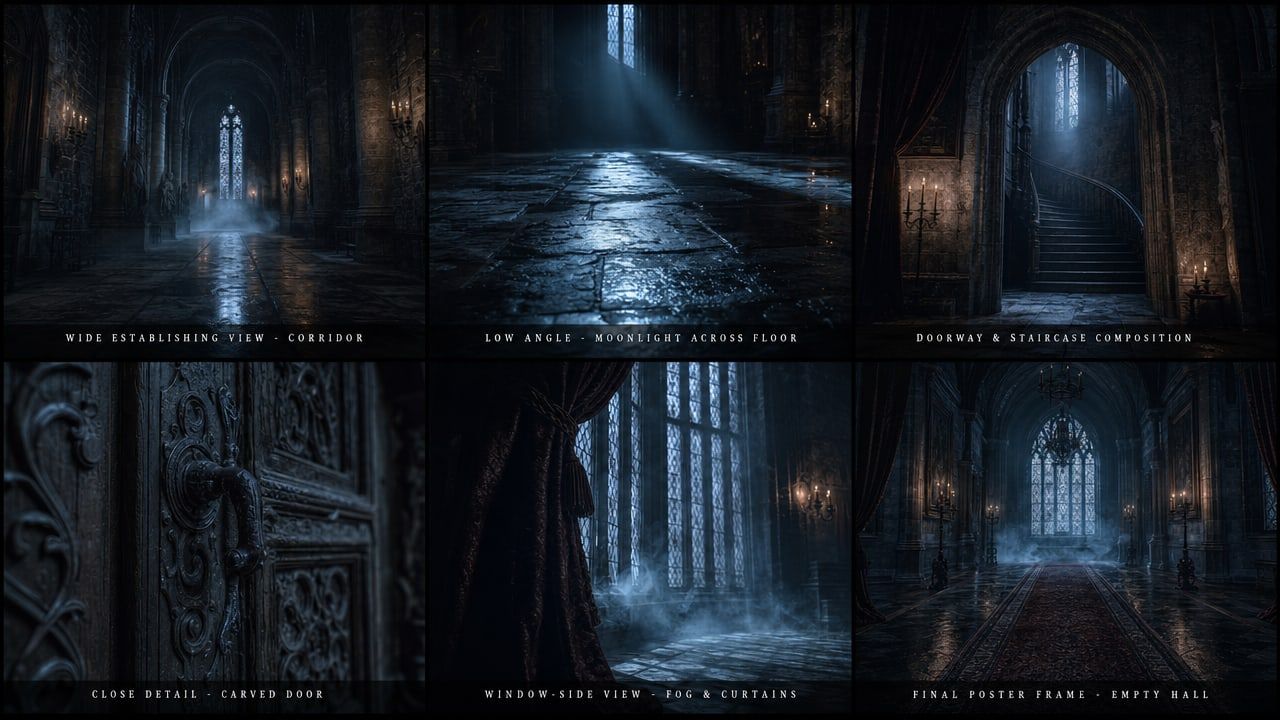 Mi propia ejecución de GPT Image 2 del prompt del tablero del Paso 2.
Paso 3: Generar la toma con MiniMax H3 reference-to-video
Dos imágenes de referencia más un prompt que lleva las posiciones de cámara y la dirección de audio. El sonido se produce en la misma pasada, por lo que no hay un paso separado de voz o partitura. Mantén la duración corta mientras ajustas, luego súbela a 15 para el corte real.
plaintext1La imagen de referencia 1 es la hoja de personaje: el hombre a la IZQUIERDA es el protagonista masculino, la mujer a la DERECHA es la protagonista femenina. Mantén ambas identidades exactamente como se muestran: su mandíbula, cabello oscuro ondulado, abrigo de terciopelo negro, chaleco de brocado negro y corbata de seda negra; su cabello castaño claro con trenza a medio recoger y vestido de encaje victoriano color crema. La imagen de referencia 2 es el tablero de localización e iluminación: iguala su luz de luna azul fría, niebla a la deriva, piso de piedra mojado reflectante y tonos negros desaturados. 2 39:16 vertical, aspecto premium de drama corto de acción real, profundidad de campo reducida, contraste cinematográfico, sin subtítulos, sin texto en pantalla, sin marca de agua. 4 5Toma 1: Plano medio cercano, cámara entrando lentamente. La protagonista femenina está de pie en el pasillo iluminado por la luna, respirando superficialmente, con la mirada fija en algo fuera de cuadro a la derecha. La niebla pasa a su altura de rodilla. 6Toma 2: Corte duro. Plano sobre el hombro desde detrás de ella, el protagonista masculino sale del arco oscuro a la luz de la luna, el abrigo atrapa la luz, expresión fría y curiosa. 7Toma 3: Primer plano cerrado de su rostro, medio iluminado por la ventana, luego un primer plano equivalente del de ella mientras se niega a apartar la mirada. 8 9Audio: zumbido grave sostenido, eco de piedra distante, su respiración irregular, una pisada pesada cuando él entra en la luz, un solo crescendo suave de cuerdas en el último corte.
Configuraciones: modelo MiniMax H3 Reference-to-Video, Resolución 2K, Duración 8 (el valor predeterminado del control deslizante; súbelo a 15 para el corte real), Relación de aspecto adaptativa, y ambos archivos en Materiales de Referencia. El panel los cuenta como 2 de 9, por lo que tienes mucho espacio para agregar placas de vestuario o utilería más adelante.
Vale la pena señalar lo que sucedió con la relación. Dejé Relación de aspecto en adaptativa y solo escribí "9:16 vertical" dentro del prompt. H3 devolvió vertical de todos modos, por lo que leyó el encuadre del texto en lugar de necesitar el campo de formulario.
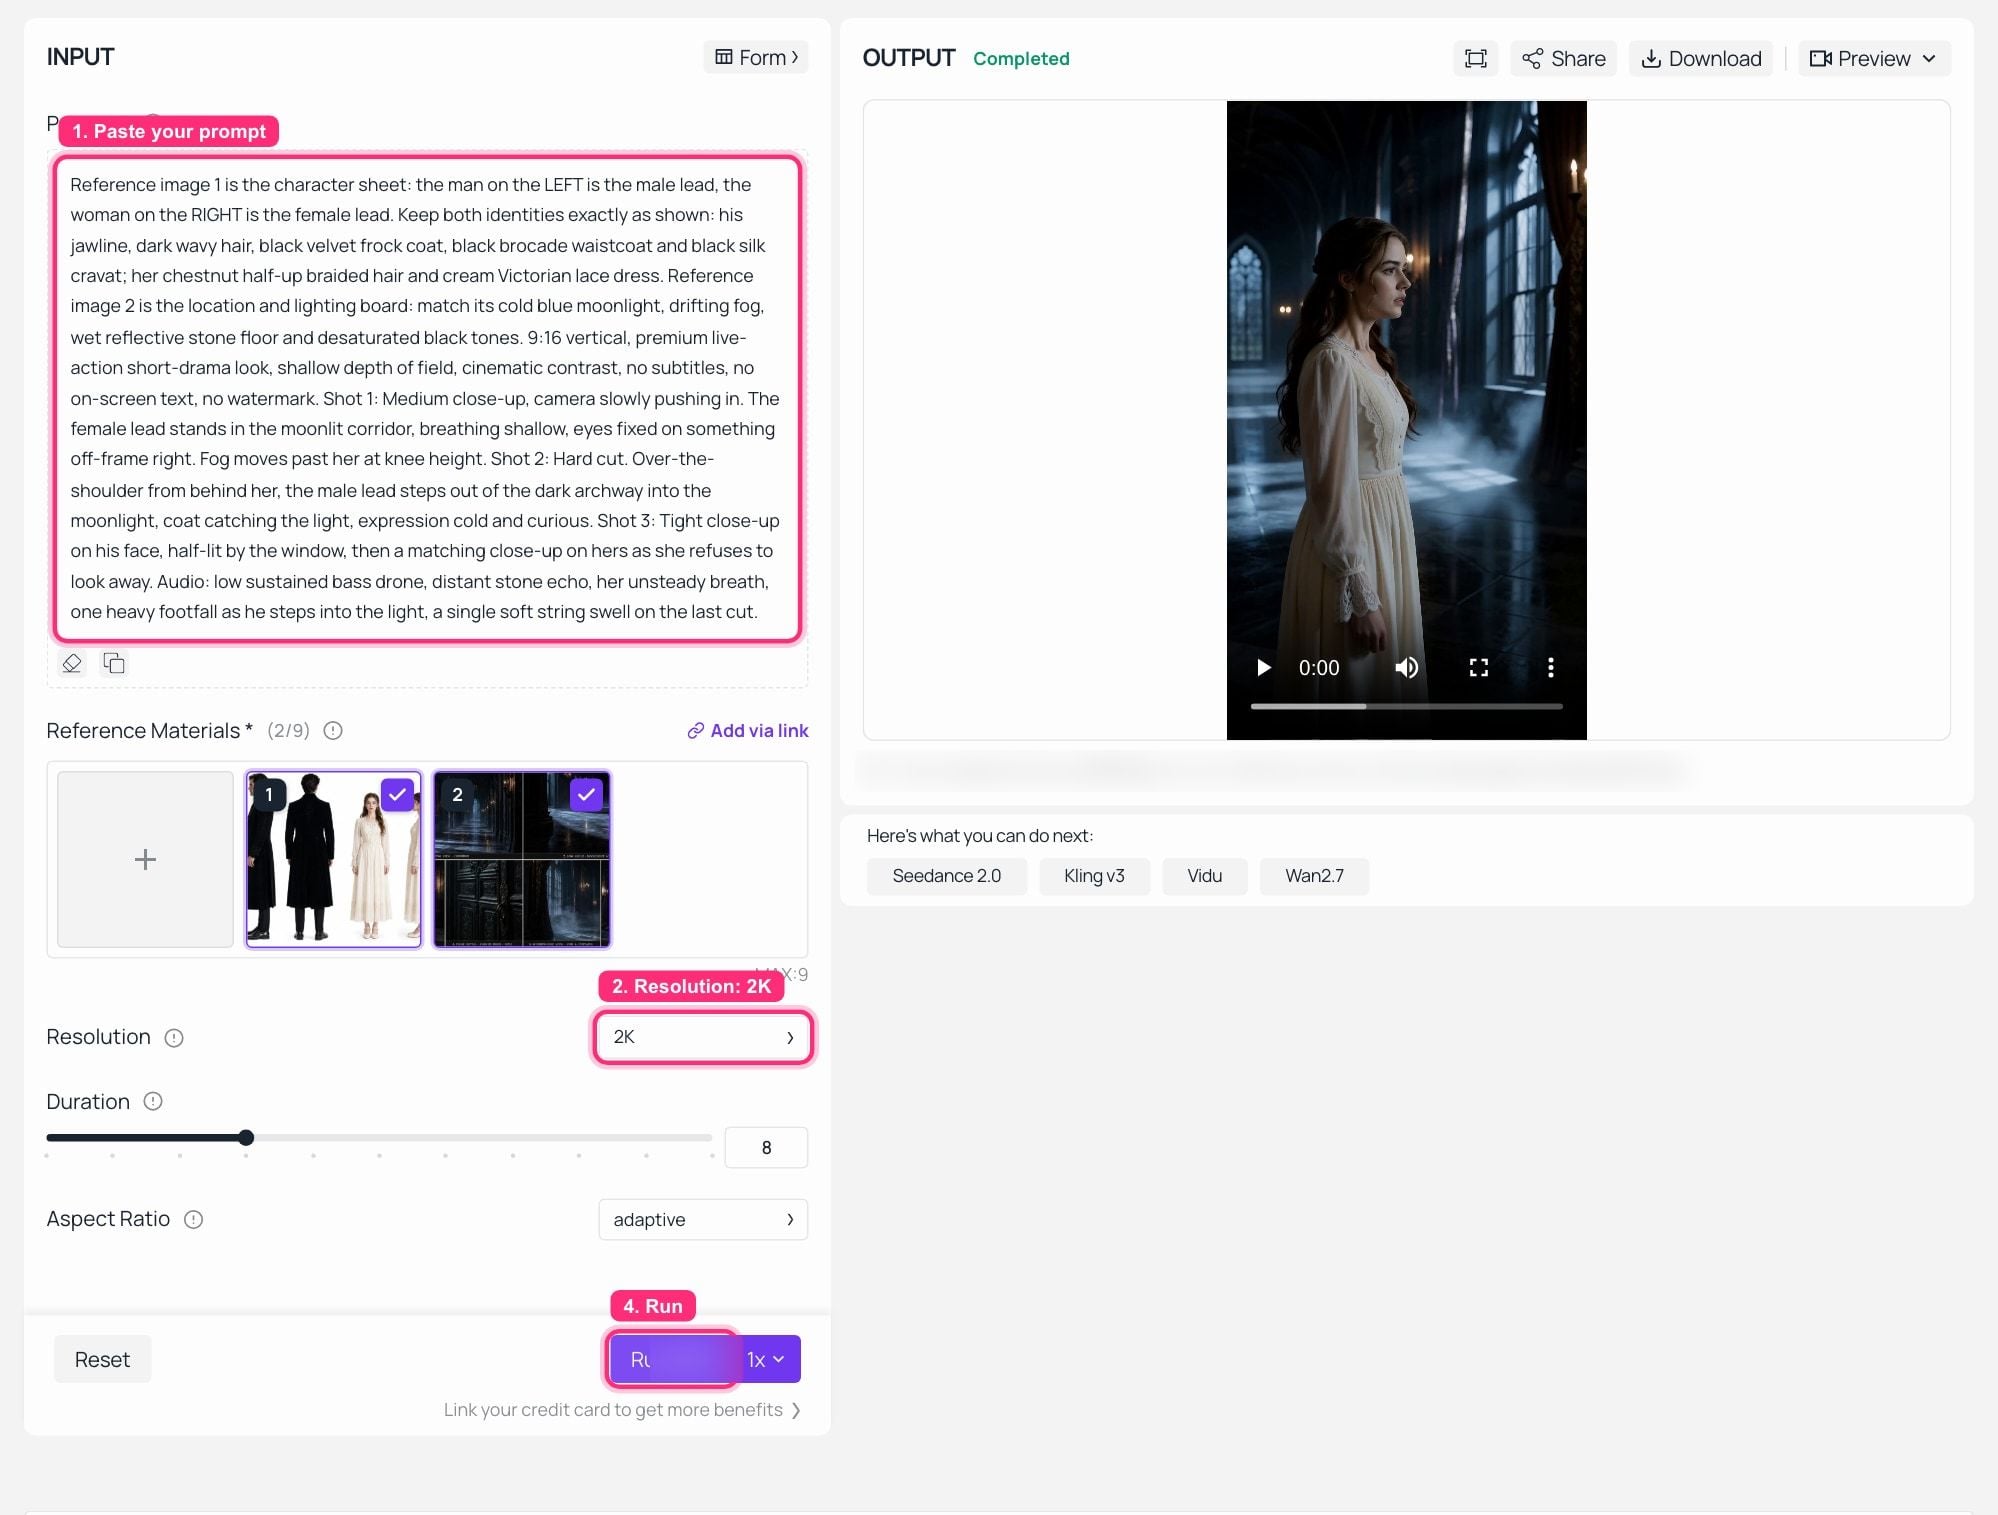 MiniMax H3 Reference-to-Video en Atlas Cloud, ejecución completada: ambos archivos de referencia cargados como 2 de 9, resolución 2K, y el clip vertical generado reproduciéndose en el panel OUTPUT.
El primer fotograma es la protagonista femenina con el corpiño de encaje color crema, de pie en el pasillo del panel 1 del tablero, con niebla a la altura de la rodilla y la luz de la luna golpeando el suelo mojado exactamente donde el tablero la colocó. Ambas imágenes de referencia aterrizaron.
Paso 4: Ejecutar el control Seedance 2.5 vs MiniMax H3 con el paquete idéntico
No cambies ni una palabra. Las mismas dos imágenes de referencia, el mismo prompt, modelo diferente. Dejé la duración predeterminada de cada página sola en lugar de forzar una coincidencia, y digo lo que cada una devolvió a continuación. Reformular un prompt "para" el otro modelo es exactamente cómo las comparaciones comienzan a mentir.
plaintext1Mismo prompt que el Paso 3, textualmente. No lo reformules para el otro modelo.
Configuraciones: modelo Seedance 2.0 Reference-to-Video, Resolución 720p, las mismas dos imágenes de referencia en Imágenes de Referencia (nuevamente 2 de 9, con espacios separados para hasta 3 videos de referencia y 3 archivos de audio de referencia). Duración dejada en el valor predeterminado de la página, que devolvió un clip de 10 segundos.
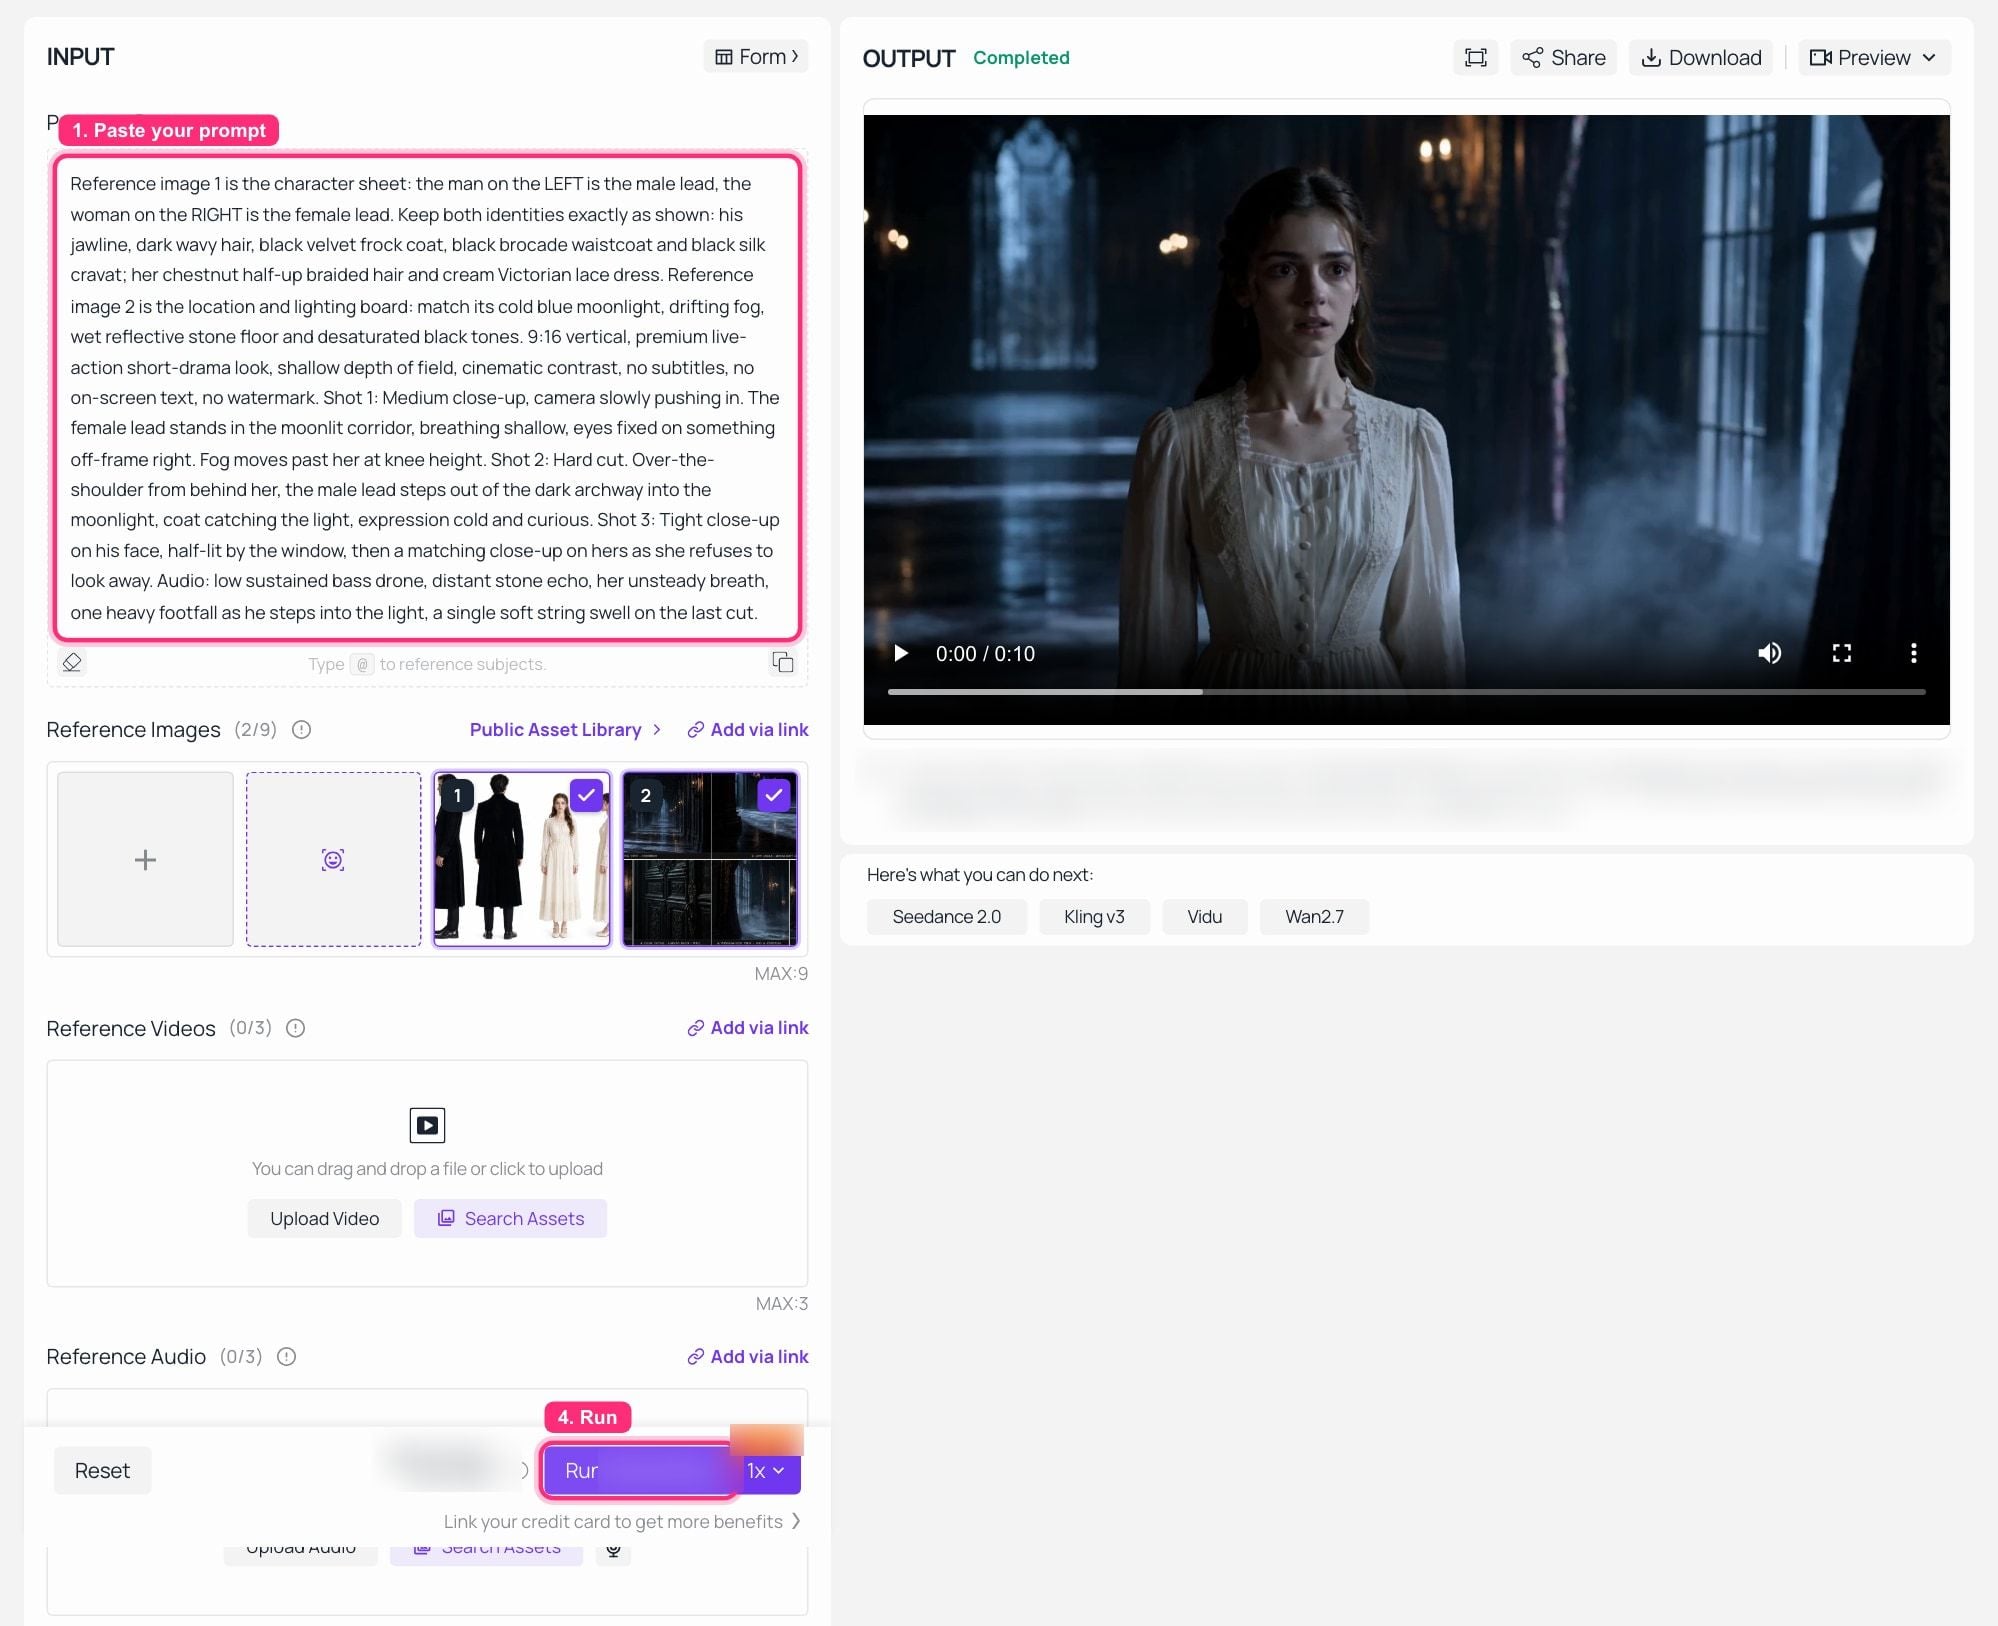 Seedance 2.0 Reference-to-Video en Atlas Cloud, ejecución completada con el paquete de referencia y prompt idénticos del Paso 3, y un resultado de 10 segundos en el panel OUTPUT.
Esto es lo que los dos paneles OUTPUT mostraron realmente, y lo informo de manera plana en lugar de elegir un ganador.
Ambas ejecuciones mantuvieron el personaje. El mismo vestido de encaje color crema con el mismo escote y puños de manga, el mismo cabello castaño claro, el mismo pasillo de niebla y luz de luna extraído del tablero. Ninguno inventó una mujer diferente. El paquete de referencia hizo ese trabajo en ambos lados, que es el hallazgo que más me importa.
Las diferencias fueron sobre la forma, no el rostro. Este endpoint de Seedance entregó 720p; H3 entregó 2K con entradas idénticas. Y la división del encuadre: H3 leyó "9:16 vertical" directamente del texto del prompt y devolvió vertical, mientras que la ejecución de Seedance devolvió 16:9 porque esa página tiene su propio control de relación de aspecto y el texto del prompt solo no lo anuló. Si estás editando para TikTok, esa diferencia te costará una ejecución la primera vez que olvides el campo de formulario. Seedance 2.5 probablemente cambiaría la mitad de la resolución de esto y agregaría regeneraciones a nivel de región, y no voy a pretender que medí eso.
Paso 5: Arreglar una toma sin regenerar todo el clip
El costo real de un drama corto no es la generación uno. Es la revisión siete. H3 acepta un clip existente como entrada y edita según instrucciones, manteniendo lo que no mencionaste. La propuesta de Seedance 2.5 aquí es más fina: redibujar una región del fotograma y dejar el rendimiento, la iluminación y la cámara intactos.
plaintext1Usando el clip proporcionado: mantén los dos personajes, su vestuario, los movimientos de cámara y el ritmo de corte exactamente como están. Cambia solo el entorno, reemplaza el pasillo de piedra iluminado por la luna con el mismo salón de baile del castillo, ventanas altas arqueadas, una araña de luces encendida y luz de velas cálida, y vuelve a iluminar a ambos personajes para que su luz principal provenga de la araña en el lado izquierdo del cuadro en lugar de la ventana. Reescribe su única línea hablada a "Nunca estabas dormido, ¿verdad?". Mantén el tiempo de su actuación en los mismos compases.
Configuraciones: MiniMax H3 Reference-to-Video con el clip del Paso 3 como entrada de referencia, Duración 5, Resolución 2K.
Más allá de la prueba Seedance 2.5 vs MiniMax H3: Cuatro formas de impulsar un paquete de referencia
Mismo personaje, próximo episodio. Guarda la hoja del Paso 1 como un activo y cambia solo la lista de tomas y el bloque de la historia en el prompt. La identidad proviene de un archivo, no de tu memoria de cómo lo redactaste el martes pasado.
Fija también la voz. H3 acepta hasta tres referencias de audio, de 2 a 15 segundos cada una, y deben acompañar a una entrada de imagen o video. Dale una muestra de voz y el personaje habla en ese timbre, para que no tengas que volver a contratar a un actor de doblaje entre episodios.
Bloquea la cámara antes de pagar por el renderizado. El reference-to-video de Seedance 2.5 acepta maquetas 3D en blanco y placas de croma, para que puedas fijar el encuadre en geometría gris y solo entonces comprometerte con un aspecto final. Este ejemplo se ejecutó en Seedance 2.1, un miembro anterior de la familia, pero la forma del flujo de trabajo es la misma.
Localiza un corte maestro en lugar de volver a filmarlo. El reemplazo a nivel de región intercambia un rostro, un producto o un idioma hablado mientras la cámara, el tiempo y la duración de los labios permanecen iguales. Aquí, un corte maestro de belleza se vuelve a protagonizar y a poner voz para español, coreano e hindi, manteniendo la habitación, el encuadre y la duración de los labios.
Y porque alguien preguntará cómo se ve la transferencia de movimiento cuando dejas de ser sensato: tres hombres con trajes, reemplazados por tres capibaras fotorrealistas, siguiendo la trayectoria de movimiento del clip original golpe por golpe hasta que se apilan en una pirámide.
También está la versión simple de todo esto, la que nadie publica: un póster estático se convierte en un póster en movimiento, y el diseño sobrevive.
 El póster fuente estático. Aliméntalo a reference-to-video con "mantén el cuadro, la paleta y el diseño, anima el texto" y obtienes una versión en movimiento del mismo diseño.
Lo que realmente te cuesta un cortometraje Seedance 2.5 vs MiniMax H3
Sin números aquí, porque los números se mueven y la estructura no. Ambas familias facturan por segundo, pago por uso, sin asiento ni suscripción. Eso deja tres variables: segundos, nivel de resolución y regeneraciones.
La tercera es toda la factura. Un clip de 15 segundos que aterriza en el primer intento es un solo cobro. El mismo clip en el séptimo intento son siete. Por lo tanto, el movimiento para ahorrar dinero no es elegir el modelo más barato por segundo, sino hacer bien el paquete de referencia antes de generar nada. Esas dos llamadas de imagen en el Paso 1 y el Paso 2 son la línea más barata en toda la tubería y la que decide cuántas llamadas de video haces. El mayor retorno de inversión en toda la cadena, por mucho.
Luego corrige el instinto de por segundo. Mismo paquete de referencia, mismo tiempo de ejecución: el reference-to-video de H3 devuelve 1440p, este endpoint de reference-to-video de Seedance devuelve 720p. Por segundo es la unidad incorrecta. Píxeles por fotograma, y si luego tienes que pagar por una pasada de mejora de escala separada, es la correcta.
El audio también pertenece a la aritmética. Ambos lados producen sonido sincronizado nativo en la misma pasada. Si tu tubería actual es modelo de video más TTS más un editor alineando pistas, lo que ahorras son dos llamadas API y la tarde de una persona, y ese ahorro no aparece en ninguna lista de precios.
Cuál para qué trabajo:
| Trabajo | Elige | Por qué | Advertencia |
|---|---|---|---|
| Drama corto vertical, 9:16, TikTok o ReelShort | MiniMax H3 | 1440p vertical con estéreo nativo, disponible ahora, 15 s es un gancho completo | cortas a 15 s, así que planifica los beats en consecuencia |
| Película de marca continua de 30 segundos | Seedance 2.5 | generación única, sin costuras, 4K nativo | verifica la disponibilidad en tu plataforma primero |
| Arreglar una toma dentro de un corte aprobado | Seedance 2.5 | redibujo a nivel de región deja el resto intacto | la edición de clip completo de H3 te lleva la mayor parte del camino hoy |
| Recortes de producto y comercio electrónico | cualquiera | ambos mantienen bien el texto en pantalla y las marcas | verifica el texto en la resolución que entregues |
| Demos de juegos o interfaces | MiniMax H3 | la estabilidad de UI y tipografía a 2K es fuerte | límite de 15 s para una sola pasada |
| Versiones multilingües de un maestro | Seedance 2.5 | reemplazo de región más voz multilingüe | la calidad de localización aún necesita un control nativo |
| Envío esta noche | MiniMax H3 | tres endpoints en vivo, más todo Seedance 2.0 | el acceso a Seedance 2.5 varía según la plataforma |
Antes de enviar. MiniMax dijo que los pesos de H3 seguirían en días después del lanzamiento, y los pesos abiertos no son lo mismo que una licencia comercial, así que lee los términos antes de autoalojar. La política de marca de agua y uso comercial también difiere entre aplicaciones de consumo y acceso API en ambos lados, y no pude confirmar ninguna de las dos desde una página de términos principal mientras escribía esto, así que verifica los términos del proveedor en lugar de tomar mi palabra. Y nada en ninguna licencia de modelo cubre la imagen o la marca registrada. Si una persona real, una marca real o la propiedad intelectual de otra persona está en tu paquete de referencia, esa es una pregunta legal separada y los términos del modelo no la responderán.
Todos los modelos en las tablas anteriores se ejecutan con la misma clave, y las páginas de modelos llevan las tarifas actuales más código de copiar y pegar, incluidas las promociones que puedan estar vigentes en la línea Seedance esta semana.
Preguntas frecuentes
¿Es Seedance 2.5 mejor que MiniMax H3 para la consistencia de personajes?
En teoría debería serlo, con hasta 50 referencias multimodales frente a los 12 archivos de H3, más las regeneraciones a nivel de región. Pero al 31 de julio de 2026 no hay ninguna prueba pública pareada a la que pueda señalar, y Seedance 2.5 aún no tiene calificación en la arena. En las ejecuciones que realmente pude hacer, la variable que decidió la estabilidad de la identidad fue la estructura del paquete de referencia, no la generación del modelo: con una hoja de referencia compuesta más un tablero de iluminación, ambos lados mantuvieron el personaje. Haz bien el paquete antes de perder tiempo comparando modelos.
¿Puedo usar Seedance 2.5 ahora mismo, o tengo que esperar?
Su API está activa en ByteDance. La disponibilidad en plataformas de modelos de terceros es desigual, y en la que probé sigue siendo un aviso de Día 0. Si necesitas resultados esta noche, las opciones invocables son los tres endpoints de MiniMax H3 y toda la línea de Seedance 2.0 en envío.
¿MiniMax H3 realmente hace video de 30 segundos?
No. La especificación es de 5 a 15 segundos por generación a 24 fps. Cualquier cosa más larga es extensión o costura, que es una cosa diferente con diferente riesgo de deriva. La generación única de 30 segundos pertenece a Seedance 2.5. No dejes que las dos afirmaciones se mezclen.
¿Ambos modelos generan audio, y puedo mantener una misma voz entre episodios?
Ambos producen audio sincronizado nativo en la misma pasada, y H3 genera estéreo en cada resultado. Para una voz persistente, H3 acepta hasta tres referencias de audio de 2 a 15 segundos cada una, que deben enviarse junto con una entrada de imagen o video, no por sí solas.
¿Cuántas imágenes de referencia debería enviar realmente?
Menos de las que piensas, mejor estructuradas de lo que piensas. Un compuesto bien hecho generalmente supera a seis recortes sueltos, porque los archivos separados invitan al modelo a promediarlos en una persona que no existe. Dale dos trabajos claros, identidad e iluminación, y no incluyas muestras de estilo que compitan entre sí.
¿Qué modelo debería usar para drama corto vertical estilo TikTok o ReelShort?
En envío esta semana, en 9:16, en alta resolución con sonido ya mezclado: MiniMax H3. Planeando una escena continua de 30 segundos donde esperas regenerar regiones individuales en lugar de clips completos: construye para Seedance 2.5 y verifica cuándo tu plataforma lo abre.


