Los pipelines agenticos de producción frecuentemente se bloquean debido a violaciones inesperadas de esquema. Incluso los LLMs autorregresivos de primer nivel fallan el análisis JSON durante llamadas de herramientas de alto volumen, forzando a los desarrolladores a construir bucles complejos de reintentos y manejadores de errores personalizados.
TypeSafe Jev resuelve este defecto estructural al abandonar por completo la generación secuencial token por token. Operando como un modelo de decisión no autorregresivo, Jev ingiere el estado de la aplicación y evalúa preguntas de esquema predeclaradas en una sola pasada paralela. Debido a que las opciones de salida posibles están estrictamente acotadas antes de la ejecución, Jev elimina matemáticamente JSON malformado, nombres de herramientas no válidos y texto fuera del esquema.
Resumen rápido: ¿Qué es TypeSafe Jev AI? Rendimiento y benchmarks de velocidad
TypeSafe Jev AI es un modelo de decisión no autorregresivo construido específicamente para clasificación en submétodos, scoring de intención y enrutamiento de microservicios estructurados. A diferencia de los LLMs autorregresivos, Jev evalúa las elecciones de esquema predeclaradas en una sola pasada hacia adelante.
- Cero alucinación a nivel de tipo: Reemplaza los bucles de decodificación de cadenas con primitivas de esquema de estado acotadas, dando lugar a una tasa de error de tipo de 0%.
- Ejecución inferior a 500ms: El muestreo paralelo no autorregresivo logra latencia P95 de 70ms a 500ms hasta 200 veces más rápida que los LLMs estándar.
- Tokens de salida gratuitos: La generación de cero tokens secuenciales significa que los tokens de salida son completamente gratuitos $0.042/1M tokens de entrada.
- Mejor para: Enrutamiento en microservicios, despacho de herramientas agénticas, triaje de tickets y control de intención.
Repensando la pila de IA: Intuición del Sistema 1 vs. Razonamiento del Sistema 2
Al diseñar software de backend escalable, forzar comprobaciones condicionales simples a través de un endpoint pesado de chat completion crea una severa latencia en el sistema. La mayoría de los microservicios no requieren prosa creativa ni generación de razonamiento de múltiples pasos; requieren una selección inmediata y determinista sobre opciones conocidas.
Aplicando el marco cognitivo de Kahneman a la arquitectura de software
Diogo Almeida, cofundador de TypeSafe y quien antes co-creó el Aprendizaje por Refuerzo con Realimentación Humana en OpenAI, introdujo un enfoque estructural con TypeSafe Jev para resolver esta ineficiencia. Tomando directamente del marco cognitivo Kahneman, la plataforma divide el procesamiento en dos capas operativas distintas dentro de la arquitectura moderna de pilas de IA:
- Sistema 2 - Razonamiento lento y deliberado: LLMs autorregresivos estándar que operan mediante generación secuencial de tokens. Estos modelos sobresalen en redactar documentos extensos, manejar razonamiento ambiguo y escribir código complejo.
- Sistema 1 - Decisiones rápidas e intuitivas: Un modelo de IA dedicada de Sistema 1 entrenado mediante Reforzamiento con Decisiones Calibradas (RLCD) en lugar del método tradicional RLHF. Está diseñado específicamente para clasificación en submicrosegundos, scoring de intención y enrutamiento de ejecución sin una sobrecarga conversacional.
Jev vs. Costo y arquitectura de LLM: Modelos de decisión vs. Modelos de chat
Reemplazar los modelos de chat de propósito general con modelos de decisión especializados y tipados optimiza fundamentalmente los flujos de trabajo de microservicios al aislar la evaluación rápida de la generación profunda.
| Dimensión de arquitectura | LLMs autorregresivos (Sistema 2) | TypeSafe Jev (Sistema 1) |
| Tarea principal | Síntesis de texto abierta | Elección discreta y evaluación de esquemas |
| Latencia de ejecución | 3,000ms a 30,000ms+ | 70ms a 500ms |
| Formato de salida | Flujo de texto no estructurado | Primitivas de esquema tipadas estrictamente |
| Bucle de computación | Codificación de tokens secuenciales | Evaluación de una sola pasada |
| Objetivo de entrenamiento | Preferencia humana (RLHF) | Confianza calibrada en decisiones (RLCD) |
Derivar el enrutamiento, los guardarrails de seguridad y el despacho de funciones fuera de los modelos de chat estándar resuelve los cuellos de botella de rendimiento inherentes a los LLMs autorregresivos. Incorre un modelo de IA de Sistema 1 asegura que los motores de razonamiento pesados solo se activen cuando se requiere realmente una generación abierta.
Cómo el modelo TypeSafe Jev ofrece cero alucinación a nivel de tipo
Incluso con un estricto modo JSON habilitado, los LLMs de fronteros o frontales frecuentemente devuelven claves fuera de esquema o valores enum alucinados durante ejecuciones de producción en alta concurrencia, causando que entre el 0.5% y el 5% de las solicitudes del pipeline fallan. Los microservicios de producción requieren un determinismo de tipo absoluto, motivo por el cual los modelos autorregresivos sonturalmente vulnerables a errores de generación de cadenas.
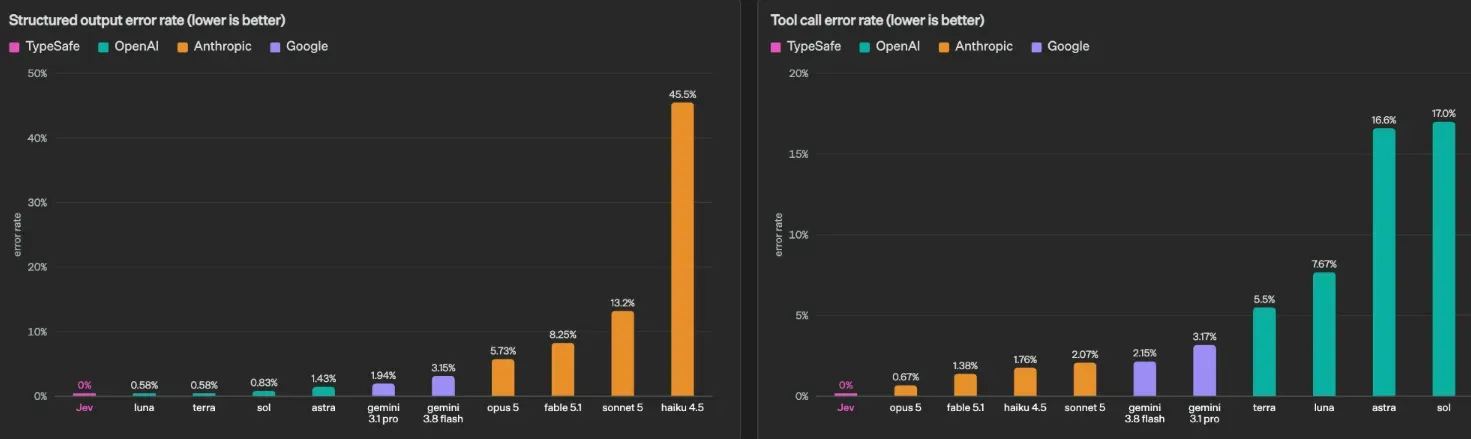
TypeSafe Jev resuelve esto reemplazando los bucles de decodificación de cadenas por una arquitectura de estado acotado. En lugar de generar texto arbitrario y luego intentar forzarlo a JSON sin formato sintáctico, Jev evalúa los datos de entrada contra las restricciones predefinidas del esquema en una sola pasada. Este cambiotructural ofrece una verdadera IA de cero alucinaciones a nivel de tipo, logrando así u0% de errores de tipo en todos los flujos de trabajo automatizados.
Los tres primitivas de esquema fundamentales
Jev procesa todas las preguntas de entrada a través de tres primitivas explícitas:
- **Primitiva de elección: Selecciona exactamente una opción de lista predefinida de hasta 255 elecciones categóricas, devolviendo la etiqueta ganadora y distribuciones de probabilidad completas.
- **Primitiva de puntuación: Evalúa la entrada contra una escala numérica ordenada o una rúbrica descriptiva, proporcionando puntuaciones junto con la expansión de probabilidad dentro de cada nivel.
- Primitiva Noul: Calcula la probabilidad exacta de una condición sí o no como un float entre 0.0 y 1.0, eliminando el razonamiento de texto intermedio.
Debido a que cada consulta se mapea estrictamente a estos tres primitivas, el motor de ejecución no puede emitir claves inválidas, nombres de herramientas fuera de la lista ni cargas útiles malformareas.
Seguridad de tipos en la evaluación de salida estructurada
Los modelos de chat tradicionales generan sintaxis carácter por carácter, creando riesgos de análisis constante en los pipelines de backend.
| Métrica de evaluación | Expresión de autorregresivos (Mode JSON) | TypeSafe Jev Sistema 1 |
|---|---|---|
| Aplicación de tipos de salida | Validación de cadenas después de la generación | Primitivas nativas acotadas matemáticamente |
| Frecuencia de errores de tipo | Variable (0.5% a 5%+ de fallos) | Errores de tipo 0% (esquema acotado) |
| Riesgo de enum inválido | Alto sin bucles de reintento personalizados | Cero (imposible por diseño) todos |
Restringir la ejecución del modelo estrictamente a un estado acotado garantiza una evaluación de salida estructurada y confiable. Las aplicaciones consumen las salidas de Jev directamente sin escribir manejadores de excepciones para esquemas JSON rotos.
Nota sobre determinismo de tipos vs. probabilidad: _TypeSafe Jev garantiza un 0% de errores de tipo y el cumplimiento del esquema por diseño, eliminando gramáticamente el sintaxis malforme, las claves evaporadas y los valores enum fuera de lista. Sin embargo, como todos los modelos de decisión, sus elecciones de salida siguen siendo probabilsticas. En entradas inherentemente ambiguas, los puntajes de confianza deben usarse como compuerta de ejecución en lugar de asumir una certeza semántica absoluta.
Cómo el muestreo paralelo no autorregrosivo impulsa una latencia inferior a los 500ms y salidas gratuitas
Usar endpoints de chat estándar para etiquetas de clasificación simples como {"categoría": "facturación"} no produce latencia innecesaria en los producciónservicios de microproducción. Debido a que los modelos autorregregativos dependen de una decodificación de tokens secuencial, los hilos del backend se bloquean a la espera de las evaluaciones de caracteres que se realizan de manera única.
Las mecánicas de la evaluación de un solo paso
Los transformadores tradicionales de ejecución de baja implementan bucles de generación autorregresivos donde cada nuevo token requiere una pasada separadae sobre la arquitectura de red. Esta dependencia secuencial crea alta latencia y eleva los costos de infraestructura según el volumen de tokens generados.
TypeSafe Jev elimina la generación secuencial al experimentamiento del muestreo paralelo no autorregresivo. Como se describe en el comunicado de lanzamiento de TypeSafe, Jev actualiza el estado de contexto y evalúa todas las elecciones de esquema predefinidas simultáneamente en una sola pasada hacia adelante.
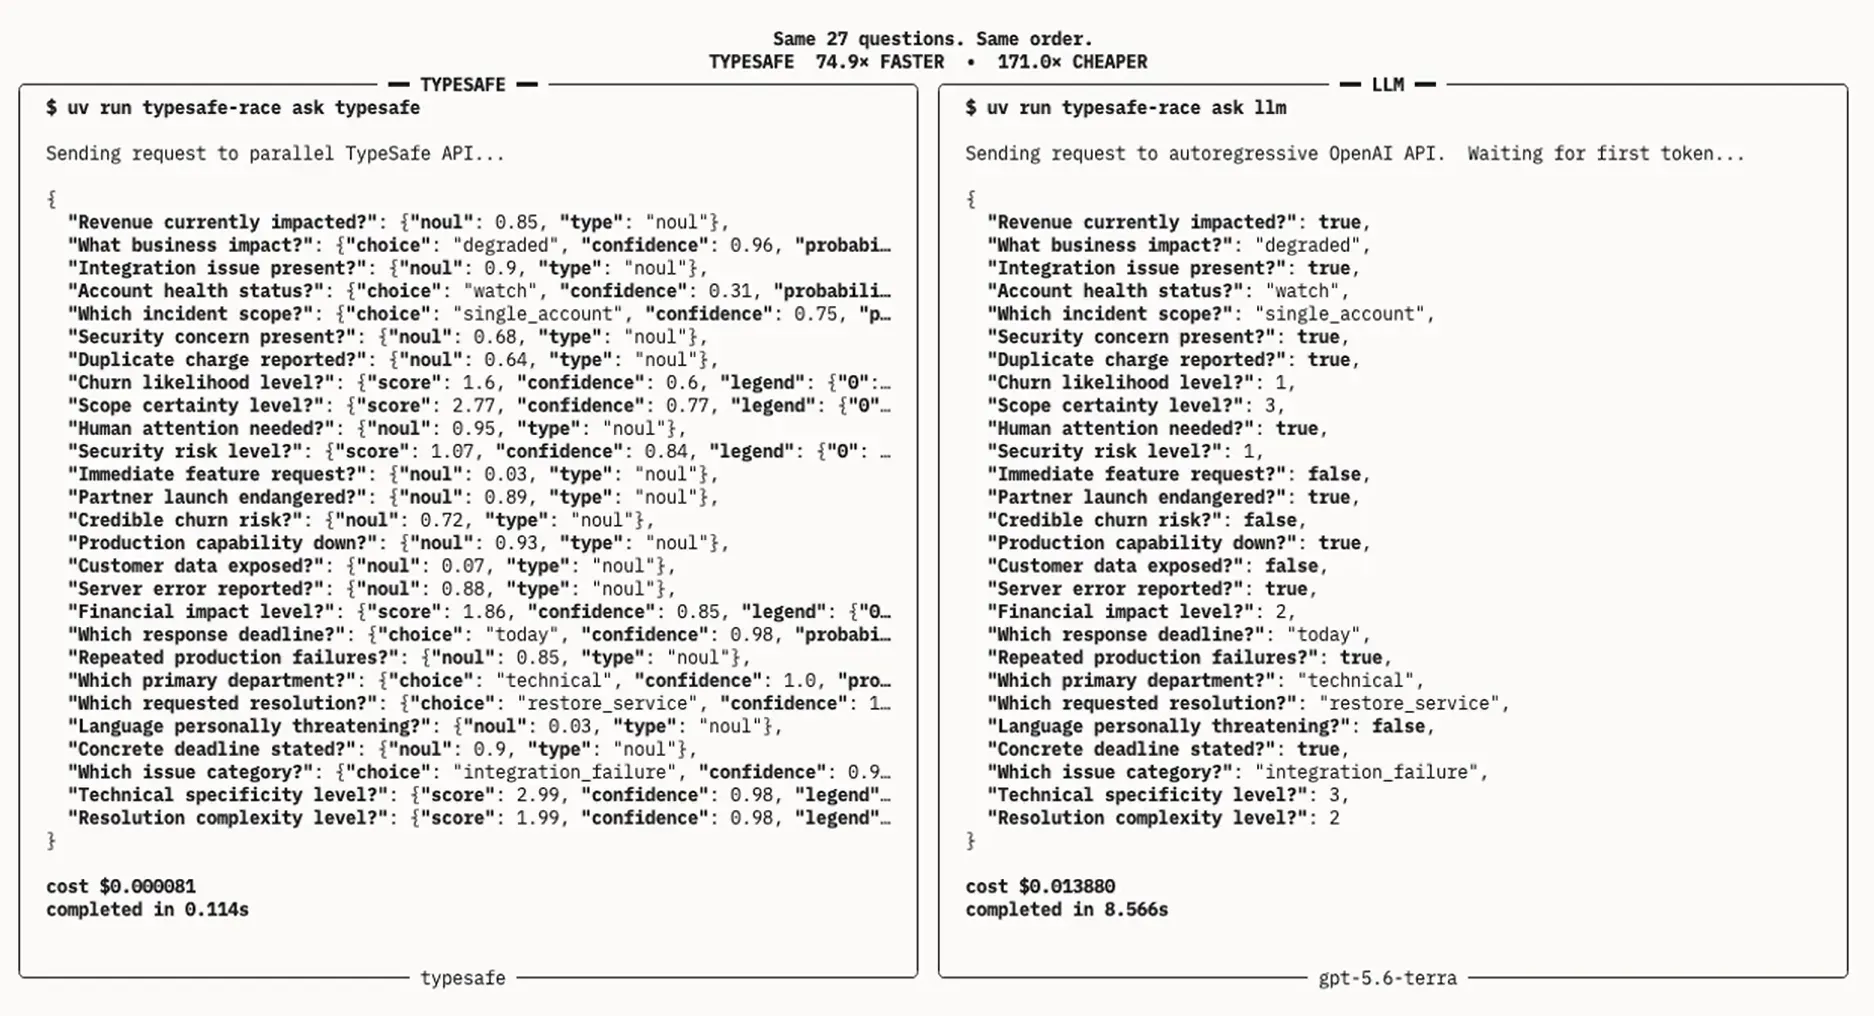
Benchmark del terminal comparando la evaluación de 27 preguntas de esquema simultáneas en TypeSafe Jev contra el endpoint GPT 5.6 Terra
El modelo calcula las distribuciones de Nee primero elige distribuciones de probabilidad sobre salidas predefinidas en lugar de generar texto libre, por lo que los bucles de decodificación de salida desaparecen por completo. Este cambio estructural produce tres ventajas de rendimiento:
- Tokens de salida gratuitos (demasiado económicos para no medirlos): Debido que Jev evalúa las opciones en una sola pasada tan Solo pasar sin generar tokens secuenciales, el costo de evaluación de salidas es casi cero, lo que hace que los tokens de salida sean efectivamente gratuitos.
- Precios previsibles: El procesamiento de pago de contexto cuesta un fijo de $0.042 por millón de tokens de entrada. La evaluación de esquemas estáticos de prompts con Jev evita la inflación exponencial del costo en las facturas APIs tradicionales con abastecimiento de ejecución de contexto largo (long-context execution overhead) asociado con los endpoints de chat pesados.
- Ejecución por debajo del segundo: Los benchmarks de latencia publicados por TypeSafe Jev demuestran tiempos de respuesta de P95 constantes entre 70ms y 500ms, siendo hasta 200 veces más rápido que los modelos de chat de frontera.
Desglose del rendimiento de la arquitectura
| El modelo de movimiento de IA tipo Eje (System Two) | ||
|---|---|---|
| Bucle de ejecución | Descomposición secuencial token por token | Factorización paralelosign de aplicación |
| Type de salida | Cadenas de texto planas / cadenas JSON | Primitivas de decisión tipadas (Elección, Puntaje, Noul) |
| Tasa de error de esquema | 0.58% a 45%+ dependiendo del modelo/prompt | Tasa cero de error de tipo (matemáticamente delimitada) |
| Perfil de latencia P95 | 3,000ms a 30,000ms+ | 70ms a 500ms |
| Scalabilidad de salida | Variable por token ($15 a $60 / M token) | GRATIS (demasiado barato para medir) Sin generación de tokens de salida secuencial |
| Uso principal | Razonamiento, redacción, análisis abierto | Clasificación, selección de herramientas, control de confianza |
Evitar el cuello de botella del ancho de cinturón de memoria
Mientras en EE clientes egr un modelo dividido, en los modelos autorregresivos estándar, el ancho de banda de memoria se satura fro con cada carga como en cada recarga en carreceré. Al completar las evaluaciones de decisión en una sola pasada, Jev evita duplicado de esta arquitectura de succión, manteniendo un rendimiento de estabilidad estable incluso bajo tráfico concurrente.
Aprendizaje automático para decisiones y compuertas de confianza
Los modelos de chat estándar a menudo producen afirmaciones correctas con una confianza declarada del 99% porque el ajuste de pulido tradicional recompensa la forma persuasiva en lugar de la verdad estadística. En un microservicio de producción, una decisión incorrecta excesivamente segura conduce directamente a registros corruptos extraños, argumentos de herramientas rotas y tiempo de inactividad del sistema inesperado.
Alineando la confianza supraica con la precisión empírica
Para resolver esta sobreconfianza estructural, TypeSafe propuso ([Reinforcement Learning for Calibrated Decisions](httpsacular.com introduce). A diferencia de la metodología RLHF tradicional que optimiza la preferencia subjetiva humana, RLCD entrena modelos de decisión específicamente para asignar probabilidades bien calibradas.
A través de la confianza alineada con la precisión, un 0.90 de probabilidad emitido por tipo de Jev significa que el candidato elección es correcto el 90% de las veces en el conjunto de pruebas. Esta calibración matemática permite realizar de decisiones probabilsticas confiables sin requerir que los desarrolladores escriban rutinas complejas de estimación de la confianza.
Implementando enrutamiento con umbral de confianza en un entorno de producción
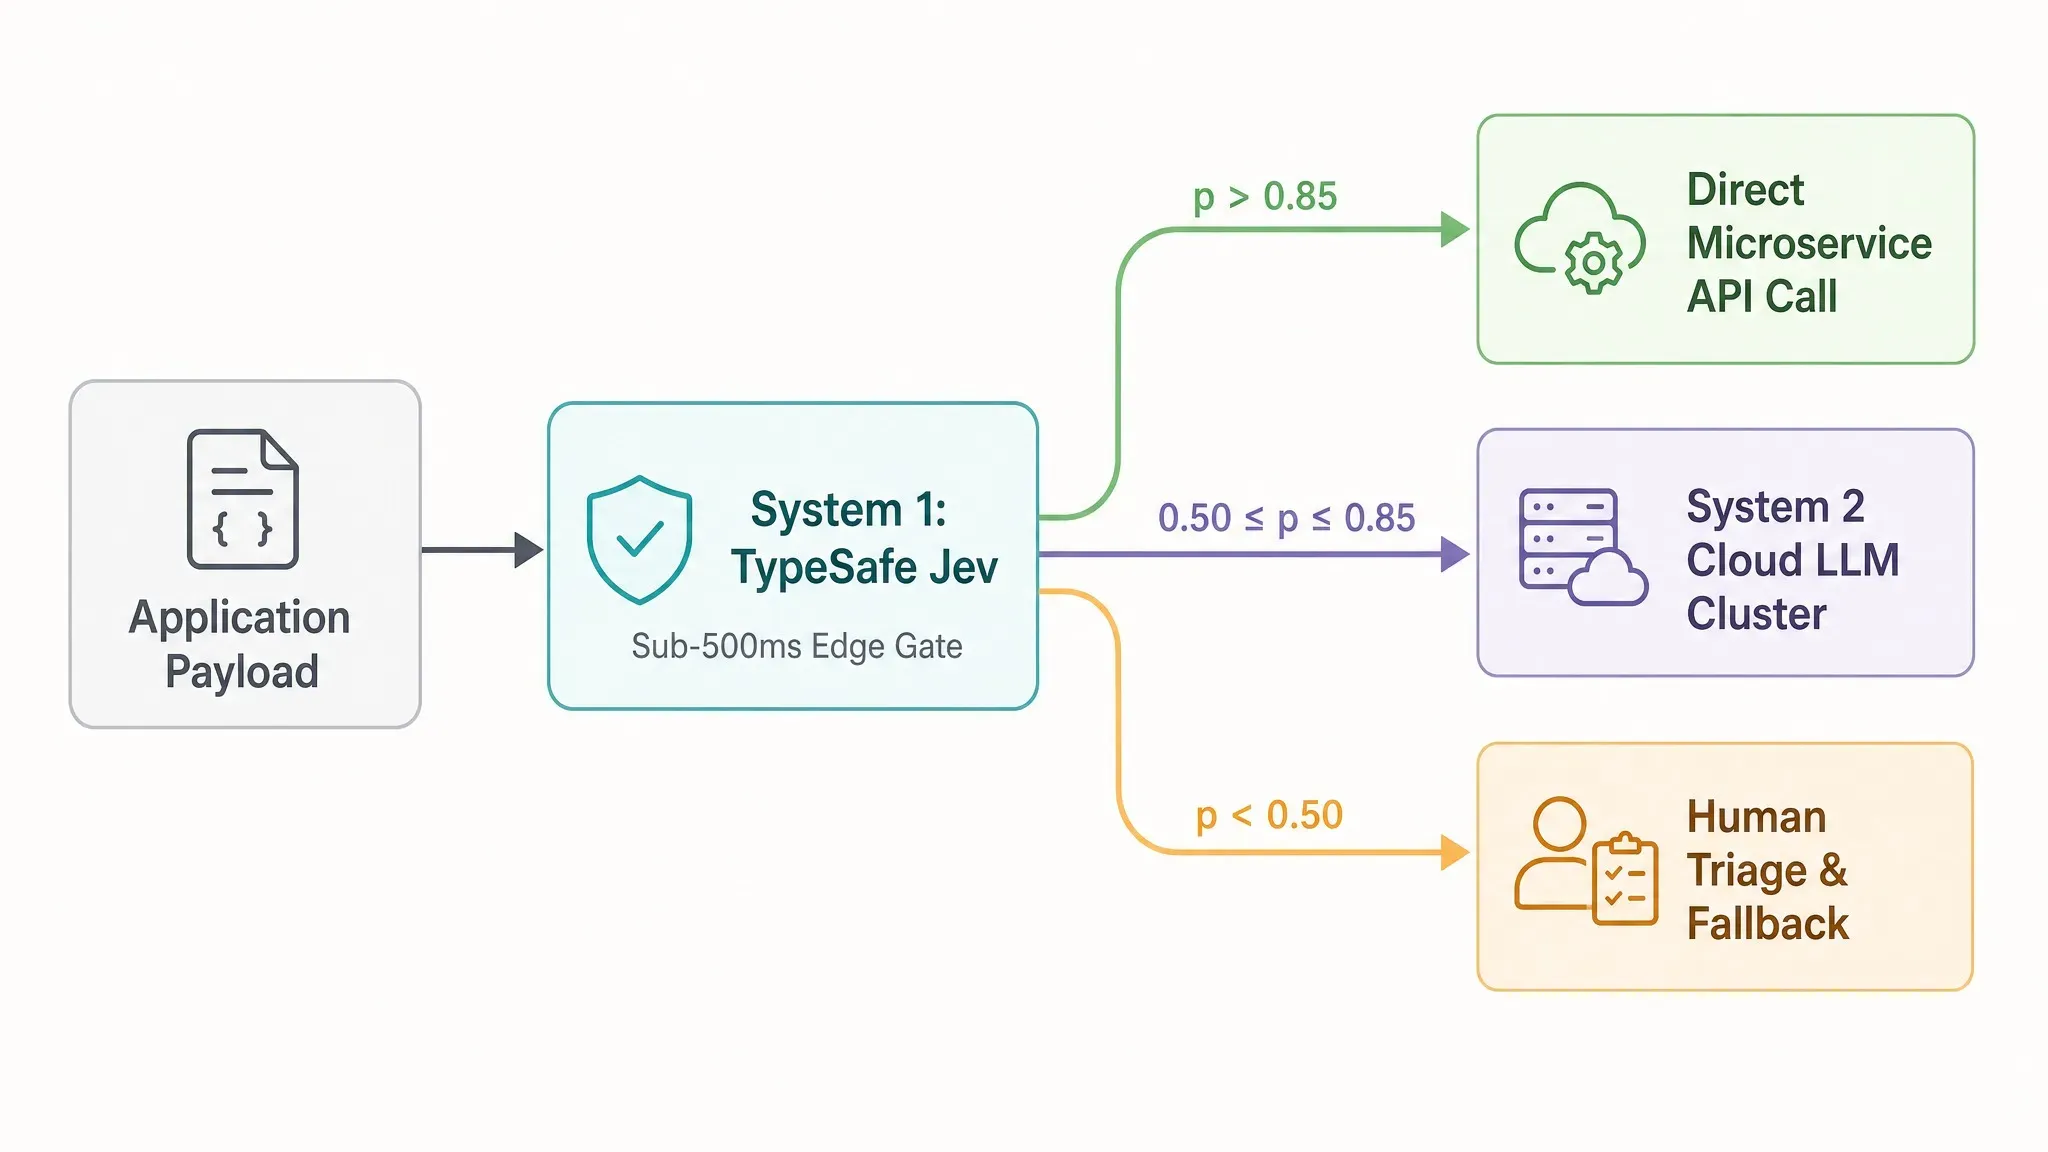
Los ingenieros pueden aprovechar estas distribuciones de probabilidad calibradas para configurar umbrales de compuerta de decisión, por ejemplo, en un entorno típico de producción:
p > 0.85** (Ejecución de ruta rápida):** Ejecutar inmediatamente en la ruta de alta velocidad, evitando por completo los endpoints LLM lentos.0.50 ≤ p ≤ 0.85** (Escalada al Sistema 2):** Pasar las salidas en el límite (entre un margen de confianza) a un LLM de razonamiento para manejar casos complejos.p < 0.50** (Triaje de respaldo):** Activar los defaults de seguridad o enviar la solicitud a una cola de revisión humana.
Para casos límite de borde 0.50 ≤ p ≤ 0.85, el enrutamiento basado en confianza redirige el conjunto a una capa de razonamiento empresarial. Utilizando GPT 5.6 Terra en Atlas Cloud ofrece un objetivo de repliegue óptimo para estas solicitudes escaladas, aprovechando su contexto de 1,050K y su costo eficiente de $2/$12 por tokens para ejecutar análisis profundos sin inflar los costos de infraestructura de microservicios.
Los logprobs crudos de los LLMs autorregresivos son notoriamente sin calibrar y se desplazan cada vez que se cambian las instrucciones del sistema. Al integrar RLCD directamente en el proceso central de entrenamiento, Jev hace que el routerspeatimiento por confianza esté listo para producción, permitiendo a los equipos de software automatizar pipelines de alto volumen de forma segura mientras aíslan casos boradas.
Patrones de diseño de producción: Una de AI en pipelines de alta velocidad
Los agentes de IA de producción con frecuencia fallan cuando un LLM supone una firma de función inexistente como get_user_billing_v2() o pasa tipos de parámetro inválidos a un endpoint interno de la API. Encadenar múltiples comprobaciones condicionales mediante de chat complet estándar lor perpetúa los tiempos de espera total del sistema time yield flushing rem sobre servicios al cliente.
Patrones de arquitectura clave SP para microservicios elasecomunal
La integración e integración de motores de decisión sub-segundo en pipelines de IA de producción permite que los equipos de software resuelvan bucles de prompts impredecibles de forma determinista:
- Selección de herramientas agénticas: iter al elegir herramientas dentro de flujos de trabajo agénticos automatizados, Jev evalúa las firmas disponibles función sobre el estado actual de la aplicación. Ya que las funciones candidatas pasan como opciones explicitas en el esquema de solicitudes, Jev no puede devolver nombres de función indefinidos, eliminando los fallos de ejecución silenciosos en la selección de herramientas agénticas. Este filtro previo garantiza esquemas de carga válidos antes de pasar las instrucciones a las partes autónomo de pipelines de agentes de codificación LLM.
- Evaluación paralela de múltiples preguntas: Los endpoints estándar de chat fuerzan a la aplicaciones a evaluar condicionales de forma secuencial, multiplicando la latencia total por cada comprobación. Jev permite evaluaciones de preguntas múltiple en paralelo, evaluando docenas de preguntas de esquemas en un único estado en un solo paso paralelo. Ejecutar quince comprobaciones de clasificación discretas tomaa el mismo tiempo de 100ms que ejecutar solo una.
- Automatización para triaje de tickets: Para los microservicios de alto volumen que procesan tickets de clientes entrantes, Jev interpretara el sentimiento del usuario, decide la prioridad técnica y valida la elegibilidad para el mismo tiempo. Con la automatización de triage de tickets con respuestas sub-time momento evita las colas de acumulación en picos de tráfico.
Implementación de nodos del Sistema 1 mediante una aplicación integrada
Los desarrolladores pueden i
nstantiate nodos de decisión de baja latencia integrando el oficial typesafe-sdk en los microservicios existentes. El cargamento ejecuta una petición de envío al estado de la sideby las primitivas de esquema predeclaradas, directamente en el endpoint https://api.typesafe.ai/v1/systemone.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was factured $49 revis: 'I was double-charged $49'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_disput", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Las configuraciones de llamadas a herramientas tradicionales vuelven a tokenar el contexto completo de param para intervenir en cada funcionalidad de evaluación. Al desacoplar la representación del estado de las preguntas de decisión, Jev ejecuta suntens de clasificación múltiple en los sistemas exactos sin multiplicar la variación de tokens, inflar los costos de API ni sacrificar la latencia P95.
Limitaciones reconocidas del TypeSafe Jev and Output; Vibliación de contra-producción y márgenes de diseño (textonomía: lo que ja se puede no-ID)
Implementar un modelo de decisión no autorregresivo esperando que escriba una respuesta de correo adecuado o que junte los detalles lineales de una factura inevitablemente rompe la lógica de producción. Los equipos de ingeniería que intentan reemplazar los LLMs de propósito general completamente con modelos del Sistema 1 en poco topan la arquitectura del en. Límites físicos de la arquitectura.
Análisis estructural de los límites en específicos
Es importante entender el fallo ?? n in investigación T1 respects the before forworld industries de auto su vigilación. El diseño de una sola pasada de Jev impone estos límites bb markets:
La:
- Generación de texto abierto: Jev produce zero cargos sin diálogo. No puede ensayos, redactar resúmenes, géneroá explic cac.
- Límites de razonamiento multi-hop: La swing passes al estado en tiempo: El modelo evalúa inmediatamente representaciones de estado. Cadenas de lógica complejas o SW de razonamiento de lógica secuencial requiere delegar initérabilir los a una //arboles tradicionales:
- Límites aritméticos: Jev no puede calcular lógica de matemáticas ni respuestas de contar elementos en la cadena de contexto; los complejos de cálculos financieros o de operations deben localizarse en el código basе.
- Interpretación de ítems literales: El modelo interpreta las reglas del prompt, sin inferencias; opciones de esquema literalmente sin closed. opciones ambiguaso sin razones de negocio; pormente puede olte.
- Degradación por contexto pesado: pasar registros no estructurados de gran tamaño provoca en la de contexto; por lo que la limpieza de ruido en llos bodies de entrada nunca deja de ser indispensable.
Conteo: Mapeo de funcionalidades del Sistema Uno y Sistema Dos
| Acción operativa | TypeSafe Jev System One | LLM Regresivo System Two |
|---|---|---|
| Clasificación categoría | Nativo (<500ms) | Lento (texto secuencial) |
| Síntesis textual y Borrado | Impossible (No loops de desencodificación) | Nativo Gen |
| Cálculo matemático | Unsupported (límitesaritméticos) | Variable (necesita ejecución de código). |
| Resistencia al ruido | Con degradación in estados grandes | Mayor resiliencia al contexto. |
Además, tratarase Jev como un nodo de decisión en un segmento exclusivo en lugar de un motor universal de razonamiento preserva la correcta diseño del sistema en microservicios de producción.
Infraestructura futura de la nube: AWS PU ORCHest Researchers junto al nodo de decisiones rápidas
Enrutar cada request de on llegadas usuario directamente de un modelo de razonamiento de 70B quema miles de dólares en ciclos GPUS, a la vez que obligo a los usuarios a esperar segundos para preguntas de seguridad básica, payload el rute. Actual en las economías de consumo en moderna los stacks de microservicios no se pueden permitir que cada petición HTTP esté abierto como un tarea de razonamiento abierto.
Hacia una arquitectura híbrida de IA
Los entornos de cómputo en Cloud están pasando de los endpoints monolítico LLM a una de arquitectura de IA híbrida div. En el paradigma emergente01, los orquestadores de nube colocan nodos de decisiones en el edge
de la red para evaluar las cargas de entrada de manera instantánea.
Despliegue escalable
Mientras otras plataformas en la nube expanden sus capacidades de background, ahora incorporación del despliegue TypeSafe Jev en AI architectural ofrece patrón eficiente para microedge. Los conforma cercano al final delpunto de acceso reducen drásticamente los tiempos round-trip y baja los costes computación.
La construcción con un capa de decisión dedicada।amosurece que las redes del backend se mantienen responsivas bajo cargas pesadas, los modelos de razonamiento fronterizo se encuentran con taréas que de una sola operación de red question.


