Última actualización: Wan 3.0 ya está disponible desde el 24 de agosto de 2026.
Creaste una carpeta para un anuncio de 15 segundos. Dos fotogramas de personajes. Un video de tono de marca que el cliente envió. Un libro de marca que solo existe como PDF. Una muestra de voz del actor que realmente quieres.
Luego abriste tu modelo de video y te pidió una sola imagen.
Así que hiciste lo que todos hacen. Tradujiste la carpeta a un prompt de 800 palabras y rezaste. La cara se desvió en el plano tres. La chaqueta cambió de color. La voz era de otra persona completamente.
La referencia omni de Wan 3.0 es la primera vez que un modelo de video dice: está bien, dame la carpeta. Hasta 20 activos en una sola llamada, en cinco tipos de entrada, mantenidos juntos a lo largo de una toma continua de 30 segundos.
Este artículo hace tres cosas y se salta el resto. Desglosa qué son realmente esos 20 activos, utiliza los propios clips generados por Alibaba como evidencia, y te da un flujo de trabajo equivalente que puedes ejecutar hoy, porque Wan 3.0 sigue en beta pública en la nube de Alibaba y aún no se puede llamar desde plataformas de terceros.
Conclusiones clave
- La referencia multimodal de Wan 3.0 acepta hasta 20 activos en una sola llamada, abarcando imágenes, videos, audio, documentos y páginas web en vivo, y los mantiene consistentes a lo largo de una sola toma de 30 segundos.
- Es el primer modelo de video convencional que trata un PDF, una presentación de diapositivas o una URL como una entrada creativa en lugar de algo que parafraseas en un prompt.
- Wan 3.0 entró en beta pública el 6 de agosto de 2026 en Alibaba Cloud Model Studio y Qwen Cloud como
wan3.0-video. Tiene pesos cerrados. Cualquiera que te diga que ya es Apache 2.0 está adivinando. - El titular de los 20 activos no es donde realmente destaca. Los modelos de referencia a video que puedes llamar ahora mismo ya aceptan más de 20 activos. La diferencia son los documentos y las páginas web, no la cantidad.
- Puedes probar el formato de dos personajes, con referencia bloqueada y con voz completa, de forma gratuita con el generador de skits publicitarios AI gratuito de Atlas Cloud: cuatro fotos de producto de entrada, un skit hablado de 15 segundos de salida, sin tarjeta.
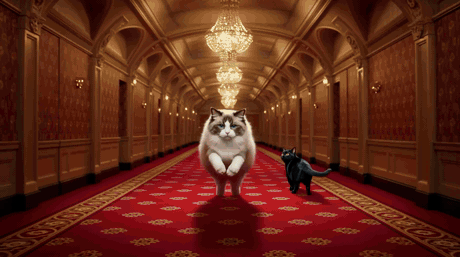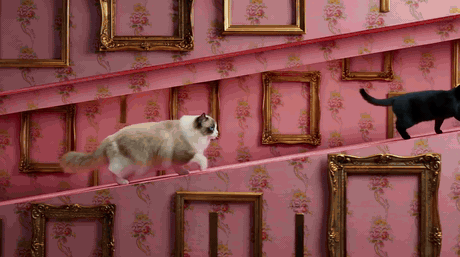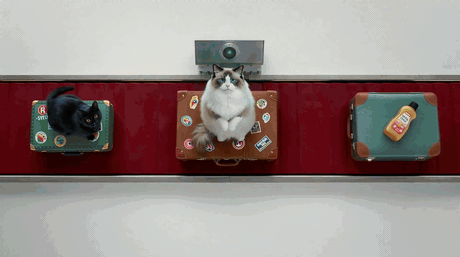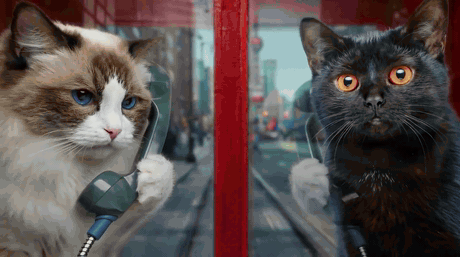
Dos gatos perseguidos a través de cinco escenarios diferentes por Wan 3.0 sin desviación de personaje_Dos imágenes de referencia. Cinco escenarios completamente diferentes, desde un corredor de hotel hasta un tambor de lavadora y una cabina telefónica roja. Ni un solo fotograma de desviación. Fuente: manual oficial del creador de Wan 3.0 de Alibaba_ Wan 3.0 creator handbook , agosto de 2026, que también es de donde provienen todos los demás clips de Wan 3.0 en este artículo.
Por qué el video de múltiples referencias se desmorona, y qué cambia la referencia multimodal de Wan 3.0
Los modelos de video no tienen memoria entre clips. Cada generación comienza desde cero. Ese es todo el problema en una frase.
Entonces, en el momento en que tu historia necesita más de un plano, estás cosiendo. El plano uno te da una cara que te encanta. El plano dos te da un primo de esa cara. El plano tres cambia silenciosamente la chaqueta de ciruela a burdeos, y para cuando te das cuenta, ya has pagado por once renders.
La referencia de imagen única ayudó, pero solo bloqueó una cosa. Una cara. No podía mantener simultáneamente una cara, un atuendo, un accesorio, una ubicación y una voz, porque había un solo espacio y cinco trabajos.
Hay dos formas de salir. Dale al modelo más espacios, o deja de hacer que comience de nuevo. Wan 3.0 hace ambas cosas a la vez, y por eso las dos características principales son realmente una sola característica. Una toma nativa de 30 segundos significa que no hay corte para que el personaje se desvíe. Veinte activos de referencia significa que cada elemento que debe permanecer fijo obtiene su propio espacio dedicado en lugar de competir por uno.
Esto es lo que parece cuando no se cose nada. Treinta segundos, una cámara continua, un niño en un carrito de compras que termina incrustado dentro de una valla publicitaria y luego sale de debajo de ella.
30 segundos completos en una sola pasada, sin cortes, con la banda sonora generada en la misma pasada. Fuente: manual oficial del creador de Wan 3.0 de Alibaba.
Qué significan realmente "20 activos" dentro de la referencia multimodal de Wan 3.0
Veinte es un número llamativo. Lo que importa es que los veinte no son todos del mismo tipo. La referencia omni de Wan 3.0 cubre cinco tipos de entrada, y cada uno controla un eje diferente de la salida.
Las imágenes controlan la identidad. Una ficha de personaje, una foto de producto, una placa de ubicación. Wan 3.0 llama a esto consistencia a nivel de píxel, y en los propios ejemplos de Alibaba, el bloqueo se extiende más allá de la cara a la vestimenta: la bata gris en capas, el jubón de cuero con correas, la faja oscura en la cintura sobreviven a una pelea cuerpo a cuerpo de dieciséis segundos en tres ubicaciones.
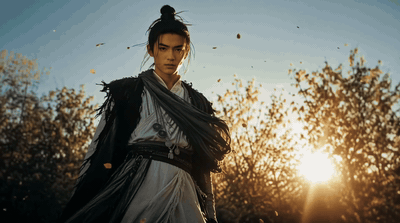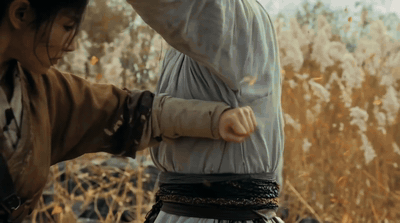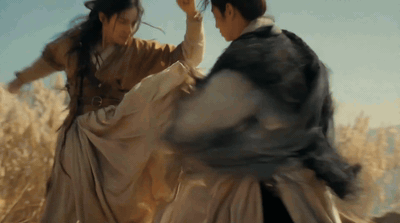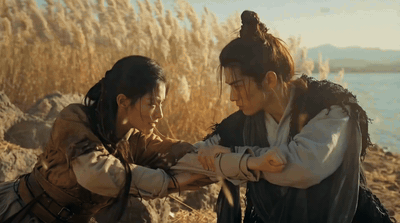
Dos fichas de personaje impulsando una escena de lucha wuxia con detalles de vestuario mantenidos fotograma a fotograma
Dos fichas de personaje más una placa de ubicación de la orilla de juncos. La vestimenta y el escenario se mantienen a través de cada lanzamiento. Se muestra aquí como un GIF silencioso; el archivo entregado lleva una mezcla estéreo de 44.1 kHz. Fuente: manual oficial del creador de Wan 3.0 de Alibaba.
El audio controla la voz. Esta es la parte que hace que "multimodal" sea más que marketing. Adjuntas una muestra de voz por personaje, escribes las líneas en el prompt, y el diálogo regresa en ese timbre, sincronizado con los labios, en la misma pasada que la imagen. Dos personas, dos referencias de voz, un gimnasio.
Dos imágenes de sujeto más dos clips de referencia de voz separados, y el diálogo regresa en esas dos voces. Vale la pena activar el sonido para este. Fuente: manual oficial del creador de Wan 3.0 de Alibaba.
El video controla el tiempo. Un video de referencia no está ahí para ser copiado. Está ahí para donar su ritmo: cuánto tiempo se mantiene un beat, cómo se mueve una transición. En este, cinco fotogramas clave proporcionan los sujetos y un video de referencia proporciona la cadencia de giro de tarjeta horizontal entre ellos.
Cinco fotogramas clave volteados con el ritmo tomado de un video de referencia_Cinco_ imágenes de fotograma clave para los sujetos, un video de referencia para el ritmo de giro. Fuente: manual oficial del creador de Wan 3.0 de Alibaba.
Los documentos y las páginas web controlan la estructura. Este es el realmente nuevo. Wan 3.0 acepta archivos de documentos y URLs en vivo como entrada creativa, y los informes de la beta enumeran .doc, .xls, .ppt, .pdf y .txt entre los formatos aceptados (AlphaSignal, agosto de 2026). La misma lógica ya funciona con una imagen de storyboard: un tablero de entrada, seis planos de salida, en el orden del propio tablero.
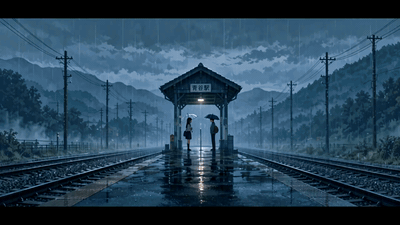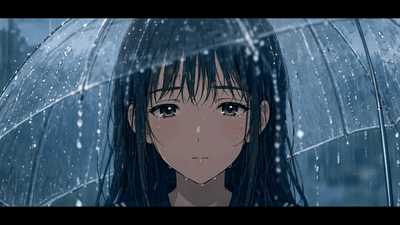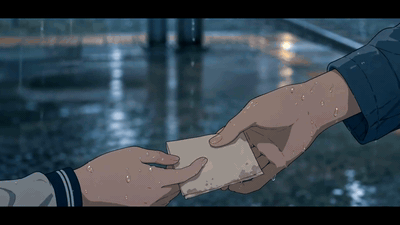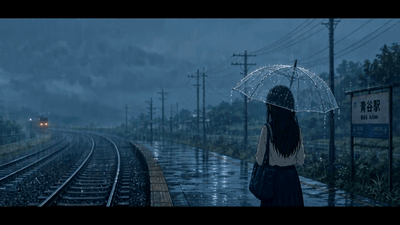
Una sola hoja de storyboard expandida en seis planos secuenciales en una plataforma de tren lluviosa
Una hoja de storyboard como referencia, seis planos generados en su orden, hasta el paso de notas en el plano cinco. Fuente: manual oficial del creador de Wan 3.0 de Alibaba.
Los primeros y últimos fotogramas controlan los puntos finales. El truco más antiguo del libro, aún compatible, sigue siendo la forma más rápida de delimitar un plano.
Así es como se compara con la versión que la mayoría de la gente usa realmente hoy.
| Wan 2.7 Referencia a video | Wan 3.0 referencia omni | |
|---|---|---|
| Activos de referencia | una imagen por sujeto, hasta 3 videos, 1 clip de voz | hasta 20 activos en total |
| Modalidades | imagen, video, audio | imagen, video, audio, documento, página web |
| Duración máxima, una pasada | 10 s | 30 s nativos, más duración inteligente |
| Audio en la misma pasada | sí | sí |
| Edición y extensión de video | no expuesto | edición basada en instrucciones y referencia, más extensión |
| Disponibilidad | en vivo en APIs de terceros | Alibaba Cloud Model Studio y Qwen Cloud beta |
Hay una regla que nadie pone en los documentos y todos aprenden a la fuerza: una referencia, un trabajo. Imagen1 bloquea la cara y el atuendo. Video1 dona solo movimiento. Audio1 dona solo timbre. En el momento en que le das a un solo activo dos trabajos conflictivos, o subes una imagen de referencia con dos personas, el modelo tiene que adivinar, y adivinar es exactamente lo que estabas tratando de evitar. El manual de Alibaba es contundente al respecto también: un sujeto por imagen de referencia.
El flujo de trabajo de referencia multimodal de Wan 3.0 que puedes ejecutar hoy
Respuesta directa primero. Wan 3.0 está en beta pública en la nube de Alibaba, bajo el id de modelo wan3.0-video (Alibaba Wan, agosto de 2026). Aún no ha llegado a plataformas API de terceros, incluido Atlas Cloud. Cualquiera que te venda acceso a la API de Wan 3.0 ahora mismo está revendiendo otra cosa.
Lo que ha llegado es la forma del flujo de trabajo. Paquete de referencia de entrada, una llamada, clip terminado con sonido de salida. Eso se ejecuta hoy en modelos de referencia a video que puedes llamar en una pestaña del navegador, y una vez que los alineas todos, el titular de los 20 activos se ve diferente.
| Modelo | Activos de referencia | Modalidades | Duración máxima | Audio nativo | Precio por segundo |
|---|---|---|---|---|---|
| Wan 3.0 (beta de Alibaba, no en Atlas) | 20 en total | imagen, video, audio, documento, página web | 30 s | Sí | reportado $0.05 a $0.20 por resolución |
| Wan 2.7 Referencia a video | 1 imagen por sujeto, 3 videos, 1 clip de voz | imagen, video, audio | 10 s | Sí | $0.10 |
| Seedance 2.5 Referencia a video | 50 (30 imagen / 10 video / 10 audio) | imagen, video, audio | 30 s | Sí | $0.13 |
| MiniMax H3 Referencia a video | mixto, sin límite declarado | imagen, video, audio | 15 s | Sí | $0.10 |
| Kling Video O3 Pro Referencia a video | 7 imágenes, o 4 imágenes + 1 video | imagen, video | 15 s | Sí | $0.10 |
| Vidu Q3-Mix Referencia a video | 4 imágenes | imagen | 16 s | Sí | $0.11 |
| Veo 3.1 Referencia a video | 3 imágenes | imagen | 8 s | Opcional | $0.20 |
Los precios son las tarifas de Atlas Cloud a partir de agosto de 2026. Las cifras de Wan 3.0 son las reportadas para la beta de Alibaba Cloud, no una tarifa de Atlas, y Alibaba no ha publicado una página de precios pública para el modelo todavía, así que trata esa fila como provisional.
Lee esa tabla dos veces y la historia real aparece. El titular de los 20 activos no es donde Wan 3.0 se destaca, porque Seedance 2.5 ya toma 50 y alcanza los 30 segundos. Lo que ninguna otra cosa en esa lista toma es un PDF.
Para el tutorial a continuación, la demo se ejecuta en Wan 2.7 Referencia a video, porque su forma de entrada es la más cercana a la referencia omni: múltiples imágenes de sujeto, un video de referencia opcional y un clip de voz, todo mapeado a las etiquetas character1 y character2 dentro del prompt. Tres modelos, una pestaña del navegador, sin instalación local.
Para una ejecución alojada actual, abre Wan 3.0 en Atlas Cloud y prueba un prompt como el de abajo antes de publicar el flujo de trabajo.
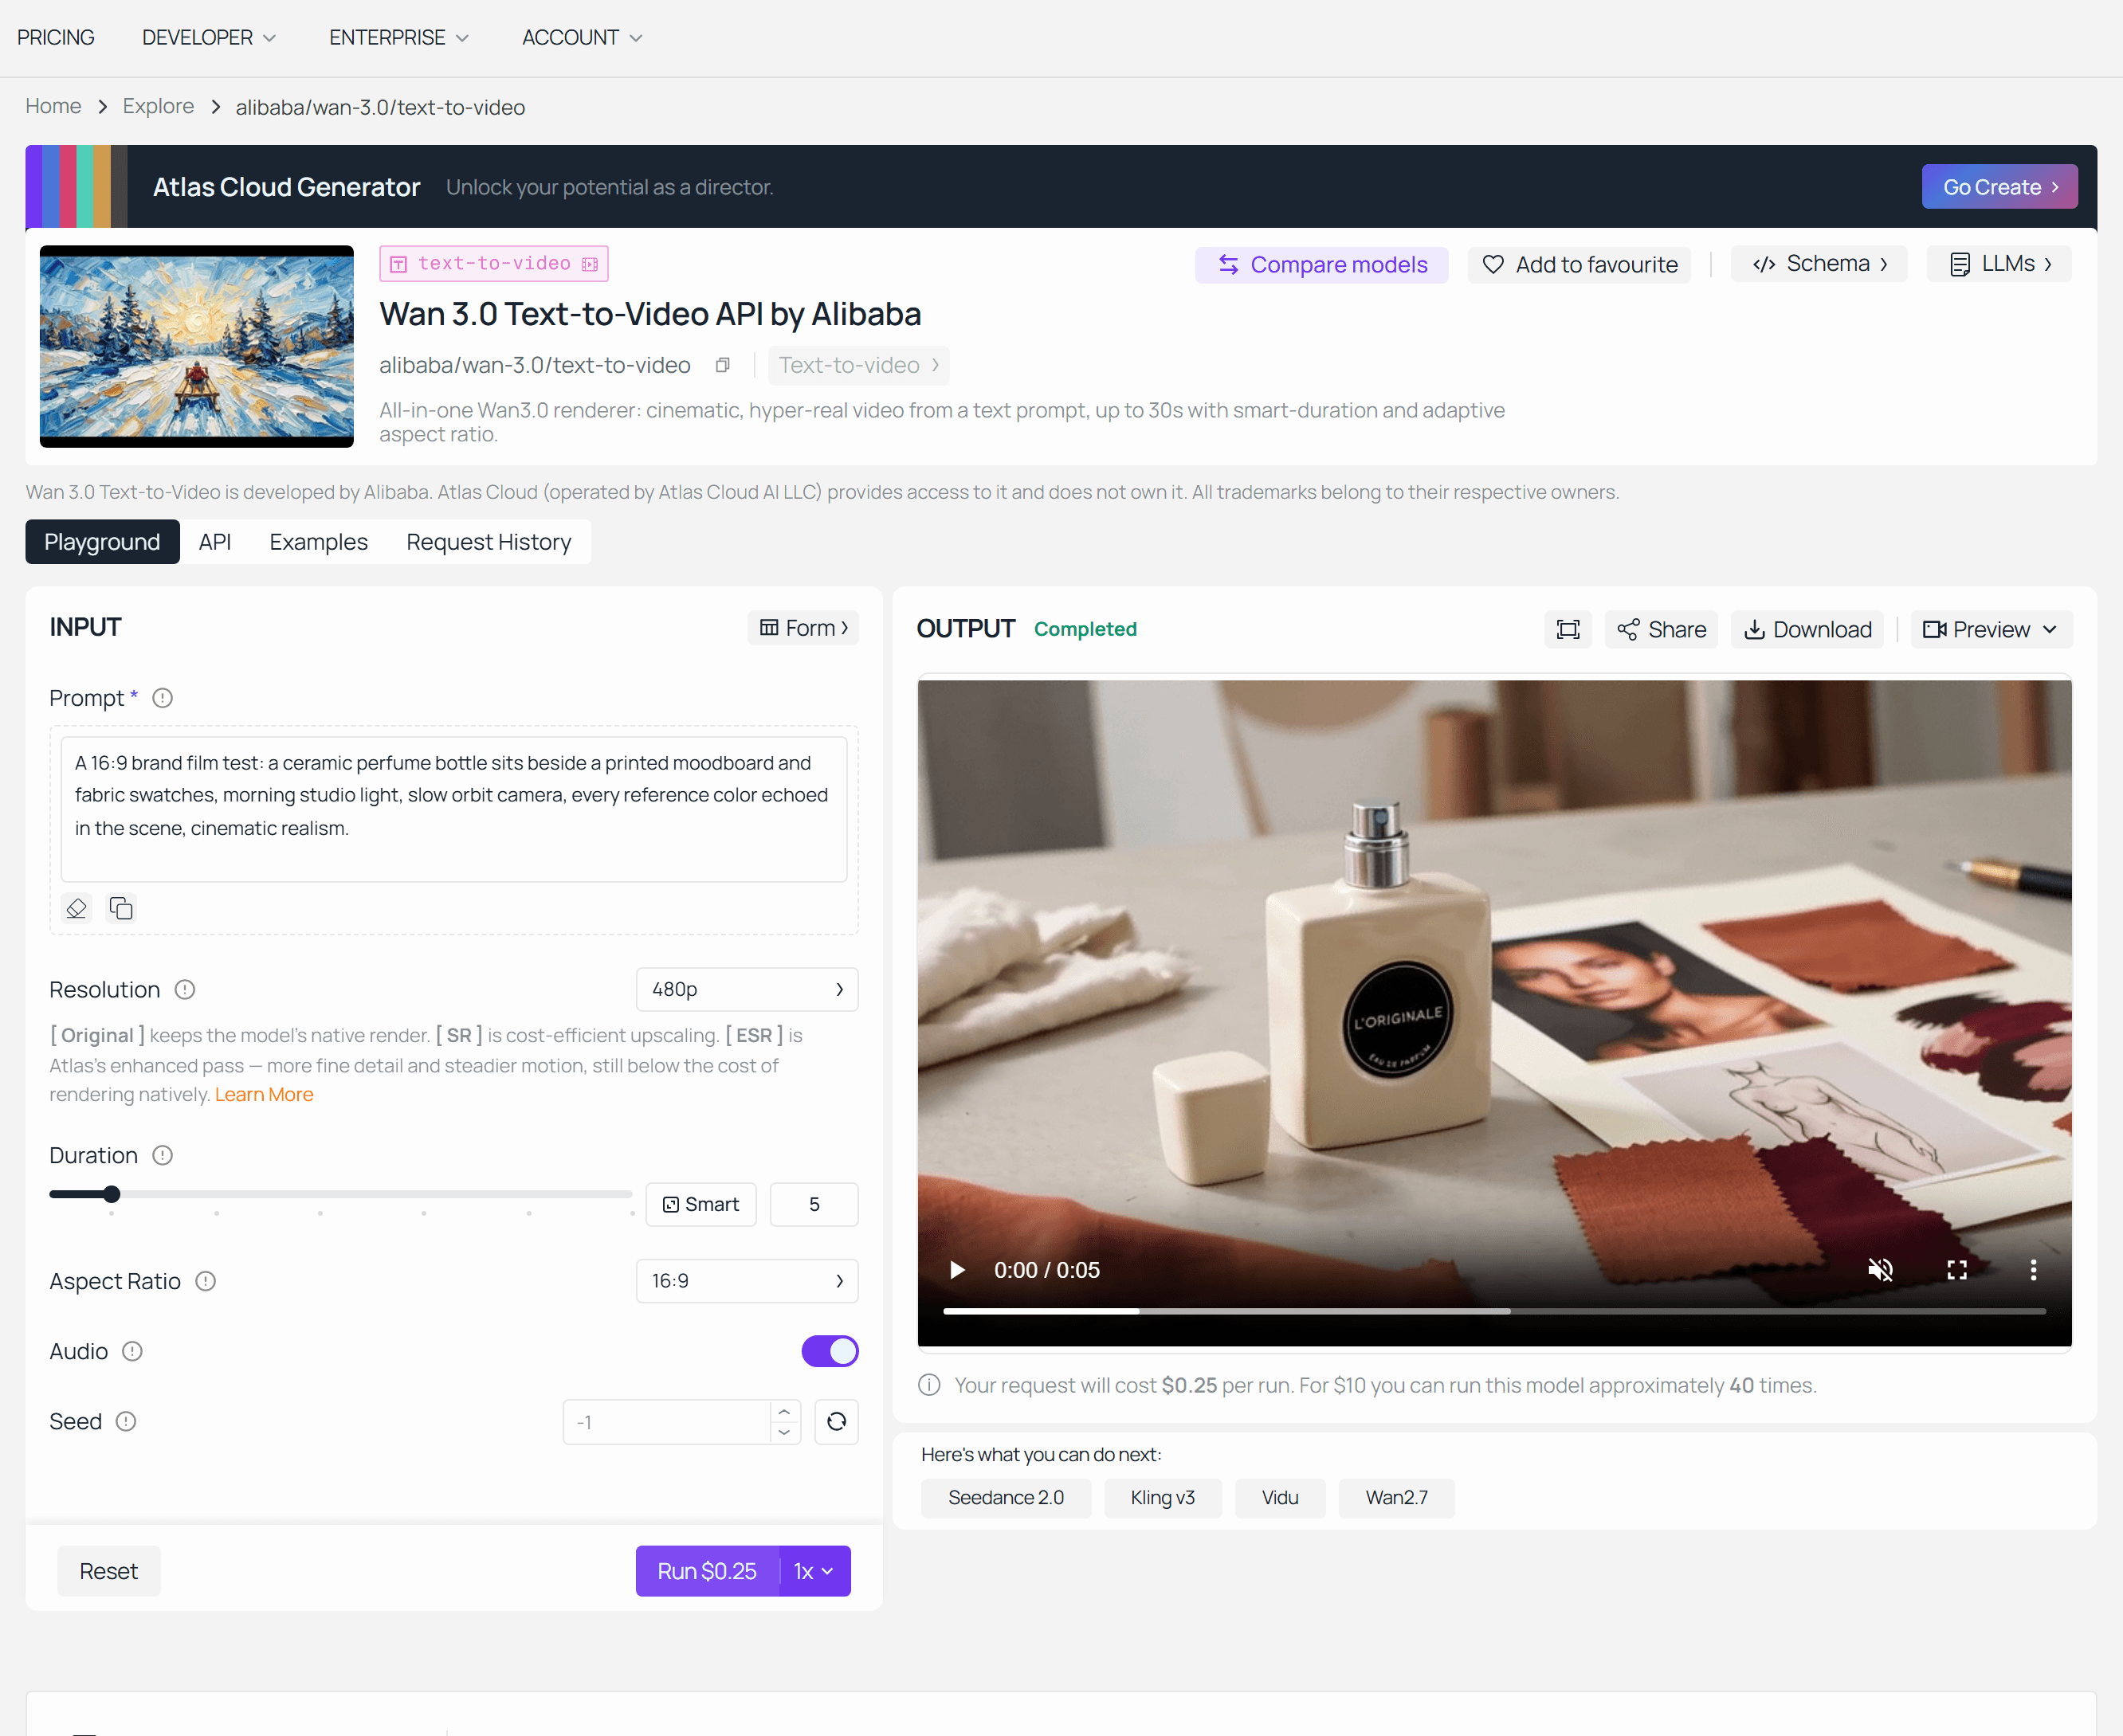
Captura de pantalla de Wan 3.0 prompt a resultado: entrega de marca de 20 referencias.
Constrúyelo tú mismo: una escena de referencia multimodal en cuatro pasos
La escena: una recepción de hotel de colores pastel. Un conserje inexpresivo. Un viajero que sostiene un gato de trapo. El conserje mira directamente a la cámara y dice "El gato tiene reserva. Tú no."
Dos imágenes más un clip de voz, que son tres activos de referencia en dos modalidades. Esa es la construcción más pequeña que es honestamente multimodal en lugar de solo multiimagen.
Paso 1. Generar la imagen de referencia 1, el sujeto que debes bloquear
Las imágenes de referencia tienen tres trabajos y solo tres: un sujeto, de frente a la cámara, fondo limpio. Todo lo demás es decoración. Usa GPT Image 2 con calidad high, tamaño 16:9, n=1.
Plain1Retrato de cuerpo completo de un conserje de hotel de mediana edad con expresión inexpresiva, de pie en el centro contra una pared plana de color rosa polvoriento. Lleva un uniforme de botones morado ciruela de doble botonadura con ribetes dorados y botones de latón, un pequeño gorrito de pastillero redondo y un bigote fino. Encuadre perfectamente simétrico, luz frontal suave y uniforme, sin sombra proyectada en la pared, grano de película de 35 mm, paleta pastel apagada. Solo un sujeto, sin otras personas, sin texto, sin logotipo, sin accesorios en el encuadre. 2
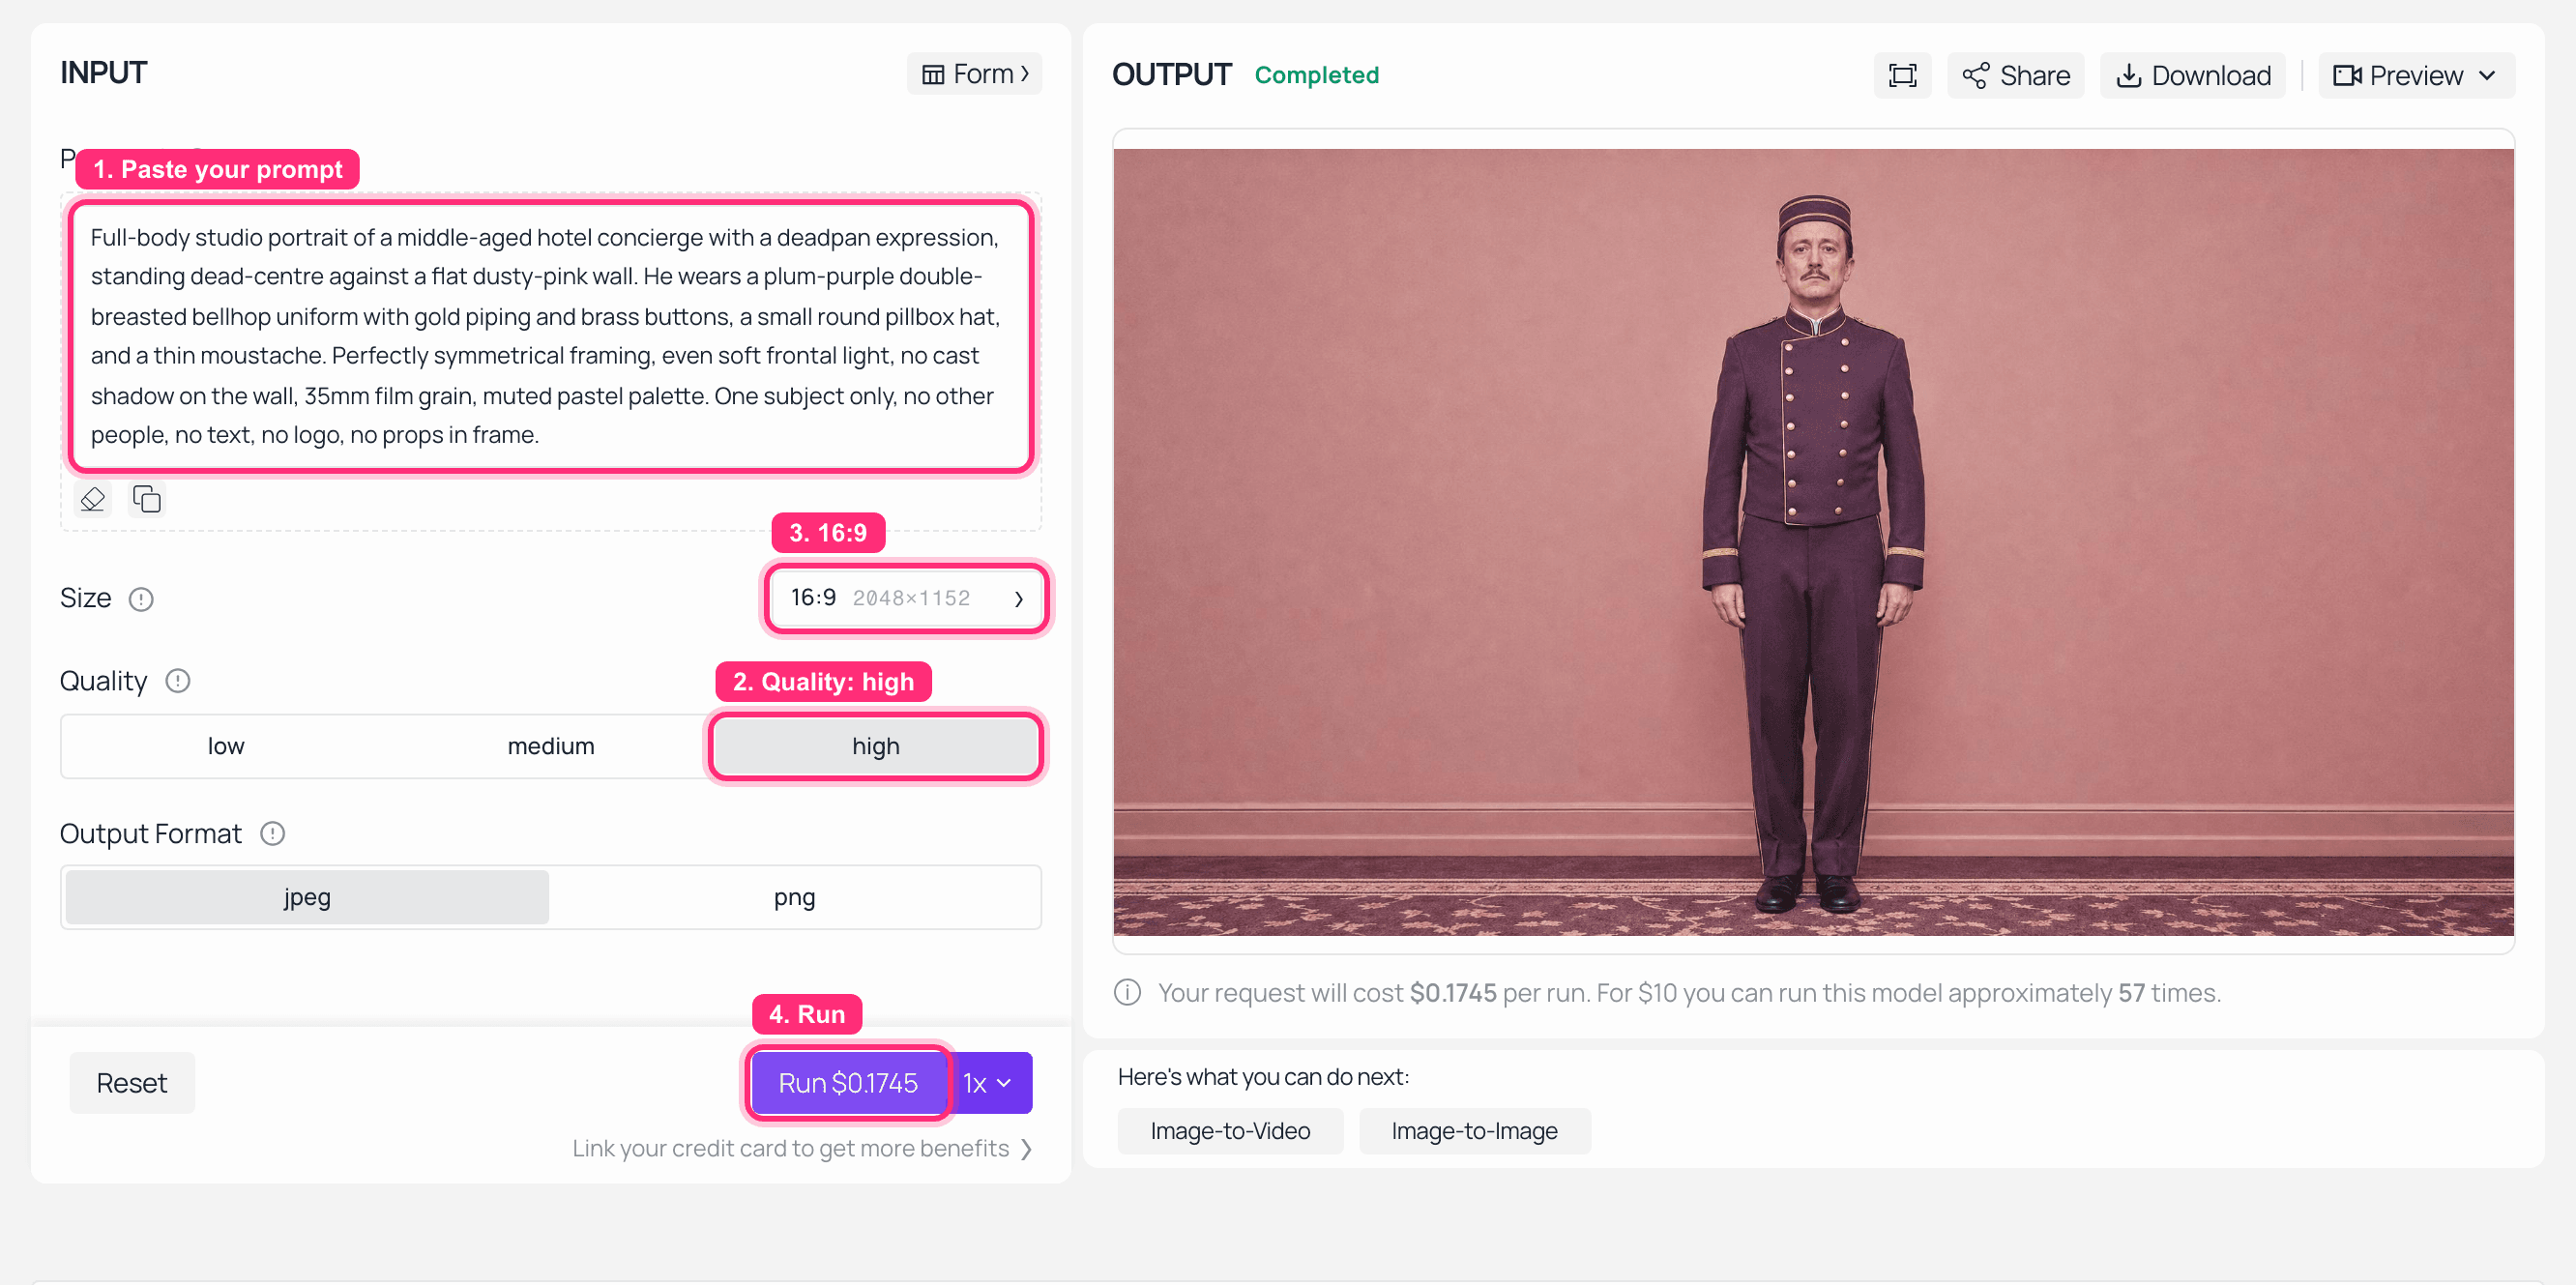
Área de juegos de GPT Image 2 en Atlas Cloud con el retrato de referencia del conserje renderizado en el panel de salida
GPT Image 2 en Atlas Cloud: calidad alta, 16:9, un sujeto, fondo plano. Este es el archivo que se convierte en character1.
Paso 2. Generar la imagen de referencia 2, el segundo sujeto bloqueado
Mismo modelo, mismas configuraciones. El contraste de color entre los dos personajes es deliberado, ya que le da al modelo una forma fácil de mantenerlos separados cuando comparten un encuadre.
Plain1Retrato de cuerpo completo de una joven viajera que sostiene un gato de trapo esponjoso contra su pecho, de pie en el centro contra una pared plana de color amarillo mostaza. Lleva un abrigo de lana mostaza, una boina roja y gafas redondas de carey, y sostiene una pequeña maleta de cuero vintage en la mano libre. Encuadre perfectamente simétrico, luz frontal suave y uniforme, sin sombra proyectada en la pared, grano de película de 35 mm, paleta pastel apagada. Solo un sujeto, sin otras personas, sin texto, sin logotipo. 2
Paso 3. Generar la referencia de voz, que es la parte realmente multimodal
El clip de voz es lo que convierte esto de un trabajo multiimagen en uno multimodal. El espacio de audio de Wan 2.7 quiere una muestra corta, aproximadamente de 1 a 10 segundos, así que mantén la línea corta. Usa MiniMax Speech 2.6 HD y elige una voz masculina grave, plana y despreocupada.
Plain1Buenas noches. ¿Se registra? Por supuesto. Todos lo hacen. 2
Paso 4. Una llamada, tres referencias, un clip terminado
Ahora todo el paquete entra junto en Wan 2.7 Referencia a video. Configuraciones: resolution: 1080P, ratio: 16:9, duration: 10, que es el límite de este modelo, prompt_extend: false, seed: -1. Carga images en orden, primero el paso 1, para que se mapee a character1, luego el paso 2 como character2, y adjunta el archivo del paso 3 a audio.
Plain1Plano general simétrico y centrado del vestíbulo de un hotel de colores pastel con mostrador de recepción, paredes rosa polvoriento y un tablero de llaves amarillo mostaza detrás. character1 es el conserje de pie detrás del mostrador; character2 es la viajera de pie frente a él, todavía sosteniendo su gato de trapo. La cámara se acerca lentamente a lo largo de un eje central perfecto y nunca se inclina. character1 mira directamente a la cámara y dice con voz plana: "El gato tiene reserva. Tú no." character2 parpadea una vez, gira lentamente la cabeza hacia el gato y luego vuelve al mostrador. El gato mira fijamente a la cámara sin moverse. Grano de película de 35 mm, iluminación suave y uniforme, paleta pastel apagada, sin movimiento de cámara, sin cortes. 2
Prompt negativo:
Plain1movimiento de cámara, cortes abruptos, subtítulos, texto en pantalla, marca de agua, personas adicionales, manos deformadas, transformación de rostro, cambio de color, desenfoque de movimiento 2
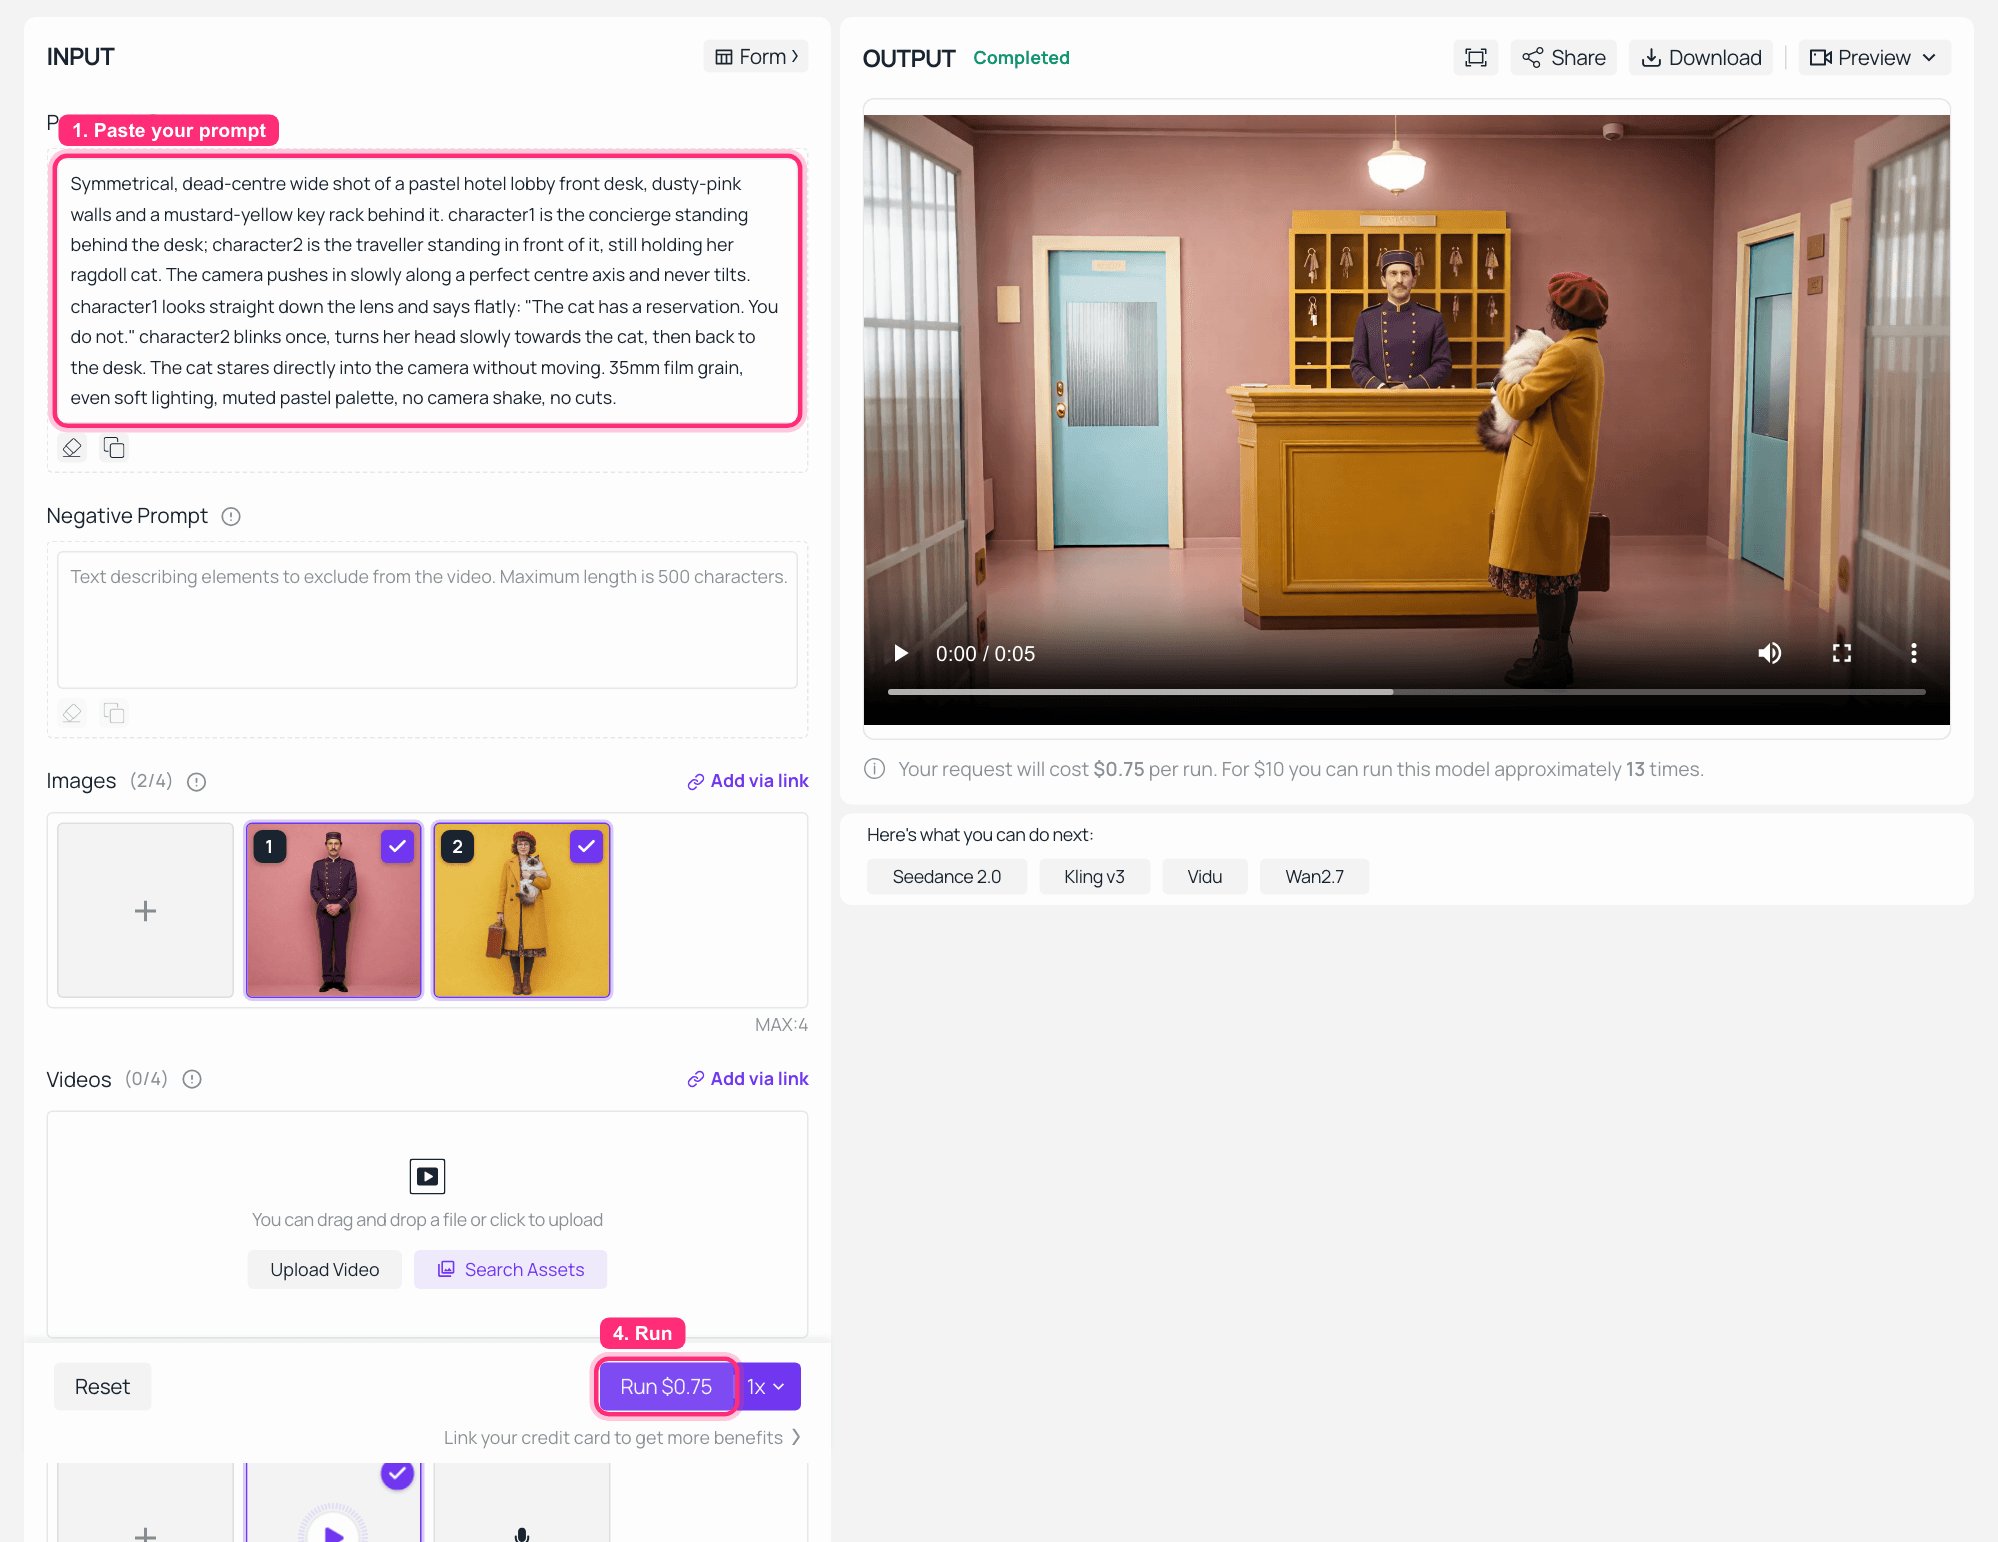
Área de juegos de Wan 2.7 Referencia a video en Atlas Cloud con dos imágenes de referencia y un archivo de audio cargados y el clip terminado en el panel de salida
Wan 2.7 Referencia a video en Atlas Cloud: dos imágenes de referencia y un clip de voz adjuntos a la izquierda, la toma terminada reproduciéndose a la derecha a 1080P y 16:9. Esta captura se ejecutó con la duración predeterminada del modelo; configúrala en 10 para la versión completa a continuación.
El clip terminado. Ambas caras se mantuvieron, ambos atuendos se mantuvieron, y la línea se entregó con la voz clonada del paso 3, así que vale la pena reproducir este con sonido.
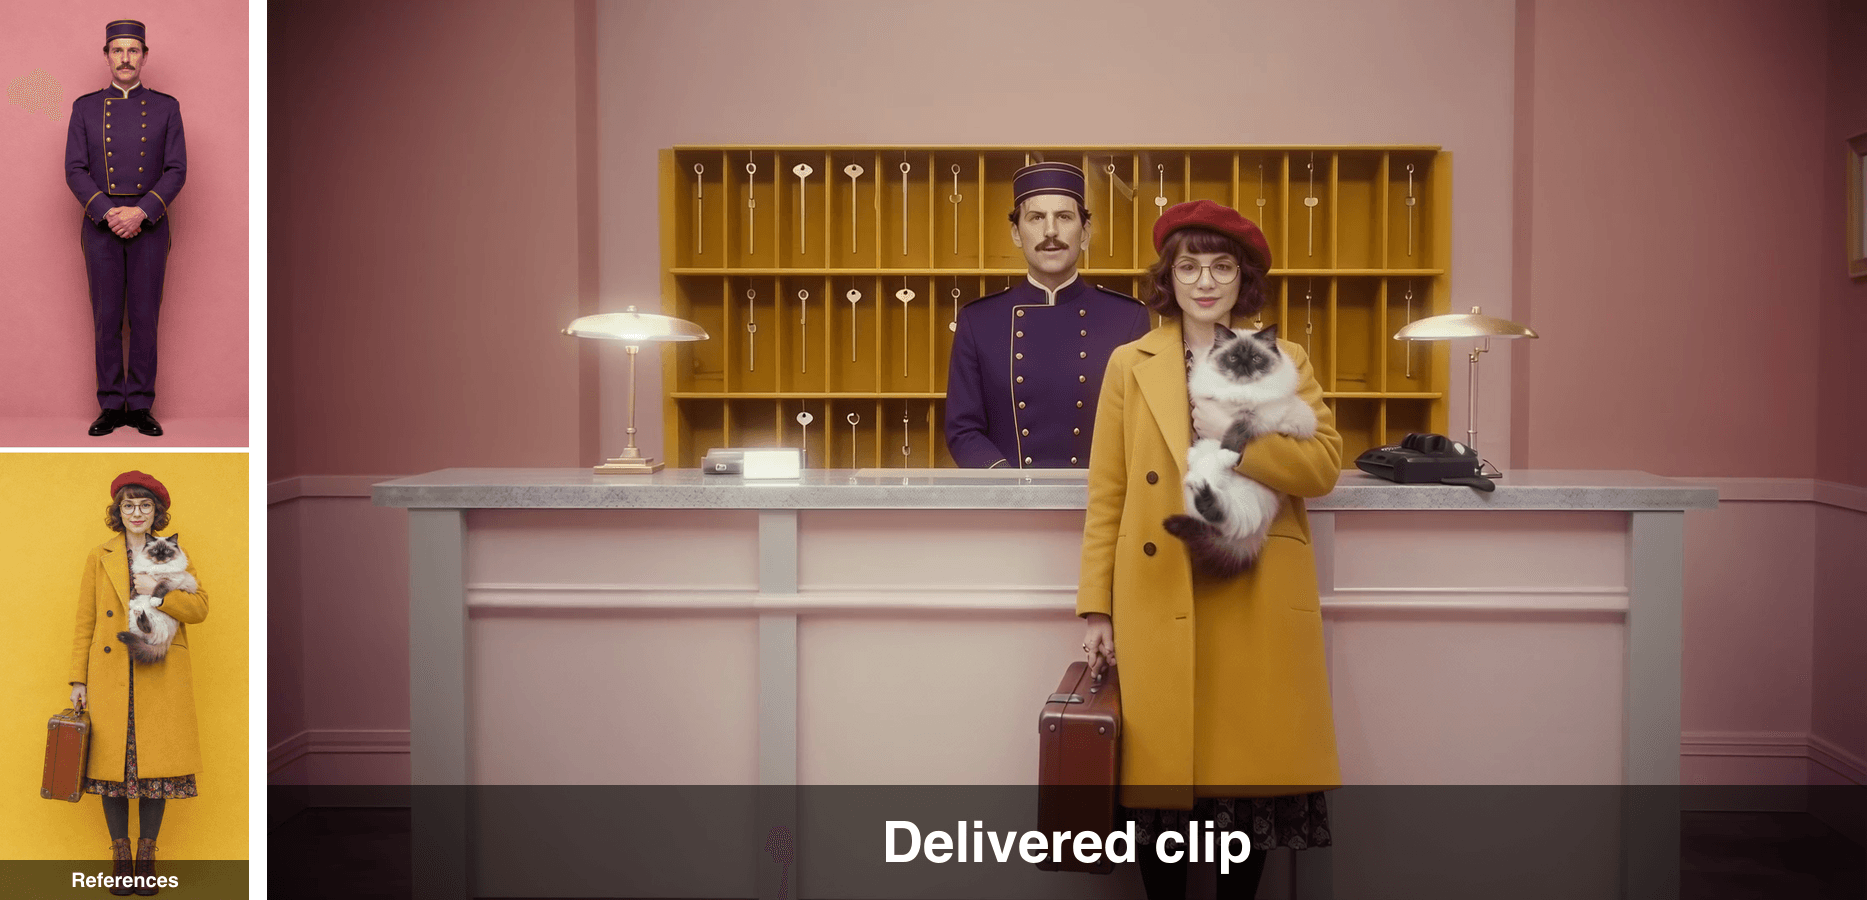
Los dos retratos de referencia junto a un fotograma del clip terminado, mostrando las mismas caras y atuendos
Referencias a la izquierda, un fotograma del clip entregado a la derecha. Los ribetes del uniforme, la boina, las gafas y el gato sobreviven al viaje.
Variaciones del flujo de trabajo de referencia multimodal de Wan 3.0
Llévalo a 30 segundos. El mismo paquete de referencia se ejecuta en Seedance 2.5 Referencia a video con duration: 30, lo que te da la duración que promete Wan 3.0 sin esperar la beta. Toma hasta 30 imágenes de referencia, 10 videos y 10 clips de audio, así que el paquete tiene espacio para crecer. Escribe los 20 segundos adicionales como beats en el prompt, no como vibraciones, o el modelo los rellenará.
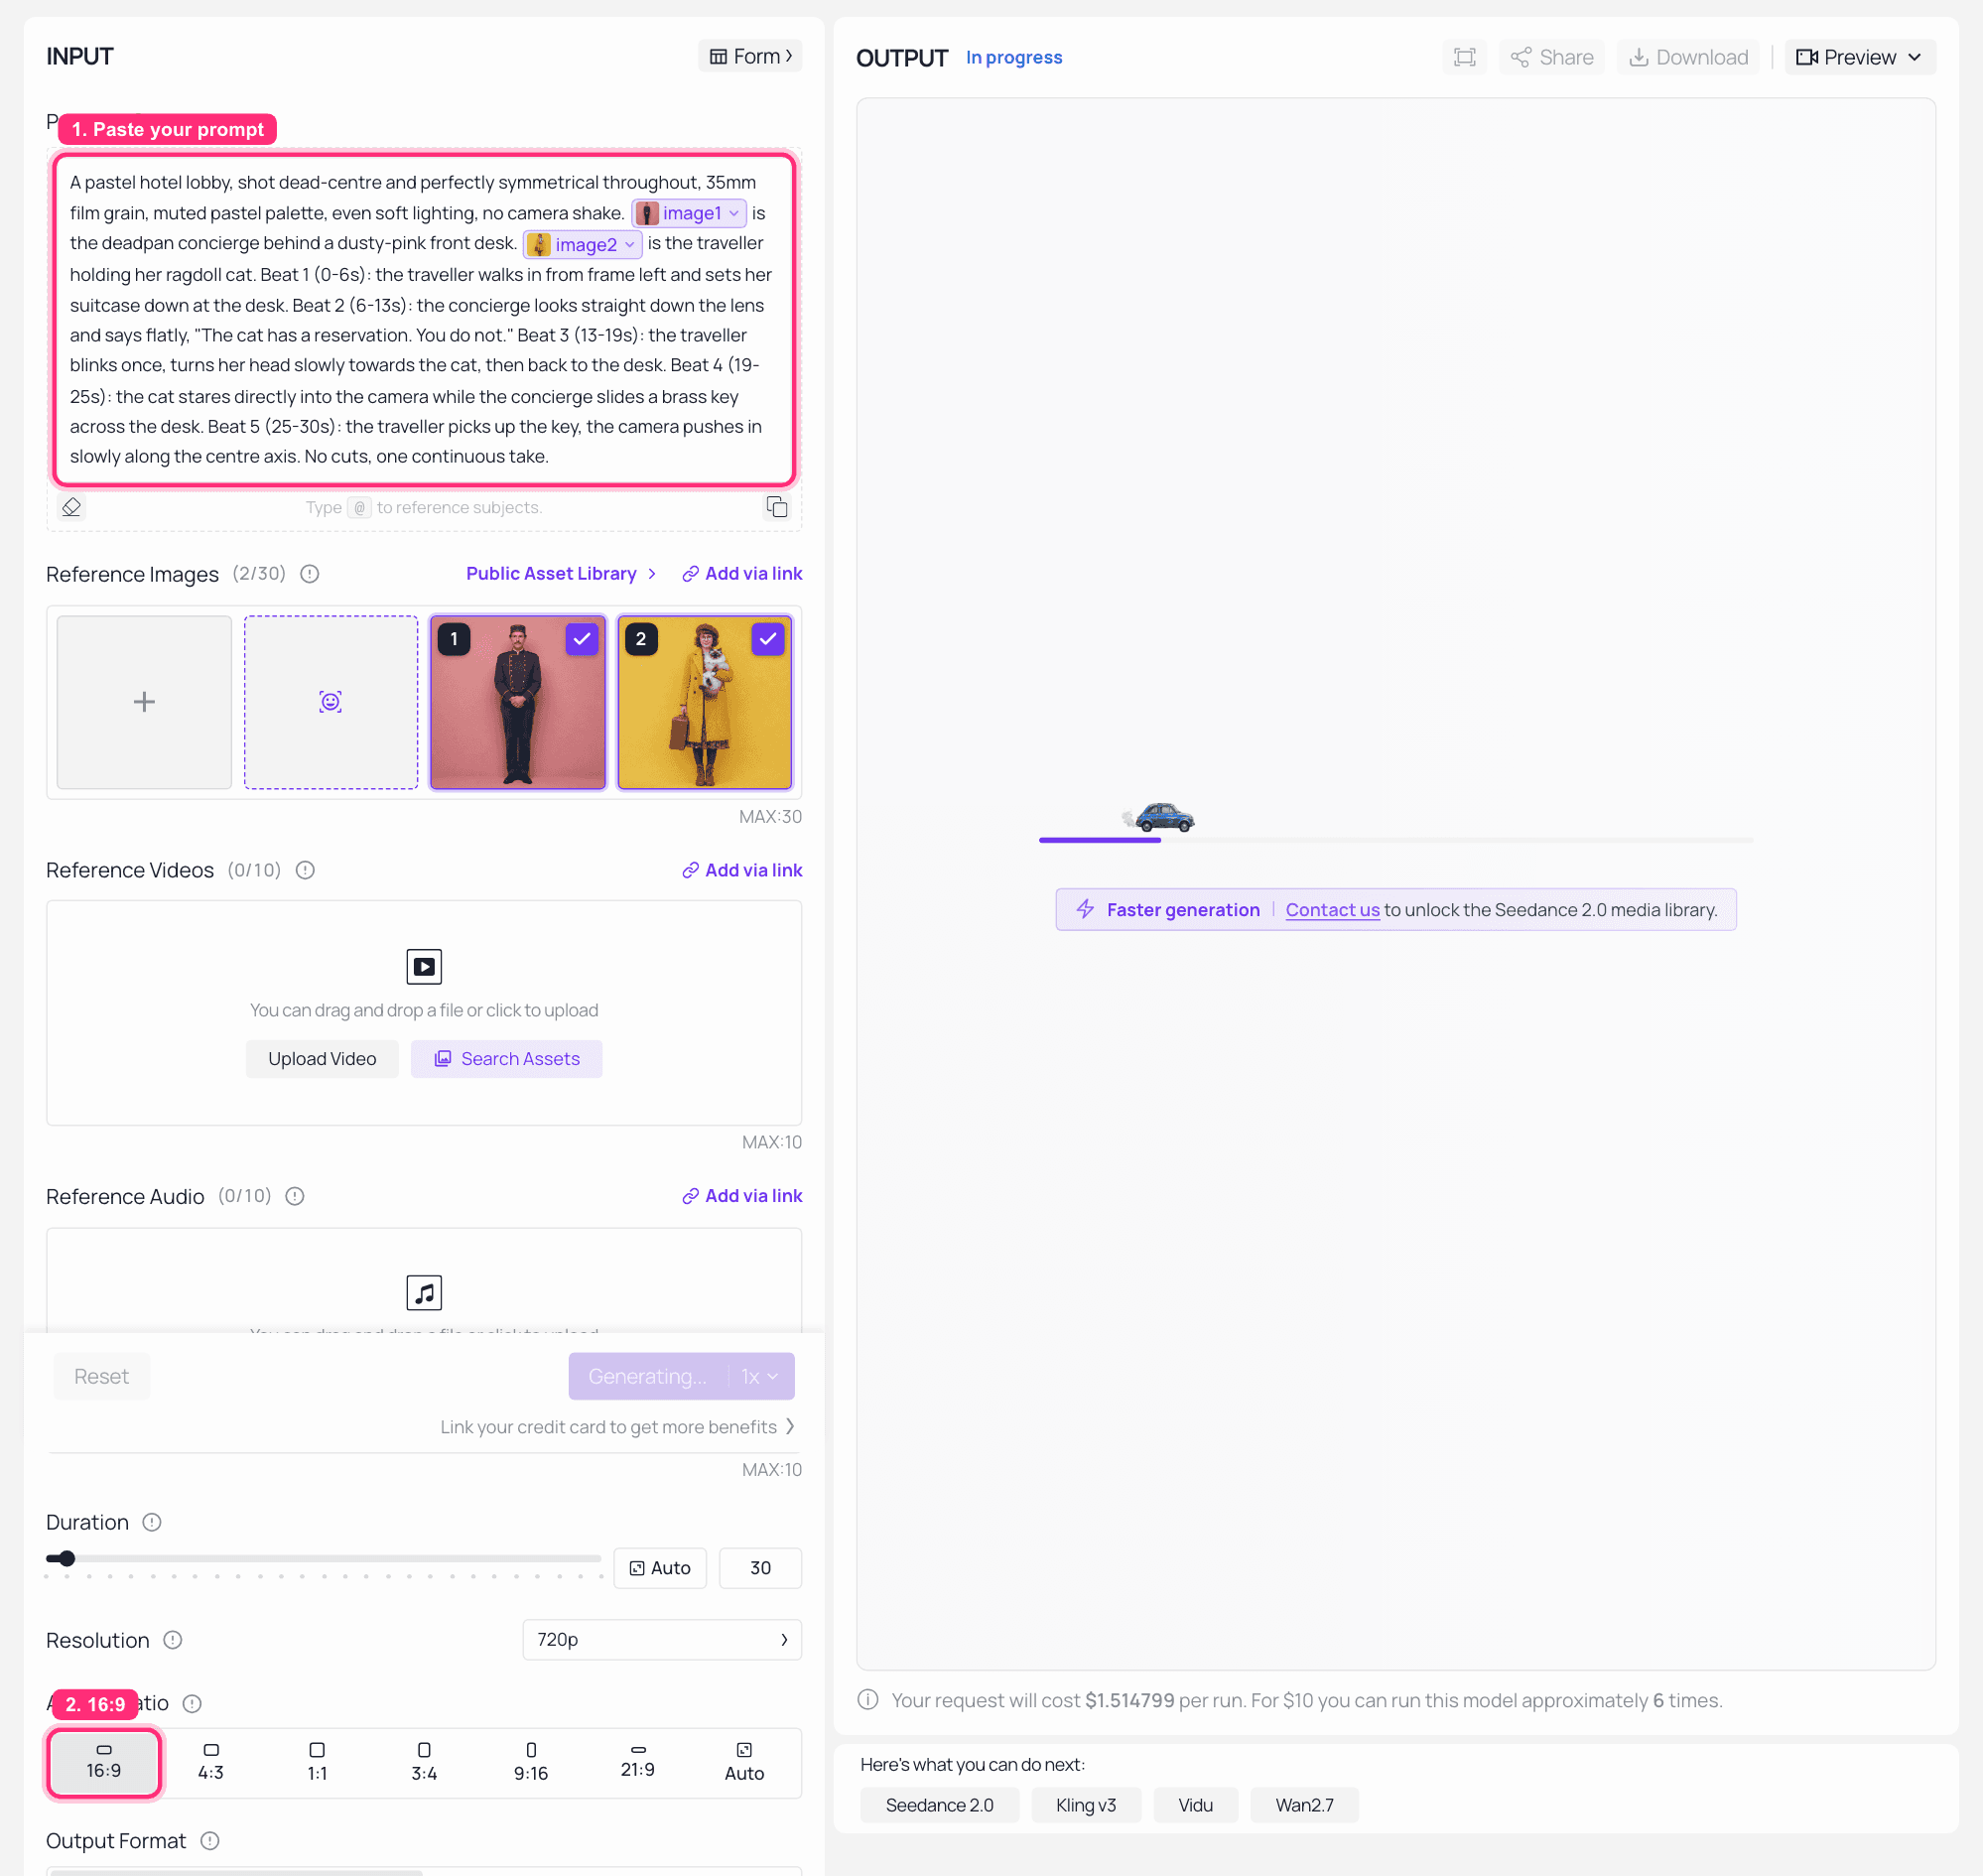
Área de juegos de Seedance 2.5 Referencia a video en Atlas Cloud con duración configurada en 30 y la toma larga renderizada
Seedance 2.5 Referencia a video en Atlas Cloud con duración configurada en 30 y los mismos dos retratos de referencia adjuntos, capturados a mitad de generación. Observa las fichas @image1 y @image2 en el prompt: así es como le dices a Seedance qué referencia interpreta qué parte. Verifica el precio citado en el botón Run antes de comprometerte, ya que refleja la duración que el trabajo enviará realmente.
La versión de 30 segundos de la misma escena, mismo paquete de referencia, beats escritos plano por plano.
Agrega un video de referencia solo para movimiento. Adjunta un clip cuyo ritmo te guste y dilo explícitamente en el prompt, algo como "sigue el video de referencia solo para el ritmo de corte, ignora sus sujetos y escenario". Ese es el truco detrás del ejemplo de giro de tarjeta anterior.
Arregla la deriva con el prompt negativo antes de tocar el positivo. La transformación de rostro, el cambio de color y el movimiento de cámara son los tres que arruinan las tomas bloqueadas por referencia, y generalmente son más baratos de suprimir que de describir en exceso.
Prueba el formato de referencia multimodal de forma gratuita
Si quieres la forma de esto antes de querer los parámetros, Atlas Cloud lanzó un generador de skits publicitarios AI gratuito la semana pasada que ejecuta la misma cadena sin ninguno de los controles.
Escribes una línea sobre tu producto y sus puntos de venta. Te escribe un guion de comedia de dos personajes, gancho, conflicto, giro, y luego renderiza un video de 15 segundos con diálogo hablado y efectos de sonido incorporados. Puedes adjuntar hasta cuatro fotos reales de producto como referencias, y el anuncio mantiene su forma, color, etiqueta y logotipo desde el guion hasta el fotograma final. Seis estilos vienen con él, desde meme divertido hasta giro argumental y sitcom, pasando por lujo y venta directa, y el diálogo regresa en el idioma en que escribiste la descripción.
Esa es la misma cadena de dos personajes más imágenes de referencia más voz del tutorial, menos la escritura del prompt y menos la factura. Lo que lo convierte en una forma decente de descubrir si este formato se adapta a tu producto antes de gastar algo en afinarlo.
Para tener una idea de lo que una pila de fotogramas de referencia le hace a una pieza de producto, esta es la propia versión de Wan 3.0 del trabajo: cinco imágenes de entrada, un reel de lanzamiento de salida, cada fotograma anclando un beat de la edición.
Cinco fotogramas de referencia expandidos en un reel de lanzamiento de producto estilo Material Design_Cinco imágenes de referencia impulsando un video de producto de nueve segundos, cada una anclando un beat y pasando al siguiente. Fuente: manual oficial del creador de Wan 3.0 de Alibaba._
Cuánto cuesta un clip de referencia multimodal de Wan 3.0
| Paso | Modelo | Precio unitario | Cantidad | Costo |
|---|---|---|---|---|
| 1 y 2, dos imágenes de referencia | GPT Image 2 | $0.009 por imagen | 2 | $0.02 |
| 3, referencia de voz | MiniMax Speech 2.6 HD | $0.08 por 1K caracteres | 49 caracteres | $0.00 |
| 4, la toma de 10 segundos a 1080P | Wan 2.7 Referencia a video | $0.15 por segundo a 1080P | 10 s | $1.50 |
| Total del tutorial | aprox. $1.52 | |||
| Variación, 30 segundos | Seedance 2.5 Referencia a video | $0.134 por segundo a 480P | 30 s | aprox. $4.02 |
| Ruta gratuita | Generador de Skits AI Gratuito | gratis | 1 clip, 15 s | $0 |
Esas son las tarifas propias de la plataforma, verificadas en agosto de 2026 y facturadas según uso. Dos cosas mueven el total más de lo que la gente espera. La resolución es la primera: los $0.10 por segundo en la tabla de comparación es la tarifa base de Wan 2.7, y 1080P se factura a $0.15, de ahí los $1.50 anteriores. La segunda es que Seedance cobra por recuento de píxeles, por lo que su precio listado de $0.134 por segundo es la cifra para 480P y una toma a 720P cuesta más de lo que sugiere una multiplicación directa. Como referencia, la tarifa beta reportada de Wan 3.0 de $0.20 por segundo a 1080p pondría una toma completa de 30 segundos en alrededor de $6, que es más que la ruta de Seedance a 480P hoy.
Una nota sobre el uso de esto. Wan 3.0 es una beta y sus términos pueden cambiar, así que vuelve a leerlos antes de construir un pipeline sobre él. Si tus imágenes de referencia son personas reales, obtén su permiso primero, ya que la referencia a video es precisamente la capacidad que hace que eso importe. Los clips de ejemplo en este artículo son resultados generados por el propio Alibaba de su manual público para creadores, reproducidos aquí con fines de comentario.
Preguntas frecuentes
¿Cuántas referencias puede tomar realmente la referencia multimodal de Wan 3.0?
Hasta 20 activos en una sola llamada, extraídos de imágenes, videos, audio, documentos y páginas web. El límite práctico es más bajo que el técnico. Asigna a cada activo exactamente un trabajo, un sujeto por imagen, y usarás muchos menos de 20 para la mayoría de las escenas.
¿Puede Wan 3.0 realmente convertir un PDF o una página web en un video?
Sí, esa es la parte genuinamente única. Junto con texto, imagen, audio y video, acepta archivos de documentos y URLs en vivo, con informes de la beta que enumeran .doc, .xls, .ppt, .pdf y .txt. Ningún otro modelo de referencia a video en la tabla de comparación anterior acepta un documento.
¿Es Wan 3.0 de código abierto? ¿Puedo ejecutarlo en ComfyUI?
No, y no por ahora. Wan 3.0 es una beta cerrada que se ejecuta en la nube de Alibaba. Las generaciones anteriores de Wan se lanzaron abiertamente, por lo que existe la expectativa, pero Alibaba no ha confirmado los pesos para 3.0. Las páginas que afirman un lanzamiento Apache 2.0 de 1.3B o 14B de Wan 3.0 no están respaldadas por nada oficial.
¿Está disponible Wan 3.0 a través de APIs de terceros?
Todavía no, incluido Atlas Cloud. Lo más cercano que puedes llamar hoy es Wan 2.7 Referencia a video, cuya forma de entrada coincide casi exactamente con la referencia omni, aparte de las modalidades de documento y página web, o Seedance 2.5 Referencia a video si necesitas los 30 segundos completos.
¿Cuál es la forma más barata de probar un video de dos personajes bloqueado por referencia?
El generador de skits publicitarios AI gratuito enlazado arriba. Cuatro fotos de referencia de entrada, un clip de 15 segundos hablado de dos personajes de salida, sin parámetros y sin gasto. Si mantiene tu producto y tu formato, entonces ve a afinar la cadena de pago.
¿Por qué mis personajes aún se desvían incluso con imágenes de referencia?
Tres causas, en orden de frecuencia. Una referencia está realizando dos trabajos, por lo que se le pide que fije tanto la cara como la ubicación. La imagen de referencia tiene más de una persona o un fondo ocupado, por lo que el modelo no sabe qué parte bloquear. O la deriva es un artefacto de renderizado en lugar de una falla de referencia, en cuyo caso pon transformación de rostro, cambio de color en el prompt negativo antes de reescribir cualquier cosa.


