
Grok API: xAI Reasoning and Coding Models
Grok, développé par xAI, est une série de grands modèles de langage construits autour d'une conscience en temps réel et d'un raisonnement de pointe. Grok 4.3 est le modèle conversationnel avancé de xAI, optimisé pour le dialogue naturel, l'exploration des connaissances et le raisonnement en plusieurs étapes sur une fenêtre de contexte de 1 000 000 de tokens. Grok Build 0.1 prend une direction différente : il est spécialement conçu pour le développement de logiciels, avec des capacités axées sur la génération de code, le débogage et la refactorisation à travers des flux de travail de développeurs complexes. Les deux modèles sont disponibles sur Atlas Cloud via des endpoints d'API compatibles avec OpenAI, à partir de 1 $ par million de tokens.
Grok est développé par xAI. Atlas Cloud (exploité par Atlas Cloud AI LLC) en fournit l’accès mais n’en est pas propriétaire. Toutes les marques appartiennent à leurs détenteurs respectifs.
Explorez les Modèles Leaders
Atlas Cloud vous offre les derniers modèles créatifs de pointe de l'industrie.

Comparer les modèles de l'API Grok
Match each job to the right model: Grok 4.3 for reasoning across a 1M token context and Grok Build 0.1 for agentic coding, both reachable through one OpenAI-compatible key on Atlas Cloud.
| Model | Type | Best For | Context | Inputs | Function Calling | Structured Outputs | Prompt Caching | Status |
|---|---|---|---|---|---|---|---|---|
| Grok 4.3 | Flagship reasoning model | Logic, analysis, multi-step agents, long-document work | 1M tokens | Text, image | Yes | Yes | Yes | Flagship, GA |
| Grok Build 0.1 | Coding-focused model | Code generation, debugging, refactoring, coding agents | 256K tokens | Text, image | Yes | Yes | Yes | Early access |
Grok API Features
The Grok API brings xAI's reasoning and coding models to Atlas Cloud with a 1M token context window, always-on reasoning, function calling, structured outputs, vision input, and prompt caching, all behind one OpenAI-compatible key.
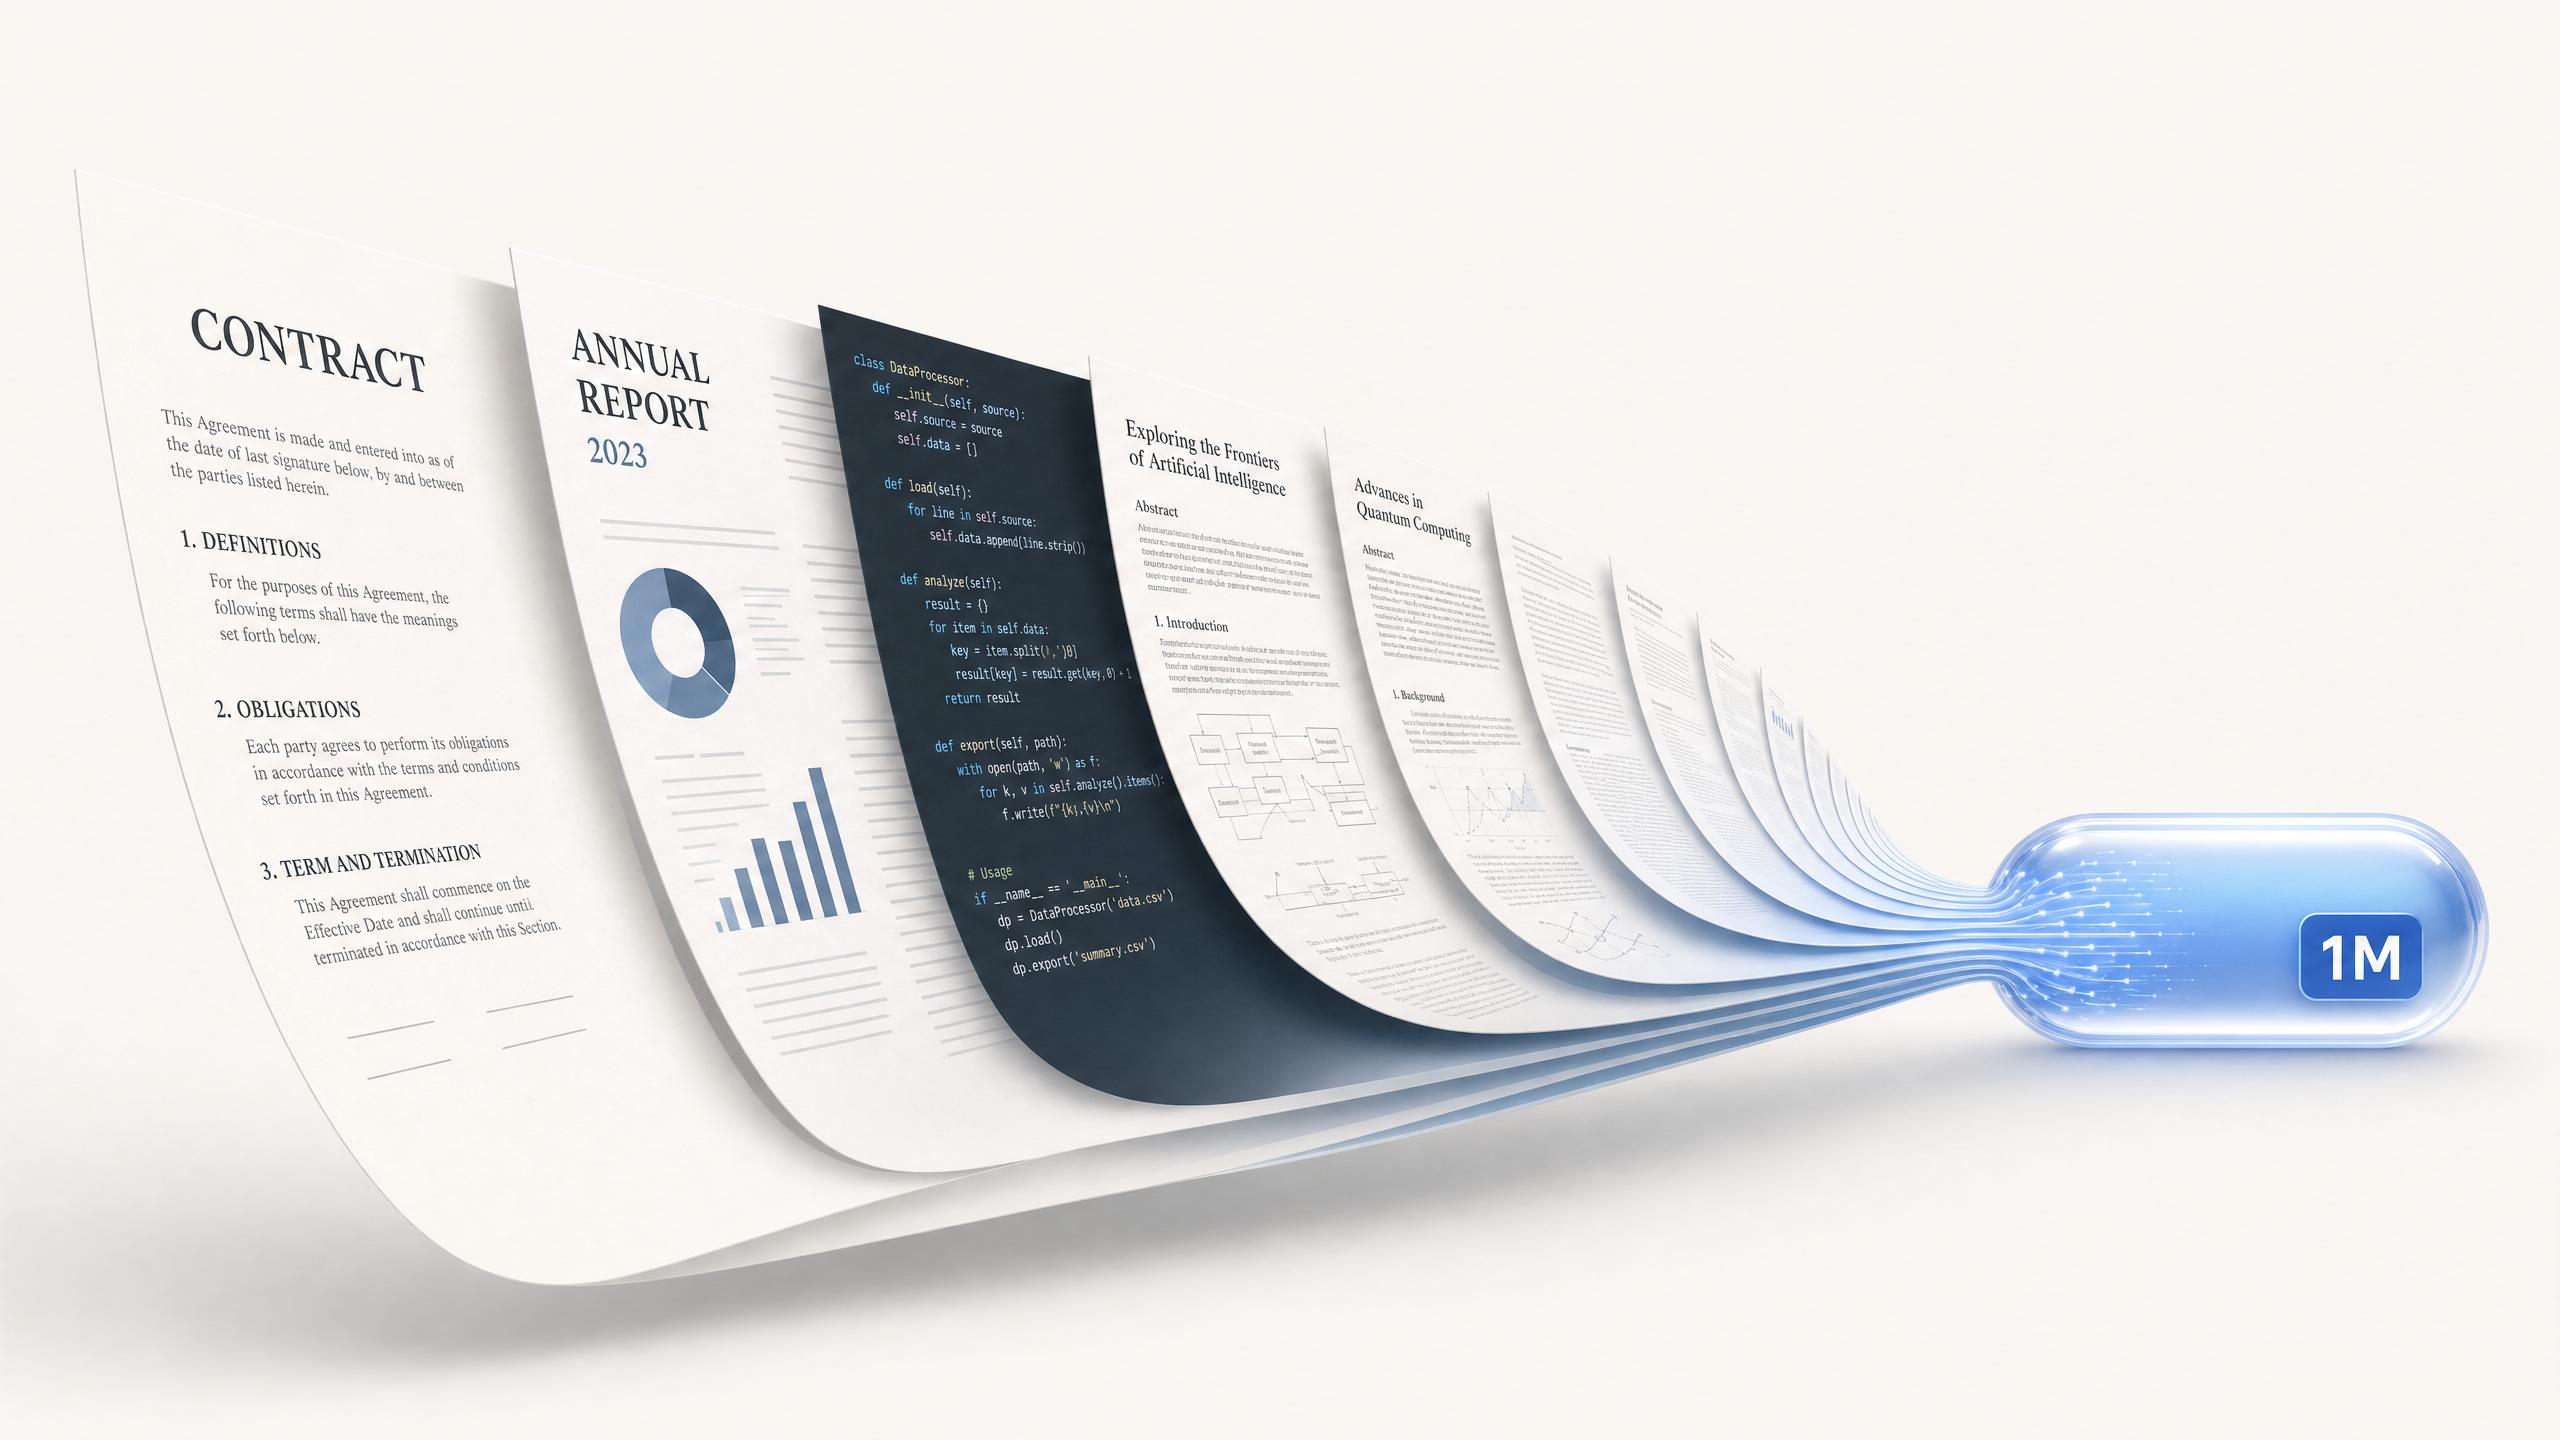
1M Token Context Window
Grok 4.3 handles up to one million tokens in a single request, enough for full contract sets, large codebases, or long multi-turn agent sessions. The wide context removes chunked retrieval and preserves cross-document reasoning that shorter models lose.
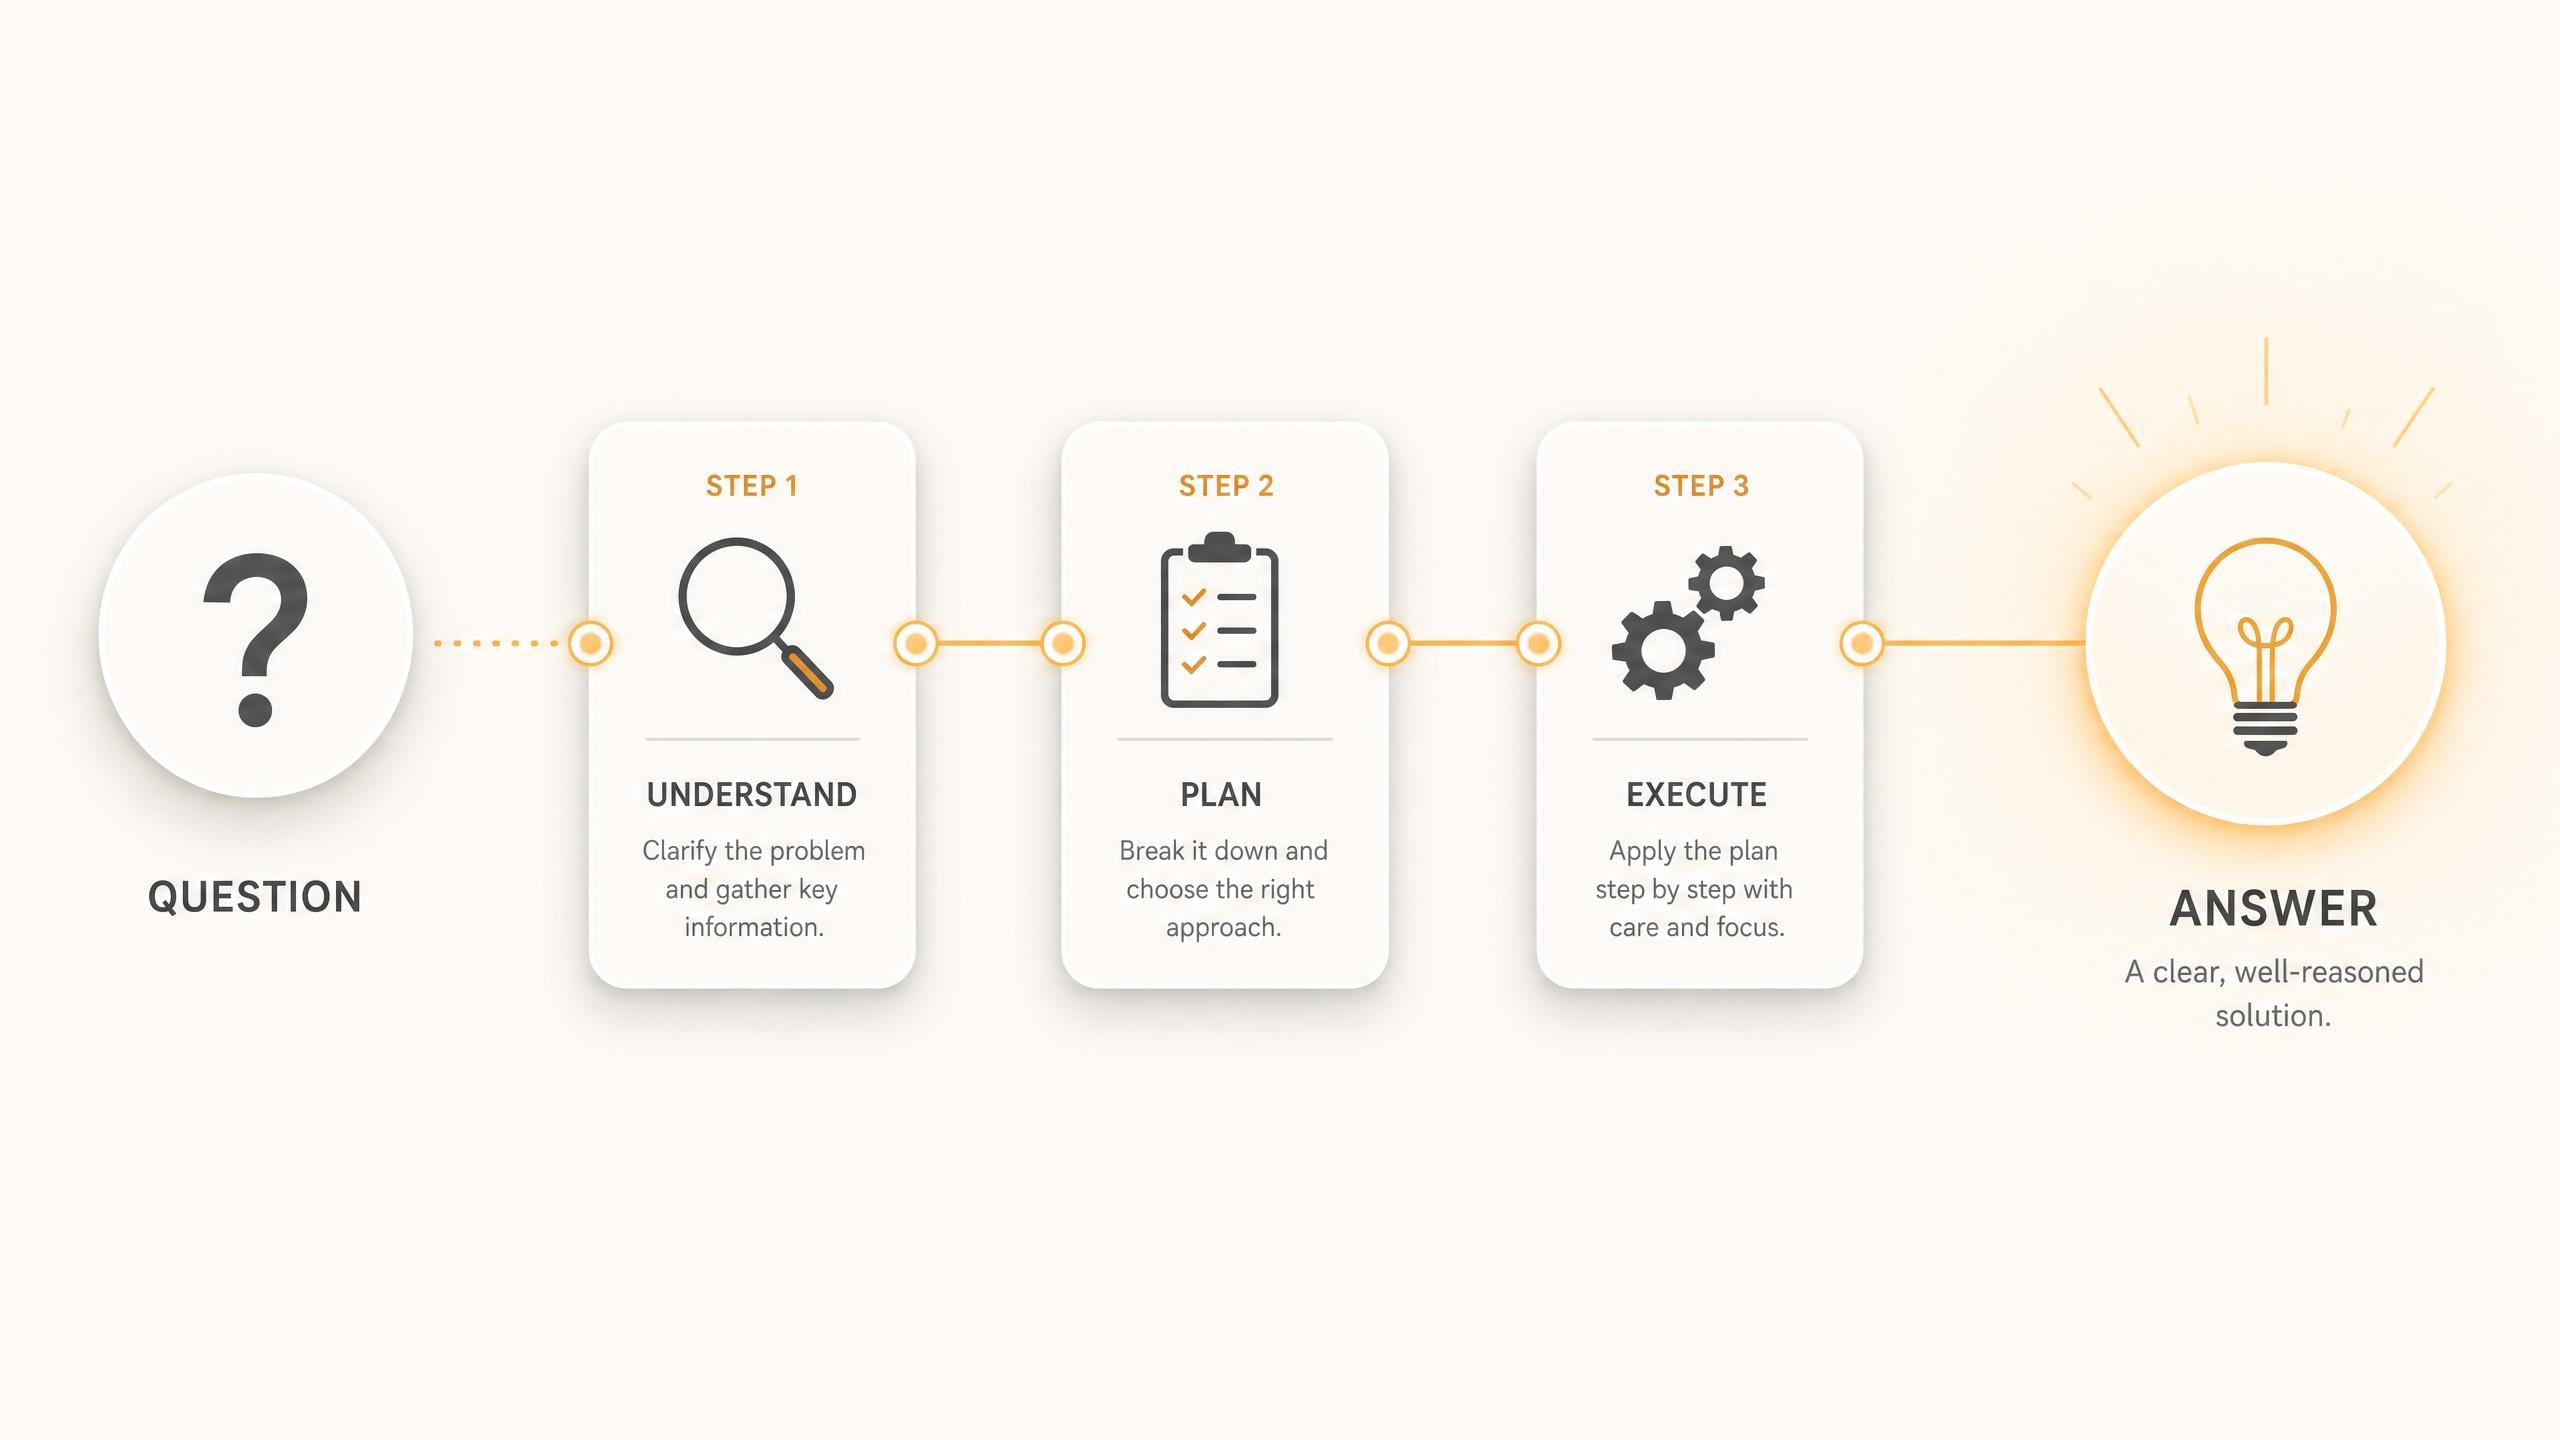
Always-On Reasoning with the Grok API
The Grok API runs Grok 4.3 with built-in step-by-step reasoning, tuned for accuracy-critical work like logic, math, and multi-step analysis. The model thinks before it answers, which lifts factual reliability and instruction following on complex prompts.
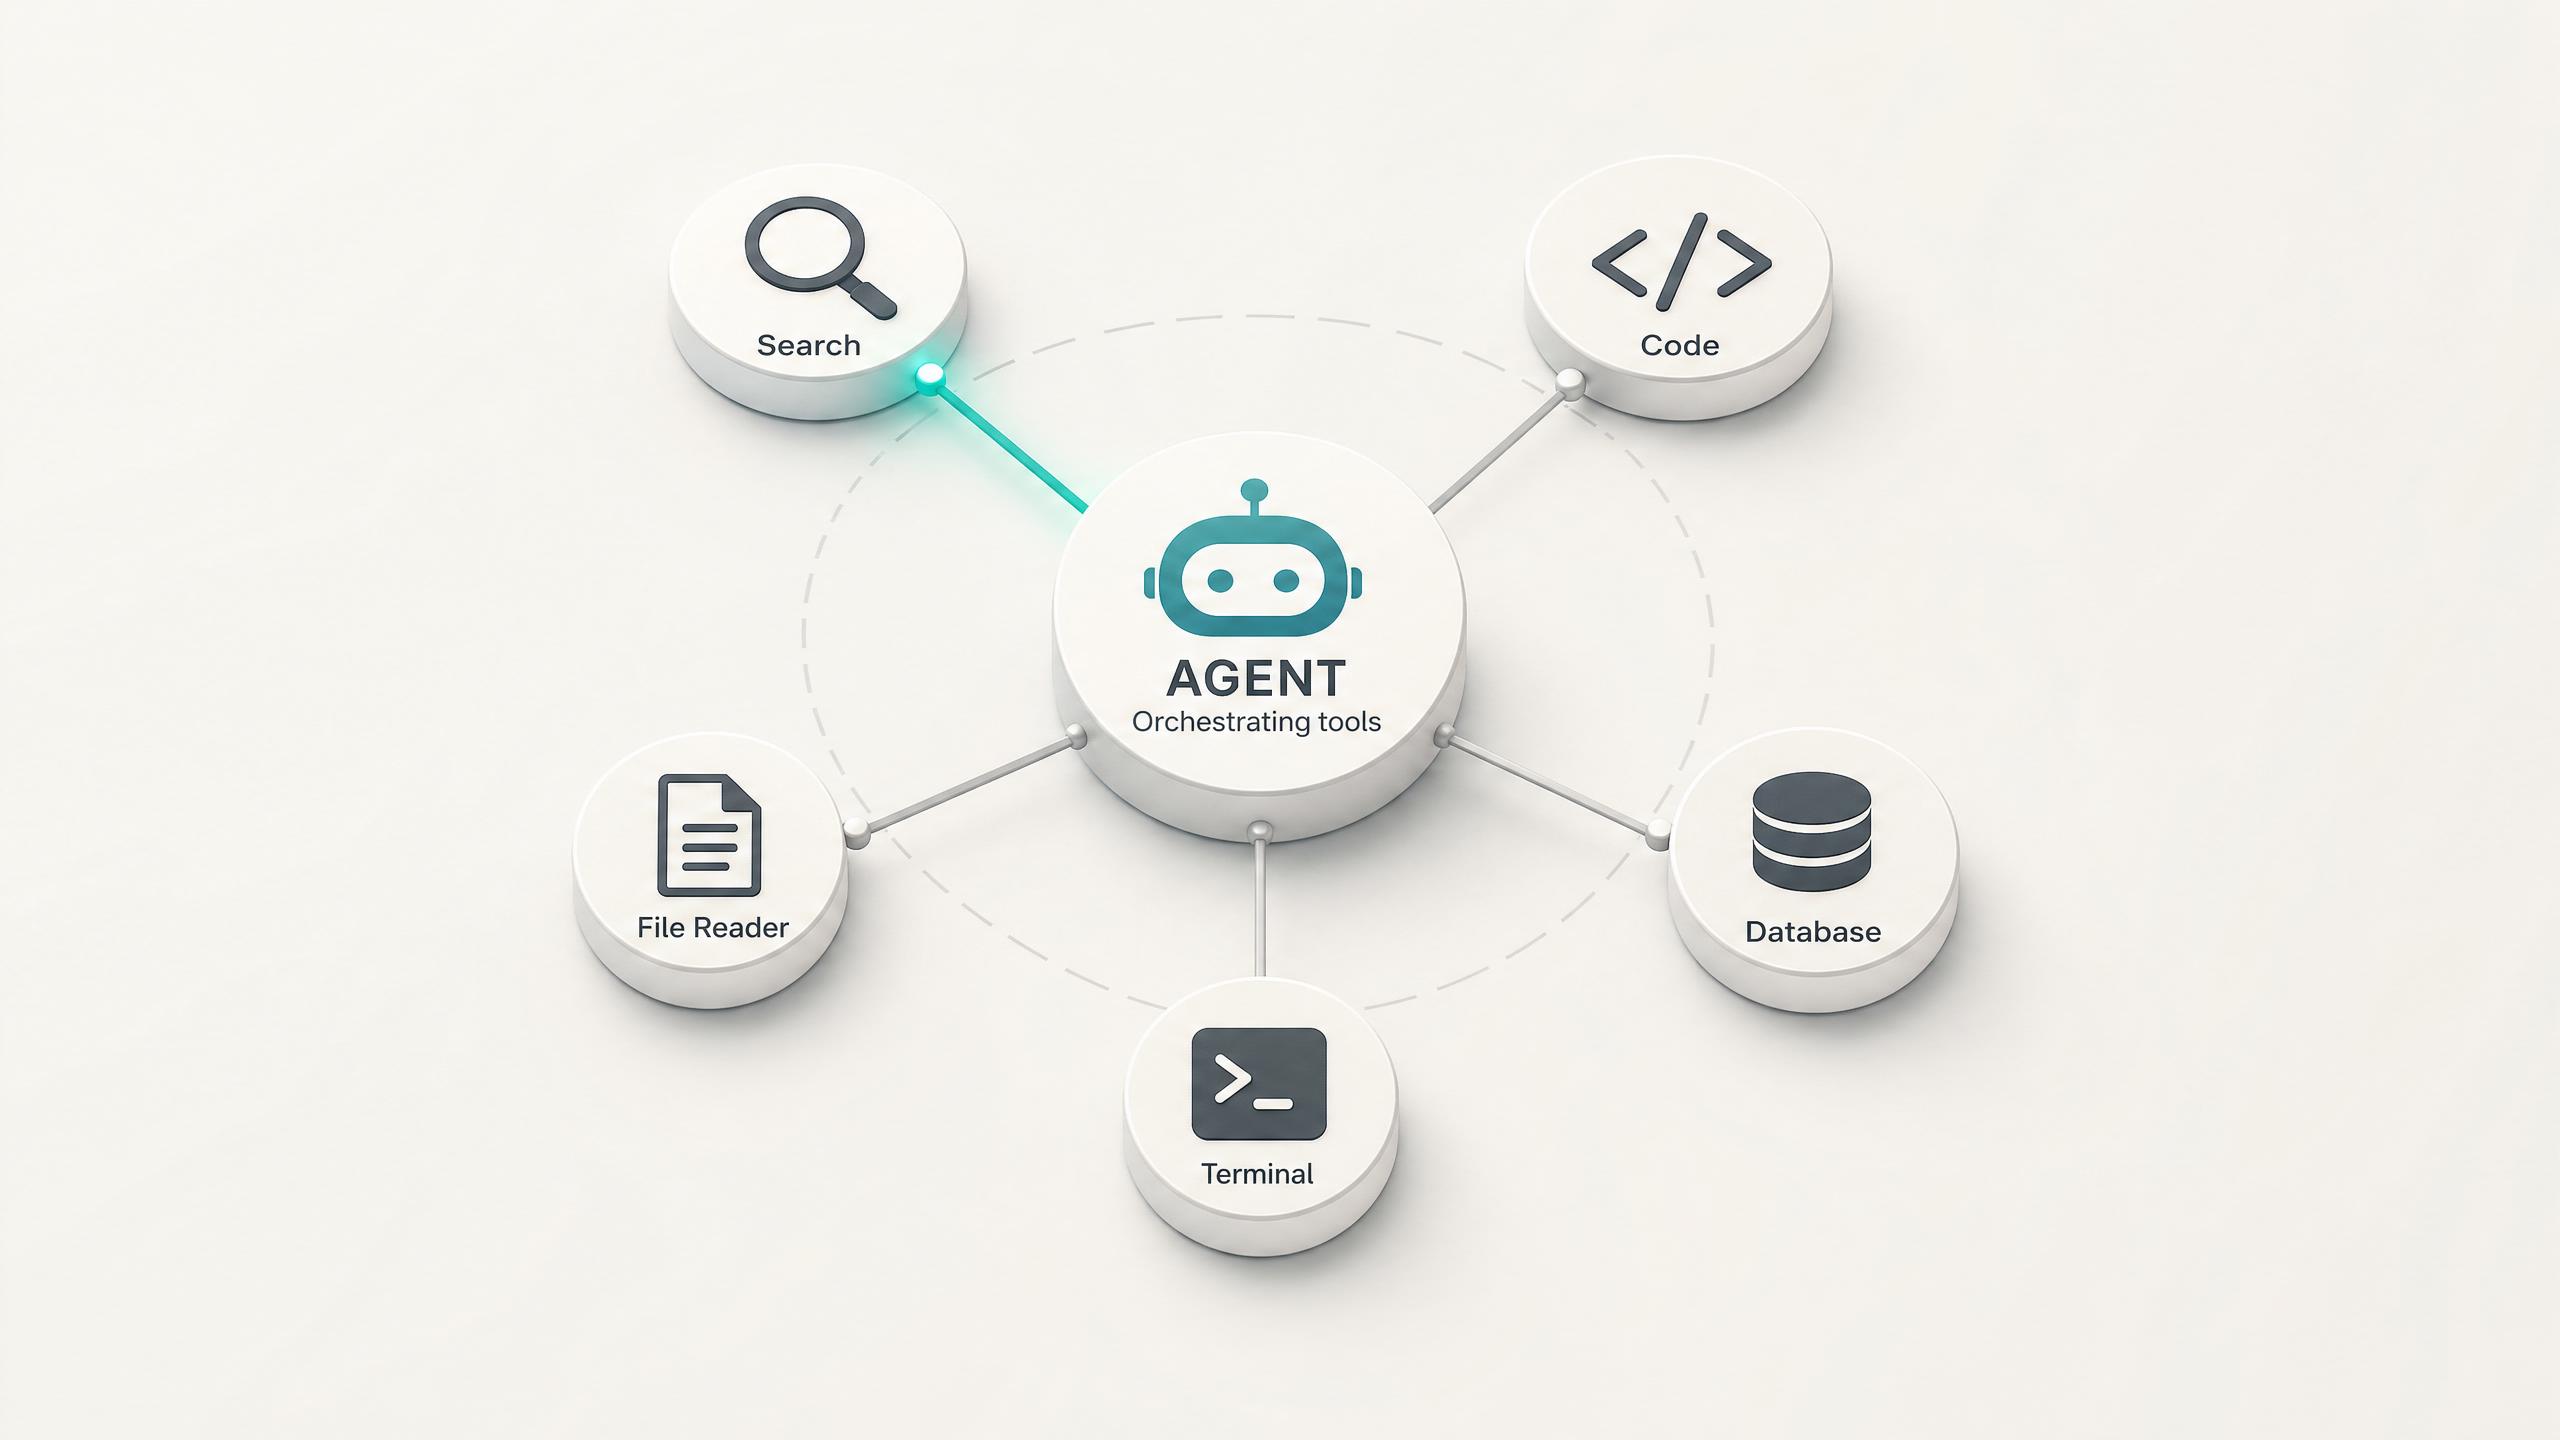
Agentic Tool Calling
Grok 4.3 is built for agents: it plans, calls functions in sequence, and adjusts on intermediate results. Native function calling lets it trigger tools and APIs mid-task, the foundation for research agents, support bots, and automation that runs without a human in the loop.
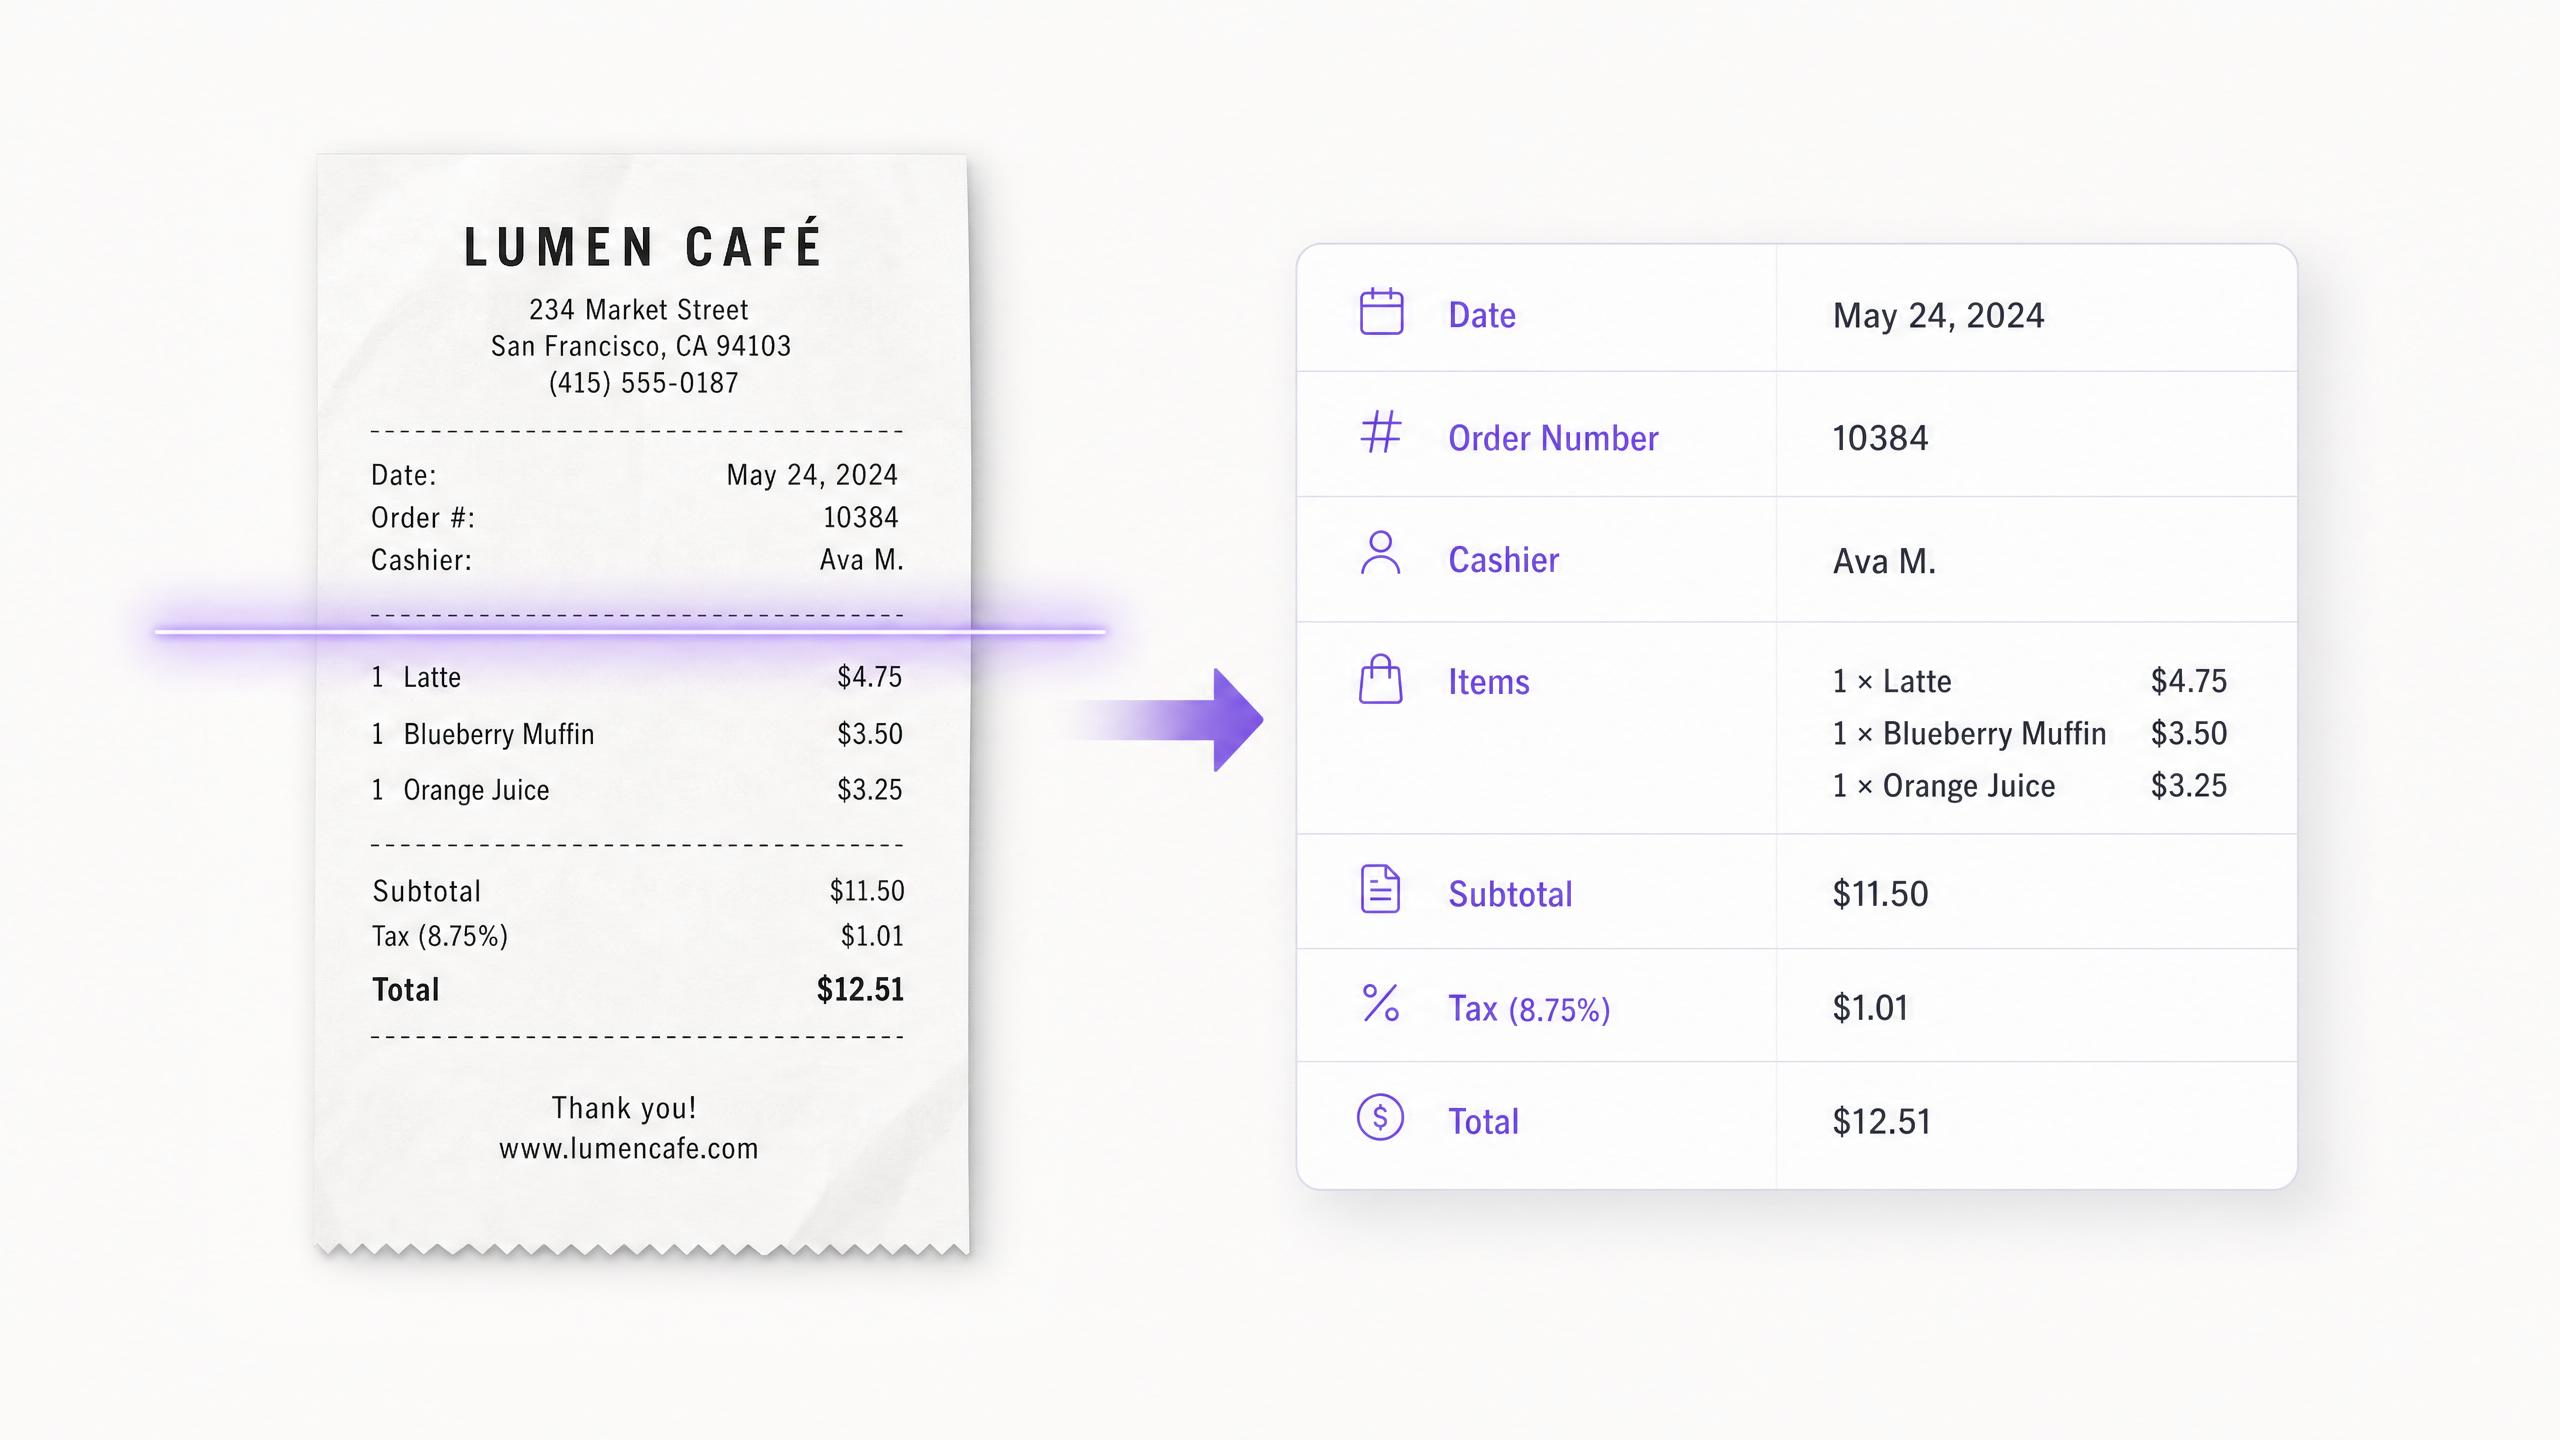
Structured Outputs and Vision with the Grok API
The Grok API returns structured JSON that matches your schema, so extracted data flows straight into downstream code. Grok 4.3 also accepts images alongside text, handling diagrams, screenshots, and UI mockups in the same call.
Coding with Grok Build 0.1
Grok Build 0.1 is xAI's coding-tuned model for code generation, debugging, and refactoring across developer workflows, with a 256K token context. It targets interactive coding agents and multi-step development tasks rather than general chat.
Prompt Caching on the Grok API
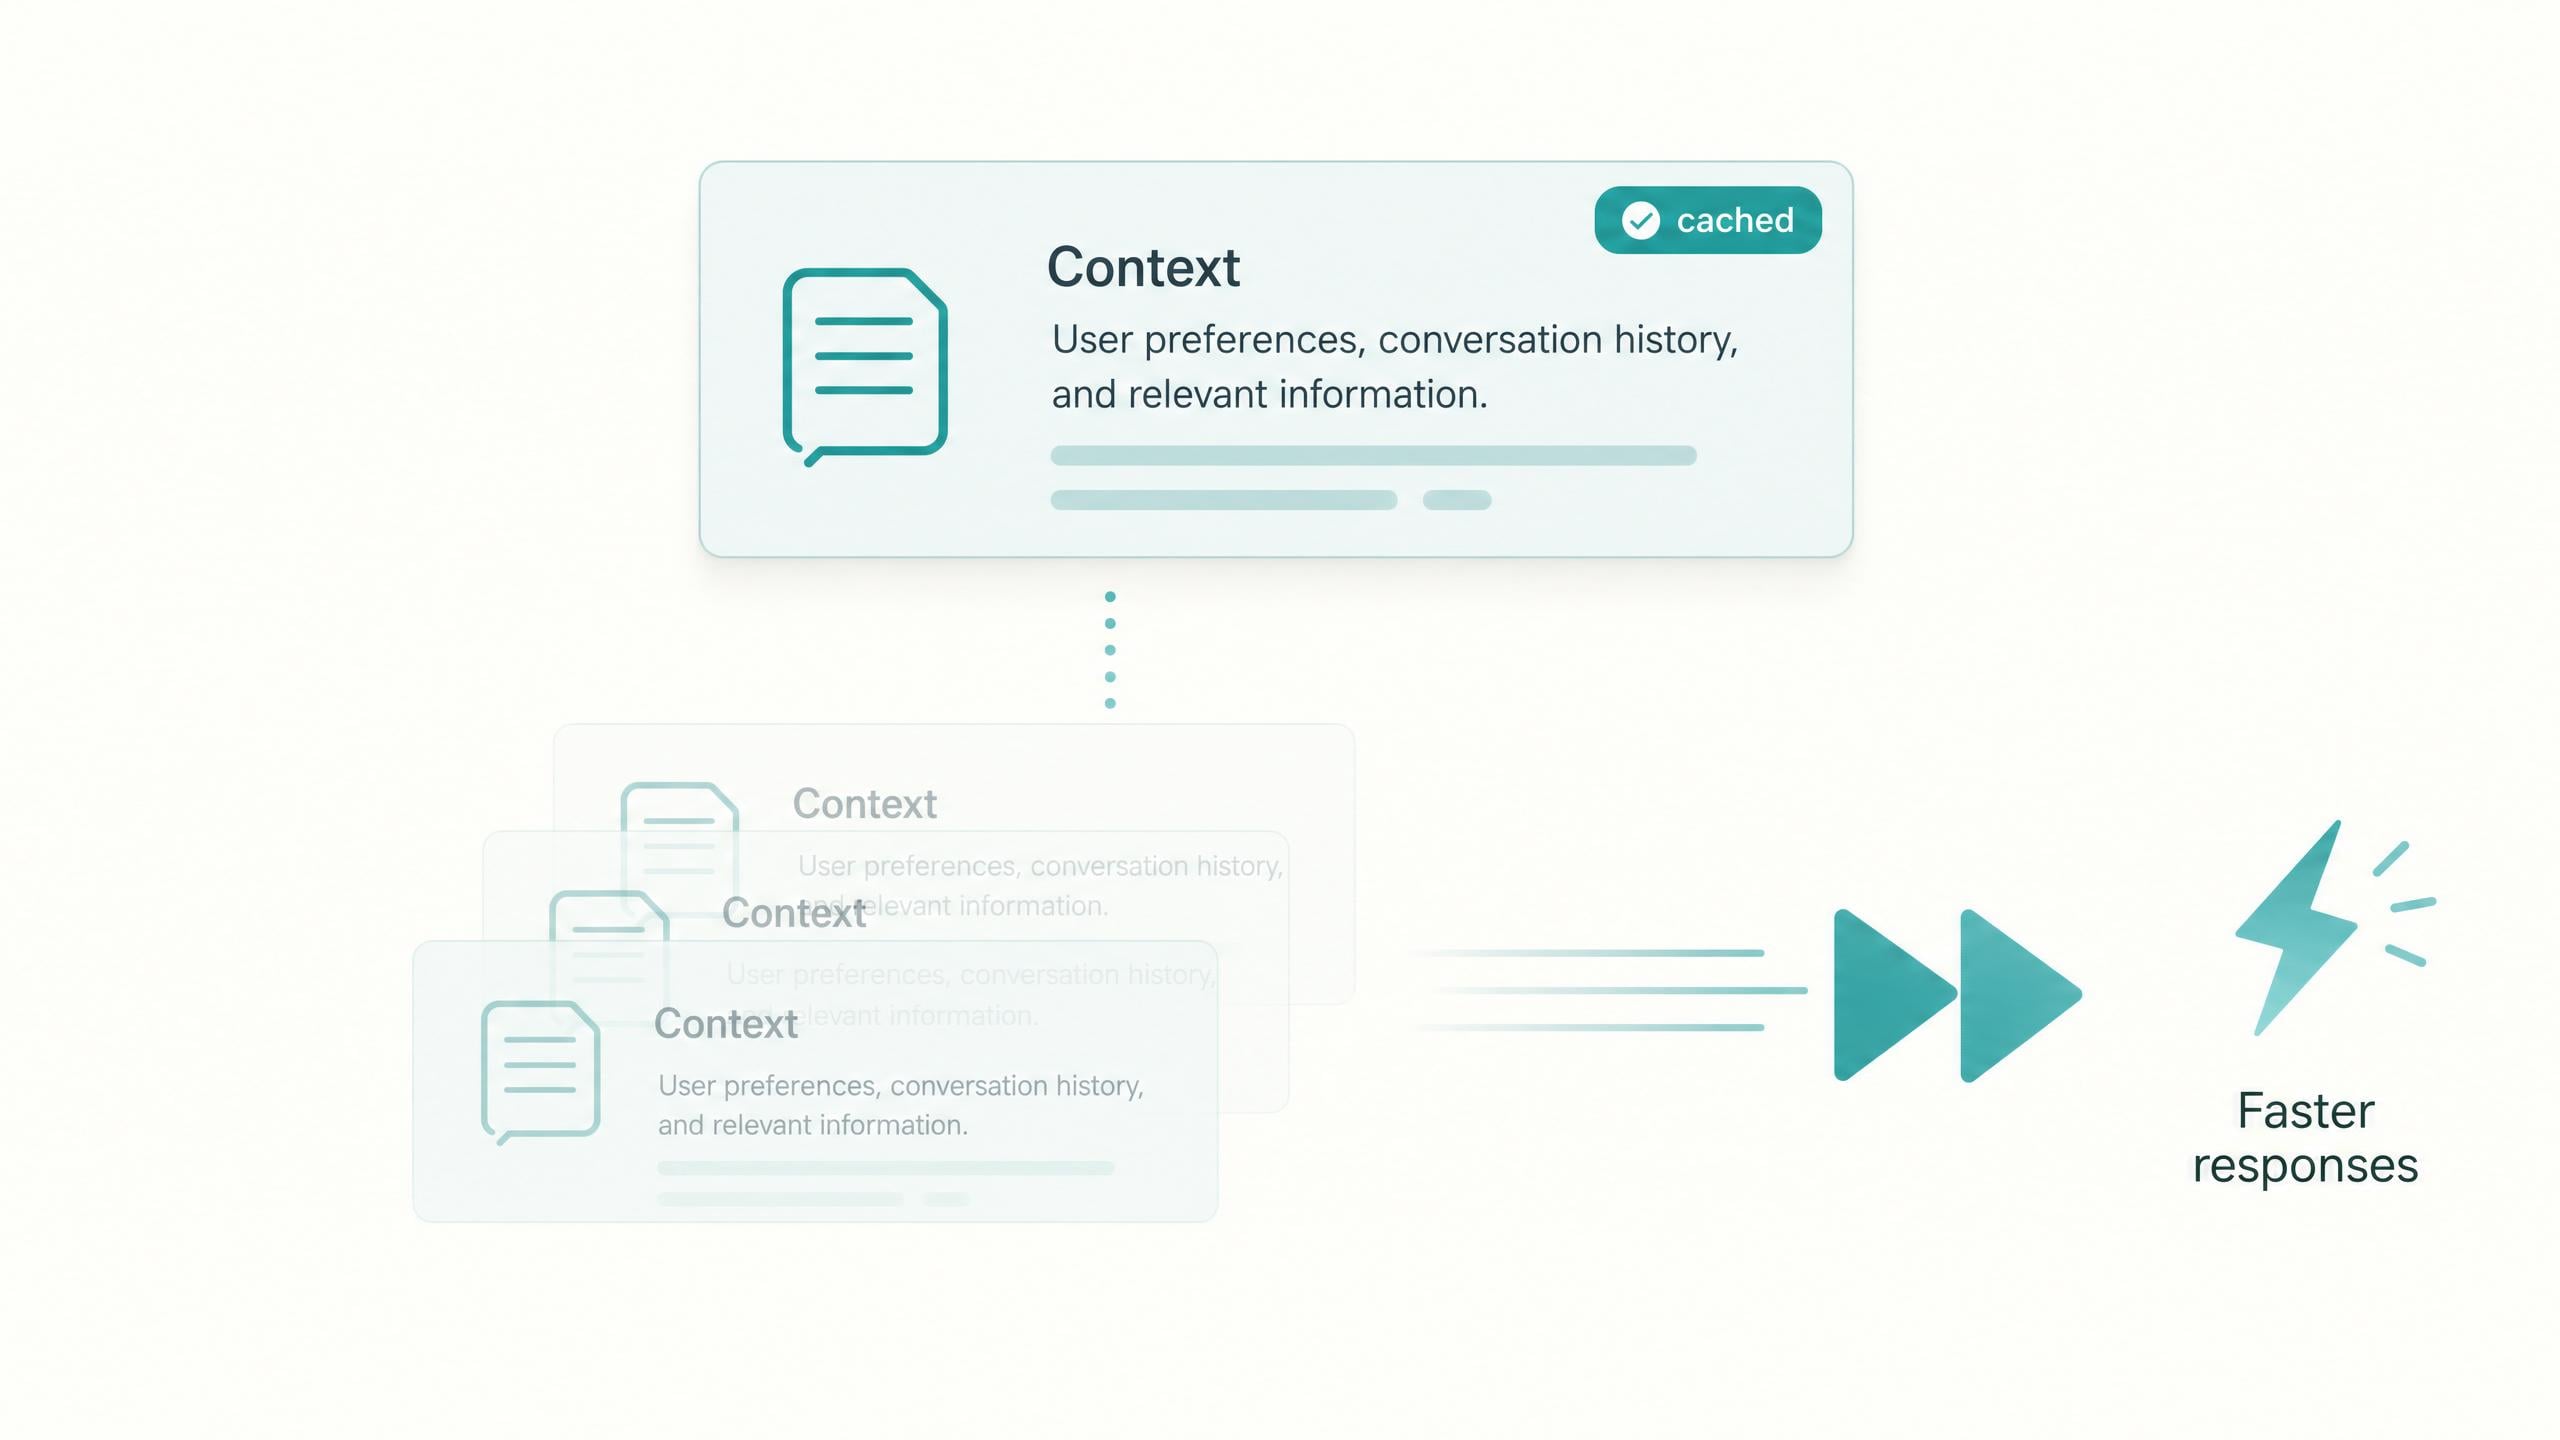
The Grok API supports prompt caching, which reuses a shared system prompt or context prefix at a lower token rate. For agentic loops that send the same instructions across many calls, this cuts repeated input cost without changing your code.
Un prompt de construction unique à travers les modèles
Soumettez le même prompt de construction à Grok et aux autres modèles sur Atlas Cloud, et observez chacun générer une page web complète et exécutable, afin de pouvoir comparer côte à côte le style de codage et le résultat final.
Créez un seul fichier HTML autonome présentant un système solaire 3D interactivo utilisant Three.js à partir d'un CDN. Rendez le soleil et les huit planètes en orbite avec des textures approximées par des couleurs et des lueurs, des orbites animées et un fond d'étoiles. Permettez à l'utilisateur de faire pivoter et de zoomer la caméra avec la souris, et de cliquer sur une planète pour faire voler doucement la caméra vers elle et afficher ses statistiques. Incluez un titre superposé élégant et un contrôle pour accélérer ou ralentir le temps. Conservez tout dans un seul fichier HTML avec l'importation CDN de Three.js. Donnez la priorité à un rendu cinématographique époustouflant.
Grok 4.3
GLM 5
Grok Build 0.1
Créez un seul fichier HTML autonome qui soit un tableau de bord d'analyse animé. Incluez un graphique à barres animé, un graphique linéaire qui se dessine au chargement, un graphique en anneau et des cartes de statistiques récapitulatives avec un comptage croissant. Utilisez des exemples de données codés en dur, des animations d'entrée fluides et une présentation de tableau de bord sombre, moderne et épurée. Ajoutez une subtile info-bulle au survol sur chaque élément du graphique. Utilisez uniquement du CSS en ligne et du JavaScript natif avec canvas ou SVG, sans aucune bibliothèque externe. Faites en sorte qu'il ressemble à un tableau de bord SaaS premium.
Grok 4.3
GLM 5
Grok Build 0.1
Ce que vous pouvez faire avec l'API Grok LLM sur Atlas Cloud
Grok 4.3 combine une fenêtre de contexte de 1 million de tokens avec une recherche web et sur X en temps réel, le rendant pratique pour les flux de travail de production qui nécessitent des informations actualisées ainsi qu'un raisonnement profond.

Pipelines de recherche et d'intelligence en temps réel
Les équipes développant des outils de recherche utilisent les modules complémentaires Web Search et X Search de Grok 4.3 pour extraire des données en temps réel du web et de X directement dans la génération, sans couche de récupération distincte. Cela est utile pour l'analyse concurrentielle, le résumé d'actualités et les flux de travail d'intelligence économique où la réponse dépend d'informations publiées après la date limite d'entraînement du modèle. Web Search et X Search sont facturés 5 $ pour 1 000 appels sur l'API xAI.

Backend LLM de production rentable
Les équipes d'ingénierie qui passent de GPT-4.1 ou Claude Sonnet utilisent Grok 4.3 comme un remplacement direct via le endpoint de Atlas Cloud compatible avec OpenAI. À 1,25 $ par million de tokens d'entrée, Grok 4.3 est environ 37 % moins cher que GPT-4.1 et 58 % moins cher que Claude Sonnet 4.6 en entrée. La migration ne nécessite qu'un changement de la base URL et de la clé API dans le code SDK existant.

Analyse de documents longs avec un contexte de 1M
Les équipes juridiques, financières et de recherche utilisent la fenêtre de contexte de 1 million de tokens de Grok 4.3 pour traiter des ensembles complets de contrats, des déclarations financières ou de la documentation technique en un seul appel API. Ce large contexte élimine le besoin de pipelines d'extraction fragmentés et préserve le raisonnement inter-documents que les modèles à contexte plus court brisent. La mise en cache des prompts réduit encore les coûts lorsque le même contexte de document est réutilisé lors de multiples appels d'analyse.

Codage Multimodal et Analyse Visuelle
Les développeurs utilisent la compréhension d'images de Grok 4.3 pour transmettre des diagrammes, des captures d'écran, des maquettes d'interface utilisateur et des journaux d'erreurs en même temps que du texte dans le même appel d'API. Cela s'avère utile pour les flux de travail de débogage où la capture d'écran d'une erreur ou le diagramme d'architecture d'un système fournit un contexte que le texte seul ne peut pas offrir. L'appel de fonction et les sorties structurées sont pris en charge lors du même appel, de sorte que les données visuelles extraites peuvent être renvoyées dans un schéma prêt pour un traitement en aval.

Exécution Agéntique de Tâches Multi-étapes
Les équipes produit utilisent l'optimisation agentique de Grok 4.3 pour créer des agents qui planifient, exécutent et itèrent à travers plusieurs étapes sans invite humaine entre elles. Le modèle est spécifiquement paramétré pour la décomposition de tâches complexes — divisant un objectif de haut niveau en sous-tâches, appelant des outils en séquence et s'ajustant en fonction des résultats intermédiaires. Associé à l'appel de fonctions et à l'extension Web Search, cela couvre des flux de travail allant de la recherche à la production, tels que "trouver des concurrents, analyser les prix, rédiger un rapport comparatif" en une seule exécution de l'agent.

Exécution de code en contexte pour l'analyse de données
Les équipes de données et d'analyse utilisent Grok 4.3 avec le module complémentaire Code Execution pour exécuter Python directement dans l'appel d'inférence, traiter les données et renvoyer les résultats calculés aux côtés du raisonnement du modèle. Cela élimine le besoin d'un environnement d'exécution de code séparé lors de la création d'outils d'analyse de données ou de pipelines de reporting automatisés. Code Execution est facturé 5 $ pour 1 000 appels sur la xAI API, indépendamment des coûts des tokens.
Comparatif de l'API Grok
Découvrez comment la Grok API se compare aux autres LLMs de premier plan sur Atlas Cloud en matière de contexte, d'entrées et de focalisation, afin que vous puissiez acheminer chaque tâche vers le modèle approprié, le tout sous une seule clé.
| Model | Provider | Context Window | Inputs | Best For |
|---|---|---|---|---|
| Grok 4.3 | xAI | 1M tokens | Text | Agentic reasoning, long-document analysis, high factual accuracy |
| Grok Build 0.1 | xAI | 256K tokens | Text | Code generation, debugging, refactoring |
| DeepSeek V4 Pro | DeepSeek | 1M tokens | Text | Cost-efficient reasoning and agentic tool use at scale |
| Kimi K2.6 | Moonshot | 262K tokens | Text, image | Long-horizon coding agents and multimodal workflows |
| GLM 5.2 | Z.ai | 202.8K tokens | Text | Long-horizon agentic engineering and project-scale coding |
Comment utiliser Grok sur Atlas Cloud
Soyez opérationnel en quelques minutes — suivez ces étapes simples pour intégrer et déployer des modèles via la plateforme Atlas Cloud.
Créer un compte Atlas Cloud
Inscrivez-vous sur atlascloud.ai et complétez la vérification. Les nouveaux utilisateurs reçoivent des crédits gratuits pour explorer la plateforme et tester les modèles.
Pourquoi Utiliser Grok sur Atlas Cloud
Combiner les modèles Grok avancés avec la plateforme accélérée par GPU d'Atlas Cloud offre des performances, une évolutivité et une expérience développeur inégalées.
Performance et Flexibilité
Faible Latence :
Inférence optimisée par GPU pour un raisonnement en temps réel.
API Unifiée :
Exécutez Grok, GPT, Gemini et DeepSeek avec une seule intégration.
Tarification Transparente :
Facturation prévisible par token avec options serverless.
Entreprise et Échelle
Expérience Développeur :
SDK, analytiques, outils de fine-tuning et modèles.
Fiabilité :
99,99% de disponibilité, RBAC et journalisation conforme.
Sécurité et Conformité :
SOC 2 Type II, alignement HIPAA, souveraineté des données aux États-Unis.
Foire aux questions sur Grok LLM
Atlas Cloud héberge Grok 4.3, le LLM phare actuel de xAI, disponible à 1,25 $ par million de tokens en entrée. Le modèle prend en charge le chat, le raisonnement, l'appel de fonctions, les sorties structurées et la compréhension d'images dans une seule API. Consultez la page de collection xAI d'Atlas Cloud pour toute version supplémentaire de Grok au fur et à mesure de leur ajout.
Grok 4.3 prend en charge une fenêtre de contexte d'un million de tokens. C'est suffisamment grand pour traiter des bases de code complètes, de longs documents de recherche ou des sessions d'agents multi-tours prolongées en un seul appel. La limite de contexte s'applique aux entrées de texte et d'image combinées.
Oui. L'API xAI prend en charge Web Search et X Search en tant que modules complémentaires optionnels, facturés séparément à 5 $ pour 1 000 appels. Cela permet à Grok de récupérer des informations en temps réel sur le web ou sur X lors d'une génération. Accédez à ces fonctionnalités via le endpoint API standard en parallèle de vos appels API réguliers.
Oui. L'API xAI prend en charge la mise en cache des prompts, ce qui réduit le coût des requêtes qui réutilisent le même prompt système ou préfixe de contexte. Les tokens d'entrée mis en cache sont facturés à un tarif nettement inférieur à celui des tokens non mis en cache. Cela est particulièrement utile pour les flux de travail d'agents qui envoient les mêmes instructions à travers de nombreux appels.
Oui. Grok 4.3 prend en charge l'entrée multimodale, acceptant les images en plus du texte dans le même appel API. Vous pouvez transmettre des URL d'images ou des images encodées en base64 via le format de messages standard. Cela permet des cas d'utilisation tels que la réponse aux questions visuelles, l'analyse de documents et la génération de code guidée par l'image.
Oui. Grok 4.3 prend en charge l'appel de fonctions, les sorties structurées et les réponses en continu. Ces fonctionnalités fonctionnent avec le schéma de fonctions standard compatible avec OpenAI, de sorte que les définitions d'outils existantes provenant d'intégrations basées sur GPT sont directement transférables. L'exécution de code est également disponible en tant que module complémentaire optionnel au prix de 5 $ pour 1 000 appels.
La mise en cache de prompts réutilise un préfixe de contexte répété, tel qu'un long prompt système ou des instructions partagées, à un tarif de tokens d'entrée réduit lors des appels ultérieurs. Pour les chatbots et les agents qui renvoient la même configuration à chaque requête, cela réduit le coût des entrées répétées sans modifier votre code. Placez le contenu statique au début du prompt et le contenu utilisateur variable à la fin pour que le cache s'applique.
Les limites de taux et la simultanéité varient selon le niveau du compte, ajoutez donc un recul exponentiel et une nouvelle tentative lors d'une réponse 429, et mettez les requêtes en file d'attente pendant les pics de trafic. Pour les tâches hors ligne importantes, le traitement par lots permet d'éviter que le travail de masse n'affecte vos limites en temps réel. Un coût caché courant à grande échelle est le renvoi de l'historique complet de la conversation à chaque appel, transmettez donc un résumé compact au lieu du fil de discussion entier, et contactez le support pour augmenter les limites au fur et à mesure de votre croissance.
L'API Grok utilise une facturation à l'usage (pay-as-you-go) basée sur l'utilisation de tokens, les tokens d'entrée et de sortie étant mesurés par requête, sans aucun abonnement requis. Exécuter Grok aux côtés de plus de 300 autres modèles sur Atlas Cloud implique un seul compte et une seule facture, au lieu de contrats séparés par fournisseur. La mise en cache des prompts et le traitement par lots peuvent réduire le coût effectif sur les charges de travail répétitives ou hors ligne.
Créez un compte sur Atlas Cloud, générez une clé API et dirigez votre client compatible OpenAI existant vers le point de terminaison Atlas avec le nom du modèle Grok. Envoyez votre première requête à Grok 4.3 pour le raisonnement ou à Grok Build 0.1 pour le codage, puis évoluez selon vos besoins. Étant donné que la même clé permet d'accéder à plus de 300 modèles, vous pouvez tester d'autres modèles sans aucune configuration supplémentaire.
Explorer Plus de Familles
Kling 4.0
L'API Kling 4 fournit Kling 4.0, le modèle vidéo publié par Kuaishou le 15 octobre 2026. Il génère jusqu'à 30 secondes en un seul passage, suit jusqu'à 10 images clés, fusionne 15 images, vidéos et sujets via Omni Reference, et ajoute un son stéréo avec synchronisation labiale. Atlas Cloud dessert les quatre points de terminaison, y compris le montage vidéo, sur une seule clé compatible OpenAI à partir de 0,11 $ par seconde. Commencez à créer dès aujourd'hui.

Seedance 2.5
L'API Seedance 2.5 offre aux développeurs le modèle conjoint audio et vidéo de ByteDance Seed, générant 4 à 30 secondes en un seul passage à partir de texte, d'une première image ou de jusqu'à 50 références parmi des images, des vidéos et des audios. Elle édite des régions sélectionnées, prolonge des clips et suit les entrées de modèles blancs et d'écrans verts. Atlas Cloud, un revendeur autorisé aux États-Unis, ajoute un mode brouillon en 480p, des fichiers finaux natifs en 1080p et une livraison 4K améliorée avec une tarification à l'usage.
Wan 3.0
Wan 3.0 est le tout nouveau modèle vidéo d'Alibaba, capable de produire jusqu'à 30 secondes de vidéo 1080p à 30fps avec audio en une seule génération. Guidez-le à l'aide d'un prompt textuel, d'une première image, de jusqu'à 10 images de référence ou d'un document. Standard coûte moins cher par seconde, tandis que Prime conserve les mêmes capacités et renvoie les résultats plus rapidement. Les deux fonctionnent avec la même clé Atlas Cloud que Wan 2.7, 2.6 et 2.5.
MiniMax H3
MiniMax H3 est la famille vidéo multimodale de MiniMax, conçue pour la création guidée par du texte, des images et des références. Sur les routes prises en charge, elle préserve les sujets des médias de référence, offre des rapports d’aspect flexibles et associe un son généré aux visuels via H3 Developer, avec des profils de sortie sélectionnés par endpoint. Atlas Cloud unifie cette famille derrière une seule clé compatible avec OpenAI, avec une tarification transparente à l’usage à partir du tarif standard de 0,038 $ par seconde. Commencez à développer dès aujourd’hui.
GPT Image 2.5
GPT Image 2.5 est le modèle de génération et d'édition d'images d'OpenAI, sorti le 8 septembre 2026 en deux versions d'API. Flare est la version par défaut, offrant une latence jusqu'à 50 % inférieure à celle de GPT Image 2, tandis que Sunburst prend plus de temps pour offrir un contrôle plus précis sur les modifications détaillées. Les deux prennent en charge jusqu'à 16 images de référence, cinq niveaux de qualité, des arrière-plans transparents et des tailles personnalisées jusqu'à 3840px. Atlas Cloud dessert l'API GPT Image 2.5 aux tarifs par jeton d'OpenAI, ou à un prix fixe par image selon le niveau 1K, 2K ou 4K.
Seedream 5.0 Pro
L'API Seedream 5.0 Pro offre aux développeurs le modèle d'édition d'images contrôlable de ByteDance sur Atlas Cloud. Elle positionne les modifications avec précision à l'aide d'ancrages et de coordonnées, sépare les images en calques modifiables, fusionne de multiples références et fait correspondre les couleurs et matériaux exacts, avec du texte multilingue en 2K et 3K. Sur Atlas Cloud, vous y accédez via une seule clé !
Seedance 2.0
Seedance 2.0 est le modèle vidéo de production de ByteDance pour créer des plans avec précision. Transformez vos prompts en vidéos, animez une image de première image avec un guidage facultatif par la dernière image, ou façonnez vos résultats à l’aide de médias de référence et d’une recherche web facultative. Atlas Cloud regroupe ces workflows dans une API unifiée, avec une tarification transparente à l’usage et une clé compatible avec OpenAI. Commencez à développer dès aujourd’hui.
Kling V3.0
Issu de Kuaishou, la famille d’API Kling V3 prend en charge les workflows de génération à partir de texte, d’images et de vidéos de référence. Transférez les mouvements tout en préservant l’identité des personnages, guidez la génération à l’aide de références visuelles et modifiez des vidéos avec des commandes en langage naturel. Atlas Cloud propose des points de terminaison Standard et Pro adaptés à différents besoins de production. Mise à jour : Kling V4 est désormais disponible sur Atlas Cloud. Découvrez-le sur la page [Kling V4](https://www.atlascloud.ai/zh/models/kling-v4).
Grok Imagine Video
Grok Imagine Video donne aux développeurs accès à la famille de modèles vidéo de xAI pour créer, animer, prolonger et retoucher des clips. Générez des vidéos de 1 à 15 secondes à partir de prompts, guidez des personnes, des objets ou des styles avec jusqu'à sept images de référence, et travaillez en 480p ou 720p. Atlas Cloud réunit ces fonctionnalités via des points de terminaison compatibles avec OpenAI, avec une tarification transparente à l'usage. Commencez à créer dès aujourd'hui.
Vidu Q4 Preview
Vidu Q4 est le dernier modèle vidéo phare de Vidu, conçu pour la génération image-to-video et reference-to-video. Il peut animer une seule image fixe et créer automatiquement des transitions entre les scènes, offrant ainsi aux développeurs deux modes d’entrée pour différents flux de produits. Atlas Cloud fournit des points de terminaison API dédiés, avec des schémas de paramètres publiés, au tarif standard vérifié de $0.04 par seconde. Commencez dès aujourd’hui à développer.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash est la famille vidéo nativement multimodale de Google DeepMind, conçue pour des workflows de production flexibles. Modifiez des séquences existantes à l’aide d’instructions textuelles, préservez la cohérence visuelle avec jusqu’à 10 images de référence et 3 clips vidéo, ou prolongez un plan par segments enchaînables jusqu’à 40 secondes. Accédez à tous les workflows sur Atlas Cloud avec une seule clé API compatible OpenAI, une tarification à l’usage et une disponibilité dès le Day-0. Commencez à développer dès aujourd’hui.
Nano Banana 2.1
Nano Banana 2.1 is Google's image model family built on Gemini 3.6 Flash. It delivers Pro-level generation and editing at Flash-level speed, supports natural-language edits and merges across 1 to 14 input images, and maintains consistency for up to 4 characters and 10 objects. Through Atlas Cloud, developers can access the family with one OpenAI-compatible key, reliable uptime, and Day-0 availability. Start building today.
Articles recommandés
Guides, tutoriels et actualités produit pour tirer le meilleur d'Atlas Cloud.


