
Grok API: xAI Reasoning and Coding Models
Grok, sviluppato da xAI, è una serie di modelli linguistici di grandi dimensioni basati sulla consapevolezza in tempo reale e sul ragionamento all'avanguardia. Grok 4.3 è l'avanzato modello conversazionale di xAI, ottimizzato per il dialogo naturale, l'esplorazione della conoscenza e il ragionamento multi-fase attraverso una finestra di contesto di 1.000.000 di token. Grok Build 0.1 prende una direzione diversa: è costruito specificamente per lo sviluppo di software, con funzionalità focalizzate sulla generazione di codice, il debug e il refactoring attraverso complessi flussi di lavoro per sviluppatori. Entrambi i modelli sono disponibili su Atlas Cloud tramite endpoint API compatibili con OpenAI, a partire da 1 $ per milione di token.
Grok è sviluppato da xAI. Atlas Cloud (gestita da Atlas Cloud AI LLC) ne fornisce l’accesso ma non ne è proprietaria. Tutti i marchi appartengono ai rispettivi titolari.
Esplora i Modelli di Punta
Atlas Cloud ti fornisce i più recenti modelli creativi leader del settore.

Confrontare i modelli dell'API Grok
Match each job to the right model: Grok 4.3 for reasoning across a 1M token context and Grok Build 0.1 for agentic coding, both reachable through one OpenAI-compatible key on Atlas Cloud.
| Model | Type | Best For | Context | Inputs | Function Calling | Structured Outputs | Prompt Caching | Status |
|---|---|---|---|---|---|---|---|---|
| Grok 4.3 | Flagship reasoning model | Logic, analysis, multi-step agents, long-document work | 1M tokens | Text, image | Yes | Yes | Yes | Flagship, GA |
| Grok Build 0.1 | Coding-focused model | Code generation, debugging, refactoring, coding agents | 256K tokens | Text, image | Yes | Yes | Yes | Early access |
Grok API Features
The Grok API brings xAI's reasoning and coding models to Atlas Cloud with a 1M token context window, always-on reasoning, function calling, structured outputs, vision input, and prompt caching, all behind one OpenAI-compatible key.
1M Token Context Window
Grok 4.3 handles up to one million tokens in a single request, enough for full contract sets, large codebases, or long multi-turn agent sessions. The wide context removes chunked retrieval and preserves cross-document reasoning that shorter models lose.
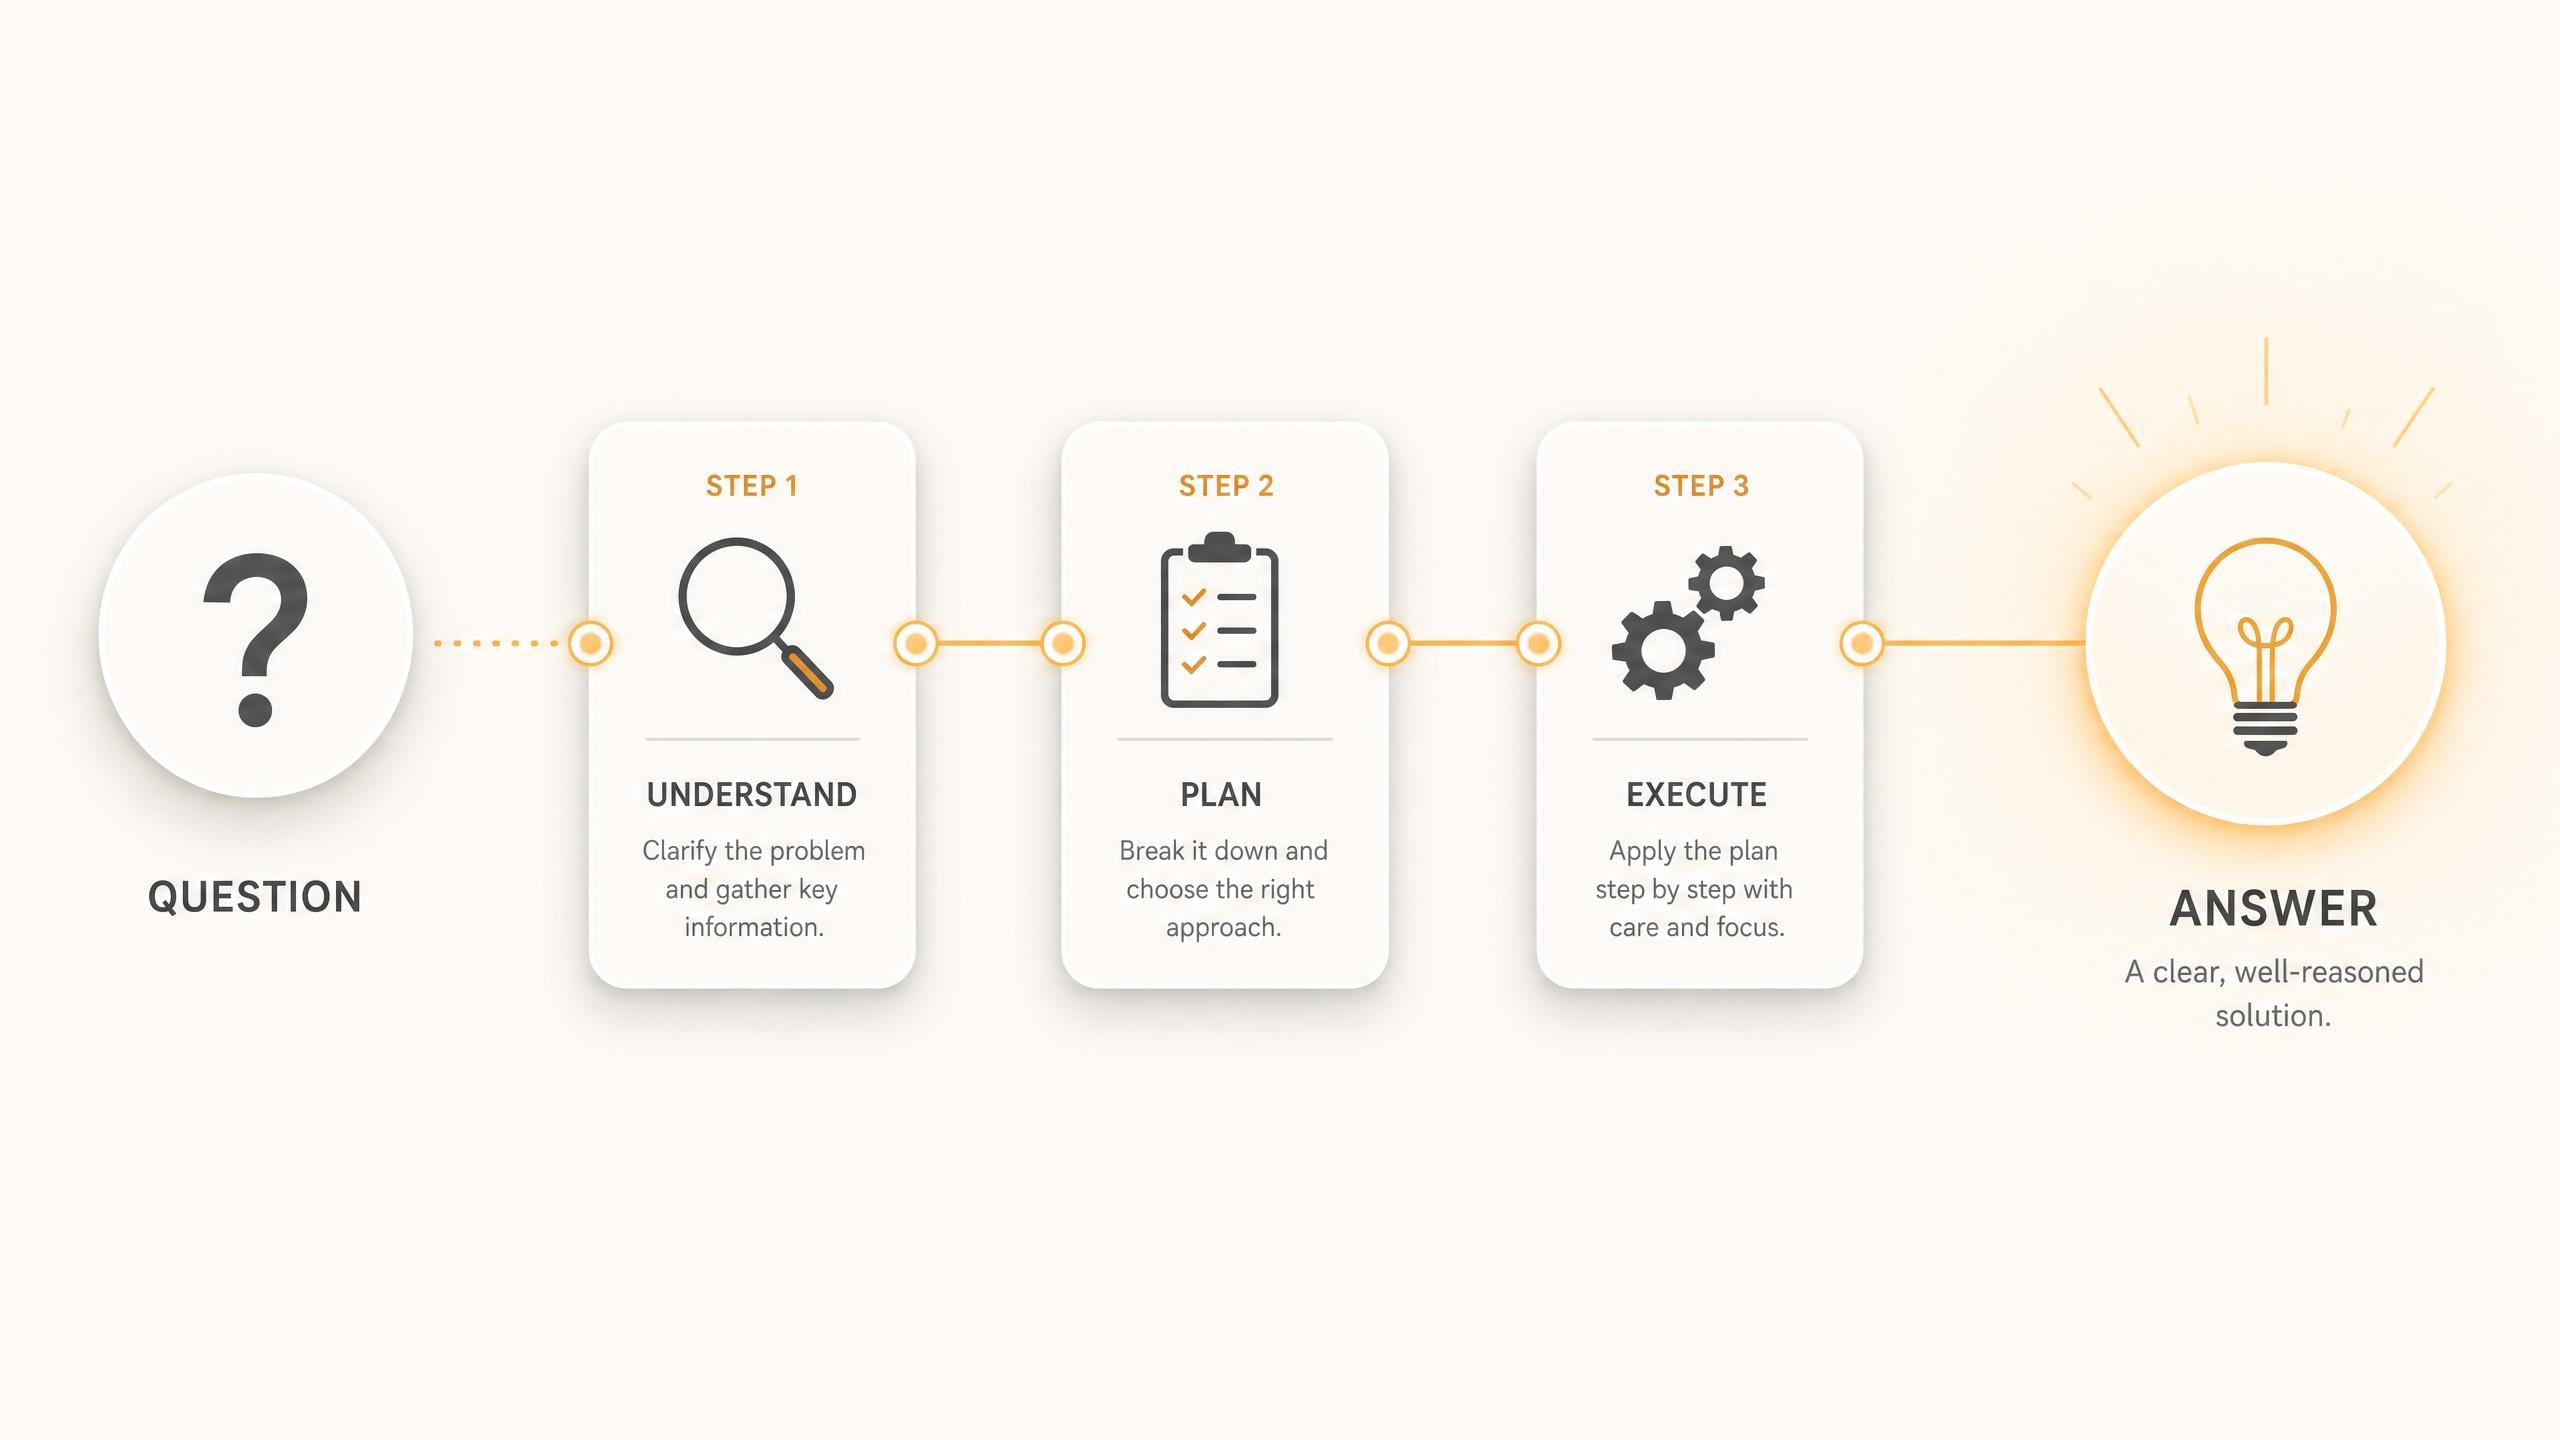
Always-On Reasoning with the Grok API
The Grok API runs Grok 4.3 with built-in step-by-step reasoning, tuned for accuracy-critical work like logic, math, and multi-step analysis. The model thinks before it answers, which lifts factual reliability and instruction following on complex prompts.
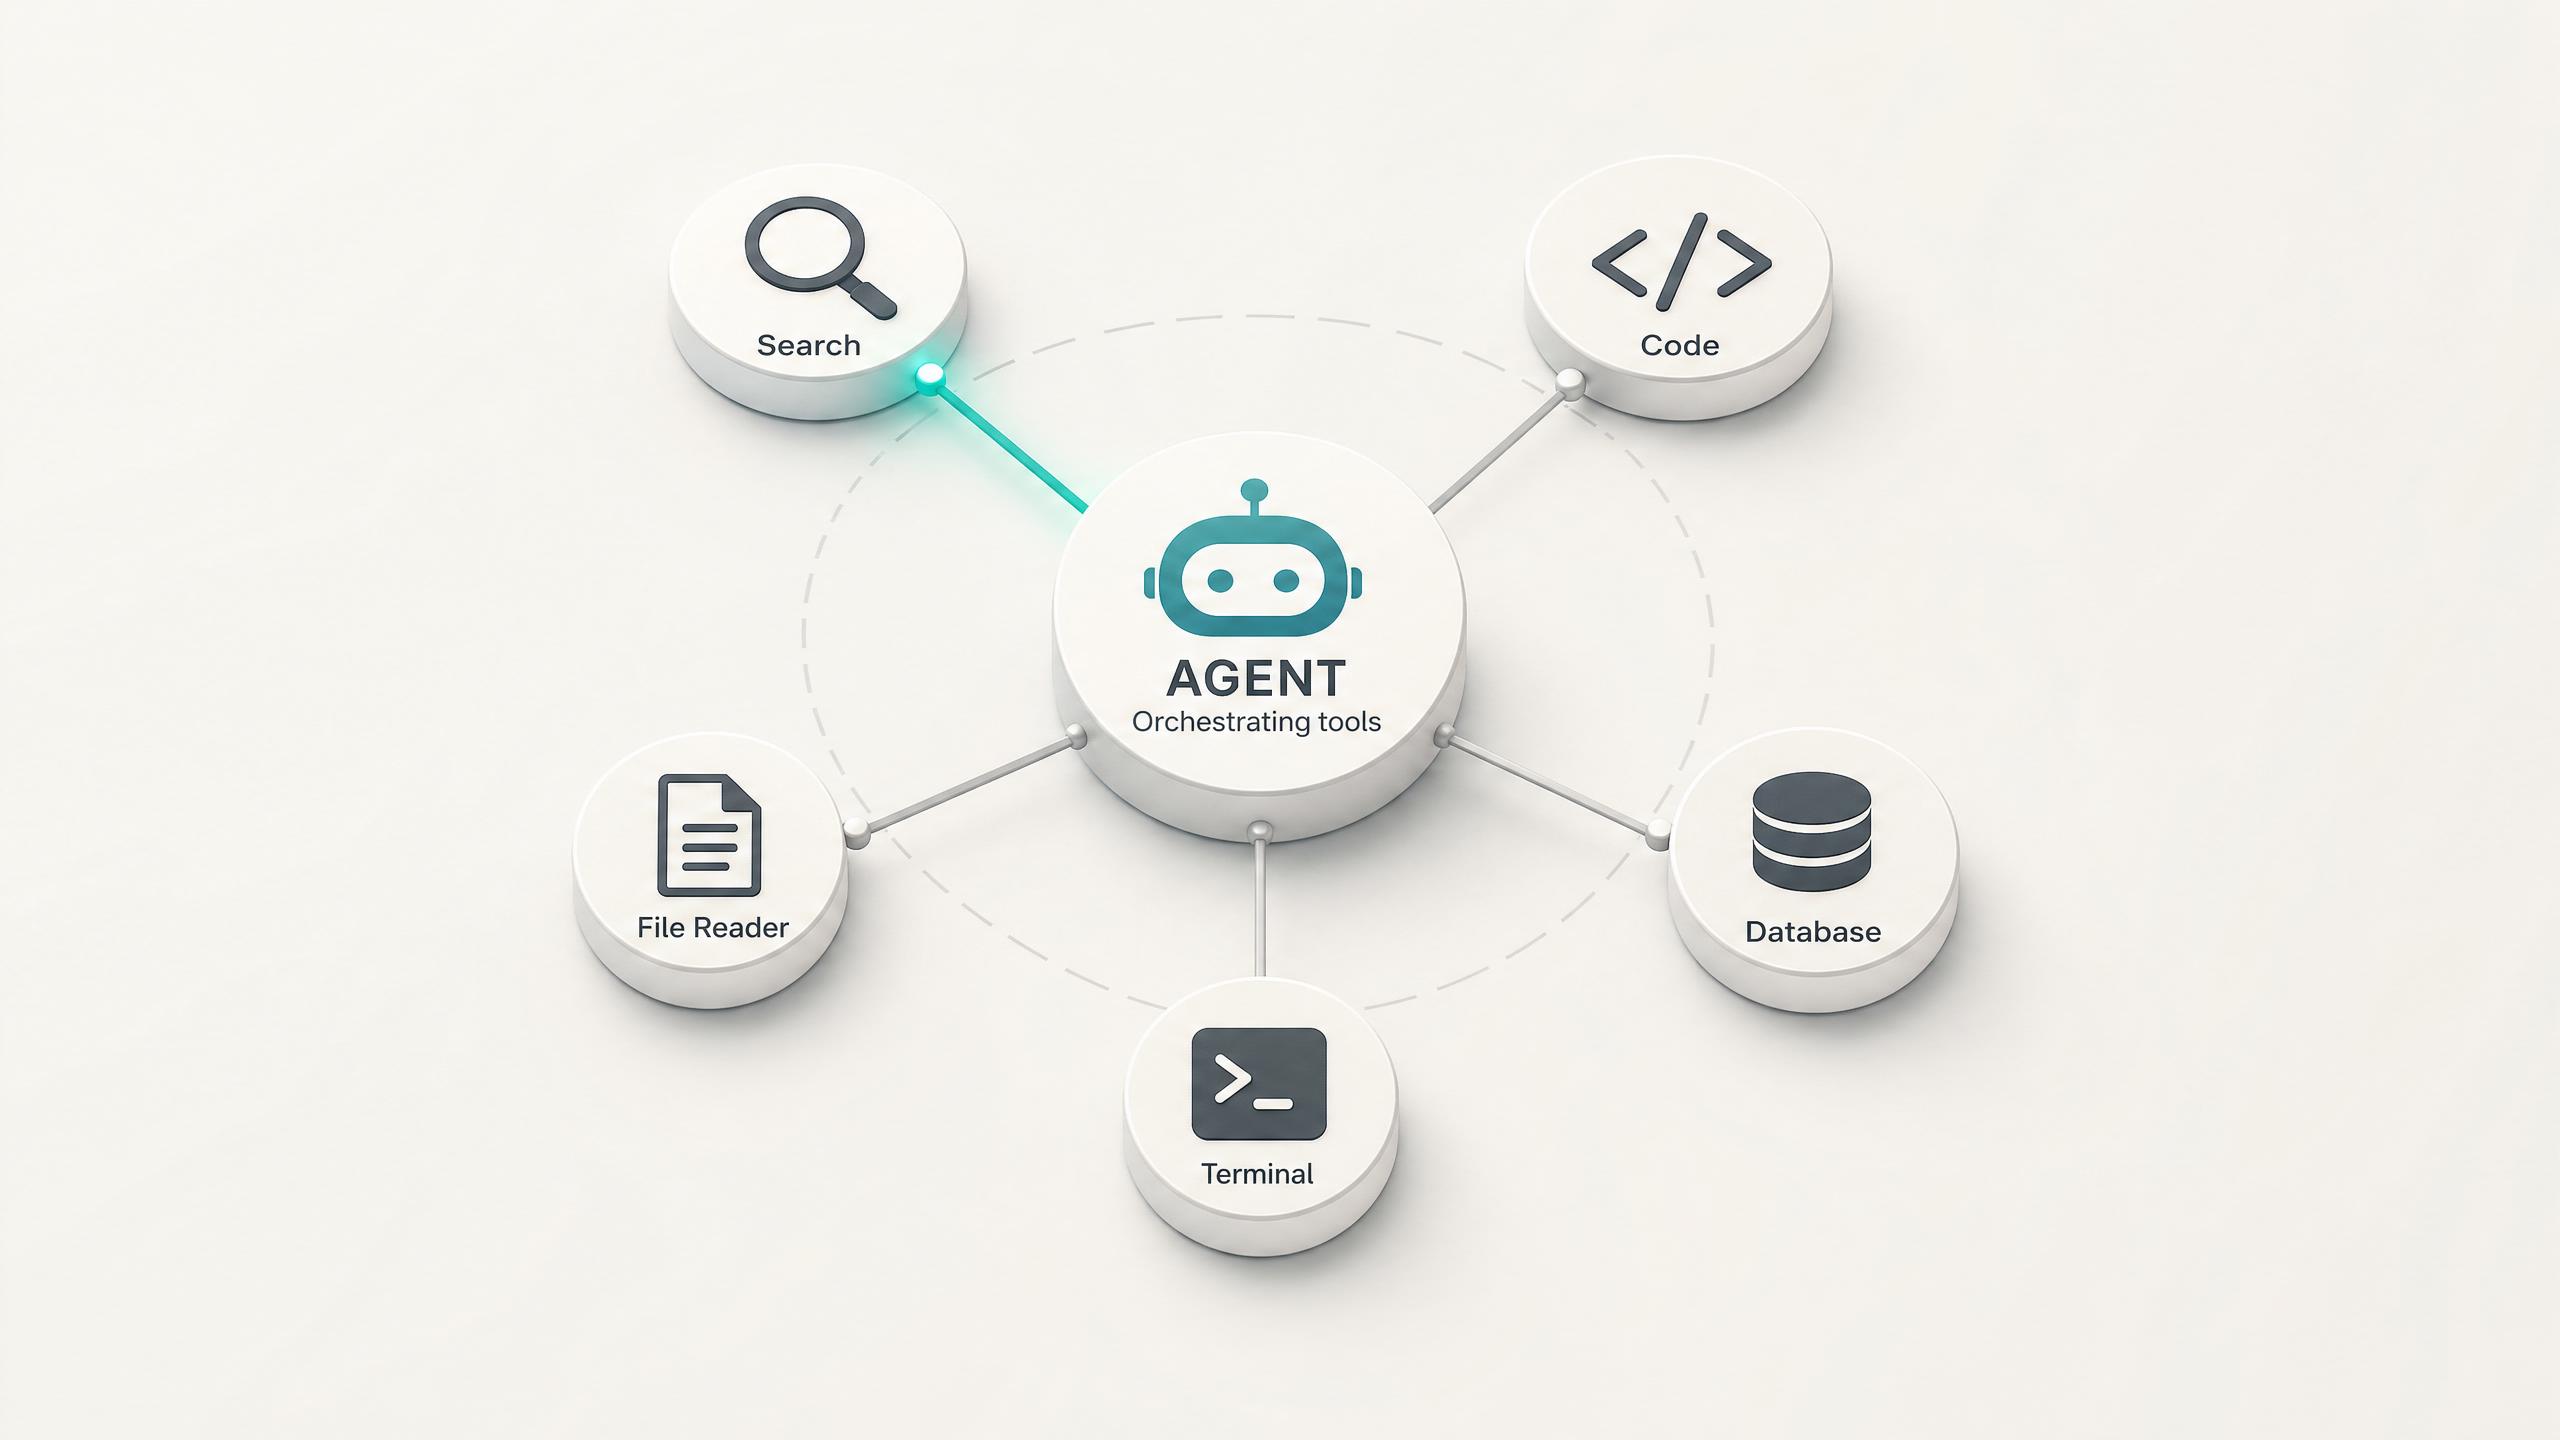
Agentic Tool Calling
Grok 4.3 is built for agents: it plans, calls functions in sequence, and adjusts on intermediate results. Native function calling lets it trigger tools and APIs mid-task, the foundation for research agents, support bots, and automation that runs without a human in the loop.
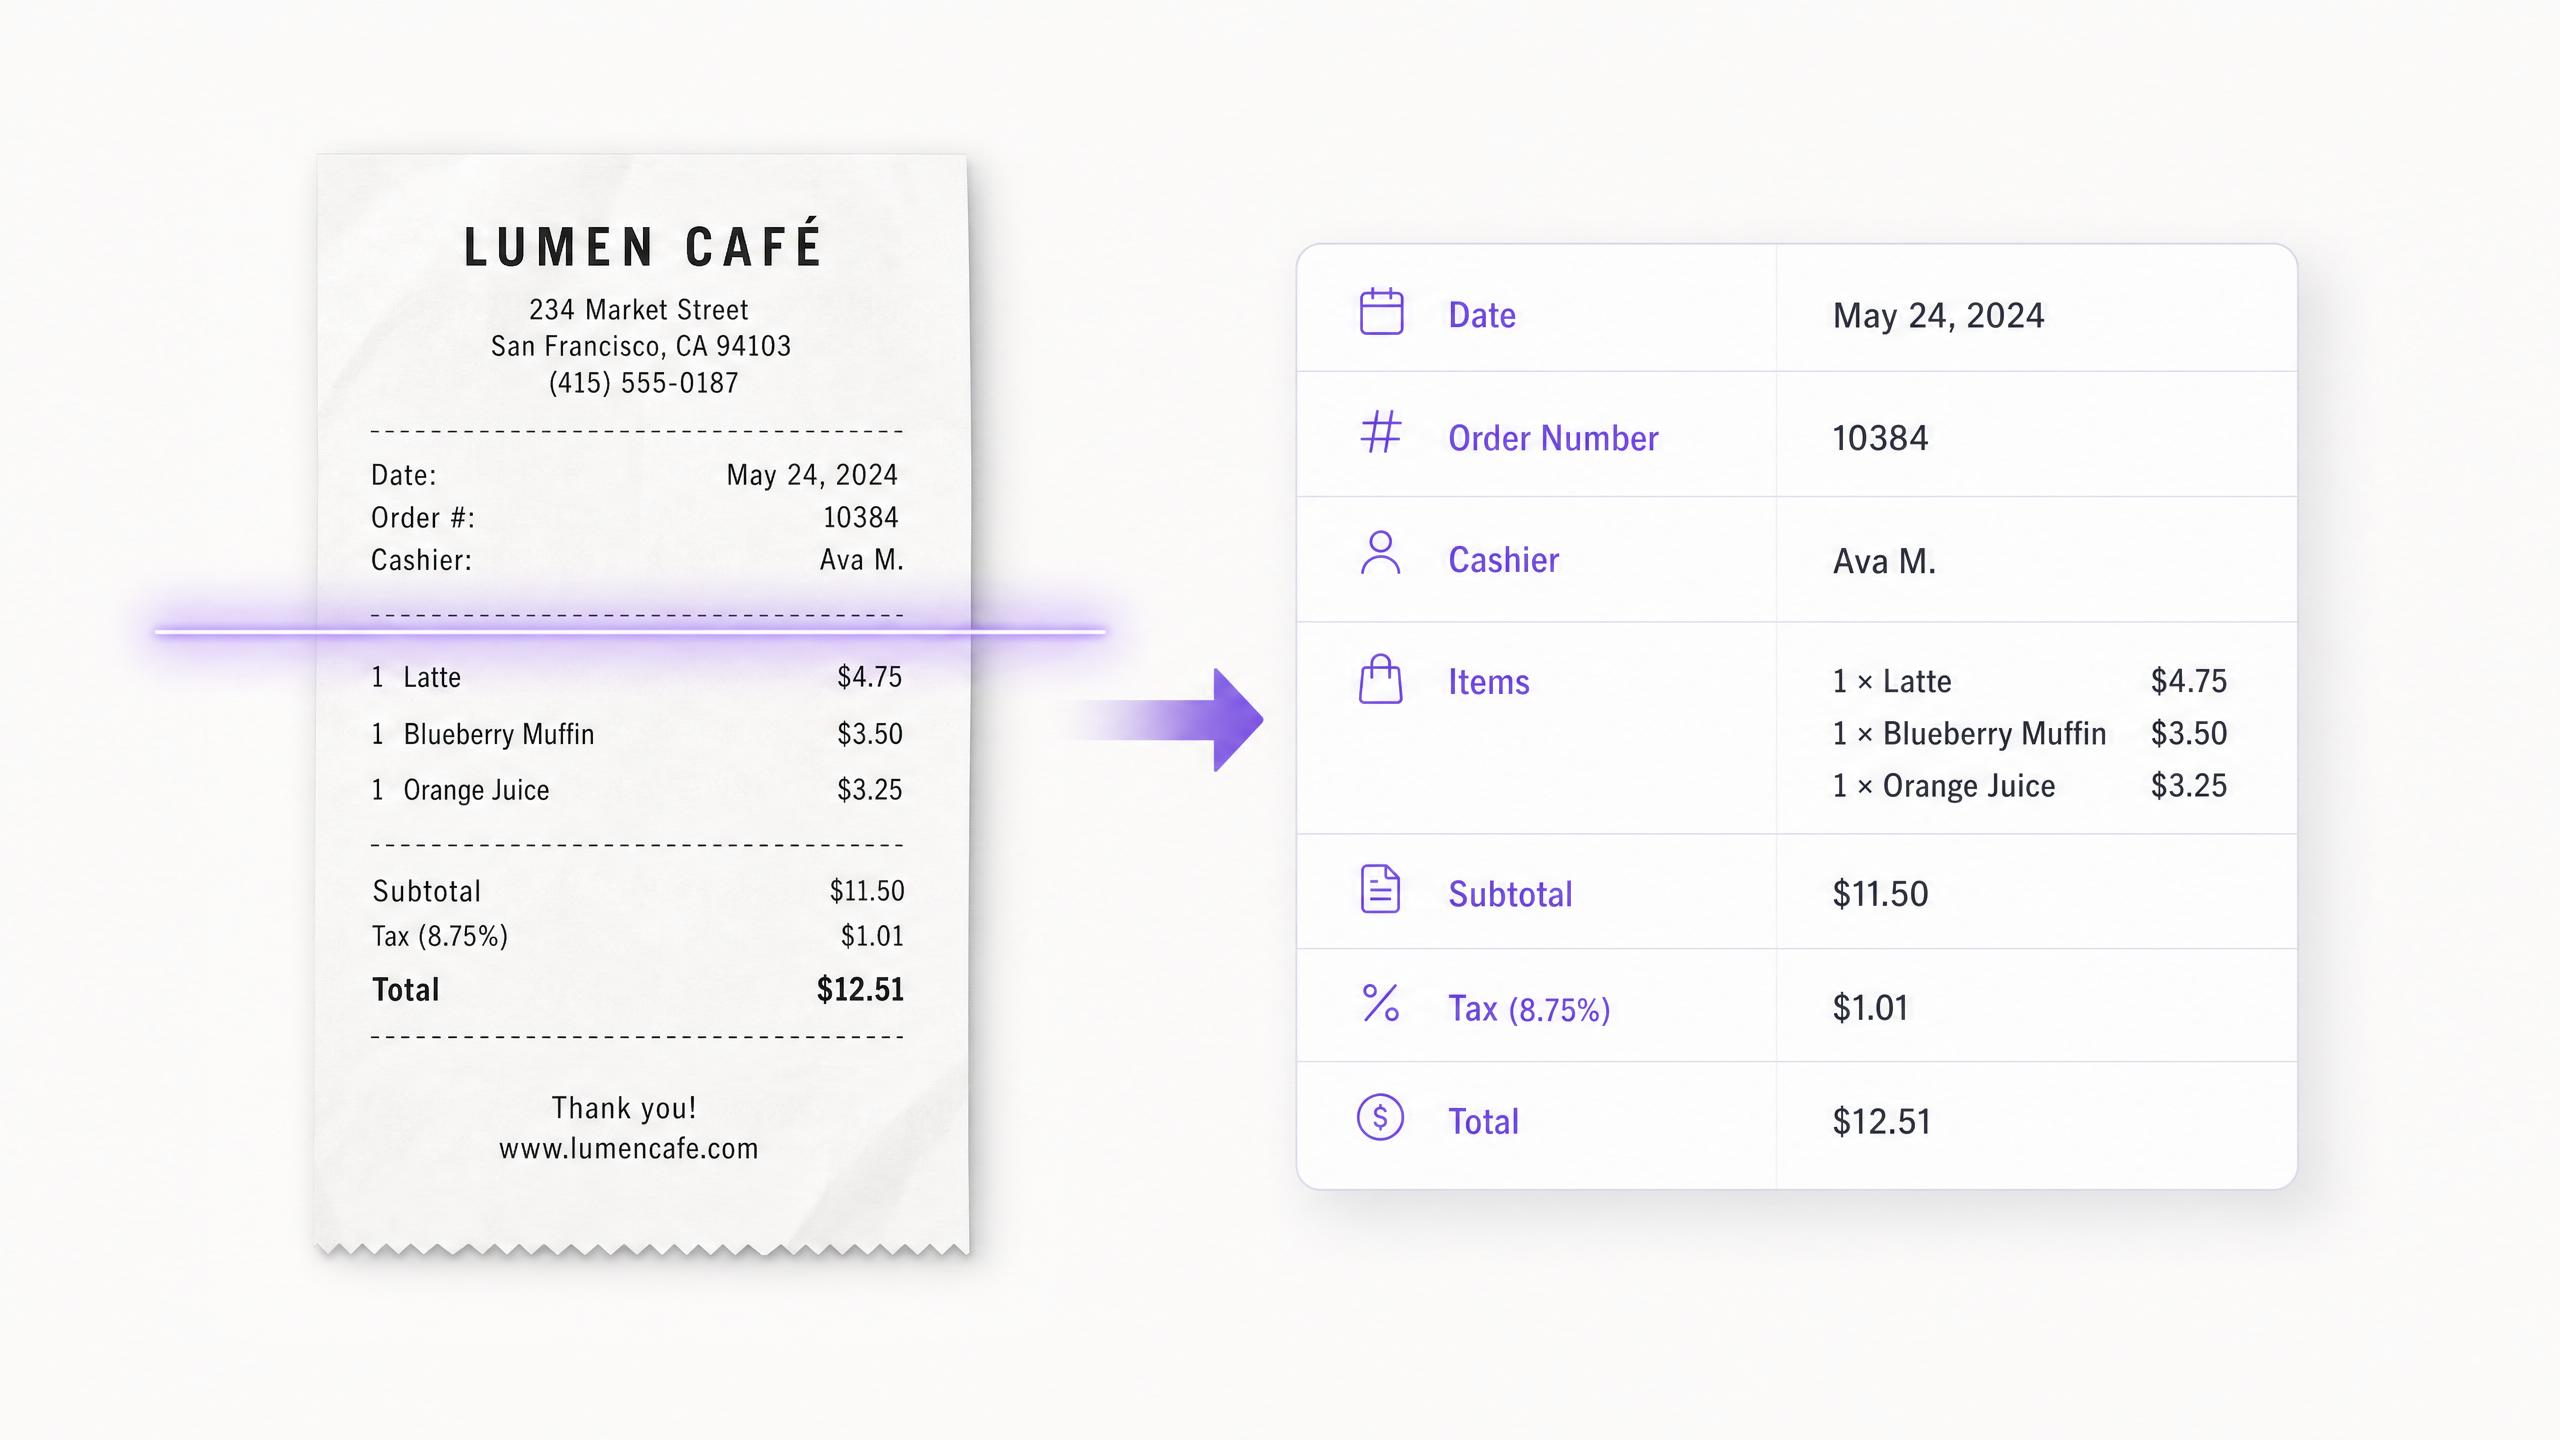
Structured Outputs and Vision with the Grok API
The Grok API returns structured JSON that matches your schema, so extracted data flows straight into downstream code. Grok 4.3 also accepts images alongside text, handling diagrams, screenshots, and UI mockups in the same call.
Coding with Grok Build 0.1
Grok Build 0.1 is xAI's coding-tuned model for code generation, debugging, and refactoring across developer workflows, with a 256K token context. It targets interactive coding agents and multi-step development tasks rather than general chat.
Prompt Caching on the Grok API
The Grok API supports prompt caching, which reuses a shared system prompt or context prefix at a lower token rate. For agentic loops that send the same instructions across many calls, this cuts repeated input cost without changing your code.
Un unico prompt di costruzione trasversale ai modelli
Fornisci lo stesso prompt di costruzione a Grok e agli altri modelli su Atlas Cloud, e osserva ciascuno di essi generare una pagina web completa ed eseguibile, in modo da poter confrontare lo stile di programmazione e l'output fianco a fianco.
Costruisci un singolo file HTML autonomo che mostri un sistema solare 3D interattivo utilizzando Three.js da una CDN. Renderizza il sole e otto pianeti in orbita con texture approssimate da colori e bagliori, orbite animate e uno sfondo stellato. Consenti all'utente di ruotare e ingrandire la fotocamera con il mouse e di fare clic su un pianeta per far volare fluidamente la fotocamera verso di esso e visualizzarne le statistiche. Includi un elegante titolo in sovrimpressione e un controllo per accelerare o rallentare il tempo. Mantieni tutto in un unico file HTML con l'importazione CDN di Three.js. Dai la priorità a un aspetto sbalorditivo e cinematografico.
Grok 4.3
GLM 5
Grok Build 0.1
Crea un singolo file HTML autonomo che funga da dashboard di analisi animata. Includi un grafico a barre animato, un grafico a linee che si disegna da solo al caricamento, un grafico a ciambella e schede di statistiche di riepilogo con conteggio incrementale. Utilizza dati di esempio hardcoded, animazioni di ingresso fluide e un layout per dashboard scuro, pulito e moderno. Aggiungi un delicato tooltip al passaggio del mouse su ciascun elemento del grafico. Utilizza solo CSS inline e JavaScript puro (vanilla) con canvas o SVG, senza librerie esterne. Fai in modo che sembri una dashboard SaaS premium.
Grok 4.3
GLM 5
Grok Build 0.1
Cosa puoi fare con l'API Grok LLM su Atlas Cloud
Grok 4.3 combina una finestra di contesto di 1 milione di token con la ricerca web e su X in tempo reale, rendendolo pratico per i flussi di lavoro di produzione che necessitano di informazioni aggiornate insieme a un ragionamento profondo.

Pipeline di ricerca e intelligenza in tempo reale
I team che creano strumenti di ricerca utilizzano i componenti aggiuntivi Web Search e X Search di Grok 4.3 per estrarre dati in tempo reale dal web e da X direttamente nella generazione, senza un livello di recupero separato. Questo è utile per l'analisi della concorrenza, il riepilogo delle notizie e i flussi di lavoro di market intelligence in cui la risposta dipende dalle informazioni pubblicate dopo la data limite di addestramento del modello. Web Search e X Search vengono fatturati a 5 $ ogni 1.000 chiamate sull'API xAI.

Backend LLM di produzione efficiente in termini di costi
I team di ingegneria che passano da GPT-4.1 o Claude Sonnet utilizzano Grok 4.3 come sostituzione diretta tramite l'endpoint di Atlas Cloud compatibile con OpenAI. A 1,25 $ per milione di token di input, Grok 4.3 è circa il 37% più economico di GPT-4.1 e il 58% più economico di Claude Sonnet 4.6 in fase di input. La migrazione richiede solo la modifica del base URL e della chiave API nel codice SDK esistente.

Analisi di documenti lunghi con contesto da 1M
I team legali, finanziari e di ricerca utilizzano la finestra di contesto da 1 milione di token di Grok 4.3 per elaborare set completi di contratti, dichiarazioni finanziarie o documentazione tecnica in una singola chiamata API. L'ampio contesto elimina la necessità di pipeline di recupero a blocchi e preserva il ragionamento tra documenti che i modelli a contesto più breve interrompono. Il prompt caching riduce ulteriormente i costi quando lo stesso contesto del documento viene riutilizzato su più chiamate di analisi.

Codifica Multimodale e Analisi Visiva
Gli sviluppatori utilizzano la comprensione delle immagini di Grok 4.3 per passare diagrammi, screenshot, mockup di interfacce utente e log di errore insieme al testo nella stessa chiamata API. Ciò è utile per i flussi di lavoro di debug in cui uno screenshot di un errore o un diagramma dell'architettura di sistema fornisce un contesto che il solo testo non può offrire. La chiamata di funzioni e gli output strutturati sono supportati nella stessa chiamata, pertanto i dati visivi estratti possono essere restituiti in uno schema pronto per l'elaborazione a valle.

Esecuzione di Task Multi-step Basata su Agenti
I team di prodotto utilizzano l'ottimizzazione agentica di Grok 4.3 per creare agenti che pianificano, eseguono e iterano attraverso passaggi multipli senza bisogno di prompt umani intermedi. Il modello è specificamente ottimizzato per la scomposizione di task complessi: divide un obiettivo di alto livello in sotto-attività, richiama gli strumenti in sequenza e si adatta in base ai risultati intermedi. Combinato con il function calling e il componente aggiuntivo Web Search, ciò copre flussi di lavoro dalla ricerca all'output come "trova concorrenti, analizza i prezzi, stendi un rapporto di confronto" in una singola esecuzione dell'agente.

Esecuzione di codice nel contesto per l'analisi dei dati
I team di dati e analisi utilizzano Grok 4.3 con il componente aggiuntivo Code Execution per eseguire Python direttamente all'interno della chiamata di inferenza, elaborare i dati e restituire i risultati calcolati insieme al ragionamento del modello. Ciò elimina la necessità di un ambiente di esecuzione del codice separato durante la creazione di strumenti di analisi dei dati o pipeline di reportistica automatizzate. Code Execution viene fatturato a $5 ogni 1.000 chiamate sull'xAI API, separatamente dai costi dei token.
Confronto della Grok API
Scopri come la Grok API si confronta con altri LLMs leader su Atlas Cloud in base a contesto, input e focus, in modo da poter indirizzare ogni attività al modello più adatto, il tutto con un'unica chiave.
| Model | Provider | Context Window | Inputs | Best For |
|---|---|---|---|---|
| Grok 4.3 | xAI | 1M tokens | Text | Agentic reasoning, long-document analysis, high factual accuracy |
| Grok Build 0.1 | xAI | 256K tokens | Text | Code generation, debugging, refactoring |
| DeepSeek V4 Pro | DeepSeek | 1M tokens | Text | Cost-efficient reasoning and agentic tool use at scale |
| Kimi K2.6 | Moonshot | 262K tokens | Text, image | Long-horizon coding agents and multimodal workflows |
| GLM 5.2 | Z.ai | 202.8K tokens | Text | Long-horizon agentic engineering and project-scale coding |
Come Utilizzare Grok su Atlas Cloud
Inizia in pochi minuti — segui questi semplici passaggi per integrare e distribuire i modelli tramite la piattaforma Atlas Cloud.
Crea un Account Atlas Cloud
Registrati su atlascloud.ai e completa la verifica. I nuovi utenti ricevono crediti gratuiti per esplorare la piattaforma e testare i modelli.
Perché Usare Grok su Atlas Cloud
Combinando i modelli avanzati di Grok con la piattaforma GPU-accelerata di Atlas Cloud, ottieni prestazioni, scalabilità ed esperienza di sviluppo senza pari.
Prestazioni e Flessibilità
Bassa Latenza:
Inferenza ottimizzata su GPU per elaborazione in tempo reale.
API Unificata:
Esegui Grok, GPT, Gemini e DeepSeek con un'unica integrazione.
Prezzi Trasparenti:
Fatturazione prevedibile per token con opzioni Serverless.
Enterprise e Scalabilità
Esperienza Sviluppatore:
SDK, analytics, strumenti di fine-tuning e template.
Affidabilità:
99,99% di uptime, RBAC e logging conforme alle normative.
Sicurezza e Conformità:
SOC 2 Type II, allineamento HIPAA, sovranità dei dati negli USA.
Domande frequenti su Grok LLM
Atlas Cloud ospita Grok 4.3, l'attuale LLM di punta di xAI, disponibile a 1,25 $ per milione di token di input. Il modello supporta chat, ragionamento, chiamate di funzione, output strutturati e comprensione delle immagini in una singola API. Controlla la pagina della collezione xAI di Atlas Cloud per eventuali versioni aggiuntive di Grok man mano che vengono aggiunte.
Grok 4.3 supporta una finestra di contesto di 1 milione di token. È sufficientemente grande per elaborare intere codebase, lunghi documenti di ricerca o sessioni estese di agenti multi-turno in una singola chiamata. Il limite di contesto si applica alla combinazione di input di testo e immagini.
Sì. L'API di xAI supporta Web Search e X Search come componenti aggiuntivi opzionali, fatturati separatamente a 5 dollari per 1.000 chiamate. Ciò consente a Grok di recuperare informazioni in tempo reale dal web o da X durante una generazione. Accedi a queste funzionalità tramite l'endpoint API standard insieme alle tue normali chiamate API.
Sì. L'API di xAI supporta il caching dei prompt, il che riduce i costi per le richieste che riutilizzano lo stesso prompt di sistema o prefisso di contesto. I token di input memorizzati nella cache vengono fatturati a una tariffa significativamente inferiore rispetto ai token non memorizzati nella cache. Ciò è particolarmente utile per i flussi di lavoro basati su agenti che inviano le stesse istruzioni in molteplici chiamate.
Sì. Grok 4.3 supporta l'input multimodale, accettando immagini insieme al testo nella stessa chiamata API. È possibile passare URL di immagini o immagini codificate in base64 tramite il formato standard dei messaggi. Ciò consente casi d'uso come la risposta a domande visive, l'analisi di documenti e la generazione di codice guidata dalle immagini.
Sì. Grok 4.3 supporta la chiamata di funzioni, gli output strutturati e le risposte in streaming. Queste funzionalità operano con lo schema di funzioni standard compatibile con OpenAI, in modo che le definizioni degli strumenti esistenti dalle integrazioni basate su GPT si trasferiscano direttamente. L'esecuzione del codice è inoltre disponibile come componente aggiuntivo opzionale a 5 $ ogni 1.000 chiamate.
Il caching dei prompt riutilizza un prefisso di contesto ripetuto, come un lungo prompt di sistema o istruzioni condivise, a una tariffa ridotta per i token di input nelle chiamate successive. Per chatbot e agenti che rinviano la stessa configurazione a ogni richiesta, questo riduce i costi di input ripetuti senza modificare il codice. Inserisci il contenuto statico all'inizio del prompt e il contenuto utente variabile alla fine in modo che la cache venga applicata.
I limiti di frequenza e la concorrenza variano in base al livello dell'account, pertanto è consigliabile aggiungere un backoff esponenziale e un nuovo tentativo in caso di risposta 429, nonché mettere in coda le richieste durante i picchi di traffico. Per i lavori offline di grandi dimensioni, l'elaborazione batch mantiene il lavoro di massa fuori dai limiti in tempo reale. Un costo nascosto comune su larga scala è il reinvio della cronologia completa delle conversazioni a ogni chiamata, quindi trasmetti un riepilogo compatto invece dell'intero thread e contatta l'assistenza per aumentare i limiti man mano che cresci.
L'API di Grok utilizza una fatturazione a consumo (pay-as-you-go) basata sull'utilizzo dei token, in cui i token di input e output vengono misurati per richiesta e non è necessario alcun abbonamento. Eseguire Grok accanto a oltre 300 altri modelli su Atlas Cloud significa avere un unico account e un'unica fattura anziché contratti separati per ogni provider. La memorizzazione nella cache dei prompt e l'elaborazione batch possono ridurre il costo effettivo sui carichi di lavoro ripetitivi o offline.
Crea un account su Atlas Cloud, genera una chiave API e indirizza il tuo client compatibile con OpenAI esistente verso l'endpoint Atlas con il nome del modello Grok. Invia la tua prima richiesta a Grok 4.3 per il ragionamento o a Grok Build 0.1 per la programmazione, quindi scala in base alle necessità. Poiché la stessa chiave consente di accedere a più di 300 modelli, puoi testare altri modelli senza alcuna configurazione aggiuntiva.
Esplora Altre Famiglie
Kling 4.0
L'API Kling 4 offre Kling 4.0, il modello video rilasciato da Kuaishou il 15 ottobre 2026. Genera fino a 30 secondi in un singolo passaggio, segue fino a 10 fotogrammi chiave, fonde 15 immagini, video e soggetti tramite Omni Reference e aggiunge audio stereo con sincronizzazione labiale. Atlas Cloud serve tutti e quattro gli endpoint, incluso l'editing video, su un'unica chiave compatibile con OpenAI a partire da $ 0,11 al secondo. Inizia a costruire oggi stesso.

Seedance 2.5
L'API Seedance 2.5 offre agli sviluppatori il modello congiunto audio e video di ByteDance Seed, generando da 4 a 30 secondi in un solo passaggio a partire da testo, un primo fotogramma o fino a 50 riferimenti tra immagini, video e audio. Modifica le regioni selezionate, estende le clip e segue gli input di modelli bianchi e schermi verdi. Atlas Cloud, un rivenditore autorizzato negli Stati Uniti, aggiunge una modalità bozza a 480p, risultati finali nativi a 1080p e una consegna in 4K migliorata con prezzi basati sul consumo.
Wan 3.0
Wan 3.0 è il nuovo modello video di Alibaba, in grado di produrre fino a 30 secondi di video a 1080p a 30fps con audio in una singola generazione. Guidalo con un prompt di testo, un primo fotogramma, fino a 10 immagini di riferimento o un documento. Standard ha un costo inferiore al secondo, mentre Prime mantiene le stesse capacità e restituisce i risultati più velocemente. Entrambi funzionano sulla stessa chiave Atlas Cloud di Wan 2.7, 2.6 e 2.5.
MiniMax H3
MiniMax H3 è la famiglia di modelli video multimodali di MiniMax per la creazione guidata da testo, immagini e riferimenti. Sulle route supportate, mantiene i soggetti presenti nei media di riferimento, offre rapporti d’aspetto flessibili e abbina l’audio generato alle immagini tramite H3 Developer, con profili di output selezionati in base all’endpoint. Atlas Cloud riunisce l’intera famiglia dietro un’unica chiave compatibile con OpenAI, con prezzi trasparenti a consumo a partire dalla tariffa standard di $0.038 al secondo. Inizia a sviluppare oggi stesso.
GPT Image 2.5
GPT Image 2.5 è il modello di generazione e modifica di immagini di OpenAI, rilasciato l'8 settembre 2026 in due versioni API. Flare è quello predefinito, con una latenza fino al 50% inferiore rispetto a GPT Image 2, mentre Sunburst richiede più tempo per offrire un controllo più preciso sulle modifiche dettagliate. Entrambi supportano fino a 16 immagini di riferimento, cinque livelli di qualità, sfondi trasparenti e dimensioni personalizzate fino a 3840px. Atlas Cloud fornisce l'API di GPT Image 2.5 alle tariffe per token di OpenAI, o a un prezzo fisso per immagine in base al livello 1K, 2K o 4K.
Seedream 5.0 Pro
L'API Seedream 5.0 Pro offre agli sviluppatori il modello di editing delle immagini controllabile di ByteDance su Atlas Cloud. Posiziona le modifiche con precisione tramite ancore e coordinate, separa le immagini in livelli modificabili, fonde più riferimenti e abbina colori e materiali esatti, con testo multilingue a 2K e 3K. Su Atlas Cloud puoi accedervi tramite una sola chiave!
Seedance 2.0
Seedance 2.0 è il modello video di produzione di ByteDance per la creazione precisa di inquadrature. Trasforma i prompt in video, anima un’immagine del primo fotogramma con una guida opzionale dell’ultimo fotogramma oppure modella i risultati con contenuti multimediali di riferimento e la ricerca web opzionale. Atlas Cloud riunisce questi flussi di lavoro in un’unica API, con prezzi trasparenti a consumo e una chiave compatibile con OpenAI. Inizia a sviluppare oggi.
Kling V3.0
Da Kuaishou, la famiglia di API Kling V3 supporta flussi di lavoro con testo, immagini e video di riferimento. Trasferisci i movimenti preservando l’identità dei personaggi, guida la generazione con riferimenti visivi e modifica i video tramite comandi in linguaggio naturale. Atlas Cloud offre endpoint Standard e Pro per diverse esigenze di produzione. Aggiornamento: Kling V4 è ora disponibile su Atlas Cloud. Scoprilo nella pagina [Kling V4](https://www.atlascloud.ai/zh/models/kling-v4).
Grok Imagine Video
Grok Imagine Video offre agli sviluppatori l’accesso alla famiglia di modelli video di xAI per creare, animare, estendere e modificare clip. Genera video da 1 a 15 secondi a partire da prompt, guida persone, oggetti o stili con fino a sette immagini di riferimento e lavora a 480p o 720p. Atlas Cloud riunisce queste funzionalità tramite endpoint compatibili con OpenAI e prezzi trasparenti secondo il consumo. Inizia a sviluppare oggi stesso.
Vidu Q4 Preview
Vidu Q4 è l’ultimo modello video di punta di Vidu, progettato per la generazione da immagine a video e da riferimento a video. Può animare una singola immagine statica e creare transizioni automatiche tra le scene, offrendo agli sviluppatori due modalità di input per diversi flussi di lavoro dei prodotti. Atlas Cloud mette a disposizione endpoint API dedicati con schemi dei parametri pubblicati, al prezzo standard verificato di $0.04 al secondo. Inizia a sviluppare oggi.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash è la famiglia video nativamente multimodale di Google DeepMind, progettata per flussi di produzione flessibili. Modifica filmati esistenti tramite istruzioni testuali, mantieni la coerenza visiva con fino a 10 immagini di riferimento e 3 clip video oppure estendi un’inquadratura in segmenti concatenabili fino a 40 secondi. Accedi a tutti i flussi di lavoro su Atlas Cloud con un’unica chiave API compatibile con OpenAI, prezzi a consumo e disponibilità dal giorno zero. Inizia a sviluppare oggi.
Nano Banana 2.1
Nano Banana 2.1 è la famiglia di modelli di immagini di Google basata su Gemini 3.6 Flash. Offre generazione e modifica a livello Pro con la velocità di Flash, supporta modifiche e fusioni in linguaggio naturale tra 1 e 14 immagini di input e mantiene la coerenza fino a 4 personaggi e 10 oggetti. Tramite Atlas Cloud, gli sviluppatori possono accedere alla famiglia con una sola chiave compatibile con OpenAI, uptime affidabile e disponibilità dal Day-0. Inizia a costruire oggi.
Articoli consigliati
Guide, tutorial e novità di prodotto per sfruttare al meglio Atlas Cloud.


