
MiniMax API
Come suite di punta di Large Language Models (LLM) sviluppata da MiniMax AI, MiniMax è progettata per ridefinire la produttività nel mondo reale attraverso un'intelligenza artificiale all'avanguardia. L'ecosistema include MiniMax M2.5, realizzato appositamente per ambienti professionali ad alta efficienza, e MiniMax M2.1, un modello che offre funzionalità di programmazione multilingue notevolmente potenziate per affrontare attività tecniche complesse e su larga scala. Grazie a prestazioni SOTA nel coding, nell'uso agentico degli strumenti, nella ricerca intelligente e nell'automazione dei flussi di lavoro d'ufficio, MiniMax consente agli utenti di semplificare un'ampia gamma di operazioni ad alto valore economico con precisione e affidabilità senza pari.
MiniMax è sviluppato da MiniMax. Atlas Cloud (gestita da Atlas Cloud AI LLC) ne fornisce l’accesso ma non ne è proprietaria. Tutti i marchi appartengono ai rispettivi titolari.
Esplora i Modelli di Punta
Atlas Cloud ti fornisce i più recenti modelli creativi leader del settore.



Confronta la gamma di modelli MiniMax API
Una panoramica chiara di ciò che ciascun endpoint MiniMax accetta, produce e costa, tra testo, coding, workflow agentic e generazione musicale.
| Modalità | Descrizione |
|---|---|
| MiniMax M3 API (Text) | Ti serve un modello agentic veloce? MiniMax M3 trasforma prompt testuali in codice, chiamate a tool e ragionamento, grazie a un core leggero da 10 billion activated parameter progettato per bassa latenza e scalabilità. Il prezzo standard è di $0.6 per milione di token di input e $2.4 per milione di token di output, con una fascia separata applicata quando un prompt supera 512K token. È adatto a lunghe sessioni agent con molti tool e allo sviluppo di applicazioni moderne. |
| MiniMax M2.7 (Text) | MiniMax M2.7 trasforma istruzioni in linguaggio naturale in codice di produzione e azioni agent multi-step, usando lo stesso design da 10 billion activated parameter per un throughput elevato. Il prezzo standard è di $0.3 per milione di token di input e $1.2 per milione di token di output, mantenendo convenienti le esecuzioni agentic su larga scala. Sceglilo quando coding affidabile e capacità di creazione di app contano più della dimensione grezza del modello. |
| MiniMax M2.5 (Text) | Se il tuo workload richiede ragionamento conveniente e scalabile, MiniMax M2.5 gestisce coding, orchestrazione agentic e sviluppo applicativo quotidiano con un motore compatto da 10 billion activated parameter. Il prezzo indicato è di $0.3 per milione di token di input e $1.2 per milione di token di output, con input in cache a $0.03 per milione per ridurre il costo del contesto ripetuto. Questo lo rende una scelta predefinita pratica per pipeline ad alto volume con riuso del contesto. |
| MiniMax Music 2.6 API (Text to Music) | Descrivi uno stile e fornisci testi strutturati con tag come [Verse] e [Chorus], e MiniMax Music 2.6 restituisce una traccia vocale o strumentale completa da una singola richiesta di generazione. I formati di output includono MP3, WAV e PCM con frequenze di campionamento fino a 44.1 kHz e bitrate fino a 256 kbps, accettando prompt fino a 2.000 caratteri e testi fino a 3.500. A $0.15 per generazione, è indicato per prototipi di colonne sonore, jingle e musica di sottofondo per app e video. |
Nuove funzionalità di MiniMax + Showcase
La combinazione di modelli avanzati con la piattaforma accelerata da GPU di Atlas Cloud offre velocità, scalabilità e controllo creativo senza pari per la generazione di immagini e video.
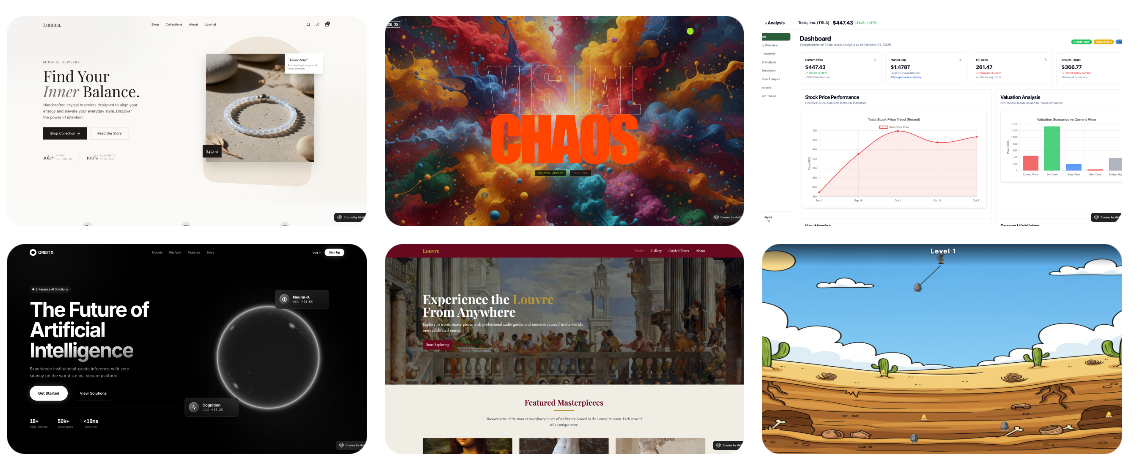
Coding avanzato e pianificazione agentica con MiniMax M2.5
MiniMax M2.5 supporta oltre 10 linguaggi di programmazione, tra cui Rust, Go e Python, per agevolare lo sviluppo full-stack completo su piattaforme Web, mobile e desktop. Integrando una profonda conoscenza di settore per la formattazione professionale dei documenti e la modellazione finanziaria, consente passaggi fluidi dalla progettazione dell’architettura di sistema ai test finali dei deliverable. È la soluzione definitiva per workflow complessi di ingegneria del software e produttività d’ufficio ad alta criticità.
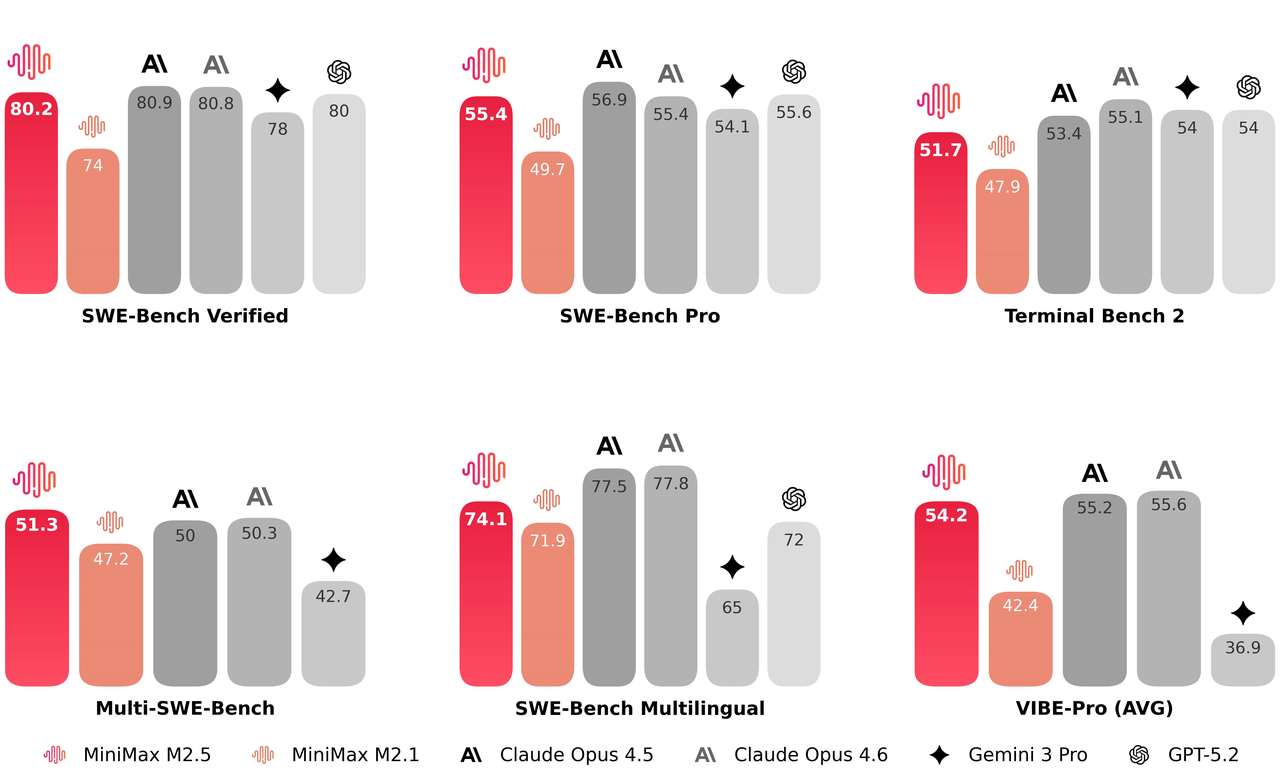
Risposta rapida ed efficienza decisionale nelle attività con MiniMax M2.5
L’architettura M2.5 ottiene un aumento della velocità del 37% nell’esecuzione end-to-end, riducendo in modo significativo la durata delle attività complesse da 31.3 a 22.8 minuti su SWE-bench. Ottimizzando la logica di scomposizione delle attività, il modello richiede il 20% in meno di token e cicli di ricerca per raggiungere gli obiettivi in benchmark come BrowseComp. Offre una soluzione ottimizzata per decisioni ad alta velocità, eliminando al contempo l’overhead computazionale ridondante.
Pensiero intercalato che conserva il ragionamento
I token di ragionamento vengono conservati tra i turni, quindi il modello riprende ogni passaggio di una conversazione agentica multi-turno mantenendo intatto il processo di pensiero precedente. Questo pensiero intercalato gli consente di pianificare, agire, osservare e perfezionare senza scartare la logica che lo ha portato fin lì. Il risultato è un processo decisionale più stabile su orizzonti lunghi, un vantaggio decisivo quando una singola attività comprende molte chiamate sequenziali agli strumenti.
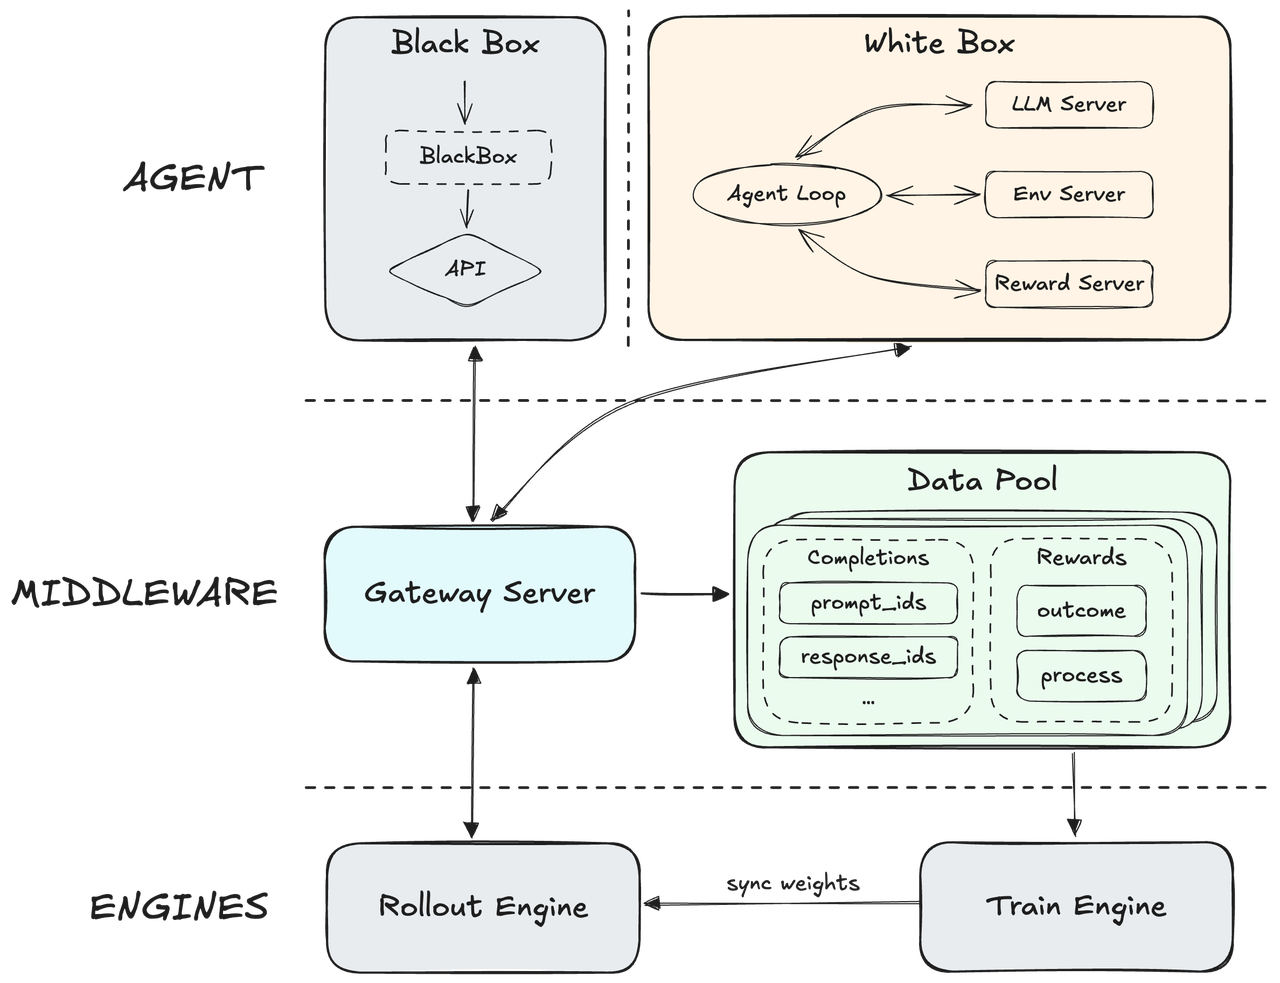
Architettura evolutiva tramite RL su larga scala con MiniMax M2.5
Basato su un framework Agent RL nativo, MiniMax disaccoppia il proprio motore principale dallo scaffolding agentico per generalizzare su centinaia di migliaia di ambienti reali eterogenei. Integra un sofisticato meccanismo di reward di processo che utilizza feedback di esecuzione in tempo reale per perfezionare i percorsi di ragionamento e garantire una qualità di output d’eccellenza. Questo crea un sistema altamente adattivo, capace di mantenere un’accuratezza superiore massimizzando al contempo la velocità complessiva di risposta operativa.
Una finestra di contesto da 196K token nella MiniMax API
Ogni richiesta a MiniMax M2.1 dispone di una finestra di contesto da 196,608 token, sufficientemente ampia da contenere in un unico passaggio monorepo estesi, centinaia di pagine di specifiche o lunghi transcript agentici. Poiché il quadro completo resta residente, il modello segue le dipendenze tra file invece di perdere il filo a metà attività. I team che lavorano su codebase di grandi dimensioni e corpus di ricerca densi ottengono una coerenza che i modelli a contesto breve non possono eguagliare.
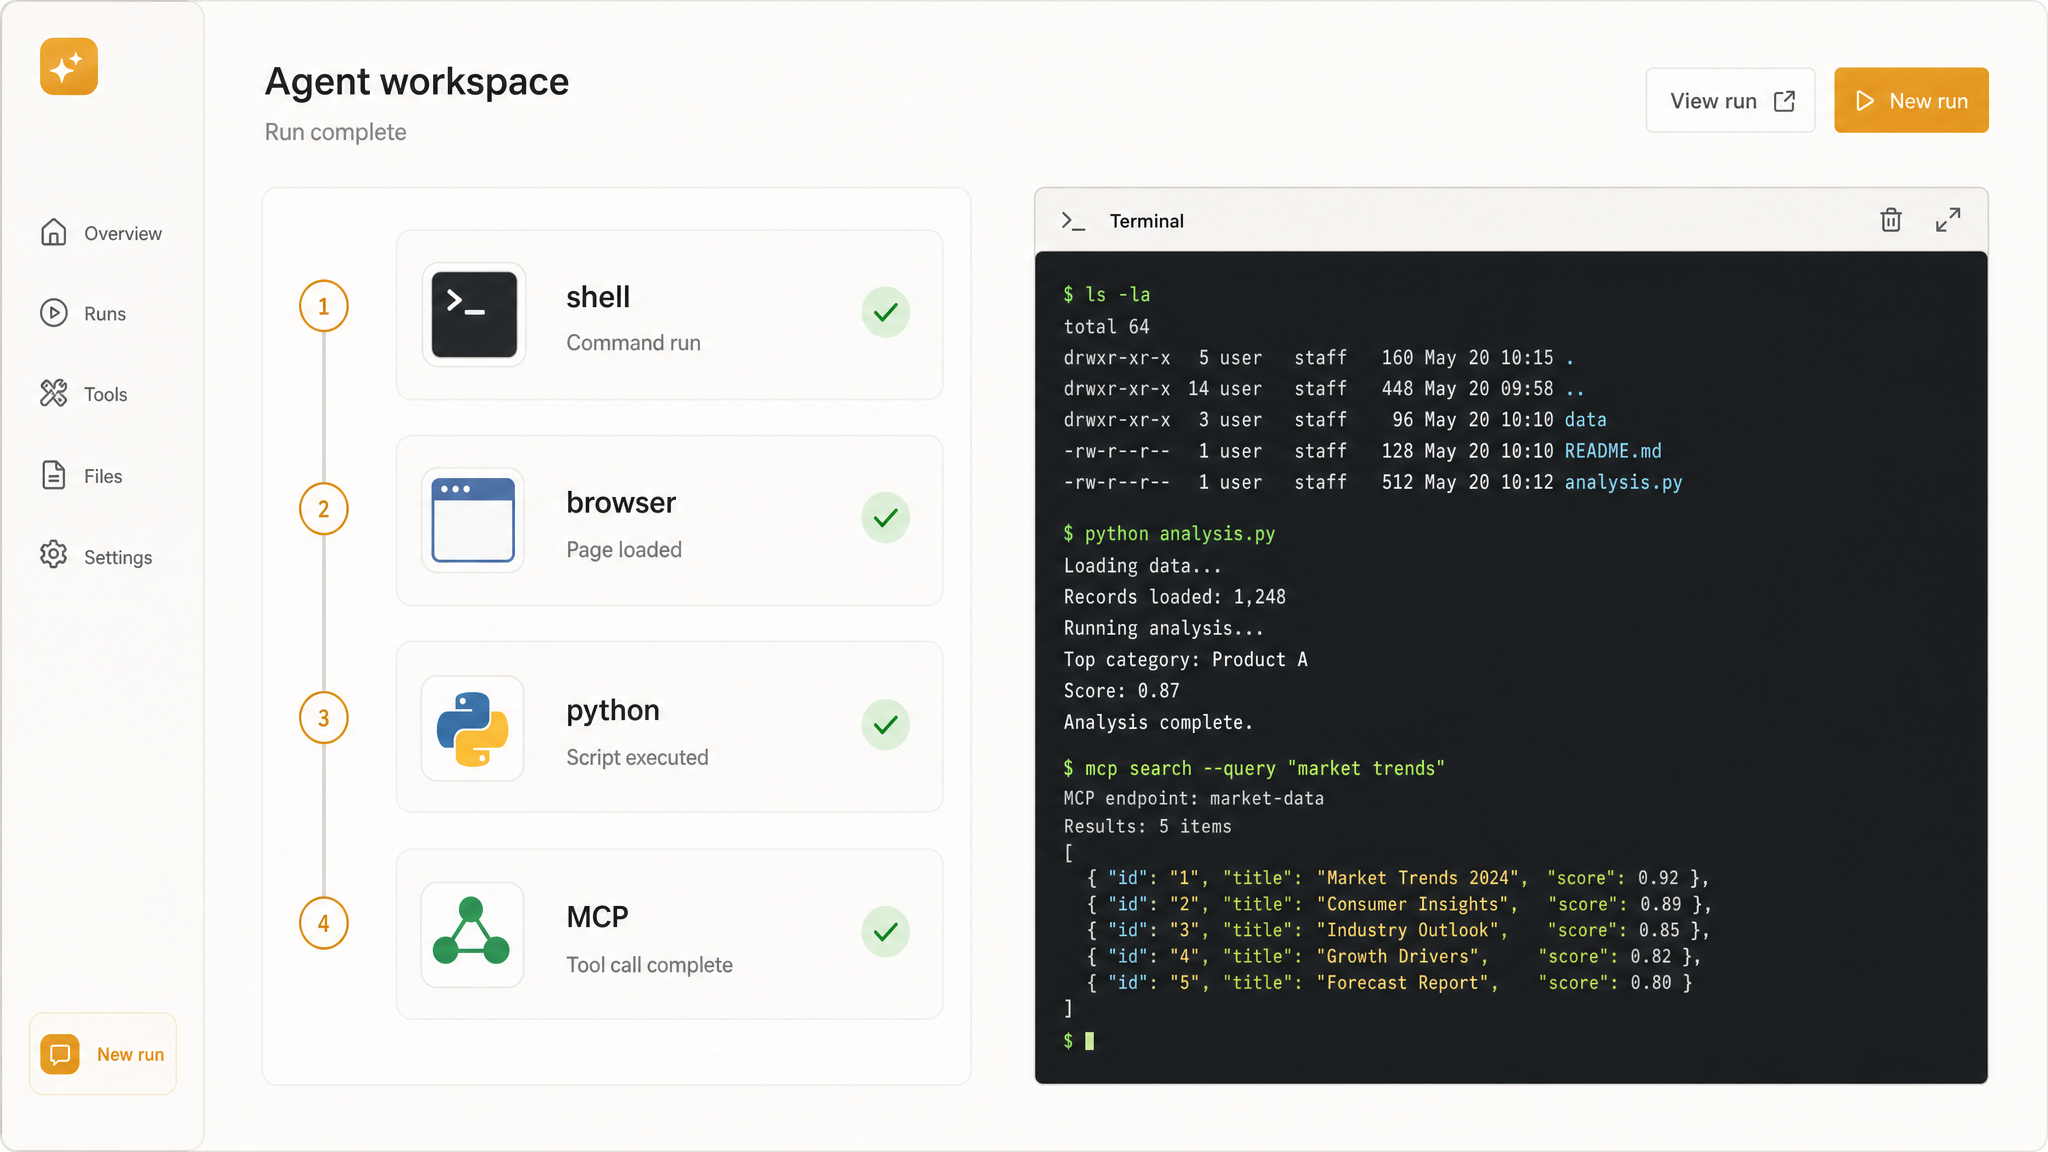
Orchestra shell, browser e codice con la MiniMax API
Il function calling trasforma MiniMax M2.1 in un agente attivo che orchestra comandi shell, sessioni browser, esecuzione Python e strumenti MCP lungo piani a lungo orizzonte. Collega decine di passaggi, legge il feedback di esecuzione e si autocorregge invece di fermarsi al primo risultato. Con un punteggio del 47.9 percento su Terminal-bench 2.0, offre una base affidabile per cicli autonomi di build, test e deployment.
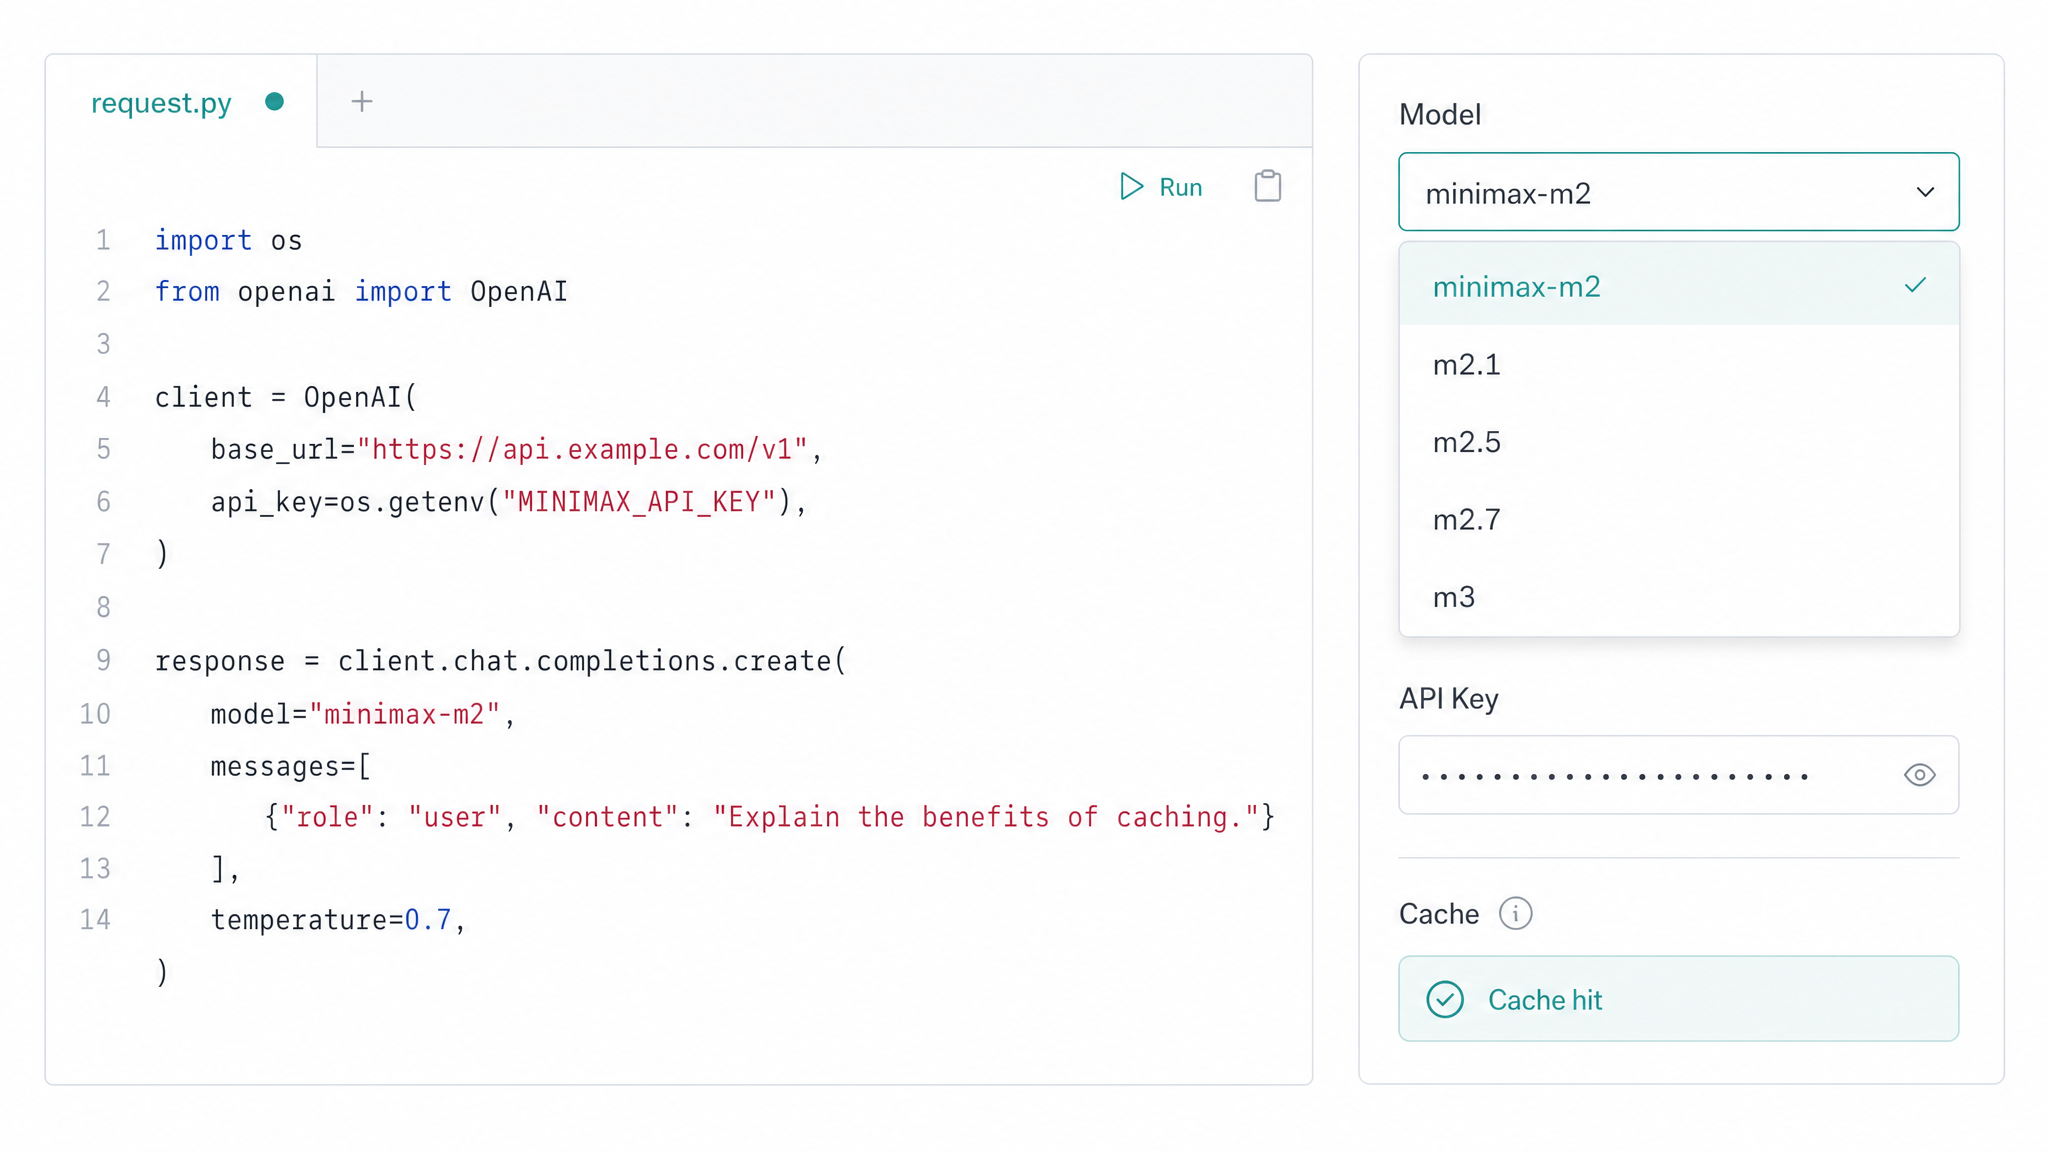
Una sola MiniMax API Key per ogni tier di modello
Una singola chiave compatibile con OpenAI sblocca l’intera gamma MiniMax, da M2 e M2.1 fino a M2.5, M2.7 e M3, insieme ad Anthropic SDK e all’accesso HTTP raw. Puoi cambiare tier modificando una sola stringa del modello, senza riconfigurare il tuo stack. Il prompt caching addebita il contesto ripetuto a $0.03 per milione di token, così i loop agentici iterativi e i lunghi prompt di sistema restano convenienti su larga scala.
Un prompt, tre modelli: la sfida di coding con MiniMax API
Dai lo stesso prompt di sviluppo alla MiniMax API e a due modelli rivali, poi osserva come ciascuno trasforma una singola istruzione in una pagina web funzionante, in un unico file.
Una pagina HTML impeccabile, in un unico file e completamente autonoma (solo CSS e JavaScript inline — assolutamente nessuna libreria esterna, CDN, font o URL di immagini; ogni texture costruita esclusivamente con gradienti CSS, box-shadow e ombre inset) che renderizzi un BANCO DA COMPOSIZIONE TIPOGRAFICA LETTERPRESS interattivo e scheumorfico: riempi il viewport con un caldo piano di lavoro in legno di noce (gradienti marroni stratificati + venatura sottile tramite repeating linear-gradients e puntinatura d’ombra simile a rumore), illuminato da una singola lampada al tungsteno calda dall’angolo in alto a sinistra, così che le parti in metallo spazzolato catturino un morbido riflesso speculare e ogni oggetto in rilievo proietti una lunga ombra soffusa verso il basso a destra. A sinistra: una cassa tipografica a scomparti (California job case) con celle a griglia che contengono minuscoli caratteri mobili in piombo goffrati (lettere, numeri, punteggiatura), ciascuno come un lingotto metallico smussato con un glifo in rilievo e specchiato sulla faccia. Al centro: un compositoio / vassoio di galea aperto dove si accumulano i caratteri composti. Fornisci un flusso di composizione tipografica completo e funzionante: (1) l’utente digita sulla tastiera fisica OPPURE clicca i glifi nella cassa, e per ogni carattere un carattere mobile in piombo si anima volando dalla propria cella e cade nel compositoio con una nitida micro-animazione di assestamento a “clack” con rimbalzo; (2) sottili spaziatori in piombo trascinabili tra i caratteri permettono all’utente di regolare letter-spacing/kerning trascinandoli, con ridisposizione live del layout; (3) un rullo inchiostratore rotante (brayer) che l’utente trascina sulla forma serrata, lasciando sulle facce in rilievo dei caratteri una lucente patina di inchiostro indaco intenso (riflesso speculare mobile animato); (4) una leva di impressione a tiraggio che l’utente preme (click-and-hold o pulsante) abbassa un foglio di carta vergata color crema sulla forma inchiostrata e lo stampa — il momento culminante è la leva che scatta indietro mentre la riga appena stampata appare sulla carta con una tipografia letterpress davvero incavata: ogni lettera impressa nella carta con un’ombra inset che dà un’indentazione fisica, l’inchiostro che sborda/sfrangia leggermente nella grana visibile delle fibre della carta, un tenue alone di impressione della piastra attorno al blocco. Palette: terra d’ombra bruciata, oro ottone spazzolato e crema caldo/bianco sporco carta di riso dominano, con inchiostro indaco intenso come UNICO accento freddo. Includi dettagli tattili: viti zigrinate in ottone, una serratura a cuneo quoin, pulsanti in tonalità legno con stati premuti/attivi realistici e easing appagante su ogni transizione (cubic-bezier elastico). Rendilo responsive (si ridimensiona con grazia fino alla larghezza tablet), mantieni tutto lo stato in vanilla JS e lascia che l’utente componga un breve verso poetico completo, lo inchiostri e tiri una stampa da ammirare visivamente — tutto deve sembrare artigianale, massiccio e cerimoniale, con la fisica della caduta, del trascinamento e dell’impressione comunicata tramite movimento e ombra anziché tramite asset esterni.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Crea un singolo file HTML completo e autonomo che si apra direttamente in qualsiasi browser moderno senza dipendenze esterne — tutto il CSS e il JavaScript devono essere inline, e non sono consentiti librerie esterne, CDN, font o URL di immagini (disegna tutto con Canvas 2D o SVG generato via codice). Costruisci un “Brass Gear Train Workbench” interattivo: un simulatore meccanico di ingranaggi componibili renderizzato su un tavolo da lavoro con blueprint polveroso, dove l’utente assembla un treno di ingranaggi funzionante e osserva una rotazione fisicamente accurata propagarsi lungo la catena. Requisiti principali di interazione e simulazione: - Renderizza il palco principale come una superficie da disegno tecnico blueprint: una griglia fine ciano su carta blu tecnico scuro con un lieve velo di polvere e vignettatura, più tacche dimensionali e annotazioni da disegno lungo i bordi. - Fornisci un contenitore/barra laterale dei pezzi a sinistra con ingranaggi di varie dimensioni distinte (diversi numeri di denti / modules, ad es. 12, 18, 24, 36, 48 denti). L’utente trascina un ingranaggio dal contenitore al palco; al rilascio si aggancia alla griglia. - Ogni ingranaggio deve essere disegnato come una vera ruota dentata in stile involute, in toni ottone — corpo oro caldo, bordo rame invecchiato con patina, riflesso avorio, mozzo visibile, raggi e foro centrale — con una sottile ombreggiatura smussata affinché il metallo sembri metallo. - Implementa un vero rilevamento dell’ingranamento: quando due ingranaggi posizionati si trovano a una distanza tra i centri pari alla somma dei loro raggi primitivi (module × teeth / 2) entro una tolleranza, si accoppiano automaticamente e si bloccano in una catena trainata; disegna un indicatore di ingranamento nel punto in cui i denti si intersecano. Le catene possono ramificarsi attraverso più ingranaggi. - Posiziona un volantino a manovella in basso a sinistra come origine visiva e meccanica. L’utente gira la manovella (trascinandola per ruotarla, oppure tenendo premuto un pulsante); l’intera catena ingranata ruota quindi in sequenza. Calcola velocità angolare e direzione di ogni ingranaggio a valle rigorosamente dal rapporto di trasmissione (ω_out = ω_in × N_in / N_out, con direzione alternata a ogni ingranamento), e anima i denti mantenendoli perfettamente sincronizzati in fase nel punto di contatto, in modo che nessun dente si sovrapponga visibilmente o passi attraverso un altro. - L’ingranaggio finale della catena aziona una lancetta su un quadrante numerato; la lancetta deve mostrare una lettura reale derivata dal rapporto di trasmissione cumulativo (mostra l’output RPM calcolato e il rapporto totale come testo live). - Se l’utente prova a posizionare ingranaggi la cui geometria dei denti non può ingranare (spaziatura/module incompatibili), quel giunto deve incepparsi: lampeggia in rosso, interrompe la propagazione oltre il giunto difettoso e mostra un piccolo avviso “tooth mismatch”. - Aggiungi un fascio di luce: un raggio di caldo sole mattutino obliquo da una finestra in alto attraverso il palco, con pulviscolo animato che fluttua nel fascio e caldi bagliori speculari che scorrono sui denti degli ingranaggi mentre ruotano, così la macchina sembra risvegliarsi. Rifinitura visiva e UX: - Direzione artistica: tratto rétro da disegno tecnico a mano fuso con metallo fotorealistico — griglia fine blueprint sotto ottone, bronzo invecchiato, verde-blu patina e bianco avorio; luce laterale calda con lunghe ombre morbide per scolpire volume e profondità. - La composizione deve far leggere la manovella come punto di ingresso, con la catena motrice che taglia diagonalmente l’inquadratura. - Includi un HUD pulito che mostri velocità della manovella, rapporto di trasmissione totale, output RPM e numero di ingranaggi, più piccoli controlli per invertire la manovella, svuotare il palco e regolare la velocità della manovella con uno slider. - Tutto deve essere fluido (requestAnimationFrame), responsive rispetto alla dimensione della finestra e continuare a funzionare in modo interattivo — trascinamento, aggancio, ingranamento e aggiornamento delle letture devono rispondere tutti in tempo reale. Fallo sembrare tattile, preciso e vivo.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Sviluppa software di produzione con l'API MiniMax
Dalle build full-stack multilingue agli agenti d'ufficio autonomi, l'API MiniMax trasforma la profondità di codifica e l'uso di strumenti a lungo termine di M2.1 in flussi di lavoro che il tuo team distribuisce ogni giorno.

Sviluppo full-stack in più linguaggi
MiniMax M2.1 scrive e revisiona codice di produzione in Rust, Go, TypeScript, C++ e altri linguaggi, coprendo dai sistemi di basso livello ai layer applicativi. I team che sviluppano servizi poliglotti lo usano per mantenere coerente ogni livello.

App mobile native tramite la MiniMax API
Quando le funzionalità Android e iOS devono essere rilasciate insieme, la MiniMax API genera Kotlin, Swift e Objective-C allineati alle convenzioni delle piattaforme. Così i team piccoli possono gestire entrambi gli store senza dividere lo sforzo di engineering.

Agenti di coding autonomi sulla MiniMax API
Integra M2.1 nel loop del tuo agente tramite function calling per pianificare attività multi-step, eseguire strumenti e autocorreggersi su orizzonti lunghi. Gli sviluppatori lo usano per creare assistenti che completano ticket reali, non solo snippet.

Dipendenti digitali per workflow d’ufficio
Agendo come un dipendente digitale, M2.1 esegue attività end-to-end in amministrazione, finanza, data science e HR a partire da comandi in linguaggio naturale. I team operations lo distribuiscono per smaltire su larga scala il lavoro ripetitivo di back office.

Ragionamento sull’intera codebase con contesto 196K
Devi fare refactoring in un repository che non conosci? Con una finestra di contesto da 196.61K token, M2.1 legge centinaia di file in una volta, traccia le dipendenze e fa emergere le modifiche realmente richieste da una migrazione.

Interfacce web interattive con la MiniMax API
Una solida comprensione del design consente alla MiniMax API di creare frontend web curati, interazioni complesse e persino simulazioni di scene scientifiche 3D. I team di prodotto rilasciano dashboard e visualizzazioni ricche di dati direttamente da un prompt.
Come l'API MiniMax si confronta con altri LLM di coding e agenti
Confronta l'API MiniMax con i modelli concorrenti di agenti e programmazione su Atlas Cloud, analizzando nel dettaglio la finestra di contesto, il limite di output e le tariffe dei token a consumo.
| Model | Context Window | Max Output | Input Price ($/1M) | Output Price ($/1M) |
|---|---|---|---|---|
| MiniMax M3 | 524K tokens | 512K tokens | $0.60 / $1.20 (>512K) | $2.40 / $4.80 (>512K) |
| MiniMax M2.7 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| MiniMax M2.5 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| Kimi K2.7 Code | 262K tokens | 262K tokens | $0.95 | $4.00 |
| GLM 4.7 | 203K tokens | 203K tokens | $0.60 | $2.20 |
| DeepSeek V4 Flash | 1M tokens | 393K tokens | $0.14 | $0.28 |
Come Utilizzare MiniMax su Atlas Cloud
Inizia in pochi minuti — segui questi semplici passaggi per integrare e distribuire i modelli tramite la piattaforma Atlas Cloud.
Crea un Account Atlas Cloud
Registrati su atlascloud.ai e completa la verifica. I nuovi utenti ricevono crediti gratuiti per esplorare la piattaforma e testare i modelli.
Perché Usare MiniMax su Atlas Cloud
Combinando i modelli avanzati di MiniMax con la piattaforma GPU-accelerata di Atlas Cloud, ottieni prestazioni, scalabilità ed esperienza di sviluppo senza pari.
Prestazioni e Flessibilità
Bassa Latenza:
Inferenza ottimizzata su GPU per elaborazione in tempo reale.
API Unificata:
Esegui MiniMax, GPT, Gemini e DeepSeek con un'unica integrazione.
Prezzi Trasparenti:
Fatturazione prevedibile per token con opzioni Serverless.
Enterprise e Scalabilità
Esperienza Sviluppatore:
SDK, analytics, strumenti di fine-tuning e template.
Affidabilità:
99,99% di uptime, RBAC e logging conforme alle normative.
Sicurezza e Conformità:
SOC 2 Type II, allineamento HIPAA, sovranità dei dati negli USA.
Domande sulla MiniMax API, con risposte
La MiniMax API offre agli sviluppatori accesso programmatico alla famiglia MiniMax di large language model realizzati da MiniMax AI, una serie progettata per programmazione, uso agentico degli strumenti e ragionamento su orizzonti lunghi. Su Atlas Cloud accedi a questi modelli tramite un unico endpoint compatibile con OpenAI, con prezzi pay-as-you-go trasparenti e accesso Day-0 alle nuove release.
Atlas Cloud ospita i modelli di testo della serie M, tra cui MiniMax M2.5, MiniMax M2.7 e il modello di punta MiniMax M3, insieme a MiniMax Music 2.6 per la generazione da testo a musica. Tutti i modelli condividono la stessa autenticazione e lo stesso endpoint, quindi per passare dall’uno all’altro basta modificare un singolo identificatore del modello nella richiesta.
Questi modelli sono ottimizzati per il software engineering end-to-end: gestiscono modifiche su più file, cicli compile-run-fix e riparazioni validate dai test in molti linguaggi di programmazione. Si comportano bene anche in scenari agentici che richiedono function calling, pianificazione multi-step e recupero dagli errori di esecuzione, il che li rende una scelta naturale per agenti di coding autonomi e workflow basati su strumenti.
Poiché la MiniMax API è compatibile con OpenAI, puoi puntare l’SDK OpenAI standard al base URL di Atlas Cloud, passare la tua chiave e impostare il campo model sulla versione desiderata. Streaming, function calling e output strutturato in JSON usano tutti la stessa interfaccia, quindi per iniziare la maggior parte delle integrazioni esistenti richiede solo la modifica del base URL e della chiave.
Le finestre di contesto variano in base alla versione. MiniMax M2 gestisce circa 200K token, sufficienti per caricare una codebase ampia o una documentazione estesa in una singola richiesta, mentre il più recente M3 estende il limite a circa 1 million token. Scegli il modello con contesto più ampio quando il tuo task coinvolge molti file o materiale di riferimento lungo.
La fatturazione è pay-as-you-go e misurata per token, senza abbonamento obbligatorio. I modelli di testo della serie M2 partono da $0.30 per million input tokens e $1.20 per million output tokens, mentre M3, con capacità superiore, costa $0.60 per million input e $2.40 per million output; l’input in cache viene fatturato a una tariffa inferiore.
Sì. MiniMax ha rilasciato come open source i pesi della serie M con una licenza MIT modificata che aggiunge un requisito di attribuzione per deployment commerciali molto grandi. Puoi eseguire in self-hosting i pesi per la valutazione, poi passare alla Atlas Cloud API quando vuoi infrastruttura gestita, uptime costante e nessuna manutenzione GPU.
MiniMax punta a offrire qualità di coding e capacità agentiche di livello frontier a una frazione del costo dei modelli proprietari più grandi, usando un’architettura mixture-of-experts che attiva solo circa 10 billion dei suoi 230 billion parametri per token. Se il tuo workload riguarda generazione di codice, refactoring o agenti che usano strumenti con un budget contenuto, offre un ottimo equilibrio tra capacità, velocità e prezzo. Il posizionamento nei benchmark cambia a ogni release, quindi valida la versione corrente sui tuoi task prima di impegnarti.
Esplora Altre Famiglie
Seedance 2.5
L'API Seedance 2.5 è ora disponibile su Atlas Cloud! Offre agli sviluppatori il più recente modello video di ByteDance. Genera fino a 30 secondi di video nativo in un unico passaggio da testo, una singola immagine o fino a 50 riferimenti multimodali, con audio sincronizzato e testo multilingue nell'inquadratura. Su Atlas Cloud vi si accede tramite un'unica chiave, con la coerenza del soggetto e la fisica migliorata che mantengono coerenti le riprese lunghe.

Wan 3.0
L'API Wan 3.0 è la generazione successiva della famiglia di video Wan di Alibaba, creata per spingere la generazione di formati lunghi, il controllo multi-riferimento e la qualità audiovisiva a nuovi livelli. Atlas Cloud ospita già Wan 2.7, 2.6 e 2.5, e Wan 3.0 funziona sulla stessa chiave unificata senza alcuna configurazione separata. Inizia a costruire oggi stesso. Scorri verso il basso fino alla vetrina per vedere cosa è in grado di creare Wan 3.0.
MiniMax H3
MiniMax H3 è la famiglia di modelli video di MiniMax per la generazione guidata da testo, immagini e riferimenti. Crea clip da 5 a 15 secondi, guida il movimento con un ultimo fotogramma opzionale, mantieni i soggetti delle immagini di riferimento oppure seleziona H3 Developer quando l'audio generato si adatta al flusso di lavoro. Atlas Cloud riunisce H3, H3 Fast, H3 Max e H3 Developer in un unico flusso di lavoro API, con prezzi standard a partire da $0.038 al secondo. Inizia a sviluppare oggi.
Seedream 5.0 Pro
L'API Seedream 5.0 Pro offre agli sviluppatori il modello di editing delle immagini controllabile di ByteDance su Atlas Cloud. Posiziona le modifiche con precisione tramite ancore e coordinate, separa le immagini in livelli modificabili, fonde più riferimenti e abbina colori e materiali esatti, con testo multilingue a 2K e 3K. Su Atlas Cloud puoi accedervi tramite una sola chiave!
Seedance 2.0
L'API Seedance 2.0 ti offre l'accesso in produzione al modello video multimodale di ByteDance: input quadrimodali (testo, immagine, video, audio) e un sistema "Universal Reference" leader del settore che blocca la composizione, i movimenti di macchina e le azioni dei personaggi tra le diverse inquadrature. Integra un controllo di livello registico con una sola chiamata API, una tariffa fissa di $0,09/s, chiave istantanea e nessuna lista d'attesa, il tutto supportato da uptime e conformità di livello enterprise. Seedance 2.0 Native 4K è ora disponibile!
GPT Image 2.5
La famiglia gpt-image-2.5 di OpenAI offre agli sviluppatori la scelta tra Flare e Sunburst per i flussi di lavoro di produzione delle immagini. Esegui il rendering a risoluzioni arbitrarie fino a 3840x2160 e scegli tra cinque livelli di qualità, inclusi xhigh e max, per soddisfare requisiti di output specifici. Atlas Cloud offre un’inferenza REST pronta all’uso, senza avvii a freddo e con prezzi standard a partire da $0.004 per generazione. Inizia a creare oggi stesso.
GPT Image 2
L'API GPT Image 2 offre agli sviluppatori l'accesso all'ultimo modello di immagini di OpenAI, il successore di GPT Image 1.5. Genera e modifica immagini con un rendering accurato del testo nei caratteri latini e CJK, oltre a una solida composizione per poster, mockup e infografiche. Su Atlas Cloud puoi accedervi tramite un'unica API unificata insieme a oltre 300 modelli, con crediti gratuiti, un tempo di attività del 99,99% e nessuna verifica dell'organizzazione OpenAI richiesta.
Gemini Omni Flash
L’API gemini omni porta agli sviluppatori la famiglia Gemini Omni Flash nativamente multimodale di Google DeepMind, incluso Gemini Omni 1.1 Flash. Crea video cinematografici con audio nativo sincronizzato, anima immagini statiche con un controllo preciso dei fotogrammi iniziale e finale oppure modifica filmati esistenti tramite modifiche guidate dal testo, preservando i contenuti non modificati. Atlas Cloud offre un’unica chiave compatibile con OpenAI, accesso unificato e prezzi trasparenti basati sul consumo. Inizia a creare oggi.
Grok Imagine
L'API Grok Imagine supporta i modelli di immagine, video e sintesi vocale di xAI, da Image 2.0 a Video 1.5 e xAI TTS v1. Genera immagini statiche 1K o 2K su 14 proporzioni d'aspetto, crea scene fino a 15 secondi di movimento 1080p, guida gli scatti con fino a 7 immagini di riferimento, o narrarli in 20 lingue. Atlas Cloud esegue ogni modalità su un singolo endpoint, con prezzi pay-as-you-go da $0,02 per immagine e $0,05 al secondo. Inizia a sviluppare oggi.
I modelli creativi più potenti di Google sono tutti disponibili su Atlas Cloud. Veo 3.1 offre la generazione di video cinematografici, Nano Banana 2 alimenta la creazione di immagini ad alta fedeltà e Gemini porta l'intelligenza multimodale in ogni flusso di lavoro. Accedi alla suite completa di modelli Google tramite una singola API key con disponibilità Day-0 e prezzi a consumo (pay-as-you-go).
Seedance 2.0 Mini
Seedance 2.0 Mini porta la generazione video multimodale di ByteDance nei flussi di lavoro in cui velocità e costi sono fondamentali. Offre le capacità principali di Seedance 2.0 con un impatto minore: generazione più rapida, costi inferiori per video e la stessa integrazione API che utilizzi già. Per i team che gestiscono pipeline ad alto volume o prototipazione su larga scala, Mini è l'opzione predefinita pratica.
ByteDance
Dalla generazione di video cinematografici alla creazione di immagini ad alta fedeltà, i modelli più potenti di ByteDance sono disponibili su Atlas Cloud. Esegui Seedance e Seedream su larga scala con i prezzi di inferenza più bassi e zero costi generali di infrastruttura.
Articoli consigliati
Guide, tutorial e novità di prodotto per sfruttare al meglio Atlas Cloud.


