MiniMaxは金曜日にH3をリリースした。24時間以内にSeedance 2.5が人々の手に渡り、タイムラインは一つの会話に集約された:30秒、ネイティブ4K、50の参照入力。H3のリリース投稿はその下に静かに置かれ、ほとんど誰も実際にテストを実行しなかった。
理由はわかる。30秒は素晴らしい数字だ。見出しに収まる。
しかし、実際に縦型ショートドラマを制作しているなら、あなたの夜を台無しにするのは30秒目ではないことを知っている。それはショット4だ。男性主人公の顎のラインが半センチずれ、彼のクラバットの折り目が消え、視聴者はフックがかかる前にスワイプアウトする。クリップが15秒ではなく30秒だったからといって、誰も離脱しない。クローズアップの男がワイドの男と違うから離脱するのだ。
そこで私はスペックシートの対決をスキップした。1枚のキャラクターターンアラウンドシート、1枚の6パネルロケーションボードを作成し、1つの15秒ゴシックショートドラマプロンプトを書き、両方のモデルに同一のパッケージを送信した。そして、私は顔を見つめた。
重要なポイント
- 今日呼び出せるのはH3のみ — Seedance 2.5のAPIはByteDanceから出ているが、このプラットフォームではまだDay-0ページ。
- スペックは明確に分かれる: Seedance 2.5 = 1ショットで30秒、ネイティブ4K、最大50の参照;H3 = 5~15秒、2K、すべてのクリップにステレオ音声。
- キャラクターの安定性はパッケージングの問題 — より大きなモデルではなく、適切な参照パックが顔を保持する。
- 両方ともネイティブ音声を生成; H3は最大3つの音声参照から声を固定することもできる。
- 秒ではなく、ピクセル/フレームで判断する — 同じ実行で、H3は1440pを返し、Seedanceは720pを返した。
理論抜きのSeedance 2.5 vs MiniMax H3結果
理論抜きで、ワークフローが生成するものを示す。これらは完成した15秒の縦型クリップから抜き出した4つのショットをタイル状に並べたものである。MiniMax独自のH3参照実行であり、ステップ1とステップ2で紹介するキャラクターシートとロケーションボードからそのまま構築され、ネイティブ1440x2560で出力されている。同じパックを使用した私自身の実行結果は、チュートリアル内でプレイグラウンドの状態を表示しながら後ほど紹介する。
彼女は彫刻されたドアにたどり着く。これはロケーションボードのパネル4である。次に廊下での対峙、彼のタイトなクローズアップ、そして2ショット。彼の生え際は横顔とクローズアップで同じように分かれている。彼女のハーフアップの編み込みクラウンは、大半のモデルが静かに顔を再構築するまさにその場所、フルフェイスクローズアップでも崩れない。クリームレースのボディスは、最初のフレームから最後のフレームまで、同じネックラインと袖口を保っている。
これがテストのすべてだ。30秒ではない。4つのショットと顎のラインだ。
Seedance 2.5 vs MiniMax H3が同じ週にリリースされた理由、そしてほとんどのキャラクターテストが役に立たない理由
MiniMaxは7月30日にH3をリリースした。これは汎用マルチモーダルビデオモデルであり、テキスト、画像、ビデオ、音声を1つのコンテキストとして読み取り、5~15秒のクリップを最大2K、ネイティブステレオ音声で返す。また、既存の映像を編集し、あるクリップから別のクリップにモーションを転送することもでき、MiniMaxはウェイトも数日以内に公開すると述べていた(Reuters、2026年7月)。
Seedance 2.5は同じ時期に、より大きな数字を引っさげて登場した:1回の生成で30秒、ネイティブ4K、1ジョブあたり最大50のマルチモーダル参照入力(The Next Web、2026年7月)。そのAPIはすでに開発者の手に渡っており、フレームの一部を再描画しながらパフォーマンス、照明、カメラの振る舞いをそのまま維持するローカライズド編集、グリーンスクリーンプレートや3Dホワイトモデルブロックアウトを受け入れる参照からビデオへの変換、11言語、そして実験的なロングビデオモード(180秒まで)を含んでいる(CineD、2026年7月)。
注目の差が興味深い部分だ。私が見つけたほとんどすべての投稿は2.5のクリップだった。一方、公開アリーナの数値は別のことを示している:Artificial Analysisの画像からビデオへのリーダーボードでは、Seedance 2.0(720p)が1,196 Eloでトップ、Gemini Omni Flashが1,195で続き、MiniMax H3はリリースから4日で既に1,185で3位となっている。Seedance 2.5はまだそこに評価がない(Artificial Analysis、2026年7月)。最も話題が少ないモデルが、スコアと注目度の比率で最も高いという結果だ。
さて、実際に出力を決める部分について話そう。それはほとんど、どのロゴを選ぶかとは関係がない。
ほとんどのキャラクター一貫性テストは、モデルが関与する前に失敗する。4つの失敗モードがあり、そのすべてはあなたが修正できるものだ:
| 失敗モード | 出力に見られるもの | 修正方法 |
|---|---|---|
| 複数ビューの参照を別々のファイルとして送信 | 各ショットの顔が「ほぼ正しい」が、どれも一致しない | ビューを1つの画像に合成し、プロンプトで役割を割り当てる(「左の男」、「右の女」) |
| ショットごとにキャラクターの説明を書き直す | ショット間で衣装やアクセサリーがドリフトする | アイデンティティブロックを一度記述し、そのまま再利用する。各ショットで変更するのはカメラとアクションのみ |
| 照明をシーンに合わせて動かす | 新しい照明で顔が構造的に再構築される | 照明の方向、フォグ、床の反射を固定する別のロケーションボードを作成し、それを参照として与える |
| 最大継続時間を品質指標として扱う | 30秒以内の1回のドリフトが30秒すべてを台無しにする | 再ロール可能な粒度にカットし、その後で長さについて語る |
Seedance 2.5とMiniMax H3を同じプロンプトで自分で比較したいですか? Atlas Cloudのモデル比較では、1回のパスで両方を並べて実行します — 同一のプロンプトと設定で、生成前にコストも見積もられるため、2つの別々のテストを予約することなく、顔、モーション、画面上のテキストを評価できます。
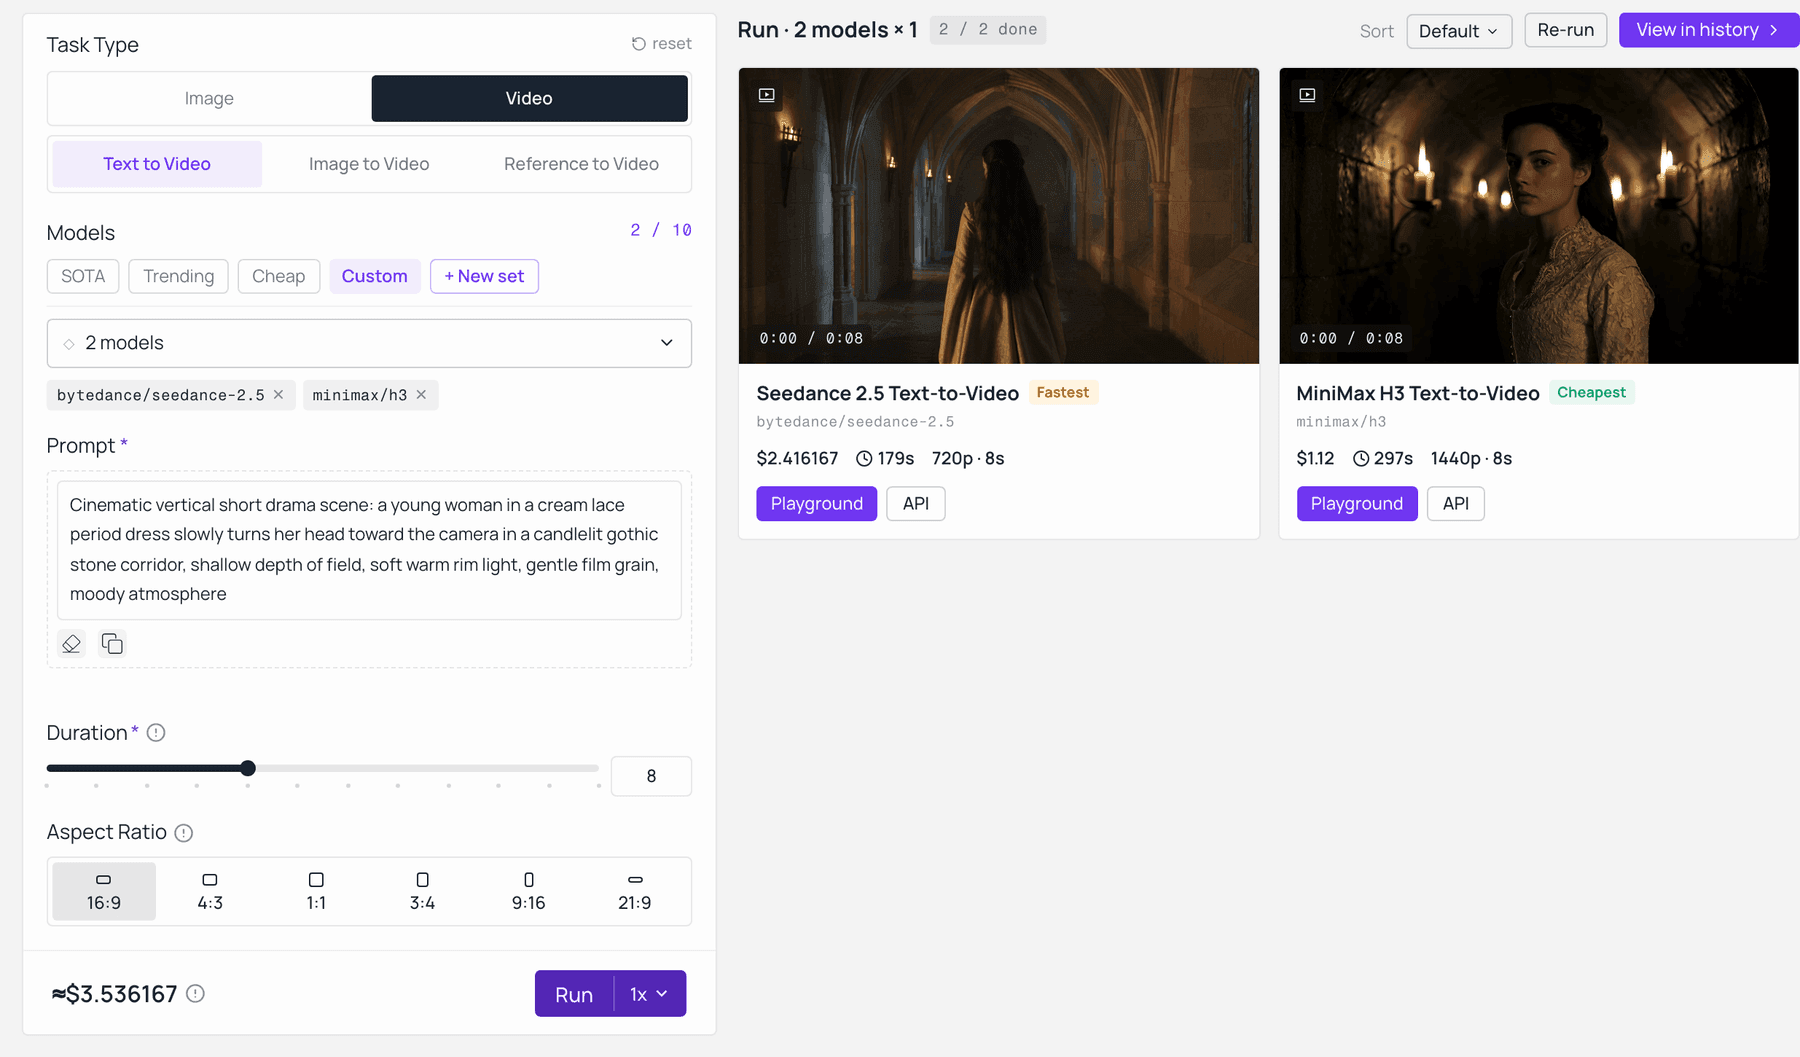
Atlas Cloudのモデル比較で、同一プロンプトでのSeedance 2.5とMiniMax H3。Seedance 2.5は720p、$2.42を返し、MiniMax H3は1440p、$1.12を返し、両方の価格は実行前に見積もられた。モデルエクスプローラーでライブキャプチャ。
最初の行が最も多くの人が間違えるところだ。6枚の単一ビュー画像を送信すると、モデルはそれらを6人の候補人物として扱い、平均化する。1枚のきれいな合成画像を送信すると、それらを3方向から見た1人の人物として扱う。同じピクセルでも、結果はまったく異なる。
Seedance 2.5 vs MiniMax H3スペックシート、そして今日実際に呼び出せるもの
機能と可用性を分けると、緊張が明確になる。生の機能では、Seedance 2.5は継続時間、解像度の上限、参照数、編集の細かさでリードする。可用性では、H3は今週、汎用モデルプラットフォーム上で3つのライブエンドポイントを持つ。2026年の計画のためにAIビデオモデル比較を行う場合、その2番目の列は最初の列と同じくらい重要だ。
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-to-Video(私が実行したもの) | |
|---|---|---|---|
| 1生成あたりの最大長 | 5~15秒 | 最大30秒、ステッチなし(ベータモードで180秒まで、実験的) | 短いクリップメニュー、モデルページ参照 |
| 解像度 | ネイティブ2K、16:9~9:16で短辺1440p;768pティアは近日提供予定 | ネイティブ4K、10ビットカラー | このエンドポイントでは最大720p |
| フレームレート | 24 fps | 個別に公開されていない | 個別に公開されていない |
| 参照入力 | 9画像+3動画+3音声、合計12ファイル | 最大50のマルチモーダル参照 | 9画像+3動画+3音声 |
| ネイティブ音声 | はい、すべての出力、ステレオ | はい、さらに11の字幕と音声言語 | はい |
| 編集の細かさ | クリップ全体の指示編集(キャラクター、背景、照明、ダイアログの交換) | フレームの一部を再描画するリージョンレベルの編集 | クリップ全体の指示編集 |
| プロンプト上限 | 7,000文字 | 公開されていない | 公開されていない |
| オープンウェイト | リリース後数日以内に公開予定と発表 | 発表されていない | 発表されていない |
| Artificial Analysis I2V Elo, 2026年7月31日 | 1,185(3位) | まだ評価なし | 1,196(1位、Dreamina 720pエントリー) |
| テストしたプラットフォームで呼び出し可能か | はい、3エンドポイント | まだ、Day-0ページ | はい |
テスト設定に関する完全な開示。 これを実行した時点では、私のプラットフォームでSeedance 2.5は利用できなかったため、Seedance側はSeedance 2.0 Reference-to-Videoであり、同じファミリーの現在出荷中のメンバーで、同じ4モーダル参照システムを持つ。2.5が答えを変える場合、その旨を明記する。Seedance 2.5ページは現時点ではDay-0のお知らせである。
以下はすべて、1つのブラウザタブ、1つのキーで実行され、合計3モデルである:
| ステップ | モデル | 生成物 | 主要設定 | コストを決めるもの |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | キャラクターターンアラウンドシート | quality high, 16:9 | 画像ごと、従量課金、現在のレートはモデルページ参照 |
| 2 | 同一モデル、2回目の実行 | 6パネルロケーション&ライティングボード | quality high, 16:9 | 画像ごと、従量課金 |
| 3 | MiniMax H3 Reference-to-Video | ネイティブ音声付き9:16クリップ | 9:16, 2K, テスト用5秒、本番用15秒 | 秒数×解像度、秒単位で課金 |
| 4 | Seedance 2.0 Reference-to-Video | 制御実行、同一入力 | 9:16, 利用可能な最高解像度、同一長さ | 秒数×解像度、秒単位で課金 |
| 5 | H3 Reference-to-Video、クリップを入力として | すべてを再ロールせずに1つのショットを修正 | 同一解像度、短い長さ | 秒数×解像度、秒単位で課金 |
H3には、純粋なテキストベースラインや最初と最後のフレーム制御が必要な場合に備えて、text-to-videoおよびimage-to-videoエントリもある。
バッチを計画する前に知っておくべきもう1つのこと:画面上のテキスト。この15秒のH3タイトルシーケンスは、8回のハードカットを通過して英語のクレジットを保持し、1つのスペルミスもない。これは生成ビデオで安定させるのが最も難しいことの1つだ。
Seedance 2.5 vs MiniMax H3ショートドラマワークフロー、ステップバイステップ
5つのステップ。プロンプトは書かれたとおりに正確にコピーすること。醜い部分も含めて。記事用にクリーンアップしていないので、モデル用にもクリーンアップすべきではない。
ステップ1:GPT Image 2でキャラクターシートを作成する
ビデオを作成する前に、参照パックを作成する。1枚の画像、2人のキャラクター、それぞれ3ビュー、純白のシームレスな背景、均一なスタジオ照明。これにより、気にする必要のある1つのあいまいさ(つまり、この人物がどのように見えるか)を除くすべてのあいまいさが除去される。
plaintext1純白のシームレスな背景上の全身キャラクターターンアラウンド参照シート。2人のキャラクターを並べ、合計6体のフィギュア。均一でニュートラルなスタジオ照明、床に影なし、テキストなし、ラベルなし、透かしなし。 2 3左半分、男性主人公、3つのビューを一列に:正面、右側面、背面。20代後半、青白い肌、暗いウェーブのかかったミディアムヘア、シャープな顎のライン。着用:床までの長さの黒いベルベットフロックコート(ラペルと袖口に微妙なトーンオントーンの刺繍)、黒いブロケードウェストコート、黒いシルククラバット、ストレートの黒いトラウザーズ、磨かれた黒いレザーダービーシューズ。腕は体の両側でリラックス、ニュートラルな表情。 4 5右半分、女性主人公、3つのビューを一列に:正面、右側面、背面。20代前半、明るい肌、長いウェーブのかかった栗色の髪(ハーフアップの編み込みクラウン)。着用:クリーム色のビクトリアンコットンレースドレス、レースカフスの長袖、小さなボタンのフィットしたボディス、足首までの丈のフルスカート、クリーム色のアンクルストラップ付きローヒールシューズ。腕は体の両側でリラックス、ニュートラルな表情。 6 7フォトリアリスティック、6体すべてのフィギュア間で一貫したスケール、同じベースラインに合わせた足、端から端までシャープなフォーカス。
設定: モデル OpenAI GPT Image 2 Text-to-Image、Quality high、アスペクト比 16:9、その他はデフォルト。
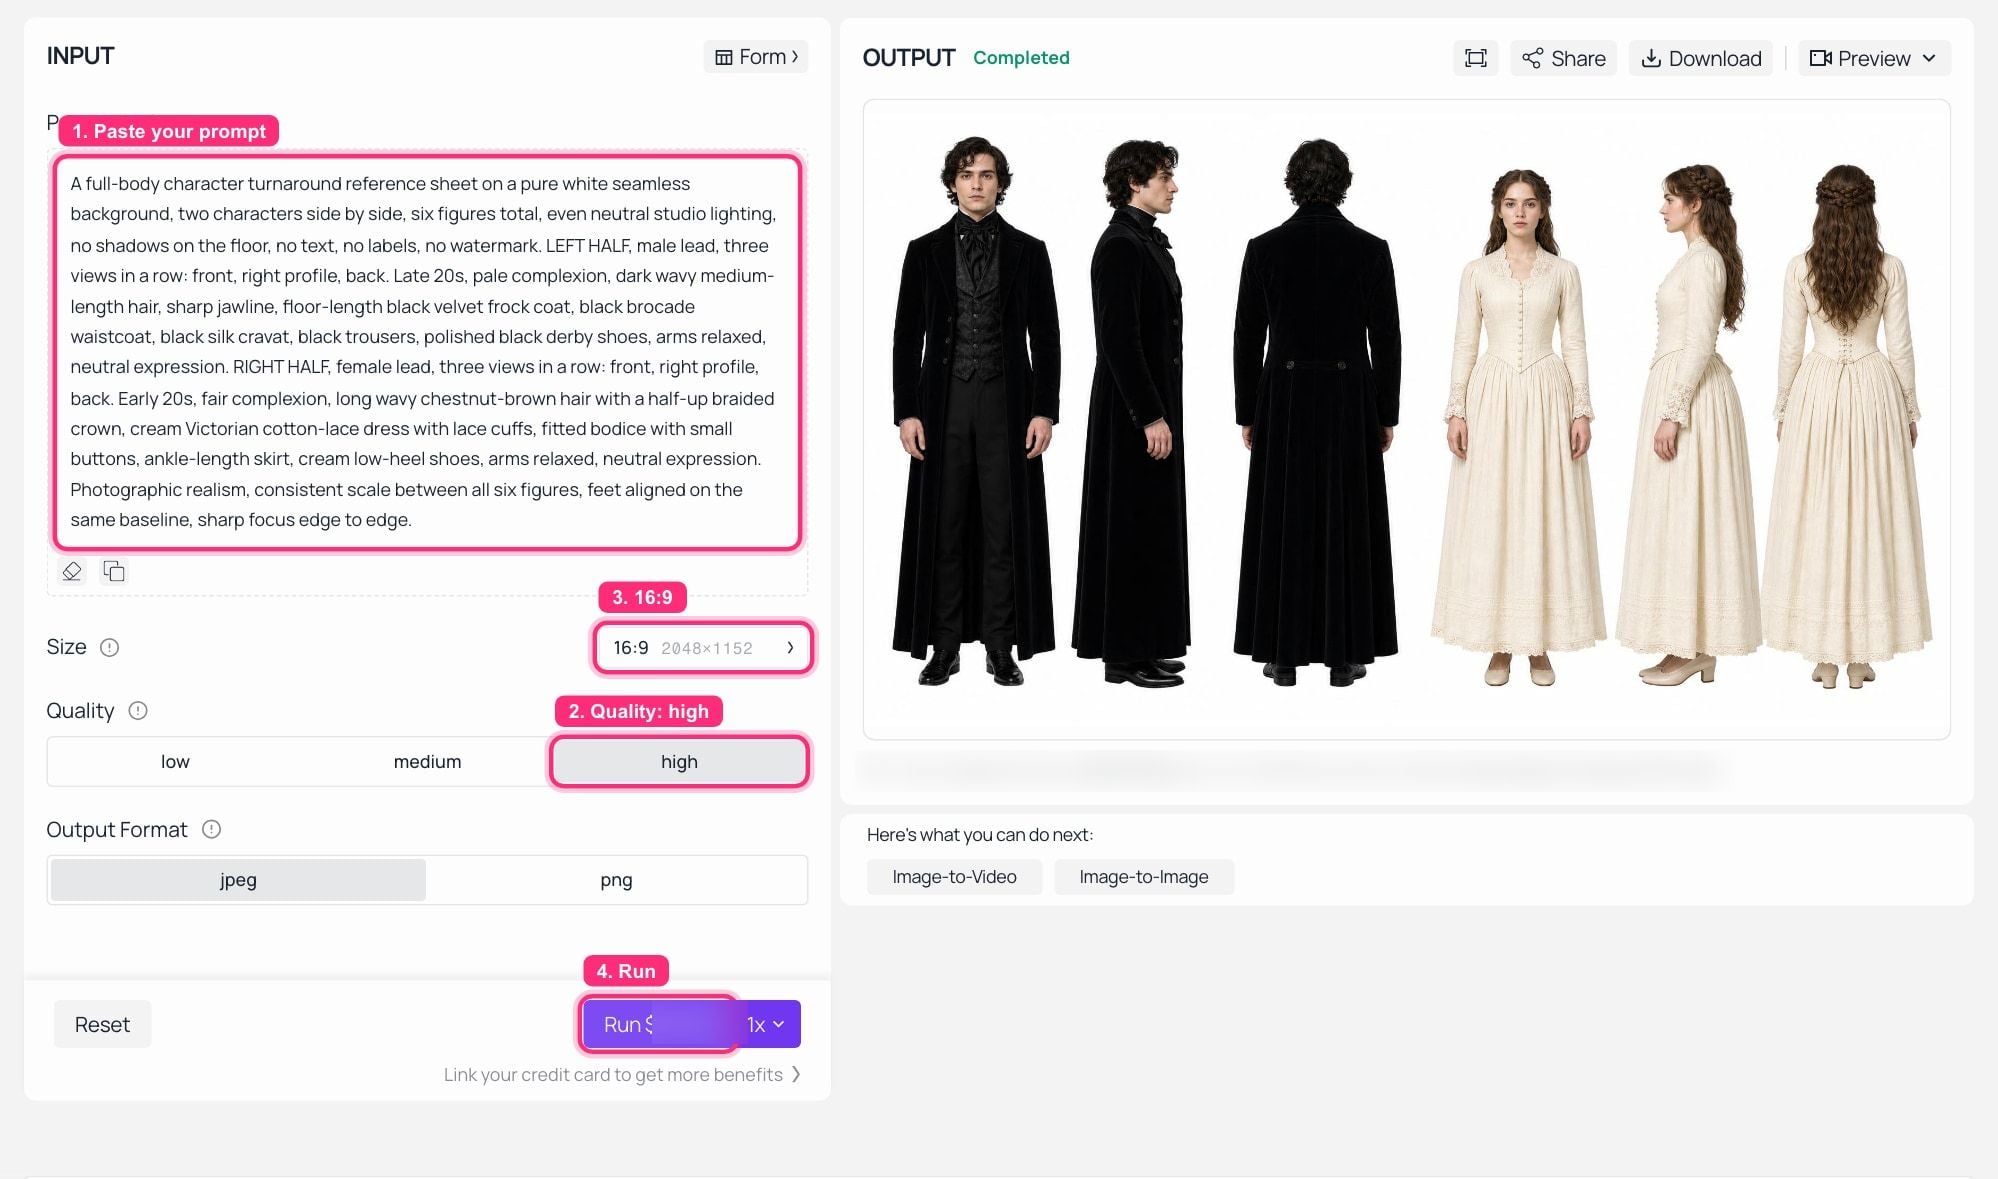 Atlas Cloud上のGPT Image 2 Text-to-Image、実行完了:左側にターンアラウンドプロンプト、OUTPUTパネルに6体のフィギュアが1枚の白いシートに。
これが目標の形状である。6体、1つのベースライン、背景に議論の余地なし:
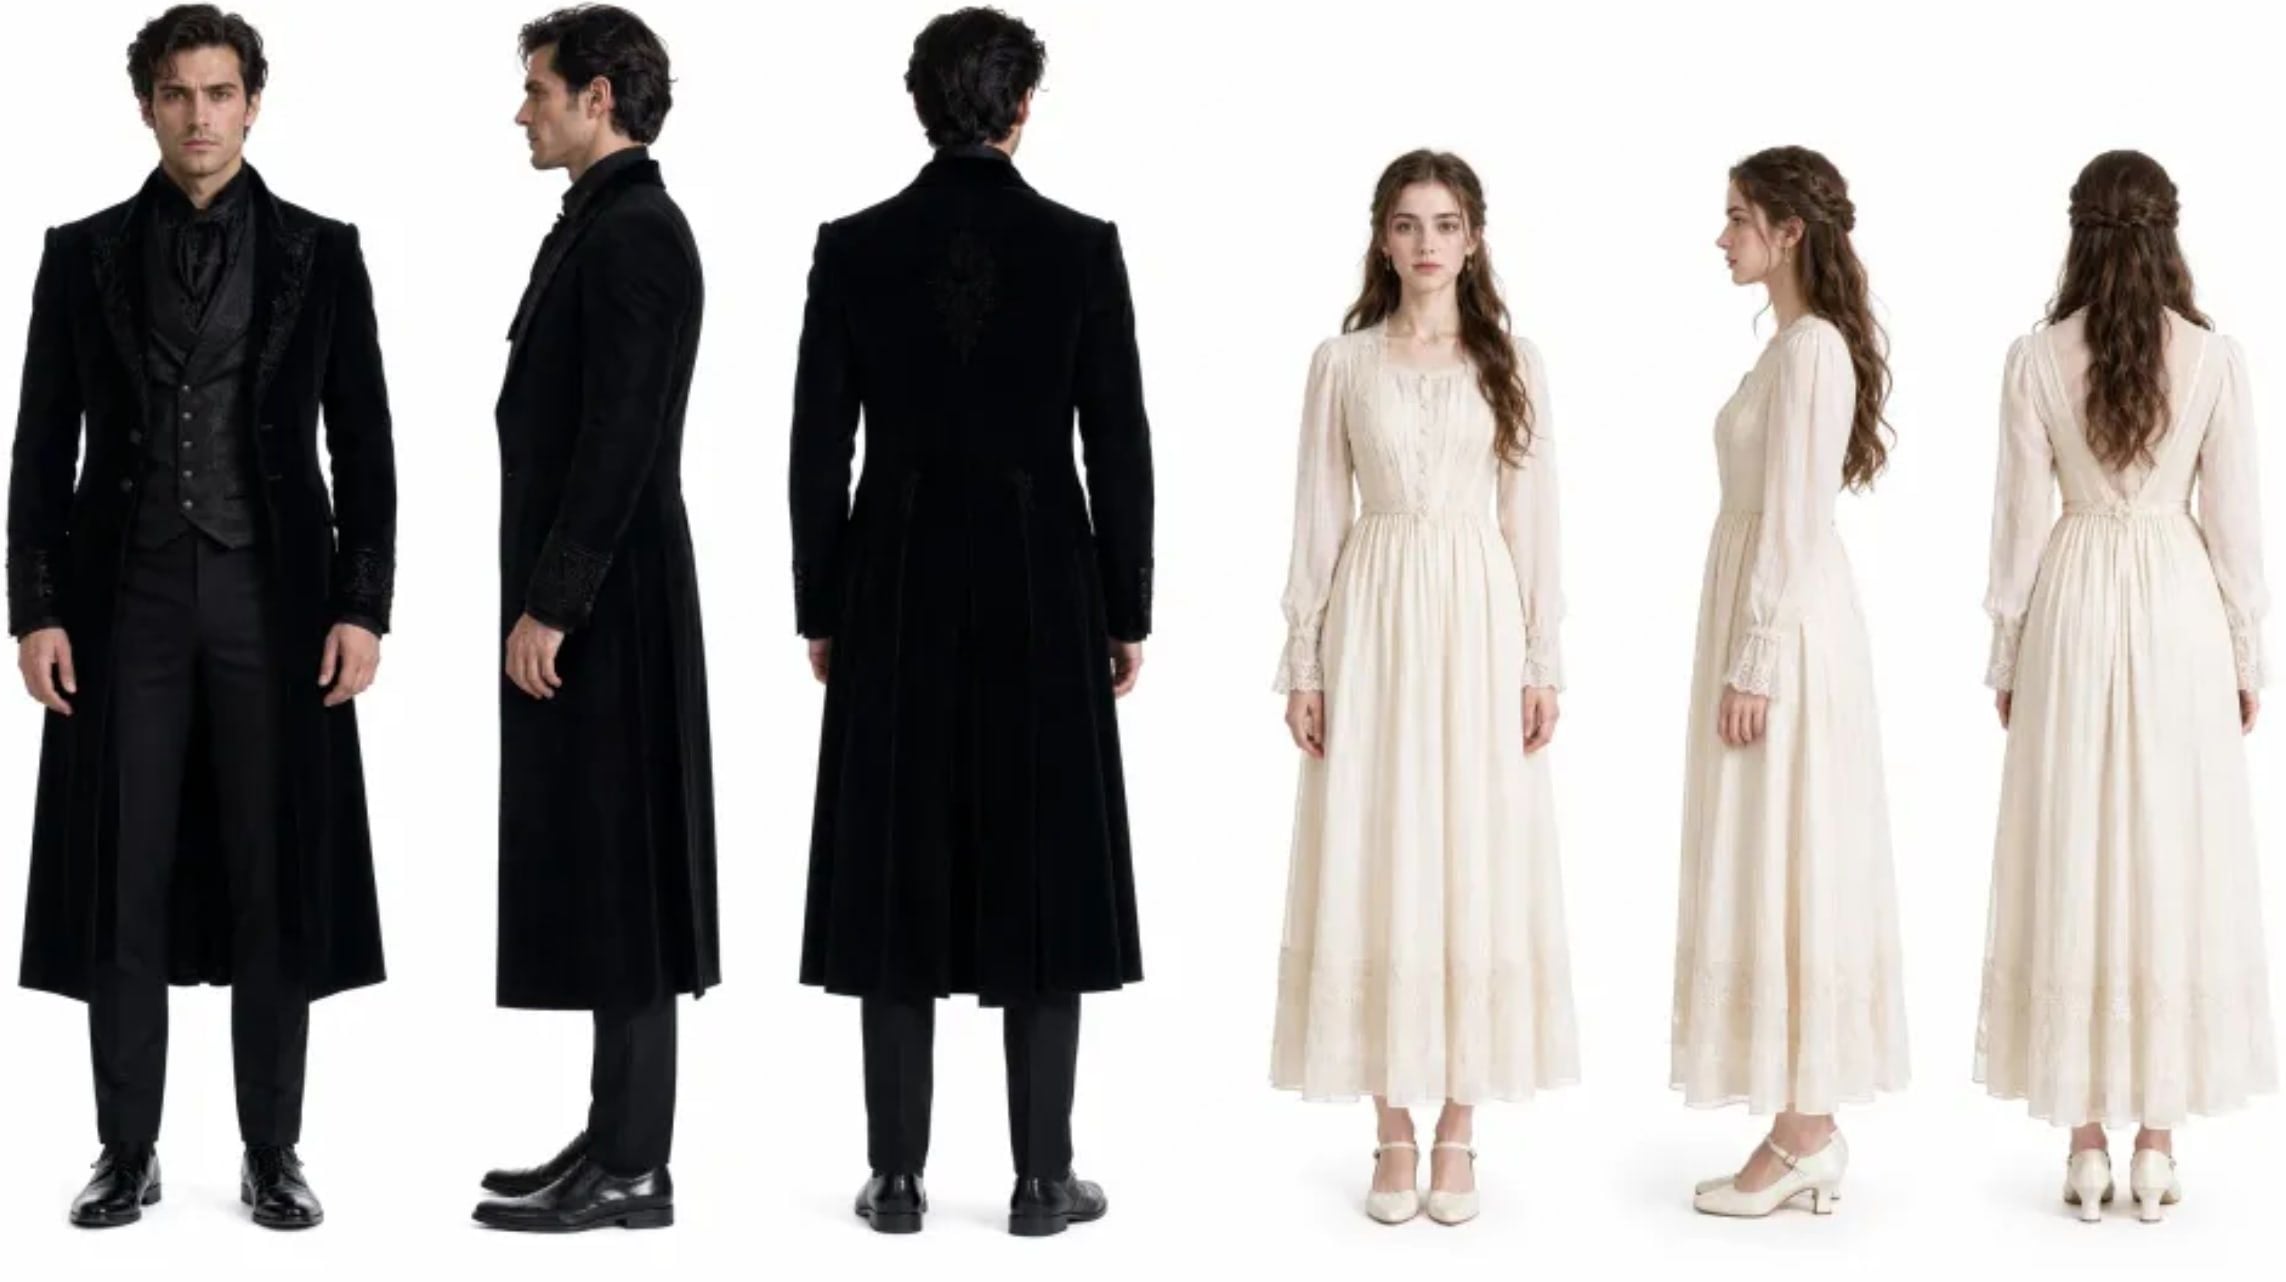 デモクリップを駆動した参照パック:黒いベルベットの男性主人公、クリーム色のビクトリアンレースの女性主人公、それぞれ3ビュー、1ファイル。
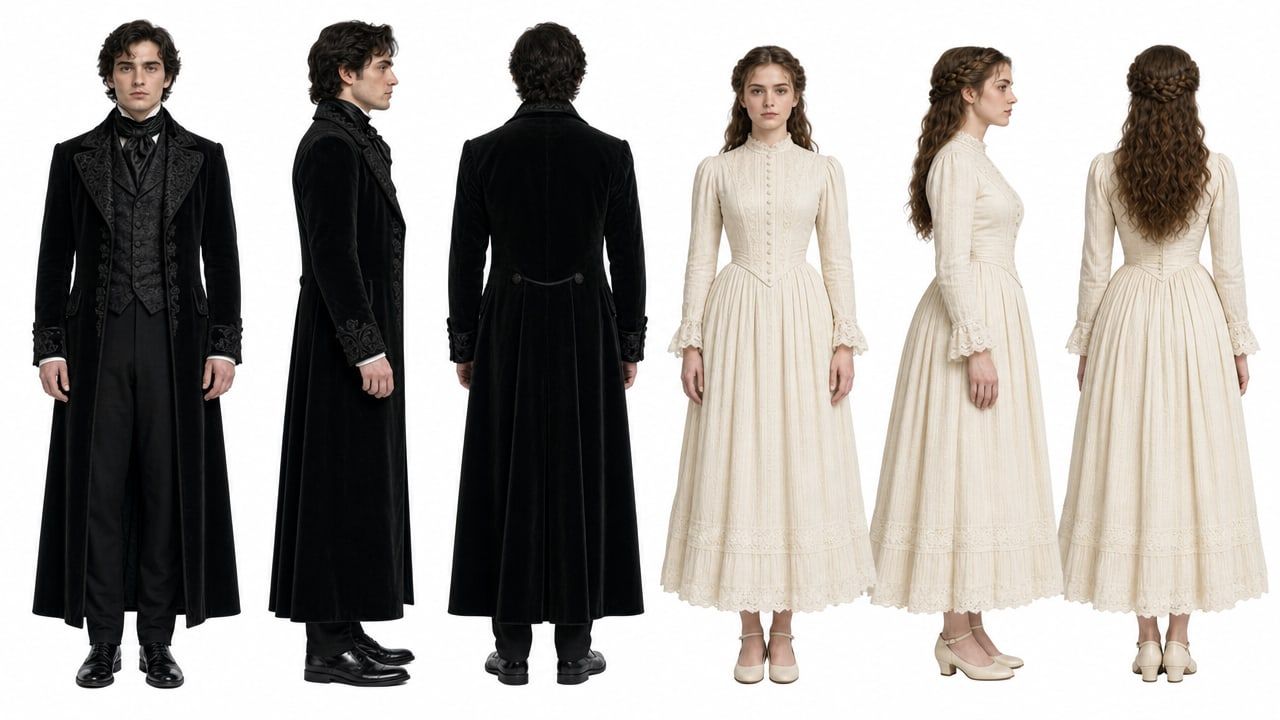 ステップ1のプロンプトを使用した私自身のGPT Image 2実行。上記の参照と比較用。
ステップ2:6パネルシーンボードでロケーションを固定する
顔は保持した。照明は依然としてあなたを裏切る可能性がある。2番目の参照画像は、6つのカメラ位置、月明かりの方向、空気中のフォグの量、床の濡れ具合を確定させる。この映画には正確に1つの照明設定しかないことをモデルに伝えている。
plaintext16パネルのシネマティックロケーションボード、2行3列、パネル間の細い黒いガター、各パネルの下部に小さなエレガントな白いオールキャップス文字間隔のタイプでキャプション。主題:夜の放棄されたゴシック城の内部。冷たい青い月明かり、漂う低いフォグ、濡れた反射性の石の床、高いステンドグラスの窓、小さな暖かい炎の鉄の燭台、深い彩度を落とした黒、厚いベルベットのカーテン。どのパネルにも人物なし。 2 3パネル1、キャプション「ワイドエスタブリッシングビュー - 廊下」:照明のあるステンドグラスの窓に向かって後退する長い柱のある廊下。 4パネル2、キャプション「ローアングル - 床を横切る月明かり」:低いカメラ、濡れた敷石を横切る月明かりの筋。 5パネル3、キャプション「玄関と階段の構図」:曲線的な石の階段を囲むアーチ型の出入り口。 6パネル4、キャプション「クローズ詳細 - 彫刻されたドア」:鉄の取っ手付きの重い彫刻された木のドアのタイトショット。 7パネル5、キャプション「窓際ビュー - フォグとカーテン」:高い窓、フォグが入り込み、前景にカーテンの端。 8パネル6、キャプション「最終ポスターフレーム - 空のホール」:対称的な空のホール、パターンのあるランナーラグが窓へと続く。 9 10フォトグラフィック、シネマティック、フィルムグレイン、6つのパネルすべてで一貫したカラーグレード。
設定: 同じモデル、Quality high、アスペクト比 16:9。
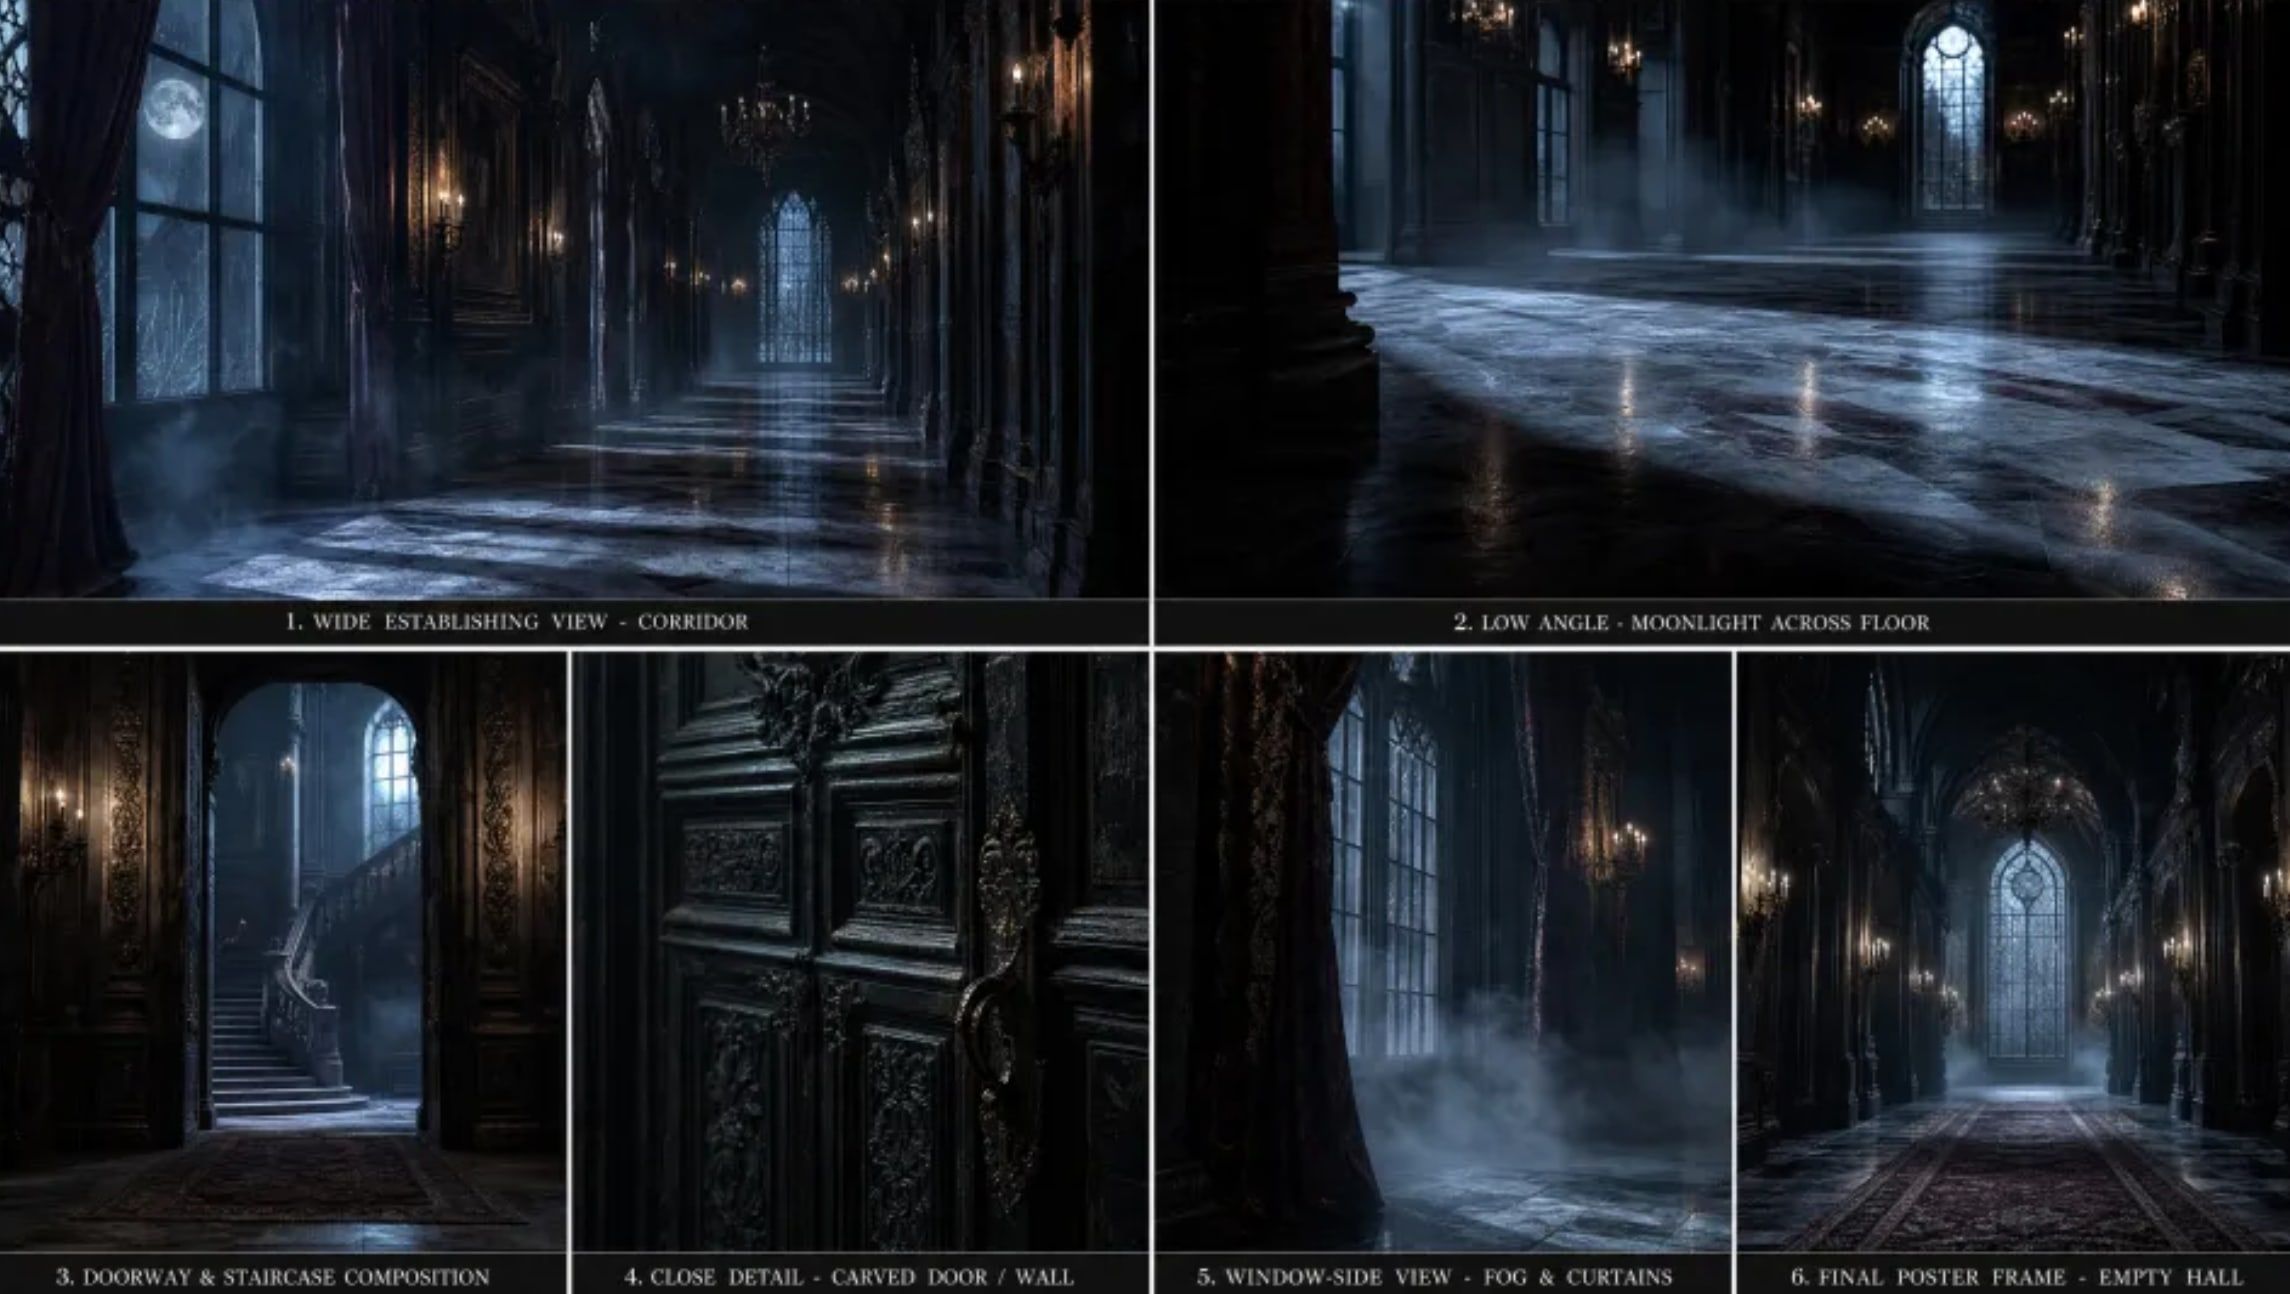 デモクリップを駆動したロケーションボード:6つのゴシック城内部、1つのカラーグレード、キャプションは読み取り可能。
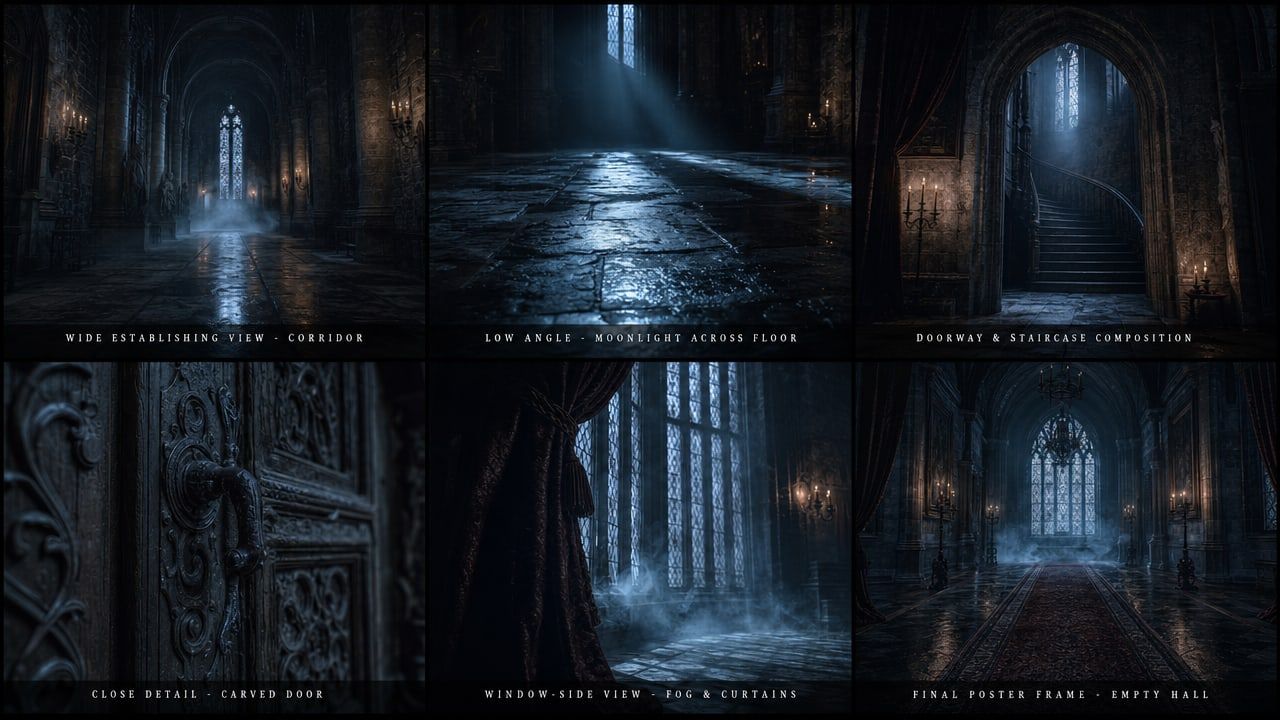 ステップ2のボードプロンプトを使用した私自身のGPT Image 2実行。
ステップ3:MiniMax H3参照からビデオへの変換でショットを生成する
2つの参照画像と、カメラ位置とオーディオ指示を含む1つのプロンプト。サウンドは同じパスで生成されるため、別途のボイスやスコアのステップはない。チューニング中は長さを短く保ち、本番カットでは15秒に伸ばす。
plaintext1参照画像1はキャラクターシート:左の男が男性主人公、右の女が女性主人公。両方のアイデンティティを正確にそのまま保持すること:彼の顎のライン、暗いウェーブのかかった髪、黒いベルベットフロックコート、黒いブロケードウェストコート、黒いシルククラバット;彼女の栗色のハーフアップ編み込みヘアとクリーム色のビクトリアンレースドレス。参照画像2はロケーション&ライティングボード:その冷たい青い月明かり、漂うフォグ、濡れた反射性の石の床、彩度を落とした黒いトーンに合わせること。 2 39:16縦型、プレミアムライブアクションショートドラマルック、浅い被写界深度、シネマティックコントラスト、字幕なし、画面上のテキストなし、透かしなし。 4 5ショット1:ミディアムクローズアップ、カメラがゆっくりと押し込む。女性主人公が月明かりの廊下に立ち、浅く呼吸し、視線はフレーム右外の何かに固定されている。フォグが膝の高さで彼女の横を通り過ぎる。 6ショット2:ハードカット。彼女の背後からのオーバー・ザ・ショルダー、男性主人公が暗いアーチ道から月明かりの中に足を踏み入れる、コートが光を受け、表情は冷たく好奇心に満ちている。 7ショット3:彼の顔のタイトクローズアップ、窓から半分だけ照らされ、次に彼女のマッチングクローズアップ、彼女が視線をそらすことを拒否する。 8 9オーディオ:低く持続したベースドローン、遠くの石のこだま、彼女の不安定な呼吸、彼が光の中に足を踏み入れるときの1つの重い足音、最後のカットでの1つの柔らかいストリングスの盛り上がり。
設定: モデル MiniMax H3 Reference-to-Video、解像度 2K、長さ 8(スライダーデフォルト;本番カットでは15に変更)、アスペクト比 adaptive、両方のファイルを参照素材に。パネルはそれらを9のうち2としてカウントするため、後でワードローブやプロッププレートを追加する余地は十分にある。
比率で何が起こったかは注目に値する。アスペクト比をadaptiveのままにし、プロンプト内に「9:16縦型」と書いただけだった。H3はそれでも縦型で返ってきたため、フォームフィールドではなくテキストからフレーミングを読み取った。
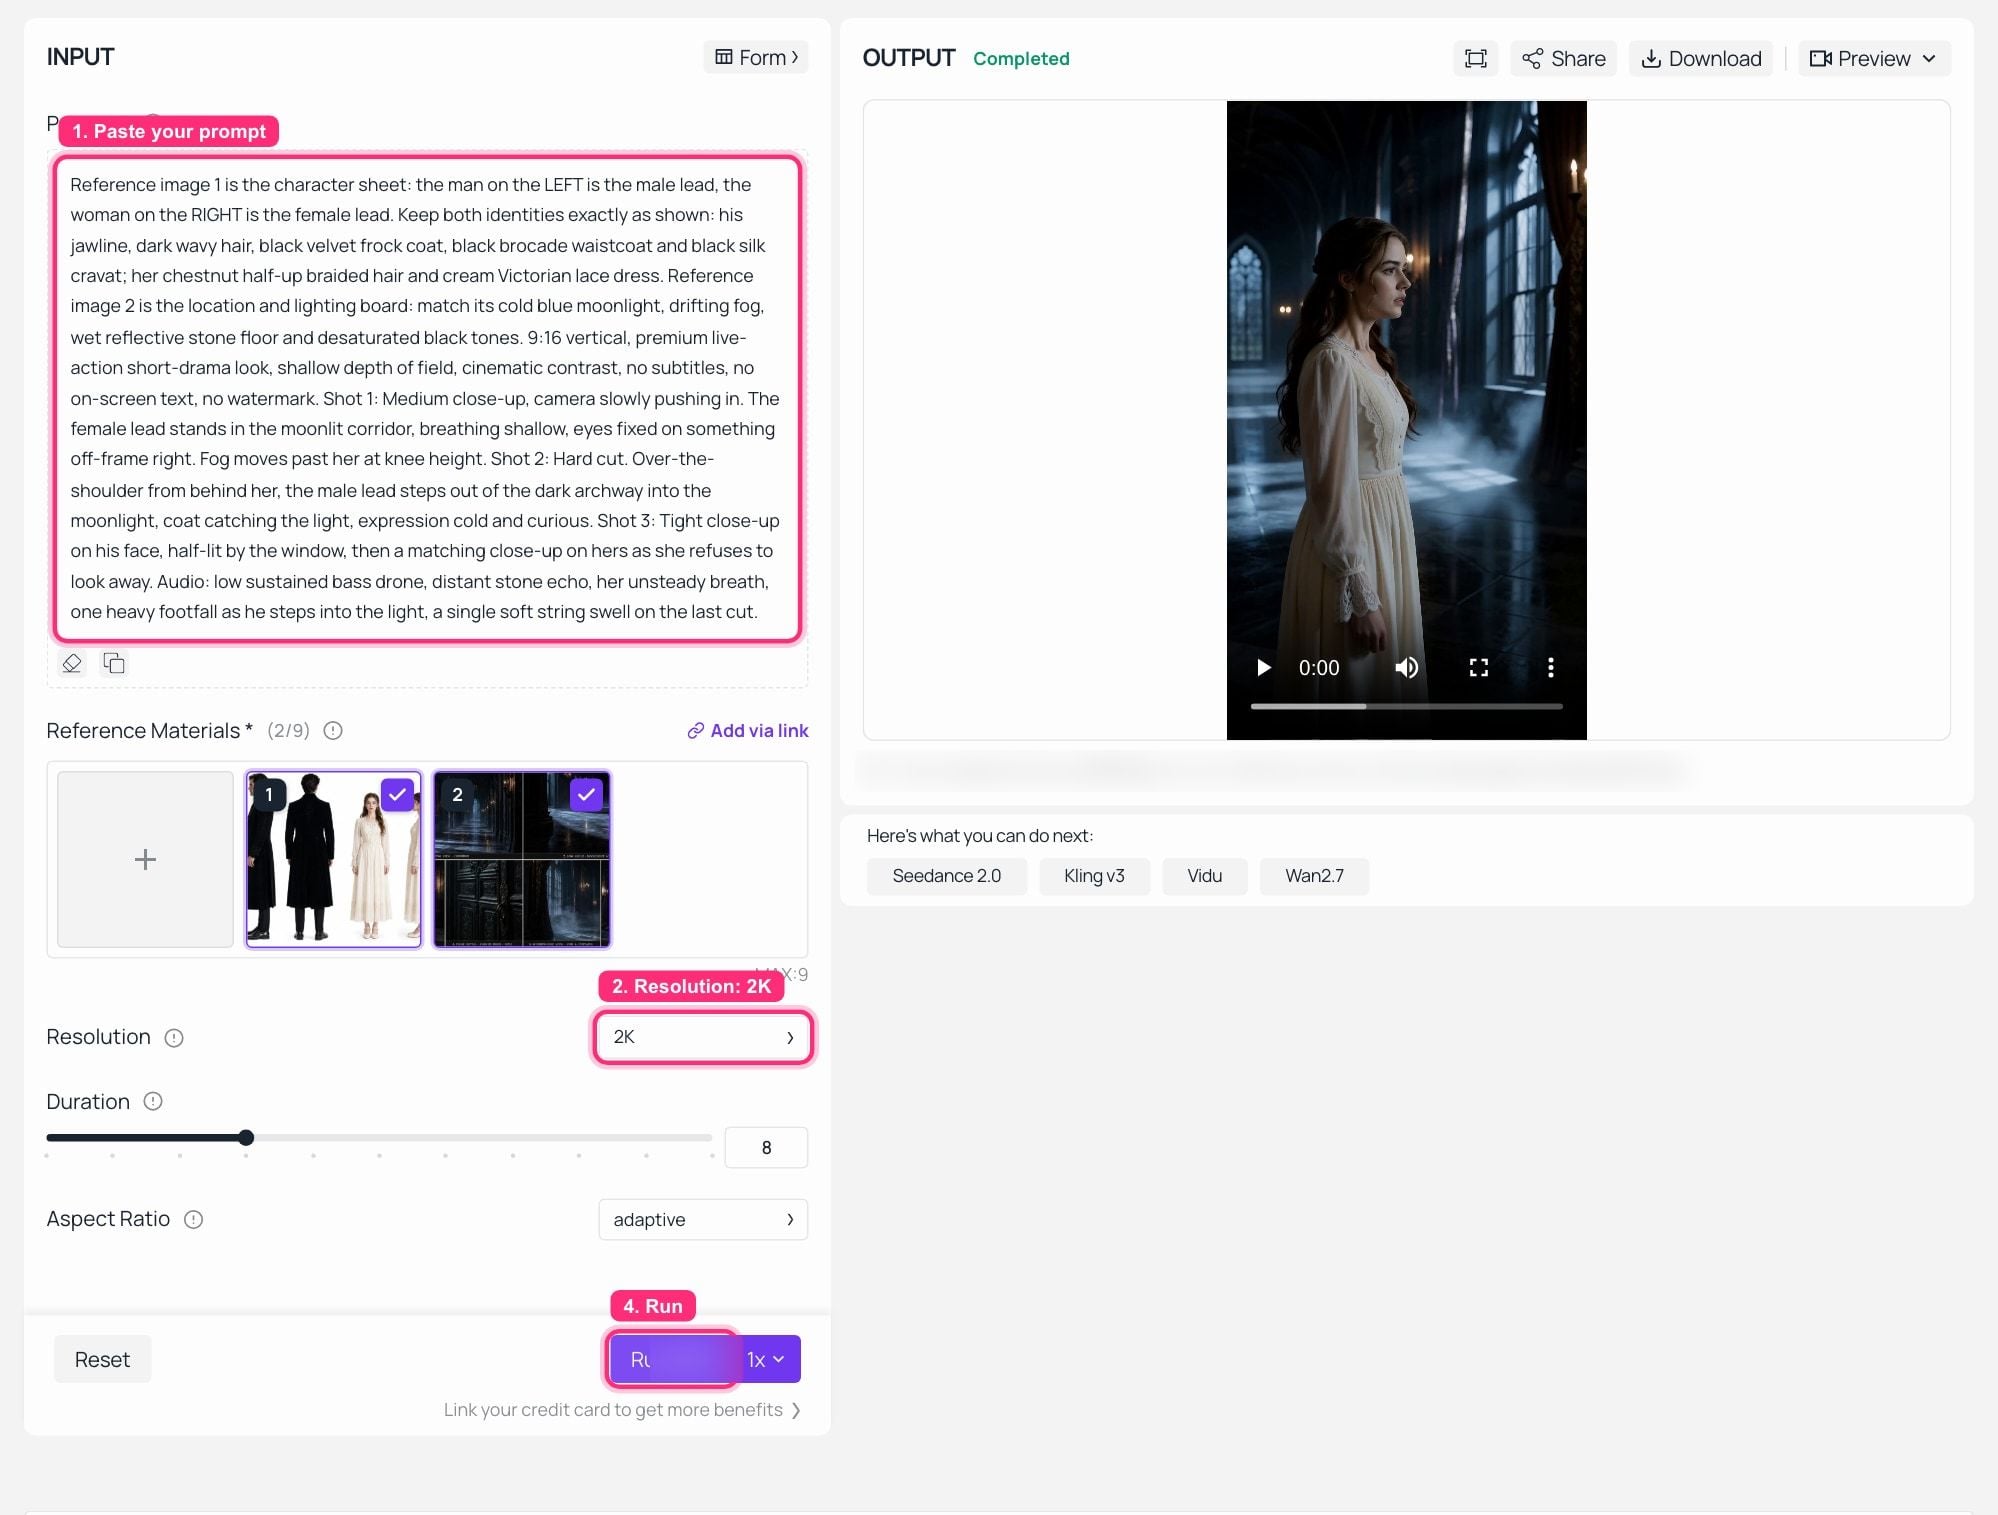 Atlas Cloud上のMiniMax H3 Reference-to-Video、実行完了:両方の参照ファイルが9のうち2としてロードされ、解像度2K、生成された縦型クリップがOUTPUTパネルで再生中。
最初のフレームは、クリームレースのボディスを着た女性主人公が、ボードのパネル1の廊下に立ち、膝の高さにフォグがあり、月明かりがボードが設定した場所に正確に濡れた床を照らしている。両方の参照画像が反映された。
ステップ4:Seedance 2.5 vs MiniMax H3の制御実行を同一パックで行う
一言も変更しない。同じ2枚の参照画像、同じプロンプト、異なるモデル。各ページの独自の長さデフォルトはそのままにして強制的に一致させず、それぞれが何を返したかを以下に記す。「他のモデルに合わせて」プロンプトを言い換えることは、比較が嘘をつき始めるまさにその方法である。
plaintext1ステップ3と同じプロンプト、そのまま。他のモデルに合わせて言い換えないこと。
設定: モデル Seedance 2.0 Reference-to-Video、解像度 720p、同じ2枚の参照画像を参照画像に(再び9のうち2、最大3つの参照動画と3つの参照音声ファイル用の別個のスロットあり)。長さはページデフォルトのままにし、10秒のクリップが返ってきた。
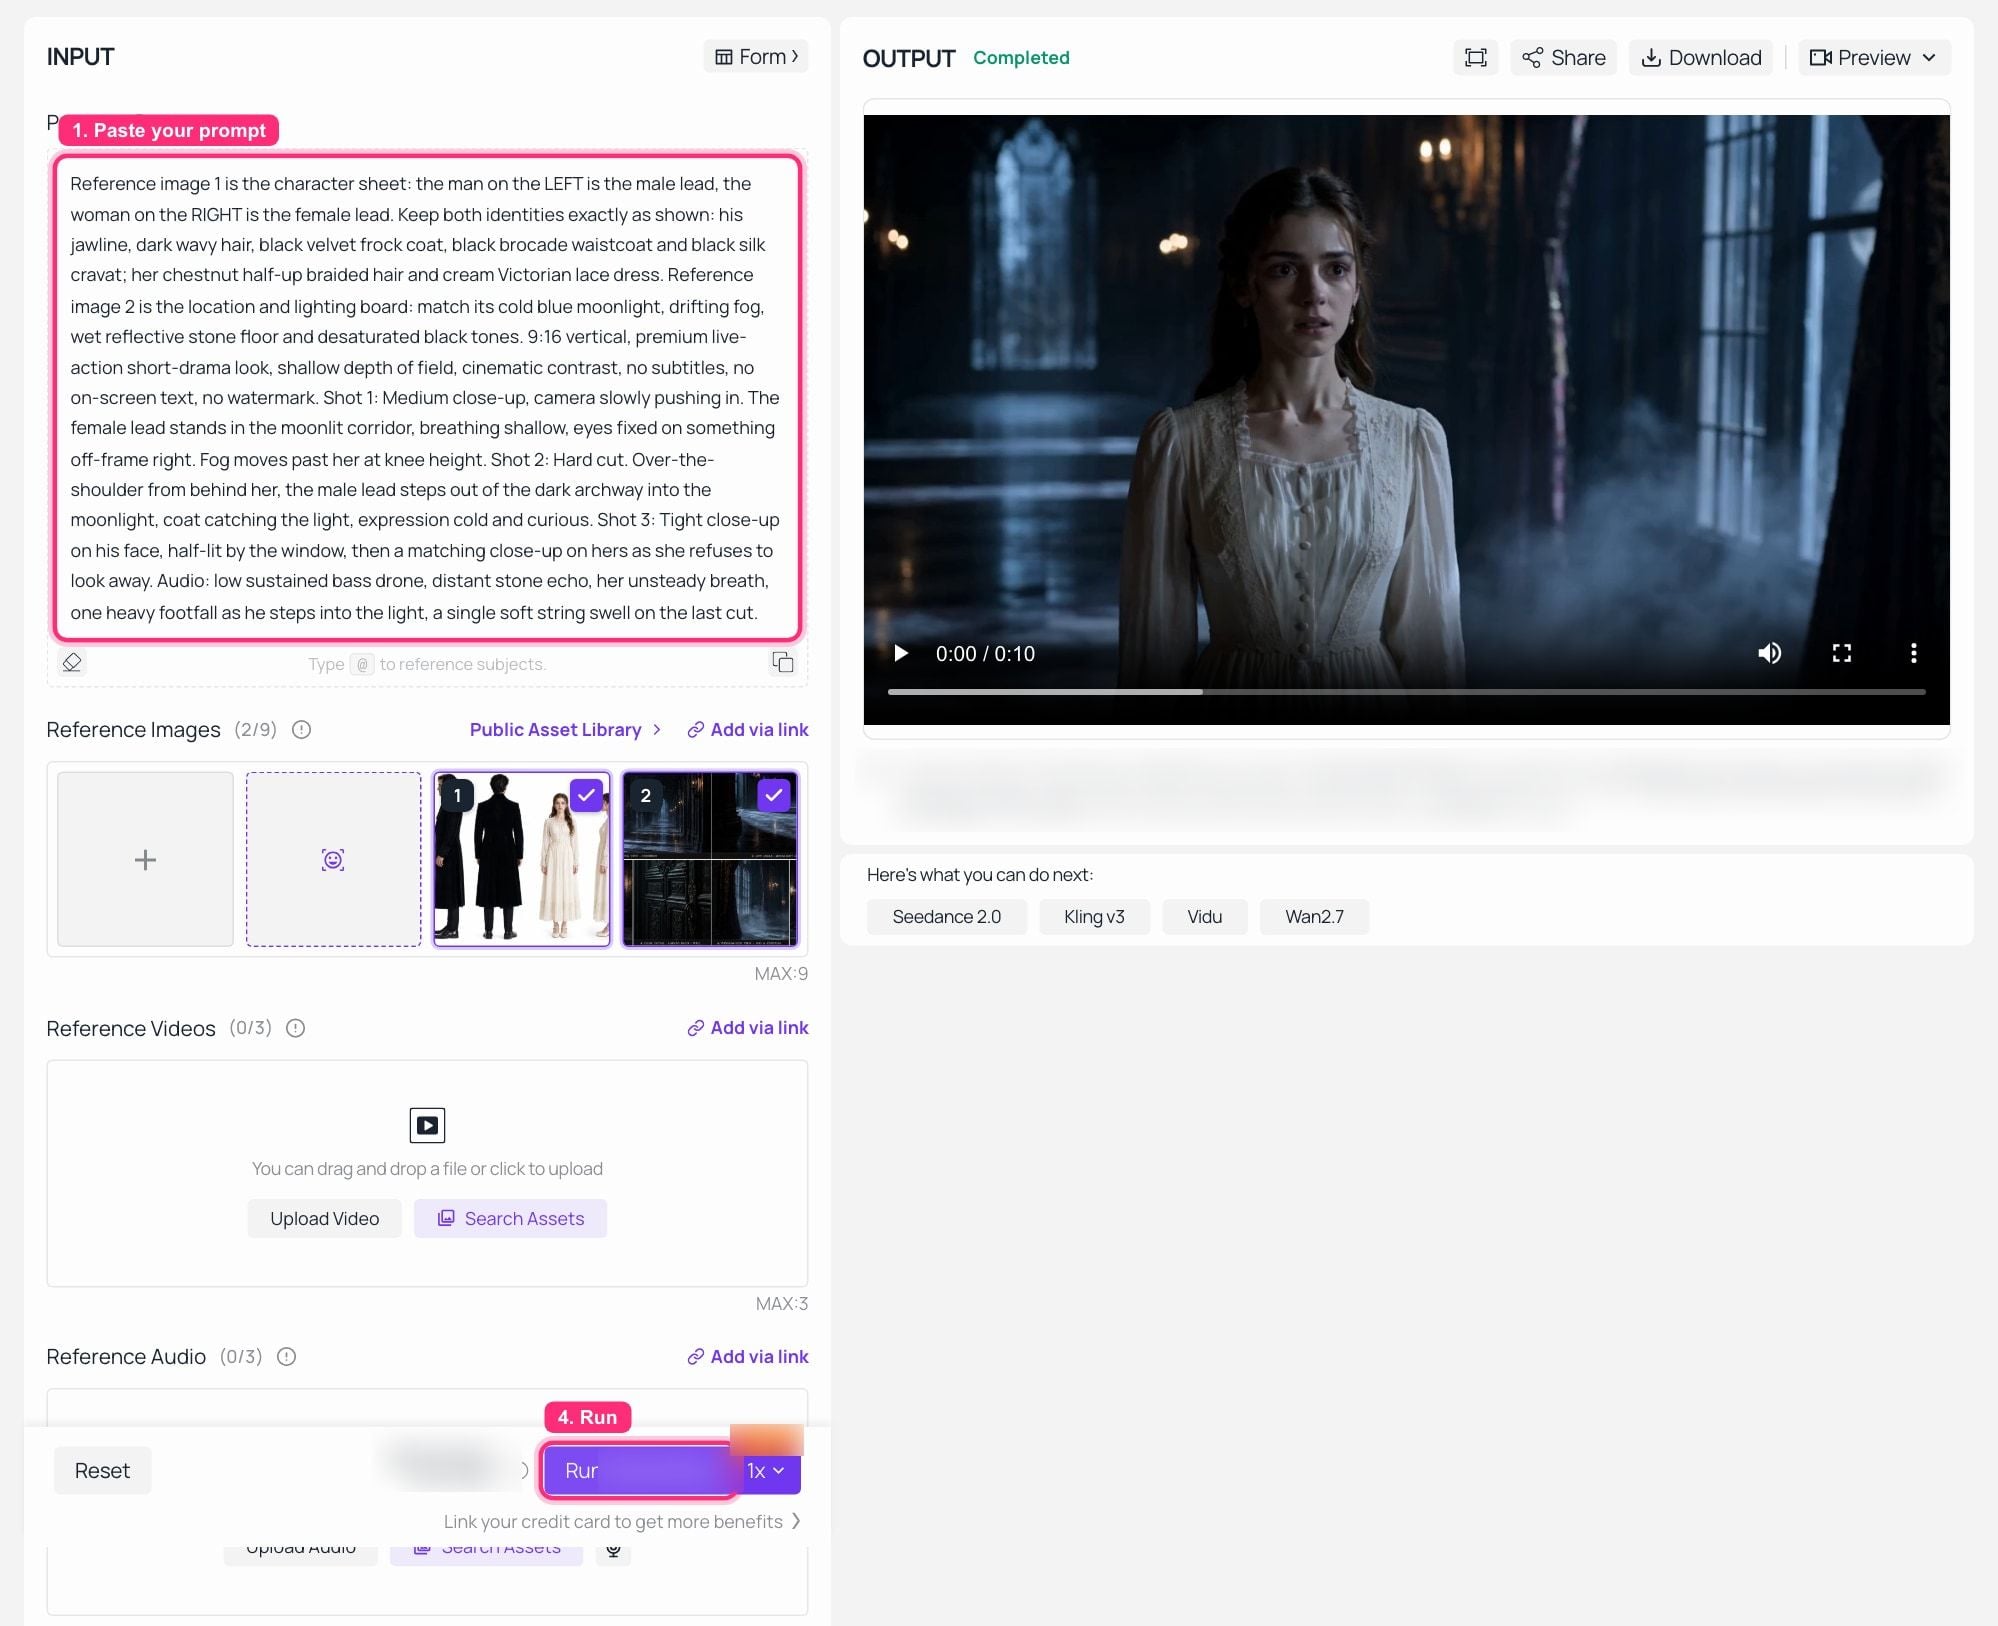 Atlas Cloud上のSeedance 2.0 Reference-to-Video、実行完了。ステップ3と同じ参照パックとプロンプトを使用し、OUTPUTパネルに10秒の結果。
2つのOUTPUTパネルが実際に示したものは以下の通りであり、勝者を選ぶのではなく、ありのままを報告する。
両方の実行でキャラクターは保持された。同じネックラインと袖口の同じクリームレースドレス、同じ栗色の髪、ボードから引き出された同じフォグと月明かりの廊下。どちらも異なる女性を発明しなかった。参照パックが両側でその作業を行った。これが私が最も気にしている発見である。
違いは形式に関するものであり、顔に関するものではなかった。このSeedanceエンドポイントは720pを提供した。H3は同一の入力から2Kを提供した。そしてフレーミングの分割:H3はプロンプトテキストから直接「9:16縦型」を読み取り、縦型を返したが、Seedanceの実行は16:9で返ってきた。なぜなら、そのページには独自のアスペクト比制御があり、プロンプトテキストだけではそれをオーバーライドしなかったからだ。TikTok用にカットしている場合、この違いにより、フォームフィールドを忘れた最初の実行でコストがかかるだろう。Seedance 2.5はおそらくこの解像度の半分を変更し、リージョンレベルの再ロールを追加するだろうが、それを測定したふりはしない。
ステップ5:クリップ全体を再ロールせずに1つのショットを修正する
ショートドラマの真のコストは最初の生成ではない。リビジョン7である。H3は既存のクリップを入力として受け入れ、指示に従って編集し、触れなかった部分を保持する。Seedance 2.5のここでの提案はより細かい:フレームの領域を再描画し、パフォーマンス、照明、カメラをそのままにする。
plaintext1提供されたクリップを使用:2人のキャラクター、その衣装、カメラの動き、カッティングリズムをそのまま正確に維持すること。環境のみを変更し、月明かりの石の廊下を同じ城の舞踏室に置き換える。高いアーチ型の窓、照明付きのシャンデリア、暖かいキャンドルライト。両方のキャラクターのライティングを再調整し、キーライトが窓の代わりにフレーム左のシャンデリアから来るようにする。彼女の唯一の話す台詞を「あなたは決して眠っていなかったのね」に書き換える。彼女のパフォーマンスのタイミングは同じビートに保つ。
設定: MiniMax H3 Reference-to-Video、ステップ3のクリップを参照入力として、長さ5、解像度2K。
Seedance 2.5 vs MiniMax H3テストを超えて:参照パックを押し上げる4つの方法
同じキャラクター、次のエピソード。 ステップ1のシートをアセットとして保存し、プロンプト内のショットリストとストーリーブロックのみを変更する。アイデンティティはファイルから来るのであって、先週の火曜日にどのように表現したかという記憶からではない。
声も固定する。 H3は最大3つの音声参照(2~15秒)を受け取り、それらは画像またはビデオ入力と一緒に提出する必要がある。音声サンプルを与えると、キャラクターはその音色で話すため、エピソード間で声優を再キャストする必要はない。
レンダリングにお金を払う前にカメラをブロックする。 Seedance 2.5の参照からビデオへの変換は、3Dホワイトモデルブロックアウトとグリーンスクリーンプレートを受け入れるため、グレーのジオメトリでフレーミングを固定し、その後で完成したルックにコミットできる。この例はSeedance 2.1(ファミリーの初期メンバー)で実行されたが、ワークフローの形状は同じである。
1つのマスターカットをローカライズし、再撮影しない。 リージョンレベルの置き換えは、顔、製品、話し言葉を交換する一方で、カメラ、タイミング、リップの長さはそのまま維持する。ここでは、1つのマスタービューティーカットがスペイン語、韓国語、ヒンディー語に再キャストされ、再音声化され、部屋、フレーミング、リップの長さはそのまま保持されている。
そして、誰かが常識をやめたときのモーショントランスファーがどのように見えるかについて:スーツを着た3人の男性が、3体のフォトリアルなカピバラに置き換えられ、オリジナルクリップのモーションパスを忠実に追跡し、最終的にピラミッドに積み重なる。
また、誰も投稿しない、これらすべてのプレーンなバージョンもある:静的なポスターが動くポスターになり、レイアウトは生き残る。
 静的なソースポスター。これを参照からビデオへの変換に「フレーム、パレット、レイアウトを維持し、テキストをアニメーション化」という指示で与えると、同じデザインの動くバージョンが得られる。
Seedance 2.5 vs MiniMax H3ショートフィルムの実際のコスト
ここに数字はない。数字は動き、構造は動かないからだ。両方のファミリーは秒単位で課金され、従量課金、シートやサブスクリプションはない。これにより、3つの変数が残る:秒数、解像度ティア、再ロール数。
3番目が全体の請求額である。最初の試行で決まる15秒のクリップは1回の課金である。同じクリップの7回目の試行は7回の課金である。したがって、お金を節約する方法は、より安い秒単位のモデルを選ぶことではなく、何かを生成する前に参照パックを正しく準備することである。ステップ1とステップ2の2回の画像呼び出しは、パイプライン全体で最も安いラインであり、ビデオ呼び出しの回数を決定するラインである。チェーン全体で最も高いリターン・オン・スペンドであり、はるかに差がある。
次に、秒単位の直感を修正する。同じ参照パック、同じランタイム:H3の参照からビデオへの変換は1440pを返し、このSeedanceの参照からビデオへのエンドポイントは720pを返す。秒単位は間違った単位である。ピクセル/フレーム、そしてその後別途アップスケールパスにお金を払う必要があるかどうかが正しい単位である。
オーディオも計算に含めるべきである。両方のモデルは、同じパスでネイティブの同期サウンドを生成する。現在のパイプラインがビデオモデル+TTS+トラックを調整するエディターである場合、節約できるのは2回のAPI呼び出しと1人の午後であり、その節約はどこにも価格表に表示されない。
どの仕事にどちらを選ぶか:
| ジョブ | 選択 | 理由 | 注意点 |
|---|---|---|---|
| 縦型ショートドラマ、9:16、TikTokまたはReelShort | MiniMax H3 | ネイティブステレオ付き1440p縦型、今すぐ呼び出し可能、15秒はフルフック | 15秒でカットするため、ビートに応じて計画する |
| 1つの連続30秒ブランドフィルム | Seedance 2.5 | 1回の生成、ステッチなし、ネイティブ4K | まずプラットフォームでの可用性を確認 |
| 承認済みカット内の1ショットの修正 | Seedance 2.5 | リージョンレベルの再描画で残りをそのまま | H3のクリップ全体編集でも今日はほとんどの場合に対応可能 |
| プロダクトおよびEコマースカットダウン | どちらでも | どちらも画面上のテキストとブランドマークをうまく保持する | 出荷する解像度でテキストを確認する |
| ゲームまたはインターフェースデモ | MiniMax H3 | UIとタイポグラフィの安定性が2Kで強力 | 1回のパスで15秒の上限 |
| 1つのマスターの多言語バージョン | Seedance 2.5 | リージョン置き換え+多言語音声 | ローカライゼーションの品質は依然としてネイティブチェックが必要 |
| 今夜出荷 | MiniMax H3 | 3つのエンドポイントがライブ、さらにSeedance 2.0のすべて | Seedance 2.5のアクセスはプラットフォームにより異なる |
出荷前の注意点。 MiniMaxはH3のウェイトがリリース後数日以内に公開されると述べていたが、オープンウェイトと商用ライセンスは同じものではないため、セルフホストする前に利用規約を読むこと。透かしと商用利用ポリシーも、コンシューマーアプリとAPIアクセスで両側で異なる可能性があり、これを書いている時点で主要な利用規約ページからどちらも確認できなかったため、私の言葉ではなくプロバイダーの利用規約を確認すること。また、モデルライセンスのいずれも、肖像権や商標をカバーしていない。実在の人物、実在のブランド、または他者のIPが参照パックに含まれている場合、それは別個の法的問題であり、モデルの利用規約では答えられない。
上記の表のすべてのモデルは同じキーで実行され、モデルページには現在のレートとコピペ用コードが掲載されており、今週Seedanceラインで実施されているかもしれないプロモーションも含まれている。
よくある質問
Seedance 2.5はキャラクターの一貫性においてMiniMax H3より優れていますか?
理論上は、H3の12ファイルに対して最大50のマルチモーダル参照、さらにリージョンレベルの再ロールを備えているため、優れているはずです。しかし、2026年7月31日現在、私が参照できる公開されたペアテストはなく、Seedance 2.5にはまだアリーナ評価もありません。実際に実行できたテストでは、アイデンティティの安定性を決定した変数はモデルの世代ではなく、参照パックの構造でした。1枚の合成ターンアラウンドシートと1枚のライティングボードで、両方のモデルがキャラクターを保持しました。モデルを比較検討する前に、パックを正しく準備してください。
Seedance 2.5は今すぐ使用できますか、それとも待つ必要がありますか?
そのAPIはByteDanceでライブです。サードパーティのモデルプラットフォームでの可用性は不均一であり、私がテストしたプラットフォームではまだDay-0のお知らせです。今夜出力が必要な場合、呼び出し可能なオプションはMiniMax H3の3つのエンドポイントと、現在出荷中のSeedance 2.0ライン全体です。
MiniMax H3は本当に30秒のビデオを生成しますか?
いいえ。仕様は1回の生成で5~15秒、24fpsです。それより長いものは拡張またはステッチであり、これは異なるものであり、異なるドリフトリスクがあります。30秒の単一生成はSeedance 2.5に属します。2つの主張を混同しないでください。
両方のモデルはオーディオを生成しますか、そしてエピソード間で同じ声を維持できますか?
両方とも同じパスでネイティブの同期オーディオを生成し、H3はすべての結果でステレオを出力します。永続的な声の場合、H3は最大3つの音声参照(2~15秒)を受け入れますが、これらは単独ではなく画像またはビデオ入力と一緒に提出する必要があります。
実際には何枚の参照画像を送信すべきですか?
思っているよりも少なく、より構造化して。1枚の適切に構成された合成画像は、一般的に6枚のバラバラなクロップよりも優れています。なぜなら、別々のファイルはモデルにそれらを平均化して存在しない人物を作り出すよう誘うからです。アイデンティティと照明という2つの明確なジョブを与え、互いに競合するスタイルサンプルを含めないでください。
TikTokやReelShortスタイルの縦型ショートドラマにはどのモデルを使用すべきですか?
今週出荷する場合、9:16、高解像度、サウンドがすでにミックスされているもの:MiniMax H3。30秒の連続シーンを計画しており、クリップ全体ではなく単一の領域を再ロールすることを期待している場合:Seedance 2.5用に構築し、プラットフォームがそれを開放するのを確認してください。


