
GLM API for Autonomous Task Execution
GLM は、Zhipu AI による Z.ai のフラッグシップ LLM シリーズです。GLM API は、エージェント型の GLM-5 から効率的な 357B MoE GLM-4.6 までを幅広くカバーしています。これらのモデルは、自律的なタスク実行、複雑なエージェントオーケストレーション、本番運用レベルのプログラミングに特化しています。Atlas Cloud では、単一の統合 endpoint から GLM ファミリー全体へ Day-0 アクセスでき、従量課金と信頼性の高い本番稼働時間を利用できます。今すぐ構築を始めましょう。
GLM は Z.ai が開発したモデルです。Atlas Cloud(運営:Atlas Cloud AI LLC)は本モデルへのアクセスを提供するものであり、その所有者ではありません。すべての商標は各所有者に帰属します。
主要モデルを探索
Atlas Cloudは、業界をリードする最新のクリエイティブモデルを提供します。
GLM APIモデル比較:GLM-4.6からGLM-5.2まで
各エンドポイントをワークロードと予算に合わせて選択できます。
| モダリティ | 説明 |
|---|---|
| GLM-5.2 | エージェント指向モデルとして専用設計されたGLM-5.2は、自然言語プロンプトとツール呼び出しのコンテキストを、構造化された推論、関数呼び出し、自律的なタスク実行へ変換します。モデル自身が計画し、実行し、反復する必要がある複雑な問題向けにチューニングされています。自律エージェントや長期的なツール利用ワークフローを構築する場合に適しており、料金は100万入力トークンあたり$1.4、100万出力トークンあたり$4.4です。 |
| GLM-5.1 | GLM-5.1にコーディングタスクや多段階の問題を与えると、安定したステップ実行とともに高品質なプログラミング出力を返します。Z.AIの最新フラッグシップとして、より自然な対話と洗練されたフロントエンド表現も実現します。複雑なWebアプリやエージェントパイプラインを構築するチームに適しており、料金は100万トークンあたり入力$1.4、出力$4.4です。 |
| GLM-5v Turbo | GLM-5v Turboは、フラッグシップの強化されたプログラミング性能と安定した多段階実行を維持しながら、テキストプロンプトを高速な補完に変換します。このturboバリアントは、会話の自然さを損なうことなく、インタラクティブで高スループットなプロダクト向けに低レイテンシを優先します。応答性が最重要の場合に選ぶべきモデルで、料金は100万入力トークンあたり$1.2、100万出力トークンあたり$4です。 |
| GLM-5 Turbo | GLM-5 Turboでは、テキストを入力すると高速に補完が返されます。これは、強化されたプログラミング能力と信頼性の高い多段階推論を備えた、レイテンシ最適化済みのフラッグシップです。自然な応答とクリーンなフロントエンド生成を保ちながら、リアルタイム用途のスループットを高めます。チャットインターフェースや高速なエージェントループに適しており、料金は100万入力トークンあたり$1.2、100万出力トークンあたり$4です。 |
| GLM-5 | GLM-5は、Z.AIの中核となるフラッグシップリリースとして、テキスト指示からコード、推論チェーン、会話応答を生成します。主なアップグレードは、複雑なエージェントタスクにおけるより強力なプログラミング能力と、より安定した多段階実行にあります。フルスタック開発と日常的な推論にバランスよく使える選択肢で、料金は100万トークンあたり入力$1、出力$3.2です。 |
| GLM-4.7 | GLM-4.7にコーディングやエージェントのオーケストレーションを指示すると、信頼性の高い多段階実行と自然な対話で応答します。このフラッグシップ級モデルは、強化されたプログラミング能力と洗練されたフロントエンド出力を、より利用しやすい価格で両立します。コストを重視する本番ワークロードに適しており、料金は100万入力トークンあたり$0.6、100万出力トークンあたり$2.2です。 |
| GLM-4.6 | Zhipu AIの357Bパラメータを持つ効率的なMixture-of-ExpertsモデルであるGLM-4.6は、テキストプロンプトを高品質な補完に変換し、高いスループットを発揮します。MoE設計により、各リクエストに必要なエキスパートのみを有効化し、分析やコンテンツ作成タスク全般で効率的な推論を維持します。データ分析、スライド作成、Webコンテンツ向けに導入でき、料金は100万トークンあたり入力$0.6、出力$2.2です。 |
GLM APIを支える技術
スパースMixture-of-Expertsコアと200K-tokenコンテキストから、ネイティブなツール呼び出し、切り替え可能な思考モードまで、GLM APIはZ.aiのフラッグシップである推論・コーディングスタックを、単一のOpenAI互換エンドポイントで提供します。
大規模なスパースMixture-of-Experts
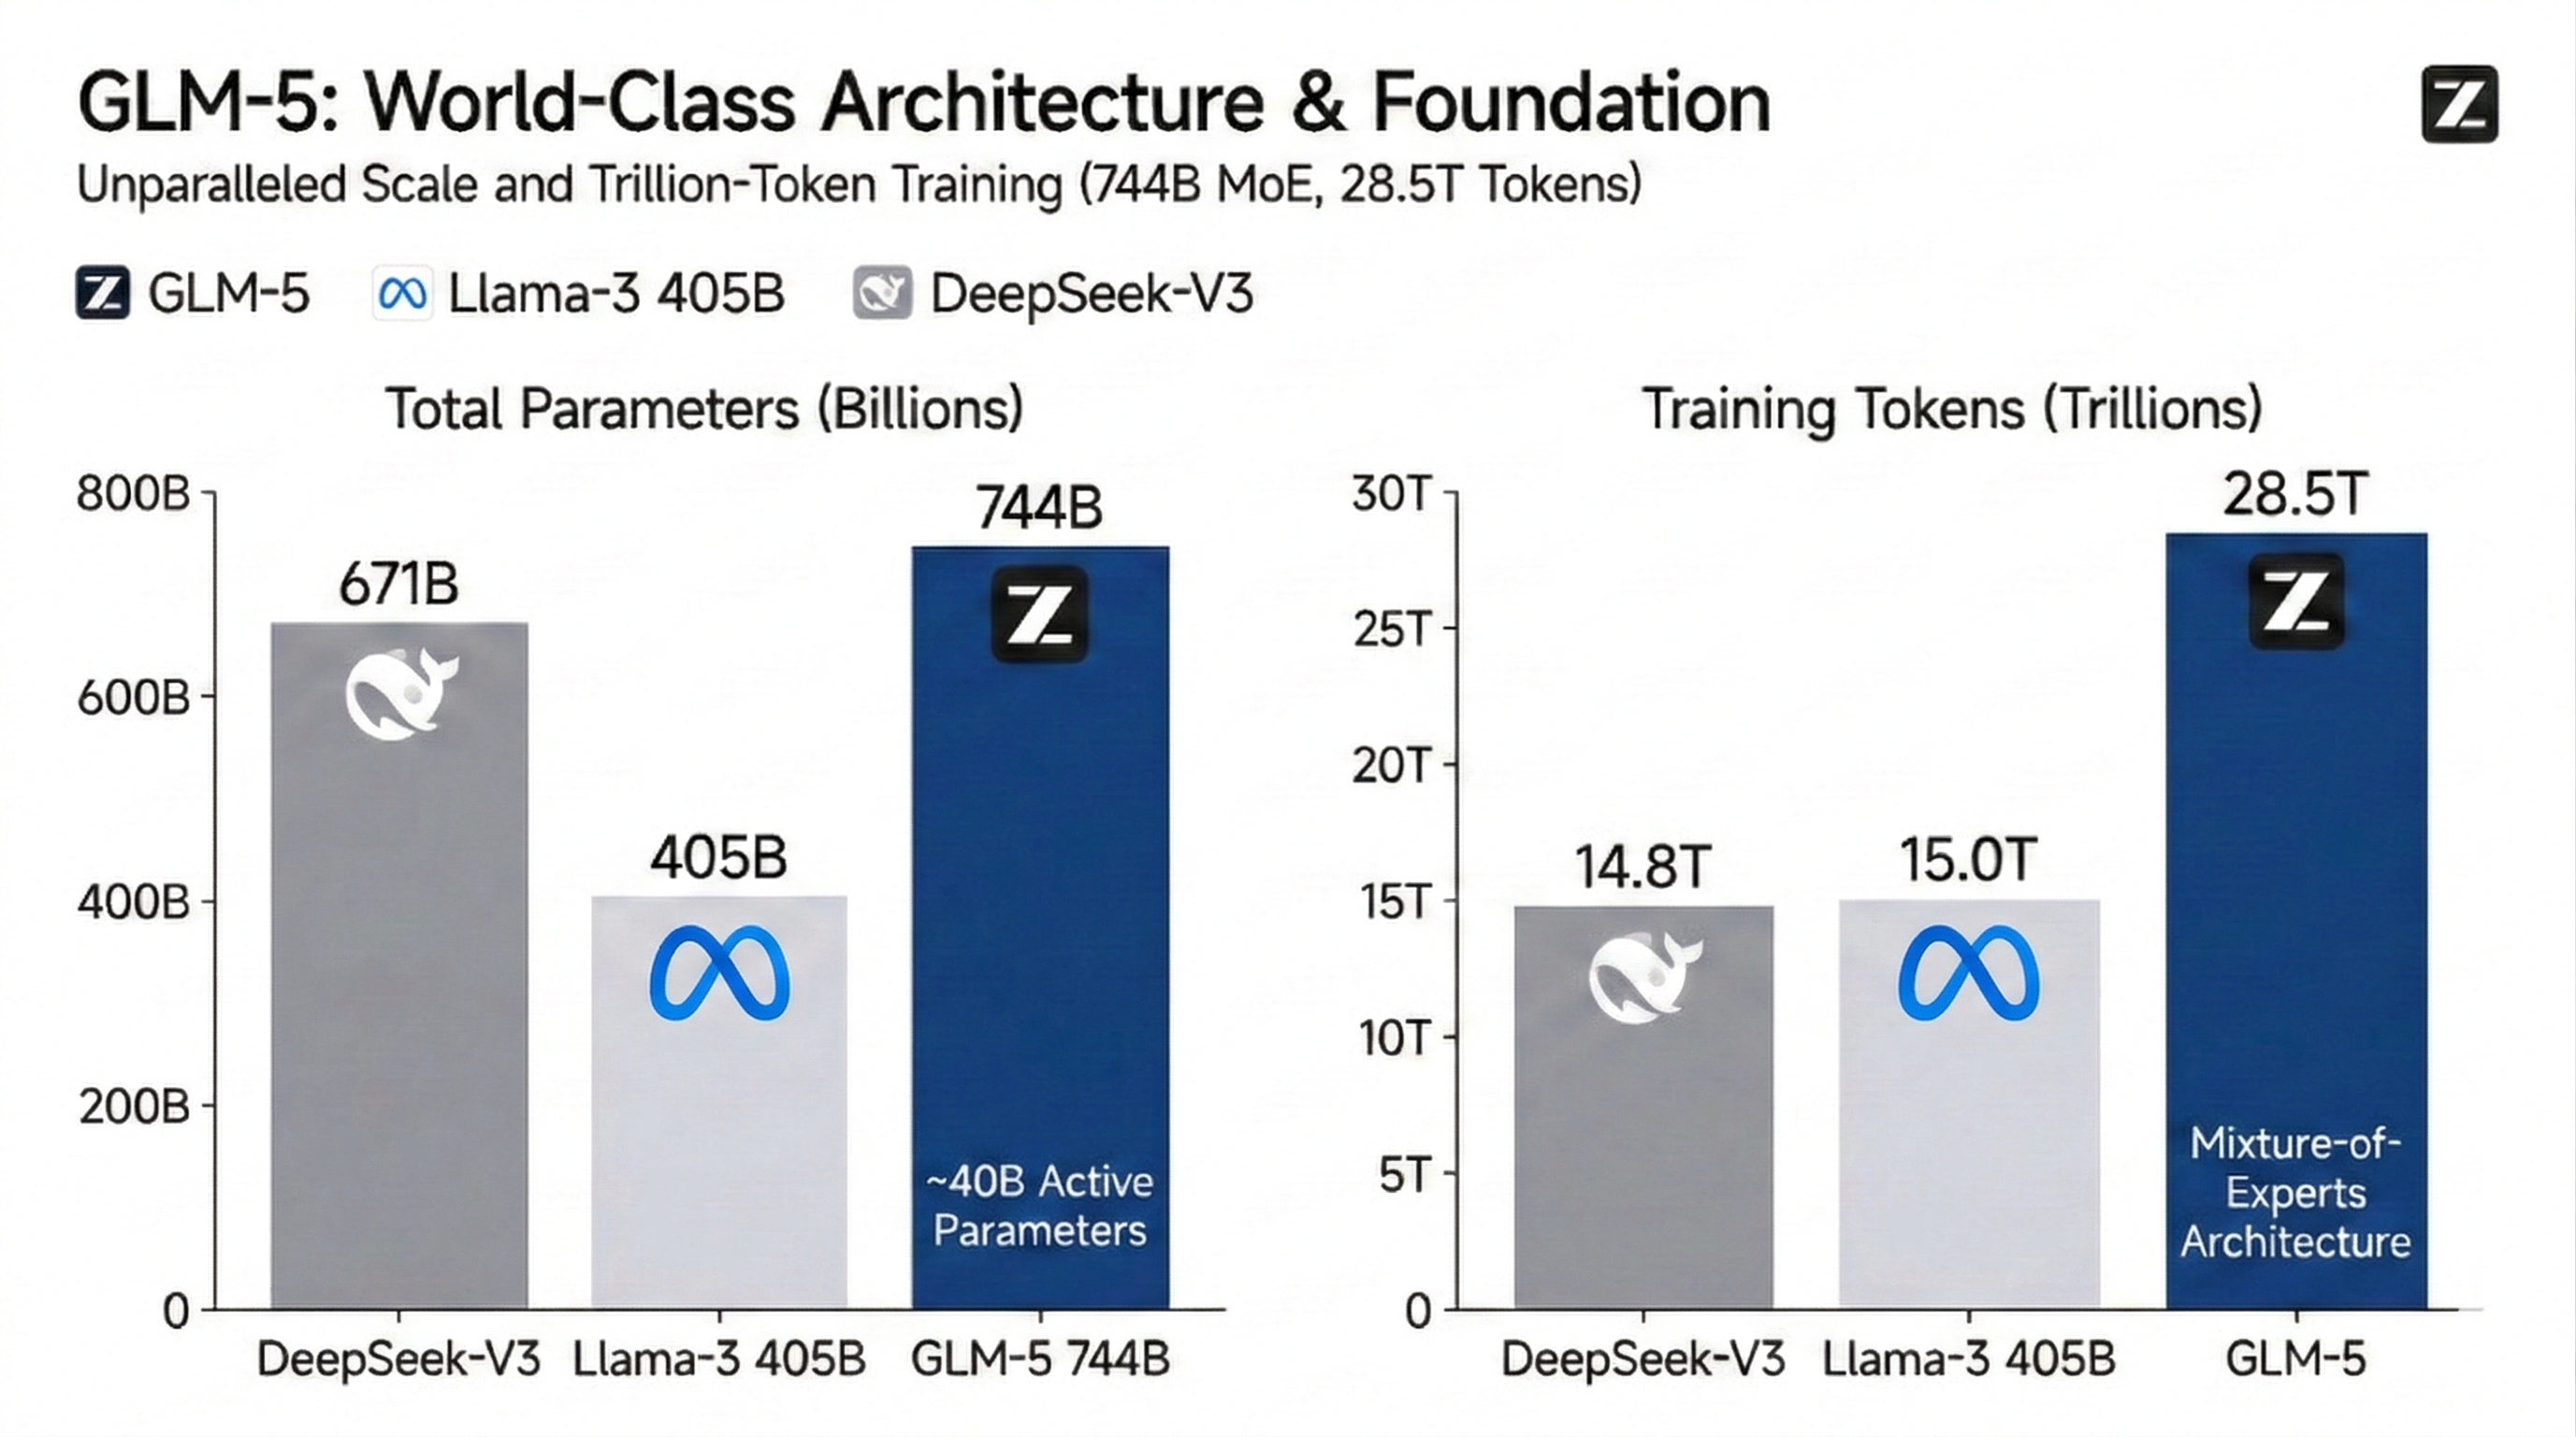
スパースMixture-of-Expertsコアは、はるかに大きなエキスパート群を活用しながら、クエリごとに約40 billion個のパラメータだけを有効化します。その結果、毎回の呼び出しで密なモデル並みのコストをかけることなく、深い知識と正確な想起を実現します。
GLM APIに組み込まれたエージェント実行
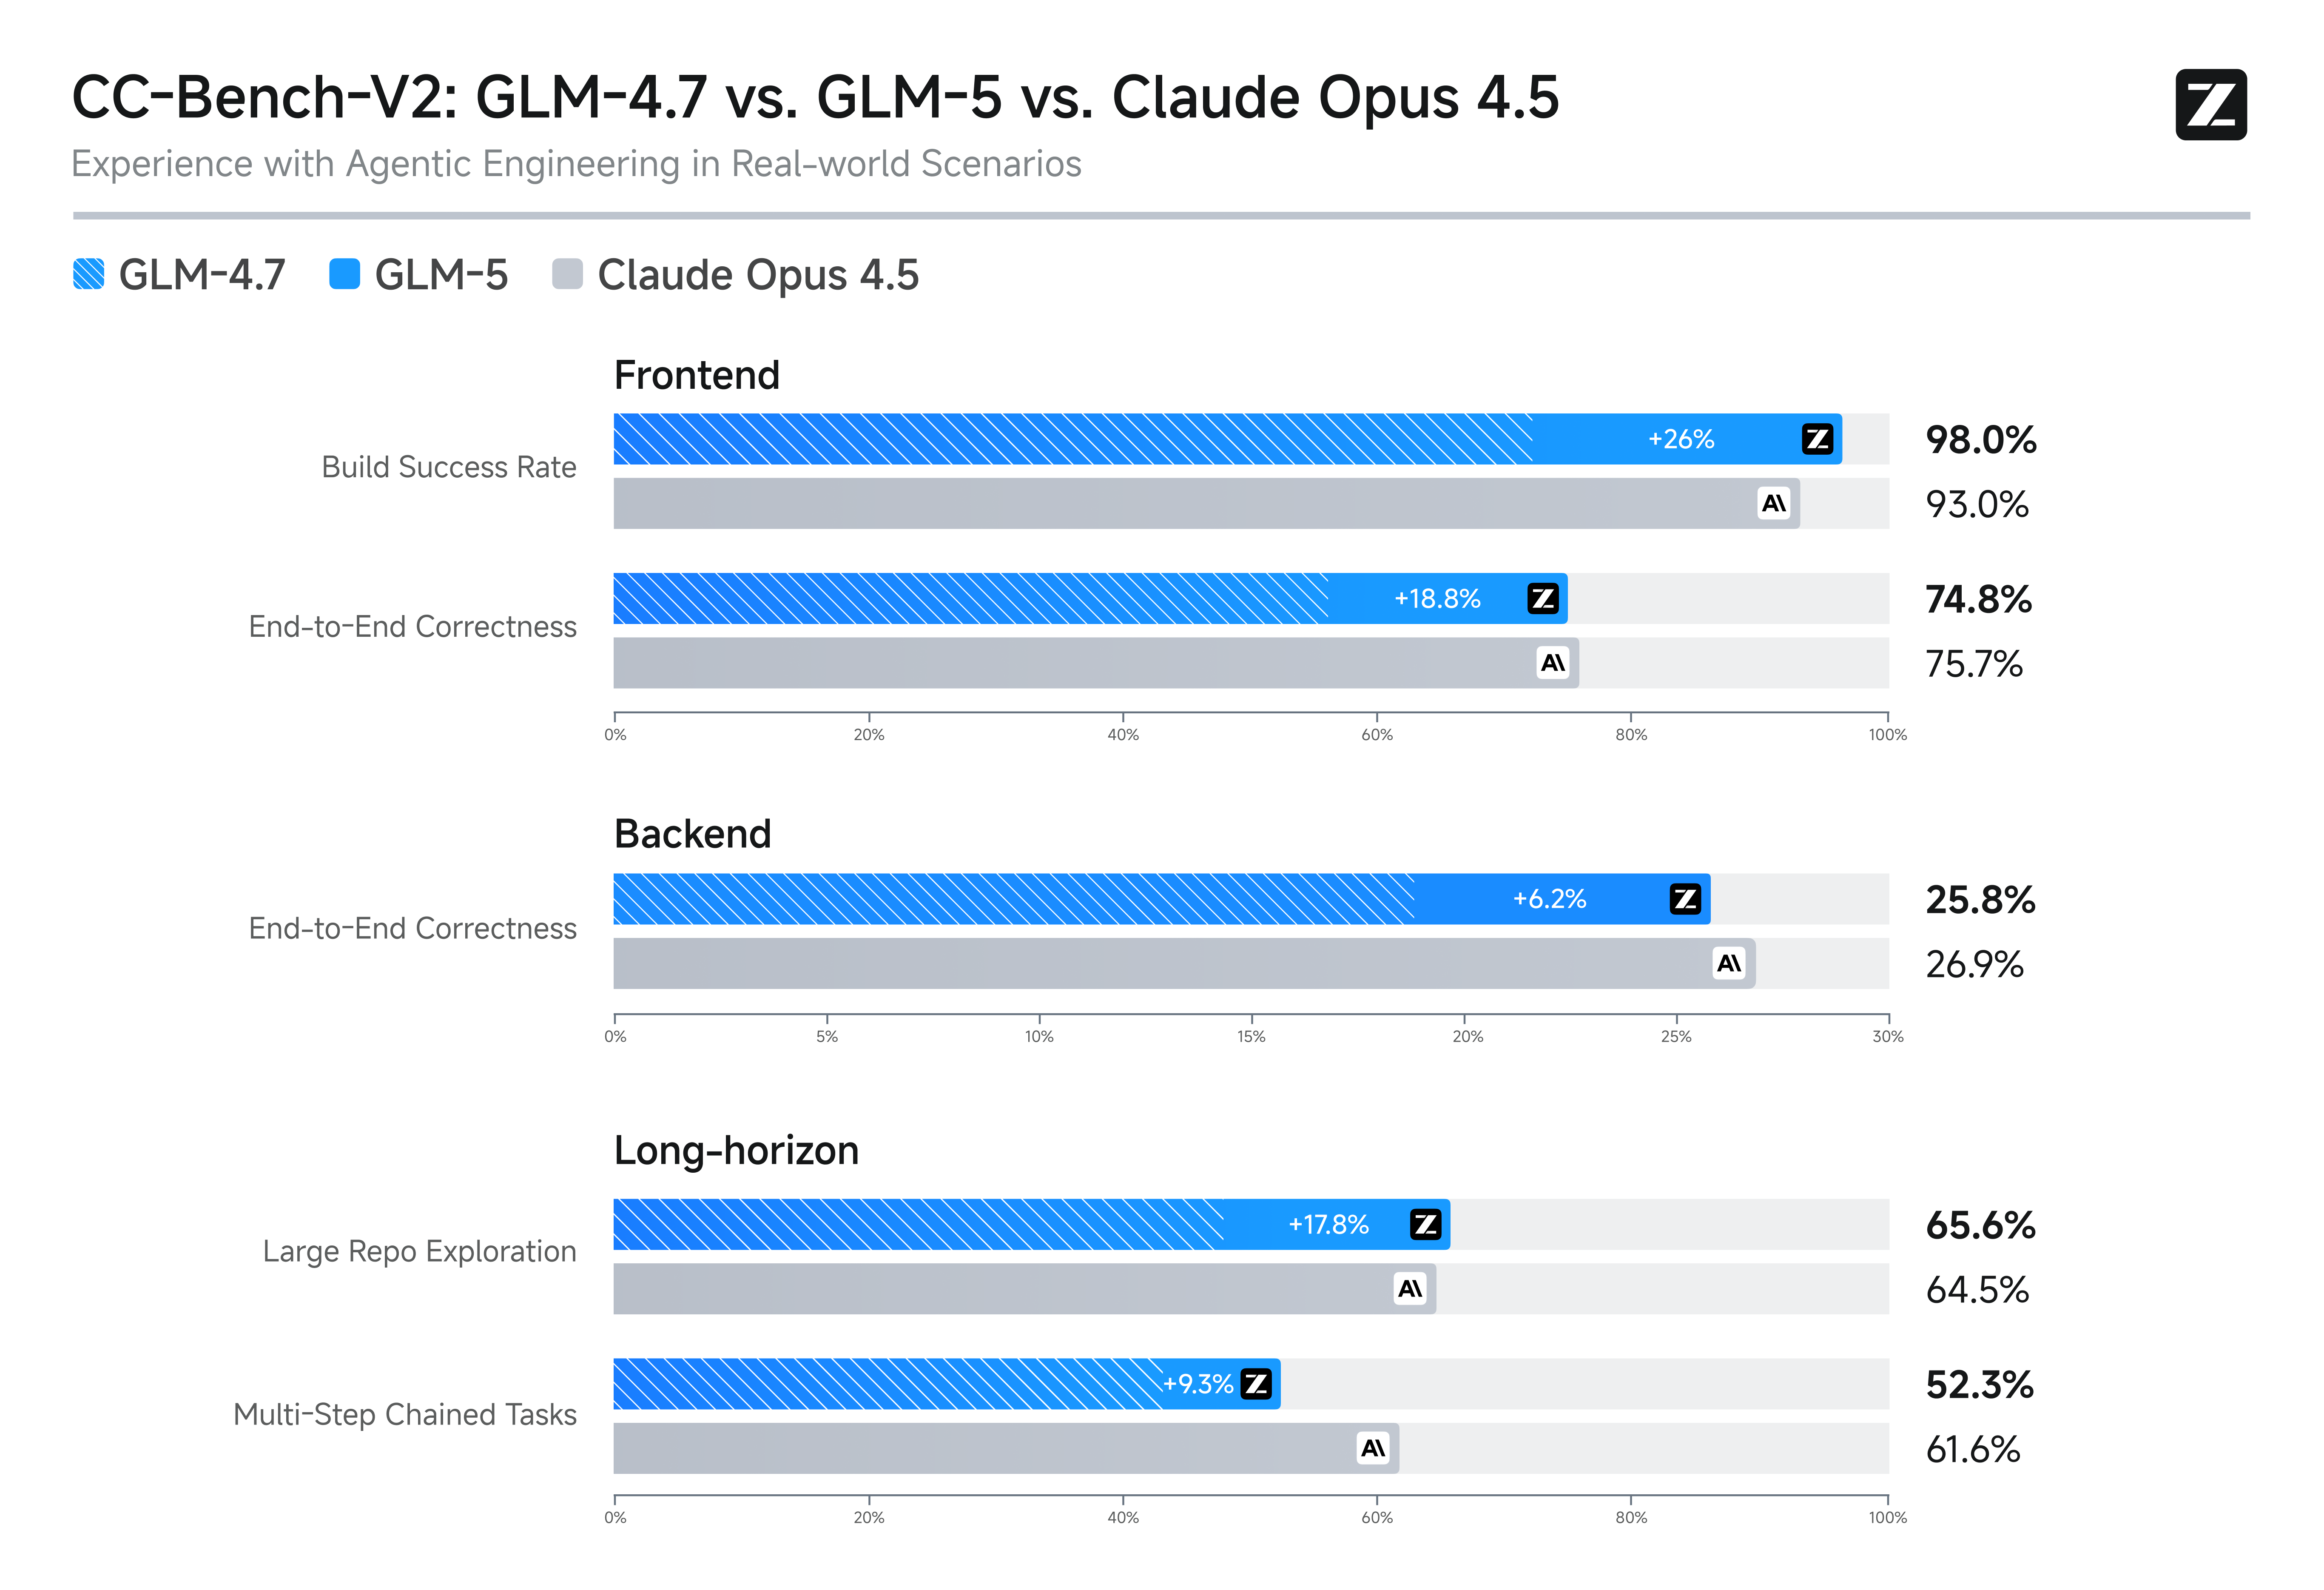
計画ロジックがGLM APIに組み込まれているため、エージェントは長期的で多段階のタスクを、方向性を見失うことなく実行できます。この安定性は、自動化されたソフトウェア開発、研究パイプライン、多数のステップにわたって一貫性を保つワークフローに適しています。
強化学習でチューニングされたコーディングと推論
強化学習によるポストトレーニングにより、以前のGLMリリースを大きく上回るレベルで、モデルのコード生成とアルゴリズム推論が磨かれています。開発者は、より信頼性の高いフルスタック出力と、小さなロジックエラーが積み重なりやすい場面でのより強力な構造的問題解決を得られます。
スパースAttentionによる200Kコンテキストウィンドウ
各モデルは200K tokens以上のコンテキストを扱え、最大128K output tokensに対応します。さらにスパースAttentionにより、そのスケールを低コストに保ちます。リポジトリ全体、長大な契約書、研究ブリーフを一度に視野に入れられます。
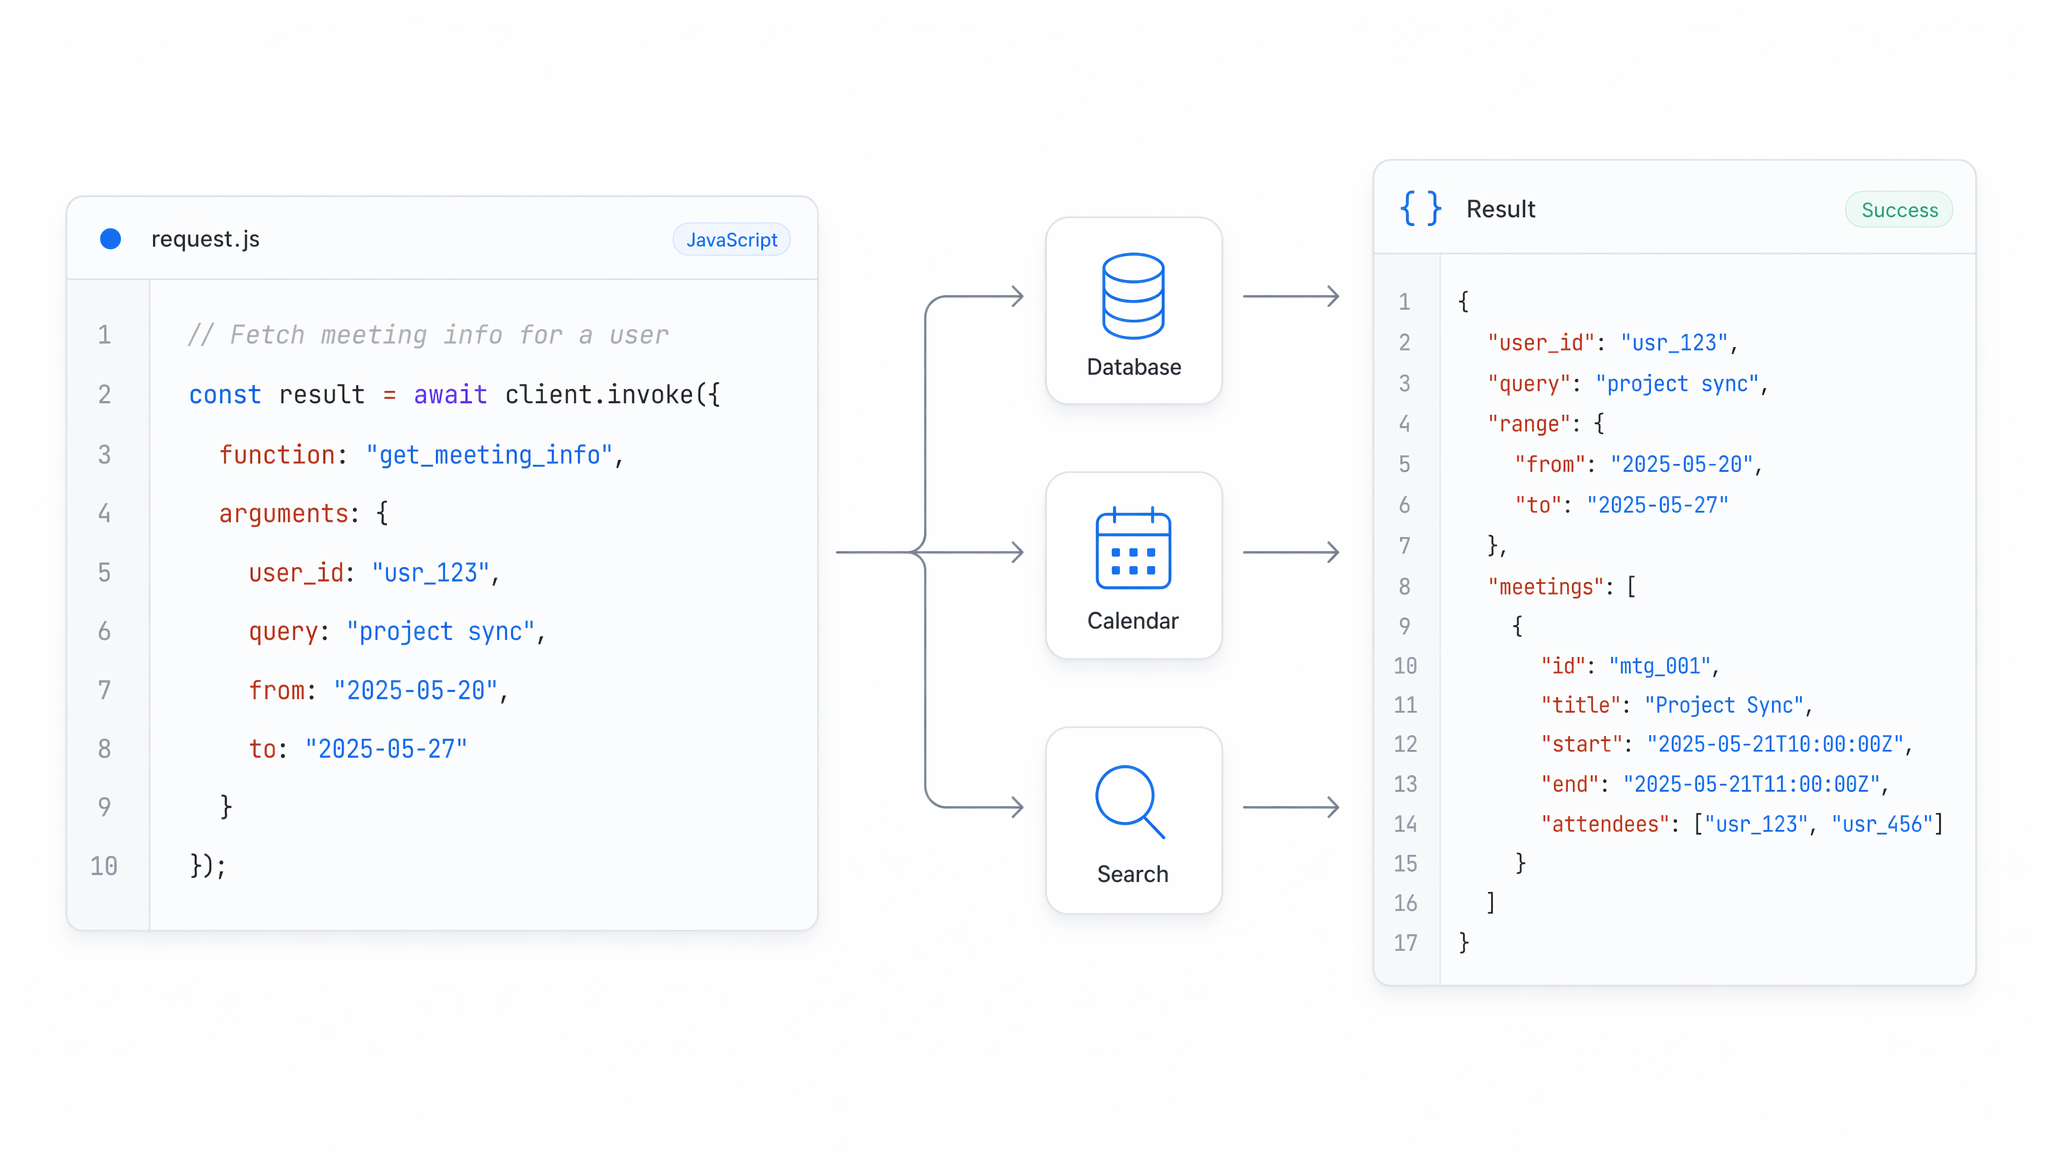
GLM APIによるネイティブなツール呼び出し
ネイティブな関数呼び出しと構造化JSON出力を通じて、外部ツールやサービスをGLM APIに接続できます。モデルはツールを呼び出すタイミングを判断し、引数をあなたのスキーマに合わせて整形し、機械可読な結果を返します。
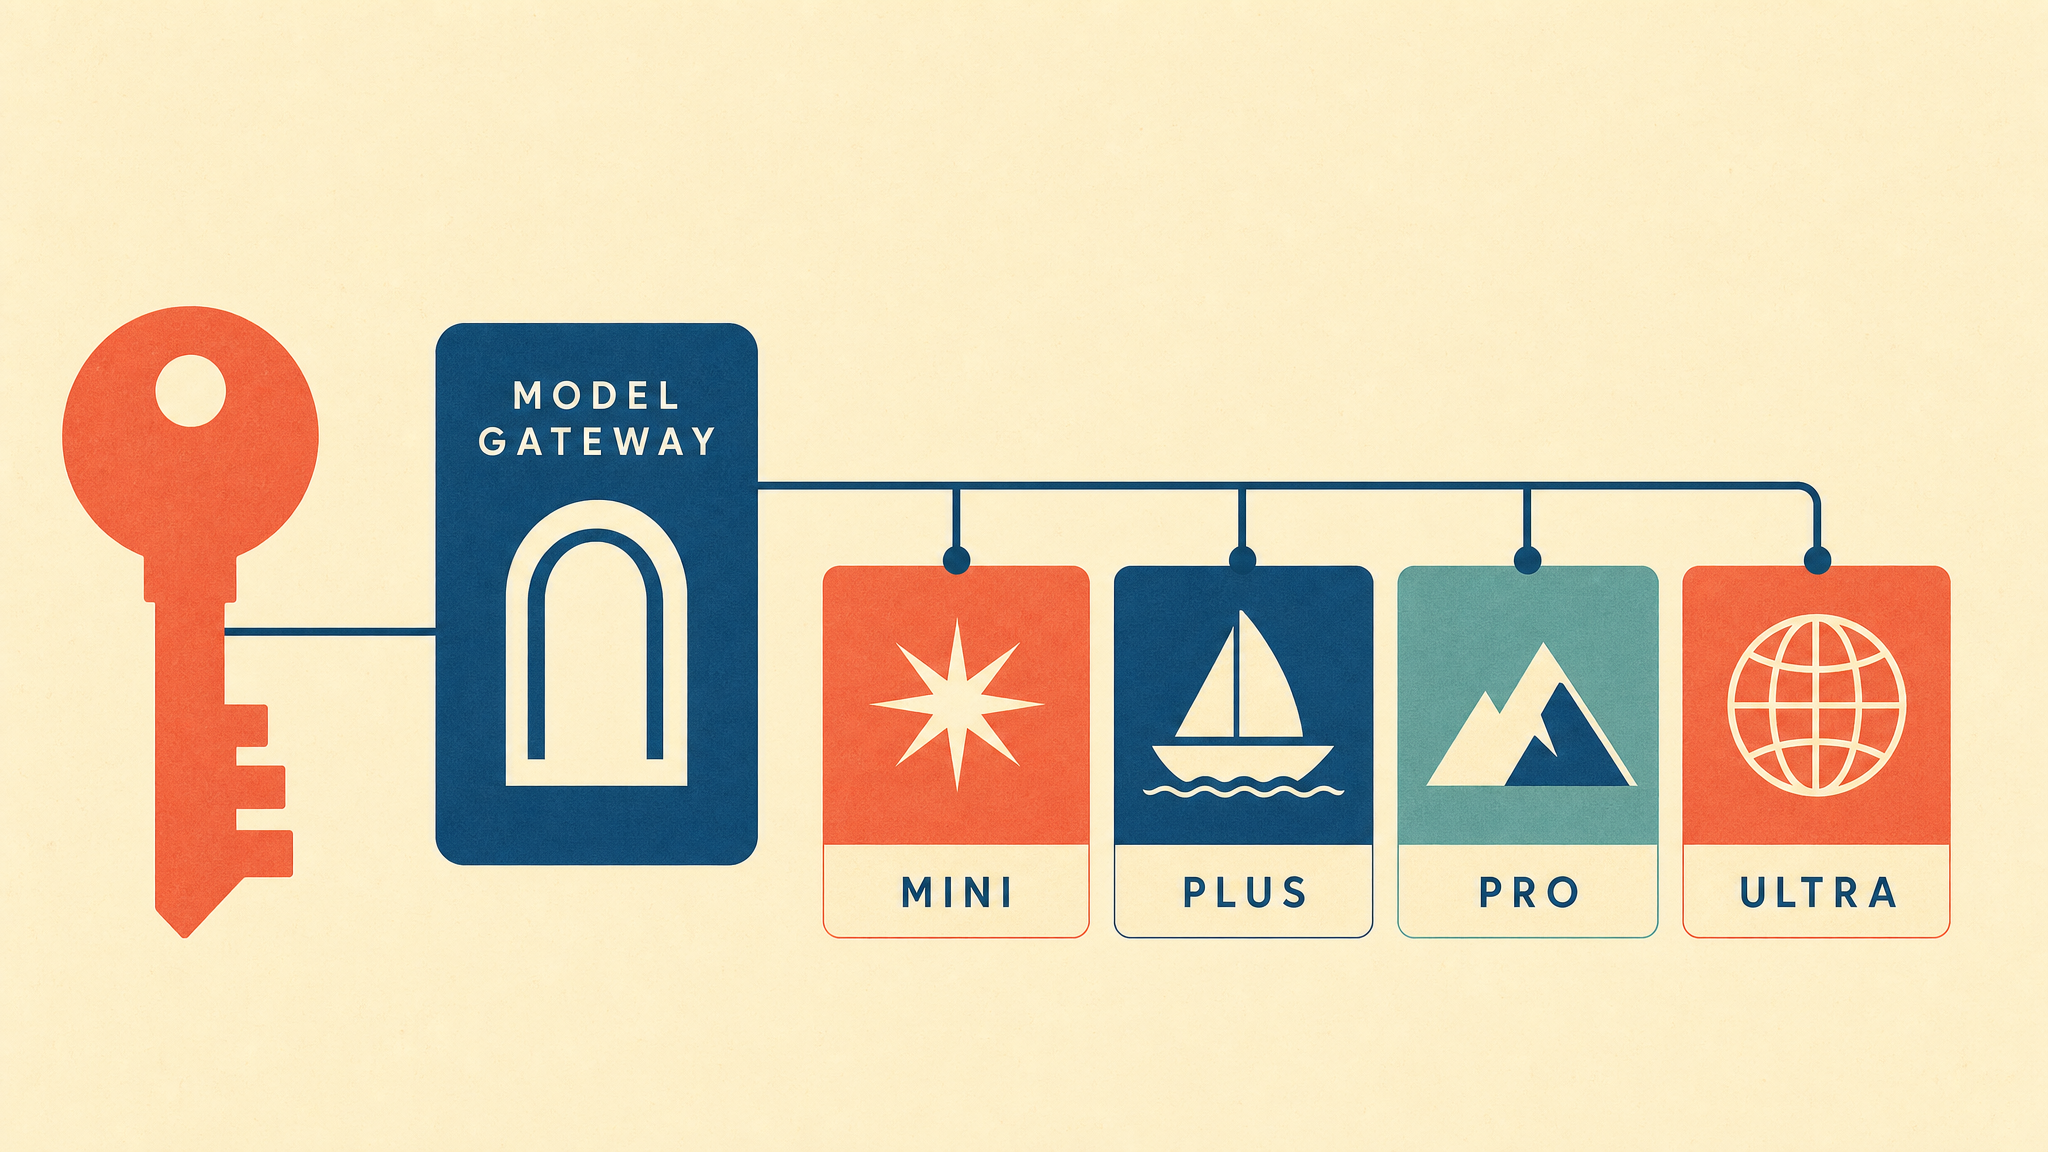
1つのキーで使えるGLM APIの全ラインアップ
1つのOpenAI互換キーで、フラッグシップのGLM-5.2からTurbo tiers、コスト効率の高いGLM-4.6まで、GLM APIの全ラインアップにアクセスできます。軽量なtierでプロトタイプを作成し、その後は1行の変更と従量課金で本番環境へ移行できます。
GLM API 徹底比較:1つの指示で3つのモデルを比較
GLM API に単一のビルドリクエストを送り、GLM 5.2、DeepSeek V4 Pro、GLM 5 が同じ指示を実際に動作するインタラクティブページへ変換する様子を確認できます。フロントエンド品質、レイアウトロジック、インタラクションの磨き込みをひと目で比較できます。
完全な単一ファイルの自己完結型 HTML ドキュメントを生成してください(すべての CSS と JavaScript はインライン化し、外部依存は一切なし、CDN なし、画像 URL なし、外部フォントなし)。内容はインタラクティブな「Aurora Tuning Console」です。真夜中の極地の空をフルビューポートの WebGL 体験として描画し、オーロラは GLSL フラグメントシェーダー内でリアルタイム計算してください。スプライト、テクスチャ、パーティクルの積み重ねで見せかけることは絶対に避けてください。 コア描画要件:単一のフルスクリーンクアッドを描画し、視覚表現のすべてをフラグメントシェーダーで行ってください。オーロラは、レイヤー化されたフラクタルな value/simplex noise(fbm、4〜6 オクターブ)から手続き的に生成し、uniform の時計によって時間とともに流れ、ワープさせます。背の高い垂直の光のカーテンが呼吸し、さざめき、結び目を作り、消散していく表現にしてください。オーロラは自己発光するボリュメトリックな輝きとしてモデル化してください。垂直方向の減衰に沿って明るさを蓄積し、各カーテンの根元に柔らかな bloom を加え、暗い上空にはかすかに漂う星屑ノイズを散らします。構図はミニマルな低い地平線から見上げる視点にし、画面の約 80% を空にします。下部には暗いシルエットの山稜と、鏡のように静かな湖を配置し、オーロラと星を柔らかく波打つ上下反転コピーとして反射させます。基本パレットはほぼ黒に近いインディゴ(深い青紫の夜)とし、オーロラだけを高彩度の要素にしてください。抑制された、発光感のある、半透明の表現で、けばけばしくしないでください。 インタラクション(すべてリアルタイムで滑らか、かつ明確に反応すること): - 空をマウスドラッグすると、光のカーテンを布のように「引っ張る」ようにしてください。ポインター位置と速度を shader uniforms に渡し、オーロラがカーソル方向へ曲がり、伸び、流れ、リリース後は穏やかな慣性で元に戻るようにします。 - マウスホイールのスクロールで「season」を循環させ、オーロラの色帯をエメラルドグリーン → マゼンタ → インディゴ(そして戻る)へ連続的に補間してください。離散的なジャンプではなく、滑らかなグラデーション変化として見せます。 - ダブルクリックすると、その空の位置に新しい星を点火してください。星は脈動(正弦波状の明るさ変化)し、湖面に対応する反射を落とします。同時に多数の星をサポートしてください。 - 読み込み時には、最初の光のカーテンがゆっくり目覚めて広がっていくような、控えめなアイドルアニメーションを維持してください。静かで、神聖で、冷たく静止した雰囲気にします。 UI と仕上げ:隅に小さく上品な半透明のコントロールオーバーレイを配置し、現在の season/color と、操作方法(drag / scroll / double-click)を示す淡い 1 行ヒントを表示してください。クリーンでモダンな寒色系の美学にし、柔らかなフェード遷移を付けます。完全にレスポンシブにしてください。ウィンドウリサイズ時には WebGL canvas をリサイズし、resolution uniforms を更新して、どのビューポートでも画面いっぱいに表示し、高 DPI 画面でも鮮明さを保ちます。requestAnimationFrame を使い、安定した 60fps を目標にしてください。WebGL が利用できない場合は、丁寧なフォールバックメッセージを表示してください。ノイズの流れの数学的品質、ボリュメトリックな輝き、インタラクションの流動性を最優先してください。ここが、有能なモデルが弱いモデルを目に見えて上回るべき部分です。
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
完全な単一ファイルの自己完結型 HTML ドキュメントを作成してください(すべての CSS と JavaScript を 1 ファイル内にインライン化し、外部依存は完全にゼロ — CDN なし、外部スクリプトなし、Web フォントなし、画像 URL なし、ネットワーク経由で取得する SVG アセットなし。すべての音はネイティブの Web Audio API で生成し、すべてのビジュアルは CSS と Canvas/DOM で描画すること)。任意のモダンブラウザで直接開け、1980 年代シンセウェーブネオンのビジュアル言語を持つ、プレイ可能なサイバーパンク風ステップシーケンサー・ドラムマシンとして動作させてください。 コア楽器:16 列 × 6 トラックの発光するステップマトリクスを画面横方向に配置して描画してください。各行は 1 つのボイス — キック、スネア、クローズドハイハット、オープンハイハット、クラップ、シンセベース — に対応します。96 個すべてのセルはクリック可能なパッドです。クリックするとオン/オフが切り替わり、アクティブなセルは彩度の高いマゼンタからシアンへのグローで光り、非アクティブなセルはほぼ黒のインディゴ背景上に、暗くくぼんだ長方形として表示されます。ユーザーは列ごとにセルを点灯させてビートをプログラムします。セル上をクリック&ドラッグして、多数のセルをまとめて切り替えるペイント操作をサポートしてください。 オーディオ:すべてのドラムボイスを Web Audio API でライブ合成してください。キックは高速な振幅減衰を持つピッチスイープ正弦波、スネアとクラップはエンベロープ付きのフィルタ処理されたホワイトノイズバースト、クローズド/オープンハイハットは短い/長い減衰を持つハイパスノイズ、シンセベースは選択可能なルート音を演奏する、デチューンした saw/square をレゾナントローパスフィルタに通した音にします。単純な setInterval タイミングではなく、正確な先読みクロックでステップをスケジュールし、高速テンポでもループが盤石に保たれるようにしてください。再生中は 16 ステップパターンを連続ループします。 トランスポートとコントロールは、下部全幅に固定された左右対称のコントロールバーに配置してください。大きな Play/Stop ボタン、BPM ダイヤルまたはロータリーノブ(ドラッグ可能、範囲はおよそ 60〜200 BPM、デフォルト 120、ライブ数値表示付き)、マスターボリュームフェーダー、トラックごとのミュートボタン、Clear ボタン、もっともらしいビートを生成する Randomize ボタンを含めます。移動するプレイヘッド — 垂直の光の刃 — がグリッド上をオーディオと完全同期して掃引し、ヒットしたセルがアクティブなら、すべて放射状のリップルパルスで bloom し、フェードアウトします。マスター出力の振幅をリアルタイムで可視化し、音に反応するライブオシロスコープ/波形表示を含めてください。 ビジュアルスタイル:深いインディゴからバイオレットへのグラデーション背景にし、ほぼ黒に見えるほど暗くしてください。グリッド線と UI アクセントはエレクトリックなマゼンタとシアンにし、すべての発光は要素自身のグローとヒット時のフラッシュ bloom(box-shadow グロー、加算合成のようなハイライト)から生まれるようにして、ループに脈動する深夜のアンダーグラウンドクラブ感を演出します。全体のグリッドを画面中央に置き、コントロールバーが下部を圧縮する左右対称のレイアウトを保ち、小さなビューポートでもグリッドが自然に縮小するレスポンシブ設計にしてください。可読性を損なわない範囲で、控えめなアニメーション scanline や chromatic shimmer を雰囲気として加えてください。 インタラクション要件:すべてが即座に反応すること — パッドのクリック、BPM ノブとボリュームフェーダーのドラッグ、ミュート切り替え、スペースバーでの Play/Stop、数字キーでのベースのルート音ジャンプ。状態(どのセルがアクティブか、BPM、音量、ミュート、再生状態)はクリーンに管理し、UI とオーディオが決して同期ずれしないようにしてください。ページへの最初のインタラクションで AudioContext も unlock/resume する必要があります。オーディオとビジュアルの緻密な同期、プレイヘッドとリップルの滑らかな 60fps アニメーション、そして初期状態から本当に満足できる音楽的な結果を最優先してください。
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
開発者が GLM API を活用する場面
自律型コーディングエージェントや長期的なリサーチから、対話型プロダクト、高ボリュームのデータ分析まで、GLM API は信頼性の高いエージェント駆動ソフトウェアを構築するための OpenAI 互換エンドポイントを開発者に提供します。

GLM API による自律型コーディングエージェント
自律的なタスク実行を前提に設計された GLM models は、プロジェクトの文脈を失うことなく、複数ステップのワークフロー全体でコードを計画し、記述し、改善します。開発チームはこれを活用して、PR レビューボット、リファクタリング支援ツール、ビルドパイプラインを動かしています。

長期的なリサーチとワークフローのオーケストレーション
安定した複数ステップの推論により、これらのモデルは広範なリサーチ課題を分解し、外部ツールを呼び出し、依存関係のある長いアクションの連鎖全体で文脈を保持できます。複数ソースの統合やクロスプラットフォーム運用を自動化するアナリストやプロダクトチームに適しています。

洗練されたフロントエンドインターフェースの構築
GLM models は、ラフなモックアップやプレーンな説明を、視覚的な完成度の高いクリーンでレスポンシブなインターフェースコードに変換します。個人創業者やデザイン志向の開発者は、機能するプロトタイプや本番向け UI をはるかに速く出荷できます。

GLM API 上の対話型プロダクト
人間らしく感じられるアシスタントを作りたいですか?GLM API は安定した推論に支えられた自然な会話体験を提供し、長く分岐する対話でも一貫性を保つチャットボット、サポートコパイロット、アプリ内アシスタントを実現します。

ツール呼び出しバックエンドと関数実行
これらのモデルはツール利用を前提に設計されているため、エージェント型システム内で関数を選択し、引数を整形し、API 呼び出しを連鎖できます。エンジニアはこれを使って、GLM をオーケストレーション層、RAG パイプライン、マルチエージェントスタックに組み込んでいます。

GLM API によるデータ分析のスケール
GLM API を活用すれば、大規模なドキュメント、スプレッドシート、レポートを推論し、効率的な Mixture-of-Experts 設計によって構造化されたインサイトを抽出できます。信頼性の高い高ボリューム分析を必要とする金融、法務、オペレーションチームに最適です。
GLM APIと競合LLM:仕様・料金マトリクス
Atlas Cloud上の主要テキストLLMと各GLM APIモデルを、コンテキスト長、最大出力、透明性のある従量課金料金で比較できます。
| モデル | コンテキストウィンドウ | 最大出力 | 入力($/1M tokens) | 出力($/1M tokens) |
|---|---|---|---|---|
| GLM 5.2 | 1M | 128K | $1.40 | $4.40 |
| GLM 5.1 | 203K | 203K | $1.40 | $4.40 |
| GLM 5 | 203K | 203K | $1.00 | $3.20 |
| GLM 4.7 | 203K | 203K | $0.60 | $2.20 |
| DeepSeek V4 Pro | 1M | 384K | $1.74 | $3.45 |
| Kimi K2.7 Code | 256K | 256K | $0.95 | $4.00 |
| MiniMax M3 | 512K | 512K | $0.60 / $1.20 >512K | $2.40 / $4.80 >512K |
Atlas Cloud で GLM を使う方法
数分で始められます — 以下の簡単なステップに従って、Atlas Cloud プラットフォームでモデルを統合・デプロイしましょう。
Atlas Cloud アカウントを作成
atlascloud.ai でサインアップし、認証を完了します。新規ユーザーには無料クレジットが付与され、プラットフォームの探索やモデルのテストに使用できます。
Atlas CloudでGLMを使用する理由
高度なGLMモデルとAtlas CloudのGPU加速プラットフォームを組み合わせることで、比類のないパフォーマンス、スケーラビリティ、開発者エクスペリエンスを提供。
パフォーマンスと柔軟性
低レイテンシ:
リアルタイム推論のためのGPU最適化推論。
統合API:
1つの統合でGLM、GPT、Gemini、DeepSeekを実行。
透明な料金:
サーバーレスオプション付きの予測可能なtoken単位の課金。
エンタープライズとスケール
開発者エクスペリエンス:
SDK、分析、ファインチューニングツール、テンプレート。
信頼性:
99.99%の稼働率、RBAC、コンプライアンス対応ロギング。
セキュリティとコンプライアンス:
SOC 2 Type II、HIPAA準拠、米国内のデータ主権。
GLM API: Answers to Common Developer Questions
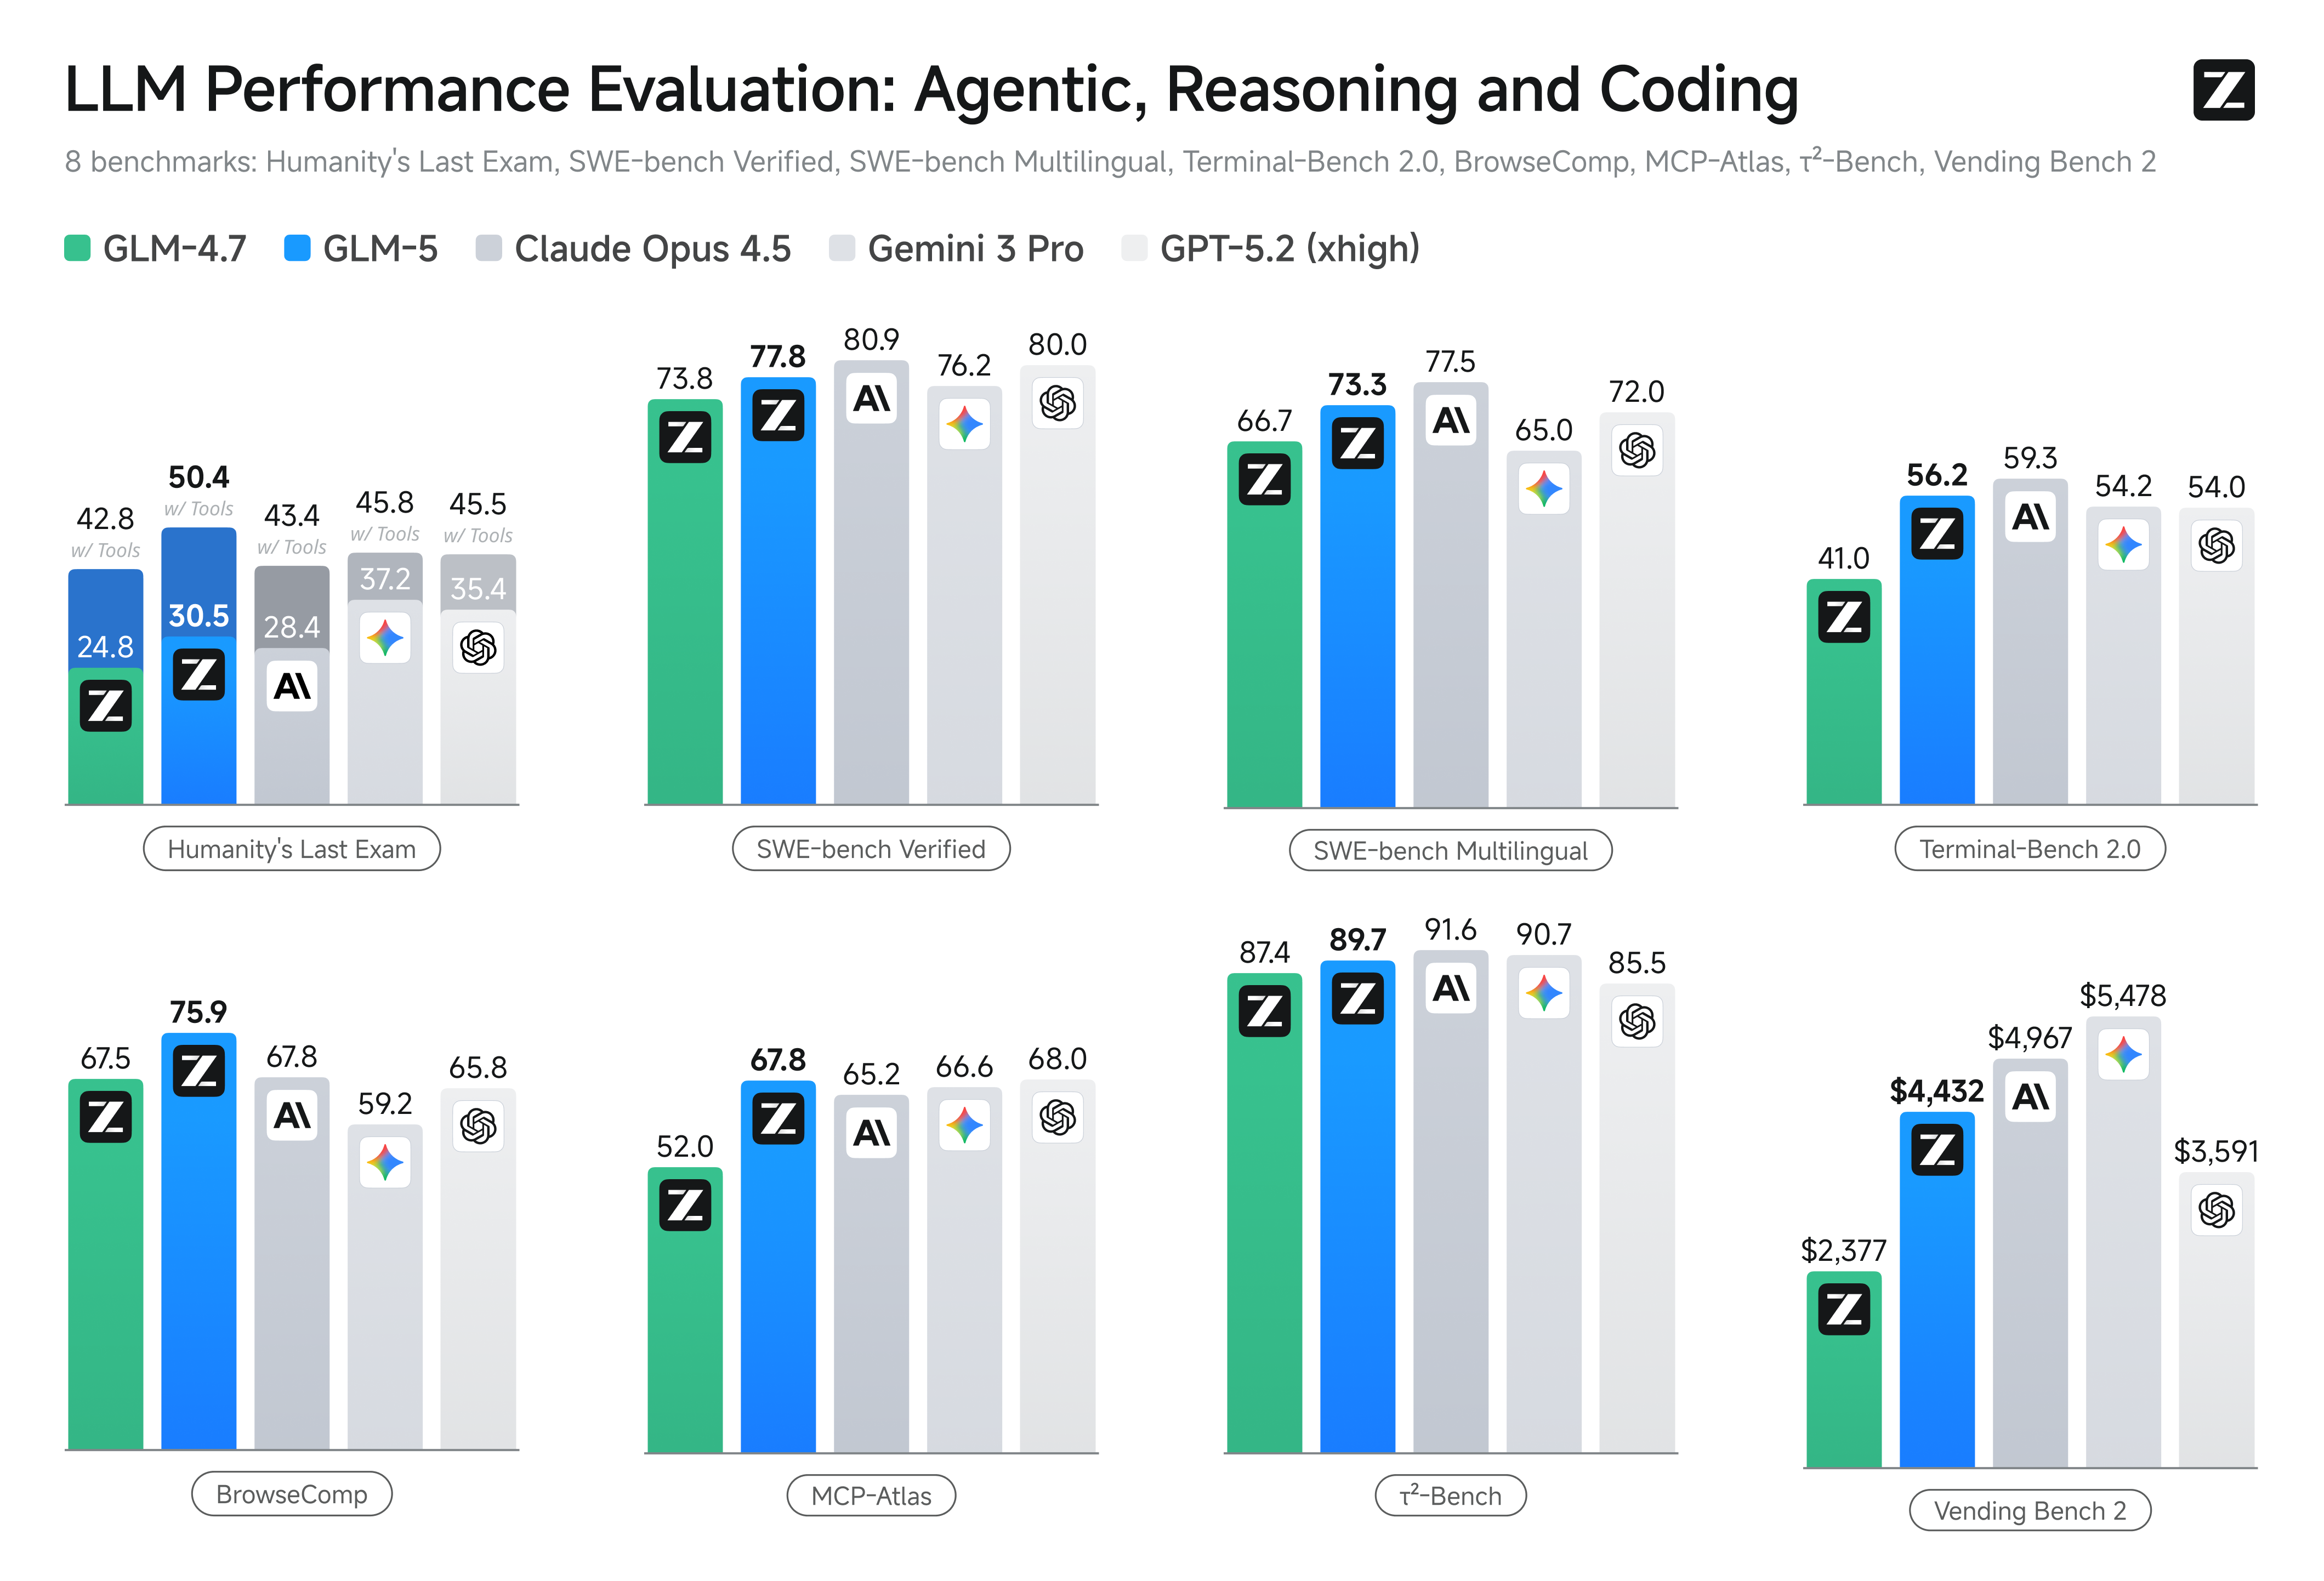
28.5Tトークンの学習データと輝かしいベンチマーク結果を持つGLM-5は、「オープンソースの最高峰」として広く認識されています。能力と論理性において世界トップクラスの商用モデルに匹敵、あるいは凌駕し、世界の開発者エコシステムに強力で高性能な基盤を提供します。
HLEは、AIが専門家レベルの人間の知識と推論能力を備えているかをテストするために設計された高難易度のベンチマークです。GLM-5が最高スコアを達成したことは、最先端科学と複雑な論理に対するその習熟度が、主要なクローズドソースモデルのレベルに到達、あるいはそれを凌駕したことを意味します。
BrowseCompは、「エージェンティック(Agentic)」能力に関する決定的なリーダーボードであり、実世界のWeb環境における複雑なタスクの計画と実行に焦点を当てています。最高スコアは、ブラウザを自律的に操作し、ページ間の情報を統合するGLM-5の能力を表しており、これが最高峰のWeb Agentエンジンであることを示しています。
このアーキテクチャは、7,440億パラメータという巨大な「知識ベース」を提供しながら、推論時にはわずか約400億パラメータのみをアクティブにします。開発者にとって、これは世界クラスの知識密度と推論の深さを意味し、Llama-3 405Bのようなデンスモデルを凌駕しつつ、より低いレイテンシとコストを実現します。
総パラメータ数はモデルの「知識容量」を表し、744Bという規模により、世界中の事実や専門的な論理を膨大に蓄積することが可能です。アクティブパラメータは、推論ごとに使用される「計算能力」を表します。MoEアーキテクチャのおかげで、GLM-5はわずか40Bの計算量で744Bレベルの知能を実現し、巨大な知識ベースと高速かつコスト効率の高いパフォーマンスを両立させています。
事前学習データの量は、モデルの「視野の広さ」を決定します。28.5Tトークンは世界最大級のデータセットの一つであり(Llama-3の約2倍)、希少言語、専門的な学術論文、そして膨大な高品質コードを網羅しています。これにより、GLM-5は複雑なロングテールクエリ、異文化間のニュアンス、低レベルのシステムプログラミングに取り組む際、優れた精度と汎化能力を発揮します。
These models are built for programming, long-horizon reasoning, and autonomous agent execution. Common uses include whole-repository code analysis, full-stack prototyping, and multi-step research or workflow automation. The flagship GLM-5 series handles the most demanding agentic work, while GLM-4.6 offers a strong balance of speed and capability for everyday tasks.
GLM's flagship models are positioned as competitive open-weight alternatives to leading closed-source models on coding and agentic benchmarks. The main practical draw is cost, since per-token pricing runs a fraction of comparable proprietary models while programming performance stays strong. For teams weighing budget against quality, GLM offers frontier-level capability at a lower rate.
Yes. Atlas Cloud serves GLM models through an OpenAI-compatible endpoint, so any framework or SDK that accepts a custom base URL and model name can call them with minimal changes. This lets you drop GLM into tool-calling agents, coding assistants, and multi-step orchestration pipelines you already run. Start building today.
Yes. The GLM series is released by Z.ai (Zhipu AI) as open-weight models under a permissive license, which is why they are widely regarded as a leading open-source option. On Atlas Cloud you get managed, production-ready access to these models without hosting or maintaining the infrastructure yourself.
さらにファミリーを探索
Kling 4.0
Kuaishouが開発したKling V4は、プロフェッショナルな制作向けの動画モデルです。安定した複雑なモーションに加え、21:9のウルトラワイド形式に対応し、表情、カメラアングル、背景、ビジュアルスタイル、台詞を狙いどおりに編集できます。Atlas Cloudでは、OpenAI互換の単一キーと透明性の高い従量課金制による、柔軟な統合を実現するDay-0アクセスを準備中です。今すぐ開発を始めましょう。

Seedance 2.5
Seedance 2.5 APIがAtlas Cloudで利用可能になりました!これにより、開発者はByteDanceの最新の動画モデルを利用できます。テキスト、単一の画像、または最大50のマルチモーダルな参照から、同期されたオーディオとフレーム内の多言語テキストを含む最大30秒のネイティブ動画をシングルパスで生成します。Atlas Cloudでは1つのキーでアクセスでき、被写体の一貫性と改善された物理演算により、ロングショットの整合性が保たれます。
Wan 3.0
Wan 3.0 APIは、AlibabaのWanビデオファミリーの次世代モデルであり、長尺動画生成、マルチリファレンス制御、およびオーディオビジュアル品質を新たな高みへと押し上げるために構築されました。Atlas CloudはすでにWan 2.7、2.6、2.5をホストしており、Wan 3.0は追加のセットアップなしで同じ統合キーで実行されます。今日から開発を始めましょう。Wan 3.0で何を作成できるかを確認するには、下のショーケースまでスクロールしてください。
MiniMax H3
MiniMax H3は、テキスト、画像、リファレンスによる生成に対応したMiniMaxのマルチモーダル動画ファミリーです。対応するルート全体で参照メディアの被写体を保持し、柔軟なアスペクト比を提供します。また、H3 Developerを通じて生成音声と映像を組み合わせ、出力プロファイルはエンドポイントごとに選択されます。Atlas Cloudは、1つのOpenAI互換キーのもとでこのファミリーを統合し、標準料金である1秒あたり$0.038からの明瞭な従量課金制を提供します。今すぐ開発を始めましょう。
GPT Image 2.5
OpenAIのgpt-image-2.5ファミリーでは、本番の画像ワークフロー向けにFlareとSunburstを選択できます。最大3840x2160までの任意の解像度でレンダリングし、xhighやmaxを含む5段階の品質ティアから、具体的な出力要件に合ったものを選択できます。Atlas Cloudでは、コールドスタートなしですぐに使えるREST推論を、生成1回あたり$0.004からの標準料金で提供しています。今すぐ開発を始めましょう。
Seedream 5.0 Pro
Seedream 5.0 Pro API は、開発者に Atlas Cloud 上で ByteDance の制御可能な画像編集モデルを提供します。アンカーと座標を使用して編集を正確に配置し、画像を編集可能なレイヤーに分離し、複数の参照を融合し、正確な色と素材を一致させ、2K および 3K での多言語テキストをサポートします。Atlas Cloud では、単一のキーでアクセスできます!
Seedance 2.0
Seedance 2.0は、正確なショット作成に対応したByteDanceの本番向け動画モデルです。プロンプトから動画を生成したり、オプションの最終フレームガイダンスを使って先頭フレームの画像をアニメーション化したり、参照メディアとオプションのウェブ検索で結果を形作ったりできます。Atlas Cloudは、これらのワークフローを透明性の高い従量課金と1つのOpenAI互換キーで、統合されたAPIにまとめます。今すぐ開発を始めましょう。
Kling V3.0
KuaishouのKling V3 APIファミリーは、テキスト、画像、参照動画を使ったワークフローに対応しています。キャラクターの同一性を保ちながら動きを転写し、ビジュアル参照で生成を誘導し、自然言語の指示で動画を編集できます。Atlas Cloudでは、さまざまな本番環境のニーズに応えるStandardおよびProエンドポイントを提供しています。すでにKling 3.0で制作していますか?Kling V4がAtlas Cloudで利用可能になりました。[Kling V4](https://www.atlascloud.ai/models/kling-v4)のファミリーページをご覧ください。
Grok Imagine Video
Grok Imagine Video は、開発者が xAI の動画ファミリーにアクセスし、クリップの作成、アニメーション化、拡張、編集を行えるようにします。プロンプトから 1~15 秒の動画を生成し、最大 7 枚の参照画像を使って人物、オブジェクト、スタイルを指定できます。また、480p または 720p で利用できます。Atlas Cloud は、透明性の高い従量課金制の料金体系と OpenAI 互換エンドポイントを通じて、これらの機能を一つにまとめます。今すぐ開発を始めましょう。
Vidu Q4 Preview
Vidu Q4は、画像から動画およびリファレンスから動画を生成するために設計された、Viduの最新フラッグシップ動画モデルです。1枚の静止画をアニメーション化し、シーン間のトランジションを自動で作成できるため、さまざまなプロダクトワークフローに対応する2つの入力パスを開発者に提供します。Atlas Cloudでは、公開済みのパラメータスキーマを備えた専用APIエンドポイントを、確認済みの標準価格である1秒あたり$0.04で利用できます。今すぐ開発を始めましょう。
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flashは、柔軟な制作ワークフローに対応するGoogle DeepMindのネイティブマルチモーダル動画ファミリーです。テキスト指示で既存の映像を編集したり、最大10枚の参照画像と3本の動画クリップでビジュアルの一貫性を維持したり、ショットを連結可能なセグメントとして拡張して最大40秒の映像を作成したりできます。OpenAI互換APIキー1つで、Atlas Cloud上のすべてのワークフローにアクセスできます。従量課金制で、Day-0から利用可能です。今すぐ開発を始めましょう。
Nano Banana 2.1
Nano Banana 2.1は、Gemini 3.6 Flashを基盤にGoogleが構築した画像モデルファミリーです。Flashレベルの速度でProレベルの生成・編集を実現し、1〜14枚の入力画像をまたいだ自然言語による編集や合成に対応しています。また、最大4人のキャラクターと10個のオブジェクトの一貫性を維持できます。Atlas Cloudを通じて、開発者は1つのOpenAI互換キーでこのモデルファミリーにアクセスでき、安定した稼働率とDay-0での利用開始が可能です。今すぐ開発を始めましょう。
おすすめ記事
Atlas Cloud を最大限に活用するためのガイド、チュートリアル、製品アップデート。





