


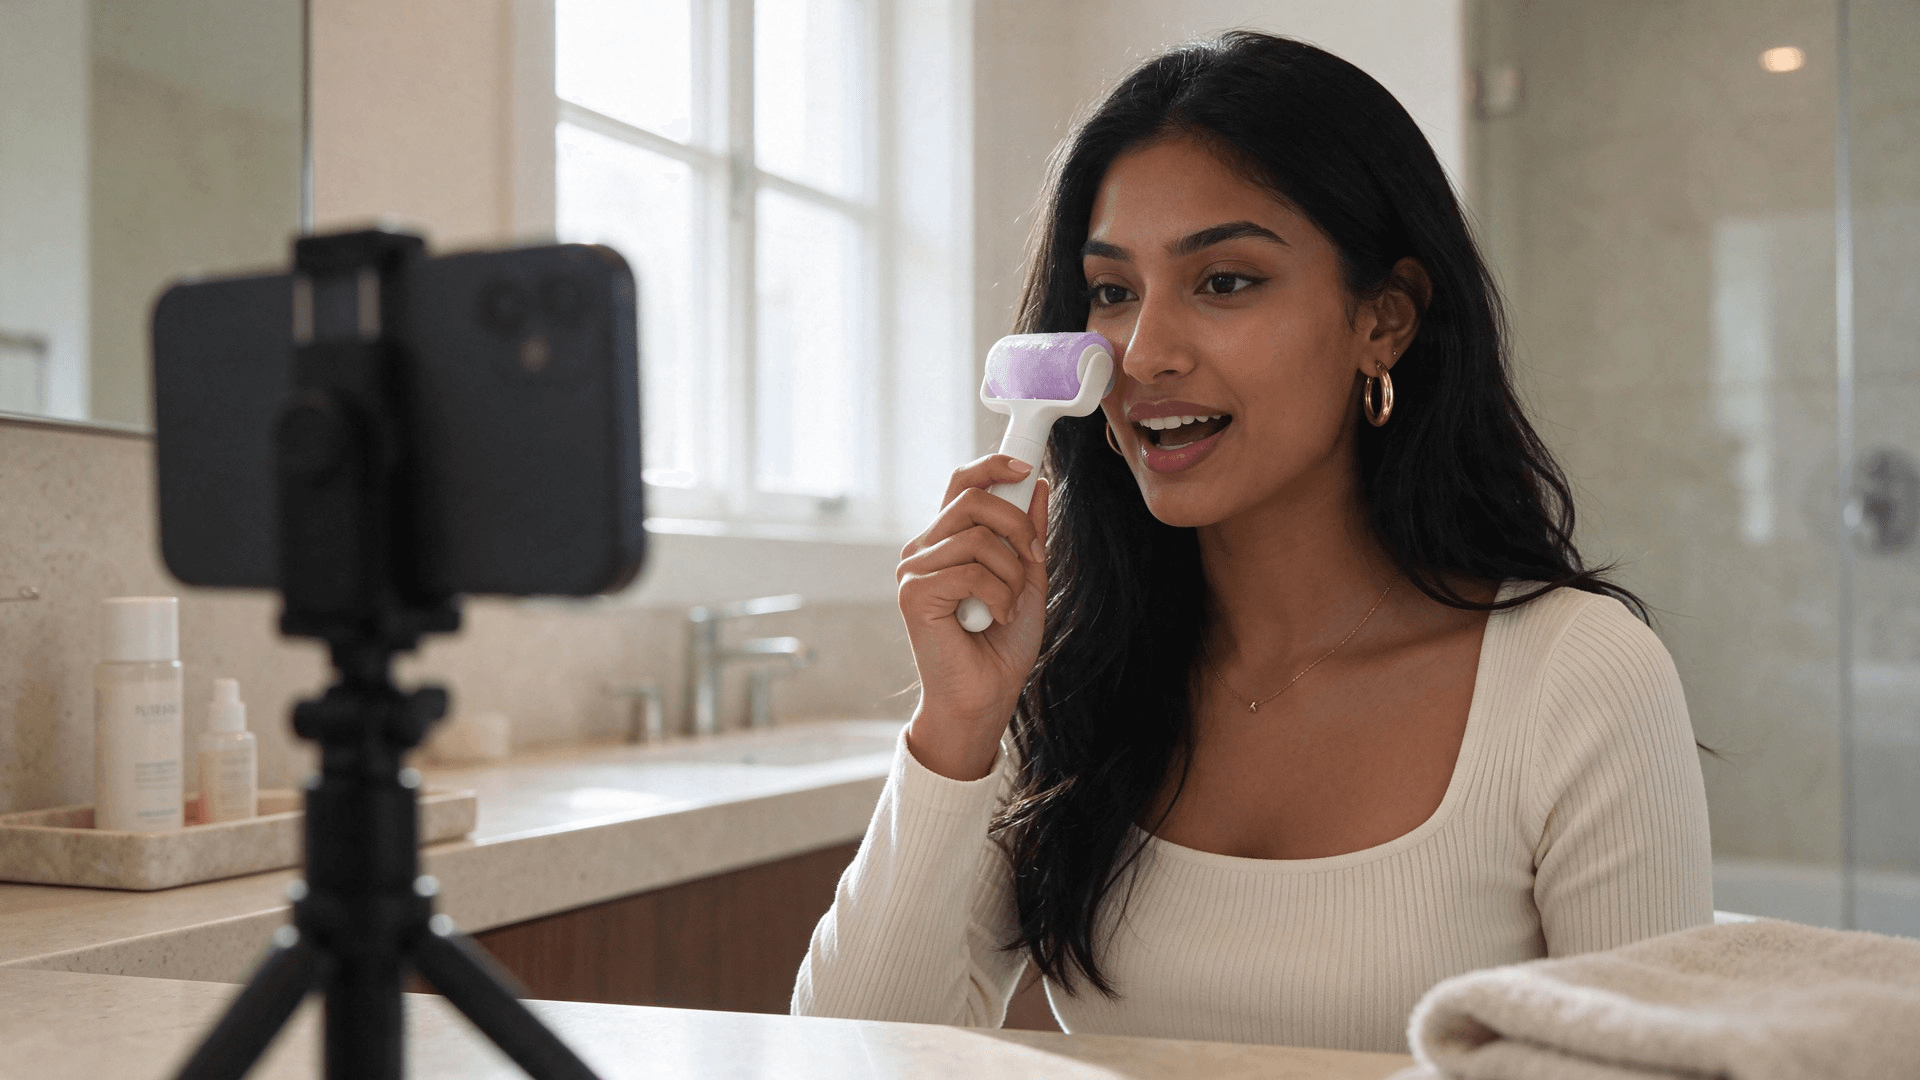
클립은 한 여성이 욕실 화장대에 앉아 있는 장면으로 시작한다. 그녀는 프로스티드 아이스 롤러를 광대뼈 위로 굴리며 네 시간 잠을 자고 받은 오전 7시 통화에 대해 불평한다. 아무도 그녀에게 카메라를 들이대지 않았다. 이 영상은 인물 사진 한 장, 제품 사진 한 장, 8초짜리 음성 한 줄에서 나왔다.
이 가이드는 브랜드 영상용으로 그녀 같은 AI 인플루언서를 만드는 방법을 단계별로 다룬다: 어떤 장면에서든 재사용할 수 있는 얼굴, 이미 바이럴된 영상에서 빌려온 훅, 대본이 바뀔 때마다 다시 생성할 수 있는 말하는 클립이다. 우리는 이 글을 쓰면서 이 영상을 직접 만들었기에, 모든 단계에서 실제 입력과 출력을 보여준다.
핵심 요약
- AI 인플루언서는 하나의 일관된 얼굴로, 단일 참조 사진에서 만들어 영상마다 재사용하는 것이다.
- 검증된 TikTok 훅에서 시작하라: 대본 한 줄을 쓰기 전에 바이럴 영상 하나를 분석하라.
- Seedance 2.5 는 인물 사진 하나, 제품 컷 하나, 음성 라인 하나를 립싱크된 말하는 영상으로 바꾼다.
- 훅 대사를 세 개 쓰고, 각각을 클립으로 실행한 뒤, 첫 3초가 먹히는 하나를 남겨라.
- TikTok에서 AI가 만든 진행자를 라벨링하고, 사용 허가를 받은 실제 얼굴만 사용하라.
AI 인플루언서란 무엇이며 누가 만드는가
AI 인플루언서는 같은 얼굴, 목소리, 스타일로 카메라에 계속 등장하는 생성된 인물이다. '계속'이라는 부분이 핵심이다. 잘생기거나 예쁘게 나온 프레임 하나는 쉽다. 월요일에는 주방에서, 금요일에는 차 안에서 같은 여성처럼 보이는 진행자가 사람들이 실제로 검색하는 것이다.
이들을 만드는 두 집단이 있으며, 원하는 것이 다르다:
| 페르소나 계정 | 브랜드 진행자 | |
|---|---|---|
| 목표 | 가상 인물로 팔로워 늘리기 | 제품 영상과 광고 전면에 서기 |
| 고정해야 할 것 | 얼굴, 성격, 인생 스토리 | 얼굴, 목소리, 전달 스타일 |
| 일반적인 결과물 | 일상 게시물, 스토리, 라이브 | 10~30초 훅과 데모 |
| 성공 지표 | 시청자 규모 | 시청 시간과 제품 클릭 |
이 가이드는 두 번째 열을 다룬다. 이 형식 자체가 처음이라면, AI UGC란 무엇인가에 대한 해설에서 기본기를 먼저 다룬다.
사진 한 장으로 Atlas Cloud에서 말하는 AI 인플루언서 만들기
이론은 잠시 미루고 완성된 클립을 먼저 보자: 10초, 세로형, 그녀의 목소리, 롤러가 작동하는 클로즈업, 마지막에 제품을 들어 보여주는 장면이 담겨 있다.
이 영상은 Atlas Cloud에서 Seedance 2.5 Reference-to-Video로 만들었다. AI 인플루언서 생성기로서, 여러분의 입력에서 시작한다: 얼굴, 제품, 목소리를 가져오면 그 주변으로 장면을 구성한다.
한 요청에 실제 인물 사진을 포함해 최대 30장의 참조 이미지를 받을 수 있으며, 오디오 클립 하나만으로 립싱크를 구동할 수 있다.
이는 브랜드 진행자에게 중요하다. 얼굴은 모든 영상에서 여러분의 것으로 유지되고, 대본이 바뀌면 재촬영을 잡는 대신 오디오 파일 하나만 교체하면 된다.
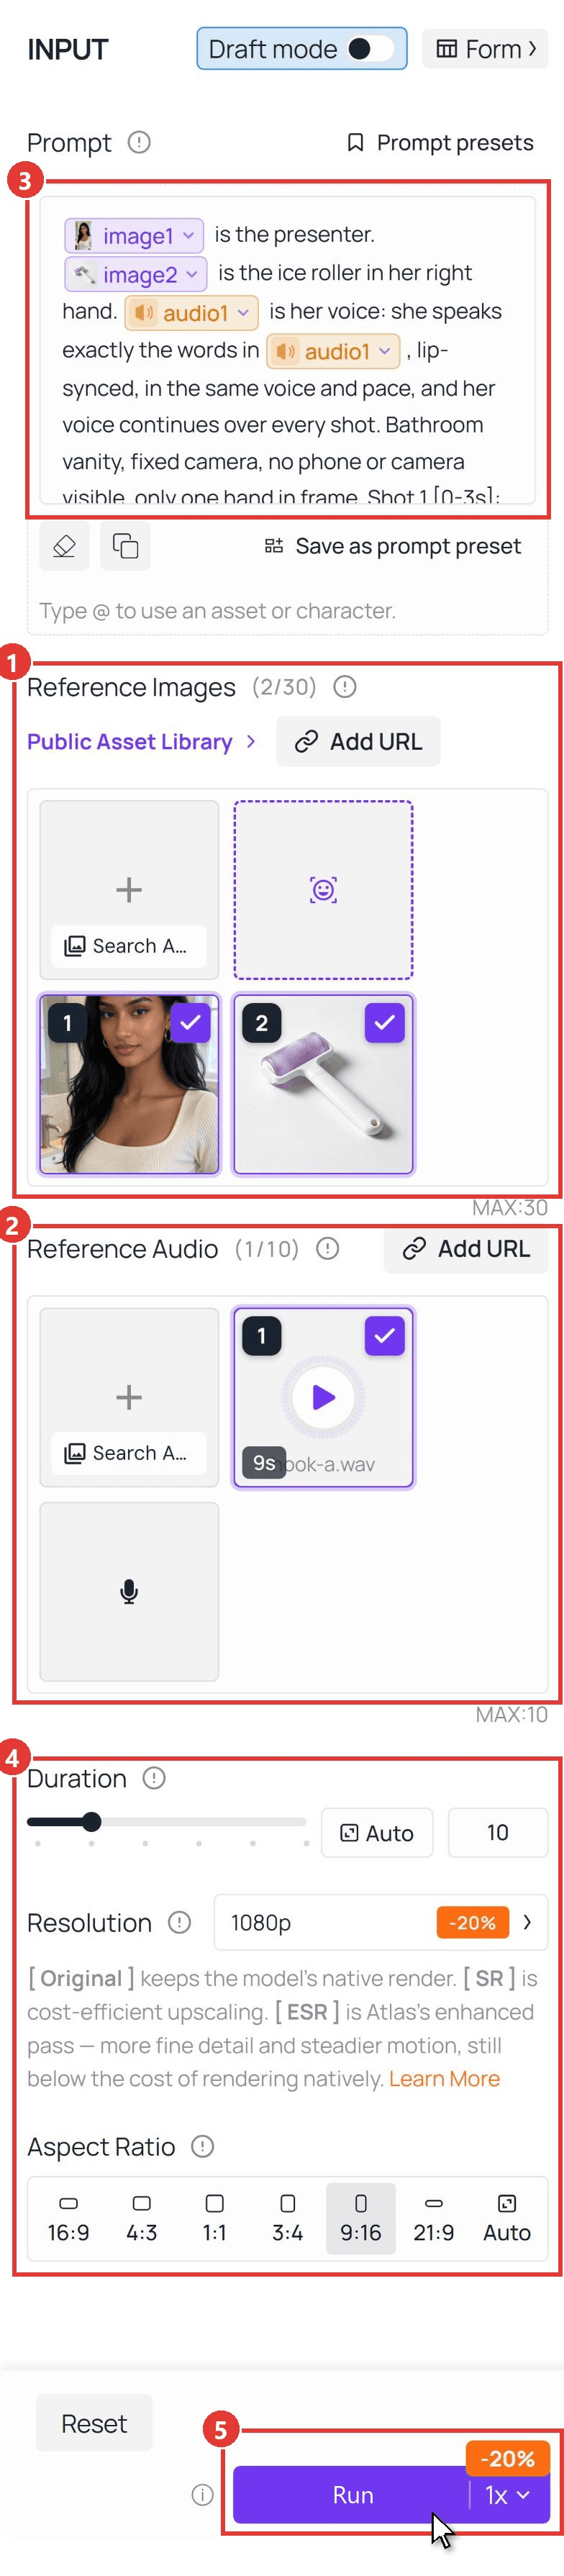
전체 실행은 Seedance 2.5 Reference-to-Video 플레이그라운드 한 페이지에서 이루어진다:
- Reference Images 아래에 인물 사진을 먼저 업로드한 다음 제품 사진을 업로드한다. 순서가 중요하다: 첫 번째 파일이 Image1이 된다.
- Reference Audio 아래에 음성 라인을 업로드한다.
- 프롬프트를 붙여 넣은 뒤, 각 @ 멘션을 다시 입력하고 목록에서 일치하는 파일을 선택해 태그로 바뀌게 한다.
- Duration을 10, Resolution을 1080p, Aspect Ratio를 9:16으로 설정한다.
- Run을 클릭한다.
5단계로 AI 인플루언서 만드는 방법
플레이그라운드는 마지막 클릭일 뿐이다. 영상이 스크롤을 멈추게 할지 결정하는 것은 그 전에 넣는 모든 입력이다. 그래서 리서치부터 완성된 훅까지 AI 인플루언서를 만드는 방법을 소개한다.
1단계: 실제 바이럴 영상에서 TikTok 훅 분석하기
빈 대본으로 시작하지 마라. 이미 조회수를 끌어낸, 자신의 니치에 맞는 쇼츠 하나를 골라 해부하라.
우리는 All You Can Face 채널의 19초 루틴, 붓기 있는 얼굴, 붓기 있는 눈꺼풀, 붓기 있는 눈 밑을 위한 하나의 루틴을 사용했다. 열 번 보는 대신 Atlas Cloud API를 통해 링크를 Gemini 3.5 Flash에 넘겼다. 공개 YouTube 링크는 비디오 입력으로 바로 작동한다:
plaintext1curl -X POST "https://api.atlascloud.ai/v1/models/google/gemini-3.5-flash:generateContent" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "contents": [{ 6 "role": "user", 7 "parts": [ 8 {"fileData": {"mimeType": "video/mp4", "fileUri": "https://www.youtube.com/shorts/V_rNa1iOuXA"}}, 9 {"text": "Return the 0-3s hook line verbatim, the hook type, each shot change with its timestamp, all on-screen text, and the hook as one reusable template sentence."} 10 ] 11 }] 12 }'
돌아온 결과를 요약하면 다음과 같다:
| 우리가 요청한 것 | 영상이 하는 일 |
|---|---|
| 오프닝 대사 | "푸석한 얼굴로 일어나면 이걸 20번 하세요." |
| 훅 유형 | 고통점을 직접적인 지시로 표현 |
| 구조 | 문제당 하나씩, 네 개의 샷, 각 샷은 같은 문장 틀로 시작 |
| 화면 텍스트 | 샷마다 항목이 하나씩 추가되는 체크리스트 |
| 프레이밍 | 가슴 위까지, 내내 렌즈를 응시 |
| 재사용 가능한 패턴 | [Action] for [amount] if you wake up with [problem] |
TikTok 훅 목록은 첫 문장을 제공한다. 분석에서 유용한 부분은 대사 아래의 구조다: 하나의 반복 문장 틀, 샷마다 하나의 눈에 보이는 보상, 인트로 없음. 그것이 우리가 대본에 반영한 것이다.
2단계: 하나의 얼굴을 고정하고 장면마다 재사용하기
인플루언서가 시청자에게 실제처럼 느껴지려면 매번 같은 사람처럼 보여야 한다. 사용 권리가 있는 인물 사진 하나에서 시작한 뒤, 얼굴을 제외한 모든 것, 즉 의상, 방, 조명을 바꿔라.
참조 이미지로 편집하는 이미지 모델이면 무엇이든 가능하다. 우리는 Atlas Cloud의 Seedream을 사용했다: 5.5 Edit 모델로 스튜디오 인물 사진을 욕실 화장대 마스터 샷으로 바꾸고, 5.0 Lite 순차 편집기로 그 마스터에서 한 요청으로 세 장면을 더 만들었다.
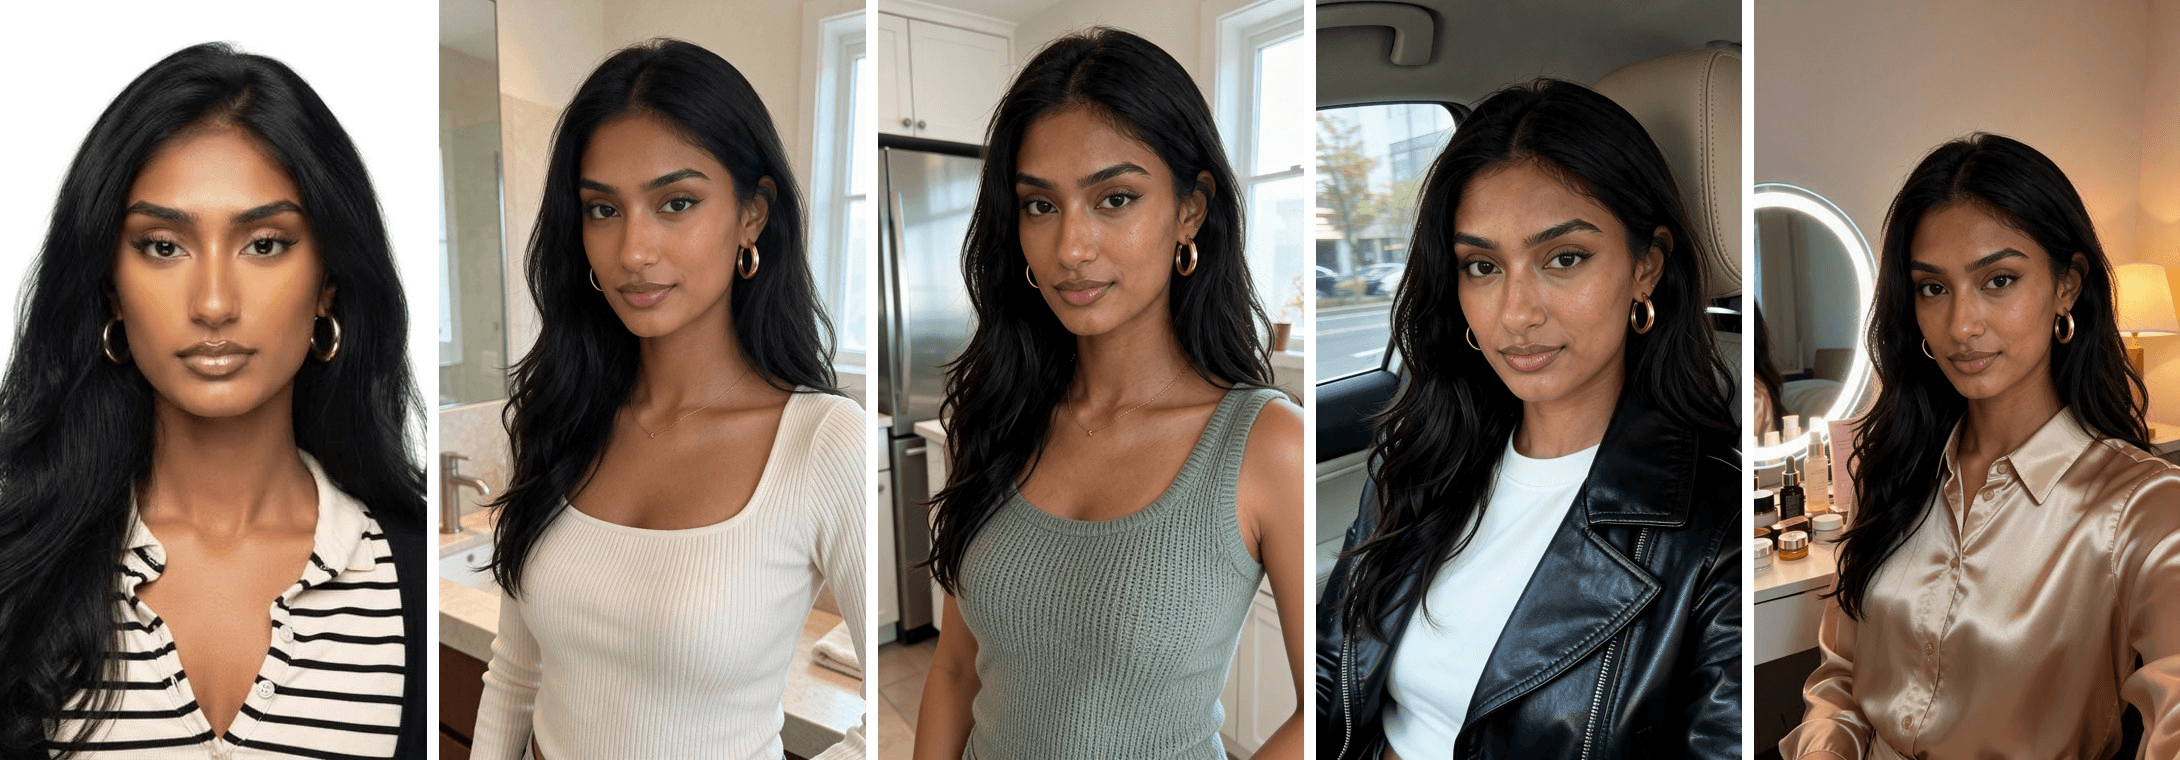
얼굴을 안정적으로 유지한 세 가지는 다음과 같다:
- 정체성은 고정하고 스타일링은 자유롭게. 첫 문장에 바뀌면 안 되는 것(얼굴, 피부톤, 헤어, 귀걸이)을 명시한 다음, 새 의상과 방을 설명하라.
- 기기가 아니라 카메라를 설명하라. "가슴 높이의 고정 카메라에서 촬영"이라고 하면 깔끔한 셀피 스타일 프레임이 나온다. 카운터 위의 휴대폰을 언급하면 모델이 휴대폰을 그리는 경향이 있다.
- 그녀를 크리에이터처럼 입혀라. 기본 스웨트셔츠는 스톡 영상처럼 보인다. 골지 사각넥 상의나 새틴 셔츠는 스스로를 의도적으로 촬영하는 사람처럼 보이게 한다.
3단계: 검증된 패턴으로 TikTok 바이럴 훅 작성하기
1단계의 패턴이 있으면 글쓰기는 빈칸 채우기가 된다. 우리는 아이스 롤러용 대사를 세 개 작성했고, 각각 다른 오프너를 빌려왔다:
| 훅 | 대사 | 오프너 유형 | | A | 네 시간밖에 못 잤는데 오전 7시 통화가 있었어. 이걸로 2분만 쓰니까 아무도 피곤해 보이냐고 안 물었어. 내가 쓰는 방법은 이거야. | 기행 + 숫자 | | B | 푸석한 얼굴로 일어나면 이걸 2분만 하세요. 턱에서 위로, 각 눈 밑, 그다음 이마를 가로질러 굴리세요. 끝. | 1단계의 패턴 | | C | 붓기 때문에 아이크림 사는 건 그만두세요. 이걸 밤새 냉동실에 넣두고 2분만 굴리면 카메라에도 차이가 보여요. | 역발상 조언 |
그다음 각 대사에 자체 음성 트랙을 붙인다. Seedance 2.5는 참조 오디오 자체에 립싱크하므로, 오디오가 곧 대본이다: 각 훅을 같은 목소리로 별도 파일로 녹음하거나 생성하라.
우리는 Atlas Cloud의 Gemini 2.5 Pro TTS로 생성했고, Sulafat 음성을 사용해 텍스트 앞에 캐주얼하고 따뜻하며 약간 장난스러운 낭독을 요청하는 한 줄 스타일 노트를 넣었다.
4단계(방법 1): 플레이그라운드에서 말하는 영상 생성하기
위 스크린샷의 다섯 번 클릭을 훅마다 한 번씩 실행한다. 실행 사이에 바뀌는 것은 오디오 파일뿐이다. 프롬프트는 동일하게 유지된다:
plaintext1@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced, in the same voice and pace, and her voice continues over every shot. Bathroom vanity, fixed camera, no phone or camera visible, only one hand in frame. 2Shot 1 [0-3s]: chest-up, she talks straight to the lens, holding the roller near her chin. 3Shot 2 [3-6s]: extreme close-up on her cheek. The roller head is pressed flat against her skin and rolls slowly upward along her cheekbone. The lilac cylinder turns on its axle as it moves, the white frost streaks on its surface rotating up and out of view, while the white handle stays still. Her skin gently dips under the roller. 4Shot 3 [6-10s]: back to chest-up, she holds the roller up beside her face toward the lens and finishes the line.
그 프롬프트에서 두 가지 선택이 대부분의 역할을 한다. 중간 샷을 클로즈업으로 한 이유는 실린더가 도는 것 같은 작은 기계적 디테일이 제품이 프레임을 가득 채울 때 가장 잘 읽히기 때문이다. 그리고 음성 라인이 컷 위로 명시적으로 이어지므로, 클로즈업이 한 테이크 안의 B-roll처럼 느껴진다.
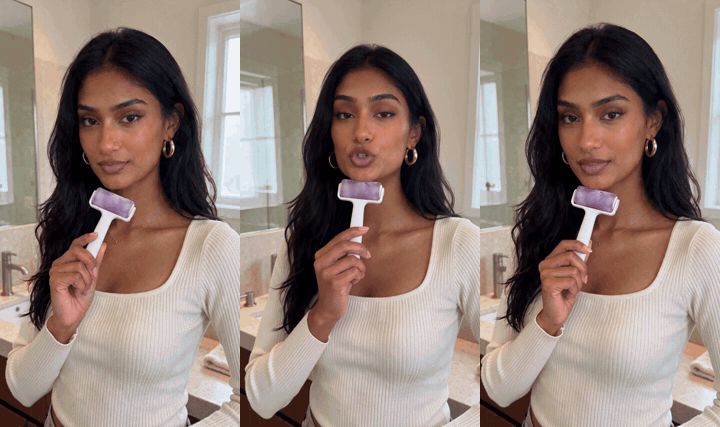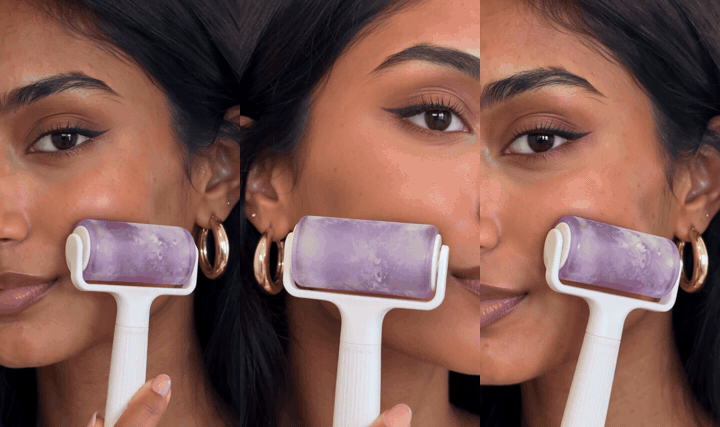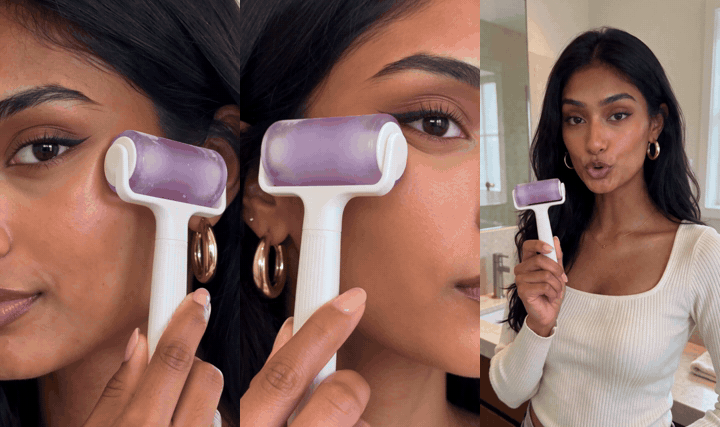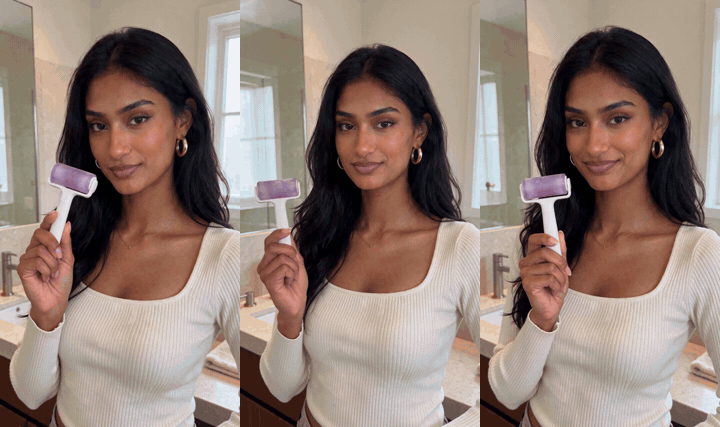
우리는 1080p 버전으로 훅 A를 남겼다. 첫 2초에 숫자와 이해관계(네 시간 수면, 오전 7시 통화)가 담겨 있어 시청자는 첫 컷 전에 보상을 알게 된다. 모든 프레임과 샷 리스트를 직접 쓰고 싶다면, 우리의 20분 AI UGC 광고 워크플로가 그 방식을 다룬다.
5단계(방법 2): API로 훅 일괄 처리하기
훅 하나가 효과가 있으면, API는 나머지 열 개를 오디오 파일 루프로 바꾼다.
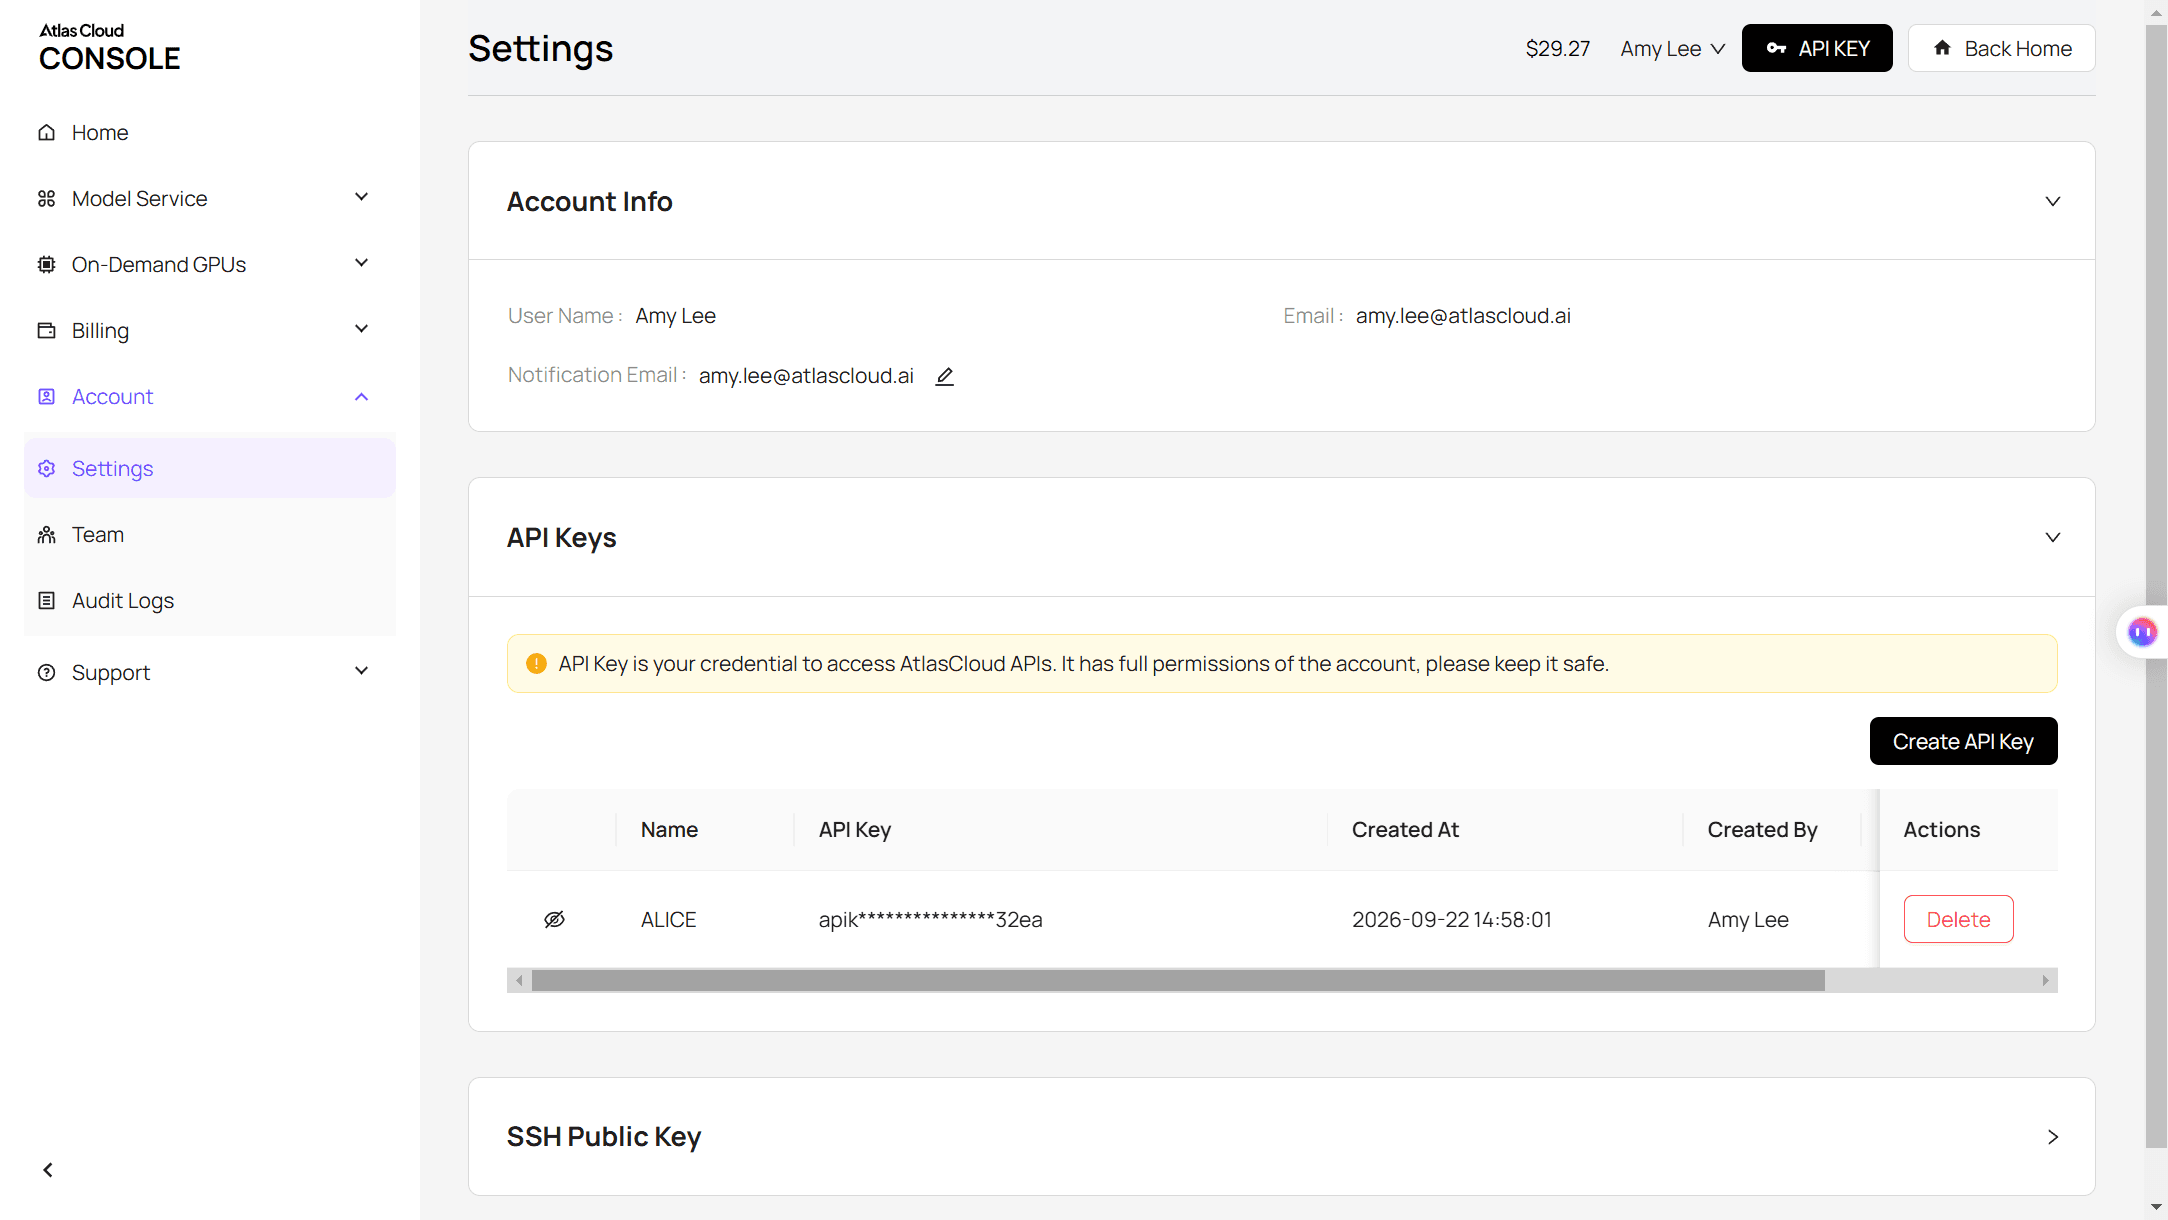
1단계: API 키를 생성하고 복사한다. Atlas Cloud 콘솔을 열고 Settings로 이동한 다음 API Keys에서 Create API Key를 클릭한다.
2단계: API 문서를 확인한다. 여기서 사용한 참조 필드를 포함해 모든 모델의 파라미터는 API 문서에 있다.
3단계: 첫 요청을 보낸다. 훅 하나를 제출한다:
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced. Shot 1 [0-3s]: chest-up, talking to the lens. Shot 2 [3-6s]: extreme close-up, the roller pressed to her cheek, the cylinder turning on its axle as it rolls upward. Shot 3 [6-10s]: chest-up, she holds the roller beside her face and finishes the line.", 7 "reference_images": ["https://your-cdn.com/presenter.png", "https://your-cdn.com/ice-roller.png"], 8 "reference_audios": ["https://your-cdn.com/hook-a.wav"], 9 "duration": 10, 10 "resolution": "1080p", 11 "ratio": "9:16", 12 "generate_audio": true 13 }'
응답은 prediction ID를 반환한다. 상태가 completed로 읽힐 때까지 폴링한다:
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
일괄 처리하려면 본문은 고정하고 각 훅마다 reference_audios URL만 바꾼다. Atlas Cloud는 모델 전반에 하나의 API를 실행한다: 모든 비디오 모델이 이 엔드포인트, 키, 폴링 루프를 공유하므로 모델을 바꾸려면 model 문자열만 바꾸면 된다. 위의 이미지 및 음성 단계도 같은 키와 같은 제출 후 폴링 패턴을 사용한다.
훅별·형식별 전체 테스트 그리드는 UGC 광고 제작을 확장하는 방법을 참고하라.
AI 인플루언서 규칙: 라벨과 초상권
그녀가 무엇이든 팔기 전에 두 종류의 규칙을 확인하라: 플랫폼 라벨과 광고 속 합성 인물에 관한 법률이다.
| 어디서 | 무엇을 요구하는가 | 해야 할 일 | | TikTok | 현실적인 장면이나 사람을 보여주는 AI 생성 콘텐츠에 라벨 표시 | 게시할 때 AI 생성 라벨을 켜거나 캡션 또는 스티커 추가 | | 뉴욕주 광고 | 광고주가 합성 퍼포머 사용을 아는 경우 광고에 공개 | 광고에 명확하고 눈에 띄는 공개 문구 추가 | | 참조로 쓰는 실제 얼굴 | 초상을 사용하는 사람의 허가 | 서면 동의를 받거나, 사용 권리가 있는 인물 사진에서 시작 |
TikTok은 2023년 9월에 AI 생성 콘텐츠 라벨을 도입했고, 크리에이터에게 현실적인 AI 콘텐츠에 이를 사용하도록 요청한다. 뉴욕주의 합성 퍼포머 법, S.8420-A는 2025년 12월 11일 서명되어 2026년 6월 9일 시행되었으며, 첫 위반 시 $1,000, 그 이후 각 위반마다 $5,000의 민사 벌금이 부과된다.
모델 측면에서 Atlas Cloud의 Seedance 2.5는 실제 사람 사진을 참조로 받아들이고 자동으로 자산으로 등록한다. 해당 문서는 실제 사람의 초상을 승인을 받은 경우에만 사용하라고 요청하며, 이는 인간 크리에이터에게 적용하는 것과 같은 규칙이다.
자주 묻는 질문
AI 인플루언서를 만드는 데 비용이 얼마나 드나요?
인물 사진은 Seedream 5.5 Edit로 9:16에서 장당 약 $0.03이었다. Seedance 2.5 영상은 해상도와 길이에 따라 가격이 책정된다: 참조 이미지 두 장과 음성 파일 하나가 있는 10초 세로 클립은 Atlas Cloud에서 720p 기준 약 $3.02, 1080p 기준 약 $5.94이다.
이 가격은 2026년 11월 13일 기준이며 20% 할인이 적용된 것이다. 모든 훅이 각각의 클립이므로, 주요 AI UGC 비용은 승자를 고르기 전에 얼마나 많은 훅을 테스트하느냐에 달려 있다.
사용할 수 있는 TikTok 훅 생성기가 있나요?
어떤 텍스트 모델이든 훅을 생성할 수 있지만, 주제 대신 패턴을 주면 출력이 좋아진다. 먼저 바이럴 영상 하나를 분석한 뒤(1단계), 모델에게 제품에 맞는 바로 그 문장 틀로 열 개의 대사를 요청하라. 촬영할 세 개를 고르는 것이 쉰 개를 생성하고 하나도 촬영하지 않는 것보다 낫다.
내 AI 인플루언서가 다른 언어를 말할 수 있나요?
네. 모델 문서에 따르면 Seedance 2.5는 10개 이상의 언어로 음성을 네이티브로 생성한다. 가장 정교한 립싱크를 위해서는 대상 언어로 음성 라인을 먼저 생성한 뒤, 영어와 마찬가지로 참조 오디오로 전달하라.
AI 인플루언서 영상 하나는 얼마나 길 수 있나요?
Seedance 2.5 생성 한 번은 4초에서 30초까지 가능하다. 훅은 짧을수록 가장 잘 작동한다: 우리의 세 클립은 각각 10초로, 한 대사, 한 클로즈업, 한 제품 들고 보여주기 장면을 넣을 여유가 있다. 더 긴 광고는 장면을 각각 생성해 이어 붙여라.
결론
이제 얼굴은 쉬운 부분이다. 판매하는 진행자와 그저 보기 좋은 진행자를 가르는 것은 그녀를 둘러싼 작업이다: 이미 바이럴된 것에서 가져온 훅 패턴, 장면마다 재사용한 단일 인물 사진, 입술이 말과 맞도록 각 대사에 붙인 음성 트랙이다.
자신의 제품을 위한 AI 인플루언서를 만드는 방법을 찾고 있다면 작게 시작하라. 영상 하나를 분석하고, 대사 세 개를 쓰고, 클립 세 개를 실행한 뒤, 첫 3초를 벌어들이는 하나를 남겨라. 그런 다음 API가 이후의 모든 훅에 대해 이 루프를 반복하게 하라.




