




남성 여러분, 클리퍼를 들기 전에 다음 헤어스타일을 먼저 시도해 보세요.
AI 헤어스타일 체인저로 사진을 업로드하고 남성 헤어스타일, 페이드, 맨번을 무료로 체험해 보세요. 미용실 의자에 앉기 전에 새로운 헤어컷을 미리 확인하세요.
Optional, 1 image. Without it a virtual model is designed for your product.
의류를 업로드하고 누가 입어야 하는지 지정하세요. 템플릿이 옷이 어떻게 드리워지고 여며지는지 계산하고, 모델에 맞게 핏을 잡은 다음, 이를 바탕으로 필름을 렌더링합니다.
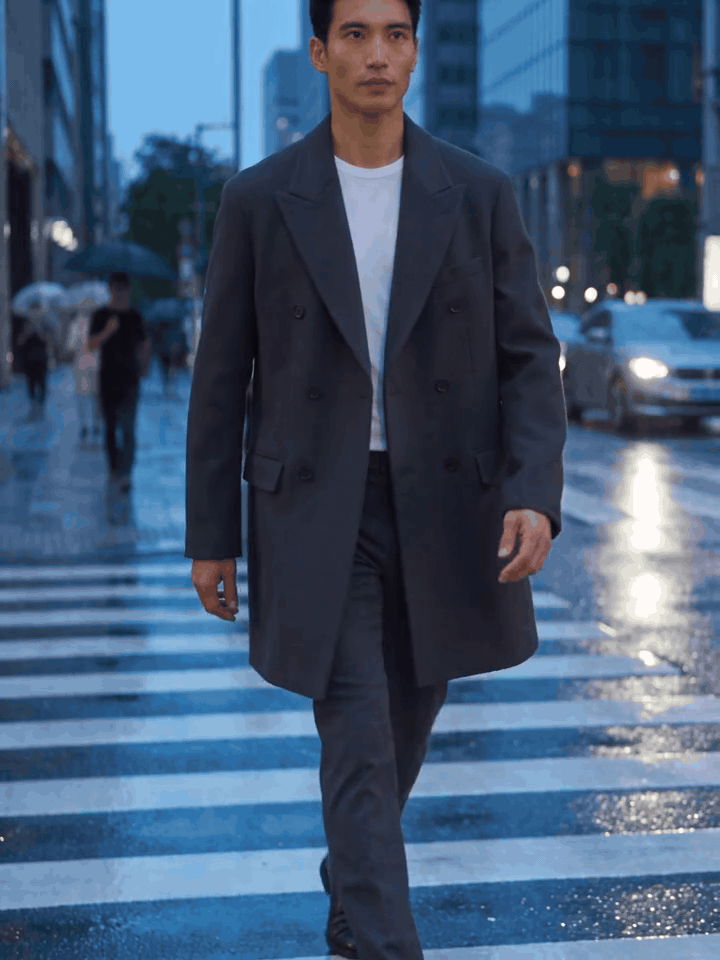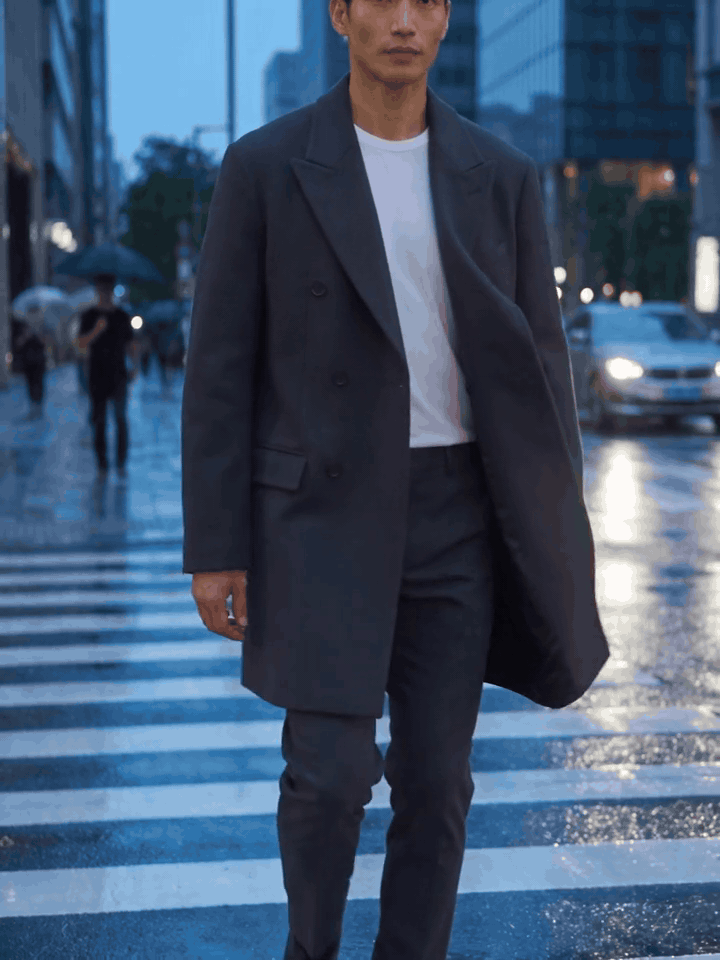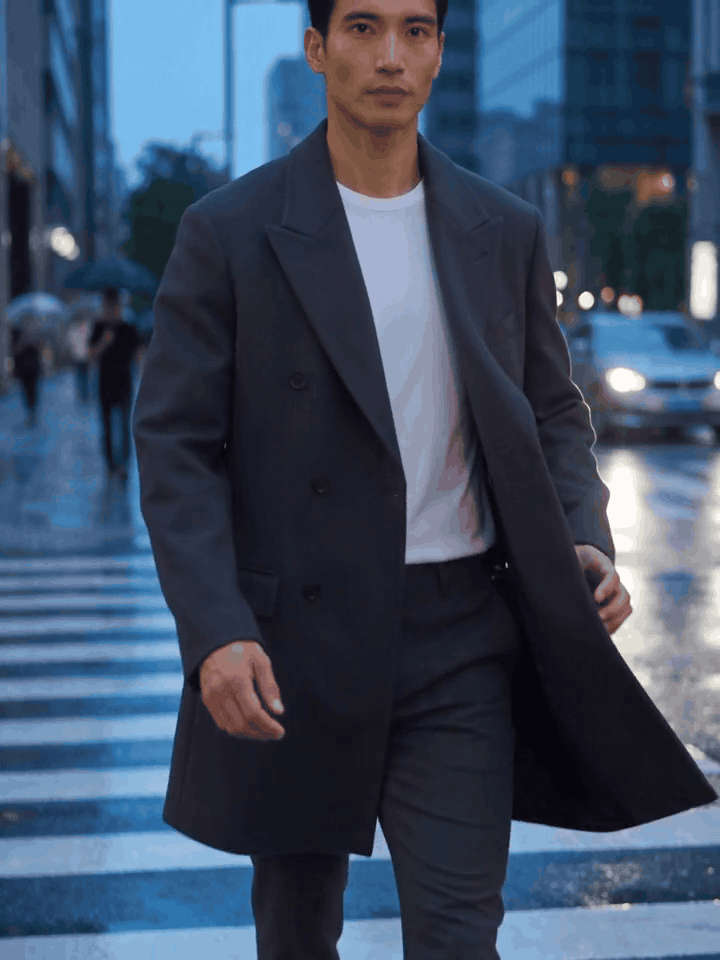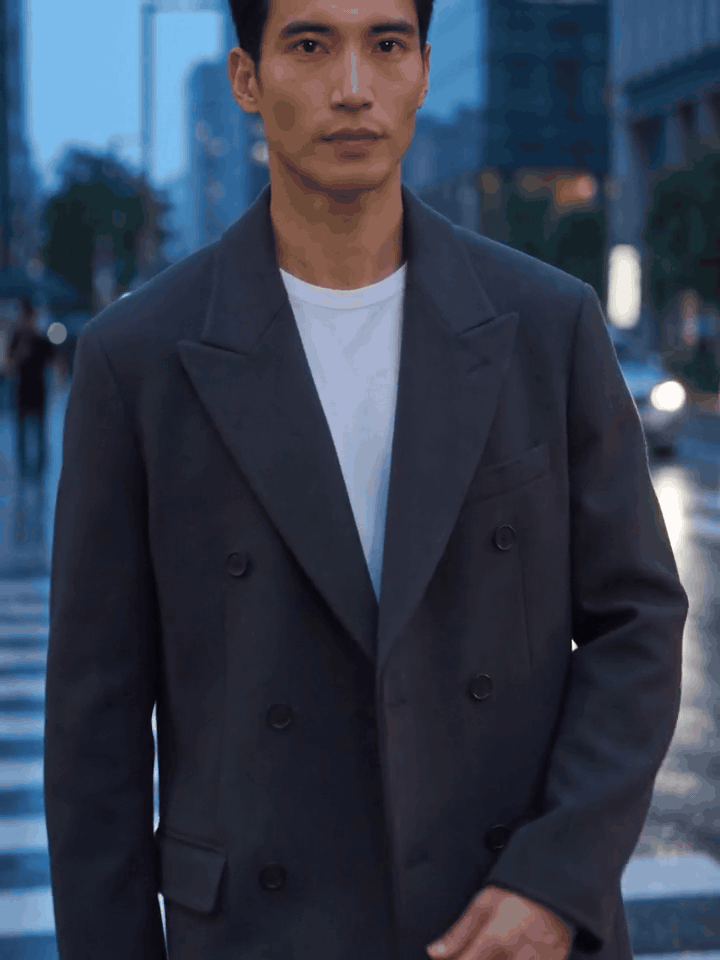
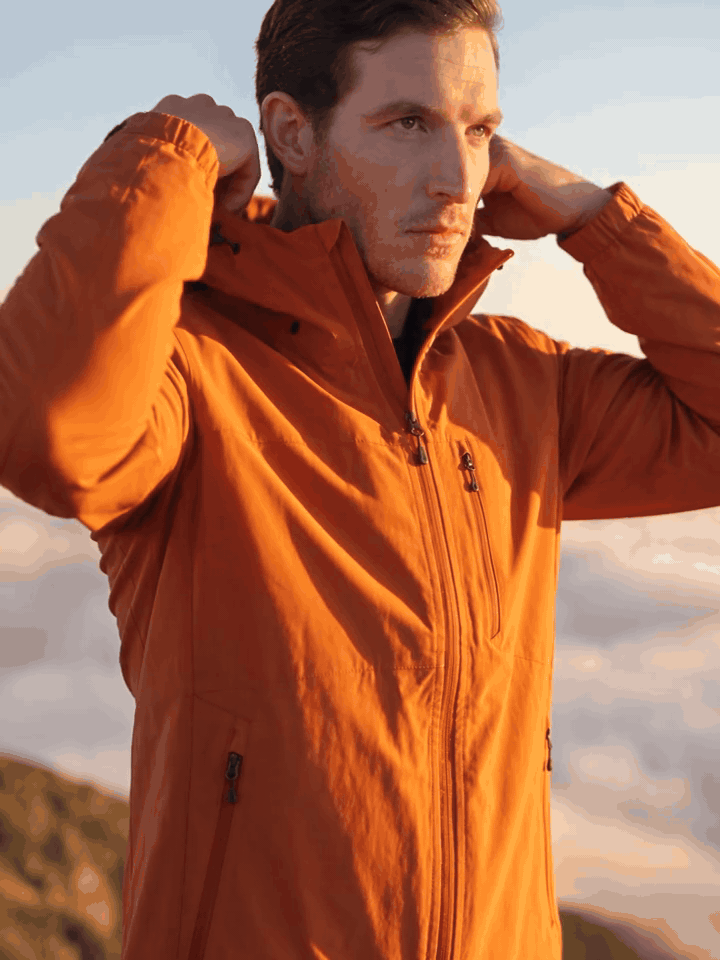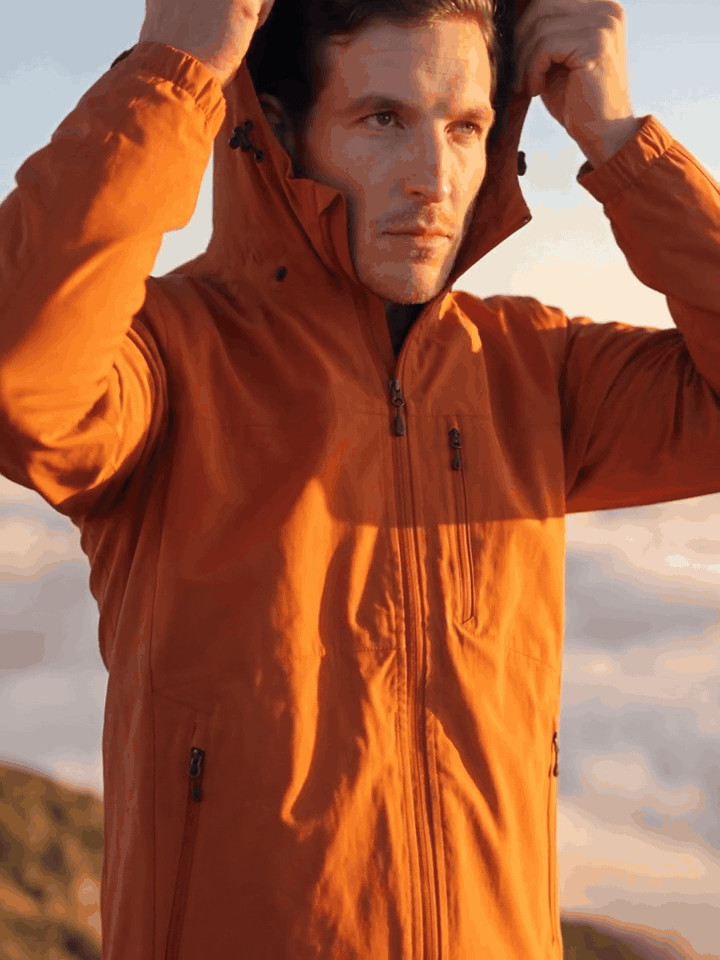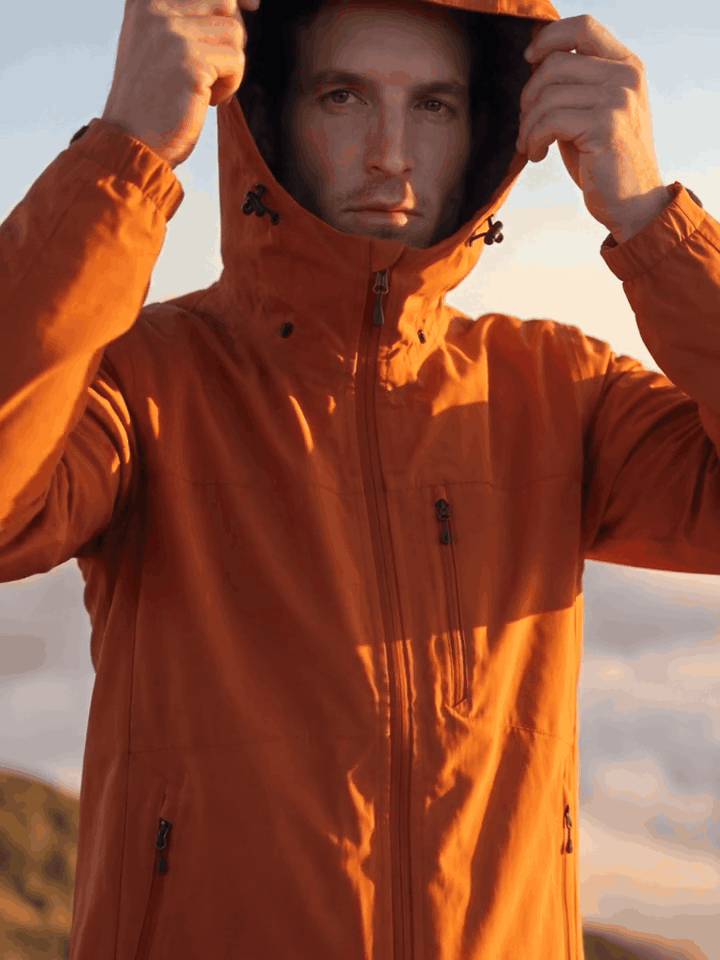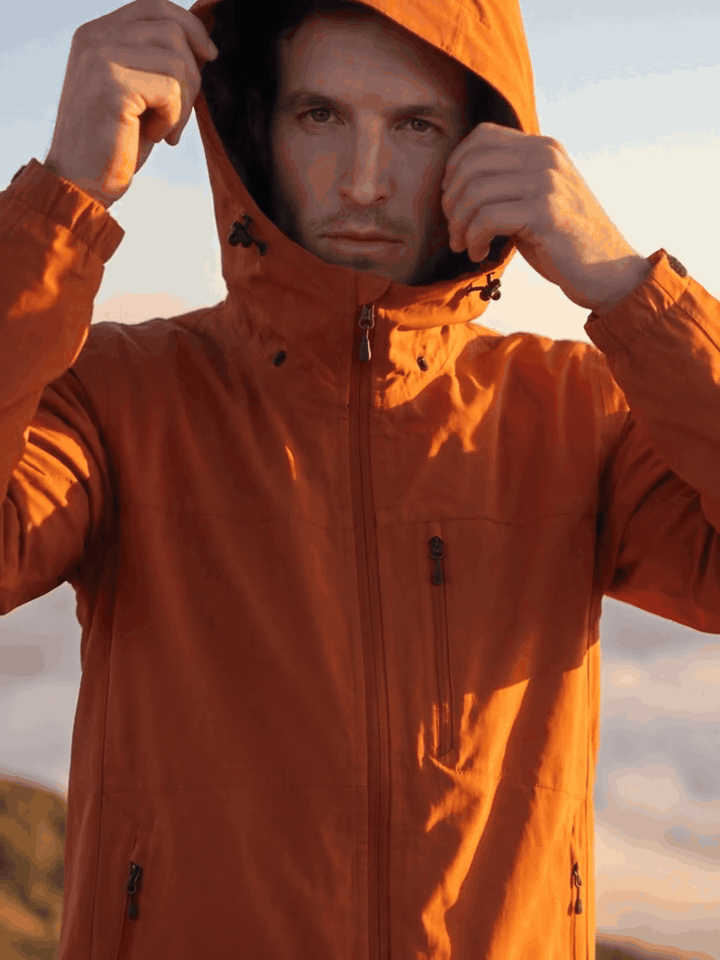
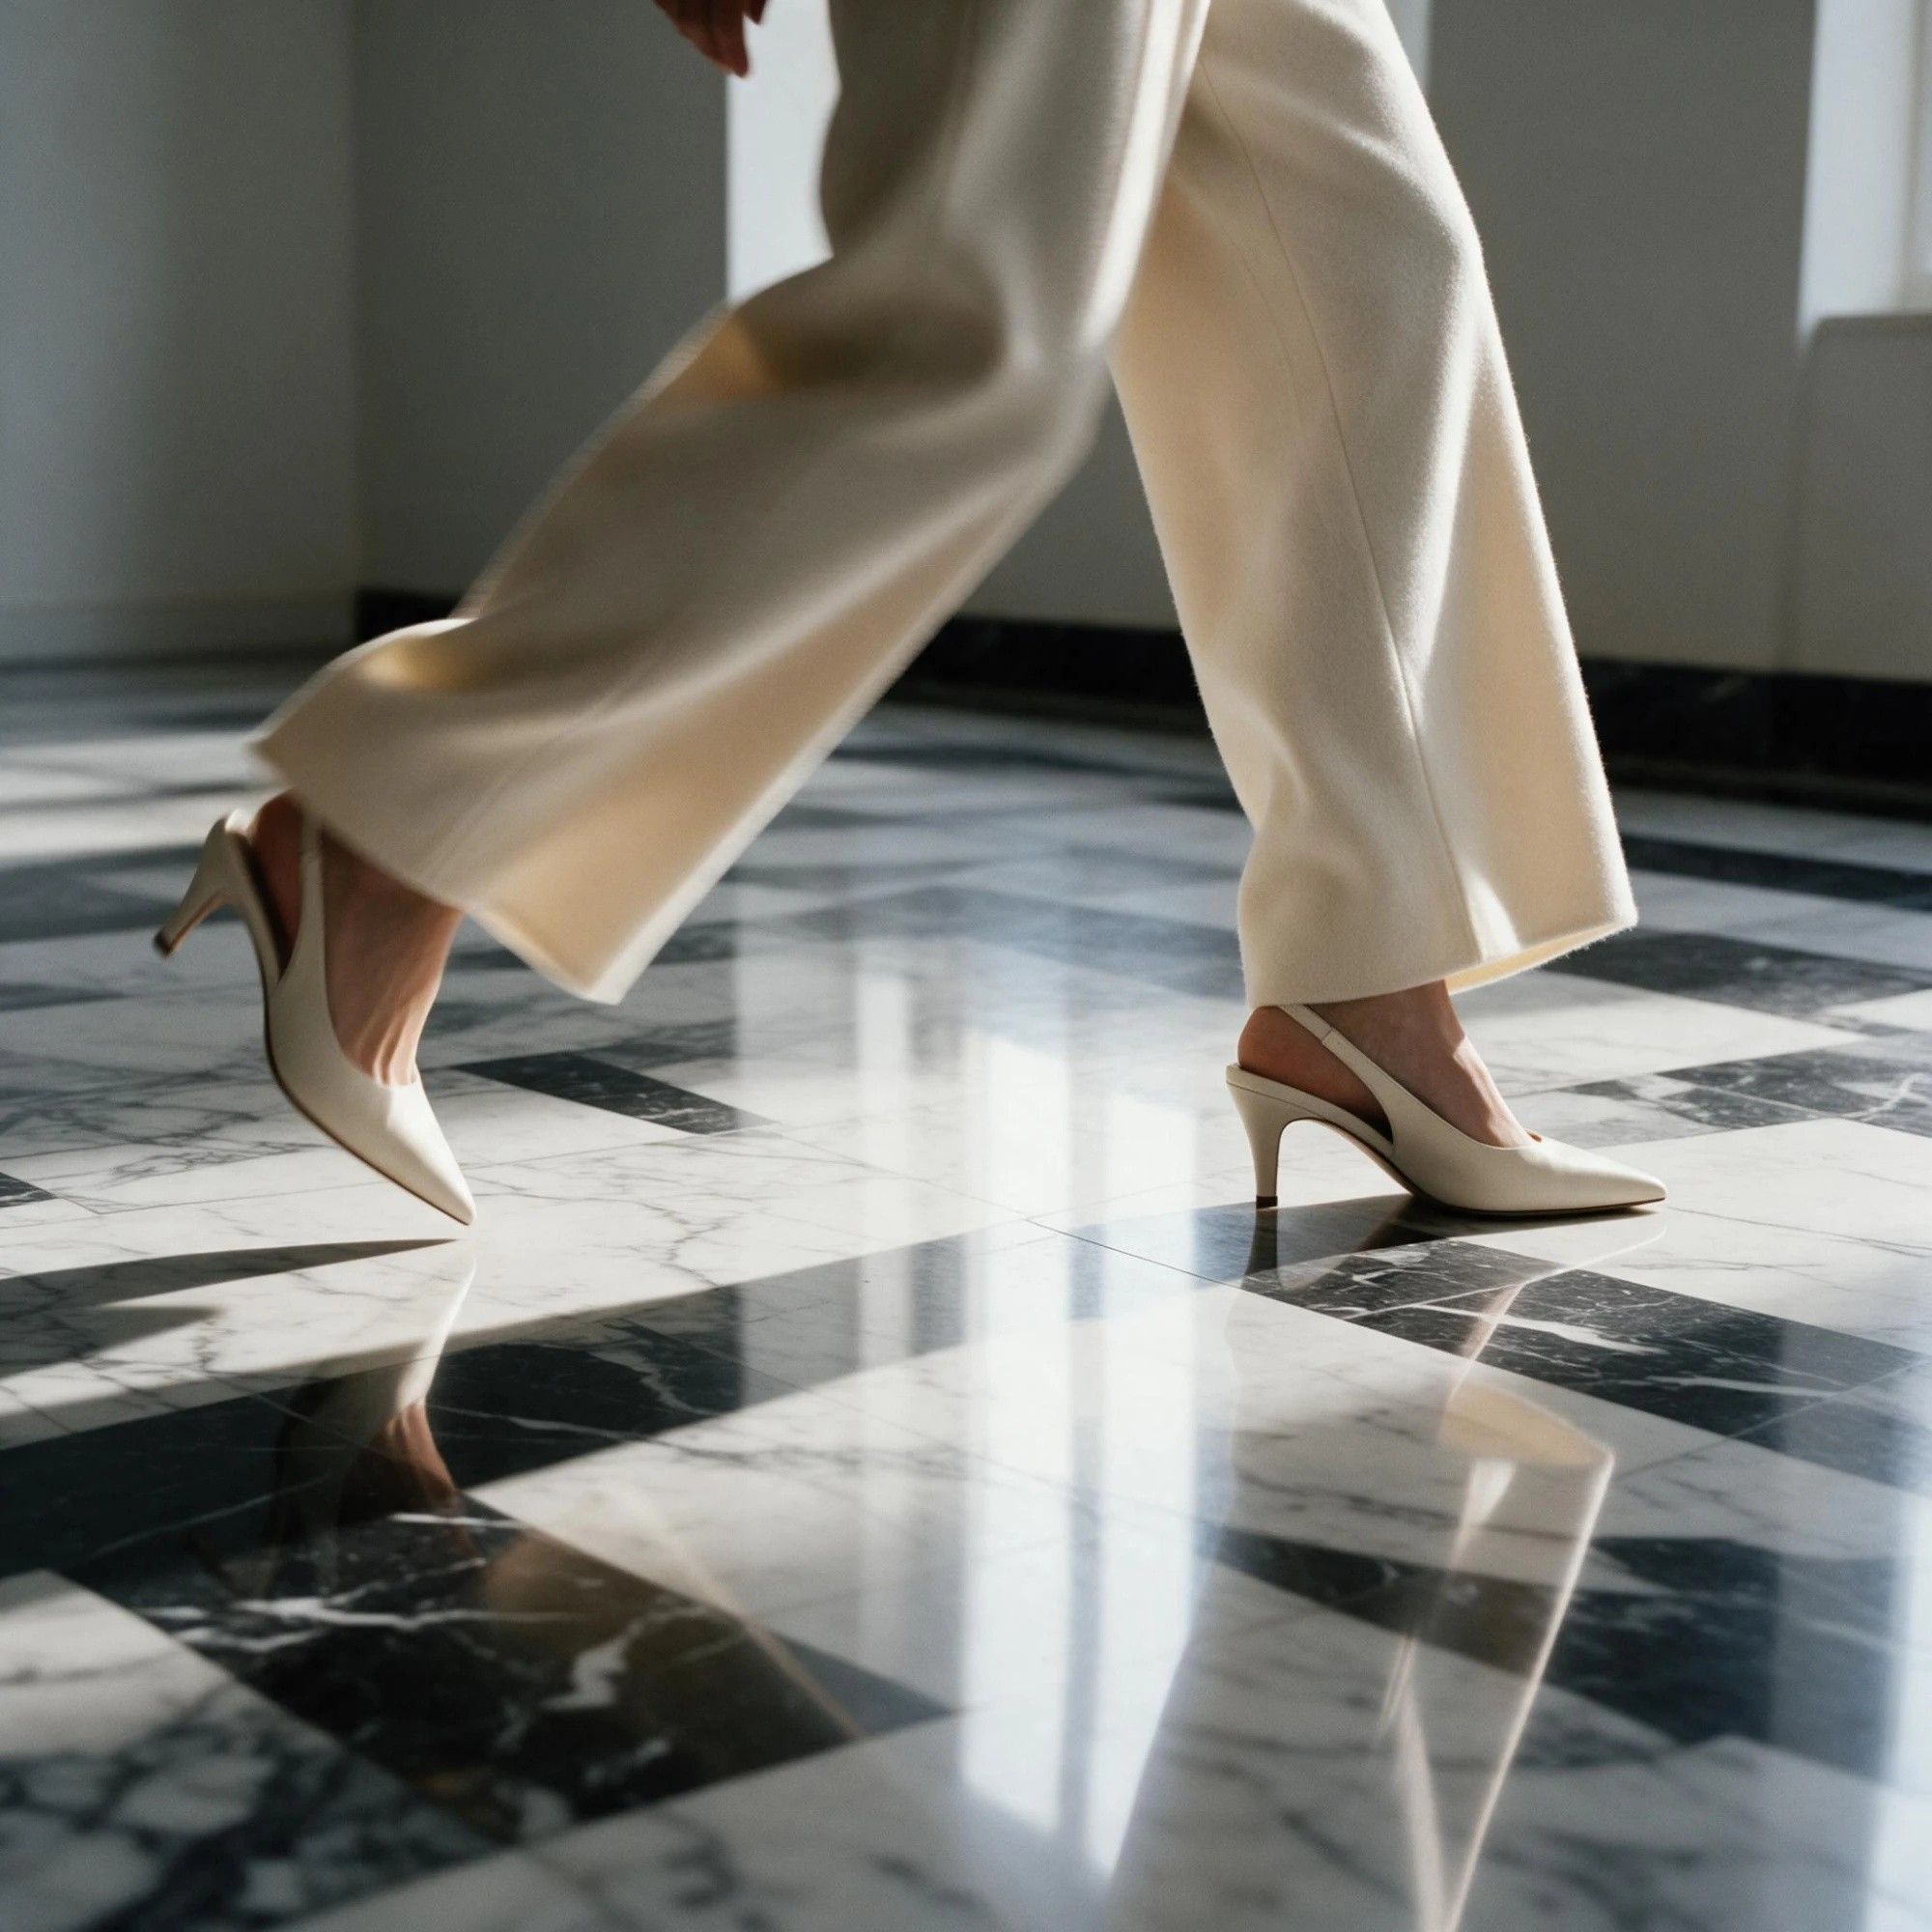
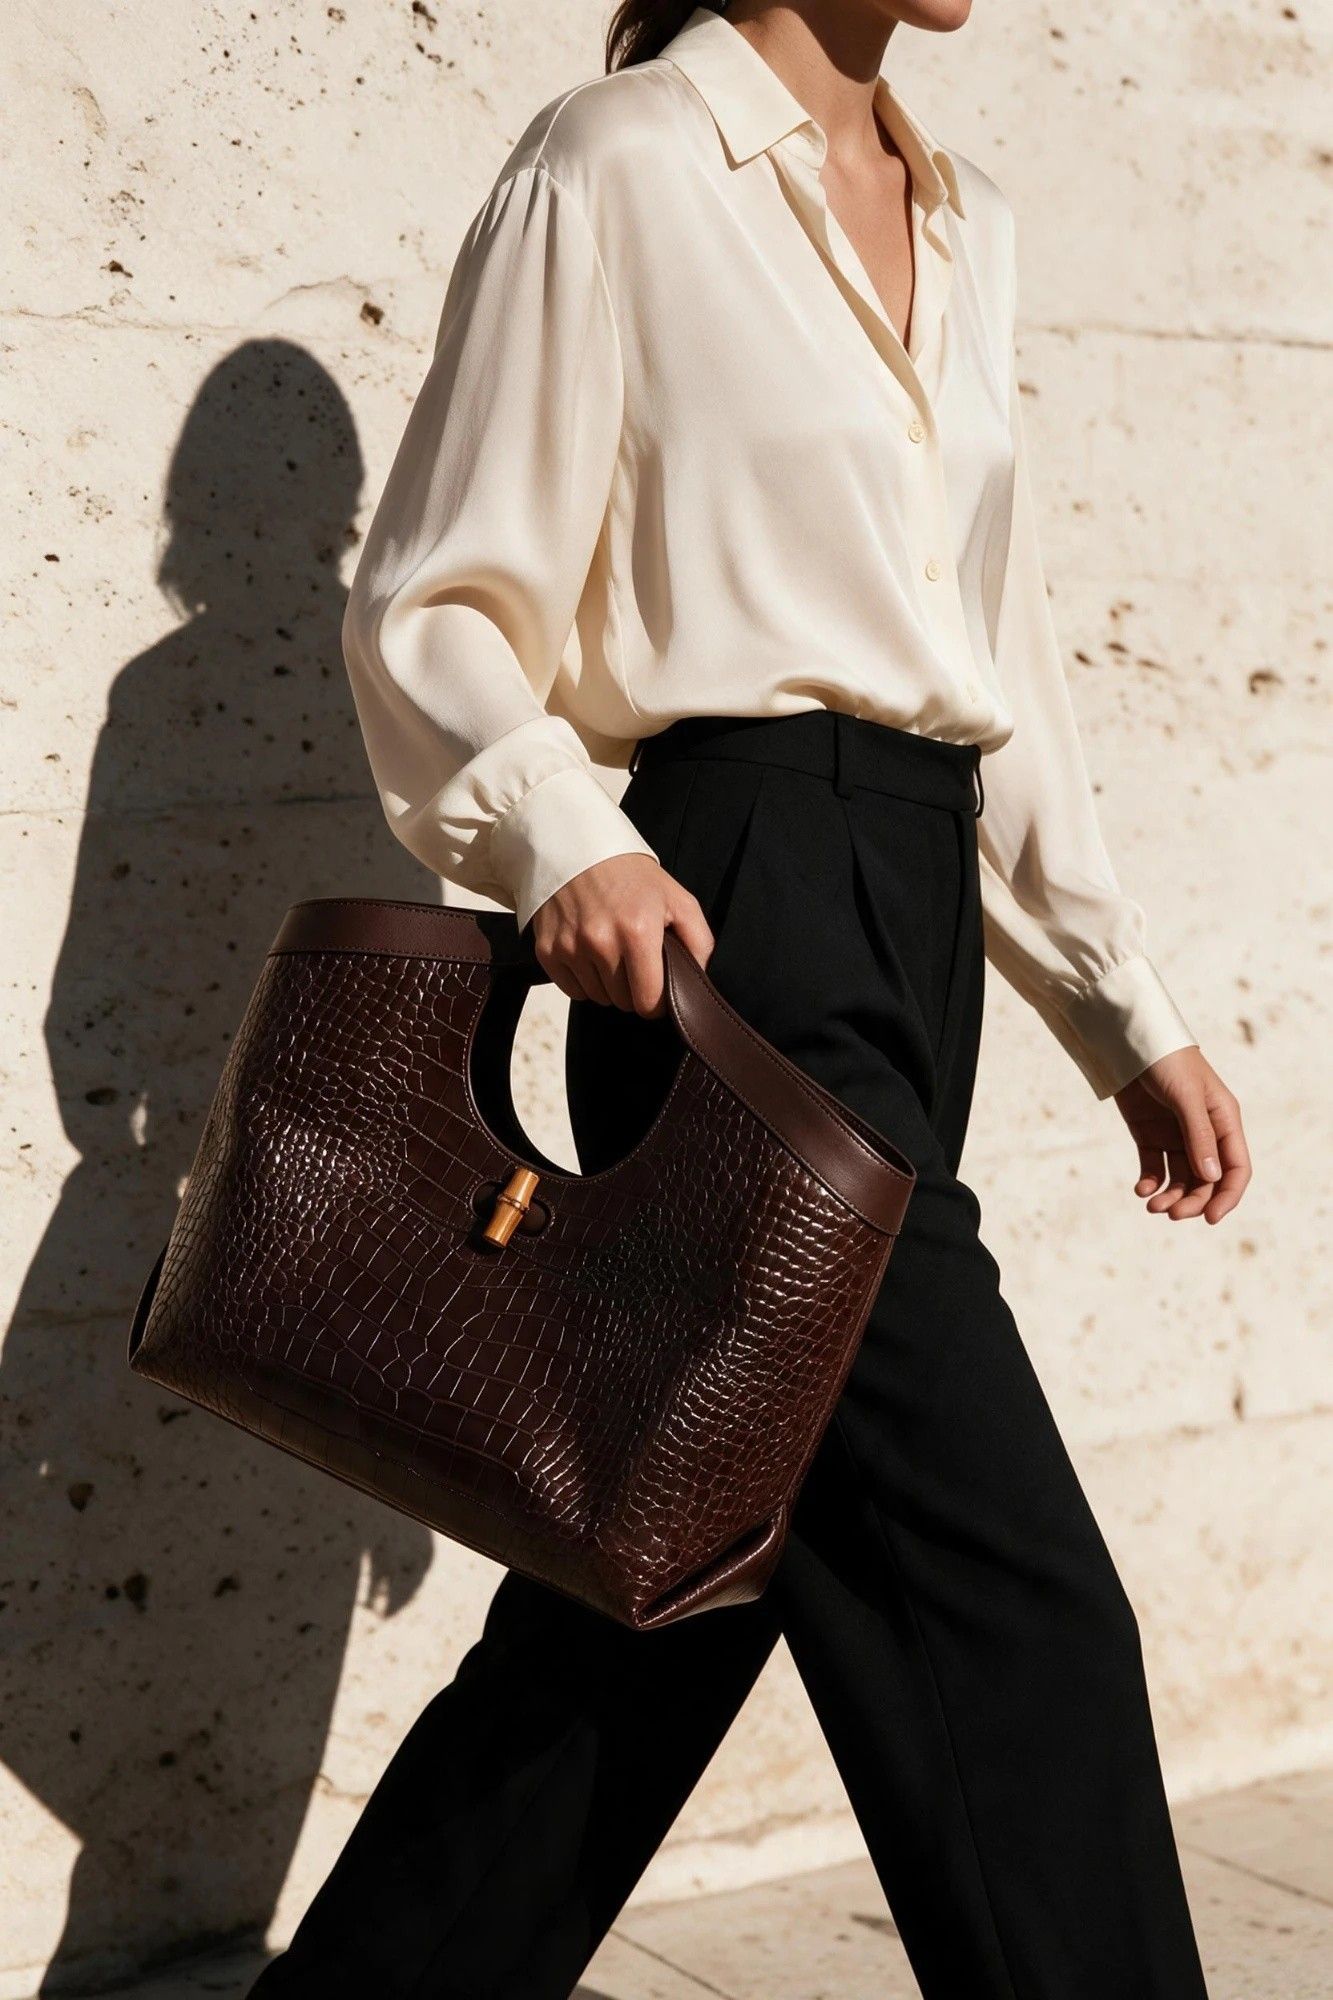
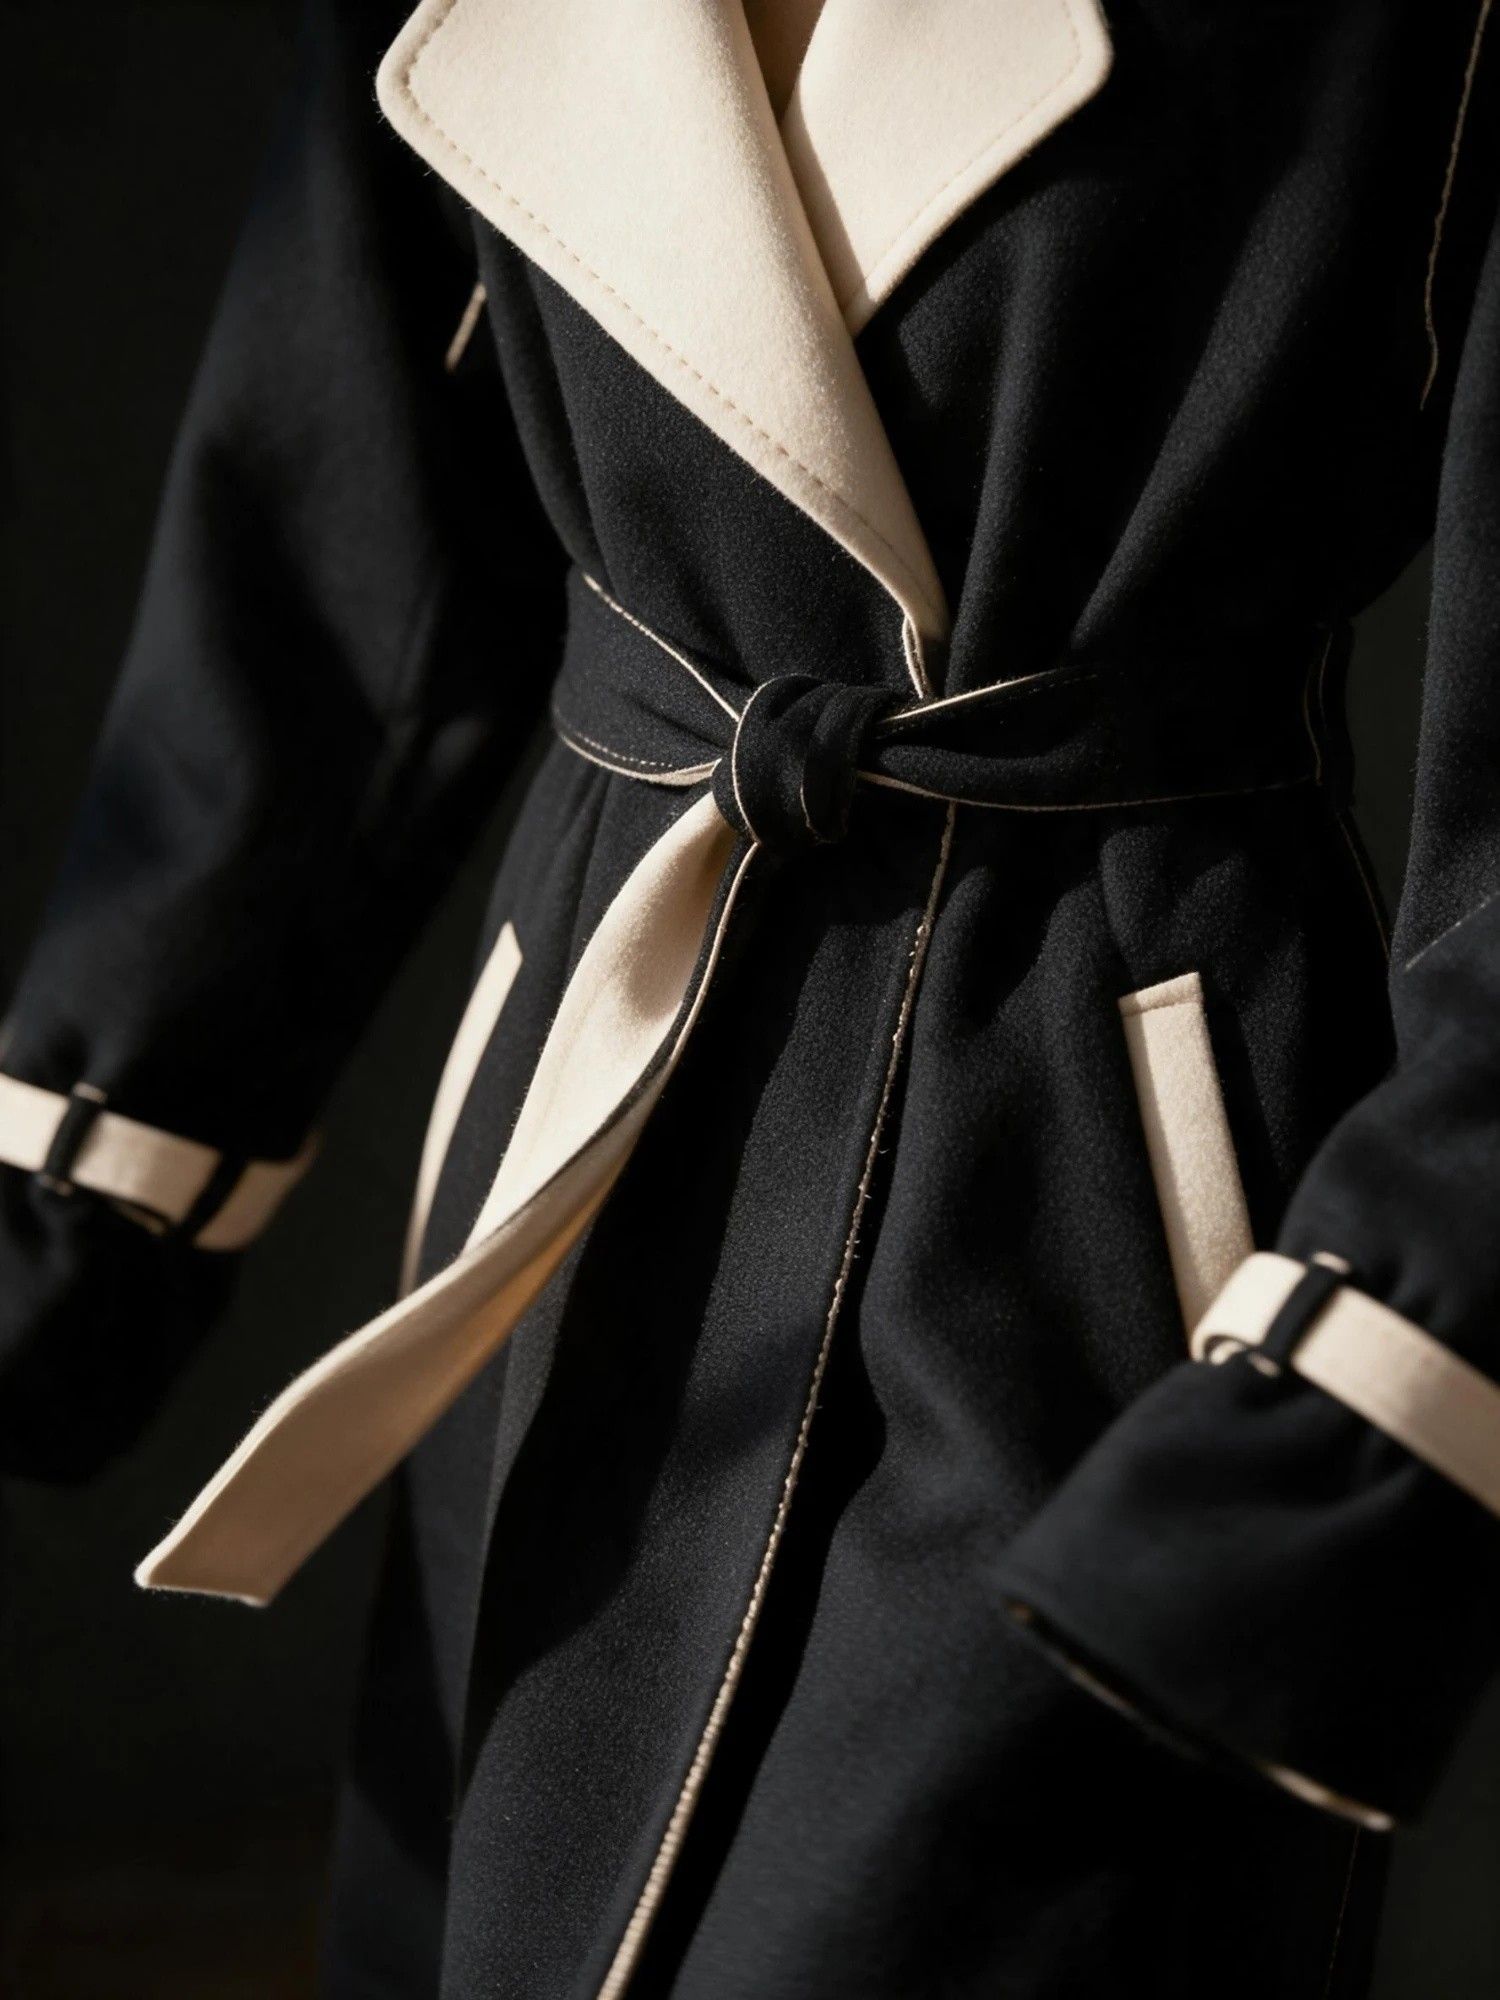
옷은 사진으로 찍기 쉽지만 잘 팔리지 않는다. 사진은 옷이 입혀진 모습을 보여줄 수 없기 때문이다. 다음은 영상이 만들어지는 방식, 즉 핏, 모델, 샷 구성, 그리고 움직임이 더하는 효과를 다룬다.
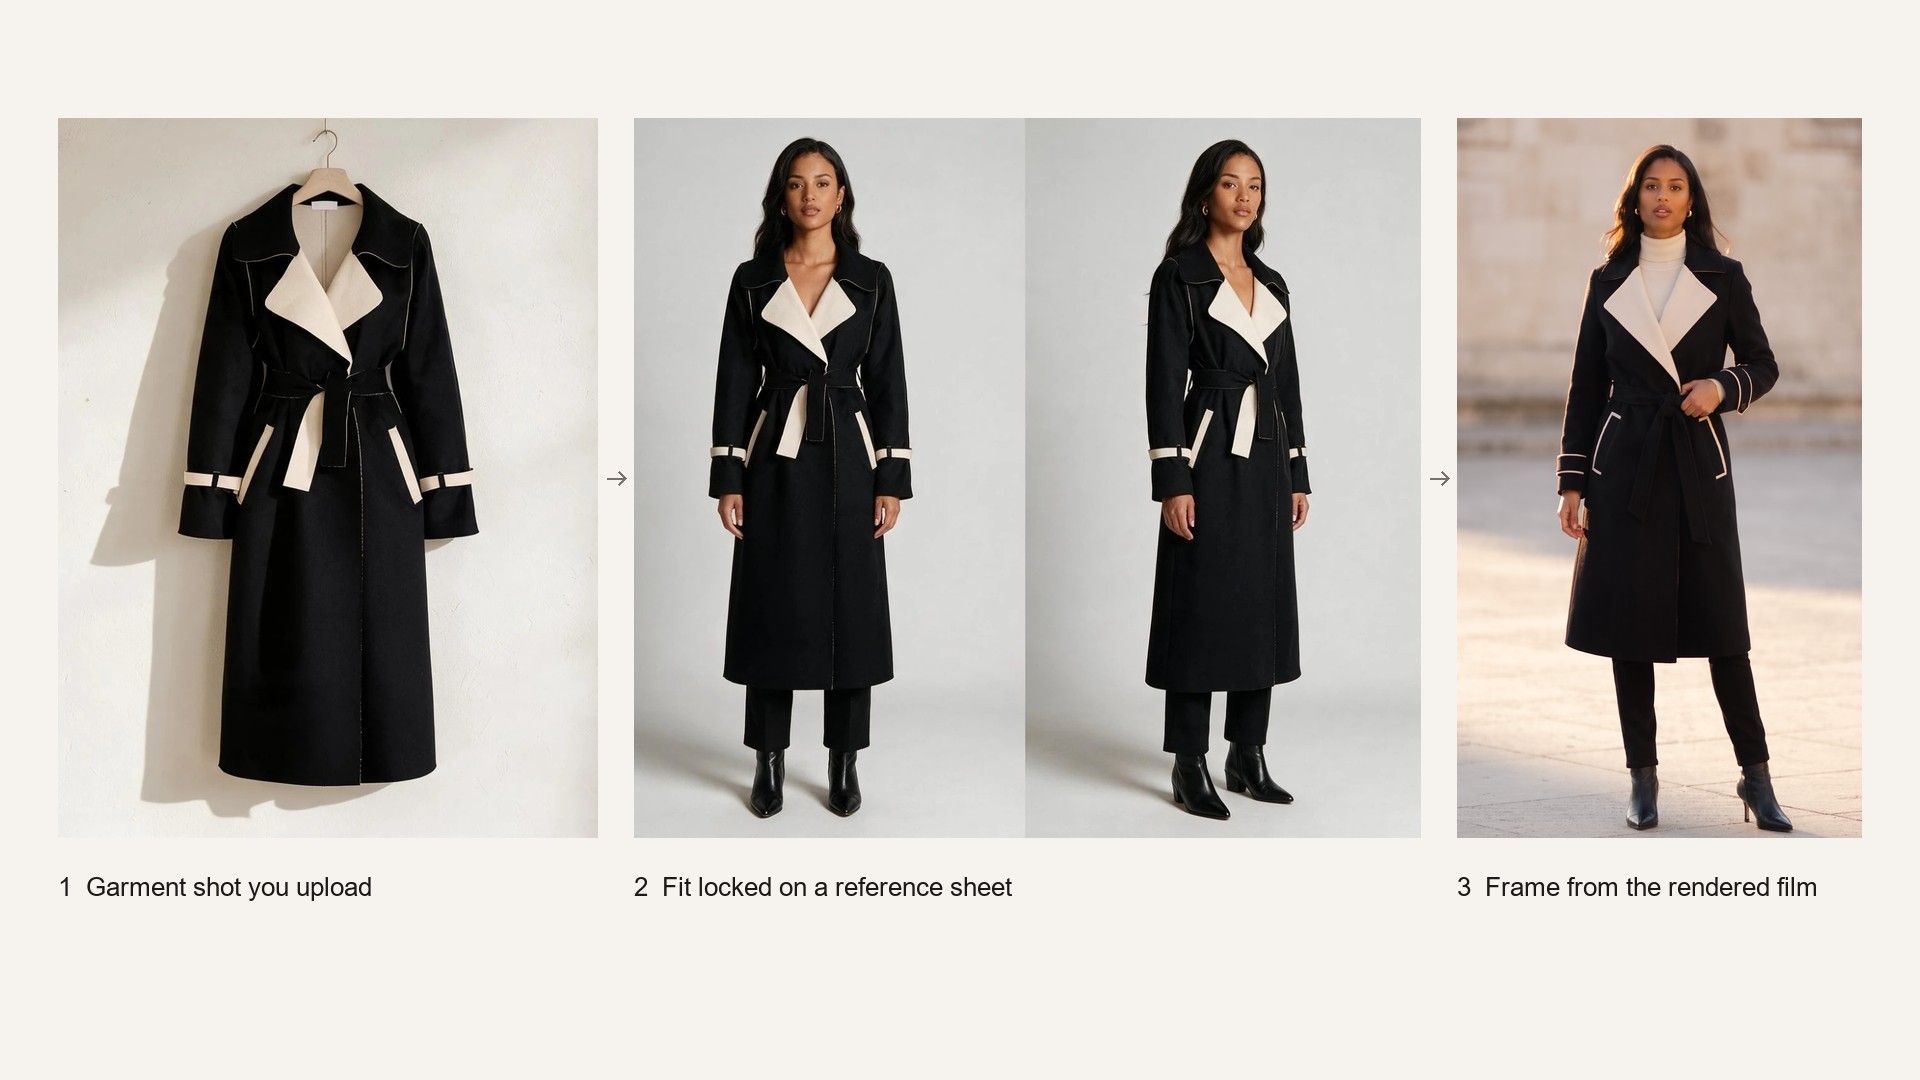
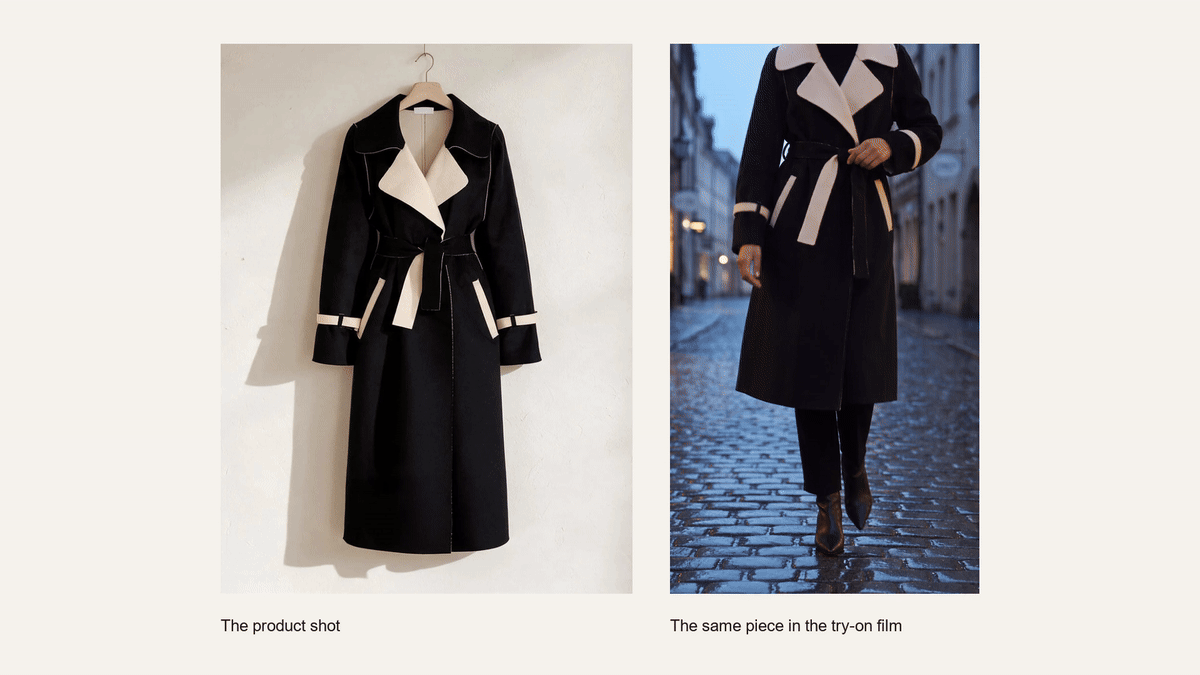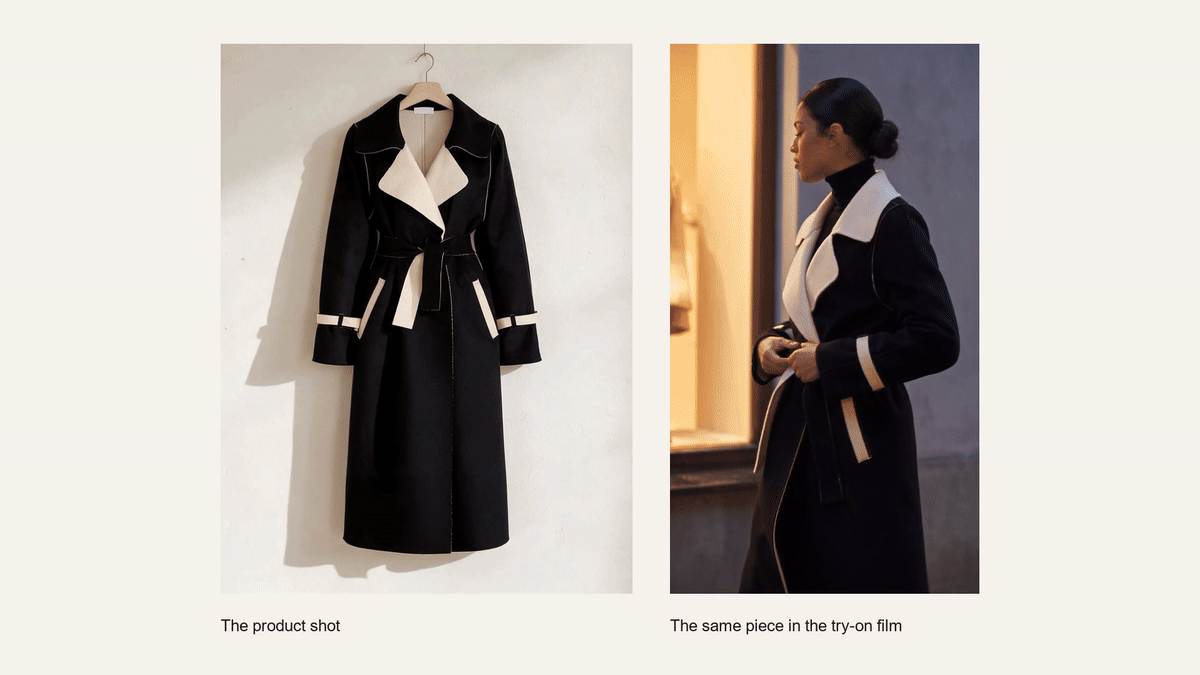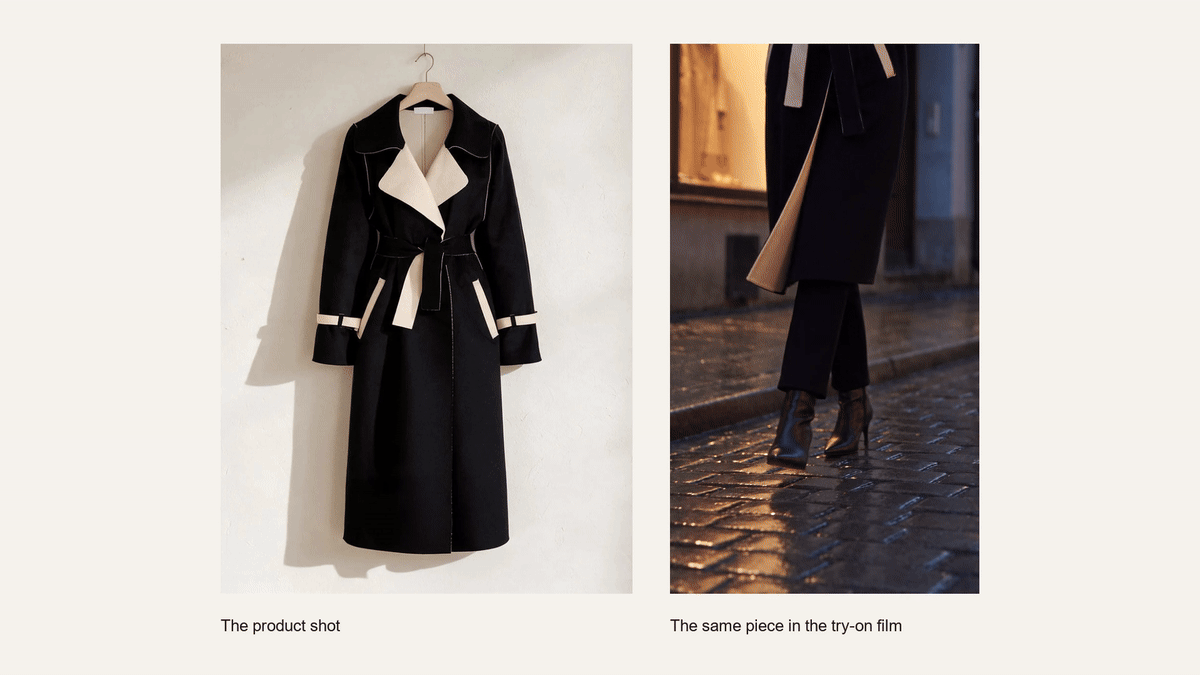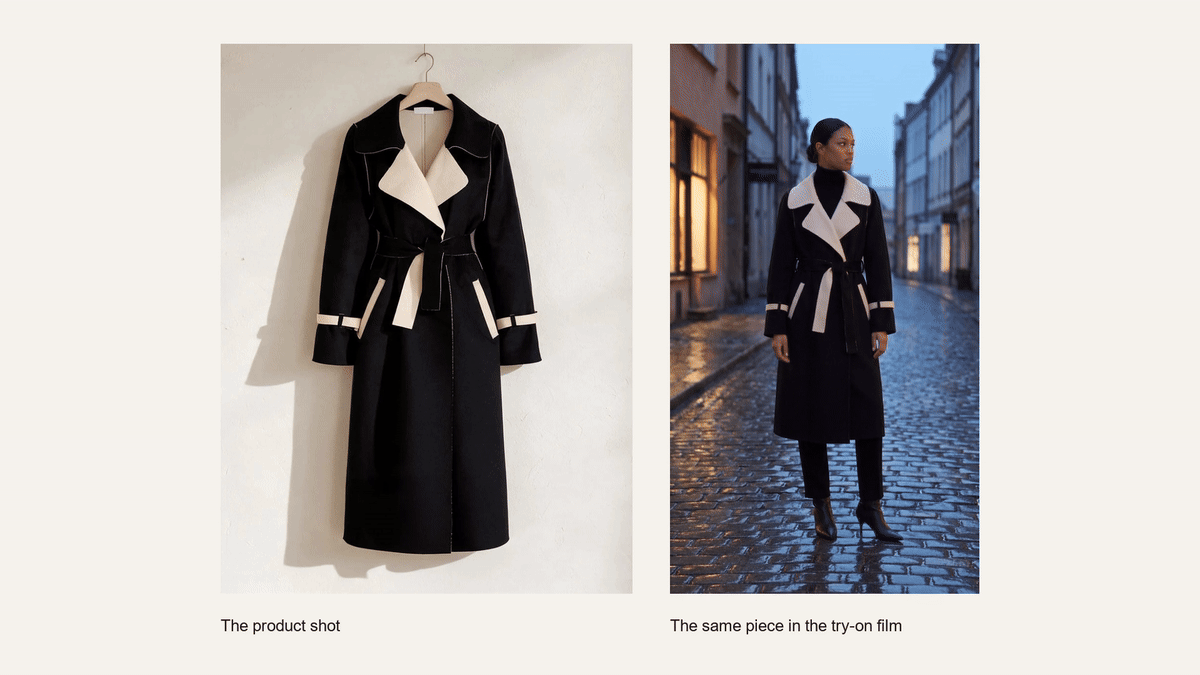
재킷과 니트는 떨어지는 방식이 같지 않고, 스트랩은 소매가 놓이는 위치에 자리하지 않습니다. 렌더링이 시작되기 전에 템플릿은 업로드한 항목의 구조와 착용 로직을 읽고, 제품과 모델 모두의 참조 시트를 만든 다음, 착용 스틸로 핏을 고정합니다. 영상은 이를 기반으로 렌더링되며, 프레임별로 즉흥적으로 만들어지지 않습니다.
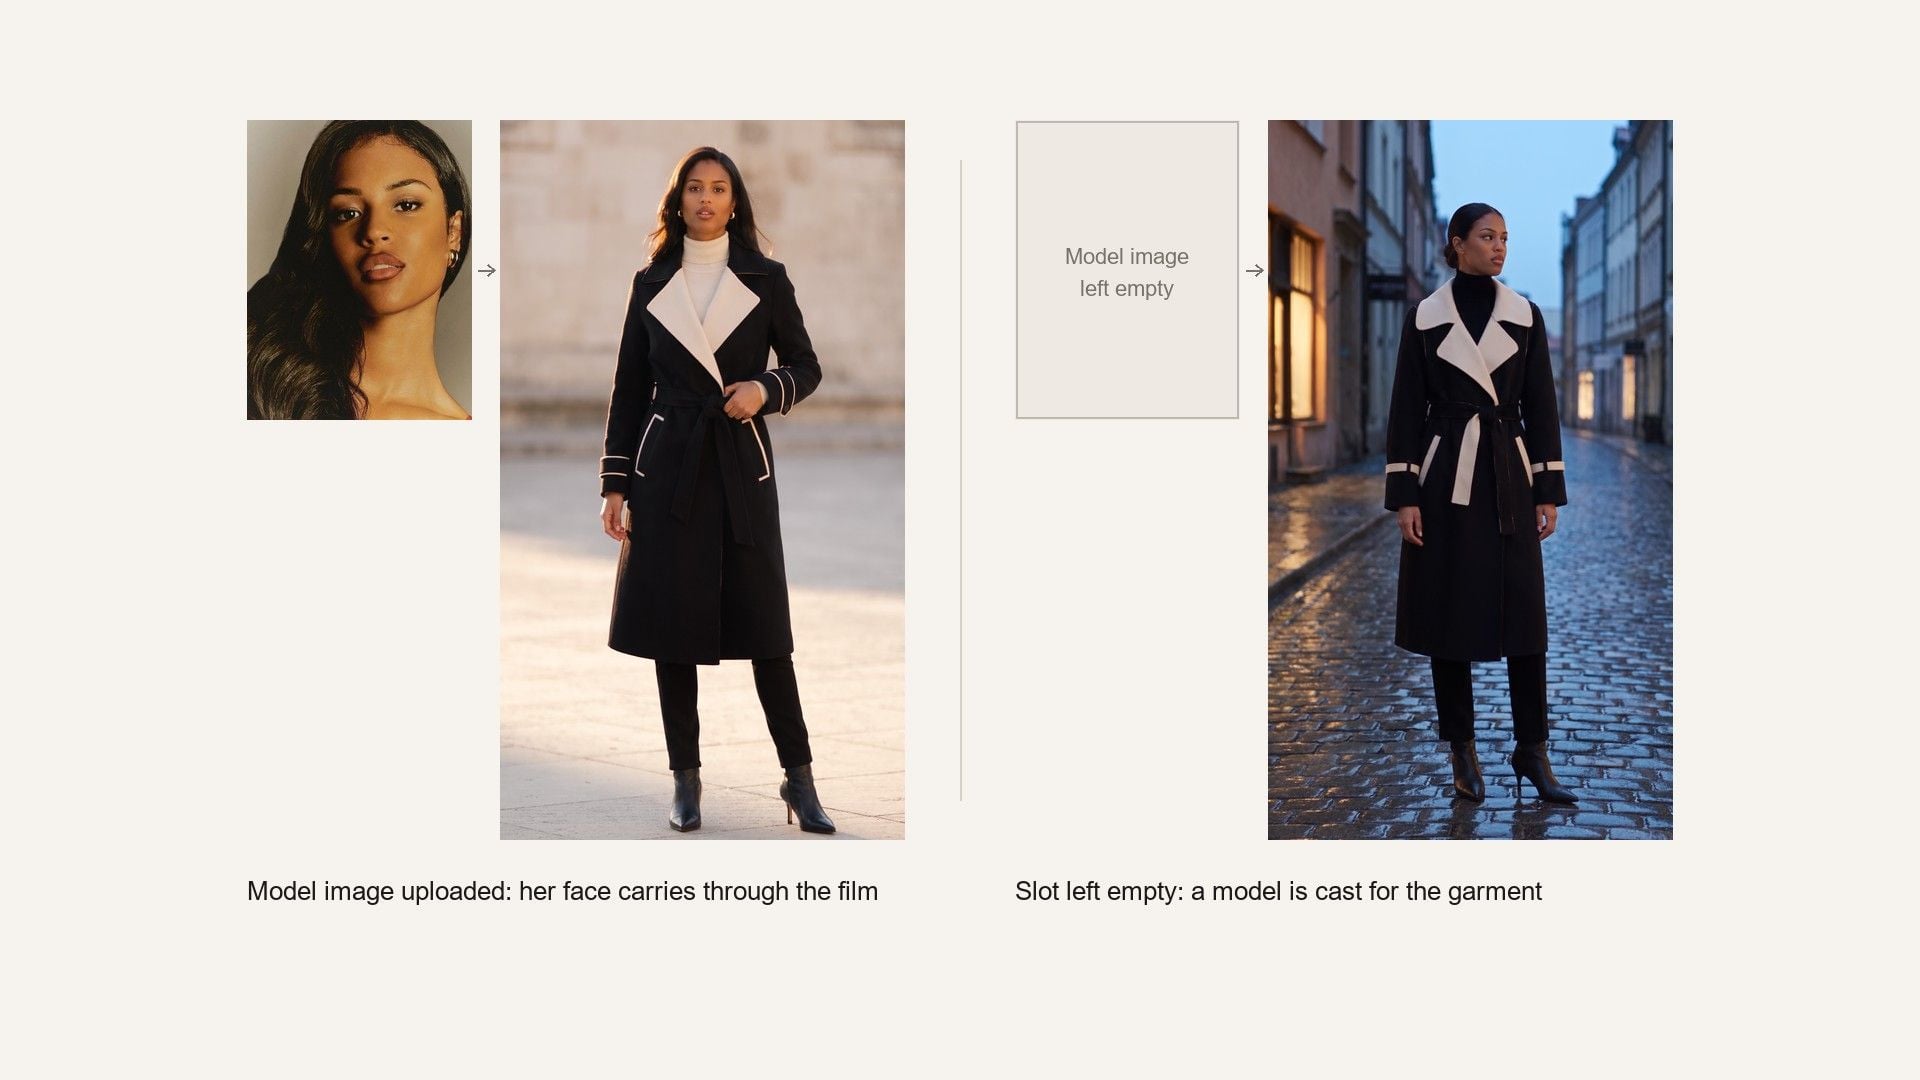
원하는 사람이 그 옷을 입은 사진을 업로드하면 그 얼굴이 필름 전반에 이어지며, 이것이 스무 개 제품에 걸쳐 한 시즌의 일관성을 유지하게 합니다. 슬롯을 비워 두면 대신 그 의상을 입을 모델이 캐스팅됩니다.
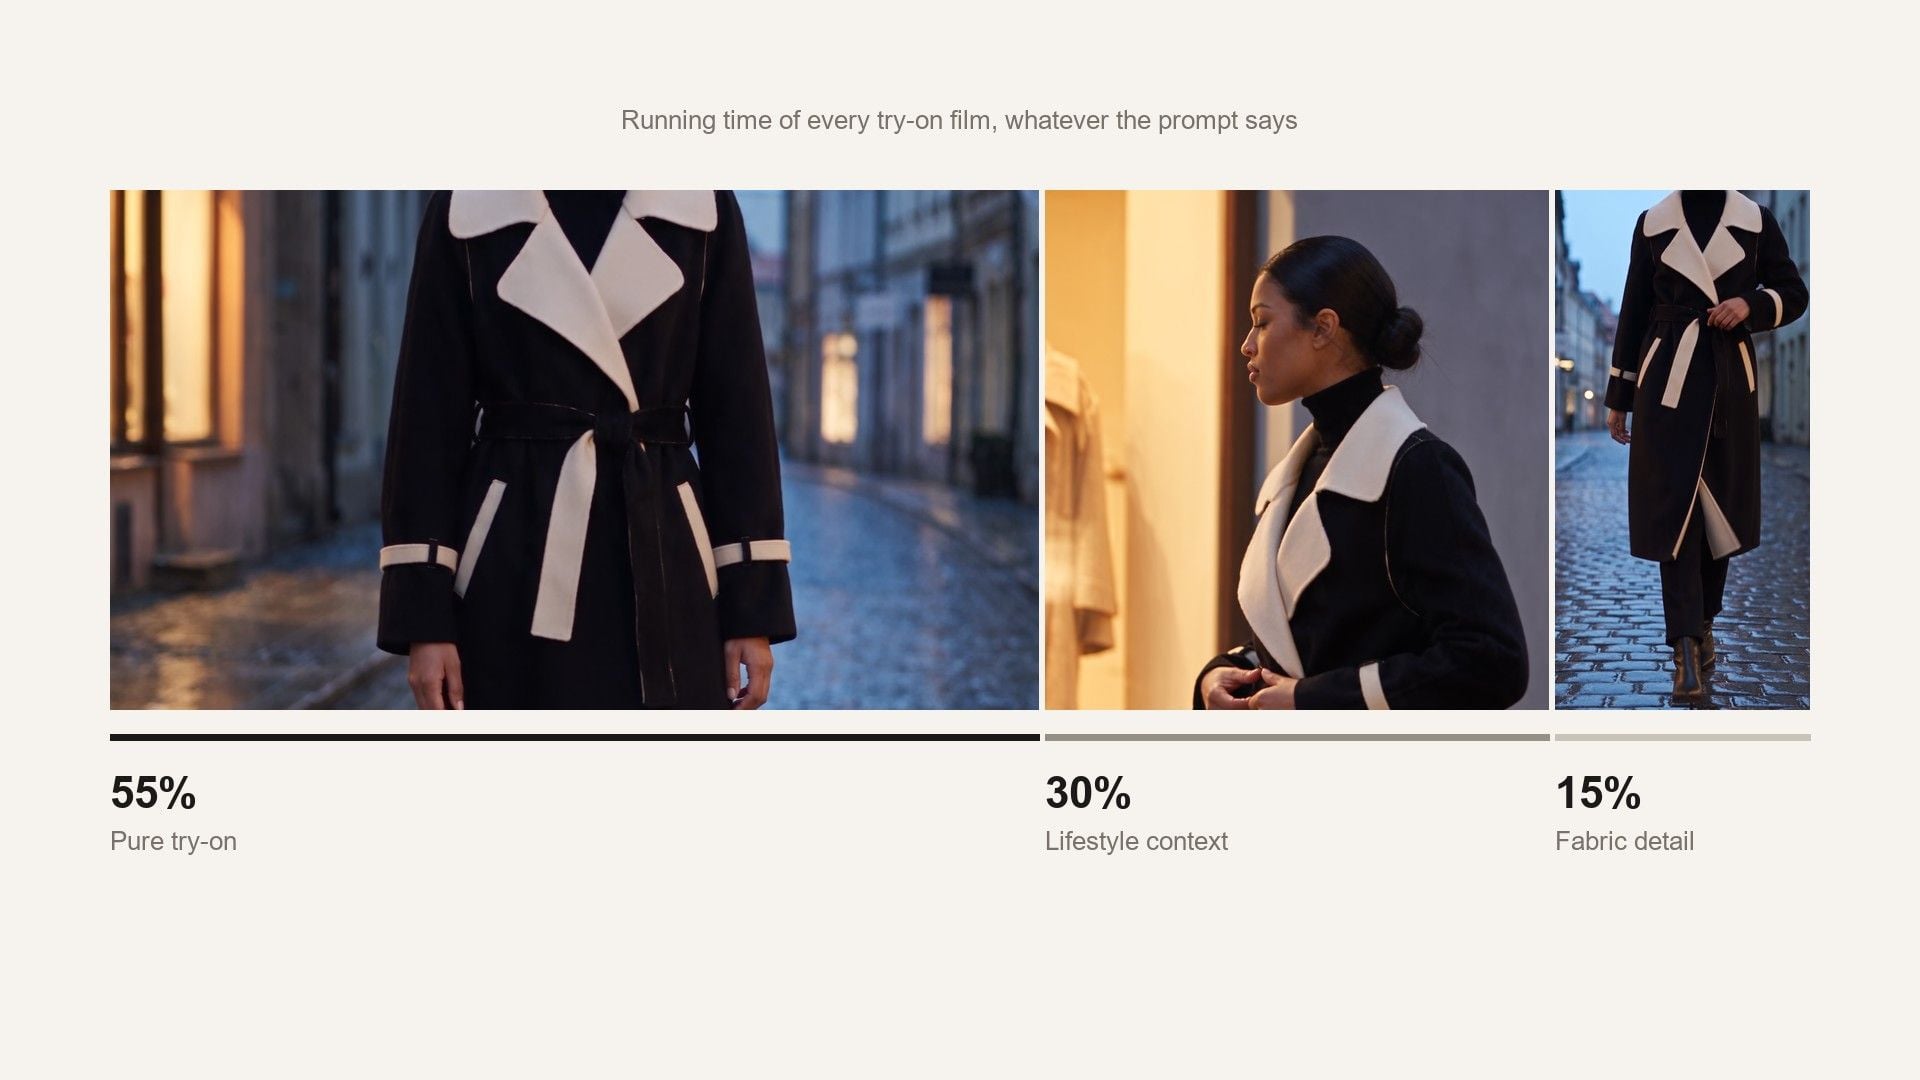
라이프스타일 영상은 만들기 쉽고 과해지기도 쉽습니다. 풍경에 시간을 쏟는 영상은 재킷을 팔지 못합니다. 템플릿이 샷 구성을 고정하므로 프롬프트로도 바꿀 수 없습니다. 러닝타임 대부분은 옷을 입은 모습이며, 이를 배치할 만큼의 맥락과 원단을 가까이 비추는 장면이 더해질 뿐입니다.
쇼퍼가 사진으로는 알 수 없는 궁금증은 무엇일까요? 누군가 걸을 때 밑단이 어떻게 떨어지는지, 그리고 원단이 표방하는 소재처럼 움직이는지입니다. 스틸 사진은 의류를 한 가지 포즈로 고정하지만, 영상은 움직임을 보여줍니다. 그래서 런은 기본적으로 세로형인 4~15초 분량의 영상을 제공하며, 룩북에 필요할 때는 네 가지 다른 형태로도 제공합니다.
제품을 평평하게 놓거나 옷걸이에 걸어 깔끔하게 한 장 촬영해 주세요.
누가 입고 있는지, 어디서인지, 그리고 후드를 고쳐 쓰는 것처럼 보여줄 만한 동작이 있는지 말해 주세요. 특정 인물이 중요하다면 얼굴도 업로드해 주세요.
길이와 모양을 설정한 다음 실행하세요. 세로가 이미 선택되어 있습니다.
업무에 가장 가까운 탭을 선택하세요.
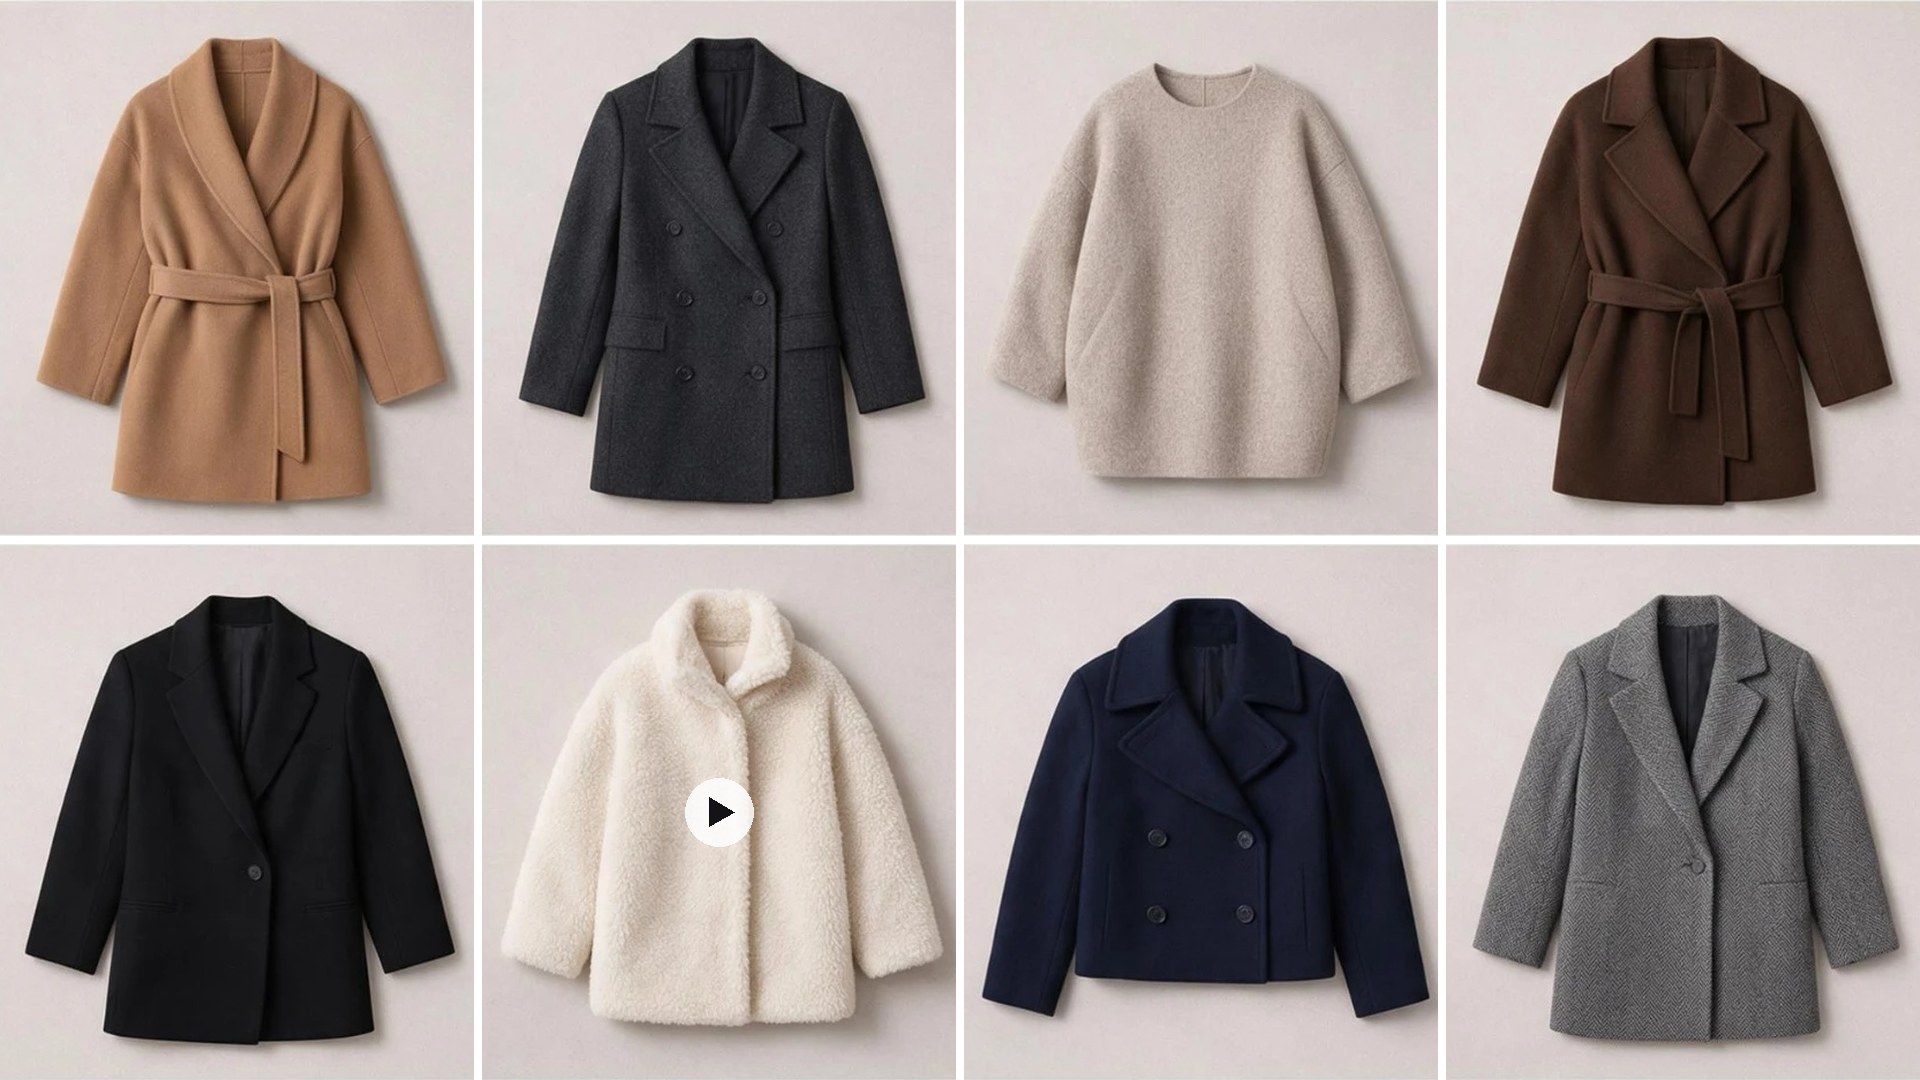
룩북 촬영일에는 대표 제품을 담고, 모델을 8시간만 섭외했기 때문에 드롭의 나머지 제품은 플랫레이로 온라인에 올라간다. 남은 SKU를 템플릿에 적용하면 전체 제품군이 움직이기 시작한다. 촬영할 가치가 없었던 제품은 보통 페이지에 정보가 가장 적은 제품이다.
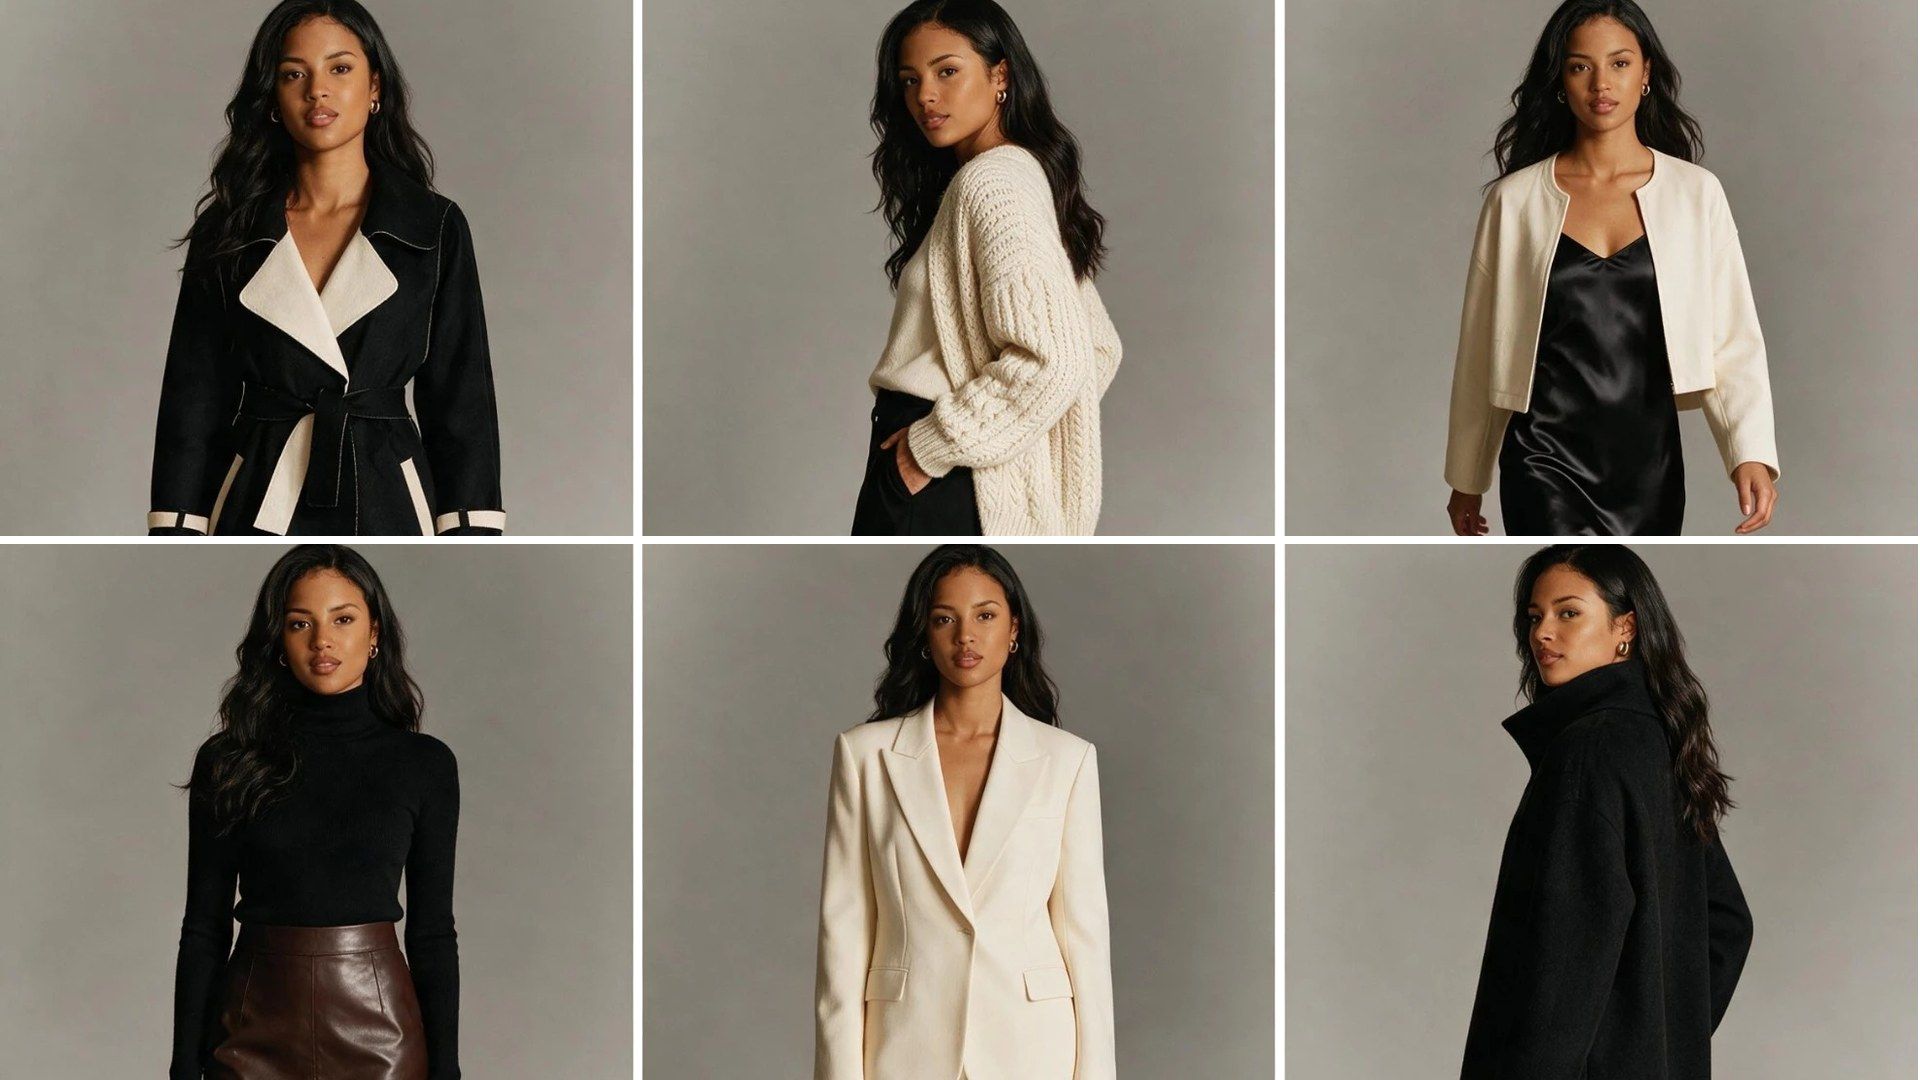
카테고리 페이지는 똑같은 제품 스틸 이미지로 가득한 벽과 같고, 그중 상당수는 같은 조명을 쓴 같은 도매업체에서 온 것입니다. 그 페이지에서 다른 누구도 갖지 못한 단 하나는 바로 그 옷을 착용한 몇 초의 영상입니다. 이 영상은 길이와 드레이프도 보여주는데, 대부분의 의류 반품이 결국 여기서 비롯됩니다.
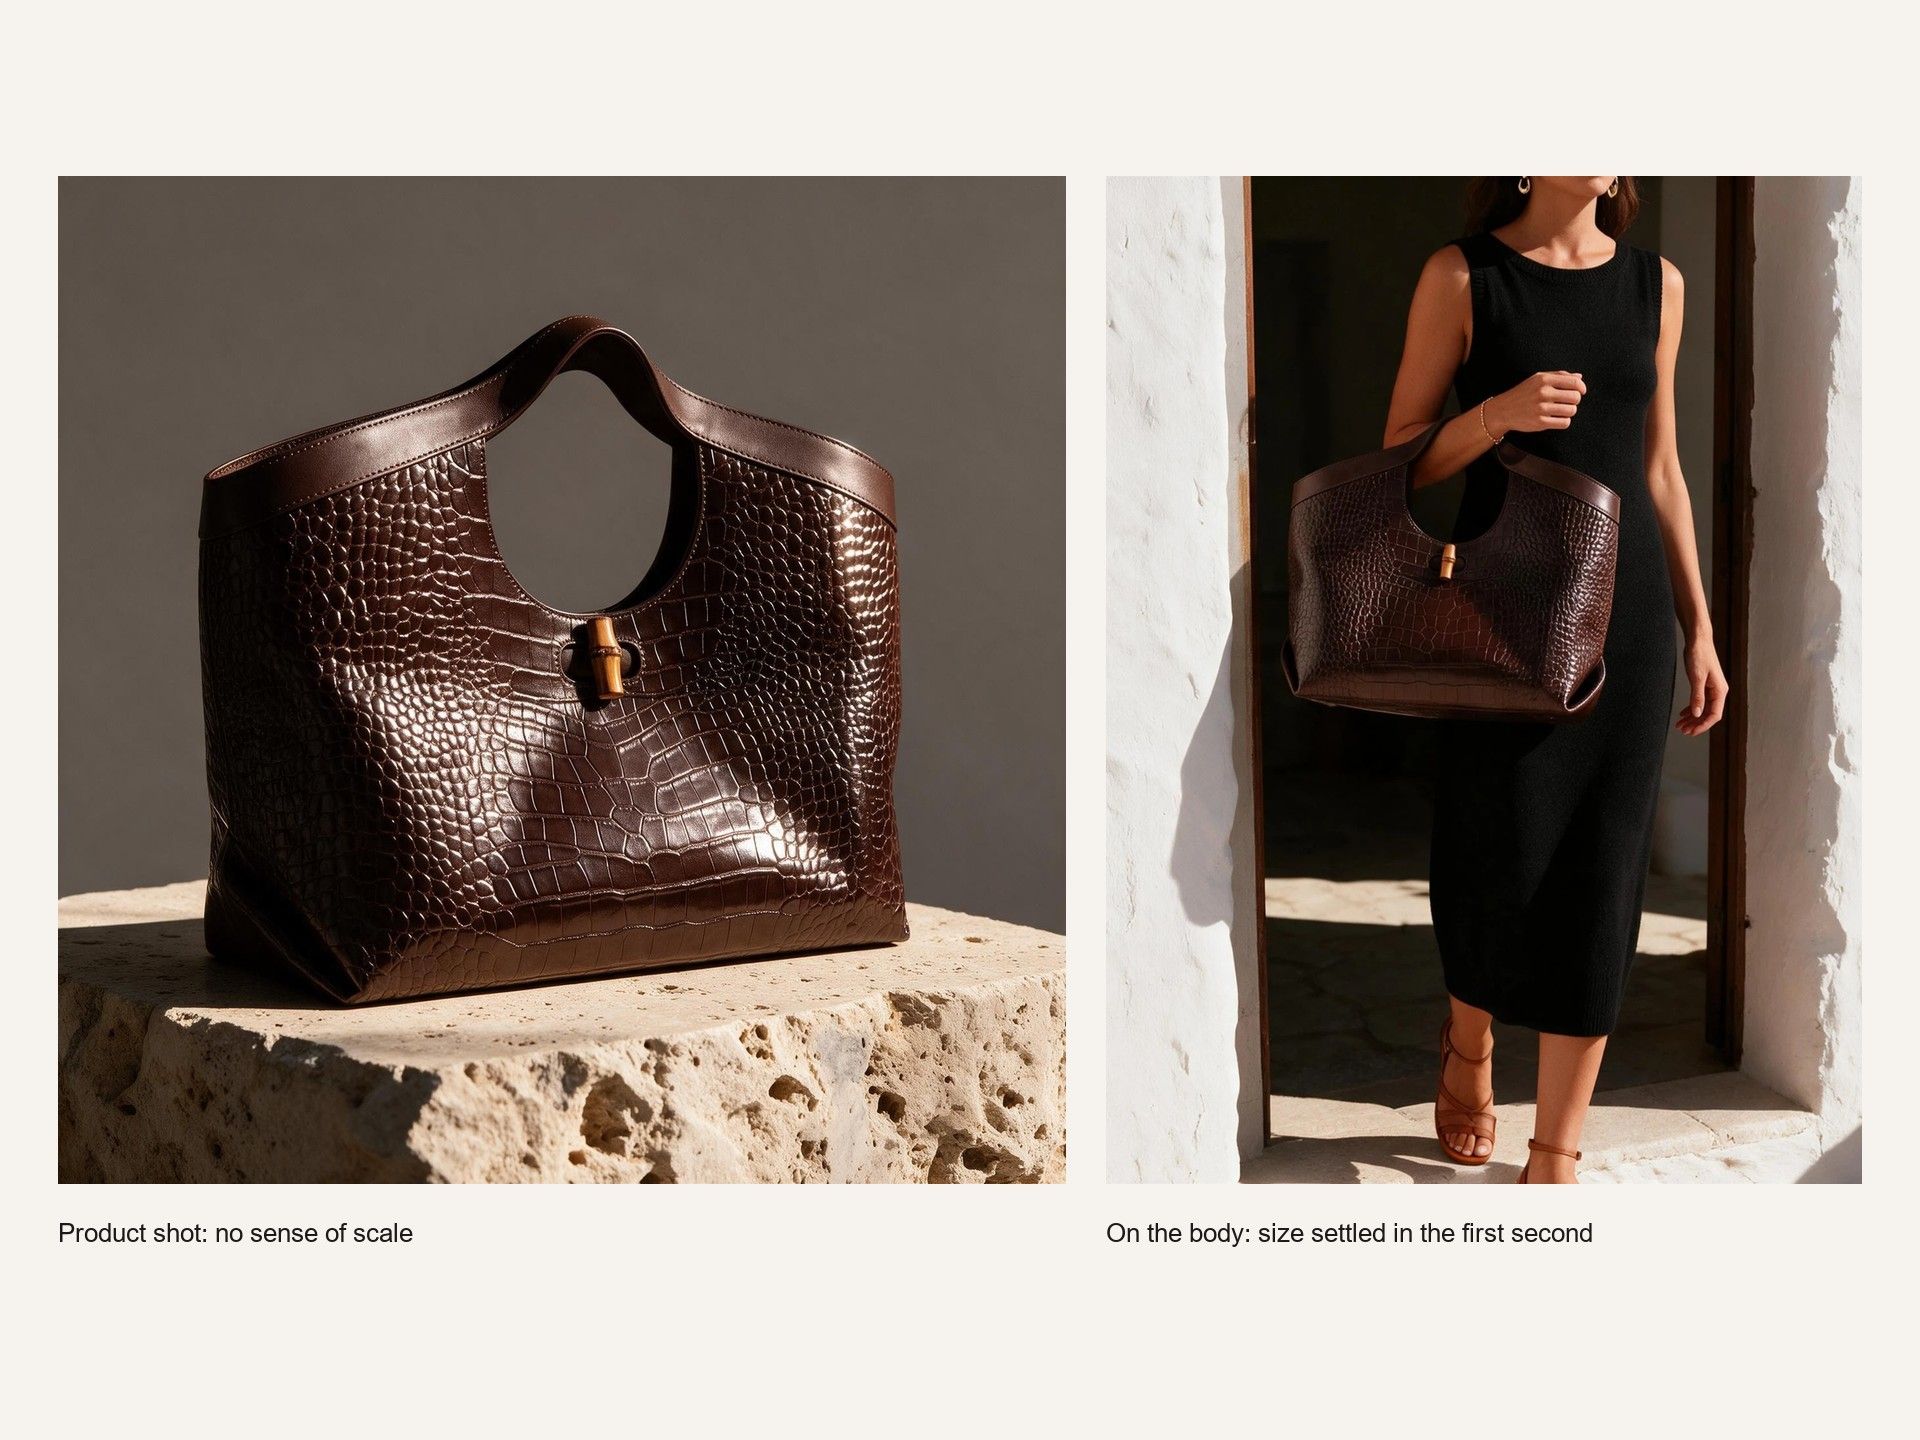
반지든 가방이든 제품 사진만으로는 크기를 가늠하기 어렵고, 쇼핑객이 가장 먼저 묻는 것도 실제로 얼마나 큰지입니다. 소형 제품 카탈로그를 위해 손 모델을 고용하는 비용은 좀처럼 본전을 뽑지 못합니다. 착용 영상은 첫 1초 만에 크기 문제를 해결하는데, 이는 사람들이 무언가를 보는 시간과 대략 일치합니다.
캠페인 방향을 설득할 때는 볼 수 있는 무언가가 있으면 더 쉽습니다. 무드보드는 클라이언트에게 상상하라고 요구하죠. 의상 한 벌과 브리프만 있으면 회의에서 반응할 수 있는 영상이 마련됩니다. 방향이 잘못됐다면 촬영을 예약하기 전에 알아차리는 것이 가장 비용이 적게 드는 시점입니다.
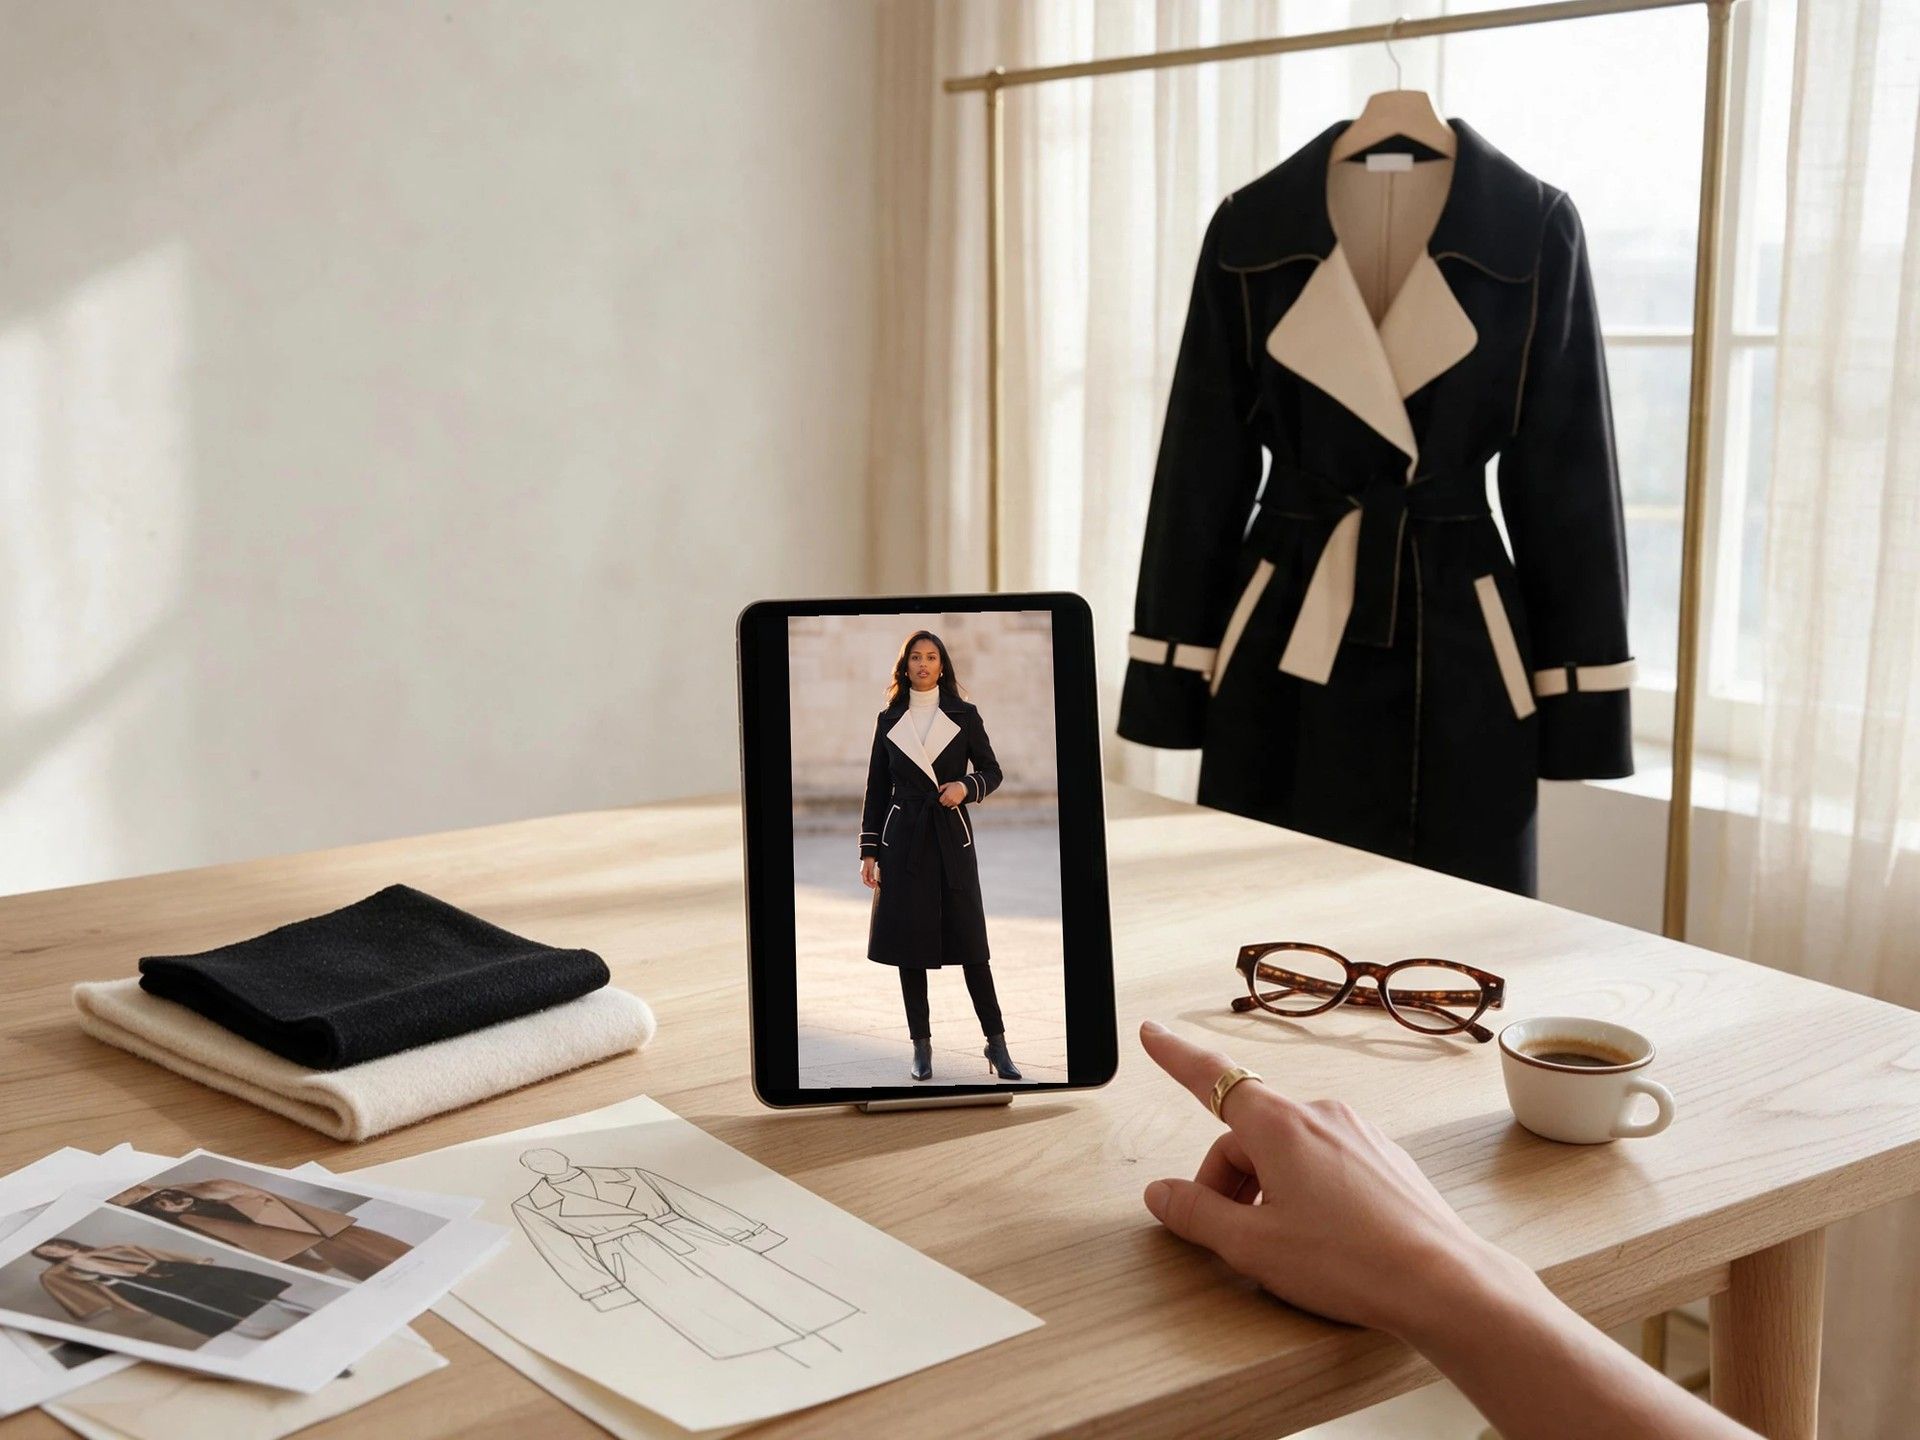
제품 사진에서 생성된, 의류를 착용한 모습의 짧은 영상입니다. 모델을 촬영하는 대신 제품 사진을 사용합니다. 의류 사진과 누가 입어야 하는지 설명하는 한 줄을 입력하면, 모델이 핏을 계산하고 영상을 렌더링한 뒤 동영상 파일을 반환합니다.
둘 다 되고, 마네킹도 그렇다. 중요한 것은 옷의 형태가 분명히 드러나는 것이다: 솔기, 밑단, 여밈이 어디에 있는지. 구겨진 플랫 레이는 같은 옷의 행거 샷보다 핏 단계가 활용할 정보가 적다.
이 템플릿은 순수 착용 장면 55%, 라이프스타일 맥락 30%, 원단 디테일 15%를 목표로 하므로, 4초짜리 컷조차 대부분의 시간을 착용된 의류에 할애합니다.
4에서 15까지의 정수 초입니다. 폼은 8로 열리며, 이는 템플릿 자체 예시가 렌더링된 길이입니다.
가격은 길이와 해상도에 따라 달라집니다. 720p에서 4초 클립은 약 $1.76, 10초는 약 $3.58, 전체 15초는 약 $5.09입니다. 렌더링이 실패하면 비용이 부과되지 않습니다.
가방, 모자, 주얼리는 의류와 동일한 단계를 거칩니다: 사진에서 인식하고, 모델에 피팅한 다음, 촬영합니다. 상자에 넣거나 접힌 상태가 아니라 착용하거나 들고 있는 그대로 제품을 업로드하세요. 그래야 피팅 단계에서 인식할 정보가 있습니다.
재단, 원단, 부자재, 그리고 모든 프린트는 업로드하신 사진에서 그대로 가져오므로, 그래픽이 선명하게 찍힌 사진일수록 렌더가 참고할 정보가 가장 많습니다. 움직이는 의류 위의 빽빽한 프린트는 다른 어디서나 그렇듯 여기서도 가장 어려운 사례입니다.
Seedance 2.5. 의류 판독, 참조 시트, 핏 스틸은 렌더링이 시작되기 전에 이 템플릿이 제공하는 요소입니다.
광고 플랫폼과 유통 채널은 광고에 등장하는 합성 인물과 생성된 모델 이미지에 대해 각기 다른 규칙을 두고 있으며, 그 어느 것도 오래 고정되어 있지 않습니다. 영상이 공개되기 전에 게시 대상이 생성된 인물에 대해 현재 안내하는 내용을 확인하세요.
네, 한 피스당 한 번의 호출입니다. /api/v1/model/generateVideo에 model을 atlascloud/studio/virtual-try-on으로 설정해 POST를 보낸 다음, 상태가 completed로 돌아올 때까지 /api/v1/model/prediction/{request_id}를 폴링하세요. 매 호출마다 동일한 model_image를 전달하는 것이 범위 전체에서 하나의 얼굴을 유지하는 방법입니다. API 문서부터 시작하세요.
무엇을 촬영할지, 누구를 캐스팅할지, 그리고 각 컷이 어디에 들어갈지.
AI 헤어스타일 체인저로 사진을 업로드하고 남성 헤어스타일, 페이드, 맨번을 무료로 체험해 보세요. 미용실 의자에 앉기 전에 새로운 헤어컷을 미리 확인하세요.
FitRoom AI 옷 갈아입히기 도구와 Atlas Cloud의 무료 대안을 비교하세요. 가격, 크레딧, 그리고 각 가상 피팅 도구가 2026년에 어떻게 작동하는지 확인하세요.
Seedance 2.5 vs Seedance 2: ByteDance가 방금 50개의 참조 입력을 지원하는 30초 네이티브 4K 모델을 공개했습니다. 변경된 점과 아직 입증되지 않은 점을 소개합니다.