
 Atlas Cloud jest teraz autoryzowanym resellerem Dreamina Seedance 2.5 i Seedream 5.0 Pro w USA.Atlas Cloud jest teraz autoryzowanym resellerem Dreamina Seedance 2.5 i Seedream 5.0 Pro w USA.

ChatGPT API w Atlas Cloud udostępnia najnowszą rodzinę modeli GPT 5.6 od OpenAI w ramach jednej integracji, obejmującej Sol do zaawansowanego rozumowania na granicy możliwości, Terra do ugruntowanych obciążeń produkcyjnych oraz Luna do naturalnych konwersacji i generowania treści. Kieruj wszystkie modele przez jeden klucz zgodny z OpenAI, korzystaj z niezawodności klasy produkcyjnej i płać przejrzyste stawki pay-as-you-go zaczynające się od $1 za milion tokenów wejściowych. Zacznij tworzyć już dziś.
ChatGPT został opracowany przez OpenAI. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.
Pięć endpointów generowania tekstu, od zaawansowanego rozumowania po ekonomiczne konwersacje, dostępnych przez jeden klucz zgodny z OpenAI i z przejrzystym cennikiem pay-as-you-go.
| Modalność | Opis |
|---|---|
| GPT 5.6 Sol API (Text to Text) | Stworzony z myślą o najbardziej zaawansowanych obciążeniach AI, GPT 5.6 Sol przekształca złożone prompty tekstowe w dogłębne, wieloetapowe wyniki rozumowania do ambitnego rozwiązywania problemów. Standardowa cena wynosi $5 za milion tokenów wejściowych i $30 za milion tokenów wyjściowych, co czyni go flagowym wyborem, gdy jakość odpowiedzi jest ważniejsza niż koszt. |
| GPT 5.6 Terra API (Text to Text) | Potrzebujesz niezawodnego domyślnego modelu produkcyjnego? GPT 5.6 Terra przekształca prompty w osadzony w kontekście, praktyczny tekst do rzeczywistych przepływów pracy i potoków analitycznych w cenie $2.50 za wejście i $15 za wyjście za milion tokenów. Zespoły wdrażają go w aplikacjach skierowanych do klientów, gdzie spójność jest ważniejsza niż eksperymentalna głębia. |
| GPT 5.6 Luna API (Text to Text) | Kieruj ruch konwersacyjny i kreatywny do GPT 5.6 Luna — modelu tekstowego dostrojonego do naturalnego dialogu, generowania treści i spersonalizowanych doświadczeń AI. Przy cenie $1 za wejście i $6 za wyjście za milion tokenów jest to najbardziej ekonomiczny punkt wejścia w tej ofercie ChatGPT API, dobrze dopasowany do produktów czatowych i masowego generowania tekstów marketingowych. |
| GPT 5.4 API (Text to Text) | GPT 5.4 przetwarza instrukcje tekstowe na niezawodny kod, długie formy treści i uporządkowane wyniki rozwiązywania problemów z wysoką dokładnością. Zaprojektowany jako zaawansowany model multimodalny, plasuje się w średnim poziomie cenowym: $2.50 za wejście i $15 za wyjście za milion tokenów, co czyni go praktycznym wyborem dla asystentów programowania i platform treści. |
| GPT 5.5 API (Text to Text) | Gdy trudne problemy uzasadniają wyższe wydatki, GPT 5.5 zapewnia zaawansowane rozumowanie, kodowanie i generowanie treści z jednego endpointu tekstowego. Wyceniony na $5 za wejście i $30 za wyjście za milion tokenów, jest przeznaczony do złożonych obciążeń krytycznych pod względem niezawodności, takich jak orkiestracja agentów i analiza techniczna. |
Uzyskaj dostęp do pełnej linii GPT 5.x oraz modelu z otwartymi wagami GPT OSS 120B przez jedno ChatGPT API, dostrajaj wysiłek rozumowania od low do xhigh, łącz tekst, obrazy i pliki w jednym wywołaniu oraz korzystaj z natywnych narzędzi z wyszukiwaniem w sieci na żywo przy użyciu jednego klucza zgodnego z OpenAI.
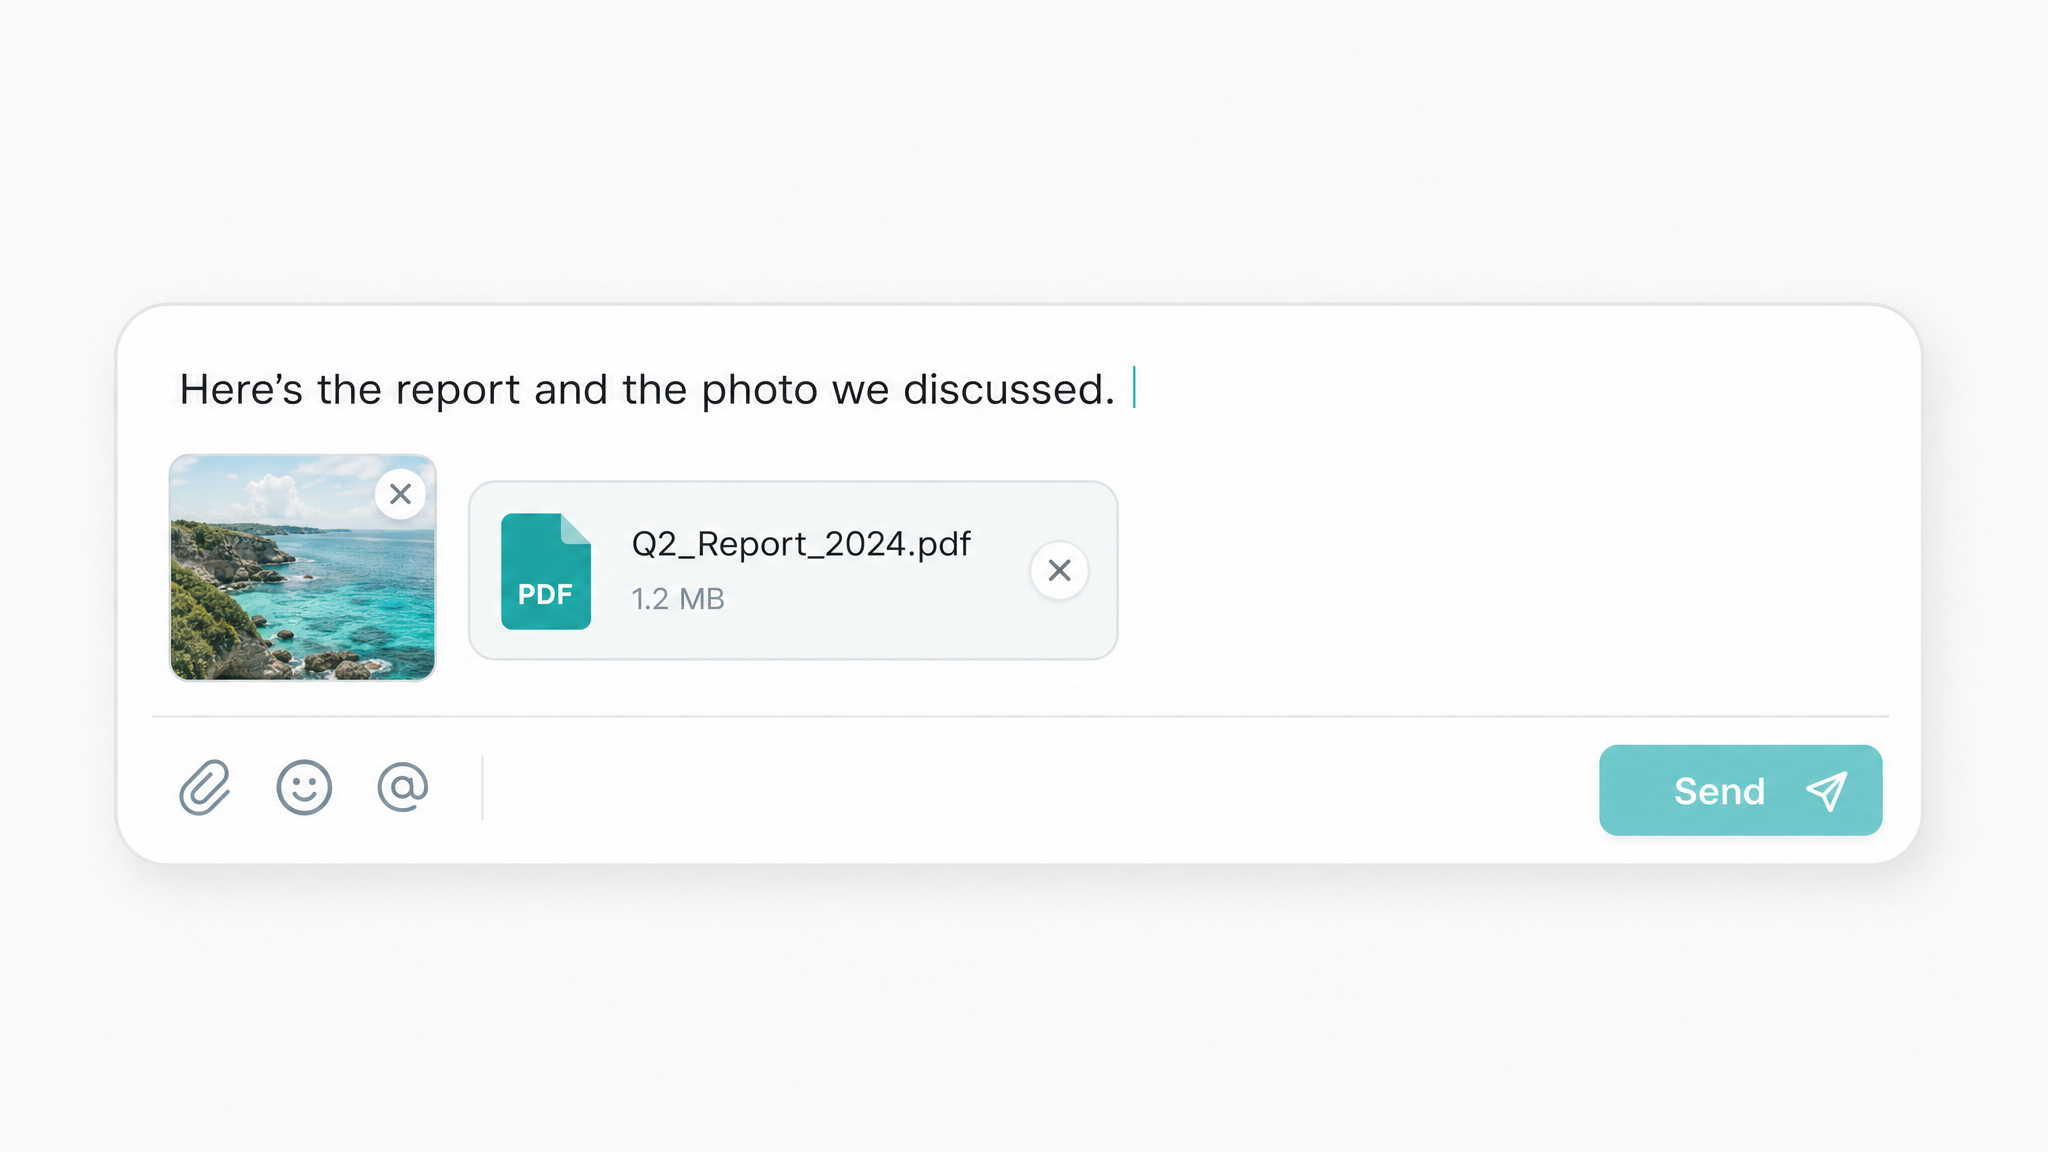
Pojedyncze żądanie ChatGPT API może połączyć zwykły tekst, adresy URL obrazów i pliki dokumentów w jednej wiadomości. Eliminuje to potrzebę korzystania z osobnych usług OCR lub wizji komputerowej, dzięki czemu możesz podsumowywać zeskanowane umowy albo odczytywać zrzuty ekranu w jednym przebiegu.
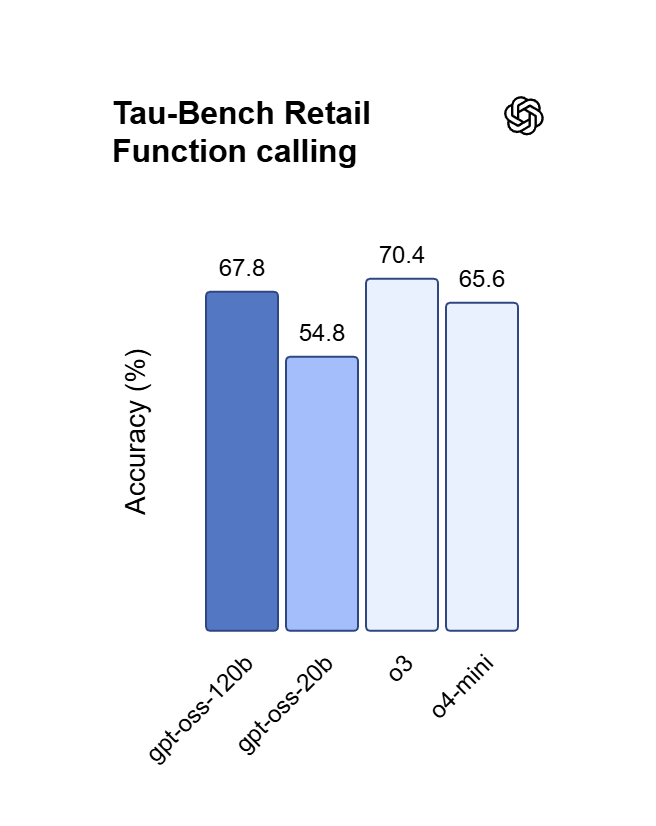
GPT OSS 120B trzyma się warstwowych promptów systemowych, utrzymując stabilne formaty, ograniczenia i ton w kolejnych odpowiedziach bez dryfu. Ta niezawodność sprawdza się w autonomicznych agentach, ekstrakcji strukturalnej i potokach produkcyjnych, w których wynik musi przestrzegać reguł.
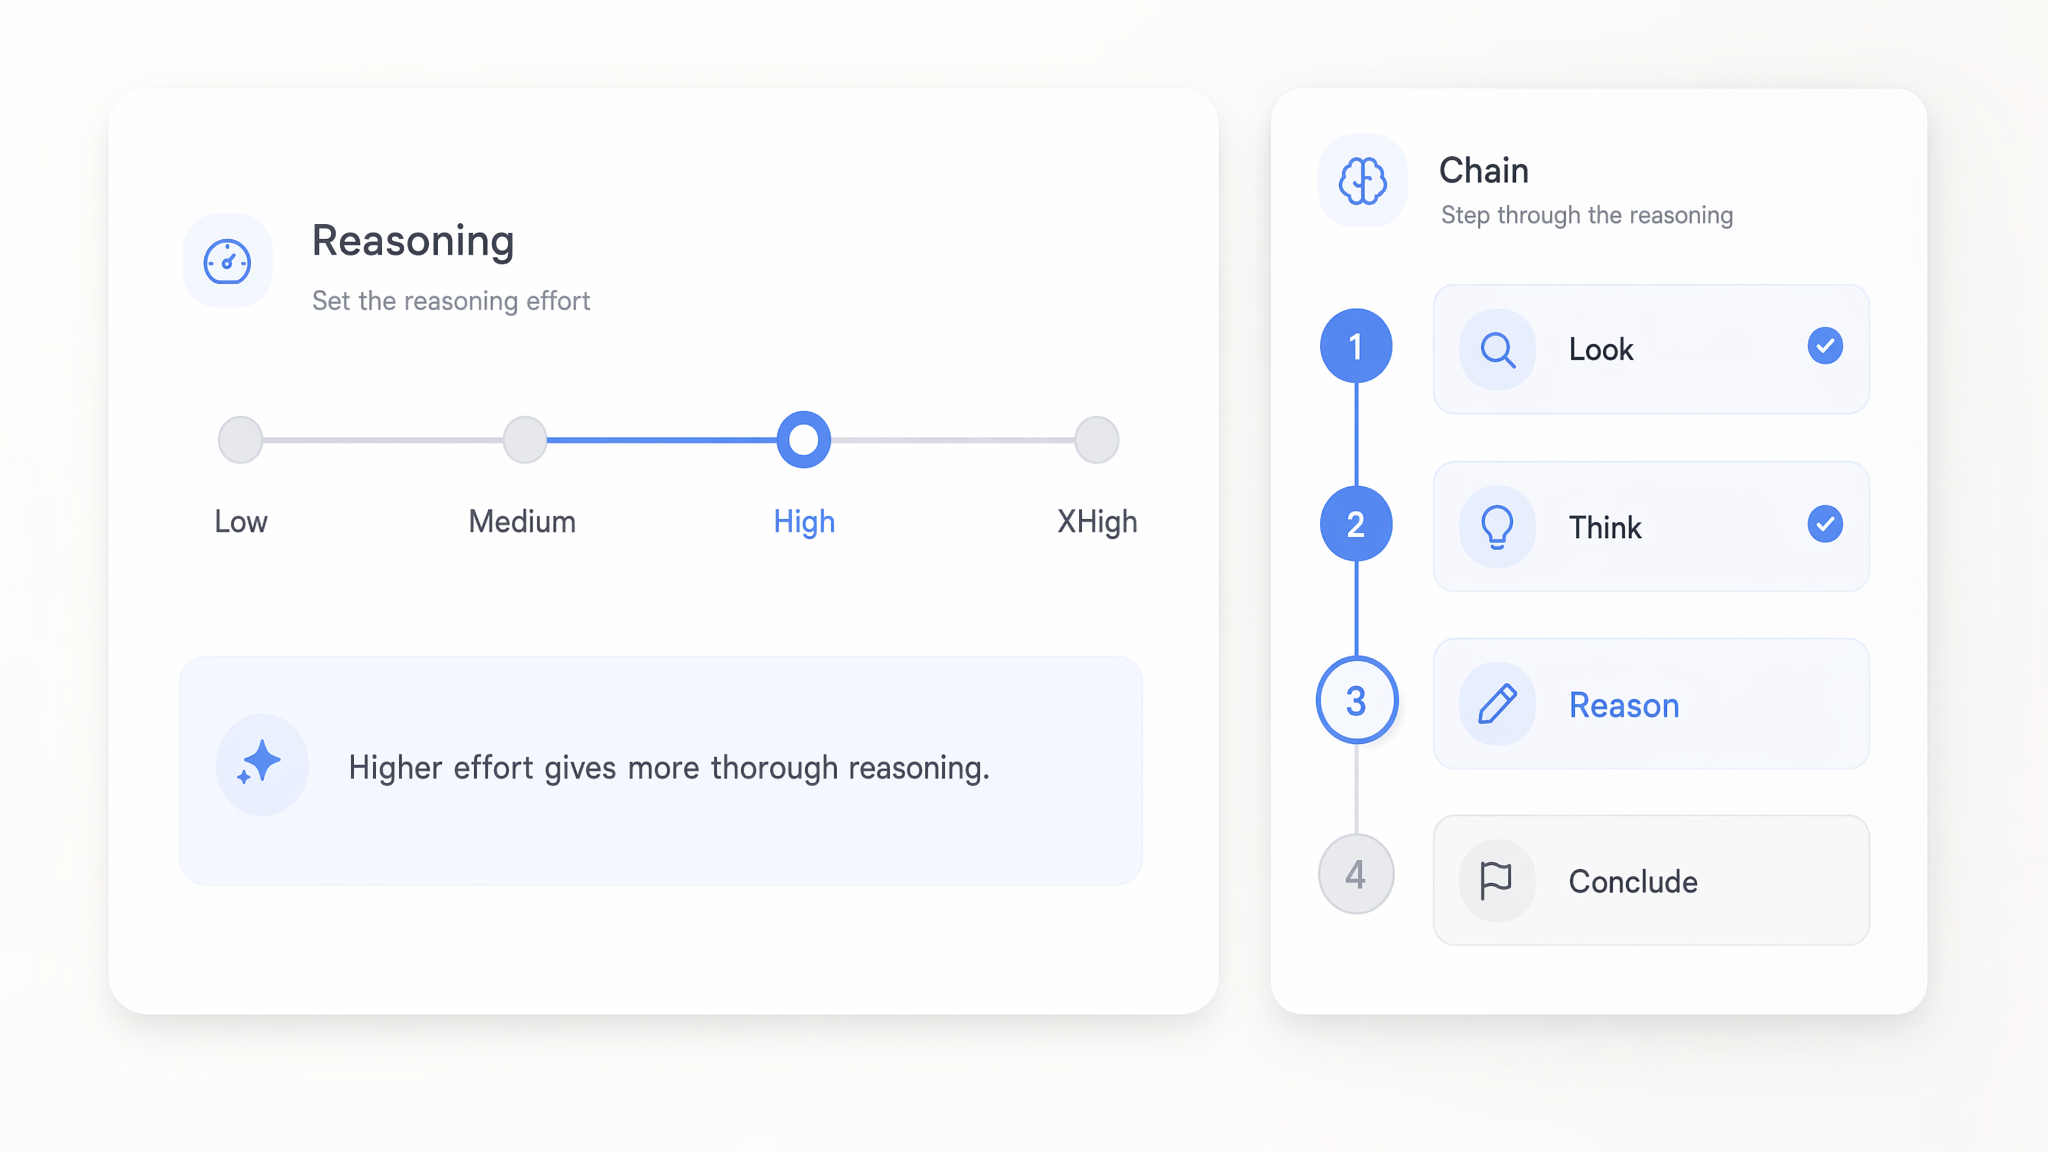
Ustaw wysiłek rozumowania w modelach GPT 5.x w dowolnym zakresie od low do xhigh, aby kontrolować, jak głęboko analizują problem przed odpowiedzią. Ustawienia low szybko i tanio obsługują proste wywołania, a xhigh przeznacza więcej mocy obliczeniowej na trudną, wieloetapową logikę.
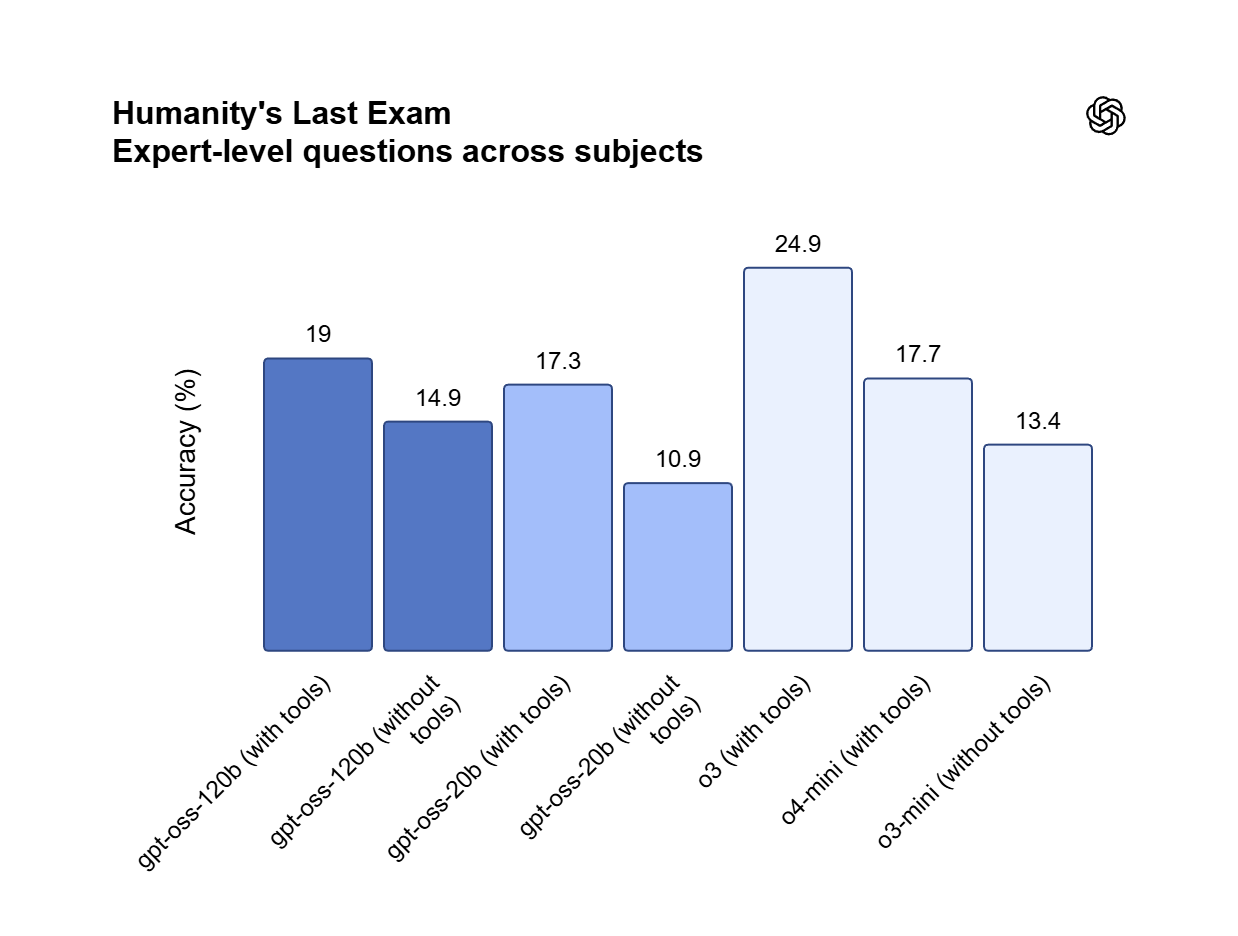
Udostępniany na licencji Apache 2.0, GPT OSS 120B pozwala na użycie komercyjne i prywatne dostrajanie na pojedynczym GPU 80GB. Uruchom go lokalnie, aby zachować dane własnościowe wewnątrz organizacji i całkowicie uniknąć opłat za tokeny.
Jedno ChatGPT API obsługuje pełną linię GPT 5.x, z cenami od Luna za $1 do Sol za $5 za milion tokenów wejściowych. Dopasuj każde wywołanie do poziomu wymaganego kosztu i inteligencji, bez zmiany endpointu.
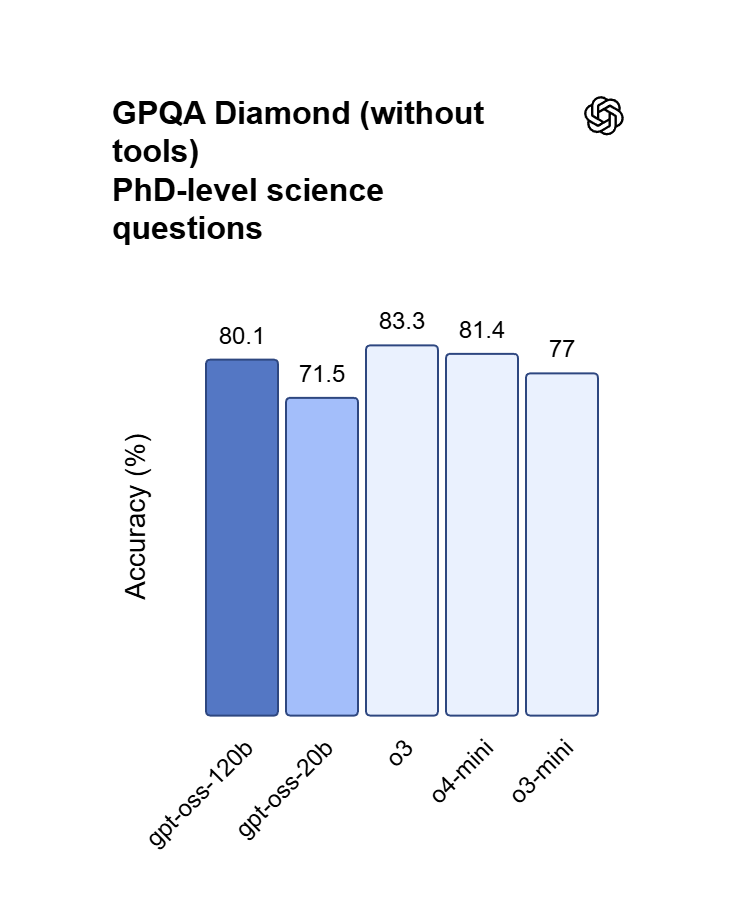
Prawie pełna zgodność z OpenAI o4-mini pozwala GPT OSS 120B obsługiwać wieloetapową syntezę kodu i dowody matematyczne. Zamieniaj pomysły opisane naturalnym językiem w działające aplikacje webowe, debuguj zagnieżdżoną logikę i orkiestruj złożone przepływy planowania zadań.
Modele GPT 5.x obsługują wywoływanie funkcji z automatycznym wyborem narzędzi oraz wbudowane wyszukiwanie w sieci, które pobiera aktualne wyniki. Strumieniuj odpowiedzi jako server-sent events, a cache promptów obniża koszt buforowanego wejścia GPT 5.6 Sol do $0.5 za milion tokenów.
Przekazaliśmy dokładnie tę samą instrukcję budowania modelom przez ChatGPT API oraz dwóm konkurencyjnym flagowcom, a następnie wyrenderowaliśmy każdą surową odpowiedź HTML bez zmian, aby można było porównać obok siebie głębię rozumowania, jakość kodu i wyczucie designu.
Zbuduj pojedynczy, samowystarczalny plik HTML (wyłącznie inline CSS i JavaScript — absolutnie bez zewnętrznych bibliotek, CDN-ów, frameworków, fontów ani adresów URL obrazów), który otwiera się bezpośrednio w dowolnej nowoczesnej przeglądarce i uruchamia żywy, samorozrastający się symulator ekosystemu szklanej szklarni, renderowany w całości jako płaska ilustracja wektorowa Canvas/SVG. Scena na cały viewport przedstawia kopułową wiktoriańską szklarnię: zakrzywiona szklana kopuła łukiem przecina górę jako element ramujący, jej tafle są narysowane jako półprzezroczyste jadeitowozielone wielokąty z miękkimi refleksami i cienkimi obrysami szczeblin, a wzdłuż dołu biegnie pas ciemnej ziemi uprawnej. Kierunek artystyczny to czysta ilustracja wektorowa — liście i łodygi rysowane ostrymi liniami żyłek oraz półprzezroczystymi, warstwowymi wypełnieniami, paleta oparta na mglistym szałwiowym zielonym i mchowym brązie z bursztynowym światłem słonecznym oraz akcentami jadeitowego szkła; bez fotorealizmu, bez gradientów używanych jako tekstury, zachowaj graficzny, ręcznie ilustrowany charakter. Główna interakcja: kliknięcie w dowolnym miejscu ziemi sadzi w tym punkcie nasiono, a roślina rośnie w czasie rzeczywistym z użyciem rzeczywistego L-system — zaimplementuj rekurencyjną gramatykę przepisywania (aksjomat plus reguły produkcji z nawiasami rozgałęzień oraz losowym odchyleniem kąta/długości dla każdej instancji, tak aby żadne dwie rośliny nie były identyczne) i animuj wyprowadzanie, aby gałęzie wydłużały się, rozdwajały i stopniowo rozwijały liście przez kilka sekund, zamiast pojawiać się od razu w pełnej formie. Tropikalne paprocie i pnącza powinny fototropicznie wyginać się i zawijać w stronę przeciąganego słońca: wyrenderuj świecący bursztynowy dysk słońca, który użytkownik może chwycić i przeciągnąć w dowolne miejsce na niebie, a każdy rosnący wierzchołek musi stale przeorientowywać kierunek wzrostu ku aktualnej pozycji słońca, aby przeciąganie słońca wyraźnie sterowało tym, jak cały ogród pochyla się i wspina. Siewki rozwijają się z animacją easing, a krople kondensacji tworzą się na szkle i powoli zsuwają w pętli. Steruj całością cyklem dnia i nocy powiązanym z pozycją słońca: oświetlenie otoczenia i poświata nieba płynnie przechodzą po gradiencie od ciepłego złota do chłodnego błękitu, położenie słońca wyznacza kierunek i długość miękkich cieni roślin rzucanych na podłogę oraz dryfujących plam światła na szkle, a o zmierzchu świetliki łagodnie pojawiają się jako małe, pulsujące punkty światła unoszące się wśród listowia. Kompozycja promieniuje wzrostem roślin od podstawy ku górze, w stronę środka, zamknięta łukiem kopuły. Użyj requestAnimationFrame do ciągłej, spokojnie oddychającej pętli animacji; utrzymaj płynną wydajność przy wielu roślinach widocznych jednocześnie. Dodaj subtelne, nienachalne kontrolki (np. suwak lub automatycznie przesuwany przełącznik pory dnia oraz przycisk resetowania/czyszczenia) stylizowane zgodnie z ilustracyjną estetyką, a także jednowierszową podpowiedź informującą użytkownika, by kliknął ziemię, aby posadzić roślinę, i przeciągnął słońce, aby kierować wzrostem. Dopasuj widok responsywnie do dowolnego rozmiaru okna i nadaj mu spokojny, nieruchomy, a zarazem żywy nastrój — pierwsze poranne światło wpada pod skosem, gdy delikatne pędy otwierają się razem. To symulacja generatywna, nie gra ani dashboard: priorytetem są prawdziwy rekurencyjny algorytm wzrostu, pętla animacji oraz fizyka światła/cienia/fototropizmu.
Generated with GPT 5.6 Sol on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Zbuduj kompletną, jednoplikową stronę HTML zawierającą interaktywny dashboard globalnego finansowania startupów z fikcyjnymi, lecz wewnętrznie spójnymi danymi dla 8 sektorów branżowych na przestrzeni 5 lat. Cały CSS i JavaScript muszą być inline, bez żadnych zewnętrznych zależności, bez bibliotek wykresów, CDN-ów ani obrazów. Wyrenderuj trzy ręcznie zakodowane wizualizacje na canvas lub SVG: animowany wykres słupkowy, który sortuje się ponownie z easingiem, gdy użytkownik wybierze rok na suwaku, wykres liniowy z tooltipami po najechaniu pokazującymi dokładne wartości i pionową prowadnicą śledzącą, oraz wykres donut, którego segmenty rozszerzają się po najechaniu z animacją sprężynową. Dodaj ciemny, nowoczesny UI z paletą akcentów od fioletu do turkusu, animowane liczniki liczb w czterech kartach statystyk KPI, wiersz filtrów sektorów w formie przełączanych chipów, który natychmiast aktualizuje wszystkie wykresy, oraz przełącznik motywu jasny/ciemny z płynnymi przejściami kolorów. Układ musi być responsywny i poniżej 768px zwijać się do jednej kolumny, a każda interakcja musi reagować w czasie rzeczywistym bez przeładowania strony.
Generated with GPT 5.6 Sol on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GPT 5.4 on Atlas Cloud
Od agentowego kodowania i ekstrakcji strukturalnej po czat wsparcia oparty na źródłach i treści na dużą skalę — ChatGPT API w Atlas Cloud kieruje każde zadanie do odpowiedniej warstwy GPT 5.6 za pomocą jednego klucza zgodnego z OpenAI.

Kieruj złożone refaktoryzacje i syntezę kodu obejmującą wiele plików do GPT 5.6 Sol — warstwy tej rodziny przeznaczonej do głębokiego rozumowania i zaprojektowanej z myślą o najbardziej zaawansowanych obciążeniach inżynieryjnych. Zespoły tworzące copilots do kodowania, automatyczne boty do review i generatory testów otrzymują logikę gotową do produkcji.

GPT 5.6 Luna, kreatywna warstwa tej rodziny, tworzy szkice wpisów blogowych, opisy produktów i zlokalizowane teksty z naturalnym tonem oraz spersonalizowanym wynikiem. Zespoły contentowe i platformy ecommerce produkują duże wolumeny tekstów bez utraty spójności głosu marki.

Potrzebujesz chatbota, który trzyma się scenariusza? GPT 5.6 Terra dostarcza niezawodne, ugruntowane odpowiedzi stworzone do rozmów produkcyjnych, dzięki czemu zespoły wsparcia i produkty SaaS mogą automatyzować zgłoszenia i skutecznie ograniczać powtarzalne zapytania.

Przekaż pełne podręczniki procedur lub archiwa badawcze do modelu z długim kontekstem i uzyskaj ugruntowane odpowiedzi wierne źródłom. Zespoły prawne, medyczne i zajmujące się wyszukiwaniem wewnętrznym zyskują niezawodny silnik do odpowiadania na pytania wspomaganego wyszukiwaniem.

Chaotyczne faktury, e-maile i pliki PDF zamieniają się w czysty JSON, któremu mogą zaufać systemy downstream. Niezawodne wykonywanie instrukcji utrzymuje schematy w nienaruszonym stanie, obsługując potoki danych, automatyzację CRM i przepływy analityczne, które nie tolerują odchyleń.

Gdy liczą się budżet i opóźnienia, przełączaj się między Sol, Terra i Luna za pomocą jednego klucza zgodnego z OpenAI. Startupy i niezależni deweloperzy szybko prototypują w modelu pay-as-you-go, a następnie skalują tę samą integrację do produkcji.
Zobacz, jak wypadają modele różnych dostawców — porównaj wydajność, ceny i unikalne mocne strony, aby podjąć świadomą decyzję.
| Model | Kontekst | Maks. wynik | Wejście | Pozycjonowanie |
|---|---|---|---|---|
| GPT OSS 120B | 131.07K | 131.07K | Tekst | Wysokowydajny LLM do rozumowania |
| GLM-5 | 202.75K | 202.75K | Tekst | Flagowy model bazowy |
| DeepSeek V3.2 | 163.84K | 163.84K | Tekst | Flagowy model ogólnego zastosowania |
| MiniMax-M2.5 | 204.8K | 196.6K | Tekst | Najnowocześniejsze agentowe kodowanie |
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Połączenie zaawansowanych modeli ChatGPT z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj ChatGPT, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
ChatGPT API pozwala deweloperom wysyłać prompty do modeli GPT firmy OpenAI i programowo odbierać uzupełnienia, zamiast korzystać z interfejsu czatu. W Atlas Cloud uzyskujesz dostęp do pełnej linii GPT 5.6, wraz z GPT 5.4 i GPT 5.5, przez jeden endpoint zgodny z OpenAI. Każde wywołanie jest rozliczane za token według przejrzystego cennika pay-as-you-go, więc płacisz tylko za to, co wygenerujesz.
Pięć modeli obejmuje zakres od zaawansowanego rozumowania po codzienny czat. GPT 5.6 Sol jest przeznaczony do ambitnego rozwiązywania problemów i zadań frontier, GPT 5.6 Terra obsługuje niezawodne przepływy produkcyjne, a GPT 5.6 Luna jest dostrojony do naturalnej rozmowy i generowania treści. GPT 5.4 i GPT 5.5 dodają rozumowanie multimodalne oraz kodowanie dla zespołów, które chcą sprawdzonej, uniwersalnej wydajności.
Wygeneruj jeden klucz API, ustaw bazowy URL na https://api.atlascloud.ai/v1 i wybierz identyfikator modelu, taki jak openai/gpt-5.6-terra. Ponieważ tutejsze ChatGPT API jest w pełni zgodne z OpenAI, istniejący kod oparty na OpenAI SDK działa po zmianie tylko bazowego URL-a i klucza. Nie ma listy oczekujących ani subskrypcji, a nowe wydania są dostępne w Day-0 access, więc pierwsze żądanie możesz wysłać tego samego dnia.
Ceny zależą od wybranego modelu. GPT 5.6 Luna jest najbardziej ekonomiczny: $1 za milion tokenów wejściowych i $6 za milion tokenów wyjściowych, GPT 5.6 Terra kosztuje $2.5 i $15, a GPT 5.6 Sol — $5 i $30. Buforowanie promptów obniża koszt powtarzanego wejścia, a rozliczenia pozostają w modelu pay-as-you-go, więc płacisz tylko za użyte tokeny.
Tak. Endpoint używa formatu OpenAI Chat Completions, więc oficjalne OpenAI SDK, LangChain i większość bibliotek zgodnych z OpenAI działają po podmianie bazowego URL-a i klucza. Oznacza to, że istniejącą integrację z ChatGPT API można przenieść bez przepisywania logiki żądań.
Streaming i function calling działają tak samo jak w implementacji OpenAI, więc ustawiasz stream na true, aby otrzymywać dane token po tokenie, i przekazujesz tablicę tools, aby wywoływać funkcje. Strukturyzowane odpowiedzi JSON korzystają z tego samego formatu żądań zgodnego z OpenAI, co zapewnia przewidywalność orkiestracji agentów i pipeline'ów ekstrakcji danych.
Te modele przyjmują duże prompty do pracy z długimi dokumentami i pełnymi repozytoriami. Cennik jest warstwowy od progu 272,000 tokenów: standardowa stawka obowiązuje dla promptów poniżej tej wartości, a druga stawka dla promptów przekraczających 272,000 tokenów. Możesz więc przekazać rozległy kontekst w jednym żądaniu i dokładnie wiedzieć, jak zmienia się stawka wraz ze wzrostem promptu.
Dopasuj model do zadania. Wybierz GPT 5.6 Sol, gdy potrzebujesz rozumowania frontier i ambitnego rozwiązywania problemów, GPT 5.6 Terra do ugruntowanej analizy klasy produkcyjnej, a GPT 5.6 Luna do pracy konwersacyjnej lub kreatywnej, gdy koszt ma największe znaczenie. GPT 5.4 i GPT 5.5 pozostają mocnymi opcjami multimodalnymi do kodowania i ogólnego rozumowania.
Atlas Cloud uruchamia ChatGPT API na zarządzanej infrastrukturze, która skaluje się wraz z ruchem, dzięki czemu unikasz provisioningu GPU i orkiestracji węzłów typowych dla self-hostingu. Nowe wersje modeli trafiają do usługi z Day-0 access, więc pozostajesz na bieżąco bez prac migracyjnych. Gdy Twoje potrzeby wzrosną, ten sam klucz zgodny z OpenAI obejmuje każdy model w rodzinie, więc skalowanie nigdy nie oznacza nowej integracji.
API Seedance 2.5 jest już dostępne w Atlas Cloud! Zapewnia deweloperom najnowszy model wideo od ByteDance. Generuje do 30 sekund natywnego wideo w jednym przebiegu z tekstu, pojedynczego obrazu lub nawet 50 wielomodalnych odniesień, z zsynchronizowanym dźwiękiem i wielojęzycznym tekstem w kadrze. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza, a spójność obiektu i ulepszona fizyka zachowują spójność długich ujęć.

API Wan 3.0 to kolejna generacja rodziny wideo Wan firmy Alibaba, stworzona po to, by wznieść generowanie długich form, kontrolę wielu referencji i jakość audiowizualną na nowe wyżyny. Atlas Cloud hostuje już Wan 2.7, 2.6 i 2.5, a Wan 3.0 działa na tym samym ujednoliconym kluczu bez konieczności oddzielnej konfiguracji. Rozpocznij budowanie już dziś. Przewiń w dół do sekcji prezentacji, aby zobaczyć, co potrafi stworzyć Wan 3.0.
MiniMax H3 to multimodalna rodzina modeli wideo MiniMax do tworzenia na podstawie tekstu, obrazu i materiałów referencyjnych. We wszystkich obsługiwanych trasach zachowuje obiekty z materiałów referencyjnych, oferuje elastyczne proporcje obrazu i łączy wygenerowany dźwięk z obrazem za pośrednictwem H3 Developer, a profile wynikowe są wybierane na poziomie endpointu. Atlas Cloud udostępnia całą rodzinę za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym rozliczeniem pay-as-you-go według standardowej stawki $0.038 za sekundę. Zacznij tworzyć już dziś.
Rodzina modeli gpt-image-2.5 firmy OpenAI daje programistom wybór między Flare i Sunburst na potrzeby produkcyjnych procesów generowania obrazów. Renderuj w dowolnych rozdzielczościach do 3840x2160 i wybieraj spośród pięciu poziomów jakości, w tym xhigh i max, aby spełnić konkretne wymagania dotyczące wyników. Atlas Cloud zapewnia gotową do użycia inferencję REST bez zimnych startów i ze standardową ceną od $0.004 za generowanie. Zacznij tworzyć już dziś.
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0 to produkcyjny model wideo firmy ByteDance, umożliwiający precyzyjne tworzenie ujęć. Zamieniaj polecenia na wideo, animuj obraz pierwszej klatki z opcjonalnym wskazaniem ostatniej klatki lub kształtuj wyniki za pomocą materiałów referencyjnych i opcjonalnego wyszukiwania w sieci. Atlas Cloud łączy te procesy w jeden ujednolicony interfejs API, oferując przejrzyste rozliczanie zgodnie z użyciem oraz jeden klucz kompatybilny z OpenAI. Zacznij tworzyć już dziś.
Kling 3.0 API przenosi flagowy pakiet wideo Kuaishou do Atlas Cloud za pomocą jednego klucza kompatybilnego z OpenAI. Obejmuje on dwa modele: Kling 3.0 do opowiadania historii AI Director, wielojęzycznej synchronizacji ruchu warg i precyzyjnego tekstu na ekranie, oraz Kling 3.0 Omni (O3) do klonowania obiektów i głosu z krótkiego wideo lub obrazu. Oba generują natywny dźwięk w tym samym przebiegu, z rozdzielczością wyjściową do 4K. Buduj kinowe narracje, globalny marketing, wielojęzyczne reklamy i serializowane treści z postaciami w niezawodnej infrastrukturze.
Grok Imagine Video zapewnia deweloperom dostęp do rodziny modeli wideo xAI do tworzenia, animowania, wydłużania i edytowania klipów. Generuj filmy o długości od 1 do 15 sekund na podstawie promptów, steruj postaciami, obiektami lub stylami, korzystając z maksymalnie siedmiu obrazów referencyjnych, i pracuj w rozdzielczości 480p lub 720p. Atlas Cloud udostępnia te możliwości za pośrednictwem endpointów zgodnych z OpenAI, oferując przejrzyste rozliczanie pay-as-you-go. Zacznij tworzyć już dziś.
Vidu Q4 to najnowszy flagowy model wideo firmy Vidu, przeznaczony do generowania wideo na podstawie obrazu oraz referencji. Potrafi animować pojedynczy obraz nieruchomy i automatycznie tworzyć przejścia między scenami, oferując deweloperom dwie ścieżki wejściowe na potrzeby różnych przepływów pracy produktu. Atlas Cloud udostępnia dedykowane endpointy API z opublikowanymi schematami parametrów w zweryfikowanej standardowej cenie $0.04 za sekundę. Zacznij tworzyć już dziś.
Gemini Omni 1.1 Flash to natywnie multimodalna rodzina modeli wideo Google DeepMind, przeznaczona do elastycznych procesów produkcyjnych. Edytuj istniejący materiał za pomocą instrukcji tekstowych, zachowuj spójność wizualną dzięki maksymalnie 10 obrazom referencyjnym i 3 klipom wideo lub wydłużaj ujęcia w łączonych segmentach do 40 sekund. Uzyskaj dostęp do wszystkich procesów w Atlas Cloud za pomocą jednego klucza API zgodnego z OpenAI, z rozliczaniem według zużycia i dostępnością od pierwszego dnia. Zacznij tworzyć już dziś.
Nano Banana 2.1 to rodzina modeli obrazowych firmy Google, zbudowana na bazie Gemini 3.6 Flash. Zapewnia generowanie i edycję na poziomie Pro z szybkością Flash, obsługuje edycję w języku naturalnym oraz łączenie od 1 do 14 obrazów wejściowych, a także zachowuje spójność do 4 postaci i 10 obiektów. Dzięki Atlas Cloud deweloperzy mogą korzystać z tej rodziny za pomocą jednego klucza zgodnego z OpenAI, niezawodnej dostępności i dostępności od Day-0. Zacznij tworzyć już dziś.
Twórz za pomocą API Nano Banana 2, napędzanego przez model Gemini 3.1 Flash Image od Google. Generuje ono natywne obrazy 4K o rozdzielczości do 4096x2304 z dokładnym renderowaniem tekstu i spójnymi postaciami w oparciu o maksymalnie 14 obrazów referencyjnych, zarówno w przypadku generowania, jak i edycji. W Atlas Cloud zyskujesz do niego dostęp poprzez jedno ujednolicone API obok ponad 300 modeli, z cenami od 0,04 USD za obraz, gwarantowanym czasem bezawaryjnej pracy na poziomie 99,99% i darmowymi kredytami na start.
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.



