
GLM API for Autonomous Task Execution
GLM to flagowa seria LLM Z.ai od Zhipu AI, a GLM API obejmuje wszystko: od agentowego GLM-5 po wydajny 357B MoE GLM-4.6. Modele te specjalizują się w autonomicznym wykonywaniu zadań, złożonej orkiestracji agentów oraz programowaniu na poziomie produkcyjnym. W Atlas Cloud jeden ujednolicony endpoint daje dostęp Day-0 do całej rodziny GLM, z rozliczeniem według użycia i niezawodną dostępnością produkcyjną. Zacznij budować już dziś.
GLM został opracowany przez Z.ai. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Poznaj Wiodące Modele
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.
Porównanie modeli GLM API: od GLM-4.6 do GLM-5.2
Dopasuj każdy endpoint do swojego obciążenia i budżetu.
| Modalność | Opis |
|---|---|
| GLM-5.2 | GLM-5.2 został zaprojektowany jako model zorientowany na agentów: przekształca prompty w języku naturalnym i kontekst wywołań narzędzi w uporządkowane rozumowanie, wywołania funkcji oraz autonomiczne wykonywanie zadań. Jest dostrojony do złożonych problemów, w których model musi samodzielnie planować, działać i iterować. Wybierz go przy budowie autonomicznych agentów i długich workflow korzystających z narzędzi; cena wynosi $1.4 za milion tokenów wejściowych i $4.4 za milion tokenów wyjściowych. |
| GLM-5.1 | Podaj GLM-5.1 zadanie programistyczne lub wieloetapowy problem, a zwróci mocne wyniki kodowania wraz ze stabilnym wykonaniem krok po kroku. Jako najnowszy flagowy model Z.AI oferuje też bardziej naturalną konwersację i dopracowaną estetykę front-endu. Sprawdzi się w zespołach budujących złożone aplikacje webowe i potoki agentowe; koszt to $1.4 za wejście i $4.4 za wyjście na milion tokenów. |
| GLM-5v Turbo | GLM-5v Turbo przekształca prompty tekstowe w szybkie uzupełnienia, zachowując ulepszone możliwości programistyczne flagowego modelu i stabilne wykonywanie wieloetapowe. Ten wariant turbo priorytetowo traktuje niższe opóźnienia w interaktywnych produktach o dużej przepustowości, bez utraty jakości konwersacji. Wybierz go, gdy najważniejsza jest responsywność; cena wynosi $1.2 za milion tokenów wejściowych i $4 za milion tokenów wyjściowych. |
| GLM-5 Turbo | Tekst trafia na wejście, a uzupełnienia wracają szybko dzięki GLM-5 Turbo — zoptymalizowanemu pod kątem opóźnień flagowemu modelowi do ulepszonego programowania i niezawodnego rozumowania wieloetapowego. Zachowuje naturalność odpowiedzi i czyste generowanie front-endu, jednocześnie przyspieszając przepustowość w zastosowaniach czasu rzeczywistego. Dobrze pasuje do interfejsów czatu i szybkich pętli agentowych; rozliczany po $1.2 za milion tokenów wejściowych i $4 za milion tokenów wyjściowych. |
| GLM-5 | GLM-5 przyjmuje instrukcje tekstowe i generuje kod, łańcuchy rozumowania oraz odpowiedzi konwersacyjne jako główne flagowe wydanie Z.AI. Najważniejsze usprawnienia koncentrują się na mocniejszym programowaniu i stabilniejszym wykonywaniu wieloetapowym w złożonych zadaniach agentowych. To zrównoważony wybór do rozwoju full-stack i codziennego rozumowania, oferowany w cenie $1 za wejście i $3.2 za wyjście na milion tokenów. |
| GLM-4.7 | Poproś GLM-4.7 o kodowanie lub orkiestrację agentów, a odpowie niezawodnym wykonaniem wieloetapowym i naturalnym dialogiem. Ten model klasy flagowej łączy ulepszone programowanie z dopracowanym wynikiem front-endowym w bardziej przystępnej cenie. Pasuje do produkcyjnych obciążeń wrażliwych na koszty; rozliczany po $0.6 za milion tokenów wejściowych i $2.2 za milion tokenów wyjściowych. |
| GLM-4.6 | Wydajny model Mixture-of-Experts o 357B parametrach od Zhipu AI, GLM-4.6 mapuje prompty tekstowe na wysokiej jakości uzupełnienia z dużą przepustowością. Jego architektura MoE aktywuje tylko tych ekspertów, których potrzebuje dane żądanie, utrzymując efektywną inferencję w zadaniach analitycznych i contentowych. Wdrażaj go do analizy danych, przygotowywania slajdów i treści webowych w cenie $0.6 za wejście i $2.2 za wyjście na milion tokenów. |
Co napędza GLM API
Od rzadkiego rdzenia Mixture-of-Experts i kontekstu 200K-token po natywne wywoływanie narzędzi i przełączane tryby myślenia — GLM API udostępnia flagowy stos Z.ai do rozumowania i kodowania za jednym punktem końcowym zgodnym z OpenAI.
Rzadki Mixture-of-Experts na dużą skalę
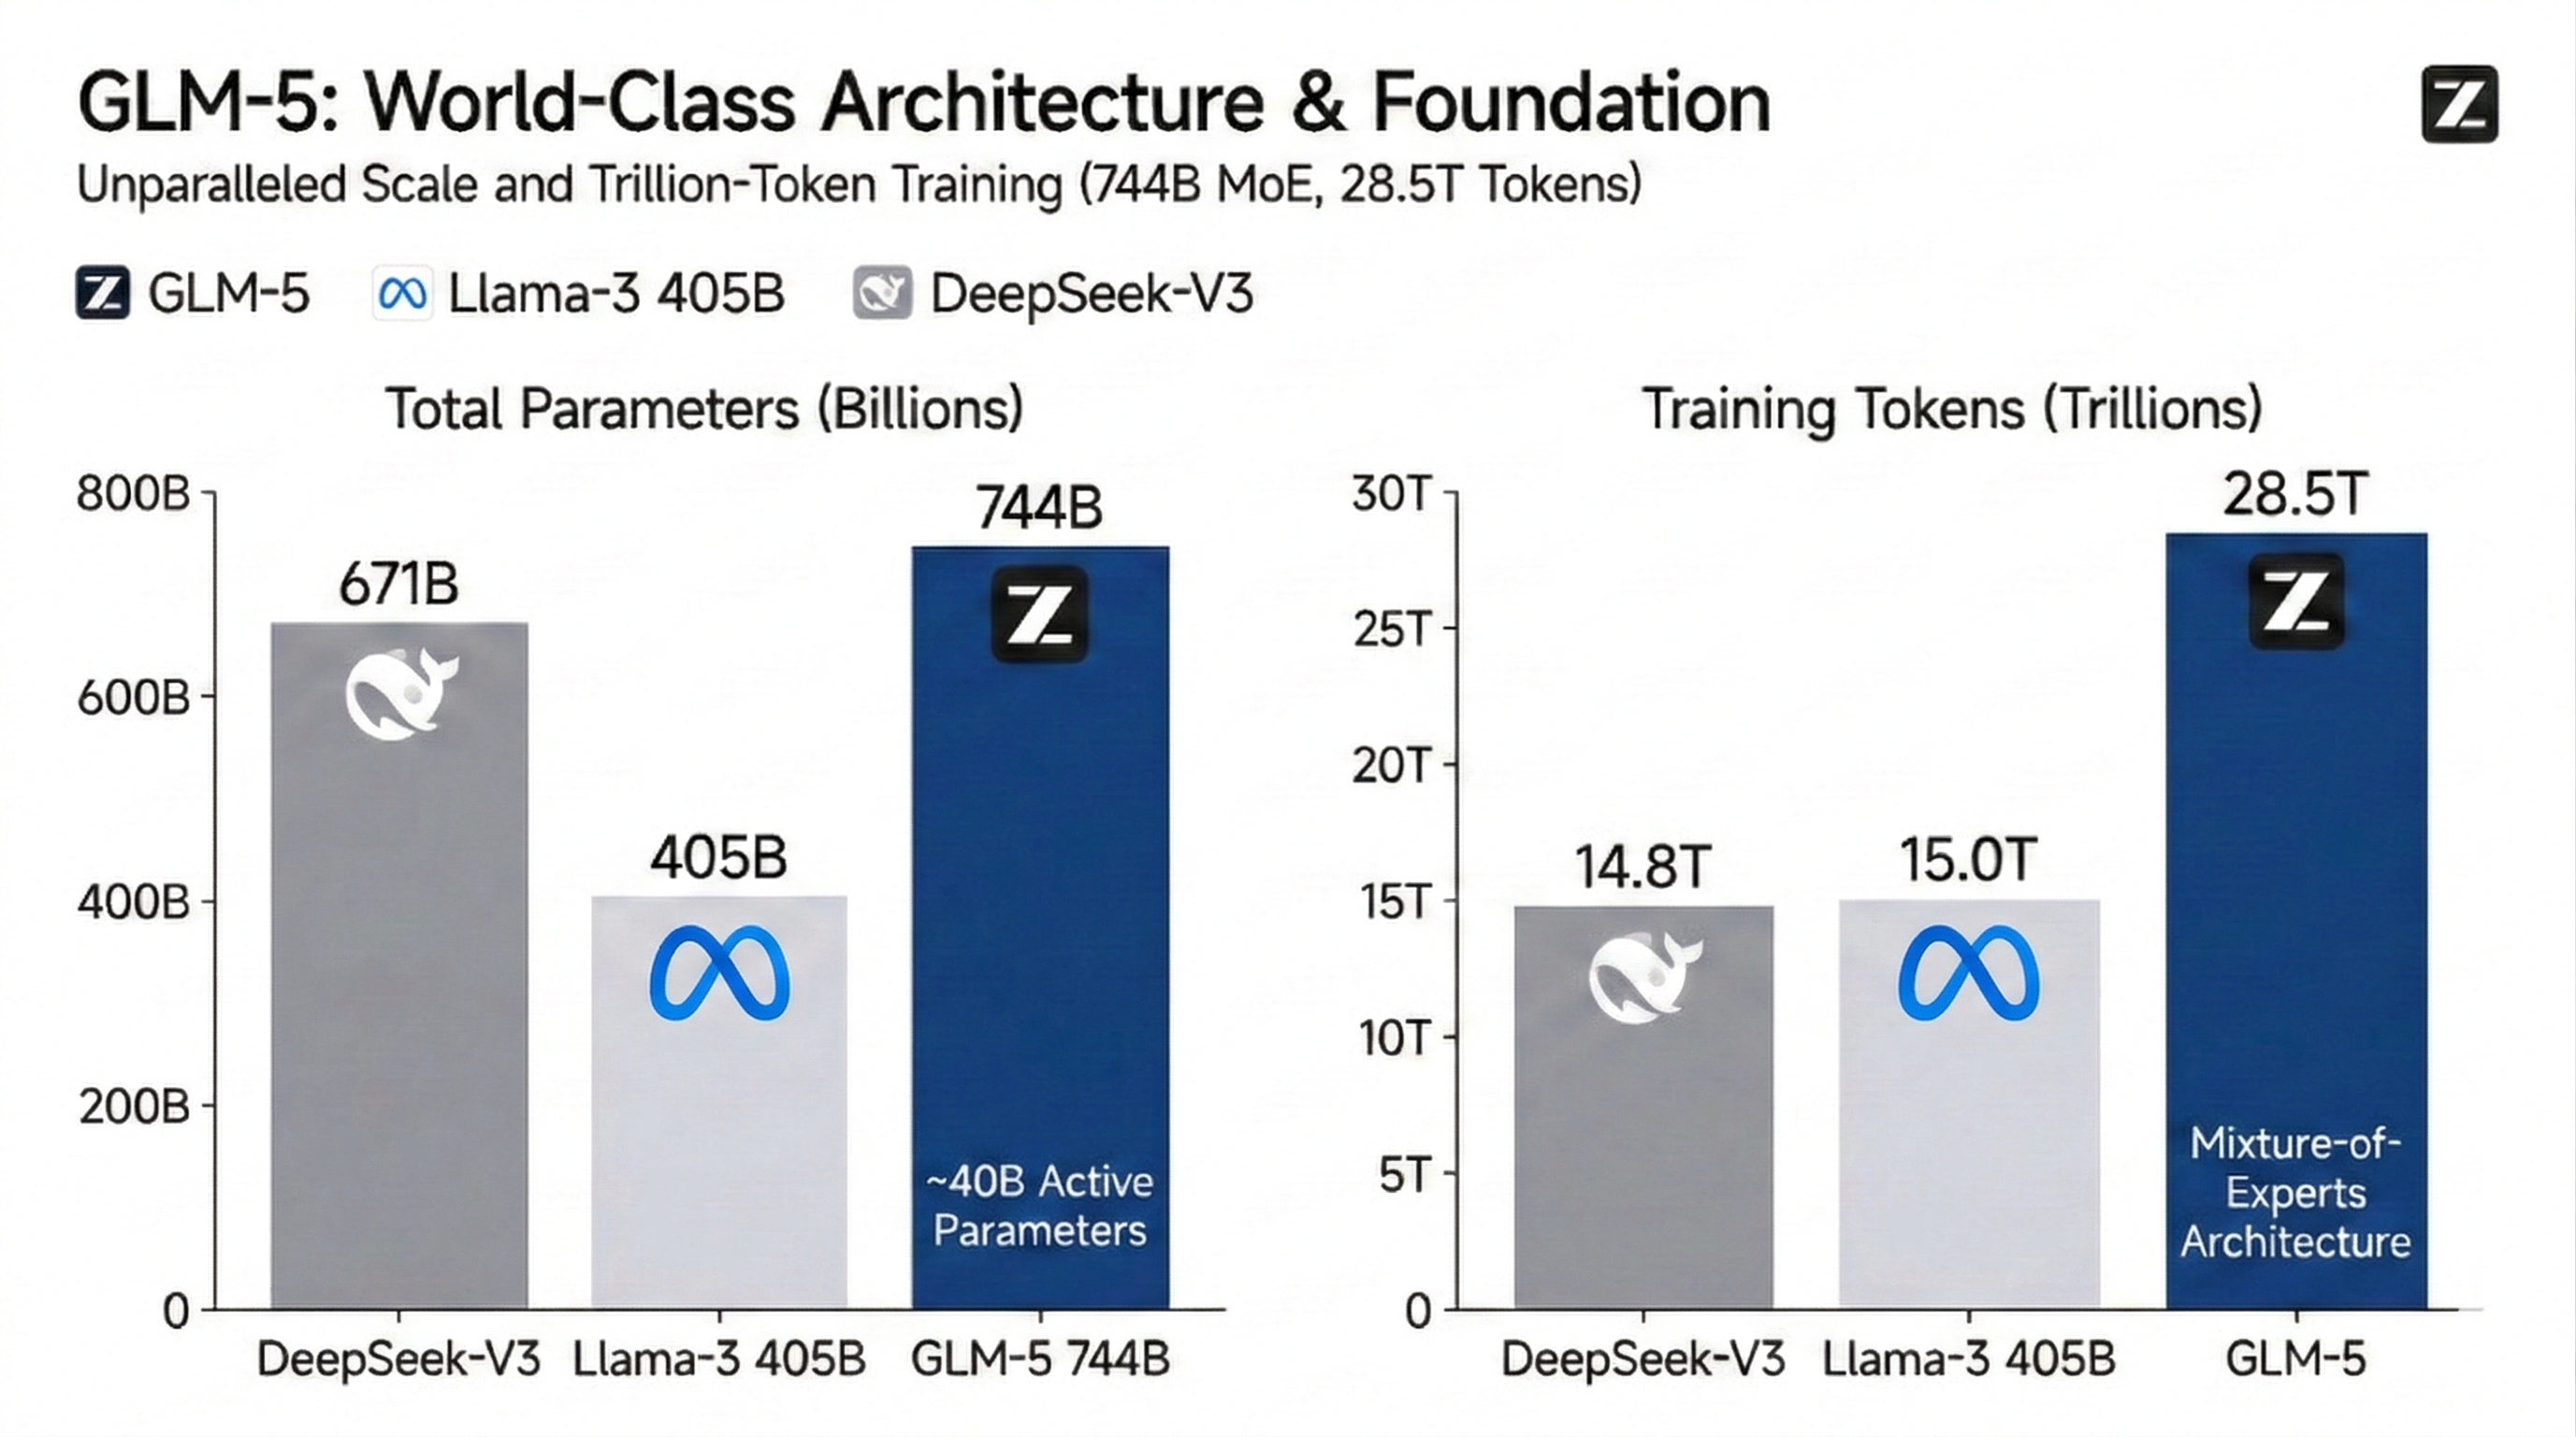
Rzadki rdzeń Mixture-of-Experts aktywuje tylko około 40 miliardów parametrów na zapytanie, korzystając ze znacznie większej puli ekspertów. Efektem jest głęboka wiedza i precyzyjne przywoływanie informacji bez kosztu modelu gęstego przy każdym wywołaniu.
Agentowe wykonywanie zadań wbudowane w GLM API
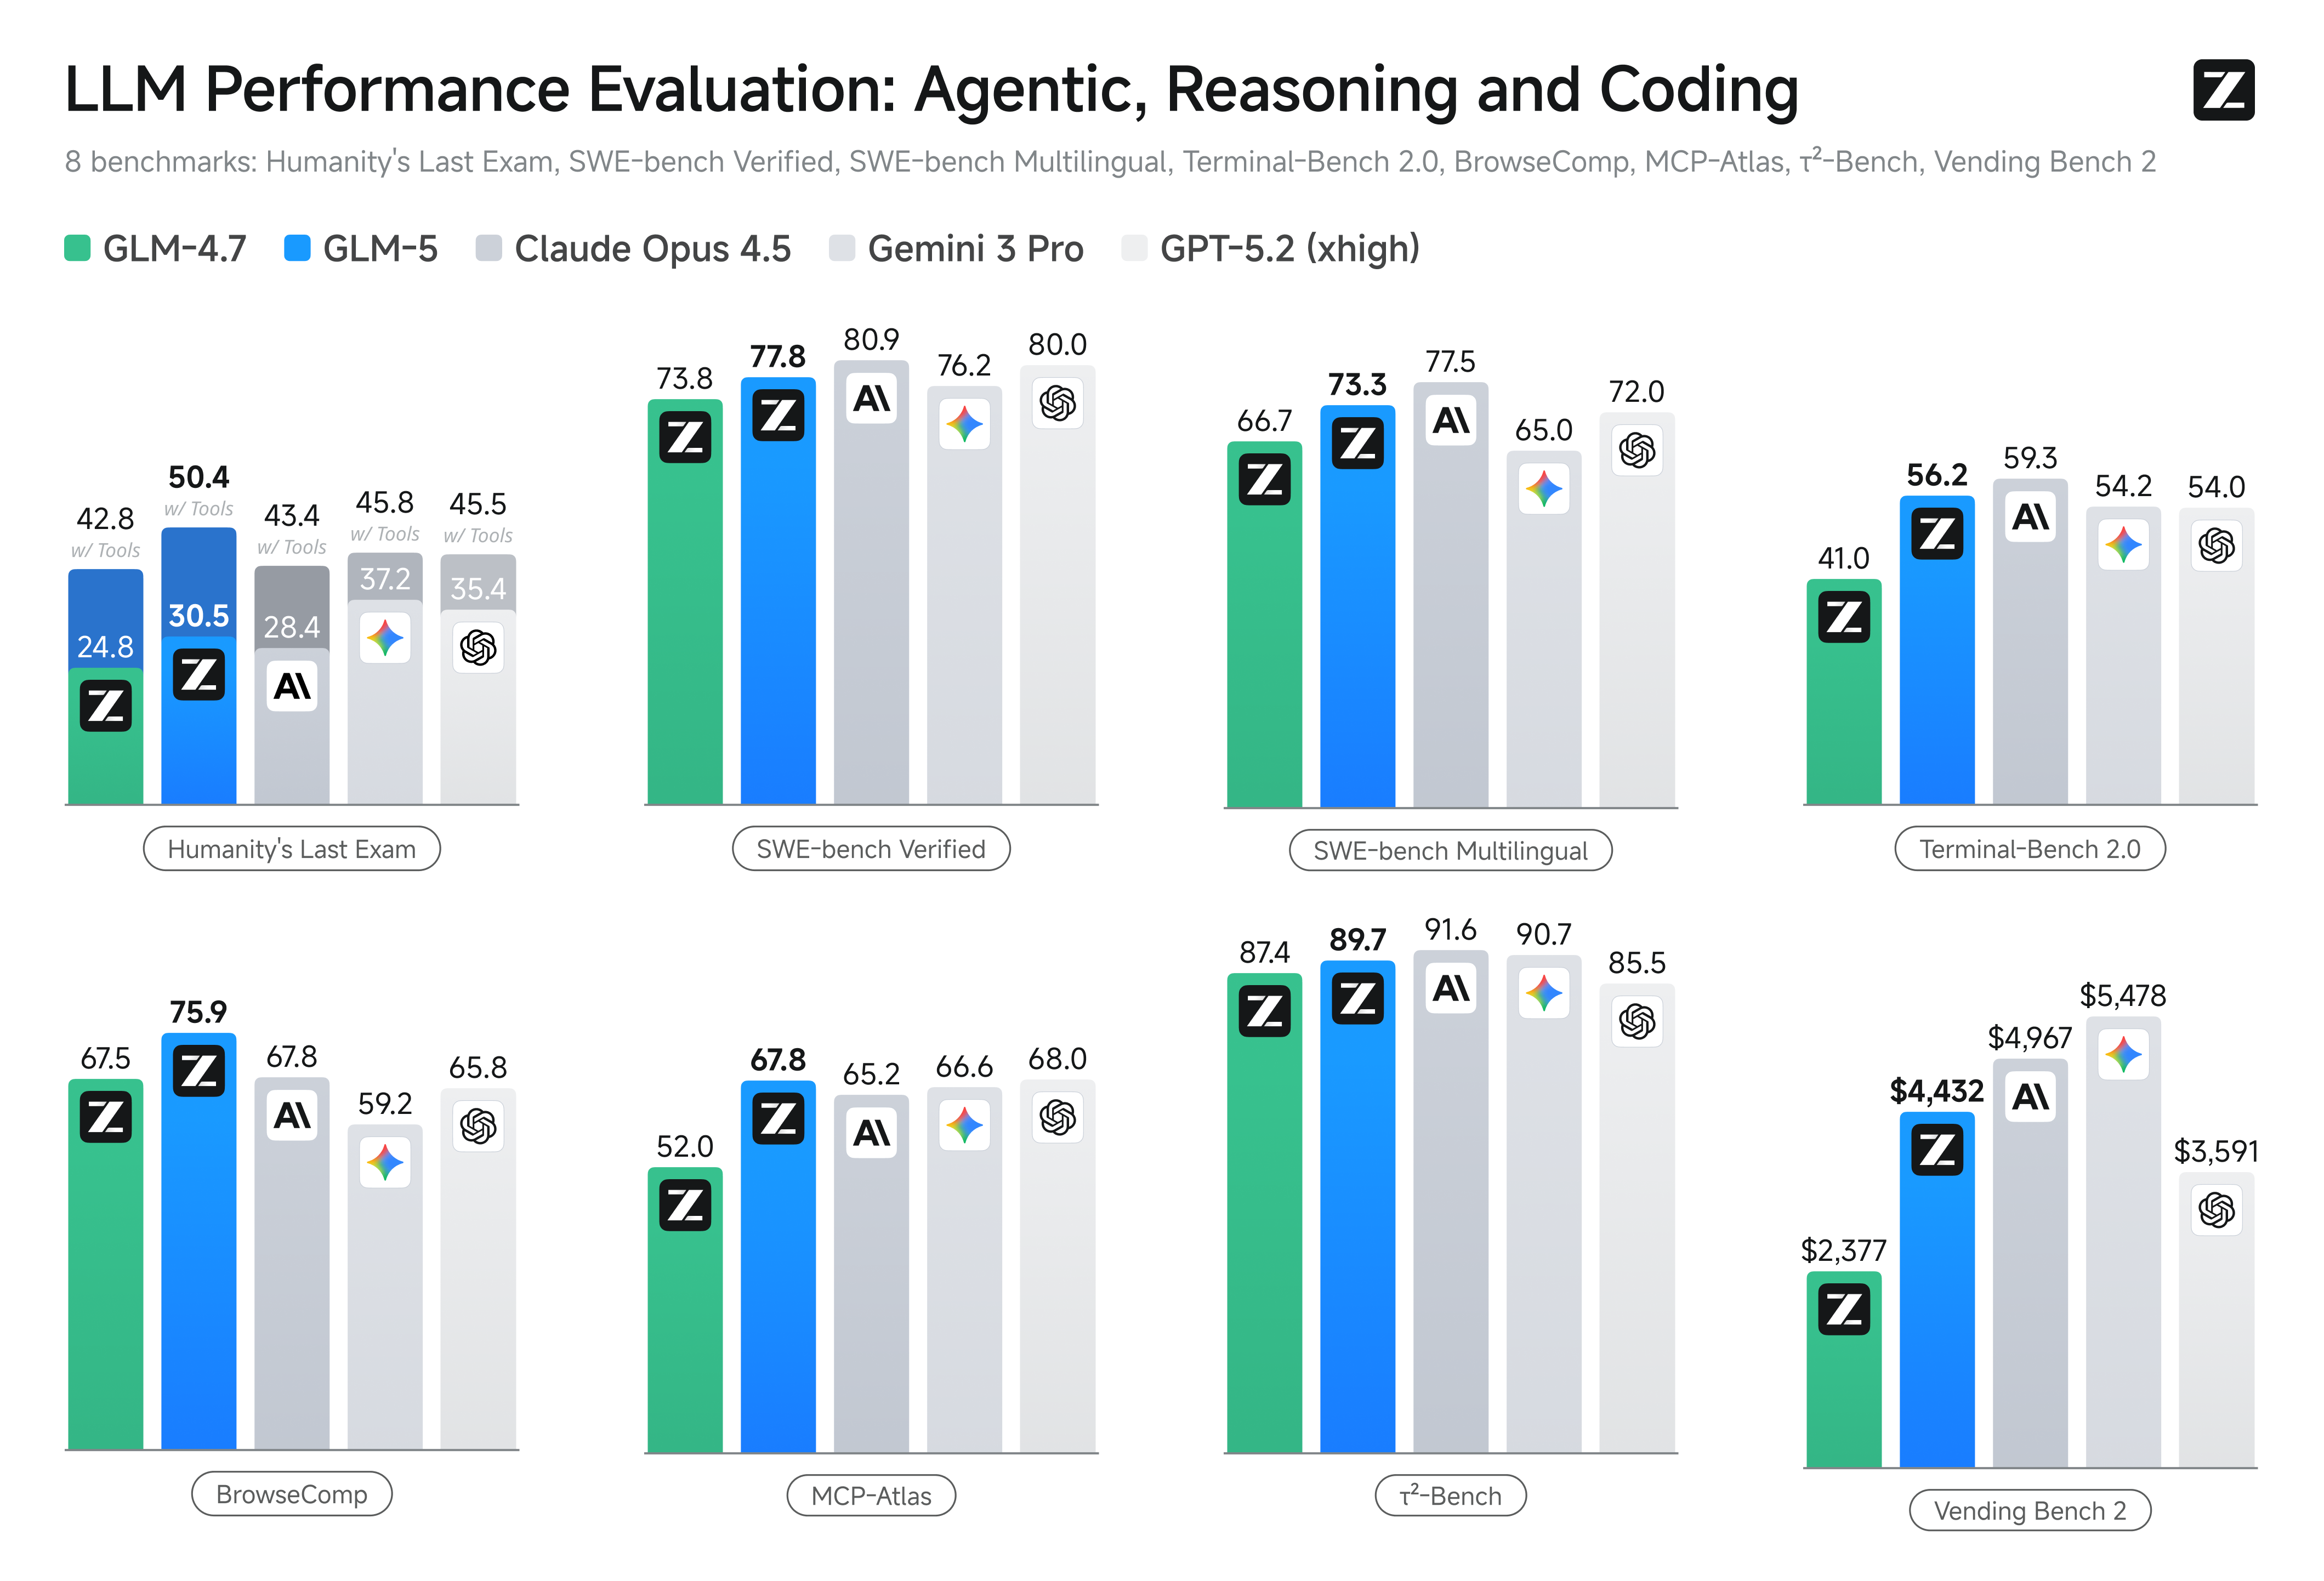
Logika planowania jest wbudowana w GLM API, dzięki czemu agenci wykonują długoterminowe, wieloetapowe zadania bez zbaczania z kursu. Ta stabilność sprawdza się w zautomatyzowanym tworzeniu oprogramowania, pipeline’ach badawczych i przepływach pracy, które zachowują spójność przez wiele kroków.
Kodowanie i rozumowanie dostrojone przez reinforcement learning
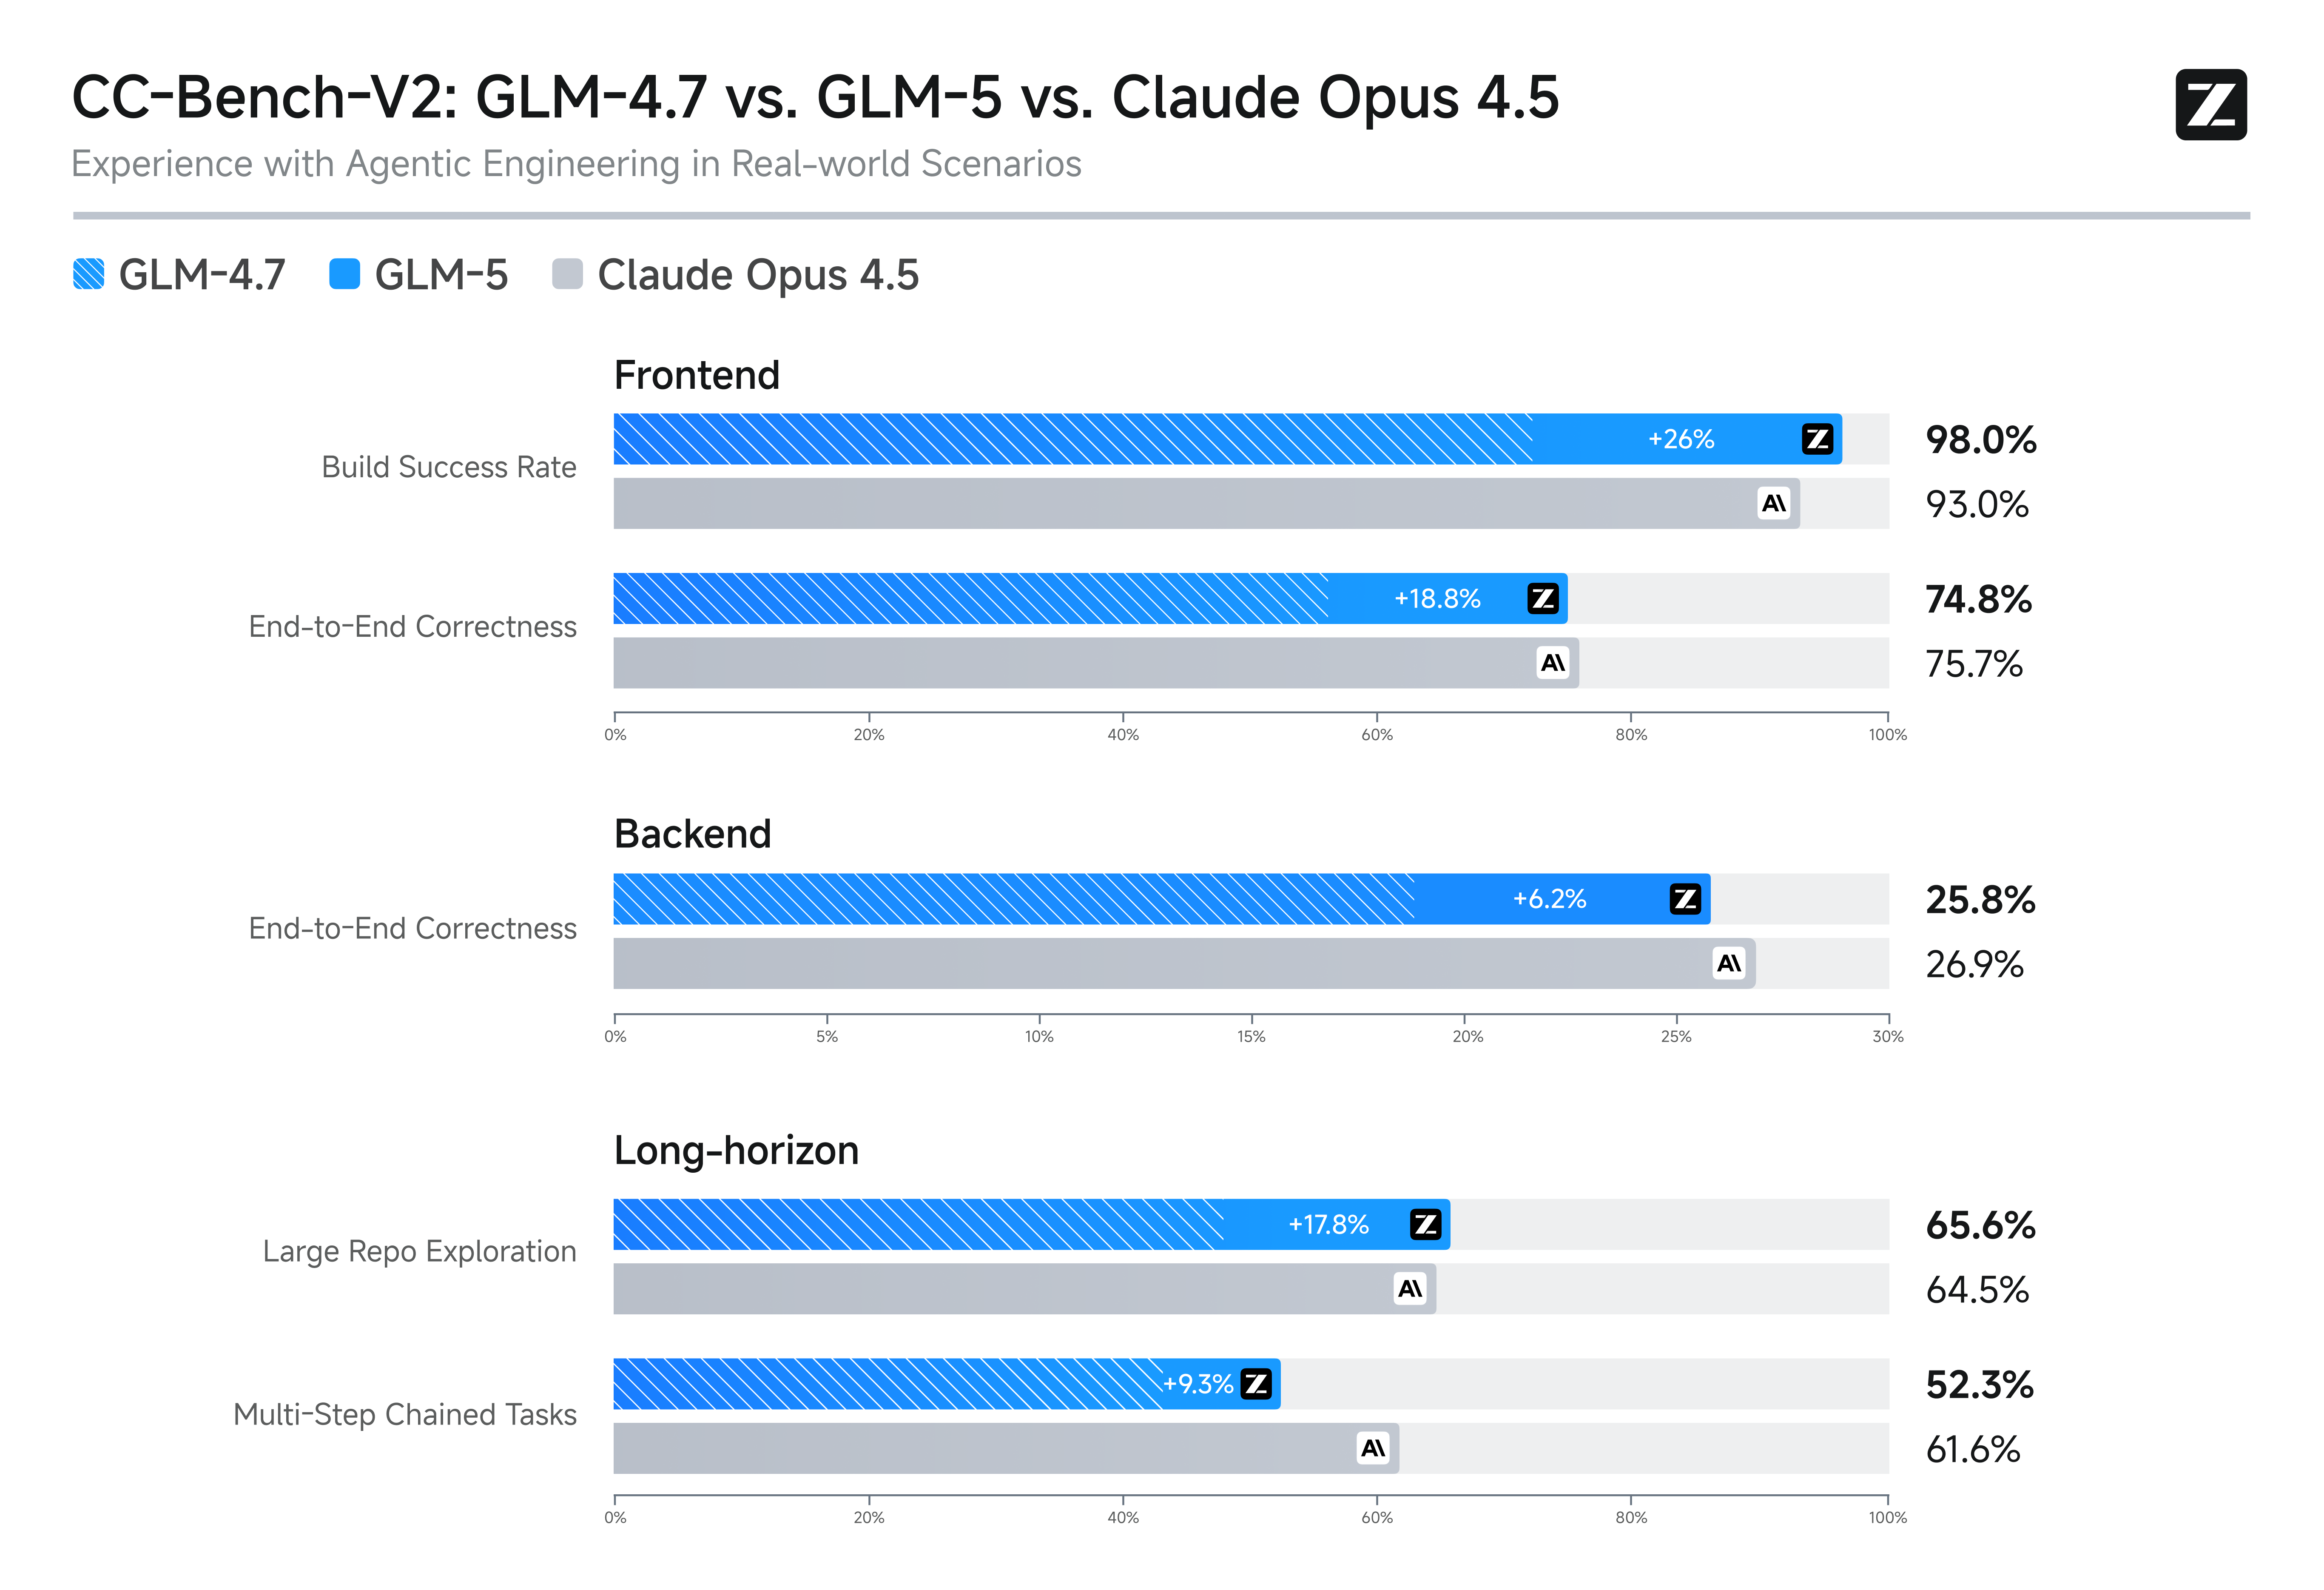
Post-training z użyciem reinforcement learning wyostrza generowanie kodu i rozumowanie algorytmiczne modelu znacznie bardziej niż we wcześniejszych wydaniach GLM. Deweloperzy otrzymują bardziej niezawodne wyniki full-stack oraz mocniejsze strukturalne rozwiązywanie problemów tam, gdzie drobne błędy logiczne mają tendencję do narastania.
Okno kontekstu 200K z rzadką uwagą
Każdy model obsługuje 200K tokens kontekstu lub więcej, z maksymalnie 128K output tokens, a sparse attention pozwala utrzymać tę skalę w rozsądnych kosztach. Całe repozytoria, długie umowy i briefy badawcze pozostają widoczne jednocześnie.
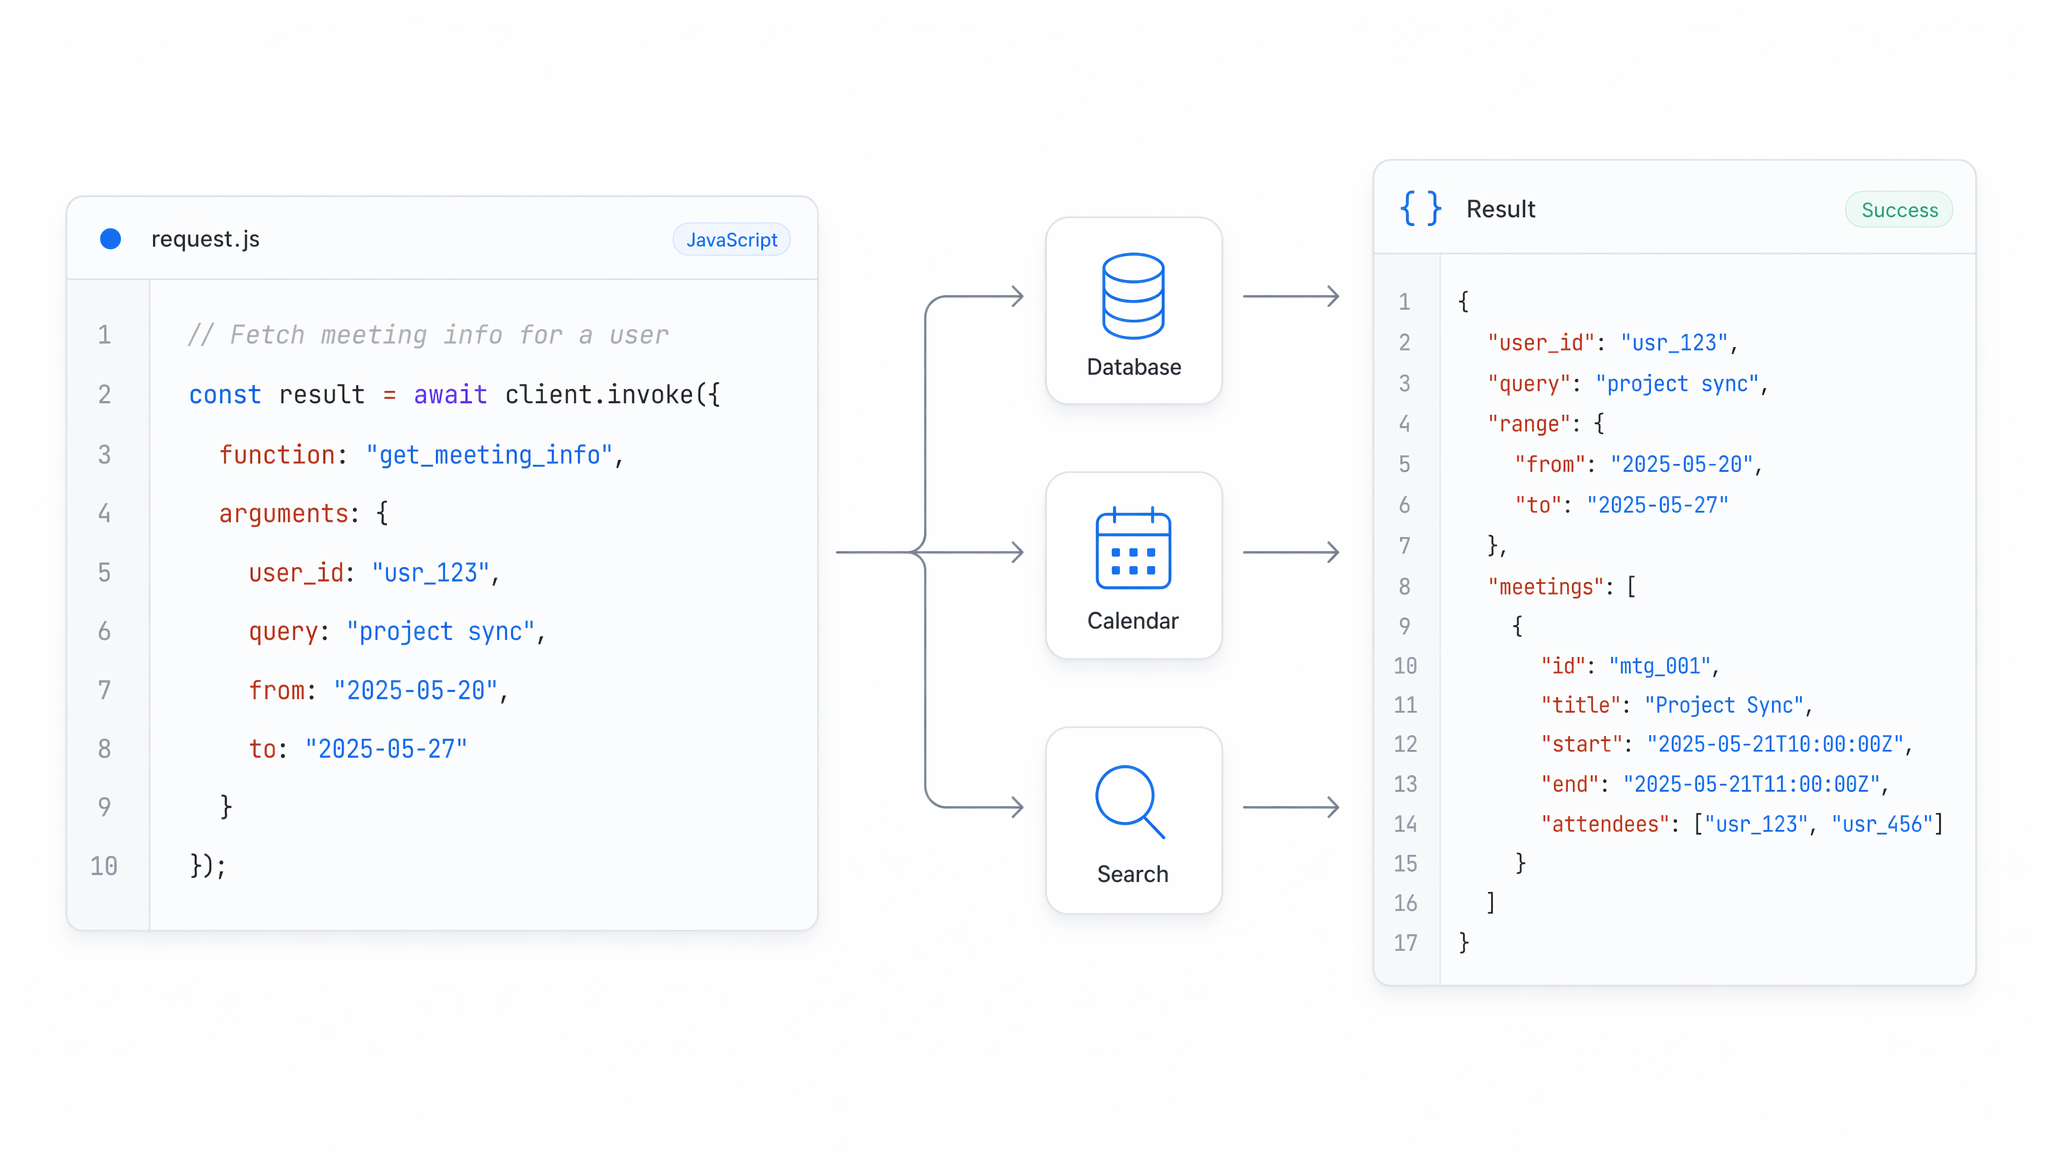
Natywne wywoływanie narzędzi przez GLM API
Podłącz zewnętrzne narzędzia i usługi do GLM API dzięki natywnemu wywoływaniu funkcji i ustrukturyzowanym danym wyjściowym JSON. Model decyduje, kiedy wywołać narzędzie, formatuje argumenty zgodnie z Twoim schematem i zwraca wyniki czytelne maszynowo.
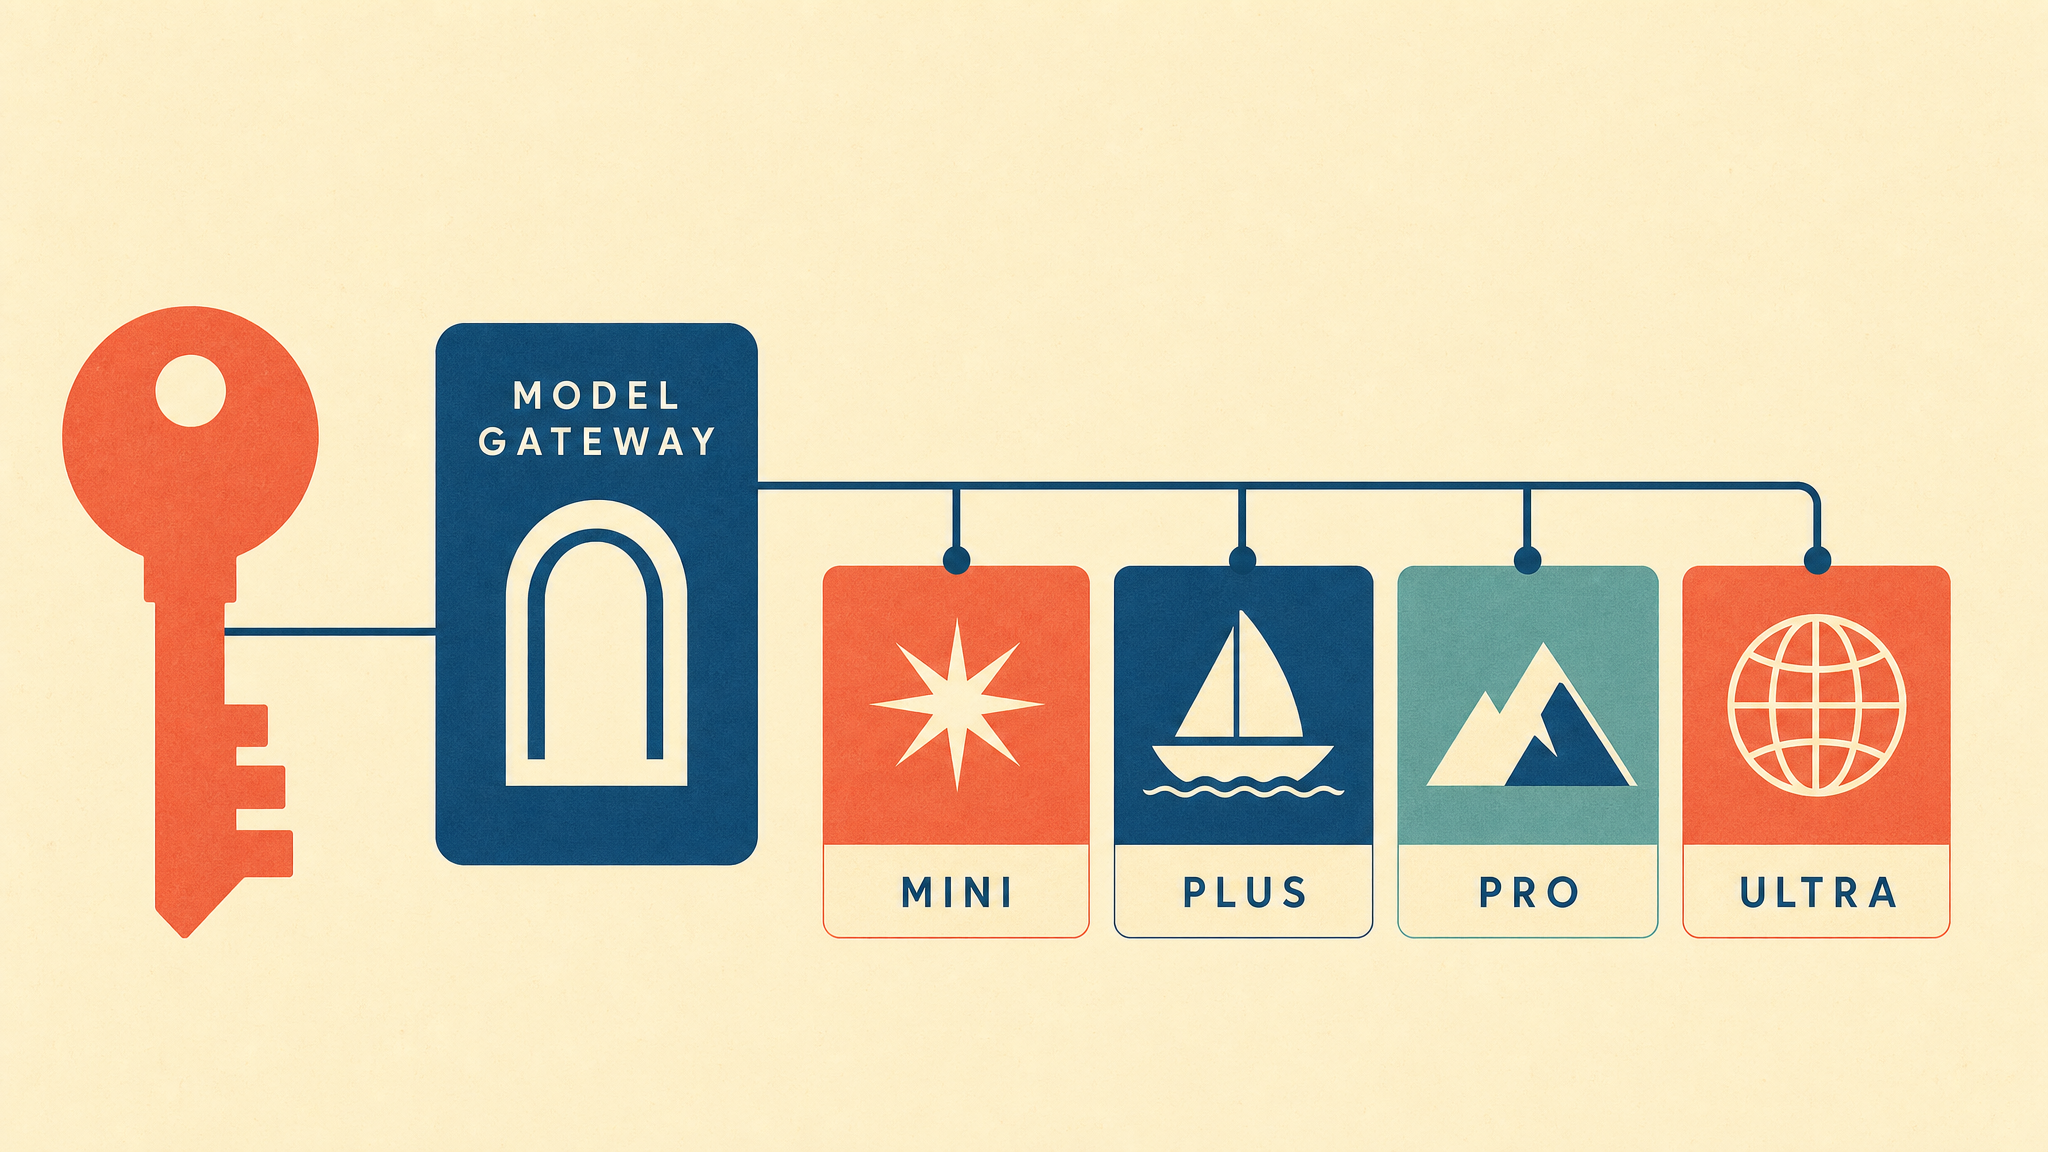
Pełna oferta GLM API pod jednym kluczem
Jeden klucz zgodny z OpenAI zapewnia dostęp do całej oferty GLM API — od flagowego GLM-5.2 po poziomy Turbo i oszczędny GLM-4.6. Prototypuj na lżejszym poziomie, a potem przejdź na produkcję jedną linią kodu i z rozliczeniem pay-as-you-go.
GLM API Head to Head: jeden brief, trzy modele w porównaniu
Wyślij jedno żądanie budowania przez GLM API i zobacz, jak GLM 5.2, DeepSeek V4 Pro oraz GLM 5 zamieniają tę samą instrukcję w działającą interaktywną stronę, aby szybko ocenić jakość front-endu, logikę układu i dopracowanie interakcji.
Wygeneruj kompletny, jednoplikowy, samowystarczalny dokument HTML (cały CSS i JavaScript osadzony inline, absolutnie bez zewnętrznych zależności, bez CDN, bez adresów URL obrazów, bez zewnętrznych fontów), który renderuje interaktywną „Aurora Tuning Console” — pełnoekranowe doświadczenie WebGL przedstawiające północne niebo o północy, gdzie zorza jest obliczana w czasie rzeczywistym wewnątrz shadera fragmentów GLSL, nigdy nie udawana za pomocą sprite’ów, tekstur ani stosów cząstek. Główne wymaganie renderowania: wyrenderuj pojedynczy pełnoekranowy quad i wykonaj całą pracę wizualną w shaderze fragmentów. Zorza polarna musi być generowana proceduralnie z warstwowego fraktalnego value/simplex noise (fbm, 4–6 oktaw), który płynie i odkształca się w czasie przez uniform zegara, tworząc wysokie pionowe kurtyny światła, które oddychają, falują, wiążą się w sploty i rozpraszają. Modeluj zorzę jako samoemisyjną poświatę wolumetryczną: akumuluj jasność wzdłuż pionowego zaniku, dodaj miękki bloom u podstawy każdej kurtyny i rozprosz subtelny dryfujący szum gwiezdnego pyłu w ciemnym górnym niebie. Skomponuj kadr jako minimalistyczne spojrzenie w górę znad niskiego horyzontu — około 80% nieba, z ciemną sylwetką górskiego grzbietu i idealnie spokojnym jeziorem u dołu, które odbija zorzę i gwiazdy w miękko falującej, pionowo lustrzanej kopii. Paleta bazowa to niemal czarny indygo (głęboka niebieskofioletowa noc); zorza jest jedynym elementem o wysokim nasyceniu — stonowana, świetlista, półprzezroczysta, nigdy krzykliwa. Interakcje (wszystkie w czasie rzeczywistym, płynne i wyraźnie responsywne): - Przeciąganie myszą po niebie „ciągnie” kurtyny światła jak tkaninę — przekaż pozycję i prędkość wskaźnika do uniformów shadera, aby zorza wyginała się, rozciągała i spływała w stronę kursora, a po puszczeniu łagodnie wracała z delikatną bezwładnością. - Przewijanie kółkiem myszy przełącza „porę roku”, ciągle interpolując pasmo kolorów zorzy przez emerald green → magenta → indigo (i z powrotem), pokazując płynne przesunięcie gradientu, a nie skokowe zmiany. - Dwuklik zapala nową gwiazdę w tym punkcie nieba: pulsuje ona (sinusoidalna jasność) i rzuca dopasowane odbicie na jezioro. Obsłuż wiele jednoczesnych gwiazd. - Zachowaj subtelną animację bezczynności, aby pierwsza kurtyna światła po wczytaniu wyglądała, jakby powoli budziła się i rozwijała — cichy, sakralny, zimny i nieruchomy nastrój. UI i dopracowanie: mały, elegancki, półprzezroczysty panel sterowania w rogu, pokazujący bieżącą porę roku/kolor oraz delikatną jednowierszową podpowiedź sterowania (przeciągnij / przewiń / dwuklik), stylizowany w czystej, nowoczesnej, chłodnej estetyce z miękkimi przejściami zanikania. Zadbaj o pełną responsywność: zmieniaj rozmiar canvas WebGL i aktualizuj uniformy rozdzielczości przy zmianie rozmiaru okna, aby wypełniał dowolny viewport i pozostawał ostry na ekranach high-DPI. Celuj w stabilne 60fps z użyciem requestAnimationFrame. Dodaj elegancki komunikat awaryjny, jeśli WebGL jest niedostępny. Priorytetem jest matematyczna jakość przepływu szumu, poświata wolumetryczna i płynność interakcji — właśnie tu mocny model powinien wyraźnie przyćmić słabszy.
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
Zbuduj kompletny, jednoplikowy, samowystarczalny dokument HTML (cały CSS i JavaScript osadzone inline w jednym pliku, absolutnie zero zewnętrznych zależności — bez CDN, bez zewnętrznych skryptów, bez web fontów, bez adresów URL obrazów, bez zasobów SVG pobieranych z sieci; generuj każdy dźwięk natywnym Web Audio API i rysuj każdy element wizualny za pomocą CSS oraz Canvas/DOM), który otwiera się bezpośrednio w dowolnej nowoczesnej przeglądarce i uruchamia grywalny cyberpunkowy automat perkusyjny step-sequencer w języku wizualnym neonowego synthwave’u lat 80. Główny instrument: wyrenderuj świecącą matrycę kroków 16 kolumn × 6 ścieżek, rozłożoną poziomo na ekranie, po jednym wierszu na głos — Kick, Snare, Closed Hi-Hat, Open Hi-Hat, Clap oraz Synth Bass. Każda z 96 komórek jest klikalnym padem; kliknięcie przełącza ją on/off, aktywna komórka rozświetla się nasyconą poświatą od magenta do cyan, a nieaktywna wygląda jak przygaszony, wpuszczony prostokąt na niemal czarnym tle indygo. Użytkownik programuje beat, zapalając komórki kolumna po kolumnie. Obsłuż malowanie przez kliknięcie i przeciąganie po komórkach, aby przełączać wiele naraz. Audio: syntetyzuj wszystkie głosy perkusyjne na żywo za pomocą Web Audio API — kick jako sinus z przemiataną wysokością i szybkim zanikiem amplitudy, snare i clap jako filtrowane wybuchy białego szumu z obwiednią, closed i open hi-hat jako szum górnoprzepustowy z krótkim vs. długim zanikiem, a synth bass jako rozstrojona piła/kwadrat przepuszczona przez rezonansowy filtr dolnoprzepustowy grająca wybieralną nutę podstawową. Planuj kroki z użyciem dokładnego zegara look-ahead (nie naiwnego taktowania setInterval), aby pętla pozostawała absolutnie stabilna przy wysokim tempie. Zapętlaj 16-krokowy pattern bez przerwy podczas odtwarzania. Transport i kontrolki, zadokowane w symetrycznym pasku sterowania przypiętym na dole: duży przycisk Play/Stop, pokrętło BPM lub rotary knob (przeciągane, zakres ~60–200 BPM, domyślnie 120) z bieżącym odczytem liczbowym, suwak głośności master, przyciski wyciszenia dla każdej ścieżki, przycisk Clear oraz przycisk Randomize generujący wiarygodny beat. Poruszający się playhead — pionowe świetlne ostrze — przesuwa się po siatce w idealnej synchronizacji z audio, a każda trafiona aktywna komórka rozkwita promienistym impulsem fali, który zanika. Dodaj podgląd oscyloskopu/przebiegu fali na żywo, który wizualizuje amplitudę wyjścia master w czasie rzeczywistym, reagując na dźwięk. Styl wizualny: gradient tła od głębokiego indygo do fioletu, tak ciemny, że odbierany jako niemal czarny, linie siatki i akcenty UI w elektrycznym magenta i cyan, całe światło pochodzące z samoświecenia elementów oraz bloom błysków trafień (poświata box-shadow, akcenty o addytywnym wrażeniu), aby przywołać nocny undergroundowy klub pulsujący w rytm pętli. Wyśrodkuj pełną siatkę na ekranie, utrzymaj symetryczny układ z paskiem sterowania kompresującym dół i zapewnij responsywność, aby siatka płynnie skalowała się na mniejszych viewportach. Dodaj subtelne animowane scanline’y lub chromatyczne migotanie dla atmosfery, bez pogarszania czytelności. Wymagania interakcji: wszystko reaguje natychmiast — klikanie padów, przeciąganie pokrętła BPM i suwaka głośności, przełączanie mute, naciśnięcie spacji do Play/Stop oraz użycie klawiszy numerycznych do zmiany nuty podstawowej basu. Stan (aktywne komórki, BPM, głośność, mute, status odtwarzania) musi być zarządzany czysto, aby UI i audio nigdy się nie rozjeżdżały. Pierwsza interakcja ze stroną powinna też odblokować/wznowić AudioContext. Priorytetem są ścisła synchronizacja audio-wideo, płynna animacja playheada i impulsów w 60fps oraz naprawdę satysfakcjonujący, muzyczny efekt od razu po uruchomieniu.
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
Gdzie deweloperzy wykorzystują GLM API
Od autonomicznych agentów programistycznych i długoterminowych badań po produkty konwersacyjne i analizę danych na dużą skalę — GLM API daje deweloperom jeden endpoint zgodny z OpenAI do tworzenia niezawodnego, agentowego oprogramowania.

Autonomiczni agenci programistyczni z GLM API
Modele GLM, stworzone do autonomicznego wykonywania zadań, planują, piszą i udoskonalają kod w wieloetapowych przepływach pracy bez utraty kontekstu projektu. Zespoły deweloperskie wykorzystują je do zasilania botów do przeglądu PR, asystentów refaktoryzacji i pipeline’ów buildów.

Długoterminowe badania i orkiestracja przepływów pracy
Stabilne, wieloetapowe rozumowanie pozwala tym modelom rozbijać rozległe pytania badawcze na mniejsze części, wywoływać narzędzia zewnętrzne i utrzymywać kontekst przez długie łańcuchy zależnych działań. To dobre rozwiązanie dla analityków i zespołów produktowych automatyzujących syntezę z wielu źródeł oraz operacje międzyplatformowe.

Tworzenie dopracowanych interfejsów front-endowych
Modele GLM przekształcają wstępne makiety i proste opisy w czysty, responsywny kod interfejsu z wyraźnym wyczuciem estetyki. Samodzielni founderzy i deweloperzy zorientowani na design znacznie szybciej dostarczają działające prototypy i produkcyjne UI.

Produkty konwersacyjne na GLM API
Chcesz asystentów, którzy sprawiają wrażenie ludzkich? GLM API zapewnia naturalne doświadczenia konwersacyjne oparte na stabilnym rozumowaniu, zasilając chatboty, copilots wsparcia i asystentów w aplikacji, którzy zachowują spójność w długich, rozgałęzionych dialogach.

Backendy wywołujące narzędzia i wykonywanie funkcji
Ponieważ te modele są projektowane z myślą o użyciu narzędzi, wybierają funkcje, formatują argumenty i łączą wywołania API w systemach agentowych. Inżynierowie wykorzystują to do wpinania GLM w warstwy orkiestracji, pipeline’y RAG i stosy wieloagentowe.

Skalowanie analizy danych z GLM API
Wykorzystaj GLM API do rozumowania na dużych dokumentach, arkuszach kalkulacyjnych i raportach oraz wydobywania ustrukturyzowanych wniosków dzięki wydajnej architekturze Mixture-of-Experts. Idealne dla zespołów finansowych, prawnych i operacyjnych, które potrzebują niezawodnej analizy na dużą skalę.
GLM API kontra konkurencyjne LLM-y: macierz specyfikacji i cen
Porównaj każdy model GLM API z wiodącymi tekstowymi LLM-ami w Atlas Cloud pod kątem długości kontekstu, limitów wyjścia i przejrzystych cen w modelu płatności za faktyczne użycie.
| Model | Okno kontekstu | Maks. wyjście | Wejście ($/1M tokenów) | Wyjście ($/1M tokenów) |
|---|---|---|---|---|
| GLM 5.2 | 1M | 128K | $1.40 | $4.40 |
| GLM 5.1 | 203K | 203K | $1.40 | $4.40 |
| GLM 5 | 203K | 203K | $1.00 | $3.20 |
| GLM 4.7 | 203K | 203K | $0.60 | $2.20 |
| DeepSeek V4 Pro | 1M | 384K | $1.74 | $3.45 |
| Kimi K2.7 Code | 256K | 256K | $0.95 | $4.00 |
| MiniMax M3 | 512K | 512K | $0.60 / $1.20 >512K | $2.40 / $4.80 >512K |
Jak używać GLM na Atlas Cloud
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Utwórz konto Atlas Cloud
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Dlaczego Używać GLM na Atlas Cloud
Połączenie zaawansowanych modeli GLM z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Wydajność i Elastyczność
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj GLM, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Przedsiębiorstwo i Skala
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
GLM API: odpowiedzi na częste pytania deweloperów
GLM API zapewnia deweloperom dostęp do serii GLM otwartowagowych dużych modeli językowych Z.ai (Zhipu AI), w tym GLM-5.2, GLM-5, GLM-4.7 i GLM-4.6. Modele te zaprojektowano z myślą o kodowaniu, wieloetapowym rozumowaniu i zadaniach autonomicznych agentów. W Atlas Cloud uzyskujesz dostęp do całej rodziny przez jeden endpoint zgodny z OpenAI, z rozliczeniem pay-as-you-go.
Atlas Cloud udostępnia aktualną linię GLM, w tym GLM-5.2, GLM-5.1, GLM-5, GLM-5 Turbo, GLM-5v Turbo, GLM-4.7 i GLM-4.6. Wersje flagowe są przeznaczone do złożonych zadań agentowych i programistycznych, natomiast warianty Turbo stawiają na szybsze odpowiedzi o niższych opóźnieniach. Przełączenie między nimi wymaga jedynie zmiany identyfikatora modelu w żądaniu.
Zarejestruj się w Atlas Cloud, wygeneruj jeden klucz API i skieruj istniejącego klienta zgodnego z OpenAI na nasz endpoint. Ponieważ GLM API korzysta z formatu żądań OpenAI, większość integracji wymaga jedynie zmiany bazowego URL i nazwy modelu, aby zacząć wysyłać żądania. Dostęp jest rozliczany w modelu pay-as-you-go, z przejrzystymi cenami za wywołanie i bez subskrypcji.
Ceny są rozliczane w modelu pay-as-you-go za token, bez wymaganej subskrypcji. GLM-4.7 i GLM-4.6 zaczynają się od $0.60 za milion tokenów wejściowych i $2.20 za milion tokenów wyjściowych, GLM-5 kosztuje $1.00 za wejście i $3.20 za wyjście, a GLM-5.2 kosztuje $1.40 za wejście i $4.40 za wyjście. Buforowane wejście jest rozliczane po niższej stawce, co obniża koszt przy powtarzanym kontekście.
Modele GLM w Atlas Cloud oferują duże okno kontekstu wynoszące około 200K tokenów, a maksymalna długość wyjścia w wersjach flagowych sięga około 131K tokenów. Taka pojemność wystarcza, aby w jednym żądaniu załadować całe repozytoria, długie dokumenty lub rozbudowane historie agentów. W rodzinie GLM istnieją warianty z dłuższym kontekstem, więc sprawdź dokładny limit na stronie danego modelu.
Tak. Modele GLM obsługują wywoływanie narzędzi i funkcji oraz uporządkowane dane wyjściowe JSON, dzięki czemu można je bezpośrednio włączać do potoków agentowych i systemów produkcyjnych oczekujących odpowiedzi czytelnych maszynowo. W połączeniu z formatem zgodnym z OpenAI GLM API łatwo podłączyć do istniejących przepływów pracy korzystających z narzędzi.
Modele te są tworzone z myślą o programowaniu, rozumowaniu w długim horyzoncie i wykonywaniu zadań przez autonomicznych agentów. Typowe zastosowania obejmują analizę kodu całych repozytoriów, prototypowanie full-stack oraz wieloetapowe badania lub automatyzację przepływów pracy. Flagowa seria GLM-5 radzi sobie z najbardziej wymagającymi zadaniami agentowymi, a GLM-4.6 oferuje mocny balans szybkości i możliwości w codziennych zadaniach.
Flagowe modele GLM są pozycjonowane jako konkurencyjne otwartowagowe alternatywy dla wiodących modeli zamkniętych w benchmarkach kodowania i zadań agentowych. Główną praktyczną zaletą jest koszt, ponieważ ceny za token stanowią ułamek stawek porównywalnych modeli własnościowych, a wydajność w programowaniu pozostaje wysoka. Dla zespołów ważących budżet względem jakości GLM oferuje możliwości na poziomie frontier w niższej cenie.
Tak. Atlas Cloud udostępnia modele GLM przez endpoint zgodny z OpenAI, więc każdy framework lub SDK akceptujący niestandardowy bazowy URL i nazwę modelu może wywoływać je przy minimalnych zmianach. Dzięki temu możesz włączyć GLM do agentów wywołujących narzędzia, asystentów kodowania i wieloetapowych potoków orkiestracji, których już używasz. Zacznij budować już dziś.
Tak. Seria GLM jest udostępniana przez Z.ai (Zhipu AI) jako modele otwartowagowe na liberalnej licencji, dlatego powszechnie uznaje się je za jedną z czołowych opcji open-source. W Atlas Cloud otrzymujesz zarządzany, gotowy do produkcji dostęp do tych modeli bez samodzielnego hostingu ani utrzymywania infrastruktury.
Poznaj Więcej Rodzin
Kling 4.0
Opracowany przez Kuaishou Kling V4 to model wideo przeznaczony do profesjonalnej produkcji. Łączy stabilne odwzorowanie złożonego ruchu z ultraszerokim formatem 21:9 i precyzyjną edycją mimiki, kątów kamery, tła, stylów wizualnych oraz dialogów. Atlas Cloud przygotowuje dostęp od pierwszego dnia za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym cennikiem opartym na rzeczywistym użyciu, który ułatwia elastyczną integrację. Zacznij tworzyć już dziś.

Seedance 2.5
API Seedance 2.5 jest już dostępne w Atlas Cloud! Zapewnia deweloperom najnowszy model wideo od ByteDance. Generuje do 30 sekund natywnego wideo w jednym przebiegu z tekstu, pojedynczego obrazu lub nawet 50 wielomodalnych odniesień, z zsynchronizowanym dźwiękiem i wielojęzycznym tekstem w kadrze. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza, a spójność obiektu i ulepszona fizyka zachowują spójność długich ujęć.
Wan 3.0
API Wan 3.0 to kolejna generacja rodziny wideo Wan firmy Alibaba, stworzona po to, by wznieść generowanie długich form, kontrolę wielu referencji i jakość audiowizualną na nowe wyżyny. Atlas Cloud hostuje już Wan 2.7, 2.6 i 2.5, a Wan 3.0 działa na tym samym ujednoliconym kluczu bez konieczności oddzielnej konfiguracji. Rozpocznij budowanie już dziś. Przewiń w dół do sekcji prezentacji, aby zobaczyć, co potrafi stworzyć Wan 3.0.
MiniMax H3
MiniMax H3 to multimodalna rodzina modeli wideo MiniMax do tworzenia na podstawie tekstu, obrazu i materiałów referencyjnych. We wszystkich obsługiwanych trasach zachowuje obiekty z materiałów referencyjnych, oferuje elastyczne proporcje obrazu i łączy wygenerowany dźwięk z obrazem za pośrednictwem H3 Developer, a profile wynikowe są wybierane na poziomie endpointu. Atlas Cloud udostępnia całą rodzinę za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym rozliczeniem pay-as-you-go według standardowej stawki $0.038 za sekundę. Zacznij tworzyć już dziś.
GPT Image 2.5
Rodzina modeli gpt-image-2.5 firmy OpenAI daje programistom wybór między Flare i Sunburst na potrzeby produkcyjnych procesów generowania obrazów. Renderuj w dowolnych rozdzielczościach do 3840x2160 i wybieraj spośród pięciu poziomów jakości, w tym xhigh i max, aby spełnić konkretne wymagania dotyczące wyników. Atlas Cloud zapewnia gotową do użycia inferencję REST bez zimnych startów i ze standardową ceną od $0.004 za generowanie. Zacznij tworzyć już dziś.
Seedream 5.0 Pro
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0
Seedance 2.0 to produkcyjny model wideo firmy ByteDance, umożliwiający precyzyjne tworzenie ujęć. Zamieniaj polecenia na wideo, animuj obraz pierwszej klatki z opcjonalnym wskazaniem ostatniej klatki lub kształtuj wyniki za pomocą materiałów referencyjnych i opcjonalnego wyszukiwania w sieci. Atlas Cloud łączy te procesy w jeden ujednolicony interfejs API, oferując przejrzyste rozliczanie zgodnie z użyciem oraz jeden klucz kompatybilny z OpenAI. Zacznij tworzyć już dziś.
Kling V3.0
Rodzina API Kling V3 od Kuaishou obsługuje przepływy pracy z tekstem, obrazami i referencyjnymi materiałami wideo. Przenoś ruch, zachowując tożsamość postaci, kieruj generowaniem za pomocą odniesień wizualnych i edytuj filmy poleceniami w języku naturalnym. Atlas Cloud udostępnia endpointy Standard i Pro, dostosowane do różnych potrzeb produkcyjnych. Tworzysz już za pomocą Kling 3.0? Kling V4 jest już dostępny w Atlas Cloud. Poznaj go na [stronie rodziny modeli Kling V4](https://www.atlascloud.ai/models/kling-v4).
Grok Imagine Video
Grok Imagine Video zapewnia deweloperom dostęp do rodziny modeli wideo xAI do tworzenia, animowania, wydłużania i edytowania klipów. Generuj filmy o długości od 1 do 15 sekund na podstawie promptów, steruj postaciami, obiektami lub stylami, korzystając z maksymalnie siedmiu obrazów referencyjnych, i pracuj w rozdzielczości 480p lub 720p. Atlas Cloud udostępnia te możliwości za pośrednictwem endpointów zgodnych z OpenAI, oferując przejrzyste rozliczanie pay-as-you-go. Zacznij tworzyć już dziś.
Vidu Q4 Preview
Vidu Q4 to najnowszy flagowy model wideo firmy Vidu, przeznaczony do generowania wideo na podstawie obrazu oraz referencji. Potrafi animować pojedynczy obraz nieruchomy i automatycznie tworzyć przejścia między scenami, oferując deweloperom dwie ścieżki wejściowe na potrzeby różnych przepływów pracy produktu. Atlas Cloud udostępnia dedykowane endpointy API z opublikowanymi schematami parametrów w zweryfikowanej standardowej cenie $0.04 za sekundę. Zacznij tworzyć już dziś.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash to natywnie multimodalna rodzina modeli wideo Google DeepMind, przeznaczona do elastycznych procesów produkcyjnych. Edytuj istniejący materiał za pomocą instrukcji tekstowych, zachowuj spójność wizualną dzięki maksymalnie 10 obrazom referencyjnym i 3 klipom wideo lub wydłużaj ujęcia w łączonych segmentach do 40 sekund. Uzyskaj dostęp do wszystkich procesów w Atlas Cloud za pomocą jednego klucza API zgodnego z OpenAI, z rozliczaniem według zużycia i dostępnością od pierwszego dnia. Zacznij tworzyć już dziś.
Nano Banana 2.1
Nano Banana 2.1 to rodzina modeli obrazowych firmy Google, zbudowana na bazie Gemini 3.6 Flash. Zapewnia generowanie i edycję na poziomie Pro z szybkością Flash, obsługuje edycję w języku naturalnym oraz łączenie od 1 do 14 obrazów wejściowych, a także zachowuje spójność do 4 postaci i 10 obiektów. Dzięki Atlas Cloud deweloperzy mogą korzystać z tej rodziny za pomocą jednego klucza zgodnego z OpenAI, niezawodnej dostępności i dostępności od Day-0. Zacznij tworzyć już dziś.
Polecane artykuły
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.





