
Grok API: xAI Reasoning and Coding Models
Grok, opracowany przez xAI, to seria dużych modeli językowych zbudowanych wokół świadomości w czasie rzeczywistym i rozumowania na najwyższym poziomie. Grok 4.3 to zaawansowany model konwersacyjny xAI, zoptymalizowany pod kątem naturalnego dialogu, eksploracji wiedzy i wieloetapowego wnioskowania w oknie kontekstowym liczącym 1 000 000 tokenów. Grok Build 0.1 obiera inny kierunek — został stworzony specjalnie do tworzenia oprogramowania, a jego możliwości skupiają się na generowaniu kodu, debugowaniu i refaktoryzacji w złożonych przepływach pracy programistów. Oba modele są dostępne w Atlas Cloud za pośrednictwem punktów końcowych API kompatybilnych z OpenAI, w cenie od 1 USD za milion tokenów.
Grok został opracowany przez xAI. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Poznaj Wiodące Modele
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.

Porównanie modeli Grok API
Match each job to the right model: Grok 4.3 for reasoning across a 1M token context and Grok Build 0.1 for agentic coding, both reachable through one OpenAI-compatible key on Atlas Cloud.
| Model | Type | Best For | Context | Inputs | Function Calling | Structured Outputs | Prompt Caching | Status |
|---|---|---|---|---|---|---|---|---|
| Grok 4.3 | Flagship reasoning model | Logic, analysis, multi-step agents, long-document work | 1M tokens | Text, image | Yes | Yes | Yes | Flagship, GA |
| Grok Build 0.1 | Coding-focused model | Code generation, debugging, refactoring, coding agents | 256K tokens | Text, image | Yes | Yes | Yes | Early access |
Grok API Features
The Grok API brings xAI's reasoning and coding models to Atlas Cloud with a 1M token context window, always-on reasoning, function calling, structured outputs, vision input, and prompt caching, all behind one OpenAI-compatible key.
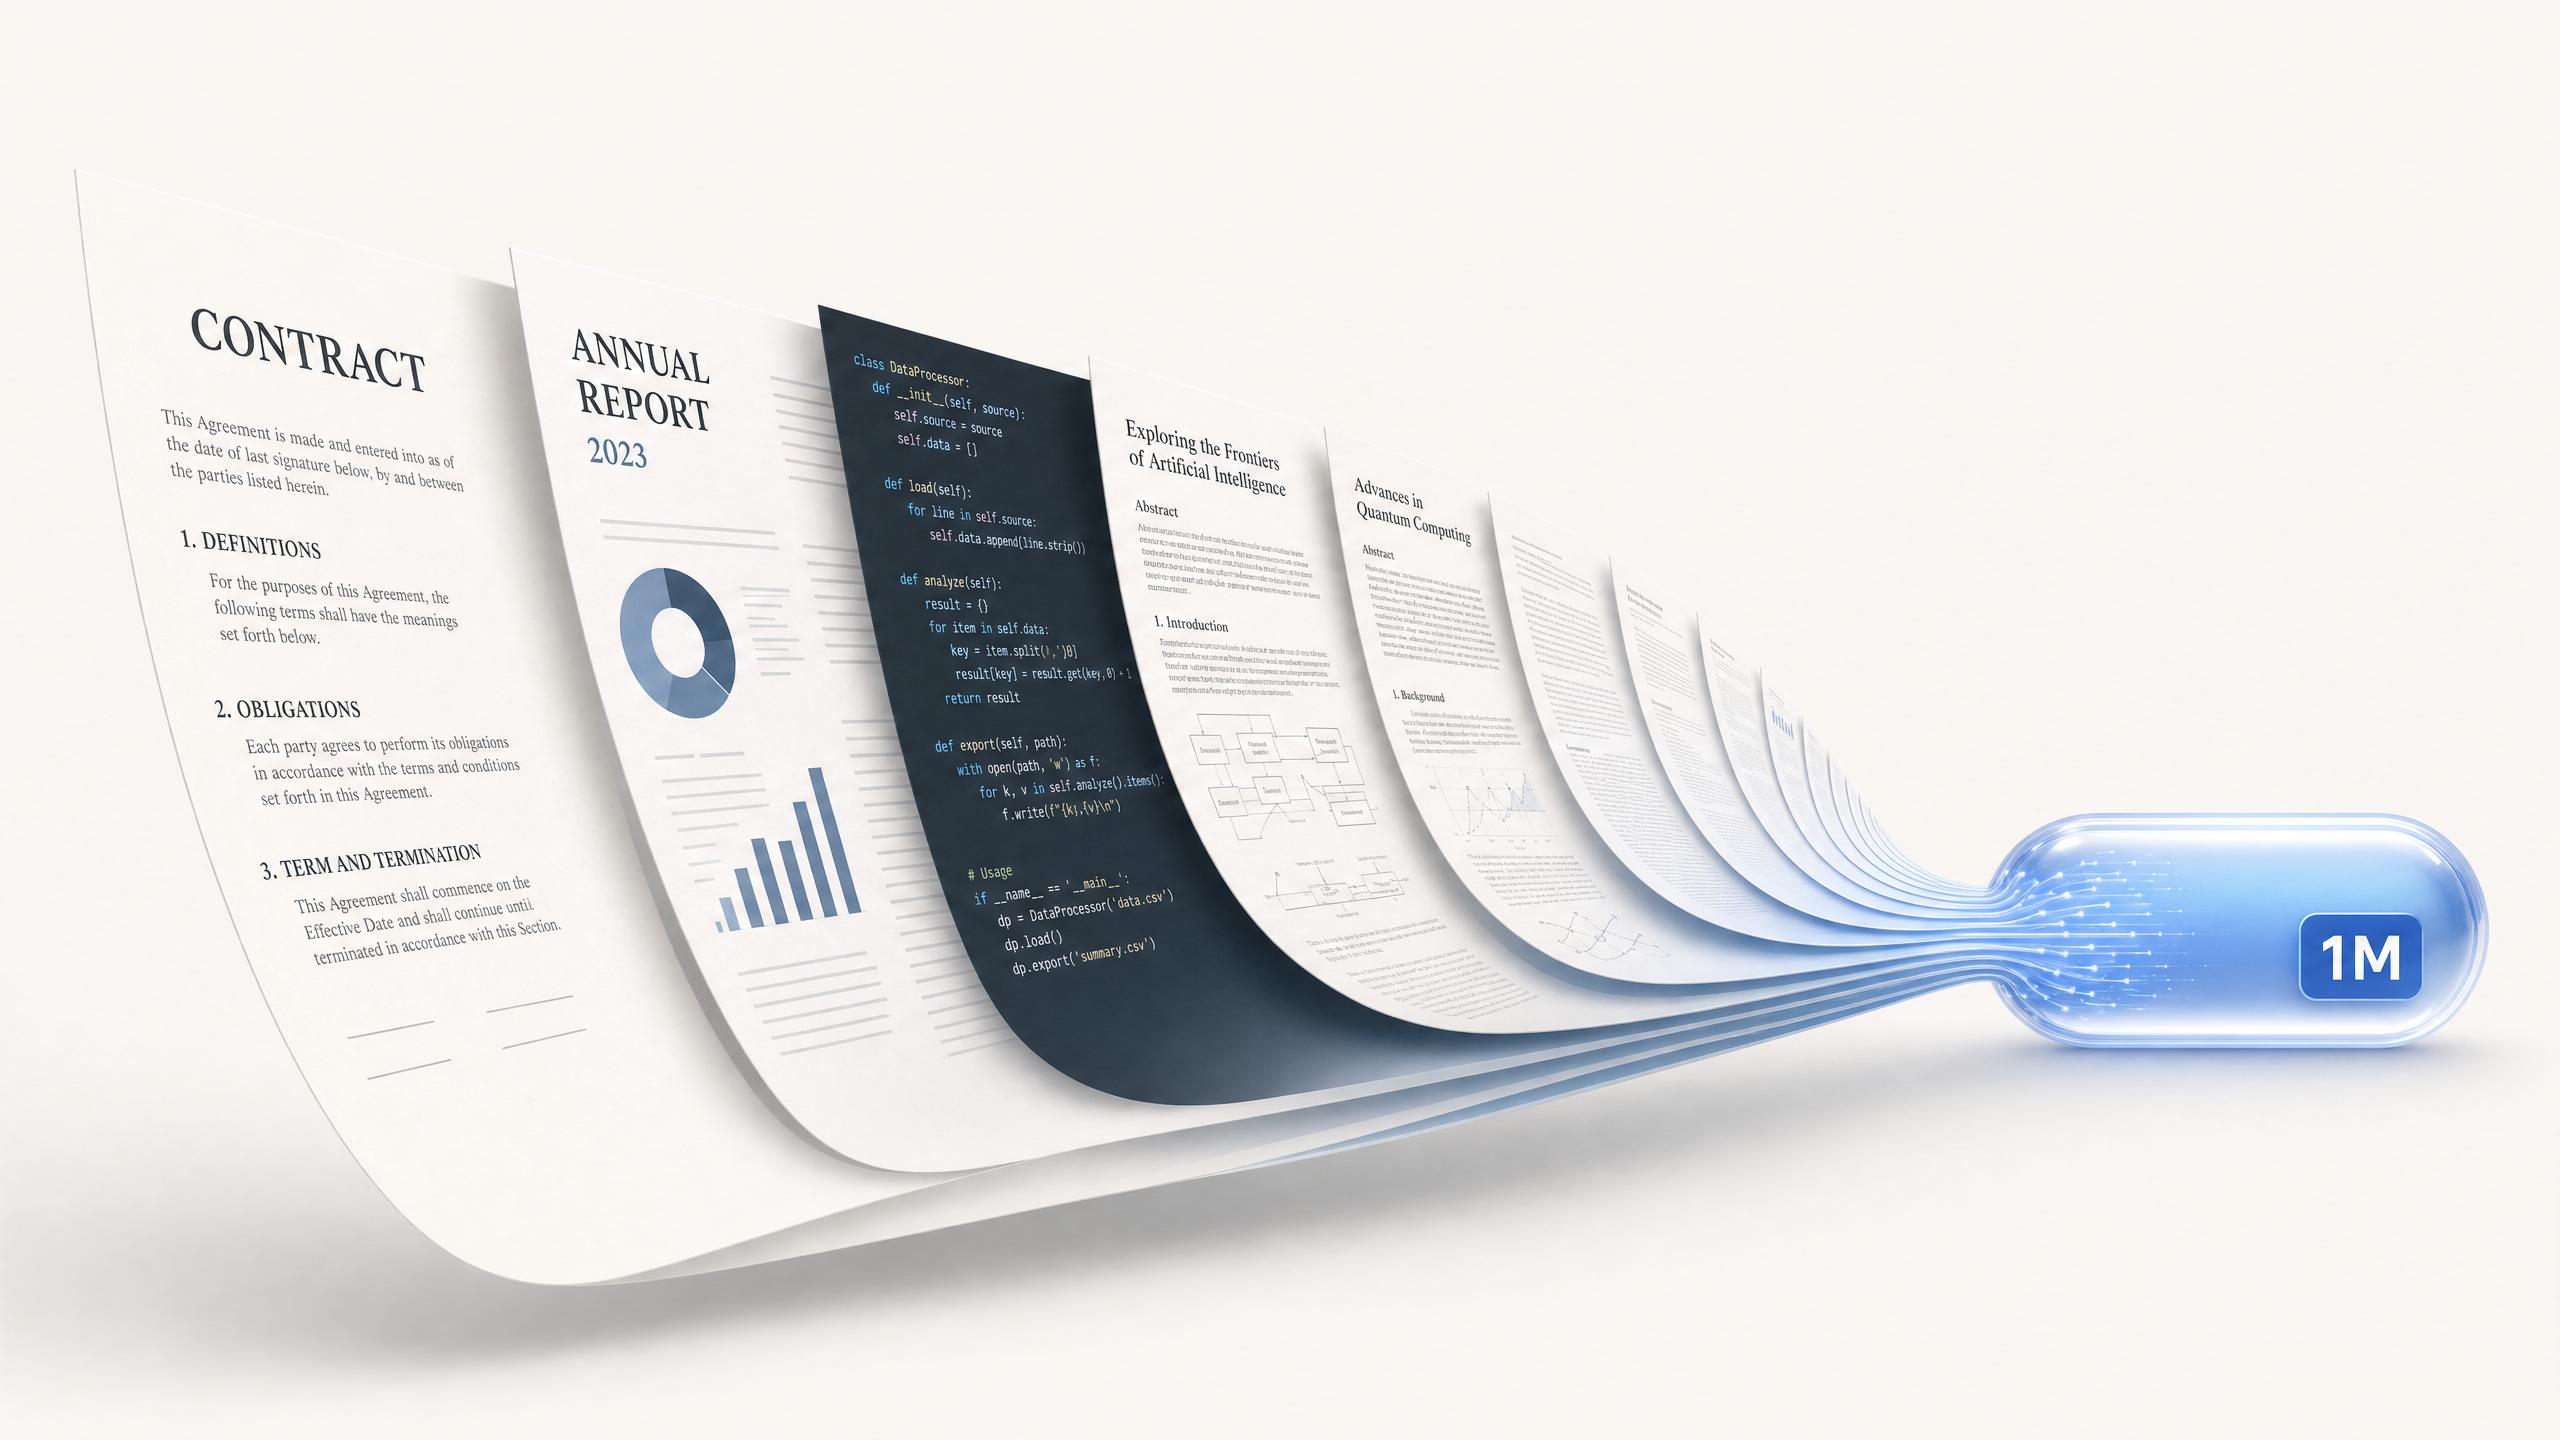
1M Token Context Window
Grok 4.3 handles up to one million tokens in a single request, enough for full contract sets, large codebases, or long multi-turn agent sessions. The wide context removes chunked retrieval and preserves cross-document reasoning that shorter models lose.
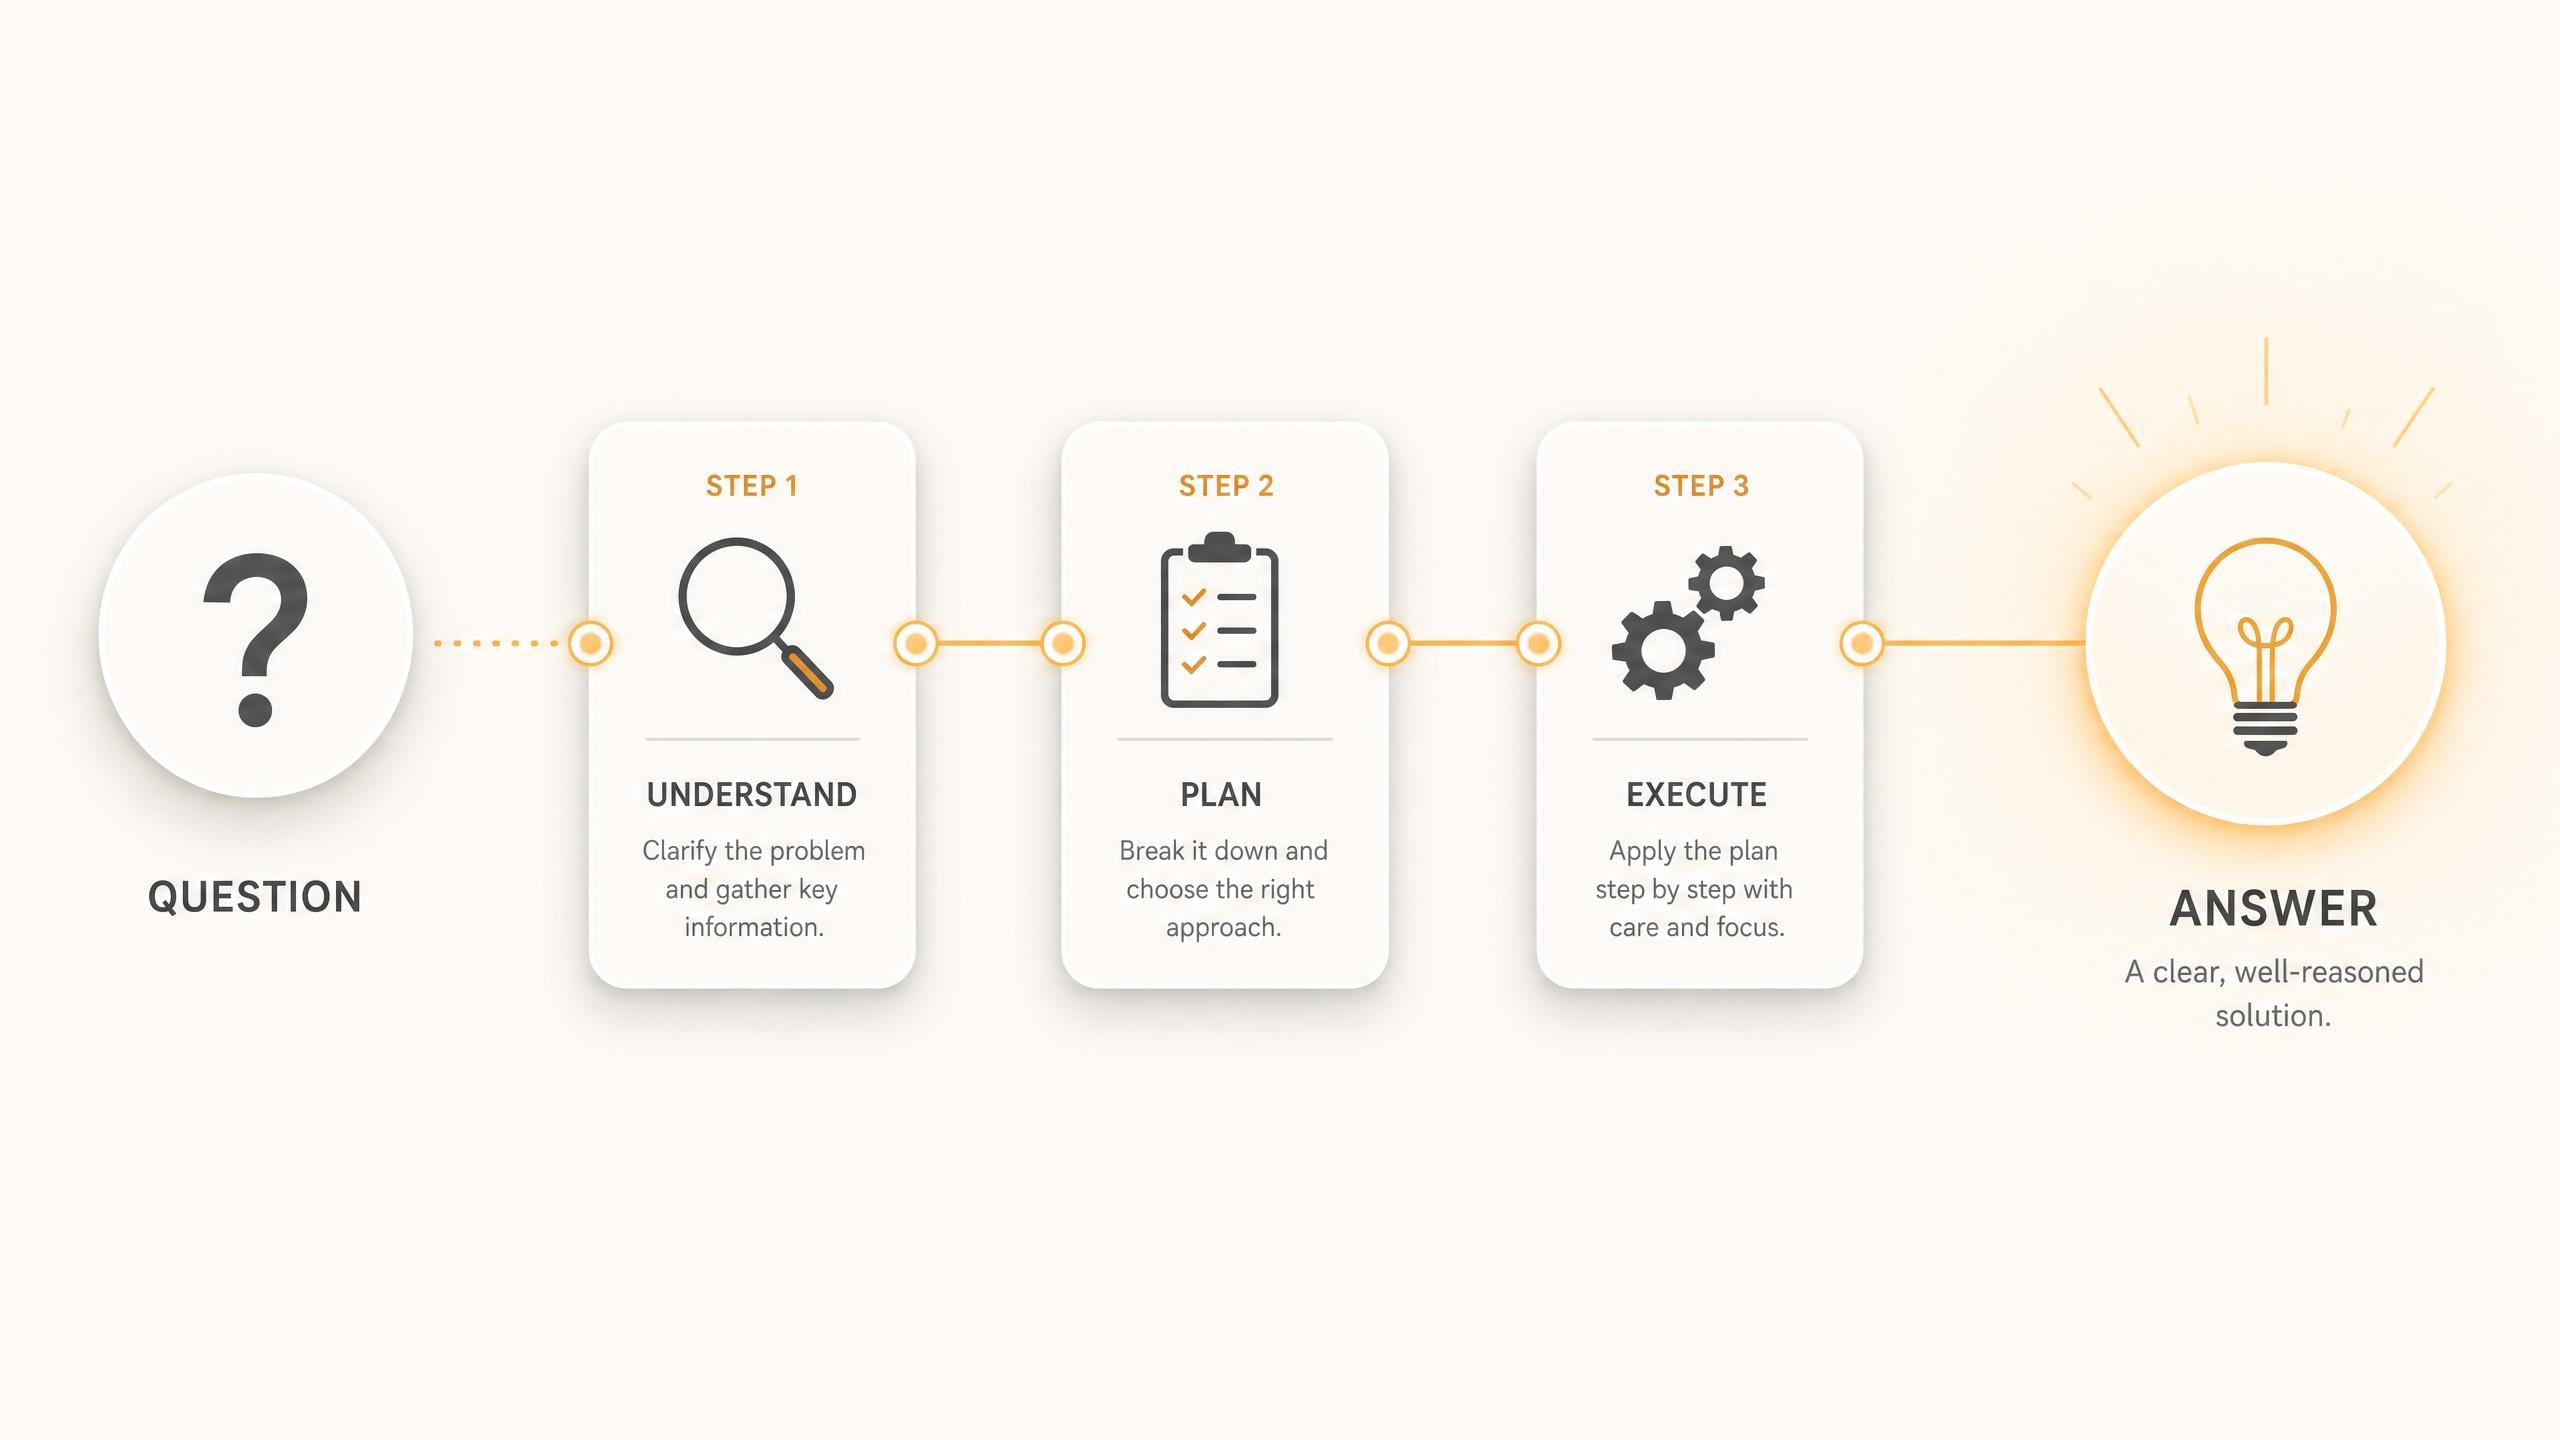
Always-On Reasoning with the Grok API
The Grok API runs Grok 4.3 with built-in step-by-step reasoning, tuned for accuracy-critical work like logic, math, and multi-step analysis. The model thinks before it answers, which lifts factual reliability and instruction following on complex prompts.
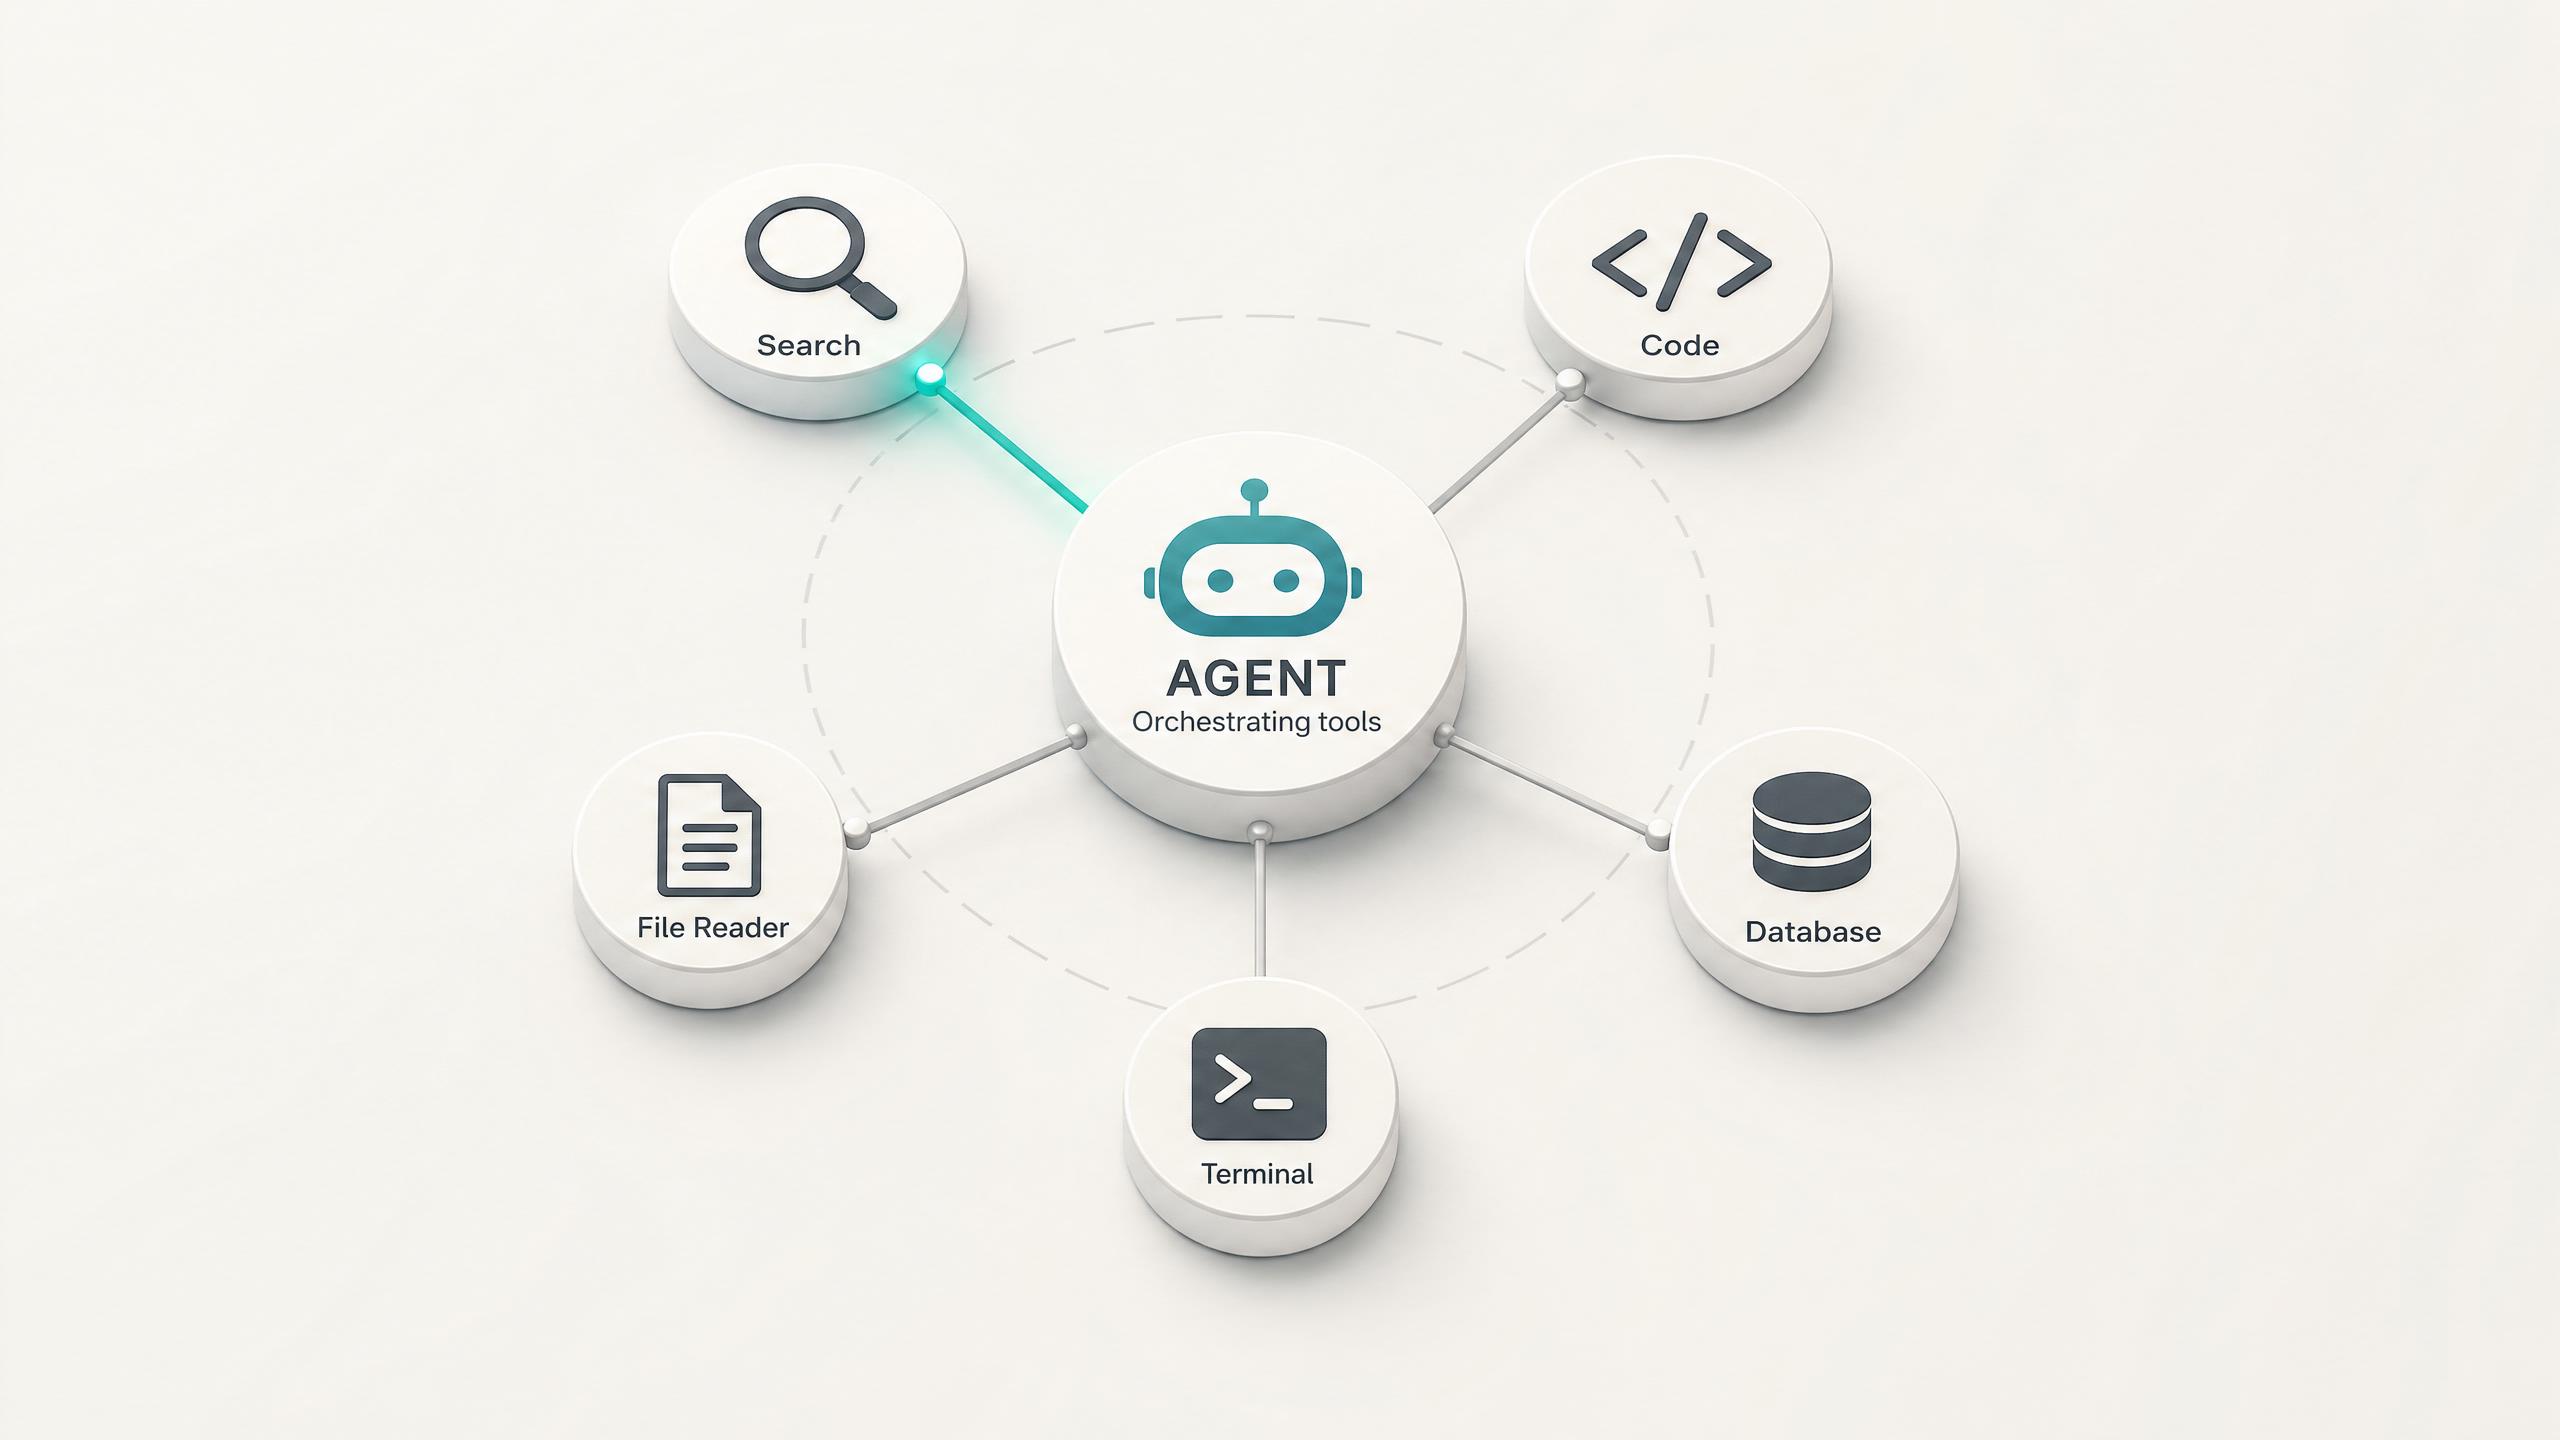
Agentic Tool Calling
Grok 4.3 is built for agents: it plans, calls functions in sequence, and adjusts on intermediate results. Native function calling lets it trigger tools and APIs mid-task, the foundation for research agents, support bots, and automation that runs without a human in the loop.
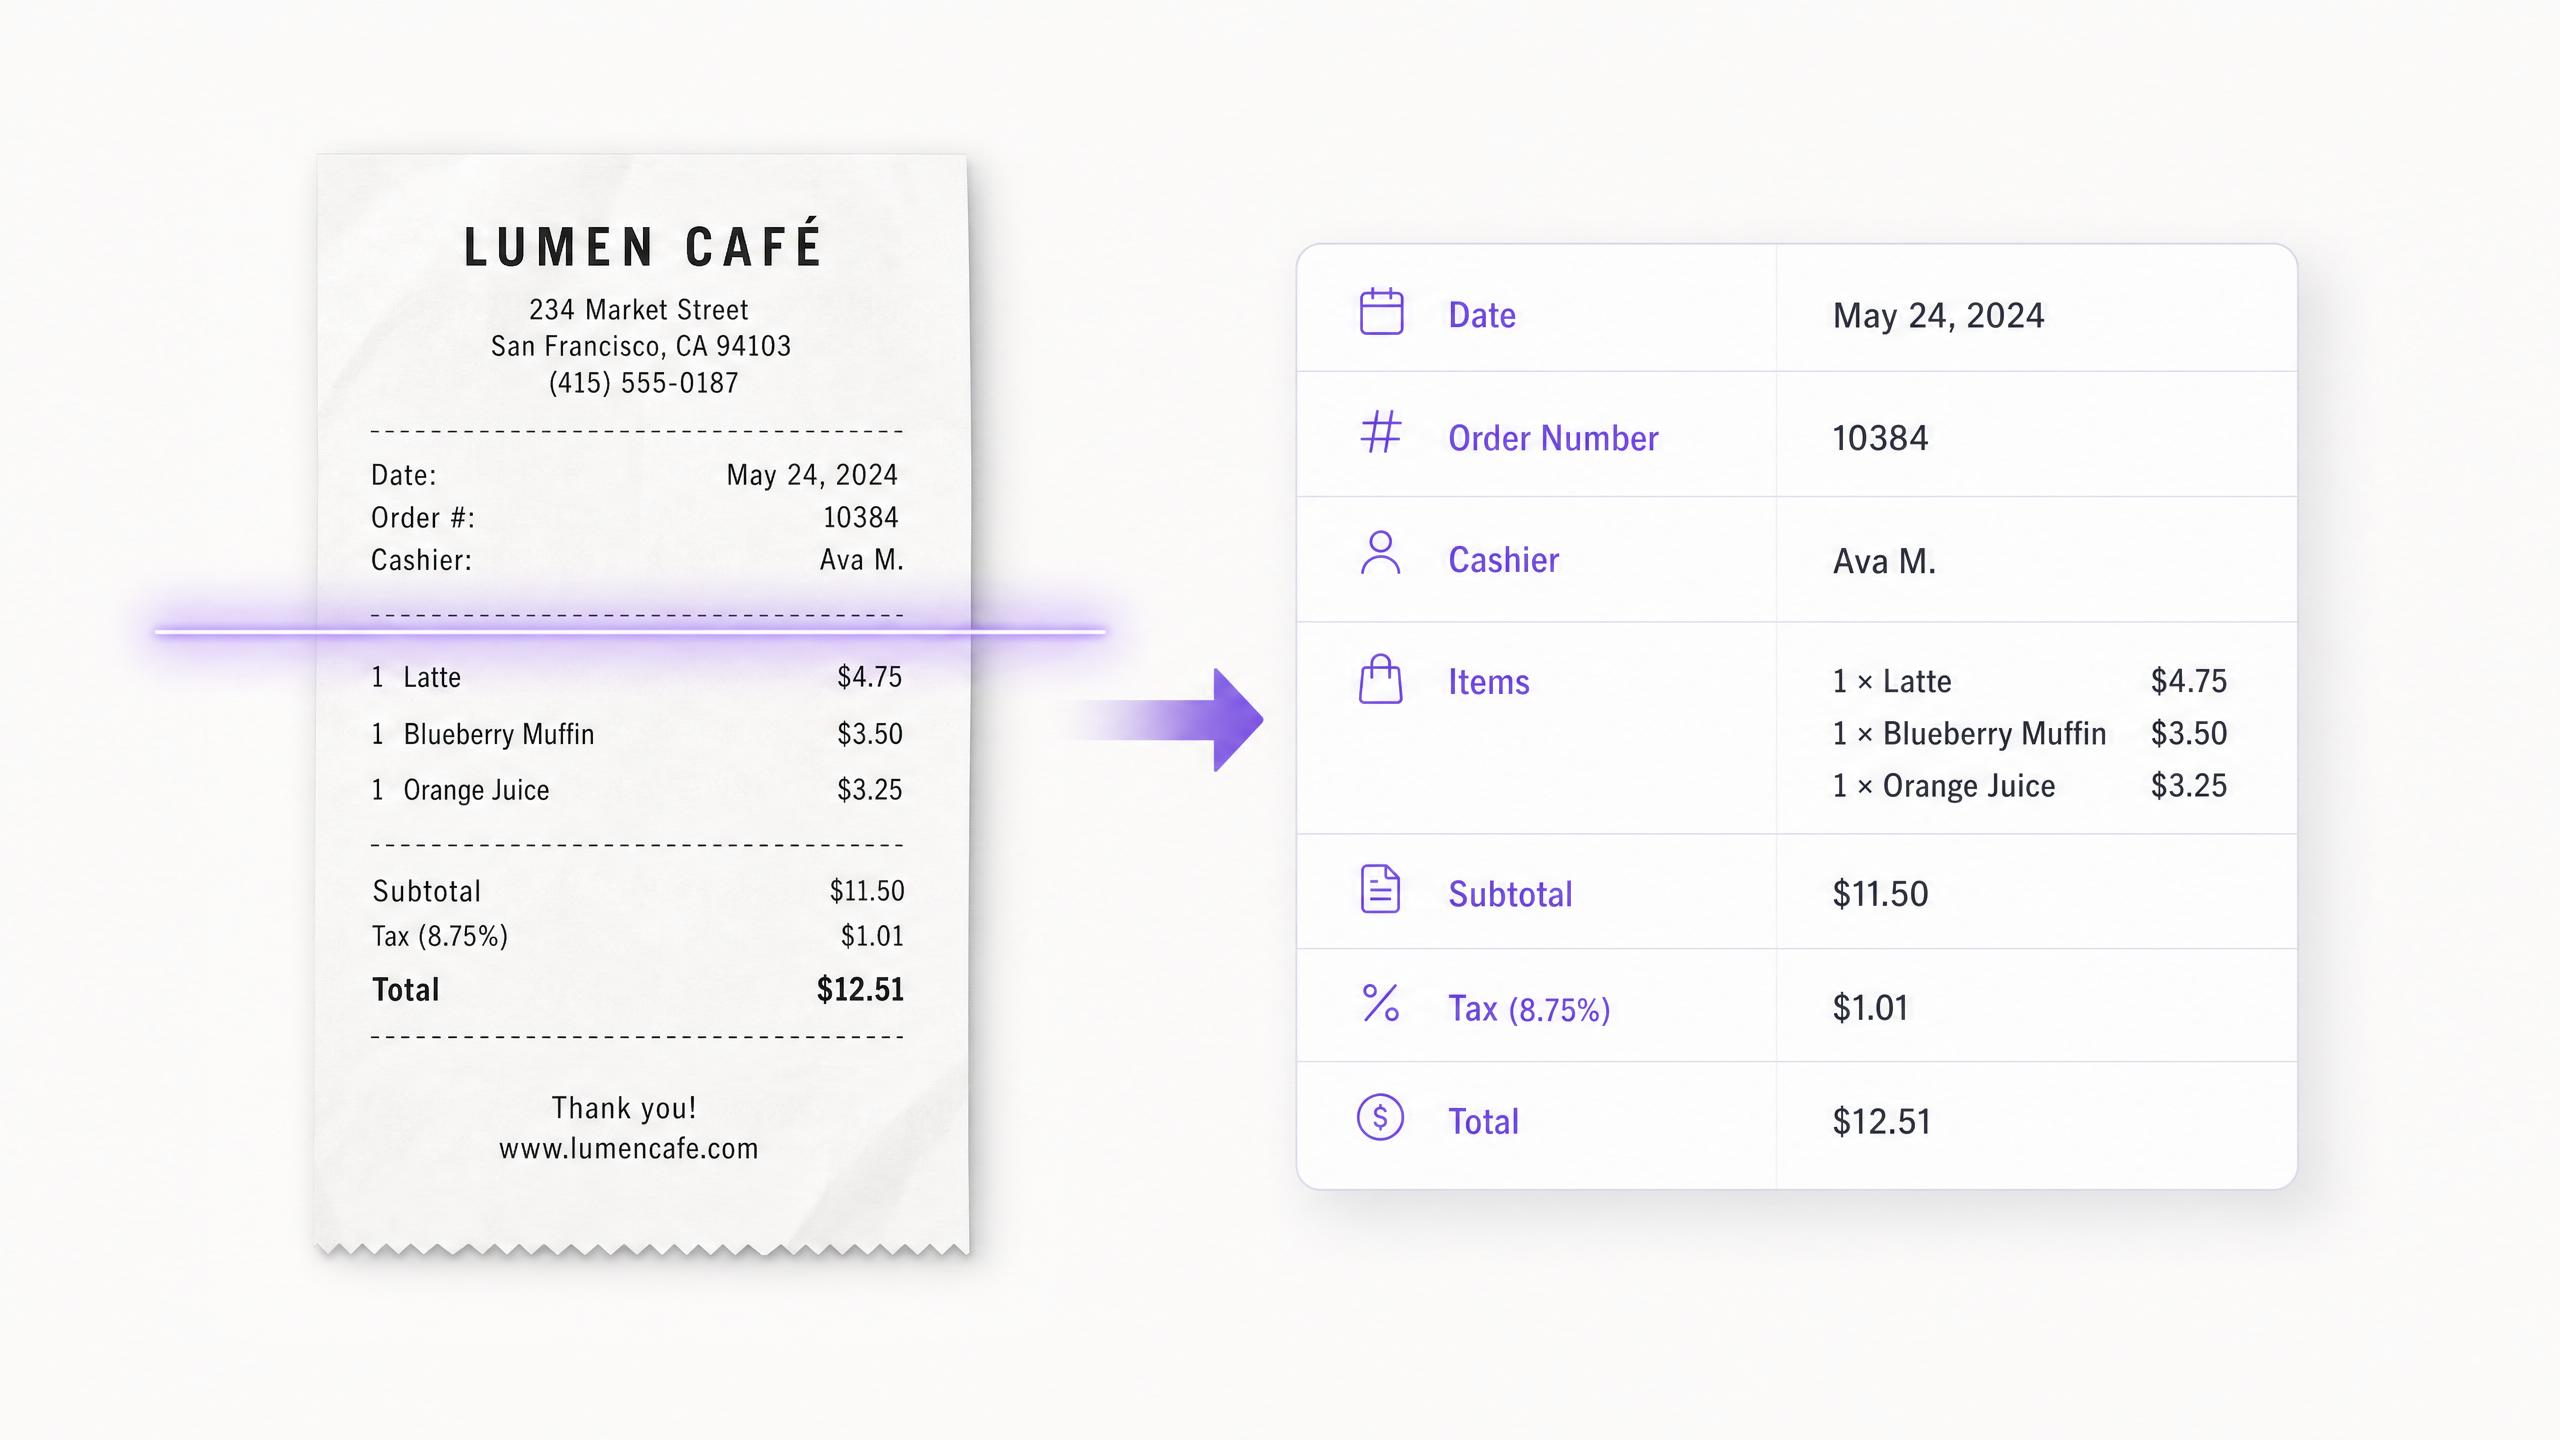
Structured Outputs and Vision with the Grok API
The Grok API returns structured JSON that matches your schema, so extracted data flows straight into downstream code. Grok 4.3 also accepts images alongside text, handling diagrams, screenshots, and UI mockups in the same call.
Coding with Grok Build 0.1
Grok Build 0.1 is xAI's coding-tuned model for code generation, debugging, and refactoring across developer workflows, with a 256K token context. It targets interactive coding agents and multi-step development tasks rather than general chat.
Prompt Caching on the Grok API
The Grok API supports prompt caching, which reuses a shared system prompt or context prefix at a lower token rate. For agentic loops that send the same instructions across many calls, this cuts repeated input cost without changing your code.
Jeden prompt budujący dla różnych modeli
Przekaż ten sam prompt kompilacji do Grok i innych modeli w Atlas Cloud i obserwuj, jak każdy z nich generuje kompletną, gotową do uruchomienia stronę internetową, dzięki czemu możesz zestawić i porównać ze sobą styl kodowania oraz wyniki.
Zbuduj pojedynczy, samowystarczalny plik HTML wyświetlający interaktywny układ słoneczny 3D przy użyciu Three.js z CDN. Wyrenderuj słońce i osiem orbitujących planet z teksturami przybliżonymi przez kolory i poświatę, animowanymi orbitami oraz tłem gwiezdnego pola. Pozwól użytkownikowi obracać i przybliżać kamerę za pomocą myszy, a po kliknięciu na planetę płynnie przemieścić do niej kamerę i wyświetlić jej statystyki. Dołącz elegancki nakładający się tytuł oraz kontrolkę do przyspieszania lub zwalniania upływu czasu. Zachowaj wszystko w jednym pliku HTML wraz z importem Three.js z CDN. Priorytetem ma być oszałamiający, kinowy wygląd.
Grok 4.3
GLM 5
Grok Build 0.1
Zbuduj pojedynczy, samowystarczalny plik HTML, który będzie animowanym pulpitem analitycznym. Dołącz animowany wykres słupkowy, wykres liniowy, który rysuje się przy ładowaniu, wykres pierścieniowy oraz karty podsumowujące statystyki, które odliczają w górę. Użyj na sztywno zakodowanych danych przykładowych, płynnych animacji wejściowych oraz czystego, nowoczesnego, ciemnego układu pulpitu. Dodaj subtelną etykietkę (tooltip) aktywowaną po najechaniu kursorem na każdy element wykresu. Używaj wyłącznie wbudowanego (inline) CSS oraz czystego JavaScriptu (vanilla JS) z canvas lub SVG, bez zewnętrznych bibliotek. Spraw, aby wyglądał jak najwyższej klasy pulpit SaaS.
Grok 4.3
GLM 5
Grok Build 0.1
Co możesz zrobić z API Grok LLM w Atlas Cloud
Grok 4.3 łączy okno kontekstowe o rozmiarze 1 miliona tokenów z wyszukiwaniem w sieci i na platformie X w czasie rzeczywistym, co czyni go praktycznym rozwiązaniem dla produkcyjnych przepływów pracy wymagających aktualnych informacji wraz z głębokim wnioskowaniem.

Potoki badań i inteligencji w czasie rzeczywistym
Zespoły tworzące narzędzia badawcze korzystają z dodatków Web Search i X Search w Grok 4.3, aby pobierać dane na żywo z sieci i platformy X bezpośrednio do procesu generowania, bez konieczności stosowania oddzielnej warstwy pobierania. Jest to przydatne do analizy konkurencji, podsumowywania wiadomości i przepływów pracy związanych z analizą rynku, w których odpowiedź zależy od informacji opublikowanych po dacie końcowej trenowania modelu. Opłata za Web Search i X Search wynosi 5 USD za 1000 wywołań w xAI API.

Opłacalny produkcyjny backend LLM
Zespoły inżynieryjne przechodzące z GPT-4.1 lub Claude Sonnet używają Grok 4.3 jako bezpośredniego zamiennika za pośrednictwem kompatybilnego z OpenAI endpointu Atlas Cloud. Przy cenie 1,25 USD za milion tokenów wejściowych, Grok 4.3 jest o około 37% tańszy niż GPT-4.1 i 58% tańszy niż Claude Sonnet 4.6 na wejściu. Migracja wymaga jedynie zmiany base URL i klucza API w istniejącym kodzie SDK.

Analiza długich dokumentów w kontekście 1M
Zespoły ds. prawnych, finansowych i badawczych używają okna kontekstowego 1M tokenów w Grok 4.3 do przetwarzania pełnych zestawów umów, dokumentacji finansowej lub technicznej w pojedynczym wywołaniu API. Duży kontekst eliminuje potrzebę stosowania pofragmentowanych potoków wyszukiwania i zachowuje możliwość wnioskowania między dokumentami, którą modele o krótszym kontekście tracą. Buforowanie promptów dodatkowo obniża koszty, gdy ten sam kontekst dokumentu jest ponownie używany w wielu wywołaniach analitycznych.

Multimodalne Kodowanie i Analiza Wizualna
Programiści wykorzystują funkcję rozumienia obrazu w Grok 4.3, aby przekazywać diagramy, zrzuty ekranu, makiety interfejsu użytkownika i dzienniki błędów wraz z tekstem w tym samym wywołaniu API. Jest to przydatne w przepływach pracy związanych z debugowaniem, w których zrzut ekranu z błędem lub diagram architektury systemu zapewnia kontekst, którego sam tekst nie potrafi oddać. Wywoływanie funkcji i ustrukturyzowane dane wyjściowe są obsługiwane w tym samym wywołaniu, dzięki czemu wyodrębnione dane wizualne mogą zostać zwrócone w schemacie gotowym do dalszego przetwarzania.

Agentowe Wieloetapowe Wykonywanie Zadań
Zespoły produktowe wykorzystują optymalizację agentową Grok 4.3 do budowania agentów, którzy planują, wykonują i iterują przez wiele kroków bez konieczności wprowadzania podpowiedzi przez człowieka pomiędzy nimi. Model jest specjalnie dostrojony do dekompozycji złożonych zadań — rozbijania celu wysokiego poziomu na podzadania, sekwencyjnego wywoływania narzędzi i dostosowywania działań na podstawie wyników pośrednich. W połączeniu z wywoływaniem funkcji i dodatkiem Web Search, obejmuje to przepływy pracy od badań do wyników, takie jak "znajdź konkurentów, przeanalizuj ceny, sporządź raport porównawczy" w ramach pojedynczego uruchomienia agenta.

Wykonywanie kodu w kontekście dla analizy danych
Zespoły ds. danych i analityki używają Grok 4.3 z dodatkiem Code Execution, aby uruchamiać język Python bezpośrednio w wywołaniu inferencji, przetwarzać dane i zwracać obliczone wyniki wraz z wnioskowaniem modelu. Eliminuje to potrzebę stosowania oddzielnego środowiska wykonawczego kodu podczas tworzenia narzędzi do analizy danych lub zautomatyzowanych potoków raportowania. Usługa Code Execution jest rozliczana w cenie 5 USD za 1000 wywołań w xAI API, niezależnie od kosztów tokenów.
Porównanie Grok API
Zobacz, jak Grok API wypada na tle innych wiodących LLMs w Atlas Cloud pod kątem kontekstu, danych wejściowych i obszaru skupienia, dzięki czemu możesz skierować każde zadanie do odpowiedniego modelu, a wszystko to za pomocą jednego klucza.
| Model | Provider | Context Window | Inputs | Best For |
|---|---|---|---|---|
| Grok 4.3 | xAI | 1M tokens | Text | Agentic reasoning, long-document analysis, high factual accuracy |
| Grok Build 0.1 | xAI | 256K tokens | Text | Code generation, debugging, refactoring |
| DeepSeek V4 Pro | DeepSeek | 1M tokens | Text | Cost-efficient reasoning and agentic tool use at scale |
| Kimi K2.6 | Moonshot | 262K tokens | Text, image | Long-horizon coding agents and multimodal workflows |
| GLM 5.2 | Z.ai | 202.8K tokens | Text | Long-horizon agentic engineering and project-scale coding |
Jak używać Grok na Atlas Cloud
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Utwórz konto Atlas Cloud
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Dlaczego Używać Grok na Atlas Cloud
Połączenie zaawansowanych modeli Grok z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Wydajność i Elastyczność
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj Grok, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Przedsiębiorstwo i Skala
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
Często zadawane pytania dotyczące Grok LLM
Atlas Cloud hostuje Grok 4.3, obecny flagowy model LLM firmy xAI, dostępny za 1,25 USD za milion tokenów wejściowych. Model obsługuje czat, wnioskowanie, wywoływanie funkcji, ustrukturyzowane dane wyjściowe i rozumienie obrazów w jednym API. Sprawdzaj stronę kolekcji Atlas Cloud xAI pod kątem wszelkich dodatkowych wersji Grok, w miarę ich dodawania.
Grok 4.3 obsługuje okno kontekstowe o wielkości 1 miliona tokenów. Jest ono wystarczająco duże, aby w jednym wywołaniu przetwarzać kompletne bazy kodu, obszerne dokumenty badawcze lub rozbudowane, wieloturowe sesje agentów. Limit kontekstu dotyczy łącznie wprowadzanych danych tekstowych i obrazowych.
Tak. xAI API obsługuje Web Search i X Search jako opcjonalne dodatki, rozliczane osobno w cenie 5 USD za 1000 wywołań. Pozwala to modelowi Grok na pobieranie informacji w czasie rzeczywistym z sieci lub serwisu X podczas generowania. Dostęp do tych funkcji można uzyskać za pośrednictwem standardowego punktu końcowego API wraz z regularnymi wywołaniami API.
Tak. API xAI obsługuje buforowanie promptów, co zmniejsza koszty zapytań wykorzystujących ten sam prompt systemowy lub prefiks kontekstu. Zbuforowane tokeny wejściowe są rozliczane według znacznie niższej stawki niż tokeny niezbuforowane. Jest to szczególnie przydatne w przypadku przepływów pracy opartych na agentach, które wysyłają te same instrukcje w wielu wywołaniach.
Tak. Grok 4.3 obsługuje wejście multimodalne, akceptując obrazy wraz z tekstem w tym samym wywołaniu API. Możesz przekazywać adresy URL obrazów lub obrazy zakodowane w formacie base64 za pośrednictwem standardowego formatu wiadomości. Umożliwia to przypadki użycia, takie jak wizualne odpowiadanie na pytania, analiza dokumentów i generowanie kodu na podstawie obrazów.
Tak. Grok 4.3 obsługuje wywoływanie funkcji, ustrukturyzowane dane wyjściowe i odpowiedzi strumieniowe. Funkcje te współpracują ze standardowym schematem funkcji zgodnym z OpenAI, dzięki czemu istniejące definicje narzędzi z integracji opartych na GPT można przenosić bezpośrednio. Wykonywanie kodu jest również dostępne jako opcjonalny dodatek w cenie 5 USD za 1000 wywołań.
Buforowanie promptów pozwala na ponowne wykorzystanie powtarzającego się prefiksu kontekstu, takiego jak długi prompt systemowy lub udostępnione instrukcje, przy obniżonej stawce za tokeny wejściowe w późniejszych wywołaniach. W przypadku chatbotów i agentów, którzy ponownie wysyłają tę samą konfigurację przy każdym żądaniu, obniża to koszty powtarzających się danych wejściowych bez zmiany kodu. Umieść statyczną treść na początku promptu, a zmienną treść użytkownika na końcu, aby pamięć podręczna mogła zostać zastosowana.
Limity zapytań i współbieżność różnią się w zależności od poziomu konta, dlatego dodaj wykładnicze opóźnienie (exponential backoff) i ponowną próbę przy odpowiedzi 429, a także kolejkuj żądania podczas skoków ruchu. W przypadku dużych zadań offline przetwarzanie wsadowe pozwala uniknąć obciążania limitów w czasie rzeczywistym. Częstym ukrytym kosztem przy skalowaniu jest ponowne wysyłanie pełnej historii konwersacji przy każdym wywołaniu, więc przekazuj zwięzłe podsumowanie zamiast całego wątku i skontaktuj się z pomocą techniczną, aby zwiększyć limity w miarę rozwoju.
API Grok korzysta z modelu rozliczeń pay-as-you-go opartego na zużyciu tokenów, w którym tokeny wejściowe i wyjściowe są mierzone dla każdego zapytania, bez konieczności posiadania subskrypcji. Uruchomienie Grok obok ponad 300 innych modeli w Atlas Cloud oznacza jedno konto i jedną fakturę zamiast oddzielnych umów z każdym dostawcą. Buforowanie promptów i przetwarzanie wsadowe mogą obniżyć rzeczywiste koszty powtarzalnych lub działających w trybie offline obciążeń roboczych.
Utwórz konto w Atlas Cloud, wygeneruj klucz API i skieruj swój istniejący klient kompatybilny z OpenAI na punkt końcowy Atlas z nazwą modelu Grok. Wyślij swoje pierwsze żądanie do Grok 4.3 w celu wnioskowania lub do Grok Build 0.1 w celu kodowania, a następnie skaluj w zależności od potrzeb. Ponieważ ten sam klucz pozwala na dostęp do ponad 300 modeli, możesz testować inne modele bez żadnej dodatkowej konfiguracji.
Poznaj Więcej Rodzin
Kling 4.0
Interfejs API Kling 4 udostępnia Kling 4.0, model wideo wydany przez Kuaishou 15 października 2026 r. Generuje do 30 sekund w jednym przebiegu, podąża za maksymalnie 10 klatkami kluczowymi, łączy 15 obrazów, filmów i obiektów za pośrednictwem Omni Reference oraz dodaje dźwięk stereo z synchronizacją ruchu warg. Atlas Cloud obsługuje wszystkie cztery punkty końcowe, w tym edycję wideo, za pomocą jednego klucza kompatybilnego z OpenAI w cenie od 0,11 USD za sekundę. Rozpocznij budowanie już dziś.

Seedance 2.5
API Seedance 2.5 udostępnia programistom wspólny model audio i wideo ByteDance Seed, generujący od 4 do 30 sekund w jednym przejściu na podstawie tekstu, pierwszej klatki lub do 50 odniesień z obrazów, wideo i audio. Edytuje wybrane obszary, wydłuża klipy i podąża za wejściami typu white-model oraz green-screen. Atlas Cloud, autoryzowany sprzedawca w USA, dodaje tryb roboczy 480p, natywne wersje końcowe 1080p oraz ulepszone dostarczanie 4K w modelu cenowym pay-as-you-go.
Wan 3.0
Wan 3.0 to najnowszy model wideo od Alibaba, generujący do 30 sekund wideo 1080p przy 30fps z dźwiękiem w jednym procesie generowania. Steruj nim za pomocą promptu tekstowego, pierwszej klatki, do 10 obrazów referencyjnych lub dokumentu. Wersja Standard kosztuje mniej za sekundę, podczas gdy Prime zachowuje te same możliwości i szybciej zwraca wyniki. Obie wersje działają na tym samym kluczu Atlas Cloud co Wan 2.7, 2.6 i 2.5.
MiniMax H3
MiniMax H3 to multimodalna rodzina modeli wideo MiniMax do tworzenia na podstawie tekstu, obrazu i materiałów referencyjnych. We wszystkich obsługiwanych trasach zachowuje obiekty z materiałów referencyjnych, oferuje elastyczne proporcje obrazu i łączy wygenerowany dźwięk z obrazem za pośrednictwem H3 Developer, a profile wynikowe są wybierane na poziomie endpointu. Atlas Cloud udostępnia całą rodzinę za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym rozliczeniem pay-as-you-go według standardowej stawki $0.038 za sekundę. Zacznij tworzyć już dziś.
GPT Image 2.5
GPT Image 2.5 to model OpenAI do generowania i edycji obrazów, wydany 8 września 2026 roku w dwóch wersjach API. Flare to wersja domyślna, charakteryzująca się o 50% niższą latencją niż GPT Image 2, podczas gdy Sunburst działa wolniej, aby zapewnić bardziej precyzyjną kontrolę nad szczegółowymi edycjami. Obie wersje obsługują do 16 obrazów referencyjnych, pięć poziomów jakości, przezroczyste tła oraz niestandardowe rozmiary do 3840px. Atlas Cloud udostępnia API GPT Image 2.5 według stawek za token OpenAI lub w cenie stałej za obraz w podziale na poziomy 1K, 2K lub 4K.
Seedream 5.0 Pro
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0
Seedance 2.0 to produkcyjny model wideo firmy ByteDance, umożliwiający precyzyjne tworzenie ujęć. Zamieniaj polecenia na wideo, animuj obraz pierwszej klatki z opcjonalnym wskazaniem ostatniej klatki lub kształtuj wyniki za pomocą materiałów referencyjnych i opcjonalnego wyszukiwania w sieci. Atlas Cloud łączy te procesy w jeden ujednolicony interfejs API, oferując przejrzyste rozliczanie zgodnie z użyciem oraz jeden klucz kompatybilny z OpenAI. Zacznij tworzyć już dziś.
Kling V3.0
Rodzina API Kling V3 firmy Kuaishou obsługuje przepływy pracy z tekstem, obrazami i wideo referencyjnym. Przenoś ruch, zachowując tożsamość postaci, kieruj generowaniem za pomocą odniesień wizualnych i edytuj filmy poleceniami w języku naturalnym. Atlas Cloud oferuje endpointy Standard i Pro dostosowane do różnych potrzeb produkcyjnych. Aktualizacja: Kling V4 jest już dostępny w Atlas Cloud. Poznaj go na stronie [Kling V4](https://www.atlascloud.ai/zh/models/kling-v4).
Grok Imagine Video
Grok Imagine Video zapewnia deweloperom dostęp do rodziny modeli wideo xAI do tworzenia, animowania, wydłużania i edytowania klipów. Generuj filmy o długości od 1 do 15 sekund na podstawie promptów, steruj postaciami, obiektami lub stylami, korzystając z maksymalnie siedmiu obrazów referencyjnych, i pracuj w rozdzielczości 480p lub 720p. Atlas Cloud udostępnia te możliwości za pośrednictwem endpointów zgodnych z OpenAI, oferując przejrzyste rozliczanie pay-as-you-go. Zacznij tworzyć już dziś.
Vidu Q4 Preview
Vidu Q4 to najnowszy flagowy model wideo firmy Vidu, przeznaczony do generowania wideo na podstawie obrazu oraz referencji. Potrafi animować pojedynczy obraz nieruchomy i automatycznie tworzyć przejścia między scenami, oferując deweloperom dwie ścieżki wejściowe na potrzeby różnych przepływów pracy produktu. Atlas Cloud udostępnia dedykowane endpointy API z opublikowanymi schematami parametrów w zweryfikowanej standardowej cenie $0.04 za sekundę. Zacznij tworzyć już dziś.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash to natywnie multimodalna rodzina modeli wideo Google DeepMind, przeznaczona do elastycznych procesów produkcyjnych. Edytuj istniejący materiał za pomocą instrukcji tekstowych, zachowuj spójność wizualną dzięki maksymalnie 10 obrazom referencyjnym i 3 klipom wideo lub wydłużaj ujęcia w łączonych segmentach do 40 sekund. Uzyskaj dostęp do wszystkich procesów w Atlas Cloud za pomocą jednego klucza API zgodnego z OpenAI, z rozliczaniem według zużycia i dostępnością od pierwszego dnia. Zacznij tworzyć już dziś.
Nano Banana 2.1
Nano Banana 2.1 to rodzina modeli obrazowych firmy Google, zbudowana na bazie Gemini 3.6 Flash. Zapewnia generowanie i edycję na poziomie Pro z szybkością Flash, obsługuje edycję w języku naturalnym oraz łączenie od 1 do 14 obrazów wejściowych, a także zachowuje spójność do 4 postaci i 10 obiektów. Dzięki Atlas Cloud deweloperzy mogą korzystać z tej rodziny za pomocą jednego klucza zgodnego z OpenAI, niezawodnej dostępności i dostępności od Day-0. Zacznij tworzyć już dziś.
Polecane artykuły
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.


