
Qwen API from Flash to Flagship
Qwen to rodzina dużych modeli językowych Alibaba Cloud, a Qwen API udostępnia deweloperom całą linię modeli. Korzystaj z flagowego Qwen3.7 Max do zaawansowanego rozumowania i programowania, wydajnych modeli mixture-of-experts w wielu skalach oraz Qwen3.5 Flash do natychmiastowych odpowiedzi przy dużym wolumenie. W Atlas Cloud każdy model działa przez jeden endpoint, z przejrzystymi cenami pay-as-you-go i dostępem do nowych wydań od Day-0. Zacznij tworzyć już dziś.
Qwen został opracowany przez Alibaba. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Poznaj Wiodące Modele
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.

Porównanie modeli tekstowych Qwen API obok siebie
Zobacz, jak każdy endpoint Qwen API przekształca prompty tekstowe w generowany tekst — od szybkich, lekkich asystentów po flagowe modele rozumujące — aby dobrać odpowiedni model do swojego obciążenia.
| Modalność | Opis |
|---|---|
| Qwen3.6 35B A3B (tekst na tekst) | Najnowszy model rozumujący w tej linii: ten endpoint mixture-of-experts 35B aktywuje około 3B parametrów na token, dzięki czemu głębokie rozumowanie pozostaje opłacalne. Wysyłaj do niego wieloetapowe zadania matematyczne, logiczne i analityczne, w których jakość chain-of-thought jest ważniejsza niż sama szybkość. |
| Qwen3.6 Plus (tekst na tekst) | Wszechstronny w scenariuszach czatu i produktywności, Qwen3.6 Plus łączy wysoką jakość konwersacji z cache’owaniem promptów i progowym cennikiem obejmującym konteksty powyżej 256K tokenów. Sięgnij po niego, gdy asystenci muszą zachować spójność w długich dokumentach lub rozbudowanych sesjach wieloturowych. |
| Qwen3.5 122B A10B (tekst na tekst) | Działając z mniej więcej 10B aktywnych parametrów na token, ten model mixture-of-experts 122B poświęca odrobinę skali na rzecz szybszej i tańszej inferencji. Sprawdza się w ogólnym generowaniu tekstu, streszczaniu i rozumowaniu, gdy potrzebujesz jakości dużego modelu przy koszcie ze średniej półki. |
| Qwen3.5 35B A3B (tekst na tekst) | Gdy liczą się zarówno przepustowość, jak i budżet, ten endpoint MoE 35B utrzymuje aktywne tylko około 3B parametrów na token. Używaj go do czatu o dużym wolumenie, tworzenia szkiców i klasyfikacji, których uruchamianie na modelu flagowym byłoby nieefektywne kosztowo. |
| Qwen3.5 27B (tekst na tekst) | Gęsty model 27B, Qwen3.5 27B zapewnia przewidywalne opóźnienia i spójną jakość bez routingu mixture-of-experts. Pasuje do prostych zadań generowania i wykonywania instrukcji, które korzystają z kompaktowego, niezawodnego zaplecza. |
| Qwen3.5 397B A17B (tekst na tekst) | Największy model w warstwie 3.5: ten endpoint mixture-of-experts 397B aktywuje około 17B parametrów na token i dodaje cache’owanie promptów, aby obniżyć koszt powtarzanego kontekstu. Kieruj do niego wymagające zadania rozumowania i generowania, które potrzebują największej pojemności tej rodziny. |
| Qwen3.7 Max (tekst na tekst) | Jako model flagowy, Qwen3.7 Max jest przeznaczony do zaawansowanego rozumowania, kodowania i złożonych zadań wieloetapowych, z cache’owaniem promptów obniżającym koszt przy powtarzanym kontekście. Wybierz go do potoków agentowych, trudnych problemów programistycznych i obciążeń, w których trafność jest ważniejsza niż cena. |
| Qwen3.5 Plus (tekst na tekst) | Zaprojektowany z myślą o efektywności, Qwen3.5 Plus obsługuje codzienne zadania i asystentów AI, wspierając cache’owanie promptów oraz wejścia przekraczające 256K tokenów. To niezawodny domyślny wybór dla asystentów produkcyjnych, którzy potrzebują stabilnej jakości przy rozsądnych kosztach. |
| Qwen3.7 Plus (tekst na tekst) | Potrzebujesz możliwości, szybkości i efektywności w jednym modelu? Qwen3.7 Plus równoważy wszystkie trzy cechy, dodaje cache’owanie promptów i stosuje progowy cennik dla promptów powyżej 256K tokenów. Wdrażaj go dla skalowanych asystentów i przepływów pracy opartych na dużej liczbie dokumentów, które nadal wymagają szybkich odpowiedzi. |
| Qwen3.5 Flash (tekst na tekst) | Zoptymalizowany pod kątem natychmiastowych odpowiedzi i użycia na dużą skalę, Qwen3.5 Flash jest najszybszą i najbardziej ekonomiczną opcją w tej rodzinie. Wdrażaj go w czacie o dużym ruchu, autouzupełnianiu i funkcjach czasu rzeczywistego, gdzie priorytetem jest niskie opóźnienie. |
| Qwen3 VL 235B A22B Thinking (tekst na tekst) | Ten endpoint dostrojony do rozumowania działa na architekturze mixture-of-experts 235B z około 22B aktywnych parametrów i dedykowanym trybem thinking. Sięgnij po niego do ustrukturyzowanego rozwiązywania problemów i analiz, w których opłaca się jawne rozumowanie krok po kroku. |
| Qwen3-235B-A22B-Instruct-2507 (tekst na tekst) | Z 235B parametrów łącznie i około 22B aktywnych na token, ten dostrojony do instrukcji model MoE z serii Qwen3 obsługuje szerokie zastosowania generowania tekstu i rozumowania. Wydanie 2507 czyni go solidnym wyborem dla uniwersalnych asystentów i potoków treści w Qwen API. |
Wewnątrz Qwen API: rozumowanie, narzędzia i długi kontekst
Qwen API łączy za jednym kluczem zgodnym z OpenAI tryb myślenia dual-mode, natywne function calling, kontekst przekraczający 256K tokens, obsługę 119 języków oraz prompt caching — od Qwen3.5 Flash po Qwen3.7 Max.
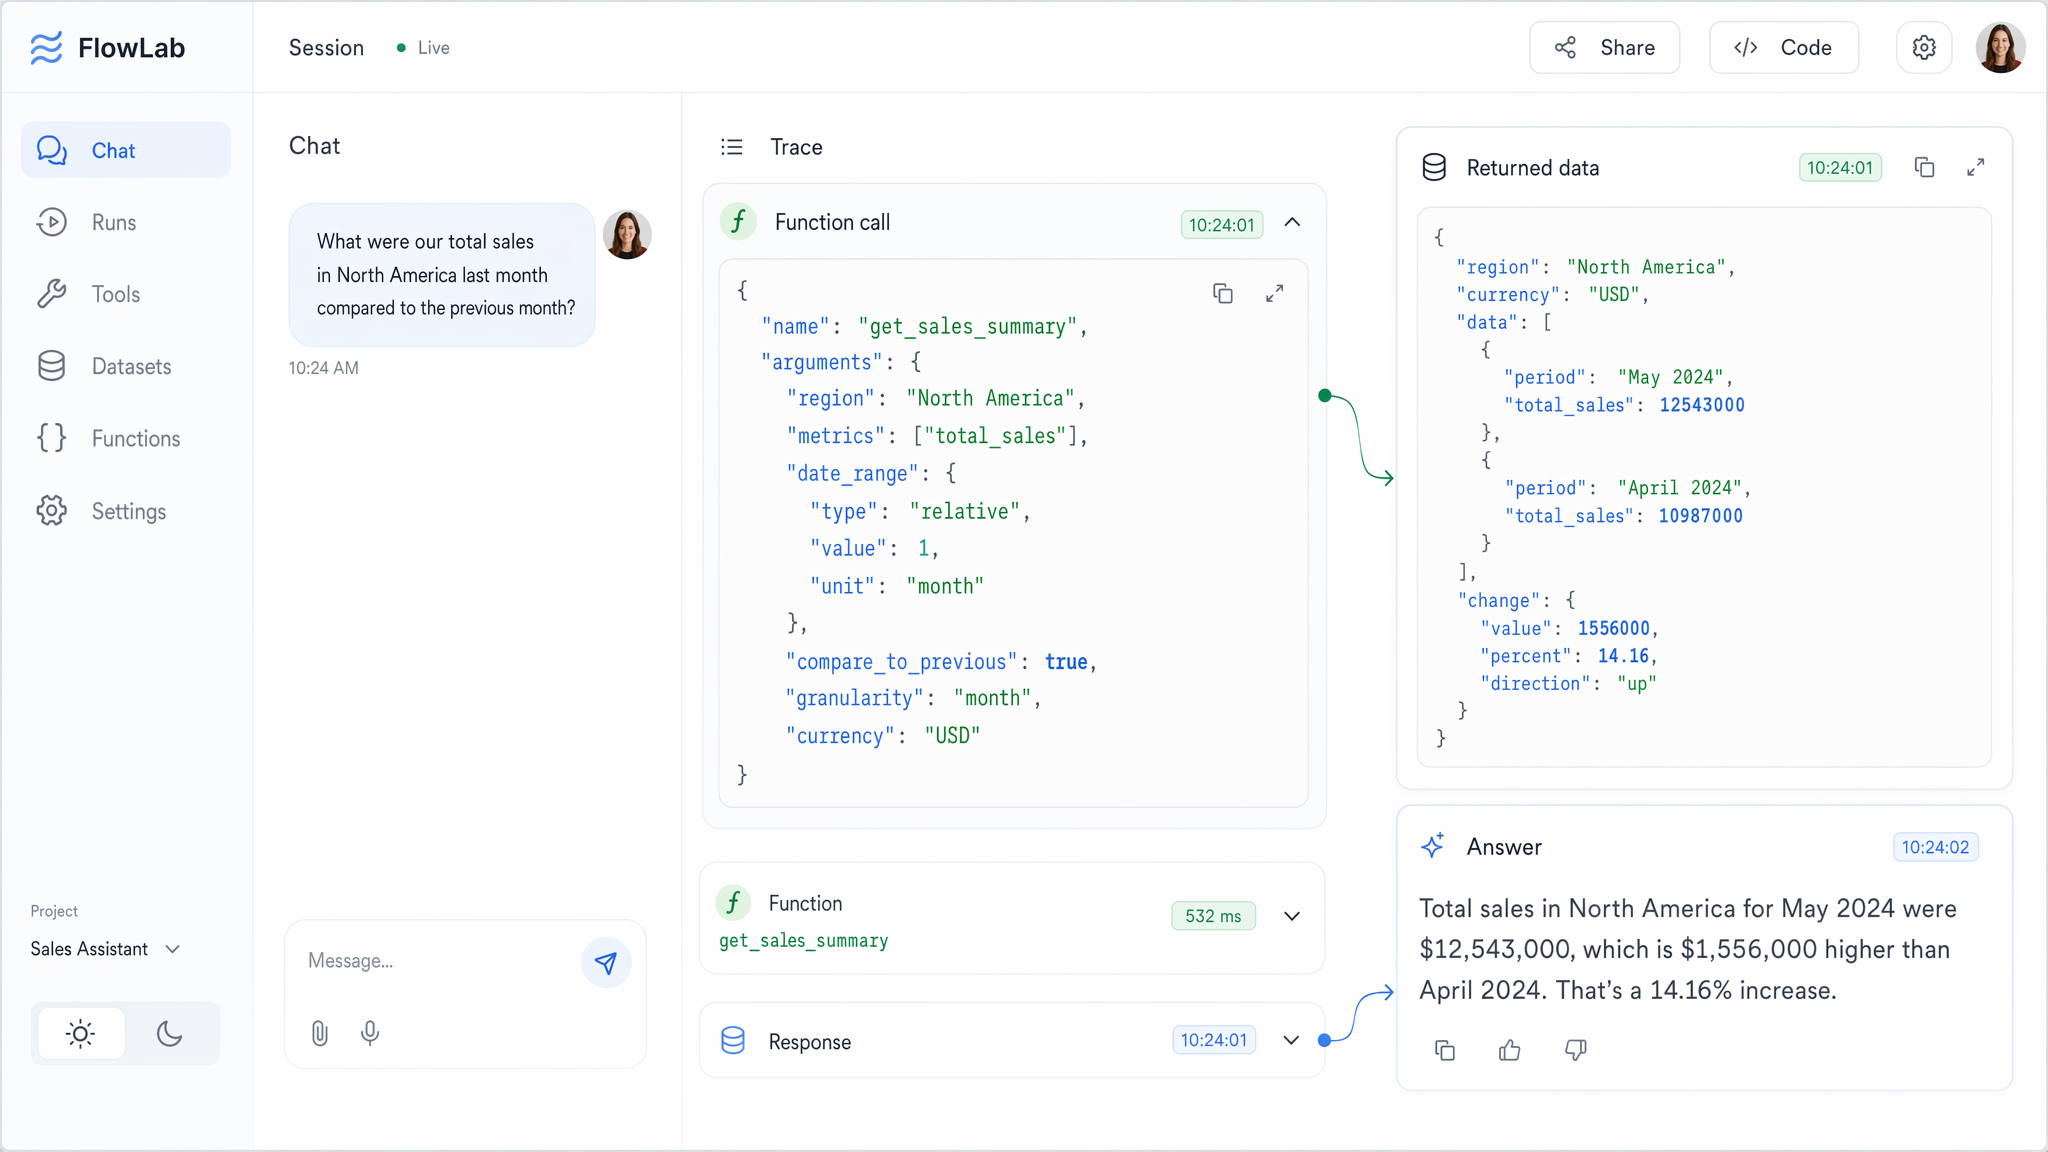
Natywne Function Calling dla agentów
Function calling pozwala modelom Qwen generować ustrukturyzowane wywołania narzędzi, które można bezpośrednio podłączyć do własnych API, baz danych i serwerów MCP. Model decyduje, kiedy wywołać funkcję, formatuje argumenty, a następnie włącza wynik z powrotem do swojej odpowiedzi. W połączeniu z endpointem zgodnym z OpenAI zmienia to istniejący kod SDK w autonomicznych agentów, pipeline’y retrieval oraz automatyzacje workflow.
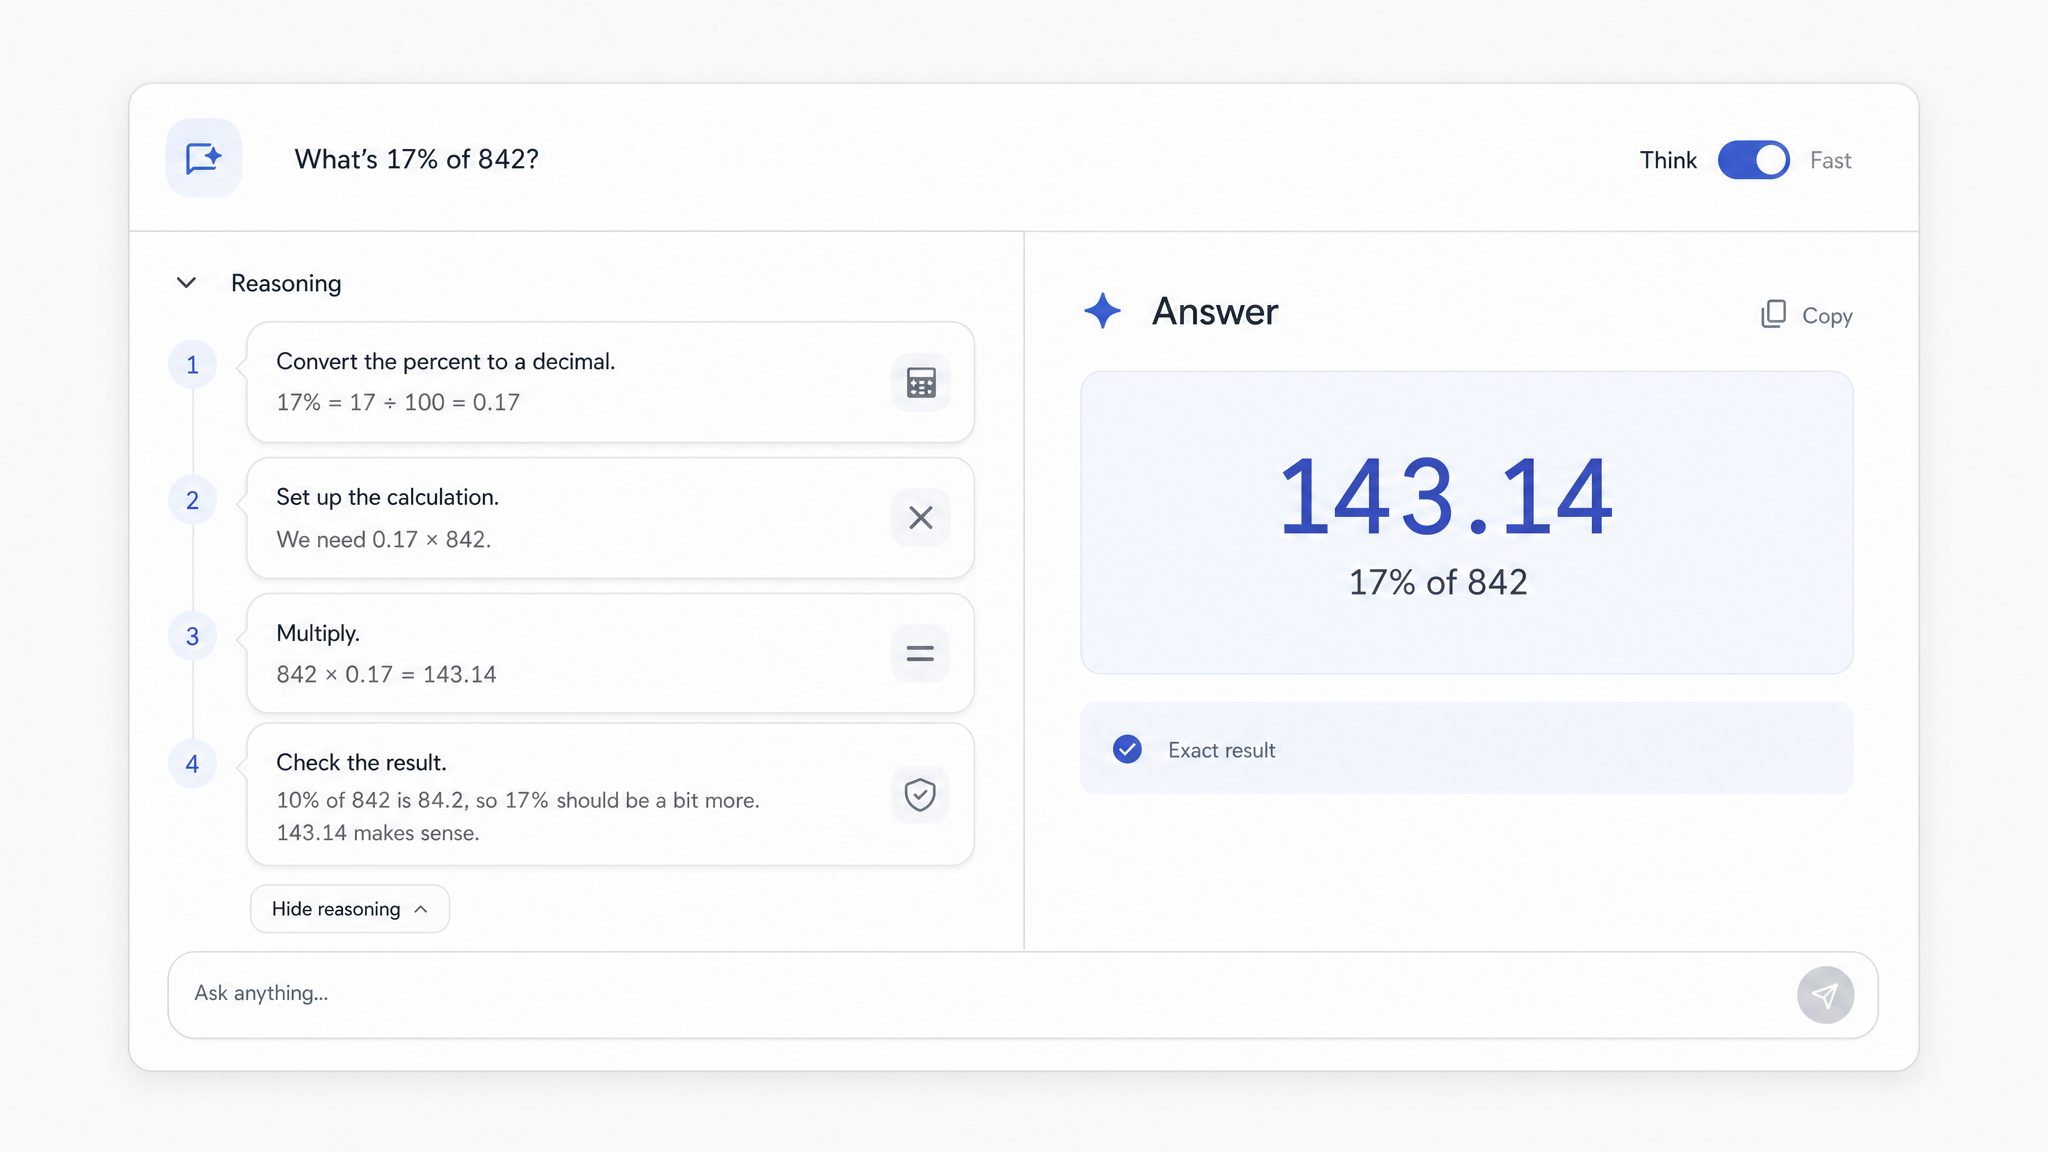
Myślenie i rozumowanie w trybie dual-mode
Przełączaj pojedynczy model między przemyślanym trybem myślenia do matematyki, logiki i kodowania a szybkim trybem bez myślenia do codziennych dialogów. Modele reasoning, takie jak Qwen3.6 35B A3B oraz flagowy Qwen3.7 Max, udostępniają tę głębię przez jeden endpoint. Gdy zadanie wymaga dedukcji krok po kroku, włączasz myślenie; gdy liczy się opóźnienie, wyłączasz je — bez zmiany modelu ani klucza.
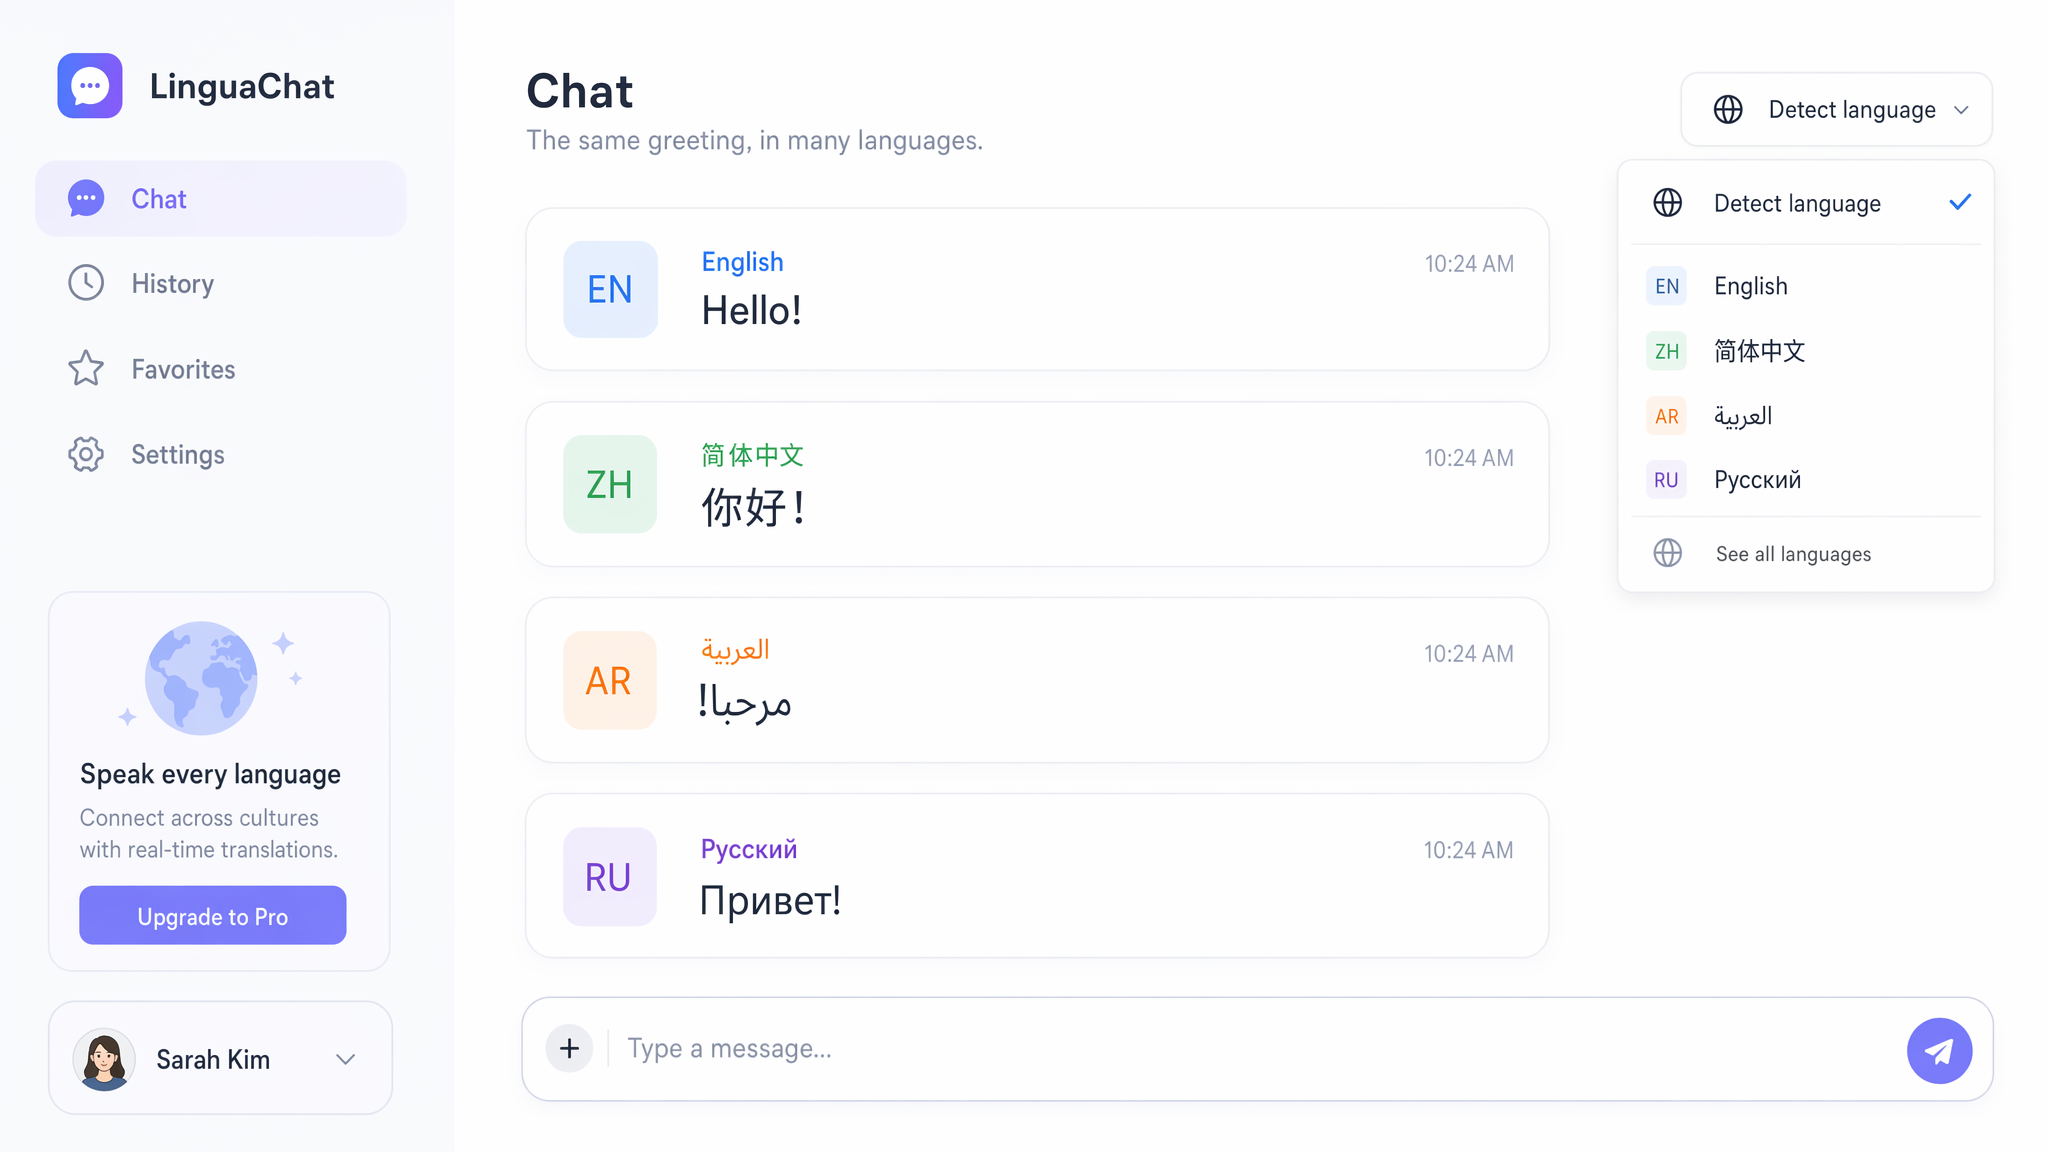
Zasięg wielojęzyczny w 119 językach
Wytrenowany na 119 językach i dialektach Qwen równie płynnie obsługuje wykonywanie instrukcji i tłumaczenia w wielu językach, w tym po chińsku i angielsku. Jeden prompt może przechodzić między językami bez osobnej usługi tłumaczeniowej. Zespoły tworzące produkty dla globalnych odbiorców wykorzystują go do zlokalizowanego czatu, wyszukiwania międzyjęzykowego oraz treści, które brzmią naturalnie na każdym rynku docelowym.
Pełna rodzina modeli Qwen API
Od niskolatencyjnego Qwen3.5 Flash po flagowy Qwen3.7 Max — cała rodzina działa z jednym kluczem zgodnym z OpenAI. Wydajne architektury mixture-of-experts, takie jak 397B A17B i 235B A22B, aktywują tylko ułamek swoich parametrów na token, a każdy poziom korzysta z tego samego formatu żądań. Kieruj proste wywołania do Flash, a trudne zadania reasoning do Max, bez przepisywania ani jednej linii kodu integracji.
Prompt Caching obniżający koszty Qwen API
Powtarzający się kontekst jest rozliczany według stawki cached, znacznie niższej niż standardowa cena wejścia, więc system prompts i współdzielone dokumenty kosztują mniej przy każdym kolejnym wywołaniu. Cennik pozostaje przejrzysty i oparty na pay-as-you-go, z opublikowanymi stawkami za token i bez subskrypcji. Najwięcej zyskują asystenci o dużym wolumenie, stosy RAG i długie konwersacje, ponieważ ten sam prefiks jest wysyłany raz za razem.
One Prompt Across Models: The Qwen API Head to Head
Hand one identical brief to the Qwen API and to rival engines, then watch each model turn the very same instruction into a working single file web page you can open and click right away.
Build a complete, single-file, self-contained HTML page (all CSS and JavaScript inlined in one .html file) that renders an interactive "Late-Night French Patisserie Window" — a boutique dessert display case, still glowing with warm light after closing hours. Absolute constraint: NO external resources of any kind — no CDNs, no linked stylesheets or scripts, no web fonts, no `<img>` tags, no SVG files, no base64 photos, no emoji as art. Every visual must be constructed purely from HTML elements styled with CSS: layered linear/radial/conic gradients, stacked and inset box-shadows, border-radius, blur/backdrop-filter, transforms, and canvas or DOM-drawn shapes only. This is a test of rendering faux-realistic material and light with vector CSS alone. The scene: a front-on, eye-level view into a glass patisserie window, shelves arranged in a calm rule-of-thirds composition. On the shelf sits a row of at least four distinct, meticulously crafted desserts, each built entirely from gradients and shadows: (1) a glossy chocolate-cocoa mousse dome with a mirror-glaze finish that shows a soft specular highlight and reflected light; (2) a mille-feuille with many crisp, visibly separated puff-pastry layers; (3) a tiered macaron tower with sugar-frosted, slightly matte shells; (4) a lemon tart on a slowly rotating turntable plate. Model believable depth: warm golden spotlight from above (the window's display lamp) contrasted against a cool blue ambient night, with cast shadows, rim light on edges, and gentle glossy reflections. A subtle glass layer floats in front of everything — faint reflections, streaks, and a scatter of condensation droplets — and there is a soft reflection of each dessert on the shelf surface below it. Interactions (all smooth, spring-like CSS/JS transitions): - HOVER a dessert: it lifts gently, its spotlight and shadow intensify, and a cross-section "cutaway" animation reveals its internal structure — the layered cream, ganache, curd, and biscuit/pastry base drawn as stacked gradient bands with a label. - CLICK a dessert to enter a "Customize" mode: an elegant panel appears with sliders and toggles that let the user add and adjust decorative elements in real time — sprinkled sugar pearls (density slider), drizzled pulled caramel (amount + strand thickness), and a mirror-glaze/glossy pectin coat (glossiness slider), plus an accent-berry-red drizzle. The dessert must repaint live as values change, with the highlight/gloss responding to the glossiness value. Provide a "Reset" and an "Exit" control. Persist each dessert's customization while switching between them. - Optional ambient touches: a faint animated flicker on the warm lamp, drifting condensation, and the lemon tart's turntable rotating on a loop. Visual style: refined, cozy, seductive late-night mood; palette of caramel brown, cream white, and berry red, accented with mint green, over a deep cool-blue night background. Typography should feel like a chic patisserie — set headings and dessert names in an elegant CSS-only serif stack with generous letter-spacing; keep the layout tidy, ordered, and responsive so it looks good from mobile to widescreen. Prioritize tasteful micro-animations, layered depth, and material realism over clutter. Include everything needed to open the file directly in a browser and immediately interact with it. Output only the full HTML document, nothing else.
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.5 397BA17B on Atlas Cloud
Create a single self-contained HTML file (all CSS and JavaScript inline, absolutely no external libraries, CDNs, images, fonts, or network requests) that renders a real-time, playable whitewater kayaking game called "Rapid Run" entirely on a single HTML5 Canvas element that fills the browser window and stays responsive on resize. The view is a third-person top-down camera with slight forward perspective, looking down a procedurally generated alpine mountain stream that scrolls continuously from top to bottom and never repeats: seed the level with a noise/pseudo-random generator so each run carves a different braided channel with narrowing chutes, midstream boulders, swirling whirlpools, small waterfall drops, and churning white-foam wave trains. The player pilots a single crimson-and-amber kayak that holds near the lower third of the screen while the river rushes past; steer with Left/Right arrow keys (or A/D) to edge and carve, and let the mouse act as a paddle — the kayak leans and pulls toward the horizontal mouse position, with a click or held button to plant a hard paddle stroke that snaps the boat onto a tighter line. Simulate the water as a live flow field driven by layered scrolling noise: the current pushes the kayak downstream and sideways, faster in the tongues and slower in eddies, so the player must read the water and fight for the racing line. Emit a rich GPU-friendly particle system — a fan of spray bursting off the bow when it slaps a wave, a trailing turbulence wake churning off the stern, foam sheets exploding on impacts, and rings rippling out of whirlpools. Hitting a rock spins the boat out with a jarring wobble, momentary loss of control, and a shudder of the camera. Render in a crisp flat-illustration style fused with light fluid realism: the water surface shows animated ripples and refractive highlight glints from the flow field, noon high-plateau top light, cool white speculars on the spray, and deep pools graded from turquoise green into inky teal. Color palette is glacier cyan-blue dominant, with the kayak's vermilion-orange-yellow as the punchy accent, banks dressed in grey stone and pine green. Include an on-screen HUD: distance traveled, current speed, a stability/health meter that drains on rock hits, and a live score; show a start screen with brief controls, a game-over screen when stability is depleted with a Restart option, and gradually ramp difficulty (faster current, denser hazards) the farther you descend. Target a smooth 60fps game loop using requestAnimationFrame with delta-time physics, all tuned for a genuinely tense, satisfying feel where nailing a clean line through a foaming chute feels earned.
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.7 Max on Atlas Cloud
Qwen API a konkurencyjne interfejsy API LLM w Atlas Cloud
Zobacz, jak Qwen API wypada na tle innych flagowych modeli tekstowych w Atlas Cloud pod względem długości kontekstu, limitów wyjścia, obsługiwanych typów wejścia oraz przejrzystych cen za wywołanie.
| Model | Okno kontekstu | Maks. liczba tokenów wyjściowych | Typy danych wejściowych | Cena wejścia ($/1M) | Cena wyjścia ($/1M) |
|---|---|---|---|---|---|
| Qwen3.7 Max | 1M | 67,072 | Tekst | $2.50 | $7.50 |
| Qwen3.7 Plus | 1M | 67,072 | Tekst | $0.40 (≤256K) / $1.20 (>256K) | $1.60 / $4.80 |
| Qwen3.6 35B A3B | 256K | 65,536 | Tekst, obraz, wideo | $0.248 | $1.485 |
| Qwen3.5 Flash | 1M | 67,072 | Tekst | $0.10 | $0.40 |
| DeepSeek V4 Pro | 1M | 393,216 | Tekst | $1.74 | $3.45 |
| Grok 4.5 | 500K | 500,000 | Tekst | $2.00 | $6.00 |
| GLM 5.2 | 1M | 131,072 | Tekst | $1.40 | $4.40 |
Jak używać Qwen na Atlas Cloud
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Utwórz konto Atlas Cloud
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Dlaczego Używać Qwen na Atlas Cloud
Połączenie zaawansowanych modeli Qwen z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Wydajność i Elastyczność
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj Qwen, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Przedsiębiorstwo i Skala
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
Najczęstsze pytania deweloperów o Qwen API
Qwen API zapewnia deweloperom programistyczny dostęp do rodziny dużych modeli językowych Qwen od Alibaba Cloud do generowania tekstu, rozumowania, kodowania i zadań wielojęzycznych. W Atlas Cloud masz dostęp do pełnej gamy modeli przez jeden endpoint zgodny z OpenAI, więc jeden klucz obejmuje każdy model Qwen.
Atlas Cloud udostępnia szeroką gamę modeli — od szybkiego i ekonomicznego Qwen3.5 Flash, przez wszechstronne poziomy Plus, po flagowy Qwen3.7 Max, zaprojektowany z myślą o zaawansowanym rozumowaniu i kodowaniu. Dostępne są też modele ukierunkowane na rozumowanie, takie jak Qwen3.6 35B A3B, oraz duże warianty mixture-of-experts, takie jak Qwen3.5 397B A17B, do bardziej wymagających obciążeń.
Rozpoczęcie pracy wymaga tylko kilku kroków: utwórz konto Atlas Cloud, wygeneruj klucz API i skieruj swojego istniejącego klienta zgodnego z OpenAI na endpoint Atlas. Cennik działa w modelu pay-as-you-go z przejrzystymi stawkami za wywołanie, a dostęp Day-0 oznacza, że nowe wydania Qwen są gotowe od razu w momencie premiery. Zacznij tworzyć już dziś.
Tak. Qwen API w Atlas Cloud korzysta z formatu OpenAI chat completions, więc większość SDK działa po prostej zamianie base URL i klucza. Zachowujesz dotychczasowe narzędzia i możesz wywoływać dowolny model Qwen bez przepisywania integracji.
Modele Qwen w Atlas Cloud korzystają z przejrzystego cennika pay-as-you-go rozliczanego za token, bez wymaganego abonamentu. Stawki zaczynają się od $0.1 za milion tokenów wejściowych i $0.4 za milion tokenów wyjściowych dla Qwen3.5 Flash, rosnąc do $2.5 i $7.5 za milion tokenów dla flagowego Qwen3.7 Max, dzięki czemu możesz dopasować koszty do każdego obciążenia.
Flagowe modele, takie jak Qwen3.7 Max, oferują okna kontekstu do jednego miliona tokenów, co sprawdza się przy długich dokumentach, dużych bazach kodu i rozbudowanej historii rozmów. Rodzina obejmuje też warianty tekstowe oraz vision-language, takie jak Qwen3-VL, dając Ci opcje, gdy zadanie wykracza poza zwykłe prompty tekstowe.
Poza zwykłym czatem modele Qwen obsługują odpowiedzi strumieniowe, function calling oraz ustrukturyzowane użycie narzędzi przez standardowe parametry API. Dedykowane modele rozumowania, takie jak Qwen3.7 Max i Qwen3.6 35B A3B, dodają krokowe rozwiązywanie problemów dla matematyki, kodowania i złożonych zadań agentowych.
Wybór sprowadza się do potrzebnej równowagi między szybkością, kosztem i możliwościami. Sięgnij po Qwen3.5 Flash, gdy liczy się opóźnienie i duży wolumen, po poziomy Plus do codziennych asystentów i przepływów produktywności, a po Qwen3.7 Max, gdy zadanie wymaga najsilniejszego rozumowania i kodowania. Ponieważ wszystkie modele współdzielą jeden endpoint, przełączanie się między nimi to zmiana jednego parametru.
Poznaj Więcej Rodzin
Kling 4.0
Opracowany przez Kuaishou Kling V4 to nadchodzący model wideo przeznaczony do profesjonalnej produkcji. Łączy stabilne, złożone ruchy z panoramicznym formatem 21:9 oraz ukierunkowaną edycją mimiki, kątów kamery, tła, stylów wizualnych i dialogów. Atlas Cloud przygotowuje dostęp od pierwszego dnia za pomocą jednego klucza zgodnego z OpenAI i przejrzystego rozliczania według użycia, co zapewnia elastyczną integrację. Zacznij tworzyć już dziś.

Seedance 2.5
API Seedance 2.5 jest już dostępne w Atlas Cloud! Zapewnia deweloperom najnowszy model wideo od ByteDance. Generuje do 30 sekund natywnego wideo w jednym przebiegu z tekstu, pojedynczego obrazu lub nawet 50 wielomodalnych odniesień, z zsynchronizowanym dźwiękiem i wielojęzycznym tekstem w kadrze. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza, a spójność obiektu i ulepszona fizyka zachowują spójność długich ujęć.
Wan 3.0
API Wan 3.0 to kolejna generacja rodziny wideo Wan firmy Alibaba, stworzona po to, by wznieść generowanie długich form, kontrolę wielu referencji i jakość audiowizualną na nowe wyżyny. Atlas Cloud hostuje już Wan 2.7, 2.6 i 2.5, a Wan 3.0 działa na tym samym ujednoliconym kluczu bez konieczności oddzielnej konfiguracji. Rozpocznij budowanie już dziś. Przewiń w dół do sekcji prezentacji, aby zobaczyć, co potrafi stworzyć Wan 3.0.
MiniMax H3
MiniMax H3 to multimodalna rodzina modeli wideo MiniMax do tworzenia na podstawie tekstu, obrazu i materiałów referencyjnych. We wszystkich obsługiwanych trasach zachowuje obiekty z materiałów referencyjnych, oferuje elastyczne proporcje obrazu i łączy wygenerowany dźwięk z obrazem za pośrednictwem H3 Developer, a profile wynikowe są wybierane na poziomie endpointu. Atlas Cloud udostępnia całą rodzinę za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym rozliczeniem pay-as-you-go według standardowej stawki $0.038 za sekundę. Zacznij tworzyć już dziś.
GPT Image 2.5
Rodzina modeli gpt-image-2.5 firmy OpenAI daje programistom wybór między Flare i Sunburst na potrzeby produkcyjnych procesów generowania obrazów. Renderuj w dowolnych rozdzielczościach do 3840x2160 i wybieraj spośród pięciu poziomów jakości, w tym xhigh i max, aby spełnić konkretne wymagania dotyczące wyników. Atlas Cloud zapewnia gotową do użycia inferencję REST bez zimnych startów i ze standardową ceną od $0.004 za generowanie. Zacznij tworzyć już dziś.
Seedream 5.0 Pro
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0
Seedance 2.0 to produkcyjny model wideo firmy ByteDance, umożliwiający precyzyjne tworzenie ujęć. Zamieniaj polecenia na wideo, animuj obraz pierwszej klatki z opcjonalnym wskazaniem ostatniej klatki lub kształtuj wyniki za pomocą materiałów referencyjnych i opcjonalnego wyszukiwania w sieci. Atlas Cloud łączy te procesy w jeden ujednolicony interfejs API, oferując przejrzyste rozliczanie zgodnie z użyciem oraz jeden klucz kompatybilny z OpenAI. Zacznij tworzyć już dziś.
Kling V3.0
Kling 3.0 API przenosi flagowy pakiet wideo Kuaishou do Atlas Cloud za pomocą jednego klucza kompatybilnego z OpenAI. Obejmuje on dwa modele: Kling 3.0 do opowiadania historii AI Director, wielojęzycznej synchronizacji ruchu warg i precyzyjnego tekstu na ekranie, oraz Kling 3.0 Omni (O3) do klonowania obiektów i głosu z krótkiego wideo lub obrazu. Oba generują natywny dźwięk w tym samym przebiegu, z rozdzielczością wyjściową do 4K. Buduj kinowe narracje, globalny marketing, wielojęzyczne reklamy i serializowane treści z postaciami w niezawodnej infrastrukturze.
Grok Imagine Video
Grok Imagine Video zapewnia deweloperom dostęp do rodziny modeli wideo xAI do tworzenia, animowania, wydłużania i edytowania klipów. Generuj filmy o długości od 1 do 15 sekund na podstawie promptów, steruj postaciami, obiektami lub stylami, korzystając z maksymalnie siedmiu obrazów referencyjnych, i pracuj w rozdzielczości 480p lub 720p. Atlas Cloud udostępnia te możliwości za pośrednictwem endpointów zgodnych z OpenAI, oferując przejrzyste rozliczanie pay-as-you-go. Zacznij tworzyć już dziś.
Vidu Q4 Preview
Vidu Q4 to najnowszy flagowy model wideo firmy Vidu, przeznaczony do generowania wideo na podstawie obrazu oraz referencji. Potrafi animować pojedynczy obraz nieruchomy i automatycznie tworzyć przejścia między scenami, oferując deweloperom dwie ścieżki wejściowe na potrzeby różnych przepływów pracy produktu. Atlas Cloud udostępnia dedykowane endpointy API z opublikowanymi schematami parametrów w zweryfikowanej standardowej cenie $0.04 za sekundę. Zacznij tworzyć już dziś.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash to natywnie multimodalna rodzina modeli wideo Google DeepMind, przeznaczona do elastycznych procesów produkcyjnych. Edytuj istniejący materiał za pomocą instrukcji tekstowych, zachowuj spójność wizualną dzięki maksymalnie 10 obrazom referencyjnym i 3 klipom wideo lub wydłużaj ujęcia w łączonych segmentach do 40 sekund. Uzyskaj dostęp do wszystkich procesów w Atlas Cloud za pomocą jednego klucza API zgodnego z OpenAI, z rozliczaniem według zużycia i dostępnością od pierwszego dnia. Zacznij tworzyć już dziś.
Nano Banana 2.1
Nano Banana 2.1 to rodzina modeli obrazowych firmy Google, zbudowana na bazie Gemini 3.6 Flash. Zapewnia generowanie i edycję na poziomie Pro z szybkością Flash, obsługuje edycję w języku naturalnym oraz łączenie od 1 do 14 obrazów wejściowych, a także zachowuje spójność do 4 postaci i 10 obiektów. Dzięki Atlas Cloud deweloperzy mogą korzystać z tej rodziny za pomocą jednego klucza zgodnego z OpenAI, niezawodnej dostępności i dostępności od Day-0. Zacznij tworzyć już dziś.
Polecane artykuły
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.





