
GLM API for Autonomous Task Execution
GLM คือซีรีส์ LLM เรือธงของ Z.ai จาก Zhipu AI และ GLM API ครอบคลุมตั้งแต่ GLM-5 แบบ agentic ไปจนถึง GLM-4.6 แบบ 357B MoE ที่มีประสิทธิภาพสูง โมเดลเหล่านี้โดดเด่นด้านการดำเนินงานแบบอัตโนมัติ การจัดการ agent ที่ซับซ้อน และการเขียนโปรแกรมระดับใช้งานจริง บน Atlas Cloud endpoint เดียวแบบรวมศูนย์ช่วยให้คุณเข้าถึงตระกูล GLM ทั้งหมดได้ตั้งแต่ Day-0 พร้อมการคิดราคาตามการใช้งานและ uptime สำหรับ production ที่เชื่อถือได้ เริ่มสร้างได้วันนี้
GLM พัฒนาโดย Z.ai โดย Atlas Cloud (ดำเนินการโดย Atlas Cloud AI LLC) เป็นผู้ให้บริการเข้าถึงโมเดลนี้ แต่ไม่ได้เป็นเจ้าของโมเดล เครื่องหมายการค้าทั้งหมดเป็นของเจ้าของที่เกี่ยวข้อง
สำรวจโมเดลชั้นนำ
Atlas Cloud มอบโมเดลสร้างสรรค์ล่าสุดที่นำหน้าในอุตสาหกรรมให้กับคุณ
เปรียบเทียบโมเดล GLM API: ตั้งแต่ GLM-4.6 ถึง GLM-5.2
จับคู่แต่ละ endpoint ให้เหมาะกับเวิร์กโหลดและงบประมาณของคุณ
| รูปแบบข้อมูล | คำอธิบาย |
|---|---|
| GLM-5.2 | GLM-5.2 สร้างมาโดยเฉพาะในฐานะโมเดลที่เน้น agent โดยแปลงพรอมป์ภาษาธรรมชาติและบริบทการเรียกใช้เครื่องมือให้เป็นการให้เหตุผลแบบมีโครงสร้าง การเรียกใช้ฟังก์ชัน และการดำเนินงานอัตโนมัติ โมเดลนี้ปรับแต่งมาสำหรับปัญหาซับซ้อนที่ต้องให้โมเดลวางแผน ลงมือทำ และวนปรับปรุงด้วยตนเอง เหมาะสำหรับการสร้าง autonomous agents และเวิร์กโฟลว์ที่ใช้เครื่องมือระยะยาว โดยมีราคา $1.4 ต่อหนึ่งล้าน input tokens และ $4.4 ต่อหนึ่งล้าน output tokens |
| GLM-5.1 | ป้อนงานเขียนโค้ดหรือปัญหาหลายขั้นตอนให้ GLM-5.1 แล้วจะได้ผลลัพธ์ด้านการเขียนโปรแกรมที่แข็งแกร่ง พร้อมการดำเนินการทีละขั้นตอนที่เสถียร ในฐานะโมเดลเรือธงล่าสุดของ Z.AI โมเดลนี้ยังให้บทสนทนาที่เป็นธรรมชาติมากขึ้นและความสวยงามของ front-end ที่ประณีตขึ้น เหมาะกับทีมที่สร้างเว็บแอปซับซ้อนและ agent pipelines โดยคิดราคา input ที่ $1.4 และ output ที่ $4.4 ต่อหนึ่งล้าน tokens |
| GLM-5v Turbo | GLM-5v Turbo แปลงพรอมป์ข้อความเป็น completions ได้รวดเร็ว ขณะยังคงความสามารถด้านการเขียนโปรแกรมที่ยกระดับขึ้นและการดำเนินการหลายขั้นตอนที่เสถียรของโมเดลเรือธง รุ่น turbo นี้ให้ความสำคัญกับ latency ที่ต่ำลงสำหรับผลิตภัณฑ์แบบโต้ตอบและรองรับปริมาณงานสูง โดยไม่ลดทอนความลื่นไหลของบทสนทนา เลือกใช้เมื่อความเร็วในการตอบสนองสำคัญที่สุด ในราคา $1.2 ต่อหนึ่งล้าน input tokens และ $4 ต่อหนึ่งล้าน output tokens |
| GLM-5 Turbo | GLM-5 Turbo รับข้อความเข้าและสร้าง completions ออกมาอย่างรวดเร็ว เป็นโมเดลเรือธงที่ปรับแต่งเพื่อลด latency สำหรับการเขียนโปรแกรมที่ดีขึ้นและการให้เหตุผลหลายขั้นตอนที่เชื่อถือได้ โมเดลนี้ยังคงให้คำตอบที่เป็นธรรมชาติและสร้าง front-end ได้สะอาด พร้อมเร่ง throughput สำหรับการใช้งานแบบเรียลไทม์ เหมาะกับอินเทอร์เฟซแชตและ agent loops ที่ต้องการความรวดเร็ว โดยคิดราคา $1.2 ต่อหนึ่งล้าน input tokens และ $4 ต่อหนึ่งล้าน output tokens |
| GLM-5 | GLM-5 รับคำสั่งแบบข้อความและสร้างโค้ด ลำดับการให้เหตุผล และคำตอบเชิงสนทนา ในฐานะรุ่นเรือธงหลักของ Z.AI จุดเด่นของการอัปเกรดอยู่ที่ความสามารถด้านการเขียนโปรแกรมที่แข็งแกร่งขึ้นและการดำเนินการหลายขั้นตอนที่เสถียรกว่าสำหรับงาน agent ที่ซับซ้อน เป็นตัวเลือกที่สมดุลสำหรับการพัฒนา full-stack และการให้เหตุผลทั่วไปในชีวิตประจำวัน โดยเสนอราคา $1 สำหรับ input และ $3.2 สำหรับ output ต่อหนึ่งล้าน tokens |
| GLM-4.7 | สั่ง GLM-4.7 ให้เขียนโค้ดหรือประสานงาน agent แล้วโมเดลจะตอบกลับด้วยการดำเนินการหลายขั้นตอนที่เชื่อถือได้และบทสนทนาที่เป็นธรรมชาติ โมเดลระดับเรือธงนี้ผสานความสามารถด้านการเขียนโปรแกรมที่ยกระดับขึ้นกับผลลัพธ์ front-end ที่ประณีต ในราคาที่เข้าถึงได้มากขึ้น เหมาะกับเวิร์กโหลด production ที่ต้องคุมต้นทุน โดยคิดราคา $0.6 ต่อหนึ่งล้าน input tokens และ $2.2 ต่อหนึ่งล้าน output tokens |
| GLM-4.6 | GLM-4.6 เป็นโมเดล Mixture-of-Experts ขนาด 357B-parameter ที่มีประสิทธิภาพจาก Zhipu AI ซึ่งแมปพรอมป์ข้อความให้เป็น completions คุณภาพสูงพร้อม throughput ที่แข็งแกร่ง สถาปัตยกรรม MoE จะเปิดใช้งานเฉพาะ experts ที่แต่ละคำขอต้องใช้ ทำให้การ inference มีประสิทธิภาพสำหรับงานวิเคราะห์และงานคอนเทนต์ ใช้งานได้ดีสำหรับการวิเคราะห์ข้อมูล การร่างสไลด์ และคอนเทนต์เว็บ ในราคา $0.6 สำหรับ input และ $2.2 สำหรับ output ต่อหนึ่งล้าน tokens |
อะไรคือขุมพลังของ GLM API
ตั้งแต่แกน sparse Mixture-of-Experts และบริบท 200K-token ไปจนถึงการเรียกใช้เครื่องมือแบบ native และโหมดคิดที่สลับได้ GLM API นำสแตก reasoning และ coding ระดับเรือธงของ Z.ai มาไว้หลัง endpoint เดียวที่เข้ากันได้กับ OpenAI
Sparse Mixture-of-Experts ที่ขยายได้ในระดับใหญ่
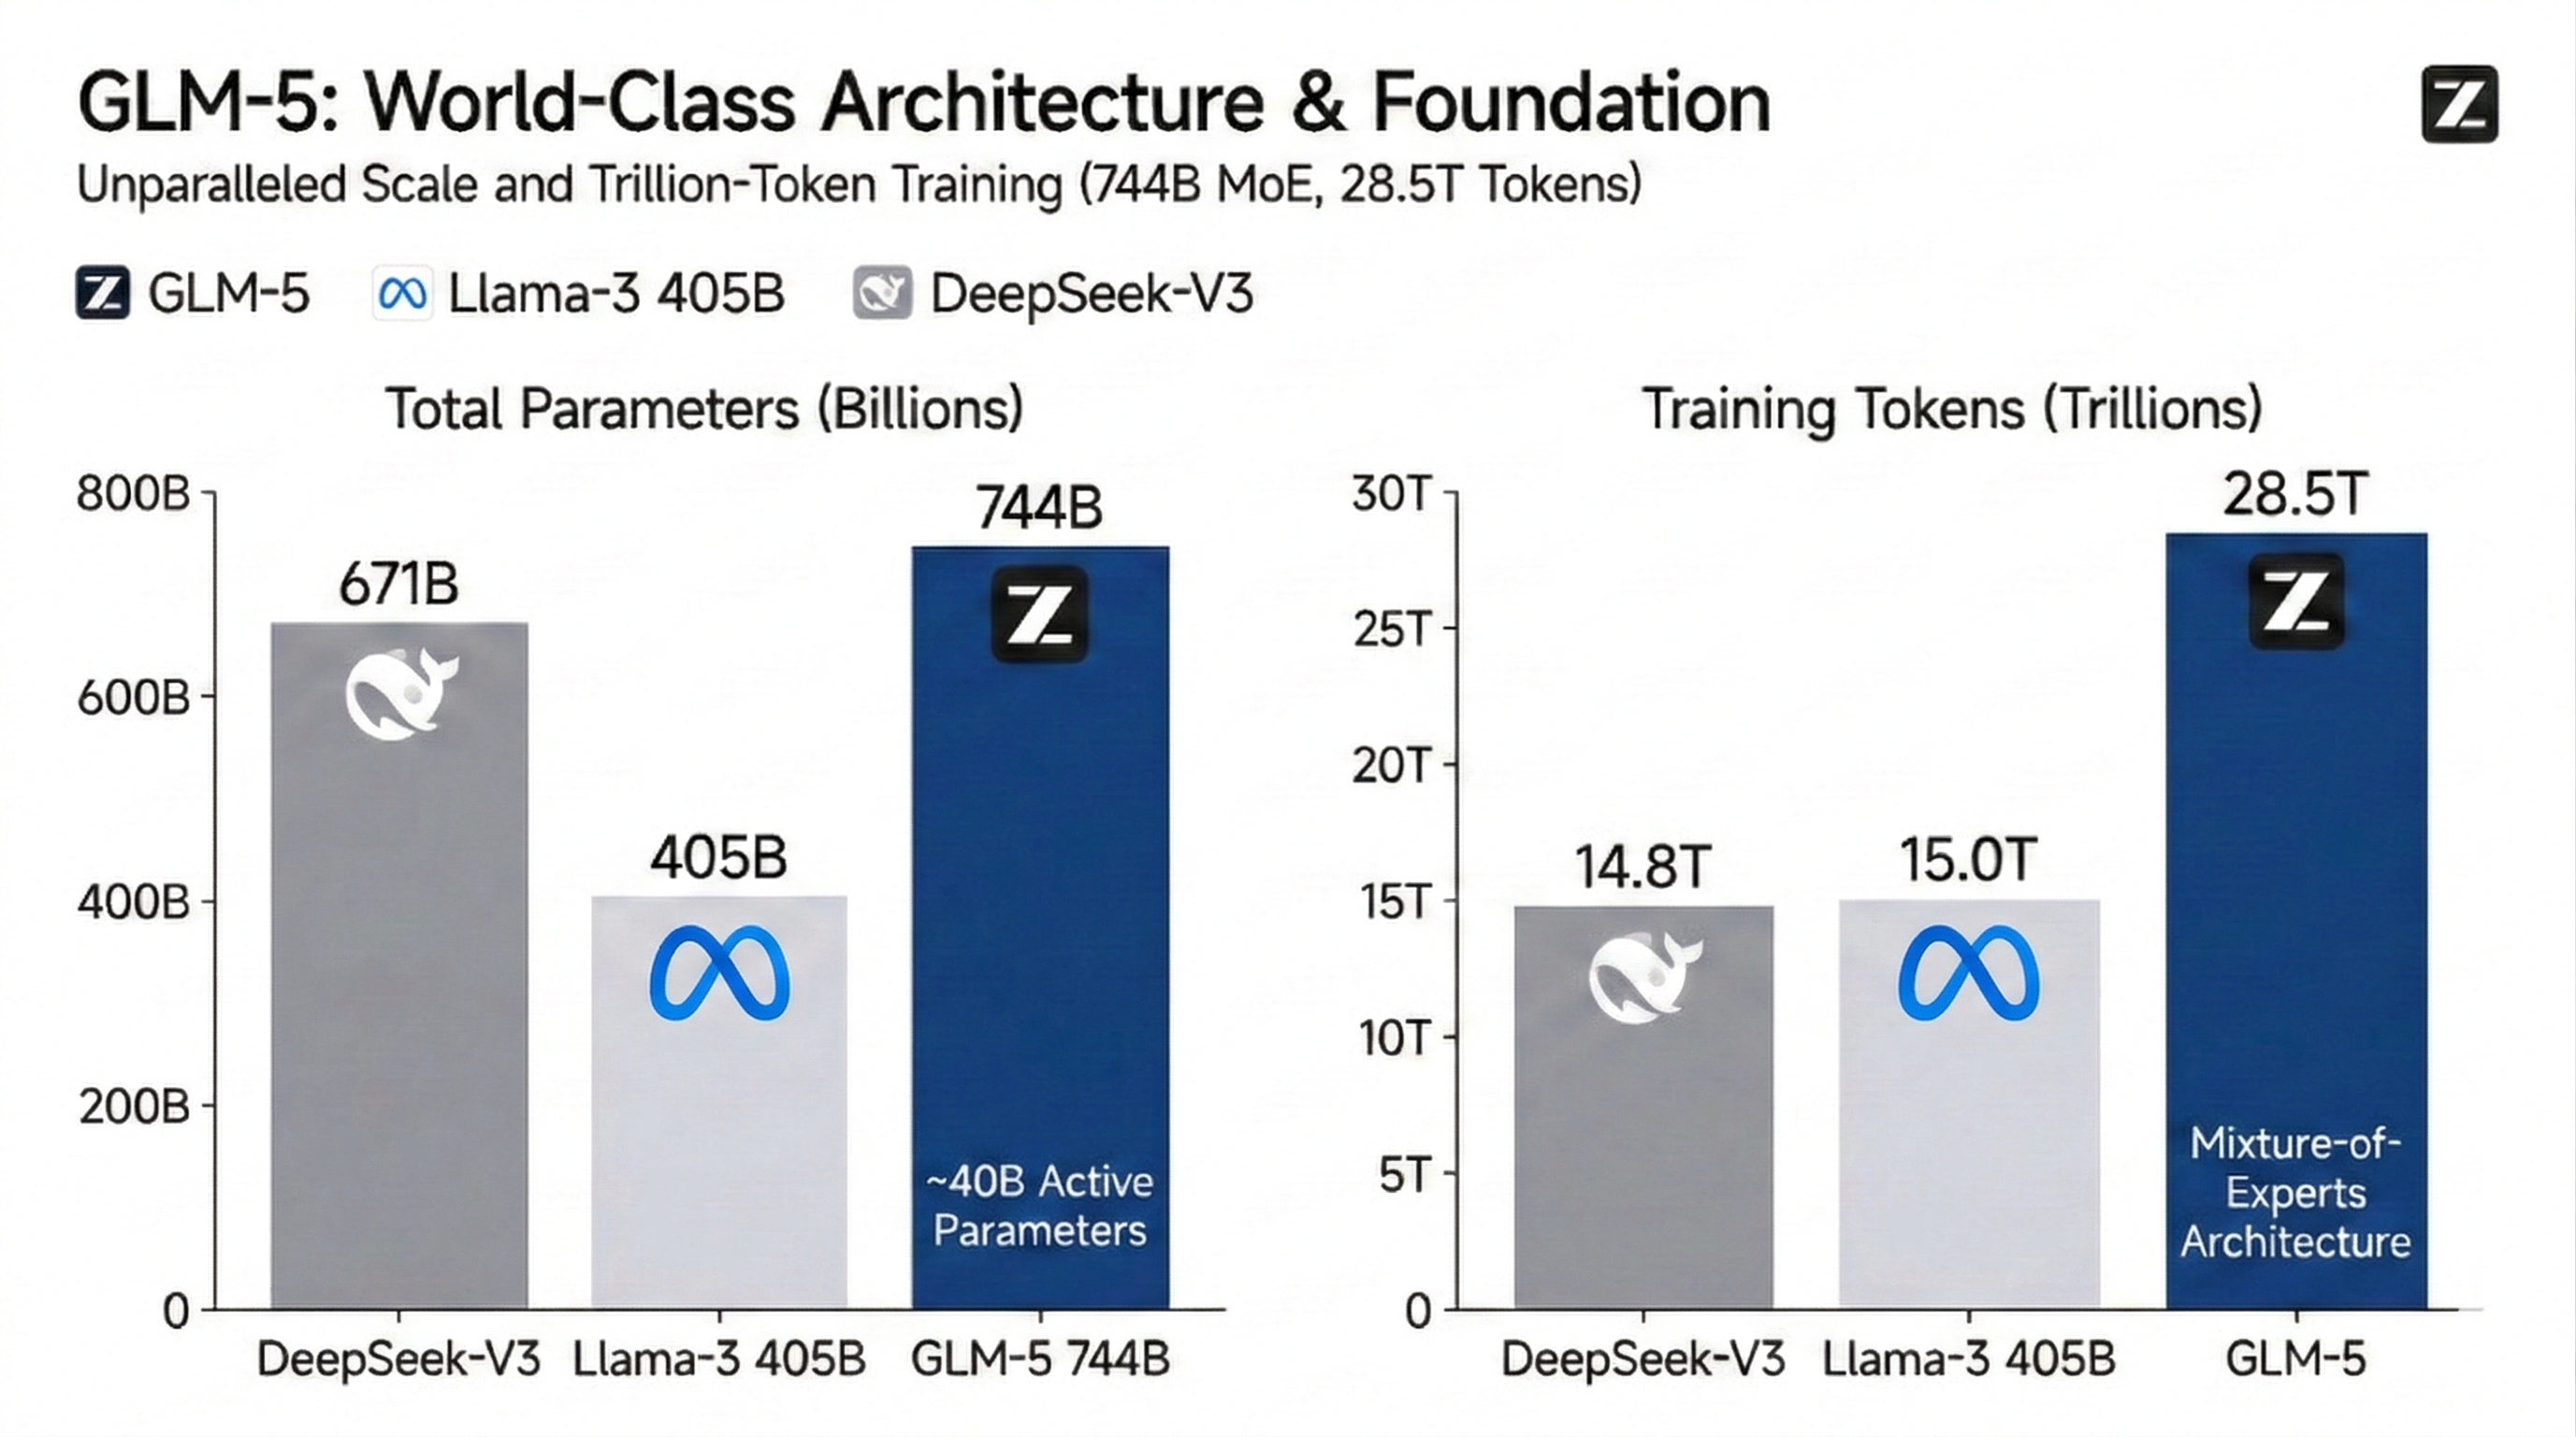
แกน sparse Mixture-of-Experts จะเปิดใช้พารามิเตอร์เพียงประมาณ 40 พันล้านตัวต่อหนึ่ง query โดยดึงความสามารถจากกลุ่มผู้เชี่ยวชาญที่ใหญ่กว่านั้นมาก ผลลัพธ์คือความรู้เชิงลึกและการเรียกคืนข้อมูลที่แม่นยำ โดยไม่ต้องแบกรับต้นทุนแบบ dense-model ในทุกการเรียกใช้
Agentic Execution ที่ฝังมาใน GLM API
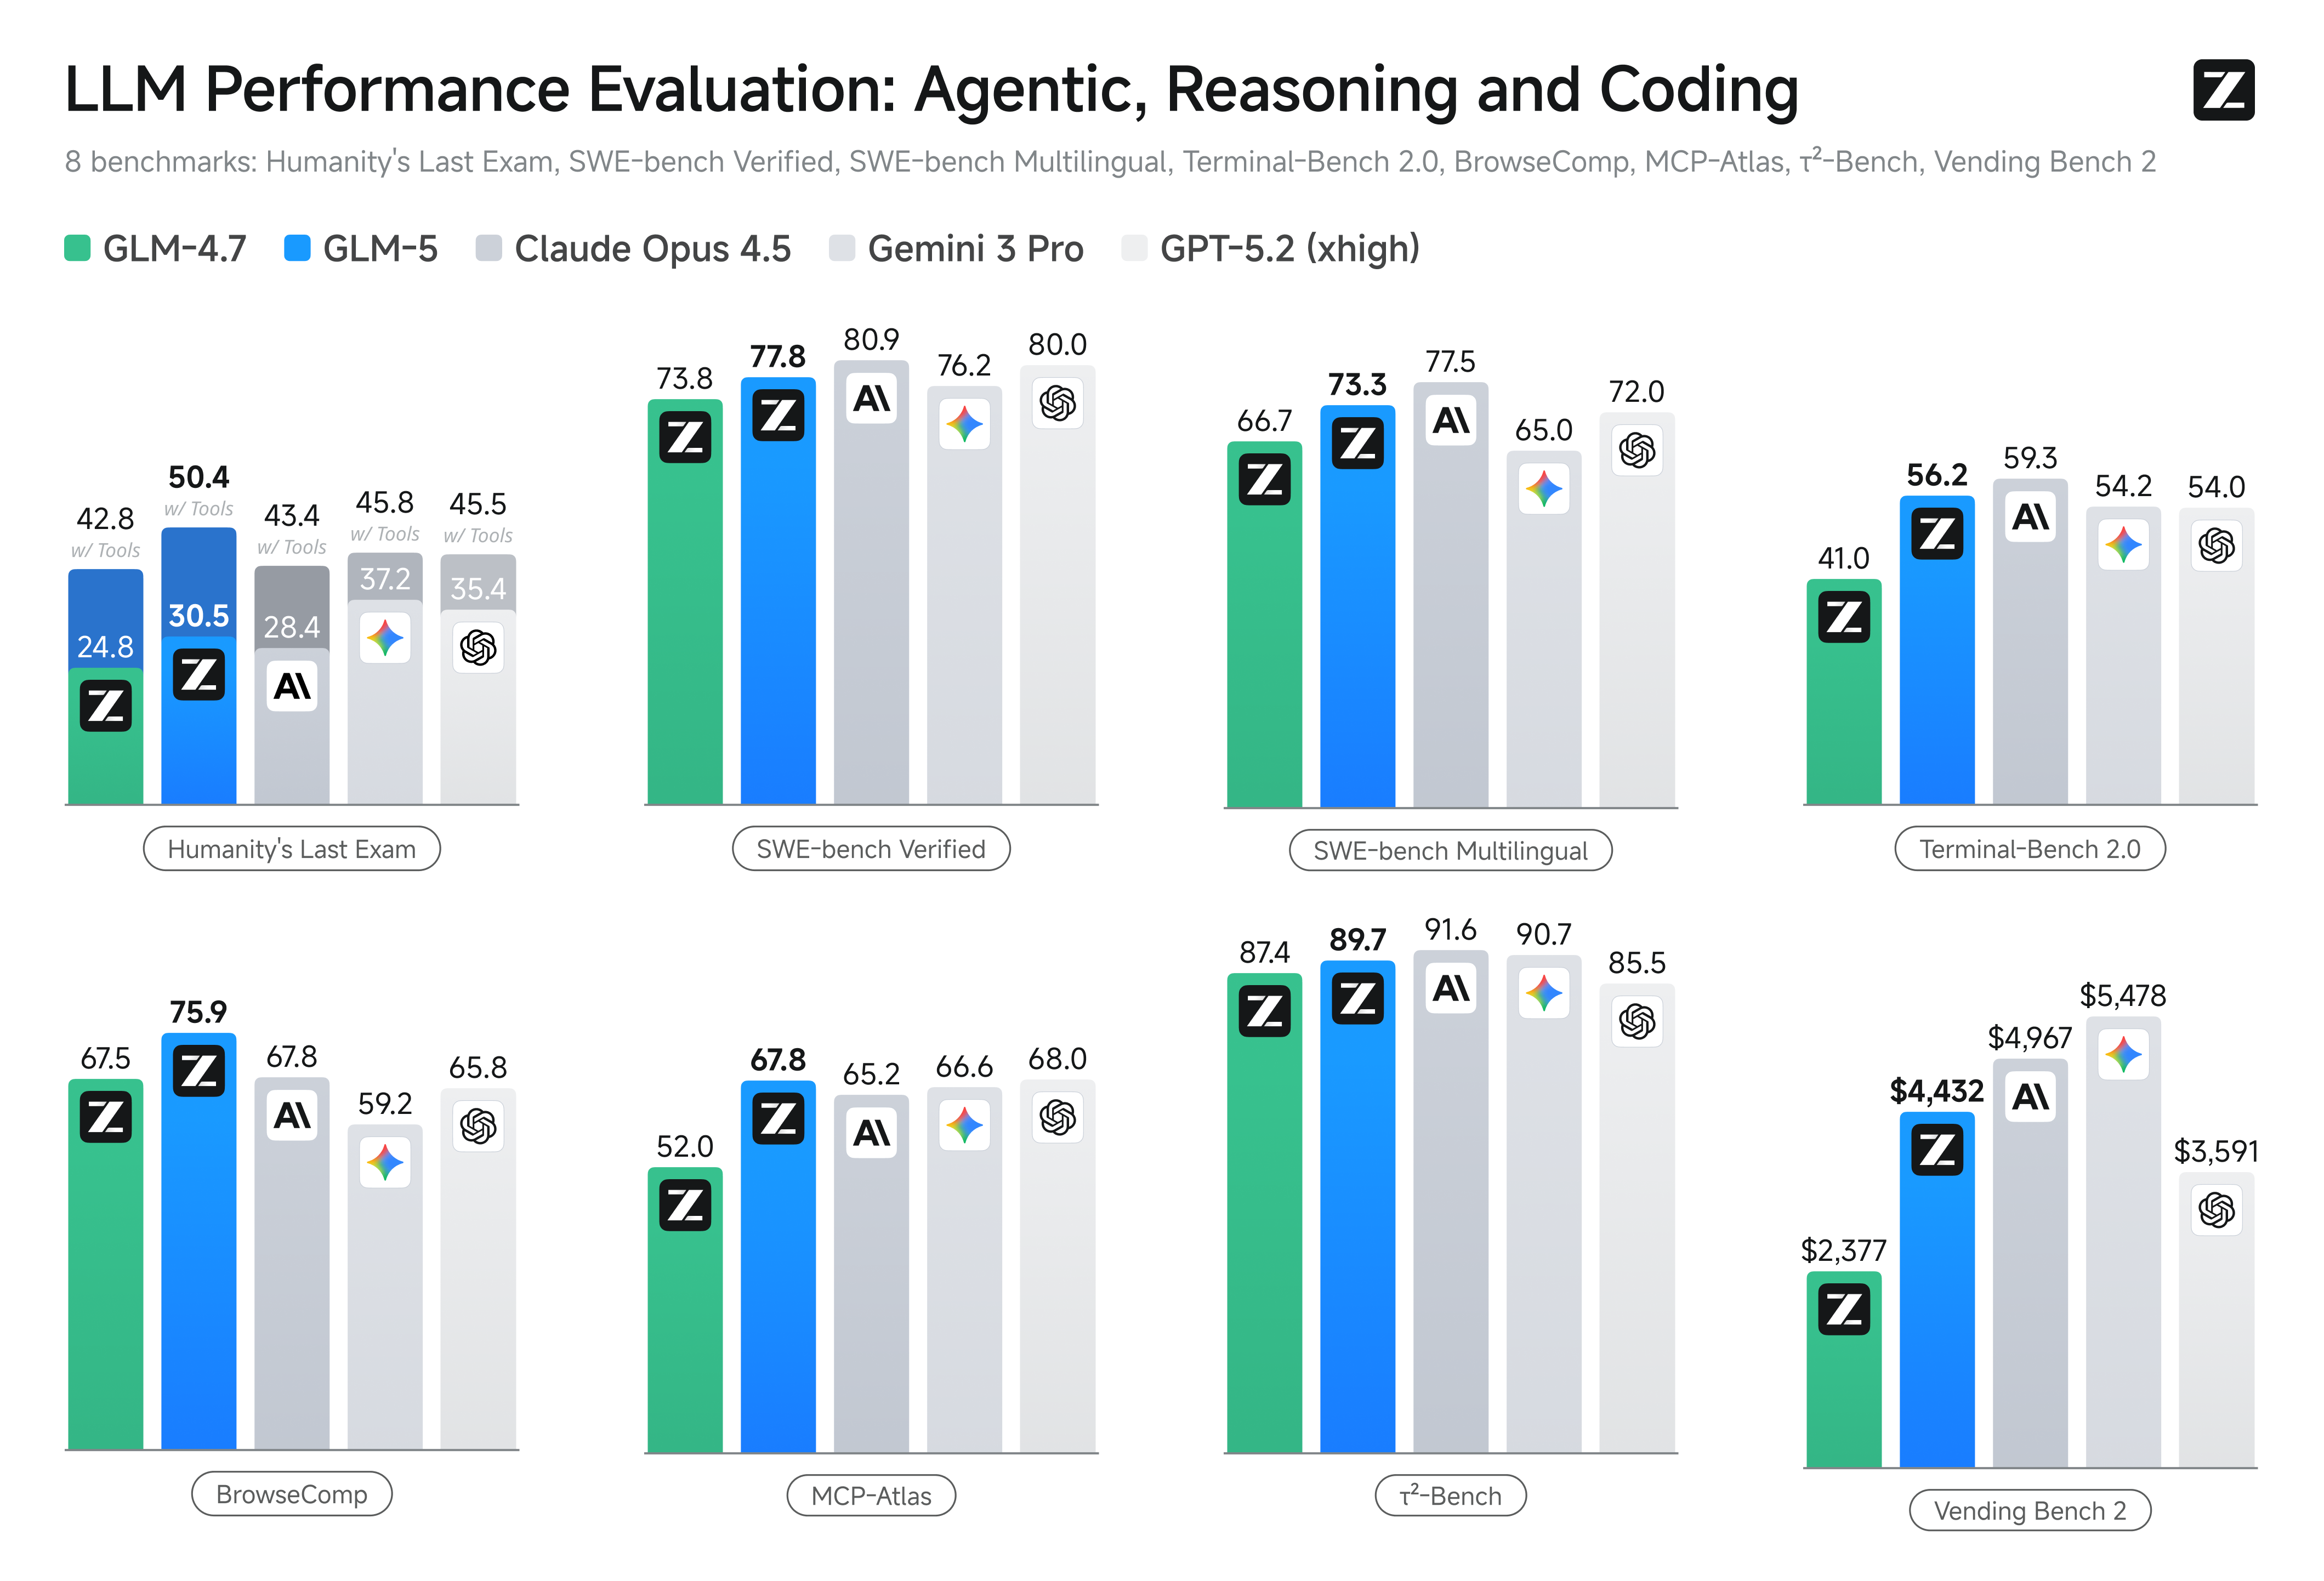
ตรรกะการวางแผนถูกฝังอยู่ใน GLM API เพื่อให้ agent ทำงานระยะยาวแบบหลายขั้นตอนได้โดยไม่หลุดทิศทาง ความเสถียรนี้เหมาะกับการพัฒนาซอฟต์แวร์อัตโนมัติ pipeline งานวิจัย และ workflow ที่ต้องคงความสอดคล้องต่อเนื่องหลายขั้นตอน
Coding และ Reasoning ที่ปรับจูนด้วย Reinforcement
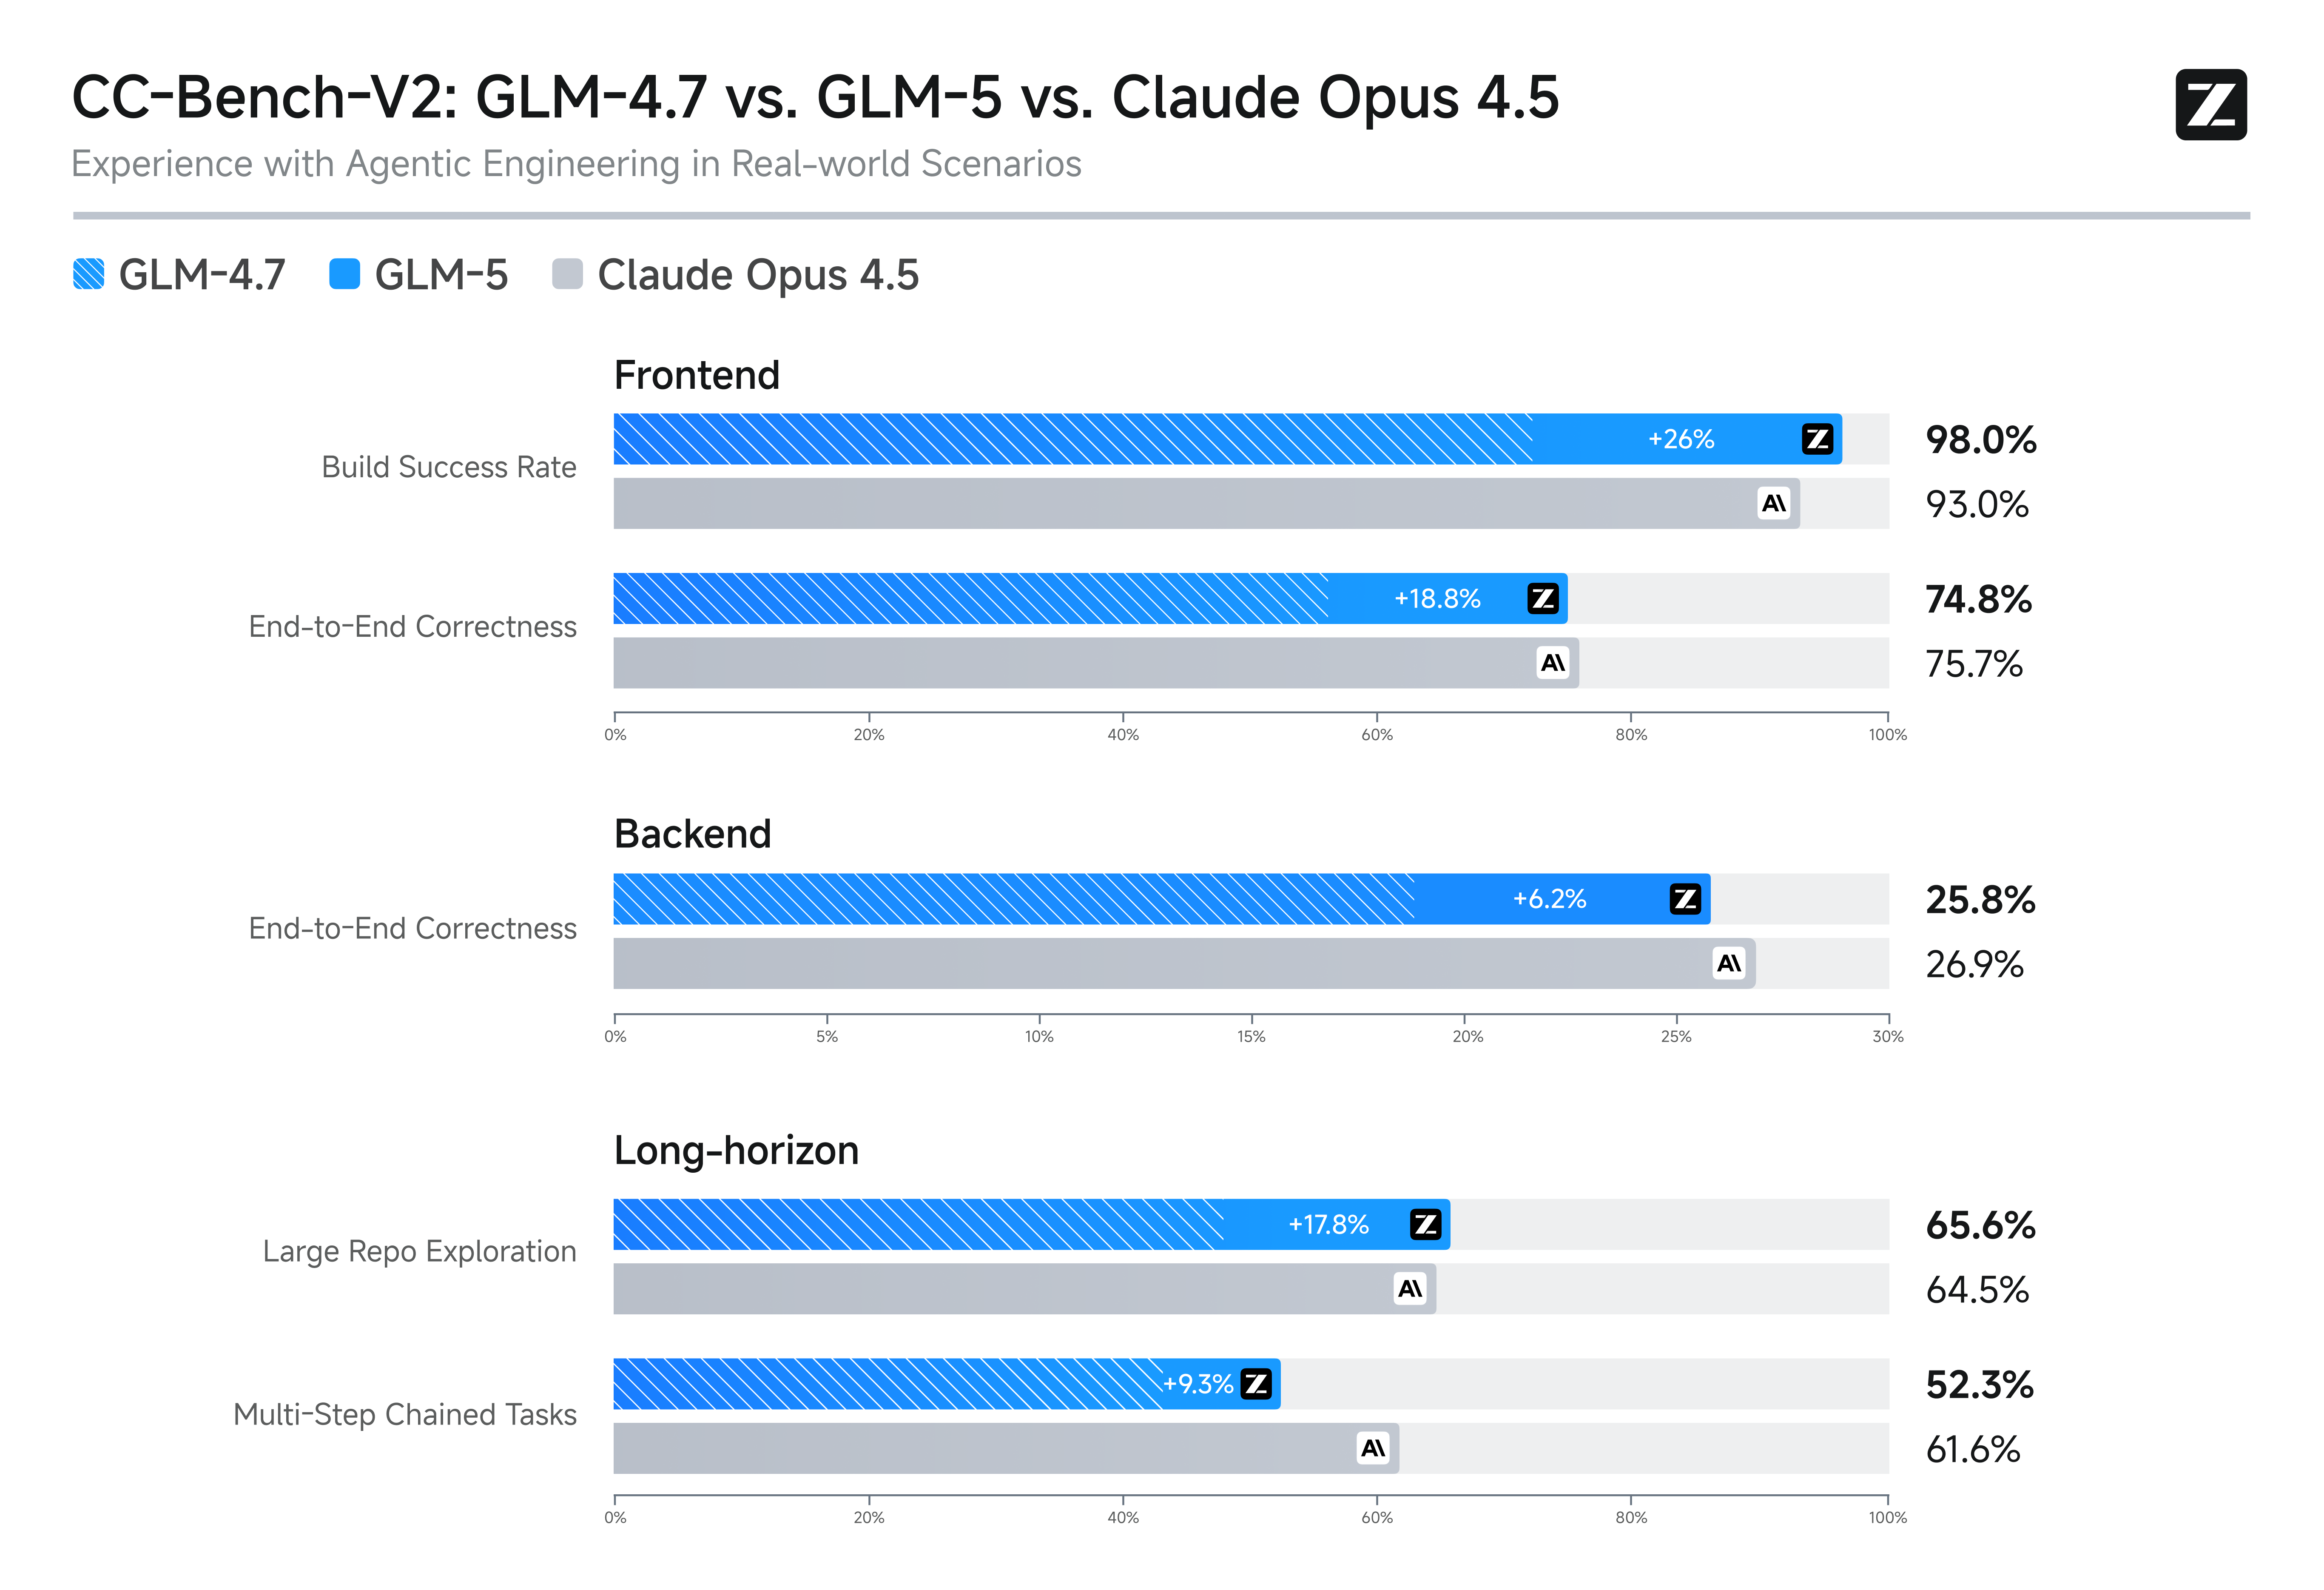
การ post-training ด้วย reinforcement-learning ช่วยลับคมความสามารถในการสร้างโค้ดและการให้เหตุผลเชิงอัลกอริทึมของโมเดลให้เหนือกว่า GLM รุ่นก่อนหน้าอย่างชัดเจน นักพัฒนาจะได้ output แบบ full-stack ที่เชื่อถือได้มากขึ้น และการแก้ปัญหาเชิงโครงสร้างที่แข็งแกร่งขึ้นในจุดที่ข้อผิดพลาดทางตรรกะเล็ก ๆ มักลุกลามได้ง่าย
Context Window 200K พร้อม Sparse Attention
แต่ละโมเดลรองรับบริบท 200K tokens หรือมากกว่า พร้อม output tokens ได้สูงสุด 128K และ sparse attention ช่วยให้การใช้งานในสเกลนี้มีต้นทุนที่เข้าถึงได้ repository ทั้งชุด สัญญาขนาดยาว และ brief งานวิจัยจึงอยู่ในบริบทพร้อมกันได้
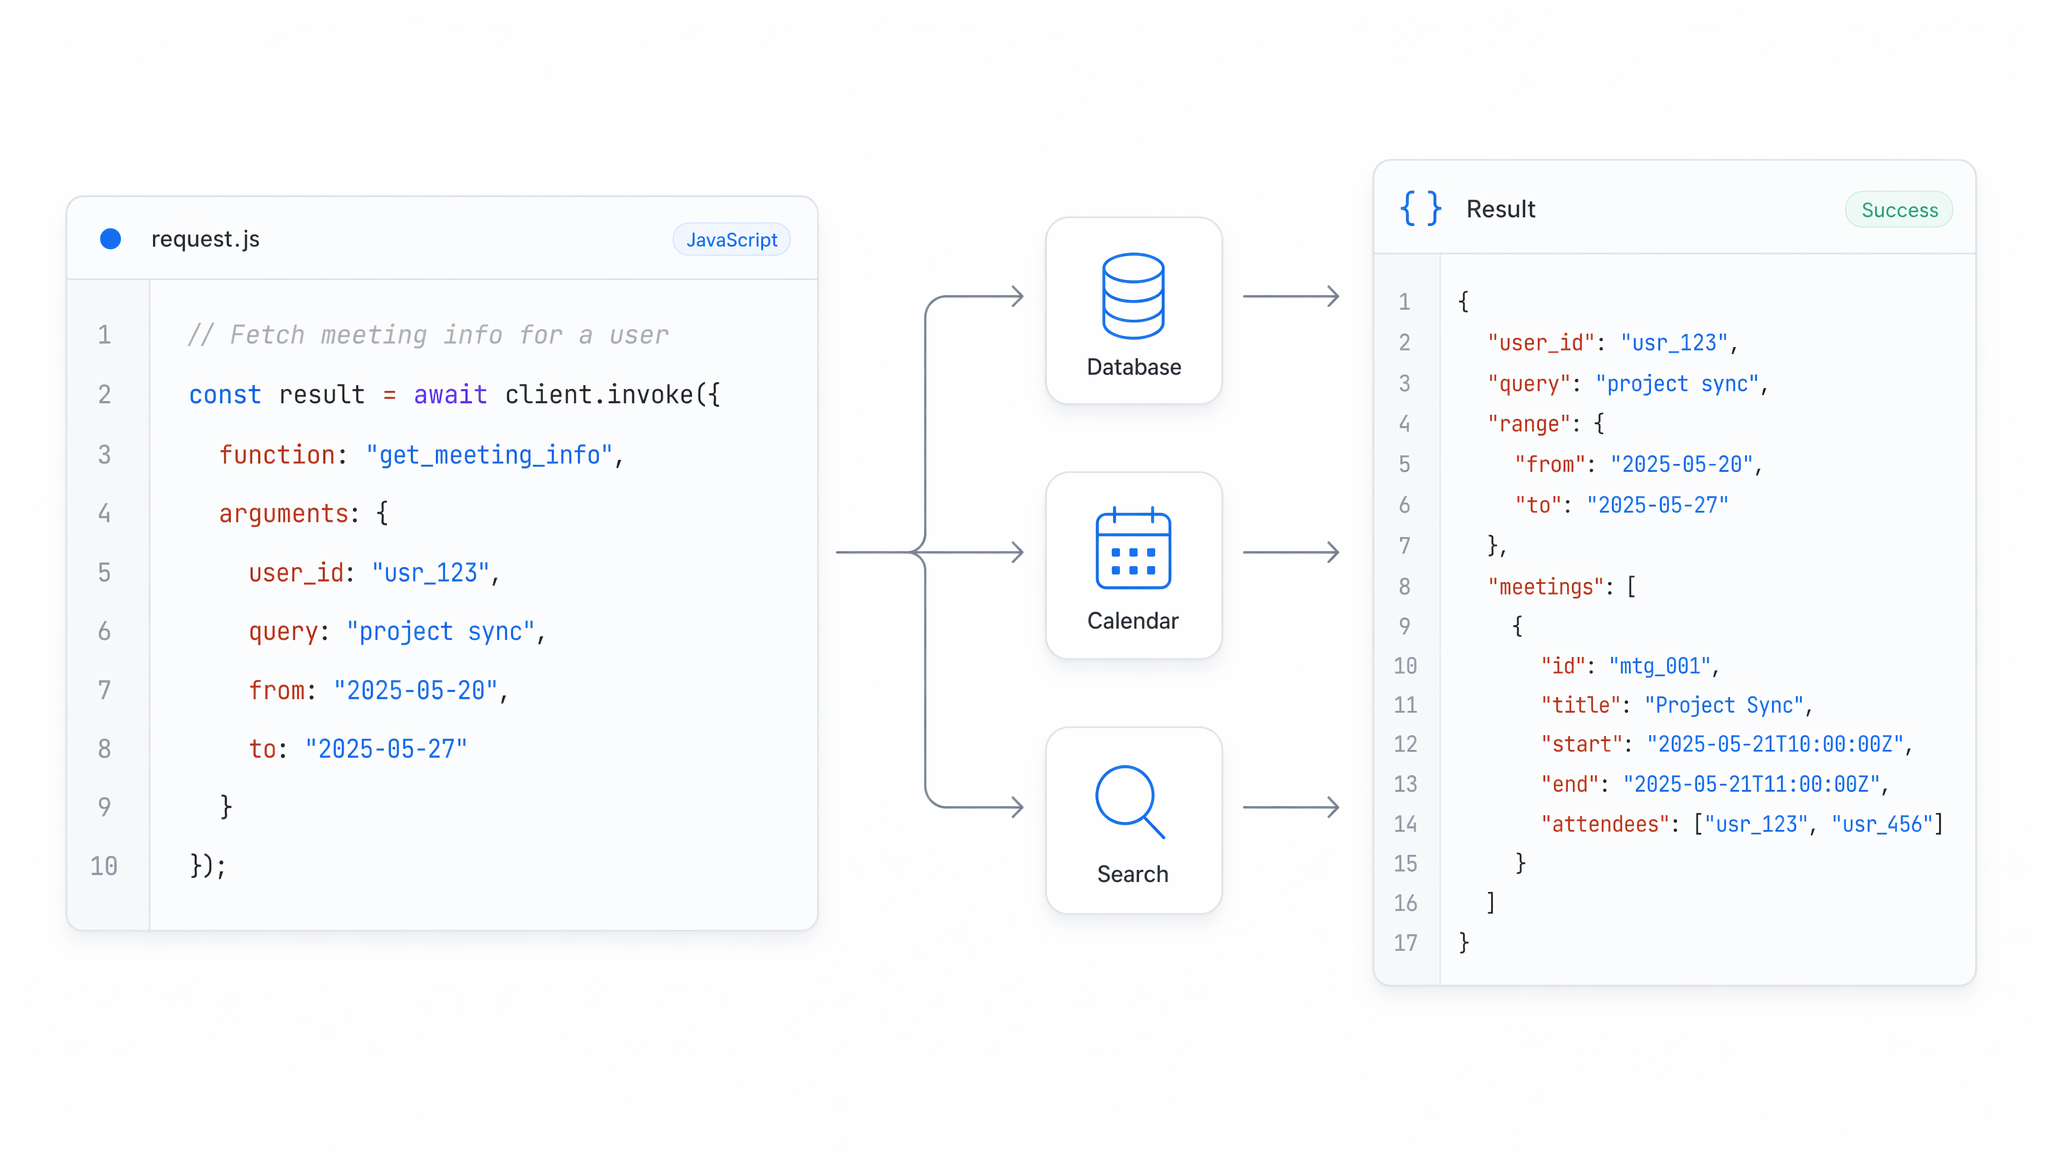
การเรียกใช้เครื่องมือแบบ Native ผ่าน GLM API
เชื่อมต่อเครื่องมือและบริการภายนอกเข้ากับ GLM API ผ่าน native function calling และ output แบบ JSON ที่มีโครงสร้าง โมเดลจะตัดสินใจเองว่าควรเรียกใช้เครื่องมือเมื่อใด จัดรูปแบบ argument ตาม schema ของคุณ และส่งคืนผลลัพธ์ที่เครื่องอ่านได้
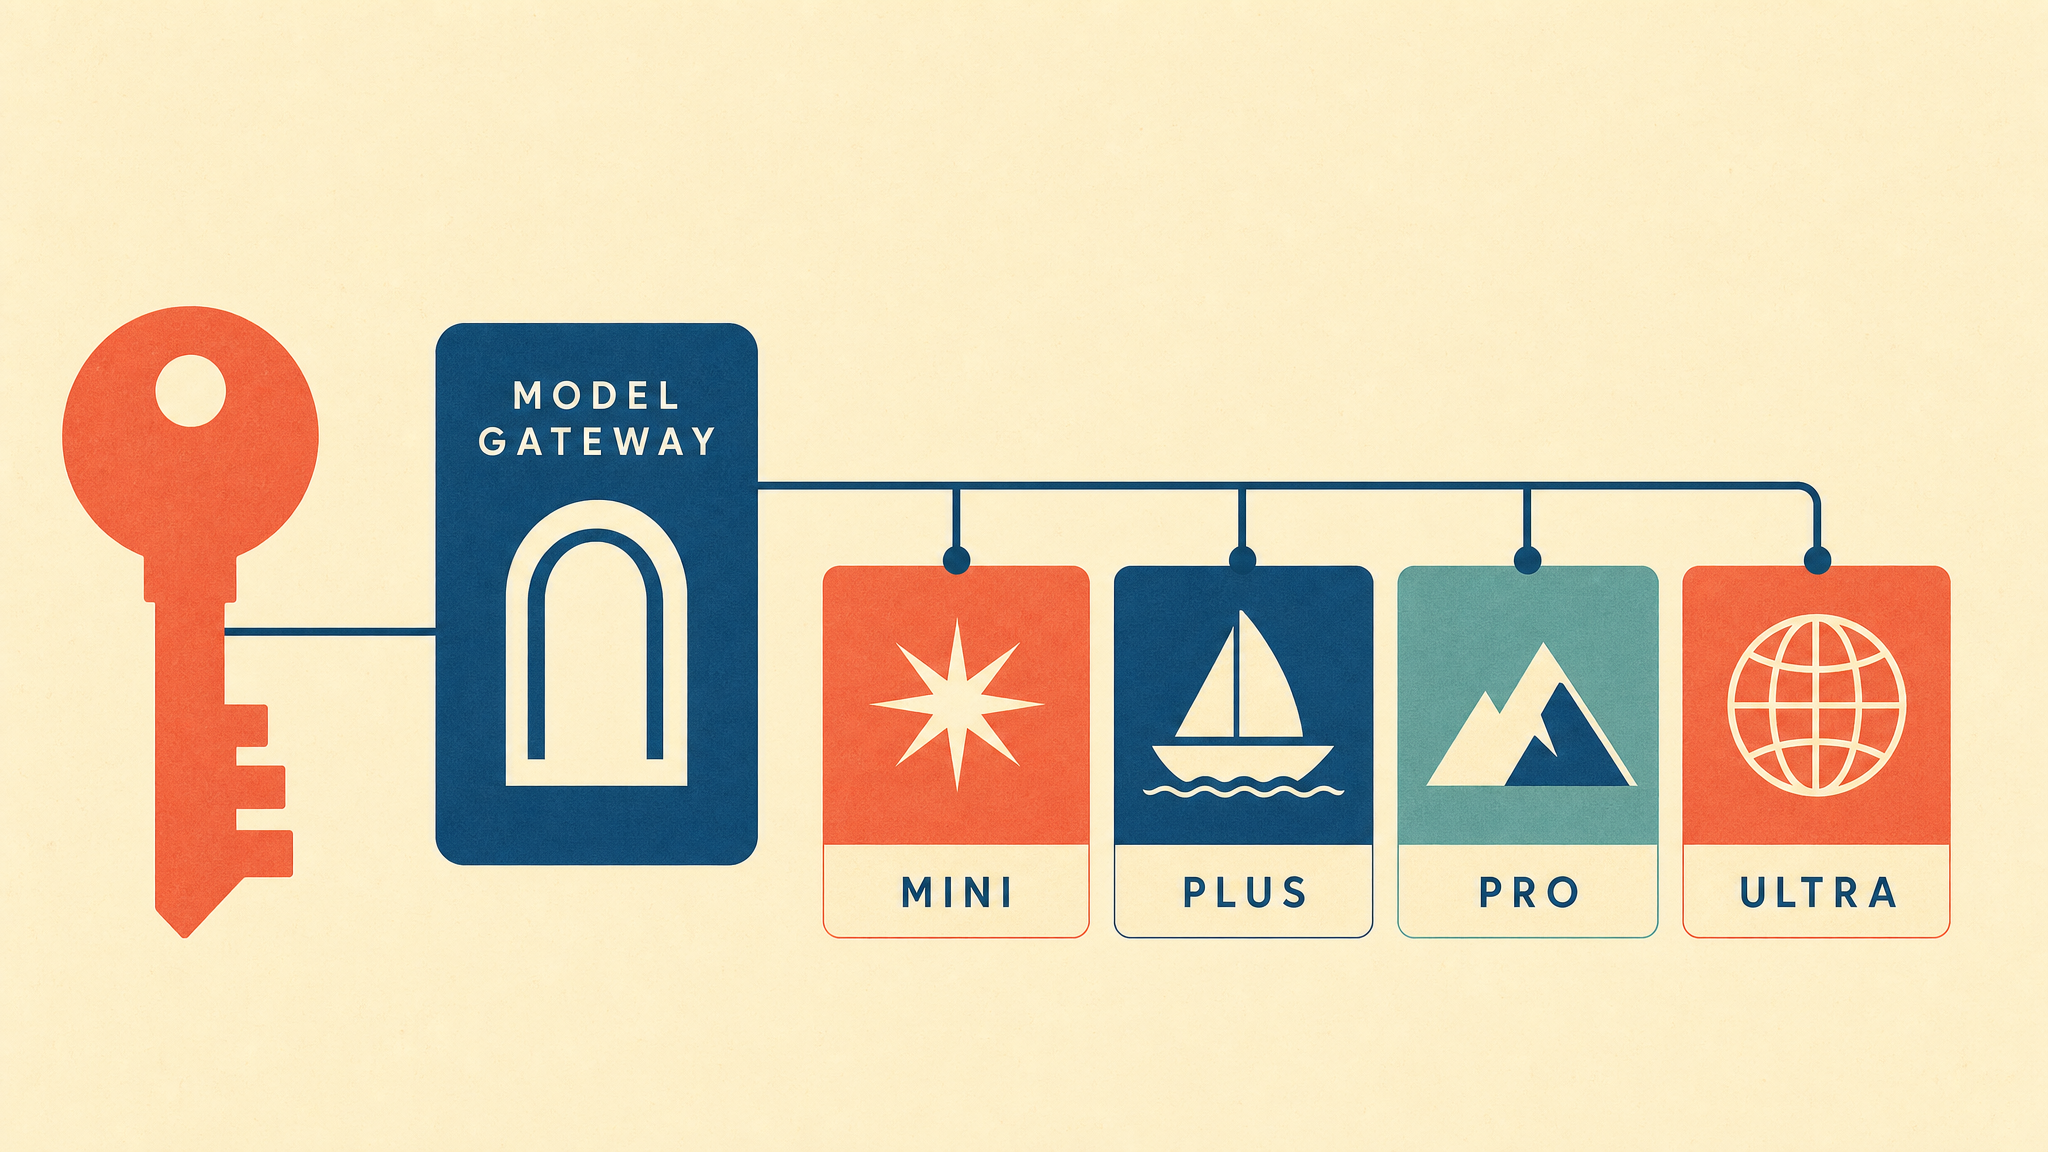
ไลน์อัป GLM API ครบชุดภายใต้ Key เดียว
Key เดียวที่เข้ากันได้กับ OpenAI เข้าถึงไลน์อัป GLM API ได้ทั้งหมด ตั้งแต่ GLM-5.2 ระดับเรือธง ไปจนถึงระดับ Turbo และ GLM-4.6 ที่คุ้มต้นทุน เริ่ม prototype บน tier ที่เบากว่า แล้วโปรโมตสู่ production ได้ด้วยโค้ดเพียงบรรทัดเดียวและราคาแบบ pay-as-you-go
GLM API เทียบกันแบบตัวต่อตัว: บรีฟเดียว เปรียบเทียบสามโมเดล
ส่งคำขอ build เพียงครั้งเดียวผ่าน GLM API แล้วดูว่า GLM 5.2, DeepSeek V4 Pro และ GLM 5 เปลี่ยนคำสั่งเดียวกันให้เป็นหน้าอินเทอร์แอกทีฟที่ใช้งานได้อย่างไร เพื่อให้คุณประเมินคุณภาพ front-end ตรรกะเลย์เอาต์ และความประณีตของ interaction ได้ในพริบตา
สร้างเอกสาร HTML แบบไฟล์เดียวที่สมบูรณ์และ self-contained (ฝัง CSS และ JavaScript ทั้งหมดไว้ภายใน ห้ามมี external dependencies โดยเด็ดขาด ไม่มี CDNs ไม่มี image URLs ไม่มี external fonts) ที่เรนเดอร์ "Aurora Tuning Console" แบบอินเทอร์แอกทีฟ — ประสบการณ์ WebGL เต็ม viewport ของท้องฟ้าขั้วโลกยามเที่ยงคืน โดยคำนวณแสงออโรราแบบ real time ภายใน GLSL fragment shader เท่านั้น ห้ามปลอมด้วย sprites, textures หรือ particle stacks ข้อกำหนดหลักด้านการเรนเดอร์: เรนเดอร์ full-screen quad เพียงหนึ่งชิ้น และทำงานภาพทั้งหมดใน fragment shader แสง aurora borealis ต้องสร้างแบบ procedural จาก layered fractal value/simplex noise (fbm, 4–6 octaves) ที่ไหลและบิดเบี้ยวตามเวลาโดยใช้ uniform clock ทำให้เกิดม่านแสงแนวตั้งสูงที่หายใจ ระลอก ผูกเป็นปม และค่อย ๆ สลายตัว จำลอง aurora เป็น self-emissive volumetric glow: สะสมความสว่างตาม vertical falloff เพิ่ม soft bloom ที่ฐานของม่านแต่ละผืน และกระจาย star-dust noise จาง ๆ ที่ล่องลอยในท้องฟ้ามืดด้านบน จัดองค์ประกอบเฟรมเป็นมุมมองเงยขึ้นแบบ minimalist low-horizon — ท้องฟ้าประมาณ 80% พร้อมสันเขาเงามืดและทะเลสาบนิ่งเหมือนกระจกบริเวณด้านล่างที่สะท้อน aurora และดวงดาวเป็นภาพคัดลอกแบบ vertically-mirrored ที่มีระลอกอ่อน ๆ พาเลตพื้นฐานคือ indigo เกือบดำ (กลางคืนสีน้ำเงิน-ม่วงเข้ม); aurora เป็นองค์ประกอบเดียวที่มี saturation สูง — สุขุม เรืองแสง โปร่งบาง และไม่ฉูดฉาด Interactions (ทั้งหมดต้อง real-time ลื่นไหล และตอบสนองชัดเจน): - การลากเมาส์ข้ามท้องฟ้า "ดึง" ม่านแสงเหมือนผ้า — ส่งตำแหน่ง/ความเร็วของ pointer เข้า shader uniforms เพื่อให้ aurora โค้ง ยืด และไหลเข้าหา cursor จากนั้นค่อย ๆ คืนตัวด้วย inertia นุ่มนวลเมื่อปล่อย - การเลื่อน mouse-wheel เปลี่ยน "season" โดย interpolate แถบสีของ aurora อย่างต่อเนื่องผ่าน emerald green → magenta → indigo (และวนกลับ) แสดงเป็นการเลื่อน gradient ที่นุ่มนวล ไม่ใช่การกระโดดเป็นขั้น ๆ - Double-click จุดดาวดวงใหม่ ณ ตำแหน่งนั้นบนท้องฟ้า: ดาวจะกะพริบเป็นจังหวะ (sinusoidal brightness) และทอดเงาสะท้อนสีเดียวกันบนทะเลสาบ รองรับดาวหลายดวงพร้อมกัน - คง idle animation แบบละเอียดอ่อน เพื่อให้ม่านแสงแรกดูเหมือนค่อย ๆ ตื่นและคลี่ตัวเมื่อโหลด — อารมณ์เงียบ ศักดิ์สิทธิ์ เย็น และนิ่งสงบ UI & polish: overlay ควบคุมขนาดเล็ก สง่างาม กึ่งโปร่งใสที่มุมหนึ่ง แสดง season/color ปัจจุบันและ hint หนึ่งบรรทัดแบบจาง ๆ ของ controls (drag / scroll / double-click) จัดสไตล์เป็น aesthetic โทนเย็นสมัยใหม่ที่สะอาด พร้อม transition แบบ soft fade ทำให้ responsive เต็มรูปแบบ: resize WebGL canvas และอัปเดต resolution uniforms เมื่อ window resize เพื่อให้เต็มทุก viewport และคมชัดบนหน้าจอ high-DPI ตั้งเป้า 60fps ที่นิ่งด้วย requestAnimationFrame ใส่ fallback message ที่สุภาพหาก WebGL ใช้งานไม่ได้ ให้ความสำคัญกับคุณภาพเชิงคณิตศาสตร์ของ noise flow, volumetric glow และความลื่นไหลของ interactions — ตรงนี้คือจุดที่โมเดลเก่งควรโดดเด่นกว่าโมเดลที่อ่อนกว่าอย่างเห็นได้ชัด
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
สร้างเอกสาร HTML แบบไฟล์เดียวที่สมบูรณ์และ self-contained (ฝัง CSS และ JavaScript ทั้งหมดในไฟล์เดียว ไม่มี external dependencies เลย — ไม่มี CDNs ไม่มี external scripts ไม่มี web fonts ไม่มี image URLs ไม่มี SVG assets ที่ดึงผ่านเครือข่าย; สร้างเสียงทั้งหมดด้วย native Web Audio API และวาดภาพทั้งหมดด้วย CSS และ Canvas/DOM) ที่เปิดได้โดยตรงในเบราว์เซอร์สมัยใหม่ใด ๆ และรัน cyberpunk step-sequencer drum machine ที่เล่นได้จริงในภาษาภาพของ 1980s synthwave neon เครื่องดนตรีหลัก: เรนเดอร์ step matrix เรืองแสงขนาด 16 columns × 6 tracks วางเรียงแนวนอนเต็มหน้าจอ หนึ่งแถวต่อหนึ่ง voice — Kick, Snare, Closed Hi-Hat, Open Hi-Hat, Clap และ Synth Bass แต่ละ cell จากทั้งหมด 96 cells เป็น pad ที่คลิกได้; คลิกเพื่อ toggle on/off, cell ที่ active จะสว่างด้วย glow สี magenta-to-cyan ที่อิ่มตัว ส่วน cell ที่ inactive จะเป็นสี่เหลี่ยมบุ๋มมืดบนพื้นหลัง indigo เกือบดำ ผู้ใช้โปรแกรม beat โดยเปิดไฟ cell ทีละ column รองรับ click-and-drag painting ข้าม cells เพื่อ toggle หลาย cell พร้อมกัน Audio: สังเคราะห์ drum voices ทั้งหมดแบบ live ด้วย Web Audio API — kick เป็น sine ที่ pitch-swept พร้อม amplitude decay รวดเร็ว, snare และ clap เป็น filtered white-noise bursts พร้อม envelope, closed และ open hi-hats เป็น high-passed noise ที่มี decay สั้นเทียบกับยาว และ synth bass เป็น detuned saw/square ผ่าน resonant low-pass filter เล่น root note ที่เลือกได้ จัด schedule steps ด้วย look-ahead clock ที่แม่นยำ (ไม่ใช่ timing แบบ setInterval ตรง ๆ) เพื่อให้ loop แน่นนิ่งแม้ tempo สูง Loop pattern 16-step อย่างต่อเนื่องเมื่อเล่น Transport และ controls ให้ dock อยู่ใน control bar สมมาตรที่ pin ตลอดแนวด้านล่าง: ปุ่ม Play/Stop ขนาดใหญ่, BPM dial หรือ rotary knob (ลากได้ ช่วงประมาณ 60–200 BPM ค่าเริ่มต้น 120) พร้อม numeric readout แบบ live, master volume fader, ปุ่ม mute ราย track, ปุ่ม Clear และปุ่ม Randomize ที่สร้าง beat ที่สมเหตุสมผล playhead ที่เคลื่อนที่ — vertical light-blade — กวาดผ่าน grid แบบ sync กับ audio อย่างสมบูรณ์ และทุก cell ที่ active เมื่อถูกชนจะบานเป็น radial ripple pulse แล้วค่อย ๆ จางลง ใส่ oscilloscope/waveform display แบบ live ที่ visualize amplitude ของ master output แบบ real time และตอบสนองต่อเสียง Visual style: พื้นหลัง gradient indigo-to-violet เข้มจนอ่านเป็นเกือบดำ เส้น grid และ accent ของ UI เป็น electric magenta และ cyan ความสว่างทั้งหมดมาจาก self-glow ขององค์ประกอบและ hit-flash bloom (box-shadow glow, highlight ที่ให้ความรู้สึก additive) เพื่อชวนให้นึกถึงคลับใต้ดินยามดึกที่เต้นไปตาม loop จัด grid ทั้งหมดไว้กึ่งกลางหน้าจอ รักษาเลย์เอาต์ให้สมมาตรโดยมี control bar บีบฐานด้านล่าง และทำให้ responsive เพื่อให้ grid scale ลงอย่างสวยงามบน viewport ขนาดเล็ก เพิ่ม scanline หรือ chromatic shimmer แบบเคลื่อนไหวละเอียดอ่อนเพื่อสร้างบรรยากาศโดยไม่ลดความอ่านง่าย Interaction requirements: ทุกอย่างต้องตอบสนองทันที — คลิก pads, ลาก BPM knob และ volume fader, toggle mutes, กด spacebar เพื่อ Play/Stop และกด number keys เพื่อกระโดดไปยัง bass root note จัดการ state (cells ที่ active, BPM, volume, mutes, playing status) อย่างสะอาดเพื่อให้ UI และ audio ไม่ drift ออกจาก sync interaction แรกกับหน้าควร unlock/resume AudioContext ด้วย ให้ความสำคัญกับ audio-visual synchronization ที่แน่น, animation 60fps ที่ลื่นไหลของ playhead และ ripples และผลลัพธ์ทางดนตรีที่น่าพอใจจริง ๆ ตั้งแต่เปิดใช้งาน
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
นักพัฒนานำ GLM API ไปใช้งานที่ไหนบ้าง
ตั้งแต่เอเจนต์เขียนโค้ดอัตโนมัติและงานวิจัยระยะยาว ไปจนถึงผลิตภัณฑ์สนทนาและการวิเคราะห์ข้อมูลปริมาณมาก GLM API มอบ endpoint ที่เข้ากันได้กับ OpenAI เพียงจุดเดียวให้นักพัฒนาใช้สร้างซอฟต์แวร์ที่ขับเคลื่อนด้วยเอเจนต์ได้อย่างน่าเชื่อถือ

เอเจนต์เขียนโค้ดอัตโนมัติด้วย GLM API
GLM models ถูกสร้างมาเพื่อการทำงานอัตโนมัติ วางแผน เขียน และปรับปรุงโค้ดในเวิร์กโฟลว์หลายขั้นตอนได้โดยไม่สูญเสียบริบทของโปรเจกต์ ทีมพัฒนาใช้ความสามารถนี้เพื่อขับเคลื่อนบอตรีวิว PR ผู้ช่วยรีแฟกเตอร์โค้ด และ build pipelines

งานวิจัยระยะยาวและการจัดการเวิร์กโฟลว์
การให้เหตุผลหลายขั้นตอนที่เสถียรช่วยให้โมเดลเหล่านี้แยกคำถามวิจัยขนาดใหญ่ออกเป็นส่วนย่อย เรียกใช้เครื่องมือภายนอก และรักษาบริบทตลอดลำดับการทำงานที่พึ่งพากันยาว ๆ เหมาะสำหรับนักวิเคราะห์และทีมผลิตภัณฑ์ที่ต้องการทำงานสังเคราะห์ข้อมูลจากหลายแหล่งและดำเนินการข้ามแพลตฟอร์มแบบอัตโนมัติ

สร้างอินเทอร์เฟซ Front-End ที่ประณีต
GLM models เปลี่ยน mockups คร่าว ๆ และคำอธิบายธรรมดาให้เป็นโค้ดอินเทอร์เฟซที่สะอาด ตอบสนองได้ดี และมีความประณีตด้านภาพสูง ผู้ก่อตั้งเดี่ยวและนักพัฒนาที่ใส่ใจงานออกแบบสามารถส่งมอบต้นแบบที่ใช้งานได้จริงและ UIs สำหรับโปรดักชันได้รวดเร็วยิ่งขึ้นมาก

ผลิตภัณฑ์สนทนาบน GLM API
ต้องการผู้ช่วยที่ให้ความรู้สึกเหมือนมนุษย์หรือไม่? GLM API มอบประสบการณ์การสนทนาที่เป็นธรรมชาติ พร้อมรองรับด้วยการให้เหตุผลที่เสถียร เพื่อขับเคลื่อน chatbots, support copilots และผู้ช่วยในแอปที่ยังคงสอดคล้องตลอดบทสนทนายาว ๆ ที่แตกแขนงหลายทาง

แบ็กเอนด์เรียกใช้เครื่องมือและการรันฟังก์ชัน
เพราะโมเดลเหล่านี้ถูกสร้างมาเพื่อการใช้เครื่องมือ จึงเลือกฟังก์ชัน จัดรูปแบบอาร์กิวเมนต์ และเชื่อมต่อ API calls ภายในระบบแบบ agentic ได้ วิศวกรใช้ความสามารถนี้เพื่อเชื่อม GLM เข้ากับ orchestration layers, RAG pipelines และ multi-agent stacks

ขยายการวิเคราะห์ข้อมูลด้วย GLM API
ใช้ GLM API เพื่อให้เหตุผลกับเอกสาร สเปรดชีต และรายงานขนาดใหญ่ พร้อมดึงข้อมูลเชิงลึกแบบมีโครงสร้างผ่านดีไซน์ Mixture-of-Experts ที่มีประสิทธิภาพ เหมาะสำหรับทีมการเงิน กฎหมาย และปฏิบัติการที่ต้องการการวิเคราะห์ปริมาณมากที่เชื่อถือได้
GLM API เทียบกับ LLM คู่แข่ง: ตารางสเปกและราคา
เปรียบเทียบโมเดล GLM API ทุกตัวกับ text LLM ชั้นนำบน Atlas Cloud ทั้งความยาวบริบท เพดานเอาต์พุต และราคาแบบจ่ายตามการใช้งานที่โปร่งใส
| โมเดล | หน้าต่างบริบท | เอาต์พุตสูงสุด | อินพุต ($/1M tokens) | เอาต์พุต ($/1M tokens) |
|---|---|---|---|---|
| GLM 5.2 | 1M | 128K | $1.40 | $4.40 |
| GLM 5.1 | 203K | 203K | $1.40 | $4.40 |
| GLM 5 | 203K | 203K | $1.00 | $3.20 |
| GLM 4.7 | 203K | 203K | $0.60 | $2.20 |
| DeepSeek V4 Pro | 1M | 384K | $1.74 | $3.45 |
| Kimi K2.7 Code | 256K | 256K | $0.95 | $4.00 |
| MiniMax M3 | 512K | 512K | $0.60 / $1.20 >512K | $2.40 / $4.80 >512K |
วิธีใช้ GLM บน Atlas Cloud
เริ่มต้นได้ในไม่กี่นาที — ทำตามขั้นตอนง่าย ๆ เหล่านี้เพื่อเชื่อมต่อและใช้งานโมเดลผ่านแพลตฟอร์ม Atlas Cloud
สร้างบัญชี Atlas Cloud
สมัครสมาชิกที่ atlascloud.ai และยืนยันตัวตน ผู้ใช้ใหม่จะได้รับเครดิตฟรีเพื่อสำรวจแพลตฟอร์มและทดสอบโมเดล
ทำไมต้องใช้ GLM บน Atlas Cloud
การรวมโมเดล GLM ขั้นสูงเข้ากับแพลตฟอร์มที่เร่งด้วย GPU ของ Atlas Cloud ให้ประสิทธิภาพ ความสามารถในการขยาย และประสบการณ์นักพัฒนาที่ไม่มีใครเทียบได้
ประสิทธิภาพและความยืดหยุ่น
เวลาแฝงต่ำ:
inference ที่ปรับแต่ง GPU เพื่อการตอบสนองแบบเรียลไทม์
API แบบรวมศูนย์:
รัน GLM, GPT, Gemini และ DeepSeek ด้วยการเชื่อมต่อเดียว
ราคาโปร่งใส:
ชำระเงินต่อโทเค็นที่คาดเดาได้พร้อมตัวเลือก serverless
องค์กรและขนาด
ประสบการณ์นักพัฒนา:
SDK, การวิเคราะห์, เครื่องมือปรับแต่ง และเทมเพลต
ความน่าเชื่อถือ:
ความพร้อมใช้งาน 99.99%, RBAC และการบันทึกที่พร้อมสำหรับการปฏิบัติตาม
ความปลอดภัยและการปฏิบัติตาม:
SOC 2 Type II, สอดคล้อง HIPAA, อธิปไตยข้อมูลในสหรัฐอเมริกา
GLM API: คำตอบสำหรับคำถามที่นักพัฒนาพบบ่อย
GLM API ช่วยให้นักพัฒนาเข้าถึงโมเดลภาษาขนาดใหญ่แบบ open-weight ในตระกูล GLM ของ Z.ai (Zhipu AI) ได้ ซึ่งรวมถึง GLM-5.2, GLM-5, GLM-4.7 และ GLM-4.6 โมเดลเหล่านี้ออกแบบมาสำหรับงานเขียนโค้ด การให้เหตุผลหลายขั้นตอน และงานของ autonomous agent บน Atlas Cloud คุณสามารถเข้าถึงทั้งตระกูลผ่าน endpoint เดียวที่เข้ากันได้กับ OpenAI พร้อมราคาแบบจ่ายตามการใช้งาน
Atlas Cloud ให้บริการโมเดล GLM รุ่นปัจจุบัน ซึ่งรวมถึง GLM-5.2, GLM-5.1, GLM-5, GLM-5 Turbo, GLM-5v Turbo, GLM-4.7 และ GLM-4.6 เวอร์ชันเรือธงมุ่งเน้นงาน agentic และงานเขียนโค้ดที่ซับซ้อน ส่วนรุ่น Turbo ให้ความสำคัญกับการตอบสนองที่เร็วขึ้นและ latency ต่ำกว่า การสลับใช้งานระหว่างโมเดลทำได้เพียงเปลี่ยน model identifier ในคำขอของคุณ
สมัครใช้งาน Atlas Cloud สร้าง API key หนึ่งรายการ แล้วชี้ client ที่เข้ากันได้กับ OpenAI ที่คุณมีอยู่ไปยัง endpoint ของเรา เนื่องจาก GLM API ใช้รูปแบบคำขอของ OpenAI การผสานการทำงานส่วนใหญ่จึงต้องเปลี่ยนเพียง base URL และชื่อโมเดลเพื่อเริ่มส่งคำขอ การเข้าถึงเป็นแบบจ่ายตามการใช้งาน พร้อมราคาต่อครั้งที่โปร่งใสและไม่มีค่าสมัครสมาชิก
ราคาเป็นแบบจ่ายตามการใช้งานและคิดค่าบริการตาม token โดยไม่ต้องสมัครสมาชิก GLM-4.7 และ GLM-4.6 เริ่มต้นที่ $0.60 ต่อ input tokens หนึ่งล้าน token และ $2.20 ต่อ output tokens หนึ่งล้าน token, GLM-5 อยู่ที่ $1.00 สำหรับ input และ $3.20 สำหรับ output และ GLM-5.2 อยู่ที่ $1.40 สำหรับ input และ $4.40 สำหรับ output ส่วน cached input จะคิดในอัตราที่ต่ำกว่า ซึ่งช่วยลดค่าใช้จ่ายเมื่อใช้ context ซ้ำ
โมเดล GLM บน Atlas Cloud มี context window ขนาดใหญ่ประมาณ 200K tokens โดยเวอร์ชันเรือธงสามารถให้ output สูงสุดได้ราว 131K tokens ความจุระดับนี้เพียงพอสำหรับโหลดทั้ง repository เอกสารยาว หรือประวัติการทำงานของ agent ที่ต่อเนื่องยาวนานภายในคำขอเดียว ในตระกูล GLM ยังมีรุ่นที่รองรับ context ยาวกว่า ดังนั้นโปรดตรวจสอบหน้าของแต่ละโมเดลเพื่อดูขีดจำกัดที่แน่นอน
รองรับ โมเดล GLM รองรับ tool calling และ function calling รวมถึง structured JSON output ทำให้สามารถนำไปใช้ใน agentic pipeline และระบบ production ที่ต้องการคำตอบแบบ machine-readable ได้โดยตรง เมื่อใช้ร่วมกับรูปแบบที่เข้ากันได้กับ OpenAI แล้ว GLM API จึงเชื่อมต่อเข้ากับ workflow การใช้เครื่องมือที่มีอยู่ได้อย่างง่ายดาย
โมเดลเหล่านี้สร้างขึ้นสำหรับงานเขียนโปรแกรม การให้เหตุผลระยะยาว และการทำงานของ autonomous agent กรณีใช้งานทั่วไป ได้แก่ การวิเคราะห์โค้ดทั้ง repository การทำต้นแบบ full-stack และการวิจัยหลายขั้นตอนหรือ workflow automation ซีรีส์เรือธง GLM-5 รองรับงาน agentic ที่ท้าทายที่สุด ส่วน GLM-4.6 ให้สมดุลที่ดีระหว่างความเร็วและความสามารถสำหรับงานประจำวัน
โมเดลเรือธงของ GLM ถูกวางตำแหน่งให้เป็นทางเลือกแบบ open-weight ที่แข่งขันได้กับโมเดล closed-source ชั้นนำใน benchmark ด้านการเขียนโค้ดและงาน agentic จุดเด่นในทางปฏิบัติหลักคือค่าใช้จ่าย เพราะราคาต่อ token อยู่เพียงบางส่วนของโมเดล proprietary ที่เทียบเคียงกันได้ ขณะที่ประสิทธิภาพด้านการเขียนโปรแกรมยังแข็งแกร่ง สำหรับทีมที่ต้องชั่งน้ำหนักระหว่างงบประมาณกับคุณภาพ GLM มอบความสามารถระดับ frontier ในอัตราที่ต่ำกว่า
ได้ Atlas Cloud ให้บริการโมเดล GLM ผ่าน endpoint ที่เข้ากันได้กับ OpenAI ดังนั้น framework หรือ SDK ใดก็ตามที่รองรับ custom base URL และชื่อโมเดลก็สามารถเรียกใช้ได้โดยแทบไม่ต้องปรับแก้ วิธีนี้ช่วยให้คุณนำ GLM ไปใช้กับ tool-calling agents, coding assistants และ multi-step orchestration pipelines ที่คุณใช้งานอยู่แล้วได้ เริ่มสร้างได้วันนี้
ใช่ ซีรีส์ GLM เผยแพร่โดย Z.ai (Zhipu AI) ในรูปแบบโมเดล open-weight ภายใต้สัญญาอนุญาตแบบเปิดกว้าง จึงได้รับการยอมรับอย่างแพร่หลายว่าเป็นหนึ่งในตัวเลือก open-source ชั้นนำ บน Atlas Cloud คุณจะได้รับการเข้าถึงโมเดลเหล่านี้แบบ managed และพร้อมใช้งานใน production โดยไม่ต้องโฮสต์หรือดูแลโครงสร้างพื้นฐานเอง
สำรวจกลุ่มเพิ่มเติม
Kling 4.0
Kling V4 ซึ่งพัฒนาโดย Kuaishou เป็นโมเดลวิดีโอ 4K HDR ที่สร้างขึ้นสำหรับการผลิตระดับมืออาชีพ ผสมผสานการเคลื่อนไหวที่ซับซ้อนและเสถียรเข้ากับรูปแบบอัลตราไวด์ 21:9 และการแก้ไขที่ตรงจุดสำหรับสีหน้า มุมกล้อง พื้นหลัง สไตล์ภาพ และบทสนทนา Atlas Cloud ให้บริการนี้ผ่านคีย์ที่เข้ากันได้กับ OpenAI พร้อมโครงสร้างราคาแบบจ่ายตามการใช้งาน (pay-as-you-go) ที่โปร่งใส เริ่มต้นสร้างสรรค์ได้แล้ววันนี้

Seedance 2.5
Seedance 2.5 API พร้อมใช้งานแล้วบน Atlas Cloud! มอบโมเดลวิดีโอใหม่ล่าสุดของ ByteDance ให้กับนักพัฒนา สร้างวิดีโอเนทีฟได้นานถึง 30 วินาทีในการประมวลผลเพียงครั้งเดียวจากข้อความ รูปภาพเดียว หรือการอ้างอิงหลายรูปแบบสูงสุด 50 รายการ พร้อมเสียงที่ซิงโครไนซ์และข้อความหลายภาษาในเฟรม บน Atlas Cloud คุณสามารถเข้าถึงได้ผ่านคีย์เดียว โดยมีความสอดคล้องของวัตถุและระบบฟิสิกส์ที่ได้รับการปรับปรุงซึ่งช่วยให้ภาพระยะยาวมีความต่อเนื่อง
Wan 3.0
Wan 3.0 API คือเจเนอเรชันถัดไปของตระกูลวิดีโอ Wan จาก Alibaba ซึ่งสร้างขึ้นเพื่อยกระดับการสร้างวิดีโอแบบยาว การควบคุมแบบหลายข้อมูลอ้างอิง และคุณภาพของภาพและเสียงให้ก้าวไปอีกขั้น Atlas Cloud ได้โฮสต์ Wan 2.7, 2.6 และ 2.5 ไว้แล้ว และ Wan 3.0 สามารถทำงานบนคีย์แบบรวมเดียวกันโดยไม่ต้องตั้งค่าแยกต่างหาก เริ่มต้นสร้างสรรค์ได้ตั้งแต่วันนี้ เลื่อนลงไปที่ส่วนจัดแสดงเพื่อดูว่า Wan 3.0 สามารถสร้างอะไรได้บ้าง
MiniMax H3
MiniMax H3 คือผลิตภัณฑ์วิดีโอแบบมัลติโมดัลของ MiniMax สำหรับการสร้างสรรค์โดยใช้ข้อความ รูปภาพ และข้อมูลอ้างอิง ในเส้นทาง API ที่รองรับ ระบบจะคงลักษณะของวัตถุจากสื่ออ้างอิงไว้ มีอัตราส่วนภาพที่ยืดหยุ่น และจับคู่เสียงที่สร้างขึ้นกับภาพผ่าน H3 Developer โดยโปรไฟล์เอาต์พุตจะถูกเลือกตาม endpoint Atlas Cloud รวมผลิตภัณฑ์ในตระกูลนี้ไว้เบื้องหลังคีย์เดียวที่รองรับ OpenAI พร้อมการคิดค่าบริการตามการใช้งานอย่างโปร่งใส เริ่มต้นที่อัตรามาตรฐาน $0.038 ต่อวินาที เริ่มพัฒนาได้วันนี้
GPT Image 2.5
ตระกูล gpt-image-2.5 จาก OpenAI มอบทางเลือก Flare และ Sunburst ให้แก่นักพัฒนาสำหรับกระบวนการทำงานด้านการสร้างภาพเพื่อใช้งานจริง เรนเดอร์ด้วยความละเอียดตามต้องการสูงสุด 3840x2160 และเลือกได้จากระดับคุณภาพ 5 ระดับ รวมถึง xhigh และ max เพื่อให้ตรงตามข้อกำหนดของเอาต์พุตแต่ละแบบ Atlas Cloud ให้บริการอนุมานผ่าน REST ที่พร้อมใช้งาน โดยไม่มี cold start และคิดค่าบริการตามมาตรฐานเริ่มต้นที่ $0.004 ต่อการสร้างภาพ เริ่มพัฒนาได้วันนี้
Seedream 5.0 Pro
Seedream 5.0 Pro API มอบโมเดลการแก้ไขภาพที่ควบคุมได้ของ ByteDance บน Atlas Cloud ให้กับนักพัฒนา โดยจะวางการแก้ไขอย่างแม่นยำด้วยจุดยึดและพิกัด แยกภาพออกเป็นเลเยอร์ที่แก้ไขได้ ผสานข้อมูลอ้างอิงหลายรายการ และจับคู่สีและวัสดุที่แน่นอน พร้อมข้อความหลายภาษาที่ความละเอียด 2K และ 3K บน Atlas Cloud คุณสามารถเข้าถึงได้ผ่านคีย์เดียว!
Seedance 2.0
Seedance 2.0 คือโมเดลวิดีโอสำหรับการใช้งานจริงของ ByteDance ที่ออกแบบมาเพื่อสร้างช็อตได้อย่างแม่นยำ เปลี่ยนพรอมป์ต์เป็นวิดีโอ ทำให้ภาพเฟรมแรกเคลื่อนไหวโดยมีตัวเลือกให้ใช้คำแนะนำจากเฟรมสุดท้าย หรือปรับแต่งผลลัพธ์ด้วยสื่ออ้างอิงและการค้นหาเว็บแบบเลือกใช้ได้ Atlas Cloud รวมเวิร์กโฟลว์เหล่านี้ไว้ใน API เดียว พร้อมการคิดค่าบริการตามการใช้งานจริงอย่างโปร่งใสและคีย์เดียวที่เข้ากันได้กับ OpenAI เริ่มสร้างสรรค์ได้วันนี้
Kling V3.0
Kling V3 API family จาก Kuaishou รองรับเวิร์กโฟลว์ทั้งข้อความ รูปภาพ และวิดีโออ้างอิง ถ่ายทอดการเคลื่อนไหวโดยคงเอกลักษณ์ของตัวละครไว้ ใช้ภาพอ้างอิงเพื่อกำกับการสร้าง และตัดต่อวิดีโอด้วยคำสั่งภาษาธรรมชาติ Atlas Cloud มี endpoint แบบ Standard และ Pro สำหรับความต้องการในการผลิตที่แตกต่างกัน เริ่มสร้างสรรค์ด้วย Kling 3.0 อยู่แล้วใช่ไหม? ตอนนี้ Kling V4 พร้อมใช้งานบน Atlas Cloud แล้ว สำรวจได้ที่หน้ารวมโมเดล [Kling V4](https://www.atlascloud.ai/models/kling-v4)
Grok Imagine Video
Grok Imagine Video เปิดให้นักพัฒนาเข้าถึงตระกูลวิดีโอของ xAI เพื่อสร้าง ทำให้เคลื่อนไหว ขยาย และตัดต่อคลิป สร้างวิดีโอความยาว 1 ถึง 15 วินาทีจากพรอมต์ กำกับบุคคล วัตถุ หรือสไตล์ด้วยภาพอ้างอิงได้สูงสุดเจ็ดภาพ และทำงานที่ความละเอียด 480p หรือ 720p Atlas Cloud รวมความสามารถเหล่านี้ไว้ผ่าน endpoint ที่เข้ากันได้กับ OpenAI พร้อมการคิดค่าบริการแบบจ่ายตามการใช้งานอย่างโปร่งใส เริ่มสร้างสรรค์ได้วันนี้
Vidu Q4 Preview
Vidu Q4 คือโมเดลวิดีโอเรือธงรุ่นล่าสุดของ Vidu ออกแบบมาสำหรับการสร้างวิดีโอจากภาพและจากภาพอ้างอิง สามารถทำให้ภาพนิ่งภาพเดียวมีชีวิตขึ้นมาและสร้างการเปลี่ยนฉากโดยอัตโนมัติ ช่วยให้นักพัฒนามีช่องทางป้อนข้อมูล 2 รูปแบบสำหรับเวิร์กโฟลว์ผลิตภัณฑ์ที่แตกต่างกัน Atlas Cloud มี API endpoints เฉพาะ พร้อมสคีมาพารามิเตอร์ที่เผยแพร่ไว้ ในราคามาตรฐานที่ยืนยันแล้วที่ $0.04 ต่อวินาที เริ่มสร้างสรรค์ได้วันนี้
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash เป็นตระกูลวิดีโอแบบมัลติโมดัลโดยกำเนิดของ Google DeepMind สำหรับเวิร์กโฟลว์การผลิตที่ยืดหยุ่น แก้ไขฟุตเทจที่มีอยู่ด้วยคำสั่งข้อความ รักษาความสอดคล้องทางภาพด้วยภาพอ้างอิงสูงสุด 10 ภาพและคลิปวิดีโอ 3 คลิป หรือขยายช็อตเป็นช่วงที่ต่อเนื่องกันได้สูงสุด 40 วินาที เข้าถึงทุกเวิร์กโฟลว์บน Atlas Cloud ด้วยคีย์ API ที่เข้ากันได้กับ OpenAI เพียงคีย์เดียว ราคาตามการใช้งาน และพร้อมให้บริการตั้งแต่ Day-0 เริ่มสร้างสรรค์ได้วันนี้
Nano Banana 2.1
Nano Banana 2.1 คือกลุ่มโมเดลภาพของ Google ที่สร้างขึ้นบน Gemini 3.6 Flash ให้ความสามารถในการสร้างและแก้ไขภาพระดับ Pro ด้วยความเร็วระดับ Flash รองรับการแก้ไขและผสานภาพด้วยภาษาธรรมชาติจากภาพอินพุต 1 ถึง 14 ภาพ พร้อมรักษาความสอดคล้องของตัวละครสูงสุด 4 ตัวและวัตถุ 10 รายการ ผ่าน Atlas Cloud นักพัฒนาสามารถเข้าถึงกลุ่มโมเดลนี้ด้วยคีย์เดียวที่รองรับ OpenAI พร้อมความเสถียรในการให้บริการและพร้อมใช้งานตั้งแต่ Day-0 เริ่มสร้างสรรค์ได้ตั้งแต่วันนี้
บทความแนะนำ
คู่มือ บทแนะนำ และอัปเดตผลิตภัณฑ์ ที่ช่วยให้คุณใช้ Atlas Cloud ได้อย่างเต็มประสิทธิภาพ





