
 Atlas Cloud เป็นผู้ขายต่อที่ได้รับอนุญาตในสหรัฐฯ ของ Dreamina Seedance 2.5 และ Seedream 5.0 Pro แล้วAtlas Cloud เป็นผู้ขายต่อที่ได้รับอนุญาตในสหรัฐฯ ของ Dreamina Seedance 2.5 และ Seedream 5.0 Pro แล้ว
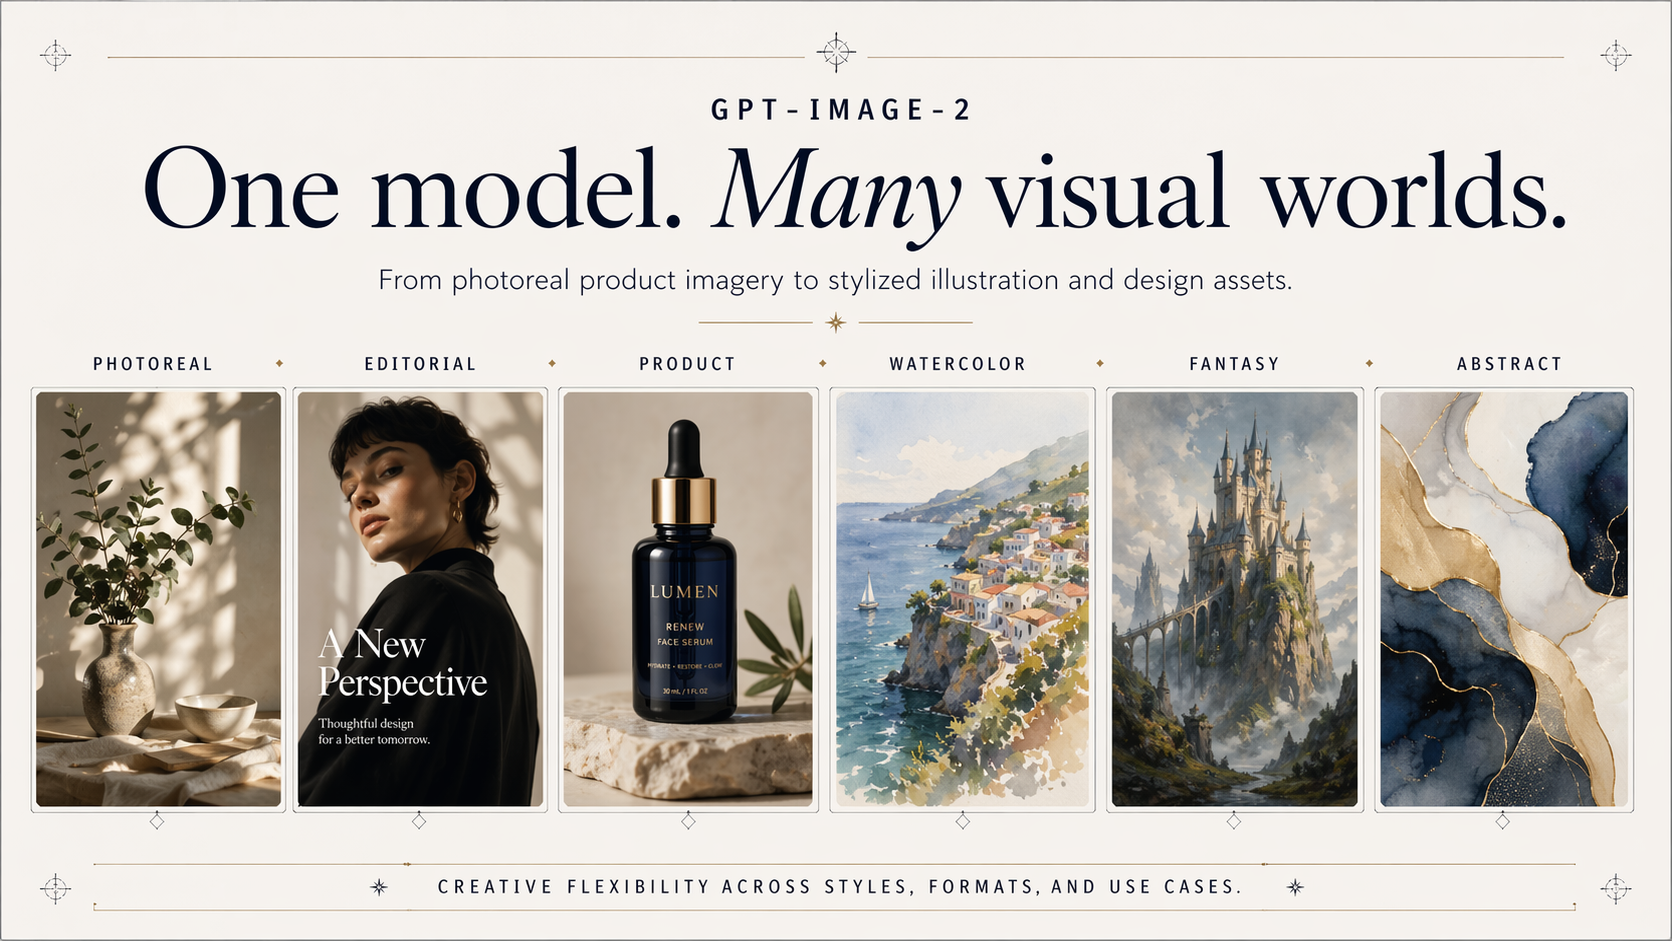
GPT Image 2 API ช่วยให้นักพัฒนาสามารถเข้าถึงโมเดลรูปภาพล่าสุดของ OpenAI ซึ่งเป็นรุ่นสืบทอดจาก GPT Image 1.5 โดยสามารถสร้างและแก้ไขรูปภาพพร้อมกับการเรนเดอร์ข้อความที่แม่นยำทั้งในอักษรละตินและ CJK รวมถึงการจัดวางองค์ประกอบที่ยอดเยี่ยมสำหรับโปสเตอร์ ม็อกอัป และอินโฟกราฟิก บน Atlas Cloud คุณสามารถเข้าถึงโมเดลนี้ผ่าน API ที่เป็นหนึ่งเดียวร่วมกับโมเดลอื่นๆ อีกกว่า 300 รุ่น พร้อมเครดิตฟรี เวลาทำงาน 99.99% และไม่จำเป็นต้องมีการตรวจสอบยืนยันองค์กรจาก OpenAI
GPT Image 2 พัฒนาโดย OpenAI โดย Atlas Cloud (ดำเนินการโดย Atlas Cloud AI LLC) เป็นผู้ให้บริการเข้าถึงโมเดลนี้ แต่ไม่ได้เป็นเจ้าของโมเดล เครื่องหมายการค้าทั้งหมดเป็นของเจ้าของที่เกี่ยวข้อง
Atlas Cloud มอบโมเดลสร้างสรรค์ล่าสุดที่นำหน้าในอุตสาหกรรมให้กับคุณ
เปรียบเทียบปลายทาง API ของ GPT Image 2 ในทั้งตระกูลผลิตภัณฑ์ ซึ่งมีฟีเจอร์แปลงข้อความเป็นรูปภาพและการแก้ไขสำหรับ GPT Image 2, 1.5, 1 และ Mini เพื่อให้คุณสามารถจับคู่ต้นทุนและคุณภาพให้เหมาะสมกับแต่ละงานได้ผ่านการรวมระบบเพียงครั้งเดียว
| รูปแบบ | คำอธิบาย |
|---|---|
| GPT Image 2 T2I API (Text to Image) | เปลี่ยนพรอมต์ให้เป็นรูปภาพที่เสร็จสมบูรณ์ด้วย Text to Image API ของ GPT Image 2 ซึ่งสามารถเรนเดอร์ข้อความในรูปภาพได้อย่างแม่นยำทั้งในอักษรละตินและ CJK โดยสามารถทำตามพรอมต์ที่ยาวและมีหลายส่วนได้อย่างแม่นยำ และสร้างรายละเอียดที่สมจริงระดับภาพถ่ายสำหรับงานภาพทางการตลาด UI และงานบทบรรณาธิการ |
| GPT Image 2 Edit API (Image to Image) | GPT Image 2 Edit API ช่วยปรับแต่งรูปภาพที่มีอยู่จากภาษาธรรมชาติ โดยใช้การวาดภาพซ่อมแซม (Inpainting) และการวาดภาพต่อขยาย (Outpainting) แบบอิงมาสก์เพื่อเปลี่ยนเฉพาะพื้นที่ที่คุณต้องการ นอกจากนี้ยังรวมภาพอ้างอิงหลายภาพไว้ในฉากเดียวโดยที่ส่วนที่เหลือยังคงสภาพเดิม เพื่อการแก้ไขที่แม่นยำและนำกลับมาใช้ใหม่ได้ |
สำรวจความสามารถของ GPT Image 2 API ตั้งแต่ข้อความในรูปภาพที่แม่นยำในอักษรละตินและ CJK ไปจนถึงการเรนเดอร์ที่สมจริงราวกับภาพถ่าย การแก้ไขโดยใช้มาสก์ และการจัดองค์ประกอบภาพแบบหลายข้อมูลอ้างอิง
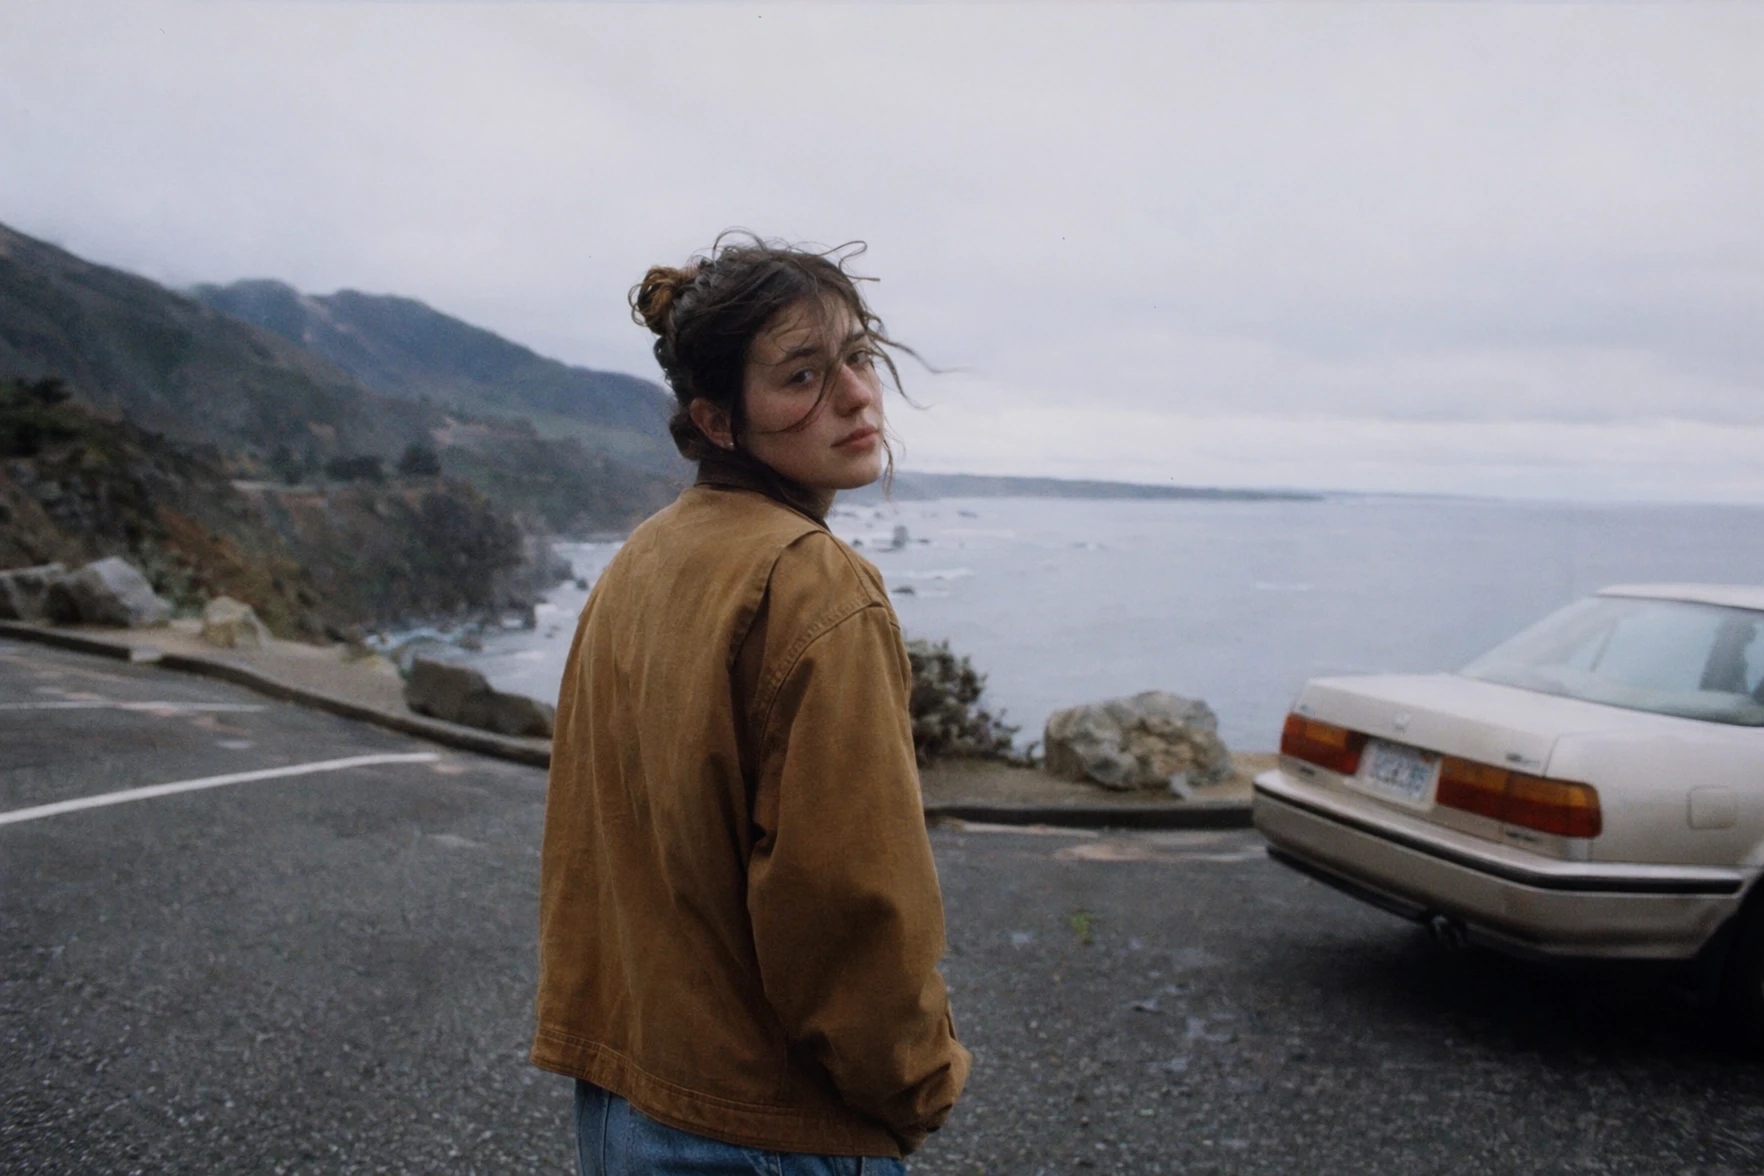
GPT Image 2 มอบผลลัพธ์ที่สมจริงราวกับภาพถ่ายในงานกราฟิกการตลาด ภาพผลิตภัณฑ์ เนื้อหาโซเชียล และม็อคอัพ ซึ่งความแม่นยำมีความสำคัญพอๆ กับคุณภาพของภาพถ่าย แสดงให้เห็นถึงความเข้าใจอย่างแท้จริงเกี่ยวกับฟิสิกส์ การจัดแสง และคุณสมบัติของวัสดุ พร้อมให้สีที่เป็นกลางและแม่นยำในฉากทุกประเภท
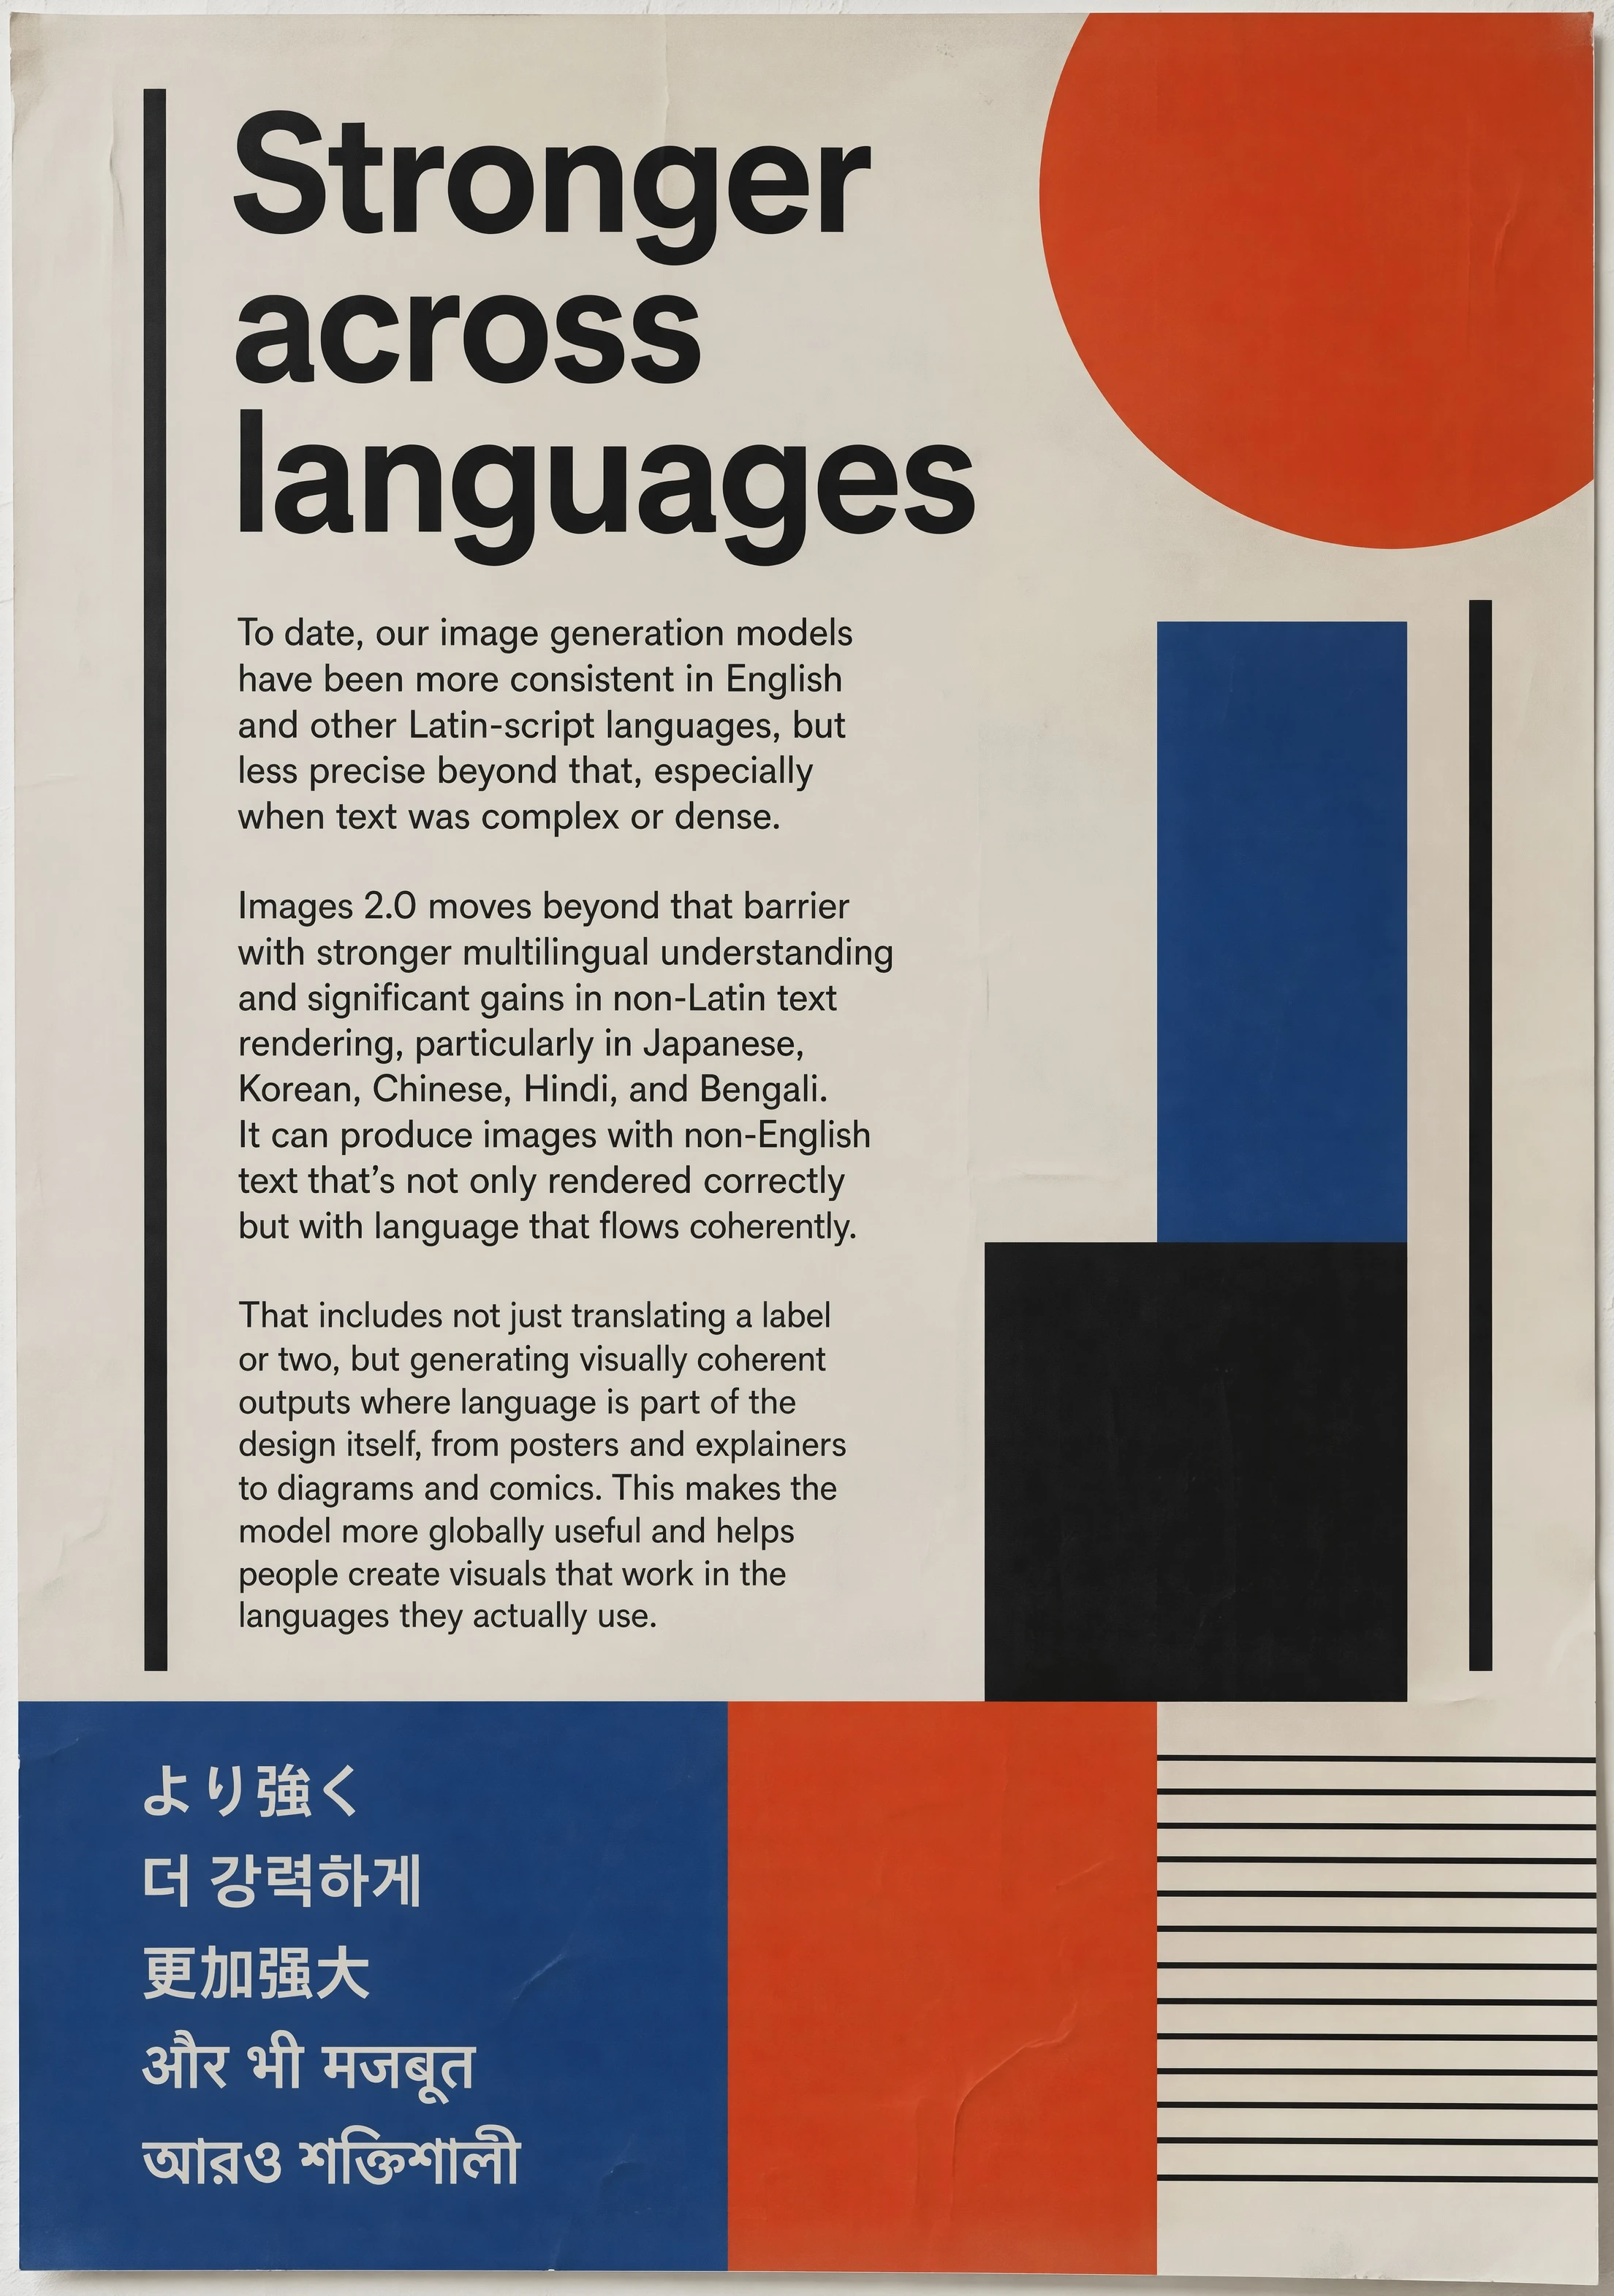
GPT Image 2 เรนเดอร์ข้อความที่สะกดอย่างถูกต้องและจัดวางอย่างเป็นธรรมชาติภายในรูปภาพ ตั้งแต่ป้ายและฉลาก UI ไปจนถึงโปสเตอร์ โดยสามารถสร้างกราฟิกการตลาด ชิ้นงานโฆษณา และส่วนหัวของอีเมลที่มีข้อความถูกต้องในสเกลขนาดใหญ่ได้อย่างน่าเชื่อถือ
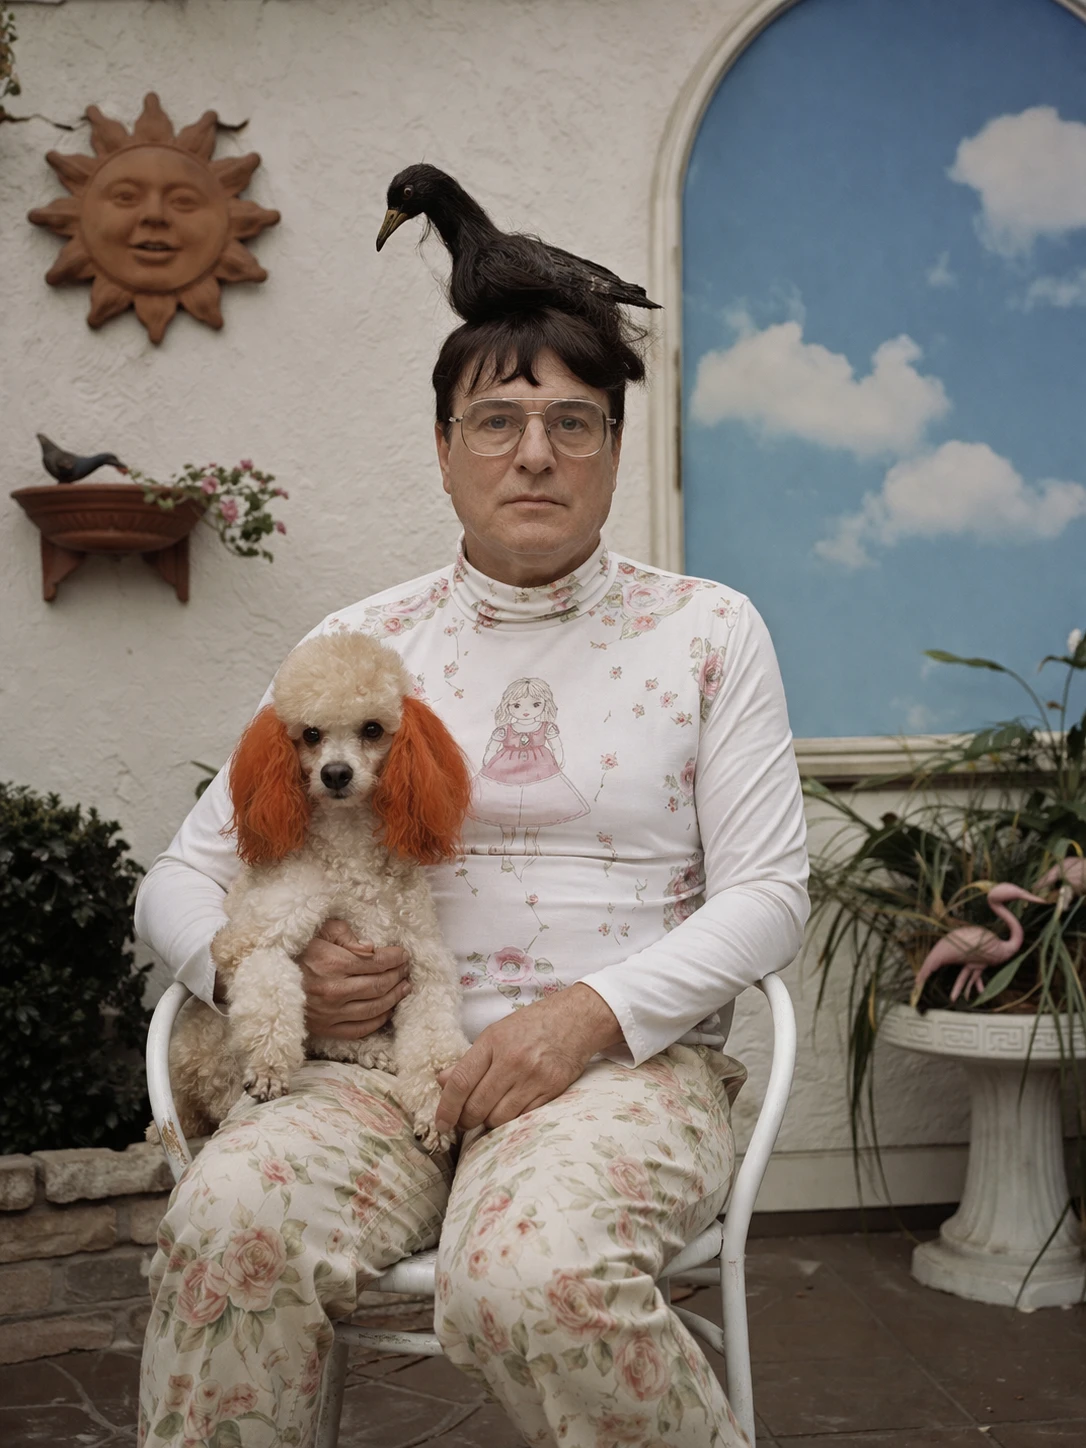
GPT Image 2 จัดการกับฉากที่มีวัตถุหลายชิ้นที่ซับซ้อนโดยไม่มีข้อผิดพลาดเรื่องการบดบังและการจัดวางเหมือนในรุ่นก่อนหน้า โดยสามารถทำตามคำสั่ง (prompt) ที่ยาวและมีหลายส่วนได้อย่างแม่นยำ พร้อมกับรักษาองค์ประกอบภาพ แสง และรายละเอียดเล็กๆ น้อยๆ ไว้ได้
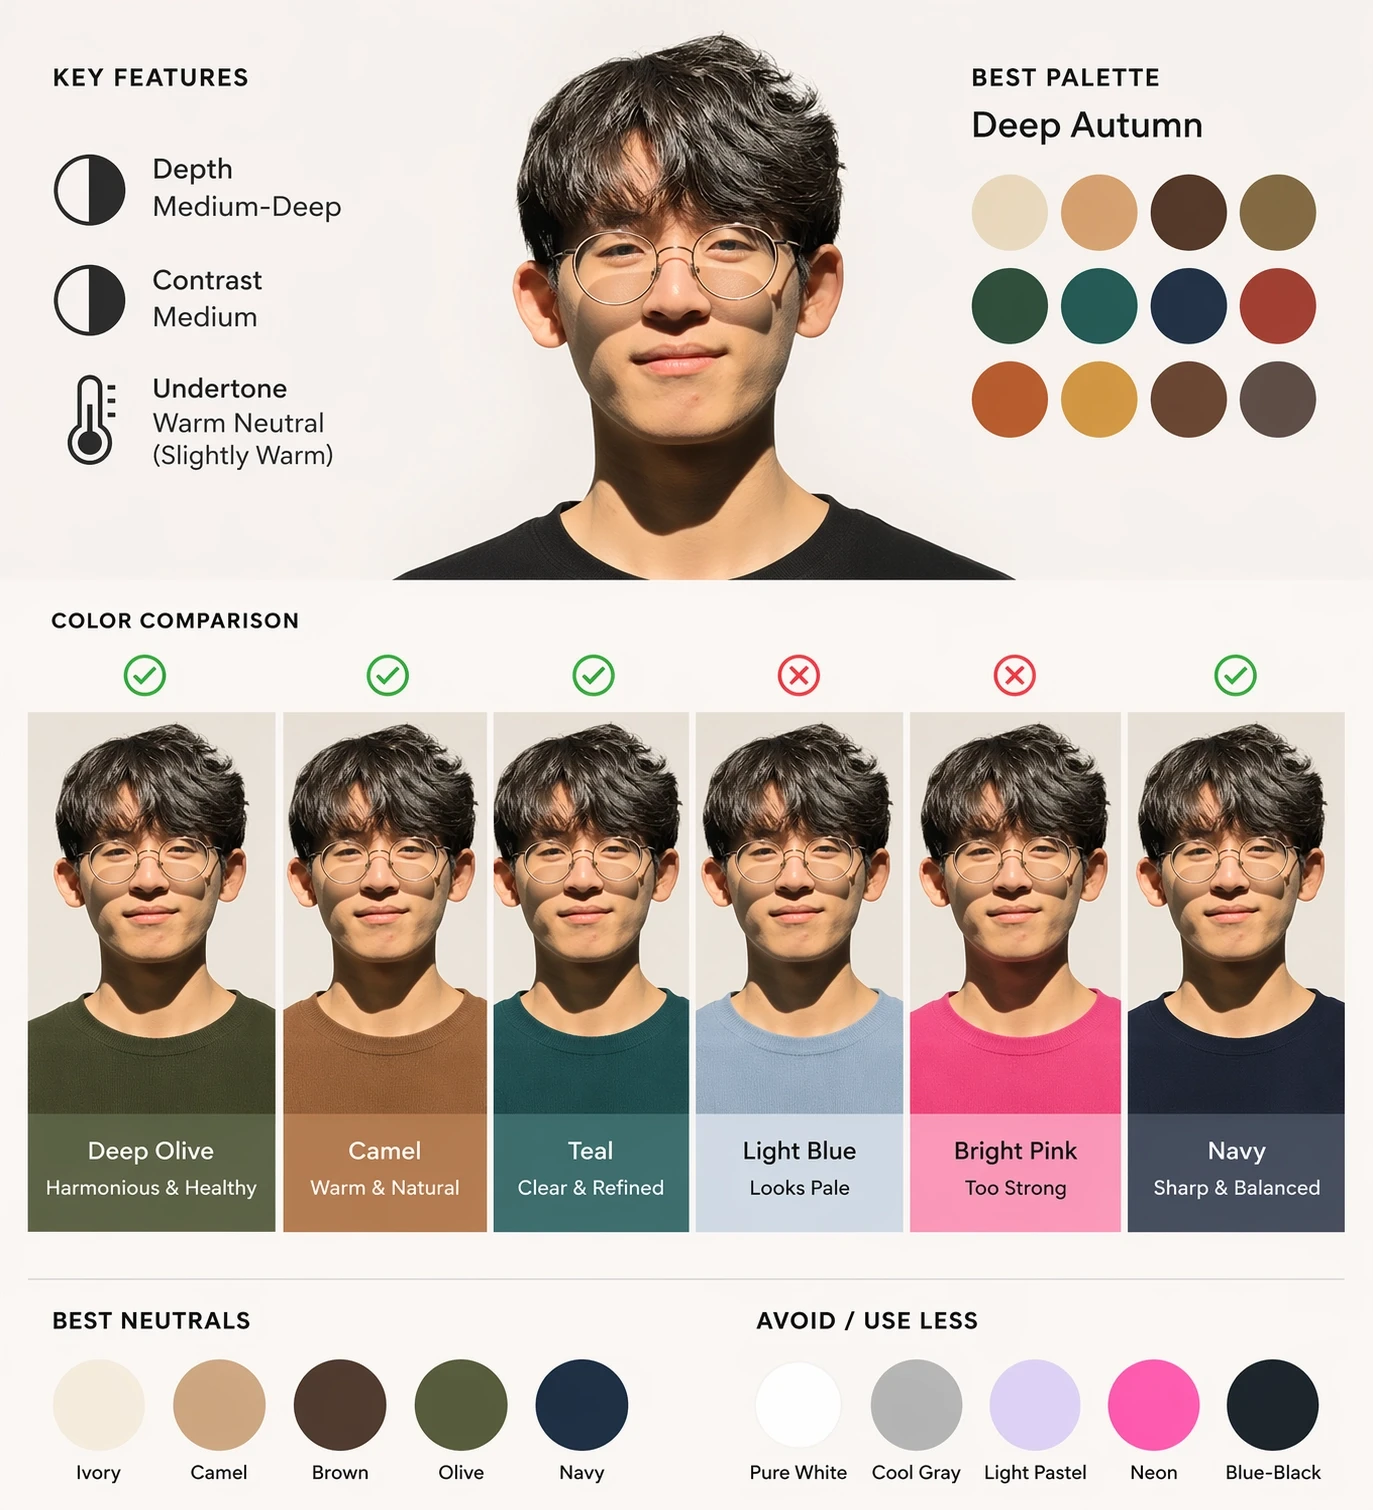
GPT Image 2 รักษาความสอดคล้องของเอกลักษณ์ตัวละคร อุปกรณ์ประกอบฉาก และการจัดแสงจากการสร้างภาพหลายครั้ง ความสอดคล้องของตัวแบบนี้ยังคงอยู่แม้ในการจัดวางองค์ประกอบภาพที่มีหลายส่วน ทำให้มีความน่าเชื่อถือสำหรับการจัดชุดภาพแบบแยกย่อยและงานซีรีส์
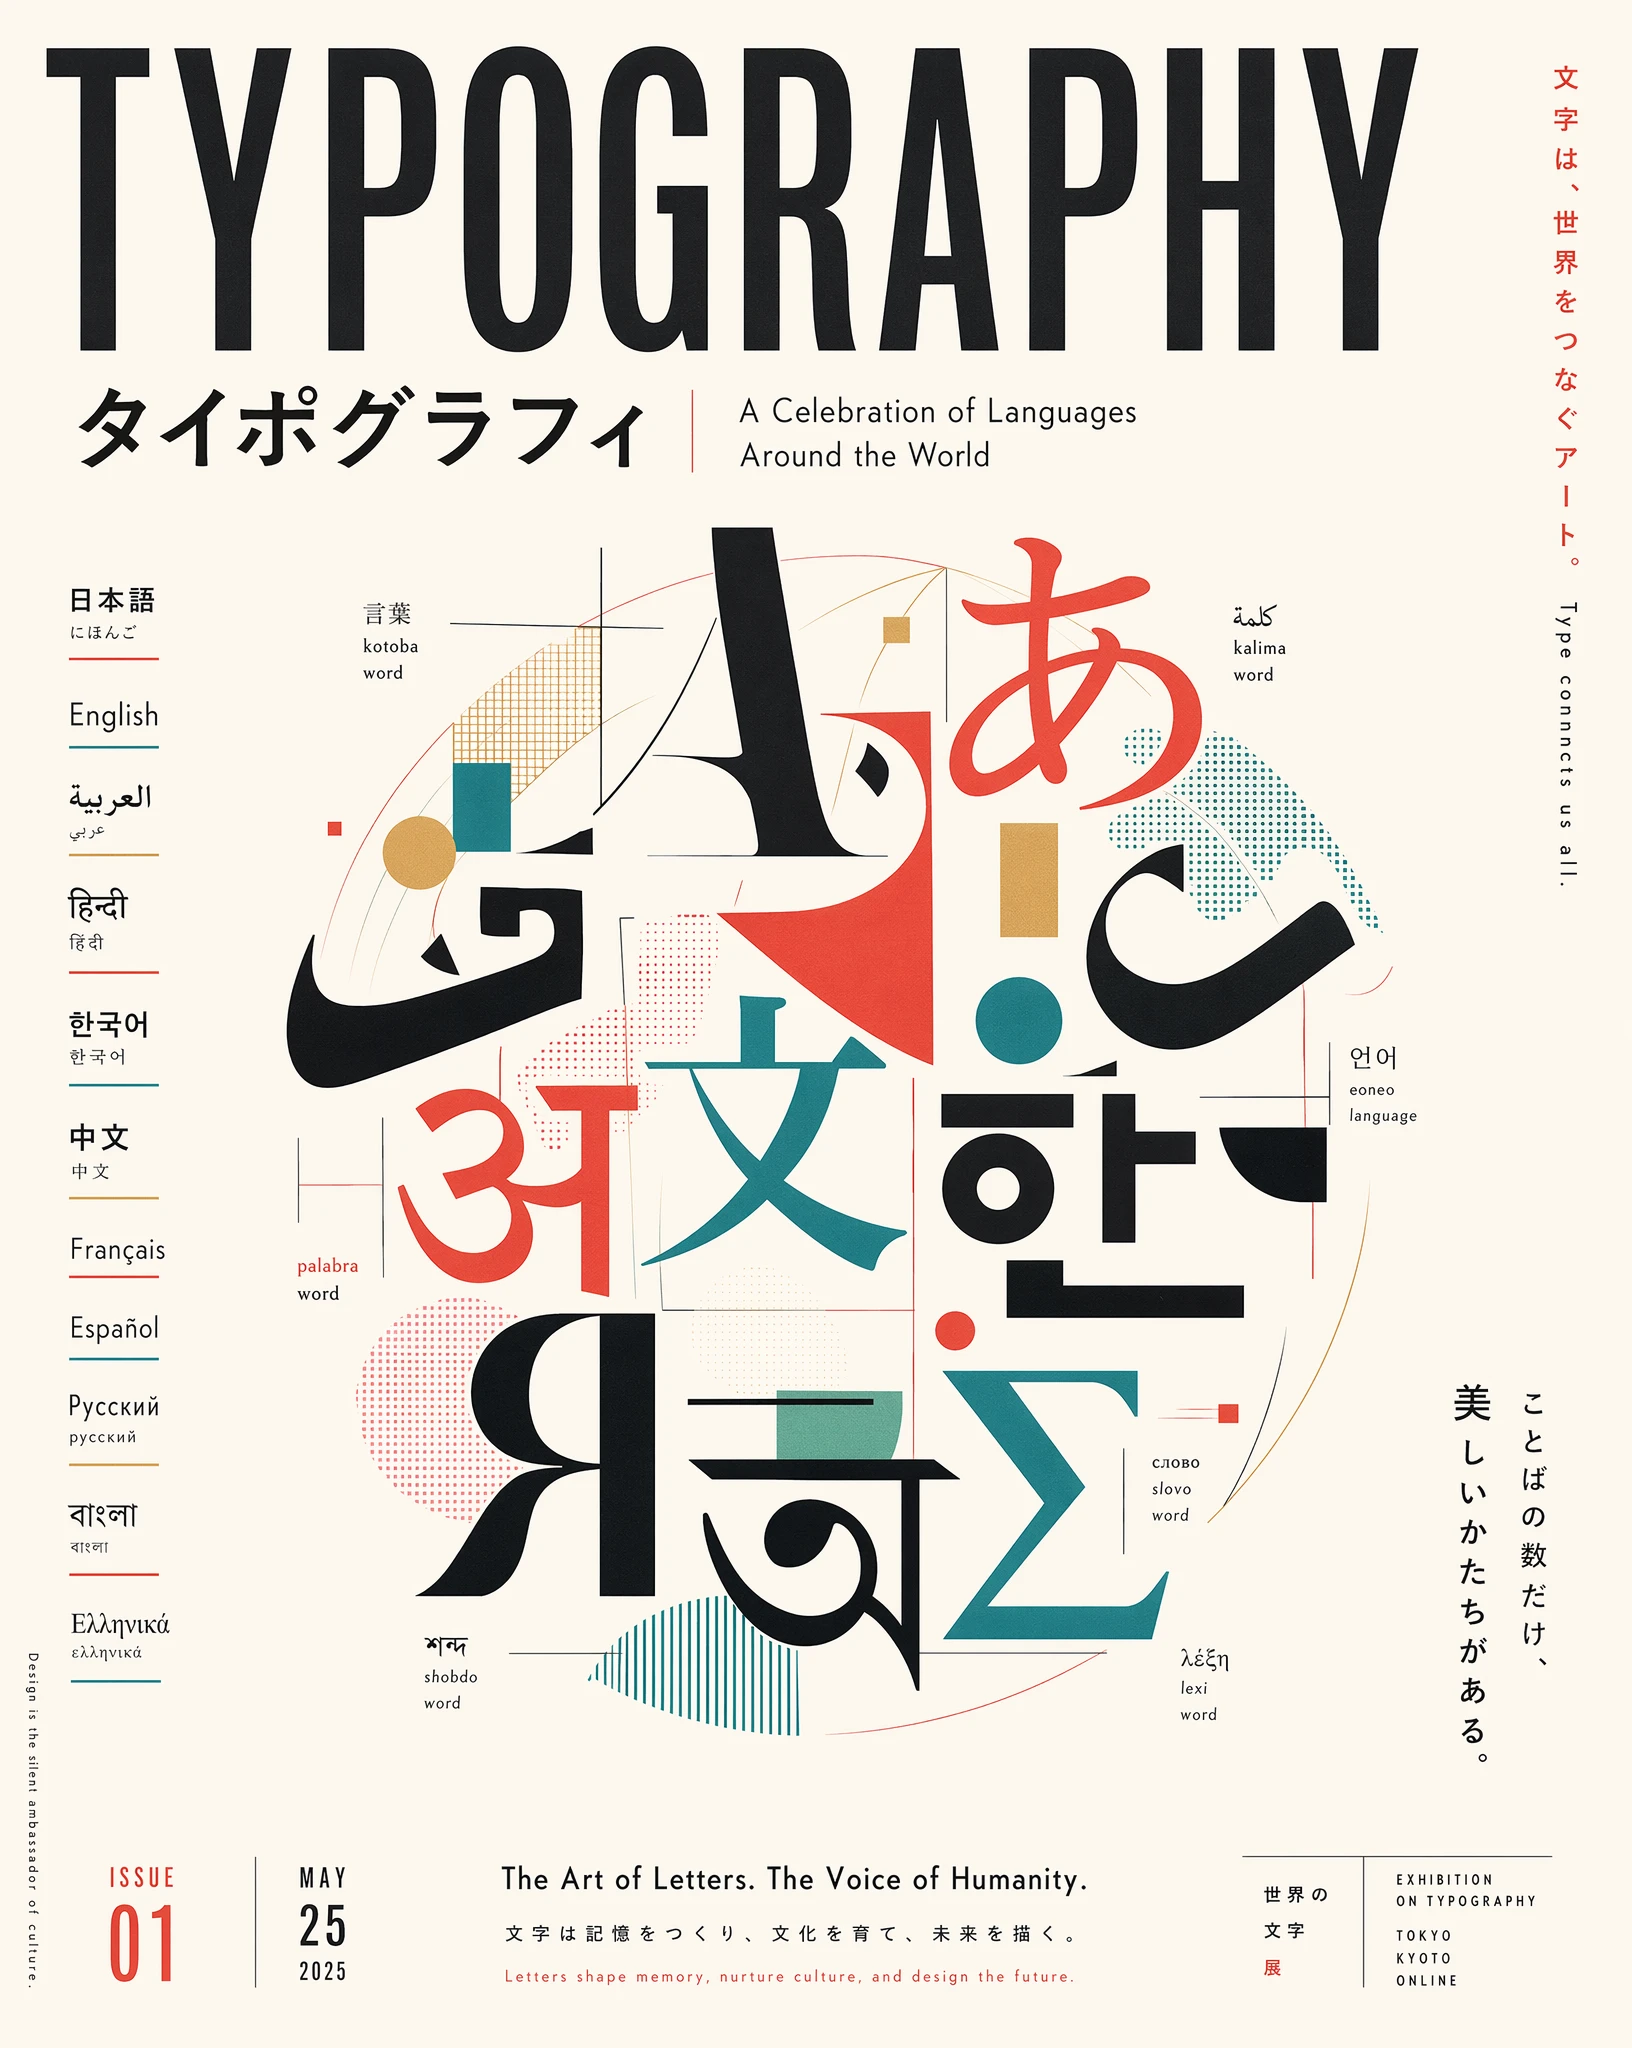
GPT Image 2 เรนเดอร์อักขระ CJK ด้วยรูปอักขระที่แม่นยำและลายเส้นที่ชัดเจน ซึ่งเป็นการพัฒนาที่ชัดเจนจากจุดอ่อนของรุ่นก่อนหน้าในการเขียนตัวอักษรที่ไม่ใช่ภาษาละติน รองรับการเรนเดอร์ข้อความที่มีประสิทธิภาพทั้งในภาษาละตินและภาษา CJK
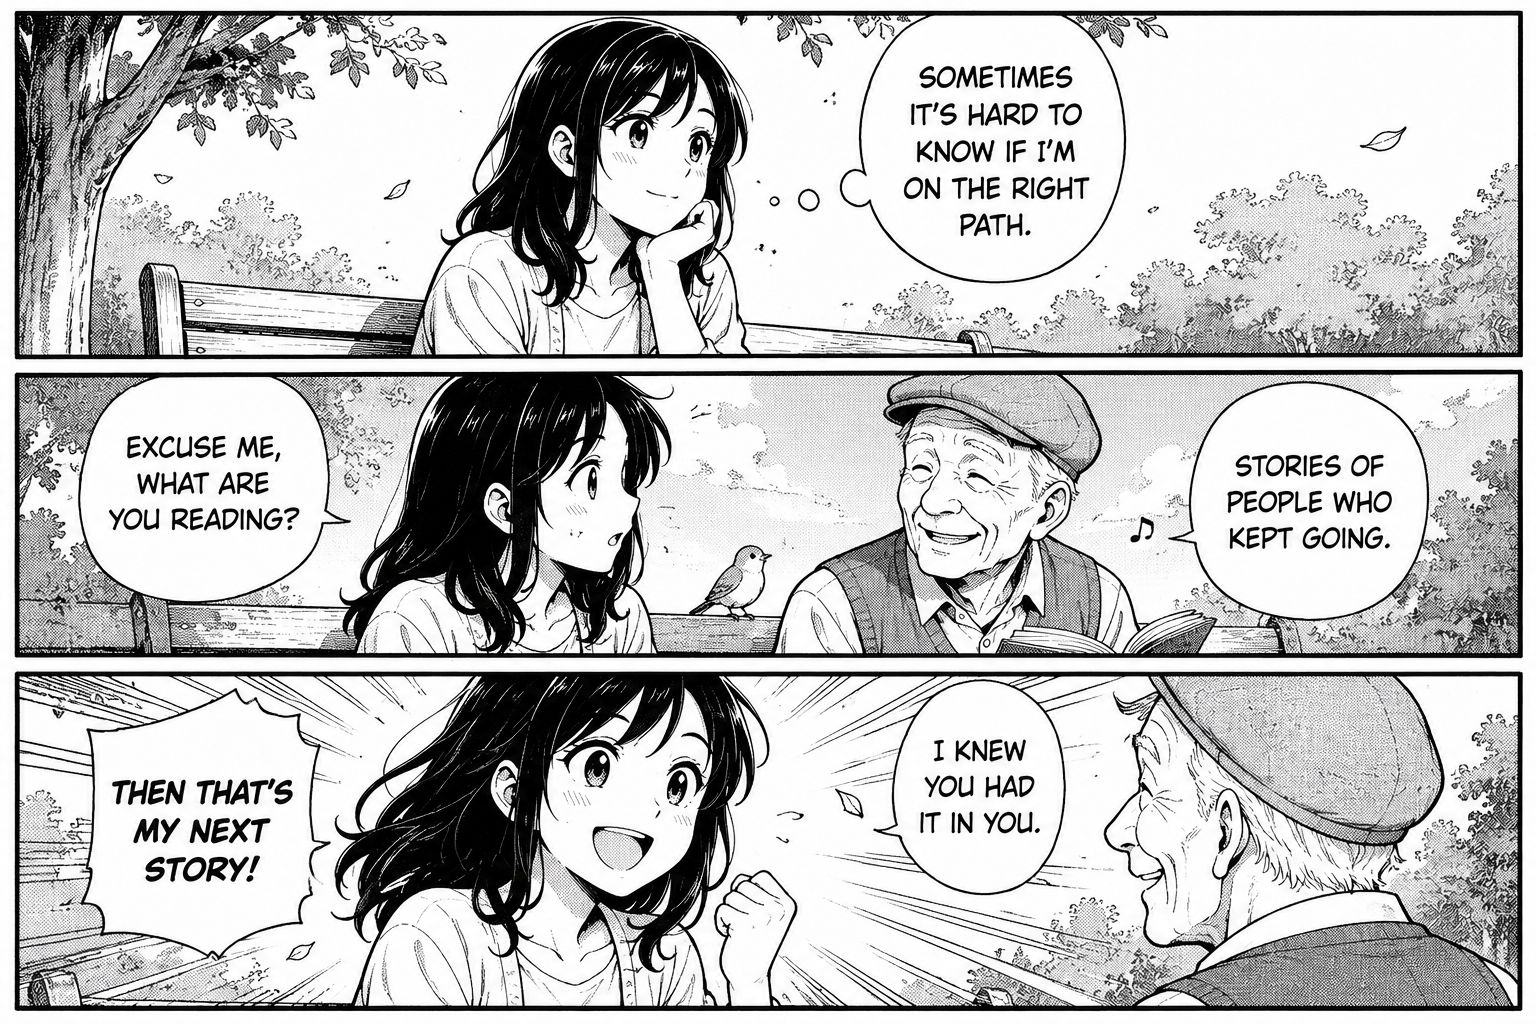
Edit API รองรับการทำ inpainting และ outpainting ที่แม่นยำผ่านภาพมาสก์ เพื่อให้คุณสามารถปรับเปลี่ยนพื้นที่เฉพาะในขณะที่ทุกพิกเซลที่ไม่เกี่ยวข้องยังคงอยู่เหมือนเดิม สิ่งนี้ทำให้ GPT Image 2 API มีความน่าเชื่อถือสำหรับการรีทัช การลบวัตถุ และการทำความสะอาดองค์ประกอบภาพที่มีการควบคุม
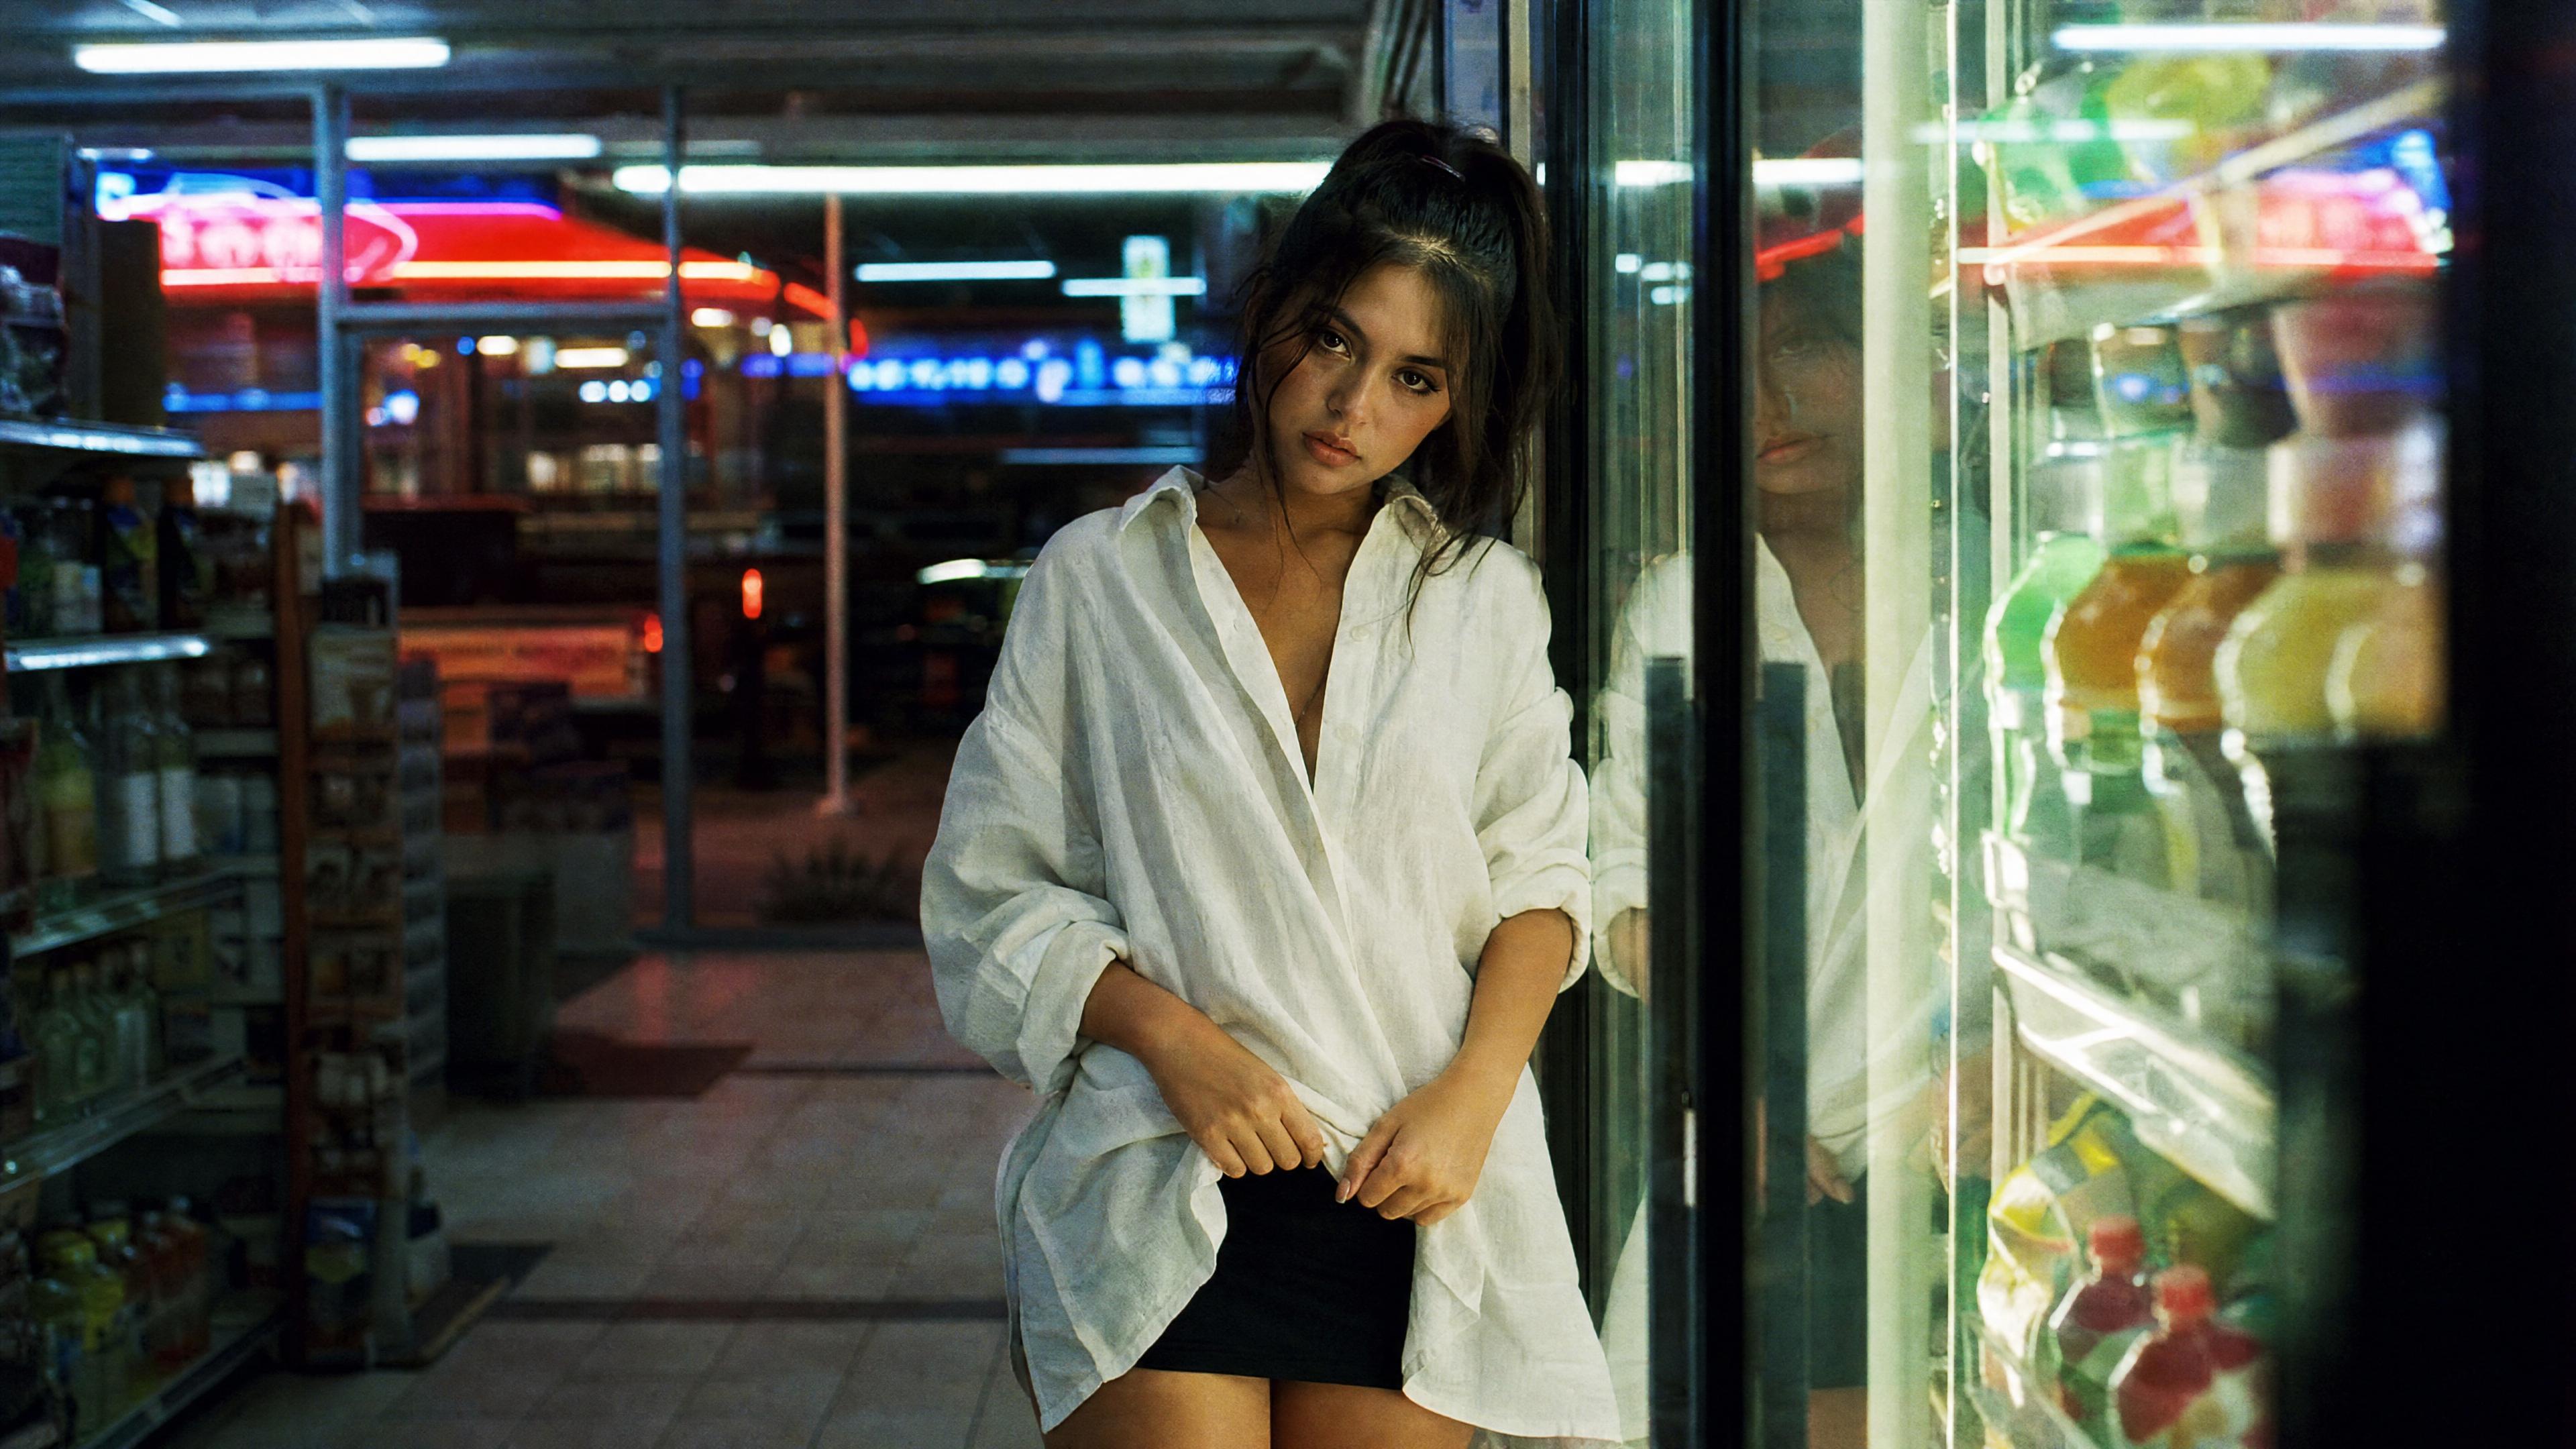
GPT Image 2 API สามารถรวมรูปภาพอินพุตหลายรูปให้เป็นผลลัพธ์ที่สอดคล้องกันเพียงหนึ่งเดียว โดยมี prompt ภาษาธรรมชาติเป็นตัวชี้นำ ฟีเจอร์นี้รองรับการจัดวางผลิตภัณฑ์ การถ่ายโอนสไตล์ และความสอดคล้องของตัวละครในชุดภาพวิชวลที่สร้างขึ้น
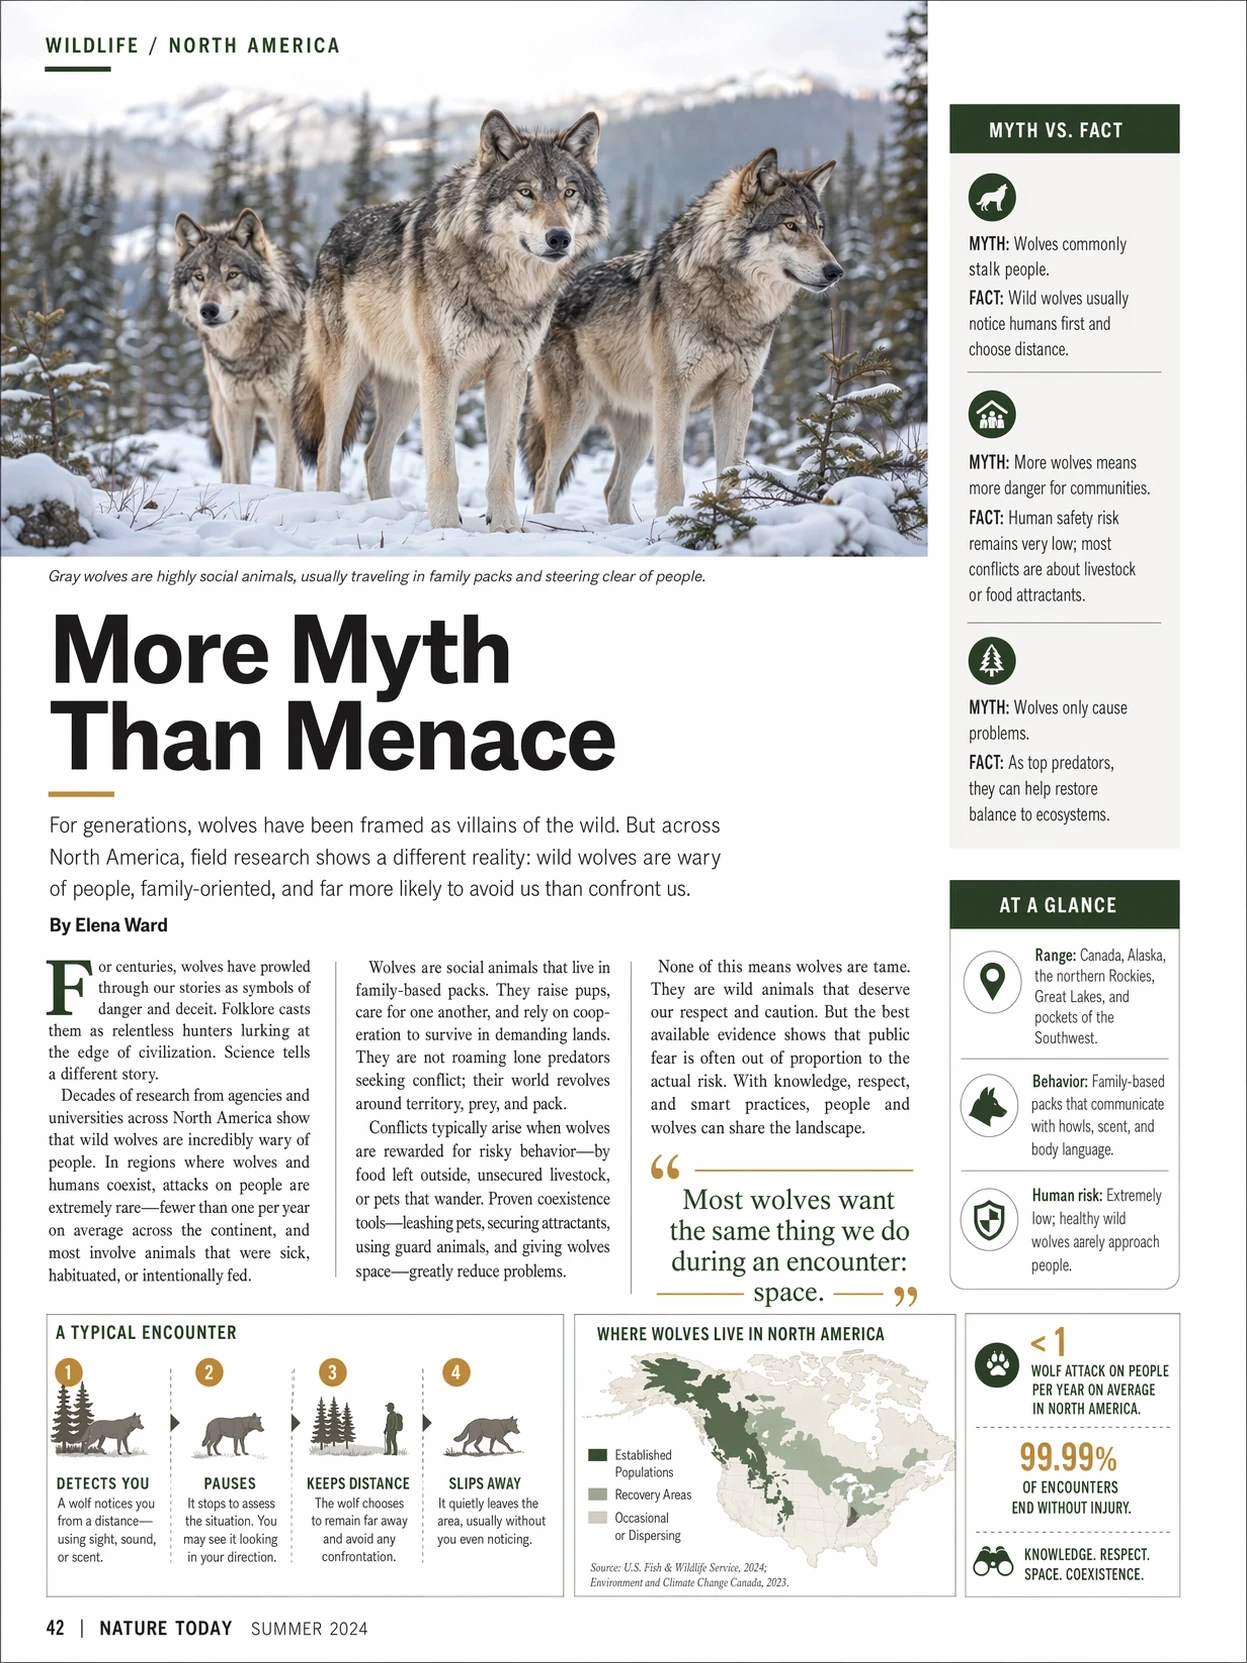
GPT Image 2 สร้าง Mockup ของ UI และอินเทอร์เฟซแอปพลิเคชันด้วยข้อความบนปุ่มที่สะกดอย่างถูกต้องและโครงสร้างเลย์เอาต์ที่สะอาดตา เหมาะสำหรับหน้าจอแนวคิดที่ต้องการความรวดเร็วและตัวอย่างการออกแบบที่ความสามารถในการอ่านข้อความบนหน้าจอเป็นสิ่งสำคัญ
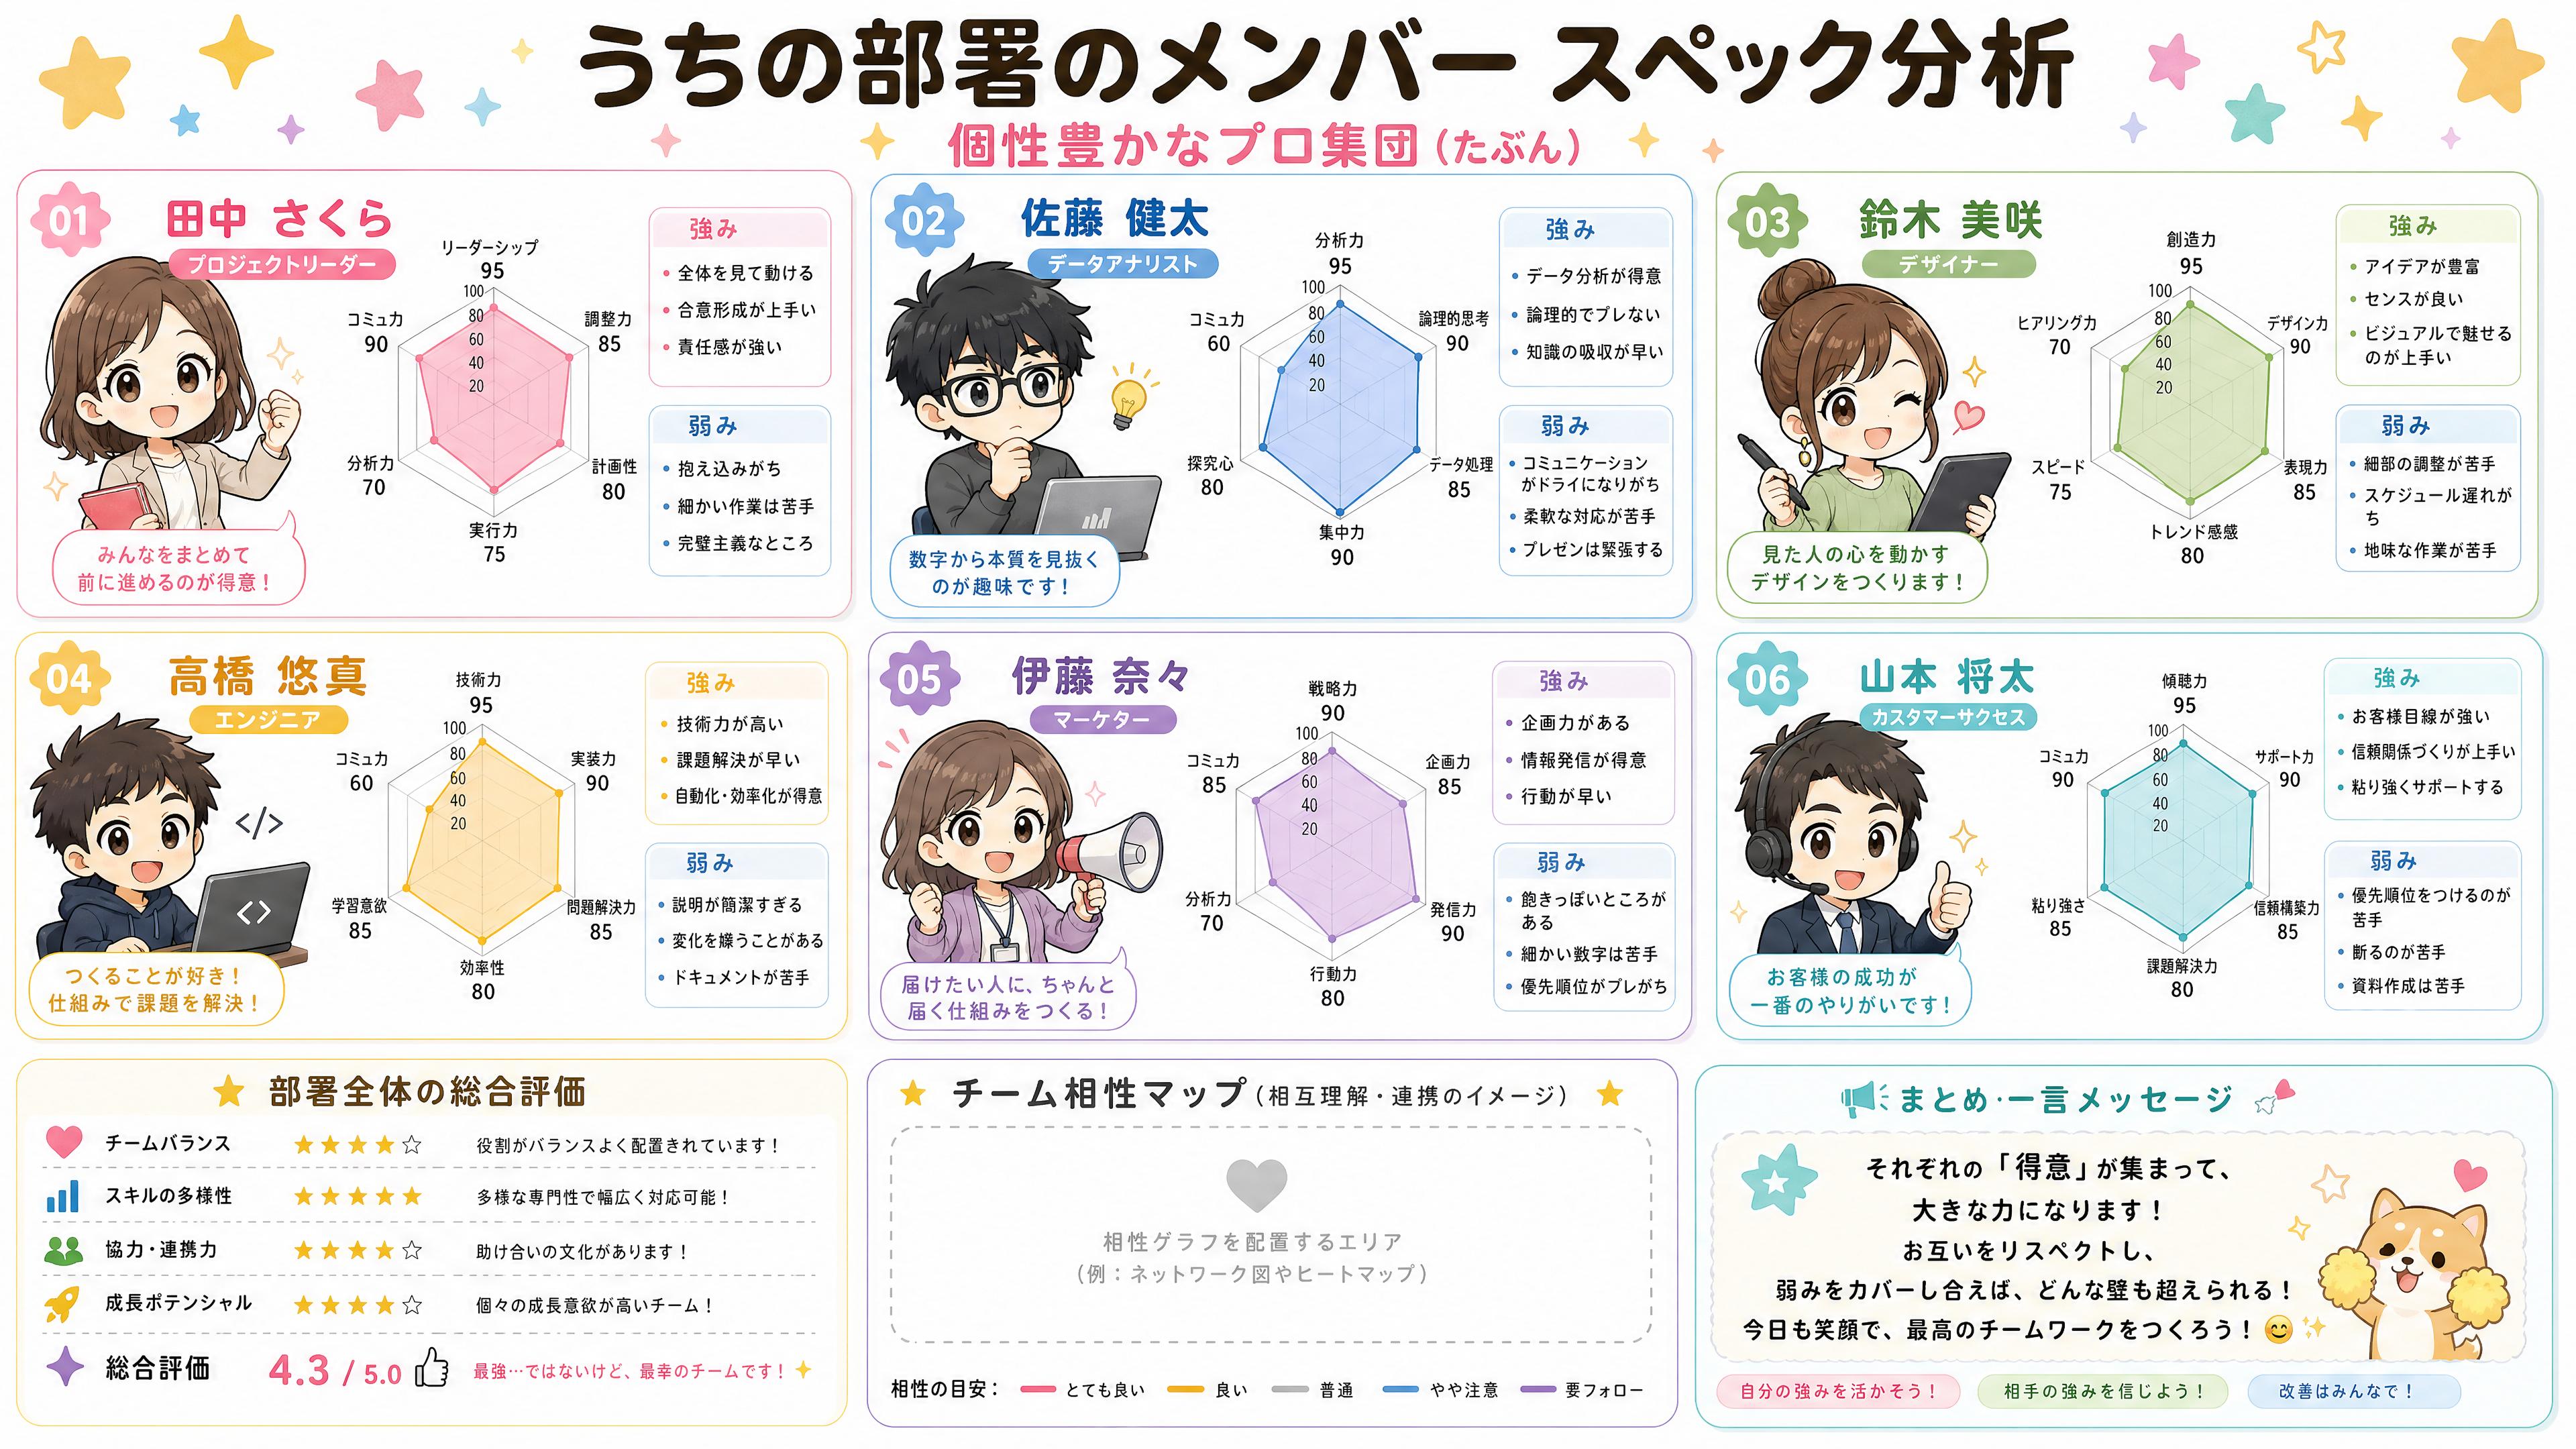
GPT Image 2 API สามารถทำตามคำสั่ง (prompts) ที่ยาวและมีหลายส่วนได้อย่างแม่นยำและน่าเชื่อถือ โดยยังคงรักษาองค์ประกอบภาพ ตัวเลือกการจัดแสง และรายละเอียดที่ละเอียดอ่อนไว้ ผลลัพธ์ที่ได้คือจำนวนการทำซ้ำที่ลดลงและผลลัพธ์ที่เชื่อถือได้สำหรับเวิร์กโฟลว์การผลิต
Create a Japanese-language infographic titled "うちの部署のメンバー スペック分析" (Our Department Member Spec Analysis) with subtitle "個性豊かなプロ集団(たぶん)". Layout as a 2x3 grid of six member cards on a clean white background with pastel accents and star decorations. Each card features a cute chibi-style cartoon avatar and includes: member name and role in Japanese, a radar chart or bar chart showing their stats, bullet-point strengths and weaknesses in Japanese. Add a summary section at the bottom with overall team evaluation, a team compatibility graph placeholder, and a final takeaway note. Cheerful office illustration style, soft rounded UI elements, kawaii aesthetic, highly legible Japanese typography, no watermark.
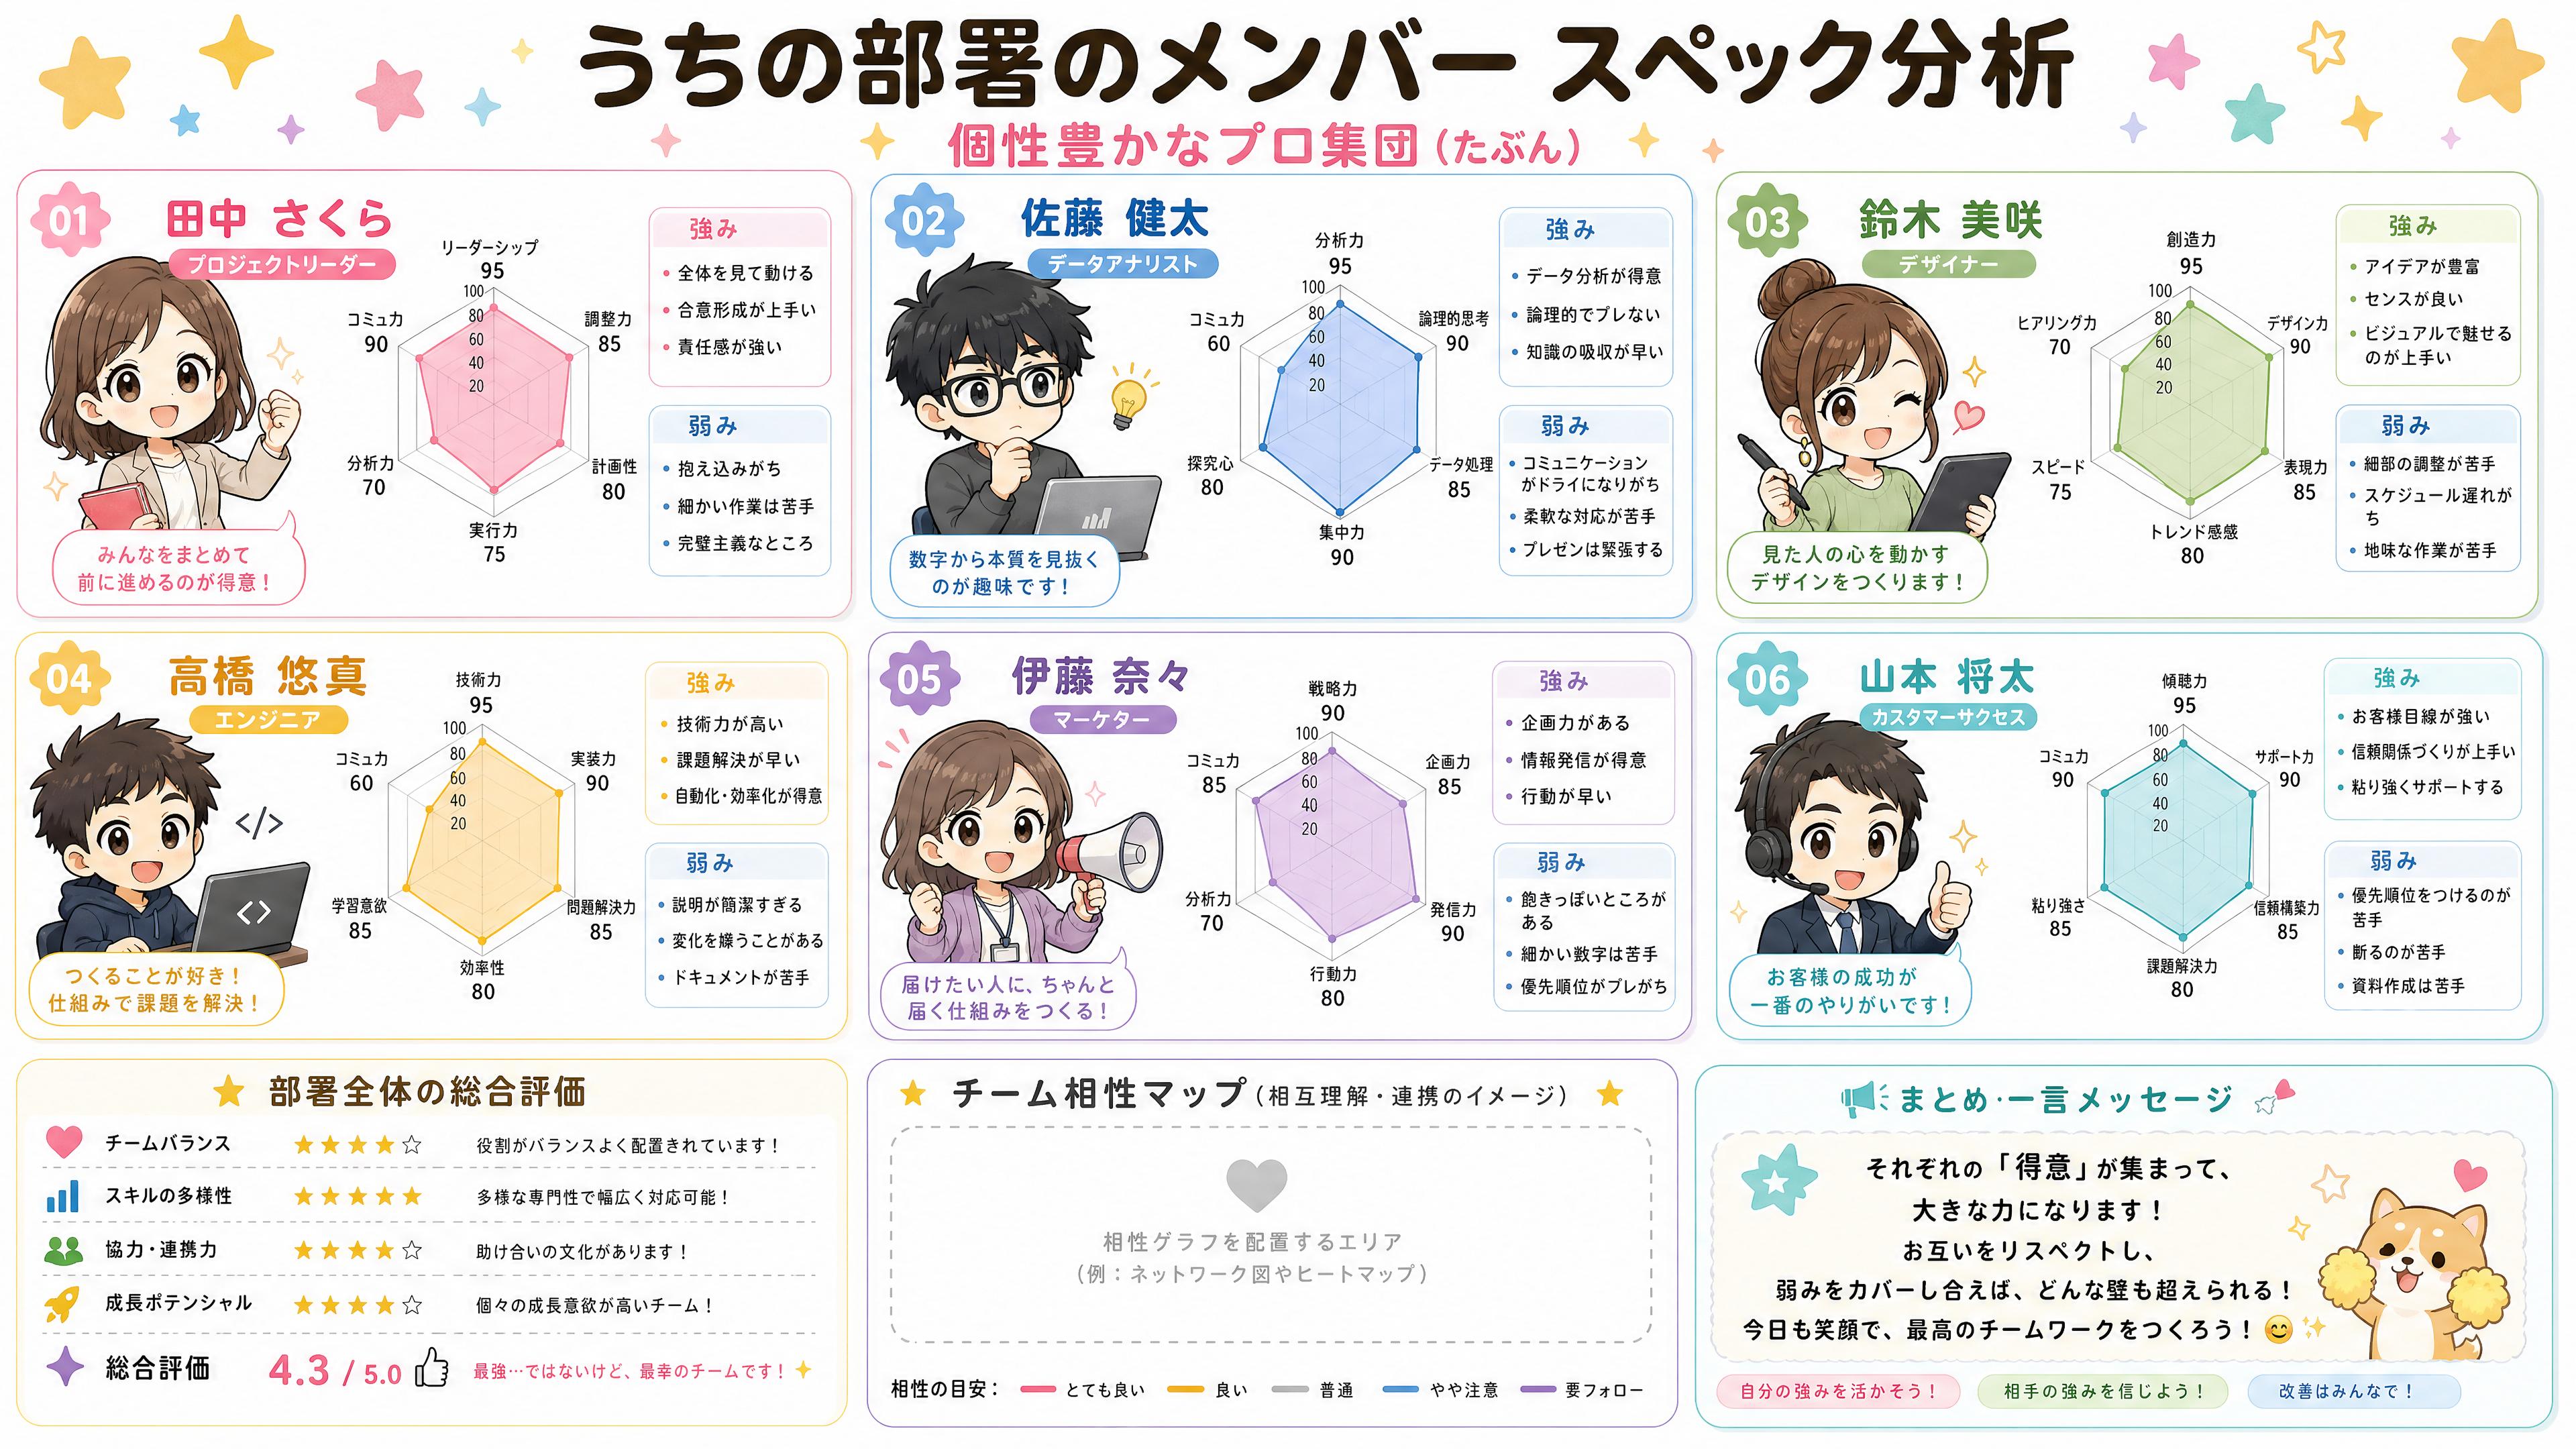
GPT Image 2
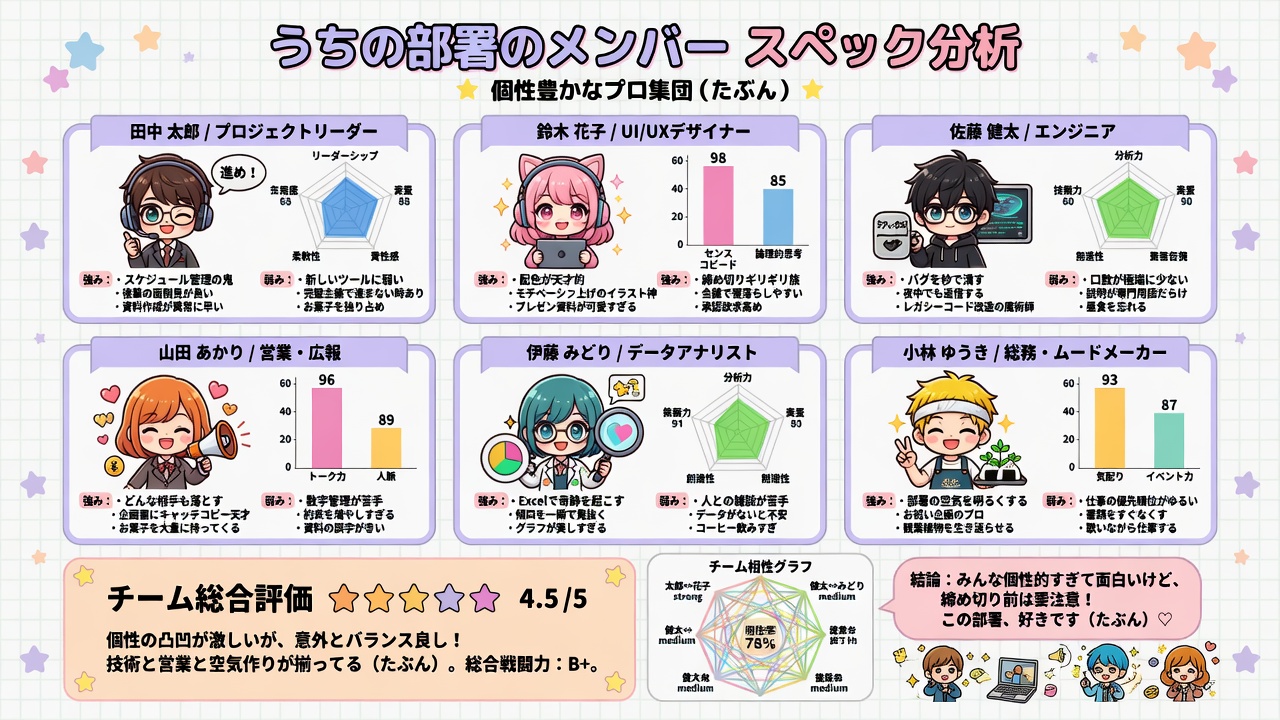
Grok Imagine
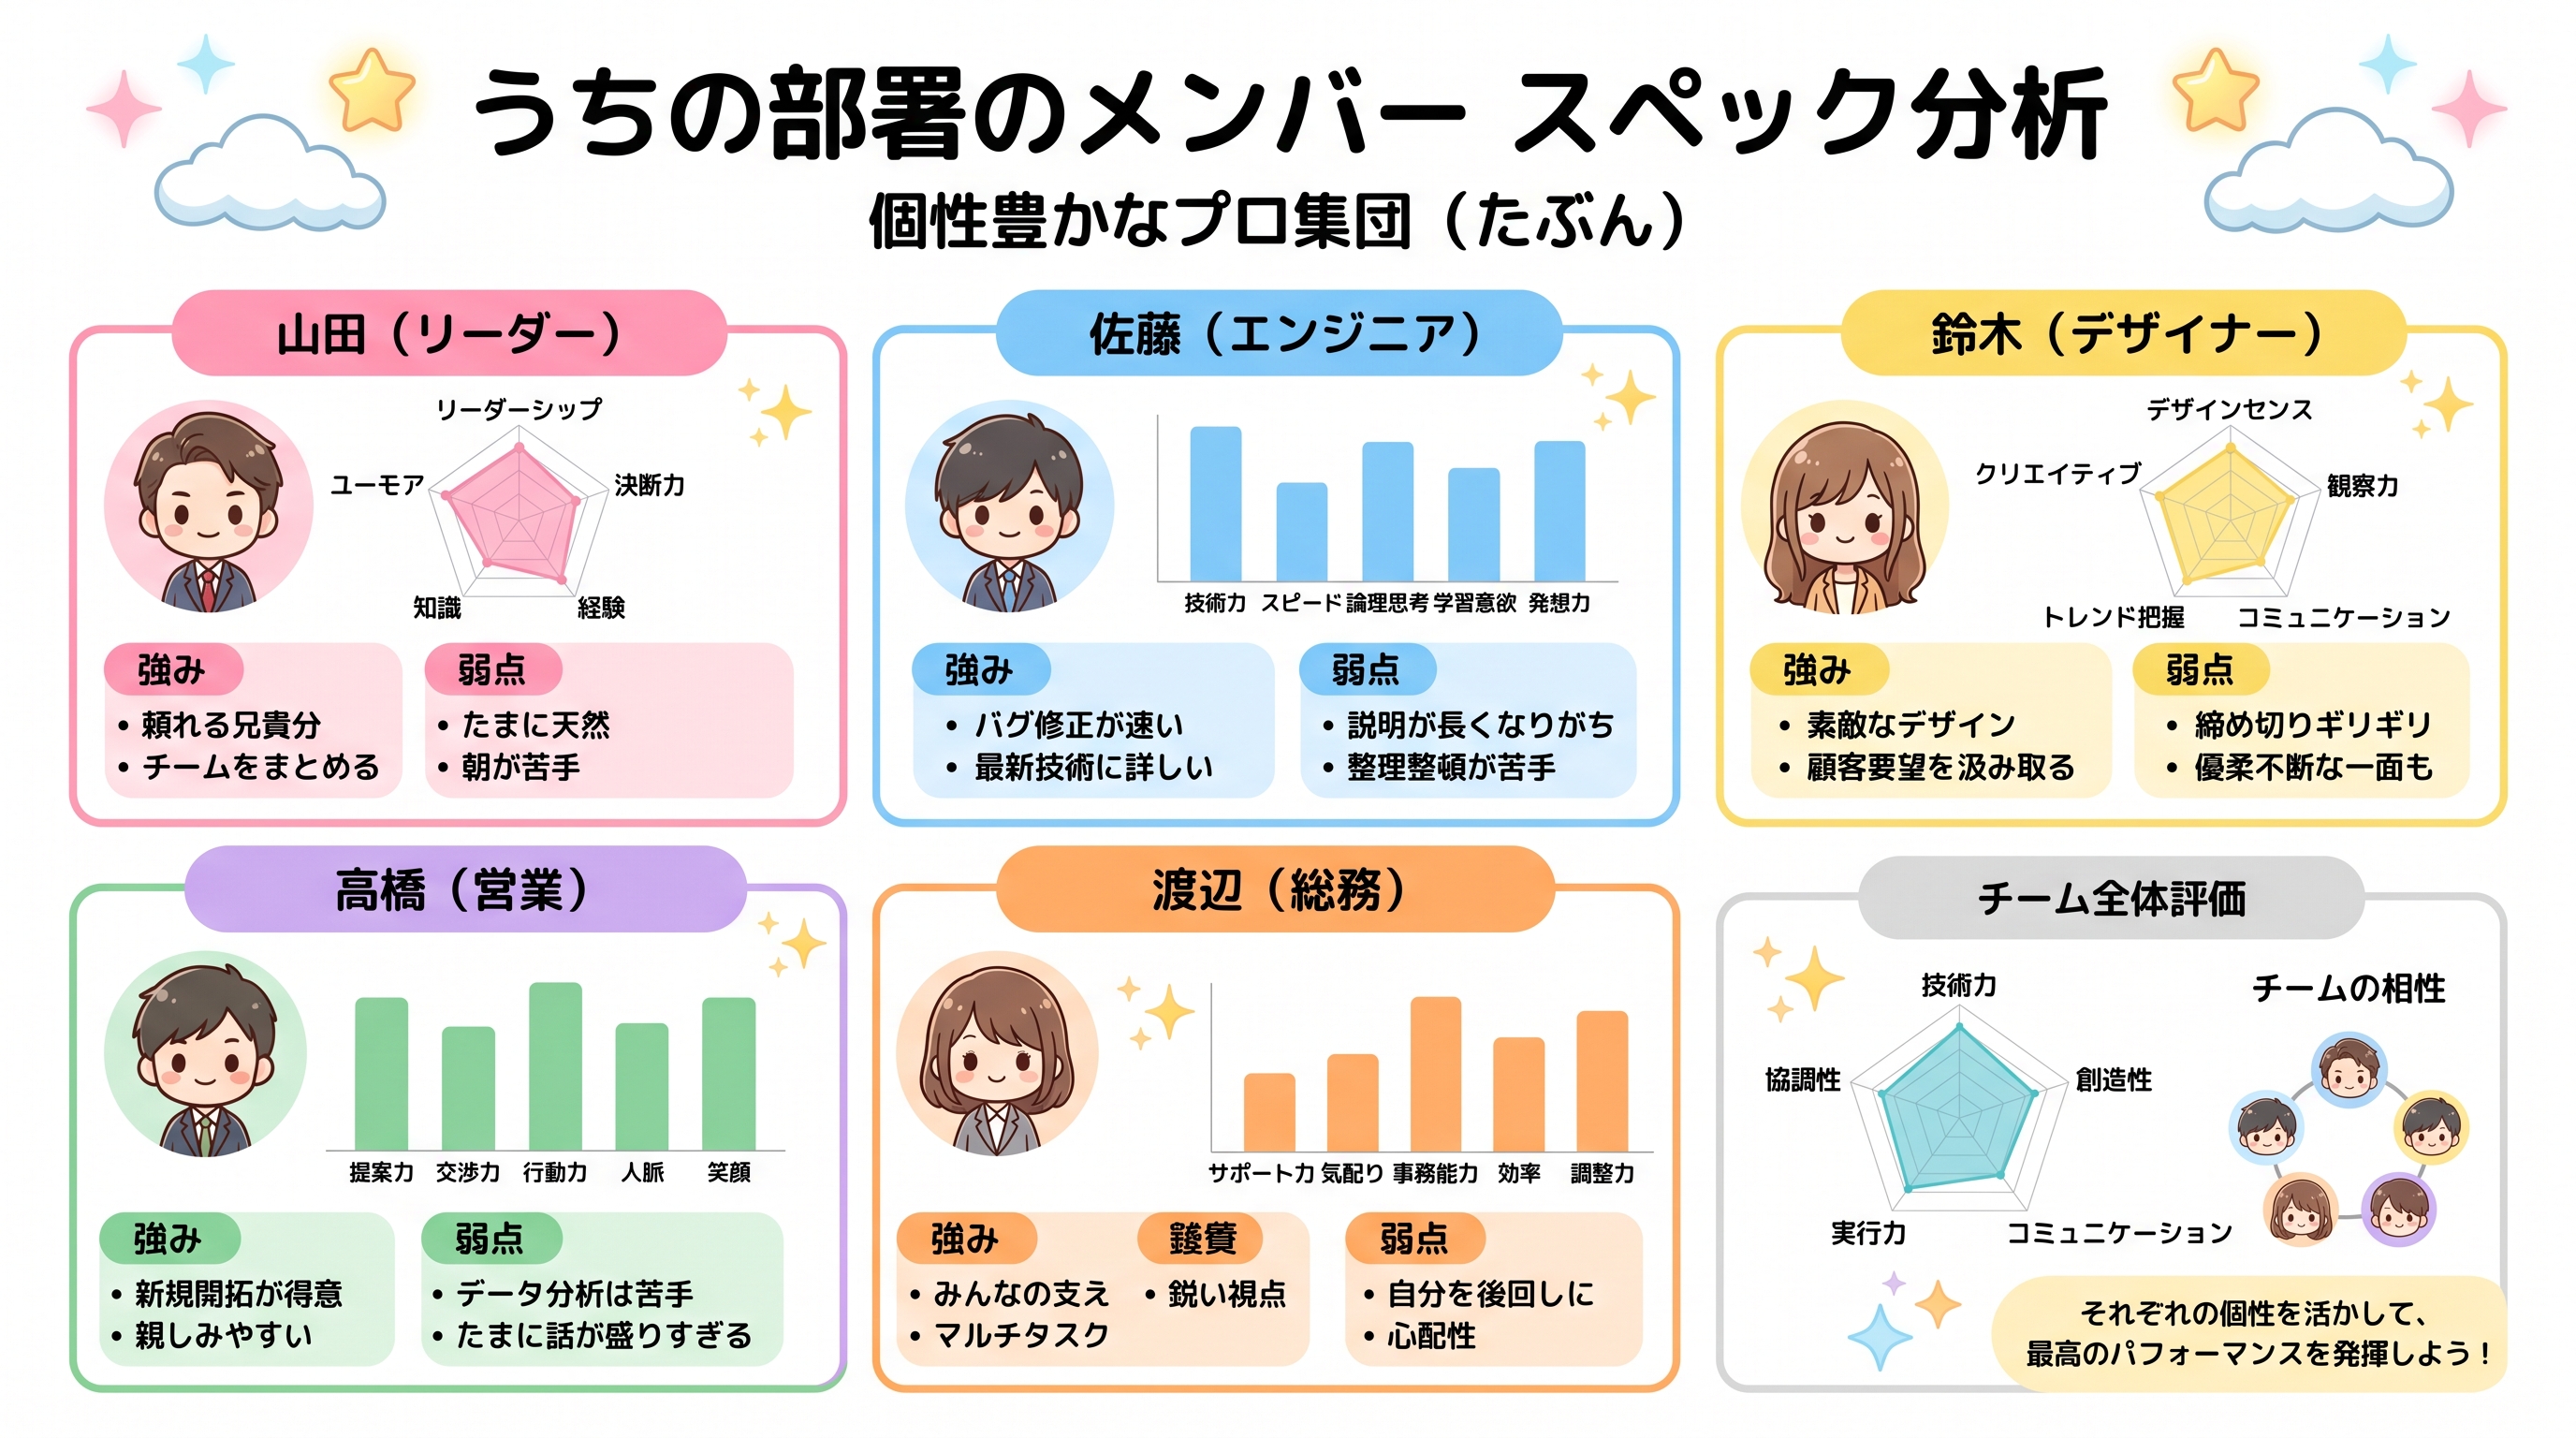
Nano Banana 2
ตั้งแต่ชิ้นงานโฆษณาและภาพวิชวลของผลิตภัณฑ์ ไปจนถึงม็อกอัป UI เนื้อหาที่ปรับให้เข้ากับท้องถิ่น และอินโฟกราฟิกเชิงบรรณาธิการ ดูว่า GPT Image 2 API สามารถสร้างอะไรได้บ้าง
คาดว่า GPT Image 2 จะมีประสิทธิภาพสูงมากสำหรับระบบอัตโนมัติทางการตลาด (marketing automation) — ในการสร้างกราฟิกสำหรับโซเชียลมีเดีย ชิ้นงานโฆษณา และส่วนหัวของอีเมลพร้อมข้อความที่แม่นยำในปริมาณมาก เมื่อทำงานร่วมกับ MindStudio ด้วยการปฏิบัติตามคำสั่ง (prompt) ที่เกือบจะสมบูรณ์แบบและความสมจริงของภาพที่ได้รับการปรับปรุง โมเดลนี้จึงมุ่งเป้าไปที่การสร้างสินทรัพย์ของแคมเปญที่พร้อมใช้งานจริงโดยไม่ต้องพึ่งพาการถ่ายภาพ
GPT Image 2 กำลังถูกพูดถึงอย่างมากในบริบทของภาพผลิตภัณฑ์และเนื้อหาโซเชียลที่ความแม่นยำมีความสำคัญเท่าๆ กับคุณภาพของภาพ Dreamina การปรับปรุงความสม่ำเสมอของตัวละครและการรักษาภาพ ทำให้เหมาะอย่างยิ่งสำหรับการขยายแคตตาล็อกผลิตภัณฑ์ การสร้างภาพไลฟ์สไตล์ และการผลิตชุดผลิตภัณฑ์ย่อยที่สม่ำเสมอ
ม็อกอัป UI และอินเทอร์เฟซแอปพลิเคชัน — ที่มีข้อความบนปุ่มสะกดอย่างถูกต้องและโครงสร้างเลย์เอาต์ที่ดูสะอาดตา — เป็นหนึ่งในกรณีการใช้งานที่ผู้ทดสอบในระยะแรกให้ความสำคัญเป็นพิเศษ ทีมผลิตภัณฑ์และนักออกแบบของ Dzine สามารถใช้ GPT Image 2 สำหรับม็อกอัปแนวคิดที่ต้องการความรวดเร็ว ภาพวิชวลสำหรับหน้าแลนดิงเพจ และเนื้อหาสำหรับงานนำเสนอ
การเรนเดอร์งานสถาปัตยกรรมและการตกแต่งภายในที่มีมิติความลึกและความสมจริงของวัสดุที่ได้รับการปรับปรุง เป็นหนึ่งในจุดแข็งที่คาดหวังของ GPT Image 2 การปรับปรุงความสมจริงของภาพถ่ายและองค์ประกอบภาพของ Dzine ทำให้เป็นเครื่องมือที่ใช้งานได้จริงสำหรับการนำเสนองานออกแบบและการตลาดอสังหาริมทรัพย์
GPT Image 2 API สามารถเรนเดอร์ข้อความได้อย่างแม่นยำในภาษาจีน ญี่ปุ่น เกาหลี และตัวอักษรอื่นๆ คุณจึงสามารถผลิตป้าย โพสต์บนโซเชียลมีเดีย และสื่อแบรนด์ต่างๆ ที่ในอดีตจำเป็นต้องซ้อนทับข้อความด้วยตนเองได้ ซึ่งทำให้การปรับใช้แคมเปญให้เข้ากับท้องถิ่นและการสร้างภาพที่เฉพาะเจาะจงสำหรับภูมิภาคในระดับขนาดใหญ่กลายเป็นเรื่องในทางปฏิบัติที่ทำได้จริง
GPT Image 2 API ใช้สำหรับสร้างหน้าปกหนังสือ บทความที่มีภาพประกอบ อินโฟกราฟิก และสื่อวิชวลเพื่อการศึกษา ซึ่งข้อความในภาพที่อ่านได้คือข้อกำหนดที่สำคัญ ด้วยการจัดรูปแบบตัวอักษรที่แม่นยำและการสร้างที่มีโครงสร้างสำหรับแผนภูมิ ไดอะแกรม และสื่ออธิบาย จะช่วยเปลี่ยนข้อมูลที่ซับซ้อนให้กลายเป็นกราฟิกที่ชัดเจนและพร้อมแชร์
ดูว่าโมเดลจากผู้ให้บริการต่างๆ เปรียบเทียบกันอย่างไร — เปรียบเทียบประสิทธิภาพ ราคา และจุดแข็งเฉพาะตัวเพื่อตัดสินใจอย่างมีข้อมูล
| โมเดล | ขีดจำกัดภาพอ้างอิง | จำนวนเอาต์พุต | ความละเอียด | อัตราส่วนภาพ |
|---|---|---|---|---|
| GPT Image-2 | 16 | 1-10 | Up to 2048×2048 (2K) native;4K via scaling | 1:1, 2:3, 3:2 |
| GPT Image-1.5 | 10 | 1 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| GPT Image-1 | 4 | 1~10 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| GPT Image-1 Mini | 4 | 1~10 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| Nano Banana 2 | 14 | 1 | 512×512, 1024×1024, 2048×2048, 4096×4096 (0.5K/1K/2K/4K) | 1:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9, 1:4, 4:1, 1:8, 8:1 |
| Grok Imagine | 1 | 1-10 | 1024×1024 (1K), 2048×2048 (2K) | 1:1, 3:2, 2:3, 16:9, 9:16 |
เริ่มต้นได้ในไม่กี่นาที — ทำตามขั้นตอนง่าย ๆ เหล่านี้เพื่อเชื่อมต่อและใช้งานโมเดลผ่านแพลตฟอร์ม Atlas Cloud
สมัครสมาชิกที่ atlascloud.ai และยืนยันตัวตน ผู้ใช้ใหม่จะได้รับเครดิตฟรีเพื่อสำรวจแพลตฟอร์มและทดสอบโมเดล
การรวมโมเดล GPT Image 2 ขั้นสูงเข้ากับแพลตฟอร์มที่เร่งด้วย GPU ของ Atlas Cloud ให้ประสิทธิภาพ ความสามารถในการขยาย และประสบการณ์นักพัฒนาที่ไม่มีใครเทียบได้
เวลาแฝงต่ำ:
inference ที่ปรับแต่ง GPU เพื่อการตอบสนองแบบเรียลไทม์
API แบบรวมศูนย์:
รัน GPT Image 2, GPT, Gemini และ DeepSeek ด้วยการเชื่อมต่อเดียว
ราคาโปร่งใส:
ชำระเงินต่อโทเค็นที่คาดเดาได้พร้อมตัวเลือก serverless
ประสบการณ์นักพัฒนา:
SDK, การวิเคราะห์, เครื่องมือปรับแต่ง และเทมเพลต
ความน่าเชื่อถือ:
ความพร้อมใช้งาน 99.99%, RBAC และการบันทึกที่พร้อมสำหรับการปฏิบัติตาม
ความปลอดภัยและการปฏิบัติตาม:
SOC 2 Type II, สอดคล้อง HIPAA, อธิปไตยข้อมูลในสหรัฐอเมริกา
GPT Image 2 API ช่วยให้นักพัฒนาสามารถเข้าถึง GPT Image 2 ของ OpenAI ผ่านการเขียนโปรแกรมได้ ซึ่งเป็นโมเดลรูปภาพที่เปิดตัวในเดือนเมษายน 2026 เพื่อสืบทอดต่อจาก GPT Image 1.5 และแทนที่ DALL-E 3 โมเดลนี้สามารถสร้างและแก้ไขรูปภาพจากการป้อนข้อความและรูปภาพ โดยมีข้อความในรูปภาพที่แม่นยำ รองรับหลายภาษา และมีความสมจริงของภาพถ่ายระดับสูง บน Atlas Cloud คุณสามารถเรียกใช้งานโมเดลนี้ผ่าน API ที่เป็นหนึ่งเดียวร่วมกับโมเดลอื่นๆ อีกกว่า 300 โมเดล
ใช่ GPT Image 2 API รองรับทั้งการสร้างรูปภาพจากข้อความและการแก้ไขรูปภาพในโมเดลเดียว การแก้ไขครอบคลุมถึงการทำ inpainting และ outpainting อย่างแม่นยำด้วยภาพมาสก์ รวมไปถึงการคอมโพสิตแบบหลายอ้างอิงที่ผสานอินพุตหลายรายการให้เป็นผลลัพธ์ที่สอดคล้องกันเพียงหนึ่งเดียว
ไม่ใช่ GPT Image 2 คือรุ่นสืบทอดจาก GPT Image 1.5 ไม่ใช่ DALL-E โดย OpenAI ได้ยกเลิกการใช้แบรนด์ DALL-E อย่างสิ้นเชิงแล้ว ทั้ง DALL-E 2 และ DALL-E 3 จะถูกปิดตัวลงในวันที่ 12 พฤษภาคม 2026 ตระกูล GPT Image ใช้สถาปัตยกรรมการถดถอยในตัวเองที่สร้างขึ้นแบบเนทีฟภายในโมเดลภาษา ซึ่งแตกต่างอย่างสิ้นเชิงกับแนวทางที่ใช้การแพร่กระจายที่ DALL-E ใช้
ใช่ GPT Image 2 API รองรับทั้งการสร้างรูปภาพจากข้อความและการแก้ไขรูปภาพในโมเดลเดียว การแก้ไขรวมถึงการทำ Inpainting และ Outpainting อย่างแม่นยำด้วยภาพมาสก์ รวมถึงการจัดองค์ประกอบแบบอ้างอิงหลายรายการที่รวมอินพุตหลายตัวเข้าเป็นผลลัพธ์ที่สอดคล้องกัน
ใช่ API ของ GPT Image 2 เรนเดอร์ข้อความบนสคริปต์ละตินและ CJK (จีน ญี่ปุ่น เกาหลี) รวมถึงภาษาจีน ภาษาญี่ปุ่น และภาษาเกาหลี ด้วยสัญลักษณ์ที่แม่นยำและลายเส้นที่ชัดเจน สิ่งนี้ช่วยให้คุณสร้างป้ายที่ปรับให้เข้ากับท้องถิ่น โพสต์โซเชียล และสื่อของแบรนด์ ซึ่งก่อนหน้านี้จำเป็นต้องวางซ้อนข้อความด้วยตนเอง
GPT Image 2 API รองรับขนาดภาพและอัตราส่วนภาพที่ยืดหยุ่น โดยให้ความละเอียดเอาต์พุตดั้งเดิมสูงสุด 2K และสามารถใช้ 4K ได้ผ่านการปรับขนาด คุณสามารถขอขนาดที่ตั้งไว้ล่วงหน้าหรือขนาดที่กำหนดเองเพื่อให้เหมาะกับโพสต์โซเชียล แบนเนอร์ และแอสเซ็ตที่พร้อมสำหรับพิมพ์
ไม่ OpenAI จำกัดการใช้งานกลุ่ม GPT Image ไว้หลังการยืนยันองค์กรในคอนโซลนักพัฒนาซอฟต์แวร์ของตนเอง ซึ่งอาจกีดกันนักพัฒนาอิสระได้ แต่ด้วย GPT Image 2 API บน Atlas Cloud คุณต้องการเพียงแค่บัญชี Atlas Cloud เท่านั้น คุณจึงสามารถรับคีย์และเริ่มสร้างได้โดยไม่ต้องผ่านการยืนยันจาก OpenAI
OpenAI คิดค่าบริการ GPT Image 2 ตาม token ดังนั้นต้นทุนต่อภาพจึงแปรผันตามความละเอียด คุณภาพ และภาพอ้างอิง ซึ่งยากต่อการคาดเดา บน Atlas Cloud ตัว GPT Image 2 API ใช้ราคาคงที่ต่อภาพ: การแปลงข้อความเป็นภาพ (text to image) เริ่มต้นที่ 0.009 ดอลลาร์ต่อภาพ และการแก้ไขที่ 0.01 ดอลลาร์ต่อภาพ โดยลดลงเหลือ 0.004 ดอลลาร์และ 0.005 ดอลลาร์ในระดับนักพัฒนาซอฟต์แวร์ (developer tier) ผู้ใช้ใหม่ยังได้รับเครดิตฟรีเพื่อทดสอบก่อนที่จะใช้จ่ายจริง
Seedance 2.5 API พร้อมใช้งานแล้วบน Atlas Cloud! มอบโมเดลวิดีโอใหม่ล่าสุดของ ByteDance ให้กับนักพัฒนา สร้างวิดีโอเนทีฟได้นานถึง 30 วินาทีในการประมวลผลเพียงครั้งเดียวจากข้อความ รูปภาพเดียว หรือการอ้างอิงหลายรูปแบบสูงสุด 50 รายการ พร้อมเสียงที่ซิงโครไนซ์และข้อความหลายภาษาในเฟรม บน Atlas Cloud คุณสามารถเข้าถึงได้ผ่านคีย์เดียว โดยมีความสอดคล้องของวัตถุและระบบฟิสิกส์ที่ได้รับการปรับปรุงซึ่งช่วยให้ภาพระยะยาวมีความต่อเนื่อง

Wan 3.0 API คือเจเนอเรชันถัดไปของตระกูลวิดีโอ Wan จาก Alibaba ซึ่งสร้างขึ้นเพื่อยกระดับการสร้างวิดีโอแบบยาว การควบคุมแบบหลายข้อมูลอ้างอิง และคุณภาพของภาพและเสียงให้ก้าวไปอีกขั้น Atlas Cloud ได้โฮสต์ Wan 2.7, 2.6 และ 2.5 ไว้แล้ว และ Wan 3.0 สามารถทำงานบนคีย์แบบรวมเดียวกันโดยไม่ต้องตั้งค่าแยกต่างหาก เริ่มต้นสร้างสรรค์ได้ตั้งแต่วันนี้ เลื่อนลงไปที่ส่วนจัดแสดงเพื่อดูว่า Wan 3.0 สามารถสร้างอะไรได้บ้าง
MiniMax H3 คือผลิตภัณฑ์วิดีโอแบบมัลติโมดัลของ MiniMax สำหรับการสร้างสรรค์โดยใช้ข้อความ รูปภาพ และข้อมูลอ้างอิง ในเส้นทาง API ที่รองรับ ระบบจะคงลักษณะของวัตถุจากสื่ออ้างอิงไว้ มีอัตราส่วนภาพที่ยืดหยุ่น และจับคู่เสียงที่สร้างขึ้นกับภาพผ่าน H3 Developer โดยโปรไฟล์เอาต์พุตจะถูกเลือกตาม endpoint Atlas Cloud รวมผลิตภัณฑ์ในตระกูลนี้ไว้เบื้องหลังคีย์เดียวที่รองรับ OpenAI พร้อมการคิดค่าบริการตามการใช้งานอย่างโปร่งใส เริ่มต้นที่อัตรามาตรฐาน $0.038 ต่อวินาที เริ่มพัฒนาได้วันนี้
ตระกูล gpt-image-2.5 จาก OpenAI มอบทางเลือก Flare และ Sunburst ให้แก่นักพัฒนาสำหรับกระบวนการทำงานด้านการสร้างภาพเพื่อใช้งานจริง เรนเดอร์ด้วยความละเอียดตามต้องการสูงสุด 3840x2160 และเลือกได้จากระดับคุณภาพ 5 ระดับ รวมถึง xhigh และ max เพื่อให้ตรงตามข้อกำหนดของเอาต์พุตแต่ละแบบ Atlas Cloud ให้บริการอนุมานผ่าน REST ที่พร้อมใช้งาน โดยไม่มี cold start และคิดค่าบริการตามมาตรฐานเริ่มต้นที่ $0.004 ต่อการสร้างภาพ เริ่มพัฒนาได้วันนี้
Seedream 5.0 Pro API มอบโมเดลการแก้ไขภาพที่ควบคุมได้ของ ByteDance บน Atlas Cloud ให้กับนักพัฒนา โดยจะวางการแก้ไขอย่างแม่นยำด้วยจุดยึดและพิกัด แยกภาพออกเป็นเลเยอร์ที่แก้ไขได้ ผสานข้อมูลอ้างอิงหลายรายการ และจับคู่สีและวัสดุที่แน่นอน พร้อมข้อความหลายภาษาที่ความละเอียด 2K และ 3K บน Atlas Cloud คุณสามารถเข้าถึงได้ผ่านคีย์เดียว!
Seedance 2.0 คือโมเดลวิดีโอสำหรับการใช้งานจริงของ ByteDance ที่ออกแบบมาเพื่อสร้างช็อตได้อย่างแม่นยำ เปลี่ยนพรอมป์ต์เป็นวิดีโอ ทำให้ภาพเฟรมแรกเคลื่อนไหวโดยมีตัวเลือกให้ใช้คำแนะนำจากเฟรมสุดท้าย หรือปรับแต่งผลลัพธ์ด้วยสื่ออ้างอิงและการค้นหาเว็บแบบเลือกใช้ได้ Atlas Cloud รวมเวิร์กโฟลว์เหล่านี้ไว้ใน API เดียว พร้อมการคิดค่าบริการตามการใช้งานจริงอย่างโปร่งใสและคีย์เดียวที่เข้ากันได้กับ OpenAI เริ่มสร้างสรรค์ได้วันนี้
Kling 3.0 API นำชุดเครื่องมือวิดีโอระดับเรือธงของ Kuaishou มาสู่ Atlas Cloud ผ่านคีย์ที่รองรับ OpenAI เพียงคีย์เดียว โดยครอบคลุมสองโมเดล ได้แก่ Kling 3.0 สำหรับการเล่าเรื่องผ่าน AI Director การลิปซิงค์หลายภาษา และข้อความบนหน้าจอที่แม่นยำ และ Kling 3.0 Omni (O3) สำหรับการโคลนวัตถุและเสียงจากวิดีโอสั้นหรือรูปภาพ ทั้งสองโมเดลสร้างเสียงต้นฉบับในกระบวนการเดียวกัน พร้อมเอาต์พุตสูงสุดถึง 4K สร้างการเล่าเรื่องแบบภาพยนตร์ การตลาดระดับโลก โฆษณาหลายภาษา และเนื้อหาตัวละครแบบซีรีส์บนโครงสร้างพื้นฐานที่เชื่อถือได้
Grok Imagine Video เปิดให้นักพัฒนาเข้าถึงตระกูลวิดีโอของ xAI เพื่อสร้าง ทำให้เคลื่อนไหว ขยาย และตัดต่อคลิป สร้างวิดีโอความยาว 1 ถึง 15 วินาทีจากพรอมต์ กำกับบุคคล วัตถุ หรือสไตล์ด้วยภาพอ้างอิงได้สูงสุดเจ็ดภาพ และทำงานที่ความละเอียด 480p หรือ 720p Atlas Cloud รวมความสามารถเหล่านี้ไว้ผ่าน endpoint ที่เข้ากันได้กับ OpenAI พร้อมการคิดค่าบริการแบบจ่ายตามการใช้งานอย่างโปร่งใส เริ่มสร้างสรรค์ได้วันนี้
Vidu Q4 คือโมเดลวิดีโอเรือธงรุ่นล่าสุดของ Vidu ออกแบบมาสำหรับการสร้างวิดีโอจากภาพและจากภาพอ้างอิง สามารถทำให้ภาพนิ่งภาพเดียวมีชีวิตขึ้นมาและสร้างการเปลี่ยนฉากโดยอัตโนมัติ ช่วยให้นักพัฒนามีช่องทางป้อนข้อมูล 2 รูปแบบสำหรับเวิร์กโฟลว์ผลิตภัณฑ์ที่แตกต่างกัน Atlas Cloud มี API endpoints เฉพาะ พร้อมสคีมาพารามิเตอร์ที่เผยแพร่ไว้ ในราคามาตรฐานที่ยืนยันแล้วที่ $0.04 ต่อวินาที เริ่มสร้างสรรค์ได้วันนี้
Gemini Omni 1.1 Flash เป็นตระกูลวิดีโอแบบมัลติโมดัลโดยกำเนิดของ Google DeepMind สำหรับเวิร์กโฟลว์การผลิตที่ยืดหยุ่น แก้ไขฟุตเทจที่มีอยู่ด้วยคำสั่งข้อความ รักษาความสอดคล้องทางภาพด้วยภาพอ้างอิงสูงสุด 10 ภาพและคลิปวิดีโอ 3 คลิป หรือขยายช็อตเป็นช่วงที่ต่อเนื่องกันได้สูงสุด 40 วินาที เข้าถึงทุกเวิร์กโฟลว์บน Atlas Cloud ด้วยคีย์ API ที่เข้ากันได้กับ OpenAI เพียงคีย์เดียว ราคาตามการใช้งาน และพร้อมให้บริการตั้งแต่ Day-0 เริ่มสร้างสรรค์ได้วันนี้
Nano Banana 2.1 คือกลุ่มโมเดลภาพของ Google ที่สร้างขึ้นบน Gemini 3.6 Flash ให้ความสามารถในการสร้างและแก้ไขภาพระดับ Pro ด้วยความเร็วระดับ Flash รองรับการแก้ไขและผสานภาพด้วยภาษาธรรมชาติจากภาพอินพุต 1 ถึง 14 ภาพ พร้อมรักษาความสอดคล้องของตัวละครสูงสุด 4 ตัวและวัตถุ 10 รายการ ผ่าน Atlas Cloud นักพัฒนาสามารถเข้าถึงกลุ่มโมเดลนี้ด้วยคีย์เดียวที่รองรับ OpenAI พร้อมความเสถียรในการให้บริการและพร้อมใช้งานตั้งแต่ Day-0 เริ่มสร้างสรรค์ได้ตั้งแต่วันนี้
สร้างสรรค์ผลงานด้วย Nano Banana 2 API ที่ขับเคลื่อนโดยโมเดล Gemini 3.1 Flash Image ของ Google ซึ่งสามารถสร้างภาพ 4K แบบเนทีฟที่ความละเอียดสูงสุด 4096x2304 พร้อมการเรนเดอร์ข้อความที่แม่นยำและตัวละครที่สอดคล้องกันผ่านรูปภาพอ้างอิงสูงสุด 14 รูป สำหรับทั้งการสร้างและการแก้ไข บน Atlas Cloud คุณสามารถเข้าถึงได้ผ่าน API แบบรวมศูนย์ร่วมกับโมเดลอื่นๆ มากกว่า 300 โมเดล โดยมีราคาเริ่มต้นที่ 0.04 ดอลลาร์ต่อรูปภาพ มีอัปไทม์ 99.99% และเครดิตฟรีสำหรับการเริ่มต้น
คู่มือ บทแนะนำ และอัปเดตผลิตภัณฑ์ ที่ช่วยให้คุณใช้ Atlas Cloud ได้อย่างเต็มประสิทธิภาพ


