綠燈的 API 測試報告讓人安心,直到你發現每個斷言都只檢查 HTTP 200。回應即使包含錯誤客戶的記錄,仍可能通過。
選擇 ai tools for api testing 時,請圍繞你現有的工作來挑選。如果你的團隊維護 collections,可評估 Postman Agent Mode;如果規格是你的起點,可評估 KushoAI;如果你需要從錄製流量生成流程或回歸測試,則可評估 Keploy。在信任產出的測試前,先審查並執行它們。
本指南涵蓋用於測試一般 API 的 AI 輔助。測試 AI 模型答案的準確性,是另一個獨立評估問題。
重點摘要
- 提供契約、請求相依性,以及已核可的業務預期。
- 檢查斷言是否會拒絕錯誤資料、缺少欄位與損壞的型別。
- 只有在經審查的測試能在你打算使用的 CI 環境中反覆執行後,才購買。
下方的產品比較反映 2026 年 9 月 21 日查核的官方文件。這不是三個付費帳號的正面對決基準測試。
實作範例使用固定版本的 Swagger Petstore 規格,並區分契約預期、觀察到的行為,以及刻意修改的回應副本。
我們在本機的執行通過 5 項 live 測試,並拒絕全部 3 個刻意變更的回應副本。另行進行的缺少 name 探測仍傳回 200,顯示綠燈報告的涵蓋範圍為何重要。
AI API 測試工具實際上會做什麼
AI 輔助通常會介入 API 測試的四個部分。模型會讀取你的規格、提出情境、草擬斷言,並協助解釋失敗。每個部分都需要不同證據。對失敗提出看似合理的解釋,並不能證明所提議的修正正確。
針對規格審查,提供 OpenAPI 檔案與相關業務規則。針對情境規劃,加入有效資料與已知邊界的範例。針對可執行腳本,納入你的執行器、驗證設定與 fixture 慣例。針對診斷,提供移除機密後的真實請求、回應與失敗訊息。
評估產品時,請將這四種機制分開看待:
- LLM 生成: 根據語言、結構描述與範例提出測試。審查者必須檢查預期結果。
- 流量重播: 將後續行為與擷取到的互動相比較,通常使用錄製的相依性回應。
- 屬性導向測試: 系統性地建構輸入,以挑戰結構描述符合性等屬性。
- 測試執行: 傳送請求、評估斷言,並傳回報告與結束代碼。
產品可能結合多種機制。詢問每項測試是由哪種機制產生,以及什麼決定其預期結果。錄製錯誤的回應,可能把相同錯誤保留為回歸基準。產生一個漂亮測試名稱,可能掩蓋沒有依據的預期。
從三個深度思考斷言。第一,伺服器是否成功回應?第二,主體是否具備文件所述的欄位與型別?第三,這個主體是否代表你要求的資源與操作?
以查詢寵物為例,一個具備整數 ID 的有效物件,若該 ID 屬於另一隻寵物,仍會無法通過第三項檢查。反之,符合所要求的 ID 並不能證明每個欄位都滿足結構描述。兩項檢查都要用,並且只在團隊對業務規則有共識來源時加入業務規則。
你想要的實用產出,是可維護且具備可解釋判定依據(oracle)的測試資產:每個結果為什麼應該通過或失敗,都有清楚理由。計算審查後有用的情境數量,包括你拒絕的情境,而不是慶祝最初生成清單的長度。
依工作流程比較 AI API 測試工具
從你的團隊今天能提供的產出物開始。遷移既有 collection、重建缺少的業務規則,以及設定相依性錄製,是不同的專案。適合某個起點的工具,到了另一個起點可能反而增加工作。
| 工具或方法 | 有用輸入 | AI 或自動化角色 | 執行與 CI 途徑 | 可審查的輸出 | 主要試用問題 |
|---|---|---|---|---|---|
| Postman Agent Mode | Collections、請求、回應、環境、規格 | 在工作區脈絡中草擬與編輯測試腳本 | Collection Runner 與相容的 CLI 工作流程 | 標準 Postman JavaScript 斷言 | 它是否保留你的變數並測試契約? |
| KushoAI | OpenAPI、Postman collection、cURL | 產生情境與測試套件;支援自然語言精修 | 平台執行與文件所述的 CI 整合;請確認權益 | 檢查產生的請求、相依性與預期結果 | 你選用的方案能否在你需要的位置執行並保留套件? |
| Keploy | 規格或請求定義;或真實流量 | AI 生成與另一條錄製/重播途徑 | 在支援的本機/CI 環境中執行生成的流程或錄製的測試 | 審查測試定義、基準與相依性 mock | 哪條途徑涵蓋你實際的失敗模式? |
| 既有執行器加 LLM | 已核可的矩陣、規格、fixture 慣例 | 草擬待審查的程式碼 | 你的 pytest 或其他既有執行器 | 提交至你儲存庫的程式碼 | 審查是否比直接撰寫相同測試更便宜? |
用於現有 Collections 的 Postman Agent Mode
當你的 collection 已包含有用的請求順序、環境變數與驗證設定時,Postman 是合理的首選評估對象。Agent Mode 可利用該脈絡產生標準 JavaScript 測試腳本。這些腳本可進入既有的 collection 執行工作流程,而不需要新的斷言語言。
聚焦的試用比要求它測試所有東西更能揭露問題。選擇該 collection 中,用來擷取稍早建立之資源的請求。提供其結構描述,並要求進行必填欄位驗證、文件所述的欄位型別,以及一項將傳回 ID 連到已儲存建立 ID 的斷言。
接著在接受的提案前先檢查。回應範例可能包含一隻叫 Milo 的寵物。如果你的 fixture 明確建立了 Milo,與 Milo 相等就有意義;如果產生器從共享範例記錄複製了名稱,這種斷言就很脆弱。同一個字面值可以是有效斷言,也可以是意外相依性,取決於其來源。
仔細檢查變數範圍。儲存在環境變數中的 ID,必須可供後續請求使用,且必須屬於該次執行。並行執行之間共用變數,可能造成間歇性失敗,看起來像伺服器缺陷。要求產生器解釋設定與清理,以及斷言。
第一次驗收測試時,請對隔離資料執行 collection 兩次,然後檢查匯出或版本化的表示。確認隊友不需要重複 AI 對話,就能審查變更過的腳本。同時確認你選擇的 CLI、報告器與方案支援你打算使用的執行途徑。
本文未展示實際操作的 Postman 生成。有用的評估問題是:其工作區脈絡是否能減少你對既有 collection 的審查工作。這需要你自己的 collection 與帳號層級試用,而不是從產品截圖得出的結論。
用於規格導向測試生成的 KushoAI
KushoAI 接受 Swagger/OpenAPI、Postman 與 cURL 輸入,並記錄測試生成、自然語言精修與 CI 執行。當團隊有可用的 API 定義,但有大量尚未撰寫的測試待辦時,這使其成為候選工具。這些是供應商描述的能力,不是實測的缺陷偵測結果。(KushoAI 文件,2026 年 9 月)
選擇具備最豐富可信脈絡的輸入。cURL 請求可以描述一個有效請求,但通常不太能說明選填欄位、允許的 enum 值或文件所述的錯誤。OpenAPI 檔案增加了結構;已核可的情境矩陣則增加了結構可能留下模糊空間的意圖。
進行 Petstore 試用時,要求分別針對有效寵物、缺少必填 name、型別錯誤的 ID,以及無效的 status 篩選條件建立案例。審查該工具是否區分請求主體要求與回應結構描述要求。這些在範例中可能看起來相似,但施加的義務不同。
接著檢查相連的建立-讀取-更新流程。讀取必須使用與目前設定相關聯的 ID。更新必須以相同資源為目標,之後的讀取必須驗證已變更的欄位。四個獨立請求搭配吸引人的測試名稱,並不能證明相依性鏈有效。
把第一次生成視為提案。保留有文件依據的預期,修訂資料流錯誤的腳本,並將規格不足的結果標記為待需求決策。如果工具建議多個等效的缺少欄位案例,保留有用的區別,而不是付費維護重複項目。
購買前,要求從你打算使用的 pipeline 執行套件,並檢查失敗產出物。確認所選方案目前的 CI 權限、認證處理與可用匯出格式。不要假設免費互動試用會授予與團隊部署相同的自動化權利。
用於生成測試與流量重播的 Keploy
Keploy 的文件提出兩條不同的起始途徑。AI 生成接受 OpenAPI、Postman、cURL 或端點等資源,並建構相連的 API 流程。錄製與重播會擷取 API 互動及其相依性,供日後搭配 mock 執行。AI 流程說明與相依性錄製說明不應被視為相同機制。(Keploy 文件,2026 年 9 月)
如果你的困難是重現應用程式對資料庫或上游服務做了什麼,請評估錄製途徑。在隔離環境中擷取一小段建立-讀取-更新旅程,檢查擷取到的相依性,並在受控的應用程式變更後重播。在規劃更大規模推行前,先確認 runtime 支援什麼。
如果你的困難是從規格推導案例,請另行評估生成途徑。詢問其提出的請求如何取得認證、如何在步驟之間傳遞 ID,以及如何清理資料。產品其他部分具備錄製功能,並不能回答生成套件的這些問題。
動態值需要判斷。時間戳記可能合理變動;資源 ID 可能連接兩個請求,因此需要比較。一概忽略每個變動欄位可能掩蓋錯誤。逐欄審查排除項目,並保留能表達有意義關係的比較。
接受基準前也要檢查。含有錯誤總數、意外 fallback 回應或過時資料的錄製,可能一致地重播。一致性有助於偵測變更,但團隊仍須決定擷取到的行為是否正確。
實用補充: Schemathesis 提供結構描述驅動的屬性導向 API 測試。它可搭配已審查的範例,以生成的輸入挑戰 API。請將其視為不同的測試機制,而不是 LLM 測試生成器的同義詞。其發現仍需依據契約與實作來解讀。
免費 AI API 測試工具:限制與成本
「免費」可以指用戶端、有限 AI 額度、開源執行器或臨時試用。這些方案涵蓋工作流程的不同部分。免費用戶端並不代表自動生成、排程執行或報告匯出也免費。
截至 2026 年 9 月 21 日查核,Postman 的 Free 方案列出 每月 50 個 AI 額度。額度是其計費單位;不代表 50 項測試或 50 個完整套件。其比較表區分 AI 額度與執行、資料驅動功能及結果匯出。(Postman 定價,2026 年 9 月)
KushoAI 目前的定價呈現使用 Developer Edition 與 Enterprise。Keploy 區分 Playground、Pro 與 Enterprise,以及其開源方案。請使用目前購買畫面確認相關限制。較舊的工具彙整文章可能描述已退場的方案名稱,或把分開計費的額度混在一起。
| 成本組成 | 試用時應記錄什麼 | 什麼會讓帳單造成誤導 |
|---|---|---|
| 席次與方案 | 編輯者、審查者、計費週期、必要功能 | 拿年度標示價格與每月承諾相比 |
| AI 生成 | 同一項已核可工作的額度用量,包括重試 | 假設一個額度等於一項測試 |
| 執行 | 本機執行、託管執行、CI 工作、排程、報告 | 把互動式執行視為允許所有自動化途徑 |
| 獨立模型 | 草擬與審查所用的輸入與輸出 token | 忽略重複提交完整規格 |
| 工程時間 | 審查、fixture 修復、失敗分類、維護 | 把初始生成時間當成總交付時間 |
用一項小型驗收工作估算成本。給每個候選工具相同的操作與預期,然後記錄有多少情境通過審查。將生成時間、人工審查時間與執行時間分開列欄。等待模型與修正危險斷言,對團隊造成的成本不同。
有用的分母是你的團隊願意保留、經審查且可執行的情境。這可避免產生大量冗餘案例的生成器,僅因輸出較長就顯得較便宜。記錄你移除的無依據案例,以及仍未解決的需求。
本文不聲稱有實測的省工百分比,也不比較付費方案吞吐量。那些數字需要以等效輸入進行受控試用。若要做購買決策,請納入一項實際的維護變更,例如新增必填欄位,讓估算涵蓋下一個 sprint 以及第一次示範。
AI API 測試工具:從 OpenAPI 到首次執行
使用真實 Swagger Petstore 專案的隔離本機執行個體。固定 commit d57941e8fe959e508796b27469b1e8bba73392dc;其規格宣告 OpenAPI 3.0.4 與應用程式版本 1.0.29-SNAPSHOT。請閱讀固定檔案,而不是獨立更新的公開示範。(Swagger Petstore 規格,2026 年 9 月)
1. 準備服務並記錄環境。 透過該來源頁面取得儲存庫,簽出固定修訂版,並安裝相容的 JDK 與 Maven。專案 README 提供從儲存庫目錄開始的啟動命令:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty 使用連接埠 8080。將 BASE_URL 設為該連接埠上你的 loopback HTTP 來源,並附加 /api/v3。在測試前,先確認相對於該 base 可讀取 /openapi.json。
本次執行使用 Temurin JDK 17.0.20.1、Maven 3.9.9、Python 3.12、pytest 9.1.1 與 jsonschema 4.26.0。也請記錄你的版本。原始碼建置會下載相依性與 Swagger UI,因此僅固定應用程式 commit 並不是完全封閉的建置。
2. 匯入固定規格。 選取 /pet、/pet/{petId} 與 /pet/findByStatus。保留 delete 以供清理。用你的本機 base 覆寫規格的公開伺服器位置。在傳送任何寫入請求前檢查此設定。
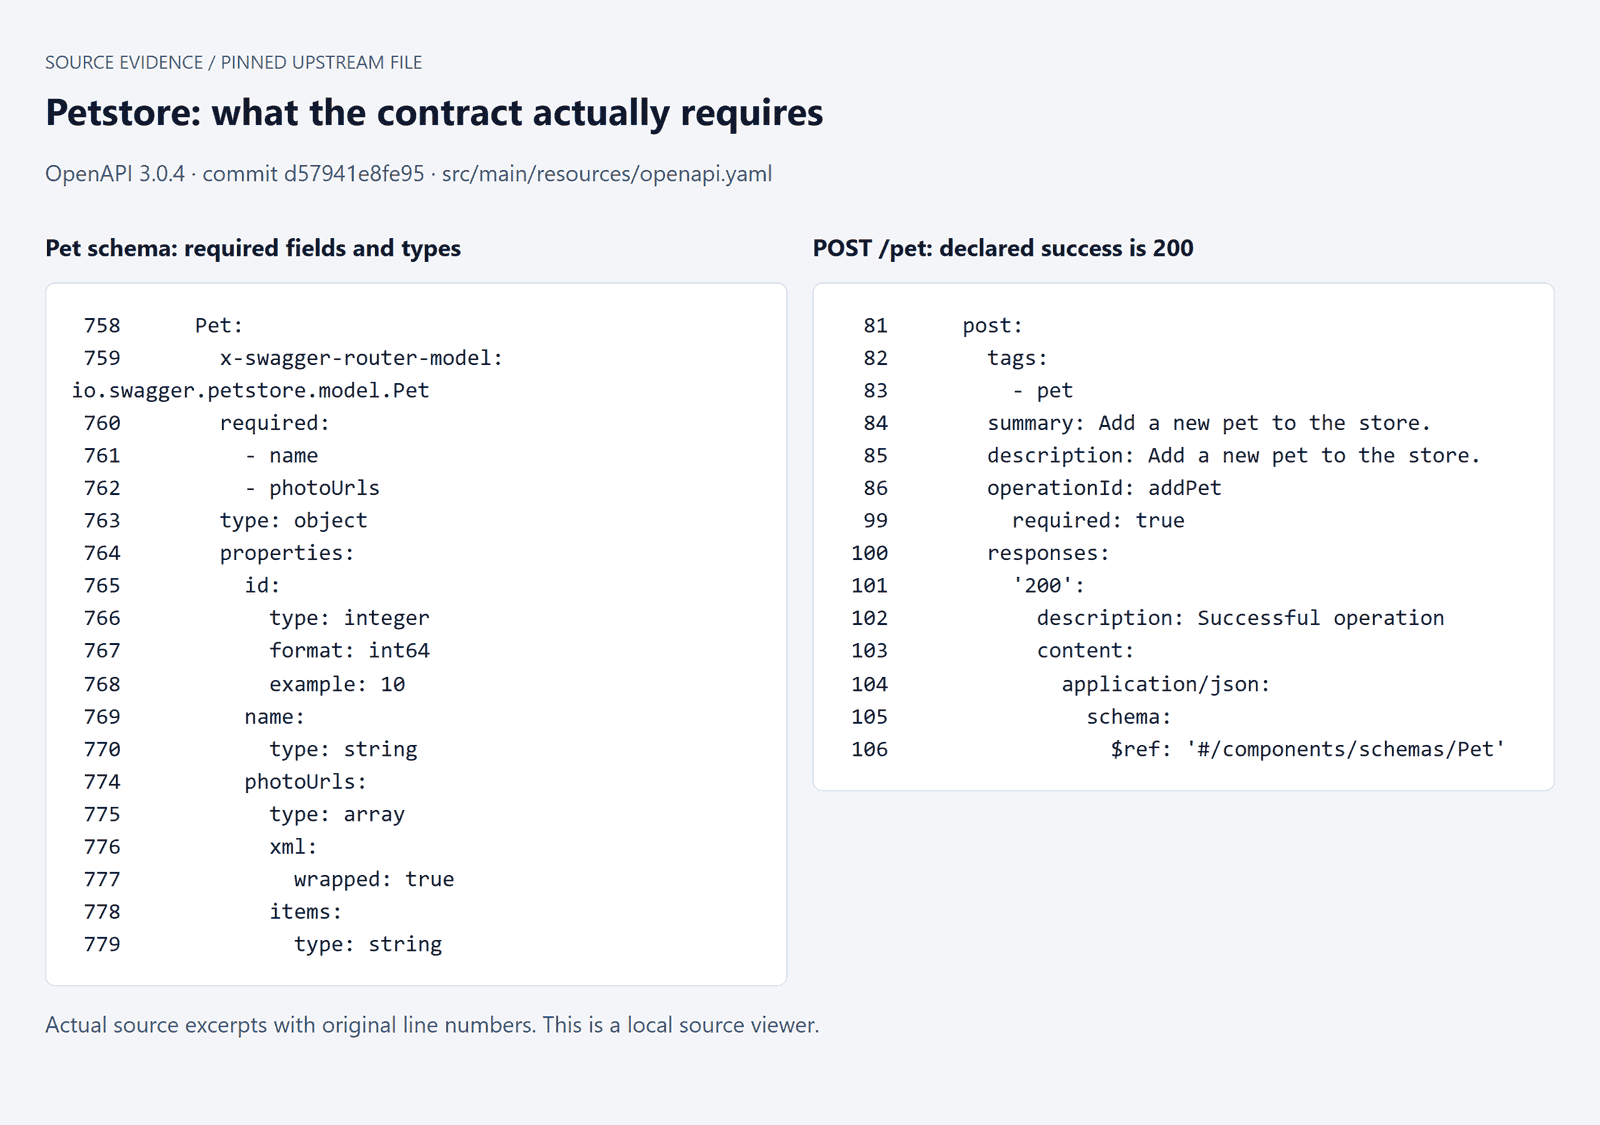 固定版 OpenAPI Petstore 原始碼,顯示必填欄位與選定的操作定義
實際在本機呈現的原始碼摘錄:Pet 需要 name 與 photoUrls;POST /pet 宣告成功時傳回 200。原始行號予以保留。
3. 在可執行程式碼之前生成矩陣(Prompt A)。 附上規格,並將此提示貼到你選擇的生成器:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. 審查每個情境的判定依據。 Petstore 將成功建立記錄為 200。其 Pet 結構描述要求 name 與 photoUrls;id 的型別是整數,但不在必填清單中。因此缺少欄位驗證與請求和回應身分需要使用不同的檢查。
| 操作 | 輸入或序列 | 預期結果證據 | 待審查斷言 | 執行狀態 |
|---|---|---|---|---|
| addPet、getPetById | 建立,然後讀取目前 ID | 文件所述的 200 與 Pet 結構描述;明確的流程預期 | 驗證主體並比較傳回的 ID | 本機通過 |
| updatePet、getPetById | 變更 name 後再次讀取 | 更新操作加上已核可的 fixture 意圖 | 相同 ID、新 name、有效結構描述 | 本機通過 |
| findPetsByStatus | 設定後查詢 available | 文件所述的 enum 與成功陣列回應 | 所有傳回的 status 都相符;建立的 ID 存在 | 本機通過 |
| getPetById | 非整數路徑 ID | 文件所述的無效 ID 400 | 此文件案例的確切狀態 | 通過:400 |
| findPetsByStatus | 未記載的 enum 值 | 文件所述的無效 status 400 | 確切狀態,保留任何不符 | 通過:400 |
| addPet | 省略必填 name | 必填結構描述欄位;400 與 422 說明並未對應每種變化 | 記錄行為;在設為門檻前解決確切對應 | 未帶 name 仍傳回 200;保留差異 |
5. 生成並檢查執行檔案(Prompt B)。 附上已核可的矩陣與規格,並使用此提示:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. 執行、保存與清理。 使用該次執行專屬的寵物 ID,擷取建立回應,並將其 ID 傳入後續請求。透過重新讀取驗證更新。僅有成功的更新回應,不能證明伺服器已保存變更。
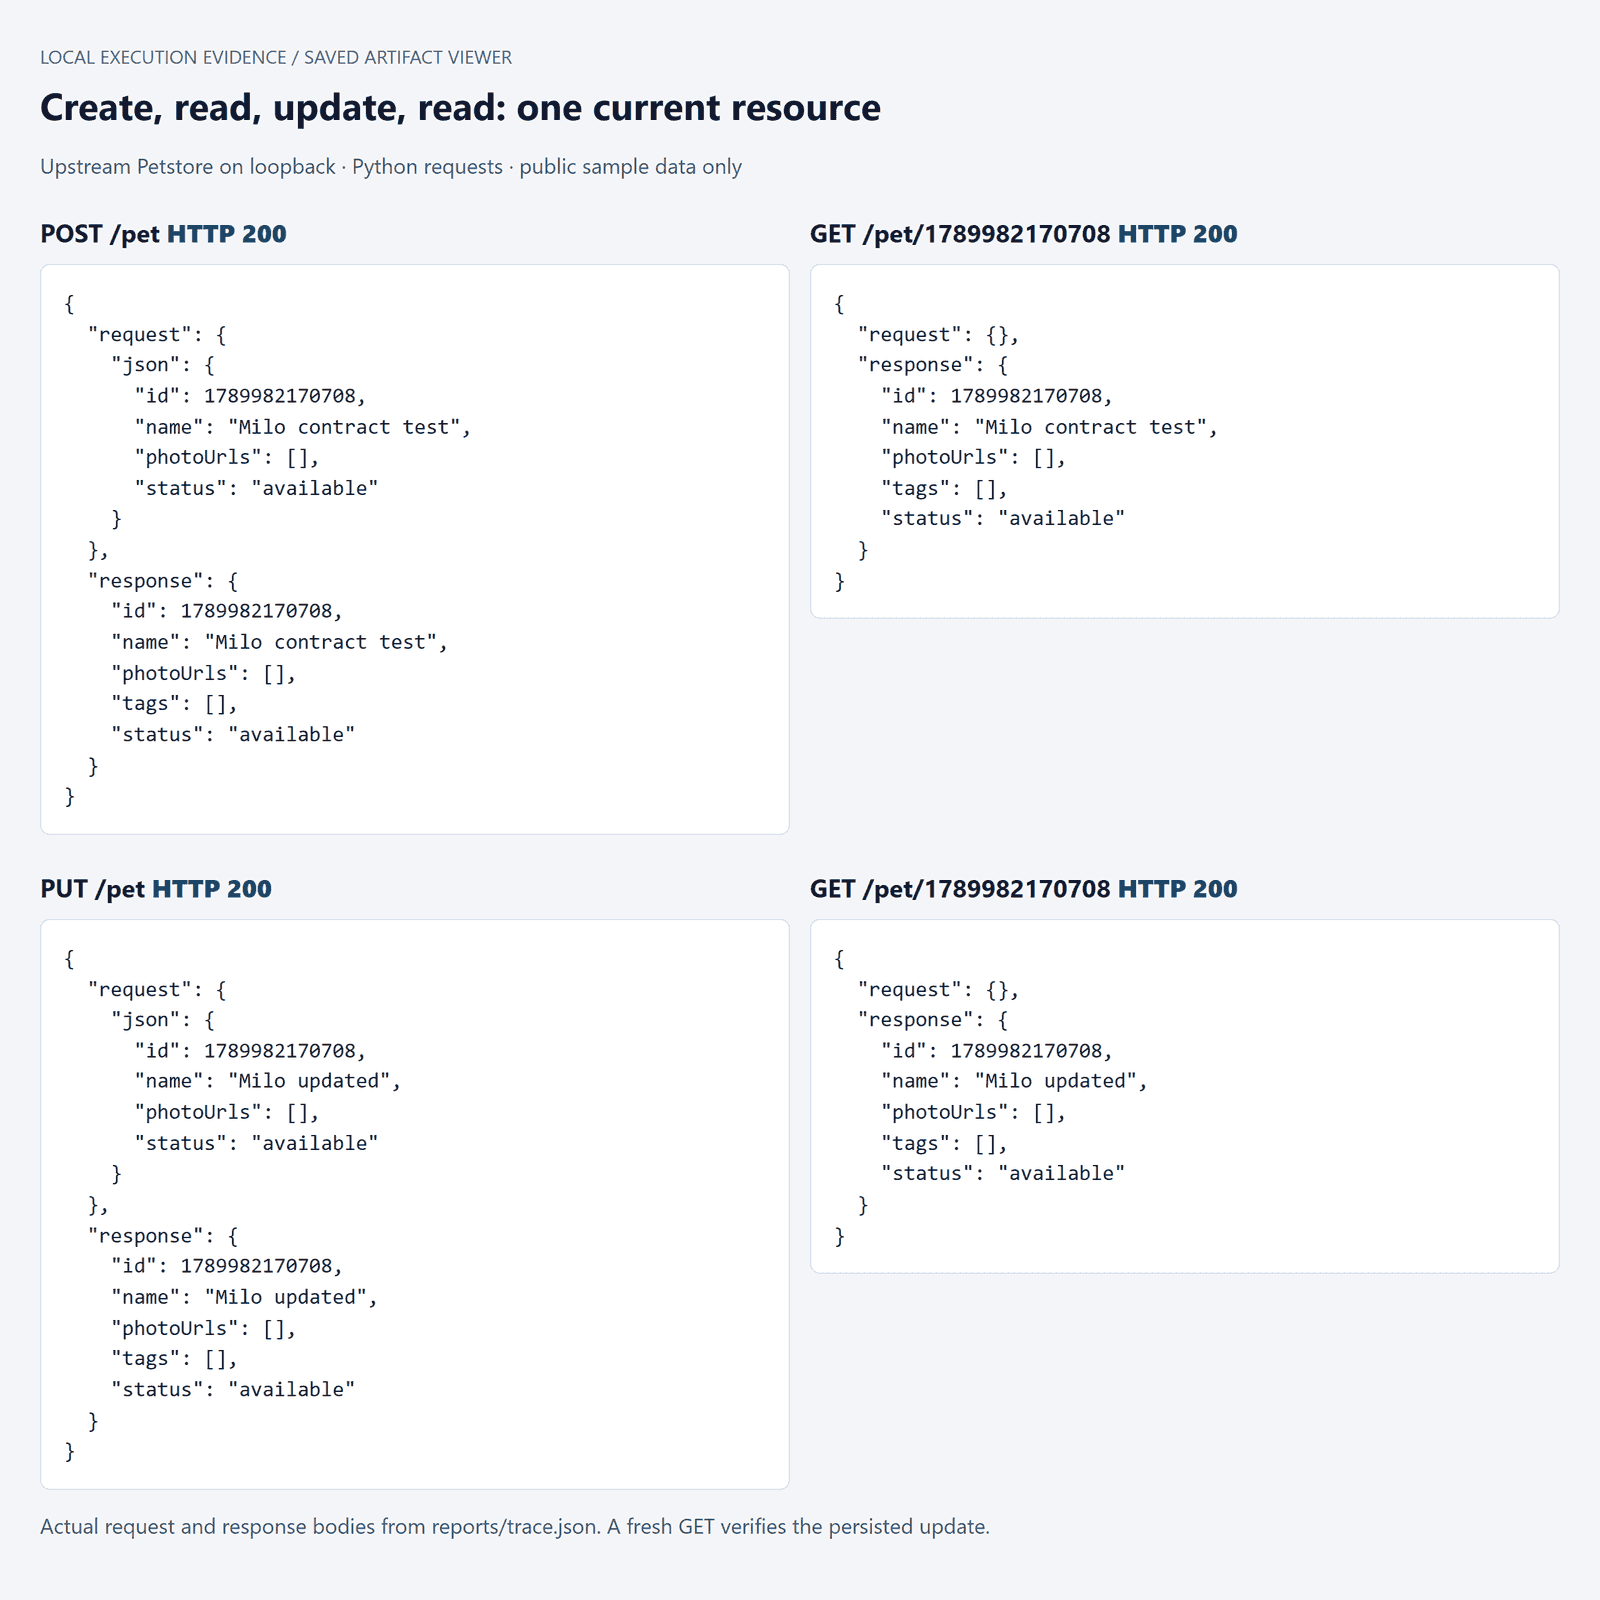 本機 Petstore 請求鏈證據,顯示建立、查詢、更新與 ID 傳遞
實際儲存的本機請求與回應:同一個執行專屬 ID 在建立、讀取、更新與重新讀取後仍存在。顯示的全部 4 個請求都傳回 200。
保存請求主體、回應、斷言失敗與清理結果。限制刪除範圍為本次執行建立的 ID。將非預期回應保留為發現,包括示範實作接受無效輸入的情況。不要只是為了取得綠色截圖而調整斷言。
本次執行發現: 5 個 live 測試函式通過,包括無效 ID 與無效 status 檢查傳回 400。另行進行的缺少 name 探測傳回 200,且主體沒有 name。我們將該結構描述差異保留在綠色套件之外;其確切預期錯誤對應仍需釐清。兩筆建立的記錄都成功刪除。
本機測試是在本文此次執行中草擬,獨立於三個商業工具。全部 5 個 live 測試都保留;執行後沒有任何測試被移除或放寬預期。人工審查時間未測量。證據資料夾包含測試檔案、相依性鎖定檔、原始回應與重現說明。
如何驗證 AI API 測試工具
有用的斷言應該能拒絕相關的錯誤答案。你可以在不變更執行中服務的情況下測試這項特性:保存一個真實的成功回應,複製它,並刻意一次修改一個欄位。這些是受控回應變異,不是生產環境漏洞,也不是完整的變異測試基準。
將原始狀態與主體保存在一起。先對未修改的回應執行驗證器,確認它接受基準。接著建立三個獨立副本。變更 ID、將 name 的型別改成數字,並移除必填的 name。每個副本都應因與該變更相符的原因而失敗。
| 儲存的基準 | 受控修改 | 相關檢查 | 實際結果 |
|---|---|---|---|
| 成功查詢目前寵物 | 替換成另一個整數 ID;保留狀態 200 | 傳回的 ID 等於本次執行預期的 ID | 失敗:預期與實際 ID 不同 |
字串 name | 將 name 替換成數字 | Pet 結構描述的字串型別 | 失敗:42 不是字串 |
存在必填 name | 移除 name | Pet 結構描述的必填清單 | 失敗:name 為必填 |
ID 範例暴露常見弱點。結構描述驗證器可能接受錯誤的整數,因為形狀仍然有效。關聯性斷言提供了缺少的限制。在其他兩個範例中,結構描述驗證提供了僅檢查狀態看不出的限制。
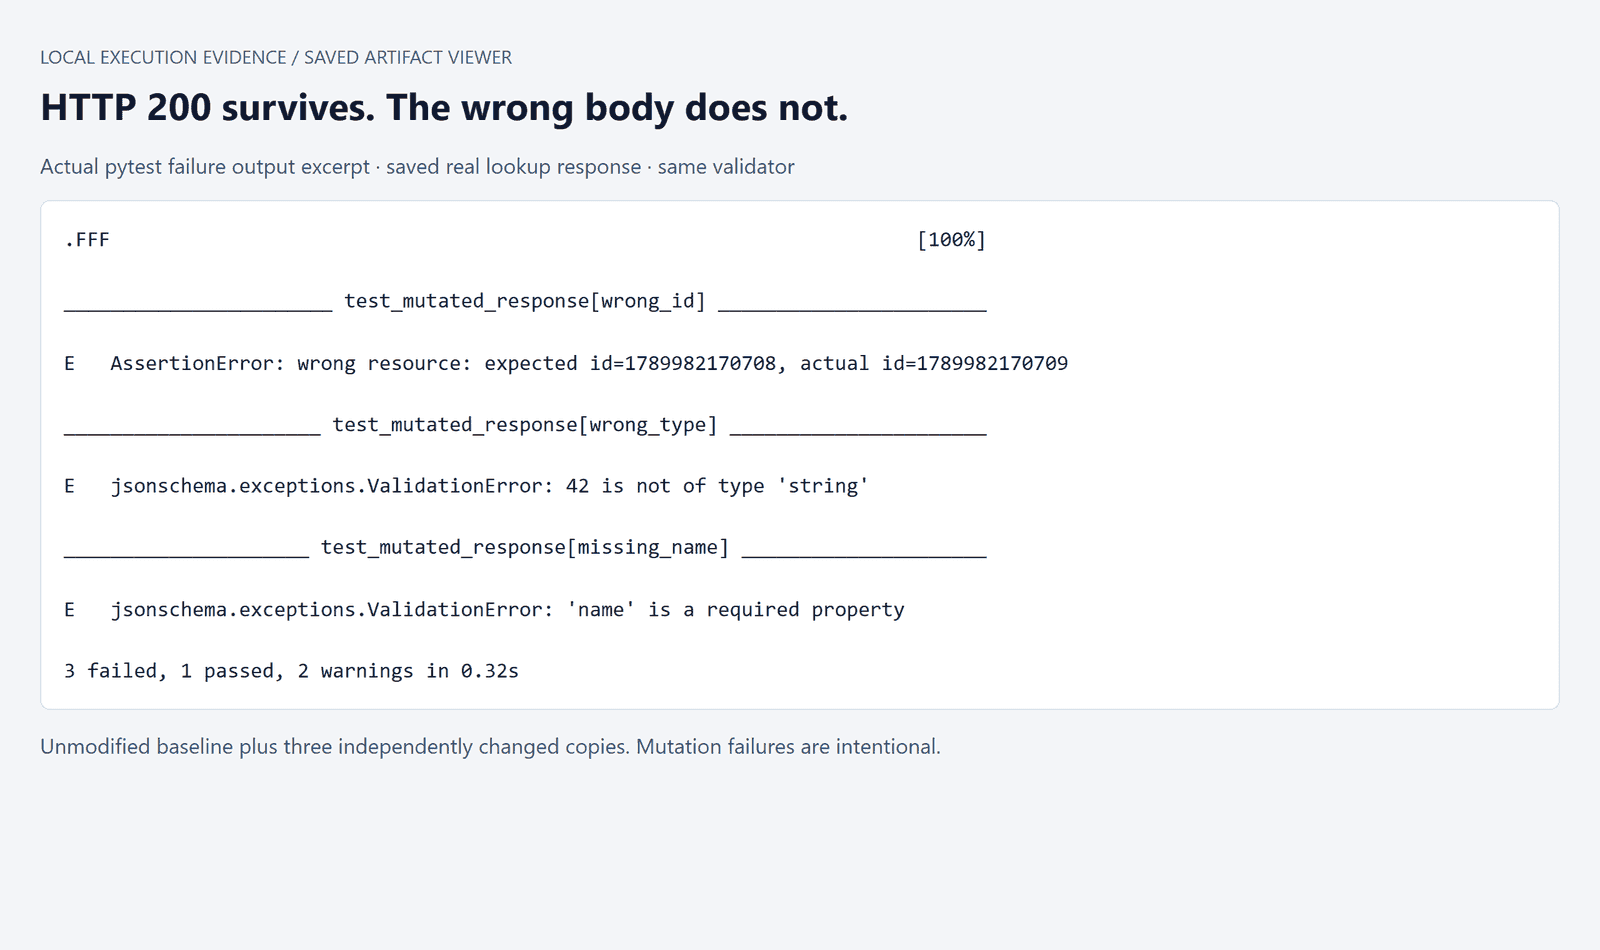 受控 Petstore 回應變異的實際斷言失敗輸出
實際 pytest 失敗摘錄:原始回應通過,且全部 3 個獨立變異都失敗。這些失敗是在儲存的副本中刻意誘發。
在本次執行中,未變更的基準通過,而 3 個中的 3 個 變更副本失敗。變異執行傳回結束代碼 1,保留失敗訊號。驗證器套用 Pet 結構描述的相關結構限制,以及獨立的 ID 關聯檢查;這個小型示範不是完整的 OpenAPI 符合性驗證器。
若要進行可重複的稽核,請將測試檔案與固定規格附到 Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
特別小心審查建議的「自我修復」變更。將預期的 400 替換成 200 可能隱藏回歸。合法的契約變更需要需求參考與已審查的測試變更。觀察到的回應是調查證據,不是自動允許重新定義正確性。
在要求 AI 修正前,先區分失敗類別。逾時可能表示環境無法使用。查詢失敗可能來自損壞的 fixture。匯入錯誤屬於測試程式碼。與已同意契約可重現的不符,可能屬於產品。保留足夠脈絡以區分它們。
誠實報告分母。偵測到三個選定的回應變更,證明對這三個變更有敏感度。它不能確立端點涵蓋率、程式碼涵蓋率、安全性涵蓋率或一般缺陷偵測率。同樣地,大量測試數量對重複情境或其斷言強度說明不多。
在適合的應用程式中,驗證與授權值得獨立測試:缺少認證、過期認證,以及存取另一位使用者的資源。Petstore 的示範行為不能確立你的生產環境存取控制有效。
CI/CD 中的 AI API 測試工具
一旦審查者接受套件,就提交該確切版本。建置應對候選應用程式執行已知預期。每次建置都重新生成測試會引入另一個變動元件,讓失敗更難重現。
固定執行器、相依性、fixtures 與規格。將相依性鎖定檔與測試一起儲存,並在報告中保留應用程式修訂版。從 CI 環境解析機密,將其排除在生成檔案之外,並檢查失敗記錄不會暴露它們。
使用 pytest 時,基本報告形式很簡單:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
透過 job 環境提供 BASE_URL。在 job 生命週期中啟動本機服務,等待就緒,然後執行套件。一律收集報告與服務記錄,即使失敗也一樣。最後停止 job 自己的服務並清理其資料;避免在共享代理上使用全程序清理命令。
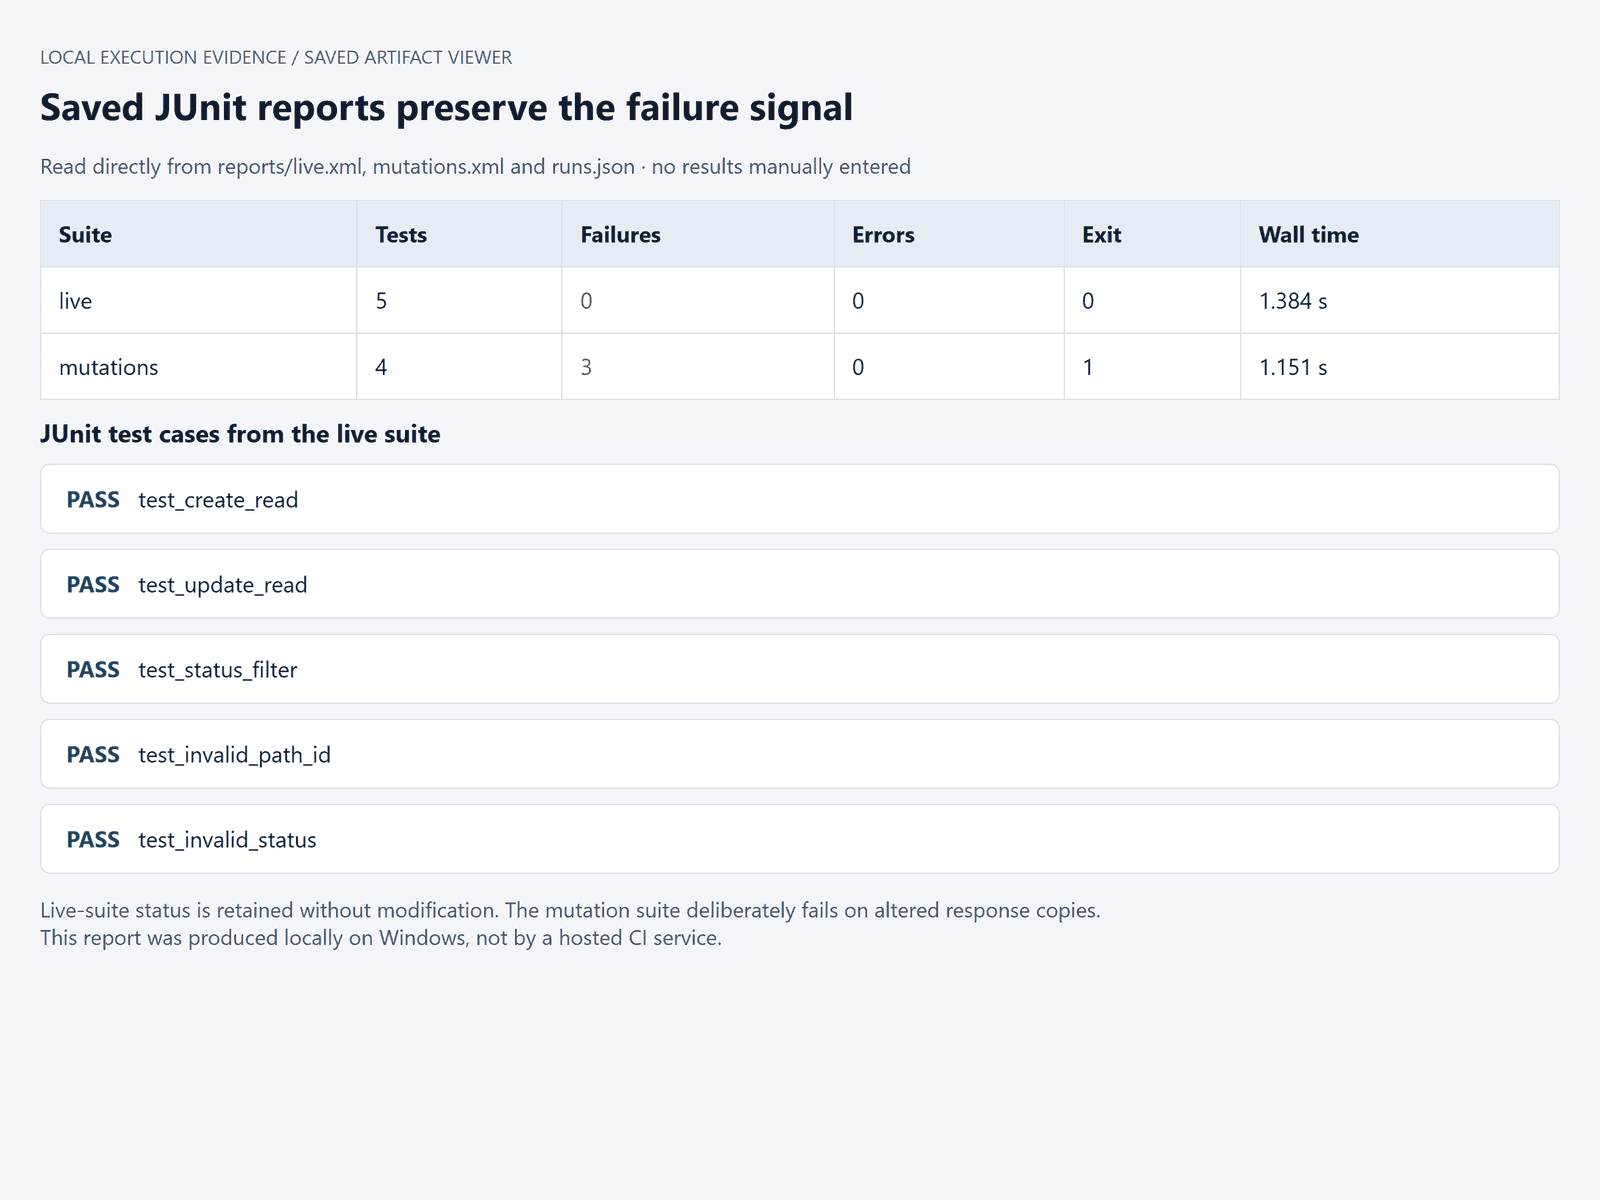 本機 pytest JUnit 報告,含分開的 live-contract 與 assertion-check 結果sActual local
JUnit 結果:5 個 live 測試通過;受控副本套件包含 1 個通過的基準與 3 個刻意失敗。未聲稱有託管 CI 執行。
量測到的 wall time,包括 Python 程序啟動,live 套件為 1.384 秒,受控副本套件為 1.151 秒。這些不包含服務建置/啟動、相依性安裝、草擬與審查。JUnit 檔案與未刪節記錄分開保存。
在依賴 gate 前先測試失敗路徑。失敗的斷言必須產生失敗的 job 結束代碼。重試應有界限,且對已知基礎設施暫時性問題有正當理由;反覆重試最終掩蓋產品失敗,會讓 gate 資訊量降低。
明確處理清理失敗。讓主要斷言失敗保持可見,記錄哪個資源仍存在,並讓 teardown 報告自己的問題。平行 job 需要獨立的識別碼或命名空間。單獨執行會通過、但讀取另一個 job 資料的測試,尚未準備好無人看管使用。
如果你已經有 pytest,可以另行選擇草擬模型。 Atlas Cloud 適合這個較窄的角色:為自訂工作流程提供模型層,而該工作流程的執行與報告已經存在。本文不將其呈現為完整的 API 測試平台,或上述三個產品的原生後端。
就該評估而言,開啟 DeepSeek V4.1 Flash,模型 ID deepseek-ai/deepseek-v4.1-flash,並提供與本機使用相同的公開規格與已審查矩陣。使用 Prompt B,然後將傳回的草稿與已審查測試分開保存。在執行任何內容前,將其假設與契約相比較。
若介面提供,溫度 0.2 是草擬的起始設定,不是確定性保證。檢查可用輸出限制與你的套件大小。請查閱目前模型目錄以取得 token 定價,而不是根據舊文章編列預算。
工作分工仍然明確:模型提出程式碼,審查者核可預期,執行器產生結果。本文的測試環境存取 gate 阻擋了完成 Atlas 執行,因此這是評估配方,而不是實測模型結果。你可以評估這條途徑,而不必遷移可用的測試執行器,或將其執行責任交給聊天模型。
為你的團隊選擇 AI API 測試工具
選擇能改變你決策的最小評估。使用一個相連工作流程、一個有文件依據的負面案例,以及幾個受控錯誤回應。讓各候選工具的輸入維持等效。精美的入門體驗不應勝過無法辨識錯誤資源的測試。
對於成熟 collection 工作流程,先評估該工作區中的 AI 功能。既有環境設定與請求相依性是有價值的脈絡。衡量生成的變更是否節省審查工作,且不引入脆弱假設。
對於有扎實規格與撰寫待辦的團隊,評估規格導向生成。注意規格不完整時會發生什麼。能清楚標示缺少預期的生成器,比自信地發明預期的生成器更容易審查。
對於失敗取決於上游行為的應用程式,評估錄製與重播。在投入大型錄製前,檢查擷取的基準與相依性支援。決定哪些動態欄位可以變動,哪些關係必須保持不變。
對於有穩定執行器的團隊,評估獨立模型用於草擬與審查。你保留已經熟悉的執行格式,但也承擔整合、fixture 設計與維護。將這份責任納入成本計算。
在為 AI API 測試工具付費前,要求五項具體示範:
- 經審查的套件能在你打算使用的環境中執行。
- 相關的受控錯誤會讓適當的斷言失敗。
- 測試與有用的報告能以可接受的格式保留。
- 重複執行(包括 CI 執行)能保持隔離與失敗訊號。
- 生成、執行與維護成本符合團隊預算。
指派人員維護已接受的套件。規格變更應觸發對受影響斷言、fixtures 與消費者的審查。在變更被理解前,保留舊的失敗證據。這會讓下一次發布更容易評估,並給團隊理由信任綠燈報告。
常見問題
我該使用哪個 AI 工具進行 API 測試?
從你既有的輸入開始。針對既有 collections 評估 Postman Agent Mode,針對規格導向生成評估 KushoAI,並針對其獨特的生成流程與錄製途徑評估 Keploy。如果你的團隊已經維護 pytest 或其他執行器,另行使用草擬模型可能適合。用相同的小型工作流程評估每個候選工具的斷言、執行與審查工作。
有免費的 AI API 測試工具嗎?
有免費用戶端、開源測試工具與有限 AI 額度。它們涵蓋不同需求。截至 2026 年 9 月 21 日,Postman 的 Free 方案列出每月 50 個 AI 額度;那不是測試數量。在把互動式試用視為免費 CI 解決方案前,先檢查你需要的匯出、自動化、報告與協作功能是否包含在內。
AI 可以從 OpenAPI 規格生成 API 測試嗎?
可以,生成器可使用操作、結構描述、參數與回應定義來提出測試。規格仍可能省略業務規則,或讓錯誤對應保持模糊。提供已核可的預期並審查結果。在固定版 Petstore 範例中,成功建立記錄為 200,說明為何熟悉的 REST 慣例不能取代實際契約。
我要如何知道 AI 生成的斷言是否有用?
檢查三件事:有文件依據的結構描述限制、請求與回應之間的關係,以及對刻意錯誤資料的敏感度。保存真實回應,修改一個相關屬性,然後重新執行相同驗證器。保留失敗訊息。這會為那些斷言提供狹窄、可重現的證據,同時將更廣泛的涵蓋率與安全性問題留待另行測試。
我可以在 CI/CD 中執行 AI 生成的 API 測試嗎?
可以,只要生成的格式、執行器、環境與方案支援該途徑。提交經審查的測試、安裝固定相依性、使用隔離 fixtures,並匯出結構化報告,例如 JUnit。確認失敗會傳回非零結束代碼。本機執行成功可讓套件準備進入 CI;並不證明託管 pipeline 已執行。
AI 可以取代手動 API 測試嗎?
AI 可以減少重複草擬,並協助審查者找出薄弱斷言。人們仍需決定預期行為、調查模糊失敗,並探索所提供範例之外的風險。使用 AI API 測試工具產生可審查的測試資產,然後以可重現證據評判。能捕捉有意義錯誤的較小套件,比無法解釋的一堆綠色檢查更容易信任。


