

一套服裝構想可能聽起來完美,直到你想像自己穿著它四小時。帽子遮住你的臉。披風拖在地上。那個巧妙道具需要占用你原本打算拿手機的手。AI 萬聖節服裝 預覽能幫你在想法還容易修改時發現這些問題。先從一張清楚、全身的照片開始,在同一人身上測試幾套服裝,然後選擇你真的能組裝、也能活動自如的版本。生成的圖片是供檢視的概念,不是尺寸表,也不是服裝合身度的保證。
重點摘要
- 每套造型都使用同一張全身照、相同姿勢與背景,這樣你比較的是服裝,而不是相機把戲。
- 描述真實的衣物層次與簡單配件。請生成器讓你的臉、比例與身體位置保持可辨識。
- 對結果做兩次判斷:先當成圖片,再當成一份你能穿、能拿或能製作的物品清單。
- 購買或製作前,檢查實體服裝是否合身、視線是否清楚,以及防火安全。
先決定你需要哪一種服裝答案
AI 萬聖節服裝生成器可以回答三種不同問題。它可以憑空創造一套服裝、把提案服裝顯示在特定人物身上,或協助你修改已經喜歡的設計。這些是不同的工作。如果你一次要求全部三項,結果可能很吸睛卻難以使用:人物變了、服裝多了不可能存在的部件,而且之後也沒有明確的決定可做。
| 你的問題 | 最佳起點 | 有用的輸出 | 它無法證明的事 |
|---|---|---|---|
| 我可以打扮成什麼? | 用文字描述你的時間、衣物與偏好的氛圍 | 一個服裝概念或簡短方向清單 | 它是否適合你的臉或身材 |
| 這穿在我身上可能看起來如何? | 一張光線良好的全身照 | 同一人物身上的視覺服裝預覽 | 實際尺寸、布料觸感或舒適度 |
| 我要如何改進這個版本? | 你的照片加上第一個生成結果 | 針對某件衣物或配件的修改 | 看不見的接縫或閉合處是否能運作 |
當你搜尋 AI 生成的萬聖節服裝 時,這個區別很重要。許多吸引人的結果其實是角色肖像。角色肖像可以啟發派對照片,但如果服裝依賴漂浮裝飾、看不見的固定件或拖地長襬,它就不是好的購物指南。為了做出服裝決定,請先要求工具在普通光線下顯示整套服裝,再要求戲劇化場景。
下面三種造型就是為這類決定而設計。它們使用同一人、同一相機角度與同一純色背景。衣物會改變;比較條件保持不變。你可以把結果並排放置,問一個有用的問題:哪個輪廓與零件清單值得帶進現實世界?
從生成器真的能用的照片開始
選一張能顯示你從頭到鞋子的照片。自然站立,手臂周圍留一些空間,並確保你的頭髮、臉與目前穿著的衣物都看得見。素面牆或整潔的房間能幫助模型把你的身體與背景分開。這裡均勻光線比陰森的萬聖節燈光更有用,因為你需要檢視服裝的形狀。鏡子自拍可以用來預覽頭飾,但手機遮住你的軀幹會讓整套服裝預覽的資訊量變少。
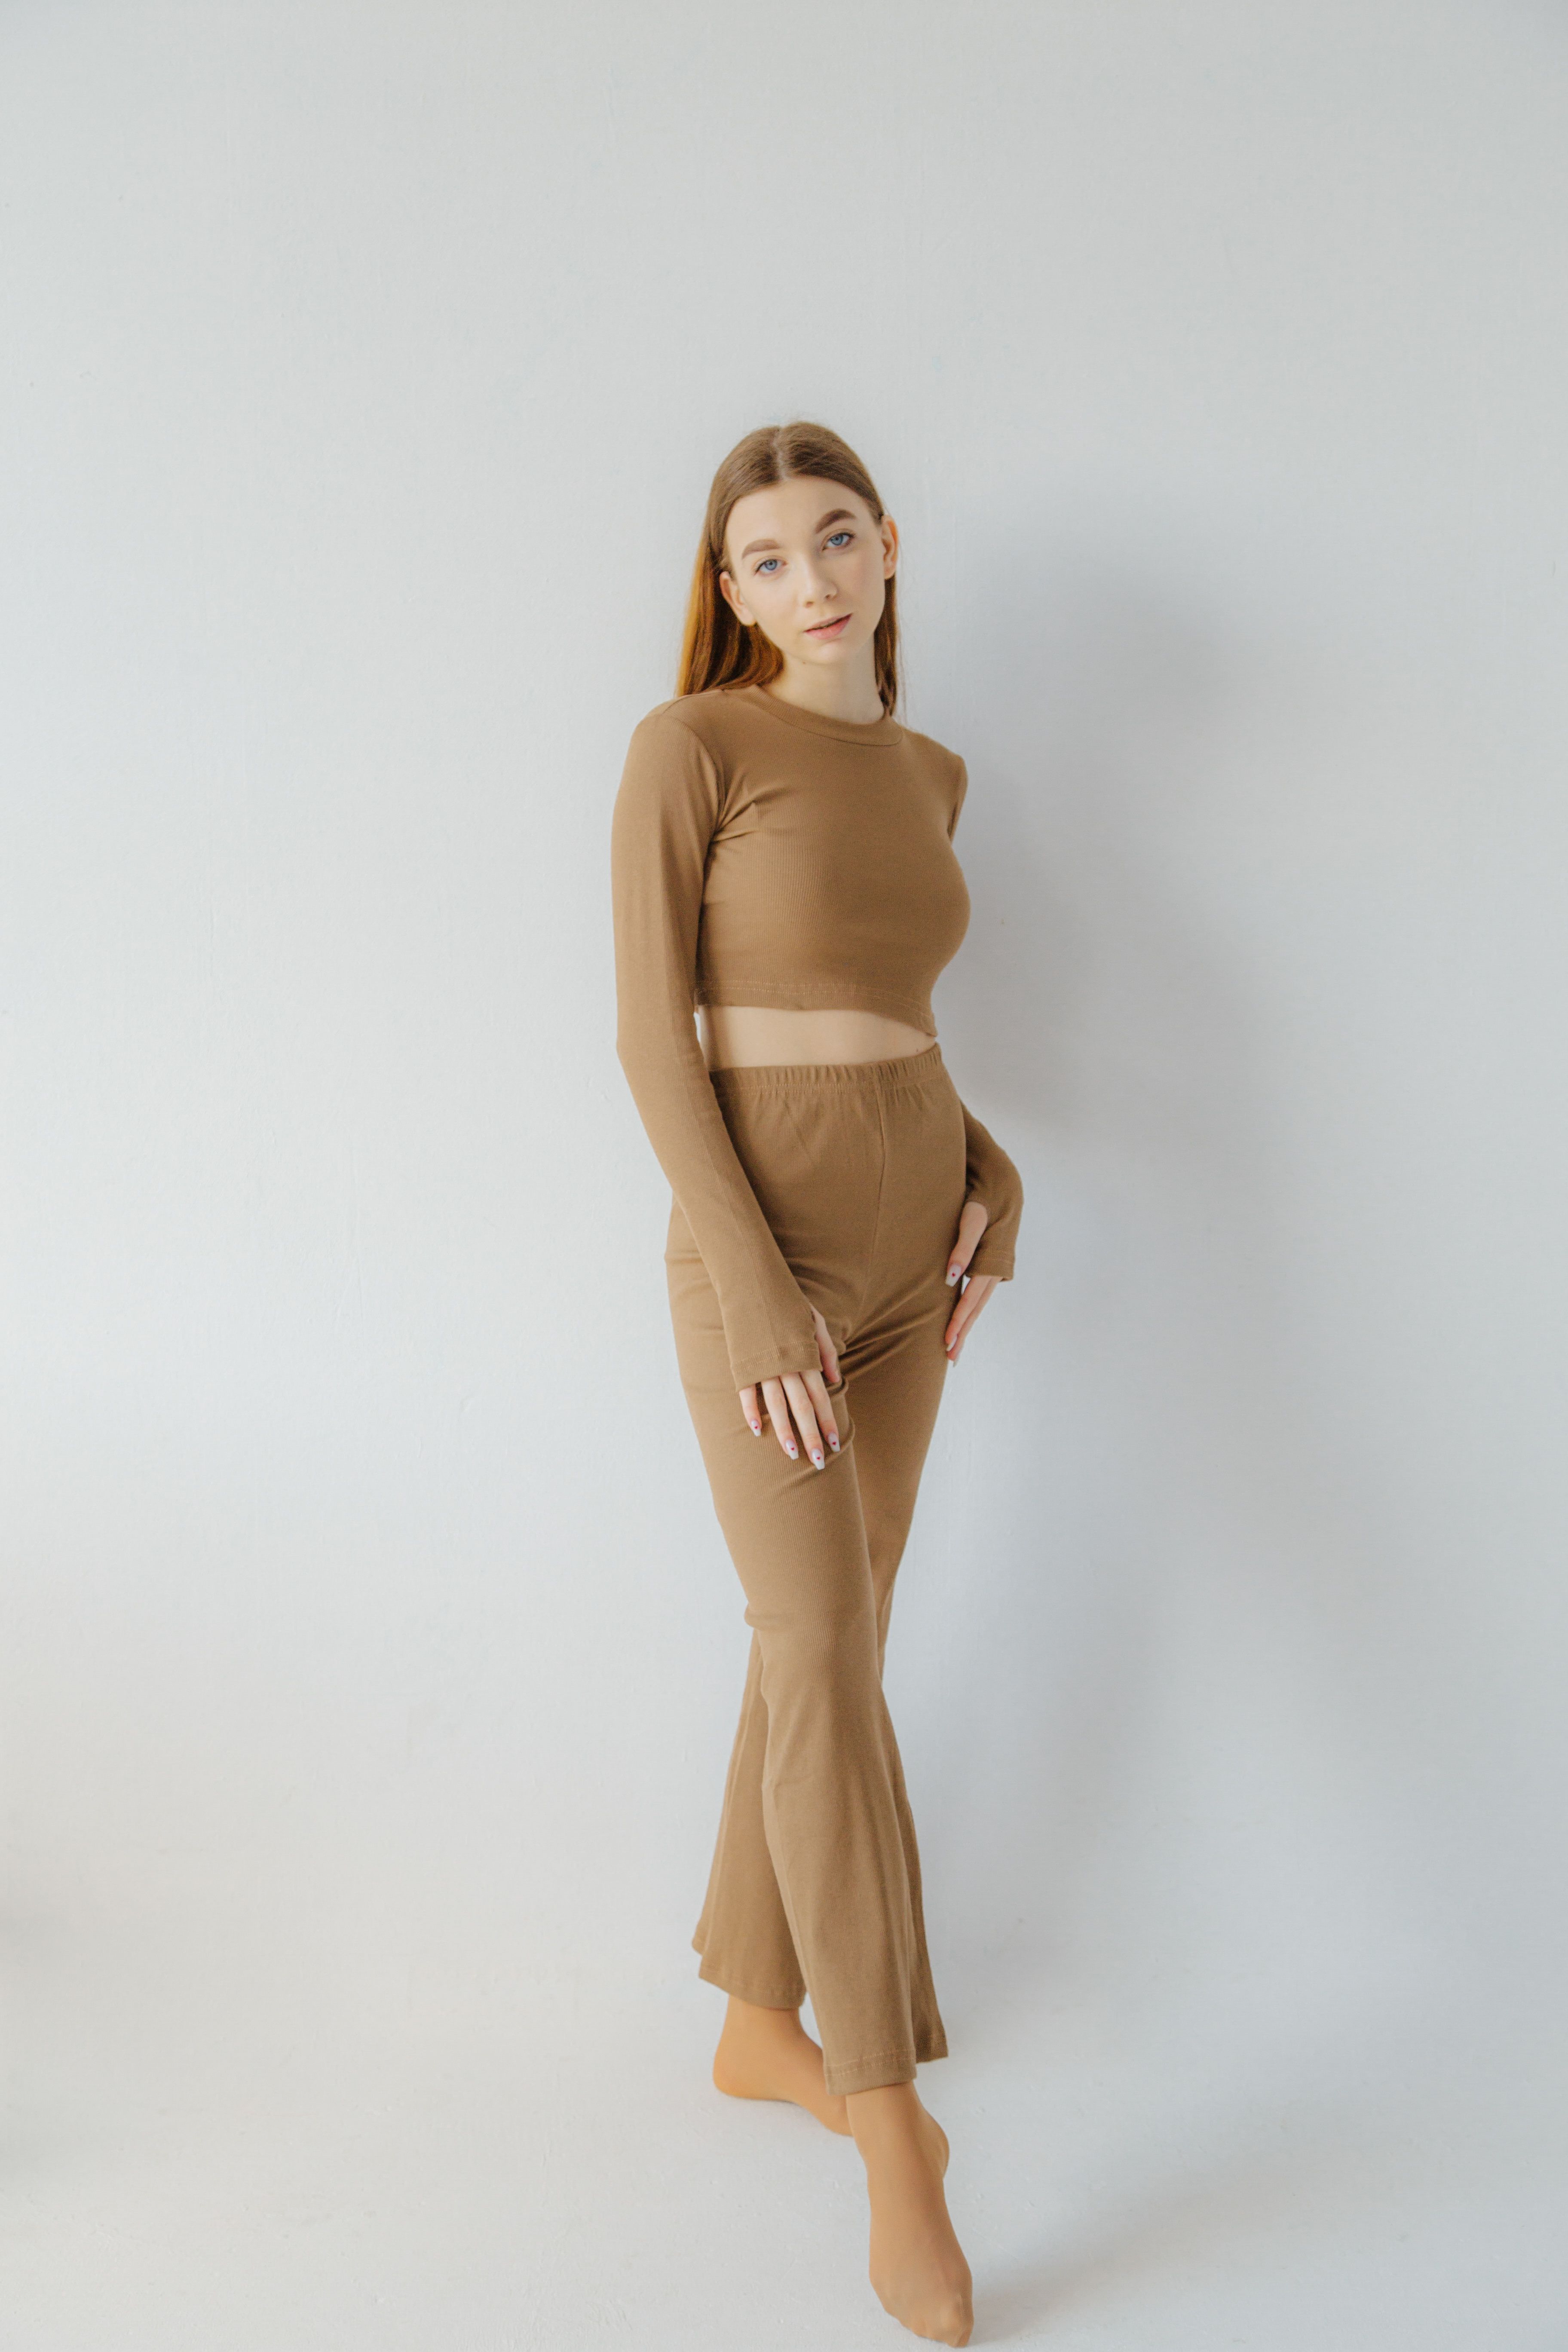
一張全身參考照能讓人物、姿勢與背景在三種造型之間保持一致。
如果服裝需要夥伴,請上傳一張包含兩人的照片。告訴模型確切人數,以及每個人站的位置。若是單人比較,每個造型都使用同一張來源圖片。在不同提示之間更換來源照片會改變姿勢、裁切與光線,這樣服裝就不再是唯一變數。請使用你擁有,或已獲授權可編輯與分享的照片。
打開影像工具前,先寫下你真正的限制條件。你的衣櫃裡已經有哪些單品?你會走到戶外嗎?你需要坐下、跳舞或拿東西嗎?有你不會戴的帽子、面具或臉部彩繪嗎?這些細節會讓 線上萬聖節服裝設計 比籠統的「把我變得陰森」要求更有用。你可以把它們放進提示中,而不是之後才試著修補不切實際的結果。
好的預覽提示包含四個部分:要保留的人物、要更換的衣物、你需要的視角,以及要避免的事物。「保留我的臉與站姿;只替換我的服裝;以同一面牆為背景顯示全身;不要有漂浮部件」會比「把我變成女巫」給生成器更狹窄的任務。等服裝本身合理之後,你仍然可以要求氛圍。
在同一人身上試三種不同造型
這些是起點,不是每個人都該穿的服裝清單。每個提示對時間與材料有不同要求:一個以衣櫃單品為基礎的經典造型、一個手工製作的角色,以及一個用常見外套打造的趣味造型。三種都上傳 同一張全身照。分別生成每個結果,並保持原始取景,這樣你比較的是服裝,而不是場景。
1. 能用衣櫃單品打造出現代女巫
這個版本要求普通的黑色層次穿搭、低筒鞋,以及兩個可拆卸的重點配件。帽子提供可辨識的輪廓,而圍巾與別針帶來色彩,又不需要複雜的洋裝。如果輸出擅自加上飄逸披風,就偏離了實用需求。先要求更短的衣襬,再決定這個概念是否可行。
plaintext1Edit my uploaded full-body photo into a practical modern-witch Halloween costume. Keep my 2recognizable face, skin tone, hairstyle, body proportions, standing pose, and the same plain 3background. Change only the outfit: a black long-sleeved top, straight black trousers, a 4deep-plum scarf, low black shoes, a soft felt wide-brim hat, and one small crescent pin. 5Every piece should look wearable and separately removable. Show me head to shoes in even 6studio-like light so I can judge the silhouette. No broom, cape, floating objects, mask, 7text, extra people, or altered hands.
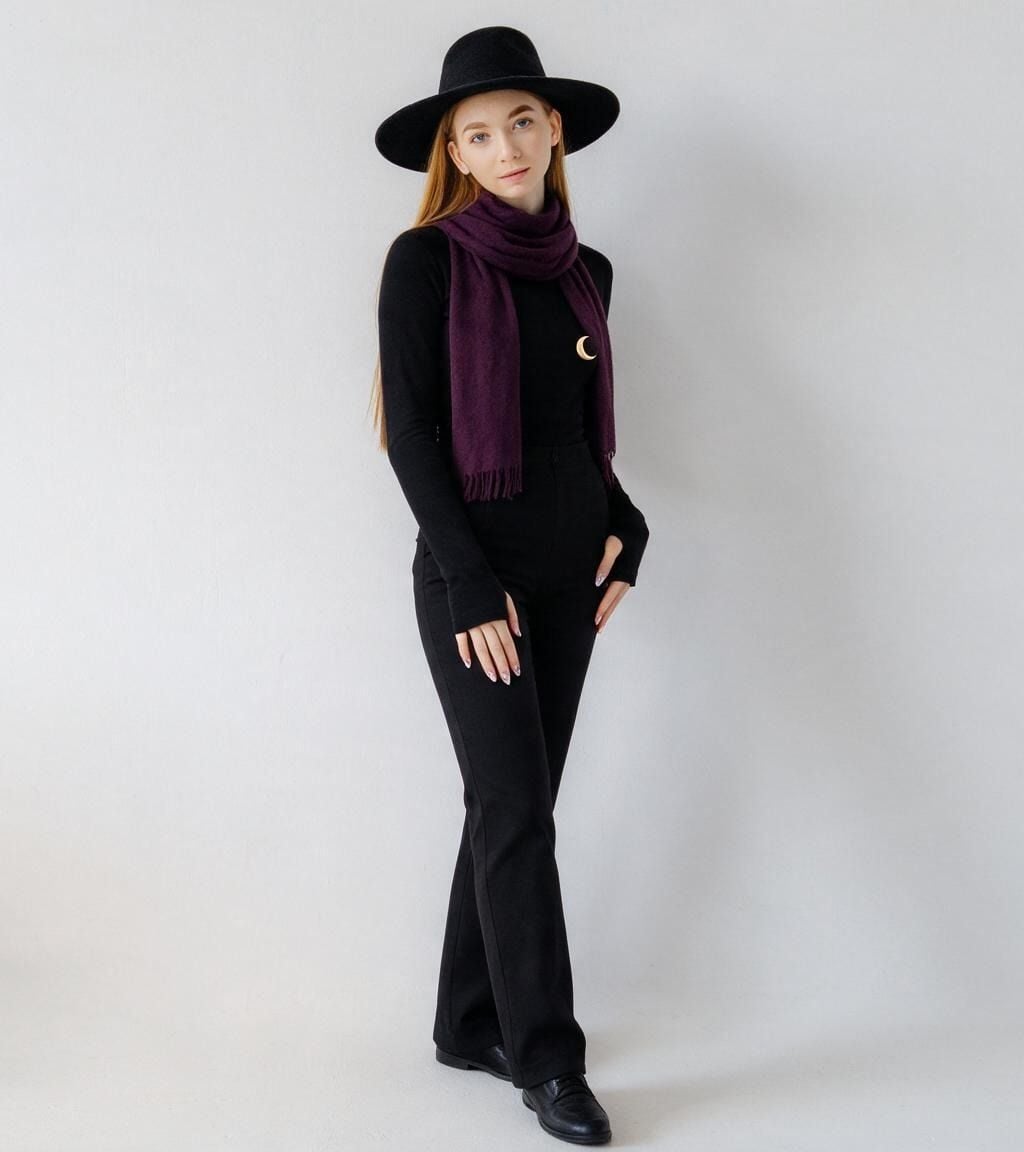
帽子、圍巾與新月別針在與參考照相同的純色背景下清楚可見,讓這套服裝更容易與其他造型比較。
有用的測試不是圖片看起來是否充滿魔力。看看帽子相對於你肩膀的大小、圍巾是否遮住你的臉,以及這套服裝是否能由你已經擁有的物品組成。好的第一版結果仍可能無法通過其中一項檢查。
2. 帶有手工細節的月光植物學家
植物學家保留熟悉的外套加長褲輪廓,但加入你可以自行固定的小型布料細節。它比女巫更能測試手工投入程度:葉子需要落在接縫或口袋上,胸針也需要有真正可固定的位置。當 AI 圖片顯示沒有可見固定方式的裝飾時,把它當成草圖,而不是指令。
plaintext1Use the same uploaded full-body photo as the identity and pose reference. Keep my face, skin 2tone, hairstyle, body proportions, camera angle, and plain background unchanged. Replace my 3clothing with a wearable moonlit-botanist costume: an olive utility jacket over a dark 4shirt, straight black trousers, practical flat shoes, a narrow belt, a few fabric leaf 5appliqués sewn to the jacket cuffs and pocket edges, and one small felt moth brooch pinned 6to the lapel. The costume should be easy to move in, with no trailing fabric. Show the full 7outfit in even light. No plants growing from the body, floating leaves, glowing effects, 8mask, text, or extra people.
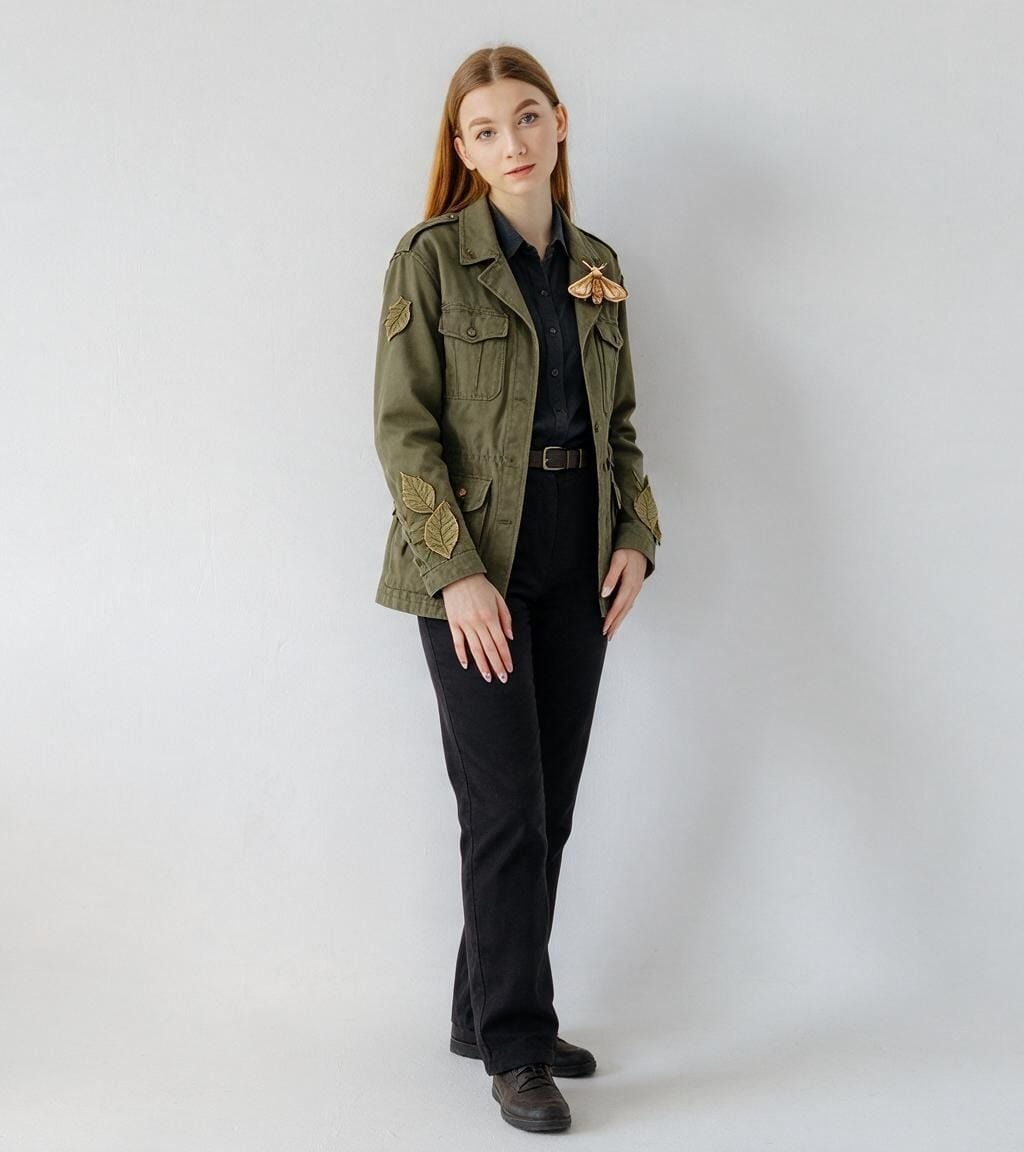
葉子細節位於外套袖口,飛蛾胸針位於翻領,因此圖片顯示了手工部件會固定在哪裡。
用同樣的問題把這個輸出與女巫比較。哪些部件已經有現成的?哪些細節需要花一個晚上製作?如果答案取決於數十個微小裝飾,就簡化設計。當 AI 能幫你刪減工作量,也能加入視覺想法時,它才真正有用。
3. 帶著一個醒目道具的風暴記者
這個造型以雨衣與靴子為基礎,因此成功與否較不取決於剪裁,而更取決於清楚、安全的配件。輕量雲朵髮箍與布料雨滴能說明笑點,又不會遮住臉。紙板麥克風能讓角色更容易被讀懂,但應該小到容易攜帶。
plaintext1Edit the same uploaded full-body photo into a playful storm-reporter Halloween costume. 2Preserve my recognizable face, hair, skin tone, body proportions, standing pose, camera 3height, and plain background. Dress me in a navy raincoat that ends above the knees, dark 4trousers, practical rain boots, and a blue scarf. Add a lightweight foam-cloud headband with 5a few short fabric raindrops attached securely above my hair, plus one small cardboard 6microphone in my right hand. Keep my face and eyes unobstructed, the left hand free, and all 7pieces physically wearable. Show head to shoes in even light. No real lightning, floating 8clouds, long cords, logos, writing, extra hands, or extra people.
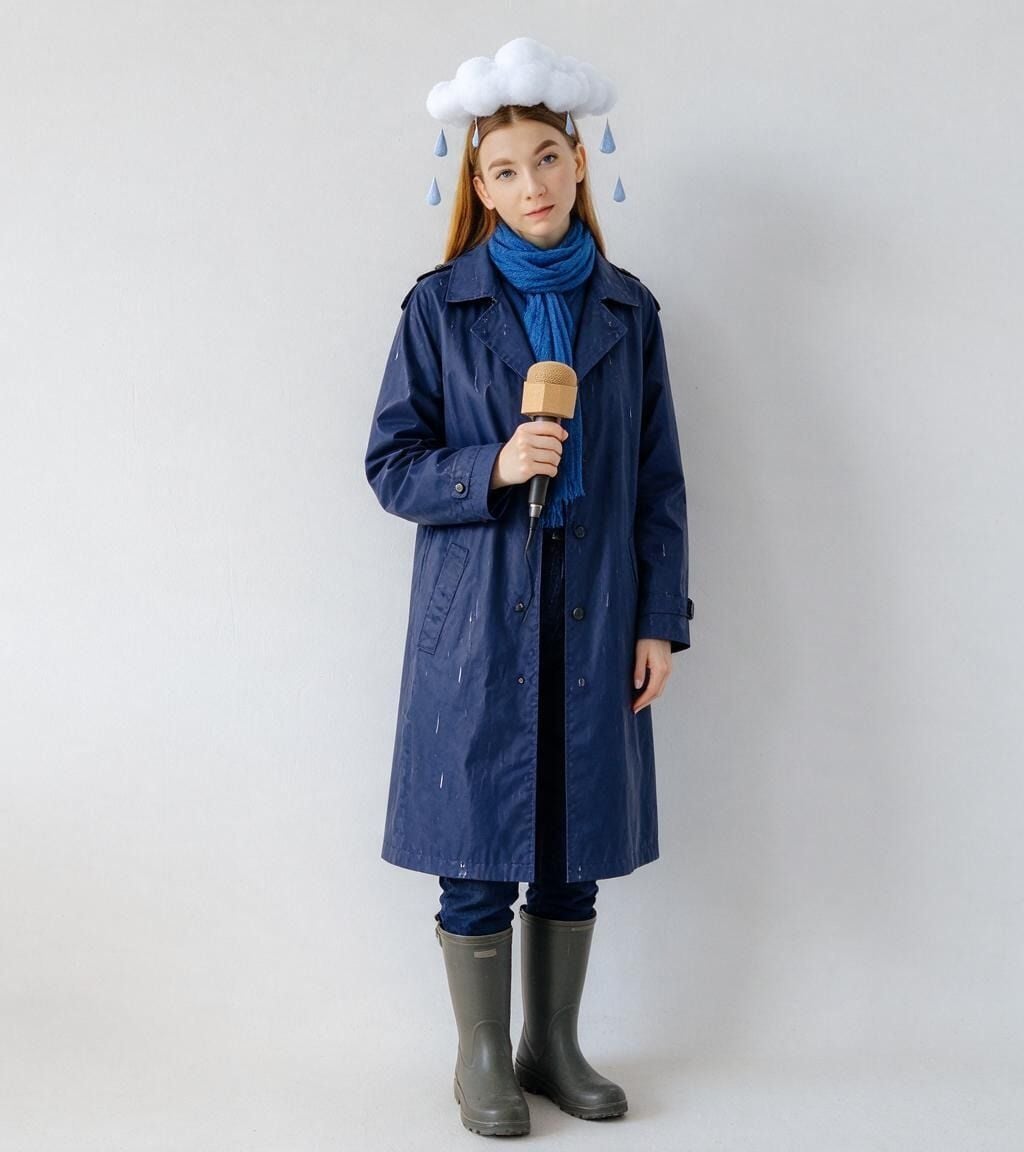
髮箍讓臉保持可見,左手也保持空閒。生成的雨衣長度及膝以下,比要求更長,因此在把這個預覽當成零件清單之前,衣襬是需要修改的一個細節。
這裡的決定與活動有關。這套服裝在靜態圖片中可能很容易辨認,但要檢查你轉身時髮箍是否會移位,以及道具是否還讓你空出一隻手。一套能讓你撐完整場活動的服裝,比只在某個角度好看的圖片更有用。
使用影像生成器進行受控比較
Atlas Cloud 在同一個工作空間中提供影像生成與編輯。它的 Image Generator 支援文字提示與上傳參考圖片。針對這三種造型,請選擇影像編輯或參考圖片工作流程,而不是純文字流程,因為重點是看到同一人物身上的服裝。可用控制項可能因模型而異;請使用能接受你的照片並讓你描述編輯的選項。
每個提示都上傳一次全身照,然後用能辨識該造型的名稱儲存每個結果。保持相同長寬比。如果工具提供多種變化,請用同一份檢查清單比較它們,而不是每次執行之間更改提示。記下模型在哪裡遵循需求、在哪裡自行發明新服裝。這份紀錄會讓下一個指令更明確。
選定方向後,做一個小幅編輯。例如:「保留我的臉、外套、長褲、姿勢與背景。只縮短帽簷,讓兩邊眉毛都保持可見。」這比用「把它變更好」重新生成整套服裝更容易測試。如果你改用別的 OpenAI 圖片編輯指南 也描述了在 ChatGPT Images 中上傳圖片並要求針對性修改。分享時,請註明實際產生結果的工具。
如果你不想上傳個人照片,可以先從純文字服裝概念與虛構成人模特兒開始。這能幫助你選擇顏色與部件,但它不是你個人合身度的預覽。當 AI 萬聖節服裝生成器 的輸入符合你想回答的問題時,它才最有用。
把預覽變成你能穿的服裝
這張圖片是決策輔助,不是縫紉紙樣。購買任何東西之前,先從選定的結果寫一份簡短零件清單:基本衣物、一或兩個具代表性的配件、鞋子,以及任何手工部件。標記哪些是你擁有的、哪些可以借、哪些需要製作。如果你無法確認某個部件固定在哪裡,就把那個細節視為選配,直到你用真正的固定件或服裝解決它。
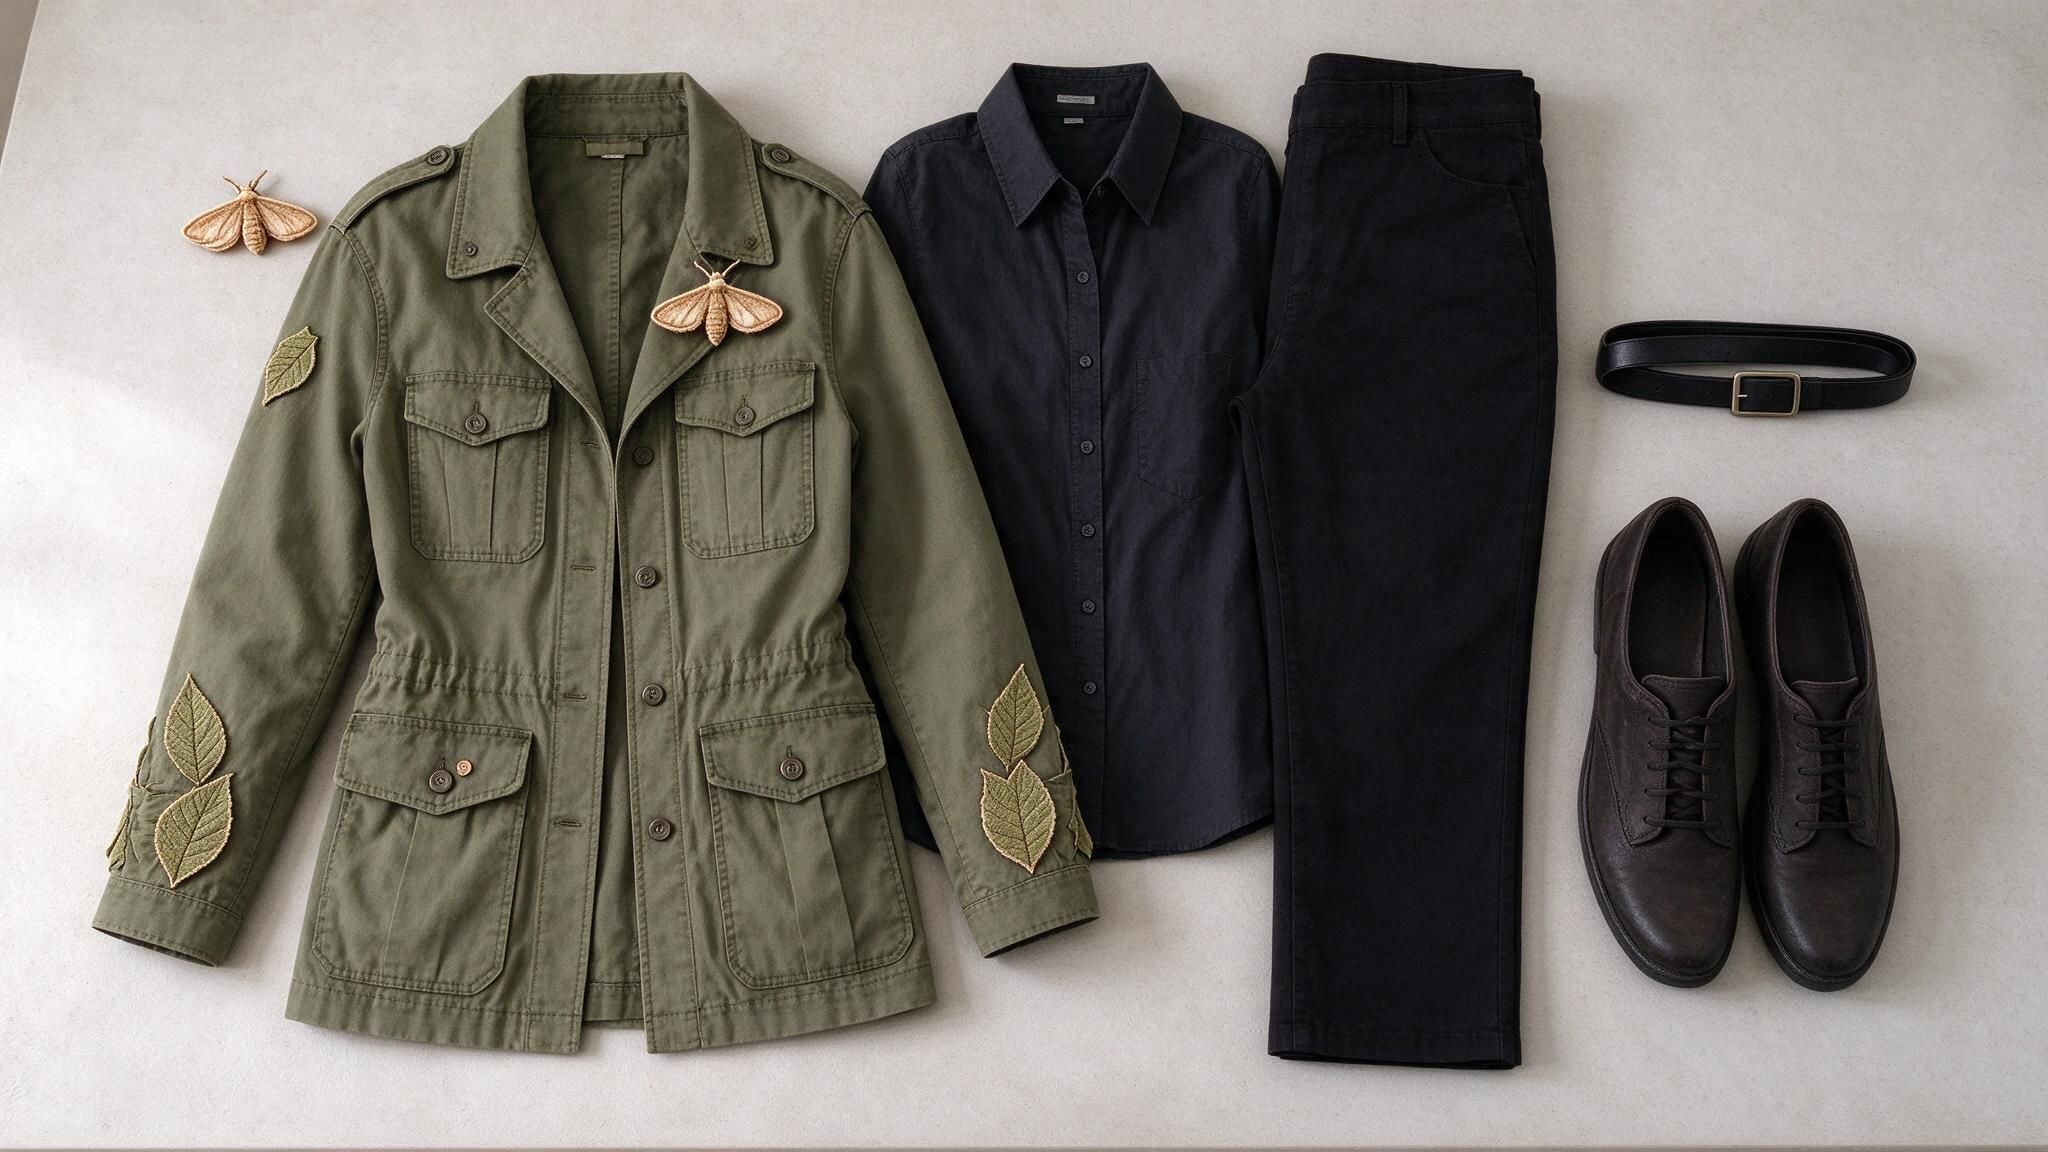
這張 AI 生成的零件板把植物學家預覽變成可檢查的清單:基本衣物、鞋子、腰帶,以及讓角色可辨識的小細節。
用正常大小與放大檢視結果。正常大小時,問問自己:如果沒有文字說明,別人是否看得懂這套服裝?放大時,檢查衣襬、閉合處、袖口與道具。生成的圖片可能用姿勢遮住缺少的袖子,或暗示布料無法維持的僵硬形狀。對上面三種造型來說,最難的檢查各不相同:女巫的帽子可見度、植物學家的貼布位置,以及記者的髮箍穩定性。
然後用實際物品做現實世界檢查。美國消費品安全委員會的萬聖節指南 建議服裝要合身、不要拖地,並在入夜後仍保持可見;它也建議尋找防火布料,並避免在火源附近穿著過於蓬鬆的部件。生成的預覽無法驗證其中任何一項特性。如果服裝要在戶外穿著,請在你走路、轉身,以及拿著預期會拿的物品時加以評估。
這正是 AI 萬聖節服裝生成器 在流程中發揮價值的地方。它幫助你在花時間之前先淘汰薄弱的想法。一旦你選定一個,最終依據是穿在真人身上的真實服裝,而不是精緻的算圖。
修正一個錯誤細節,而不是從頭開始
大多數第一版結果都有需要修正的地方。判斷問題是人物身分、服裝,還是實用性。如果臉變了,再次使用原始照片,並要求臉部特徵與它相符。如果某件衣物變得太複雜,指名要簡化的確切項目。如果姿勢遮住配件,要求正面視角並讓雙臂可見。保持場景其餘部分不變,這樣你才能看出編輯是否有幫助。
plaintext1Keep the same person, face, standing pose, camera angle, background, lighting, and all 2approved clothing. Change only [one specific problem]. The corrected detail must look 3physically wearable and match the surrounding outfit. Do not add new people, props, text, 4extra hands, or floating pieces.
把括號替換成可觀察的變更,例如「移除裙子的長襬」、「把葉子貼布移到外套袖口」,或「把雲朵髮箍變小,讓它不遮住兩眼」。避免像「讓它更酷」這類主觀指令。它們不會告訴你在下一個結果中該檢查什麼。
如果你說的 AI 萬聖節服裝 是指打扮 成 AI 角色,同樣的方法仍然適用。從可穿的基礎開始,例如深色外套、幾何布料貼片與反光滾邊,而不是虛構的全像投影。要求以全身照呈現服裝,並讓接縫可見,不要有螢幕般的圖形或無法辨讀的文字。這樣你就能用真實材料打造角色,不必依賴圖片發明不可能存在的裝置。
常見問題
我可以用自拍代替全身照嗎?
臉部彩繪、帽子或半身萬聖節肖像可以用自拍。它無法顯示外套、裙子、靴子或道具在全身上的樣子。若要做服裝決定,可以的話請拍一張新的全身照。
ChatGPT 能製作 AI 萬聖節服裝預覽嗎?
ChatGPT Images 可以用文字指令編輯上傳的照片。使用與其他影像編輯器相同的身份、服裝與取景細節。它的輸出仍然是視覺概念,因此請對照你的原始照片與你打算穿著的實際衣物來檢查。
AI 生成的萬聖節服裝準確到可以直接照著購買嗎?
它們能幫助你比較輪廓與配件想法。它們無法確認服裝尺寸、布料表現或舒適度。用圖片做出候選清單,然後檢查尺寸表、材質與實際物品。
如果我沒有照片可以上傳呢?
描述你現有的衣物、活動場合,以及你想自己製作的程度。要求在純色場景中生成虛構的全身服裝概念。你可以把它當成零件清單,但不要把它當成你本人的試穿。





