程式碼看起來完成了。接著測試失敗,修正改了某個介面,然後又有另一個請求開始執行。選擇最適合程式開發的 AI API,意味著找到能在可接受預算內完成你這類工作的模型與端點。
先從 Claude、GPT 或 Gemini 當作參考候選。若想要其他部署與花費選項,就用相同的任務比較 DeepSeek、Qwen 和 Kimi。除錯時,優先重視迴歸測試。重構時,檢查差異。若使用程式開發代理,在比較 Token 價格之前,先驗證整個工具迴圈。
這種挫折感是可以量化的。在 2025 年 Stack Overflow 開發者調查中,回答挫折相關問題的受訪者裡,有 66% 表示 AI 給出的解法幾乎正確;45% 表示花更多時間除錯生成的程式碼。這些是問卷回答,不是 2026 年的模型評估。(Stack Overflow 開發者調查,2025 年)
重點摘要
- 分開選擇 API 與代理。
- 依任務與所需端點功能篩選候選。
- 保留最初的回覆,並用固定的驗收測試評判。
- 將失敗的嘗試與修正一併納入成本計算。
本指南提供一份候選清單、三個可直接複製的評估任務,以及一份成本工作表。研究於 2026 年 9 月 21 日查核。模型可用性、文件記載的能力,以及實測結果,在全文都屬於不同的證據類別。
最適合程式開發的 AI API:候選清單
先從兩個候選開始:一個符合你現有應用程式,一個替代方案。用以下六個系列來建立這組初始配對。
下表提出可測試的項目,但不宣稱比較效能。存取權取決於你的帳號、地區、配額與端點;文件中有列出,不代表你的憑證一定能呼叫。
| 具體模型與 ID | 存取路徑 | 值得評估的任務 | 主要決策界線 | 端點證據 | 價格查核 |
|---|---|---|---|---|---|
Claude Opus 5,claude-opus-5 | Anthropic API | 受約束的多檔案變更 | 驗證用戶端與推理控制 | Claude Platform 模型總覽;帳號存取未測試 | 未報價 |
GPT-6 Astra,gpt-6-astra | OpenAI API | 多條件程式開發任務 | 驗證路由與工具 | OpenAI 模型文件;帳號存取未測試 | 未報價 |
Gemini 3.8 Flash,gemini-3.8-flash | Gemini API | 互動式生成與審閱 | 驗證延遲與協定 | Google AI 模型目錄;帳號存取未測試 | 未報價 |
DeepSeek V4 Pro,deepseek-ai/deepseek-v4-pro | Atlas Cloud 模型路由 | 數值修正;上下文實驗 | 將 0813 版本分開處理 | 已驗證確切模型頁面;執行階段功能未測試 | 2026 年 9 月 21 日 |
Qwen3.5 122B A10B,qwen/qwen3.5-122b-a10b | Atlas Cloud 模型路由 | 重構;自成一體的介面 | 指定版本;非最新版 | 已驗證確切模型頁面;執行階段功能未測試 | 2026 年 9 月 21 日 |
Kimi K3,moonshotai/kimi-k3 | Atlas Cloud 模型路由 | 相同三個任務;CSV 介面 | 驗證輸出與完成上限 | 已驗證確切模型頁面;執行階段功能未測試 | 2026 年 9 月 21 日 |
Claude、GPT 和 Gemini 提供有用的參考候選。 它們的官方模型目錄列出上述版本。用你已經熟悉的供應商當基準,然後測試替代方案是否能降低已接受任務的成本或整合工作量。不要將消費級助理的行為視為對應 API 的結果。
OpenAI 的模型目錄將 GPT-6 Astra 與 GPT-5.6 系列並列。這確立了一個當前候選,但不代表它在程式開發上勝過其他列。此表刻意避免從未標註日期的比較頁面引入舊模型 ID。(OpenAI 模型目錄,2026 年 9 月存取)
DeepSeek 值得作為獨立模型系列加以調查。 測試它是否能修正特定錯誤,而不擴大變更範圍。若部署的路由無法滿足你要求的回應格式、工具行為或延遲上限,無論該模型一般評價如何,都應另選候選。
依版本評估 Qwen。 指定的 122B A10B 部署提供了具體的價格參考。在得出價值結論之前,先執行解析與瀏覽器檢查。其他 Qwen 版本的上下文數字不能套用到這個模型。
Kimi 是可實際操作的設定候選。 其公開頁面標示了模型 ID。設定可以審閱;成功生成仍待驗證。用與其他候選相同的限制條件來評估它完成的輸出。
在這份比較中,Atlas Cloud 位於存取層。它不是第七個模型。它的相關性是實務上的:你可以在投入某個工作流程之前,先檢視多個候選模型頁面並比較其整合需求。
若使用開放權重,請驗證確切的發行授權與部署產物。託管推論有另計的服務條款與營運成本;單憑模型系列無法確立這些內容。
程式開發 API、模型與代理的差異
模型會針對輸入產生內容。API 定義你的應用程式如何送出該輸入並接收結果。程式開發代理則統籌周邊工作:讀取檔案、呼叫工具、套用編輯、執行測試,以及判斷是否繼續。
這三層可能各自獨立失敗。模型可能提出正確的修補,但代理把它寫到錯誤的檔案。API 可能回傳有效的 JSON,但應用程式忽略了工具呼叫。能力足夠的代理可能因為所選端點拒絕某個參數而停滯。
假設你送出一個處理常式,要求做一個 ID 解析器。基本的程式碼生成 API 會回傳包含程式碼的文字。你的程式仍需要擷取那段程式碼、放進合適的工作區,然後執行測試。HTTP 回應成功只代表已送達,並不代表正確。
只有在你提供工具與權限時,代理才能自動化這些步驟。它也需要停止條件。沒有停止條件,它可能反覆編輯已經可接受的函式、擴大任務範圍,或花費額外請求試圖改善無關的細節。
請把三條預算項目分開:
- 工具訂閱: 你使用的應用程式、編輯器整合或代理服務。
- 推論用量: 依其計費條款,對所選模型端點發出的請求。
- 執行環境: 容器、測試執行器、儲存與其他基礎設施。
有些產品會捆綁部分堆疊。其他則要你自行提供個別憑證。在假設編輯器訂閱包含你自己應用程式的任意 API 流量之前,請先確認特定方案。
協定相容性也有界線。一個接受熟悉 messages 陣列的服務,仍可能提供不同的工具行為、串流事件、上下文限制或推理控制。複製 base URL 並不能確立在另一個供應商生態系統中對每項功能的支援。
把應用程式、代理、端點、模型、工具與測試對應起來。在更換模型之前,先確認每一步的可計費元件與負責的營運者。
最適合程式開發的 AI API:7 項選擇檢查
1. 功能正確性與迴歸行為。 在請求程式碼之前先寫好預期輸出。一個能處理一般整數、卻把 null 當成零的價格函式違反了契約。同時執行新的邊界案例與專案既有測試;通過一項新測試,可能掩蓋了其他呼叫端已被破壞的事實。
2. 變更範圍。 將修補與請求比較。擷取 ID 解析器應保留 URL、成功回應與錯誤回應。未經要求的框架遷移,即使在替代方案能編譯的情況下,也會增加審閱工作。事先決定無關的編輯是否會讓答案不合格,或需要修正。
3. 有用的上下文與輸出空間。 你的請求包含指示、相關檔案、工具定義與先前的對話。也要為答案保留足夠空間。宣稱很大的上下文視窗,並不代表模型會找到相關的不變條件,也不代表你的端點接受相同的最大值。
用一個重要的相依性來測試上下文品質。納入一個介面必須保持穩定的呼叫端,並驗證模型是否遵守。另外單獨測量截斷:一個在函式中途結束的回應,不能因為開頭幾行看起來不錯就被接受。
4. 工具呼叫與結構化輸出。 用你實際的工具結構描述來驗證部署的路由。檢查引數型別、缺少的欄位、工具識別碼,以及工具結果之後的後續回應。一個寫出看似合理 JSON 物件的模型,未必完成了一趟原生工具呼叫往返。
5. 達到可接受結果的時間。 記錄整次嘗試的持續時間,包括修正與測試。對互動式助理而言,出現第一個可見文字的時間也很重要,但不能取代完成時間。快速出現第一個 Token,接著是很長卻無法使用的答案,仍然會卡住開發者。
6. 輸入、輸出、快取與重試費用。 閱讀你所選端點實際回報的計費類別。若適用,將快取讀取與一般輸入分開。追蹤不成功的請求與中止的迴圈。若供應商未揭露你需要的細節,請明確標示估計中缺少的假設。
7. 整合與程式碼處理條件。 確認你的編輯器或應用程式支援該路由、驗證方法與錯誤格式。在送出私有原始碼之前,先檢閱供應商目前的資料處理條款。開放權重描述的是一種模型散布方式的選擇;它無法確立託管服務如何處理你的請求。
公開基準測試能協助你選擇候選,前提是你讀懂其條件。SWE-bench Verified 包含 500 個人類篩選的實例。其現行頁面也描述了使用相同 mini-SWE-agent 環境的 Bash Only 檢視。這些細節有助於說明實際比較的是什麼。(SWE-bench,2026 年 9 月存取)
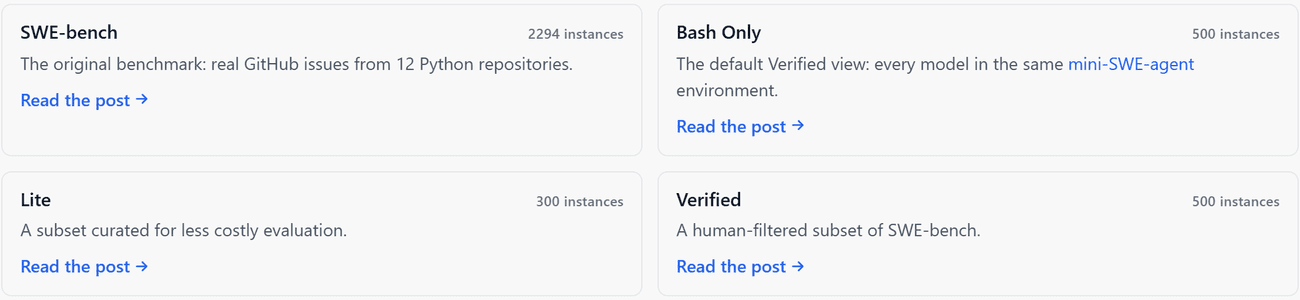 SWE-bench 頁面顯示 Verified 資料集大小與共用的代理環境
來源證據:真實的基準測試頁面,擷取於 2026 年 9 月 21 日。資料集與執行條件應與任何效能聲明並列。
基準測試結果描述的是一套特定設定。你的語言、商業規則、權限與審閱標準可能不同。請就你能檢視的工作做出最終決定。
最適合程式開發的 AI API:執行三項實務檢查
這三個可重現的評估範例會揭露不同的失敗模式。在請求輸出之前,先固定它們的驗收規則。無論說明品質如何,都要依契約評判函式或頁面。
對 DeepSeek V4 Pro、Qwen3.5 122B A10B 和 Kimi K3 而言,預定的協定是每個任務獨立執行三次。也就是 27 次初始嘗試。每次嘗試最多允許一次回饋修正,保留最初的答案,並分別報告初始與修正後的結果。
只在支援的地方要求 temperature 為零,並記錄實際接受的設定。在確認端點限制後,A 和 B 使用 4,096 Token 的請求輸出上限,C 使用 8,192。預設值與不受支援的控制項都必須記錄。低溫不保證答案完全相同。
證據狀態: 測試環境的存取被 Cloudflare Access 登入畫面阻擋。這 27 次候選嘗試無法執行。以下證據顯示的是本機執行的原始程式碼,以及本文撰寫的 CSV 參考測試資料,並非候選模型的結果。模型通過率、Token 用量與任務成本仍未測量。
任務 A:修正數值價格選擇。 將這段確切的提示詞貼到全新的工作階段:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
固定的驗收輸入為 [2,10,3]、["12","3"]、空陣列、僅含無效值、零、負數,以及僅含空白字元的字串。在修剪後拒絕空字串。檢查呼叫之後原始陣列的元素與順序是否完全相同。
原始版本使用 JavaScript 的預設排序,並會變更其輸入。因此這個任務檢查兩項不同的義務:選出正確的數值最小值,以及避免更改呼叫端的資料。明確測試轉換規則,因為簡短的強制轉型解法可能意外接受布林值或 null。
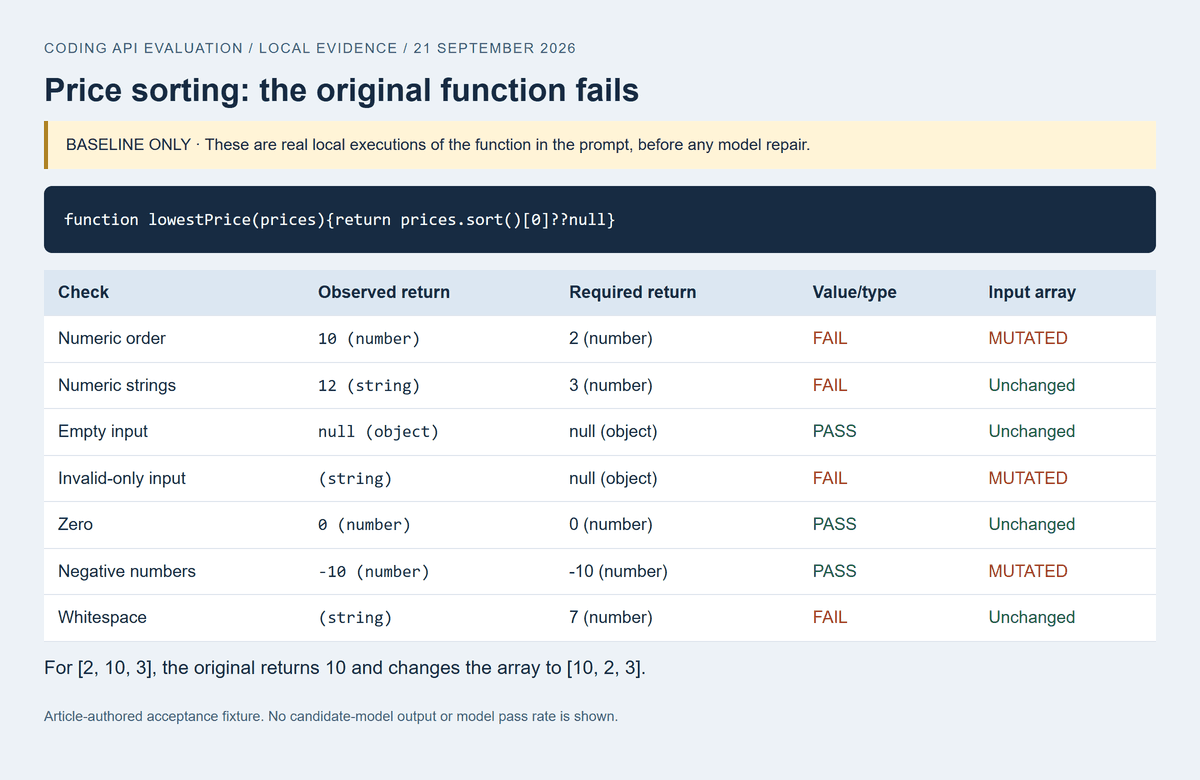 在本機執行原始價格函式,顯示數值排序錯誤且輸入被變更
已執行的基準:原始函式對 [2,10,3] 回傳 10,並將陣列變成 [10,2,3]。數值字串也不符合回傳值契約。未顯示任何模型修正。
任務 B:在小幅重構期間保留介面。 原封不動使用這段提示詞:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
接受 "12" 與 "0012" 為 12。拒絕 "1e2"、"1.0"、負數、零、空白、非字串輸入,以及超出 JavaScript 安全整數範圍的值。驗證註冊的路徑與兩個回應主體。無效輸入不得觸及 findUser。
這個任務測試模型是否理解數值轉換與指定字串文法之間的差異。檢查差異中是否有無關的變更,然後用虛設的請求與回應物件呼叫處理常式。一個正確的輔助函式配上未改動、仍舊寬鬆的處理常式,依然算失敗。
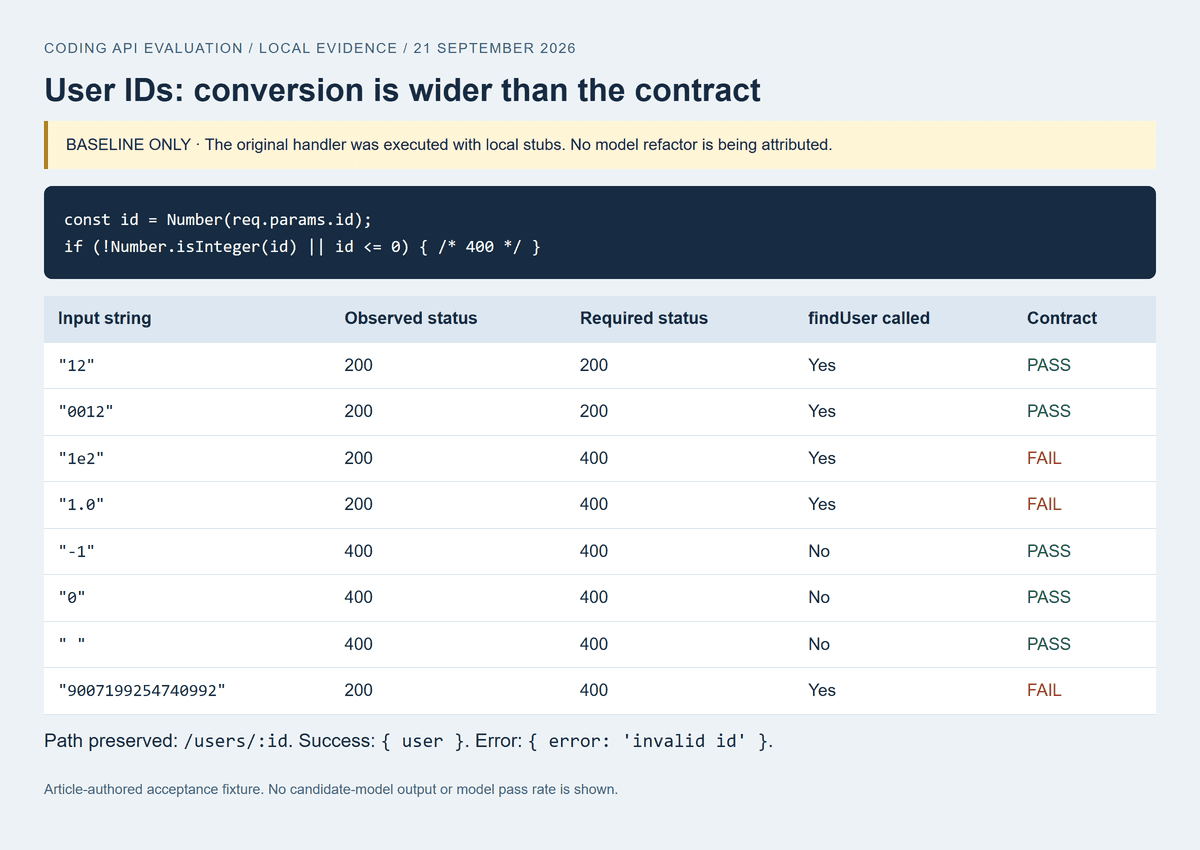 原始處理常式測試記錄顯示無效的數值字串以狀態 200 被接受
已執行的基準:對於 "1e2"、"1.0" 和 "9007199254740992",原始處理常式回傳 200,而非要求的 400 回應。本機虛設物件記錄了呼叫;這不是模型生成的重構。
任務 C:建一個你能操作的前端 CSV 預覽工具。 提交:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
用這些確切的記錄測試,先使用 LF,再使用 CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
預期為兩個欄、三列資料,Alice 的逗號在單一儲存格內,Bob 的跳脫引號正確顯示。Eve 的值必須以字面文字顯示,沒有圖片元素、事件執行或網路請求。新增一列有三個欄位的資料,確認頁面明顯地回報欄位數不符。
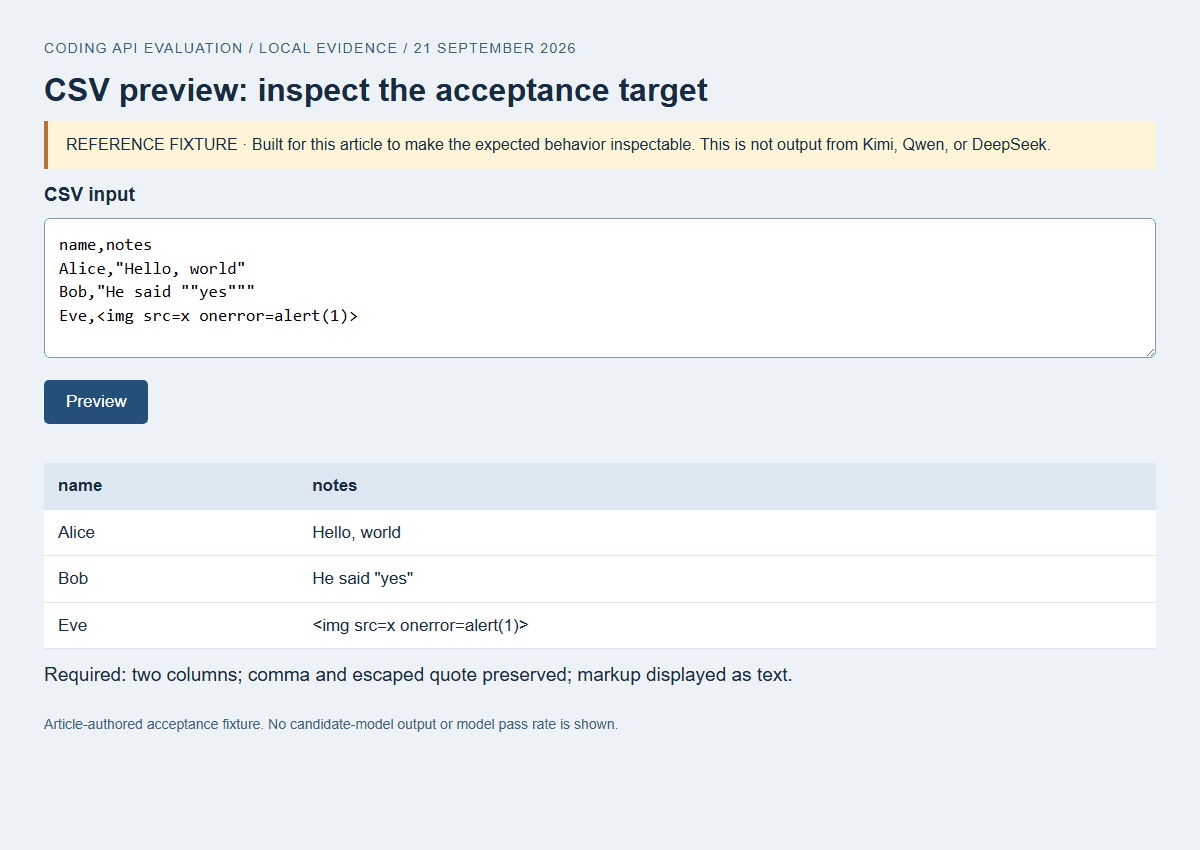 展示引號值與字面標記要求的 CSV 驗收測試資料
已操作的參考測試資料,為本文而建,不是候選模型生成的。瀏覽器檢查驗證了 LF/CRLF 解析、跳脫引號、字面標記、明顯的欄位數錯誤,以及沒有 HTTP 請求。螢幕截圖顯示點擊 Preview 後的有效輸入狀態。
保存原始輸出、記錄、模型 ID、日期、參數、計時、修正與手動編輯。將失敗的斷言送去修正,但不改變預期結果。拒絕、截斷與錯誤都要與成功案例一併保留。
預算有限時最適合程式開發的 AI API
將 Token 費率與完成品質及用量一併比較。重複的輸入可能主導程式碼審閱成本;整檔生成可能增加輸出費用。反覆修正則會同時增加兩者。
Atlas 目錄與確切詳情頁面在 2026 年 9 月 21 日顯示以下每百萬 Token 美元費率:
- DeepSeek V4 Pro: 輸入 $1.68、輸出 $3.38。另立的 V4 Pro 0813 列表採用不同費率;請勿以它替代。
- Qwen3.5 122B A10B: 輸入 $0.30、輸出 $2.40。截至 2026 年 9 月,目錄顯示原價 $0.40 與 $3.20,並有 25% 折扣。
- Kimi K3: 輸入 $3.00、輸出 $15.00。
這些是顯示的生產費率,不是本文評估所產生的帳單。快取專屬費率及其適用性未經確認。DeepSeek 與 Kimi 的促銷折扣未經確認。未觀察到折扣並不證明不存在任何優惠。
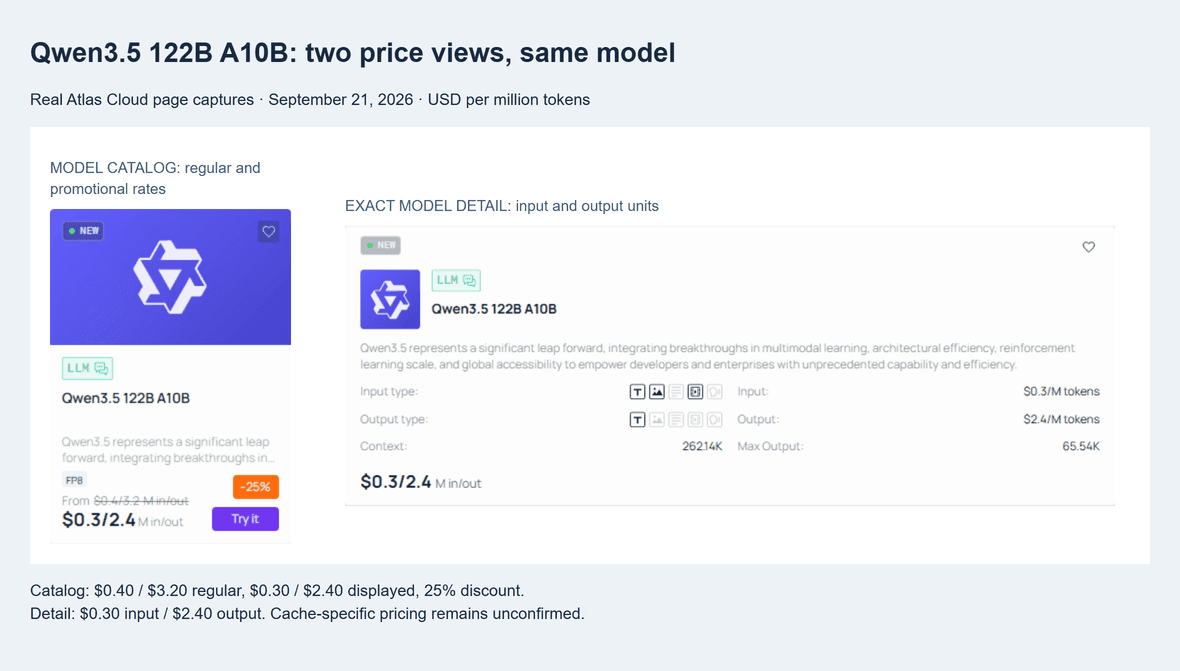 Qwen3.5 122B A10B 目錄折扣,旁邊是其確切模型詳情的輸入與輸出費率
Qwen 價格交叉查核,2026 年 9 月 21 日:目錄顯示 25% 促銷;確切模型詳情確認每百萬 Token 輸入 $0.30、輸出 $2.40。快取專屬費率仍待確認。
將任務中的模型部分計算如下:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
若計費記錄將快取 Token 分開處理,就不要再次以一般輸入計費。檢查推理用量是否計入可計費輸出。若沒有任務通過,請報告「無成功結果」;除以零或顯示零完成成本都會誤導讀者。
舉一個透明的計算範例,假設依顯示的 Qwen 費率,有 10,000 個一般輸入 Token 與 2,000 個輸出 Token。估計的模型費用為 $0.0078,不含任何其他適用項目。這是假設性請求,不是實際觀察到的 Token 用量或真實帳單。
一次相同大小的修正會讓估計值達到 $0.0156。實際修正包含不同的上下文與輸出,因此請依每次請求記錄的用量分別計算。
| 任務 | 模型 | 首次通過 | 修正後 | Token 用量 | 成本來源 | 總費用 | 總時間 | 手動變更 |
|---|---|---|---|---|---|---|---|---|
| A、B、C;各規劃重複 3 次 | DeepSeek V4 Pro | 未測量 | 未測量 | 未記錄 | 無用量記錄 | 未知 | 未測量 | 未評估 |
| A、B、C;各規劃重複 3 次 | Qwen3.5 122B A10B | 未測量 | 未測量 | 未記錄 | 無用量記錄 | 未知 | 未測量 | 未評估 |
| A、B、C;各規劃重複 3 次 | Kimi K3 | 未測量 | 未測量 | 未記錄 | 無用量記錄 | 未知 | 未測量 | 未評估 |
在你自己的工作表中,將每一列擴展為每個模型與每次重複各一列。已修正的成功在已接受任務的分母中只計一次。將不成功的嘗試納入分子,並保留首次通過與最終接受兩個獨立欄位。
分別追蹤人工審閱與基礎設施。釐清一次不必要的改寫,可能抵銷推論上的節省。比較同時符合兩項驗收要求,以及你的審閱時間預算的候選。
使用 Atlas Cloud 打造最適合程式開發的 AI API
先從 Kimi K3 模型頁面 開始,確認 ID,並檢視 API 與 Code 檢視。將所選版本與測試記錄放在一起。
在把兩個路由當成可互換之前,先閱讀 LLM 協定文件。它指出 Chat Completions 是涵蓋範圍最廣的路由,並引導使用者查看每個模型的 supported_apis。取樣控制與工具功能也取決於模型宣稱的支援。
這裡有幾個值得檢查的具體整合細節。文件指出,經轉譯的 Anthropic 請求不會套用 cache_control,而且供應商託管的工具在該轉譯路由上無法使用。若你現有的代理假設有原生快取或託管瀏覽工具,這些限制就很重要。讓用戶端符合實際路由。
以下 Node.js 範例示範一次文字請求。它使用內建的 fetch、以環境變數存放憑證,以及已驗證的 Kimi 模型 ID。將任務 A 的確切提示詞存為 task-a.txt。將 base URL 環境變數設為 Atlas API 文件所示的基底,結尾為 /v1。
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages 承載任務;model 選擇部署;max_tokens 要求輸出上限。回應讀取器在回傳程式碼之前,會先檢查是否為一般的完成文字。逾時限制了此範例的等待時間;它不能確立伺服器已停止處理,或未產生任何費用。
Temperature 被省略,因為每個模型的支援與確定的行為需要驗證。此範例不會自動重試。在加入有界限的重試策略之前,先檢閱失敗類別,並且絕不記錄授權標頭。本文的程式碼在製作期間並未以 API 金鑰執行。
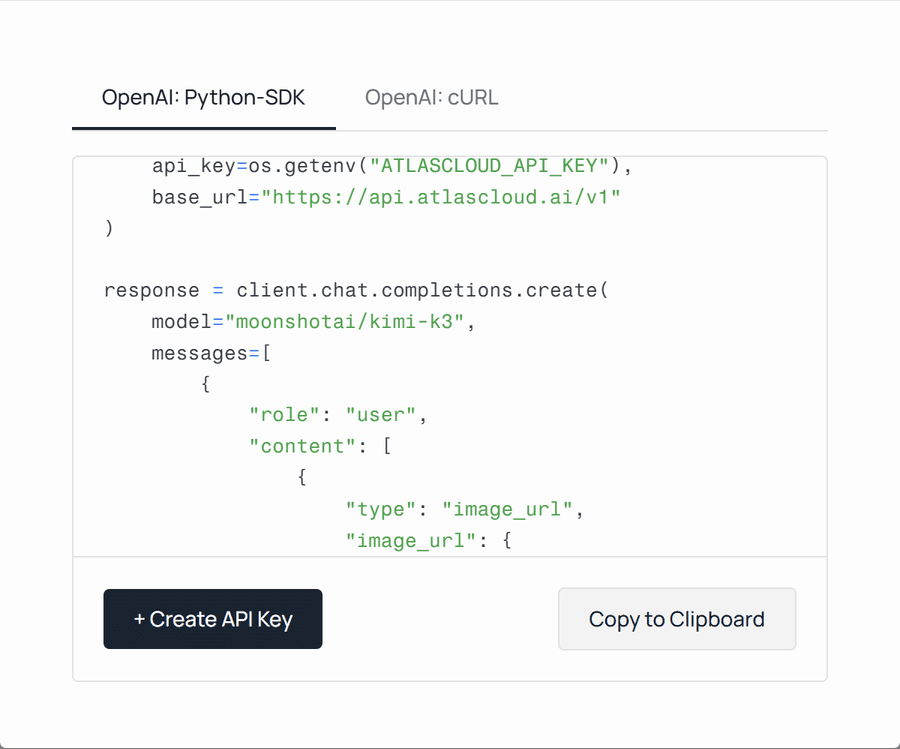 公開的 Kimi K3 API 程式碼範例,顯示 Atlas 端點與模型識別碼
公開的 Kimi K3 Code 對話框,擷取於 2026 年 9 月 21 日。這是設定證據,不是已完成的程式開發執行。該頁面的範例包含媒體輸入;本文範例僅使用文字。
對任何回傳的函式執行任務 A 的驗收檢查。在切換到 DeepSeek 或 Qwen 之前,先驗證其協定與參數。在比較輸出與用量時,保持提示詞與測試不變;共用的請求形式並不代表行為完全相同。
在生產環境使用程式開發 API 之前
先在可丟棄的分支或隔離的工作區中執行生成的程式碼。對於 CSV 任務,使用封鎖網路請求、且無法存取敏感應用程式狀態的本機瀏覽器情境。對於儲存庫任務,只給該流程評估所需的檔案與命令。
在模型回應之外定義成功。代理說「所有測試通過」時,應該引導你去查看實際的測試記錄、結束碼與已檢查的修訂版本。將差異與該證據一起保存。否則,之後的修正可能在表面成功之後改變檔案,讓報告變成過時。
將逾時與重試視為你自己擁有的應用程式行為。設定請求期限與總任務預算。將憑證或無效參數造成的錯誤,與暫時性的傳輸失敗分開。重複無效請求會浪費時間;重複會觸發副作用的請求,可能產生重複工作。
當代理能呼叫工具時,區分唯讀檢查與寫入。在你的工具設計支援時,指派操作識別碼,並在重複不確定的寫入之前確認狀態。模型端點的重試策略,無法保證你的應用程式之後所執行工具具備冪等性。
像保護原始檔一樣刻意保護記錄。記錄模型 ID、時間戳、狀態、計時與用量,但不要例行性地把機密或整個私有儲存庫複製到遙測中。將任何必要的原始輸出證據保存在適當受限的位置,並確立團隊需要保留多久。
用你真實的用戶端檢查串流。它必須處理部分事件、終止、錯誤,以及可取得時的用量記錄。確認實際帳號與部署的速率限制。一個安靜的單人實驗,無法確立同一路由在團隊同時送出請求時的行為。
使用這份簡短的發布檢查清單:
- 驗收測試與既有迴歸在最終修訂版本上通過。
- 差異維持在核准的任務界線內。
- 逾時、取消與重試行為都已演練過。
- 工具呼叫與結構化回應在所選端點上可運作。
- 記錄不含憑證與不必要的私有程式碼。
- 資料處理條款符合團隊要求。
- 備援方案有其自身已驗證的設定與測試記錄。
私有儲存庫需要針對服務個別決定。與負責程式碼的人一起檢閱目前的保留、訓練用途、存取與合約條件。只傳送已核准的資料。不要因為模型權重可取得,或協定與你已使用的那個相似,就推斷其具備機密性。
最適合程式開發的 AI API:做出最終選擇
分三輪做決定。
第一,排除缺少必要能力的候選。 寫下必須成立的條件:可接受的輸出格式、能運作的工具迴圈、適當的資料處理安排,或可行的回應期限。缺少其中一項的候選,需要先做獨立的補救決定,才能進入最終比較。
第二,比較已接受任務的成本與經過時間。 使用相同修正政策下的所有嘗試。將首次通過的成功與修正後的成功分開,並顯示缺少的用量記錄。若兩個模型都符合契約,就同時比較其審閱負擔與模型費用。你的開發者將必須與產出的修補共處。
第三,保留一個備援並定義其觸發條件。 例如端點持續中斷、結構化輸出反覆失敗,或任務成本超過選定的上限。事先測試替代設定。在壓力下切換模型 ID,若其控制項或回應行為不同,可能引入第二個整合問題。
本指南中的三個小任務是篩選練習。在依賴某個候選進行大範圍變更之前,先用你自己程式碼庫中具代表性的工作擴充這套測試。保留一些任務在提示詞調校之外,這樣你才能檢查改善是否能移轉到你未最佳化的範例之外。
最適合程式開發的 AI API,是你說得清楚的組合:它能完成所需工作、揭露你能追蹤的成本,並契合你的應用程式運作方式。做出這項決定不需要有 universally 通用的贏家。
開啟目前的模型目錄,選擇兩個候選,並保存其確切 ID 與設定。然後對兩者使用相同的任務、相同的測試與相同的停止規則。
常見問題
預算有限時,最適合程式開發的 AI API 是什麼?
先從顯示費率符合你預期輸入與輸出量的候選開始,然後比較每個已接受任務的成本。Qwen、DeepSeek 與 Kimi 這幾列提供具體版本可供調查,但不宣稱有經測試的價值贏家。限制修正次數、刻意重複使用相關上下文,並追蹤失敗的請求。將審閱時間分開計算,以免低推論帳單掩蓋了龐大的清理負擔。
程式開發訂閱比支付 API Token 便宜嗎?
這取決於你的工作負載與該方案包含的內容。訂閱可能適合在其支援的應用程式內互動使用,而用量計費可能適合流量變動的自訂服務。檢查模型存取、上限、並行數,以及是否包含外部 API 呼叫。在具代表性的期間內比較相同數量的有用工作;月費標價與 Token 費率衡量的是不同的東西。
程式開發模型與程式開發代理有何不同?
模型產生回應。代理管理這些回應周邊的迴圈,包括檔案存取、工具執行、測試與停止規則。你可以透過 API 呼叫程式開發模型,而不建構代理,例如用來建議一個供人工審閱的函式。若你想要自主編輯,就必須將模型與它實際會使用的代理及權限一起評估。
除錯與重構時該用哪個 AI API?
篩選符合你端點與程式碼處理要求的候選,然後用你工作中的小型錯誤與受約束的重構來測試。任務 A 檢查正確性與輸入變更;任務 B 檢查解析與介面保留。接著用具代表性的儲存庫測試。
偏好能以可管理的審閱心力符合你驗收條件的候選,而不是單純產出最長說明或最廣泛改寫的那個。
有免費的程式開發 AI API 嗎?
試用額度、有免費方案的應用程式,以及可下載的模型權重是不同的東西。它們都不會自動為你的應用程式提供無限的託管推論。在以免費存取編列預算之前,先驗證目前的資格、到期日、配額與支援的模型。本文不宣稱目前有任何可用的免費額度。
若你自行託管權重,即使下載權重免費,也要把運算與營運納入考量。
我可以把私有儲存庫的程式碼送到程式開發 API 嗎?
只能依特定服務的適用條款,傳送你的組織允許你分享的程式碼。針對所選部署,檢閱保留、訓練用途、存取控制與合約要求。
移除憑證與無關檔案,並檢查你的代理會自動納入提示詞與記錄中的內容。開放權重模型或熟悉的 API 格式,本身並不能確立託管服務符合你團隊的機密性要求。


