DeepSeek Harness 並未納入該基準測試,因為它在兩天後才發布。這意味著有用的問題不是「哪個贏了?」,而是如何用同一模型同時執行兩個工具的工作,並在閱讀帳單時不被自己誤導。
關鍵要點
- 在可比較的代理任務中,框架選擇可使 token 用量波動約 7 倍。
- 用同一模型和同一儲存庫狀態來評測 DeepSeek Harness 和 OpenCode。
- 在選擇日常使用的工具前,先使用不同的 API 金鑰。
兩台筆電透過兩種代理框架執行同一編碼任務
公平的設定:同一個模型、同一個任務、兩個終端。
公開基準測試告訴我們什麼
Composio 使用 DeepSeek V4 Flash,對 8 個代理框架執行了 30 個複雜的多應用工作流程,每個任務上限 900 秒,並在 240 次執行中進行二元程式化評分(Composio,2026 年 8 月)。同樣的模型,不同的框架。
| 框架 | 通過率 | 中位數時間 | 每個任務平均 token 數 |
|---|---|---|---|
| Pi Agent | 66.7% | 132.2s | 559,000 |
| Prime Agent | 62.5% | 242.1s | 1,400,000 |
| OMP | 56.7% | 272.4s | 742,000 |
| Claude Code | 53.3% | 122.7s | 742,000 |
| Codex | 53.3% | 245.0s | 678,000 |
| DeepAgents | 53.3% | 187.1s | 665,000 |
| Hermes Agent | 50.0% | 175.5s | 192,000 |
| OpenCode | 46.7% | 129.7s | 692,000 |
token 欄比排名更重要。分佈範圍從每個任務平均 192,000 到 1,400,000 個 token。這是同一模型透過不同執行環境執行類似工作所產生的差異。
OpenCode 提供了一個有來源的基準:每個任務 692,000 個 token,通過率 46.7%,中位數時間 129.7 秒。DeepSeek Harness 在該基準測試中沒有公開的對決數據,因為 DeepSeek 於 2026 年 8 月 13 日發布,比基準測試發布晚了兩天。
將此表格視為警訊,而非定論。它顯示框架可以主導成本。但並不能證明 DeepSeek Harness 在你的儲存庫上勝過 OpenCode。
切換框架時會改變什麼
在測試之前,先比較這兩個工具對開發人員工作有影響的部分:設定面、成熟度、token 可視性,以及你能取代多少代理循環。
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| 來源 | DeepSeek AI | Anomaly(原 SST) |
| 發布日期 | 2026 年 8 月 13 日 | 2025 年底 |
| GitHub 星星數 | ~143k | ~198k |
| 授權 | MIT | MIT |
| 語言 | TypeScript | Go |
| 介面 | 127.0.0.1:3080 上的 Web UI | 終端 TUI |
| 狀態 | 開發者預覽版,預期會有破壞性變更 | 成熟,廣泛部署 |
| 架構 | 模型、工具、會話、沙箱、儲存、循環和 UI 皆可替換的外掛 | 固定核心,搭配建置/規劃代理、MCP 支援和 LSP 擴充 |
| 設定 | $DSH_HOME/settings.yaml | opencode.json |
| Token 記帳 | 具有上下文壓力和細分預測的 token 計量表 | 會話層級的 token 和成本追蹤,顯示在 TUI 中 |
| 最適合 | 想要修改代理循環本身的團隊 | 想要一個今天就能運作的編碼代理的團隊 |
OpenCode 提供了一個穩定的編碼代理,周邊有擴充點。DeepSeek Harness 提供了一個循環本身可以替換的執行環境。如果你正在建構代理基礎設施,這種靈活性會有幫助。如果你本週需要一個用於生產程式碼的預設工具,則會增加風險。
兩個工具都可以連接相同的 OpenAI 相容端點。這使得公平測試成為可能:同一個模型、同一個基本 URL、同一個任務、同一個起始儲存庫狀態。
在本教學中,DeepSeek V4 Flash 透過 Atlas Cloud 執行,該服務提供兩個工具都接受的 OpenAI 相容端點。deepseek-v4-flash-0731 列表顯示,截至 2026 年 8 月,輸入 token 每百萬個 0.14 美元,輸出 token 每百萬個 0.28 美元,上下文視窗為 1,048,576 個 token,最大輸出為 393,216 個 token。只要兩個框架使用相同的端點和模型 ID,任何提供者都可以。
OpenCode 也發布彙總使用數據。DeepSeek 模型已透過 OpenCode 處理了 233 兆個 token,其中 V4 Flash 佔 85.5%,V4 Pro 佔 14.5%(OpenCode,2026 年 8 月)。這種使用模式使 V4 Flash 成為比較的實用預設值。
步驟 1:將兩個工具指向同一個模型
建立一個 API 金鑰和一個基本 URL,然後將相同的配對提供給兩個工具。在 Atlas Cloud 控制台 建立金鑰,並匯出一次:
plaintext1export ATLAS_API_KEY="your-api-key" 2
在交給任何一個框架之前,先檢查端點:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Reply with the single word: ready"}] 7 }' 8
該呼叫證明路由、金鑰和模型 ID 在框架添加工具、重試或對話重播之前即可運作。
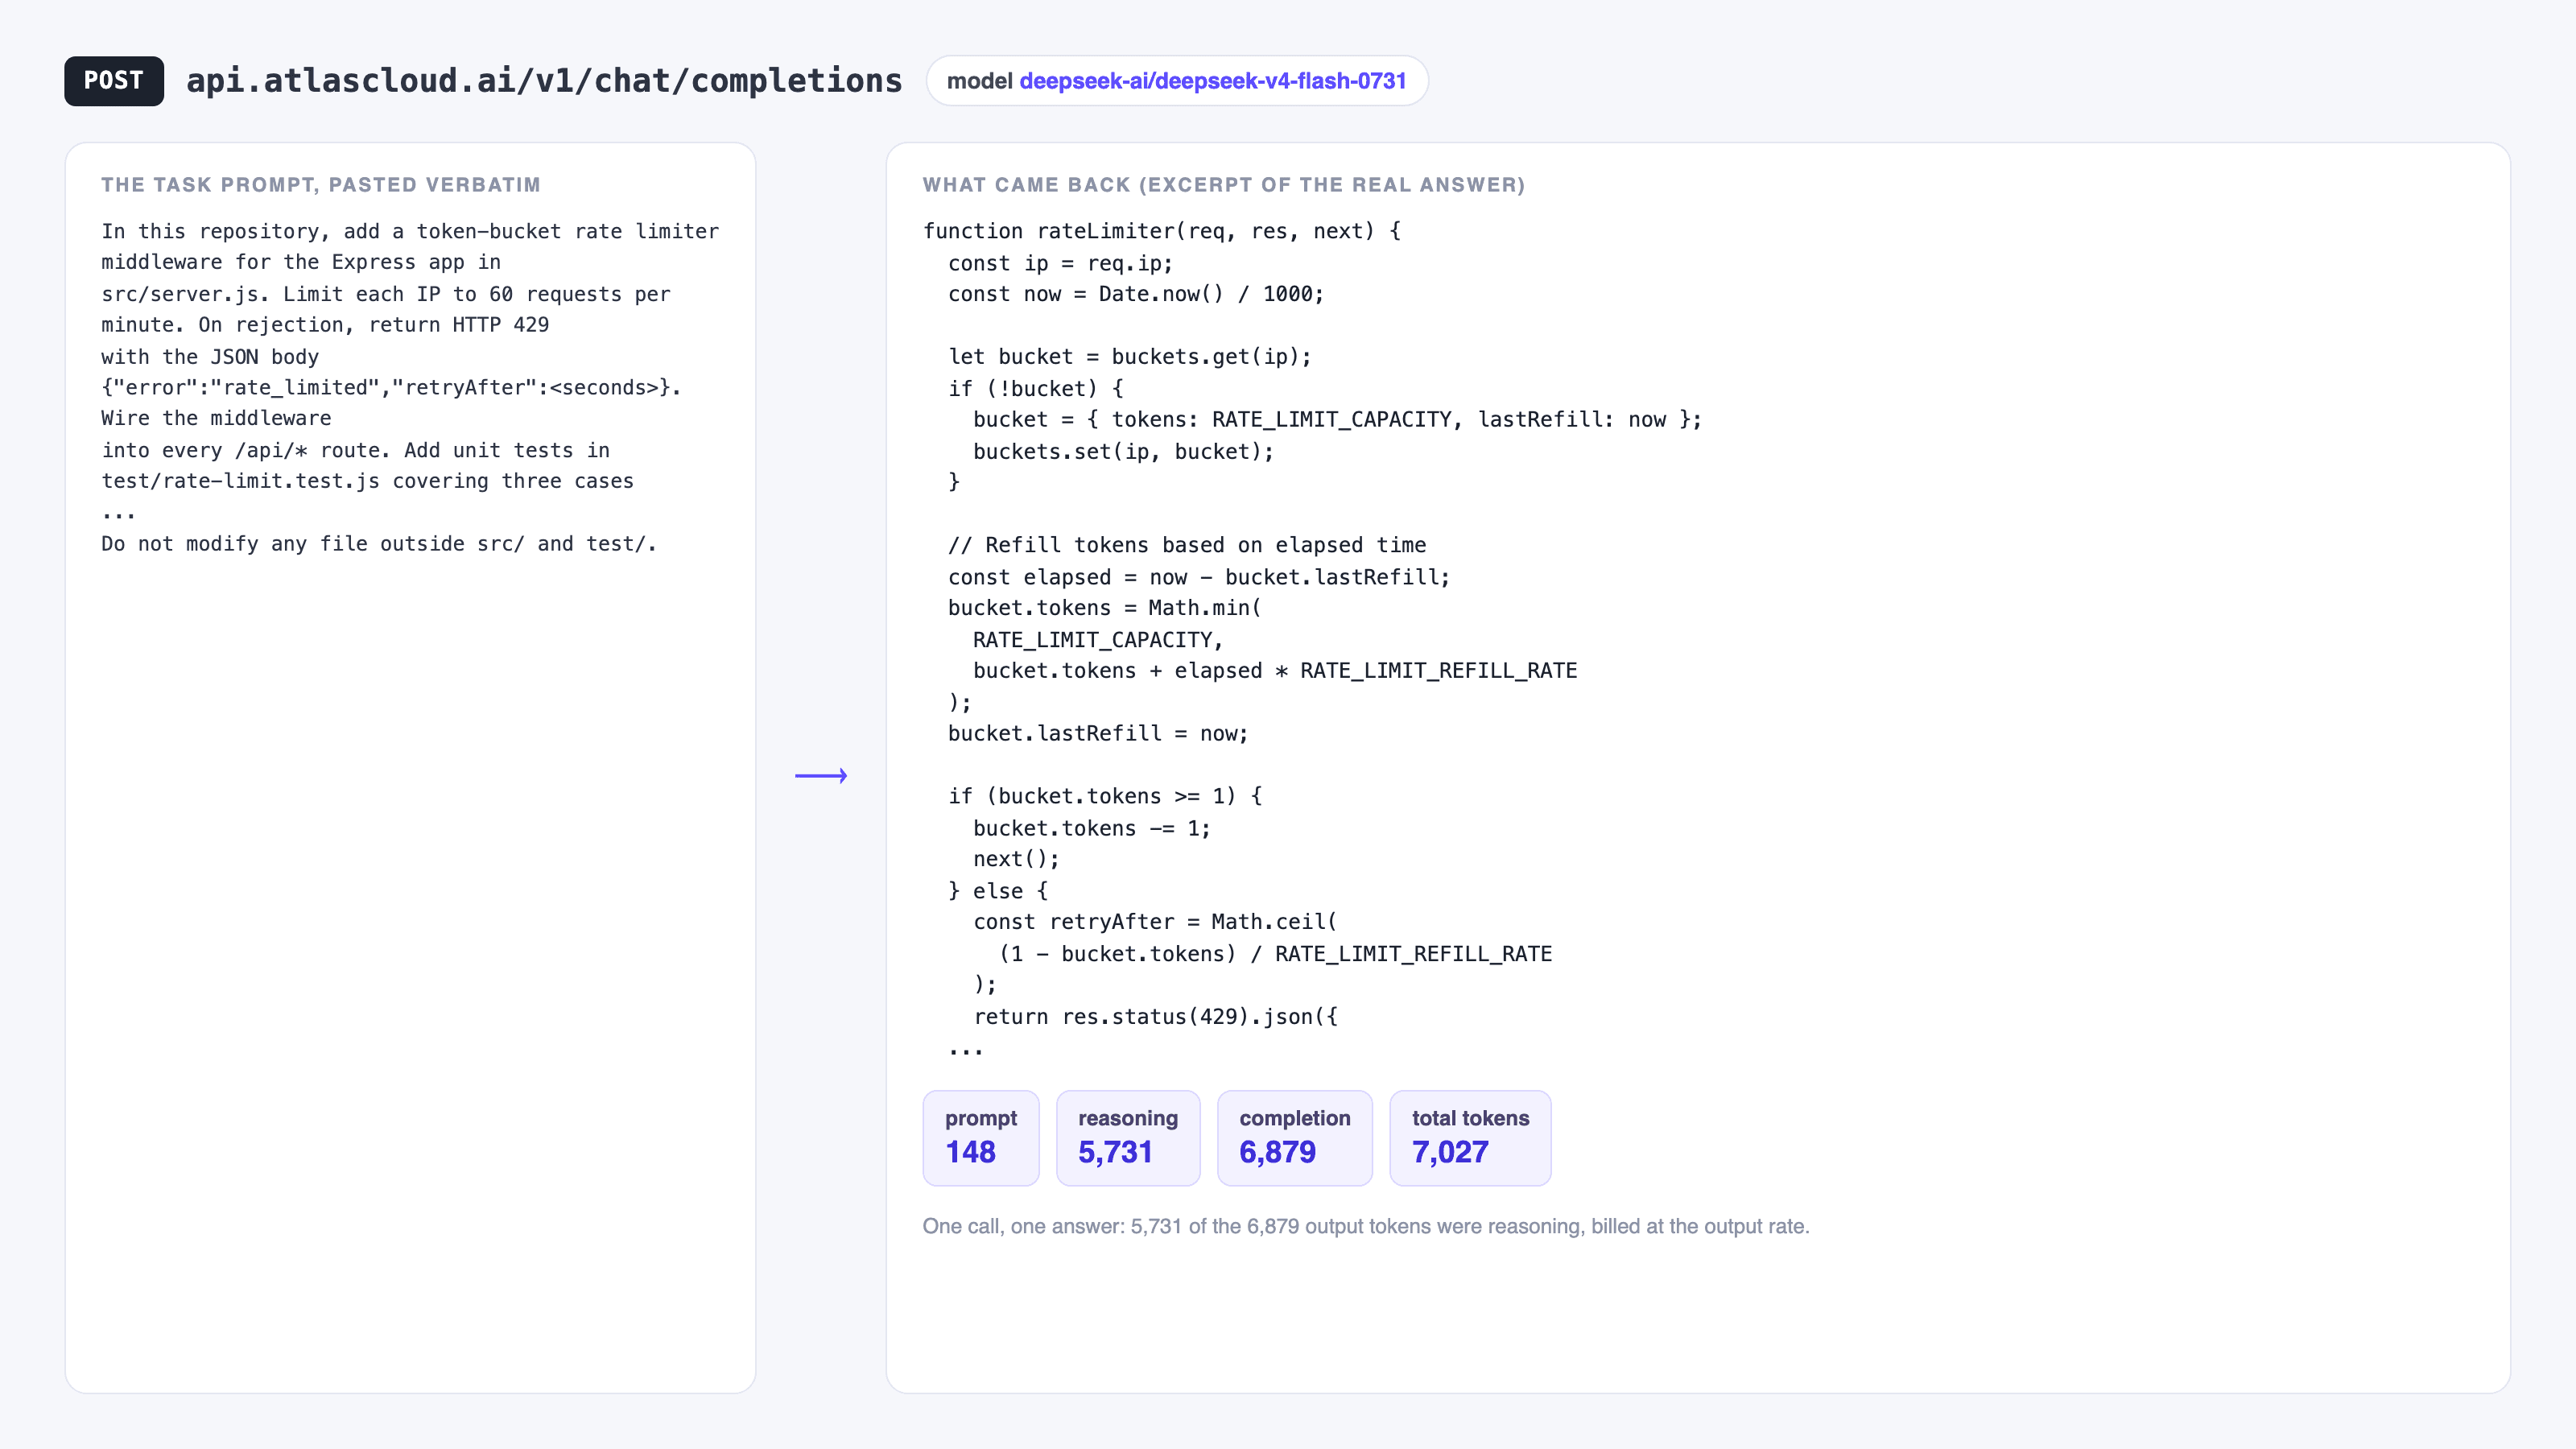
編碼提示、產生的程式碼和來自一個模型呼叫的 token 統計
對 deepseek-ai/deepseek-v4-flash-0731 的一次直接呼叫:輸入 148 個 prompt token,輸出 6,879 個 token,其中包括 5,731 個推理 token。將此視為框架添加工具架構和歷史記錄之前的最低基準。
DeepSeek Harness 讀取 $DSH_HOME/settings.yaml,自訂的 OpenAI 相容提供者放在 llm-pi-ai 外掛下(DeepSeek Harness 文件,2026 年 8 月):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
此端點使用 openai-completions。Web UI 可以從「設定」→「模型」→「新增自訂提供者」寫入相同的提供者區塊,然後將金鑰儲存在 $DSH_HOME/.credentials.yaml 中。
OpenCode 讀取專案根目錄或全域設定目錄中的 opencode.json(OpenCode 文件,2026 年 8 月):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
使用 @ai-sdk/openai-compatible,因為此端點提供 /v1/chat/completions。設定真實的上下文和輸出限制。OpenCode 在決定何時進行摘要時會使用它們,錯誤的限制可能會扭曲 token 比較。
步驟 2:在 DeepSeek Harness 中執行相同的基準測試任務
選擇一個足夠大而需要多次工具呼叫、又足夠小而可以評分的任務。兩個執行使用相同的儲存庫狀態,因此在開始前請提交或暫存。
將這個確切的任務貼到兩個工具中:
plaintext1在此儲存庫中,為 src/server.js 中的 Express 應用程式新增一個 token bucket 速率限制器中間件。將每個 IP 限制為每分鐘 60 個請求。拒絕時,回傳 HTTP 429,並帶有 JSON 主體 {"error":"rate_limited","retryAfter":<seconds>}。將此中間件應用到所有 /api/* 路由。在 test/rate-limit.test.js 中新增單元測試,涵蓋三種情況:低於限制的請求被允許;超過限制的請求被 429 封鎖;計數器在視窗過期後重置。執行測試套件並修復失敗,直到通過。請勿修改 src/ 和 test/ 以外的任何檔案。
從你的專案目錄啟動 Harness:
plaintext1cd /path/to/your/repo 2npx @deepseek-ai/dsh web 3
UI 在 http://127.0.0.1:3080 執行。選擇 atlas 提供者和 deepseek-ai/deepseek-v4-flash-0731 模型,貼上任務,然後讓它完成。執行開始後不要新增提示。為一個工具提供額外協助會使比較失效。
當 Harness 完成時,開啟「Trajectory」檢視。該會話記錄就是 token 數字所在的位置。
步驟 3:在 OpenCode 中重複執行
將儲存庫重設為確切的起始狀態。第二個框架不能繼承第一個框架已經修改的檔案。
plaintext1git checkout -- . && git clean -fd 2
然後針對同一個模型執行 OpenCode:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
貼上步驟 2 中的相同任務提示。使用預設的 build 代理。讓它完成,不要提供提示。
使用相同的指令對兩個執行進行評分:
plaintext1npm test 2
如果執行使測試套件保持紅色,則視為失敗,即使代理摘要聽起來很有信心。使用二元評分:通過或失敗。
步驟 4:讀取 token 用量
兩個工具都會追蹤用量,但這兩個計數器都不應作為你的最終帳單數字。
DeepSeek Harness 預設掛載了一個 token 計量表。它在「Trajectory」檢視中公開 tokenUsage、contextPressure 和 contextBreakdown。contextBreakdown 告訴你帳單來自系統提示、工具架構、檔案讀取還是對話重播。該計量表估計大約每四個字元一個 token,因此將其用作診斷檢視。
OpenCode 追蹤每個會話的 token 和成本,並在 TUI 狀態列中顯示。其內建的細分較小,因此需要按工具歸因的團隊通常會使用外部分析器檢查會話資料庫。
使用提供者端的數字進行比較:
| 比較項目 | 獲取位置 |
|---|---|
| 輸入 token 總數 | 提供者用量儀表板,依 API 金鑰 |
| 輸出 token 總數 | 提供者用量儀表板,依 API 金鑰 |
| 模型呼叫次數 | 框架軌跡檢視 / OpenCode 會話日誌 |
| 實際時間 | 碼表,從開始到最後一次檔案寫入 |
| 通過或失敗 | npm test 退出碼 |
建立兩個 API 金鑰,harness-test 和 opencode-test,並為每個執行使用一個金鑰。然後提供者儀表板會為你提供乾淨的並排用量,而無需調和兩個內部估算器。
為什麼帳單會變動
Token 用量的變化有具體原因。這五個通常比模型價格更重要。
對話重播會增加成本。 代理在每一步都會重新發送不斷增長的對話。一個 40 步的任務成本接近 40 個增長提示的總和,而不是 40 個相同的提示。及早進行摘要的框架會更接近基準測試分佈的低端。
快取命中可降低輸入成本。 DeepSeek V4 Flash 的快取命中價格約為每百萬個 token 0.0028 美元,而未命中則為每百萬個 0.14 美元,便宜約 98%。快取需要逐字元穩定的前綴。如果框架在呼叫之間打亂系統提示文字,就會將命中轉變為未命中。
工具架構會跟著跑。 二十個連接的 MCP 伺服器意味著提示中有二十個架構集,即使任務只用到其中兩個。在進行基準測試之前,請先斷開不需要的工具,否則你測量到的是工具設定,而不是框架。
大型工具輸出會污染上下文。 一個 3,000 行檔案的 cat 或一個冗長的失敗測試日誌會保留在後續呼叫的對話中。DeepSeek Harness 可以在摘要之前修剪過大的工具結果。當任務產生嘈雜的輸出時,請開啟此功能。
重試隱藏在呼叫次數中。 重試失敗測試循環的框架每次都會花費 token。將模型呼叫與 token 總數進行比較,這樣你就可以區分重試循環和昂貴的提示。
以 Atlas Cloud 的 DeepSeek V4 Flash 費率計算,一個 692,000 token 的任務(偏向輸入)成本落在個位數美分。對單次執行來說很小,但對整天運行代理的團隊來說則很大。如果你想在另一個模型上重複測試,並將模型效果與框架效果分開,請瀏覽完整的模型目錄。
DeepSeek Harness 仍是開發者預覽版,其 README 警告可能會有破壞性變更。如果你想要控制代理循環,請對其進行基準測試。只有當你的團隊能夠承受變動時,才將其標準化。OpenCode 是對於今天就需要一個工具的團隊來說更穩定的選擇。
常見問題
DeepSeek Harness 比 OpenCode 好嗎?
對大多數團隊來說還不是。OpenCode 成熟、原生終端、約有 198k 星級、提供者目錄龐大,而且今天就能運作。DeepSeek Harness 較新、處於開發者預覽版,並警告可能會有破壞性變更。如果你想要修改代理內部機制,請選擇 Harness。如果你想要一個用於日常工作的編碼代理,請選擇 OpenCode。
DeepSeek Harness 只能與 DeepSeek 模型搭配使用嗎?
不。它與模型無關。它內建了 DeepSeek、Anthropic、OpenAI、Bedrock、Vertex、Azure 和 Codex 的提供者目錄,並且你可以在 $DSH_HOME/settings.yaml 中新增任何支援 openai-completions、openai-responses 或 anthropic-messages 協定的自訂提供者。步驟 1 中的設定將其指向一個 OpenAI 相容端點,無需適配器程式碼。
如何檢查 DeepSeek Harness 的 token 用量?
使用「Trajectory」檢視中的內建 token 計量表。它公開 tokenUsage、contextPressure 和 contextBreakdown。將其視為估算值,因為它使用大約每四個字元一個 token。若要獲得帳單準確性,請閱讀提供者用量儀表板,最好為每個執行使用專用的 API 金鑰。
哪個框架使用較少的 token,DeepSeek Harness 還是 OpenCode?
目前還沒有公開的對決基準測試可以回答這個問題。Composio 基準測試測量 OpenCode 平均每個任務 692,000 個 token,但該測試是在 DeepSeek Harness 發布之前進行的。在你的自己的儲存庫上執行步驟 2 到步驟 4 的測試,因為 token 用量取決於程式碼庫大小、工具設定和任務形狀。
我可以對同一個 API 金鑰執行 DeepSeek Harness 和 OpenCode 嗎?
可以,進行粗略測試時可以。若要進行乾淨的測量,請使用兩個不同的金鑰,每個框架一個。然後提供者儀表板會將每個 token 歸因於正確的執行。
代理和框架之間有什麼區別?
DeepSeek 將代理描述為模型加框架。模型負責推理。框架負責將模型連接到檔案、shell 指令、工具、會話、批准以及決定下一步行動的循環。更改框架,同一模型可能會在同一個任務上花費不同數量的 token。


