百萬 token 的上下文視窗只代表模型可接受多少文字,不代表它能多可靠地解讀每一個條款。就 DeepSeek V4.1 Flash 長文件分析準確度 而言,公開證據有用但不完整:DeepSeek 的模型卡指出,V4.1 Flash 基礎模型在 1-shot 設定下於 LongBench-V2 取得 45.2 精確匹配分數,而 API 之後已改用較新的 1017 版本。該基準測試只是某個評估設定的訊號,不是你合約、年報或研究檔案庫的通過率。
實務上的做法,是使用 Flash 進行快速檢索與第一輪綜合整理,接著針對重要決策要求頁面層級證據並由人工審查。本文引用的公開來源,都沒有提供可重現、針對目前版本、涵蓋下列五項文件任務的評估。此測試計畫是一套可直接執行的協定,不是聲稱這些測試已經跑過。
重點摘要
- 此模型系列支援最多 1M token,但上下文限制並非準確度保證。
- 已發布的 45.2 LongBench-V2 分數是針對基礎模型與 1-shot 基準設定。
- DeepSeek 的 API 目前提供 V4.1-Flash-1017;其版本說明未公布新的長文件分數。
- 要求提供證據位置、對照來源檢查,並在你自己的文件上衡量錯誤。
1M token 視窗對文件分析代表什麼
DeepSeek 的模型卡說明 V4.1 Flash 支援最多一百萬 token 的上下文。API 文件目前標示所服務的模型為 DeepSeek-V4.1-Flash-1017,並列出 1M 上下文長度。這些都是容量規格。它們無法證明模型多常找到註腳、將兩份文件版本區分開來,或承認請求的事實不存在。(DeepSeek 模型卡)
一個 token 不等於一頁。頁數會因表格、註腳、版面、語言與擷取品質而異。掃描的 PDF 可能需要 OCR;表格轉成文字時可能遺失列標籤;頁首與重複的頁面元素會消耗上下文,卻對問題沒有幫助。提示與要求的答案也會使用 token。因此,名目上一百萬 token 的上限,並不代表每個百萬 token 的檔案都能透過每個聊天介面或 API 用戶端完整送達。
測試前,請記錄確切的模型識別碼、用戶端與輸入方式。檢查是否送出完整擷取文字、供應商是否截斷,以及請求是否送到預期的模型版本。目前的 DeepSeek API 針對最新 Flash 版本使用 deepseek-flash。如果你的閘道或 SDK 使用其他別名,請記錄該別名並驗證其路由。要設定可重複執行代管呼叫的團隊,可從 Atlas Cloud 的模型平台 開始,然後開啟其 DeepSeek V4.1 Flash API 列表。
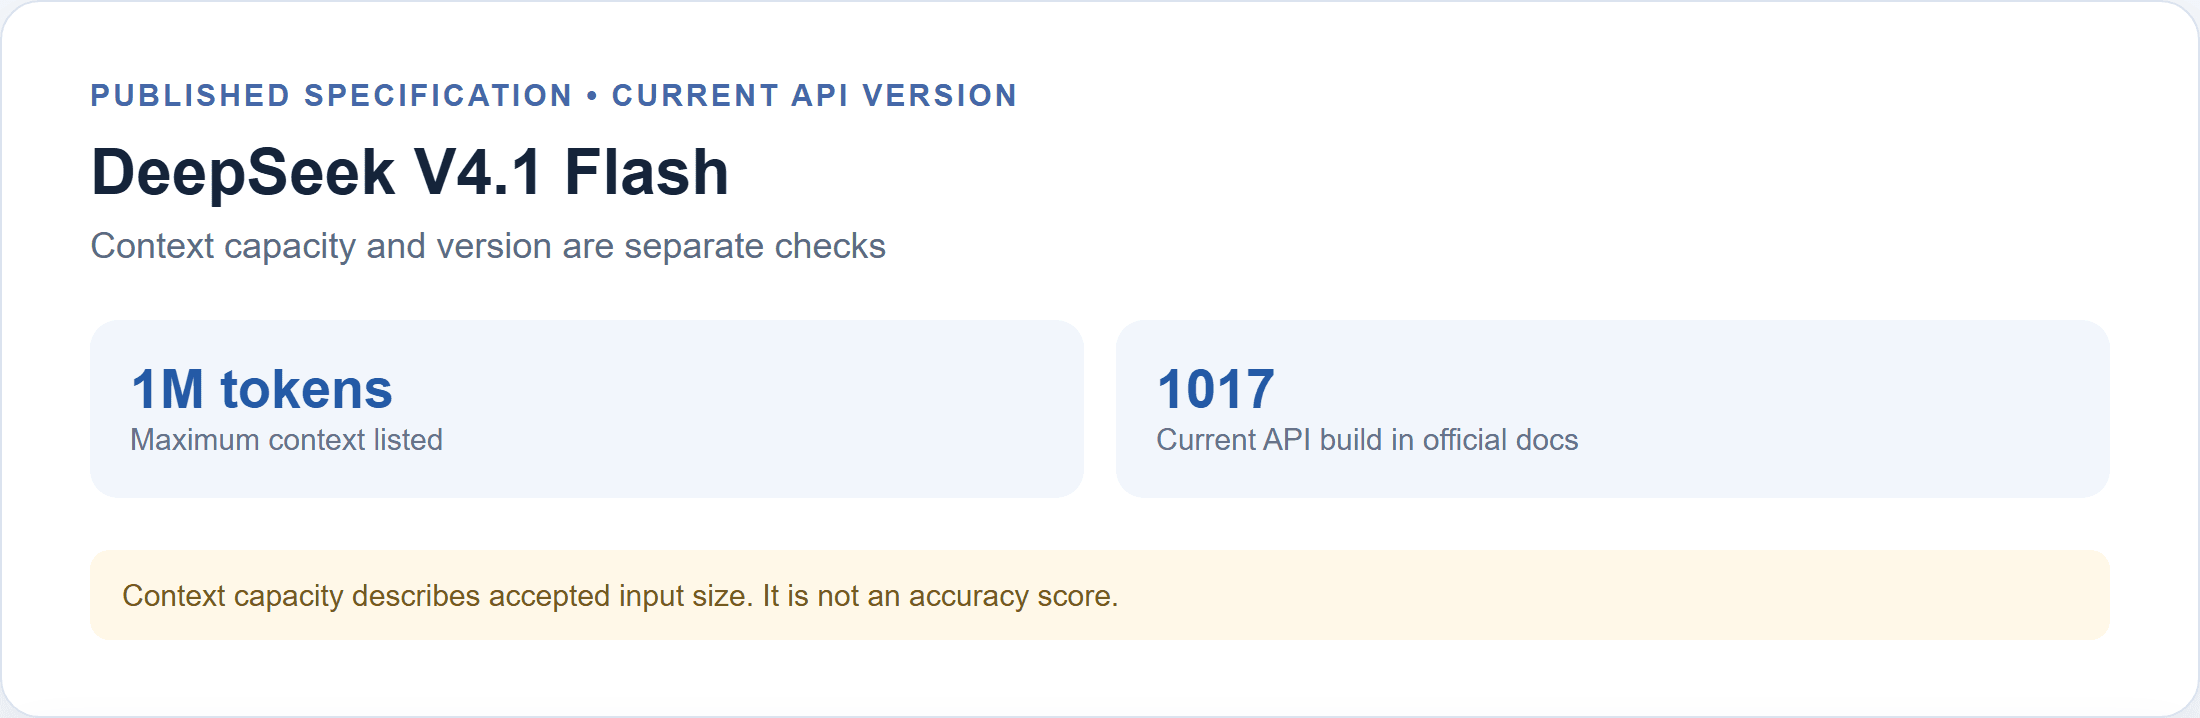
已發布的規格提供 1M 上下文上限;目前的 API 文件標示為 1017 版本。
上傳或請求成功只表示系統接受了輸入。若要確認某個相關細節影響了答案,請要求精確位置、取回該段落,並確認周遭文字支持該說法。
LongBench-V2 分數顯示與不顯示什麼
模型卡的 LongBench-V2 列顯示 1-shot 設定下的精確匹配分數。其表格將結果標示為基礎模型評估,並表示所有基礎模型都使用相同的內部評估框架。它也指出,分數差距在 0.3 以內視為等效。數值如下:
| 模型卡中的基礎模型 | LongBench-V2 (EM) | 樣本數 |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
V4-Flash-Base 與 V4.1-Flash-Base 之間的 0.5 分差距大於模型卡所述 0.3 的等效範圍,但這仍是幅度很小的基準比較。45.2 並不是「長 PDF 上 45.2% 的準確率」。它是特定基礎模型、基準集、提示設定與評估器的精確匹配分數。它並不直接評估以不同提示回答你問題的代管的指令/API 模型。
LongBench-V2 包含 503 道選擇題,涵蓋六個類別,包括單文件與多文件問答、長對話、程式碼儲存庫,以及結構化資料。其上下文範圍從 8,000 到 200 萬字。基準作者報告,專家在 15 分鐘限制下的平均準確率為 53.7%,而在其報告的評估中,最佳直接回答模型的準確率為 50.1%。其廣度讓它成為有用的壓力測試,但總體數字無法診斷哪一項文件操作強或弱。(LongBench-V2 論文)
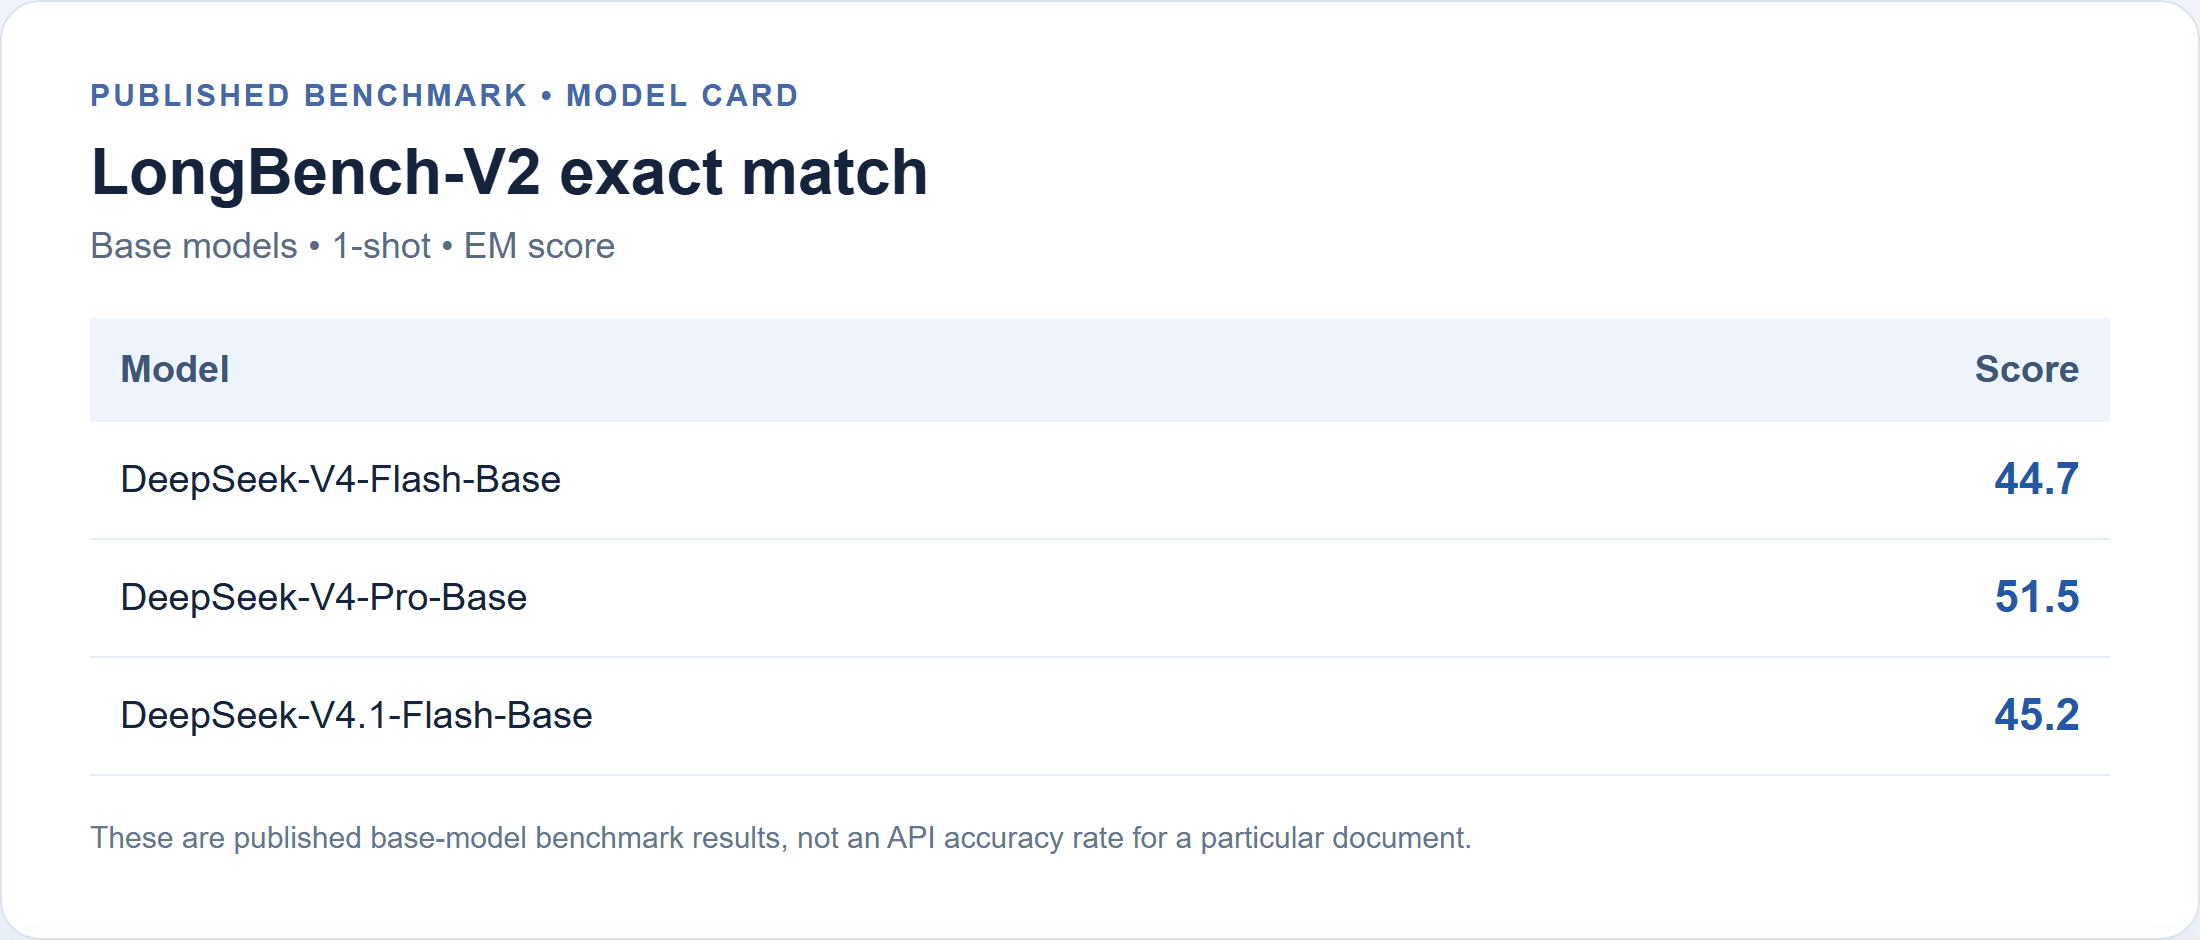
已發布的列是基礎模型、1-shot 的結果。它不是測量所得的 API 通過率。
這裡有一個版本注意事項。DeepSeek 的 10 月 17 日版本說明指出,API 與網頁應用程式已升級至 V4.1-Flash-1017,且 API 模型名稱仍為 deepseek-flash。版本說明列出更新的代理與推理基準,但未報告新的 LongBench-V2 結果。因此,45.2 仍是 V4.1 Flash 基礎模型有用的已發布參考,而目前 API 版本在長文件問題上的準確率,在那些來源中仍未量化。不要把無關的基準提升轉移到文件問答上。(DeepSeek V4.1-Flash-1017 更新)
如何執行公平的長文件準確度測試
有用的評估需要固定來源、答案鍵與評分規則。從版本與頁面結構可分享的公開年報或技術報告開始。儲存 PDF 與擷取文字,記錄來源 URL 與擷取日期,並註明你使用的是原生文字擷取還是 OCR。避免因為你已經知道模型處理某份文件處理得很好,就選擇該文件。
在提示模型之前,先自己根據來源撰寫答案鍵。針對每個問題,記錄預期答案與確切頁面或章節。這可防止有說服力的回答成為評分標準。問題要具體到足以評分,同時保留讀者實際會面臨的模糊性。
每次執行都使用相同的文件、問題集、模型識別碼、提示、推理設定與輸出格式。如果 API 暴露 temperature 或推理控制項,請記錄它們。如果想估計變異性,請將同一組執行多次;單次執行只是一個樣本,不是穩定比率。評分前不要默默修正輸出。
一組精簡測試即可涵蓋五種不同的失敗機會:
| 任務 | 範例問題形式 | 要驗證什麼 |
|---|---|---|
| 單點查詢 | 「報告針對修訂後的政策給出什麼日期?」 | 確切數值與引用頁面 |
| 跨章節連結 | 「第 2 節的風險與第 7 節的控制有何關聯?」 | 兩個段落,以及該連結是明述還是推論 |
| 例外處理 | 「誰被排除在所述保障範圍之外?」 | 註腳、範圍與限定條件 |
| 版本衝突 | 「修訂後適用哪個數值,它取代了什麼?」 | 日期、版本標籤與兩個位置 |
| 資訊缺失 | 「報告針對供應商副本指定什麼保留期限?」 | 文件未提及時是否承認 |
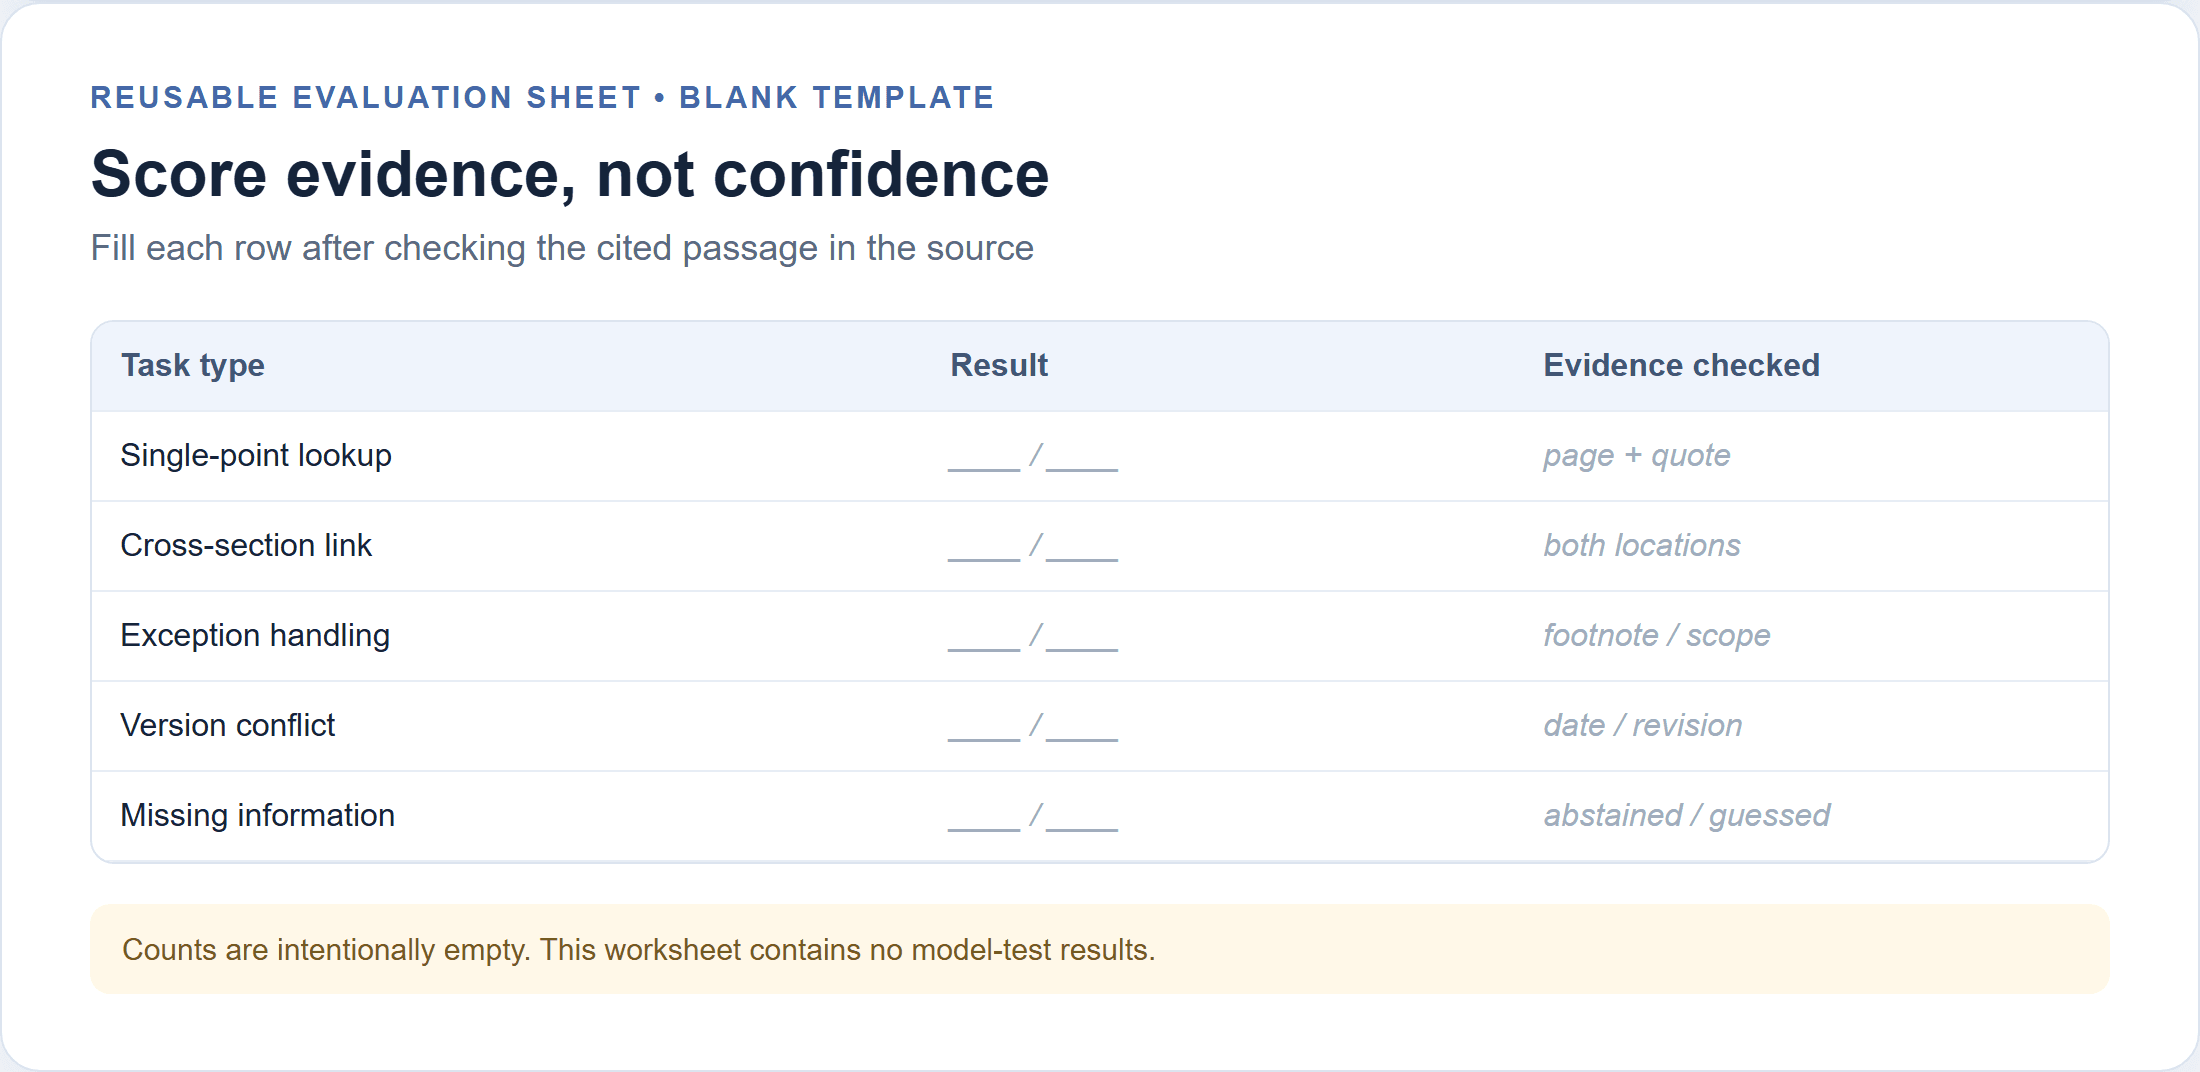
這是空白評分工作表,不是結果表。請僅在將每個答案與來源文件核對後填寫。
將每個答案評為正確、部分正確、錯誤、無依據或正確棄答。將無依據的主張與錯誤答案分開計算,因為回答可能給出正確的主要答案,卻捏造細節。檢查每個引用是否指向支持該主張的段落。一併報告問題總數與各類別數量。總體百分比會掩蓋模型是漏掉註腳,還是只在資訊分散於各章節時才出錯。
保留確切的來源檔案、擷取內容、提示、原始回應與評分表。只發布你有權分享的資料,並遮蓋機密名稱或帳戶詳細資料。審查者應該能夠從模型輸出追蹤每個已評分答案,直到已儲存來源中的某一頁。
長文件答案通常在哪裡出錯
如果沒有針對指定文件、以目前版本執行,就聲稱 V4.1 Flash 表現出特定錯誤率或失敗模式,會是錯誤的。以下類別是可供檢查的事項,不是關於此模型的實測發現。
先從範圍遺失開始。本文段落可能陳述一項規則,而註腳將其限制到某個地區、日期範圍或客戶類別。請明確要求例外,並檢查引用的段落是否包含該例外。只引用主要段落可能不足。
接著檢查版本混淆。報告可能在草案與修訂章節中重複類似的數值。請要求模型說出每個數值所附的日期或版本,而不是只要求「目前數字」。如果它默默選擇其中一個,即使碰巧選對,也應將該回答評為不完整。
跨章節問題容易引發推論。模型可能將兩項準確事實組合成文件從未提出的因果解釋。要求它將直接陳述與推論分開標示。接著將推論與證據比較,判斷就該任務而言是否合理。
最後,測試棄答。納入一個答案不存在的問題。有自信的猜測即使聽起來合理,仍是失敗。對於合約、合規、臨床資料或具重大後果的財務分析,在使用結論前,請合格人員檢查原文。
更安全答案的驗證工作流程
這個提示可讓答案更容易稽核。它不能保證正確性,也不能取代來源審查。請搭配可保留頁面標籤的擷取方式使用,然後提出聚焦問題,而不是要求對龐大檔案做一般性摘要。
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
對於長報告,依任務拆分工作,而不是自動依任意頁數拆分。先要求來源對照表:章節標題、日期、定義術語與相關表格。接著查詢特定主題並要求其支持段落。若要得出跨章節結論,請在同一回合提供或取回兩個段落,並要求模型解釋連結,同時標示任何推論。
使用人工驗證循環:
- 在原始檔案中檢查引用的頁面與引文。
- 確認引文包含鄰近的例外與表格標題。
- 將每項主張標為直接、推論、無依據或矛盾。
- 如果擷取遺漏重要結構,修正提示或拆分任務。
- 儲存原始請求與回應,讓審查者能重現決策。
當你使用代管端點時,請在執行記錄中包含 token 用量。Atlas Cloud 的 模型定價頁面 目前列出 DeepSeek V4.1 Flash 為每 1M 輸入 token $0.30、每 1M 輸出 token $1.20,以及每 1M 快取讀取 token $0.03,且未列出折扣。編列預算前請查看目前列表。此價格參考適用於 Atlas Cloud,並非通用的 DeepSeek API 價格。
依上述列價,100,000 個未快取輸入 token 與 3,000 個輸出 token 的成本約為 $0.033:輸入 $0.030 加上輸出 $0.0036。
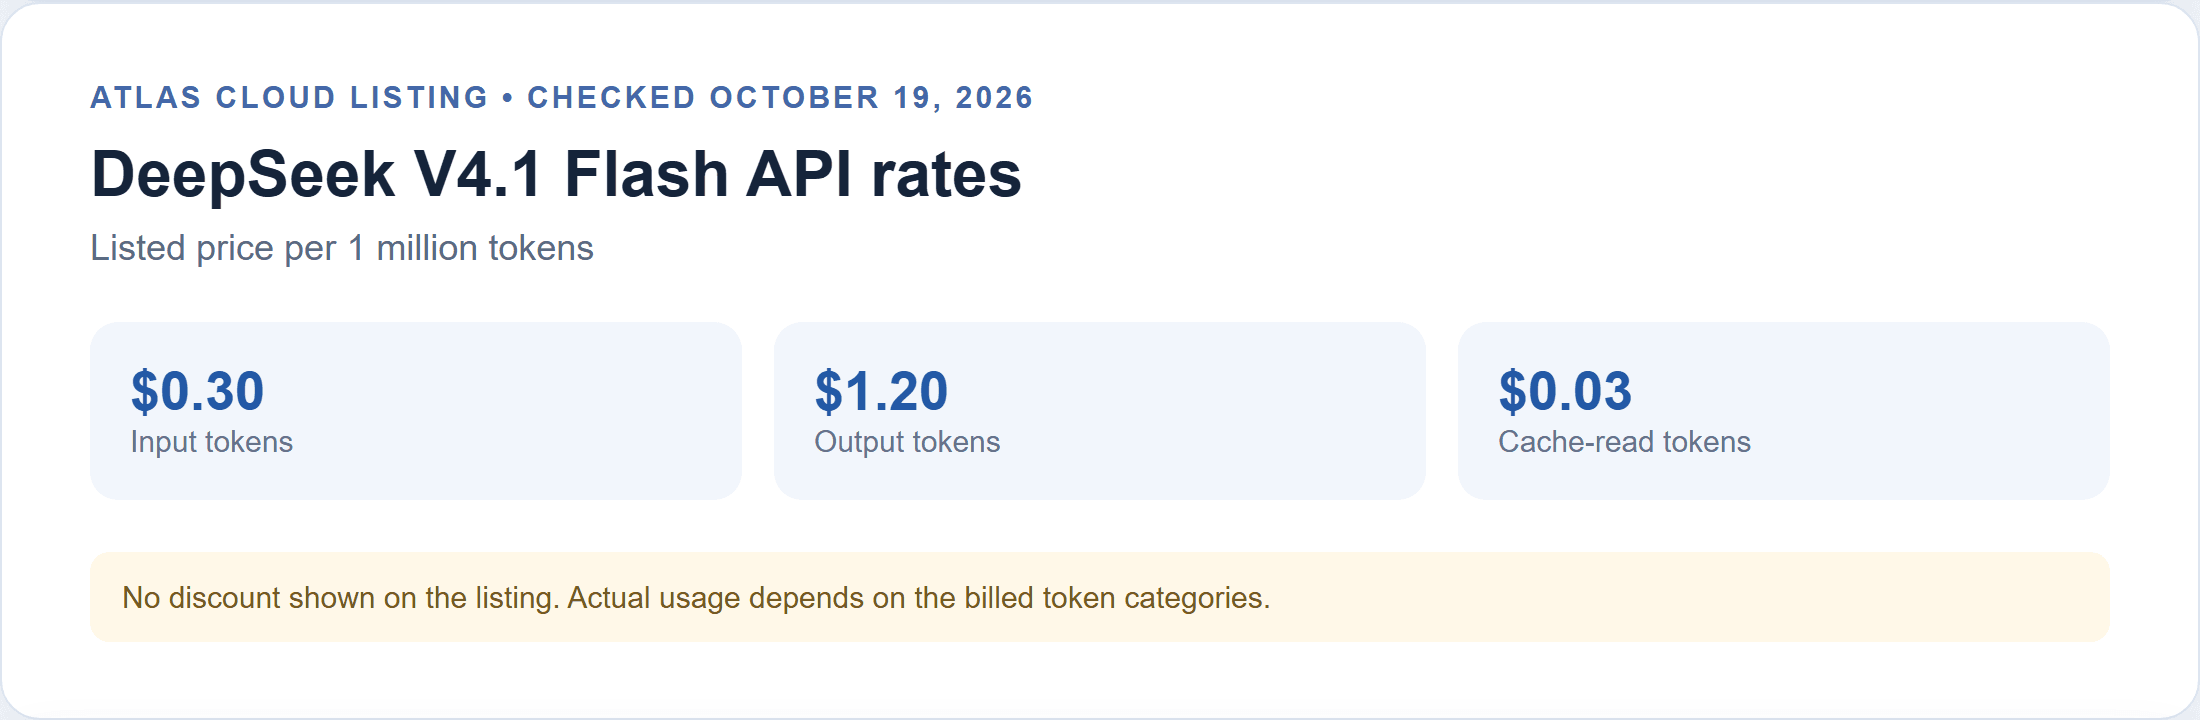
Atlas Cloud 定價查核於 2026 年 10 月 19 日;列表顯示無折扣。 在相同費率下,1M token 輸入與 20,000 token 答案的成本約為 $0.324,尚未計入快取處理或其他計費項目。這些是算術範例,不是實測的文件測試帳單。實際輸入包含提示與擷取文字;重複呼叫會增加用量。請使用供應商回傳的 token 數量,而不是從頁數估算。
何時該使用 DeepSeek V4.1 Flash 處理長文件
當你需要定位定義、收集日期、建立章節地圖,或草擬一份會由人工檢查的摘要時,Flash 是合理的第一輪工具。這些任務有可見的證據軌跡,且容易用更精確的問題重跑。對於重複性工作,請保留已知答案的問題,並在模型版本、擷取流程或提示變更時重新執行。
當問題合併相距遙遠的章節、依賴註腳或比較修訂版本時,請增加控制措施。將引用視為導覽輔助,而非本身即為證明。如果答案會影響合約義務、合規立場、財務揭露或其他高影響決策,請由合格審查者驗證來源中的每項重大主張。
有用的問題是:此模型在你版本的文件與確切工作流程上,是否會回傳經得起檢查、附有證據的答案。這才是能為你自己的使用情境建立 DeepSeek V4.1 Flash 長文件分析準確度 的測試。
常見問題
1M token 上下文視窗是否代表模型能準確分析 1M token 的文件?
不能。它描述的是支援的上下文容量。實際請求還包含指令與輸出預算,而擷取、介面限制與問題難度都會影響有用的證據是否可用並被正確解讀。
LongBench-V2 與文件問答準確度相同嗎?
不同。它包含數種長上下文任務類別,並在特定設定下報告效能。它是一種比較訊號,不是對特定 PDF、API 版本、提示或領域的保證。
我應該使用單一提示,還是將長文件拆成多個章節?
當結構重要時,使用來源對照表與聚焦問題。將必須比較的段落一起保留給綜合步驟使用,並保留頁面標籤,以便驗證回應。
我應該如何驗證 AI 生成摘要中的引用?
在原始檔案中開啟每個被引用的頁面,檢查引文與周遭文字,並確認該段落支持特定主張。除了被引用的句子,也要驗證表格標題與註腳。
輸入與輸出 token 如何影響成本?
輸入 token 涵蓋文件、指令與問題。輸出 token 涵蓋答案。較長的提示、多次呼叫與重複段落會增加用量;估算時請使用計費的 token 數量與目前的供應商價格表。





