當你能看見並聽見每句台詞由誰所說,兩人場景才會令人信服。為了讓 Gemini Omni 1.2 Flash 多人對話容易理解,請給每個角色固定的視覺與聲音身分,按說話順序撰寫簡短台詞,並用眼睛和耳朵檢視完成的影片。Google 2026 年 11 月的更新支援更自然的多人語音,以及最長 15 秒的片段,但提示詞無法保證第一次算圖就能乾淨地指派說話者。先從簡單的兩人一來一往開始,等到你能判斷基本的交接後,再加入第三輪對話或街頭環境音。
重點摘要
- Gemini Omni 1.2 Flash 會生成帶有原生聲音的影片,包括對話;它不同於僅有音訊的 Gemini 文字轉語音模型。
- 使用具名說話者、精確引號台詞、清楚位置,以及每一輪保持沉默的聆聽者。
- 在 15 秒上限內預留停頓空間,然後將每一句台詞與片段核對。
- 算圖價格應依所選時長與解析度計算,而不是平台廣告的最低費率。
Gemini Omni 1.2 Flash 中的多人對話是什麼意思?
此模型會製作一段短場景,其中人物能在生成的音訊與影片中說話。實際的測試標準是:觀眾能否在不讀逐字稿的情況下分辨每句台詞由誰所說。詞語、聲音、可見人物和嘴部動作必須同時一致。一段片段在靜音時看起來有說服力,仍可能無法通過這項測試。
Google 於 2026 年 11 月 5 日宣布 Gemini Omni 1.2 Flash,支援最長 15 秒的生成或編輯影片。它描述更流暢的對話、更清楚的脣形同步,以及更明確的多人說話者條件控制。這些是能力宣稱,並不保證每份腳本都會完全照寫的內容呈現(Google 2026 年 11 月公告)。
Google 發布的示範展示了其宣布的能力。它與下方三個提供的影片案例各自獨立。
相較於 Gemini Omni 1.1 Flash 有何改變?
官方比較指出 1.2 的上限更長:15 秒而非 10 秒。它也提到語音、脣形同步、參考遵循和對話式編輯方面的改進。額外的 5 秒讓三段式一來一往更容易寫進腳本,但如果導演同時要求停頓、肢體反應和場景變化,更長的時長並不會創造更多說話時間。
最安全的解讀是方向性的。更好的條件控制可能讓對話更容易執導,但每個交付的片段仍需檢查。創作者可以用 15 秒上限設定腳本目標。若製片人承諾精確的法律文案或精準的聲音匹配,應將生成輸出視為草稿,直到通過審查為止。
影片對話與多人文字轉語音
Gemini 文字轉語音模型接受文字並回傳音訊。其說話者設定與聲音選擇屬於該音訊工作流程,Google 另有一份文件說明(Google 的 Gemini 文字轉語音文件,取用於 2026 年 11 月)。Gemini Omni 1.2 Flash 的文字轉影片路徑接受場景提示詞,並產生帶有原生聲音的影片。文字轉語音的 speech_config 範例不是 Gemini Omni 1.2 Flash 的影片控制項。這些範例以文字描述聲音特質;它們並不聲稱能上傳、複製或選擇某個錄製的聲音。如果簡報要求特定演員的聲音,請在規劃鏡頭前另行確認該存取權與同意。
如果你的交付物是播客對話或定稿旁白,請使用文字轉語音,並圍繞該音訊剪輯畫面。如果是兩人在生成場景中明顯地說話,請使用 Gemini Omni 1.2 Flash 影片,並在實際輸出中測試對位。
可以在哪裡執行,以及一段影片要多少錢?
選擇文字轉影片路徑
Google 在其創意與開發者產品中列出 Gemini Omni 1.2 Flash。若要进行可重現的測試,請使用同一條路徑:Atlas Cloud 提供此模型,而其 Gemini Omni 1.2 Flash 文字轉影片測試場 可讓你貼上下方提示詞。路徑 ID 是 google/gemini-omni-1.2-flash/text-to-video。下方提示詞僅使用文字,不含圖像、動作或聲音參考。
提示詞要求:辦公室為 16:9、12 秒;咖啡館為 16:9、15 秒;街頭採訪為 16:9、12 秒。三個提供的檔案皆為 720p。在按下 Run 前,請確認實際控制項與所選值。產品頁上宣傳的設定,並不證明某次特定測試執行接受了它。將所選值與報價和每個輸出一起儲存。這會讓每次算圖都成為有用證據:檢視輸出時,你可以將提示詞與所選解析度及路徑進行比較。本指南指定文字轉影片路徑,因此來自圖片轉影片或參考轉影片路徑的結果應另行標明。
提供的影片檔案不包含完整的測試場截圖、所選設定或提交前報價。因此其路徑與配置仍未經驗證。
| 路徑 | 本指南的輸入 | 最適合 | 在哪裡驗證成本 |
|---|---|---|---|
| Google 創意產品 | 場景提示詞;控制項因產品而異 | 在 Google 編輯器中手動創作 | 目前方案或點數畫面 |
| Google API | 開發者影片請求 | 應用程式整合 | Google 對精確解析度的價格 |
| Atlas Cloud 文字轉影片 | 提示詞、時長、長寬比、解析度 | 在同一測試場重複這些純文字測試 | 所選配置的提交前報價 |
算圖前先確認價格
Google 透過其 API 對 720p 的報價為每生成秒 $0.07,比 Gemini Omni 1.1 Flash 低 30%。以該報價計算,12 秒的 720p 是 $0.84,不含任何其他計費工作。該計算不是 Atlas Cloud 對所提供檔案的報價;其路徑與計費未經驗證。Flow 或其他編輯器中的點數遵循該產品自身的規則。
Atlas Cloud 在其 模型目錄 上列出較低的每秒_起始_費率,但最低價可能對應另一種解析度或配置。選擇時長與解析度後,請閱讀即時報價。360p 草稿有助於探索提示詞;它是另一次生成,而不是後續 1080p 算圖的逐格預覽。
將兩個聲音塞進 15 秒場景
給每位說話者視覺與聲音身分
撰寫審查者能驗證的描述。「說話者 A 在左側,穿海軍藍襯衫」比「第一位同事」更清楚。加入可聽出的區別,例如中音與較低音。讓姓名、服裝、位置和聲音在整份提示詞中保持一致。這些錨點讓被調換的台詞更容易被發現。
視覺身分很重要,因為單靠音訊可能騙過審查者。如果聲音不同,但動的是錯誤的嘴巴,片段就有脣形同步問題。如果動的是正確的嘴巴,但 A 的聲音在 A 第二輪時改變,就是聲音漂移。咖啡館範例讓 A 在 B 之後再次說話,好讓審查者檢查 A 的聲音是否保持一致。
為說話與反應編列時間
以預定節奏朗讀腳本。在每次交接處加入自然停頓,然後留空間讓聆聽者反應,並讓開場鏡頭建立兩張臉。修訂後的辦公室腳本在 12 秒內有 5 輪。咖啡館在 15 秒內有 8 輪簡短對話,是這裡最嚴格的時間測試。這些是範例腳本,不是通用的每秒字數門檻,也不是對輸出的承諾。
| 場景預算 | 口說順序 | 詞語以外所需時間 |
|---|---|---|
| 12 秒辦公室 | A-B-A-B-A | 建立兩個人並容納 4 次交接 |
| 15 秒咖啡館 | 八輪交替 | 七次交接,幾乎沒有多餘時間 |
| 12 秒街頭 | A-B-A-B-A | 在街頭環境音中進行四次交接 |
冗長台詞容易在結尾附近被趕拍或遺漏。如果草稿朗讀起來幾乎佔滿 15 秒,請在生成前縮短。如果情境需要更多對話,請規劃不同鏡頭,並將連續性驗證視為另一項製作任務。第一次嘗試時,請讓臉部在說話台詞期間保持可見。快速剪接和嘴巴被遮住會讓說話者指派更難判斷。如果台詞順序很重要,請和兩個人做一次計時讀本。讓一人唸 A,另一人唸 B,再由第三人記下每句在哪裡結束。如果最後一個字落在片段上限,請在算圖前刪掉一個子句或一個反應節拍。較短的腳本更容易稽核,因為審查者可以重播整段交流,而不必猜測某句台詞是否原本要延伸到鏡頭外。
如何為 2 位說話者提示 Gemini Omni 1.2 Flash
有用的提示詞讀起來像一份精簡的拍攝簡報:場景與攝影機、身分、精確對話,然後是聲音與排除規則。這個順序也給審查者一份檢查清單。它是一種提示方法,不是有文件保證的控制力。從身分段落一路到對話區塊,都保持角色標籤完全一致。在關於後續輪次的指示中,避免把同一個人同時稱為 A 和「那位顧客」,除非對應關係已經明確。讀者應該能畫出兩欄,一人一欄,並將每一項要求的動作與每一句台詞準確放入其中一欄。
使用明確的說話者標籤與引號台詞
每一輪使用一行,並以 Speaker A: 或 Speaker B: 標示,加上引號中的詞語。指定誰保持沉默。要求「一場關於發布準備度的討論」會容許即興發揮。精確腳本能讓你立即標出遺漏或被改寫的字詞。
以下是第一個可複製的提示詞。它讓兩位成人保持在同一個連續鏡頭中,讓觀眾能檢查每一張嘴。
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
提供的 12 秒、720p 辦公室算圖。兩人都保持可見;五句口說台詞與脣形同步仍需進行聆聽審查。
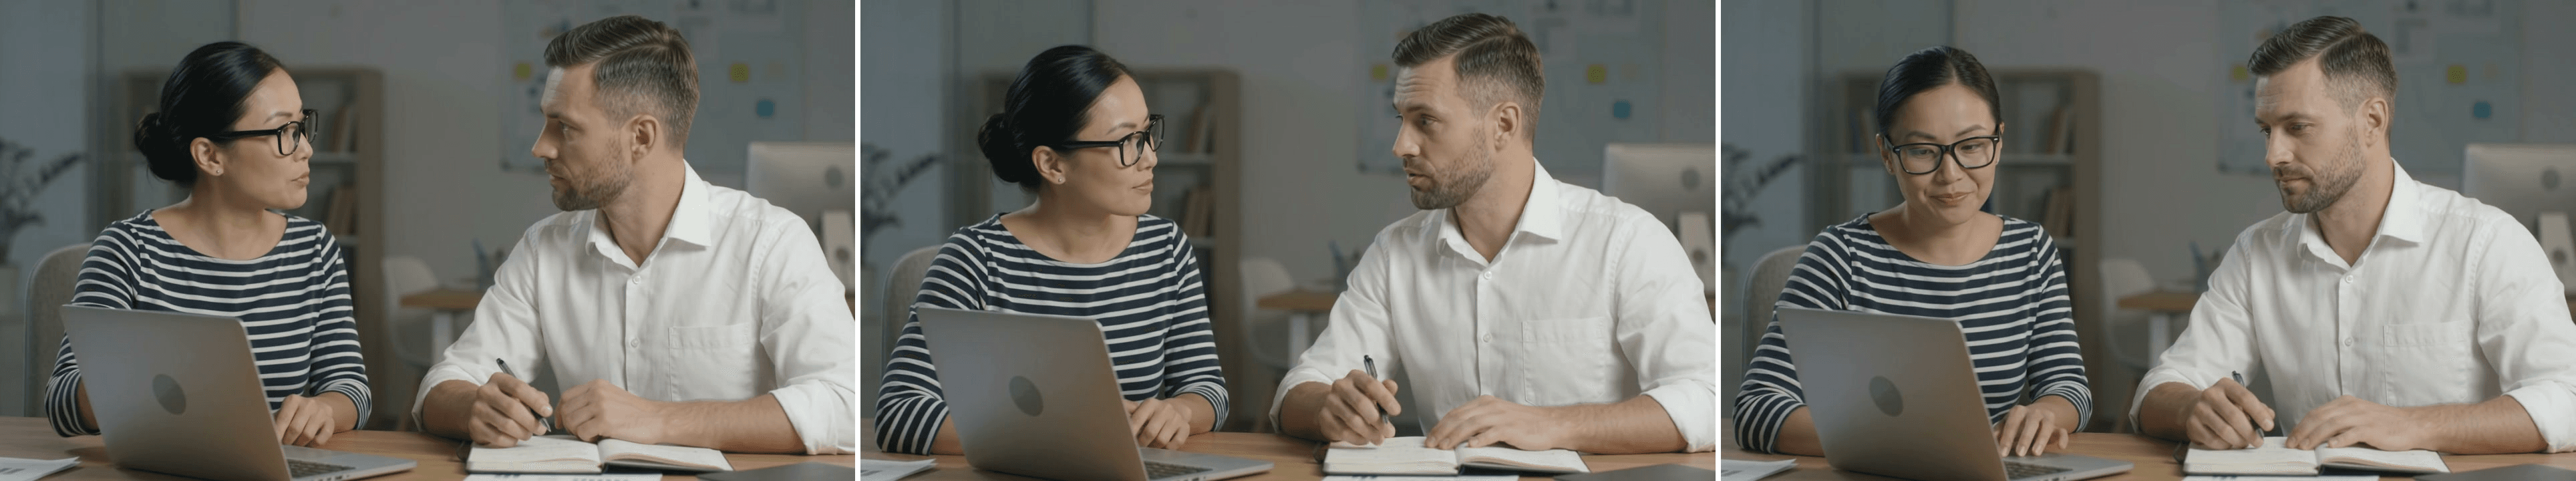 Case A 畫格,由左至右(約 0:02、0:05、0:10):女子面向她的同事;他似乎正在回覆,而兩人都留在畫面中;他們將注意力轉回筆電與筆記本。
控制攝影機而不失去說話者
連續的中景雙人鏡頭是一種診斷性選擇。兩張臉都保持在視野中,因此漏掉的交接無法躲在剪輯後面。模型仍可能改變取景,這就是為什麼最終檔案需要檢查。
一旦交接符合你的目的,試試能保留兩張臉的適度運鏡。街頭提示詞要求在 16:9 畫面中進行一次運鏡,並讓兩張臉保持可見,使嘴部動作更容易判斷。這是先建立辦公室基準的另一個理由。
讓背景音訊低於對話
明確命名環境音及其優先順序。安靜的室內底噪讓辦公室片段幾乎沒有東西與語音競爭。柔和的咖啡館聲音增添情境,同時讓台詞仍可測試。街頭提示詞要求腳步聲與遠方聲音低於兩個人的聲音,且沒有旁觀者說話。
否定式指示可能減少不想要的音訊,但它們仍然是請求。請聆聽是否有第三個聲音、旁白、音樂和品牌音訊。也要檢查畫面是否有字幕和標誌。
3 個對話場景,展示誰在何時說話
三個提供的影片檔案展示了預定的辦公室、咖啡館和街頭場景。其視覺內容可在此檢查,但這些檔案並未確立是哪條路徑或哪些設定產生了它們。下方提示詞是可重現的請求,並不聲稱輸出正確說出每一個字。辦公室檢查 5 輪,咖啡館測試 8 輪快速對話,街頭則加入環境音。
| 案例 | 提示詞要求 | 提供檔案 | 主要檢查 |
|---|---|---|---|
| A:辦公室交接 | 12 秒、16:9、5 輪 | 12 秒、16:9、720p | 五句台詞、正確的嘴部 |
| B:咖啡館交流 | 15 秒、16:9、8 輪 | 15 秒、16:9、720p | 八句台詞、穩定聲音 |
| C:街頭採訪 | 12 秒、16:9、5 輪 | 12 秒、16:9、720p | 街頭可聽度與說話者輪替 |
五輪辦公室交接
使用上方完整提示詞與影片。兩位同事都留在同一鏡頭中,因此要求的五輪各有可見人物可檢查。將每一句可聽見的台詞與文字對照記錄,並檢查正在動的嘴巴。提供的檔案建立了場景與時長,但其字詞與脣形同步尚未經獨立驗證。
一段片段中清楚的交接,只能支持關於該片段的結論,而不是整個模型的成功率。保留第一個結果,以便任何修訂都能與原始版本比較。
八輪咖啡館交流
要求 16:9、15 秒。八輪簡短對話會對重複的聲音歸屬與時間安排造成壓力。比較每個人的第一句與最後一句,然後檢查是否有任何台詞重疊或消失。提供的檔案是 720p。
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
戶外 Q&A
要求 16:9、12 秒。這會加入輕微的攝影機移動與環境音。提供的檔案是 720p、16:9,可針對五輪說話者與街頭可聽度進行檢視。
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
合併播放:0:00–0:15 是案例 B,咖啡館交流;0:15–0:27 是案例 C,街頭採訪。兩段來源片段皆完整收錄。
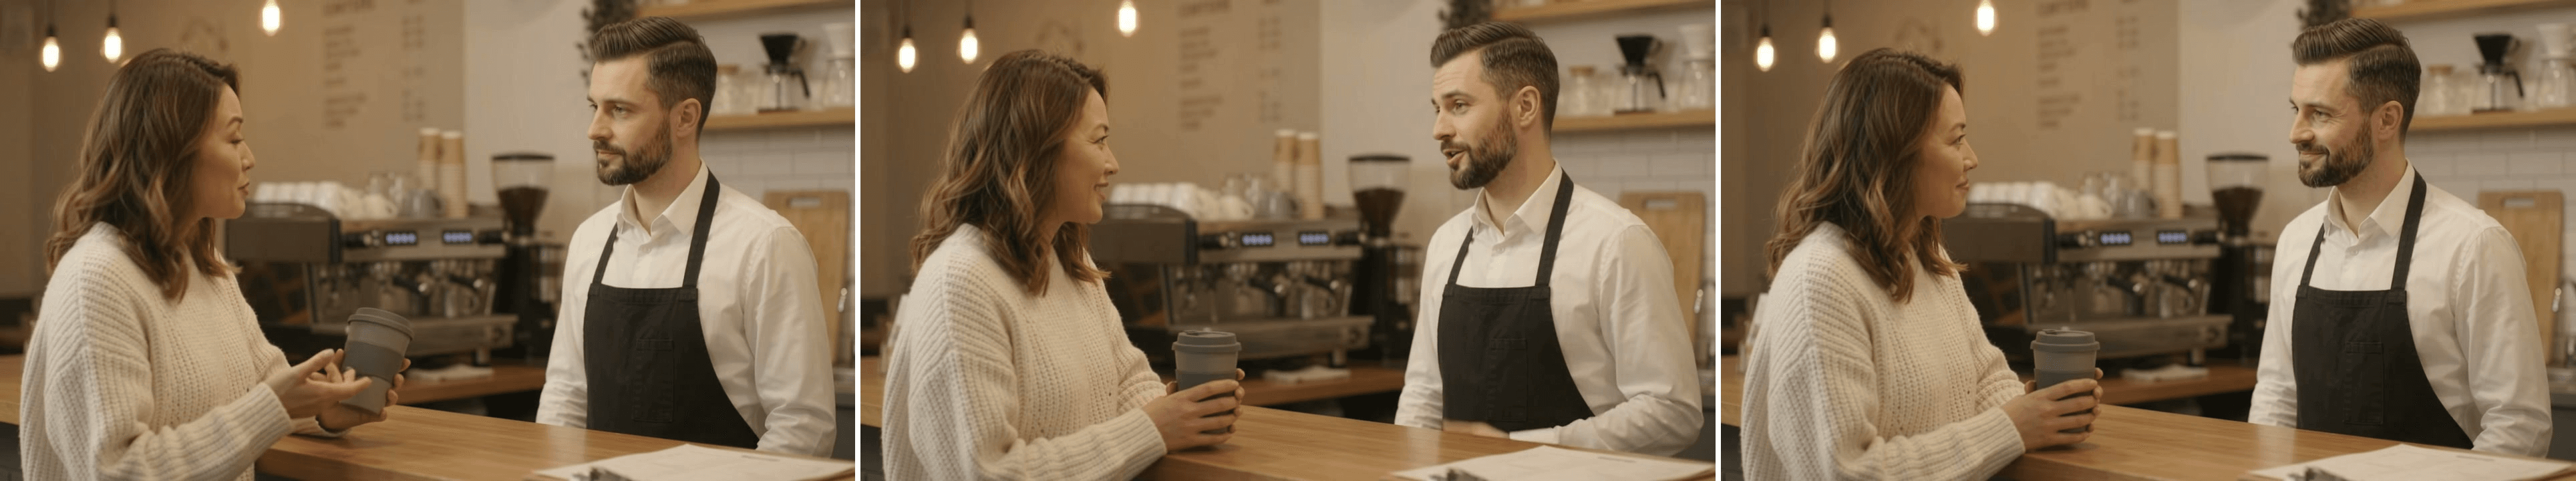 案例 B 畫格,由左至右(合併影片約 0:02、0:08、0:13):顧客展示她的杯子;咖啡館店員似乎正在回答;結尾時兩人面對彼此。
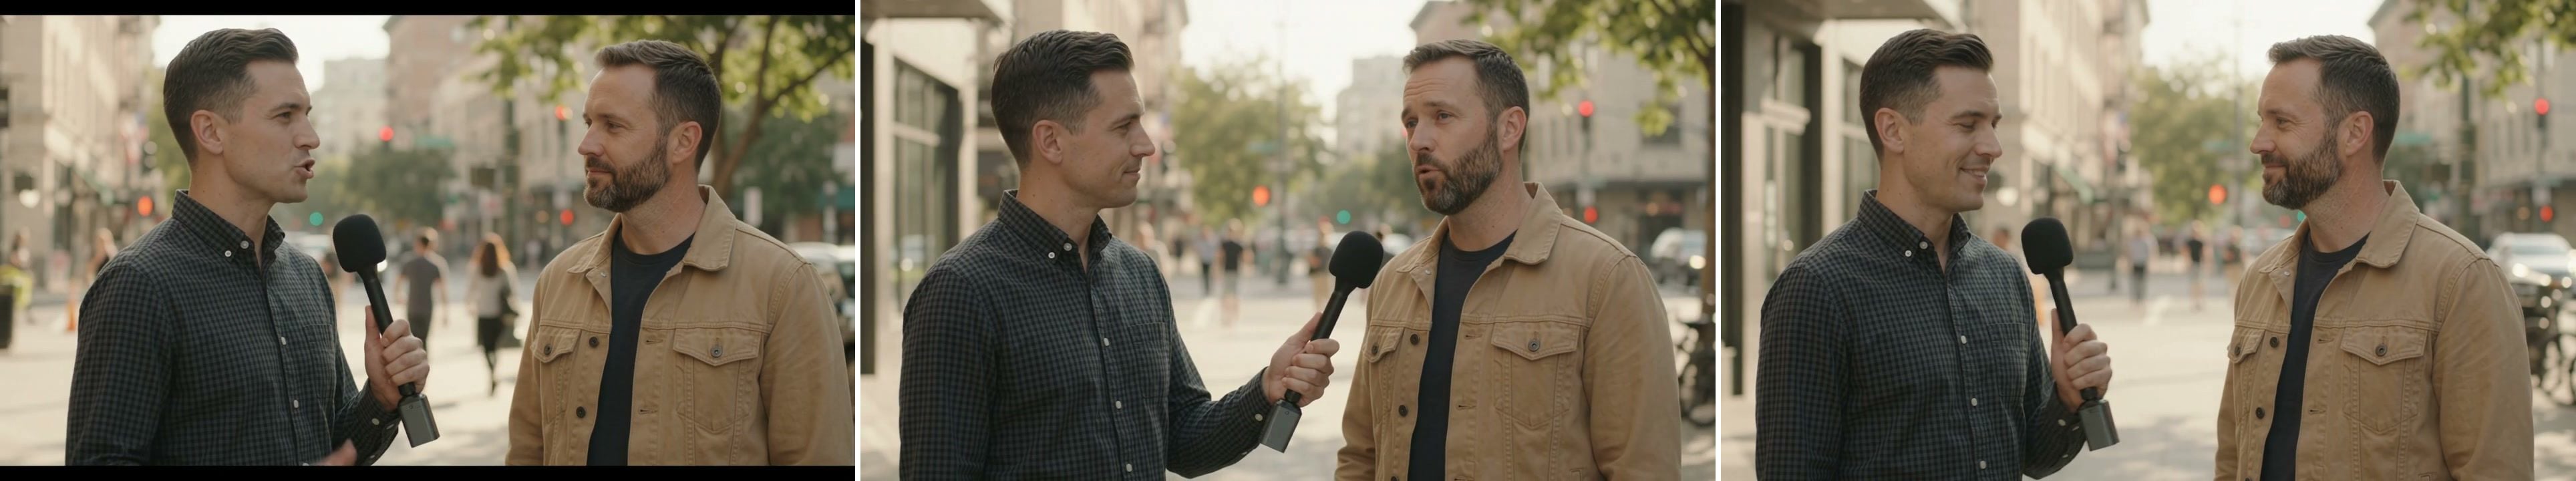
案例 C 畫格,由左至右(合併影片約 0:16、0:19、0:26):採訪者拿著麥克風;他將麥克風轉向受訪者;最後兩人面對彼此。
發布前檢查說話者順序、脣形同步與聲音漂移
逐句檢視片段
下載影片。先在不讀腳本的情況下播放一次,找出明顯的混亂,然後在旁邊放著提示詞重播。在每一輪暫停,寫下你聽見的內容。檢查兩張嘴,並記下腳本輪次之外的說話。若要進行可重複的審查,請記錄每一句可聽見台詞的開始與結束時間、預期說話者、你聽見的聲音,以及可見且正在動的嘴巴。如果臉部被遮住或聲音蓋掉某個字,請寫「不清楚」。不要因為場景其餘部分看起來有說服力,就把不清楚的欄位改成通過。一位沒看過提示詞的第二位聆聽者可以指出他們認為誰在說話;在判斷大眾觀眾是否會理解場景之前,將該判斷與腳本比較。
每一句都要檢查 4 件事:
- 詞語: 引號中的詞語是否按順序說出,沒有遺漏結尾或添加句子?
- 聲音歸屬: 具名人物聽起來像說話者嗎,尤其是在 A 回來時?
- 可見時機: 那個人的嘴巴是否在動,而聆聽者保持沉默?
- 其他內容: 片段是否加入旁白、旁觀者、字幕、標誌或音樂?
在音訊與嘴部動作逐句檢視完畢之前,帶時間戳的品質保證時間軸仍待完成。
一次修訂一個限制
如果最後一句消失,請縮短腳本,或在 15 秒上限內給它更長時長。如果錯誤角色說話,請重述視覺位置,並指定聆聽者保持沉默。如果環境音蓋住某個字,請降低或移除它。如果剪接遮住正在動的嘴巴,請回到連續雙人鏡頭。每次重試只改變一個因素,讓下一次輸出回答一個清楚問題。
這些修訂都不保證能修正。如果某次算圖需要修訂,請儲存其檔案、設定,以及你想處理的問題。製片人接著可以決定另一次算圖是否值得成本,或者錄製聲音與手動剪輯是否能提供所需精確度。對於簡短、明顯口說的交流,請從辦公室提示詞開始,並且只有在逐句檢查後才接受片段。這就是 Gemini Omni 1.2 Flash 多人對話的標準。
常見問題
Gemini Omni 1.2 Flash 能否在不同片段中保持相同聲音?
一個聲音在單一生成片段中保持可辨識,是比在不同生成之間保留它更狹窄的要求。這些純文字範例測試的是第一種情況。不要因為它們就承諾跨片段聲音一致性。需要同一位反覆出現說話者的活動,應另行執行連續性測試。
Gemini Omni 1.2 Flash 能否生成英語以外的對話?
此模型可能產生其他語言,但這些提示詞是英文。請與流利的聆聽者一起逐字檢視目標語言,包括姓名、數字和在地化說法。另一位創作者成功的語言測試是該測試的證據,不是對你腳本的保證。
如何讓每一句台詞都指派給正確的說話者?
給每個人一個視覺位置與聲音,為每一句引號台詞加上標籤,並指定在另一個人說話時誰保持沉默。逐句檢視生成的影片。如果某次算圖不符合簡報,請縮短交流,或使用可控的音訊工作流程來精確交付。
15 秒的 Gemini Omni 1.2 Flash 片段能容納多少輪對話?
咖啡館提示詞要求在 15 秒內進行八輪簡短對話,而辦公室與街頭提示詞要求在 12 秒內進行五輪。這些是腳本範例,不是保證限制。請朗讀台詞,預留停頓,如果最後一輪到達片段結尾,就縮短它們。
Gemini Omni 1.2 Flash 的雙人對話需要參考圖像嗎?
這三個文字轉影片提示詞並未使用參考圖像。它們以文字描述每位說話者的位置、服裝和聲音。如果專案需要特定臉孔或視覺風格,請測試接受參考的路徑,並另行檢視其輸出。


