假設你上傳一個白色杯子、一個咖啡吧和咖啡豆,但影片卻在一個普通房間裡顯示不同的杯子。為了妥善使用 Gemini Omni 1.2 Flash 多重參考圖像,請選擇「參考至影片」,為每張圖像指定一項明確的工作,並依上傳順序描述這些工作。先從短鏡頭開始,然後檢查開頭、中間、結尾,以及它們之間的移動。參考圖像會引導生成;它不保證逐像素複製。
測試協定會兩次使用同一個杯子鏡頭:第一次只使用杯子圖像,然後使用杯子、咖啡館和豆子。第二個範例使用萬神殿的外部和內部照片來測試移動視角。比較會區分提示要求什麼與輸出實際顯示什麼,因此你可以判斷另一個參考是有所幫助還是增加了衝突。
重點摘要
- 當圖像應引導內容而不決定開頭影格時,請選擇「參考至影片」。
- 為每張上傳的圖像指派一個角色,並在提示中依上傳順序命名。
- 在增加複雜度之前,先比較簡短的 1 張圖像基準與 3 張圖像執行。
- 檢查整個片段中的身分、場景、道具和動作,而不只是第一影格。
Gemini Omni 1.2 Flash 中的多重參考圖像能控制什麼
多重參考圖像組可以描述一個鏡頭中的多個部分。一張照片可以識別產品,另一張可以提供地點,第三張可以識別道具。你也可以將圖像用於角色或視覺風格。只有當提示說明哪些可見特徵屬於哪張圖像時,這些角色才有用。「使用所有圖像」會讓模型自行決定咖啡館照片中的第二個杯子是第二個產品還是背景雜物。
在杯子測試中,圖像 1 定義白色陶瓷杯和手柄。圖像 2 提供義式咖啡吧檯和溫暖的室內環境。圖像 3 提供杯子附近可見的咖啡豆。我們不要求模型沿用咖啡豆照片的白色背景或咖啡館吧檯上的每個物體。這種排除很重要:參考照片通常包含比你想讓它執行的工作更多的視覺資訊。
參考圖像組無法消除所有模糊性。手可能會遮住手柄。相機移動可能會顯露來源照片從未顯示的杯子側面。三張來源照片之間的光線和相機角度可能會衝突。將提示視為優先順序的階層,杯子形狀優先於與背景家具完全相符。在其 2026 年 11 月的公告中,Google 描述了 Gemini Omni 1.2 Flash 更強的參考遵循能力,同時指出快速動作和複雜物理仍是需要改進的領域。
上傳之前,為每個來源寫一句話:「這張圖像定義 X;忽略 Y。」如果你無法在不讓兩張圖像承擔相同工作的情況下做到這一點,請簡化該組。然後選擇符合你目標的輸入模式。
參考至影片還是首尾影格?
當你的圖像應影響新的動態鏡頭時,參考至影片是正確的模式。如果你需要精確的開頭圖像,請改用第一影格或圖像至影片工作流程。如果你需要兩個指定的端點,請在可用的情況下使用首尾影格工作流程。同一張上傳的照片可能因所選模式而扮演非常不同的角色,而提示句子不一定能覆寫該模式的輸入合約。
| 模式 | 輸入控制的內容 | 預期的開頭 | 最佳用途 |
|---|---|---|---|
| 參考至影片 | 主體、場景、道具或風格提示 | 由參考引導的生成視圖 | 在一個鏡頭中組合杯子、咖啡館和豆子 |
| 圖像至影片/第一影格 | 起始視覺狀態 | 與提供的第一張圖像緊密相關 | 讓特定靜態圖像動起來 |
| 首尾影格 | 起始和結束視覺狀態 | 從指定的第一張圖像開始 | 規劃固定端點之間的轉場 |
Google Cloud 的參考圖像文件(於 2026 年 11 月存取)將參考圖像描述為生成的額外指引。這個區別很實際:如果第一張上傳的照片幾乎不變地作為影格 1 出現,而你想要一個新組成的開頭,請先檢查模式和圖像插槽,然後再改寫創意提示。
在參考至影片中,純色來源背景上的白色杯子可以合理地變成咖啡館吧檯上的杯子。這就是這裡的實驗。對於萬神殿,外觀和圓頂照片將引導兩個場景,但它們不是規定的第一和最後影格。它們的工作是在連續移動期間讓建築元素可辨識。
建立模型能讀取的參考圖像組
在收集輔助圖像之前,先選擇一個清晰的主要參考。杯子應該足夠大,以便判斷其邊緣、杯身和手柄。在核准的來源照片中,杯子很小,而且看起來是淡奶油色,儘管檔案標題稱其為白色。這使得此輸入成為有用的壓力測試,但任何手柄細節的丟失可能從來源就開始了。繁忙咖啡館照片中的微小杯子是弱產品參考,因為模型幾乎沒有可保留的特定形狀資訊。輔助的咖啡館圖像有不同的工作:它應該讓環境清晰可辨,尤其是吧檯和義式咖啡設備。咖啡豆圖像應識別道具,而不是提供相互競爭的構圖。
保持上傳順序穩定。下面的提示說「第一」、「第二」和「第三」;只有在檔案順序相符時,這些詞才有幫助。如果你在重試期間取代一個來源,請在執行前再次檢查 UI。當多張照片顯示相似的杯子時,請移除或明確排除多餘的杯子。否則模型可能會混合兩者的手柄、比例或顏色。對於具有複雜包裝的產品,同一物體的多個視圖可能比單獨的風格參考更有價值。
| 上傳 | 目標細節 | 不要繼承 |
|---|---|---|
| 1:白色杯子 | 杯身、邊緣和手柄 | 來源照片的背景 |
| 2:羅馬咖啡吧 | 吧檯、設備、室內氛圍 | 其他杯子或人物作為產品參考 |
| 3:咖啡豆 | 杯子旁可辨識的豆子 | 咖啡豆照片的白色背景 |
這三張照片來自 Wikimedia Commons:白色陶瓷杯和羅馬咖啡吧照片標記為 CC0,咖啡豆照片標記為公有領域。它們聲明的重用狀態使示範更容易追溯;這並不會使生成的輸出成為真實產品的已驗證照片。
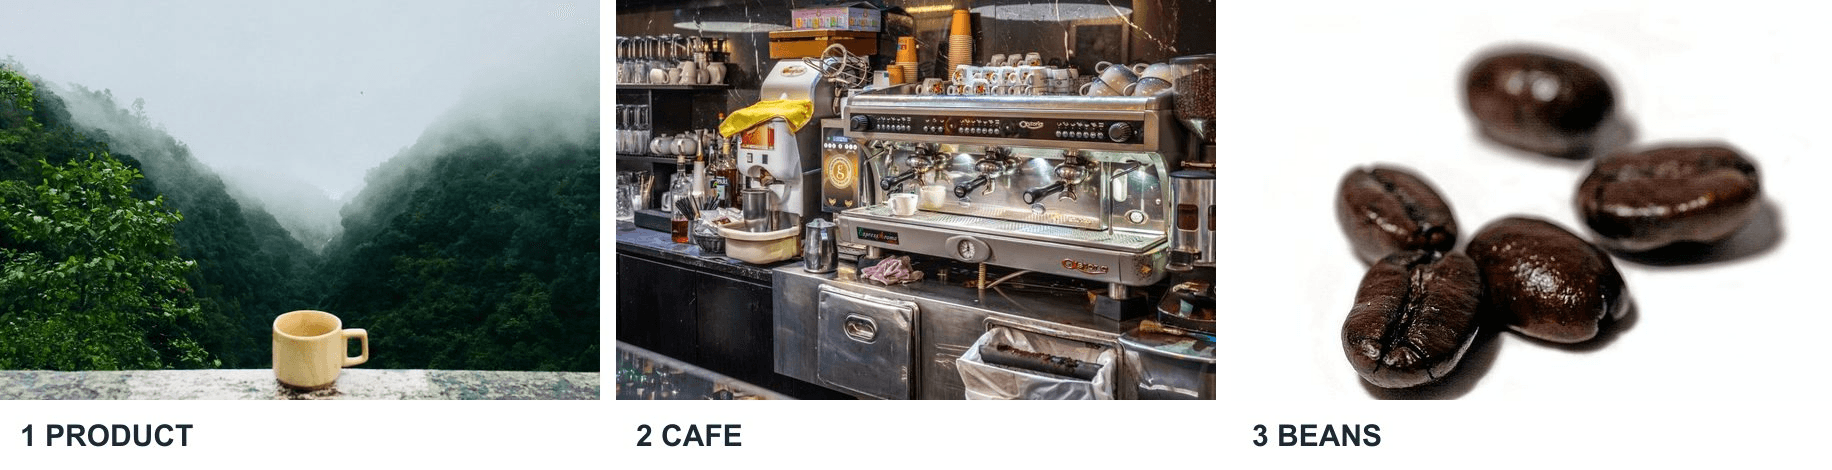
這三張來源照片在任何影片生成之前,分離了產品、場景和道具。
可直接複製的工作流程:1 個杯子、3 個參考、1 個動態鏡頭
下載完整大小的來源照片,並記下每個 Commons 檔案頁面。在 Gemini Omni 1.2 Flash 參考至影片測試平台 中,選擇參考至影片模型,而不是圖像至影片變體。為執行 A1 單獨上傳杯子。設定 8 秒、16:9、1080p 和預設思考。檢查上傳的檔案是否出現在參考圖像欄位中。完全貼上此提示:
plaintext1Create an eight-second product video featuring the white ceramic cup in the first reference image. Preserve its recognizable cup shape and handle. Begin with the cup resting still on a counter. The camera itself physically travels in a smooth semicircular arc around the stationary cup, so the counter and café background shift with clear parallax while the cup keeps the same orientation relative to the counter. Do not spin or rotate the cup, and do not place it on a turntable. After the camera arc, raise the camera to a slightly elevated viewpoint as a hand briefly lifts the cup and sets it back down without twisting it. Natural café ambience, no dialogue, no logos or added text. Use the uploaded image as a product reference, not as a literal opening frame.
執行 A1 並觀看整個輸出。第一次上傳是基準,因此請注意杯子的形狀,以及環繞和升高視角是否都發生。不要因為 A1 省略特定咖啡館或豆子而懲罰它:兩者都沒有作為參考提供。在變更表單之前,將該結果單獨儲存。
對於執行 A2,使用相同的模型和設定。依序上傳杯子、咖啡吧和豆子。確認所有三個縮圖都出現在參考欄位中,然後貼上:
plaintext1Create an eight-second product video. The first reference image defines the white ceramic cup: preserve its recognizable shape and handle. The second reference image defines the espresso bar counter and its warm indoor atmosphere, but do not copy any other cup from that image. The third reference image defines the coffee beans placed beside the cup, not the background. Begin with the cup and beans on the counter. Move the camera in a smooth semicircle around the cup, then change to a slightly elevated viewpoint as a hand lifts the cup and sets it down. Keep the same cup and counter through the whole shot. Natural café ambience, no dialogue, no logos or added text. Use all three images as references rather than literal opening frames.
執行 A2 並等待其完成輸出。檢閱生成的檔案,而不只是預覽縮圖。下面兩個完成的片段顯示哪些細節在相機移動和手部動作後保留下來。
第二張和第三張圖像帶來了什麼變化?
以相同的顯示大小比較片段。將每個片段從頭到尾播放,然後在開頭、中點和結尾附近暫停。對於杯子身分,檢查邊緣輪廓、手柄側面和杯身比例,尤其是在手將其拿起之後。對於環境,尋找吧檯和義式咖啡吧的線索,而不是普通的棕色房間。對於豆子,檢查它們是否是杯子旁明顯的道具,而不是模糊的紋理。
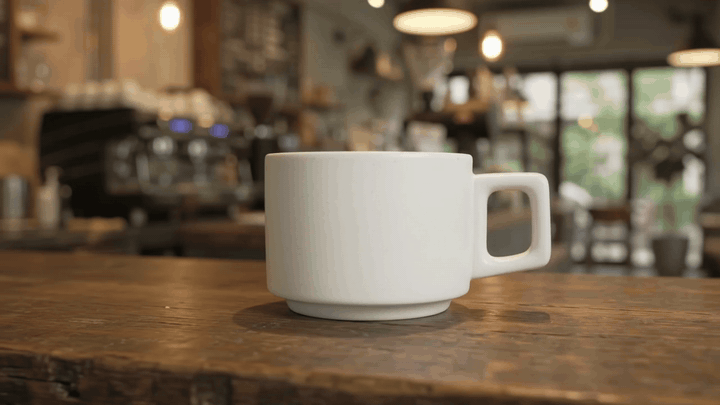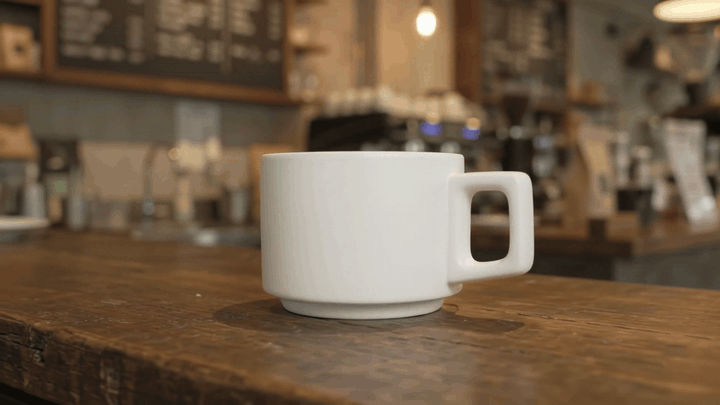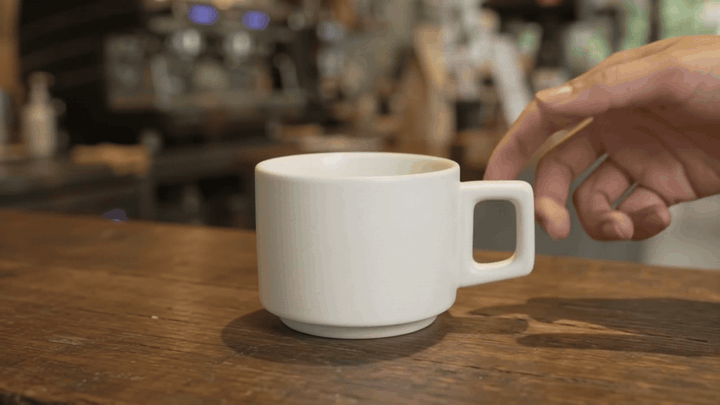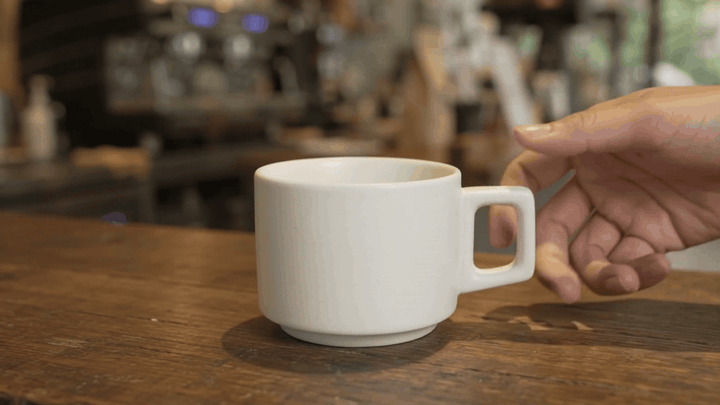
A1 在整個手部拿起過程中保持白色杯子和可見手柄。相機移動幅度不大,而不是清晰的半圓形環繞。
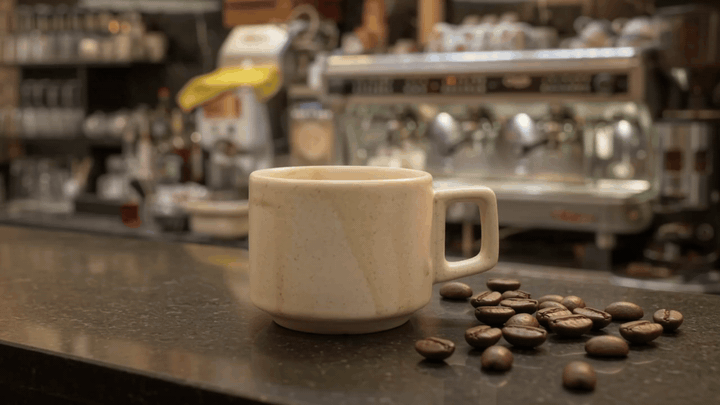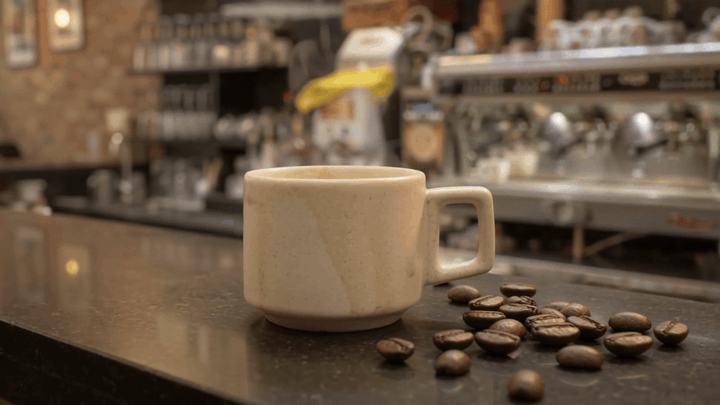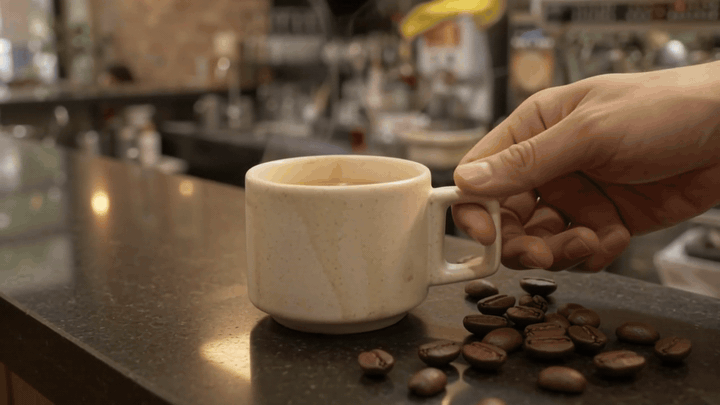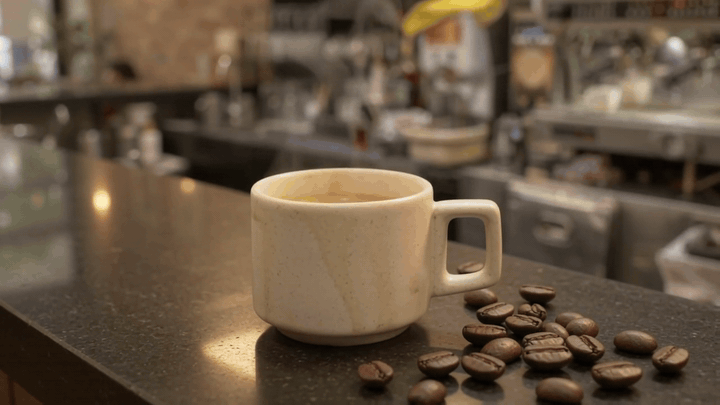
A2 增加了可見的咖啡豆和更具體的義式咖啡吧場景。杯子看起來是奶油色,且形狀比 A1 的杯子更不規則。
| 檢查項目 | A1:1 張圖像 | A2:3 張圖像 | 要尋找什麼 |
|---|---|---|---|
| 杯子形狀和手柄 | 白色杯身和手柄保持可見 | 手柄保持可見;杯身看起來是奶油色且較不規則 | 相機移動後仍可辨識的同一物體 |
| 咖啡館吧檯 | 一般咖啡館場景 | 義式咖啡機和吧檯清晰 | 環境類似吧檯來源 |
| 咖啡豆 | 未顯示 | 在杯子旁可見 | 杯子旁明顯的豆子 |
| 動作 | 手拿起杯子;相機移動幅度不大 | 手拿起杯子;視角適度變化 | 環繞、升高視角、拿起和放下 |
新增的參考使吧檯和豆子更容易識別,但杯子的顏色和形狀改變了。兩個片段都沒有明確完成要求的半圓形相機移動。這些是單一輸出,因此它們是診斷範例,而不是效能統計數據。如果杯子身分最重要,下一個測試應該加強杯子參考或簡化手部動作,同時保持其他設定不變。
雙圖像建築測試
杯子測試詢問多種細節是否共存於一個產品鏡頭中。萬神殿的兩張照片詢問不同的問題:外部和內部參考能否引導連貫的移動視角?第一張 Commons 圖像顯示外部立面;第二張顯示內部圓頂和圓頂眼。外部和圓頂照片的 Wikimedia Commons 檔案頁面都標記為 CC0。
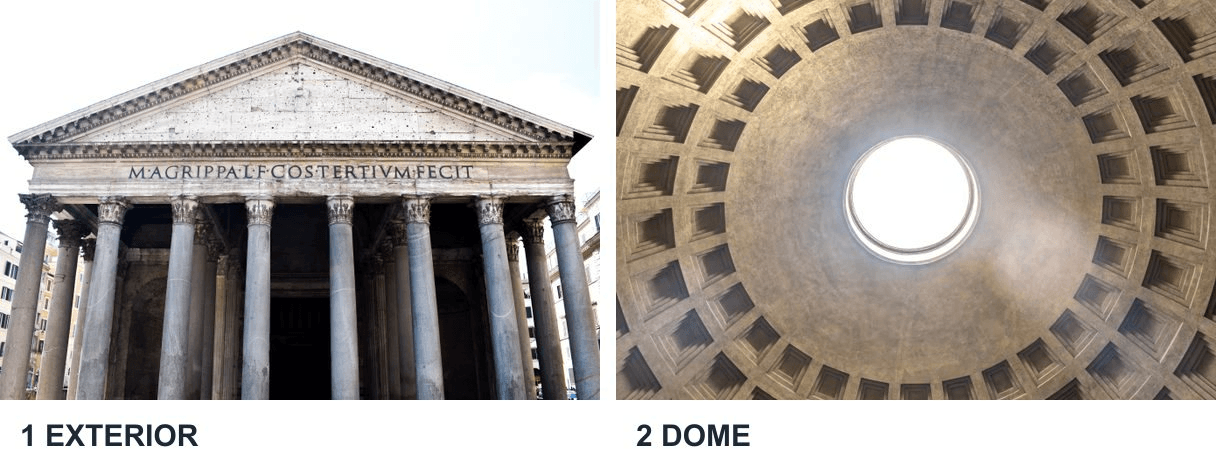 外部和圓頂照片為生成的建築通道提供個別的場景提示。
在同一個參考至影片模型中,先上傳外部,再上傳內部。設定 12 秒、16:9、1080p 和預設思考。使用下面的提示:
plaintext1Create a twelve-second architectural concept video guided by the two reference photographs of the Pantheon in Rome. The first image defines the exterior facade and entrance; the second defines the interior dome and oculus. Begin from a human-height viewpoint outside, move steadily toward and through the entrance, then tilt upward inside to reveal the dome and oculus. Use a continuous moving viewpoint with clear parallax and no sudden teleporting or isolated zoom. Keep the building recognizable while treating the result as a generated visualization, not documentary footage. Natural footsteps and room ambience, no dialogue, no titles or labels. Both images are scene references, not mandatory first and last frames.
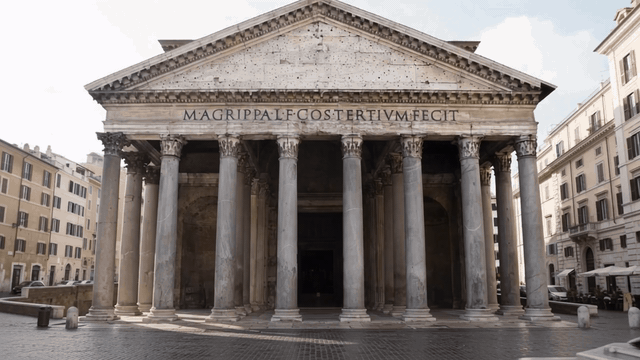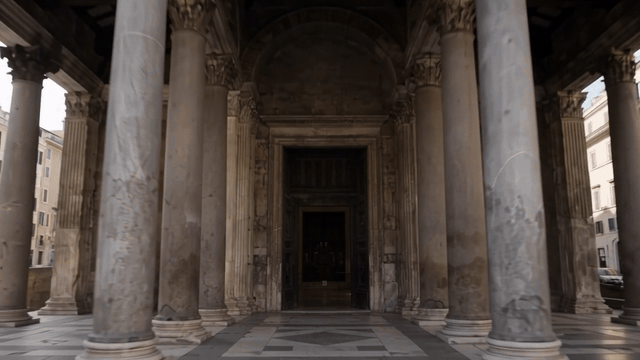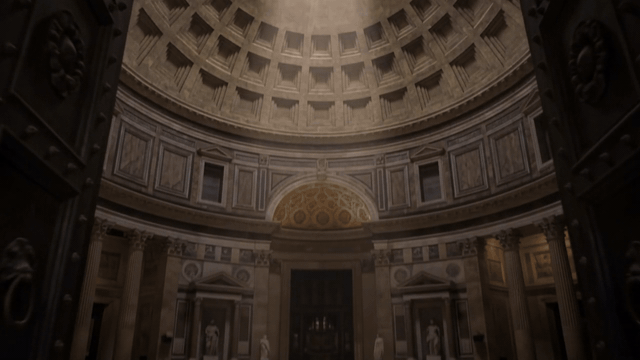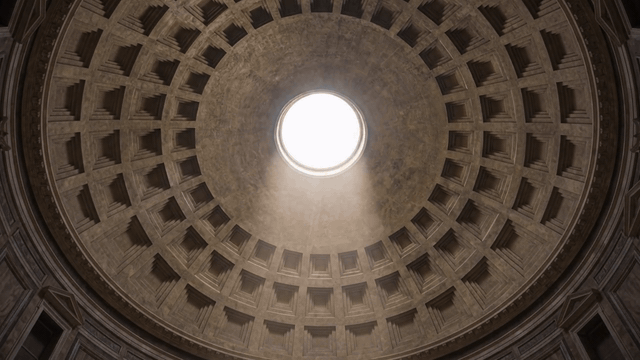
生成的通道從立面穿過門廊,進入圓頂和圓頂眼的視圖。
根據可見特徵和轉場品質來評判片段,而不是地理精確度。立面、門廊和圓頂可辨識,視角在向內看之前先朝入口推進。結果是基於照片的 AI 視覺化,而不是紀錄片片段或可靠的建築調查。首尾影格設定會回答另一個問題:如何將兩張規定的圖像作為端點連接起來。
一個 15 秒鏡頭中的三種參考角色
杯子比較測試了產品、地點和道具。這個額外鏡頭為三個參考賦予更苛刻的角色:一隻移動的動物、一個色彩繽紛的環境,以及一個稍後進入的移動群體。問題是,當相機跟隨動作時,這三者是否都保持清晰可辨,而不是只出現在孤立的影格中。
圖像 1 是一張 Wikimedia Commons 綠海龜照片,用於烏龜的寬闊龜殼、頭部和鰭足。圖像 2 是一張 Wikimedia Commons 珊瑚礁照片,用於粉紅色和奶油色的珊瑚形狀及清澈海水。圖像 3 是一張 Wikimedia Commons 黃尾魚群照片,用於魚身和群體運動。每個檔案頁面都將其照片標記為公有領域。這些來源來自不同地方,因此生成的場景是視覺概念,而不是某個真實珊瑚礁的記錄。
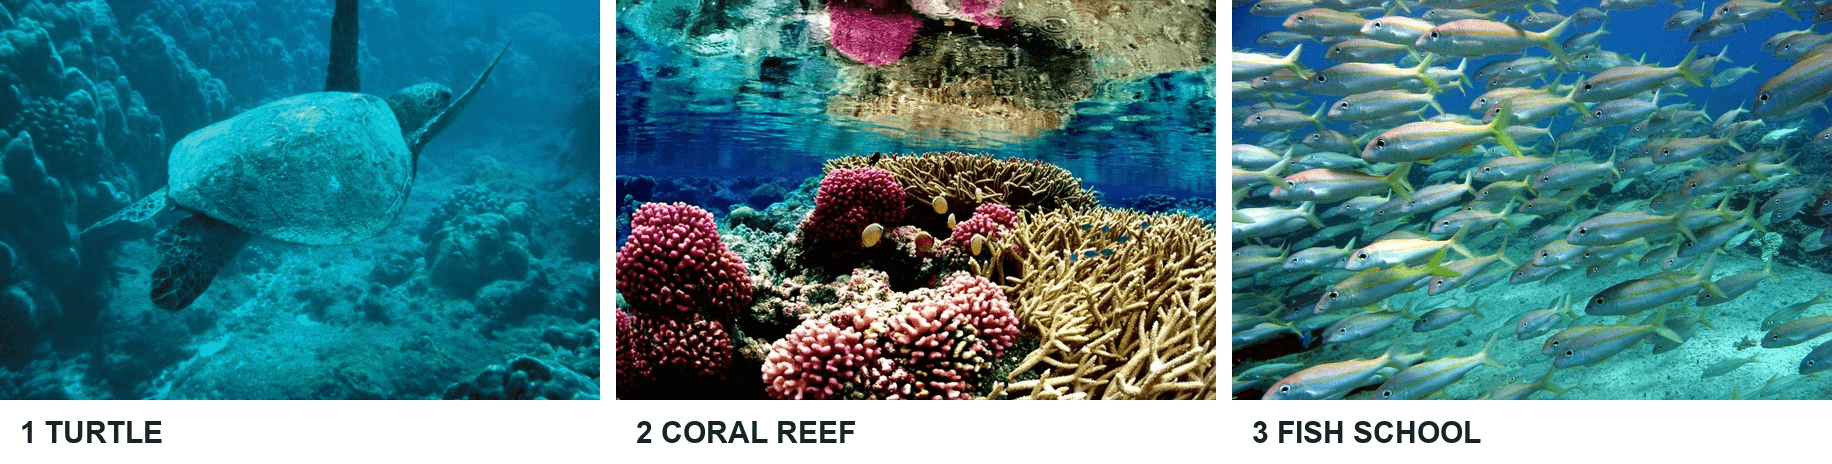 這三次上傳為模型提供了主體、場景,以及應稍後進入鏡頭的群體。
在參考至影片中依該順序上傳它們。選擇 15 秒、16:9、1080p 和預設思考。使用此提示:
plaintext1Create a 15-second, single continuous underwater concept film using the three uploaded photographs as references in their exact upload order. The first image defines one green sea turtle: preserve its broad mottled oval shell, head, and four flippers, but ignore that photo's background. The second image defines the setting: vivid pink and cream branching corals, rounded coral heads, clear turquoise water, and rippling sunlight; it is not a mandatory first frame. The third image defines a dense school of slender silver fish with yellow tails; use the fish as moving animals, not as a background texture or a copy of their original seabed. In the opening five seconds, the turtle swims forward above the colorful reef with visible flipper strokes while the camera tracks alongside it. In the middle five seconds, the yellow-tailed fish school sweeps across the frame and curves around the turtle as the camera rises to a three-quarter overhead view. In the final five seconds, the camera widens and arcs to show the same turtle, reef, and fish school together in one coherent underwater space. Keep the turtle's shell pattern and the fish appearance consistent throughout. Show real subject movement, water particles, soft sunbeams, and clear parallax. Smooth camera movement, no cuts, no teleporting, no spinning turtle, no additional turtles, no text, logos, or narration. This is a generated visualization, not documentary footage.
生成的 15 秒片段從烏龜在珊瑚上方開始,然後將黃尾魚群帶入同一個移動場景中。
烏龜的斑駁龜殼和鰭足從開頭到結尾都保持可辨識。粉紅色珊瑚在開頭附近最清晰;帶有黃尾的銀色魚群在中間左右進入,之後與烏龜共享畫面。相機追蹤並拉寬,儘管要求的俯視視角沒有明確建立。這個單一輸出顯示三個參考角色协同運作,同時也顯示提示中的相機指令僅被部分遵循。
修復參考漂移而不重新開始整個想法
當杯子改變形狀時,找出發生變化的確切影格。如果手柄僅在手遮住它時消失,那可能是遮擋。如果它在錯誤的一側返回,或者在杯子放下後邊緣輪廓改變,則產品身分漂移了。讓參考中的杯子更大更清晰、簡化拿起動作,或指定一個能讓手柄保持可見的視角。保留先前的輸出,以便判斷變更是否有幫助。
如果場景在咖啡館之間跳躍,請檢查來源組是否有衝突的房間、光線或相似物體。更換弱場景圖像,或移除提供不想要家具的參考。在提示中,說明哪張圖像擁有吧檯,以及要忽略哪些視覺元素。較長的負面指令清單可能會造成更多模糊性;一個精確的角色陳述通常更容易測試。
如果最後幾秒失去細節,請縮短動作,而不是增加更多名詞。在嘗試具有多個轉場的較長序列之前,先要求一個連續環繞和一個小幅拿起動作。Google 的發布說明指出該模型支援後續編輯,但不要假設編輯會保留每一個未觸及的細節。使用相同的開頭、中間和結尾檢查來檢閱編輯。
每次重試只改變一個變數:參考選擇、提示措辭、持續時間或相機任務。保留確切檔案和設定的日誌。這會將令人失望的輸出轉化為可操作的診斷,並防止幸運的影格被誤認為一致的控制。
限制、成本,以及在哪裡試用
Google 於 2026 年 11 月 5 日宣布推出 Gemini Omni 1.2 Flash,原生片段最長 15 秒。Atlas Cloud 參考至影片模型頁面目前列出 1–10 張參考圖像、3–15 秒持續時間選項、16:9 或 9:16 長寬比,以及 360p、720p、1080p 和 4K 輸出選項。1080p 和 4K 選項是從原生生成的影格放大而來。輸入限制可能因存取途徑而異,因此請檢查你使用之介面中的欄位。本指南只需要 1、2 或 3 張圖像。
對於確切範例,請使用工作流程中連結的模型頁面,並在每次執行前檢查其當前報價。公開的 Atlas Cloud 模型目錄 提供第二個檢查可用性和當前定價的地方。每秒的標題費率可能無法描述每種解析度或帳戶條件,因此請根據實際選擇的控制項來編列預算,而不是將發布價格複製到生產計畫中。
Gemini Omni 1.2 Flash 多重參考圖像的實際下一步是先執行杯子基準。儲存其確切提示和輸出。只有在你能識別基準缺少哪個細節後,才加入咖啡館和豆子,然後根據上述四項檢查來評判完整的動態片段。
常見問題
我可以將圖像參考與動作參考片段結合嗎?
Google 描述支援短動作參考,但這與此處的靜態照片測試是不同的輸入組合。在結合它們之前,請檢查特定入口點的限制和持續時間規則。即使動作是單獨提供的,也要保持圖像角色明確。
模型會精確複製我的參考照片嗎?
不會。參考會引導身分、場景、道具或風格。生成的影格可能會改變相機角度、光線、隱藏表面或小細節。如果你需要精確的起始影格,請選擇第一影格工作流程,並且仍然檢查片段的其餘部分。
我可以使用他人的照片或品牌資產嗎?
使用你有權使用的素材,並針對你預期的發布檢閱其授權。來源照片的 Wikimedia Commons 檔案頁面說明了其重用條款。在發布前檢查每個適用的授權。該來源狀態不會授予你之後可能加入的無關標誌、人物或資產的權利。


