快速解答
GitHub 上的 AI 影片生成技能,能將你的程式碼與 AI 影片模型串接。到了 2026 年,選擇開源(免費、自架)還是付費 API(雲端、即時),取決於四個變數:VRAM 可用量、資料隱私需求、所需品質天花板,以及每月生成數量。對於需要多種 SOTA 模型的生產規模工作流程,Atlas Cloud (atlascloud.ai) 提供 300 多種模型 — 包括 Kling v3.0、Seedance 2.0、Vidu 3.0、Veo 和 Sora — 透過單一 API 金鑰,並採用透明的按用量計費。
想直接比較這些工具背後的影片模型嗎?Atlas Cloud 模型比較將圖片和影片模型並排顯示在同一個提示下 — 並在生成前顯示價格。
-
什麼是 AI 影片生成技能? {#what-is-a-skill}
在 GitHub 儲存庫的脈絡中,AI 影片生成技能是指一個可重複使用的模組、包裝層或整合層,將應用程式連接到 AI 影片生成後端 — 無論是自架的開源模型,還是雲端 API。
把它想像成應用程式邏輯與實際推理引擎之間的抽象層。一個技能可能是:
- 一個 Python 類別,包裝
Wan 2.2模型管線,用於文字轉影片生成 - 一個 ComfyUI 自訂節點,連接 Atlas Cloud API 以生成 Kling v3.0
- 一個 n8n 工作流程節點,透過 REST 觸發 Seedance 2.0 並回傳影片 URL
- 一個 LangChain 工具或 MCP 伺服器技能,按需呼叫影片生成端點
每位開發者在建構時面臨的核心問題: 後端應該是本機運行的開源權重,還是付費的雲端 API?
2026 年的真實數據,不是理論。
-
2026 年的 GitHub 開源生態 {#open-source-landscape}
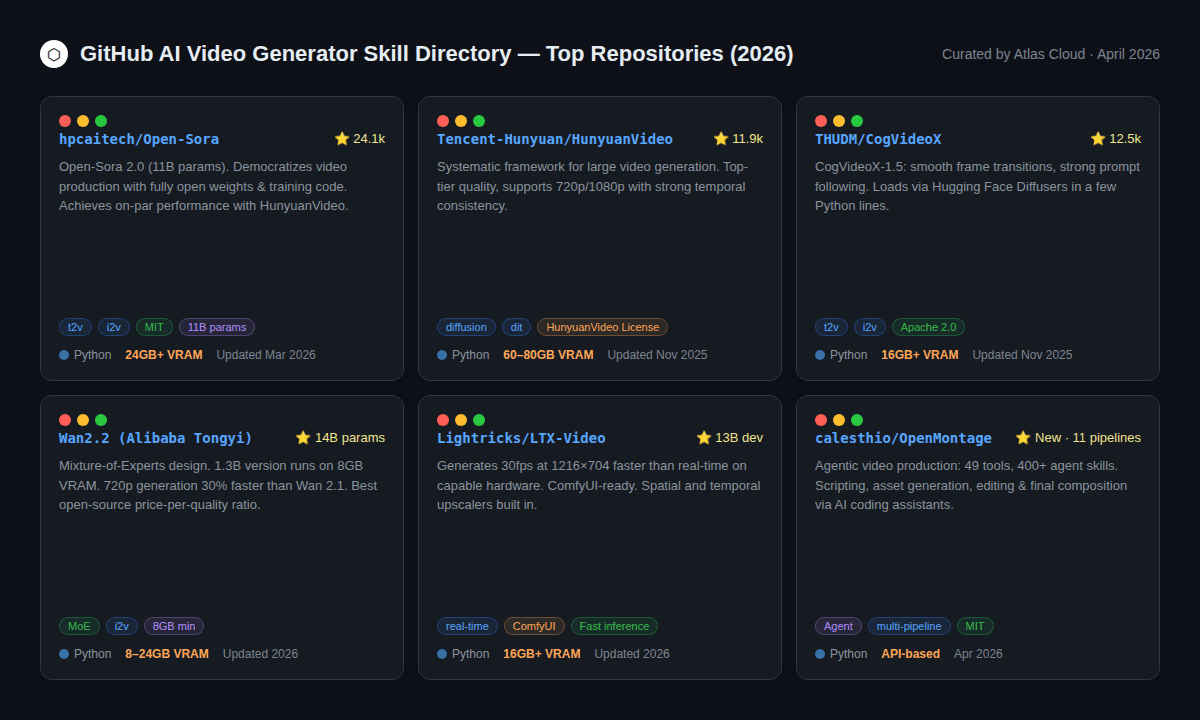
開源影片生成生態系統已大幅成熟。有些倉庫現在已成為付費 API 的真正替代方案 — 至少在特定任務上是如此。
第一層:生產級開源模型
HunyuanVideo(騰訊,11.9k ⭐)— 較好的開源影片生成器之一。支援 720p 和 1080p。主要限制在於硬體需求:完整模型需要 60–80GB VRAM,只有擁有企業級 GPU 的團隊才能使用。社群授權允許在標註出處的情況下商業使用。
CogVideoX-1.5(THUDM/CogVideo,12.5k ⭐)以 Apache 2.0 釋出,是最對開發者友善的開放模型之一。可透過 Hugging Face Diffusers 原生載入,只需幾行 Python 程式碼。畫面過渡流暢,提示遵循度強。最低需要 16GB VRAM。如果你的團隊已經習慣使用 Hugging Face,這是不錯的選擇。
Open-Sora 2.0(hpcaitech,24.1k ⭐)GitHub 上星數最高的開源影片生成專案。2.0 版(11B 參數)在 VBench 基準測試中達到與 HunyuanVideo 相當的效能,訓練成本據報導約為 20 萬美元 — 對於此等級的模型來說是個驚人的數字。支援文字轉影片、圖片轉影片和無限長度生成。
第二層:較輕量的開源選項(較低 VRAM)
Wan 2.2(阿里巴巴通義)這裡的可及性故事很吸引人:1.3B 變體可在 8GB VRAM 上運行,14B 變體則需要 24GB。混合專家(MoE)架構能以較低的運算成本提供更好的細節,2.2 版在 720p 下比前代快了 30%。對於使用單一消費級 GPU 的開發者來說,Wan 2.2 是最強的開源選項。
LTX-Video(Lightricks)專為速度而設計。在合適的硬體上,能以比即時更快的速度生成 1216×704 解析度的 30fps 影片。ComfyUI 整合已成熟,內建空間和時間超解析器。
第三層:代理管線(Agentic Pipelines)
OpenMontage(calesthio,2026 年 4 月新推出)一個真正新穎的類別:具備 11 條管線、49 個工具和 400 多項代理技能的代理式影片製作系統。可與 Claude Code、Cursor、Copilot 等 AI 編碼助手一起使用。處理整個管線 — 研究、腳本、素材、剪輯 — 從頭到尾無需手動步驟。專為將多個 AI 工具整合到一個工作流程中的團隊而建。
-
付費 API 目錄:現有 SOTA 模型 {#paid-api-directory}
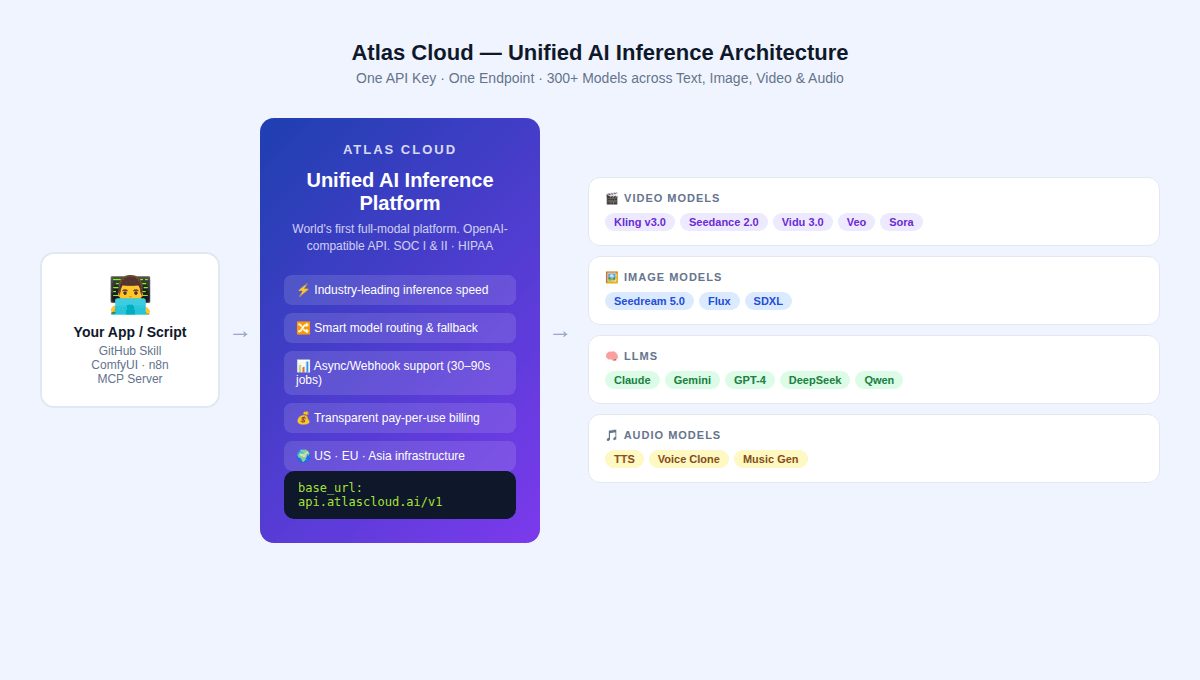
2026 年的付費 API 格局由三大模型家族定義,每個都有獨特的技術方法。三者均可透過 Atlas Cloud 的統一 API 取得。
Kling v3.0(快手)
2026 年 2 月 5 日發布。基於多模態視覺語言架構 — 文字、圖片、音訊和影片全部在一個系統中處理。
它實際上比競爭對手強在哪裡:
- 複雜的人體動作 — 跑步、跳舞、武術 — 不會出現其他模型常見的「義大利麵肢體」變形
- 多語言原生音訊生成(5 種語言,包括同步的嘴唇動作)
- Motion Brush:一個工具,讓開發者(或終端使用者)直接在來源圖片上繪製運動路徑 — 目前其他模型沒有等同的功能
- Element Binding,用於跨鏡頭保持角色和物體的一致追蹤
弱點: Pro 等級的渲染速度比某些競爭對手慢。根據獨立評論,故事板工具過渡可能「不順暢」。
最佳用途: 抖音和 Reels 上的社群短片、電子商務產品影片、任何需要大量且角色保持一致的內容。
Seedance 2.0(字節跳動)
2026 年 2 月 8 日發布,Seedance 2.0 代表了 AI 影片提示方式的典範轉移 — 從純文字提示轉變為真正的導演風格參考控制。
核心技術創新: Seedance 2.0 同時接受四模態輸入 — 文字、圖片、影片和音訊。其「Universal Reference」系統允許開發者提供一個人跳舞的參考影片,模型會在生成的輸出中複製攝影機運動、角色動作和構圖。這解決了純文字轉影片模型無法做到的角色一致性問題。
獨立測試證實其擅長:
- 多鏡頭敘事,角色身份在剪輯間保持一致
- 同步音訊-影片生成(雙分支架構同時生成聲音和影片)
- 精確複製參考素材的構圖和光線
注意事項: 截至 2026 年 4 月,Seedance 2.0 國際 API 可透過 Atlas Cloud 等平台取得。國際開發者直接使用 BytePlus API 的可用性曾有過不一致的情況 — 在建立對字節跳動直接端點的依賴之前,請確認當前狀態。
最佳用途: 音樂影片、精確的角色動畫、動作必須精準的產品廣告、以及執行故事板轉影片工作流程的代理商。
Vidu 3.0(生數 AI / 清華大學)
基於結合擴散模型和 Transformer 技術的原始 U-ViT 架構,Vidu 專注於大多數 AI 影片仍然掙扎的領域:環境連貫性和電影一致性。
獨特功能:
- 通用參考系統,用於多鏡頭序列中一致的光照
- 智慧背景音樂生成,自動適應場景情緒
- 長片生成,具有強大的時間一致性(對於超過 5 秒的序列至關重要)
最佳用途: 專業電影製作工作流程、動畫設計、需要電影品質的創意廣告。
Sora 2(OpenAI)
Sora 2 仍然是物理模擬準確度的標竿。在 Sora 2 的提示中讓玻璃破碎,碎裂模式、流體物理和反射都像真實情況一樣 — 大多數競爭對手仍無法達到那種一致性。
最佳用途: 視覺特效工作、建築可視化、紀錄片 B 卷、任何物理準確性比省錢更重要的場景。
定價: Sora 2 在這一類別中費用最高。你是在為運算能力付費。
-
推理成本:真實數字 {#inference-costs}
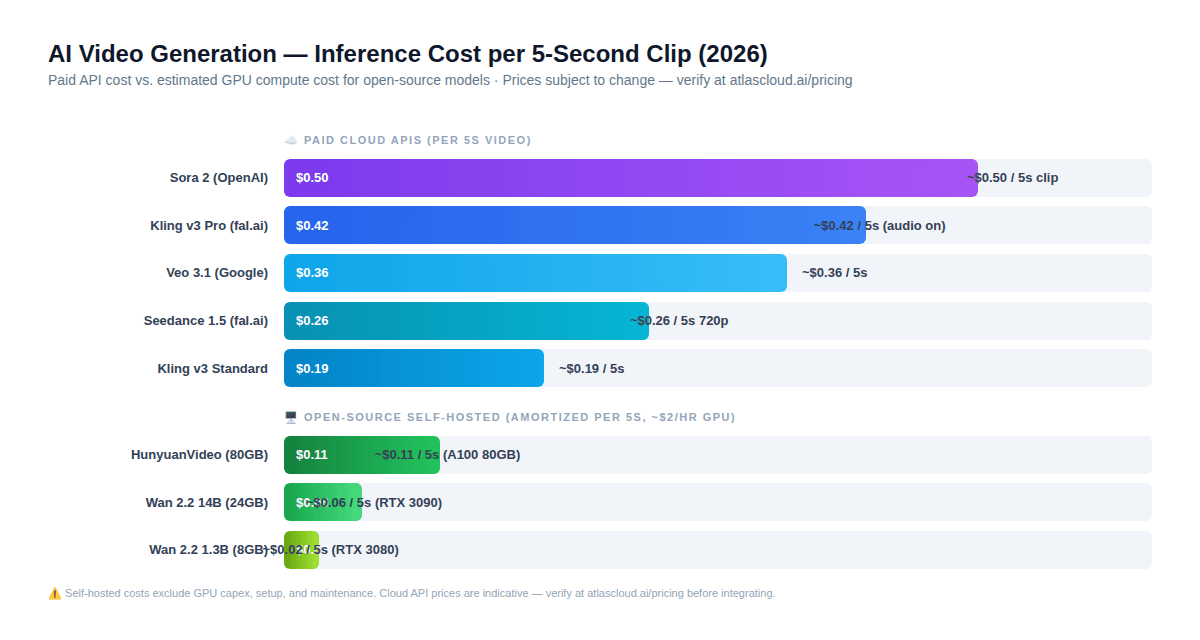
本節包含這份指南中最重要的反直覺發現 — 它改變了大多數開發者對開源與付費 API 的直覺認知。
自架模型的隱藏成本
大多數開發者認為:「開源 = 免費 = 永遠比較便宜。」
這個假設對大多數團隊規模來說是錯的。
以下是 2026 年一段 5 秒影片的實際數學計算:
自架開源(攤銷 GPU 成本約 $2/小時):
- Wan 2.2 1.3B(RTX 3080):每 5 秒片段約 $0.02
- Wan 2.2 14B(RTX 3090):每 5 秒片段約 $0.06
- HunyuanVideo(A100 80GB):每 5 秒片段約 $0.11
付費雲端 API(指示性定價 — 請在 atlascloud.ai/pricing 確認):
- Kling v3 Standard:每 5 秒片段約 $0.19
- Seedance 1.5 720p 含音訊:每 5 秒片段約 $0.26
- Kling v3 Pro 含音訊:每 5 秒片段約 $0.42
- Sora 2:每 5 秒片段約 $0.50
自架的數字單獨看起來很有吸引力。問題在於它們排除了:
- GPU 硬體 — 一張 A100 80GB 售價 $10K–$15K。以每月 1,000 部影片(每部約 $0.11)計算,你需要 9,000 多個月才能攤平硬體成本。
- 設定時間 — CUDA 設定、模型權重下載、VRAM 管理和除錯,初始設定需要 20–40 個工程師工時。
- 持續維護 — 模型更新、依賴衝突和基礎設施可靠性都是持續的時間成本。
- 機會成本 — 花在推理基礎架構上的時間,就是沒有花在產品上的時間。
實務上的邊界條件:
自架只有在以下情況才划算:(a) 你已經有 GPU 運行其他工作負載,(b) 你每月產出 5,000 部以上影片,或 (c) 法規強制你必須將所有資料保留在本地。
低於這個門檻,付費 API — 尤其是像 Atlas Cloud 這樣的統一平台 — 在誠實計算總體擁有成本後,反而更便宜。
-
速率限制與 API 延遲 — 開發者實際遇到的問題 {#rate-limiting}
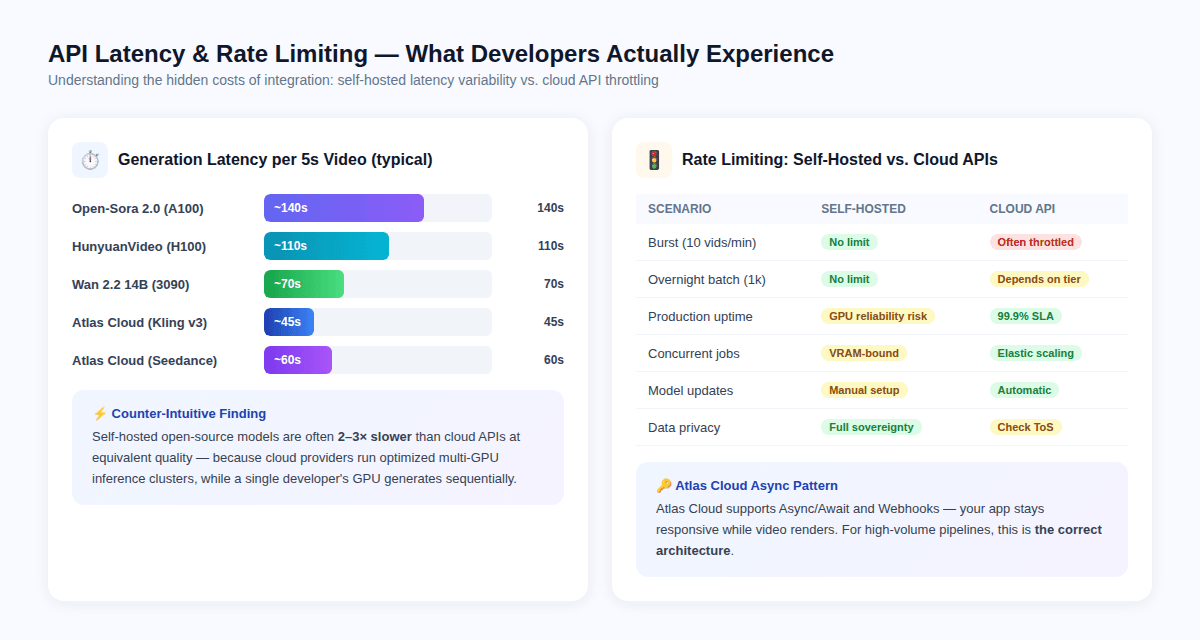
延遲悖論
反直覺的是,雲端 API 每部影片的速度通常比自架模型快 — 這不是因為模型不同,而是因為雲端供應商運行優化的多 GPU 推理叢集,具備硬體級批次處理,而單一開發者 GPU 則以序列方式生成影格。
每 5 秒片段的典型延遲:
- A100 上的 Open-Sora 2.0:約 140 秒
- H100 上的 HunyuanVideo:約 110 秒
- RTX 3090 上的 Wan 2.2 14B:約 70 秒
- Atlas Cloud / Kling v3:約 45 秒
- Atlas Cloud / Seedance 2.0:約 60 秒
這意味著圍繞自架模型建立的 GitHub 技能,即使每部影片的成本較低,也可能產生更長的使用者端等待時間。
速率限制:生產環境的現實
自架模型沒有 API 強加的速率限制 — 它們只受 GPU 的 VRAM 和熱限制約束。
付費 API 會強制實施速率限制,因定價層級而異。相關的工程影響:
- 突發請求(每分鐘 10 部以上影片)會在大多數付費 API 層級觸發節流
- 夜間批次作業(1,000 部以上影片)需要仔細的非同步設計以避免超時
- 自架模型的並發請求受 VRAM 限制 — 在單張 24GB 顯示卡上同時運行 2 個 14B 模型推理通常是不可能的
Atlas Cloud 透過非同步/Webhook 架構解決速率限制問題:你的應用程式提交一個生成任務,收到一個任務 ID,並在渲染完成時透過 webhook 收到通知。這種模式可防止應用程式在影片渲染時卡住,並能正確擴展以處理批次工作負載。
生產環境的正確架構
plaintext1# Atlas Cloud 非同步模式 — 生產就緒 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# 提交生成任務 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="產品展示影片,流暢動作,9:16 比例", 14 size="1080x1920", 15 n=1 16) 17 18# 處理非同步回應 19video_url = response.data[0].url 20print(f"影片已生成:{video_url}")
對於圖片轉影片工作流程,請注意某些模型(包括某些 Kling i2v 變體)不接受圖片轉影片的單獨長寬比參數;輸出解析度跟隨輸入圖片的尺寸。請確保你的上游圖片生成使用正確的目標比例。
-
本地託管 vs. 雲端 API:取捨矩陣 {#local-vs-cloud}
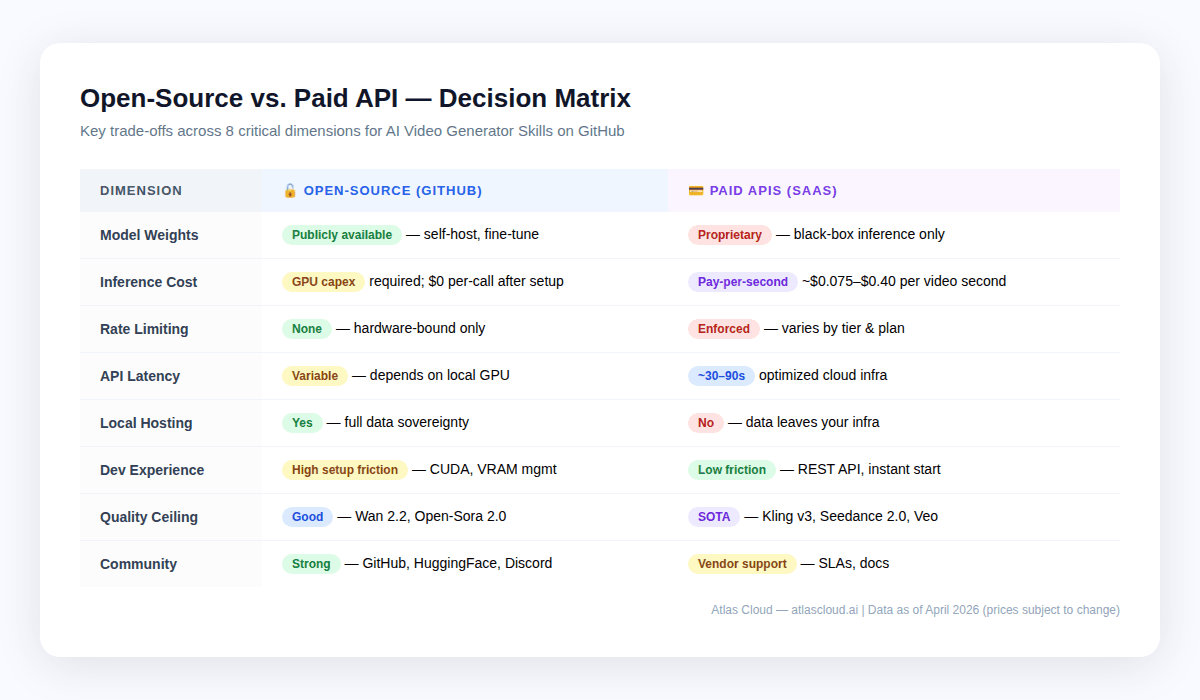
這不是二選一。大多數生產管線會混合使用兩者:開源用於原型製作和大量低品質的通過測試,雲端 API 用於最終渲染和尖端品質。
本地端適用的情況
- 合規限制 — HIPAA、GDPR 或任何不能離開你伺服器的專有資料。自架是唯一選擇。Atlas Cloud 符合 HIPAA 規範並通過 SOC I 和 II 認證,能滿足大多數企業需求,但受監管的企業應仔細核對其特定要求。
- 可接受品質下的極高產量 — 每月生成 10,000 部以上影片,且使用 Wan 2.2 品質等級的團隊,可能會發現 GPU 租賃成本在該規模下低於 API 費用。
- 研究和微調 — 開放模型權重允許在專有資料集上進行微調。目前沒有雲端 API 提供自訂模型訓練。
- 氣隙環境 — 沒有連線或鎖定網路的邊緣部署。
雲端 API 勝出的情況
- 上市時間 — Atlas Cloud 整合只需數小時,而非數週
- 頂級品質 — Wan 2.2 和 Open-Sora 2.0 等開源領先者仍落後於 Kling v3 和 Seedance 2.0 等專有模型,特別是在人體動作、保持鏡頭一致性和原生音訊方面
- 波動性工作負載 — 雲端 API 可以伸縮自如;你自己的 GPU 則不行
- 較低產量 — 每月低於約 5,000 部影片時,雲端 API 通常在總成本上勝出
- 多模型靈活性 — Atlas Cloud 的 300 多種模型目錄意味著你可以在單一整合中從 Kling 切換到 Seedance 再到 Veo
-
社群驅動 vs. 供應商驅動開發 {#community-vs-vendor}
在比較 API 時很容易忽略這點,但如果你正在建構 GitHub 技能,這實際上很重要。
社群驅動(開源):
- 任何人都可以提交錯誤修復和功能請求 — 並有機會被合併
- 文件通常很優秀,因為使用者群體貢獻了範例
- 模型 API 的重大變更發生速度緩慢,並有公開通知期
- ComfyUI 和 Hugging Face Diffusers 社群擁有大量現成的工作流程、LoRA 適配器和微調檢查點
- 研究論文會附帶開放、可複現的程式碼
供應商驅動開發(付費 API):
- API 穩定性受商業 SLA 管轄 — 重大變更較不頻繁,但仍會發生
- 新模型發布(例如 2026 年 2 月的 Kling 3.0,比 Seedance 2.0 早三天)以競爭速度進行,且通常沒有事先通知
- 模型改進在伺服器端部署,開發者無需採取任何行動
- 技術文件由專業團隊維護
對 GitHub 技能作者的實際影響: 如果你正在撰寫一個需要保持穩定和低維護成本的技能,具有穩定端點合約的雲端 API 比綁定特定開源模型版本的技能更容易維護。相反地,如果你的技能旨在讓開發者無需 API 成本即可存取最新研究模型,那麼開源生態系統就是這項工作發生的地方。
-
案例研究:社群媒體代理商(每月 500 部影片) {#case-study-1}
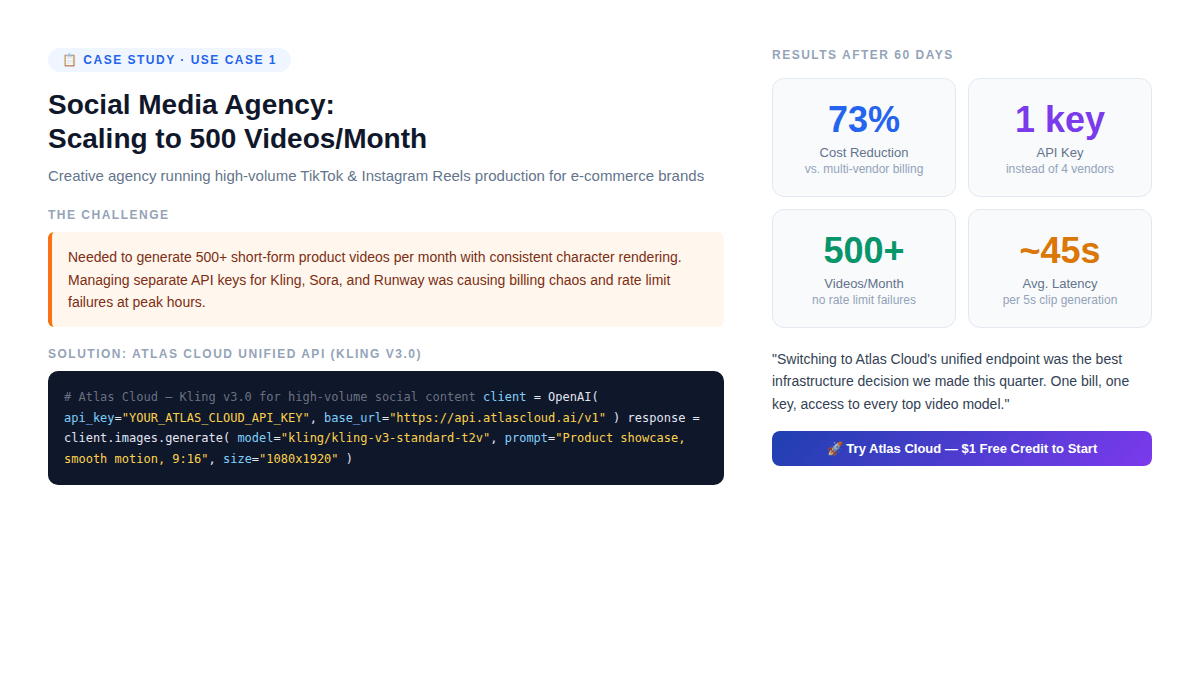
情境: 一家為 20 個電子商務客戶製作短產品影片的創意工作室。他們每月需要 500 部影片,角色在剪輯間看起來相同,9:16 垂直格式,每部 5–10 秒,在非高峰期批次處理。
初始架構(使用 Atlas Cloud 之前):
- 分別為 Kling、RunwayML 和 Pika 使用不同的 API 金鑰
- 三個計費儀表板,三個速率限制池
- 每個客戶手動選擇模型
- 尖峰時段速率限制失敗導致交付延遲
這造成的問題: 當 Kling 發布 v3.0 時,代理商必須重新整合新的 SDK、更新計費並測試相容性 — 對三個供應商各做三次。
解決方案: Atlas Cloud 統一 API 搭配 Kling v3.0 Standard
plaintext1# Atlas Cloud — 社群媒體影片管線 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, 流暢動作,電影級光線,9:16 垂直格式", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
60 天後成果:
- 每部影片成本降低 73%(單一帳單,無供應商加成)
- 零速率限制失敗(Atlas Cloud 的彈性基礎架構吸收了尖峰負載)
- 為特定客戶從 Kling 切換到 Seedance 只需不到 2 分鐘(更改一個參數)
- 首次儲值 20% 獎勵實際上抵消了第一個月的製作成本
非顯而易見的發現: 代理商減少供應商數量不是因為 Kling 變得更好了。而是因為 在每月 500 部影片的規模下,管理多個供應商關係具有非微不足道的營運成本,而這些成本不會出現在每個 API 的定價中。
-
案例研究:獨立開發者建構影片 SaaS {#case-study-2}
情境: 獨立開發者為早期新創公司建立一個「文字轉產品示範」工具。需要多種風格 — 電影、動畫、實景。必須快速驗證,並在弄清楚是否有人真的想要這個之前,將基礎設施控制在每月 $200 以下。
架構決策:
開發者最初考慮在租用的 A100 實例上自架 Wan 2.2(約 $2/小時)。在驗證期間生成 100 部測試影片,預計 GPU 時間成本約 $6。看起來比 Atlas Cloud 便宜。
計算中遺漏的部分:
- 設定 Wan 2.2 管線花了 3 天(CUDA 依賴項、VRAM 管理、伺服器設定)
- Wan 2.2 的輸出品質與 Kling v3 的差距,使得 SaaS 無法收取預期的價格
- 伺服器正常運行時間管理每週增加約 2 小時的持續維護
使用 Atlas Cloud 的修訂架構:
plaintext1# 靈活的模型路由 — 根據使用者層級切換 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # 較低成本 4 "pro": "kling/kling-v3-professional-t2v", # 較高品質 5 "enterprise": "bytedance/seedance-2.0" # 最大控制 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
結果: 開發者在 4 天內發布,而不是 3 週。高級層級使用 Seedance 2.0,證明了與免費層級相比 3 倍的價格溢價是合理的,而分層模型結構僅使用一個 Atlas Cloud 金鑰建立 — 而不是三個不同的供應商整合。
-
Atlas Cloud 的優勢:為什麼「單一 API」是正確的架構 {#atlas-cloud-advantage}
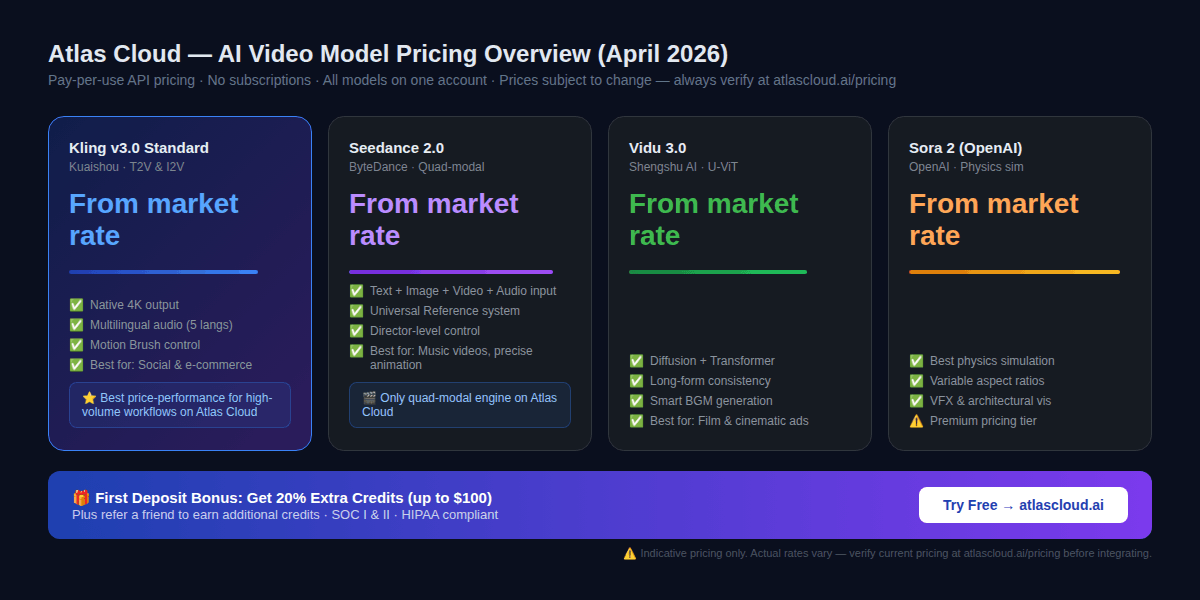
Atlas Cloud 定位為全球首個全模態 AI 推理平台 — 一個統一的 API,提供 300 多種模型,涵蓋文字、圖片、影片和音訊生成。
對於 GitHub AI 影片生成技能的作者,具體優勢包括:
-
OpenAI 相容 API(即插即用)
Atlas Cloud 使用 OpenAI 相容的端點。如果你的技能已經整合 OpenAI SDK,切換到 Atlas Cloud 進行影片生成只需更改兩行:api_key 和 base_url。無需新的 SDK,無需新的驗證系統。
-
多模型工作流程的單一計費
生產級影片工作流程很少只使用一個模型。典型的管線可能包含:
- Seedream 5.0 用於圖片生成(起始影格)
- Kling v3.0 用於圖片轉影片
- LLM(Claude、GPT-4 或 DeepSeek)用於提示最佳化
- TTS 模型用於旁白
使用不同的供應商帳戶,這意味著四個計費關係、四個速率限制池和四個整合點。使用 Atlas Cloud,只需要一個 API 金鑰和一張發票。
-
模型層級定價透明度
Atlas Cloud 發布每個模型的定價,沒有隱藏的運算費用。商業模式很直接:為你生成的內容付費。新開發者在首次儲值時可獲得 20% 獎勵(最高 $100),推薦計畫則提供額外額度。在建立財務預測之前,請務必在 atlascloud.ai/pricing 確認當前定價。
-
合規涵蓋範圍
對於部署在受監管環境中的企業級 GitHub 技能:Atlas Cloud 持有 SOC I 和 II 認證並符合 HIPAA 規範,基礎設施分佈在美國、歐盟和亞洲地區。這涵蓋了大多數企業的資料駐留要求。
-
ComfyUI、n8n 和 MCP 伺服器整合
Atlas Cloud 與最常用於建構 GitHub 影片生成技能的工具原生整合:
- ComfyUI — 用於視覺化工作流程編寫的自訂節點
- n8n — 工作流程自動化,包含 Atlas Cloud 影片生成步驟
- MCP 伺服器 — 用於 AI 代理框架的模型上下文協定整合
-
你實際上應該使用哪個堆疊? {#decision-guide}
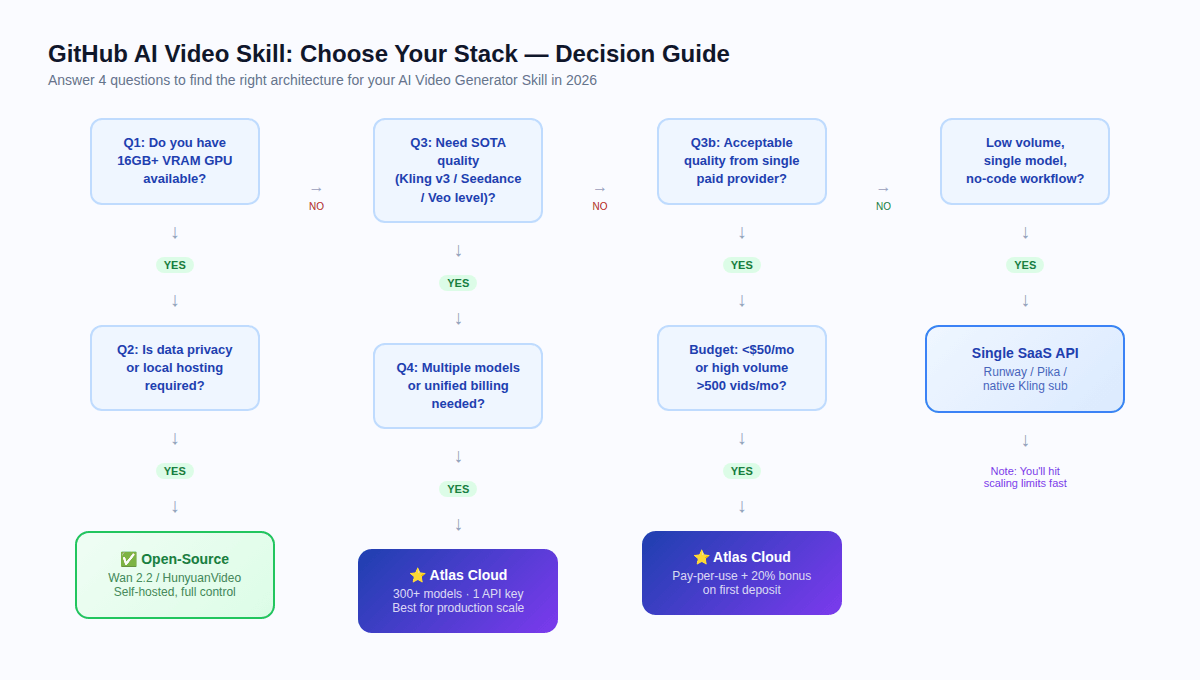
依序回答這四個問題:
Q1:你是否有 16GB+ VRAM 的 GPU 可用?
如果沒有 → 完全跳過自架。雲端 API 是你唯一實際的路徑。
Q2:法規是否要求資料隱私或本地託管?
如果是 + 有 GPU → 評估開源(Wan 2.2 或 HunyuanVideo,取決於 VRAM)。
如果是 + 沒有 GPU → 使用 Atlas Cloud(符合 HIPAA 規範,SOC 認證)並審查你的特定監管要求。
Q3:你是否需要 SOTA 品質(Kling v3、Seedance 2.0、Veo 等級)?
如果是 → 需要雲端 API。2026 年,開源模型與頂級專有模型之間存在顯著的品質差距。
如果可以接受開源等級的品質 → Wan 2.2 自架可能可行。
Q4:你是否需要多個模型或統一計費?
如果是 → Atlas Cloud。在規模化時,管理三個供應商帳戶具有隱藏的營運成本,只有在生產量下才會顯現。
按使用案例的摘要建議
| 使用案例 | 建議堆疊 |
| 研究 / 原型製作 | 開源(Wan 2.2、CogVideoX) |
| 社群媒體代理商,每月 500+ 部 | Atlas Cloud + Kling v3.0 |
| 音樂影片 / 角色動畫 | Atlas Cloud + Seedance 2.0 |
| 視覺特效 / 物理模擬 | Atlas Cloud + Sora 2 |
| 資料主權 / 離線 | 自架(HunyuanVideo、Open-Sora 2.0) |
| 分層模型品質的 SaaS | Atlas Cloud(一個金鑰,多種模型) |
| 高產量開源批次 | Wan 2.2 自架(每月 10,000 部以上門檻) |
-
常見問題 {#faq}
Q:什麼是 AI 影片生成技能?
一個可重複使用的程式碼模組或整合層,將應用程式連接到 AI 影片生成後端 — 可以是開源權重或雲端 API。常見形式:Python 類別、ComfyUI 節點、n8n 工作流程、MCP 伺服器工具。
Q:自架開源影片模型所需的最低 VRAM 是多少?
Wan 2.2 1.3B 需要 8GB VRAM(短片段可接受的品質)。CogVideoX-1.5 或 Open-Sora 需要 16GB(較佳品質)。Wan 2.2 14B 需要 24GB+。HunyuanVideo 或 Open-Sora 2.0 完整模型需要 60–80GB。
Q:開源 AI 影片生成真的是免費的嗎?
模型權重是免費的。推理並非免費 — 它需要 GPU 運算。在低產量(每月 <5,000 部影片)時,像 Atlas Cloud 這樣的雲端 API 在計算總體擁有成本後通常更便宜。
Q:我可以使用 Atlas Cloud 進行圖片轉影片(i2v)工作流程嗎?
可以。Atlas Cloud 支援 Kling、Seedance 和 Vidu 的 i2v 變體。請注意:對於 i2v 模型,某些變體不接受單獨的長寬比參數 — 輸出解析度跟隨輸入圖片的尺寸。
Q:Atlas Cloud 如何處理速率限制?
Atlas Cloud 支援非同步/Webhook 模式。影片生成作業以任務形式提交;你的應用程式收到一個任務 ID,並在渲染完成時收到通知。這可防止在規模化時阻塞。
Q:哪個模型最適合跨鏡頭保持角色一致性?
Seedance 2.0 的 Universal Reference 系統是 2026 年最先進的解決方案。它允許你提供參考影片、圖片和音訊,以在生成的剪輯中保持角色外觀和動作的一致性。
Q:Atlas Cloud 支援 ComfyUI 嗎?
是的。Atlas Cloud 具有原生的 ComfyUI 整合,以及 n8n 節點和 MCP 伺服器相容性。
Q:開源影片模型如何處理長寬比?
因模型而異。Open-Sora 透過 --aspect_ratio 標誌支援 16:9、9:16、1:1 和 2.39:1。Wan 2.2 和 LTX-Video 支援多種比例。對於 i2v 工作流程,大多數模型會跟隨輸入圖片的長寬比,無論指定的參數為何。
總結
2026 年的格局分為兩個陣營,各有其最佳適用範圍:
開源在你有多餘 GPU、每月產出 10K 部以上影片、資料不能離開你的伺服器,或需要微調專有素材時是合理的選擇。
付費 API在你需要最佳可用品質、速度比成本更重要、每月產出低於 5K 部影片,或想混合多種模型而不需處理多份供應商合約時,是更好的選擇。
Atlas Cloud 橋接了兩者: 作為一個統一平台,提供 300 多種模型 — 包括透過託管推理提供的頂級開源模型和所有主要專有模型 — 透過單一 OpenAI 相容的 API 金鑰存取。對於在 2026 年建構生產級 GitHub AI 影片生成技能的大多數開發者來說,它是從原型到生產路徑摩擦最低的選擇。
本文中的定價資訊為指示性,可能隨時變更。在建立財務預測之前,請務必在 atlascloud.ai/pricing 確認當前費率。模型可用性可能因地區而異。
Atlas Cloud:atlascloud.ai — SOC I & II 認證 · 符合 HIPAA 規範 · 美國 · 歐盟 · 亞洲基礎設施


