一位 Enterprise 客戶詢問,年度方案在續約後是否可退款。你的助理掃描大量文件後,給出乾脆的「可以」。它甚至引用了一項政策。問題在於:它選的是 v4.1,一份已封存的政策,而簽署附錄與 v4.2 說的卻是另一回事。
這就是為什麼 gpt-6 astra knowledge base best practices 要從證明開始。給模型一套權威順序,只檢索獲授權的現行證據,並讓每一項重大主張都能回溯到文件、版本與章節。若證據互相衝突或不足,答案必須停止。
GPT-6 Astra 可搭配 File Search 與 1,050,000-token 上下文視窗運作,最大輸出為 128,000 token。容量有助於調查,但它不會決定哪項政策是現行版本、哪位使用者可看見,或引用是否真的支持鄰近主張。(OpenAI GPT-6 Astra 模型頁面,2026 年 9 月)
一段 8 秒的生成式工作流程視覺:簽署的覆寫條款與現行政策留在證據區,而已封存檔案被明顯移開。這說明來源治理,並非實際產品介面或來源文件。
重點摘要
- 上傳前先核准來源權威。
- 分別衡量檢索與答案忠實度。
- 檢索前依存取權、狀態、日期與地區篩選。
- 將長上下文視為調查工具,而非預設提示。
- 將衝突與缺漏證據呈報給人員。
為何 GPT-6 Astra 知識庫會因 1M Token 而失敗
多數失敗在答案產生前就開始了。一份 Drive 匯出內容會把簽署附錄、現行政策、舊版 FAQ 與草稿,全都當成同樣可搜尋的散文。能力強的模型能很快把這堆混亂內容變成一段具說服力的文字。
四項檢查可捕捉常見失敗模式:
- 權威漂移: 較新的政策或客戶附錄,敗給受歡迎的舊版 FAQ。
- 引用表演: 答案含有來源連結,但被引用的段落並不支持該主張。
- 不受控實驗: 區塊大小、top-k 與上下文預算同時變動,因此沒人知道是什麼帶來改善。
- 存取漂移: 地區例外、受限草稿或私人備註,被錯誤的對象檢索到。
討論評估的法律 RAG 實務工作者,傾向將「檢索是否找到必要來源?」與「答案是否忠實套用該來源?」分開。這種區分應納入每個發布關卡,包括內部支援機器人。(r/Rag 法律知識庫討論,2026 年 9 月)
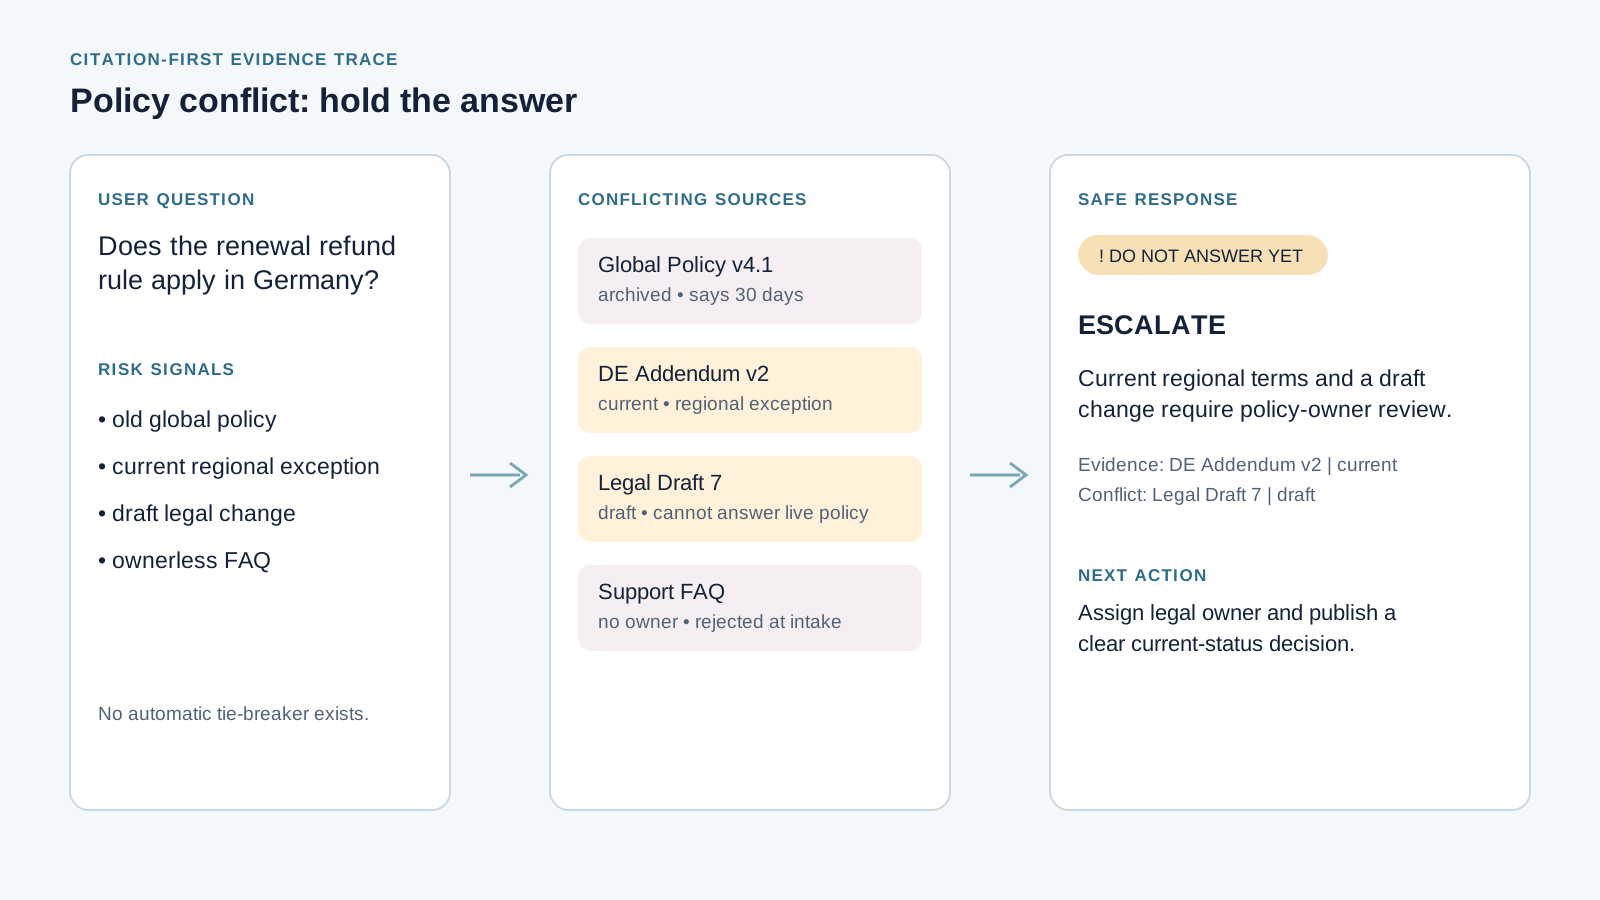
衝突是有用的輸出。此案例說明系統為何應回傳「暫不回答」,而不是在草稿、地區例外、舊政策與無主檔案之間默默選擇。
GPT-6 Astra 知識庫工作流程、模型與成本
試點時使用一個瀏覽器分頁:盤點來源、核准權威清單、正規化檔案與中繼資料、檢索一組小型證據,然後回答與評估。營運目標是可審查的證據軌跡,而不是聰明的聊天展示。
若團隊要比較堆疊的其他部分,Atlas Cloud 提供一處可檢視目前模型選項的地方。在你發布當天查核之前,不要假設某個型錄已列出 GPT-6 Astra。
| 層級 | 可解決的工作 | 無法單獨解決的事 | 試點規則 |
|---|---|---|---|
| 長上下文 | 閱讀大型調查包 | 權威、權限、引用支持 | 用於例外與調查 |
| File Search | 檢索小型來源集 | 版本治理 | 搜尋前先篩選 |
| 自訂檢索 | 調整索引與排序 | 答案忠實度 | 測試時保持上下文預算不變 |
| 人工呈報 | 解決衝突與高影響決策 | 例行規模化 | 定義負責人與回應時間 |
| 模型或工具 | 工作 | 建議設定 | 規劃時採用的已公布價格 |
|---|---|---|---|
| GPT-6 Astra | 衝突判斷、綜合、評估 | reasoning.effort: high | $10/MTok 輸入、$50/MTok 輸出 |
| OpenAI File Search | 獲授權文件檢索 | 中繼資料篩選與引用 | 上線前查核工具費用 |
| 例行模型路由 | 標籤與低風險分類 | 先進行基準測試 | 不要硬編碼價格 |
| Atlas Cloud 模型型錄 | 後續模型探索 | 使用即時型錄 | 不假設有 Astra 可用性 |
從 20 到 50 個高價值問題,以及一組刻意刁鑽的文件開始。納入一份已被取代的政策、一份缺漏的附錄、一項地區例外,以及至少一個必須無法回答的問題。
步驟 1:建立權威清單
上傳任何內容之前,先把盤點結果變成經簽核的決策層。人類負責人應在回傳的 JSON 成為 KB_MANIFEST.md 之前予以核准。這是防止完美答案建立在淘汰文字上的第一道護欄。
plaintext1You are the knowledge-governance reviewer for an enterprise support knowledge base. 2 3Goal: 4Create an authority manifest before any answer-generation workflow begins. 5 6For every supplied document, identify: 7- document_id 8- title 9- owner 10- effective_date 11- region 12- audience 13- status: current, draft, archived, superseded, or unknown 14- authority_rank from 1 to 5 15- conflict_rules 16- access_policy 17- reason_for_rank 18 19Authority rules: 201. Signed customer addenda override general policies for the covered account. 212. Current policy versions override archived or superseded versions. 223. Official policy documents override FAQs and training notes. 234. Drafts may be used only when the user explicitly asks about a draft. 245. If two current sources conflict, do not resolve the conflict. Return ESCALATE. 25 26Return valid JSON only. Do not infer missing dates or policy terms.
設定: 模型 gpt-6-astra;Responses API;reasoning.effort: high;結構化 JSON 輸出。初次審查只提供標題、負責人、生效日期、地區、狀態與存取層級。
完成條件: 每個檔案都有負責人、日期、狀態與等級,且 Refund Policy v4.1 被標記為已由 v4.2 取代。
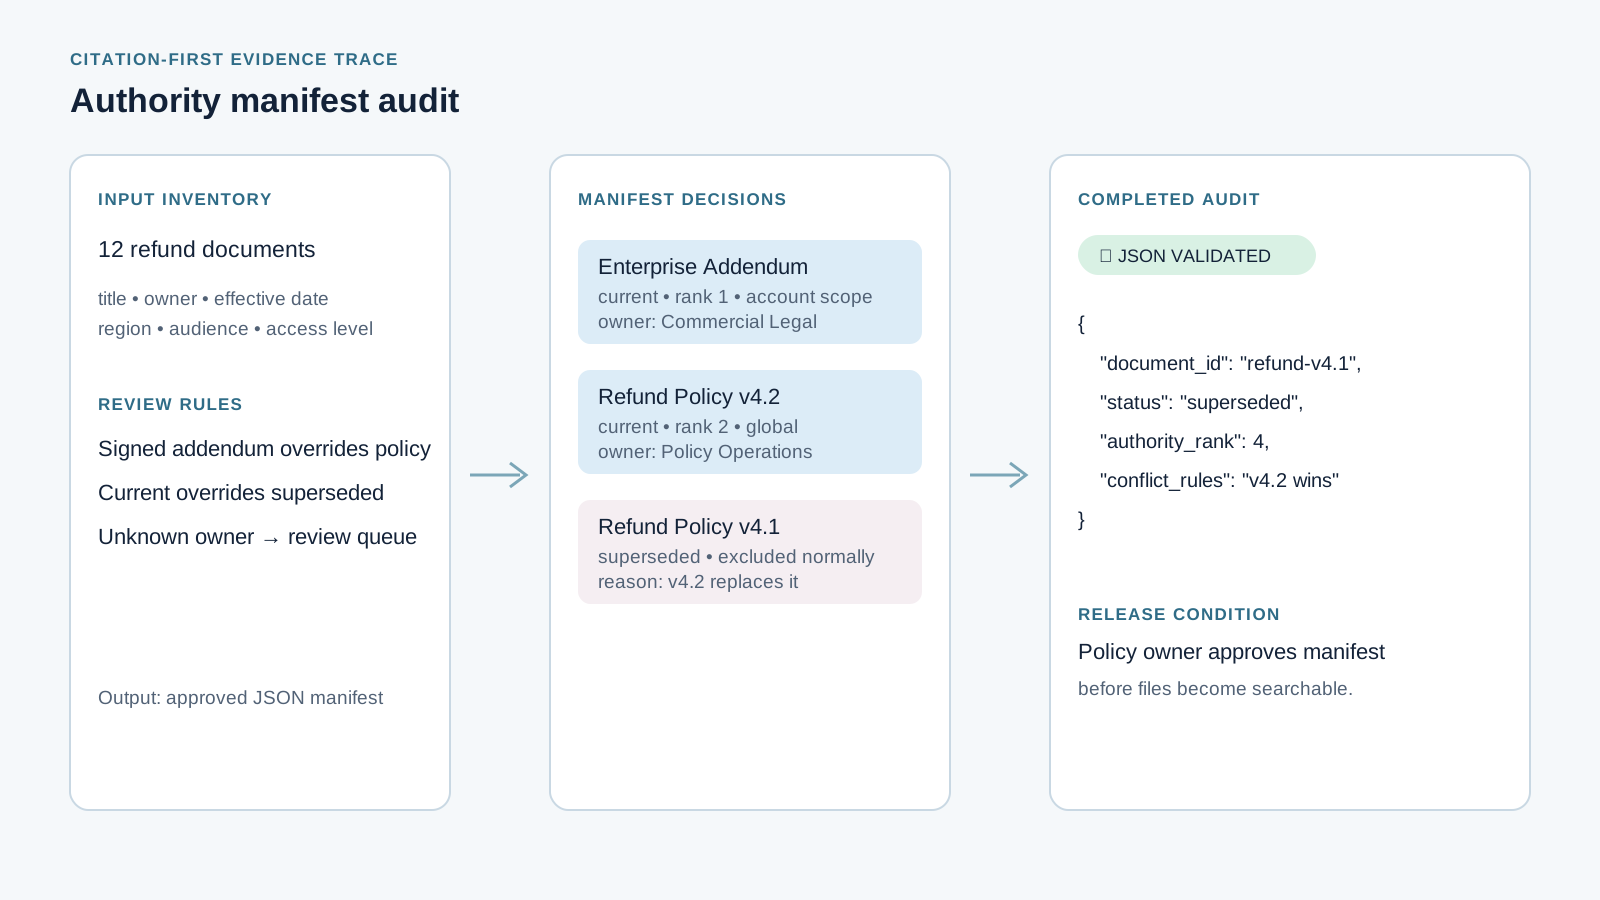
退款試點的已完成權威清單稽核。稽核頁面記錄了已被取代的 v4.1 與 Enterprise 覆寫規則。
步驟 2:為檢索準備 GPT-6 Astra 知識庫
正規化已核准的來源。保留標題、條件、頁面標記與版本資料。移除重複頁尾、導覽與 OCR 殘留。不要上傳沒有負責人或生效日期的文件。
plaintext1You are preparing files for a retrieval-based knowledge base. 2 3Inspect the supplied document inventory and return a file-preparation checklist. 4 5For each file: 61. Keep the source title, version, effective date, owner, and page or section markers. 72. Remove navigation, duplicated footers, stale boilerplate, and OCR fragments. 83. Preserve headings and lists that carry policy conditions. 94. Mark whether the file is current, archived, draft, or restricted. 105. Reject any file that cannot be assigned an owner and effective date. 11 12Return a table with: 13file_name | status | metadata_to_attach | cleanup_required | upload_decision | reason
設定: 將 document_id、version、effective_date、status、region、audience 與 authority_rank 附加為中繼資料。檢索測試開始時,總檢索上下文約為 2,000 token。一次只改一個變數:區塊策略或檢索數量,絕不要同時改。
完成條件: 已封存素材被排除於一般查詢之外,且無主檔案會進入審查佇列。
下一個動態案例讓分類決策變得可見:兩個已核准來源資料夾一起留在權威區,而一份模稜兩可的草稿移到另一條審查路徑。這是示意性工作流程算繪,並非實際的 GPT-6 回應或產品介面。
一段 8 秒的生成式工作流程視覺:已核准來源資料夾保持在一起,而未解決的資料夾被路由至人工審查。
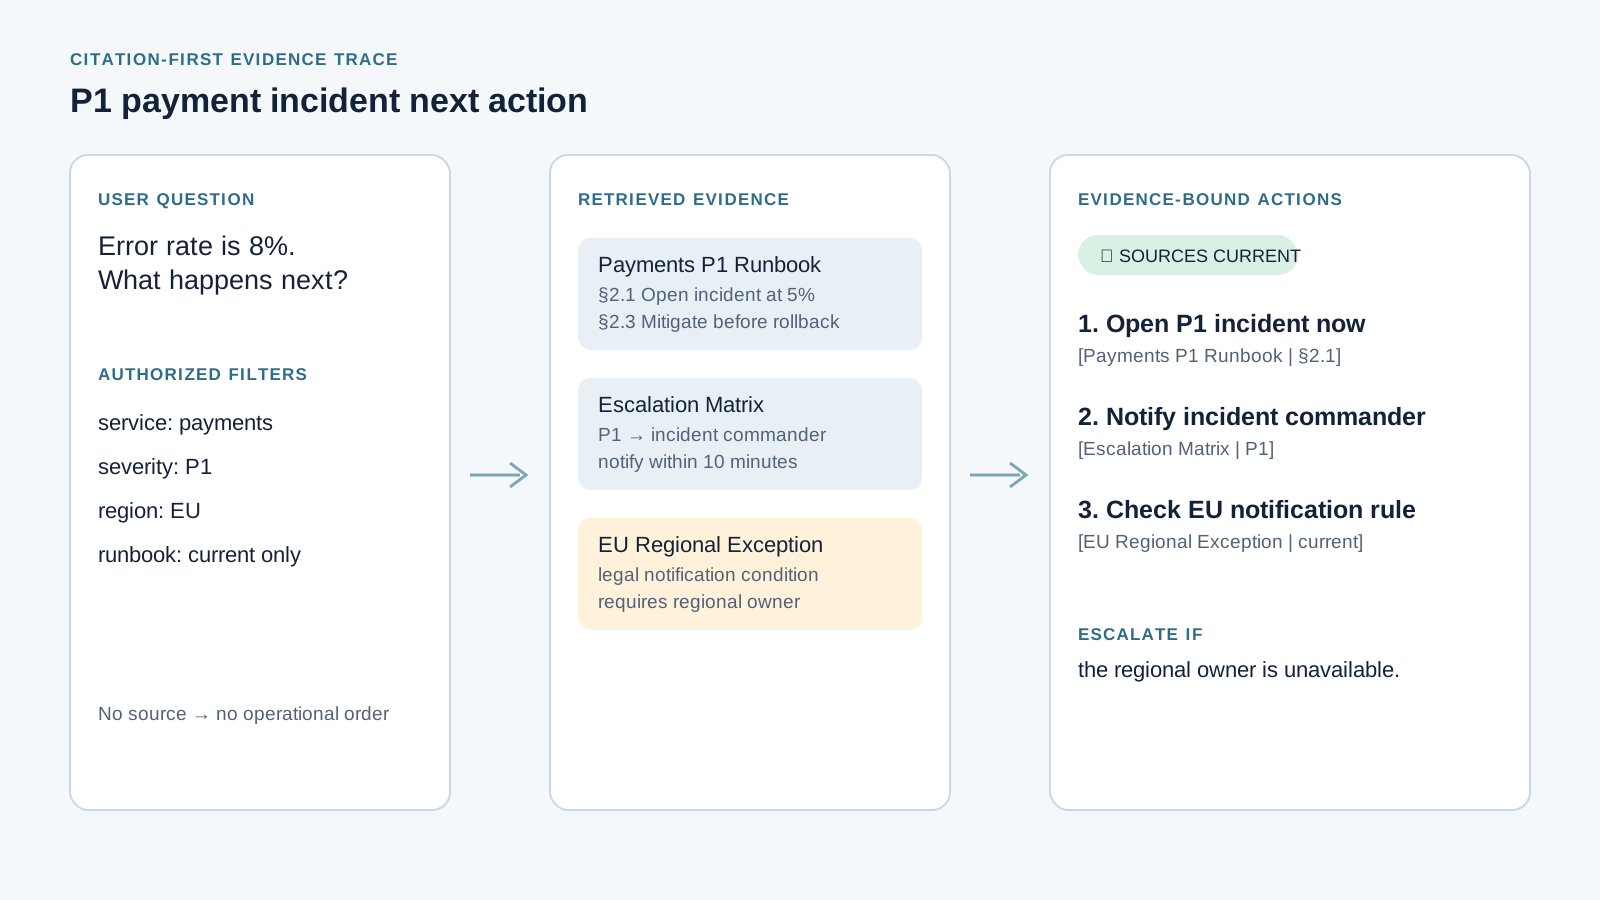
案例 2。一則付款錯誤問題會提取待命 runbook、呈報矩陣與地區例外。答案指出事件指揮官觸發條件,而不是即興擬定復原計畫。
步驟 3:要求有證據依據的答案
將答案生成綁定到已檢索、獲授權的證據。模型應區分事實、假設與後續行動,讓審查者看見系統何處停止知道。
plaintext1You are an evidence-bound knowledge-base assistant. 2 3Answer the user question using only the retrieved, authorized knowledge-base sources. 4 5Rules: 6- Treat the authority manifest as binding. 7- Prefer the highest-ranked current source that applies to the user’s region and audience. 8- Every factual claim must include [document title | version | section or page]. 9- If sources conflict, identify the conflict and return ESCALATE instead of choosing silently. 10- If the evidence does not support a claim, write INSUFFICIENT_EVIDENCE. 11- Do not use general model knowledge to fill gaps. 12- Separate confirmed facts, assumptions, and recommended next actions. 13- For regulated or high-impact questions, state that a qualified human review is required when the evidence is incomplete. 14 15User question: 16Can an Enterprise annual-plan customer receive a refund after renewal if the account has a signed Enterprise addendum? 17 18Return: 191. Decision 202. Evidence 213. Exceptions or conflicts 224. Next action 235. Confidence: supported, partial, or insufficient
設定: 使用 reasoning.effort: high 與 File Search。檢索前套用現行狀態、使用者授權、地區與對象篩選。工具呼叫屬於 Responses API;OpenAI 目前指引也建議為 Astra 工作流程定義明確的成功條件與工具界線。(OpenAI 模型指引,2026 年 9 月)
完成條件: 回覆引用現行一般政策與簽署的 Enterprise 附錄,絕不將已封存的 v4.1 當作規則,且若附錄不存在,會回傳 INSUFFICIENT_EVIDENCE。
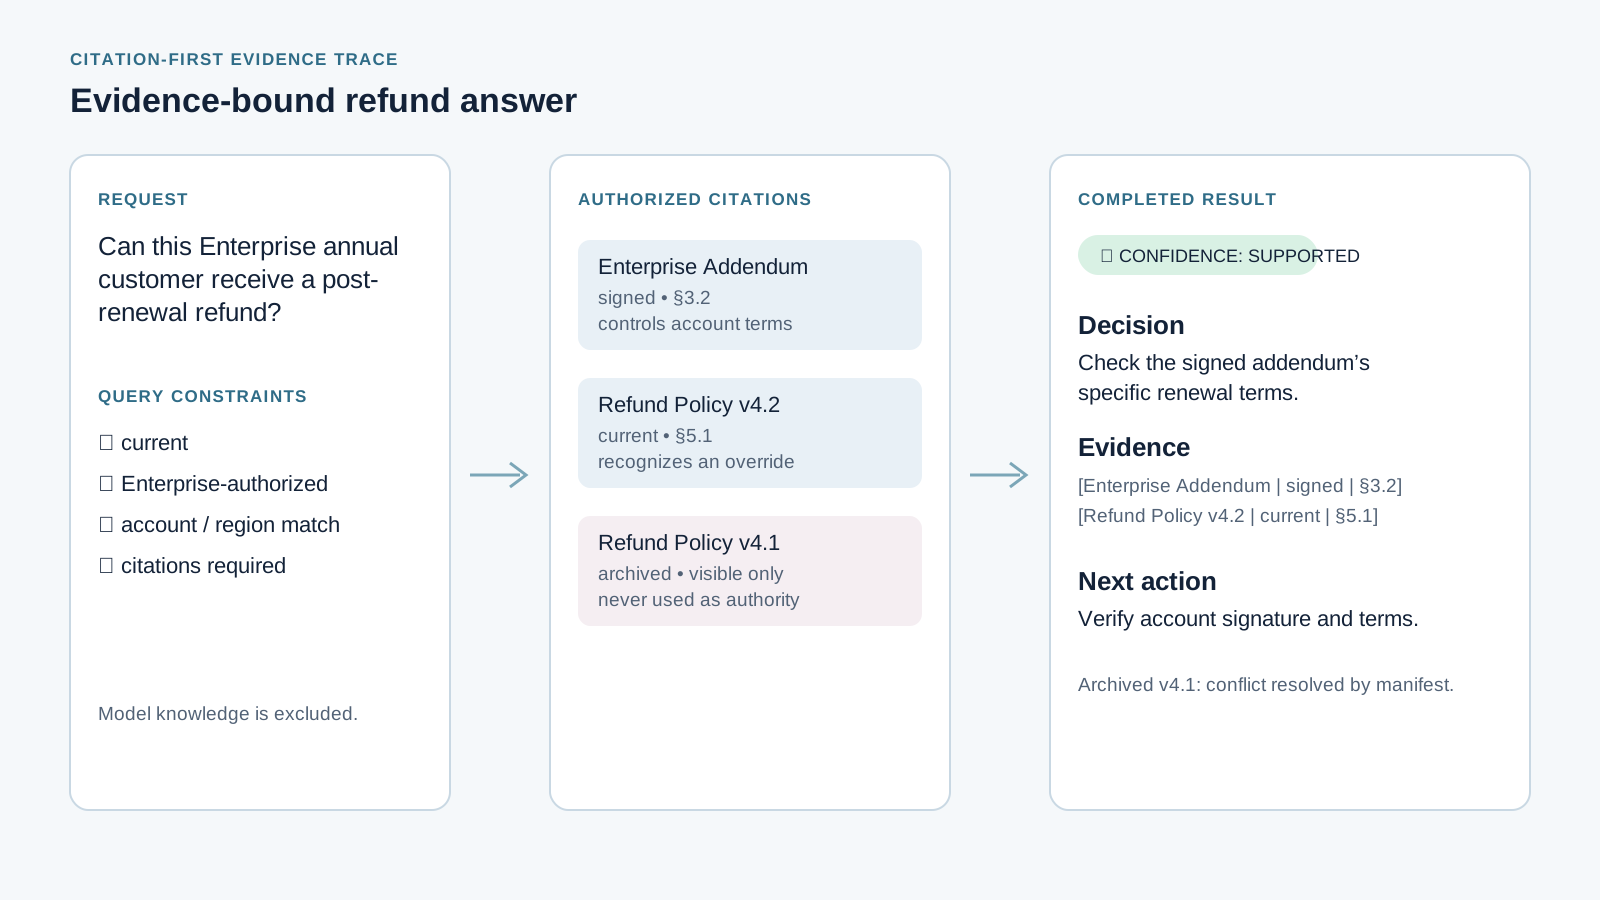
主要完成結果:該決策由 v4.2 與簽署附錄支持,而已封存文件僅以已解決衝突的形式保持可見。
步驟 4:分別評估檢索與忠實度
答案可能引用某份文件,卻套用了錯誤條款。分別為檢索召回率與主張忠實度評分。這會產生產品、支援或法律負責人可辯護的發布決策。
plaintext1You are evaluating a knowledge-base answer. 2 3Given: 4- the user question 5- expected source sections 6- retrieved source sections 7- the final answer 8 9Score these dimensions separately: 101. Retrieval recall: did the required source appear in the retrieved evidence? 112. Citation precision: does each cited source support the nearby claim? 123. Claim faithfulness: is every atomic factual claim supported by retrieved evidence? 134. Conflict handling: did the answer surface conflicting current sources? 145. Abstention quality: did the answer refuse unsupported conclusions? 15 16Return JSON with: 17question_id, retrieval_recall, citation_precision, claim_faithfulness, 18conflict_handling, abstention_quality, unsupported_claims, reviewer_notes, 19release_decision 20 21Use FAIL if any high-risk factual claim lacks supporting evidence.
設定: 建立 20 題黃金集,簡單、常見、衝突、無答案與高風險案例各 4 題。高風險與衝突問題維持高推理。只有在基準通過後,才對低風險工作測試較低推理強度。
完成條件: 該集合包含「檢索到正確文件/套用錯誤條款」的失敗案例,以及一次正確棄答。人工審查者抽查每一個有支持的高風險答案。
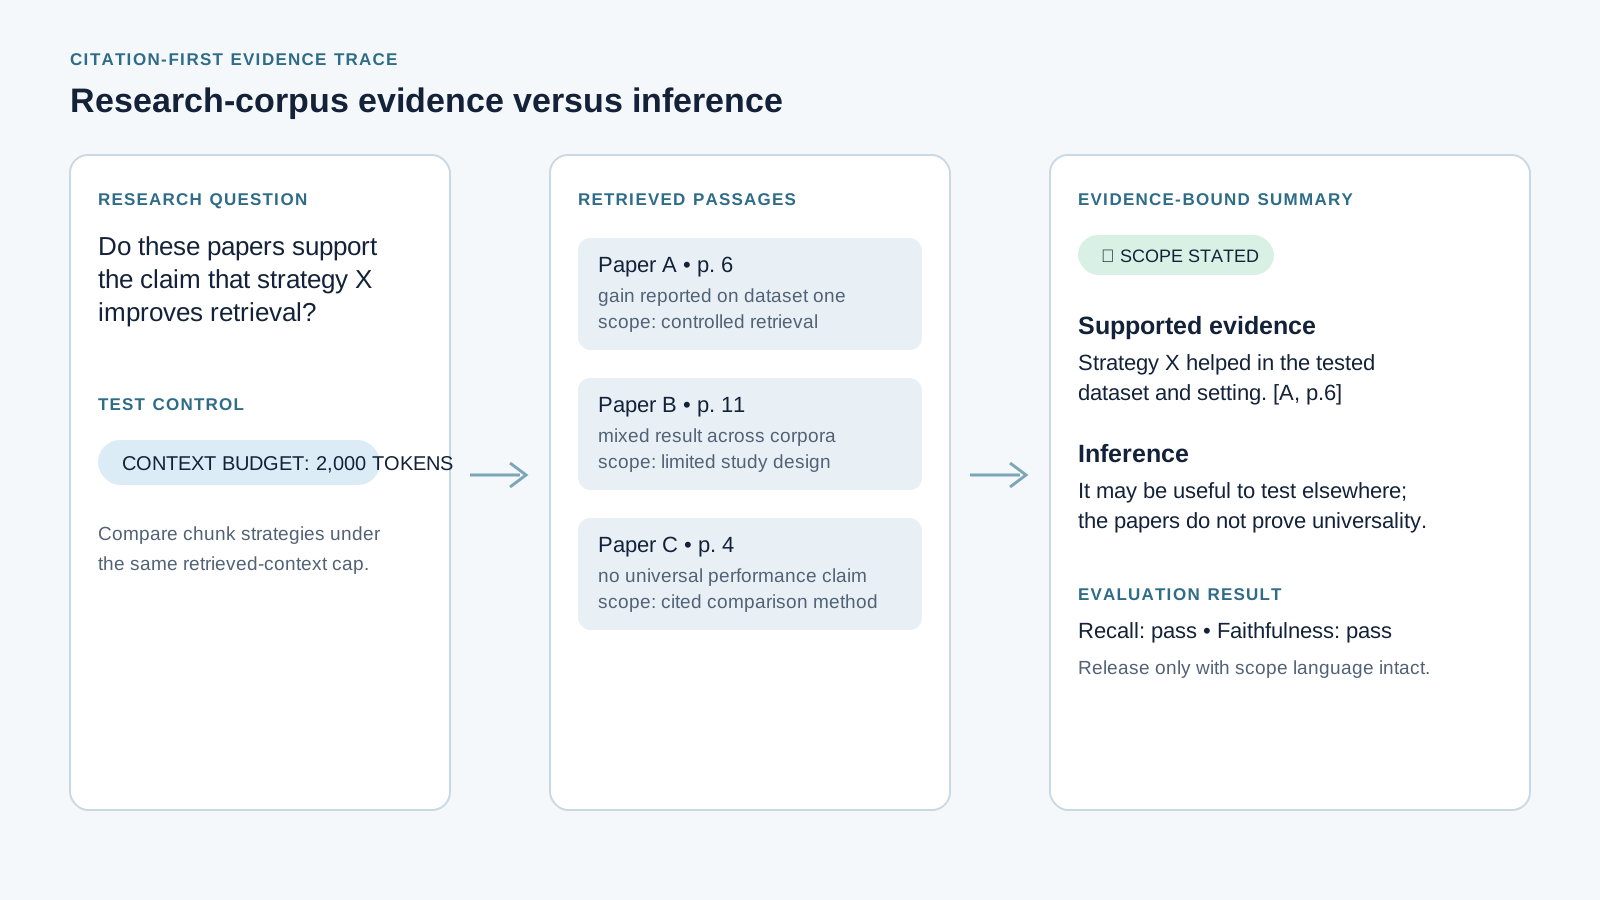
案例 3。研究語料庫答案區分三篇論文明確支持的內容與一項推論。檢索比較將上下文預算維持在 2,000 token。
擴展 GPT-6 Astra 知識庫而不失證明
試點模式會依領域而異。保留證據軌跡,但讓權威來源與拒絕界線因工作而異。
| 試點 | 權威來源 | 必要中繼資料 | 拒絕或呈報時機 | 人工發布關卡 |
|---|---|---|---|---|
| Enterprise 退款政策 | 簽署附錄、現行政策 | 帳戶、地區、生效日期、狀態 | 附錄缺漏或現行來源衝突 | 支援與政策負責人 |
| P1 事件 runbook | 現行 runbook 與呈報矩陣 | 服務、嚴重性、負責人、上次演練 | 行動缺少負責人或現行 runbook | 事件指揮官 |
| 研究語料庫 | 引用的論文段落 | DOI、頁碼、出版日期、方法 | 結論超出證據 | 主題專家審查者 |
對於程式碼與內部規則庫,為 AGENTS.md、架構決策、現行部署程序與已淘汰指令碼指定明確等級。對於研究,將「證據」與「推論」回傳為不同欄位。對於客戶支援,產品、地區與生效日期的篩選就完成多數可靠性工作。
成本與路由檢查清單。 一個高風險答案若使用 20K 輸入 token 與 2K 輸出 token,GPT-6 Astra 文字 token 成本約 $0.30:20,000 × $10 / 1,000,000 + 2,000 × $50 / 1,000,000。這不包含 File Search 與其他工具費用,上線前應在目前主控台查核。超過 272K token 的輸入有較高模型定價,因此 1M-token 提示不應是例行路徑。
| 任務風險 | 推理強度 | 證據規則 | 人工審查 |
|---|---|---|---|
| 標籤與路由 | 降低前先基準測試 | 僅中繼資料 | 抽樣 |
| 標準支援 | 測試後採中或高 | 現行引用來源 | 例外佇列 |
| 衝突、政策或事件 | 高 | 每項主張皆綁定來源 | 必要 |
| 法律、醫療、財務、人資、隱私 | 高 | 不完整時棄答 | 行動前必要 |
從上游開始控制成本:移除過時與無主檔案、檢索前先篩選中繼資料、先測試高價值問題,並保留清單、檢索到的段落、模型版本與發布決策。需要後續多模型路由的團隊,可將目前的 LLM API 文件 與自身試點結果一併檢視。
對於受監管、私人、就業、健康、財務或生產事件內容,檢索前套用存取篩選、確認資料處理與保留條款、保留撤回路徑,並將不完整證據路由給可問責的人員。在那些情境中,流暢的回應永遠不是最終建議。
常見問題
1M-token 上下文視窗會消除對 RAG 的需求嗎?
不會。它可以協助調查者閱讀更大的資料包,但不會建立文件權威、使用者存取、新鮮度、引用精確度或發布測試。例行證據選擇請使用檢索,並將廣泛上下文保留給例外調查。
什麼絕對不應進入 GPT-6 Astra 知識庫?
不要匯入無主檔案、無日期政策、沒有明確草稿工作流程的草稿、請求者未獲授權查看的內容,或缺少歷史使用規則的已封存素材。將那些檔案放入審查,或封存在一般檢索之外。
兩份互相矛盾的現行文件應如何處理?
回傳 ESCALATE、指出衝突、保留雙方引用,並指派負責人。模型不應默默編造打破平手的規則。清單需要在下一次發布前具備書面規則。
GPT-6 Astra 知識庫的最佳區塊大小是多少?
沒有通用數字。保留有意義的政策標題與條件,然後在相同上下文預算下比較策略。固定的 top-k 可能隱藏大得多的檢索 token 預算,讓實驗看起來比實際更好。
如何證明答案有正確來源依據?
為每個黃金問題儲存預期來源、檢索到的段落、最終的原子化主張,以及審查者對召回率、引用精確度、忠實度、衝突處理與棄答的評分。對於高風險答案,缺少支持連結即為失敗。
GPT-6 Astra 知識庫的成本是多少?
使用 token 公式,然後加上目前的 File Search 與工具費用。上述範例中,20K 輸入加 2K 輸出約為 $0.30 的模型 token。實際節省來自將過時素材排除在外,並在證據重要之處使用高推理。這就是 gpt-6 astra knowledge base best practices 的持久版本。


