

how i become a millionaire in 30 days 短片是一則笑話,內容是向聊天機器人詢問奇蹟般的捷徑,卻得到最不神奇的答案:「Get a job.」(去找份工作。)角色受挫的眼神、狂打字,以及第二次嘗試才是真正的故事。以下是兩個網路範例,展示同樣的鋪陳如何用在人類與寵物身上。接著,我們用原創角色、新場景、清楚可讀的對白,以及長到足以奏效的反應,打造一個更長的新版本。
重點摘要
- 可辨識的順序是:充滿希望的問題、直白的回覆、被冒犯的停頓,以及再試一次。
- 網路上的人類與寵物版本改變了表演者,卻保留了笑話的節奏。
- 我們原創的 26 秒遊樂場版本使用兒童表演者,並在剪輯時加入可讀對白,而不是要求影片模型畫出手機介面。
- 把「Get a job」當成寫好的笑點,而不是聊天機器人會怎麼回答的證據,也不是真正的致富計畫。
網路版本裡發生了什麼事?
第一個網路範例讓笑話貼近日常講電話的情境。一個人充滿自信地舉起手機,低頭看答案,然後突然失去自信。留意姿勢的變化。鋪陳是對著手機說,但笑點是朝著觀眾表演。這個反應讓那句簡短台詞令人難忘。
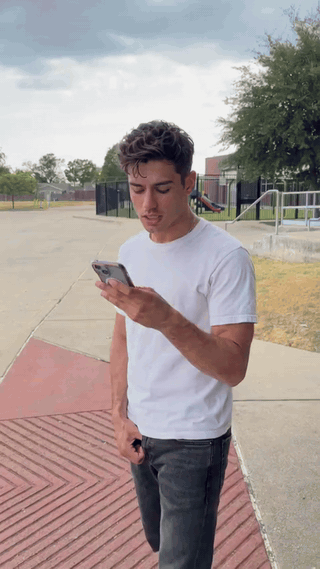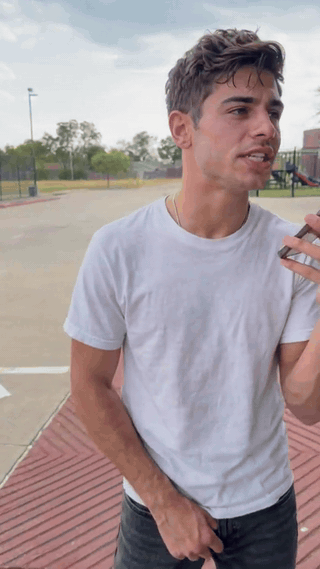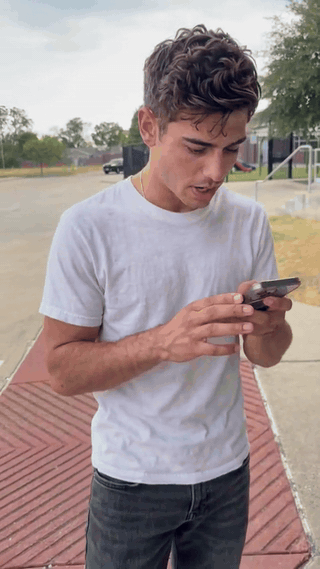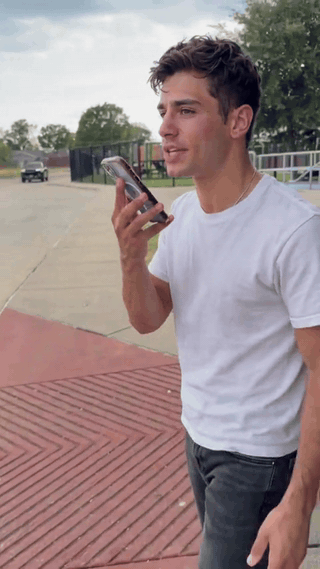
網路範例,人類版。關鍵視覺節拍是從充滿希望的語氣轉為明顯的難以置信。
第二個網路範例讓寵物扮演同樣的角色。牠直立的姿勢和手機道具,讓這份野心在答案出現前就顯得荒謬。轉頭和長時間盯著鏡頭,完成了人類演員會用眉毛和低聲抗議來做的事。這不只是換裝:動物的肢體語言改變了笑點的氛圍,而問題與回覆依然可辨識。
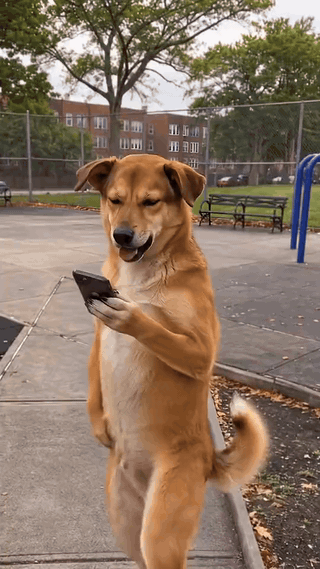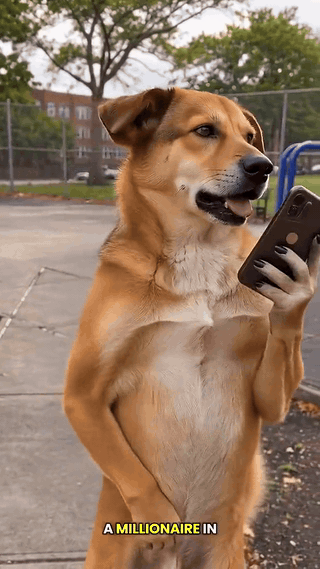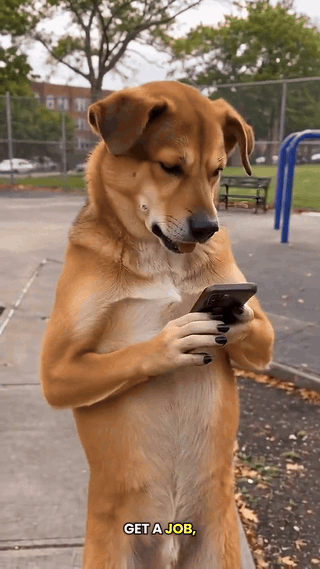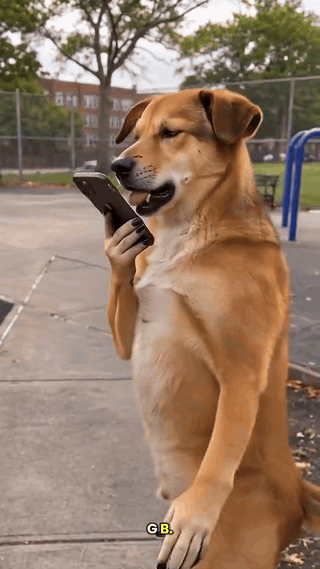
網路範例,寵物版。表演依靠直立姿勢、清楚可讀的手機動作,以及延遲出現的受冒犯神情。
這些是流傳中的影片格式範例,不是能確立某個聊天機器人回覆的錄影。喜劇短劇可以編排這段對話;AI 重製版可以生成表演者。這裡保留「how I become」這個說法,因為它是被搜尋的迷因台詞的一部分,儘管一般英文會說「how do I become」。這兩個說法都不會讓影片成為理財建議。
讓它可辨識的四個節拍
| 節拍 | 觀眾看到什麼 | 為什麼重要 |
|---|---|---|
| 提問 | 手機被舉起,彷彿能揭示秘密 | 角色的自信鋪陳出過大的期待。 |
| 回覆 | 「Get a job.」(去找份工作。)出現或被朗讀出來 | 答案刻意平淡又簡短。 |
| 反應 | 角色愣住、抬頭看,或直視鏡頭 | 這個停頓讓觀眾和角色一起發現那句冒犯。 |
| 再問一次 | 快速打字或再傳一則語音訊息 | 角色拒絕接受這個平凡答案,延長了笑話。 |
順序比精確的鏡頭長度更重要。如果回覆在觀眾理解問題之前就出現,就沒有對比。如果反應立刻被剪掉,笑點就沒有呼吸的空間。如果角色只是走開,短片就失去讓這個格式獨特的固執第二次嘗試。
如何做出屬於你自己的版本?
先從笑話的結構開始,再改變表演、場景和結局。逐鏡重拍別人的影片,會讓成果更難辨識,也讓你更難掌控對白。在我們的示範中,我們把一個虛構的孩子放在陽光充足的遊樂場。孩子帶著明亮的樂觀問如何成為百萬富翁的捷徑,然後得到直白的「Get a job.」回覆。這個建議對孩子來說刻意荒謬;從欣喜到難以置信的轉變撐起了笑話。手機螢幕面向孩子,所以模型永遠不需要發明應用程式按鈕或可讀訊息。
有用的設計限制是把表演和文字分開。影片模型可以讓一個人舉起手機、閱讀、退縮和打字的動作動起來。它在移動中的手機上渲染精確聊天文字時較不可靠。因此我們先生成演出,之後再加入乾淨的編輯字幕。字幕呈現的是笑話的腳本台詞;它們並非作為真實 ChatGPT 對話的截圖來呈現。
1. 建立一致的首幀
使用 16:9 橫向圖片,讓孩子的臉、雙手和手機都可見。半身構圖能留出空間讓表情變化,同時不會失去孩子身後色彩鮮豔的溜滑梯和鞦韆。留一些整潔的空間給字幕。首幀應該看起來充滿希望,而不是已經震驚。
在本文中,首幀是以 Atlas Cloud 上的 Seedream v5.0 Pro 生成的。提示詞刻意寫得具體:
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
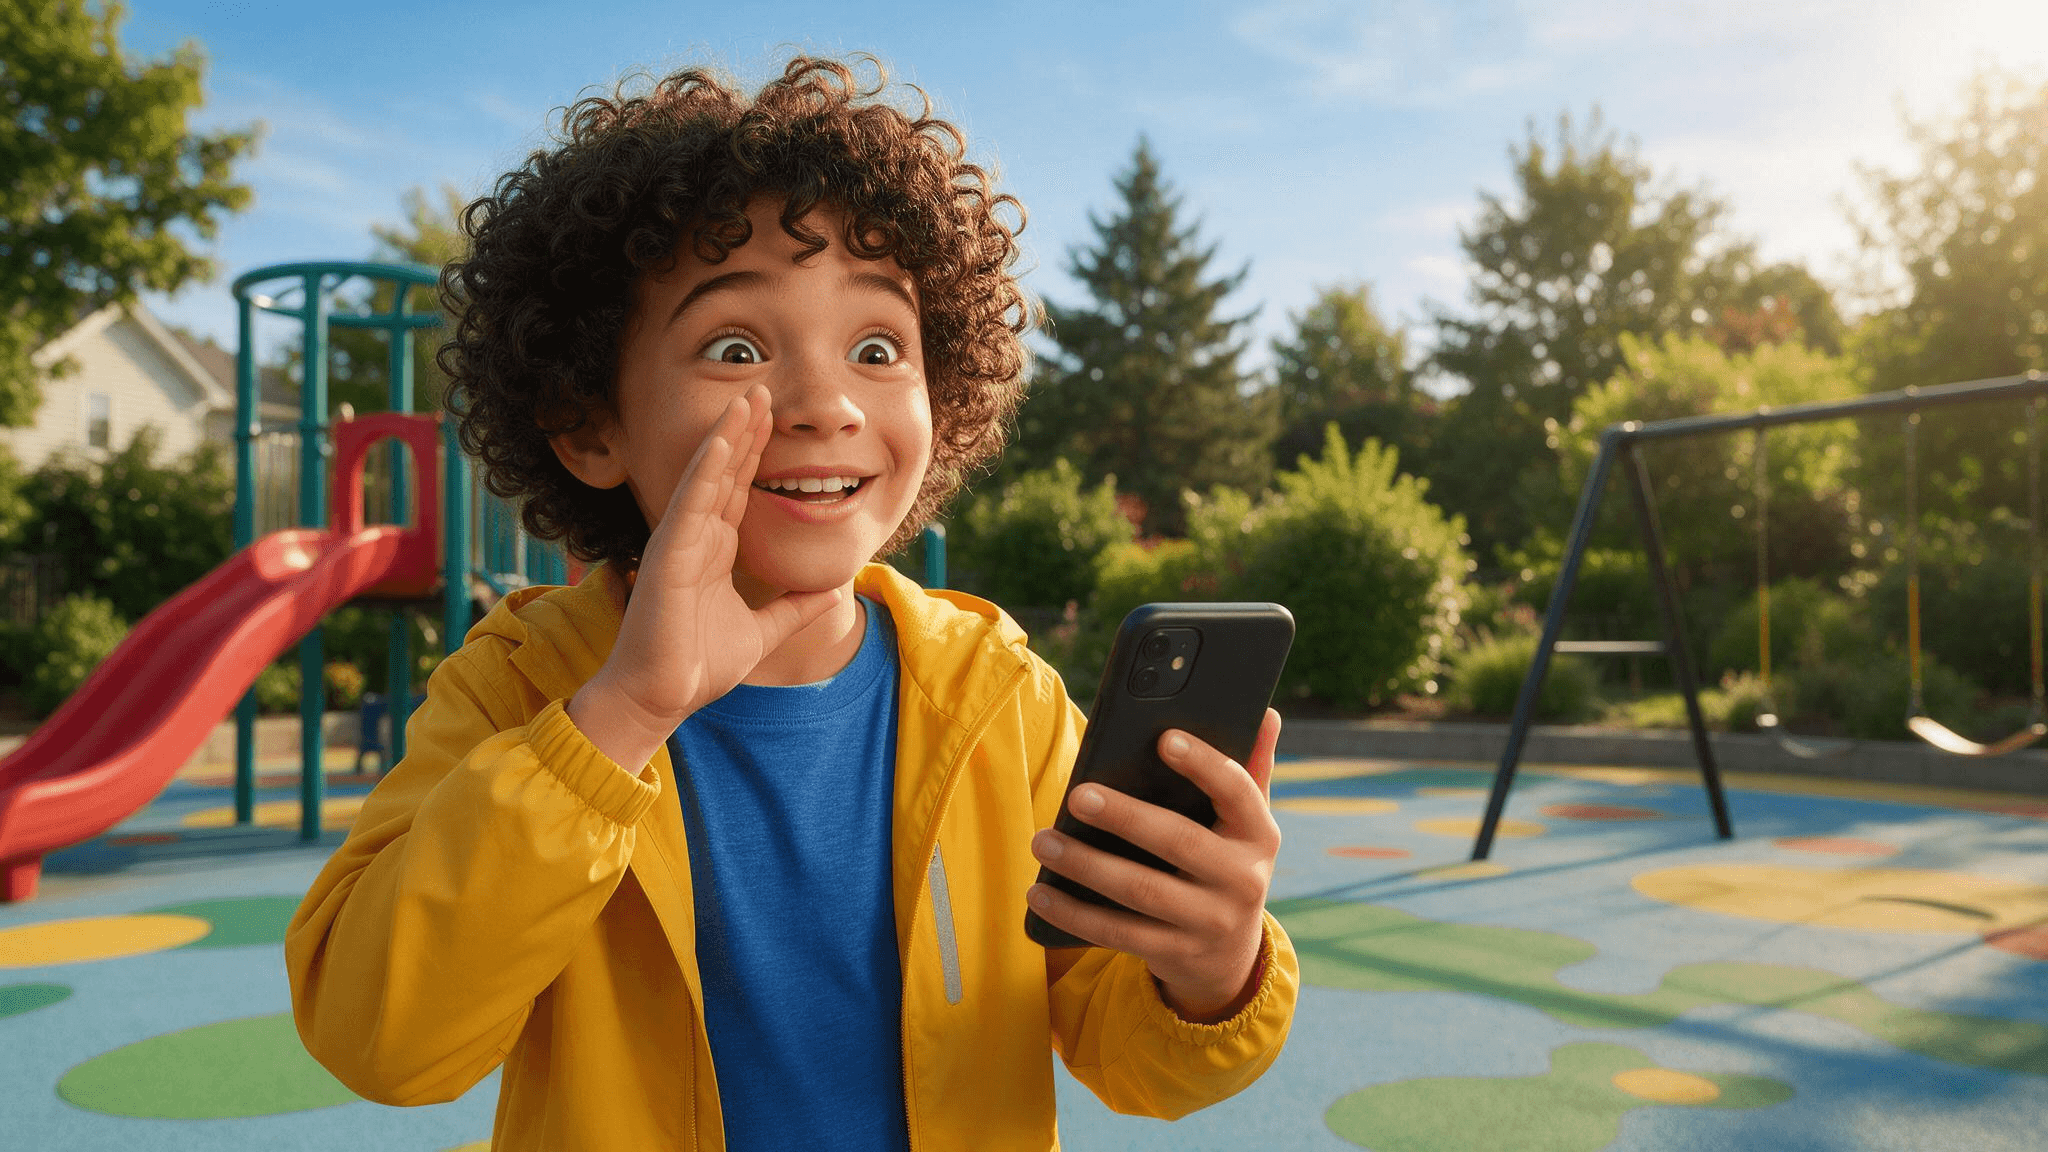
我們生成的首幀。孩子燦爛的笑容和上揚的眉毛建立了充滿希望的開場;溜滑梯和鞦韆讓新場景一目了然。
2. 讓完整的反應動起來,而不是會動的肖像
將首幀用作 Atlas Cloud 上的 Seedance 2.5 Image-to-Video 的圖片輸入。我們把目標設為 26 秒、16:9 橫向、含聲音。提示詞要求一連串不同的臉部反應。它不要求模型顯示聊天泡泡或拼出笑點,因為那些確切文字會在剪輯時加入。
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
交付的短片讓情緒轉變很容易理解:孩子一開始咧嘴笑,看到第一個回覆時驚訝張嘴,皺眉,再打另一個問題,最後無奈地聳肩。下方的額外定格畫面捕捉了平凡答案推翻孩子百萬富翁計畫的瞬間。
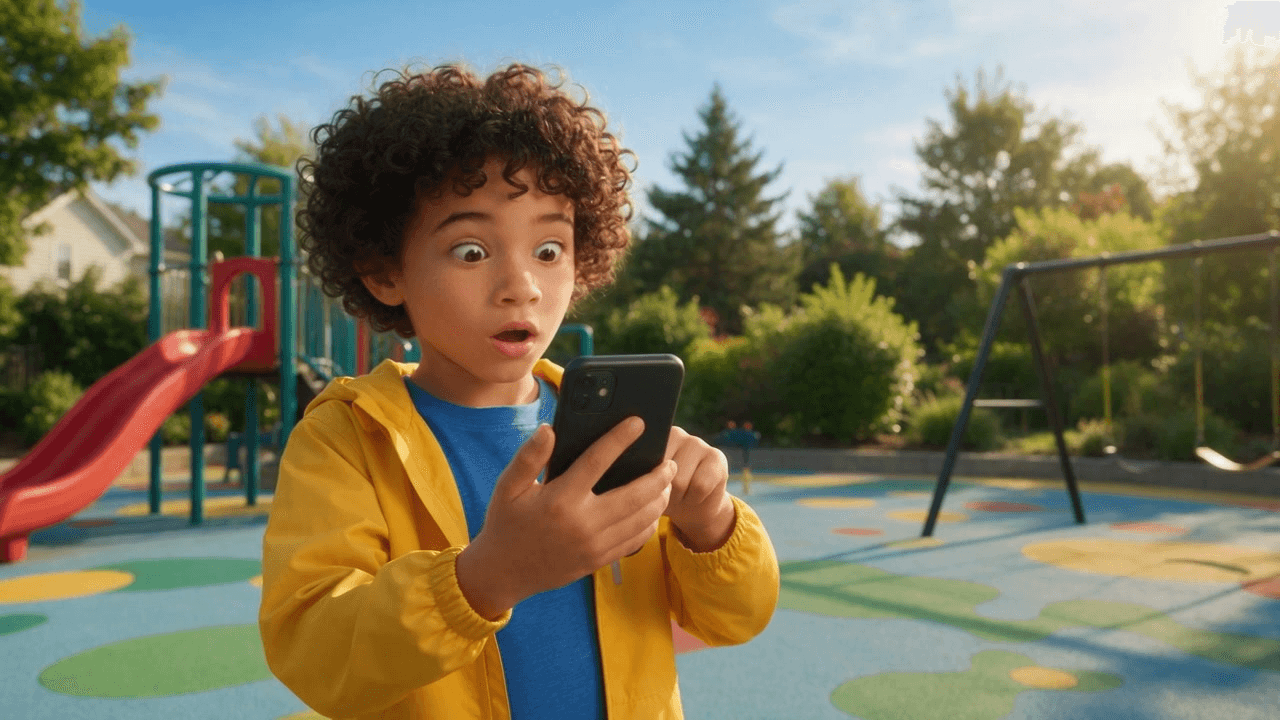
生成影片約 6 秒處的畫面。與充滿希望的首圖相比,睜大的眼睛和張開的嘴讓笑點的效果立刻可見。
3. 加入精確對白,並讓笑話在無聲時也能讀懂
簡短的腳本就夠了。在孩子對著手機說話時,把問題放到畫面上;只有在孩子讀到回覆時,才帶入「Get a job.」;並在抗議前留一個節拍。後續追問要用新的問題,而不是逐字重複開場。字幕應放在一致的安全區域,對比強烈,且絕不能遮住臉或手。
| 我們 26 秒剪輯中的時刻 | 編輯字幕 | 表演提示 |
|---|---|---|
| 開場 | 「How I become a millionaire in 30 days?」(我如何在 30 天內成為百萬富翁?) | 明亮、確定地對著手機說。 |
| 回覆 | 「Get a job.」(去找份工作。) | 眼睛垂向螢幕;笑容消失。 |
| 反應 | 「Seriously?」(認真的嗎?) | 驚訝在打字前轉為皺眉。 |
| 第二次嘗試 | 「Okay, but what if I skip that part?」(好吧,但如果我跳過那部分呢?) | 手機再次舉起;語氣轉為懇求。 |
文字要短到能一眼讀完。不要捏造逼真的聊天截圖來證明這句話是應用程式生成的。設計清楚的字幕能誠實傳達腳本對話,並讓 16:9 短片在靜音時也能理解。原始音訊會保留在影片中;顯示的四行是編輯字幕。
4. 匯出、檢查並標示
匯出一個連續的 MP4,而不是把來源短片切成好幾個文章嵌入。匯出後檢查實際長度。要求的 26 秒只有在檔案真的超過 20 秒,而且多出的時間包含有意義的動作時才重要。在本文中,最終原創範例以海報畫格嵌入下方,讓讀者能看到完整的序列。
我們的原創範例:遊樂場裡的孩子提問、得到直白回覆、難以置信地盯著看、打字,然後在單一 26 秒橫向影片中再試一次。字幕是加在生成表演上的編輯內容。
在發布 AI 生成的真實場景前,請在適用時使用平台的 AI 內容標籤。TikTok 的 AI 生成內容指引 說明了其標示工具與真實 AI 媒體的要求。YouTube 的變造或合成內容指引 說明了上傳時的揭露方式。使用你自己的肖像、虛構角色,或同意入鏡的參與者。上方兩個網路 GIF 是供分析用的範例;發布重製版需要你自己的素材、聲音和授權。
什麼讓笑點在較長剪輯中奏效?
26 秒版本需要的不是把 13 秒迷因複製兩次。我們讓孩子明顯改變策略。起初,手機被當成捷徑機器。收到回覆後,孩子不只是重複要求:他們皺眉、打字、重新表述,並試著與答案討價還價。這個轉變讓最後一個節拍變成新的笑話,而不是灌水。
靜音時的可讀性也會改變剪輯。在動態消息中,觀眾可能會以靜音狀態看到短片。字幕需要在正確時刻揭示問題和回覆,而演員的動作提供情緒。延遲出現的「Seriously?」(認真的嗎?)字幕不該在第一個愣住畫格時就出現;無聲的表情要先出現。那個微小停頓就是觀眾讀臉的時刻。
最後,讓鋪陳保持真實。這部影片是編排好的喜劇場景,那句台詞是寫好的笑哏。它不展示真實的聊天機器人對話,也不保證任何人都能在 30 天內致富。下一個有用的行動是選擇原創表演者和場景、為四個節拍畫分鏡,並測試別人能否在關掉聲音的情況下理解你的草稿。如果他們能辨識出問題和受冒犯的第二次嘗試,這個格式就奏效了。
常見問題
聊天機器人真的回答了「Get a job」嗎?
這句話是喜劇格式中的笑點。影片中出現它,並不代表真實聊天機器人對話,也不代表你一定會收到這種回覆。
我可以用寵物或朋友來做這個迷因嗎?
可以,只要你有一張合適的照片,並取得任何入鏡者的同意。寵物版需要清楚的眼睛、口鼻和毛色特徵。朋友版需要清楚的臉,以及他們同意被描繪成說出這些台詞。
為什麼要使用影片模型,然後再另外加字幕?
模型負責動作和演出;編輯負責精確文字。把這些工作分開,可以避免手機畫面文字亂碼,並讓你掌控笑點出現的時機。
這裡的原創範例超過 20 秒嗎?
是的。交付的 MP4 是在匯出後驗證,而不是只依賴生成器中選擇的長度。多出的時間用於第二次嘗試和最後的反應。





