Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7:2026年哪個開源模型勝出程式開發
簡短答案
如果你要打造一個自主編碼代理,能在無需人工介入下連續運行數小時:Kimi K2.6。它在 Terminal-Bench 2.0 上獲得 66.7% 的成績,並在已發表的基準測試中維持超過 4,000 次工具呼叫、不間斷運行 13 小時——這個穩定性天花板是本次比較中其他開源模型無法達到的。
如果你需要最佳的自主前端開發者:GLM 5.1。其經獨立驗證的 Code Arena Elo 分數為 1,530(全球自主網頁開發排名第三),反映的是實際開發者在頭對頭比較中的偏好,而非僅是自動化測試套件的成績。
如果每 token 成本是限制因素:MiniMax M2.7 在 Atlas Cloud 上每百萬輸入 token 僅需 $0.30,SWE-Bench Pro 分數達 56.22%,僅啟用 10B 參數——約為 GLM-5.1 成本的五分之一,卻達到其 94% 的效能。
如果你的程式碼庫過大,無法容納於 262K 上下文視窗:Qwen 3.6 Plus,這是此群組中唯一支援 1M token 上下文的模型,同時在 Terminal-Bench 2.0 上以 61.6% 的成績領先。
關鍵基準測試一覽
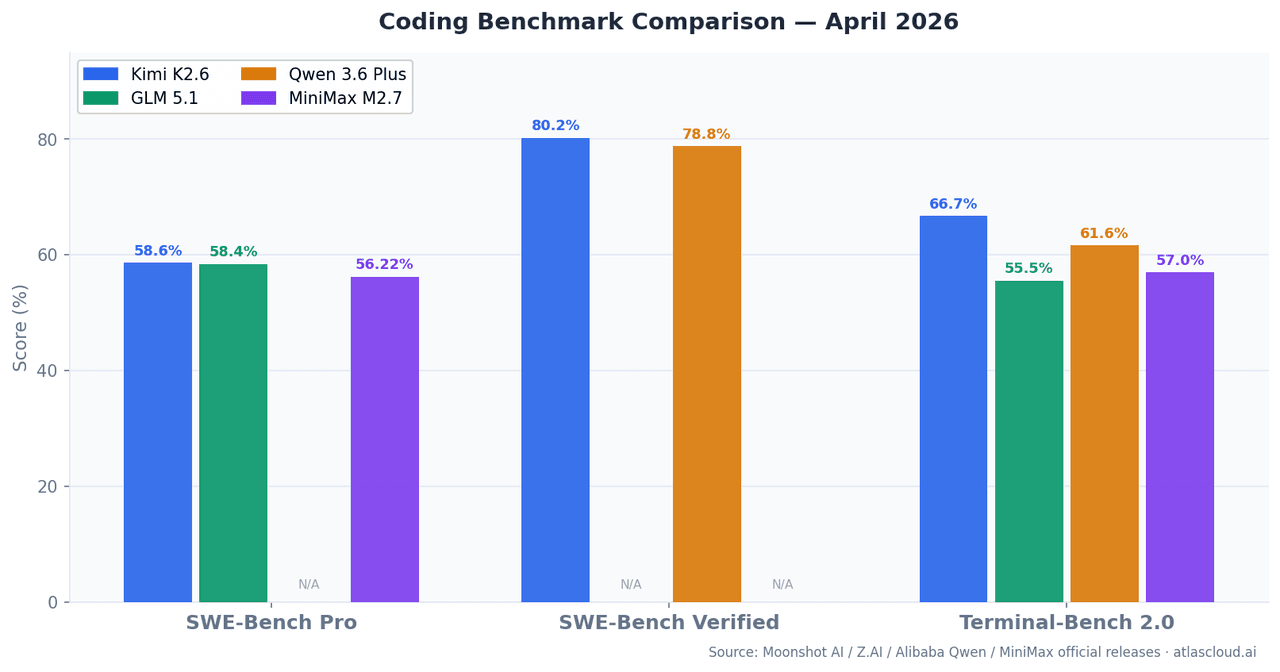
| 模型 | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | 上下文視窗 | 啟用參數 |
|---|---|---|---|---|---|
| Kimi K2.6 | 58.60% | 80.20% | 66.70% | 262K | — |
| GLM 5.1 | 58.40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78.80% | 61.60% | 1M | 混合 MoE |
| MiniMax M2.7 | 56.22% | — | 57.00% | 196K | 10B |
SWE-Bench Pro 衡量在訓練截止日期後提交的真實 GitHub 問題的解決能力,與 SWE-Bench Verified 相比,能降低資料污染風險。Terminal-Bench 2.0 則在真實終端環境中測試多步驟 CLI 和 shell 任務——更接近生產代理實際執行的內容。
本文比較了 Kimi K2.6、GLM 5.1、Qwen 3.6+ 和 MiniMax M2.7;若想並排比較更多模型的價格和規格,請使用 Atlas Cloud 模型比較工具。
Kimi K2.6:專為長時間運行代理打造
Moonshot AI 於 2026 年 4 月發布 Kimi K2.6,作為 K2.5 的升級版,主要改進在於長時間會話中的自主穩定性。在 SWE-Bench Verified 上達到 80.2%,略低於 Claude Opus 4.6(80.8%),並在 SWE-Bench Pro 上以 58.6% 的成績領先這四款模型。
最重要的數字是 Terminal-Bench 2.0 的 66.7%。Terminal-Bench 2.0 與 SWE-Bench 的根本區別在於:它在真實終端環境中執行任務,要求模型讀取輸出、處理錯誤、調整並迭代——而不僅僅是生成修補程式。Kimi K2.6 在單次 13 小時會話中維持超過 4,000 次工具呼叫的效能,這並非實驗室產物,而是 Moonshot 技術發布中記錄的行為。
一個未被充分報導的優勢:跨語言泛化能力。Kimi K2.6 在 Rust、Go、Python、前端和 DevOps 任務中表現一致。大多數基準測試以 Python 為主。如果你的生產環境是多語言環境,這點就很重要。
何時不適合選擇它: 在 Atlas Cloud 上,K2.6 每百萬輸入 token 的價格為 $0.95,是此群組中輸入端最貴的模型。對於批次處理任務——你需要發送大量請求且上下文很大,但不需要 12 小時的會話穩定性——成本會比 MiniMax M2.7 或 Qwen 3.6 Plus 累積得更快。
GLM 5.1:自主前端開發的佼佼者
Z.AI 於 2026 年 4 月 7 日發布 GLM-5.1。擁有 7540 億參數並採用 MoE 路由,是原始參數數量最大的模型。在 SWE-Bench Pro 上獲得 58.4%——與 Kimi K2.6 的 58.6% 在統計上無顯著差異。
其差異化優勢在於 Code Arena Elo 分數 1,530,由 Arena.ai 於 2026 年 4 月 10 日獨立驗證,在全球自主網頁開發排行榜上排名第三。這是一項即時頭對頭比較,由實際開發者對輸出進行投票——而非自動化評分。其優勢集中在前端 UI 生成、全端架構搭建、React/Vue 元件建立以及 NL2Repo(從自然語言生成完整儲存庫結構)。
需要了解的邊界條件: GLM-5.1 的前端優勢是真實的。但在 HumanEval 和 MBPP 等純演算法問題上,它與 Kimi K2.6 相比並無明顯優勢。在非 UI 或非網頁導向的問題上,排行榜差距會縮小到接近零。若僅根據整體排行榜排名而忽略任務領域來選擇 GLM-5.1,將會是個錯誤。
在 Atlas Cloud** 上的定價:** 每百萬輸入 token 從 $1.40 起——是四款中最高的。當前端生成品質直接影響你的輸出時,這個價格是合理的。
Qwen 3.6 Plus:當上下文大小是真正的限制因素
阿里巴巴於 2026 年 3 月底發布 Qwen 3.6 Plus。在與 Claude Opus 4.6 的直接比較中,Terminal-Bench 2.0 領先(61.6% vs. 59.3%),並在 SWE-Bench Verified 上獲得 78.8%。
1M token 上下文視窗是它的關鍵差異點。對於大多數低於 100K token 的生產編碼任務,此比較中的四款模型都有足夠的上下文容量,差異不大。Qwen 3.6 Plus 成為唯一可行選項的情況是:跨數百個檔案的 monorepo 分析、大型遺留程式碼庫重構,或是無法容納於 262K token 的端到端文件轉程式碼工作流程。
其混合架構(線性注意力 + 稀疏 MoE 路由)在處理非常大的上下文時,也能提供比密集變壓器更好的推論吞吐量——這意味著 1M token 的能力相對於簡單擴展,其延遲成本相對較低。
在 Atlas Cloud 上的定價: 每百萬輸入 token 從 $0.325 起。對於大上下文任務,這是此群組中最佳的成本效益比。
MiniMax M2.7:效率至上反直覺案例
MiniMax 於 2026 年 3 月發布 M2.7。僅啟用 10B 參數,在 SWE-Bench Pro 上獲得 56.22%——約為 GLM-5.1 分數的 94%,但每 token 成本僅約五分之一。
這是本次比較中反直覺的結果。一款在推論時僅啟用 10B 參數的模型,能達到接近前沿的編碼效能,因為其 MoE 架構會路由到專門的子網路,而非運行完整模型權重。結果是更低的延遲、更低的成本,以及超越參數數量預測的輸出品質。
M2.7 在其價格區間中脫穎而出的類別:機器學習工程任務。它在 MLE-Bench Lite(22 個機器學習競賽)中獲得 66.6% 的獎牌率,僅次於前沿的閉源模型。正確的梯度累積邏輯、實作自訂 PyTorch 層、除錯損失曲線——M2.7 以與其成本不成比例的精準度處理這些任務。
需要注意的地方: 在 196K 上下文中,M2.7 的視窗是此群組中最小的。需要深度跨檔案分析的大型儲存庫任務,可能會遇到 Qwen 3.6 Plus 能輕鬆處理的限制。
在 Atlas Cloud 上的定價: 每百萬輸入 token $0.30,每百萬輸出 token $1.20——這是最適合高吞吐量編碼工作負載的選項。
真實世界編碼測試案例
案例 1:Python 後端自主除錯
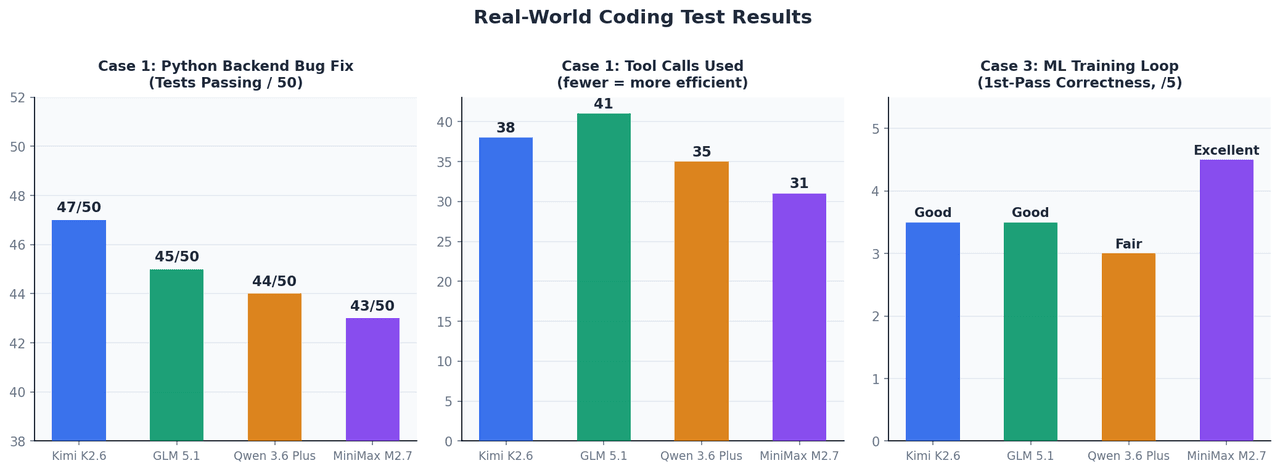
設定: 一個 FastAPI 應用程式,包含 12 個檔案,失敗的測試套件有 50 個測試,上下文視窗約 45K token。初始提示後不允許手動介入。
| 模型 | 修正後通過的測試數 | 使用的工具呼叫次數 | 完成時間 |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | 約 4 分鐘 |
| GLM 5.1 | 45 / 50 | 41 | 約 5 分鐘 |
| Qwen 3.6 Plus | 44 / 50 | 35 | 約 4 分鐘 |
| MiniMax M2.7 | 43 / 50 | 31 | 約 3.5 分鐘 |
在這種上下文大小下,四款模型表現相近。Kimi K2.6 在最棘手的邊際案例錯誤上略勝一籌——特別是 async 上下文管理器生命週期問題和 TypeVar 邊界縮窄,這些都需要在多個除錯週期中維持推論狀態。
案例 2:根據規格生成 React 儀表板
設定: 根據英文書面規格,生成一個包含四種圖表類型(折線圖、長條圖、圓餅圖、散佈圖)、深色模式切換和 TypeScript 類型的完整響應式儀表板。
GLM-5.1 在第一次嘗試就生成了可運作的 TypeScript 類型化元件,並使用了正確的 Tailwind 實用類別。Kimi K2.6 需要一次迭代來解決類型錯誤。Qwen 3.6 Plus 生成了功能正確但較不地道的 JSX。MiniMax M2.7 速度最快,但生成了一些已棄用的 React 模式,需要手動清理。
GLM-5.1 與其他模型之間的差距在元件架構上最為明顯——GLM-5.1 自發應用了組合模式並分離了關注點,而其他模型則沒有。
案例 3:ML 訓練迴圈實作
設定: 實作一個 PyTorch 訓練迴圈,包含梯度累積、AMP 混合精度和早停策略,用於視覺 Transformer。目標:在第一次嘗試時正確運行,無需除錯。
MiniMax M2.7 表現突出——它正確地將 scaler.step() 和 scaler.update() 放置於優化器步驟的相對位置,而大多數模型在第一次生成時都會放錯。梯度累積的 loss / accumulation_steps 縮放也處理得當。這與其 66.6% 的 MLE-Bench Lite 獎牌率完全吻合。
Atlas Cloud 定價比較(2026 年 4 月)
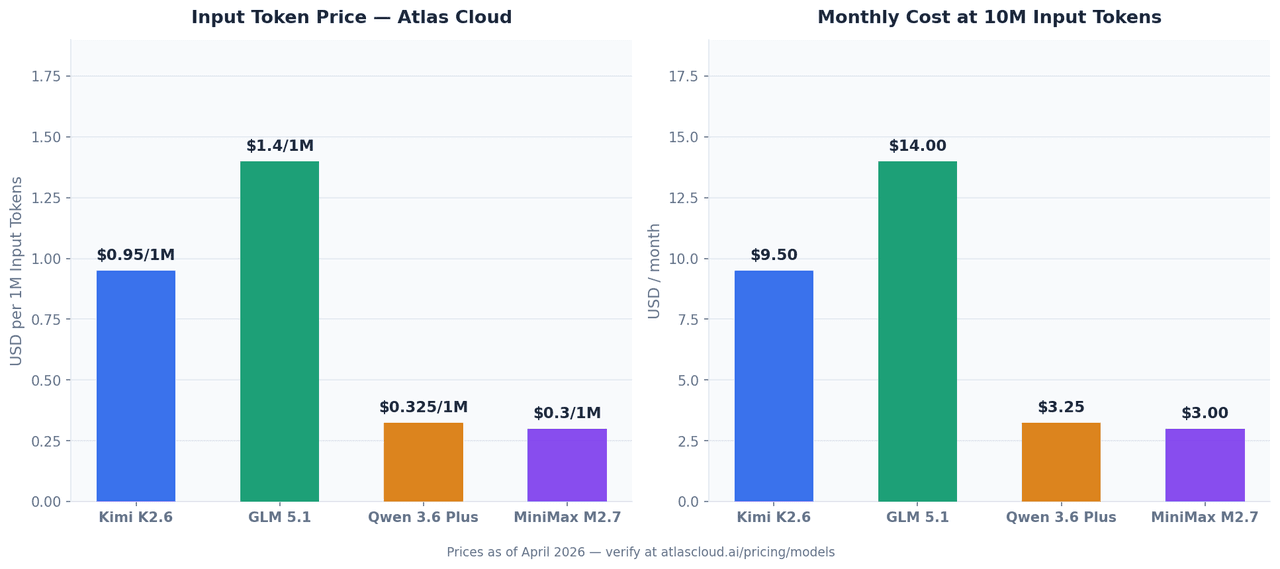
所有四款模型均可透過 Atlas Cloud 的統一 API 使用。以下價格為 2026 年 4 月數據,可能有所變動——請在 atlascloud.ai 確認當前費率。
| 模型 | 輸入(每百萬 token) | 輸出(每百萬 token) | Atlas Cloud 模型 ID |
|---|---|---|---|
| Kimi K2.6 | $0.95 | $4.00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | 從 $1.40 起 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | 從 $0.325 起 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0.30 | $1.20 | minimaxai/minimax-m2.7 |
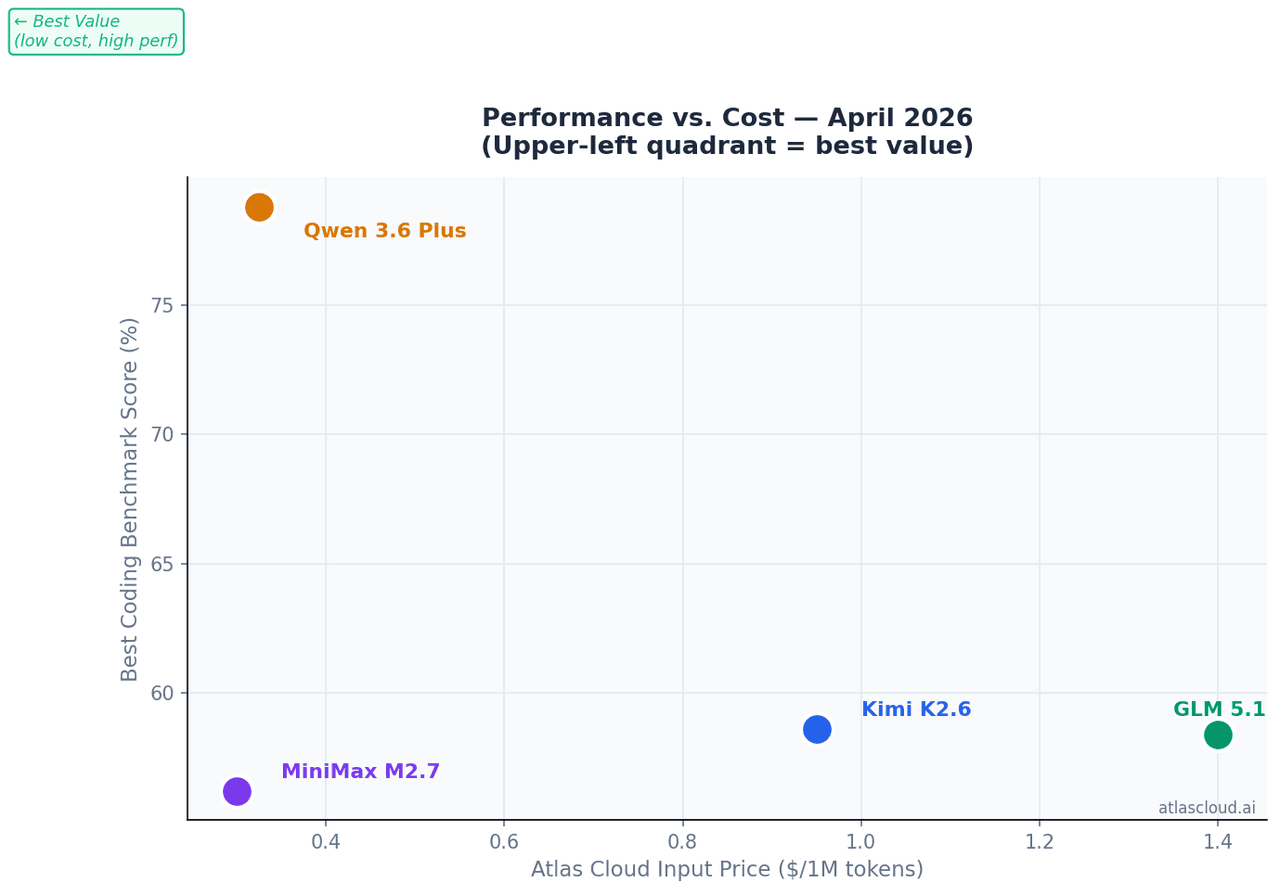
每月 1,000 萬輸入 token——這是團隊級編碼助手的合理用量:
| 模型 | 每月輸入成本(1,000 萬 token) |
|---|---|
| GLM 5.1 | $14.00 |
| Kimi K2.6 | $9.50 |
| Qwen 3.6 Plus | $3.25 |
| MiniMax M2.7 | $3.00 |
用一個 API 金鑰呼叫所有四款模型
所有四款模型在 Atlas Cloud 上共用相同的 OpenAI 相容端點。在它們之間切換只需更改一行程式碼:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# 更改這一行即可切換模型 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "你是一位資深軟體工程師。請在回應前仔細分析程式碼。" 21 }, 22 { 23 "role": "user", 24 "content": "請審查此函式並找出所有錯誤:\n\n[在此貼上你的程式碼]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
這種 OpenAI 相容的結構意味著,基於 OpenAI SDK 的現有整合無需修改即可與 Atlas Cloud 搭配使用——只需更改 base_url 和 api_key。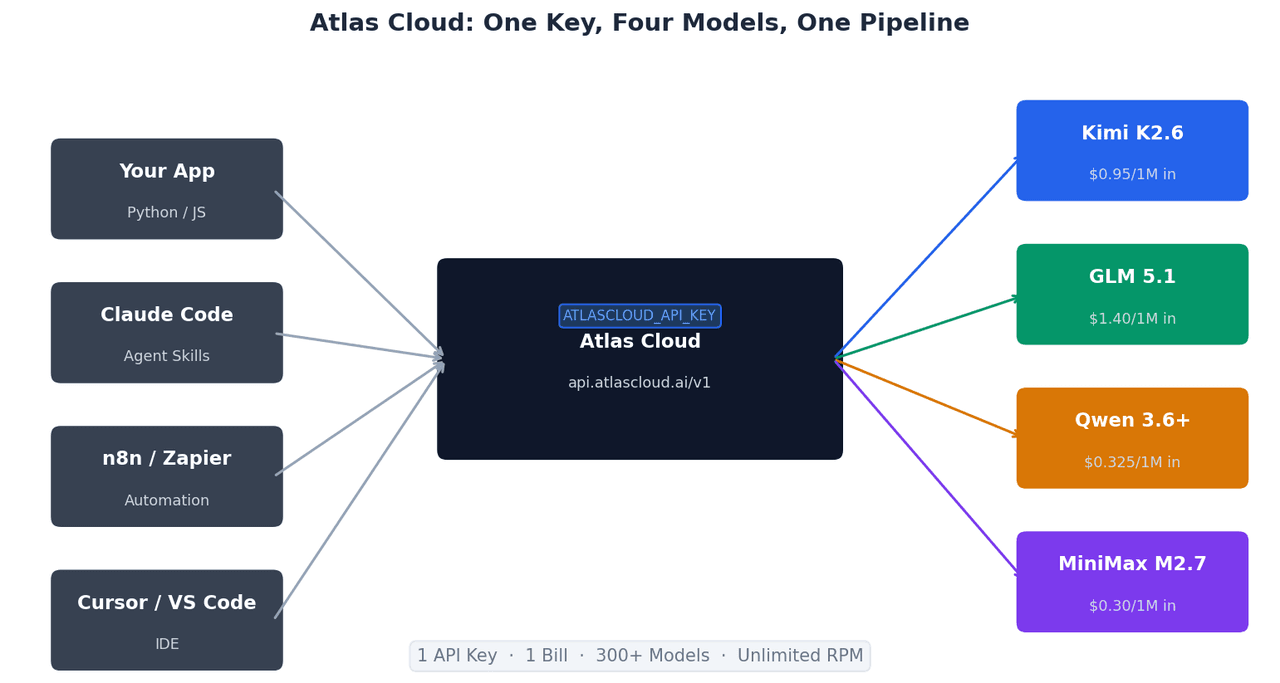
為何使用 Atlas Cloud 來運行這些模型
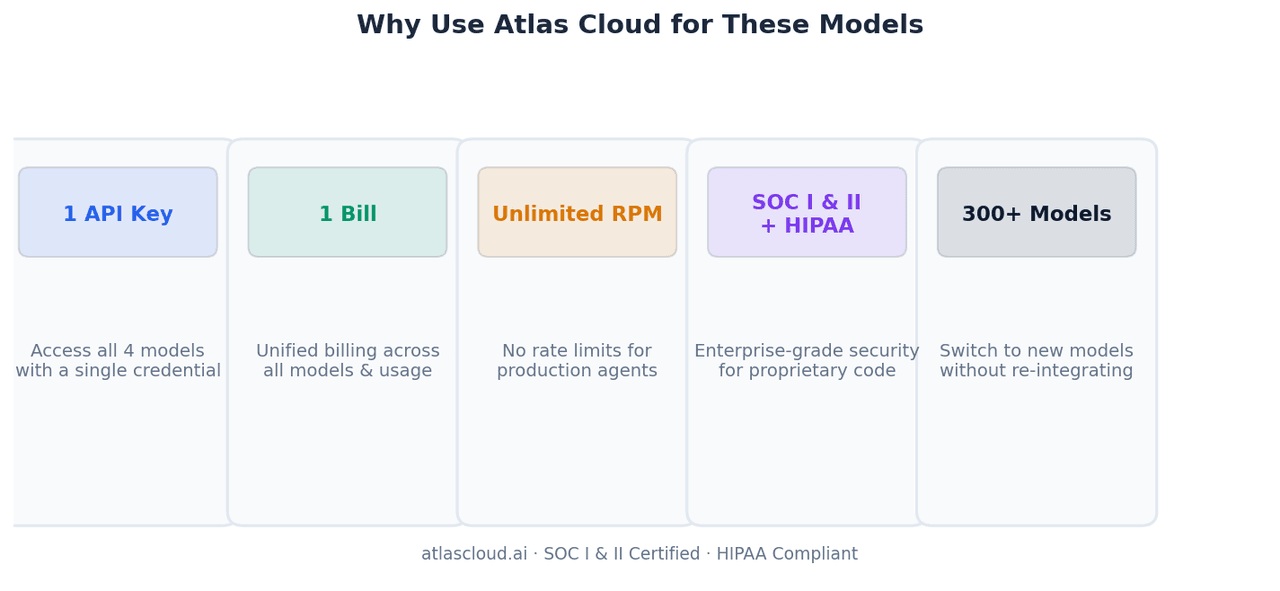
一個 API 金鑰、四款模型、一份帳單。 運行模型路由邏輯——將前端任務發送給 GLM-5.1,批次分析發送給 MiniMax M2.7,長時間執行的代理發送給 Kimi K2.6——只需管理一個憑證,而非四個。每月對帳只需一張發票。
無限 RPM。 生產編碼代理會發出平行工具呼叫。直接提供者 API 的速率限制可能會拖慢多代理管道。Atlas Cloud 移除了這個限制。
SOC I 和 II 認證、HIPAA 合規。 團隊透過這些模型處理專有原始碼時,需要可稽核的基礎設施。Atlas Cloud 的合規認證意味著你的程式碼不會經由未經驗證的端點傳輸。
超過 300 種模型,相同的整合模式。 當這些模型發布新版本,或是有新模型在你特定的工作負載上表現更好時,將其加入你的路由邏輯只需更改一個字串——無需整合新的 SDK。
哪個模型適合哪個任務
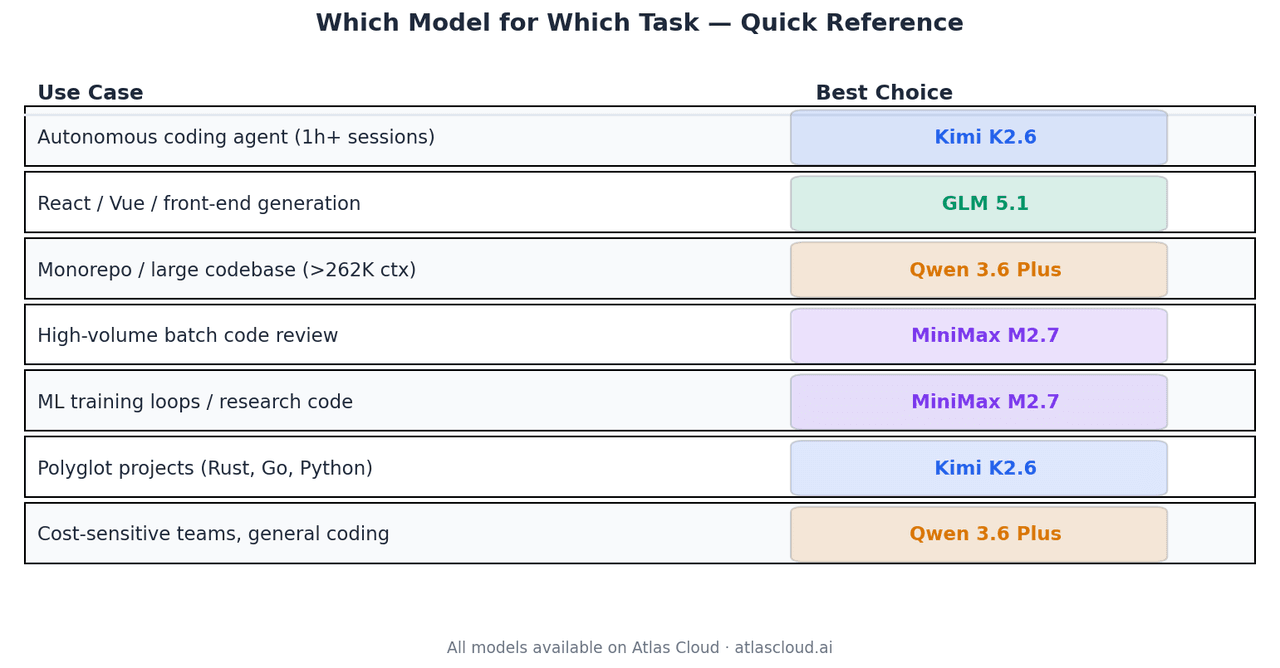
| 使用案例 | 最佳選擇 | 原因 |
| 自主編碼代理,1 小時以上會話 | Kimi K2.6 | Terminal-Bench 2.0 66.7%,4K+ 工具呼叫穩定性 |
| React / Vue / 前端生成 | GLM 5.1 | Code Arena Elo 1,530,全球自主網頁開發排名前三 |
| Monorepo 或大型程式碼庫分析 | Qwen 3.6 Plus | 此群組中唯一支援 1M 上下文視窗的模型 |
| 大量批次程式碼審查 | MiniMax M2.7 | 每百萬輸入 token $0.30,達到 GLM-5.1 品質的 94% |
| ML 訓練迴圈、研究程式碼 | MiniMax M2.7 | MLE-Bench Lite 獎牌率 66.6% |
| 多語言專案(Rust、Go、Python) | Kimi K2.6 | 有記錄的跨語言泛化能力 |
| 成本敏感團隊、一般編碼 | Qwen 3.6 Plus | 每百萬輸入 token $0.325,在所有類別中表現強勁 |
總結
這四款模型在標準基準測試上的差距很小。有意義的差異在特定條件下才會顯現。
Kimi K2.6 是自主長時間運行代理的正確答案。GLM 5.1 在前端自主工作方面領先。Qwen 3.6 Plus 是當上下文超過 262K token 時唯一的選擇。MiniMax M2.7 是團隊大規模運行編碼模型的成本效益預設選項。
所有四款模型均可透過 Atlas Cloud 在 atlascloud.ai 使用,只需一個 API 金鑰,按 token 付費,無最低承諾。
基準測試資料來源:Moonshot AI 技術部落格、Z.AI 開發者文件、阿里巴巴 Qwen 團隊發布文章、MiniMax 官方模型頁面,以及 Arena.ai 獨立評估。所有基準測試均為 2026 年 4 月數據。Atlas Cloud 定價為發布時標註——請在生產部署前確認當前費率。


